Este protocolo integra registros comportamentais multimodais para avaliar correlatos observáveis do esforço cognitivo e a eficácia funcional da revisão na tradução escrita e na interpretação simultânea entre inglês e chinês. Ele combina registro de digitação, captura de tela, análise de áudio, codificação baseada em transcrição e avaliação de qualidade padronizada.
Artigo de método
Um Protocolo Comportamental para a Avaliação do Esforço Cognitivo e da Revisão Estratégica em Tarefas de Tradução e Interpretação à Vista de Inglês para Chinês
Neste artigo
Resumo
Resumo
Este artigo apresenta um protocolo comportamental multimodal para examinar correlatos observáveis de esforço cognitivo e revisão estratégica durante tradução escrita e interpretação simultânea do inglês para o chinês. Registros de digitação e gravações de tela são sincronizados para a tradução escrita, enquanto gravações de áudio e transcrições literais são utilizadas na interpretação simultânea. Episódios de revisão e autorreparo são codificados por tipo e por resultado funcional (eficaz, neutro ou prejudicial), independentemente das avaliações holísticas da qualidade do produto final. Em uma demonstração com 62 participantes divididos em grupos novatos e treinados, ambos os grupos realizaram as duas condições de tarefa em ordem contrabalanceada. Os participantes treinados obtiveram pontuações médias mais altas na qualidade do produto final na tradução escrita (20,1 ± 2,1 vs. 16,8 ± 2,3) e na interpretação simultânea (18,9 ± 2,4 vs. 15,4 ± 2,6), além de uma proporção maior de revisões ou autorreparos eficazes. Como pausas, exclusões, latência de início e densidade de revisão são indiretos e sensíveis à tarefa, eles são interpretados como correlatos comportamentais que exigem triangulação, e não como medidas diretas de um constructo unitário. O protocolo destina-se a textos expositivos controlados e pode ser adaptado a outros pares linguísticos após o reajuste dos métodos de entrada, limiares de pausa, comparabilidade dos textos e procedimentos de pontuação.
Introdução
A tradução escrita e a interpretação simultânea do inglês para o chinês exigem compreensão do texto-fonte, transferência entre línguas e formulação na língua de destino, mas impõem condições de tarefa diferentes. A tradução escrita permite leitura recursiva e edição diferida, enquanto a interpretação simultânea exige produção oral sob restrições temporais mais rigorosas. Carga cognitiva, dificuldade de processamento e esforço cognitivo são construtos relacionados, mas não intercambiáveis: a carga refere-se às exigências da tarefa, enquanto o esforço refere-se aos recursos que um participante investe diante dessas exigências. O esforço cognitivo é latente e multidimensional; portanto, latência, pausas, exclusões e densidade de revisão são tratadas aqui como correlatos comportamentais que podem refletir planejamento, monitoramento, processos motores ou dificuldade, e devem ser interpretados conjuntamente, e não como medições diretas do esforço1,2,3,4,5,6,7,8.
A pesquisa orientada a processos combina pontuações de produtos com registros comportamentais alinhados no tempo para identificar quando e como ocorrem as decisões de tradução. O registro de pressionamento de teclas fornece informações sobre as sequências de produção e revisão, mas a composição por meio do método de entrada chinês pode separar eventos físicos das teclas dos caracteres efetivamente inseridos; portanto, é necessário gravar a tela de forma sincronizada para reconstruir o estado do texto visível9,10,11. Os limiares de pausa são escolhas analíticas e não fronteiras cognitivas universais, e limiares mais curtos podem alterar significativamente conclusões baseadas em pausas8,12. Consequentemente, o protocolo exige verificações explícitas de sincronização, análises de sensibilidade aos limiares e a separação de medidas específicas da tarefa das medidas compartilhadas.
A frequência de revisão isoladamente não indica se o monitoramento melhora um resultado. Revisões escritas e autocorreções orais podem ter como alvo a escolha lexical, a sintaxe, o significado ou o estilo, mas seu resultado funcional deve ser avaliado em relação ao significado da fonte e ao segmento-alvo imediatamente anterior. Pesquisas sobre interpretação simultânea na leitura de texto escrito envolvendo processamento entre inglês-chinês e chinês-inglês mostram que treinamento, direcionalidade, coordenação entre olhos e voz e desencadeadores específicos do problema ligados ao idioma podem alterar os padrões de desempenho13,14,15,16. Por esse motivo, o tipo de episódio, o resultado do episódio, a qualidade do produto final e o comportamento relacionado à execução são codificados como variáveis separadas.
O protocolo foi desenvolvido para adultos aprendizes ou tradutores/intérpretes treinados que trabalham com textos expositivos curtos e não especializados em sessões controladas baseadas em computador. É mais adequado quando os registros de teclas pressionadas e da tela podem ser capturados para a produção escrita, e um áudio de alta qualidade pode ser gravado para a produção oral. A estrutura pode ser adaptada a outros pares linguísticos, mas a correspondência de textos, a segmentação em unidades de informação, o comportamento do teclado ou do método de entrada, os limiares de pausa e os pontos de referência de avaliação devem ser revalidados para cada par linguístico e sistema de escrita17. A demonstração compara as condições da tarefa em vez de atribuir todas as diferenças unicamente à modalidade, pois o comprimento do texto, os limites de tempo, o modo de saída e as oportunidades de revisão também diferem.
Protocolo
Todos os métodos que envolvem o uso de seres humanos foram realizados em conformidade com as diretrizes institucionais e receberam aprovação explícita do Comitê de Ética em Pesquisa com Seres Humanos do Instituto de Tecnologia da Informação de Guilin (Número de Aprovação: UYHAJ2025899). O consentimento informado por escrito foi obtido de todos os participantes antes de sua participação. Consulte a Tabela de Materiais para obter uma lista abrangente dos equipamentos e softwares utilizados neste estudo.
1. Recrutamento dos participantes e atribuição aos grupos
- Recrute 62 participantes, compreendendo estudantes de inglês ou tradução e estagiários intérpretes profissionais. Verifique se todos os participantes são falantes nativos de chinês com visão e audição normais ou corrigidas para a normalidade.
- Atribua aos participantes com menos de 12 meses de treinamento estruturado em tradução o grupo de iniciantes, e aos que possuem pelo menos 12 meses de treinamento, o grupo treinado. Relate separadamente a prática prévia de tradução escrita e interpretação simultânea para todos os participantes.
- Triagem dos participantes antes da atribuição da tarefa para excluir aqueles com exposição prévia aos textos-fonte, deficiência sensorial não corrigida ou incapacidade de utilizar o método padronizado de entrada em chinês.
- Exclua tarefas após a gravação apenas por motivos previamente especificados, como uso proibido de ferramentas externas, execução incompleta, arquivos corrompidos ou áudio inutilizável.
- Mantenha um registro de exclusão de tarefas sem informações pessoalmente identificáveis. Relate a amostra final analisada de forma consistente no texto e na Figura 1A–D.
2. Seleção de materiais e avaliação piloto
- Selecione textos expositivos curtos em inglês de domínios acadêmicos gerais, educacionais, sociais ou de comunicação pública. Utilize textos para tradução escrita com aproximadamente 180–220 palavras e textos para interpretação simultânea com cerca de 120–160 palavras.
- Iguale ou ajuste estatisticamente o comprimento do texto, dificuldade léxica, complexidade sintática, densidade de informação e familiaridade com o tema entre as condições da tarefa.
- Instrua três especialistas bilíngues a avaliar independentemente a dificuldade léxica, complexidade sintática, densidade de informação, familiaridade com o tema e adequação para transferência em uma escala de 1 a 5 pontos (1 = muito baixa, 5 = muito alta).
- Calcule um coeficiente de correlação intraclasse (ICC) com efeitos aleatórios bidirecionais e intervalo de confiança de 95% para as médias das avaliações. Revise os itens que apresentarem baixa concordância (ICC < 0,75).
- Mantenha pares de textos apenas quando as variáveis padronizadas de correspondência estiverem dentro de uma margem de tolerância de ±10%.
- Defina uma unidade de informação como a menor proposição no texto-fonte que expressa uma ideia, relação ou evento individualmente avaliável. Resolva desacordos sobre delimitações antes da aplicação da tarefa.
- Teste as instruções, método de entrada, sincronização, qualidade sonora e limites de tempo com participantes que não serão incluídos na análise principal. Registre as distribuições de tempo de conclusão e a proporção de participantes que atingem cada limite de tempo.
- Revise um texto ou limite de tempo quando os participantes do teste apresentarem desempenho no teto ou no piso, ambiguidade persistente ou instabilidade na gravação. Documente todas as alterações antes de iniciar o estudo principal.
3. Administração da tarefa e configuração da gravação
- Avalie os participantes individualmente em uma sala silenciosa e com atenuação sonora, utilizando configurações padronizadas de hardware e software.
- Leia um roteiro de instruções padronizado e permita um item de prática não experimental. Proíba o uso de dicionários, mecanismos de busca, inteligência artificial generativa, tradução automática e corpora externos.
- Equilibre os dois tipos de ordem das tarefas (tradução escrita primeiro versus interpretação simultânea primeiro) dentro de cada grupo de treinamento e mantenha um intervalo de descanso de 5 minutos.
- Prepare a lista de alocação antes da conclusão do recrutamento e mantenha a atribuição oculta até que a elegibilidade seja confirmada. Se forem utilizados múltiplos textos-fonte, equilibre a identidade dos textos independentemente da ordem das tarefas e mantenha uma variável de identificação do texto para análise.
- Apresente o texto-fonte em inglês continuamente e instrua o participante a produzir uma tradução precisa e natural para o chinês no campo de entrada designado. Permita edição livre, mas proíba estritamente a colagem de texto externo.
- Aplique o limite máximo de 20 minutos estabelecido no estudo piloto sem exibir um cronômetro regressivo, e registre se esse limite foi atingido.
- Capture continuamente todo o processo de tradução escrita, utilizando um software de registro de teclas sincronizado com gravação contínua da tela. Mantenha as traduções finais juntamente com os arquivos de log com carimbo de tempo para extração comportamental posterior.
- Apresente o texto-fonte para interpretação simultânea na tela e instrua o participante a iniciar uma versão oral em chinês sem o uso de anotações escritas.
- Aplique consistentemente o limite máximo de 6 minutos e registre se esse limite foi atingido. Distinga uma observação com limite de tempo de uma observação concluída normalmente.
- Grave a saída oral utilizando software de captura digital de áudio. Gere transcrições rigorosas e verbatim dessas gravações para facilitar a codificação posterior.
4. Extração de indicadores do processo comportamental
- Extraia os correlatos comportamentais da tarefa escrita a partir dos arquivos de registro, definindo a latência inicial como o intervalo entre o início do estímulo e o primeiro caractere chinês inserido.
- Extraia o tempo total da tarefa, contagem e duração de pausas, taxa de exclusão, densidade de revisões e taxa de produção. Mantenha os carimbos de tempo brutos e o denominador exato utilizado para cada medida normalizada.
- Utilize 2 s como limiar operacional para pausas na escrita. Informe se foram incluídas pausas durante a navegação com o cursor, seleção de texto ou seleção de candidatos no método de entrada.
- Extraia os correlatos comportamentais da tarefa oral a partir da forma de onda e da transcrição verificada, definindo a latência de início como o intervalo entre a apresentação do estímulo e a primeira enunciação significativa na língua-alvo.
- Exclua inspirações, pigarros e sons não lexicais abandonados da latência de início. Extraia o tempo total de interpretação, pausas silenciosas, pausas preenchidas, repetições, inícios falsos, autorreparos e taxa de fala.
- Defina uma pausa oral silenciosa como um silêncio dentro de uma enunciação com duração mínima de 1,0 s. Examine os limites das pausas com base na forma de onda e na transcrição verificada, e exclua os silêncios iniciais e finais das contagens de pausas dentro da enunciação.
- Complete um registro de controle de qualidade para cada tarefa aplicada. Documente se o arquivo de processo correspondente está legível e completo, se a transcrição foi verificada e se a codificação foi concluída ou submetida à análise. Mantenha o registro original e rastreie quaisquer correções na trilha de auditoria.
5. Codificação da revisão estratégica e da autorreparação oral
- Reconstrua cada revisão escrita alinhando o registro de teclas pressionadas, o vídeo da tela e o texto final.
- Trate um episódio como uma sequência contínua de ações de edição direcionadas ao mesmo segmento-alvo e encerre o episódio quando a produção for retomada em outro local por pelo menos 2 s ou quando um segmento diferente for editado.
NOTA: Para entrada em chinês, distinga alterações na composição antes da confirmação de exclusões no texto-alvo após a confirmação e codifique apenas as últimas como revisões textuais. - Atribua um tipo primário de revisão com base em mudanças semânticas, sintáticas, lexicais ou estilísticas. Permita uma etiqueta secundária para casos sobrepostos, mas use a etiqueta primária para contagens mutuamente exclusivas. Aplique os exemplos práticos fornecidos no Arquivo Suplementar 1.
- Produza uma transcrição literal com carimbos de tempo antes de codificar a autocorreção oral. Instrua o primeiro transcritor a marcar conteúdo lexical, pausas preenchidas, repetições, falsas partidas, interrupções e trechos incompreensíveis.
- Peça a um segundo revisor treinado que verifique a transcrição em relação ao áudio e resolva discrepâncias, preservando os carimbos de tempo originais do áudio.
- Defina uma autocorreção oral como uma reformulação explícita que substitui, completa ou corrige um segmento imediatamente anterior na língua-alvo. Não infira monitoramento oculto apenas a partir do silêncio. Aplique as mesmas regras de decisão lexicais, sintáticas, semânticas e estilísticas à autocorreção oral.
- Codifique uma repetição exata sem mudança corretiva como disfluência, um início abandonado seguido por uma nova construção como falsa partida mais reparo, e uma omissão ou má tradução sem reformulação explícita como erro de saída.
- Quando o áudio for ambíguo ou quando duas categorias permanecerem igualmente plausíveis, marque o episódio como ambíguo. Mantenha etiquetas provisórias para episódios ambíguos e resolva-os antes da análise de confiabilidade.
- Avalie o resultado funcional comparando os segmentos-alvo anteriores e posteriores ao episódio com a unidade de informação fonte e o contexto local do alvo. Faça essa avaliação antes de revelar a pontuação global final. Não use uma mudança na pontuação global como definição de eficácia.
- Codifique duplamente pelo menos 20% das produções selecionadas em ambos os grupos e ordens de tarefa e calcule a confiabilidade com base nas codificações independentes antes da resolução de conflitos.
- Requalifique e recodifique quando a concordância entre avaliadores for inferior a um kappa de Cohen de 0,80. Documente esse limite exato e quaisquer ações corretivas adotadas.
6. Avaliação da qualidade e modelagem estatística
- Avalie cada tradução escrita final e cada interpretação simultânea utilizando a rubrica analítica de 25 pontos no Arquivo Suplementar 1.
- Avalie a precisão, completude, adequação lexical, coerência e naturalidade na língua de destino de 0 a 5, utilizando os pontos de referência indicados. Não interpole critérios de pontuação após inspecionar a pertinência ao grupo.
- Instrua os avaliadores a utilizarem tanto o áudio quanto a transcrição verificada para as dimensões da interpretação simultânea. Analise as pausas e as medidas de desfluentes separadamente das pontuações da rubrica.
- Treine dois avaliadores independentes utilizando o código e pelo menos 10 produções de prática, mantendo os avaliadores cegos quanto ao grupo dos participantes e à ordem das tarefas.
- Após a pontuação independente e a codificação dos episódios, calcule a confiabilidade antes da discussão. Resolva as discordâncias por consenso e consulte um terceiro avaliador apenas quando o consenso não puder ser alcançado.
- Informe um coeficiente de correlação intraclasse de efeitos aleatórios bidirecionais e de concordância absoluta para as pontuações contínuas médias de qualidade. Informe o kappa de Cohen para o código categórico primário de revisão e um kappa separado para o código de resultado eficaz/neutro/detrimental. Indique o número exato e a porcentagem de episódios codificados duplamente.
- Verifique se cada arquivo de processo é legível e completo antes da análise, alinhe os registros da tarefa escrita com os registros de tela correspondentes e verifique as transcrições em relação ao áudio.
- Registre falhas de alinhamento, problemas de inteligibilidade e ações corretivas em um registro de controle de qualidade. Normalize as medidas de frequência utilizando 100 unidades de informação do texto-fonte para a frequência de pausas e 100 caracteres chineses produzidos para a densidade de revisão escrita.
- Codifique o resultado funcional independentemente da pontuação final de qualidade holística. Codifique um episódio como eficaz quando o segmento pós-revisão melhorar o texto sem introduzir novos problemas, como neutro quando não produzir alteração significativa e como prejudicial quando introduzir um erro.
- Calcule a taxa de eficácia como o número de episódios eficazes dividido pelo total de episódios classificáveis, excluindo episódios ambíguos do denominador.
- Analise a demonstração como um conjunto de dados exploratório com medidas repetidas. Especifique o modelo de efeitos fixos para prever a pontuação total de qualidade utilizando a condição da tarefa, grupo de treinamento, métricas de pausa, densidade de revisão, taxa de eficácia, carga de desfluência e velocidade da fala.
- Inclua um intercepto aleatório por participante e inclua efeitos aleatórios do texto-fonte apenas se o delineamento contiver textos amostrados independentemente em número suficiente.
- Centralize os preditores contínuos, inspecione os resíduos e verifique a colinearidade. Informe o método de estimação, versão do software, β, EP, IC 95%, valores exatos de p, componentes de variância, AIC, BIC e R2 marginal/condicional. Descreva a análise como exploratória e evite afirmações causais confirmatórias.
- Exporte um pacote de análise reprodutível contendo dados anonimizados, dicionário, código, rubrica, detalhes do software, scripts e resultados. Confirme que cada valor de figura e tabela possa ser rastreado até uma variável e etapa de análise nomeadas antes da publicação.
Resultados
Características basais dos participantes e disponibilidade de dados
O questionário continha 62 participantes (31 novatos e 31 treinados), e a folha de tarefas continha 124 registros, indicando dois registros de tarefas concluídos por participante (Tabela 1). O grupo novato tinha menos de 12 meses de formação estruturada em tradução (máximo observado, 8,6 meses), enquanto o grupo treinado tinha pelo menos 12 meses (mínimo observado, 13,3 meses). As distribuições de idade, sexo, duração do aprendizado de inglês, proficiência e ordem das tarefas foram semelhantes entre os grupos. Figura 1 apresenta a amostra final analisada e distingue corretamente os dados específicos de cada tarefa: registros de pressionamento de teclas e gravações de tela referem-se à tradução escrita, áudios e transcrições verbais referem-se à interpretação simultânea e avaliações de qualidade aplicam-se a ambas.
Perfis comportamentais nas diferentes condições da tarefa
Os perfis comportamentais diferiram entre as duas condições da tarefa e entre os grupos de treinamento (Tabela 2; Figura 2A–E). A tradução escrita apresentou tempos de conclusão mais longos e pausas médias mais prolongadas, enquanto a interpretação simultânea apresentou mais pausas a cada 100 unidades de informação abaixo do limiar relatado. Dentro de cada condição de tarefa, o grupo treinado concluiu as tarefas mais rapidamente e obteve pontuações médias de produção mais altas. Esses contrastes não devem ser interpretados como efeitos puramente modais, pois o comprimento do texto, o limite de tempo, o modo de saída e a possibilidade de revisão também diferiram. As pausas não são uniformemente disruptivas: uma pausa pode refletir dificuldade não resolvida, planejamento bem-sucedido, monitoramento ou atividade relacionada ao método de entrada; portanto, as medidas de pausa são interpretadas em conjunto com as medidas de revisão, entrega e qualidade.
Revisão estratégica, auto-reparo e modelagem preditiva
O quadro de codificação separou o tipo de episódio do resultado funcional (Tabela 3; Figura 3A–D). Os participantes treinados produziram mais episódios de revisão escrita do que os novatos (12,4 ± 3,7 vs. 8,9 ± 3,0 por tarefa), enquanto o total de autorreparos orais não diferiu significativamente entre os grupos (4,9 ± 1,6 vs. 4,4 ± 1,5 por tarefa). O grupo treinado teve, no entanto, uma proporção maior de episódios eficazes em ambas as tarefas. O resumo dos efeitos mistos relatado na Tabela 4 apresenta associações, e não caminhos causais; portanto, a Figura 3E exibe as estimativas dos efeitos fixos relatadas e os intervalos de confiança, em vez de um diagrama causal.
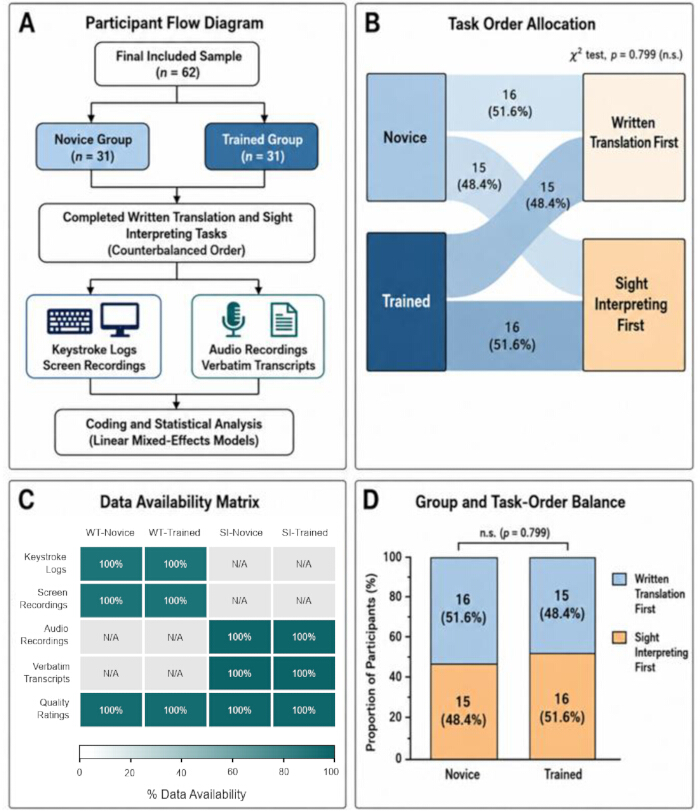
Figura 1: Fluxo de participantes, alocação da ordem das tarefas e disponibilidade de dados específicos por tarefa. (A) Amostra final analisada de 62 participantes e 124 registros de tarefas. (B) Alocação contrabalançada da ordem das tarefas dentro dos grupos novato e treinado. (C) Matriz de disponibilidade na qual os registros de pressionamento de teclas e gravações de tela são aplicáveis apenas à tradução escrita, gravações de áudio e transcrições verbais apenas à interpretação simultânea, e avaliações de qualidade a ambas as tarefas. (D) Equilíbrio entre grupo e ordem (teste qui-quadrado, p = 0,799). n = 62 participantes (31 por grupo). Clique aqui para visualizar uma versão maior desta figura.
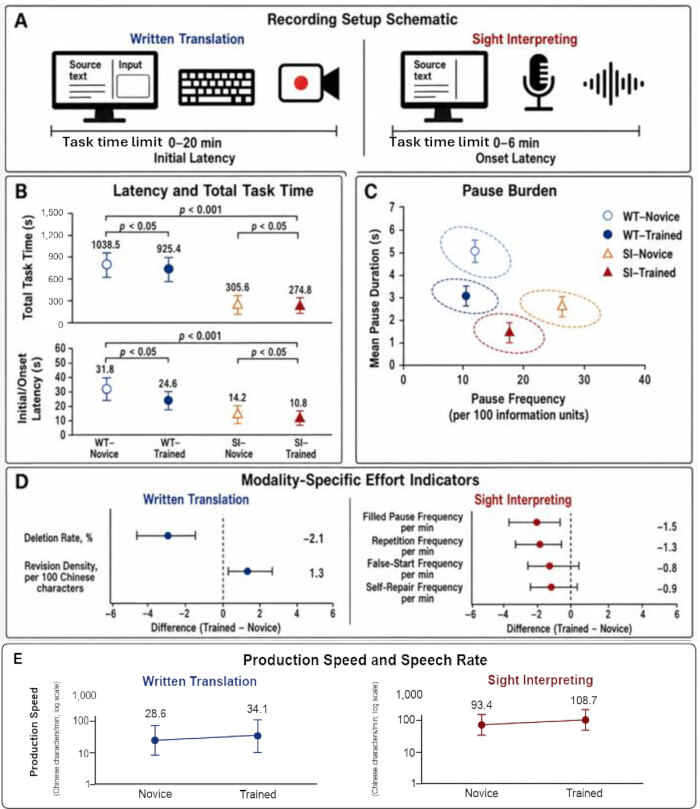
Figura 2: Perfis comportamentais nas condições de tarefa de tradução escrita e interpretação simultânea. (A) Configuração da gravação específica para cada tarefa. (B) Latência inicial/de início e tempo total da tarefa. (C) Distribuição conjunta da frequência de pausas e duração média das pausas. (D) Indicadores específicos para cada tarefa de exclusão, revisão e disfluência oral. (E) Taxa de produção escrita e taxa de fala oral. Nos painéis B, C e E, os pontos e barras de erro mostram as médias do grupo ± DP; no painel D, os pontos mostram as diferenças médias entre treinados e iniciantes e as barras de erro mostram os intervalos de confiança de 95%. n = 31 participantes por grupo. No painel E, o eixo y é exibido em escala logarítmica. Clique aqui para visualizar uma versão maior desta figura.
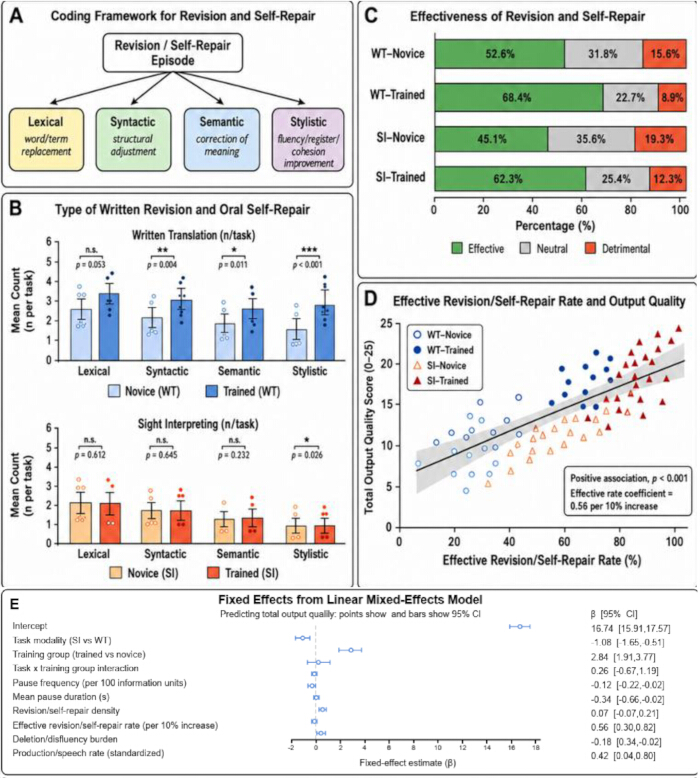
Figura 3: Codificação de revisão/autorreparo, resultado funcional e associações com a qualidade da saída. (A) Estrutura de decisão para atribuição independente do tipo de episódio e do resultado funcional. (B) Contagens médias de episódios lexicais, sintáticos, semânticos e estilísticos em cada condição da tarefa. (C) Proporções médias de episódios eficazes, neutros e prejudiciais. (D) Associação descritiva entre a taxa de episódios eficazes e a pontuação total de qualidade da saída. (E) gráfico de floresta exibindo efeitos fixos de um modelo linear de efeitos mistos com intervalos de confiança de 95% (detalhados na Tabela 4); o gráfico é associativo e não representa um modelo causal. Clique aqui para visualizar uma versão maior desta figura.
| Variáveis | Grupo novato (n = 31) | Grupo treinado (n = 31) | valor p |
| Idade, anos | 21,9 ± 1,7 | 22,4 ± 1,9 | 0,279 |
| Feminino, n (%) | 22 (71,0) | 21 (67,7) | 0,779 |
| Duração do aprendizado de inglês, anos | 12,4 ± 2,1 | 12,9 ± 2,2 | 0,36 |
| Pontuação de proficiência em inglês | 548,6 ± 41,3 | 562,4 ± 45,8 | 0,216 |
| Duração do treinamento em tradução, meses | 5,6 ± 3,0 | 18,7 ± 5,4 | <0,001 |
| Duração do treinamento em interpretação, meses | 2,3 ± 2,1 | 13,9 ± 5,7 | <0,001 |
| Prática prévia de tradução escrita ≥5 tarefas, n (%) | 9 (29,0) | 24 (77,4) | <0,001 |
| Prática prévia de interpretação simultânea ≥5 tarefas, n (%) | 5 (16,1) | 20 (64,5) | <0,001 |
| Tradução escrita primeiro, n (%) | 16 (51,6) | 15 (48,4) | 0,799 |
| Interpretação simultânea primeiro, n (%) | 15 (48,4) | 16 (51,6) | 0,799 |
Tabela 1: Características dos participantes e perfis iniciais de treinamento linguístico por grupo. As variáveis são apresentadas como média ± desvio padrão para dados contínuos e como contagens (porcentagens) para dados categóricos. Os valores de p relatados refletem comparações entre grupos para verificar o equilíbrio demográfico inicial e confirmar as diferenças pretendidas na duração do treinamento.
| Variáveis | Tradução escrita Novato (n = 31) | Tradução escrita Treinado (n = 31) | Interpretação simultânea Novato (n = 31) | Interpretação simultânea Treinado (n = 31) | Efeito da tarefa p | Efeito do grupo p |
| Latência inicial/de início, s | 31,8 ± 12,4 | 24,6 ± 9,7 | 14,2 ± 5,6 | 10,8 ± 4,2 | <0,001 | 0,003 |
| Tempo total da tarefa, s | 1038,5 ± 168,2 | 925,4 ± 151,6 | 305,6 ± 59,3 | 274,8 ± 50,7 | <0,001 | 0,004 |
| Frequência de pausas, por 100 unidades de informação | 18,6 ± 6,1 | 14,2 ± 5,0 | 24,8 ± 7,4 | 19,6 ± 6,3 | <0,001 | 0,001 |
| Duração média da pausa, s | 4,1 ± 1,2 | 3,3 ± 1,0 | 2,7 ± 0,8 | 2,3 ± 0,7 | 0,012 | 0,002 |
| Taxa de produção/fala, caracteres chineses/min | 28,6 ± 6,7 | 34,1 ± 7,5 | 93,4 ± 18,9 | 108,7 ± 20,4 | 0,001 | |
| Taxa de exclusão, % | 8,9 ± 3,4 | 6,8 ± 2,7 | 0,009 | |||
| Densidade de revisão, por 100 caracteres chineses | 7,6 ± 2,8 | 8,9 ± 3,1 | 0,087 | |||
| Frequência de pausas preenchidas, por min | 5,7 ± 1,9 | 4,2 ± 1,6 | 0,002 | |||
| Frequência de repetições, por min | 4,9 ± 1,8 | 3,6 ± 1,4 | 0,004 | |||
| Frequência de inícios falsos, por min | 2,8 ± 1,1 | 2,0 ± 0,9 | 0,006 | |||
| Frequência de autocorreção, por min | 4,8 ± 1,7 | 3,9 ± 1,4 | 0,031 | |||
| Pontuação total de qualidade, 0–25 | 16,8 ± 2,3 | 20,1 ± 2,1 | 15,4 ± 2,6 | 18,9 ± 2,4 | 0,002 | <0,001 |
| Precisão, 0–5 | 3,4 ± 0,7 | 4,1 ± 0,6 | 3,1 ± 0,8 | 3,8 ± 0,7 | 0,004 | <0,001 |
| Completude, 0–5 | 3,3 ± 0,8 | 4,0 ± 0,6 | 3,0 ± 0,8 | 3,7 ± 0,7 | 0,006 | <0,001 |
| Adequação lexical, 0–5 | 3,2 ± 0,7 | 4,0 ± 0,6 | 3,1 ± 0,7 | 3,8 ± 0,6 | 0,041 | <0,001 |
| Coesão, 0–5 | 3,5 ± 0,6 | 4,0 ± 0,6 | 3,1 ± 0,7 | 3,8 ± 0,6 | 0,003 | <0,001 |
| Naturalidade na língua de destino, 0–5 | 3,4 ± 0,7 | 4,0 ± 0,6 | 3,1 ± 0,7 | 3,8 ± 0,7 | 0,007 | <0,001 |
Tabela 2: Indicadores do processo comportamental e qualidade do resultado nas diferentes condições da tarefa e grupos. Os valores são expressos como média ± desvio padrão. Os valores de p relatados indicam os efeitos principais da modalidade da tarefa (tradução escrita versus interpretação simultânea) e da formação anterior (iniciante versus treinado) sobre cada variável de processo e qualidade.
| Variáveis | Tradução escrita Novato | Tradução escrita Treinado | valor p | Interpretação simultânea visual Novato | Interpretação simultânea visual Treinado | valor p |
| Revisão léxica/autoconserto, n/tarefa | 3,4 ± 1,5 | 4,2 ± 1,7 | 0,053 | 1,8 ± 0,8 | 1,7 ± 0,7 | 0,612 |
| Revisão sintática/autoconserto, n/tarefa | 2,1 ± 1,1 | 3,0 ± 1,2 | 0,004 | 1,1 ± 0,7 | 1,2 ± 0,8 | 0,645 |
| Revisão semântica/autoconserto, n/tarefa | 1,8 ± 1,0 | 2,5 ± 1,1 | 0,011 | 0,9 ± 0,6 | 1,1 ± 0,7 | 0,232 |
| Revisão estilística/autoconserto, n/tarefa | 1,6 ± 0,9 | 2,7 ± 1,2 | <0,001 | 0,6 ± 0,4 | 0,9 ± 0,6 | 0,026 |
| Total de episódios de revisão/autoconserto, n/tarefa | 8,9 ± 3,0 | 12,4 ± 3,7 | <0,001 | 4,4 ± 1,5 | 4,9 ± 1,6 | 0,209 |
| Episódios eficazes, % | 52,6 ± 13,5 | 68,4 ± 12,1 | <0,001 | 45,1 ± 14,2 | 62,3 ± 13,0 | <0,001 |
| Episódios neutros, % | 31,8 ± 10,4 | 22,7 ± 8,8 | 0,001 | 35,6 ± 11,7 | 25,4 ± 9,6 | 0,001 |
| Episódios prejudiciais, % | 15,6 ± 7,1 | 8,9 ± 5,6 | <0,001 | 19,3 ± 8,6 | 12,3 ± 6,8 | 0,001 |
Tabela 3: Tipo e eficácia das revisões escritas e autocorreções orais nas diferentes condições de tarefa. Os tipos de episódios são apresentados como médias de ocorrências por tarefa (± desvio padrão), e os resultados funcionais são apresentados como porcentagens médias (± desvio padrão). Os valores de p indicam a significância das diferenças entre grupos dentro de cada modalidade de tarefa.
| Efeitos fixos | β | EP | IC 95% | valor p |
| Intercepto | 16,74 | 0,42 | 15,91 a 17,57 | <0,001 |
| Modalidade da tarefa: interpretação simultânea versus tradução escrita | -1,08 | 0,29 | -1,65 a -0,51 | <0,001 |
| Grupo de treinamento: treinado versus novato | 2,84 | 0,47 | 1,91 a 3,77 | <0,001 |
| Modalidade da tarefa × grupo de treinamento | 0,26 | 0,47 | -0,67 a 1,19 | 0,581 |
| Frequência de pausas, por 100 unidades de informação | -0,12 | 0,05 | -0,22 a -0,02 | 0,018 |
| Duração média da pausa, s | -0,34 | 0,16 | -0,66 a -0,02 | 0,041 |
| Densidade de revisão/autocorreção | 0,07 | 0,07 | -0,07 a 0,21 | 0,334 |
| Taxa efetiva de revisão/autocorreção, por aumento de 10% | 0,56 | 0,13 | 0,30 a 0,82 | <0,001 |
| Carga de exclusão/desfluentes | -0,18 | 0,08 | -0,34 a -0,02 | 0,027 |
| Taxa de produção/fala, padronizada | 0,42 | 0,19 | 0,04 a 0,80 | 0,032 |
Tabela 4: Efeitos fixos relatados pelo modelo linear de efeitos mistos que prediz a qualidade total da produção. O resumo detalha os coeficientes não padronizados (β), erros padrão (SE), intervalos de confiança de 95% (IC) e valores p exatos para todos os preditores comportamentais e de tarefa especificados.
Discussão
Este estudo demonstra um protocolo multimodal para medir indicadores observáveis de processos e codificar a revisão estratégica na tradução escrita e na interpretação simultânea entre inglês e chinês. O protocolo não mede diretamente uma variável unitária de esforço cognitivo. Em vez disso, latência, pausas, exclusões e padrões de revisão são interpretados como correlatos comportamentais sensíveis à tarefa, cujo significado depende da triangulação com registros sincronizados e evidências da qualidade do produto final1,2,3,4,5,6,7,8. As duas tarefas também diferem quanto aos materiais, cronometragem, modo de saída e oportunidade de revisão; portanto, os contrastes representativos descrevem diferenças condicionadas à tarefa, e não efeitos isolados da modalidade. A principal contribuição analítica é a separação da frequência de revisão do resultado funcional. Nos resumos relatados, participantes treinados realizaram mais revisões escritas, e não menos, enquanto as contagens totais de autorreparos orais não diferiram significativamente entre os grupos. Suas proporções mais altas de episódios eficazes sugerem que o monitoramento da qualidade pode ser mais informativo do que a frequência bruta, mas essa interpretação depende de regras de decisão transparentes, codificação independente dos resultados e confiabilidade relatada. O código de codificação e os exemplos trabalhados no Arquivo Suplementar 1 têm a finalidade de tornar essa distinção reproduzível, e não promocional.
As etapas críticas são o alinhamento entre registros, a qualidade do áudio, a verificação da transcrição e a consistência da codificação. Os marcadores de tempo disponíveis e as pistas de delimitação de tarefas devem ser verificados ao alinhar os registros e gravações. O áudio deve ser inspecionado quanto a cortes e inteligibilidade antes da transcrição, e os limites de pausa propostos devem ser verificados com base na forma de onda e na transcrição. Para entrada em chinês, os toques de teclas de composição não devem ser equiparados a revisões de caracteres confirmados. Essas verificações e ações corretivas devem ser registradas em um log de controle de qualidade.
Várias limitações restringem a interpretação. A demonstração utiliza coortes de estudantes e estagiários, textos expositivos gerais breves, diferentes durações de tarefas e limites de tempo, e uma amostra baseada na disponibilidade. As condições da tarefa também diferem quanto ao modo de saída e às oportunidades de revisão, e o conjunto de dados não contém identificadores de texto-fonte amostrados independentemente para estimar a variação em nível de texto. Além disso, os limiares de pausa são escolhas operacionais, e pausas mais longas podem refletir tanto planejamento produtivo quanto dificuldades não resolvidas. A generalização para profissionais, domínios especializados, outros pares linguísticos ou outros sistemas de escrita exige a revalidação dos materiais, do tratamento dos métodos de entrada, dos limiares e dos pontos de referência de pontuação.
Trabalhos futuros podem combinar os registros comportamentais com rastreamento ocular, pupilometria ou medidas subjetivas de carga de trabalho para testar quais pausas e revisões correspondem à atenção, ao esforço experimentado ou ao planejamento bem-sucedido5,6,13,14,15,16. Shreve et al. utilizaram rastreamento ocular na tradução sob ditação e não devem ser citados como um estudo de pupilometria18; a pupilometria é discutida diretamente por Seeber5. Tais extensões multimodais devem manter a distinção entre demanda da tarefa, esforço investido, comportamento observado e desempenho. O presente protocolo deve, portanto, ser usado principalmente como um quadro transparente de avaliação de processos, cujos indicadores sustentam, mas por si só não estabelecem, afirmações sobre o esforço cognitivo latente.
Divulgações
Os autores declaram não haver conflitos de interesses comerciais ou financeiros. Em relação ao uso de inteligência artificial, os autores informam que o OpenAI Codex foi utilizado durante o processo de revisão exclusivamente para auxiliar na edição de linguagem, verificação de consistência, preparação de revisões rastreadas e regeneração de layouts de figuras com base em dados fornecidos pelos autores. Os autores revisaram minuciosamente todas as saídas assistidas por IA e assumem total responsabilidade pela precisão, integridade e originalidade do manuscrito final. A pasta de trabalho estruturada que sustenta os resumos relatados está disponível publicamente no Zenodo (https://doi.org/10.5281/zenodo.21189434). O Arquivo Suplementar 1 contém o manual de codificação e a grade de qualidade ancorada.
Agradecimentos
O autor agradece ao Instituto de Tecnologia da Informação de Guilin pelo apoio laboratorial, aos especialistas bilíngues que avaliaram os textos fonte, aos avaliadores independentes e aos participantes. Esta pesquisa não recebeu nenhuma bolsa específica de qualquer agência de fomento nos setores público, comercial ou sem fins lucrativos.
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| Software de análise acústica (Praat) | Paul Boersma e David Weenink | https://www.fon.hum.uva.nl/praat/ | |
| Computador desktop | Dell | OptiPlex | |
| Software de gravação de áudio digital (Audacity) | Equipe Audacity | https://www.audacityteam.org/ | |
| Software de registro de digitação (Inputlog) | Universidade de Antuérpia | https://www.inputlog.net/ | |
| Software de gravação de tela (OBS Studio) | Projeto OBS | https://democreator.wondershare.com/ | |
| Software de análise estatística (SPSS) | IBM | versão 27 |
Referências
- Gieshoff AC, Heeb AH. Cognitive load and cognitive effort: probing the psychological reality of a conceptual difference. Transl Cogn Behav. 2023;6(1):3–28.
- Sweller J, van Merriënboer JJG, Paas F. Cognitive architecture and instructional design. Educ Psychol Rev. 1998;10(3):251–96.
- Paas F, Tuovinen JE, Tabbers H, Van Gerven PWM. Cognitive load measurement as a means to advance cognitive load theory. Educ Psychol. 2003;38(1):63–71.
- Gile D. Basic Concepts and Models for Interpreter and Translator Training. Amsterdam: John Benjamins; 2009.
- Seeber KG. Cognitive load in simultaneous interpreting: measures and methods. Target. 2013;25(1):18–32.
- Ferreira A, Schwieter JW, Gottardo A, Jones JA. Cognitive effort in direct and inverse translation performance: insight from eye-tracking technology. Cad Trad. 2016;36(3):60–80.
- Zou D, Zhang J. Measuring the invisible: clarifying the concept of cognitive effort in translation and interpreting processes. Curr Trends Transl Teach Learn E. 2023;10:217–58.
- Lacruz I, Shreve GM, Angelone E. Average pause ratio as an indicator of cognitive effort in post-editing: a case study. Workshop on Post-Editing Technology and Practice. San Diego: Association for Machine Translation in the Americas; 2012. p. 21–30.
- Qassem M, Al Thowaini BM. Cognitive processes and translation quality: Evidence from keystroke-logging software. J Psycholinguist Res. 2023;52(5):1589–604.
- Ma X, Li D. Effect of word order asymmetry on the cognitive load of English–Chinese sight translation: Evidence from eye movement data. Transl Interpret Stud. 2024;19(1):105–31.
- Leijten M, Van Waes L. Keystroke logging in writing research: using Inputlog to analyze and visualize writing processes. Written Commun. 2013;30(3):358–92.
- Heilmann A, Neumann S, editors. Dynamic pause assessment of keystroke logged data for the detection of complexity in translation and monolingual text production. Proceedings of the Workshop on Computational Linguistics for Linguistic Complexity; 2016; Osaka: COLING.
- Su W, Li D. Identifying translation problems in English-Chinese sight translation: an eye-tracking experiment. Transl Interpret Stud. 2019;14(1):110–34.
- Su W, Li D. Exploring processing patterns of Chinese-English sight translation: an eye-tracking study. Babel. 2020;66(6):999–1024.
- Su W, Li D. Exploring the effect of interpreting training: eye-tracking English-Chinese sight interpreting. Lingua. 2021;256:103094.
- Su W. Eye-voice span in sight interpreting: an eye-tracking investigation. Perspectives. 2023;31(5):969–85.
- Rojo López AM, Muñoz Martín R. Research Methods in Cognitive Translation and Interpreting Studies. Amsterdam: John Benjamins; 2025.
- Shreve GM, Lacruz I, Angelone E. Cognitive effort, syntactic disruption, and visual interference in a sight translation task. Transl Interpret Stud. 2010;5(1):63–84.
Reimpressões e permissões
Este artigo foi publicado
Vídeo em breve