Este artigo apresenta um fluxo de trabalho bioinformático reprodutível que integra conjuntos de dados transcriptômicos públicos, aprendizado de máquina, validação externa, PCR quantitativa com transcrição reversa, triagem da Connectivity Map e acoplamento molecular para identificar biomarcadores da hipertensão pulmonar e compostos terapêuticos candidatos.
Artigo de investigação
Identificação de Biomarcadores de Hipertensão Pulmonar e Compostos Terapêuticos Candidatos via Bioinformática e Aprendizado de Máquina
Neste artigo
Resumo
Resumo
Este estudo teve como objetivo identificar biomarcadores moleculares associados à hipertensão pulmonar (HP) e compostos de pequenas moléculas candidatos utilizando dados transcriptômicos públicos e recursos independentes de validação. Três conjuntos de dados do Gene Expression Omnibus (GSE22356, GSE33463 e GSE48149) foram integrados após normalização, anotação de sondas e correção do efeito de lote pelo método ComBat. Análise de expressão diferencial, análise de rede de coexpressão gênica ponderada, análise de enriquecimento funcional, análise de rede de interação proteína-proteína e três algoritmos de aprendizado de máquina foram utilizados para identificar genes centrais característicos. O desempenho diagnóstico foi avaliado por meio de curvas de característica operacional do receptor. A validação externa incluiu uma coorte independente de tecido pulmonar (GSE117261), um conjunto de dados de sequenciamento de RNA de célula única de artéria pulmonar (GSE210248) e validação por PCR quantitativo em tempo real em amostras independentes de tecido pulmonar. A reposicionamento de fármacos baseado no Connectivity Map e o encaixe molecular foram utilizados para triagem de compostos candidatos. Setenta e oito genes diferencialmente expressos foram identificados, e CXCL10, JUN, IFIH1, MX1 e TLR7 foram selecionados como genes centrais característicos. Na coorte independente de tecido pulmonar GSE117261, JUN apresentou o suporte externo mais forte, enquanto a replicação dos outros genes foi variável. A PCR quantitativa em tempo real em 20 amostras biologicamente independentes de hipertensão arterial pulmonar e 20 amostras controle confirmou a superexpressão dos cinco genes. O modelo aparente de qRT-PCR com cinco genes e análises de validação cruzada estratificada repetida cinco vezes (100 repetições) ambos resultaram em uma área sob a curva de 1,000, embora a pequena coorte exija interpretação cautelosa e validação prospectiva independente. A análise de célula única do conjunto GSE210248 apoiou alterações na comunicação entre células imunes e estruturais e a mudança fenotípica de células musculares lisas. O composto BRD-K91900765/VX-745 obteve a classificação mais alta na triagem do Connectivity Map. MAPK14/p38α, seu alvo farmacológico estabelecido, foi incluído como proteína de referência positiva no encaixe molecular, enquanto o encaixe contra as cinco proteínas associadas aos biomarcadores foi tratado de forma exploratória. Esses achados sustentam os cinco genes como biomarcadores candidatos para HP e o VX-745 como uma hipótese computacional de reposicionamento de fármaco que exige validação experimental.
Introdução
A hipertensão pulmonar (HP) é uma síndrome cardiorrespiratória progressiva caracterizada por pressão arterial pulmonar persistentemente elevada, resistência vascular pulmonar aumentada e falência ventricular direita eventual. Os critérios hemodinâmicos atuais definem HP como uma pressão arterial pulmonar média em repouso de >20 mmHg, medida por cateterização do lado direito do coração1. Entre os diferentes subtipos clínicos, a hipertensão arterial pulmonar (HAP) é uma das formas mais graves e caracteriza-se por remodelação progressiva dos vasos pulmonares. Suas características patológicas incluem disfunção endotelial, proliferação e migração anormais das células musculares lisas arteriais pulmonares, ativação de fibroblastos da túnica adventícia, deposição de matriz extracelular, infiltração de células inflamatórias e estreitamento ou obliteração das artérias pulmonares distais2. Essas alterações indicam que a HP/HAP não é apenas um distúrbio de vasoconstrição, mas também uma doença complexa de remodelação vascular impulsionada por mecanismos moleculares, celulares e imuno-inflamatórios coordenados.
As terapias atuais para HAP visam principalmente as vias da prostaciclina, endotelina, óxido nítrico – guanilato ciclase solúvel e fosfodiesterase tipo 53˒4. Embora esses tratamentos melhorem os sintomas, a capacidade de exercício e os parâmetros hemodinâmicos, seus efeitos permanecem predominantemente vasodilatadores e hemodinâmicos. A capacidade de reverter o remodelamento vascular pulmonar estabelecido é limitada, e muitos pacientes continuam a apresentar progressão da doença apesar da terapia combinada. Portanto, a identificação de novos biomarcadores moleculares e candidatos terapêuticos que reflitam o processo de remodelamento representa uma necessidade clínica não atendida importante. Em particular, a ativação imune-inflamatória, a sinalização relacionada ao interferon, as vias dos receptores tipo Toll, o recrutamento imune mediado por quimiocinas e a transição fenotípica das células musculares lisas surgiram como possíveis fatores contribuintes para a progressão da HP/HAP5˒6.
Conjuntos de dados transcriptômicos de alto rendimento fornecem recursos valiosos para identificar assinaturas moleculares associadas a doenças na HP/HAAP. No entanto, estudos baseados em um único conjunto de dados frequentemente são limitados por tamanhos amostrais pequenos, efeitos de lote, heterogeneidade de plataforma e validação insuficiente. A análise de expressão diferencial pode identificar genes com expressão alterada, mas pode não capturar completamente módulos de coexpressão relacionados à doença ou interações em nível de rede. A análise de rede de coexpressão gênica ponderada (WGCNA) pode identificar módulos de genes associados a características da doença, enquanto a análise de rede de interação proteína-proteína (PPI) pode revelar genes altamente conectados dentro de redes biológicas. Métodos de aprendizado de máquina também podem priorizar genes com valor diagnóstico ou classificatório. Contudo, a dependência de um único algoritmo pode introduzir viés específico ao modelo. Portanto, a integração da análise de expressão diferencial, WGCNA, análise de rede PPI e múltiplos algoritmos de aprendizado de máquina pode melhorar a robustez na descoberta de biomarcadores.
Outro grande desafio nos estudos de biomarcadores transcriptômicos é a interpretação biológica. Os sinais de tecido total podem refletir alterações na expressão gênica dentro de células vasculares residentes, infiltração de células imunes ou proporções alteradas de múltiplas populações celulares. O sequenciamento de RNA de célula única oferece a oportunidade de situar genes candidatos derivados de análises em massa em um contexto celular. Na HP/HAAP, o remodelamento vascular pulmonar envolve células endoteliais, células musculares lisas, fibroblastos, monócitos/macrófagos, linfócitos e outras células imunes ou estruturais. A progressão da doença também está associada à alteração na comunicação entre células e à mudança fenotípica das células musculares lisas. Assim, a combinação de triagem transcriptômica em massa com validação em célula única pode ajudar a determinar se os biomarcadores candidatos estão associados à ativação imune, ao remodelamento estrutural vascular ou a um desequilíbrio na comunicação multicelular.
Além da descoberta de biomarcadores, assinaturas transcriptômicas podem ser utilizadas para reposicionamento computacional de fármacos. O Mapa de Conectividade (CMap) associa perfis de expressão gênica relacionados a doenças com moléculas pequenas que podem reverter ou modular essas assinaturas7. Quando combinado com curadoria de compostos e encaixe molecular, essa estratégia pode gerar hipóteses terapêuticas passíveis de teste experimental. Embora as previsões do CMap e o encaixe molecular não possam comprovar a eficácia de um fármaco, eles podem priorizar compostos candidatos para ensaios futuros de ligação ao alvo, experimentos baseados em células e validação em modelos animais.
Foi desenvolvida uma metodologia integrada e reprodutível para identificar biomarcadores de HP/HAAP e compostos terapêuticos candidatos. Três conjuntos de dados transcriptômicos públicos do Gene Expression Omnibus foram integrados após normalização e correção de efeitos de lote. Análise de expressão diferencial, WGCNA, análise de enriquecimento funcional, análise de rede de interação proteína-proteína e três algoritmos de aprendizado de máquina foram utilizados para triar genes robustos com características relevantes. A análise da curva ROC, uma coorte de validação independente de tecido pulmonar, evidências de sequenciamento de RNA de célula única da artéria pulmonar e a validação por PCR quantitativa reversa em amostras independentes foram utilizadas para avaliar ainda mais os genes selecionados. Por fim, a reposicionamento de fármacos baseado em CMap e o encaixe molecular foram aplicados para identificar compostos candidatos. A novidade do estudo reside em sua estrutura de validação em múltiplas camadas, que conecta a descoberta transcriptômica em massa, a priorização por aprendizado de máquina, a validação independente, a confirmação experimental por PCR quantitativa reversa, a interpretação mecanicista em nível de célula única e a triagem computacional de compostos. A hipótese do estudo era que a HP/HAAP é impulsionada por um programa coordenado de inflamação imunológica e remodelação vascular e que genes robustos dentro desse programa podem atuar como biomarcadores candidatos e oferecer oportunidades de reposicionamento de medicamentos.
Protocolo
Os conjuntos de dados públicos do Gene Expression Omnibus (GEO) analisados neste estudo continham dados transcriptômicos desidentificados de estudos previamente publicados e não exigiram aprovação ética adicional. O Comitê de Ética da Universidade Huaihua aprovou o estudo independente de validação por PCR quantitativa de transcrição reversa (qRT-PCR) em tecido pulmonar humano (número de aprovação: 2024(A05112)). O consentimento informado por escrito foi obtido de todos os participantes ou de seus representantes legalmente autorizados antes da coleta das amostras. Os procedimentos de aprovação e consentimento aplicaram-se a todas as 20 amostras de tecido pulmonar de hipertensão arterial pulmonar (PAH) e 20 amostras de controle incluídas na validação por qRT-PCR. As ferramentas de pesquisa utilizadas neste protocolo estão listadas na Tabela de Materiais.
1. Coleta e pré-processamento de conjuntos de dados transcriptômicos públicos
Conjuntos de dados de microarranjos relacionados à hipertensão pulmonar (HP) GSE22356, GSE33463 e GSE48149 foram obtidos a partir do banco de dados GEO. Amostras de HP/hipertensão arterial pulmonar (HAP) e controles foram extraídas de acordo com as anotações fenotípicas originais. Matrizes de expressão e arquivos de anotação da plataforma foram baixados usando scripts reprodutíveis em R e o pacote GEOquery.
A anotação das sondas e a associação aos símbolos gênicos foram realizadas de forma consistente entre os conjuntos de dados. Quando múltiplas sondas correspondiam ao mesmo gene, o valor médio de expressão foi calculado. Foi aplicada normalização por quantis, e os genes com baixa expressão ou baixa variância foram removidos. Os conjuntos de dados foram combinados, e os efeitos de lote foram corrigidos utilizando o algoritmo ComBat do pacote sva8. A correção foi avaliada por meio de boxplots e análise de componentes principais.
2. Identificação de genes diferencialmente expressos
O pacote limma foi utilizado para comparar os níveis de expressão entre amostras de PH e controles na matriz de expressão corrigida por lote9. Um modelo linear foi ajustado e estatísticas Bayesiana empíricas foram aplicadas. Os genes diferencialmente expressos foram definidos utilizando um valor de P ajustado <0,05 e uma mudança absoluta no log2 da razão > 0,585. Os resultados foram visualizados usando gráficos de vulcão e mapas de calor.
3. Construção da rede de coexpressão gênica ponderada
Uma rede de coexpressão gênica ponderada foi construída utilizando o pacote WGCNA10. A clusterização de amostras foi realizada para detectar valores atípicos. A potência de limiarização suave foi selecionada com base no índice de ajuste à topologia livre de escala. Os módulos gênicos foram identificados utilizando o algoritmo de corte dinâmico de árvores. Os eigengenes dos módulos foram correlacionados com o fenótipo de HP, e o módulo associado à doença com a correlação mais forte foi selecionado. Os genes no módulo principal foram intersectados com os genes diferencialmente expressos para obter os genes de consenso.
4. Análise de enriquecimento funcional
As categorias de processo biológico, componente celular e função molecular da Gene Ontology foram analisadas utilizando o clusterProfiler11. Foi realizada a análise de enriquecimento de vias do Kyoto Encyclopedia of Genes and Genomes para identificar vias de sinalização12. Um valor de P < 0,05 e um valor de q < 0,2 foram utilizados como limiares de enriquecimento, e os termos enriquecidos foram visualizados utilizando gráficos de bolhas11.
5. Construção da rede de interação proteína-proteína e identificação de genes centrais
A lista consenso de genes foi submetida ao banco de dados STRING, com Homo sapiens selecionado como a espécie e um limiar de confiança de interação > 0,413. O arquivo de interação foi importado para o Cytoscape, e o plug-in CytoHubba foi utilizado para classificar os genes pelo grau do nó. Os genes altamente conectados foram definidos como genes centrais.
6. Seleção de genes com características diagnósticas utilizando aprendizado de máquina
Três algoritmos independentes de seleção de características foram aplicados. Primeiro, realizou-se uma regressão logística com operador de redução e seleção por módulo mínimo utilizando o pacote glmnet e validação cruzada com 10 dobras para identificar genes com coeficientes não nulos14. Segundo, aplicou-se a eliminação recursiva de características com máquinas de vetores de suporte para remover características redundantes e selecionar o subconjunto de características que alcançou a maior precisão na validação cruzada15. Terceiro, construiu-se um modelo de floresta aleatória, e as características foram classificadas com base na diminuição média da impureza de Gini16. A intersecção dos conjuntos de genes derivados dos três algoritmos foi utilizada para definir o conjunto final de genes característicos centrais. O pacote pROC foi utilizado para gerar curvas de característica operacional do receptor e calcular os valores da área sob a curva17.
7. Validação de genes centrais utilizando conjuntos de dados independentes de bulk e de célula única
GSE117261 foi utilizado como uma coorte externa independente de validação de tecido pulmonar, contendo 58 amostras de HAP e 25 amostras de controle de doadores falecidos18. Este conjunto de dados não foi utilizado na análise de descoberta de expressão diferencial, na construção da rede de coexpressão gênica ponderada ou na seleção de características por aprendizado de máquina. A matriz de expressão foi normalizada e anotada, e a expressão diferencial foi analisada usando o limma v3.68.0. A correção da taxa de falsa descoberta de Benjamini-Hochberg foi aplicada em todo o transcriptoma anotado. Curvas de característica operacional do receptor (ROC) para genes individuais foram calculadas usando o pROC v1.19.0.1, intervalos de confiança de 95% de DeLong e pontos de corte do índice de Youden. Um modelo exploratório de regressão logística com cinco genes foi ajustado dentro do GSE117261, e seu desempenho interno foi adicionalmente avaliado usando validação cruzada aninhada repetida.
O GSE210248 (Tabela 1) foi utilizado como conjunto de dados de validação de artéria pulmonar em nível de célula única, contendo amostras de três pacientes com HAP e três doadores saudáveis19. Os dados foram processados usando o Seurat v5.5.1 para controle de qualidade, normalização, redução de dimensionalidade, agrupamento e anotação celular20. Foram identificadas as principais populações celulares, incluindo células endoteliais, células musculares lisas, fibroblastos, monócitos/macrófagos e células T/células natural killer. A comunicação célula-célula foi analisada usando o CellChat v2.1.2 e a base de dados de ligantes-receptores CellChatDB.human21. Um objeto CellChat foi criado a partir da matriz de expressão normalizada do Seurat e dos metadados de tipo celular. Foram identificados genes superexpressos e interações ligante-receptor; as probabilidades de comunicação foram calculadas; foram removidas interações envolvendo grupos celulares com menos de 10 células; e foram inferidas e agregadas redes de comunicação em nível de vias. Este conjunto de dados foi utilizado apenas para validação mecanicista externa e não para o treinamento do modelo.
| Item | Descrição |
| Conjunto de dados | GSE210248 |
| Tipo de dado | Sequenciamento de RNA de célula única baseado em microgotas da 10x Genomics; perfilagem transcriptômica de alto rendimento |
| Amostras humanas | Três amostras de artéria pulmonar de PAH e três amostras de artéria pulmonar de doadores saudáveis |
| Origem do tecido | Tecido de artéria pulmonar ex vivo, refletindo principalmente a ecologia celular da parede vascular pulmonar e o processo de remodelação vascular |
| Objetivo analítico principal | Localização do tipo celular, mudança fenotípica de células musculares lisas, comunicação entre células imunes e estruturais, e validação da consistência mecanicista de genes candidatos |
Tabela 1: Informações básicas do conjunto de dados de validação de célula única GSE210248. A tabela resume o acesso ao conjunto de dados, plataforma de sequenciamento, origem do tecido, composição da amostra e finalidade analítica da análise de validação de artéria pulmonar em célula única.
8. Validação da expressão gênica por qRT-PCR
A validação por qRT-PCR incluiu 20 amostras de tecido pulmonar de pacientes com PH/PAH independentes do ponto de vista biológico e 20 amostras de controle de tecido pulmonar independentes do ponto de vista biológico. O RNA total foi extraído utilizando o Kit de Extração de RNA Total. A concentração e a pureza do RNA foram avaliadas por meio de um espectrofotômetro, e a integridade do RNA foi analisada por eletroforese em gel de agarose. Somente amostras de RNA com valores de A260/280 entre 1,8 e 2,1 e sem degradação visível foram incluídas.
Quantidades iguais de RNA foram transcritas reversamente em DNA complementar utilizando o Kit Solarbio Universal RT-PCR (AMV; número de catálogo RP1200). A PCR quantitativa para CXCL10, JUN, IFIH1, MX1 e TLR7 foi realizada utilizando o SYBR Green PCR Master Mix em um Sistema de PCR em Tempo Real. Cada amostra biológica foi analisada em três réplicas técnicas, juntamente com controles sem molde e sem transcrição reversa. O valor médio de Ct das três réplicas técnicas foi utilizado para a análise subsequente; as réplicas técnicas não foram tratadas como observações independentes. Foram utilizados primers que abrangem junções exon-exon e produzem amplicons de 80–200 pb (Tabela 2). A especificidade dos primers foi verificada utilizando o NCBI Primer-BLAST e análise da curva de dissociação22.
A β-actina (ACTB) foi utilizada como gene de referência interno para normalizar os níveis de expressão dos genes-alvo. A expressão relativa foi calculada utilizando o método 2-ΔΔCt23. Testes Mann-Whitney U bicaudais foram utilizados para comparações entre grupos com base na distribuição dos dados, e foi aplicada a correção da taxa de falsas descobertas de Benjamini-Hochberg entre os cinco genes. Curvas ROC de um único gene foram geradas com intervalos de confiança de 95% de DeLong, e os pontos de corte ótimos foram selecionados utilizando o índice de Youden. O modelo de regressão logística de cinco genes foi inicialmente ajustado e avaliado nas mesmas 40 amostras biológicas; essa estimativa foi, portanto, definida como o desempenho aparente dentro da amostra. Para avaliar o possível superajuste, foram realizadas 100 repetições de validação cruzada estratificada em cinco partes utilizando um modelo de regressão logística com regularização L2, e o desempenho ROC combinado fora das dobras foi calculado.
| Gene | Acesso RefSeq | Primer sentido (5′–3′) | Primer antissentido (5′–3′) | Tamanho do produto (pb) | Tm (°C) | Com travessia de éxon |
| CXCL10 | NM_001565.4 | GTCAAGCCAT AATTGTTC | ATAGTGCCAG GGTAGAGT | 141 | 46.1 | Sim |
| JUN | NM_002228.4 | ACAAGTGGCA GAGTCCCG | CGCCCAAGTT CAACAACC | 152 | 54.5 | Sim |
| IFIH1 | NM_022168 | GCACAGAGCG GTAGACCCT | GCCCTGAAGC ACGAGATG | 182 | 54.7 | Sim |
| MX1 | NM_002462.5 | TTAGCCGTGG TGATTTAGC | CAAGGTGGAG CGATTCTG | 156 | 52.3 | Sim |
| TLR7 | NM_016562.4 | ATTGCCCTCGT TGTTATA | TTCCTGGAGTT TGTTGAT | 179 | 48.1 | Sim |
| ACTB | NM_001101.3 | CTCACCATGGAT GATGATATCGC | AGGAATCCTTCT GACCCATGC | 194 | 56.2 | Sim |
Tabela 2: Sequências de iniciadores utilizadas para PCR quantitativa de transcrição reversa. A tabela lista os genes-alvo, números de acesso RefSeq, sequências dos iniciadores direto e reverso, tamanhos dos produtos, temperaturas de fusão e status de abrangência de éxons dos iniciadores utilizados para qRT-PCR.
9. Triagem de compostos candidatos e acoplamento molecular
As assinaturas de genes centrais reguladas para cima e para baixo foram submetidas ao banco de dados Connectivity Map para identificar moléculas pequenas previstas para reverter o perfil de expressão associado à HP7. Os candidatos foram classificados pelo escore Logit e pela probabilidade de predição.
A estrutura tridimensional da BRD-K91900765/VX-745 foi obtida do PubChem sob o CID 303852524. Informações farmacológicas relacionadas ao composto foram compiladas a partir de bancos de dados públicos de fármacos, e descritores estruturais foram calculados utilizando o DrugBank e o SwissADME25,26. As estruturas proteicas foram obtidas do Banco de Dados de Estruturas Proteicas RCSB utilizando os seguintes identificadores PDB: CXCL10, 1LV9; JUN, 1JUN; IFIH1, 3B6E; MX1, 5GTM; TLR7, 7CYN; e MAPK14/p38α, 1OUK27. A detecção cega de cavidades e o encaixe molecular foram realizados usando o CB-Dock2 v2.0 com o mecanismo de pontuação AutoDock Vina v1.2.028,29. Os arquivos da proteína e do ligante foram enviados ao CB-Dock2, cavidades candidatas foram detectadas automaticamente, e o encaixe foi realizado dentro das caixas específicas para cada cavidade geradas pelo servidor. Para cada proteína, foram registrados o identificador da cavidade, a pontuação Vina, o volume da cavidade, o centro da caixa de encaixe, as dimensões da caixa de encaixe e o arquivo do complexo proteína-ligante. A conformação com a pontuação Vina mais negativa foi selecionada como a conformação prevista de melhor classificação. MAPK14/p38α foi incluída como o alvo farmacológico estabelecido e proteína de referência positiva para o encaixe do VX-745. O encaixe contra CXCL10, JUN, IFIH1, MX1 e TLR7 foi exploratório e não foi interpretado como evidência de direcionamento farmacológico direto, ligação, inibição ou eficácia.
10. Análise estatística e controle de reprodutibilidade
Todas as análises estatísticas foram realizadas em R, salvo indicação em contrário. Valores de P bicaudais < 0,05 foram considerados estatisticamente significativos. A correção para múltiplos testes foi aplicada às análises de expressão diferencial, enriquecimento, validação externa e qRT-PCR conforme especificado acima. A validação cruzada foi utilizada para avaliar a estabilidade dos modelos de aprendizado de máquina e combinados de qRT-PCR.
Resultados
Pré-processamento de dados transcriptômicos públicos e identificação de genes diferencialmente expressos
A integração e a correção por ComBat dos conjuntos de dados GSE22356, GSE33463 e GSE48149 reduziram as diferenças sistemáticas entre eles. Os diagramas de caixa mostraram que as distribuições de expressão das amostras tornaram-se mais consistentes após a correção. A análise de componentes principais indicou que as amostras se agrupavam principalmente de acordo com a origem do conjunto de dados antes da correção, mas passaram a se misturar mais após a correção, o que indica uma redução eficaz dos efeitos de lote (Figura 1).
Usando limiares de uma mudança absoluta no log2 da razão >0,585 e um valor P ajustado < 0,05, foram identificados 78 genes diferencialmente expressos, incluindo 44 genes superexpressos e 34 genes subexpressos (Figura 2A). O mapa de calor mostrou que genes relacionados aos interferons, incluindo XAF1, MX1, IFI44L, EPSTI1, PARP9, IFIH1, CXCL10, GBP1, STAT1, SAMHD1, TNFSF10 e TLR7, foram geralmente superexpressos nas amostras relacionadas à HP. Em contraste, genes relacionados aos eritróides, incluindo HBG1, HBD, ALAS2, CA1 e SLC4A1, tenderam a ser subexpressos (Figura 2B).
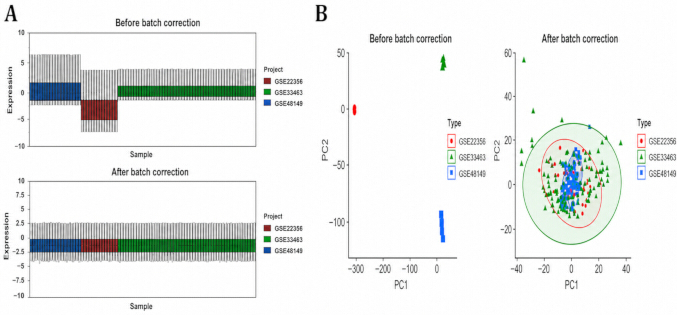
Figura 1: Correção de efeito de lote. (A) Diagramas de caixa da matriz de expressão mesclada antes e depois da correção pelo ComBat. (B) Gráficos de análise de componentes principais mostrando as distribuições das amostras antes e depois da correção de efeito de lote. Clique aqui para visualizar uma versão maior desta figura.
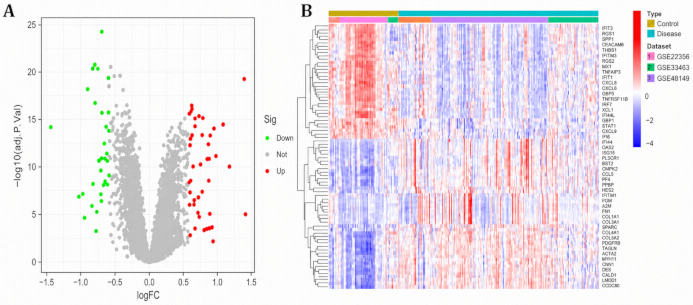
Figura 2: Genes diferencialmente expressos. (A) Gráfico de vulcão mostrando genes regulados para cima e para baixo em amostras relacionadas à HP. (B) Mapa de calor mostrando genes diferencialmente expressos entre os grupos controle e doentes. Clique aqui para visualizar uma versão maior desta figura.
Construção da rede de coexpressão gênica ponderada e enriquecimento funcional
A agrupamento de amostras mostrou um agrupamento geral estável, sem outliers evidentes (Figura 3A). O índice de ajuste da topologia livre de escala aproximou-se de 0,8 com uma potência de 9, e β = 9 foi selecionado para a construção da rede (Figura 3B). O agrupamento de genes e a identificação dinâmica de módulos geraram múltiplos módulos de coexpressão (Figura 3C). O módulo azul apresentou a associação mais forte com o status de HP (r = 0,55, P = 1 × 10⁻¹⁹), enquanto os módulos turquesa e cinza também mostraram correlações com HP (Figura 3D).
Os genes de consenso obtidos pela interseção dos genes-chave do módulo da análise de rede de coexpressão gênica ponderada com os genes diferencialmente expressos foram enriquecidos em defesa imune antiviral, regulação de NF-κB e JAK-STAT, respostas a fatores inflamatórios, ligação a receptores de citocinas e quimiocinas, e regulação transcricional (Figura 4A). A análise de enriquecimento do Kyoto Encyclopedia of Genes and Genomes identificou interação entre citocinas e seus receptores, sinalização de quimiocinas, sinalização de receptores tipo NOD, sinalização de receptores tipo Toll, sinalização de fator de necrose tumoral e sinalização de interleucina-17 (Figura 4B), sustentando a desregulação imune-inflamatória como base molecular do remodelamento vascular pulmonar.
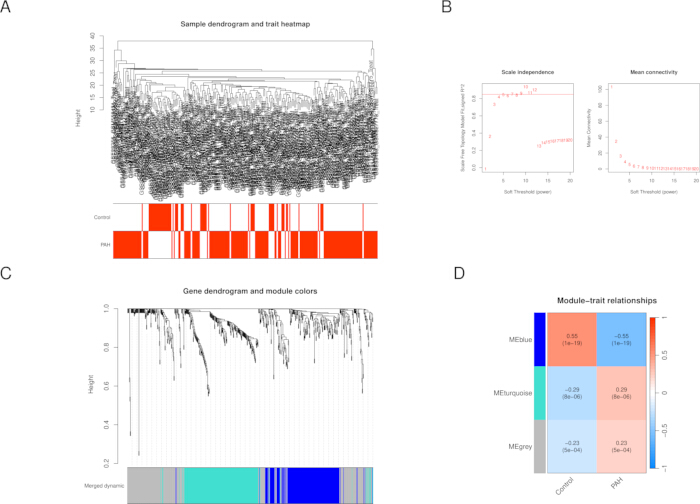
Figura 3: Análise de rede de coexpressão gênica ponderada. (A) Árvore de agrupamento de amostras e mapa de calor de traços. (B) Gráfico de seleção de limiar suave. (C) Dendrograma gênico e cores dos módulos. (D) Mapa de calor da relação entre módulos e traços. Clique aqui para visualizar uma versão maior desta figura.
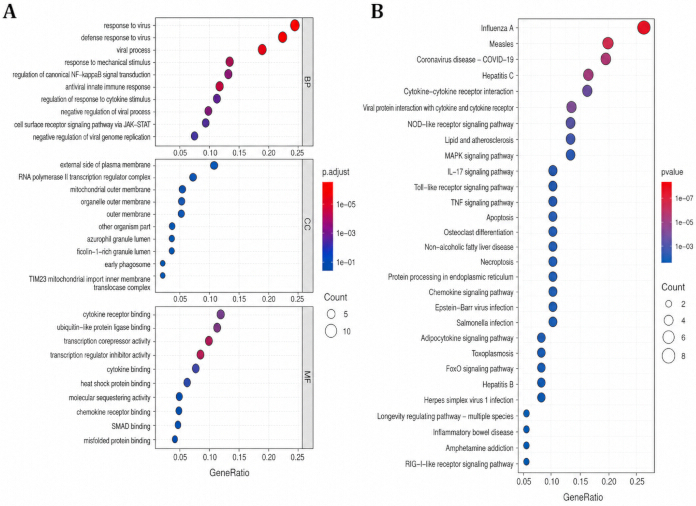
Figura 4: Análise de enriquecimento funcional. (A) Resultados do enriquecimento da Ontologia Genética para os genes em consenso. (B) Resultados do enriquecimento de vias da Enciclopédia de Genes e Genomas de Quioto para os genes em consenso. Clique aqui para visualizar uma versão maior desta figura.
Rede de interação proteína-proteína e triagem de genes centrais
A rede de interação proteína-proteína STRING construída a partir dos genes em consenso revelou uma rede imune-inflamatória interconectada (Figura 5A). A classificação CytoHubba baseada no grau mostrou que FN1, CD44, JUN, TGFB1, CXCL8 e BCL2 apresentaram alta conectividade (Figura 5B). Esses genes centrais podem participar de sinalização inflamatória, adesão celular, remodelação da matriz extracelular e remodelação estrutural vascular pulmonar.
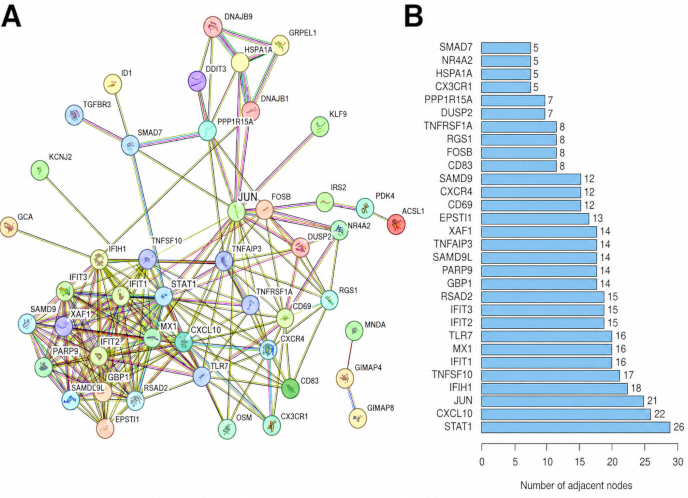
Figura 5: Rede de interação proteína-proteína e genes centrais (hub). (A) Rede de interação proteína-proteína de genes em consenso obtida por meio do STRING. (B) Genes centrais (hub) classificados por grau de conectividade identificados utilizando o CytoHubba. Clique aqui para visualizar uma versão maior desta figura.
Seleção de características e desempenho diagnóstico baseados em aprendizado de máquina
A regressão com operador de seleção e redução do erro absoluto identificou seis genes candidatos com coeficientes não nulos após validação cruzada (Figura 6A, B). A eliminação recursiva de características com máquina de vetores de suporte manteve oito genes e apresentou uma acurácia de validação cruzada de 0,883 e um erro de 0,117 (Figura 7A). O erro "out-of-bag" da floresta aleatória estabilizou-se quando o número de árvores foi ≥100, e IFIH1, JUN e TLR7 figuraram entre os principais genes de acordo com a pontuação de importância (Figura 7B).
A interseção dos resultados do operador de redução e seleção por mínimos absolutos, máquina de vetores de suporte com eliminação recursiva de características e floresta aleatória identificou cinco genes centrais: CXCL10, JUN, IFIH1, MX1 e TLR7 (Figura 8A). A análise da curva ROC para um único gene mostrou discriminação diagnóstica moderada a boa, com valores da área sob a curva de 0,842 para IFIH1, 0,833 para JUN, 0,827 para TLR7, 0,814 para CXCL10 e 0,759 para MX1 (Figura 8B).
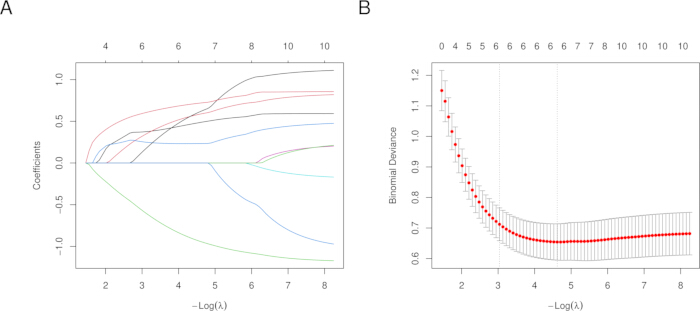
Figura 6: Análise de regressão por operador de contração e seleção por mínimos absolutos. (A) Trajetória dos coeficientes gerada pela regressão por operador de contração e seleção por mínimos absolutos. (B) Gráfico do erro de validação cruzada. Clique aqui para visualizar uma versão maior desta figura.
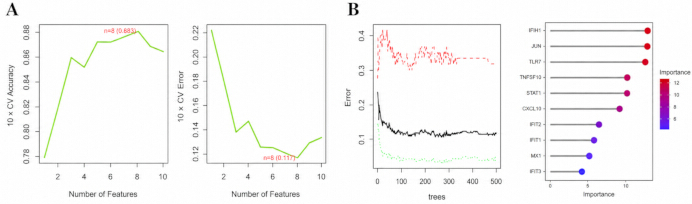
Figura 7: Análises de eliminação recursiva de características por máquina de vetores de suporte e floresta aleatória. (A) Gráfico de seleção de características por eliminação recursiva de características com máquina de vetores de suporte. (B) Modelo de floresta aleatória e classificação da importância dos genes. Clique aqui para visualizar uma versão maior desta figura.
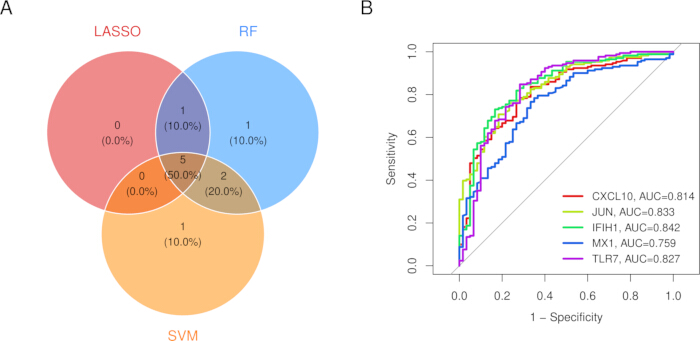
Figura 8: Resumo do aprendizado de máquina. (A) Diagrama de Venn mostrando a interseção dos três algoritmos de seleção de características. (B) Curvas da característica operacional do receptor para os cinco genes centrais. Clique aqui para visualizar uma versão maior desta figura.
Validação externa em GSE117261
GSE117261 foi utilizado como uma coorte independente de validação em tecido pulmonar e não foi incluído na triagem de expressão diferencial, na construção da rede de coexpressão gênica ponderada ou na seleção de características por aprendizado de máquina (Tabela 3). Os resultados completos de validação mostraram replicação heterogênea entre os cinco genes (Tabela 4). CXCL10 apresentou aumento (variação do log₂ = 0,677; P = 0,0410; FDR = 0,144) e resultou em uma AUC de 0,639 (IC 95%, 0,491–0,786), com ponto de corte de 6,245, sensibilidade de 0,724 e especificidade de 0,600. JUN apresentou aumento (variação do log₂ = 0,463; P = 0,00248; FDR = 0,0194) e resultou em uma AUC de 0,714 (IC 95%, 0,593–0,835), com ponto de corte de 8,708, sensibilidade de 0,707 e especificidade de 0,720.
IFIH1 (variação do log2 = 0,107; P = 0,371; FDR = 0,591; AUC = 0,543, IC 95%, 0,398–0,687), MX1 (variação do log2 = 0,109; P = 0,488; FDR = 0,690; AUC = 0,475, IC 95%, 0,337–0,614) e TLR7 (variação do log2 = -0,050; P = 0,543; FDR = 0,733; AUC = 0,546, IC 95%, 0,414–0,679) não atenderam aos critérios pré-especificados de suporte externo. TLR7 também apresentou uma direção oposta ao resultado da qRT-PCR. O modelo exploratório de cinco genes ajustado e avaliado dentro do GSE117261 apresentou um AUC aparente de 0,740, enquanto a validação cruzada aninhada repetida resultou em um AUC de 0,656. Assim, JUN obteve o suporte independente mais forte, CXCL10 mostrou evidência limitada e consistentemente direcional, e a replicação de IFIH1, MX1 e TLR7 foi fraca ou discordante.
| Item | Descrição |
| Acesso ao conjunto de dados | GSE117261 |
| Fonte dos dados | Gene Expression Omnibus (GEO) |
| Tipo de amostra | Dados de microarranjo transcriptômico de tecido pulmonar humano |
| Tamanho da amostra | 58 amostras de HAP e 25 amostras controle de doadores falecidos |
| Plataforma | GPL6244 / Affymetrix Human Gene 1.0 ST Array |
| Objetivo da validação | Diferenças de expressão, análise ROC de único gene e modelagem ROC combinada exploratória de cinco genes: CXCL10, JUN, IFIH1, MX1 e TLR7 |
| Papel neste estudo | Conjunto de dados de validação externa independente; não incluído nas análises originais de treinamento, WGCNA ou seleção de características |
Tabela 3: Informações básicas do conjunto de dados de validação externa independente GSE117261. A tabela resume a origem do conjunto de dados, tipo de amostra, tamanho da amostra, plataforma, objetivos de validação e o papel do GSE117261 no estudo.
| Gene/modelo | PAH n | Controle n | log2 mudança relativa | Valor P | FDR | AUC | IC 95% da AUC | Limiar de Youden | Sensibilidade | Especificidade |
| CXCL10 | 58 | 25 | 0.677 | 0.041 | 0.144 | 0.639 | 0.491–0.786 | 6.245 | 0.724 | 0.6 |
| JUN | 58 | 25 | 0.463 | 0.00248 | 0.019 | 0.714 | 0.593–0.835 | 8.708 | 0.707 | 0.72 |
| IFIH1 | 58 | 25 | 0.107 | 0.371 | 0.591 | 0.543 | 0.398–0.687 | 5.3 | 0.759 | 0.44 |
| MX1 | 58 | 25 | 0.109 | 0.488 | 0.69 | 0.475 | 0.337–0.614 | 6.833 | 0.724 | 0.4 |
| TLR7 | 58 | 25 | -0.05 | 0.543 | 0.733 | 0.546 | 0.414–0.679 | 4.065 | 0.138 | 1 |
| Modelo de cinco genes (aparente/in-sample) | 58 | 25 | / | / | / | 0.74 | 0.621–0.859 | 0.613 | 0.845 | 0.6 |
| Modelo de cinco genes (CV aninhado repetido) | 58 | 25 | / | / | / | 0.656 | 0.517–0.795 | 0.655 | 0.845 | 0.52 |
Tabela 4: Resultados reais de diferença de expressão e validação ROC para GSE117261. A tabela apresenta os tamanhos das amostras de PAH e controle, as variações de expressão log₂, valores de P, valores ajustados pela taxa de falsas descobertas, AUCs, intervalos de confiança de 95%, pontos de corte do índice de Youden, sensibilidades, especificidades e interpretações para os cinco genes e modelos combinados exploratórios.
Validação por PCR quantitativa de transcrição reversa
A validação por PCR quantitativa de transcrição reversa incluiu 20 amostras de tecido pulmonar de PAH independentes do ponto de vista biológico e 20 amostras controle independentes do ponto de vista biológico, com três réplicas técnicas médias para cada amostra biológica. CXCL10, JUN, IFIH1, MX1 e TLR7 foram significativamente superexpressos em PAH (Tabela 5; Figura 9A). Os valores médios de expressão relativa foram aproximadamente 3.470 para CXCL10, 2.560 para JUN, 2.760 para IFIH1, 2.650 para MX1 e 2.580 para TLR7. Os valores de P correspondentes/valores de FDR foram 1,43 × 10⁻7/7,15 × 10⁻7, 4,17 × 10⁻5/4,17 × 10⁻5, 1,10 × 10⁻5/1,38 × 10⁻5, 1,58 × 10⁻6/2,63 × 10⁻6 e 1,37 × 10⁻6/2,63 × 10⁻6, respectivamente.
A análise ROC de único gene baseada na expressão por qRT-PCR mostrou AUCs de 0,988 para CXCL10 (IC 95%, 0,961–1,000), 0,880 para JUN (IC 95%, 0,758–1,000), 0,908 para IFIH1 (IC 95%, 0,820–0,995), 0,945 para MX1 (IC 95%, 0,874–1,000) e 0,948 para TLR7 (IC 95%, 0,886–1,000) (Figura 9B; Tabela 5). O modelo de regressão logística de cinco genes alcançou um AUC aparente de 1,000 (IC 95% DeLong: 1,000–1,000), com sensibilidade e especificidade de 1,000 (Figura 9C). A consistência da direção de expressão entre a validação por PCR quantitativa de transcrição reversa e o conjunto de dados GSE117261 foi visualizada usando um mapa de calor (Figura 9D). Como as mesmas 40 amostras foram utilizadas tanto para ajuste quanto para avaliação, isso reflete o desempenho aparente dentro da amostra. Em 100 repetições de validação cruzada estratificada em cinco partes usando um modelo de regressão logística com regularização L2, o AUC agrupado fora do conjunto também permaneceu em 1,000 (IC 95%, 1,000–1,000), e cada repetição resultou em um AUC de 1,000. Apesar dessa estabilidade interna, a coorte era pequena e ainda é necessária uma validação independente e prospectiva. A comparação direcional com o conjunto de dados GSE117261 mostrou aumentos concordantes para CXCL10, JUN, IFIH1 e MX1, mas direção discordante para TLR7 (Figura 9D).
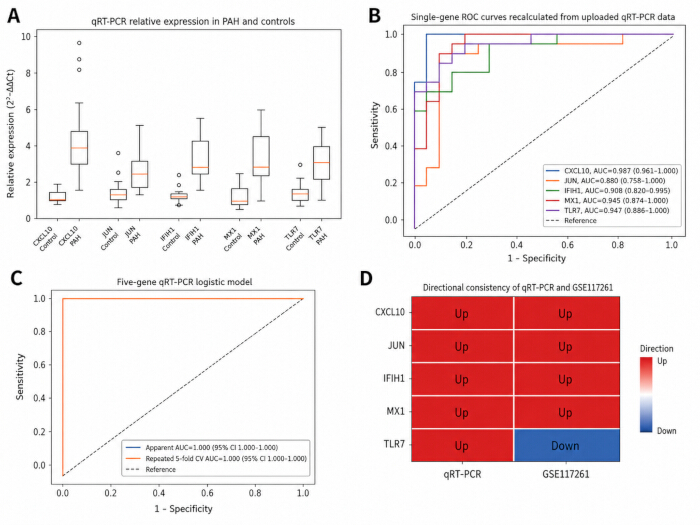
Figura 9: Validação por PCR quantitativa de transcrição reversa. (A) Gráficos de caixa mostrando a expressão relativa de CXCL10, JUN, IFIH1, MX1 e TLR7 em 20 amostras biologicamente independentes de tecido pulmonar de PAH e 20 amostras biologicamente independentes de controle. Cada amostra biológica foi medida em três réplicas técnicas, sendo o valor médio de Ct utilizado para análise. Em cada gráfico de caixa, a linha central representa a mediana, a caixa representa a amplitude interquartil, os bigodes estendem-se até 1,5 vez a amplitude interquartil e os pontos individuais além dos bigodes representam valores discrepantes. (B) Curvas ROC individuais baseadas nos valores de expressão de qRT-PCR; as AUCs e os intervalos de confiança de 95% de DeLong são apresentados. (C) Curvas ROC para o modelo de regressão logística de cinco genes, mostrando tanto o desempenho aparente/inerente quanto o desempenho combinado fora do grupo proveniente de 100 análises de validação cruzada estratificada repetida em cinco partes. (D) Mapa de calor mostrando a consistência da direção da expressão entre qRT-PCR e GSE117261; CXCL10, JUN, IFIH1 e MX1 foram aumentados de forma concordante, enquanto TLR7 foi discordante. Clique aqui para visualizar uma versão maior desta figura.
| Gene/modelo | PAH n | Controle n | Controle 2^-ΔΔCt, média ± DP | PAH 2^-ΔΔCt, média ± DP | Direção | Valor P | FDR | AUC | IC 95% da AUC | Limiar de Youden | Sensi- bilidade | Especifi- cidade | Tipo de validação | ||||
| CXCL10 | 20 | 20 | 1.099 ± 0.502 | 3.470 ± 1.043 | Superexpressão | 1.43E-07 | 7.15E-07 | 0.987 | 0.961–1.000 | 2.028 | 1 | 0.95 | Análise de qRT-PCR de gene único | ||||
| JUN | 20 | 20 | 1.158 ± 0.738 | 2.560 ± 1.609 | Superexpressão | 4.17E-05 | 4.17E-05 | 0.88 | 0.758–1.000 | 1.423 | 0.85 | 0.9 | Análise de qRT-PCR de gene único | ||||
| IFIH1 | 20 | 20 | 1.091 ± 0.440 | 2.760 ± 1.398 | Superexpressão | 1.10E-05 | 1.38E-05 | 0.908 | 0.820–0.995 | 1.579 | 0.8 | 0.85 | Análise de qRT-PCR de gene único | ||||
| MX1 | 20 | 20 | 1.132 ± 0.582 | 2.650 ± 1.085 | Superexpressão | 1.58E-06 | 2.63E-06 | 0.945 | 0.874–1.000 | 1.779 | 0.9 | 0.9 | Análise de qRT-PCR de gene único | ||||
| TLR7 | 20 | 20 | 1.080 ± 0.444 | 2.580 ± 1.284 | Superexpressão | 1.37E-06 | 2.63E-06 | 0.947 | 0.886–1.000 | 1.764 | 0.85 | 0.9 | Análise de qRT-PCR de gene único | ||||
| Modelo de cinco genes (aparente/in-sample) | 20 | 20 | Não apli- cável | Não apli- cável | Não aplicável | / | / | 1 | 1.000–1.000 | 0.998 | 1 | 1 | Mesmas 40 amostras biológicas utilizadas para ajuste e avaliação do modelo | ||||
| Modelo de cinco genes (CV 5-fold repetido 100×) | 20 | 20 | Não apli- cável | Não apli- cável | Não aplicável | / | / | 1 | 1.000–1.000 | 0.716 | 1 | 1 | Validação cruzada interna usando regressão logística com regularização L2 | ||||
Tabela 5: Resultados completos de expressão por qRT-PCR e de ROC para CXCL10, JUN, IFIH1, MX1 e TLR7, incluindo as análises do modelo combinado de cinco genes. A tabela apresenta os tamanhos das amostras de PAH e controles, valores de expressão relativa, direções da expressão, valores de P, valores ajustados pela taxa de falsas descobertas, AUCs, intervalos de confiança de 95%, pontos de corte do índice de Youden, sensibilidades, especificidades e tipos de validação para os genes individuais e modelos combinados.
Validação transcriptômica de célula única em GSE210248
O GSE210248 forneceu suporte mecanicista em nível celular ao mostrar que o remodelamento arterial pulmonar na HAP foi acompanhado por alterações na comunicação entre células imunes e células estruturais vasculares. Essa observação foi consistente com o enriquecimento transcriptômico em massa das respostas inflamatórias, sinalização de quimiocinas, sinalização do receptor tipo Toll e sinalização do fator de necrose tumoral.
Evidências de célula única sugeriram que a rede de sinalização da artéria pulmonar por PAH mudou-se em direção às células estruturais, incluindo células musculares lisas e fibroblastos. As células musculares lisas exibiram múltiplos estados, incluindo semelhante à pericitos/sensíveis ao oxigênio, contráteis, sintéticas e semelhantes a fibroblastos. Esses resultados apoiam um modelo de doença no qual a ativação imune-inflamatória e a remodelação das células estruturais vasculares conduzem conjuntamente a progressão da HP/PAH.
Triagem de compostos candidatos e docking molecular
A triagem por Mapa de Conectividade identificou BRD-K91900765 como o composto candidato com a classificação mais alta entre os 10 principais resultados, com um escore Logit de 10,13 e uma probabilidade prevista de 0,085 (Figura 10). A curadoria do composto mostrou que BRD-K91900765 corresponde à VX-745/neflamapimod, um inibidor seletivo de p38α/MAPK14 com um identificador de composto no PubChem de 3038525 e uma massa molecular de 436,27 g/mol (Tabela 6).
O encaixe exploratório de BRD-K91900765/VX-745 com as cinco proteínas associadas a biomarcadores gerou pontuações máximas de Vina de -7,5 kcal/mol para CXCL10, -7,6 kcal/mol para JUN, -7,5 kcal/mol para IFIH1, -8,7 kcal/mol para MX1 e -8,1 kcal/mol para TLR7 (Tabelas 7–11; Figura 11A–E). Esses resultados indicaram apenas compatibilidade estrutural prevista e não estabeleceram as cinco proteínas como alvos farmacológicos diretos. Previsões preliminares de absorção, distribuição, metabolismo, excreção e toxicidade sugeriram que o composto possuía várias propriedades semelhantes às de fármacos, embora o valor relativamente alto de cLogP calculado exija avaliação adicional (Tabela 12). O encaixe contra o alvo estabelecido do VX-745, MAPK14/p38α (ID PDB: 1OUK), foi incluído como análise de referência positiva. A principal cavidade de MAPK14, C1, apresentou pontuação de Vina de -7,9 kcal/mol, volume da cavidade de 3560 Å3, centro da caixa de encaixe em (2, 22, 34) e dimensões de (22, 31, 31) (Tabela 13; Figura 11F).
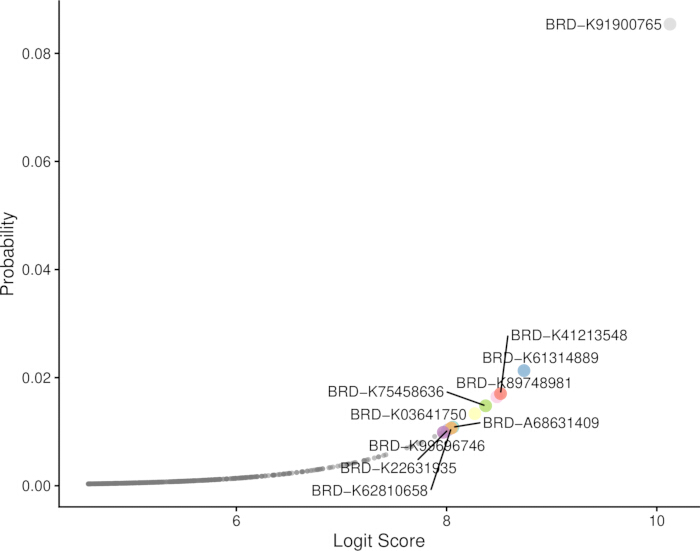
Figura 10: Classificação dos compostos candidatos do Connectivity Map. Classificação dos compostos candidatos identificados por meio da triagem do Connectivity Map. BRD-K91900765 foi o composto com classificação mais alta, com um escore Logit de 10,13 e uma probabilidade prevista de 0,085. Clique aqui para visualizar uma versão maior desta figura.
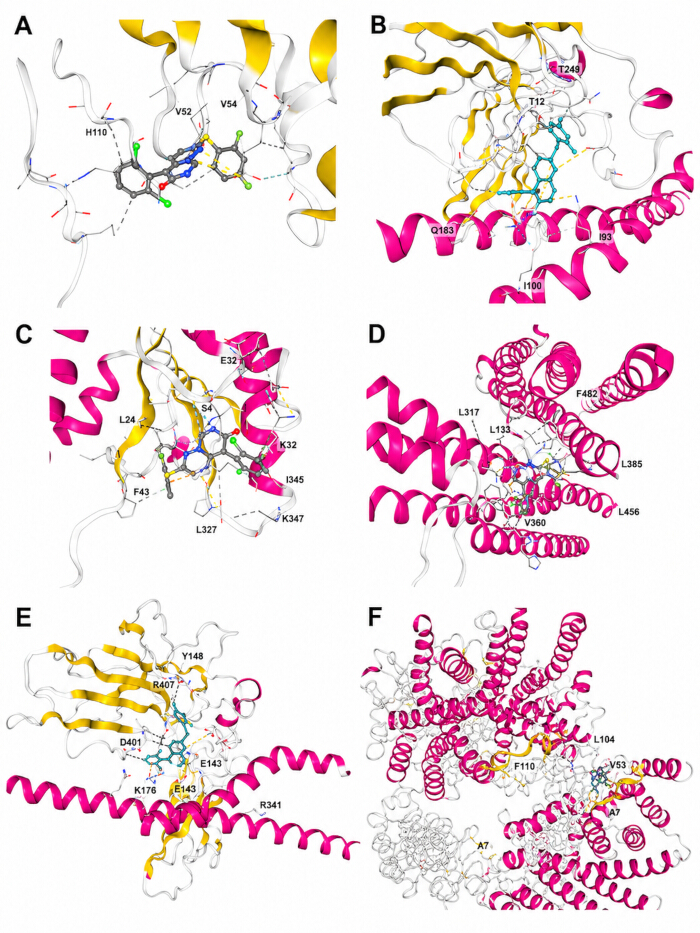
Figura 11: Diagramas tridimensionais de acoplamento molecular para BRD-K91900765/VX-745. (A) Acoplamento exploratório com CXCL10. (B) Acoplamento exploratório com JUN. (C) Acoplamento exploratório com IFIH1. (D) Acoplamento exploratório com MX1. (E) Acoplamento exploratório com TLR7. (F) Acoplamento com referência positiva com o alvo farmacológico estabelecido MAPK14/p38α (ID PDB: 1OUK). Os painéis A–E indicam compatibilidade estrutural prevista e não estabelecem direcionamento farmacológico direto. Clique aqui para visualizar uma versão maior desta figura.
| Item | Descrição |
| CMap/Broad ID | BRD-K91900765 (formato comum de lote: BRD-K91900765-001-xx-x) |
| Nome comum/alcunhas | VX-745; neflamapimod; VRT-031745; VD-31745 |
| Nome químico | 5-(2,6-diclorofenil)-2-(2,4-difluorofenil)sulfanilpirimido[1,6-b]piridazin-6-ona |
| PubChem CID | 3038525 |
| Número CAS | 209410-46-8 |
| Fórmula molecular / massa molecular relativa | C19H9Cl2F2N3OS; 436,27 g/mol |
| SMILES canônico | C1=CC(=C(C(=C1)Cl)C2=C3C=CC(=NN3C=NC2=O)SC4=C(C=C(C=C4)F)F)Cl |
| InChIKey | VEPKQEUBKLEPRA-UHFFFAOYSA-N |
| Alvo farmacológico principal estabelecido | MAPK14/p38α; também foi relatada inibição de p38β, com menor seletividade do que para p38α |
Tabela 6: Informações químicas e farmacológicas para BRD-K91900765/VX-745. A tabela resume os identificadores do composto, sinônimos, nome químico, fórmula molecular, massa molecular, descritores estruturais e alvo farmacológico estabelecido do BRD-K91900765/VX-745.
| ID do CurPocket | Pontuação Vina (kcal/mol) | Volume da cavidade (ų) | Centro (x, y, z) | Tamanho do docking (x, y, z) |
| C1 | -7.5 | 7568 | 49, 15, 4 | 34, 33, 35 |
| C4 | -7 | 160 | 46, 0, 4 | 22, 22, 22 |
| C3 | -6 | 208 | 34, 15, 9 | 22, 22, 22 |
| C2 | -5.8 | 465 | 45, -6, 19 | 22, 22, 22 |
| C5 | -5.1 | 150 | 63, 0, 20 | 22, 22, 22 |
Tabela 7: Bolsos de docking previstos para BRD-K91900765/VX-745 com CXCL10 (ID PDB: 1LV9). A tabela apresenta os identificadores de cavidade classificados, pontuações do Vina, volumes das cavidades, centros das caixas de docking e dimensões das caixas de docking gerados pelo CB-Dock2.
| ID do CurPocket | Pontuação Vina (kcal/mol) | Volume da cavidade (ų) | Centro (x, y, z) | Tamanho do docking (x, y, z) |
| C3 | -7.6 | 1593 | 26, 35, 70 | 22, 22, 22 |
| C2 | -7.5 | 1927 | 25, 21, 60 | 35, 22, 22 |
| C1 | -7.4 | 5420 | 32, 37, 48 | 35, 22, 31 |
| C5 | -6 | 464 | 26, 5, 48 | 22, 22, 22 |
| C4 | -5.3 | 683 | 59, 32, 39 | 22, 22, 22 |
Tabela 8: Bolsos de docking previstos para BRD-K91900765/VX-745 com JUN (ID PDB: 1JUN). A tabela apresenta os identificadores de cavidade classificados, pontuações do Vina, volumes das cavidades, centros das caixas de docking e dimensões das caixas de docking gerados pelo CB-Dock2.
| ID do CurPocket | Pontuação Vina (kcal/mol) | Volume da cavidade (ų) | Centro (x, y, z) | Tamanho do encaixe (x, y, z) |
| C1 | -7.5 | 583 | 15, 4, 17 | 22, 22, 22 |
| C3 | -7.2 | 146 | 19, 21, 24 | 22, 22, 22 |
| C4 | -6.6 | 141 | 31, 19, 15 | 22, 22, 22 |
| C2 | -6.2 | 273 | 38, 9, 24 | 22, 22, 22 |
| C5 | -6.2 | 125 | 27, -7, 10 | 22, 22, 22 |
Tabela 9: Bolsos de docking previstos para BRD-K91900765/VX-745 com IFIH1 (ID PDB: 3B6E). A tabela apresenta os identificadores de cavidade classificados, pontuações do Vina, volumes das cavidades, centros das caixas de docking e dimensões das caixas de docking gerados pelo CB-Dock2.
| ID do CurPocket | Pontuação Vina (kcal/mol) | Volume da cavidade (ų) | Centro (x, y, z) | Tamanho do docking (x, y, z) |
| C1 | -8.7 | 523 | -18, -14, -5 | 22, 22, 22 |
| C4 | -7.3 | 262 | -13, -6, -9 | 22, 22, 22 |
| C3 | -7 | 306 | 12, 12, -7 | 22, 22, 22 |
| C2 | -6.9 | 408 | -3, 1, -12 | 22, 22, 22 |
| C5 | -6.2 | 179 | 24, 25, 13 | 22, 22, 22 |
Tabela 10: Bolsos de docking previstos para BRD-K91900765/VX-745 com MX1 (ID PDB: 5GTM). A tabela apresenta os identificadores de cavidade classificados, pontuações do Vina, volumes das cavidades, centros das caixas de docking e dimensões das caixas de docking gerados pelo CB-Dock2.
| ID do CurPocket | Pontuação Vina (kcal/mol) | Volume da cavidade (ų) | Centro (x, y, z) | Tamanho do encaixe (x, y, z) |
| C2 | -8.1 | 7347 | 112, 137, 148 | 33, 28, 35 |
| C3 | -8.1 | 2604 | 124, 124, 176 | 30, 22, 22 |
| C1 | -8 | 7676 | 137, 112, 148 | 34, 29, 35 |
| C5 | -6.9 | 1976 | 117, 157, 88 | 22, 22, 22 |
| C4 | -6.6 | 2040 | 132, 92, 91 | 22, 22, 22 |
Tabela 11: Bolsos de docking previstos para BRD-K91900765/VX-745 com TLR7 (ID PDB: 7CYN). A tabela apresenta os identificadores de cavidade classificados, pontuações do Vina, volumes das cavidades, centros das caixas de docking e dimensões das caixas de docking gerados pelo CB-Dock2.
| Propriedade físico-química | Parâmetro | Resultado | Interpretação |
| Propriedade físico-química | Peso molecular | 436,27 g/mol | Abaixo de 500 Da, atendendo ao limite de peso molecular de Lipinski |
| Propriedade físico-química | cLogP | Aproximadamente 5,49 | Ligeiramente acima de 5, sugerindo alta lipofilicidade e a necessidade de considerar solubilidade e ligação inespecífica |
| Propriedade físico-química | TPSA | Aproximadamente 47,26 Ų | Baixa área superficial polar, compatível com permeabilidade de membrana potencialmente favorável |
| Similaridade a fármaco | HBA/HBD | Maio-00 | Atende aos limites de Lipinski para doadores e aceitores de ligações de hidrogênio |
| Similaridade a fármaco | Ligações rotatóveis | 3 | Baixa flexibilidade conformacional, favorável para conformações de ligação estáveis |
| Alertas estruturais | Alertas PAINS/Brenk | Não detectado | Nenhum alerta estrutural comum de interferência em ensaios pan-ensaios ou reatividade detectado |
| Previsão de toxicidade | Mutagenicidade de Ames | Previsto como não tóxico em teste de Ames | Sugere baixo risco mutagênico previsto; ainda é necessária validação experimental |
| Previsão de toxicidade | Carcinogenicidade | Previsto como não carcinogênico | Sugere risco carcinogênico de longo prazo relativamente baixo; ainda é necessária validação experimental |
| Observação farmacocinética | Disponibilidade oral/penetração no cérebro | A literatura e bancos de dados indicam uma molécula de baixo peso molecular disponível por via oral e capaz de atravessar a barreira hematoencefálica | Compatível com seu histórico de desenvolvimento como inibidor da p38α; ainda é necessária reavaliação para indicações de PH |
Tabela 12: Previsões preliminares de propriedades físico-químicas, semelhança a fármacos, ADMET e toxicidade para BRD-K91900765/VX-745. A tabela resume as propriedades físico-químicas previstas, medidas de semelhança a fármacos, alertas estruturais, parâmetros de toxicidade e características farmacocinéticas. Essas previsões computacionais são preliminares e não substituem a validação experimental da farmacocinética ou toxicológica.
| ID do CurPocket | Pontuação Vina (kcal/mol) | Volume da cavidade (ų) | Centro (x, y, z) | Tamanho do docking (x, y, z) |
| C1 | -7.9 | 3560 | 2, 22, 34 | 22, 31, 31 |
| C5 | -7.5 | 254 | -9, 28, 60 | 22, 22, 22 |
| C3 | -7.4 | 351 | 12, 7, 37 | 22, 22, 22 |
| C2 | -6.3 | 827 | 18, 5, 28 | 22, 22, 22 |
| C4 | -6.3 | 334 | -16, 17, 38 | 22, 22, 22 |
Tabela 13: Bolsos de docking previstos para BRD-K91900765/VX-745 com seu alvo farmacológico estabelecido MAPK14/p38α (ID PDB: 1OUK), incluído como análise de referência positiva. A tabela apresenta os identificadores de cavidade classificados, pontuações do Vina, volumes das cavidades, centros das caixas de docking e dimensões das caixas de docking gerados utilizando o mesmo fluxo de trabalho de docking aplicado aos cinco proteínas associadas a biomarcadores.
Coletivamente, as análises de descoberta e os resultados de qRT-PCR apoiam CXCL10, JUN, IFIH1, MX1 e TLR7 como biomarcadores candidatos a HP/PAH associados à desregulação imune-inflamatória e ao remodelamento vascular pulmonar, embora a replicação independente em GSE117261 tenha sido mais forte para JUN e variável para os outros genes. BRD-K91900765/VX-745 é um candidato computacionalmente priorizado para reposicionamento de fármaco com um mecanismo plausível de inibição de MAPK14/p38α; são necessárias validações de ligação ao alvo, celulares, farmacocinéticas, de toxicidade e em modelos animais antes da interpretação terapêutica.
DISPONIBILIDADE DE DADOS:
Todos os conjuntos de dados transcriptômicos públicos utilizados neste estudo estão disponíveis no banco de dados Gene Expression Omnibus sob os números de acesso GSE22356, GSE33463, GSE48149, GSE117261 e GSE210248. Todos os arquivos de código, conjuntos de dados processados, dados brutos e analisados de qRT-PCR desidentificados, saídas de modelos e arquivos de entrada/saída de docking molecular foram consolidados em um repositório estruturado no Zenodo. O repositório inclui um arquivo README que descreve cada arquivo, versões de softwares e pacotes, ordem de execução dos scripts e etapas completas de reprodução — https://zenodo.org/records/21682282
Discussão
Foi desenvolvida uma metodologia integrada e reprodutível para identificar biomarcadores moleculares associados à HP/HA e compostos terapêuticos candidatos, combinando transcriptômica pública, análise de rede de coexpressão gênica ponderada, enriquecimento funcional, análise de rede de interação proteína-proteína, três algoritmos de aprendizado de máquina, validação externa, interpretação transcriptômica de célula única, confirmação por PCR quantitativa com transcriptase reversa, triagem do Mapa de Conectividade e acoplamento molecular. CXCL10, JUN, IFIH1, MX1 e TLR7 foram consistentemente priorizados como genes centrais característicos e mapeados coletivamente para um eixo molecular relacionado à inflamação imune e à resposta ao interferon. Esses achados sustentam a ideia de que a HP/HA não é apenas um distúrbio hemodinâmico, mas também uma doença complexa de remodelação vascular envolvendo ativação imunológica, sinalização inflamatória, detecção inata de ácidos nucleicos e alterações fenotípicas celulares e estruturais2,5,6.
O potencial diagnóstico dos cinco genes foi apoiado pela seleção de características por múltiplos algoritmos e pela análise ROC da coorte de descoberta. A validação independente em GSE117261 foi heterogênea e não uniforme: JUN atendeu aos critérios pré-especificados de FDR e AUC, CXCL10 mostrou um aumento nominal consistentemente direcional sem significância de FDR em todo o transcriptoma, IFIH1 e MX1 apresentaram replicação limitada, e TLR7 mostrou uma direção discordante. Esses resultados não sustentam a afirmação de que os cinco genes foram validados independentemente e indicam possíveis efeitos da composição da coorte, da heterogeneidade tecidual, das diferenças entre plataformas e da gravidade da doença. Em contraste, a qRT-PCR em 20 amostras de tecido pulmonar de PAH e 20 controles confirmou a superexpressão significativa dos cinco genes e um desempenho favorável em análises ROC individuais por gene.
O modelo logístico de qRT-PCR com cinco genes alcançou uma AUC aparente de 1,000 (IC 95%, 1,000–1,000), e sua AUC agrupada fora da dobra permaneceu em 1,000 em 100 análises repetidas de validação cruzada estratificada em cinco partes. No entanto, o modelo foi desenvolvido com apenas 40 amostras biológicas, e a separação completa em um pequeno coorte retrospectivo pode gerar estimativas de desempenho otimistas e instáveis. Portanto, o painel deve ser considerado uma assinatura molecular exploratória, e não uma ferramenta diagnóstica clinicamente validada. Coortes maiores e multicêntricos, coeficientes de modelo fixos pré-especificados, validação ao nível de proteína, imuno-histoquímica e testes prospectivos são necessários antes da translação clínica.
Entre os cinco genes centrais, CXCL10 pode promover o recrutamento de células imunes e a amplificação inflamatória local no microambiente vascular pulmonar. IFIH1 e TLR7 estão envolvidos na detecção inata de ácidos nucleicos e podem refletir a ativação de vias inflamatórias semelhantes às antivirais. MX1 é um gene clássico estimulado por interferon e pode representar um marcador downstream da ativação da via do interferon tipo I. JUN é um fator de transcrição sensível ao estresse que conecta a estimulação inflamatória à proliferação celular, apoptose e remodelação tecidual. Juntos, esses genes sugerem um modelo biologicamente coerente no qual a ativação imune inata e a sinalização relacionada ao interferon interagem com processos de remodelação vascular na HP/APH. Essa interpretação é consistente com evidências anteriores de que inflamação, imunidade e vias relacionadas ao interferon contribuem para a patobiologia da APH2,5,6.
A validação em nível de célula única forneceu um contexto mecanicista para as descobertas derivadas de análise em massa. O GSE210248 sugeriu que o remodelamento arterial pulmonar na HAP era acompanhado por alterações na comunicação entre células imunes e células estruturais vasculares, incluindo células musculares lisas, fibroblastos, células endoteliais e monócitos/macrófagos. A presença de múltiplos estados fenotípicos de células musculares lisas, incluindo os contráteis, sintéticos, semelhantes a células sensíveis ao oxigênio/pericitos e semelhantes a fibroblastos, apoia um modelo de doença no qual ocorrem simultaneamente a ativação imune e o remodelamento estrutural das células. Essa evidência celular é importante porque os sinais transcriptômicos em massa podem surgir de alterações nas proporções celulares, infiltração de células imunes ou mudanças transcricionais em células vasculares residentes. A análise de célula única, portanto, situa CXCL10, JUN, IFIH1, MX1 e TLR7 dentro de um ecossistema multicelular de remodelamento vascular pulmonar, e não em um processo restrito a um único tipo celular18,19,20,21.
A análise de reposicionamento de fármacos identificou BRD-K91900765, correspondente a VX-745/neflamapimod, como o candidato computacional com a classificação mais alta. O VX-745 é um inibidor seletivo de p38α/MAPK14, e sua relação com as vias de estresse inflamatório torna plausível, do ponto de vista mecanicista, seu envolvimento no contexto da inflamação associada à HP/HAPE30. Por isso, o encaixe molecular (docking) contra MAPK14/p38α foi incluído como uma análise de referência positiva com relevância mecanicista. Em contraste, o encaixe molecular contra CXCL10, JUN, IFIH1, MX1 e TLR7 foi exploratório e indicou apenas compatibilidade estrutural prevista; não demonstrou que essas proteínas associadas a biomarcadores sejam alvos diretos do VX-745, nem estabeleceu ligação direta, inibição do alvo ou eficácia terapêutica. Uma hipótese mais biologicamente plausível é que o VX-745 possa modular indiretamente a assinatura transcritômica imuno-inflamatória e relacionada ao interferon identificada, por meio da inibição de MAPK14. As previsões do Connectivity Map, os escores de encaixe molecular e as estimativas de ADMET permanecem como evidências computacionais. Trabalhos futuros devem incluir ensaios bioquímicos de ligação ao alvo, experimentos em células endoteliais e musculares lisas arteriais pulmonares, modelos de estímulo inflamatório, avaliações farmacocinéticas e toxicológicas, e validação em modelos animais.
Estudos experimentais recentes sobre hipertensão pulmonar hipóxica também destacaram a importância da comunicação entre neutrófilos e células vasculares pulmonares. Já foram relatadas interações mediadas por HCK entre neutrófilos e células musculares lisas arteriais pulmonares e interações mediadas por SERPINB3 entre neutrófilos e células endoteliais como fatores contribuintes para o remodelamento vascular pulmonar31˒32. O eixo SERPINB3–STAT1/3 é particularmente relevante para os achados presentes, pois sinais relacionados à interferona, STAT1 e JAK–STAT foram identificados nas análises transcriptômicas. Em conjunto, essas observações sustentam a interpretação de que a ativação de células imunes e a comunicação com células estruturais vasculares podem contribuir para a progressão da HP/HAPO.
O estudo possui várias vantagens. Vários conjuntos de dados públicos e a correção de efeitos de lote foram utilizados para reduzir vieses específicos dos conjuntos de dados. A análise de expressão diferencial, a análise de rede de coexpressão gênica ponderada, a análise de interação proteína-proteína e três algoritmos de aprendizado de máquina foram combinados para melhorar a robustez das características. A validação independente em amostras bulk, a confirmação por qRT-PCR e evidências de sequenciamento de célula única forneceram camadas complementares, mas não idênticas, de evidência. Os achados heterogêneos do GSE117261 e o pequeno grupo de qRT-PCR também destacam limitações importantes, incluindo replicação externa incompleta, efeitos potenciais específicos de tecido e plataforma e o risco de superajuste. A descoberta de biomarcadores também foi estendida à triagem de compostos candidatos, mas as análises de docking permanecem como geradoras de hipóteses. Estudos futuros devem validar os cinco genes em coortes independentes maiores utilizando transcriptômica espacial, proteômica, imuno-histoquímica e modelos de organoides ou vasos-em-chip. No geral, CXCL10, JUN, IFIH1, MX1 e TLR7 permanecem como biomarcadores candidatos a HP/HPA associados ao remodelamento vascular imune-inflamatório e relacionado ao interferon, enquanto BRD-K91900765/VX-745 é um candidato computacional para reposicionamento de fármacos cuja relevância terapêutica exige validação experimental.
Divulgações
Os autores declaram não haver conflitos de interesses.
Agradecimentos
Este estudo foi apoiado pelo Projeto de Construção da Província Inovadora de Hunan (nº 2022JJ30465).
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| 2× SYBR Green PCR Mastermix | Beijing Solarbio Science & Technology Co., Ltd. | Catalog no. SR1110 | Amplificação quantitativa em tempo real por PCR com corante e detecção de fluorescência |
| AI21.msvmRFE.R e e1071 | Script R personalizado com o pacote CRAN e1071 | AI21.msvmRFE.R; e1071 v1.7-17 | Eliminação recursiva de características por máquina de vetores de suporte |
| Agarose | Beijing Solarbio Science & Technology Co., Ltd. | Catalog no. A8201; CAS 9012-36-6 | Avaliação da integridade do RNA total por eletroforese em gel de agarose |
| Aparelho de eletroforese em gel de agarose | Beijing Liuyi Biotechnology Co., Ltd. | Modelo DYCZ-24DN | Avaliação eletroforética da integridade do RNA |
| Motor de pontuação AutoDock Vina | Center for Computational Structural Biology, Scripps Research | v1.2.0; RRID: SCR_011958 | Pontuação de conformação proteína-ligante no fluxo de trabalho CB-Dock2 |
| CB-Dock2 | Laboratório Cao, servidor web CB-Dock2 | v2.0; acesso em julho de 2026 | Detecção cega de cavidades e acoplamento molecular de VX-745 com as estruturas proteicas selecionadas |
| CellChat | Pacote R CellChat | v2.1.2 | Inferência e visualização da comunicação célula-célula a partir da matriz de expressão de célula única |
| CellChatDB.human | Distribuído com o pacote R CellChat | CellChatDB.human; subconjunto de sinalização secretada; limiar mínimo de células = 10 | Banco de dados de interações ligante-receptor humano para CellChat |
| clusterProfiler | Pacote R Bioconductor | v4.20.0; versão Bioconductor 3.23 | Análises de enriquecimento de Ontologia Genética e do Kyoto Encyclopedia of Genes and Genomes |
| Connectivity Map (CMap/CLUE) | Broad Institute | Recurso L1000/CLUE; RRID: SCR_016204; acesso em julho de 2026 | Análise computacional de reposicionamento de fármacos |
| Primeres oligonucleotídicos personalizados | Beijing Solarbio Science & Technology Co., Ltd. | Sintetizados sob encomenda; sequências dos primeres fornecidas na Tabela 2 | Amplificação de ACTB, CXCL10, JUN, IFIH1, MX1 e TLR7 |
| cytoHubba | Loja de aplicativos Cytoscape | v0.1 | Classificação de genes centrais com base no grau na rede de interação proteína-proteína |
| Cytoscape | Consortium Cytoscape | v3.10.4; RRID: SCR_003032 | Visualização e análise da rede de interação proteína-proteína |
| DrugBank | Banco de conhecimento DrugBank | v6.0; RRID: SCR_002700 | Curação de identidade de compostos e informações farmacológicas |
| Sistema de documentação de géis | Beijing Liuyi Biotechnology Co., Ltd. | Modelo WO-9413B | Visualização e registro dos resultados de integridade do RNA em gel de agarose |
| Gene Expression Omnibus (GEO) | Centro Nacional de Informação Biotecnológica | GSE22356, GSE33463, GSE48149, GSE117261 e GSE210248; RRID: SCR_005012 | Recuperação de conjuntos de dados transcritômicos em massa e de célula única |
| GEOquery | Pacote R Bioconductor | v2.80.0; versão Bioconductor 3.23 | Download e importação programática de dados de expressão e fenótipo do GEO |
| glmnet | Pacote R CRAN | v5.0 | Regressão logística com operador de contração e seleção absoluta e modelagem logística regularizada |
| limma | Pacote R Bioconductor | v3.68.0; versão Bioconductor 3.23; RRID: SCR_010943 | Análise de expressão diferencial e estatísticas bayesianas empíricas |
| Espectrofotômetro NanoDrop | Thermo Fisher Scientific | NanoDrop ND-1000; software v3.8 | Medição da concentração de RNA e das razões de pureza A260/280 e A260/230 |
| NCBI Primer-BLAST | Centro Nacional de Informação Biotecnológica | Ferramenta web; RRID: SCR_003095; acesso em julho de 2026 | Verificação da especificidade dos primeres |
| pROC | Pacote R CRAN | v1.19.0.1; RRID: SCR_024286 | Análise de característica operacional do receptor, intervalos de confiança de DeLong e pontos de corte do índice de Youden |
| Banco de Dados de Proteínas (PDB) | RCSB Protein Data Bank | CXCL10: 1LV9; JUN: 1JUN; IFIH1: 3B6E; MX1: 5GTM; TLR7: 7CYN; MAPK14/p38α: 1OUK; RRID: SCR_012820 | Recuperação de estruturas proteicas determinadas experimentalmente para acoplamento molecular |
| PubChem | Centro Nacional de Informação Biotecnológica | PubChem CID 3038525; RRID: SCR_004284 | Recuperação da estrutura tridimensional e identificadores químicos do BRD-K91900765/VX-745 |
| R | R Foundation for Statistical Computing | v4.6.1; RRID: SCR_001905 | Computação estatística, processamento de dados, aprendizado de máquina e visualização |
| randomForest | Pacote R CRAN | v4.7-1.2 | Seleção de características por floresta aleatória e classificação de importância de variáveis |
| Sistema de PCR em tempo real | Stratagene, agora Agilent Technologies | Sistema Mx3000P de PCR em Tempo Real | Amplificação qRT-PCR, aquisição de fluorescência, análise de curva de dissociação e exportação de Ct |
| Seurat | Pacote R CRAN; Laboratório Satija | v5.5.1; RRID: SCR_016341 | Controle de qualidade, normalização, redução de dimensionalidade, agrupamento e anotação em sequenciamento de RNA de célula única |
| STRING | Consortium STRING | v12.0; RRID: SCR_005223 | Construção da rede de interação proteína-proteína |
| sva (ComBat) | Pacote R Bioconductor | v3.60.0; versão Bioconductor 3.23 | Correção de efeitos de lote entre conjuntos de dados |
| SwissADME | Instituto Suíço de Bioinformática | Servidor web; acesso em julho de 2026 | Pré-avaliação de semelhança a fármacos, propriedades físico-químicas e ADME |
| Kit de Extração de RNA Total | Beijing Solarbio Science & Technology Co., Ltd. | Catalog no. R1200 | Extração e purificação de RNA total de amostras de tecido pulmonar |
| Kit RT-PCR Universal (AMV) | Beijing Solarbio Science & Technology Co., Ltd. | Catalog no. RP1200 | Transcrição reversa de RNA total em DNA complementar |
| WGCNA | Pacote R CRAN | v1.74 | Construção de rede de coexpressão gênica ponderada e análise de módulo-traço |
Referências
- Simonneau G, et al. Haemodynamic definitions and updated clinical classification of pulmonary hypertension. Eur Respir J. 2019;53(1):1801913. doi: 10.1183/13993003.01913-2018.
- Rabinovitch M, Guignabert C, Humbert M, Nicolls MR. Inflammation and immunity in the pathogenesis of pulmonary arterial hypertension. Circ Res. 2014;115(1):165–175.
- Humbert M, et al. 2022 ESC/ERS Guidelines for the diagnosis and treatment of pulmonary hypertension. Eur Heart J. 2022;43(38):3618–3731.
- Galiè N, et al. 2015 ESC/ERS Guidelines for the diagnosis and treatment of pulmonary hypertension. Eur Respir J. 2015;46(4):903–975.
- Soon E, et al. Elevated levels of inflammatory cytokines predict survival in idiopathic and familial pulmonary arterial hypertension. Circulation. 2010;122(9):920–927.
- George PM, et al. Evidence for the involvement of type I interferon in pulmonary arterial hypertension. Circ Res. 2014;114(4):677–688.
- Subramanian A, et al. A next-generation Connectivity Map: L1000 platform and the first 1,000,000 profiles. Cell. 2017;171(6):1437–1452.e17.
- Leek JT, et al. The sva package for removing batch effects and other unwanted variation in high-throughput experiments. Bioinformatics. 2012;28(6):882–883.
- Ritchie ME, et al. limma powers differential expression analyses for RNA-sequencing and microarray studies. Nucleic Acids Res. 2015;43(7):e47. doi: 10.1093/nar/gkv007.
- Langfelder P, Horvath S. WGCNA: an R package for weighted correlation network analysis. BMC Bioinformatics. 2008;9:559. doi: 10.1186/1471-2105-9-559.
- Yu G, Wang LG, Han Y, He QY. clusterProfiler: an R package for comparing biological themes among gene clusters. OMICS. 2012;16(5):284–287.
- Kanehisa M, Goto S. KEGG: Kyoto Encyclopedia of Genes and Genomes. Nucleic Acids Res. 2000;28(1):27–30.
- Szklarczyk D, et al. The STRING database in protein–protein association networks and functional enrichment analyses for any sequenced genome of interest. Nucleic Acids Res. 2023;51(D1):D638–D646.
- Friedman J, Hastie T, Tibshirani R. Regularization paths for generalized linear models via coordinate descent. J Stat Softw. 2010;33(1):1–22.
- Guyon I, Weston J, Barnhill S, Vapnik V. Gene selection for cancer classification using support vector machines. Mach Learn. 2002;46:389–422.
- Breiman L. Random forests. Mach Learn. 2001;45(1):5–32.
- Robin X, et al. pROC: an open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics. 2011;12:77. doi: 10.1186/s12859-011-0077-8.
- Stearman RS, et al. Systems analysis of the human pulmonary arterial hypertension lung transcriptome. Am J Respir Cell Mol Biol. 2019;60(6):637–649.
- Crnkovic S, et al. Single-cell transcriptomics reveals skewed cellular communication and phenotypic shift in pulmonary artery remodeling. JCI Insight. 2022;7(20):e153471. doi: 10.1172/jci.insight.153471.
- Hao Y, et al. Integrated analysis of multimodal single-cell data. Cell. 2021;184(13):3573–3587.e29.
- Jin S, et al. Inference and analysis of cell–cell communication using CellChat. Nat Commun. 2021;12(1):1088. doi: 10.1038/s41467-021-21246-9.
- Bustin SA, et al. MIQE 2.0: revision of the Minimum Information for Publication of Quantitative Real-Time PCR Experiments guidelines. Clin Chem. 2025;71(6):634–651.
- Livak KJ, Schmittgen TD. Analysis of relative gene expression data using real-time quantitative PCR and the 2−ΔΔCt method. Methods. 2001;25(4):402–408.
- Kim S, et al. PubChem 2023 update. Nucleic Acids Res. 2023;51(D1):D1373–D1380.
- Knox C, et al. DrugBank 6.0: the DrugBank Knowledgebase for 2024. Nucleic Acids Res. 2024;52(D1):D1265–D1275.
- Daina A, Michielin O, Zoete V. SwissADME: a free web tool to evaluate pharmacokinetics, drug-likeness, and medicinal chemistry friendliness of small molecules. Sci Rep. 2017;7:42717. doi: 10.1038/srep42717.
- Burley SK, et al. RCSB Protein Data Bank: powerful new tools for exploring 3D structures of biological macromolecules for basic and applied research and education. Nucleic Acids Res. 2021;49(D1):D437–D451. doi: 10.1093/nar/gkaa1038.
- Eberhardt J, Santos-Martins D, Tillack AF, Forli S. AutoDock Vina 1.2.0: new docking methods, expanded force field, and Python bindings. J Chem Inf Model. 2021;61(8):3891–3898. doi: 10.1021/acs.jcim.1c00203.
- Liu Y, et al. CB-Dock2: improved protein-ligand blind docking by integrating cavity detection, docking, and homologous template fitting. Nucleic Acids Res. 2022;50(W1):W159–W164. doi: 10.1093/nar/gkac394.
- Duffy JP, et al. The discovery of VX-745: a novel and selective p38α kinase inhibitor. ACS Med Chem Lett. 2011;2(10):758–763.
- Sheng Y, et al. Crocin inhibits neutrophil migration and activation to treat hypoxic pulmonary hypertension through targeting HCK. Phytomedicine. 2025;148:157334. doi: 10.1016/j.phymed.2025.157334.
- Cui H, et al. Leonurine ameliorates hypoxic pulmonary hypertension by inhibiting cross-talk between neutrophils and endothelial cells via SERPINB3 targeting. Int Immunopharmacol. 2026;176:116467. doi: 10.1016/j.intimp.2026.116467.