Este estudo identifica cinco biomarcadores relacionados à cuproptose e ferroptose na colite ulcerativa por meio de aprendizado de máquina integrado, sequenciamento de RNA de única célula e validação experimental, fornecendo insights para o diagnóstico clínico e imunoterapia direcionada.
É necessária uma assinatura do JoVE para visualizar este conteúdo. Faça login ou inicie seu teste gratuito.
Artigo de investigação
Alvejando a Ferroptose e a Cuproptose na Colite Ulcerativa: Descobertas a partir de Bioinformática Abrangente e Validação Experimental
Neste artigo
Resumo
Resumo
A colite ulcerativa (CU) é uma doença intestinal persistente com patogênese parcialmente definida e taxas crescentes de prevalência e hospitalização em países recentemente industrializados. Na CU, a morte excessiva de células epiteliais intestinais rompe a barreira mucosa e desencadeia respostas inflamatórias. A ferroptose e a cuproptose são duas formas recentemente descritas de morte celular regulada. A maioria dos estudos sobre CU examinou esses processos separadamente; no entanto, seus papéis combinados na progressão da CU permanecem insuficientemente caracterizados. Para investigar seus papéis sinérgicos na patogênese da CU, utilizamos uma abordagem escalonada envolvendo perfis transcriptômicos em larga escala para identificar alvos candidatos, seguida por validação em modelos in vitro. Genes diferencialmente expressos (DEGs) foram cruzados com genes relacionados à ferroptose (FRGs) e genes relacionados à cuproptose (CRGs). Os alvos comuns foram priorizados utilizando um consenso de algoritmos de aprendizado de máquina e análise de rede de coexpressão gênica ponderada (WGCNA). Cinco biomarcadores—LCN2, IDO1, CXCL2, NOS2 e CD274—foram significativamente superexpressos na CU. A análise de célula única caracterizou sua expressão em diferentes tipos celulares, sendo LCN2 e NOS2 principalmente enriquecidos em células epiteliais. A relevância mecanicista desses marcadores foi posteriormente avaliada por meio de ensaios in vitro. O tratamento com inibidores de ferroptose ou cuproptose atenuou a inflamação associada à CU e modulou a expressão dos biomarcadores em modelos celulares Caco-2. Esses achados identificam cinco biomarcadores associados à progressão da CU e fornecem evidências experimentais que apoiam seu potencial uso no diagnóstico clínico e na intervenção terapêutica.
Introdução
A colite ulcerativa (CU) é uma doença inflamatória intestinal recorrente associada a uma carga global crescente e a custos substanciais de tratamento a longo prazo1,2. Embora aminossaliciatos, corticosteroides, terapias biológicas e medicamentos de pequenas moléculas tenham ampliado as opções de tratamento, a remissão duradoura permanece difícil de alcançar para muitos pacientes3,4. Essa necessidade clínica não atendida destaca a importância de identificar marcadores moleculares reprodutíveis e mecanismos acessíveis que possam apoiar o diagnóstico precoce e terapias guiadas por mecanismos5.
A ferroptose é uma forma dependente de ferro de morte celular regulada, impulsionada pela peroxidação lipídica, esgotamento de glutationa e atividade prejudicada da GPX46. Níveis elevados de ferro e malondialdeído na colite ulcerativa são compatíveis com lesão epitelial ferroptótica, enquanto a ativação experimental do eixo SLC7A11–GSH–GPX4 ou a inibição direta da ferroptose pode proteger a barreira intestinal7,8.
A cuproptose, descrita em 2022, é desencadeada quando o cobre se liga a proteínas mitocondriais lipoiladas, resultando no agregamento proteico e estresse proteotóxico9. Como o intestino desempenha um papel central no metabolismo do cobre, a interrupção dessa via pode amplificar as lesões epiteliais oxidativas e inflamatórias na colite ulcerativa10.
A ferroptose e a cuproptose podem convergir por meio do desequilíbrio de íons metálicos, do metabolismo mitocondrial, do esgotamento de glutationa e do estresse oxidativo11. No entanto, permanece sem solução se essa interação produz uma assinatura molecular reproduzível na colite ulcerativa e se tal assinatura responde à inibição específica da via.
A hipótese do estudo era que a interação desregulada entre ferroptose e cuproptose na colite ulcerativa converge para uma assinatura reprodutível de biomarcadores que pode ser priorizada em conjuntos de dados transcriptômicos em bulk e de célula única, além de ser atenuada pela inibição específica da via em um modelo de lesão do epitélio intestinal. Assim, bioinformática multicohorte, aprendizado de máquina, análise de célula única e experimentos direcionados em Caco-2 foram integrados para identificar e avaliar funcionalmente os biomarcadores candidatos (Figura 1).
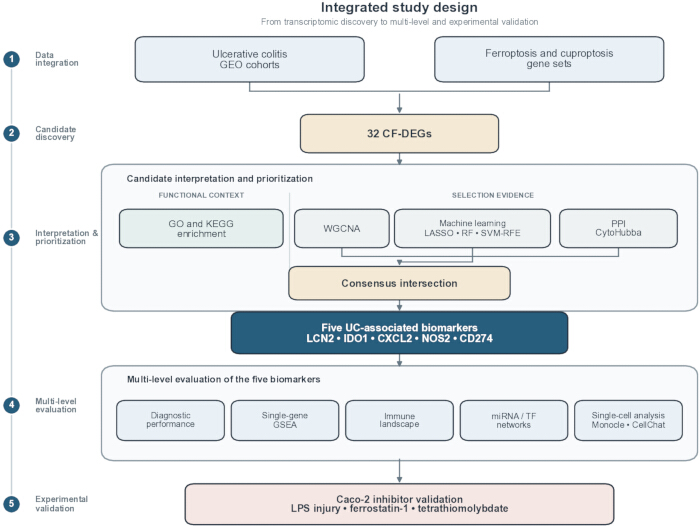
Figura 1: Fluxo de trabalho do estudo. Fluxo de trabalho integrado para triagem transcriptômica multicohorte, priorização de biomarcadores baseada em aprendizado de máquina e redes, localização em célula única e validação baseada em inibidores em células Caco-2. RC: retocolite ulcerosa; GEO: Gene Expression Omnibus; WGCNA: análise de rede de coexpressão gênica ponderada; PPI: interação proteína-proteína; ROC: característica de operação do receptor; GSEA: análise de enriquecimento de conjunto de genes. Clique aqui para visualizar uma versão maior desta figura.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Protocolo
Este estudo utilizou conjuntos de dados de acesso público e linhagens celulares humanas comercialmente disponíveis. Nenhum participante humano, tecido humano recém-coletado ou animais vertebrados foram envolvidos; portanto, não foi necessária a aprovação do comitê de ética institucional. As ferramentas de pesquisa, softwares e recursos on-line utilizados no protocolo estão listados na Tabela de Materiais.
1. Processamento de dados para análise de expressão diferencial
Para estabelecer as coortes de descoberta e validação transcriptômicas, o banco de dados Gene Expression Omnibus (GEO) foi pesquisado utilizando o termo “colite ulcerativa”. Quatro conjuntos de dados — GSE87466, GSE92415, GSE107499 e GSE75214 — foram utilizados como conjunto de treinamento, enquanto GSE47908 foi reservado para validação externa. Os conjuntos de dados de treinamento foram normalizados e corrigidos quanto a lotes utilizando o ComBat no Sangerbox 3.0, enquanto o conjunto de dados de validação foi processado de forma independente.
Um total de 583 genes relacionados à ferroptose (FRGs) foi obtido do FerrDB e complementado com genes relatados na literatura para reduzir o viés de fonte única12. Um conjunto de 96 genes relacionados à cuproptose (CRGs) foi compilado a partir de estudos publicados12,13,14. A expressão diferencial foi analisada usando o limma com limiares de |log₂ razão de variação| > 1 e P ajustado por Benjamini–Hochberg < 0,05. Gráficos diagnósticos de normalização, correção de lote, expressão diferencial e agrupamento estão disponíveis na Figura Suplementar 1. A composição das amostras, plataformas e atribuições das coortes estão descritas na Tabela Suplementar 1.
2. Identificação de DEGs associados à FC na RC
Foi realizada uma análise de correlação de Pearson utilizando limiares de |r| > 0,5 e P < 0,05 para identificar FRGs e CRGs coexpressos. O conjunto de genes resultante foi intersectado com os genes diferencialmente expressos (DEGs) para identificar genes diferencialmente expressos coexpressos de cuproptose–ferroptose (CF-DEGs).
3. Análise de enriquecimento
Análises de enriquecimento de Gene Ontology (GO) e Kyoto Encyclopedia of Genes and Genomes (KEGG) foram realizadas utilizando o clusterProfiler e a plataforma Bioinformatics.com.cn. Um valor de P ajustado por Benjamini–Hochberg < 0,05 foi utilizado como limiar de significância. Os gráficos de enriquecimento estão disponíveis na Figura Suplementar 2.
4. Análise de rede de coexpressão gênica ponderada (WGCNA)
A estrutura modular subjacente aos perfis de expressão gênica foi analisada utilizando a análise de rede de coexpressão gênica ponderada (WGCNA). Amostras anormais foram identificadas e excluídas por meio de agrupamento hierárquico combinado à função goodSamplesGenes. Um parâmetro de limiarização suave adequado (β) foi posteriormente determinado para atender ao critério de topologia livre de escala na construção da rede.
Os dados de expressão processados foram utilizados para construir uma matriz de sobreposição topológica (TOM) para análise de coexpressão gênica. Utilizando a abordagem de corte dinâmico de árvores, genes com padrões de expressão altamente consistentes foram organizados em módulos gênicos, cada um contendo pelo menos 100 genes. As associações entre eigengenes dos módulos (MEs) e fenótipos foram analisadas para identificar módulos associados ao processo da doença e extrair os conjuntos gênicos correspondentes. Os diagnósticos de triagem do WGCNA estão apresentados na Figura Suplementar 3.
5. Seleção de biomarcadores
Para priorizar candidatos para acompanhamento experimental, três algoritmos de aprendizado de máquina foram aplicados em paralelo¹⁵. A regressão por seleção e redução absoluta mínima (LASSO) foi utilizada para seleção de características, a floresta aleatória com ntree = 500 foi usada para classificar a importância dos genes, e a máquina de vetores de suporte com eliminação recursiva de características (SVM-RFE) foi empregada para identificar o subconjunto de características com o menor erro de validação cruzada. Os diagnósticos completos do triagem estão apresentados na Figura Suplementar 5.
A importância dos genes foi avaliada de acordo com a contribuição individual de cada gene para a precisão da classificação, e os genes com classificação mais alta foram reunidos para gerar um conjunto preliminar de genes¹⁶. O algoritmo SVM-RFE realizou a seleção de características e a otimização do modelo por meio da eliminação iterativa de características, permitindo a identificação do subconjunto ideal de características para classificação¹⁷. Os genes comuns aos três algoritmos foram considerados biomarcadores candidatos identificados por meio de aprendizado de máquina.
Os DEGs associados à CF foram utilizados para construir uma rede de interação proteína-proteína (PPI), e o CytoHubba foi empregado para classificar os nós centrais. A intersecção dos principais módulos do WGCNA, das três saídas do aprendizado de máquina e do conjunto central da PPI definiu cinco biomarcadores candidatos integrados: LCN2, IDO1, CXCL2, NOS2 e CD274. Esses genes foram classificados como candidatos diagnósticos associados à RC. Experimentos subsequentes com inibidores classificaram ainda LCN2, IDO1, CXCL2 e NOS2 como marcadores responsivos à inibição da ferroptose e CD274 como marcador responsivo à inibição da cuproptose. Esses genes não foram considerados reguladores upstream comprovados de nenhuma das vias.
6. Desenvolvimento do modelo preditivo e avaliação multímétodo
Para avaliar o potencial clínico-translacional da assinatura gênica identificada, foi construído um nomograma utilizando o pacote rms para avaliar o desempenho diagnóstico. O desempenho do modelo foi avaliado por meio de uma curva de calibração, o teste de Hosmer–Lemeshow (HL) e o índice de concordância de Harrell (índice C).
A calibração do modelo foi avaliada utilizando o teste de HL e o erro absoluto médio (EAM). Um valor de P > 0,05 e um EAM < 0,1 foram estabelecidos como limiares para adequação e precisão aceitáveis do modelo, respectivamente. Curvas características de operação do receptor (ROC) foram geradas, e a área sob a curva (AUC) foi calculada para avaliar o desempenho preditivo do nomograma para colite ulcerativa (UC). Um conjunto de dados independente foi utilizado para avaliar a generalização e estabilidade do modelo.
7. Análise de enriquecimento de conjuntos de genes (GSEA)
No conjunto de treinamento, foi realizada uma análise de correlação de Spearman entre cada biomarcador e todos os demais genes. Os resultados de correlação foram ordenados para gerar um conjunto de genes classificados. A análise de enriquecimento de conjuntos de genes (GSEA) foi realizada utilizando o conjunto de genes c2.cp.kegg_medicus.v2025.1.Hs.symbols da Base de Dados de Assinaturas Moleculares (MSigDB) como referência. As vias biológicas com P < 0,05 foram consideradas significativamente enriquecidas.
8. Análise da paisagem imunológica
A ferramenta CIBERSORT e a matriz de assinatura LM22 foram utilizadas para realizar a análise de desconvolução dos dados de expressão e estimar as proporções de 22 subtipos de células imunes. Em seguida, foi realizada uma análise de correlação de Spearman para avaliar as associações entre os cinco biomarcadores e os subtipos de células imunes.
9. Análise da rede regulatória
As informações sobre a regulação de fatores de transcrição (TF) e microRNAs (miRNAs) relacionados a genes foram obtidas a partir dos bancos de dados integrados ChEA3 e TarBase 9.0 por meio da plataforma NetworkAnalyst. Os miRNAs associados a pelo menos dois nós foram incluídos na rede regulatória.
10. RNA-seq de única célula
Os conjuntos de dados de células únicas de UC GSE116222, compreendendo três amostras saudáveis e três amostras de UC, e GSE214695, compreendendo seis amostras saudáveis e seis amostras de UC, foram integrados. As células foram mantidas quando continham entre 200 e 5.000 genes detectados, >1.000 identificadores moleculares únicos, < 30% dos transcritos mitocondriais, < 3% dos transcritos de hemoglobina, e < 50% dos transcritos ribossômicos. A função NormalizeData foi utilizada para normalização, e o Harmony foi utilizado para correção de lote antes do agrupamento e anotação.
Após a filtragem, os dados foram normalizados utilizando a função NormalizeData. O Harmony foi utilizado para minimizar os efeitos de lote entre as amostras. A aproximação uniforme de variedades e projeção (UMAP) e o t-SNE (t-distributed stochastic neighbor embedding) foram usados para redução de dimensionalidade e agrupamento celular, a fim de caracterizar as estruturas locais e globais dentro da população celular. Um total de 31.712 células de alta qualidade foi mantido para análises adicionais. Os tipos celulares foram anotados de acordo com genes marcadores canônicos das células.
A análise de pseudotempo foi realizada utilizando o Monocle 2 para investigar alterações nos estados das células epiteliais e mieloides de tecidos com DC. As trajetórias de desenvolvimento celular e as diferenças entre grupos foram avaliadas, e os padrões de expressão de biomarcadores ao longo da trajetória de pseudotempo foram visualizados.
O CellChat foi utilizado para avaliar a comunicação célula-célula entre subpopulações de células epiteliais e mieloides. Padrões de expressão específicos de subpopulações foram integrados para inferir probabilidades de interação e vias de sinalização-chave entre células epiteliais e mieloides e para caracterizar suas potenciais redes regulatórias intercelulares.
11. Experimentos com células
Células humanas de adenocarcinoma de cólon Caco-2 foram cultivadas em meio Eagle modificado de Dulbecco contendo 10% de soro bovino fetal, 100 U/mL de penicilina e 100 µg/mL de estreptomicina a 37 °C em 5% de CO₂. As células Caco-2 foram selecionadas como um modelo reprodutível de monocamada epitelial para ensaios de barreira intestinal e de lesão inflamatória; no entanto, sua origem maligna limita a generalização direta ao epitélio colônico não maligno. As informações sobre a passagem celular não estavam disponíveis nos registros experimentais arquivados.
Um modelo in vitro de inflamação e lesão foi estabelecido mediante exposição das células a 1 µg/mL de lipopolissacarídeo (LPS) durante 24 h. As células foram alocadas em um grupo controle com veículo de dimetilsulfóxido, um grupo somente com LPS, um grupo com LPS + 4 µM de ferrostatina-1 ou um grupo com LPS + 40 µM de tetratiomolibdato, com concentrações finais de solvente equivalentes. O grupo somente com LPS serviu como controle positivo de lesão/modelo para as comparações de resgate com inibidores.
- Viabilidade celular
A viabilidade celular foi avaliada utilizando um ensaio de viabilidade celular de acordo com as instruções do fabricante. Após incubação a 37 °C por aproximadamente 2 h, a absorbância em 450 nm foi medida utilizando um leitor de microplacas. - Medição dos níveis de MDA e Fe²⁺
Os níveis intracelulares de malondialdeído (MDA) e Fe2⁺ foram medidos utilizando os kits de ensaio correspondentes, de acordo com as instruções dos fabricantes. A proteína total foi quantificada utilizando um ensaio de ácido bicinconínico, e cada resultado foi normalizado em relação ao conteúdo proteico da amostra correspondente. - Ensaio com sonda fluorescente para íons cobre
Após a remoção do meio de cultura, uma sonda fluorescente específica para Cu2⁺ foi adicionada numa concentração final de 1 µM e incubada por 30 min a 37 °C. As imagens foram adquiridas imediatamente, sem lavagem, utilizando um microscópio de fluorescência invertido com comprimentos de onda de excitação e emissão de 510 e 578 nm, respectivamente. As configurações de aquisição foram mantidas constantes entre os grupos, e a barra de escala da imagem foi calibrada em 50 µm. - RT-qPCR
O RNA total foi isolado utilizando um reagente de extração de RNA baseado em fenol–guanidínio. O DNA complementar foi sintetizado a partir de 1 µg de RNA utilizando um kit de síntese de primeira fita de DNA complementar, e reagentes baseados em SYBR Green foram utilizados para PCR em tempo real. Cada reação foi realizada em triplicata técnica. As sequências dos iniciadores estão indicadas na Supplementary Table 2, e a abundância relativa de RNA mensageiro foi calculada utilizando o método 2⁻ΔΔCt.
12. Análise estatística
A normalidade e a homogeneidade da variância foram avaliadas utilizando os testes de Shapiro–Wilk e de Levene centrado na mediana, respectivamente. Os dados que atendiam a ambas as suposições foram analisados usando um teste t não pareado bicaudal ou uma análise de variância de um fator seguida pelo teste de diferença significativa honesta de Tukey. Quando qualquer uma das suposições não foi atendida, utilizou-se o teste t de Welch ou a análise de variância de Welch seguida pelas comparações de Games–Howell.
Os resultados são apresentados como média ± desvio padrão. As contagens reais de réplicas biológicas, os valores P exatos bicaudais e as verificações de pressupostos são relatados na Tabela Suplementar 3. A planilha-fonte arquivada da Figura 13 contém menos réplicas controle para os painéis A (n = 4), C (n = 4) e F (n = 2), enquanto todas as outras combinações de painel/grupo contêm n = 6.
As análises computacionais foram realizadas utilizando R e os fluxos de trabalho limma, WGCNA, clusterProfiler, glmnet, randomForest, e1071, pROC, rms, Seurat v4, Harmony, Monocle 2, CellChat e Cytoscape/CytoHubba. Os recursos online incluíram FerrDB, GEO, STRING, ChEA3, TarBase 9.0, NetworkAnalyst, CIBERSORT/LM22, MSigDB, Bioinformatics.com.cn e Sangerbox 3.0.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Resultados
Identificação e anotação funcional de genes coexpressos em cuproptose e ferroptose
Quatro conjuntos de dados de treinamento, compreendendo 421 amostras de UC e 97 controles saudáveis, foram integrados. Um total de 551 genes diferencialmente expressos, incluindo 362 genes superexpressos e 189 genes subexpressos, foram identificados. A análise de correlação gerou 444 genes correlacionados à ferroptose–cuproptose, e a interseção com os genes diferencialmente expressos resultou em...
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Discussão
Este estudo integrou transcritômica em massa, aprendizado de máquina, análise de célula única e experimentos celulares direcionados para investigar a interação entre ferroptose e cuproptose na colite ulcerativa (UC). Cinco candidatos diagnósticos associados à UC foram reprodutíveis nas coortes de descoberta e validação, localizaram-se principalmente em compartimentos epiteliais e mieloides e mostraram expressão responsiva à inibição de vias em células Caco-2. Esses achados apoiam um fluxo de trabalho em etapas no qual a ...
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Divulgações
Os autores não têm nada a declarar.
Agradecimentos
Este trabalho foi apoiado pelo Projeto Jovem Erudito Qihuang da Administração Nacional de Medicina Tradicional Chinesa (Termo de Doação nº 2022256). Agradece-se a todos os membros das equipes de pesquisa da Universidade de Medicina Tradicional Chinesa de Liaoning e do Terceiro Hospital Afiliado da Universidade de Medicina Tradicional Chinesa de Liaoning pelo apoio técnico e pelas contribuições na curadoria de dados e na análise bioinformática.
O OpenAI Codex (OpenAI) foi utilizado durante a revisão exclusivamente para auxiliar na edição em língua inglesa, formatação do documento e verificação da qualidade das figuras. Todo o conteúdo científico, análises, citações e a apresentação final foram revisados e verificados pelos autores, que assumem total responsabilidade pelo manuscrito.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| Kit de ensaio de proteína BCA | Beyotime Institute of Biotechnology | P0010 | Quantificação de proteína para normalização. |
| Bioinformatics.com.cn | Bioinformatics.com.cn | Plataforma online; acesso em 2026 | Plataforma de visualização e análise GO/KEGG. |
| Linhagem celular Caco-2 | ATCC | HTB-37 | Linhagem celular de adenocarcinoma colorretal humano utilizada para o modelo de lesão epitelial. |
| Kit Cell Counting Kit-8 | GLPBio | GK10001 | Ensaio de viabilidade celular medido a 450 nm. |
| CIBERSORT com assinatura LM22 | Desenvolvedores do CIBERSORT | LM22 | Desconvolução de 22 frações de células imunes. |
| ChEA3 | Laboratório Ma'ayan | Plataforma online; acesso em 2026 | Enriquecimento de fatores de transcrição e predição de rede regulatória. |
| Incubadora de CO2 | Não registrado | N/A | Incubadora umidificada utilizada para cultura a 37 °C e 5% de CO2. |
| Probe fluorescente de Cu2+ | BIOFOUNT | CAS 98907-26-7 | Detecção fluorescente intracelular de Cu2+ . |
| Cytoscape com CytoHubba | Consortium Cytoscape | Versão não registrada | Visualização de interações proteína-proteína e classificação de nós centrais. |
| Meio de Eagle modificado por Dulbecco | Gibco | 11965092 | Meio de cultura para células Caco-2. |
| Dissulfóxido de dimetila | Não registrado | N/A | Controle veicular. |
| Soro bovino fetal | Não registrado | N/A | Suplemento do meio a 10%. |
| Kit de ensaio de Fe2+ | Abcam | ab83366 | Medição de Fe2+ intracelular. |
| FerrDB | Desenvolvedores do FerrDB | Banco de dados online; acesso em 2026 | Fonte de genes relacionados à ferroptose. |
| Ferrostatina-1 | Sigma-Aldrich | SML0583 | Inibidor de ferroptose; concentração final de 4 µM. |
| Harmony | Broad Institute/comunidade | Versão não registrada | Correção de lote em células únicas. |
| Microscópio invertido de fluorescência | Olympus | IX71 | Imagem de fluorescência de Cu2+ com excitação/emissão em 510/578 nm. |
| Lipopolissacarídeo | Não registrado | N/A | Estímulo de lesão inflamatória a 1 µg/mL por 24 h. |
| Kit de ensaio de malondialdeído | Beyotime Institute of Biotechnology | S0131S | Medição de peroxidação lipídica. |
| Leitor de microplacas | Não registrado | N/A | Medição de absorbância a 450 nm. |
| Monocle | Bioconductor/comunidade | Versão 2 | Análise de pseudotempo em células únicas. |
| Banco de Dados de Assinaturas Moleculares | Broad Institute | c2.cp.kegg_medicus.v2025.1.Hs | Conjunto de genes de referência para GSEA. |
| NetworkAnalyst | Desenvolvedores do NetworkAnalyst | Plataforma online; acesso em 2026 | Integração de redes de fatores de transcrição e miRNA. |
| Penicilina–estreptomicina | Não registrado | N/A | 100 U/mL de penicilina e 100 µg/mL de estreptomicina. |
| R | Foundation R para Computação Estatística | Versão não registrada | Ambiente de análise bioinformática. |
| Conjunto de pacotes R | CRAN/Bioconductor | Versões dos pacotes não registradas | Fluxos de trabalho com limma, WGCNA, clusterProfiler, glmnet, randomForest, e1071, pROC e rms. |
| Sistema de PCR em tempo real | Não registrado | N/A | Aparelho de RT-qPCR com SYBR Green. |
| Kit RevertAid para Síntese de cDNA de Primeiro Fio | Thermo Fisher Scientific | K1622 | Síntese de cDNA de primeiro fio a partir de 1 µg de RNA. |
| Sangerbox | Desenvolvedores do Sangerbox | 3.0 | Normalização e correção de lote com ComBat. |
| Seurat | Satija Lab/comunidade | Versão 4 | Controle de qualidade, normalização, agrupamento e visualização em células únicas. |
| Software de análise estatística | Não registrado | N/A | Análise estatística dos experimentos celulares originais. |
| STRING | Consortium STRING | Banco de dados online; acesso em 2026 | Construção de rede de interação proteína–proteína. |
| Reagentes de PCR em tempo real com SYBR Green | Takara | RR820A | PCR quantitativa em tempo real. |
| TarBase | DIANA Tools | 9.0 | Interações miRNA–gene com suporte experimental. |
| Tetratiomolibdato | Sigma-Aldrich | 323446 | Quelante de cobre; concentração final de 40 µM. |
| Reagente TRIzol | Takara | 9108 | Extração de RNA total. |
Referências
- Fu M, Wang QW, Liu YR, Chen SJ. The role of the three major intestinal barriers in ulcerative colitis in the elderly. Ageing Res Rev. 2025;108:102752. https://doi.org/10.1016/j.arr.2025.102752.
- Le Berre C, Honap S, Peyrin-Biroulet L. Ulcerative colitis. Lancet. 2023;402:571–584.
- Wangchuk P, Yeshi K, Loukas A. Ulcerative colitis: Clinical biomarkers, therapeutic targets, and emerging treatments. Trends Pharmacol Sci. 2024;45:892–903.
- Kobayashi T, et al. Ulcerative colitis (primer). Nat Rev Dis Primers. 2020;6:74. https://doi.org/10.1038/s41572-020-0205-x.
- Huang J, et al. Comprehensive analysis of cuproptosis-related genes in immune infiltration and diagnosis in ulcerative colitis. Front Immunol. 2022;13:1008146. https://doi.org/10.3389/fimmu.2022.1008146.
- Liu Y, et al. Development and experimental validation of machine learning-based disulfidptosis-related ferroptosis biomarkers in inflammatory bowel disease. Genes. 2025;16:496. https://doi.org/10.3390/genes16050496.
- Hu W, et al. HIF-1α alleviates ferroptosis in ulcerative colitis by regulation of GPX4. Cell Death Dis. 2025;16:542. https://doi.org/10.1038/s41419-025-07883-8.
- Zhao C, et al. FXR acts as a therapeutic target for ulcerative colitis via suppressing ferroptosis. Mol Med. 2025;31:258. https://doi.org/10.1186/s10020-025-01305-3.
- Tsvetkov P, et al. Copper induces cell death by targeting lipoylated TCA cycle proteins. Science. 2022;375:1254–1261.
- Liu J, et al. Unveiling the cuproptosis in colitis and colitis-related carcinogenesis: A multifaceted player and immune moderator. Research (Wash D C). 2025;8:0698. https://doi.org/10.34133/research.0698.
- Liu N, Chen M. Crosstalk between ferroptosis and cuproptosis: From mechanism to potential clinical application. Biomed Pharmacother. 2024;171:116115. https://doi.org/10.1016/j.biopha.2023.116115.
- Hao S, et al. Development of prognostic model incorporating a ferroptosis/cuproptosis-related signature and mutational landscape analysis in muscle-invasive bladder cancer. BMC Cancer. 2024;24:958. https://doi.org/10.1186/s12885-024-12716-1.
- Wang Z, et al. Exosomes secreted by macrophages upon copper ion stimulation can promote angiogenesis. Mater Sci Eng C Mater Biol Appl. 2021;123:111981. https://doi.org/10.1016/j.msec.2021.111981.
- Zou M, Zhang W, Zhu Y, Xu Y. Identification of 6 cuproptosis-related genes for active ulcerative colitis with both diagnostic and therapeutic values. Medicine (Baltimore). 2023;102:e35503. https://doi.org/10.1097/MD.0000000000035503.
- Chen W, Miao J, Chen J, Chen J. Development of machine learning models for diagnostic biomarker identification and immune cell infiltration analysis in PCOS. J Ovarian Res. 2025;18:1. https://doi.org/10.1186/s13048-024-01582-8.
- Lv JH, et al. WGCNA combined with machine learning to find potential biomarkers of liver cancer. Medicine (Baltimore). 2023;102:e36536. https://doi.org/10.1097/MD.0000000000036536.
- Wu Q, Yang C, Huang C, Lin Z. Screening key genes for intracranial aneurysm rupture using LASSO regression and the SVM-RFE algorithm. Front Med. 2025;11:1487224. https://doi.org/10.3389/fmed.2024.1487224.
- Tang D, Pu B, Liu S, Li H. Identification of cuproptosis-associated subtypes and signature genes for diagnosis and risk prediction of ulcerative colitis based on machine learning. Front Immunol. 2023;14:1142215. https://doi.org/10.3389/fimmu.2023.1142215.
- Yang C, et al. Identification of cuproptosis hub genes contributing to the immune microenvironment in ulcerative colitis using bioinformatic analysis and experimental verification. Front Immunol. 2023;14:1113385. https://doi.org/10.3389/fimmu.2023.1113385.
- Yadav SK, et al. Fecal Lcn-2 level is a sensitive biological indicator for gut dysbiosis and intestinal inflammation in multiple sclerosis. Front Immunol. 2022;13:1015372. https://doi.org/10.3389/fimmu.2022.1015372.
- Luo Q, et al. Bioinformatics analysis reveals potential crosstalk genes and molecular mechanisms between ulcerative colitis and psoriasis. Arch Dermatol Res. 2024;317:118. https://doi.org/10.1007/s00403-024-02856-1.
- Nielsen OH, et al. Rectal dialysate and fecal concentrations of neutrophil gelatinase-associated lipocalin, interleukin-8, and tumor necrosis factor-alpha in ulcerative colitis. Am J Gastroenterol. 1999;94:2923–2928.
- Sun Y, et al. Natural polyphenol rutin inhibits ferroptosis in ulcerative colitis by regulating lipid metabolism via blocking the LCN2-ALOX15 axis. Food Funct. 2025;16:7169–7186.
- Sofia MA, et al. Tryptophan metabolism through the kynurenine pathway is associated with endoscopic inflammation in ulcerative colitis. Inflamm Bowel Dis. 2018;24:1471–1480.
- Shon WJ, et al. Severity of DSS-induced colitis is reduced in Ido1-deficient mice with down-regulation of TLR-MyD88-NF-kB transcriptional networks. Sci Rep. 2015;5:17305. https://doi.org/10.1038/srep17305.
- Zeng T, et al. Indoleamine 2, 3-dioxygenase 1 enhances hepatocytes ferroptosis in acute immune hepatitis associated with excess nitrative stress. Free Radic Biol Med. 2020;152:668–679.
- Pavlidis P, et al. Interleukin-22 regulates neutrophil recruitment in ulcerative colitis and is associated with resistance to ustekinumab therapy. Nat Commun. 2022;13:5820. https://doi.org/10.1038/s41467-022-33333-3.
- Urzua U, et al. The ovarian transcriptome of reproductively aged multiparous mice: Candidate genes for ovarian cancer protection. Biomolecules. 2020;10:113. https://doi.org/10.3390/biom10010113.
- Zahn A, et al. Transcript levels of different cytokines and chemokines correlate with clinical and endoscopic activity in ulcerative colitis. BMC Gastroenterol. 2009;9:13. https://doi.org/10.1186/1471-230X-9-13.
- Yi Q, et al. Application of genomic selection and experimental techniques to predict cell death and immunotherapeutic efficacy of ferroptosis-related CXCL2 in hepatocellular carcinoma. Front Oncol. 2022;12:998736. https://doi.org/10.3389/fonc.2022.998736.
- Kolios G, Valatas V, Ward SG. Nitric oxide in inflammatory bowel disease: A universal messenger in an unsolved puzzle. Immunology. 2004;113:427–437.
- Cheng F, et al. Identification of differential intestinal mucosa transcriptomic biomarkers for ulcerative colitis by bioinformatics analysis. Dis Markers. 2020;2020:8876565. https://doi.org/10.1155/2020/8876565.
- Tratensek A, et al. Oxidative stress-related biomarkers as promising indicators of inflammatory bowel disease activity: A systematic review and meta-analysis. Redox Biol. 2024;77:103380. https://doi.org/10.1016/j.redox.2024.103380.
- Zhang JL, et al. Jatrorrhizine alleviates ulcerative colitis via regulating gut microbiota and NOS2 expression. Gut Pathog. 2022;14:41. https://doi.org/10.1186/s13099-022-00516-7.
- Li H, et al. Development of a prognostic model based on ferroptosis-related genes for colorectal cancer patients and exploration of the biological functions of NOS2 in vivo and in vitro. Front Oncol. 2023;13:1133946. https://doi.org/10.3389/fonc.2023.1133946.
- Seibt TM, Proneth B, Conrad M. Role of GPX4 in ferroptosis and its pharmacological implication. Free Radic Biol Med. 2019;133:144–152.
- Holland T, Mattner J. Intestinal eosinophils: Characterization of elusive granulocytes as anti-bacterial and immunomodulatory effector cells in colitis. Signal Transduct Target Ther. 2023;8:321. https://doi.org/10.1038/s41392-023-01588-4.
- Nguyen J, et al. Overexpression of programmed death ligand 1 in refractory inflammatory bowel disease. Hum Pathol. 2022;126:19–27.
- Shen Z, et al. Exploration of a screening model for intrahepatic cholangiocarcinoma patients prone to cuproptosis and mechanisms of the susceptibility of CD274-knockdown intrahepatic cholangiocarcinoma cells to cuproptosis. Cancer Gene Ther. 2023;30:1663–1678.
- Niu Y, et al. Platelet activation stimulates macrophages to enhance ulcerative colitis through PF4/CXCR3 signaling. Int J Mol Med. 2025;55:78. https://doi.org/10.3892/ijmm.2025.5499.
- Qu F, et al. The role of macrophage polarization in ulcerative colitis and its treatment. Microb Pathog. 2025;199:107227. https://doi.org/10.1016/j.micpath.2025.107227.
- Danne C, Skerniskyte J, Marteyn B, Sokol H. Neutrophils: From IBD to the gut microbiota. Nat Rev Gastroenterol Hepatol. 2024;21:184–197.
- Zhao Q, et al. CD4+ T cell activation and concomitant mTOR metabolic inhibition can ablate microbiota-specific memory cells and prevent colitis. Sci Immunol. 2020;5:eabc6373. https://doi.org/10.1126/sciimmunol.abc6373.
- Chen E, et al. Inflamed ulcerative colitis regions associated with MRGPRX2-mediated mast cell degranulation and cell activation modules, defining a new therapeutic target. Gastroenterology. 2021;160:1709–1724.
- Xu H, Wu C, Wang D, Wang H. Alleviating effect of Nexrutine on mucosal inflammation in mice with ulcerative colitis: Involvement of the RELA suppression. Immun Inflamm Dis. 2024;12:e1147. https://doi.org/10.1002/iid3.1147.
- Luo Y, et al. Rab27A promotes cellular apoptosis and ROS production by regulating the miRNA-124-3p/STAT3/RelA signalling pathway in ulcerative colitis. J Cell Mol Med. 2020;24:11330–11342.
- Pace F, Watnick PI. The interplay of sex steroids, the immune response, and the intestinal microbiota. Trends Microbiol. 2021;29:849–859.
- Rodriguez J, Olivares M, Delzenne NM. Implication of the gut microbiota in metabolic inflammation associated with nutritional disorders and obesity. Mol Nutr Food Res. 2021;65:e1900481. https://doi.org/10.1002/mnfr.201900481.
- Ojha R, et al. Emerging role of circulating microRNA in the diagnosis of human infectious diseases. J Cell Physiol. 2019;234:1030–1043.
- Tian Y, et al. LncRNA CDKN2B-AS1 relieved inflammation of ulcerative colitis via sponging miR-16 and miR-195. Int Immunopharmacol. 2020;88:106970. https://doi.org/10.1016/j.intimp.2020.106970.
- Kulkarni N, Pathak M, Lal G. Role of chemokine receptors and intestinal epithelial cells in the mucosal inflammation and tolerance. J Leukoc Biol. 2017;101:377–394.
- Stadnyk AW. Intestinal epithelial cells as a source of inflammatory cytokines and chemokines. Can J Gastroenterol. 2002;16:241–246.
- Xu Y, Chen N. DUOX2-mediated innate immune hyperactivation drives macrophage M1 polarization via the APP-CD74 axis in inflammatory bowel disease. Presented at: 19th Congress of the European Crohn’s and Colitis Organisation (ECCO 2026); Stockholm, Sweden; 2026. https://academic.oup.com/ecco-jcc/article/20/Supplement_1/jjaf231.232/8432779.
- Shi CL, et al. Single-nucleus transcriptome unveils the role of ferroptosis in ischemic stroke. Heliyon. 2024;10:e32727. https://doi.org/10.1016/j.heliyon.2024.e32727.
- Tu H, et al. Integrated single-cell analysis with experimental validation reveals ANXA2 as a therapeutic target for ferroptosis in inflammatory bowel disease. Am J Transl Res. 2026;18:91–111.
- Yan C, et al. Exploring the anti-ferroptosis mechanism of Kai-Xin-San against Alzheimer's disease through integrating network pharmacology, bioinformatics, and experimental validation strategy in vivo and in vitro. J Ethnopharmacol. 2024;326:117915. https://doi.org/10.1016/j.jep.2024.117915.
- Shaik JP, Ahmad A. Pharmacological mechanism of cinnamic acid in the treatment of prostate cancer by network pharmacology. Archives of Medical Reports. 2024;1(2):1–6. https://doi.org/10.26524/amr.2024.2.1.
- Nimmagadda S, Patel S, MR Vishwathika. Targeting ferroptosis: A novel therapeutic avenue in osteoarthritis and bone degeneration. Archives of Medical Reports. 2025;2(5):6–9. https://doi.org/10.26524/amr.2025.5.2.
Acesso restrito. Inicie sessão ou comece um teste para visualizar este conteúdo.