Este protocolo integra desidentificação, normalização de terminologia, verificação de fonte e visualização reprodutível para gerar saídas agregadas auditáveis a partir de registros ambulatoriais reais de medicina tradicional chinesa.
Artigo de método
Mineração e Visualização Auditadas por Fontes de Registros de Casos Reais de Medicina Tradicional Chinesa Utilizando a Fórmula Hegan Jianpi
* These authors contributed equally
Neste artigo
Resumo
Resumo
Os registros ambulatoriais reais da medicina tradicional chinesa (MTC) contêm informações longitudinais sobre diagnósticos, elementos da síndrome, descrições de sintomas e prescrições individualizadas, mas seu formato semiestruturado complica a análise reprodutível. Este artigo apresenta um protocolo auditado por fonte para converter registros de casos desidentificados em tabelas agregadas rastreáveis e visualizações prontas para publicação. O fluxo de trabalho define critérios de elegibilidade e unidades de análise, preserva os mapeamentos entre a terminologia original e a normalizada, verifica todos os numeradores e denominadores relatados e regenera figuras a partir de tabelas fonte com controle de versão. Aplicado a registros de janeiro de 2015 a junho de 2024, o protocolo identificou 555 consultas com prescrições elegíveis de 396 pacientes. O conjunto final de dados continha 324 rótulos normalizados de ervas e 9.339 ocorrências de uso de ervas. O fluxo de trabalho gerou espectros paralelos de doenças da medicina ocidental e da MTC, um espectro explícito de elementos da síndrome e uma matriz de coocorrência, perfis de frequência de ervas e de matérias médicas, um espectro de sintomas derivado do histórico com 37 termos, 15 regras de associação direcionadas, agrupamento hierárquico e mapas de calor de uso de ervas estratificados por diagnóstico. Pelo menos uma palavra-chave pré-especificada do histórico foi detectada em 474 consultas (85,41%). Quando permitido pela política institucional, uma opção de inteligência artificial (IA) supervisionada por humanos pode auxiliar nas verificações terminológicas, na revisão da consistência entre arquivos e no alinhamento entre legendas e figuras. Qualquer uso de IA deve ser documentado em um registro de auditoria separado e não deve substituir a revisão dos dados fonte. Ao integrar governança, normalização, computação, interpretação clínica e saída visual em um único fluxo de trabalho reprodutível, o método transforma a documentação clínica dispersa em um recurso de pesquisa passível de revisão. O protocolo pode ser adaptado a outros conjuntos de dados de prática especializada, projetos multicêntricos de terminologia e plataformas de dados clínicos prospectivos.
Introdução
Os registros ambulatoriais de medicina tradicional chinesa (MTC) do mundo real preservam o raciocínio clínico longitudinal por meio de sintomas narrativos, sistemas diagnósticos paralelos, descrições de síndromes e prescrições individualizadas. Trabalhos iniciais de descoberta de conhecimento reconheceram os registros de casos como dados experimentais complexos que exigem métodos específicos de informática antes que seus padrões possam ser estudados de forma confiável1. Pesquisas subsequentes mostraram que expressões sinônimas de sintomas, entidades de granularidade fina e termos diagnósticos documentados localmente devem ser normalizados sem apagar a redação original2,3,4,5,6. Dados de prontuários eletrônicos de saúde (EHR) também podem apoiar pesquisas computacionais sobre prescrições e o uso de ferramentas analíticas reutilizáveis, desde que o contexto clínico e a linhagem dos dados permaneçam visíveis7,8. Referências autorizadas de materia médica são, portanto, necessárias para padronizar nomes de ervas, formas de processamento, propriedades, sabores e atribuições a meridianos9,10. No nível de relato, as diretrizes RECORD e STROBE exigem descrições transparentes das fontes de dados, critérios de elegibilidade, variáveis e decisões analíticas, enquanto os princípios FAIR enfatizam objetos de pesquisa rastreáveis e reutilizáveis11,12,13. Essas considerações são especialmente importantes quando os registros contêm visitas repetidas, campos ausentes, terminologias sobrepostas e texto livre. A avaliação de adequação ao uso deve abordar completude, conformidade, plausibilidade e concordância entre fontes14,15. A desidentificação de textos livres também exige procedimentos explícitos e revisão humana, pois métodos automatizados podem preservar conteúdo clínico útil enquanto deixam riscos residuais de privacidade16,17,18.
Uma vez estabelecidas a governança e a terminologia, a análise de frequência, a mineração de regras de associação e o agrupamento hierárquico podem fornecer visões complementares da estrutura das prescrições19,20,21. Métodos de mapeamento científico e de redes demonstram ainda como representações visuais coordenadas podem revelar relações que uma simples lista classificada não consegue captar22,23,24,25. Estudos recentes sobre artrite reumatoide com depressão, inibidores da quinase Janus na colite ulcerativa e artrite reumatoide com fibromialgia ilustram o valor de critérios de recuperação travados por versão, redes de coocorrência, agrupamento, interpretação temporal e declarações explícitas sobre limitações analíticas26,27,28. O presente estudo adapta esses princípios de design transferíveis à mineração de registros clínicos, em vez da bibliometria da literatura. Nos registros de origem, a Fórmula Hegan Jianpi refere-se a uma fórmula baseada na experiência associada à prática do Professor Nai-li Yao29,30. Publicações relacionadas descrevem sua abordagem clínica mais ampla de harmonização fígado-baço e baço-estômago29,30. Neste artigo metodológico, o nome da fórmula identifica apenas o contexto do registro de origem e não estabelece uma composição fixa, dose, indicação terapêutica ou afirmação de eficácia. O fluxo de trabalho computacional utiliza regras determinísticas e métodos estatísticos de propósito geral. A prática computacional reprodutível exige ainda a preservação das entradas, a documentação dos parâmetros, as transformações por meio de scripts e saídas passíveis de revisão31,32. Uma opção de inteligência artificial (IA) supervisionada por humanos pode auxiliar nas verificações terminológicas, nas revisões de consistência entre arquivos e no controle visual de qualidade, desde que seu uso seja documentado. A expertise clínica, as salvaguardas de privacidade e a tomada de decisões humanas responsáveis devem permanecer primordiais (Tabela Suplementar 1)33,34. O objetivo geral deste método é converter registros de casos de MTC desidentificados em uma cadeia auditada por fonte de saídas estratificadas por doença, síndrome, sintoma, uso de ervas, associações, agrupamentos e diagnósticos. O exemplo prático utiliza 555 consultas elegíveis de 396 pacientes para demonstrar como governança, normalização, computação, interpretação clínica e divulgação visual podem ser integradas sem revelar registros individuais de pacientes, detalhes exatos da formulação, proporções de doses ou instruções prescritivas.
Protocolo
Esta análise retrospectiva de registros clínicos com identificação removida foi revisada e aprovada pelo Comitê de Ética Médica do Hospital Guang'anmen, Academia de Ciências Médicas Chinesas da China (número de aprovação 2026-108-KY; 13 de julho de 2026). O Comitê isentou o requisito de consentimento informado.
1. Estabelecer ética, governança e segurança de dados
- Designe um custo de dados, analista de dados fonte, revisor de terminologia clínica, revisor quantitativo e investigador autorizado a aprovar a liberação de dados agregados. Registre cada função no registro do projeto.
- Elabore um plano de gerenciamento de dados especificando o sistema fonte permitido, período do estudo, campos, local de armazenamento, permissões de acesso, procedimento de backup, período de retenção e restrições da chave de vinculação.
- Exporte apenas as variáveis mínimas necessárias para a análise pré-especificada. Inclua um identificador local do paciente, data da consulta, idade ou data de nascimento quando permitido, sexo, diagnóstico ocidental, nome da doença em MC, texto do histórico desidentificado, descrição da língua, descrição do pulso, descrição da síndrome e campos de prescrição de ervas.
- Remova nomes, números de identificação nacional, números de telefone, endereços detalhados, identificadores de seguro, informações de contato e outros identificadores diretos dentro do ambiente institucional controlado. Substitua cada número de prontuário por um identificador de paciente específico do projeto.
- Analise campos de texto livre em busca de identificadores residuais e oculte cada item detectado. Armazene qualquer chave de vinculação separadamente do conjunto de dados analítico e exclua-a das pastas de trabalho, colaboração e submissão.
- Mantenha a exportação inicial desidentificada como uma cópia de segurança somente leitura. Registre seu nome de arquivo, data de criação, quantidade de linhas, quantidade de colunas, tamanho do arquivo e checksum em um manifesto de fonte.
- Crie diretórios separados para arquivos fonte, arquivos de trabalho, dicionários, tabelas agregadas, figuras, scripts e registros de auditoria.
- Restrinja os materiais liberados ou compartilhados a tabelas agregadas, dicionários desidentificados aprovados, scripts e figuras de publicação. Não faça upload de registros identificáveis ou potencialmente reidentificáveis para sistemas públicos de IA generativa, serviços em nuvem não aprovados ou repositórios públicos.
NOTA: Quando a política institucional permitir assistência de IA com supervisão humana, forneça apenas trechos de texto desidentificados ou tabelas agregadas. Registre na trilha de auditoria a finalidade, a saída revisada, a correção aceita, o revisor e a data.
2. Defina a regra de identificação de registro e as unidades de análise
- Defina a instituição, o ambiente ambulatorial, a equipe clínica responsável, o sistema de prontuário eletrônico e o período de origem antes da triagem. Para o exemplo trabalhado, utilize registros datados de janeiro de 2015 a junho de 2024.
- Armazene a regra de identificação da coorte em um arquivo restrito e com controle de versão antes de examinar os resultados analíticos. Registre as variantes terminológicas aceitas e todas as condições de inclusão e exclusão, sem divulgar detalhes confidenciais da formulação no manuscrito.
- Aplique a regra de identificação de registros com versão fixa no nível da prescrição-consulta após a normalização dos nomes das ervas. Finalize os arquivos de origem, dicionários, regra da coorte e parâmetros de análise como um conjunto único de liberação.
- Crie uma nova versão e regenere todas as saídas dependentes sempre que um componente com versão fixa for alterado. Não modifique a regra de identificação da coorte após examinar distribuições de doenças, frequências de ervas, regras de associação ou agrupamentos.
- Inclua uma consulta ambulatorial quando ela ocorrer dentro do período de estudo com versão fixa, corresponder a um identificador válido de paciente do projeto, contiver um registro de prescrição interpretável e satisfizer a regra restrita de identificação de registros.
- Exclua exportações exatamente duplicadas, registros fora do período de estudo, registros sem prescrição interpretável e linhas que não atendam à regra de identificação com versão fixa. Atribua um motivo primário de exclusão a cada linha excluída.
- Distinga exportações repetidas de consultas de acompanhamento genuínas. Remova apenas duplicatas exatas do sistema ou da exportação e mantenha as consultas repetidas genuínas.
- Atribua identificadores estáveis para pacientes e consultas com prescrição. Crie um manifesto da coorte contendo a versão da fonte, a versão da regra, o status de triagem, o motivo de inclusão ou exclusão, o identificador do paciente, o identificador da consulta e o status do revisor.
- Utilize um único registro por paciente para resumos fixos de dados demográficos, incluindo idade e sexo. Utilize a consulta com prescrição como unidade de análise para doenças, síndromes, palavras-chave de histórico, língua, pulso, ervas, regras de associação e análises de agrupamento.
- Se pare a elegibilidade da coorte da disponibilidade de variáveis. Mantenha uma consulta elegível em outros aspectos quando um campo específico da variável estiver ausente e informe o denominador avaliável para cada análise.
- Congele o manifesto da coorte antes da análise descritiva. Registre o número de consultas com prescrição elegíveis e de pacientes únicos, e regenere todas as saídas dependentes se uma decisão de elegibilidade for alterada.
3. Normalizar a terminologia e preservar o histórico de auditoria
- Crie dicionários separados com controle de versão para ervas, diagnósticos ocidentais, nomes de doenças da MTC, elementos da síndrome, palavras-chave do histórico, termos da língua, termos do pulso e atributos da matéria médica.
- Inclua em cada dicionário o termo original, o termo normalizado, a categoria do termo, o campo de origem, a regra, a fonte de referência, a versão do dicionário, o revisor, a data da revisão e comentários. Mantenha todos os termos originais após a normalização.
- Normalize os nomes dos materiais medicinais chineses (CMM) utilizando referências autorizadas de nomenclatura9,10. Corrija variantes tipográficas e abreviações do sistema, preservando as formas de processamento clinicamente significativas.
- Mantenha os qualificadores de processamento, incluindo refogado, processado com vinagre, refogado com mel, processado com gengibre, processado com vinho, carbonizado e cru, como rótulos separados.
- Mantenha ervas ortográfica ou clinicamente distintas separadas. Não una Bai Shao com Bai Zhu nem infira uma erva a partir de uma abreviação ambígua sem revisão da fonte.
- Preserve a dose original e a unidade em campos separados, quando disponíveis. Remova o texto da dose apenas ao construir variáveis de presença de ervas por consulta.
- Não interprete a frequência de ocorrência como dose cumulativa ou intensidade do tratamento.
- Normalize os nomes de doenças ocidentais e da MTC independentemente. Preserve o sistema diagnóstico e o status de diagnóstico principal, e não traduza um rótulo de doença da MTC em um diagnóstico ocidental, a menos que ambos estejam explicitamente registrados.
- Defina um rótulo de doença da MTC transliterado no primeiro uso, quando necessário para orientação do leitor. Mantenha o rótulo original da fonte.
- Divida textos explícitos de síndrome com múltiplos valores usando delimitadores travados por versão e mapeie expressões da fonte para elementos de síndrome normalizados. Elimine duplicatas de cada elemento normalizado dentro de uma consulta.
- Mantenha o texto explícito da síndrome separado das colunas de indicadores herdadas ou derivadas de escores.
- Preserve os campos originais da língua, pulso, sintomas estruturados e histórico desidentificado como produtos de dados separados. Não trate a correspondência de uma palavra-chave do histórico como equivalente a um sintoma estruturado inserido pelo clínico.
- Solicite que um revisor proponha cada mapeamento ambíguo ou de muitos para um, e que um segundo revisor clínico o verifique. Exclua mapeamentos incertos das análises divulgadas até que a revisão da fonte os resolva.
- Verifique a presença de rótulos normalizados em branco, mapeamentos de um para muitos, mapeamentos de muitos para um, entradas duplicadas no dicionário, termos não revisados e perda acidental de rótulos de processamento. Congele as versões dos dicionários antes de gerar tabelas agregadas.
4. Verificar os campos de origem e bloquear as saídas relatáveis
- Crie um registro de evidências com uma linha para cada alegação do manuscrito, tabela e painel de figura. Registre a unidade de análise, campo de origem, versão de origem, versão do dicionário, versão do script, numerador, denominador, arquivo de saída, revisor e redação aprovada.
- Recalcule diretamente a partir dos arquivos com versão fixada as contagens de visitas elegíveis e de pacientes únicos, resumos demográficos, contagens de doenças, contagens explícitas de síndromes, contagens de palavras-chave no histórico, frequências de ervas mescladas e totais de uso de ervas.
- Compare cada valor recalculado com o valor correspondente no manuscrito, planilha ou figura. Corrija o manuscrito e regenere as saídas dependentes sempre que uma discrepância for confirmada.
- Resolva cada discrepância no nível do campo de origem. Registre o motivo, correção, revisor e data no registro de evidências antes de liberar o resultado afetado.
- Verifique se cada tabela agregada contém o rótulo normalizado, numerador, denominador, definição de porcentagem, unidade de análise e identificador de origem necessários para reproduzir a afirmação correspondente.
- Verifique o denominador usado para cada porcentagem. Utilize pacientes únicos para características demográficas fixas e visitas de prescrição para variáveis clínicas e prescritivas dinâmicas.
- Compare rótulos, valores, ordenação e definições dos painéis das figuras com suas tabelas agregadas com versão fixada. Regenere cada figura após uma correção na tabela, em vez de editar manualmente os valores plotados.
- Solicite a um revisor clínico que verifique os mapeamentos de terminologia. Solicite a um revisor quantitativo que verifique contagens, taxas, métricas de regras e denominadores de mapas de calor.
- Trave o registro de evidências, as tabelas agregadas e as fontes das figuras sob um único identificador de versão antes da montagem do manuscrito.
5. Gerar espectros descritivos e saídas de coocorrência
- Gere resumos por paciente com dados de idade e sexo a partir de uma linha por paciente único. Mantenha e informe explicitamente as categorias desconhecidas.
- Gere espectros de doenças da medicina ocidental e da medicina tradicional chinesa separadamente, no nível de prescrição-consulta. Preserve o sistema diagnóstico original e calcule os principais rótulos normalizados usando um denominador comum de consultas.
- Gere o espectro de elementos da síndrome a partir do campo de texto de síndrome normalizado explícito. Separe os termos usando delimitadores fixos por versão, elimine duplicatas de cada termo dentro de uma consulta e calcule as frequências por consulta.
- Construa a matriz de coocorrência de síndromes a partir dos mesmos conjuntos de tokens dentro da mesma consulta. Codifique o tamanho do nó pela frequência de consultas e a largura da aresta ou intensidade do mapa de calor pelo número de coocorrência par a par.
- Prespecifique um dicionário exato de palavras-chave de histórico quando as informações de sintomas forem principalmente narrativas. Analise apenas o campo de histórico desidentificado e conte cada conceito não mais que uma vez por consulta.
- Calcule a proporção de consultas elegíveis que contenham pelo menos uma palavra-chave de histórico e ordene todas as contagens de palavras-chave. Exporte a tabela completa e o subconjunto plotado.
- Gere frequências de ervas combinadas a partir de dados de prescrição normalizados. Conte cada rótulo de erva normalizado não mais que uma vez por consulta e mantenha as formas de processamento clinicamente relevantes como rótulos separados.
- Gere perfis de Quatro-Qi, cinco sabores e tropismo meridiano a partir do dicionário de matéria médica com versão fixa. Trate o Quatro-Qi como uma categoria de valor único para cada ocorrência de erva codificada por propriedade.
- Trate cinco sabores e tropismo meridiano como atributos multirrótulo. Indique o denominador codificado por propriedade e mantenha a unidade de análise separada.
- Exporte uma tabela agregada legível por máquina para cada domínio descritivo antes de gerar as figuras finais.
6. Realize análises de regras de associação e agrupamento hierárquico
- Construa uma matriz binária de prescrição-visita-por-erva a partir da tabela de prescrição normalizada com versão fixa. Utilize uma linha para cada visita elegível e uma coluna para cada rótulo normalizado de erva.
- Calcule o suporte, confiança e elevação para regras de associação direcionadas de uma única erva19. Mantenha a direção de cada regra, pois a confiança depende do antecedente.
- Aplique os limiares pré-especificados de suporte ≥ 0,30, confiança ≥ 0,70 e elevação > 1,0. Exporte cada regra mantida com sua contagem de coocorrência e as três métricas.
- Represente graficamente o conjunto completo de regras mantidas como uma rede bipartida direcionada de regras e um perfil ordenado de força de regras. Codifique a largura da aresta da rede pelo suporte e a cor da aresta pela elevação.
- Codifique o tamanho do ponto pelo suporte e anote a confiança no perfil ordenado.
- Verifique se ambas as representações de regras contêm o mesmo conjunto de regras mantidas e preservam a direção das regras. Compare cada discrepância com a tabela de regras exportada antes da liberação.
- Selecione as 20 variáveis de presença de ervas com maior frequência para agrupamento hierárquico. Calcule as distâncias de Jaccard par a par e aplique ligação média.
- Rotule o dendrograma com os nomes normalizados das ervas. Interprete a proximidade dos ramos apenas como similaridade nos padrões de ocorrência por visita.
- Exporte a especificação da matriz binária, tabela de regras, lista de arestas da rede, ordem de entrada para agrupamento, matriz de distâncias e matriz de ligação antes da geração das figuras.
- Solicite a um revisor quantitativo que recalcule manualmente uma das métricas de regra. Compare cada aresta da rede com a tabela de regras.
- Reexecute todo o fluxo de trabalho de regras e agrupamento sempre que houver alteração na coorte, no dicionário de terminologia ou na matriz de presença de ervas.
- Para o exemplo demonstrado, realize uma análise de sensibilidade determinística de uma visita por paciente, mantendo o registro de ordem cronológica mais antigo para cada paciente. Compare as 12 regras resultantes com as 15 regras da análise por visita.
- Relate a alteração como um resultado descritivo de robustez, e não como validação em nível de paciente. Utilize o recálculo determinístico fornecido no Arquivo Suplementar 1.
7. Gerar padrões estratificados por diagnóstico e o quadro interpretativo clínico
- Selecione estratos principais de diagnóstico ocidental clinicamente relevantes antes de inspecionar as distribuições de ervas específicas por diagnóstico.
- Conte cada rótulo normalizado de erva no máximo uma vez por consulta dentro de cada estrato de diagnóstico. Calcule a prevalência como o número de consultas contendo o rótulo dividido pelo número total de consultas elegíveis naquele estrato.
- Utilize o mesmo conjunto de ervas exibido e uma escala de cores fixa de 0%–100% entre os estratos de diagnóstico. Apresente os valores das células para preservar a interpretação exata.
- Relate o numerador e o denominador de cada célula exibida em uma tabela agregada independente.
- Construa um painel separado de interpretação clínica após concluir o mapa de calor descritivo. Mantenha os resultados calculados e a interpretação especializada visualmente distintos.
- Preencha a camada de indicadores apenas com termos rastreáveis à tabela de palavras-chave históricas com versão fixa ou ao texto explícito de síndrome normalizada.
- Solicite que dois revisores clínicos concordem com interpretações contextuais concisas dos indicadores selecionados. Registre os revisores e a redação final no registro de evidências.
- Vincule cada interpretação contextual a um uso em pesquisa, como seleção de variáveis, validação prospectiva ou geração de hipóteses.
- Utilize conectores tracejados e não direcionais para a camada de interpretação. Omita conteúdo sobre dose, composição fixa e recomendações de tratamento.
- Revise conjuntamente o mapa de calor e o painel de interpretação. Assegure-se de que a prevalência calculada, o contexto especializado e o uso futuro em pesquisa permaneçam claramente separados.
8. Montar e verificar o pacote de reprodutibilidade
- Exporte o manifesto-fonte, o manifesto do coorte, as versões do dicionário, o registro de evidências, os scripts de análise, as tabelas agregadas, as fontes das figuras e as figuras finais para diretórios separados.
- Nomeie cada arquivo usando um número estável da figura ou tabela e a data da versão. Mantenha uma versão atual autoritativa e arquive as saídas substituídas separadamente.
- Gere cada figura como um único arquivo de imagem com múltiplos painéis. Exporte um PDF de alta resolução e um PNG de 300 dpi para revisão.
- Coloque as legendas das figuras no manuscrito e mantenha-as fora dos arquivos de imagem. Descreva cada painel, unidade de análise, denominador e codificação visual.
- Prepare um arquivo XLSX independente para cada tabela.
- Solicite a um revisor independente que compare os números do manuscrito com as tabelas agregadas e as porcentagens com seus respectivos numeradores e denominadores.
- Compare as bordas das regras com a tabela de regras e as células do mapa de calor com a matriz-fonte.
- Execute verificações automatizadas para consistência de nomes de arquivos, seções obrigatórias, dimensões das figuras, contagem de tabelas, contagem de referências, resíduos de modelo e termos restritos.
- Solicite à equipe de autores clínicos que revise a terminologia, a interpretação, os limites de propriedade intelectual, os dados dos autores, a ordem de financiamento, a redação ética e o conjunto final de figuras.
- Remova do pacote de submissão arquivos em nível de paciente, chaves de vinculação, textos livres irrestritos, correspondências internas e artefatos temporários de revisão.
- Congele o pacote liberado e registre sua versão, data, soma de verificação (checksum), versão do manuscrito e status de aprovação pelos autores. Crie uma nova versão e um registro de alterações para cada correção subsequente.
Resultados
A aplicação bem-sucedida do protocolo produziu uma cadeia rastreável conectando o instantâneo de origem com identificação removida, o manifesto da coorte, os dicionários de terminologia, as tabelas agregadas, os scripts e as figuras finais. O procedimento de triagem com versão fixa identificou 555 visitas com prescrição elegíveis de 396 pacientes únicos. Figura 1 resume as três etapas coordenadas do método: governança, normalização da terminologia e análise com revisão clínica. A documentação correspondente de transparência e auditoria, incluindo o limite restrito a dados agregados para revisão assistida por IA, está fornecida em Tabela Suplementar 1.
A coorte final compreendeu 555 consultas com prescrição elegíveis, realizadas por 396 pacientes únicos (Figura 2 e Tabela 1). Visitas verdadeiramente repetidas foram mantidas para variáveis clínicas e prescritivas dinâmicas, enquanto idade e sexo foram resumidos após a deduplicação por paciente. A idade dos pacientes variou de 13 a 94 anos, com média de 47,11 anos e desvio padrão de 14,88 anos. A coorte incluiu 228 pacientes do sexo feminino (57,58%), 167 pacientes do sexo masculino (42,17%) e 1 paciente com sexo desconhecido (0,25%). Essa separação das unidades de análise preservou os encontros longitudinais sem inflar o denominador demográfico.
Os espectros de doenças ocidentais e da MTC são resumidos na Figura 3. Os diagnósticos ocidentais concentraram-se em distúrbios gastrointestinais, hepatobiliares e pancreáticos. O agrupamento hierárquico atribuiu 271 consultas a distúrbios gastrointestinais, 222 a distúrbios hepatobiliares ou pancreáticos e 62 a outros sistemas (Figura 3A). Os principais diagnósticos individuais foram gastrite crônica em 133 consultas (23,96%), fígado gorduroso em 77 consultas (13,87%) e cirrose hepática em 46 consultas (8,29%), seguidos por gastrite atrófica crônica, dor abdominal, hepatite B crônica, dispepsia, esofagite de refluxo, gastrite superficial crônica e pancreatite crônica (Figura 3C e Tabela 2).
O espectro correspondente de nomes de doenças da MTC organizou as mesmas visitas de acordo com um sistema diagnóstico paralelo. Nomes de doenças do baço-estômago ou intestinais corresponderam a 280 visitas, nomes de doenças do fígado-vésicula biliar a 223, distúrbios de qi-sangue-fluidos a 26, distúrbios da mente-peito-cabeça a 12, distúrbios dos canais ou membros a 5, distúrbios ginecológicos a 4 e outras categorias a 5 visitas (Figura 3B). Wei pi, um rótulo diagnóstico mantido da MTC para plenitude ou desconforto epigástrico, foi registrado em 163 visitas (29,37%). Ji disease (um rótulo original da MTC do tipo acúmulo), Gan zhuo (literalmente, fixação do fígado; um rótulo clássico mantido da MTC), Bi disease (doença de obstrução) e Xiao ke (emaciação-sede) foram mantidos como rótulos originais da MTC e não foram convertidos em diagnósticos biomédicos modernos. Gan pi, um rótulo diagnóstico da MTC utilizado no consenso chinês contemporâneo para distúrbios de fígado gorduroso, foi registrado em 77 visitas (13,87%)35. Os campos diagnósticos ocidentais e da MTC permaneceram independentes e não foram substituídos um pelo outro (Figura 3D e Tabela 3). Xie xie (fezes moles ou aquosas) e Fu xie (diarreia) eram rótulos diagnósticos originais distintos da MTC, registrados 6 e 2 vezes, respectivamente, e nenhum foi equiparado a um diagnóstico biomédico moderno. A exibição paralela dos dois espectros preservou a lógica de cada sistema diagnóstico, ao mesmo tempo em que demonstrou a amplitude clínica dos registros originais.
O campo de texto de síndrome normalizado explícito continha 555 linhas de visitas elegíveis. Após a deduplicação dentro da visita, os elementos principais foram baço em 362 visitas (65,23%), fígado em 304 (54,77%), deficiência de qi em 295 (53,15%), estômago em 171 (30,81%), umidade em 151 (27,21%) e estagnação de qi em 109 (19,64%; Figura 4A e Tabela 4). Calor, retenção de água, sangue, estase sanguínea, canais, rim, coração e deficiência de yin compuseram o restante do espectro exibido. As porcentagens não eram exclusivas, pois múltiplos elementos de síndrome podiam ocorrer durante uma única visita.
A rede e a matriz de contagem foram geradas a partir dos mesmos conjuntos de tokens ao nível da visita (Figura 4B,C). A co-ocorrência frequente concentrou-se em baço, fígado e deficiência de qi, com conexões adicionais ao estômago, umidade, estagnação de qi, calor e retenção de água. O uso de uma única matriz com versão fixa para o gráfico de frequência, rede e mapa de calor garantiu que os três painéis representassem a mesma evidência subjacente em diferentes níveis de detalhe. A auditoria recuperada identificou 0 correspondências exatas entre síndrome-texto/indicador entre 555 linhas e uma média de similaridade de Jaccard texto-indicador de 0,1806. As colunas de indicadores foram, portanto, excluídas da apresentação substantiva. Os materiais mantidos não continham vetores de distribuição reconstrutíveis anteriores à limpeza; consequentemente, a estabilidade distribucional entre versões não foi estimada. A análise de sensibilidade de uma visita por paciente abordou, em vez disso, o efeito de visitas repetidas. Os resultados da auditoria da fonte e da qualidade dos dados são resumidos na Tabela Suplementar 2.
Após a normalização da terminologia e a retenção das formas de processamento clinicamente significativas, as 555 visitas continham 324 rótulos distintos de ervas mesclados e 9.339 ocorrências de uso de ervas. Bai Shao foi registrado em 531 visitas (95,68%), seguido por Fu Ling em 520 (93,69%), Dang Gui em 510 (91,89%), Chi Shao em 467 (84,14%) e Bai Zhu refogado em 361 (65,05%; Figura 5A e Tabela 5). A curva de frequência por classificação dos 36 principais rótulos mostrou um segmento íngreme e de alta frequência seguido por uma cauda progressivamente mais ampla (Figura 5B), fornecendo uma representação compacta dos componentes de base comum e de prescrições individualizadas. Os mapeamentos de origem para normalizado, os qualificadores de processamento, os nomes padrão de MTC, as espécies de origem e os limites de evidência subjacentes à nomenclatura das ervas estão documentados no Suplemento Tabela 3.
O dicionário auxiliar de materia medica continha 9.115 ocorrências de uso de ervas com propriedades codificadas. As principais categorias de Quatro Qi foram quente (2.588, 28,39%), ligeiramente fria (2.339, 25,66%), neutra (2.330, 25,56%) e fria (1.221, 13,40%; Figura 5C). Após a normalização da terminologia de sabor das fontes dos compostos, as cinco principais categorias de sabor foram amargo (4.488, 49,24%), doce (4.377, 48,02%) e picante (2.893, 31,74%) (Figura 5D). A codificação de tropismo meridiano foi liderada por baço (5.541, 60,79%), fígado (4.801, 52,67%), pulmão (3.358, 36,84%), estômago (2.988, 32,78%) e coração (2.702, 29,64%; Figura 5E). Figura 5F registra as unidades distintas de análise por nível de visita e com propriedades codificadas, bem como seu vínculo de reprodutibilidade. Juntos, esses painéis demonstram como a frequência de prescrição e os descritores padronizados de materia medica podem ser resumidos sem colapsar a terminologia específica de processamento.
O dicionário de histórico predefinido continha 37 conceitos exatos de sintomas. Pelo menos um conceito foi detectado em 474 das 555 visitas elegíveis (85,41%). Os termos principais foram garganta seca em 178 visitas (32,07%), fadiga em 151 (27,21%), sono ruim em 139 (25,05%), distensão abdominal em 115 (20,72%), refluxo ácido em 100 (18,02%), gosto amargo em 99 (17,84%), azia em 90 (16,22%), soluço em 87 (15,68%), arroto em 87 (15,68%) e fezes moles em 77 (13,87%; Figura 6A,B e Tabela 6).
A curva completa de frequência por posto exibiu a distribuição total de 37 termos, enquanto a linha cumulativa resumiu a concentração de todas as detecções de palavras-chave ao longo dos postos (Figura 6C). Figura 6D registra a sequência reproduzível utilizada para gerar o espectro: bloquear o dicionário, analisar o texto histórico desidentificado, deduplicar conceitos dentro de cada visita e exportar contagens e taxas agregadas.
A mineração de regras de associação utilizou a matriz de presença de prescrição-visita-por-erva com 555 linhas e versão fixa. Quinze regras direcionadas de uma única erva atenderam aos critérios de suporte ≥ 0,30, confiança ≥ 0,70 e lift > 1,0 (Figura 7A,B e Tabela 7). Os valores de suporte mantidos variaram de 0,3009 a 0,7892, os valores de confiança de 0,7302 a 0,9748 e os valores de lift de 1,0010 a 1,1226.
O par direcionado mais frequentemente co-registrado foi Chi Shao > Fu Ling, com base em 438 visitas, com suporte de 0,7892, confiança de 0,9379 e elevação (lift) de 1,0010. A regra inversa apresentou o mesmo suporte e uma confiança de 0,8423, demonstrando por que a direção da regra deve ser mantida. A sensibilidade ao limiar manteve 18, 11, 21, 14, 7 e 4 regras sob suporte ≥ 0,25 ou ≥ 0,35, confiança ≥ 0,65 ou ≥ 0,75, ou elevação > 1,02 ou > 1,05, respectivamente. Na análise de uma visita por paciente, o mesmo par ocorreu em 316 visitas, com suporte de 0,7980, confiança de 0,9489 e elevação de 0,9994; portanto, não foi mantido sob o critério de elevação > 1,0. Os resultados das perturbações de limiar e da sensibilidade a visitas repetidas estão apresentados na Supplementary Table 4, e o recálculo determinístico está disponível no Supplementary File 1. Assim, um alto suporte no nível de visita não deve ser interpretado como validação no nível do paciente.
Os maiores valores de lift foram observados para Gan Cao > Bai Zhu refogado (1,1226) e Gan Cao > Chi Shao (1.1200). Figura 7A integra todas as 15 regras retidas em uma rede bipartida direcionada, com a largura das arestas representando o suporte e a cor das arestas representando o lift. Figura 7B ordena as mesmas regras por elevação, dimensiona cada ponto pelo suporte e anota a confiança. Assim, os dois painéis distinguem a topologia da rede da intensidade quantitativa das regras, em vez de duplicar a mesma representação visual.
A clusterização hierárquica das 20 variáveis de ervas com maior frequência utilizou a distância de Jaccard e ligação média (Figura 7C). O dendrograma fornece uma representação global da similaridade nos padrões de presença em nível de visita, complementando as informações direcionais locais fornecidas pelas regras de associação. Juntos, os painéis demonstram como diferentes perspectivas analíticas complementares podem ser alinhadas a uma única matriz binária com versão fixa.
A prevalência estratificada por diagnóstico foi calculada para fígado gorduroso (77 visitas), cirrose hepática (46 visitas) e gastrite crônica (133 visitas; Figura 8A e Tabela 8). Bai Shao, Fu Ling e Dang Gui apresentaram alta prevalência nos três estratos. Nas visitas por cirrose hepática, observou-se documentação proeminente de Dan Shen (95,65%), E Zhu processado com vinagre (86,96%), Bie Jia processado com vinagre (84,78%) e Sheng Huang Qi (60,87%). Nas visitas por fígado gorduroso, houve maior prevalência de Yin Chen (41,56%) e Ze Xie (31,17%) em comparação com os outros estratos, enquanto nas visitas por gastrite crônica foram frequentes Huang Lian (44,36%), Mu Xiang (34,59%) e Chai Hu (36,09%). Assim, o mapa de calor fornece uma comparação descritiva compacta dos padrões agregados de prescrição nos principais contextos clínicos.
Figura 8B separa o cálculo da interpretação. As pistas históricas verificadas são associadas a contextos especializados concisos e, em seguida, a usos de pesquisa, incluindo a contextualização de elementos da síndrome, a comparação de padrões estratificados por diagnóstico, a seleção de variáveis para validação prospectiva e a geração de perguntas complementares. Este painel final demonstra como a experiência clínica pode enriquecer a saída analítica, mantendo-se claramente distinta da prevalência calculada.
Figura 8C resume a reprodutibilidade e os limites de liberação, distinguindo componentes verificados pela fonte ou reanalisados de elementos que exigem cautela ou confirmação adicional. Esta camada final de auditoria impede que produtos analíticos não resolvidos ou não reconstrutíveis sejam apresentados como saídas validadas.
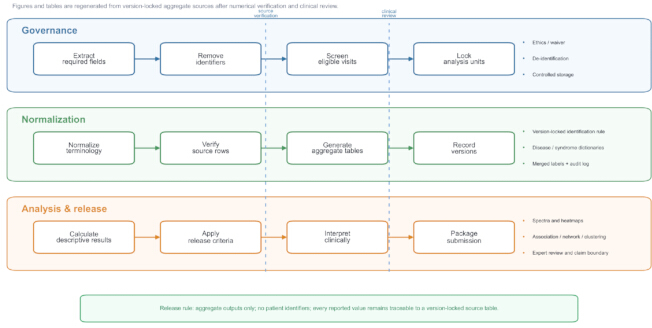
Figura 1: Fluxo de trabalho de mineração de registros de casos auditados pela fonte. A governança, a normalização de terminologia, a análise agregada, a revisão clínica e o empacotamento para liberação são apresentadas como etapas sequenciais do fluxo de trabalho. Faixas azuis, verdes e laranjas distinguem os domínios do fluxo de trabalho, e linhas verticais tracejadas indicam portas de auditoria. As setas indicam a sequência do fluxo de trabalho e não implicam causalidade biológica. A regra de liberação especifica que apenas saídas agregadas são liberadas, identificadores de pacientes são excluídos e cada valor relatado permanece rastreável até uma tabela fonte com versão fixa. Nenhuma barra de erro é aplicável. Clique aqui para visualizar uma versão maior desta figura.
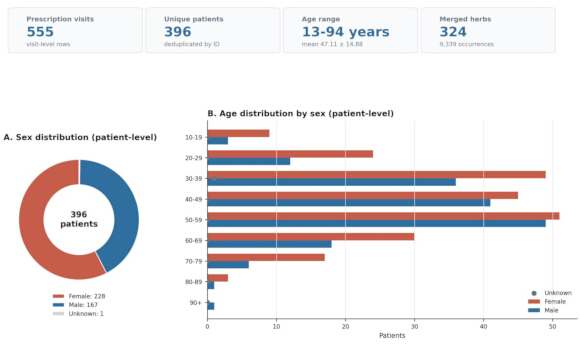
Figura 2: Perfil do conjunto de dados e dados demográficos por paciente. As caixas de resumo indicam 555 visitas com prescrição, 396 pacientes únicos, uma faixa etária por paciente de 13 a 94 anos com idade média de 47,11 ± 14,88 anos e 324 rótulos de ervas mesclados representando 9.339 ocorrências de uso de ervas. (A) Distribuição por sexo por paciente entre 396 pacientes únicos, incluindo as categorias feminino, masculino e desconhecido. (B) Distribuição por idade por sexo entre os mesmos 396 pacientes. As caixas de resumo utilizam os denominadores por visita ou por paciente exibidos, conforme aplicável. As cores distinguem as categorias de sexo e os elementos de resumo e não possuem significado inferencial. Clique aqui para visualizar uma versão maior desta figura.
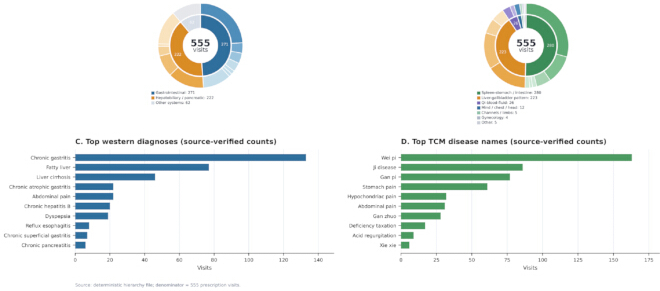
Figura 3: Espectros de doenças recuperados a partir de consultas com prescrição. (A) Grupos hierárquicos de doenças ocidentais e (B) grupos hierárquicos de doenças da MTC derivados de 555 consultas elegíveis com prescrição. (C) Principais diagnósticos ocidentais normalizados e (D) principais nomes normalizados de doenças da MTC a partir do mesmo denominador por consulta. Segmentos anulares e barras representam contagens de consultas; as cores distinguem os sistemas ou categorias diagnósticas e não representam efeitos terapêuticos. Os rótulos originais da MTC mantidos são definidos na Tabela 3: Wei pi (plenitude ou desconforto epigástrico), Ji disease (rótulo original da MTC do tipo acúmulo), Gan pi (um rótulo de doença da MTC usado para distúrbios de fígado gorduroso), Gan zhuo (literalmente, fixidez hepática; um rótulo clássico da MTC mantido), Bi disease (doença de obstrução), Xiao ke (emaciação com sede), Xie xie (fezes moles ou aquosas) e Fu xie (diarreia). Essas explicações não convertem os rótulos originais em diagnósticos biomédicos modernos. Clique aqui para visualizar uma versão maior desta figura.
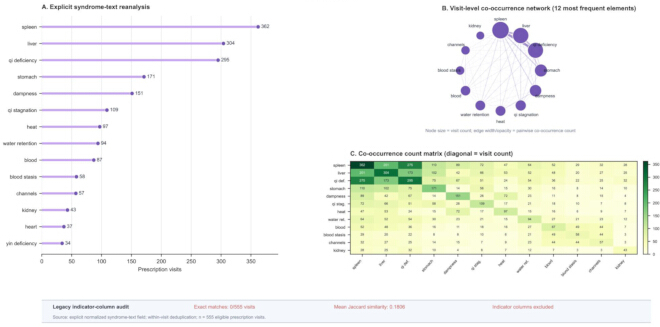
Figura 4: Espectro explícito de síndrome-texto e estrutura de coocorrência. (A) Frequências por consulta de 14 elementos de síndrome normalizados após deduplicação dentro da consulta, utilizando 555 consultas de prescrição elegíveis como denominador. (B) Rede de coocorrência dos 12 elementos de síndrome mais frequentes; o tamanho dos nós representa a frequência por consulta, e a largura e opacidade das arestas representam as contagens de coocorrência par a par. (C) Matriz simétrica correspondente de contagens de coocorrência; as células diagonais representam frequências individuais por consulta, e as células fora da diagonal representam contagens de coocorrência par a par. A faixa de auditoria relata 0 correspondência exata entre texto de síndrome e indicador em 555 linhas e uma similaridade média de Jaccard texto-indicador de 0,1806; portanto, as colunas de indicadores antigos foram excluídas da apresentação substantiva. Na matriz, Qi def. denota deficiência de qi, Qi stag. denota estagnação de qi e Water ret. denota retenção de água. A paleta de cores é descritiva. Nenhuma barra de erro é aplicável. Clique aqui para visualizar uma versão maior desta figura.
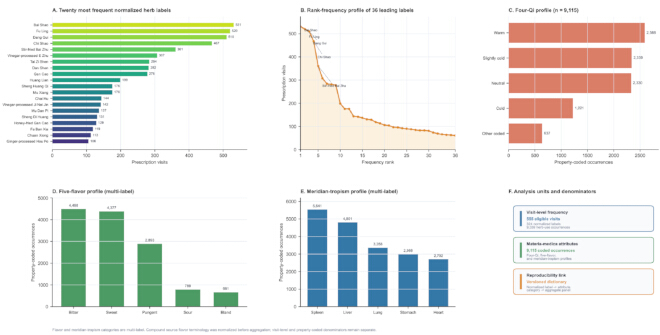
Figura 5: Ervas de alta frequência e perfis normalizados de atributos de matéria médica. (A) As vinte etiquetas de ervas normalizadas mais frequentes entre 555 consultas com prescrição elegíveis. (B) Perfil de frequência por ordem de classificação das 36 principais etiquetas de ervas normalizadas. (C) Distribuição dos Quatro-Qi com base em 9.115 ocorrências codificadas de uso de ervas; o Quatro-Qi possui valor único para cada ocorrência codificada. (D) Distribuições dos Cinco-Sabores e (E) das tropismos meridianos com base no mesmo denominador de ocorrências codificadas por propriedade; ambos são atributos com múltiplas etiquetas, e, portanto, as contagens por categoria não são exclusivas. (F) Unidades de análise por consulta e por ocorrência com propriedade codificada, e seu vínculo de reprodutibilidade. Os comprimentos das barras representam contagens, e as cores distinguem os painéis. Nenhuma barra de erro é aplicável. Clique aqui para visualizar uma versão maior desta figura.
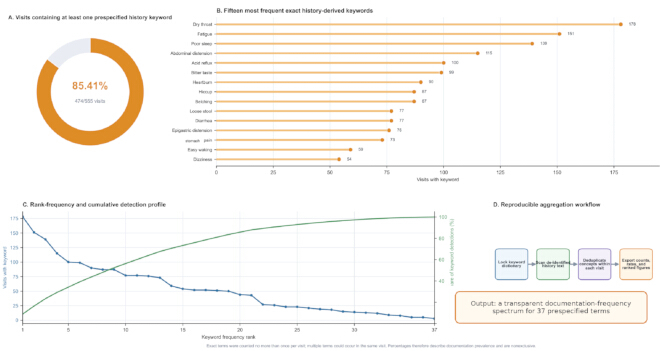
Figura 6: Espectro de palavras-chave de sintomas derivadas do histórico clínico e fluxo de trabalho reprodutível de agregação. (A) Proporção de 555 consultas elegíveis com prescrição contendo pelo menos uma palavra-chave pré-especificada do histórico clínico; 474 consultas (85,41%) continham pelo menos uma palavra-chave. (B) Os 15 conceitos exatos de sintomas derivados do histórico clínico mais frequentes. (C) Distribuição completa de frequência por posto com 37 termos e participação cumulativa das detecções de palavras-chave. (D) Fluxo de trabalho com versão fixa, partindo do dicionário pré-especificado até os resultados agregados. Cada conceito foi contado no máximo uma vez por consulta, embora múltiplos conceitos pudessem ocorrer na mesma consulta. As barras laranjas representam as contagens de palavras-chave, e as cores do fluxo de trabalho distinguem as etapas de processamento. Não se aplicam barras de erro. Clique aqui para visualizar uma versão maior desta figura.
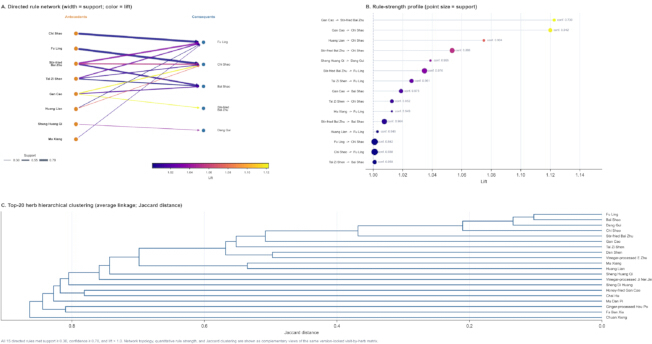
Figura 7: Regras de associação direcionadas entre ervas e agrupamento hierárquico. (A) Rede bipartida direcionada com as 15 regras de associação individuais entre ervas que atenderam aos limiares pré-especificados de suporte ≥ 0,30, confiança ≥ 0,70 e lift > 1,0. A largura das arestas representa o suporte e a cor das arestas representa o lift. (B) Perfil de intensidade das mesmas 15 regras ordenadas por lift; o tamanho dos pontos representa o suporte e as etiquetas adjacentes indicam a confiança (conf.). (C) Agrupamento hierárquico por ligação média das 20 variáveis de presença de ervas com maior frequência, utilizando a distância de Jaccard. Todos os painéis utilizam as consultas com prescrição como unidade de análise e descrevem padrões de co-registro, e não eficácia, sinergia ou uma combinação fixa recomendada. Barras de erro não são aplicáveis. Clique aqui para visualizar uma versão maior desta figura.
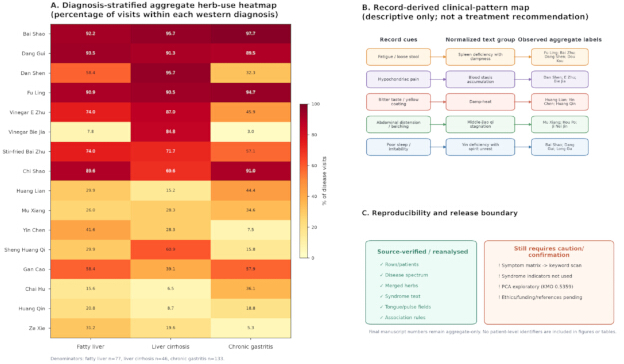
Figura 8: Padrões agregados de ervas estratificados por diagnóstico, mapa de padrão clínico e limite de liberação. (A) Mapa de calor estratificado por diagnóstico mostrando a prevalência em nível de consulta de 16 rótulos normalizados de ervas no fígado gorduroso (n = 77), cirrose hepática (n = 46) e gastrite crônica (n = 133). Cada célula representa a porcentagem de consultas elegíveis dentro do estrato de diagnóstico ocidental correspondente, utilizando uma escala de cores fixa de 0%–100%. (B) Mapa de padrão clínico derivado de registros, vinculando indicadores confirmados nos registros a grupos de texto normalizados e rótulos agregados observados de ervas. Conectores tracejados, não direcionais, distinguem esta camada interpretativa descritiva da prevalência calculada; o painel não constitui uma recomendação terapêutica. (C) Reprodutibilidade e limite de liberação que distinguem componentes verificados ou reanalisados pela fonte daqueles que exigem cautela ou confirmação. Clique aqui para visualizar uma versão maior desta figura.
| Métrica | Valor | Unidade/denominador | Status |
| Consultas com prescrição | 555 | 555 consultas com prescrição | verificado a partir do XLSX recuperado |
| Pacientes únicos | 396 | 396 pacientes únicos | verificado a partir do XLSX recuperado |
| Faixa etária por paciente | 13-94 | anos | verificado |
| Média de idade por paciente +/- DP | 47,11 +/- 14,88 | anos | verificado |
| Média de idade por consulta +/- DP | 48,22 +/- 15,82 | anos | verificado |
| Sexo por paciente | Feminino 228; masculino 167; desconhecido 1 | 396 pacientes | verificado |
| Sexo por consulta | Feminino 327; masculino 227; desconhecido 1 | 555 consultas | verificado |
| Ervas mescladas | 324 | nomes mesclados distintos | verificado |
| Ocorrências de uso de ervas mescladas | 9339 | 555 consultas com prescrição | verificado |
Tabela 1: Perfil do conjunto de dados. As características demográficas em nível de paciente e as variáveis em nível de consulta-prescrição são apresentadas utilizando seus respectivos denominadores. Os totais normalizados de ervas também são fornecidos.
| Nome da doença | Contagem | Percentual de visitas |
| Gastrite crônica | 133 | 24 |
| Fígado gorduroso | 77 | 13,9 |
| Cirrose hepática | 46 | 8,3 |
| Gastrite atrófica crônica | 22 | 4 |
| Dor abdominal | 22 | 4 |
| Hepatite B crônica | 20 | 3,6 |
| Dispepsia | 19 | 3,4 |
| Esofagite de refluxo | 8 | 1,4 |
| Gastrite superficial crônica | 7 | 1,3 |
| Pancreatite crônica | 6 | 1,1 |
| Colite ulcerativa | 6 | 1,1 |
| Pólipo da vesícula biliar | 6 | 1,1 |
| Síndrome pós-colecistectomia | 6 | 1,1 |
| Disfunção intestinal | 6 | 1,1 |
| Pedras na vesícula biliar | 6 | 1,1 |
| Hepatite crônica | 5 | 0,9 |
| Fadiga | 5 | 0,9 |
| Disfunção gastrointestinal (rótulo original incerto) | 5 | 0,9 |
| Gastrite crônica (rótulo original incerto) | 5 | 0,9 |
| Cirrose hepática autoimune | 4 | 0,7 |
Tabela 2: Principais diagnósticos ocidentais normalizados. Contagens e porcentagens dos principais diagnósticos ocidentais normalizados registrados em 555 consultas elegíveis para prescrição. As porcentagens utilizam as consultas elegíveis para prescrição como denominador.
| Nome da doença na MTC | Contagem | Percentual de consultas |
| Wei pi (plenitude ou desconforto epigástrico) | 163 | 29,4 |
| Doença Ji (rótulo clássico da MTC do tipo acúmulo) | 86 | 15,5 |
| Gan pi (rótulo de doença da MTC usado para distúrbios de fígado gorduroso) | 77 | 13,9 |
| Dor de estômago | 61 | 11 |
| Dor hipocôndrica | 32 | 5,8 |
| Dor abdominal | 31 | 5,6 |
| Gan zhuo (literalmente, fixidez hepática; um rótulo clássico mantido na MTC) | 28 | 5 |
| Deficiência com fadiga | 17 | 3,1 |
| Regurgitação ácida | 9 | 1,6 |
| Xie xie (fezes moles ou aquosas) | 6 | 1,1 |
| Insonia | 4 | 0,7 |
| Disenteria | 4 | 0,7 |
| Cefaleia | 4 | 0,7 |
| Doença Bi (doença de obstrução) | 4 | 0,7 |
| Distúrbio menstrual | 3 | 0,5 |
| Obstrução torácica | 3 | 0,5 |
| Distúrbio do suor | 3 | 0,5 |
| Constipação | 3 | 0,5 |
| Fu xie (diarreia) | 2 | 0,4 |
| Xiao ke (emaciação com sede) | 2 | 0,4 |
Tabela 3: Principais nomes normalizados de doenças da MTC. Contagens e porcentagens dos principais nomes normalizados de doenças da MTC registrados em 555 consultas com prescrição elegíveis. As porcentagens utilizam as consultas com prescrição elegíveis como denominador. Rótulos originais mantidos e explicações complementares não implicam equivalência com diagnósticos biomédicos modernos.
| Classificação | Elemento da síndrome | Consultas com prescrição | Consultas elegíveis | Percentual de consultas |
| 1 | baco | 362 | 555 | 65,23% |
| 2 | fígado | 304 | 555 | 54,77% |
| 3 | déficit de qi | 295 | 555 | 53,15% |
| 4 | estômago | 171 | 555 | 30,81% |
| 5 | umidade | 151 | 555 | 27,21% |
| 6 | estagnação de qi | 109 | 555 | 19,64% |
| 7 | calor | 97 | 555 | 17,48% |
| 8 | retenção de água | 94 | 555 | 16,94% |
| 9 | Sangue | 87 | 555 | 15,68% |
| 10 | estase sanguínea | 58 | 555 | 10,45% |
| 11 | canais | 57 | 555 | 10,27% |
| 12 | rim | 43 | 555 | 7,75% |
| 13 | coração | 37 | 555 | 6,67% |
| 14 | déficit de yin | 34 | 555 | 6,13% |
Tabela 4: Elementos principais de síndrome normalizados. Os elementos de síndrome foram extraídos do texto explícito de síndrome normalizado e desduplicados dentro de cada consulta prescrita. As contagens utilizam 555 consultas prescritas elegíveis como denominador; os percentuais não são exclusivos, pois podem ocorrer múltiplos elementos de síndrome dentro de uma mesma consulta.
| Rótulo da erva combinada | Contagem | Percentual de visitas |
| Bai Shao | 531 | 95,7 |
| Fu Ling | 520 | 93,7 |
| Dang Gui | 510 | 91,9 |
| Chi Shao | 467 | 84,1 |
| Bai Zhu refogado | 361 | 65 |
| E Zhu processado com vinagre | 307 | 55,3 |
| Tai Zi Shen | 284 | 51,2 |
| Dan Shen | 282 | 50,8 |
| Gan Cao | 278 | 50,1 |
| Huang Lian | 199 | 35,9 |
| Sheng Huang Qi | 176 | 31,7 |
| Mu Xiang | 176 | 31,7 |
| Chai Hu | 144 | 25,9 |
| Ji Nei Jin processado com vinagre | 142 | 25,6 |
| Mu Dan Pi | 137 | 24,7 |
| Sheng Di Huang | 131 | 23,6 |
| Gan Cao frito com mel | 129 | 23,2 |
| Fa Ban Xia | 119 | 21,4 |
| Chuan Xiong | 113 | 20,4 |
| Hou Po processado com gengibre | 106 | 19,1 |
| Yin Chen | 104 | 18,7 |
| Sheng Bai Zhu | 97 | 17,5 |
| Dou Kou | 96 | 17,3 |
| Sheng Long Gu | 92 | 16,6 |
| Zhe Bei Mu | 90 | 16,2 |
| Huang Qin | 88 | 15,9 |
| Dang Shen | 85 | 15,3 |
| Bie Jia processado com vinagre | 83 | 15 |
| Gui Zhi | 83 | 15 |
| Sheng Mu Li | 81 | 14,6 |
| Jiao Zhi Zi | 74 | 13,3 |
| He Huan Hua | 69 | 12,4 |
| Huang Jing processado com vinho | 66 | 11,9 |
| Chen Pi | 64 | 11,5 |
| Ze Xie | 63 | 11,4 |
| Jin Qian Cao | 61 | 11 |
Tabela 5: Principais rótulos normalizados de ervas por frequência de prescrição-consulta. Cada rótulo normalizado de erva foi contado no máximo uma vez por consulta com prescrição. As contagens e porcentagens utilizam 555 consultas com prescrição elegíveis como denominador, e as formas de processamento clinicamente significativas são mantidas como rótulos separados.
| Posição | Palavra-chave derivada do histórico | Consultas com prescrição | Consultas elegíveis | Percentual de consultas |
| 1 | Garganta seca | 178 | 555 | 32,07% |
| 2 | Fadiga | 151 | 555 | 27,21% |
| 3 | Má qualidade do sono | 139 | 555 | 25,05% |
| 4 | Dilatação abdominal | 115 | 555 | 20,72% |
| 5 | Refluxo ácido | 100 | 555 | 18,02% |
| 6 | Sabor amargo | 99 | 555 | 17,84% |
| 7 | Queimação no estômago | 90 | 555 | 16,22% |
| 8 | Soluo | 87 | 555 | 15,68% |
| 9 | Arrotos | 87 | 555 | 15,68% |
| 10 | Fezes moles | 77 | 555 | 13,87% |
| 11 | Diarréia | 77 | 555 | 13,87% |
| 12 | Dilatação epigástrica | 76 | 555 | 13,69% |
| 13 | Dor no estômago | 73 | 555 | 13,15% |
| 14 | Despertar fácil | 59 | 555 | 10,63% |
| 15 | Tontura | 54 | 555 | 9,73% |
| 16 | Vômito | 52 | 555 | 9,37% |
| 17 | Náusea | 52 | 555 | 9,37% |
| 18 | Dor maçante | 51 | 555 | 9,19% |
| 19 | Dor distendente | 50 | 555 | 9,01% |
| 20 | Falta de apetite | 44 | 555 | 7,93% |
| 21 | Dor abdominal | 43 | 555 | 7,75% |
| 22 | Opressão no peito | 27 | 555 | 4,86% |
| 23 | Irritabilidade | 26 | 555 | 4,68% |
| 24 | Dor de cabeça | 23 | 555 | 4,14% |
| 25 | Borborismo | 23 | 555 | 4,14% |
| 26 | Desconforto epigástrico | 21 | 555 | 3,78% |
| 27 | Palpitações | 19 | 555 | 3,42% |
| 28 | Urina amarela | 18 | 555 | 3,24% |
| 29 | Sensação de corpo estranho | 15 | 555 | 2,70% |
| 30 | Dor perfurante | 14 | 555 | 2,52% |
| 31 | Constipação | 13 | 555 | 2,34% |
| 32 | Sonolência | 12 | 555 | 2,16% |
| 33 | Sensação de corpo estranho na faringe | 9 | 555 | 1,62% |
| 34 | Transpiração excessiva | 8 | 555 | 1,44% |
| 35 | Dor hipocôndrica | 5 | 555 | 0,90% |
| 36 | Tenesmo | 5 | 555 | 0,90% |
| 37 | Fezes secas | 3 | 555 | 0,54% |
Tabela 6: Principais palavras-chave de sintomas derivadas do histórico clínico. Conceitos exatos de sintomas detectados em textos de histórico clínico anonimizados. Cada conceito foi contado no máximo uma vez dentro de uma consulta para prescrição, embora múltiplos conceitos pudessem ocorrer na mesma consulta. As contagens e porcentagens utilizam 555 consultas para prescrição elegíveis como denominador.
| Antecedente | Consequente | Visitas coocorrentes | Suporte | Confiança | Lift |
| Chi Shao | Fu Ling | 438 | 0.7892 | 0.9379 | 1.0010 |
| Fu Ling | Chi Shao | 438 | 0.7892 | 0.8423 | 1.0010 |
| Stir-fried Bai Zhu | Fu Ling | 350 | 0.6306 | 0.9695 | 1.0348 |
| Stir-fried Bai Zhu | Bai Shao | 348 | 0.6270 | 0.9640 | 1.0076 |
| Stir-fried Bai Zhu | Chi Shao | 320 | 0.5766 | 0.8864 | 1.0535 |
| Tai Zi Shen | Fu Ling | 273 | 0.4919 | 0.9613 | 1.0260 |
| Tai Zi Shen | Bai Shao | 272 | 0.4901 | 0.9577 | 1.0010 |
| Gan Cao | Bai Shao | 271 | 0.4883 | 0.9748 | 1.0189 |
| Gan Cao | Chi Shao | 262 | 0.4721 | 0.9424 | 1.1200 |
| Tai Zi Shen | Chi Shao | 242 | 0.4360 | 0.8521 | 1.0127 |
| Gan Cao | Stir-fried Bai Zhu | 203 | 0.3658 | 0.7302 | 1.1226 |
| Huang Lian | Fu Ling | 187 | 0.3369 | 0.9397 | 1.0029 |
| Huang Lian | Chi Shao | 180 | 0.3243 | 0.9045 | 1.0750 |
| Sheng Huang Qi | Dang Gui | 168 | 0.3027 | 0.9545 | 1.0388 |
| Mu Xiang | Fu Ling | 167 | 0.3009 | 0.9489 | 1.0127 |
Tabela 7: Regras de associação direcionadas entre ervas que atendem aos limiares pré-especificados. As regras foram geradas a partir de 555 linhas binárias de prescrição por consulta, utilizando suporte ≥ 0,30, confiança ≥ 0,70 e elevação > 1,0. O suporte utiliza 555 consultas com prescrição como denominador, e a direção da regra é mantida porque a confiança é direcional.
| Rótulo da erva | Fígado gorduroso (n) | Fígado gorduroso (N) | Fígado gorduroso (%) | Cirrose hepática (n) | Cirrose hepática (N) | Cirrose hepática (%) | Gastrite crônica (n) | Gastrite crônica (N) | Gastrite crônica (%) |
| Bai Shao | 71 | 77 | 92.21% | 44 | 46 | 95.65% | 130 | 133 | 97.74% |
| Dang Gui | 72 | 77 | 93.51% | 42 | 46 | 91.30% | 119 | 133 | 89.47% |
| Dan Shen | 45 | 77 | 58.44% | 44 | 46 | 95.65% | 43 | 133 | 32.33% |
| Fu Ling | 70 | 77 | 90.91% | 43 | 46 | 93.48% | 126 | 133 | 94.74% |
| E Zhu processado com vinagre | 57 | 77 | 74.03% | 40 | 46 | 86.96% | 61 | 133 | 45.86% |
| Bie Jia processado com vinagre | 6 | 77 | 7.79% | 39 | 46 | 84.78% | 4 | 133 | 3.01% |
| Bai Zhu refogado | 57 | 77 | 74.03% | 33 | 46 | 71.74% | 76 | 133 | 57.14% |
| Chi Shao | 69 | 77 | 89.61% | 32 | 46 | 69.57% | 121 | 133 | 90.98% |
| Huang Lian | 23 | 77 | 29.87% | 7 | 46 | 15.22% | 59 | 133 | 44.36% |
| Mu Xiang | 20 | 77 | 25.97% | 13 | 46 | 28.26% | 46 | 133 | 34.59% |
| Yin Chen | 32 | 77 | 41.56% | 13 | 46 | 28.26% | 10 | 133 | 7.52% |
| Sheng Huang Qi | 23 | 77 | 29.87% | 28 | 46 | 60.87% | 21 | 133 | 15.79% |
| Gan Cao | 45 | 77 | 58.44% | 18 | 46 | 39.13% | 77 | 133 | 57.89% |
| Chai Hu | 12 | 77 | 15.58% | 3 | 46 | 6.52% | 48 | 133 | 36.09% |
| Huang Qin | 16 | 77 | 20.78% | 4 | 46 | 8.70% | 25 | 133 | 18.80% |
| Ze Xie | 24 | 77 | 31.17% | 9 | 46 | 19.57% | 7 | 133 | 5.26% |
Tabela 8: Prevalência de uso de ervas estratificada por diagnóstico. Numeradores, denominadores e prevalência ao nível de consulta para 16 rótulos normalizados de ervas em esteatose hepática (n = 77), cirrose hepática (n = 46) e gastrite crônica (n = 133). Cada rótulo de erva foi contado não mais de uma vez por consulta com prescrição elegível.
Tabela Suplementar 1: Registro de transparência e auditoria assistido por IA. Documentação que distingue o registro de análise original da revisão de consistência realizada na fase de revisão em 21 de agosto de 2026. A tabela registra a ferramenta/modelo/versão, escopo da entrada, finalidade, discrepância identificada na cardinalidade dos Quatro Qi, correção humana, limitações de uso, informações do revisor, disposição e modelo de prompt. Nenhuma linha bruta em nível de paciente foi fornecida ao sistema de IA. Clique aqui para baixar este arquivo.
Tabela Suplementar 2: Resultados da qualidade dos dados do auditoria de fonte. A completude dos campos recuperados, as constatações da auditoria, as ações analíticas e os estados liberados são relatados para campos clínicos de origem e estruturas analíticas legadas. A tabela documenta a exclusão de indicadores de síndrome legados não reconciliados, a correção dos totais anteriores de ervas, a ausência de vetores de distribuição reconstrutíveis anteriores à limpeza para estimativa de estabilidade entre versões e as quantidades que não puderam ser reconstruídas. Clique aqui para baixar este arquivo.
Tabela Suplementar 3: Mapeamento da nomenclatura de ervas. Os rótulos padronizados para exibição de ervas estão vinculados a qualificadores de processamento, nomes padrão de materiais medicinais chineses (MMC), terminologia de origem, fontes botânicas, zoológicas ou minerais, versões de referência, localizadores de evidências e limites das evidências. Rótulos específicos de processamento são mantidos quando clinicamente relevantes. Clique aqui para baixar este arquivo.
Tabela Suplementar 4: Análises de sensibilidade de limiar e de visitas repetidas. São apresentadas perturbações nos limiares das regras de associação, comparações de conjuntos de regras com uma visita por paciente, métricas de sensibilidade de Chi Shao > Fu Ling e a comparação da distância de entrada para agrupamento de 190 pares. Clique aqui para baixar este arquivo.
Arquivo Suplementar 1: Script de limite determinístico e sensibilidade por visitas repetidas. Script determinístico utilizado para reproduzir as métricas agregadas de limite e sensibilidade por visitas repetidas a partir do conjunto de dados fonte com versão fixa. O arquivo não contém dados em nível individual de pacientes. Clique aqui para baixar este arquivo.
Discussão
A contribuição central deste protocolo é um caminho completo e inspecionável que vai de registros de casos de MTC desidentificados até figuras agregadas para pesquisa. Os passos mais críticos são: congelar a regra de identificação da coorte antes de inspecionar os resultados analíticos, distinguir pacientes únicos das consultas com prescrição, preservar todos os mapeamentos de termos originais para normalizados e verificar cada numerador e denominador antes da visualização. Esses controles transformam a limpeza de dados de uma atividade preliminar invisível em um componente documentado do método. Eles também alinham o fluxo de trabalho aos princípios RECORD, STROBE, FAIR e às estruturas estabelecidas de qualidade de dados em prontuários eletrônicos11,12,13,14,15. Um resultado é considerado pronto para divulgação apenas quando seu campo de origem, unidade de análise, versão do dicionário, regra de cálculo, denominador, tabela, figura e decisão do revisor puderem ser rastreados no registro de evidências.
O método é inovador porque integra governança, engenharia de terminologia, computação, visualização e revisão clínica, em vez de tratá-las como tarefas separadas. Uma única matriz explícita de síndrome gera o espectro de frequência, a rede de coocorrência e o mapa de calor. Uma única matriz de prescrição-visita-por-erva sustenta resumos de frequência, regras de associação direcionadas e agrupamento hierárquico19,20,21. Uma única tabela estratificada por diagnóstico sustenta tanto porcentagens exatas quanto o mapa de calor final. O fluxo de trabalho analítico utiliza ferramentas abertas e reproduzíveis com scripts36,37,38,39,40, permitindo que uma correção em um dicionário inicial ou em uma decisão de coorte se propague por todas as saídas dependentes. Trabalhos anteriores com armazéns clínicos de dados também demonstram a importância do pré-processamento vinculado à fonte e da reutilização de dados estruturados41,42. Essa arquitetura reduz a transcrição manual, mantém o alinhamento entre codificações gráficas e tabelas de origem e facilita auditoria, ensino e transferência para outras equipes de pesquisa.
Três estudos recentes de mineração de bancos de dados fornecem princípios úteis de design, embora sua unidade de análise seja uma publicação e não uma consulta clínica. O estudo sobre artrite reumatoide e depressão combina uma estratégia de busca predefinida com análises por país, instituição, autor, periódico, palavras-chave e linha do tempo26. O estudo sobre colite ulcerativa e inibidores da quinase Janus utiliza colaboração coordenada, co-citação, análises de agrupamento e de explosão temática para distinguir temas persistentes das frentes emergentes de pesquisa27. O estudo sobre artrite reumatoide e fibromialgia amplia o mapeamento bibliométrico com bioinformática, mantendo ao mesmo tempo uma distinção entre as duas camadas de evidência28. O presente protocolo aplica o mesmo princípio de vistas analíticas coordenadas, mas não intercambiáveis. A transferência para ginecologia, medicina respiratória, reumatologia ou outra especialidade exige a reconstrução de campos específicos da especialidade, dicionários de terminologia, regras de inclusão e exclusão, desfechos e procedimentos de revisão clínica antes que o conjunto de regras seja reutilizado. Espectros de doenças, redes de síndromes, palavras-chave de sintomas, regras de associação, agrupamentos e padrões estratificados por diagnóstico surgem todos de fontes com versão fixa, mas cada um aborda uma questão distinta e mantém seu próprio denominador e limite interpretativo.
A supervisão humana da IA pode fornecer uma camada adicional de controle de qualidade quando restrita a trechos desidentificados aprovados ou materiais agregados. Nesse fluxo de trabalho, a IA pode comparar a terminologia entre arquivos, destacar inconsistências entre legendas e tabelas, identificar rótulos que extrapolam os limites das figuras, verificar se cada nó da rede exibido possui uma conexão válida e sugerir redações mais claras. A IA não determina a elegibilidade da coorte, cria mapeamentos de terminologias, infere efeitos de tratamento nem substitui a revisão dos dados originais. Essa divisão de responsabilidades está de acordo com a visão mais ampla de que a IA médica deve complementar o julgamento humano em vez de obscurecer a responsabilidade33. Também reflete a ênfase do DECIDE-AI em fatores humanos transparentes, tratamento de erros e avaliação responsabilizável34. Portanto, o propósito de cada solicitação, a saída revisada, a correção aceita, o revisor e a data devem ser registrados no log de auditoria sempre que for utilizada assistência por IA.
A solução de problemas é particularmente importante quando um resultado parece clinicamente plausível, mas falha na reconciliação da fonte. Nesses casos, a interpretação posterior deve ser suspensa até que a discrepância seja rastreada até a determinação de elegibilidade, deduplicação, mapeamento de terminologia, seleção de campo, escolha do denominador ou montagem da figura. Todas as saídas dependentes devem então ser regeneradas após a correção. O exemplo trabalhado permanece como um conjunto de dados retrospectivo, de um único centro e de pacientes ambulatoriais especialistas, no qual visitas repetidas não são independentes umas das outras. A análise de sensibilidade de uma visita por paciente reduziu o conjunto de regras mantido de 15 para 12, preservando a inclusão de todas as 20 principais plantas medicinais. Em todos os 190 pares não ordenados entre essas 20 variáveis compartilhadas, a correlação de Pearson foi de 0,9944, o rho de Spearman foi de 0,9836, a mudança média absoluta na distância de Jaccard foi de 0,0146 e a mudança máxima foi de 0,0528 (Supplementary Table 4). Assim, um alto suporte no nível de visita não deve ser interpretado como validação no nível do paciente. O espectro de palavras-chave do histórico reflete documentação literal, e não uma escala de sintomas validada. Os resumos de matéria médica são ponderados por ocorrência, e não por dose. As regras de associação descrevem co-registro, e não causalidade. Os mapas de calor estratificados por diagnóstico são descritivos e não estabelecem eficácia comparativa, especificidade da doença ou necessidade de tratamento.
O protocolo pode ser aplicado à pesquisa sobre a herança da experiência clínica especializada, à descrição de coortes ambulatoriais de especialidade, à harmonização de terminologias multicêntricas, à revisão da qualidade da documentação, à seleção de variáveis para registros prospectivos e à preparação consciente da privacidade de conjuntos de dados agregados para colaboração. Trabalhos futuros podem incorporar coleta prospectiva e estruturada de sintomas, modelos agrupados por paciente, variáveis de dose explícitas, hipóteses comparativas pré-especificadas, validação externa, serviços de terminologia com controle de versões, computação que preserve a privacidade e registros interativos de evidências. O processamento de linguagem natural e a revisão assistida por IA podem reduzir ainda mais a curadoria repetitiva quando regidos por regras com versão fixa e verificação humana. De forma mais ampla, o protocolo permite que a experiência clínica dispersa seja transformada em um objeto de pesquisa transparente, que pode ser inspecionado, reproduzido, questionado e ampliado. O método não converte frequência em eficácia; ao contrário, converte decisões analíticas não documentadas em evidências visíveis, fornecendo uma base para perguntas clínicas mais rigorosas e para pesquisas em MTC no mundo real mais duradouras.
Divulgações
Os autores declaram não haver conflitos de interesses.
Agradecimentos
O OpenAI Codex (gpt-5.6-luna e gpt-5.6-sol) foi utilizado exclusivamente durante a revisão do manuscrito para verificações de consistência entre arquivos em nível agregado e sugestões de redação. Nenhum registro em nível individual de paciente foi fornecido ao sistema de inteligência artificial. Todas as saídas assistidas por IA foram verificadas independentemente em relação aos materiais originais por Tian Xia em 21 de agosto de 2026. Os autores analisaram e aprovaram o conteúdo final e assumem total responsabilidade pelo manuscrito. Este projeto foi apoiado pelo Programa Nacional de Pesquisa e Desenvolvimento Chave da China, Projeto Especial Principal sobre Modernização da Medicina Tradicional Chinesa (nº 2025YFC3512800); Projeto Nacional de Ciência e Tecnologia de Grande Relevância da China (Projeto nº 2026ZD0554100; Subprojeto nº 2026ZD0554101); Projeto de Melhoria da Capacidade de Pesquisa Clínica e Tradução de Resultados Científicos em Hospitais de Alto Nível de Medicina Tradicional Chinesa do Centro, Projeto Especial para a Transmissão da Experiência Acadêmica de Especialistas Sêniores Renomados em Medicina Tradicional Chinesa (nº HLCMHPP2023016); e pela Fundação de Ciências Naturais da Região Autônoma de Xinjiang Uigur (nº 2025D01C213).
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| Planilhas agregadas de reanálise | Arquivos locais gerados pelo autor | Não aplicável | Utilizados para contagens agregadas, tabelas e geração de figuras. |
| Exportação de prontuários ambulatoriais com identificação removida | Sistema institucional de prontuário eletrônico | Não aplicável | Utilizados apenas no ambiente institucional controlado; registros em nível de paciente não são materiais submetidos. |
| lxml | projeto lxml | 6.1.1 | Versão do software utilizada para serialização com preservação de namespace durante a regeneração na fase de revisão; não é a versão histórica original da análise. |
| Matplotlib | projeto Matplotlib (matplotlib.org) | 3.11.1 | Versão observada no ambiente de regeneração na fase de revisão e nos metadados SVG da Figura 3; não é a versão histórica original da análise. |
| NetworkX | projeto NetworkX | Pacote PyPI: networkx | Identificador do pacote registrado; a versão exata na fase de revisão não foi verificada no ambiente herdado. |
| NumPy | projeto NumPy | 2.3.5 | Versão do software utilizada para regenerar as saídas agregadas revisadas; não é a versão histórica original da análise. |
| openpyxl | projeto openpyxl | 3.1.5 | Versão do software utilizada para escrever as saídas XLSX agregadas revisadas; não é a versão histórica original da análise. |
| pandas | projeto pandas | 3.0.1 | Versão do software utilizada para regenerar as saídas agregadas revisadas; não é a versão histórica original da análise. |
| PyMuPDF | projeto PyMuPDF | 1.28.2 | Versão do software utilizada para regeneração na fase de revisão das saídas de figuras revisadas; não é a versão histórica original da análise. |
| Python | Python Software Foundation | 3.13.15 | Versão do software utilizada para regenerar as saídas agregadas revisadas; não é a versão histórica original da análise. |
| SciPy | projeto SciPy | Pacote PyPI: scipy | Identificador do pacote registrado; a versão exata na fase de revisão não foi verificada no ambiente herdado. |
Referências
- Wang YH, et al. Study on knowledge discovery in traditional Chinese medical case records [in Chinese]. Zhong Xi Yi Jie He Xue Bao. 2007;5(4):368-372.
- Wang Y, et al. Automatic symptom name normalization in clinical records of traditional Chinese medicine. BMC Bioinformatics. 2010;11:40.
- Zhou L, et al. Natural language processing algorithms for normalizing expressions of synonymous symptoms in traditional Chinese medicine. Evid Based Complement Alternat Med. 2021;2021:6676607.
- Chu X, et al. Quantitative knowledge presentation models of traditional Chinese medicine (TCM): a review. Artif Intell Med. 2020;103:101810.
- Zhang T, et al. Constructing fine-grained entity recognition corpora based on clinical records of traditional Chinese medicine. BMC Med Inform Decis Mak. 2020;20:64.
- Wang Q, et al. A study of entity-linking methods for normalizing Chinese diagnosis and procedure terms to ICD codes. J Biomed Inform. 2020;105:103418.
- Zhang H, et al. Transformer- and generative adversarial network-based inpatient traditional Chinese medicine prescription recommendation: development study. JMIR Med Inform. 2022;10(5):e35239.
- Dan W, et al. SinoMedminer: an R package and Shiny application for mining and visualizing traditional Chinese medicine herbal formulas. Chin Med. 2025;20:80.
- Chinese Pharmacopoeia Commission. Pharmacopoeia of the People's Republic of China. 2025 ed. China Medical Science and Technology Press; Beijing; 2025.
- Editorial Committee of Zhonghua Bencao, State Administration of Traditional Chinese Medicine. Zhonghua Bencao. 10 vols. Shanghai Scientific and Technical Publishers; Shanghai; 1999. ISBN: 7532351068. Available from: National Diet Library record
- Benchimol EI, et al. The REporting of studies Conducted using Observational Routinely-collected health Data (RECORD) statement. PLoS Med. 2015;12(10):e1001885.
- von Elm E, et al. The Strengthening the Reporting of Observational Studies in Epidemiology (STROBE) statement: guidelines for reporting observational studies. Lancet. 2007;370(9596):1453-1457.
- Wilkinson MD, et al. The FAIR Guiding Principles for scientific data management and stewardship. Sci Data. 2016;3:160018.
- Weiskopf NG, Weng C. Methods and dimensions of electronic health record data quality assessment: enabling reuse for clinical research. J Am Med Inform Assoc. 2013;20(1):144-151.
- Kahn MG, et al. A harmonized data quality assessment terminology and framework for the secondary use of electronic health record data. EGEMS (Wash DC). 2016;4(1):18.
- Kovačević A, Bašaragin B, Milošević N, Nenadić G. De-identification of clinical free text using natural language processing: a systematic review of current approaches. Artif Intell Med. 2024;151:102845.
- Meystre SM, et al. Text de-identification for privacy protection: a study of its impact on clinical text information content. J Biomed Inform. 2014;50:142-150.
- Neamatullah I, et al. Automated de-identification of free-text medical records. BMC Med Inform Decis Mak. 2008;8:32.
- Agrawal R, Srikant R. Fast algorithms for mining association rules in large databases. Presented at: 20th International Conference on Very Large Data Bases; Santiago, Chile; 1994. p. 487-499.
- Hahsler M, Grün B, Hornik K. arules: a computational environment for mining association rules and frequent item sets. J Stat Softw. 2005;14(15):1-25.
- Murtagh F, Contreras P. Algorithms for hierarchical clustering: an overview. WIREs Data Min Knowl Discov. 2012;2(1):86-97.
- van Eck NJ, Waltman L. Software survey: VOSviewer, a computer program for bibliometric mapping. Scientometrics. 2010;84(2):523-538.
- Chen C. CiteSpace II: detecting and visualizing emerging trends and transient patterns in scientific literature. J Am Soc Inf Sci Technol. 2006;57(3):359-377.
- Aria M, Cuccurullo C. bibliometrix: an R-tool for comprehensive science mapping analysis. J Informetr. 2017;11(4):959-975.
- Donthu N, et al. How to conduct a bibliometric analysis: an overview and guidelines. J Bus Res. 2021;133:285-296.
- Zhao Y, Chen GY, Fang M. Research trends of rheumatoid arthritis and depression from 2019 to 2023: a bibliometric analysis. J Multidiscip Healthc. 2024;17:4465-4474.
- Wang Y, et al. Research trends and hotspots in JAK inhibitors for ulcerative colitis: a bibliometric analysis from 2015 to 2024. J Multidiscip Healthc. 2025;18:6755-6771.
- Chen G, Yan Z, Wang Y, Tao Q. Rheumatoid arthritis and fibromyalgia syndrome: a bibliometric and bioinformatics perspective on comorbidity research. J Multidiscip Healthc. 2025;18:6811-6827.
- Wang SL, et al. Yao Naili's experience in applying the harmonizing liver and spleen method. Journal of Traditional Chinese Medicine. 2008;49(7):596-597.
- Wang L, et al. Analysis of Professor Naili Yao's experience in treating spleen-stomach diseases [in Chinese]. Lishizhen Med Mater Med Res. 2022;33(6):1436-1438.
- Sandve GK, Nekrutenko A, Taylor J, Hovig E. Ten simple rules for reproducible computational research. PLoS Comput Biol. 2013;9(10):e1003285.
- Munafò MR, et al. A manifesto for reproducible science. Nat Hum Behav. 2017;1:0021.
- Topol EJ. High-performance medicine: the convergence of human and artificial intelligence. Nat Med. 2019;25(1):44-56.
- Vasey B, et al. Reporting guideline for the early-stage clinical evaluation of decision support systems driven by artificial intelligence: DECIDE-AI. Nat Med. 2022;28(5):924-933.
- Branch of Gastrointestinal Diseases, China Association of Chinese Medicine. Expert consensus on traditional Chinese medicine diagnosis and treatment of Gan pi (2023). Chinese Journal of Integrative Digestive Diseases. 2024;32(9):741-747.
- McKinney W. Data structures for statistical computing in Python [conference paper]. Presented at: 9th Python in Science Conference; Austin, TX; 2010. p. 56-61. doi:10.25080/Majora-92bf1922-00a.
- Harris CR, et al. Array programming with NumPy. Nature. 2020;585(7825):357-362.
- Virtanen P, et al. SciPy 1.0: fundamental algorithms for scientific computing in Python. Nat Methods. 2020;17(3):261-272.
- Hunter JD. Matplotlib: a 2D graphics environment. Comput Sci Eng. 2007;9(3):90-95.
- Hagberg AA, Schult DA, Swart PJ. Exploring network structure, dynamics, and function using NetworkX. Presented at: 7th Python in Science Conference; Pasadena, CA; 2008. p. 11-15. doi:10.25080/TCWV9851.
- Zhou X, et al. Development of traditional Chinese medicine clinical data warehouse for medical knowledge discovery and decision support. Artif Intell Med. 2010;48(2-3):139-152.
- Liu B, et al. Data processing and analysis in real-world traditional Chinese medicine clinical data: challenges and approaches. Stat Med. 2012;31(7):653-660.