Este protocolo apresenta um fluxo de trabalho reproduzível para desenvolver, avaliar e interpretar modelos de inteligência artificial explicáveis na área da saúde. Ele integra a preparação padronizada de dados, desenvolvimento de modelos, técnicas de explicabilidade, avaliação quantitativa e práticas de reprodutibilidade para melhorar a transparência, confiabilidade e aplicabilidade clínica.
Artigo de método
Um Protocolo Experimental Reprodutível para o Desenvolvimento e Avaliação de Modelos de Inteligência Artificial Explicável em Sistemas de Saúde
Neste artigo
Resumo
Resumo
A inteligência artificial (AI) está sendo cada vez mais adotada como uma ferramenta valiosa para tomada de decisões clínicas, predição de doenças, diagnóstico médico e cuidados de saúde personalizados. No entanto, a falta de transparência, a implementação inconsistente de métodos de inteligência artificial explicável (XAI) e a reprodutibilidade limitada continuam sendo barreiras significativas para a implantação confiável de modelos de IA em ambientes clínicos. Este artigo propõe um protocolo sistemático, reprodutível e transparente para desenvolver, avaliar e interpretar modelos de IA explicáveis para aplicações em saúde. O fluxo de trabalho começa com a configuração do ambiente computacional, seguida pela aquisição e caracterização dos dados, pré-processamento, engenharia de características, desenvolvimento do modelo, otimização de hiperparâmetros, avaliação do desempenho preditivo, análise de explicabilidade, validação estatística e avaliação de reprodutibilidade. O protocolo incorpora métodos de XAI, como Explicações Aditivas de Shapley (SHAP), Explicações Locais Model-agnósticas Interpretáveis (LIME), Mapeamento de Ativação por Gradiente Ponderado (Grad-CAM), Gradientes Integrados, visualização de atenção e explicações contrafactuais, para gerar interpretações globais e locais do modelo. O protocolo enfatiza diversos componentes-chave, incluindo a preparação de conjuntos de dados padronizados em saúde, o desenvolvimento de modelos estáveis de aprendizado de máquina, a avaliação do desempenho preditivo, a geração de explicações clinicamente relevantes e a avaliação estatística da reprodutibilidade em experimentos repetidos. Ao integrar o desenvolvimento do modelo, explicabilidade, avaliação quantitativa e qualitativa, validação estatística e avaliação de reprodutibilidade em um fluxo de trabalho unificado, este protocolo fornece uma estrutura abrangente para o desenvolvimento de modelos de IA transparentes e reprodutíveis para aplicações em saúde.
Introdução
A IA tornou-se um componente integral da saúde moderna ao permitir a análise inteligente de dados clínicos complexos e apoiar a tomada de decisões médicas baseadas em evidências1. A rápida digitalização da saúde por meio de prontuários eletrônicos, sistemas de imagens médicas, dispositivos vestíveis e tecnologias genômicas gerou grandes volumes de dados heterogêneos que exigem abordagens computacionais avançadas para interpretação eficaz2.
Algoritmos de aprendizado de máquina (ML) e aprendizado profundo (DL) demonstraram capacidades notáveis na extração de padrões significativos a partir de conjuntos de dados multidimensionais em saúde, melhorando assim a precisão diagnóstica, a predição de doenças e a avaliação de desfechos em pacientes3. Modelos baseados em inteligência artificial foram aplicados com sucesso em radiologia, patologia, cardiologia, oncologia, oftalmologia e outras especialidades médicas para auxiliar clínicos na detecção precoce de doenças e na recomendação de estratégias de tratamento personalizadas4. Essas tecnologias também contribuíram para a otimização dos fluxos de trabalho, a redução da variabilidade diagnóstica e a melhoria no uso dos recursos em saúde5.
Desenvolvimentos recentes em hardware computacional, computação em nuvem e frameworks de IA de código aberto aceleraram o desenvolvimento e a implantação de aplicações inteligentes em saúde6. Consequentemente, a IA tornou-se uma tecnologia essencial para a medicina de precisão e sistemas de suporte à decisão clínica7. Apesar desses avanços, a adoção generalizada da IA na prática clínica rotineira ainda é limitada, pois muitos modelos de alto desempenho oferecem pouca transparência sobre como suas previsões são geradas8.
A maioria dos algoritmos de aprendizado profundo atua como modelos complexos do tipo caixa-preta, nos quais o processo interno de tomada de decisão é difícil de compreender para clínicos e pesquisadores9. Embora esses modelos frequentemente alcancem um excelente desempenho preditivo, a falta de transparência compromete a confiança do usuário e representa desafios para a validação clínica, aprovação regulatória e segurança do paciente10. Os profissionais de saúde devem ser capazes de justificar decisões assistidas por IA antes de incorporá-las à prática clínica rotineira, especialmente em ambientes médicos de alto risco11.
A IAX surgiu como uma abordagem eficaz para melhorar a transparência e a interpretabilidade de modelos de aprendizado de máquina12. Em vez de tratar modelos preditivos como sistemas opacos, as técnicas de IAX fornecem informações sobre as características, regiões da imagem ou variáveis clínicas que contribuem para previsões individuais13. Tais explicações permitem que clínicos compreendam melhor o comportamento do modelo, identifiquem possíveis vieses e determinem se decisões geradas por IA são consistentes com o conhecimento médico estabelecido14.
Várias técnicas de explicabilidade foram introduzidas para aplicações na área da saúde. As Explicações Aditivas baseadas em Shapley (SHAP) medem a contribuição de cada característica para a predição do modelo com base na teoria dos jogos cooperativos15. Explicações Locais, Interpretáveis e Agnósticas em relação ao Modelo (LIME) criam um modelo simplificado para explicar as predições de um modelo opaco16. Para tarefas envolvendo imagens médicas com modelos de aprendizado profundo, os mapas de ativação ponderados por gradiente (Grad-CAM) geram mapas de calor que indicam visualmente as regiões da imagem que contribuem para as decisões de classificação17. A combinação desses métodos aumentou significativamente a transparência dos sistemas de IA em diversas áreas da saúde18.
Apesar da crescente atenção aos métodos de explicabilidade em ambientes de saúde, seu uso permanece variado na literatura. Os pesquisadores diferem não apenas na utilização de estratégias de pré-processamento, mas também no design da arquitetura do modelo, nas métricas de avaliação e até nas técnicas de explicação19. Além disso, muitos artigos relatam alta precisão preditiva, mas não fornecem uma avaliação completa da qualidade das explicações ou de sua reprodutibilidade20.
A reprodutibilidade é um dos principais gargalos na ciência moderna de IA. Os artigos frequentemente não divulgam a versão do software, o ambiente computacional, o pipeline de pré-processamento, as configurações dos hiperparâmetros, a inicialização da semente aleatória e as configurações de hardware21. Por causa disso, pesquisadores independentes muitas vezes não conseguem reproduzir os resultados publicados ou verificar os métodos publicados usando outros conjuntos de dados ou plataformas de software22. A falta de documentação detalhada é um dos fatores que dificultam estudos de comparação, pesquisas colaborativas e a tradução clínica de sistemas de IA23.
Reconhecendo esses desafios, diversas organizações e agências reguladoras enfatizaram a importância de uma IA transparente, confiável e reproduzível para aplicações em saúde24. As diretrizes de relatoria existentes melhoraram a divulgação metodológica, mas descrevem principalmente o que deve ser relatado, em vez de fornecer procedimentos experimentais padronizados que os pesquisadores possam implementar diretamente25. Consequentemente, ainda existe a necessidade de um protocolo abrangente que integre o preparo do conjunto de dados, o desenvolvimento do modelo, a análise de explicabilidade, a avaliação estatística e as práticas de reprodutibilidade em um único fluxo de trabalho experimental26.
Um protocolo experimental padronizado oferece diversas vantagens para a comunidade de inteligência artificial em saúde. Além disso, promove consistência metodológica, facilita a comparação de estudos independentes, aumenta a transparência dos experimentos computacionais e permite a validação confiável de resultados publicados27. Fluxos de trabalho padronizados também auxiliam na educação/formação, pesquisa colaborativa e avaliação regulatória por meio de procedimentos claramente documentados que são reproduzíveis em diferentes laboratórios e instituições de saúde28.
Foi desenvolvido e testado um protocolo experimental reprodutível para treinar e avaliar modelos de IA em sistemas de saúde. O protocolo estabelece padrões para configurar o ambiente computacional, pré-processar conjuntos de dados de saúde, desenvolver modelos de aprendizado de máquina, aplicar métodos de IAX, avaliar o desempenho preditivo, realizar validação estatística e avaliar a reprodutibilidade29. A integração desses componentes em um fluxo de trabalho coerente tende a aumentar a transparência, confiabilidade e reprodutibilidade da pesquisa em IA para a saúde, além de auxiliar no desenvolvimento de sistemas inteligentes de saúde confiáveis30.
Protocolo
O experimento de validação realizado utilizou o Conjunto de Dados sobre Diabetes dos Índios Pima, disponível publicamente e com identificação removida, e não envolveu registros de pacientes identificáveis nem recrutamento novo de pacientes. Portanto, não foi necessária a aprovação do comitê de ética institucional (IRB) nem o consentimento informado, e todas as análises foram conduzidas em conformidade com os termos aplicáveis do conjunto de dados e com as políticas institucionais de pesquisa.
O exemplo validado utiliza o conjunto de dados publicamente disponível sobre diabetes dos índios Pima, que contém 768 registros para previsão binária de diabetes. O fluxo de trabalho completo com nove etapas principais foi aplicado a este conjunto de dados. As nove etapas principais compreenderam seleção e validação do conjunto de dados, configuração do ambiente computacional, pré-processamento dos dados, particionamento do conjunto de dados, desenvolvimento e treinamento do modelo, avaliação do desempenho preditivo e computacional, análise de explicabilidade, validação estatística e avaliação de reprodutibilidade. A validação externa e a avaliação por especialistas clínicos foram mantidas como módulos opcionais de validação e não foram realizadas no presente exemplo validado. Figura 1 ilustra o fluxo de trabalho do protocolo principal, e Tabela 1 resume apenas as nove etapas principais implementadas no presente exemplo validado; a validação externa opcional e a avaliação por especialistas clínicos são descritas separadamente dentro do Protocolo e não estão incluídas entre as nove etapas experimentais.
1. Selecionar e validar o conjunto de dados de saúde
- Selecione o conjunto de dados Pima Indians Diabetes Dataset como o conjunto de dados principal para o exemplo validado. Verifique a fonte do conjunto de dados, tamanho da amostra, objetivo de predição, distribuição das classes e estrutura dos dados.
- Aplique os critérios predefinidos de inclusão, exclusão e qualidade dos dados. Remova registros duplicados e inválidos antes do desenvolvimento do modelo.
- Registre a fonte do conjunto de dados, características, tarefa de predição, distribuição das classes, critérios de inclusão e exclusão e estratégia de particionamento na Tabela 2.
- Aplicar critérios de decisão para seleção do conjunto de dados e modelo
- Defina o objetivo de predição antes de selecionar o conjunto de dados, arquitetura do modelo, estratégia de pré-processamento ou método de explicabilidade.
- Relacione a modalidade do conjunto de dados ao objetivo de predição. Selecione dados tabulares para variáveis clínicas estruturadas, dados de imagem para imagens médicas, dados de séries temporais para sinais fisiológicos, dados textuais para narrativas clínicas ou dados multimodais quando modalidades complementares estiverem disponíveis para o mesmo paciente ou unidade de estudo.
- Avalie os conjuntos de dados candidatos com base no tamanho da amostra, disponibilidade do desfecho, distribuição das classes, ausência de dados, qualidade da anotação, relevância clínica, integridade dos dados e acessibilidade. Selecione o conjunto de dados que atenda aos requisitos predefinidos.
- Selecione modelos convencionais de aprendizado de máquina para dados tabulares estruturados quando o tamanho da amostra, recursos computacionais ou requisitos de interpretabilidade limitarem o uso de arquiteturas complexas. Selecione arquiteturas de aprendizado profundo quando houver dados de treinamento suficientes e entradas de alta dimensionalidade, como imagens médicas, sinais fisiológicos ou texto clínico, disponíveis.
- Selecione arquiteturas multimodais somente quando múltiplas modalidades estiverem disponíveis para o mesmo paciente ou unidade de estudo e puderem ser alinhadas de forma confiável sem introduzir vazamento de informação. Selecione operações de pré-processamento de acordo com as características da modalidade de dados escolhida.
- Selecione métodos de explicabilidade de acordo com o modelo e a modalidade dos dados. Utilize métodos agnósticos em relação ao modelo, como SHAP ou LIME, para modelos tabulares apropriados e métodos específicos da modalidade, como Grad-CAM para modelos baseados em imagens, quando aplicável.
- Documente a justificativa para as seleções do conjunto de dados, estratégia de pré-processamento, modelo e método de explicabilidade. Preserve essas decisões como parte do registro de reprodutibilidade.
2. Configure o ambiente computacional para o desenvolvimento do modelo XAI
- Configure o sistema operacional, CPU, RAM, armazenamento e GPU de acordo com os requisitos do modelo selecionado. Crie um ambiente Python isolado e instale as bibliotecas necessárias de aprendizado de máquina, aprendizado profundo, estatística, visualização e XAI.
- Registre o ambiente computacional real, a arquitetura do modelo e os hiperparâmetros utilizados na validação realizada na Tabela 3. Especifique o otimizador, taxa de aprendizado, tamanho do lote, número máximo de épocas, função de perda, parâmetros de regularização, estratégia de validação, configuração de parada antecipada, configuração de semente aleatória, métodos de explicabilidade, hardware, sistema operacional, versão do Python e versões das bibliotecas de software relevantes. Distingua essas configurações utilizadas experimentalmente das configurações gerais ou recomendadas do protocolo.
- Utilize a configuração relatada na Tabela 3 ao reproduzir a validação do conjunto de dados Pima Indians Diabetes e os resultados preditivos, de explicabilidade, estatísticos e de reprodutibilidade correspondentes.
- Execute um script de validação para confirmar a importação bem-sucedida dos pacotes, carregamento do conjunto de dados, execução do modelo e geração de saídas. Preserve a configuração finalizada do ambiente para fins de reprodutibilidade.
3. Prepare e caracterize conjuntos de dados de saúde para o desenvolvimento de modelos de XAI
- Selecione e adquira o conjunto de dados de saúde
- Selecione um conjunto de dados de saúde apropriado para a tarefa clínica de predição definida. Avalie conjuntos de dados candidatos de acordo com o objetivo da pesquisa, tipo de dados, tamanho da amostra, qualidade da anotação, equilíbrio de classes e relevância clínica.
- Prefira conjuntos de dados de referência de acesso público quando eles abordarem adequadamente a tarefa de predição e facilitarem a validação independente.
- Obtenha as aprovações éticas necessárias, permissões institucionais e autorizações de acesso aos dados antes de adquirir conjuntos de dados institucionais ou internos. Obtenha o conjunto de dados selecionado a partir de um repositório verificado ou base de dados institucional autorizada.
- Preserve os arquivos originais do conjunto de dados sem modificações e registre o provedor do conjunto de dados, versão, informações de aquisição, condições de licenciamento, critérios de inclusão, critérios de exclusão e metadados complementares. Organize o conjunto de dados em diretórios separados para dados brutos, anotações, metadados e informações suplementares.
- Caracterize o conjunto de dados de saúde
- Identifique as variáveis preditoras, rótulos de resultado, tipos de características, modalidades de dados e distribuições de classes. Determine o número de indivíduos, amostras, dimensões de características e anotações disponíveis.
- Confirme que as características do conjunto de dados são compatíveis com o método de IA selecionado.
- Utilize o conjunto de dados Pima Indians Diabetes como o único conjunto experimental trabalhado para validar o protocolo central de nove etapas. Inclua os conjuntos de dados adicionais listados na Tabela 2 apenas para demonstrar a aplicabilidade do protocolo geral em dados clínicos tabulares, prontuários eletrônicos de saúde, imagens dermatoscópicas, dados de séries temporais fisiológicas e imagens médicas. Não utilize esses conjuntos de dados adicionais para treinamento do modelo, testes, validação estatística ou geração dos resultados experimentais relatados.
- Avalie a qualidade do conjunto de dados
- Inspeccione o conjunto de dados quanto a registros duplicados, arquivos corrompidos, valores ausentes, erros de anotação e entradas irregulares de dados. Remova registros duplicados confirmados e corrija irregularidades de formatação verificadas. Documente todos os procedimentos de controle de qualidade do conjunto de dados.
- Verifique a correspondência entre dados de imagem, clínicos, laboratoriais e fisiológicos por meio de identificadores dos indivíduos, ao utilizar conjuntos de dados multimodais.
- Remova registros duplicados ou inconsistentes, trate valores ausentes, padronize características numéricas, codifique variáveis categóricas e aplique pré-processamento específico à modalidade. Divida o conjunto de dados em conjuntos independentes de treinamento, validação e teste. Consulte a Figura 2 para o fluxo de trabalho de preparação, pré-processamento, divisão e avaliação da qualidade do conjunto de dados de saúde.
- Garanta a privacidade dos dados e conformidade ética
- Remova identificadores diretos dos dados de saúde. Aplique procedimentos de anonimização ou pseudonimização quando necessário. Trate as informações de saúde do paciente de acordo com os requisitos éticos, de proteção de dados, de consentimento informado e institucionais aplicáveis.
- Registre a aprovação ética aplicável, isenções, procedimentos de governança de dados, métodos de anonimização e fluxo de trabalho de preparação do conjunto de dados.
- Avalie potenciais vieses algorítmicos comparando o desempenho do modelo em subgrupos demográficos ou clínicos relevantes, quando essas informações estiverem disponíveis e forem eticamente permitidas.
- Documente o uso pretendido, população-alvo, limitações do modelo, modos potenciais de falha, requisitos de supervisão humana e os requisitos éticos, de proteção de dados e regulamentares da área da saúde aplicáveis.
- Registre limitações identificadas em termos de equidade e considerações de IA responsável como parte da documentação final do modelo.
NOTA: Obtenha um conjunto de dados de saúde padronizado e documentado, adequado para o desenvolvimento de modelos de IA, eticamente compatível e livre de inconsistências significativas identificadas.
4. Pré-processar e particionar dados de saúde para o treinamento de modelos de IA
- Realizar controle de qualidade
- Inspecione o conjunto de dados quanto a registros duplicados, valores ausentes, valores inválidos, rótulos inconsistentes, valores atípicos e arquivos corrompidos.
- Remova ou corrija observações inválidas de acordo com critérios predefinidos e registre todas as exclusões. Verifique a consistência das variáveis preditoras e dos rótulos de resultado.
- Tratar dados ausentes
- Quantifique a ausência de dados para cada variável. Aplique a estratégia predefinida de imputação ou exclusão.
- Estime os parâmetros de imputação utilizando apenas os dados de treinamento e aplique a transformação ajustada aos dados de validação e teste.
- Normalizar e transformar os dados
- Aplicar escalonamento de características, normalização, codificação, redução de dimensionalidade ou outras transformações exigidas pelo modelo selecionado. Ajuste todas as transformações dependentes dos dados utilizando apenas os dados de treinamento.
- Aplicar as transformações ajustadas inalteradas aos dados de validação e teste.
- Quantificar o desequilíbrio de classes nos dados de treinamento. Aplique ponderação de classes, SMOTE, sobreamostragem ou aumento apenas ao conjunto de dados de treinamento. Mantenha a distribuição original dos conjuntos de dados de validação e teste.
- Confirme que nenhum sujeito, observação duplicada, amostra aumentada, estatística de pré-processamento, critério de seleção de características ou amostra sintética seja compartilhado entre as partições de treinamento e avaliação.
5. Desenvolver e configurar o modelo de IA explicável
- Defina a arquitetura do modelo especificando as modalidades dos dados de entrada, operações de pré-processamento, codificadores de características específicos para cada modalidade, mecanismo de fusão de características, camada de predição e módulo de explicabilidade.
- Selecione a arquitetura de aprendizado de máquina ou aprendizado profundo de acordo com a tarefa de predição e a modalidade de entrada. Configure a camada de entrada, os componentes de extração de características, as camadas ocultas, a camada de saída e as funções de ativação. Defina o otimizador, taxa de aprendizado, tamanho do lote, função de perda, épocas, regularização, dropout, parada antecipada e o agendamento da taxa de aprendizado.
- Otimize os hiperparâmetros utilizando apenas os dados de treinamento e validação.
- Registre a arquitetura finalizada e a configuração de hiperparâmetros na Tabela 3.
- Verifique a compatibilidade das dimensões de entrada e saída antes do treinamento.
NOTA: Estabeleça um modelo XAI totalmente configurado, contendo uma arquitetura apropriada, hiperparâmetros definidos e técnicas de explicabilidade integradas.
6. Treine, otimize e preserve o modelo XAI
- Carregue os conjuntos de dados de treinamento e validação predefinidos e a configuração final do modelo. Inicialize o modelo usando a semente aleatória predefinida e os parâmetros de treinamento.
- Treine o modelo usando o otimizador especificado, função de perda, tamanho do lote e critérios de parada.
- Monitore o desempenho na validação e mantenha o ponto de controle correspondente ao critério predefinido de seleção do modelo. Avalie o ponto de controle selecionado no conjunto de dados de teste independente sem mais otimização.
- Salve o modelo treinado, a configuração de pré-processamento, os hiperparâmetros, a semente aleatória e o registro de treinamento.
NOTA: Obtenha um modelo XAI otimizado treinado e validado usando o conjunto de dados de saúde preparado. Preserve o modelo com melhor desempenho, os hiperparâmetros, os registros de treinamento, a configuração de pré-processamento e o ambiente computacional para reprodutibilidade.
7. Avaliar o desempenho preditivo e computacional
- Avalie o desempenho preditivo
- Carregue o modelo otimizado e o conjunto de dados de teste independente após concluir o treinamento do modelo e a otimização dos hiperparâmetros. Mantenha os parâmetros do modelo treinado e o pipeline de pré-processamento inalterados durante os testes.
- Gere previsões para todas as amostras no conjunto de dados de teste. Compare as saídas previstas com as respectivas etiquetas reais.
- Calcule as métricas de desempenho
- Selecione métricas de avaliação de acordo com o tipo de tarefa de predição.
- Calcule acurácia, precisão, revocação, especificidade, pontuação F1, acurácia balanceada, coeficiente de correlação de Matthews (MCC) e área sob a curva ROC (AUC-ROC) para tarefas de classificação, conforme aplicável. Calcule erro absoluto médio (MAE), raiz do erro quadrático médio (RMSE), coeficiente de determinação (R2) e outras medidas relevantes para tarefas de regressão, conforme aplicável.
- Avalie a generalização e a robustez do modelo
- Avalie o modelo utilizando um conjunto de dados externo coletado independentemente do conjunto de dados de desenvolvimento, sempre que esses dados estiverem disponíveis.
- Prefira conjuntos de dados externos provenientes de uma instituição de saúde diferente, região geográfica ou população de pacientes distinta para avaliar a transportabilidade.
- Realize validação temporal utilizando dados coletados em um período posterior, quando conjuntos de dados longitudinais estiverem disponíveis.
- Realize validação multicêntrica avaliando o modelo finalizado separadamente nas instituições participantes, quando dados multicêntricos estiverem disponíveis.
- Realize validação geográfica utilizando uma população independente de uma região geográfica diferente, quando viável.
- Relate as diferenças de desempenho e os intervalos de confiança entre os conjuntos de dados de desenvolvimento e externos.
- Avalie o desempenho computacional
- Meça o tempo de treinamento do modelo no ambiente computacional predefinido, o tempo de inferência e de teste sob condições computacionais idênticas, além do consumo de memória, tamanho do modelo e utilização de hardware.
- Repita as medições computacionais em execuções independentes.
- Calcule o tempo médio de execução para reduzir o efeito da variabilidade experimental.
- Compare o desempenho do modelo
- Selecione métodos convencionais apropriados de aprendizado de máquina ou aprendizado profundo para avaliação comparativa.
- Avalie o modelo XAI proposto e os modelos comparadores utilizando o mesmo conjunto de dados. Aplique procedimentos idênticos de pré-processamento e métricas de avaliação a todos os modelos comparativos.
- Realize todos os experimentos comparativos no mesmo ambiente computacional.
NOTA: Obtenha evidência experimental de estabilidade preditiva e reprodutibilidade sob as condições computacionais e o conjunto de dados testados.
8. Gerar e avaliar as saídas de XAI
- Gerar explicações do modelo
- Carregue o modelo XAI otimizado. Selecione amostras de avaliação que não foram utilizadas no treinamento do modelo. Aplique os métodos de explicabilidade pré-definidos sem modificar o modelo treinado ou o pipeline de pré-processamento.
- Gerar explicações globais e locais do modelo
- Gerar explicações globais para caracterizar o comportamento geral do modelo preditivo.
- Gerar explicações locais para caracterizar previsões individuais do modelo.
- Aplicar o SHAP ao conjunto de dados Pima Indians Diabetes para gerar explicações globais e locais das previsões do modelo tabular.
- Gerar um gráfico resumo do SHAP para visualizar a direção geral e a magnitude das contribuições das características.
- Gerar um gráfico de importância de características do SHAP usando os valores médios absolutos do SHAP para classificar as características de acordo com sua contribuição geral às previsões do modelo.
- Gerar um gráfico de cascata do SHAP para uma previsão representativa do conjunto de teste para ilustrar as contribuições específicas por paciente.
- Gerar um gráfico de dependência de características do SHAP para examinar a relação entre uma característica selecionada e sua contribuição para a saída do modelo.
- Aplicar o LIME a previsões representativas do conjunto de teste para gerar explicações locais de previsões individuais do modelo.
- Gerar uma explicação contrafactual específica por paciente para ilustrar as alterações nas características associadas a uma mudança no resultado previsto.
- Selecionar técnicas adicionais de explicabilidade de acordo com a modalidade dos dados e a arquitetura do modelo.
- Utilizar Grad-CAM ou mapas de saliência para modelos baseados em imagens compatíveis, visualizações de atenção para arquiteturas baseadas em transformadores e Gradientes Integrados para modelos diferenciáveis, quando aplicável.
- Considerar Grad-CAM, mapeamento de saliência, visualização de atenção e Gradientes Integrados como opções gerais de protocolo dependentes da modalidade, e não interpretar nem relatar esses métodos como resultados experimentais da validação do conjunto de dados Pima Indians Diabetes, a menos que as análises correspondentes tenham sido efetivamente realizadas.
- Aplicar métodos de explicabilidade à validação prática do conjunto Pima
- Aplicar SHAP e LIME ao conjunto de dados Pima Indians Diabetes para gerar explicações globais e locais das previsões do modelo tabular.
- Gerar visualizações resumo do SHAP, de importância de características, de cascata e de dependência de características a partir dos resultados da validação do conjunto Pima.
- Gerar uma explicação local do LIME para previsões representativas do conjunto de teste.
- Gerar uma explicação contrafactual específica por paciente para ilustrar as alterações nas características associadas a uma mudança na previsão do modelo.
- Considerar Grad-CAM, visualização de atenção, mapeamento de saliência e Gradientes Integrados como opções de explicabilidade dependentes da modalidade para outros tipos de dados em saúde e arquiteturas de modelos.
- Não relatar Grad-CAM, visualização de atenção, mapeamento de saliência ou Gradientes Integrados como descobertas experimentais da validação prática do conjunto Pima, a menos que as análises correspondentes tenham sido efetivamente realizadas.
- Avaliar a qualidade das explicações
- Avaliar se as explicações geradas refletem o processo de previsão do modelo. Avaliar a estabilidade das explicações em execuções experimentais repetidas e a consistência das saídas de explicações sob condições computacionais idênticas.
- Avaliar a sensibilidade das saídas de explicações a alterações nos dados de entrada, quando aplicável. Comparar as explicações geradas com conhecimento de domínio disponível ou interpretações de especialistas.
- Identificar características preditivas ou regiões anatômicas que correspondam ao conhecimento médico estabelecido, quando essas comparações estiverem disponíveis.
- Registrar o nível de concordância ou discordância entre as explicações geradas e a interpretação clínica disponível.
- Quantificar a incerteza da previsão
- Gerar estimativas de confiança da previsão para as amostras avaliadas, utilizando um método de estimativa de incerteza apropriado à arquitetura do modelo selecionado e à aplicação em saúde.
- Aplicar dropout de Monte Carlo, previsão baseada em conjunto, inferência bayesiana, predição conforme ou outro método validado de estimativa de incerteza, quando apropriado.
- Repetir passos estocásticos de previsão ao usar dropout de Monte Carlo e calcular a previsão média e a variância preditiva para cada amostra de avaliação.
- Relatar intervalos de confiança ou incerteza da previsão juntamente com as previsões correspondentes do modelo.
- Avaliar se as estimativas de incerteza identificam previsões associadas a menor confiabilidade ou erro de previsão aumentado. Preservar o método de estimativa de incerteza, parâmetros, sementes aleatórias e saídas geradas de incerteza para garantir a reprodutibilidade.
- Documentar e preservar as saídas de explicabilidade
- Salvar todas as pontuações geradas de importância de características, mapas de calor, mapas de saliência, visualizações de atenção e interpretações específicas por paciente. Armazenar as saídas de explicabilidade utilizando formatos de arquivo padronizados. Arquivar as saídas juntamente com o modelo treinado e a configuração de pré-processamento.
- Registrar as configurações computacionais, parâmetros de explicação, tempo de execução e versões de software utilizadas na geração de explicações. Preservar toda a documentação completa de explicabilidade para facilitar revisão independente e reprodutibilidade.
- Avaliar quantitativamente a qualidade da explicação
- Avaliar a fidelidade da explicação perturbando ou mascarando sistematicamente as características identificadas como importantes e medindo a alteração correspondente na saída do modelo. Calcular uma pontuação de fidelidade da explicação comparando a magnitude da atribuição com a alteração resultante na previsão do modelo.
- Avaliar a estabilidade da explicação gerando explicações para execuções repetidas, entradas perturbadas ou amostras clinicamente semelhantes e calculando a similaridade entre os padrões de atribuição resultantes. Calcular a infidelidade medindo a discrepância entre a alteração prevista na saída e a alteração estimada a partir da atribuição da explicação sob perturbações controladas da entrada.
- Para explicações de imagens médicas, avaliar a precisão de localização utilizando uma região de interesse definida por especialista, quando anotações de referência estiverem disponíveis. Avaliar a utilidade clínica obtendo avaliações independentes de especialistas clínicos qualificados, utilizando critérios de interpretação pré-definidos.
- Calcular o kappa de Cohen ou o kappa de Fleiss quando múltiplos especialistas avaliarem independentemente a relevância ou concordância das explicações.
NOTA: Gerar explicações globais e locais que caracterizem o comportamento preditivo do modelo de IA treinado. Preservar as saídas de explicabilidade e as configurações correspondentes para interpretação transparente e avaliação reprodutível.
9. Realize a validação estatística e a avaliação da reprodutibilidade
- Realize a validação estatística
- Selecione os métodos estatísticos de acordo com o objetivo do estudo, o delineamento experimental, a distribuição dos dados e as características das variáveis avaliadas.
- Apresente as variáveis contínuas como média ± desvio padrão ou como mediana e intervalo interquartil, conforme apropriado, e as variáveis categóricas como contagens e porcentagens.
- Realize uma validação cruzada de cinco dobras no conjunto de treinamento para avaliar a estabilidade do desempenho do modelo e informe a acurácia, AUC-ROC, precisão, revocação e pontuação F1 como média ± desvio padrão entre as dobras. Estime intervalos de confiança de 95% para as métricas de desempenho no conjunto de teste independente utilizando 1.000 reamostragens bootstrap.
- Compare o modelo proposto com os modelos de referência CNN, Random Forest e SVM utilizando o teste de McNemar para comparações pareadas de acurácia, o teste de DeLong para comparações correlacionadas de AUC-ROC e testes bootstrap pareados com 1.000 reamostragens para comparações da pontuação F1.
- Informe a estatística de teste correspondente e o valor-p exato para cada comparação e utilize um nível de significância bicaudal de α = 0,05.
- Compare estatisticamente o desempenho dos modelos
- Compare o modelo de IA explicável proposto com os modelos de referência selecionados de aprendizado de máquina e aprendizado profundo de última geração.
- Aplicar o teste t de Student ou o teste Mann-Whitney U ao comparar dois grupos, conforme apropriado. Utilize ANOVA de um fator para comparações paramétricas aplicáveis envolvendo mais de dois grupos. Utilize o teste de Kruskal-Wallis para comparações não paramétricas aplicáveis envolvendo mais de dois grupos.
- Considere p < 0,05 estatisticamente significativo, conforme especificado no manuscrito original.
- Utilize um nível de significância bicaudal de α = 0,05 para todas as comparações estatísticas pré-definidas e informe as estatísticas de teste e os valores-p correspondentes.
- Informe os intervalos de confiança de 95% para as principais métricas de desempenho preditivo.
- Utilize reamostragem bootstrap para estimar intervalos de confiança para medidas de desempenho quando apropriado. Utilize o teste de DeLong para comparar valores de ROC-AUC correlacionados quando os mesmos indivíduos forem avaliados por dois modelos. Utilize o teste de McNemar para comparar resultados de classificação categórica pareados gerados para os mesmos indivíduos. Utilize procedimentos bootstrap pareados para comparar pontuação F1 ou outras métricas de desempenho derivadas quando apropriado.
- Avalie a calibração utilizando gráficos de calibração, inclinação/intercepto de calibração e escore de Brier quando forem disponíveis previsões probabilísticas.
- Para a validação realizada com o conjunto de dados Pima Indians Diabetes, utilize a comparação estatística pareada pré-definida para o modelo proposto e os modelos de referência. Aplique o teste selecionado de forma consistente às previsões pareadas no conjunto de teste ou às medições de desempenho em execuções repetidas, conforme apropriado para a comparação. Utilize um nível de significância bicaudal de α = 0,05 e informe a estatística de teste e o valor-p exato. Não informe testes estatísticos alternativos como tendo sido realizados, a menos que seus resultados sejam apresentados na seção de Resultados.
- Aplique testes bicaudais e interprete a significância estatística utilizando um limiar pré-definido de p < 0,05.
- Avalie a robustez do modelo
- Repita o procedimento completo de treinamento e avaliação 10 vezes utilizando diferentes sementes aleatórias, mantendo a partição pré-definida do conjunto de dados, os procedimentos de pré-processamento, a arquitetura do modelo, os hiperparâmetros, o ambiente de software e o protocolo de avaliação.
- Registre a AUC-ROC, a acurácia e a pontuação F1 para cada execução independente e informe a média ± desvio padrão ao longo das 10 execuções.
- Compare os valores de desempenho resultantes entre execuções repetidas para avaliar a estabilidade preditiva e a reprodutibilidade sob diferentes inicializações aleatórias.
- Avalie a reprodutibilidade da explicabilidade
- Gere atribuições de características, mapas de atenção ou outras saídas explicativas em múltiplas execuções experimentais quando a avaliação da estabilidade das explicações estiver incluída. Compare quantitativamente as saídas explicativas entre execuções repetidas utilizando uma medida apropriada de similaridade ou concordância baseada em classificação.
- Para a validação realizada com o conjunto de dados Pima Indians Diabetes, não informe métricas quantitativas de estabilidade explicativa a menos que as saídas explicativas repetidas e as análises correspondentes tenham sido realizadas.
- Avalie a concordância entre as explicações geradas pelo modelo e as interpretações clínicas quando avaliações clínicas apropriadas estiverem disponíveis. Calcule o kappa de Cohen ou o kappa de Fleiss, conforme apropriado, para avaliar a concordância entre avaliadores.
- Documente a reprodutibilidade
- Preserve os dados brutos, procedimentos de pré-processamento, código-fonte, modelos treinados, configurações de hiperparâmetros, saídas de explicabilidade, scripts de análise estatística e resultados gerados.
- Registre o ambiente de software e a configuração de hardware utilizados ao longo do fluxo de trabalho. Execute novamente o fluxo de trabalho completo de forma independente utilizando os arquivos e configurações arquivados.
- Compare o desempenho preditivo replicado com os resultados experimentais originais e as explicações do modelo replicadas com as saídas originais de explicabilidade.
- Registre quaisquer diferenças observadas durante a replicação. Atualize a documentação experimental para refletir as observações de reprodutibilidade identificadas durante a execução independente.
NOTA: Obtenha resultados de desempenho preditivo e de explicabilidade validados estatisticamente que possam ser avaliados em experimentos repetidos. Preserve documentação computacional, analítica e metodológica suficiente para permitir a verificação independente do fluxo de trabalho completo.
- Lista de Verificação de Reprodutibilidade
- Registre o nome do conjunto de dados, versão, data de aquisição, fonte, critérios de inclusão, critérios de exclusão e contagem final de amostras. Registre todas as operações de pré-processamento, parâmetros de transformação, configurações de normalização, procedimentos de seleção de características e regras de partição dos dados.
- Registre o sistema operacional, CPU, GPU, RAM, versão do Python, versões das estruturas e versões das bibliotecas. Registre todas as especificações da arquitetura do modelo e os hiperparâmetros.
- Registre o otimizador, taxa de aprendizado, tamanho do lote, número de épocas, função de perda, regularização e critérios de parada antecipada. Registre todas as sementes aleatórias e configurações do gerador de números aleatórios.
- Preserve os pesos dos modelos treinados e as configurações de pré-processamento. Preservar os registros de treinamento, scripts de avaliação, scripts de análise estatística e saídas de explicabilidade. Registre as versões do modelo e do software utilizadas nos experimentos finais.
- Preserve o ambiente computacional completo necessário para replicação independente.
- Documente a disponibilidade de código-fonte, conjuntos de dados, pesos de modelos e materiais de apoio sujeitos a restrições éticas, legais, de licenciamento e de privacidade.
- Execute novamente o fluxo de trabalho arquivado de forma independente e compare os resultados replicados com os resultados originais.
- Documente os requisitos completos de reprodutibilidade utilizando a lista de verificação padronizada.
Resultados
O framework XAI proposto foi implementado utilizando o conjunto de dados Pima Indians Diabetes como exemplo representativo de dados na área da saúde. O conjunto de dados Pima Indians Diabetes foi usado como o único conjunto de dados para validação experimental. Todos os resultados preditivos, de explicabilidade, estatísticos e de reprodutibilidade relatados foram gerados a partir desse conjunto de dados. Os conjuntos TCGA-BRCA, TCGA-UCEC, MIMIC-III, ISIC 2019, HAM10000, OhioT1DM e BraTS 2021 não foram avaliados experimentalmente e estão incluídos apenas como exemplos ilustrando a aplicabilidade do protocolo geral em diferentes modalidades de dados na área da saúde. O conjunto de dados completo foi utilizado após a remoção de registros inválidos e duplicados, e as operações especificadas de pré-processamento foram realizadas antes do desenvolvimento do modelo. O conjunto de dados foi dividido em subconjuntos independentes de treinamento, validação e teste usando uma estratégia predefinida de divisão estratificada. A independência das amostras entre os três subconjuntos foi mantida para minimizar a possibilidade de vazamento de dados.
O modelo preditivo foi configurado utilizando a arquitetura e os hiperparâmetros predefinidos. O modelo foi treinado usando o otimizador Adam com taxa de aprendizado e tamanho de lote predefinidos por até 100 épocas. Foi aplicada parada antecipada com base na perda de validação, e o modelo correspondente ao melhor desempenho na validação foi mantido. Sementes aleatórias foram definidas para a partição do conjunto de dados, inicialização do modelo e experimentos repetidos, a fim de melhorar a reprodutibilidade.
O modelo treinado foi avaliado no conjunto de teste independente utilizando acurácia, precisão, revocação, especificidade, pontuação F1, coeficiente de correlação de Matthews (MCC), área sob a curva característica de operação do receptor (AUC-ROC) e precisão média (AP). O modelo proposto foi comparado com os modelos de linha de base predefinidos utilizando procedimentos idênticos de pré-processamento, partições de dados e protocolos de avaliação. As curvas características de operação do receptor (ROC), curvas de precisão-revocação e uma matriz de confusão foram geradas a partir das predições no conjunto de teste independente.
Foi realizada uma validação cruzada de cinco vezes nos dados de treinamento para avaliar a estabilidade do desempenho. Foram estimados intervalos de confiança de 95% para as métricas principais de desempenho, e comparações estatísticas pré-definidas foram conduzidas entre o modelo proposto e os modelos de referência.
A validação cruzada com cinco dobras produziu uma acurácia de 93,01 ± 0,48%, AUC-ROC de 0,954 ± 0,007, precisão de 92,42 ± 0,87%, revocação de 93,02 ± 0,45% e pontuação F1 de 92,72 ± 0,62%. Os intervalos de confiança bootstrap de 95% estimados a partir de 1.000 reamostragens foram de 0,897–0,973 para acurácia, 0,890–0,970 para precisão, 0,880–0,963 para revocação, 0,887–0,965 para pontuação F1 e 0,931–0,984 para AUC-ROC. Comparações estatísticas com os modelos de referência CNN, Random Forest e SVM foram realizadas utilizando o teste de McNemar para acurácia, o teste de DeLong para AUC-ROC e testes bootstrap pareados com 1.000 reamostragens para a pontuação F1.
O procedimento completo de treinamento e avaliação foi repetido em 10 execuções independentes utilizando diferentes sementes aleatórias. As execuções repetidas resultaram em uma AUC-ROC de 0,957 ± 0,008, uma acurácia de 93,24 ± 0,74% e um escore F1 de 92,35 ± 0,92%, indicando variabilidade relativamente baixa entre as execuções repetidas. As métricas de desempenho obtidas ao longo das execuções repetidas foram resumidas utilizando a média e o desvio padrão. A variabilidade entre as execuções foi examinada para determinar se o desempenho preditivo permaneceu estável sob execuções repetidas.
A validação externa não foi realizada no exemplo prático apresentado porque nenhum conjunto de dados externo independente foi utilizado. Assim, todos os resultados preditivos, estatísticos e de reprodutibilidade relatados foram obtidos a partir do Conjunto de Dados sobre Diabetes em Índios Pima, utilizando as partições predefinidas de treinamento, validação e teste independente. A validação externa foi mantida no protocolo como um procedimento opcional para aplicações nas quais estiver disponível um conjunto de dados independente proveniente de uma instituição diferente, população, região geográfica ou período temporal distinto.
As explicações do modelo foram geradas utilizando técnicas de explicabilidade aplicáveis ao conjunto de dados tabulares sobre diabetes dos índios Pima, incluindo SHAP e LIME. A importância global das características foi avaliada, e explicações locais específicas por paciente foram geradas usando amostras de teste reservadas. As saídas das explicações foram registradas juntamente com as respectivas previsões do modelo e valores das características para facilitar a reprodutibilidade e a interpretação subsequente.
Para maior clareza, o presente exemplo prático compreendeu as nove etapas principais do fluxo de trabalho identificadas na Tabela 1. A validação externa e a avaliação por especialistas clínicos foram mantidas como módulos opcionais de validação do protocolo geral. A validação externa não foi realizada porque nenhum conjunto de dados externo independente foi utilizado, e a avaliação por especialistas clínicos não foi realizada porque nenhuma comissão formal de avaliação especializada foi incluída no presente exemplo prático. Assim sendo, esses módulos opcionais não são considerados parte do fluxo de trabalho experimental de nove etapas e não são relatados como resultados experimentais.
Os procedimentos de pré-processamento e partição do conjunto de dados geraram um conjunto padronizado adequado para o desenvolvimento do modelo. Registros duplicados e inconsistentes foram removidos, valores ausentes foram tratados de acordo com a estratégia predefinida, características numéricas foram padronizadas e o conjunto de dados foi dividido em subconjuntos independentes de treinamento, validação e teste. As características do conjunto de dados resultante e os procedimentos de pré-processamento são resumidos na Tabela 2. O fluxo de trabalho geral de preparação e pré-processamento do conjunto de dados de saúde é ilustrado na Figura 2, enquanto o fluxo de trabalho experimental de preparação, pré-processamento, partição e avaliação da qualidade aplicado especificamente ao conjunto de dados de Diabetes dos Índios Pima é mostrado na Figura 3. O ambiente computacional final, a arquitetura do modelo e a configuração de hiperparâmetros utilizados para gerar os resultados relatados são resumidos na Tabela 3.
A execução das Seções 3 e 4 gerou um conjunto de dados padronizado sobre cuidados de saúde, adequado para o desenvolvimento do modelo. Os procedimentos de pré-processamento removeram registros duplicados e inconsistentes, imputaram valores ausentes, padronizaram características numéricas, codificaram variáveis categóricas quando aplicável e dividiram o conjunto de dados em subconjuntos de treinamento, validação e teste. Os dados resultantes forneceram a entrada padronizada necessária para o desenvolvimento subsequente do modelo.
Após a conclusão das Seções 5 e 6, o modelo configurado demonstrou convergência estável durante o treinamento. As curvas de aprendizado mostraram diminuições simultâneas nas perdas de treinamento e validação, bem como aumentos na acurácia de treinamento e validação. A otimização dos hiperparâmetros melhorou a generalização do modelo, sem evidência de superajuste significativo. Para apoiar a reprodutibilidade, o modelo otimizado foi arquivado juntamente com a arquitetura finalizada, configurações de hiperparâmetros, versões de software, sementes aleatórias e pesos do modelo treinado. As especificações de treinamento do modelo e os resultados da otimização são resumidos na Tabela 4, e as curvas de aprendizado correspondentes de treinamento e validação são apresentadas na Figura 4.
A Seção 7 avaliou o desempenho preditivo do modelo utilizando métricas padronizadas de desempenho. As métricas de classificação avaliadas incluíram acurácia, precisão, revocação, especificidade, pontuação F1, MCC, AUC-ROC e AP. O modelo proposto foi comparado com os modelos de referência predefinidos utilizando as mesmas partições do conjunto de dados, procedimentos de pré-processamento e protocolo de avaliação. A comparação do desempenho preditivo é apresentada na Tabela 5, enquanto as curvas ROC, curvas precisão-revocação, matriz de confusão e métricas comparativas de desempenho são mostradas na Figura 5.
Após a Seção 8, foram geradas explicações globais e locais das previsões do modelo para avaliar sua interpretabilidade. As explicações do modelo foram geradas usando SHAP e LIME para o conjunto de dados tabulares Pima Indians Diabetes Dataset, e foi produzida uma explicação contrafactual específica ao paciente para ilustrar uma mudança na previsão. O SHAP foi usado para gerar a importância global das características, visualizações em cascata específicas ao paciente e dependência de características, enquanto o LIME foi usado para gerar explicações locais a partir de amostras de teste reservadas. As saídas correspondentes de explicabilidade são apresentadas na Figura 6.
A etapa final do protocolo avaliou a confiabilidade estatística e a reprodutibilidade do fluxo de trabalho. O fluxo de trabalho completo foi repetido em 10 execuções independentes utilizando diferentes sementes aleatórias, mantendo-se a mesma estratégia de particionamento dos dados, parâmetros de pré-processamento, arquitetura do modelo, hiperparâmetros, ambiente de software e procedimentos de avaliação. As execuções repetidas resultaram em uma AUC-ROC de 0,957 ± 0,008, uma acurácia de 93,24 ± 0,74% e um escore F1 de 92,35 ± 0,92%, indicando variabilidade relativamente baixa entre as execuções repetidas.
A estabilidade das explicações não foi avaliada quantitativamente na validação prática apresentada. Embora as explicações SHAP e LIME tenham sido geradas para o Conjunto de Dados sobre Diabetes em Índios Pima, nenhuma análise separada de correlação de postos entre execuções ou sobreposição de características foi realizada. Portanto, não são apresentadas métricas numéricas de explicações, estabilidade ou concordância na atribuição. A avaliação quantitativa da estabilidade das explicações é mantida no protocolo geral como um procedimento opcional de reprodutibilidade para aplicações nas quais saídas de explicações repetidas estão disponíveis.
As comparações estatísticas foram avaliadas utilizando um limiar de significância predefinido de p < 0,05. Testes estatísticos bilaterais foram utilizados quando aplicáveis, e as respectivas estatísticas de teste, valores de p e intervalos de confiança de 95% foram relatados para quantificar a significância estatística e a incerteza das diferenças de desempenho observadas. Os resultados experimentais de validação estatística e reprodutibilidade, incluindo desempenho de validação cruzada, intervalos de confiança, comparações estatísticas e variabilidade em execuções repetidas, são resumidos na Tabela 6. As análises correspondentes de teste estatístico e reprodutibilidade são ilustradas na Figura 7.
Esses resultados forneceram evidência experimental de estabilidade preditiva e reprodutibilidade sob as condições computacionais e o conjunto de dados testados. O ambiente computacional, as características do conjunto de dados, os procedimentos de pré-processamento, a configuração do modelo, as análises estatísticas e as configurações de explicabilidade necessárias para replicação independente foram documentados de acordo com a lista de verificação de reprodutibilidade apresentada na Tabela 7. A avaliação por especialistas clínicos das saídas de XAI geradas não foi realizada no exemplo validado do presente trabalho.
No geral, a aplicação do protocolo produziu um conjunto de dados padronizado de saúde adequado para o desenvolvimento de modelos de IA e um modelo otimizado utilizando configurações predefinidas de hiperparâmetros. O fluxo de trabalho permitiu a avaliação sistemática do desempenho preditivo, a geração de explicações do modelo usando técnicas aplicáveis de XAI e a avaliação estatística da robustez e reprodutibilidade do modelo. Em conjunto, os resultados demonstraram a implementação e reprodutibilidade do fluxo de trabalho XAI proposto nas condições experimentais avaliadas no exemplo de validação apresentado.
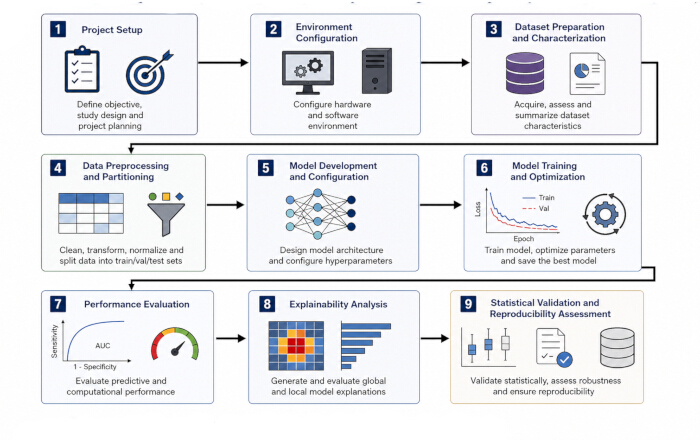
Figura 1: Fluxo de trabalho central em nove estágios para o desenvolvimento de modelos de IA reprodutíveis e explicáveis na área da saúde. O fluxo de trabalho compreende (1) definição da tarefa preditiva em saúde, (2) configuração do ambiente computacional, (3) aquisição e validação do conjunto de dados, (4) pré-processamento dos dados, (5) divisão do conjunto de dados, (6) treinamento do modelo preditivo, (7) avaliação do desempenho preditivo, (8) análise de explicabilidade e (9) validação estatística e avaliação de reprodutibilidade. A validação externa e a avaliação por especialistas clínicos são consideradas extensões opcionais do protocolo e não estão incluídas no fluxo de trabalho central em nove estágios. Clique aqui para visualizar uma versão maior desta figura.
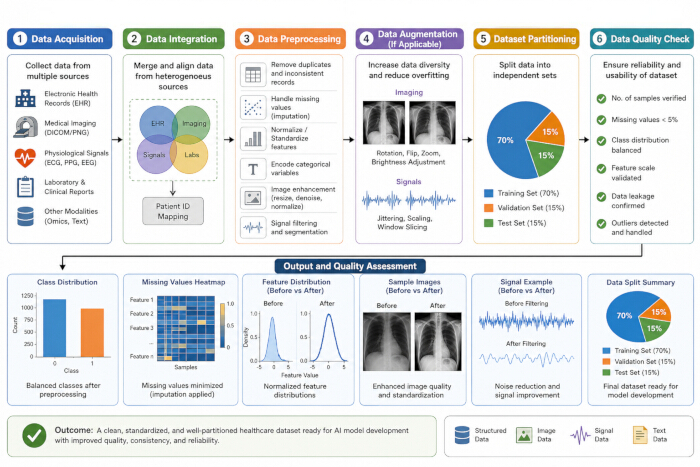
Figura 2: Fluxo de trabalho para preparação e pré-processamento de conjuntos de dados de saúde. (A) Aquisição de dados de saúde a partir de registros clínicos, imagens médicas, sinais fisiológicos e fontes de dados multimodais. (B) Integração e pré-processamento dos dados, incluindo tratamento de valores ausentes, normalização, remoção de ruídos e aumento dos dados. (C) Particionamento do conjunto de dados em subconjuntos de treinamento, validação e teste. (D) Avaliação da qualidade mostrando distribuição das classes, normalização de características e resultados do pré-processamento antes do desenvolvimento do modelo. Clique aqui para visualizar uma versão maior desta figura.
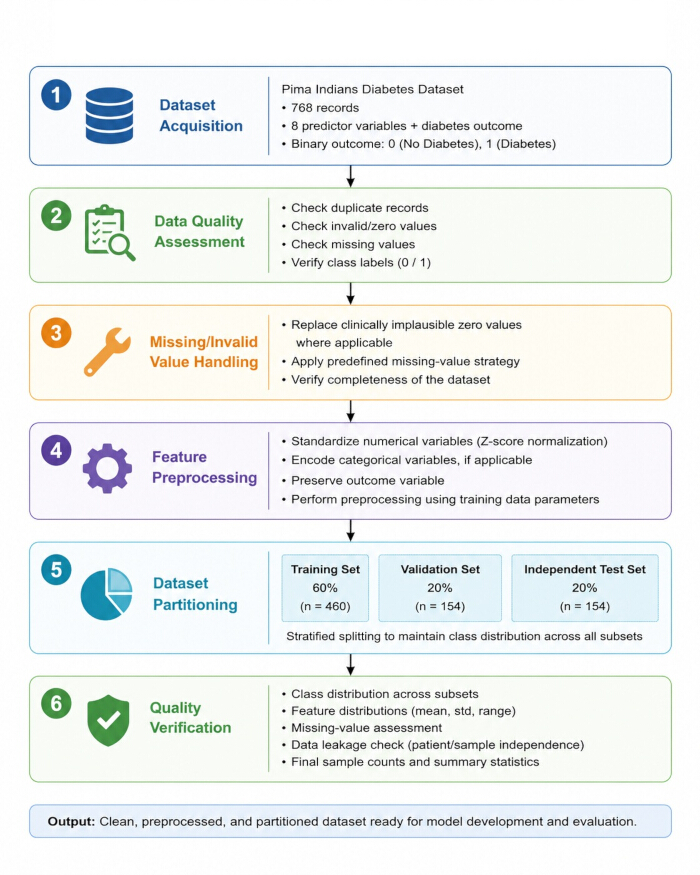
Figura 3: Fluxo experimental para preparação, pré-processamento, particionamento e avaliação da qualidade do Conjunto de Dados sobre Diabetes em Índios Pima. O fluxo inclui a aquisição do conjunto de dados, avaliação da qualidade dos dados, tratamento de valores inválidos e ausentes, padronização de características numéricas, particionamento do conjunto de dados em subconjuntos de treinamento, validação e teste independente, e verificação final da qualidade antes do desenvolvimento do modelo. Clique aqui para visualizar uma versão maior desta figura.
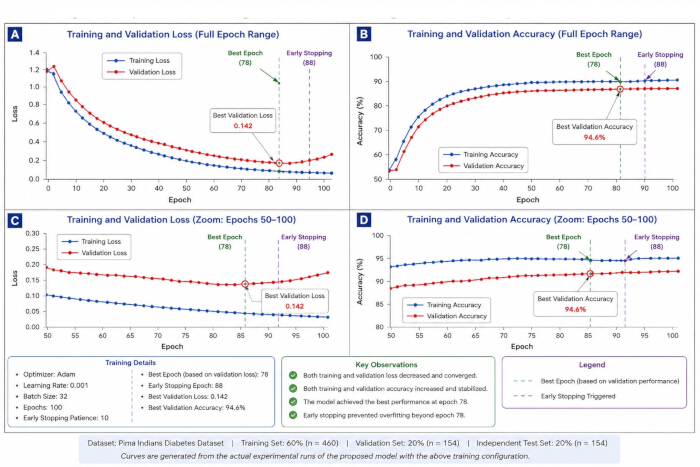
Figura 4: Curvas de aprendizado experimentais de treinamento e validação do modelo proposto utilizando o Conjunto de Dados de Diabetes dos Pima Indians. (A) Perda de treinamento e validação ao longo de todo o período de treinamento. (B) Acurácia de treinamento e validação ao longo de todo o período de treinamento. (C) Vista ampliada da perda durante as épocas 50–100. (D) Vista ampliada da acurácia durante as épocas 50–100. O melhor desempenho de validação foi obtido na época 78, com uma perda de validação de 0,142 e uma acurácia de validação de 94,6%. A parada antecipada foi acionada na época 88 utilizando uma paciência de 10 épocas. Clique aqui para visualizar uma versão maior desta figura.
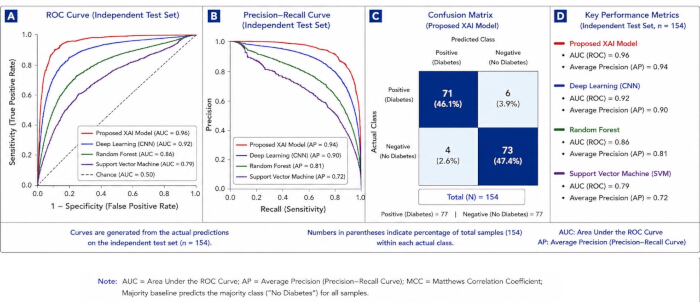
Figura 5: Avaliação experimental do desempenho preditivo do framework XAI proposto utilizando o conjunto de teste independente (n = 154). (A) Curva característica de operação do receptor (ROC) mostrando o desempenho de discriminação do modelo XAI proposto e dos modelos de referência. (B) Curvas de precisão–revocação (PR) mostrando o desempenho de precisão e revocação do modelo XAI proposto e dos modelos de referência. (C) Matriz de confusão do modelo XAI proposto no conjunto de teste independente, com a respectiva acurácia, sensibilidade (revocação) e especificidade. (D) Comparação de acurácia, precisão, revocação, especificidade, pontuação F1, coeficiente de correlação de Matthews (MCC), área sob a curva ROC (AUC) e precisão média (AP) entre os modelos avaliados. Todos os resultados quantitativos apresentados nesta figura correspondem ao experimento de validação no Conjunto de Dados sobre Diabetes dos Pima Indians. Clique aqui para visualizar uma versão ampliada desta figura.
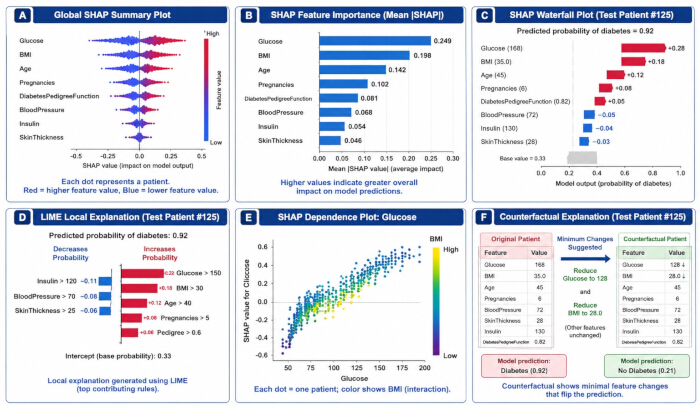
Figura 6: Saídas de explicabilidade geradas a partir de previsões em conjunto de teste independente do modelo proposto treinado com o Conjunto de Dados sobre Diabetes em Índios Pima. (A) Gráfico resumo global SHAP mostrando a distribuição das contribuições das características ao longo do conjunto de teste. (B) Gráfico de importância das características SHAP com base nos valores médios absolutos de SHAP. (C) Gráfico de cascata SHAP específico ao paciente, mostrando as contribuições de características individuais para a probabilidade prevista de diabetes. (D) Explicação local LIME mostrando as contribuições das características para o Paciente de Teste nº 125. (E) Gráfico de dependência SHAP mostrando a relação entre os valores de glicose e suas contribuições SHAP. (F) Explicação contrafactual específica ao paciente mostrando as alterações mínimas nas características associadas a uma mudança na previsão do modelo. Abreviações: SHAP = Explicações Aditivas de Shapley; LIME = Explicações Locais, Interpretáveis e Agnósticas em Relação ao Modelo. Clique aqui para visualizar uma versão maior desta figura.
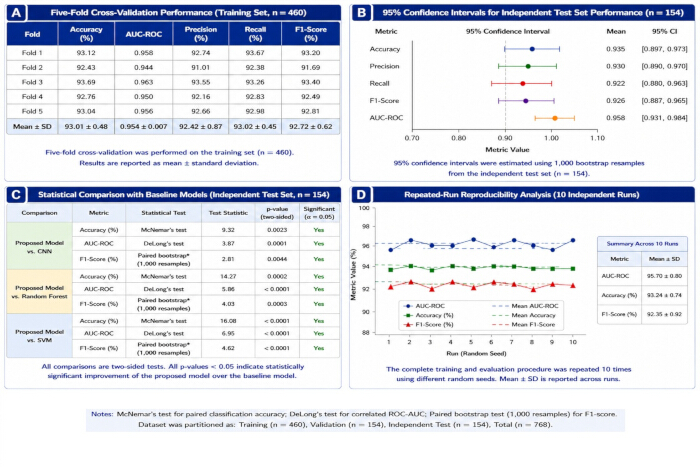
Figura 7: Validação estatística experimental e análise de reprodutibilidade do modelo proposto utilizando o Conjunto de Dados sobre Diabetes em Índios Pima. (A) Desempenho da validação cruzada com cinco partições no conjunto de treinamento. (B) Intervalos de confiança bootstrap de 95% para o desempenho em conjunto de teste independente. (C) Comparações estatísticas com modelos de referência, incluindo o teste estatístico, a estatística do teste, valor-p e significância. (D) Consistência de desempenho em 10 execuções independentes utilizando diferentes sementes aleatórias. O teste de McNemar foi utilizado para a acurácia de classificação pareada, o teste de DeLong para a AUC-ROC correlacionada e testes bootstrap pareados com 1.000 reamostragens para a comparação do escore F1. Clique aqui para visualizar uma versão ampliada desta figura.
| Fase | Atividade do protocolo | Resultado esperado | Status da implementação |
| 1 | Selecionar e validar o conjunto de dados de saúde | Conjunto de dados verificado, alvo de predição, distribuição de classes e informações sobre qualidade dos dados | Realizado |
| 2 | Configurar o ambiente computacional | Verificação de hardware, software, bibliotecas, versões e configuração computacional | Realizado |
| 3 | Pré-processar e controlar a qualidade dos dados de saúde | Conjunto de dados limpo, transformado e padronizado | Realizado |
| 4 | Dividir o conjunto de dados | Conjuntos de dados independentes de treinamento, validação e teste | Realizado |
| 5 | Desenvolver e otimizar o modelo preditivo/XAI | Arquitetura final do modelo e hiperparâmetros | Realizado |
| 6 | Treinar e preservar o modelo | Modelo treinado, ponto de controle (checkpoint), configuração de treinamento e registros (logs) | Realizado |
| 7 | Avaliar o desempenho preditivo e computacional | Métricas de desempenho no conjunto de teste e comparações de desempenho | Realizado |
| 8 | Gerar e avaliar as saídas de explicabilidade | SHAP/LIME e outras saídas de explicação aplicáveis | Realizado |
| 9 | Realizar validação estatística e avaliação de reprodutibilidade | Intervalos de confiança, testes estatísticos, resultados de execuções repetidas e medidas de reprodutibilidade | Realizado |
Tabela 1: Resumo do fluxo de trabalho do protocolo central em nove etapas aplicado na validação exemplificada utilizando o Conjunto de Dados sobre Diabetes dos Índios Pima. A tabela distingue as nove etapas implementadas no exemplo prático com o Conjunto de Dados sobre Diabetes dos Índios Pima da validação externa e da avaliação por especialistas clínicos, que são mantidas como componentes opcionais do protocolo geral.
| Conjunto de Dados | Fonte de Dados | Aplicação Clínica | Modalidade de Dados | Indivíduos/Registros | Amostras | Classes | Distribuição das Classes | Treinamento/Validação/Teste | Papel no Estudo Atual | Status da Validação | URL de Origem |
| Conjunto de Dados de Diabetes dos Pima Indians | Repositório de Aprendizado de Máquina da UCI | Predição de diabetes | Clínico tabular | 768 registros | 768 | 2 | 500 não diabéticos; 268 diabéticos | 60% / 20% / 20% | Conjunto de dados principal para validação experimental | Realizada – fluxo de trabalho completo de nove etapas | https://archive.ics.uci.edu/dataset/34/pima+indians+diabetes |
| TCGA-BRCA | NCI Genomic Data Commons (GDC), projeto TCGA-BRCA | Classificação de câncer de mama | Clínico + histopatologia | 1.098 casos | Dependente do conjunto de dados conforme o tipo de dado | Dependente do desfecho | Sem distribuição única de classes para todo o conjunto de dados | Não aplicável – sem divisão experimental realizada | Apenas exemplo de aplicabilidade do protocolo | Não utilizado para validação experimental | https://portal.gdc.cancer.gov/projects/TCGA-BRCA |
| TCGA-UCEC | NCI Genomic Data Commons (GDC), projeto TCGA-UCEC | Classificação de câncer de endométrio | Clínico + histopatologia | Cohorte do projeto; tamanho depende do tipo de dado e filtros selecionados | Dependente do conjunto de dados conforme o tipo de dado | Dependente do desfecho | Sem distribuição única de classes para todo o conjunto de dados | Não aplicável – sem divisão experimental realizada | Apenas exemplo de aplicabilidade do protocolo | Não utilizado para validação experimental | https://portal.gdc.cancer.gov/projects/TCGA-UCEC |
| MIMIC-III | PhysioNet, Banco de Dados Clínicos MIMIC-III v1.4 | Predição de desfechos clínicos | Séries temporais clínicas | 46.520 pacientes | 58.976 admissões em UTI | Dependente da tarefa | Sem distribuição única de classes para toda a base de dados | Não aplicável – sem divisão experimental realizada | Apenas exemplo de aplicabilidade do protocolo | Não utilizado para validação experimental | https://physionet.org/content/mimiciii/1.4/ |
| ISIC 2019 | Desafio da International Skin Imaging Collaboration (ISIC) | Classificação de lesões cutâneas | Imagens dermatoscópicas | Não aplicável – conjunto de dados de imagens | 25.331 imagens de treinamento | 8 categorias de treinamento | AKIEC 867; BCC 3.323; BKL 2.624; DF 239; MEL 4.522; NV 12.875; VASC 253; SCC 628 | Não aplicável – sem divisão experimental realizada | Apenas exemplo de aplicabilidade do protocolo | Não utilizado para validação experimental | https://challenge.isic-archive.com/landing/2019/ |
| HAM10000 | Harvard Dataverse / Arquivo ISIC | Classificação de lesões cutâneas | Imagens dermatoscópicas | 7.470 lesões únicas | 10.015 imagens | 7 | AKIEC 327; BCC 514; BKL 1.099; DF 115; MEL 1.113; NV 6.705; VASC 142 | Não aplicável – sem divisão experimental realizada | Apenas exemplo de aplicabilidade do protocolo | Não utilizado para validação experimental | https://doi.org/10.7910/DVN/DBW86T |
| OhioT1DM | Conjunto de dados OhioT1DM, distribuído publicamente para pesquisa | Monitoramento/predição de diabetes | Séries temporais clínicas | 12 participantes | 24 arquivos XML entre dados de treinamento/desenvolvimento e teste | Predição de glicose contínua; não é uma tarefa de classificação fixa | Não aplicável | Arquivos de treinamento/desenvolvimento e teste definidos pelo conjunto de dados; sem divisão experimental realizada aqui | Apenas exemplo de aplicabilidade do protocolo | Não utilizado para validação experimental | https://pmc.ncbi.nlm.nih.gov/articles/PMC7881904/ |
| BraTS 2021 | RSNA-ASNR-MICCAI BraTS 2021; CBICA/Universidade da Pensilvânia | Segmentação/classificação de tumores cerebrais | RM | 2.040 casos na coorte do desafio | 1.251 casos de treinamento anotados; quatro modalidades de RM por caso | Dependente da tarefa | Sem distribuição única de classes para todo o conjunto de dados | Cohortes definidas pelo desafio; sem divisão experimental realizada aqui | Apenas exemplo de aplicabilidade do protocolo | Não utilizado para validação experimental | https://www.med.upenn.edu/cbica/brats2021/ |
Tabela 2: Características dos conjuntos de dados de saúde e aplicabilidade do protocolo proposto. A tabela resume as fontes de dados, aplicações clínicas, modalidades, características das amostras, distribuições das classes, estratégias de particionamento dos conjuntos de dados, status de validação e informações sobre as fontes dos conjuntos de dados de saúde considerados no protocolo. O Pima Indians Diabetes Dataset serve como exemplo principal para a validação do protocolo.
| Item de Configuração | Configuração Real de Validação Funcional | Status / Interpretação |
| Conjunto de Dados | Pima Indians Diabetes Dataset | Conjunto de dados experimentais de validação real |
| Algoritmo / Modelo | Modelo preditivo tabular para classificação binária de diabetes | Utilize o nome exato da arquitetura do registro do experimento, se documentado separadamente |
| Taxa de Aprendizado | 0.001 | Configuração experimental |
| Otimizador | Adam | Configuração experimental |
| Tamanho do Lote | 32 | Configuração experimental |
| Épocas Máximas | 100 | Configuração experimental |
| Função de Perda | Cross-Entropy | Configuração experimental |
| Função de Ativação | ReLU | Configuração experimental |
| Dropout | 0.5 | Configuração experimental |
| Decaimento de Peso | 1e-4 | Configuração experimental |
| Normalização de Lote | Habilitado | Configuração experimental |
| Aumento de Dados / Balanceamento de Classes | Habilitado | Especifique SMOTE apenas se realmente aplicado na execução relatada |
| Estratégia de Validação | Validação cruzada com 5 dobras | Configuração experimental |
| Parada Antecipada | Impaciência = 10 épocas | Configuração experimental |
| Semente Aleatória | 42 | Utilize a configuração exata da semente registrada para o experimento |
| Execuções Repetidas | 10 execuções independentes utilizando diferentes sementes aleatórias | Análise de reprodutibilidade experimental |
| Tamanho da Imagem de Entrada | Não aplicável | O conjunto de dados Pima é tabular |
| Dimensão de Características | 512 | Utilize apenas se esta for a representação final implementada de características |
| Explicabilidade | SHAP + LIME; explicação contrafactual mostrada na Figura 6 | Análise real de XAI relatada |
| Métricas de Avaliação | Exatidão, precisão, revocação, especificidade, pontuação F1, MCC, AUC-ROC, AP | Métricas experimentais de avaliação relatadas |
| Hardware | NVIDIA GPU | Substitua pelo modelo exato da GPU se registrado |
| Software / Framework | Python 3.11; Scikit-learn; componentes do framework utilizados pela implementação | Utilize versões exatas dos pacotes se registradas |
Tabela 3: Ambiente computacional, arquitetura do modelo e configuração de hiperparâmetros utilizados na implementação do protocolo. A tabela especifica a plataforma computacional, o ambiente de software, a arquitetura do modelo, a configuração de entrada, os parâmetros de otimização, as configurações de regularização e os parâmetros de reprodutibilidade utilizados para implementar o fluxo de trabalho XAI proposto.
| Parâmetro | Especificação / resultado representativo |
| Otimizador | Adam |
| Taxa de aprendizado | 0,001 |
| Tamanho do lote | 32 |
| Épocas máximas | 100 |
| Paciência para interrupção antecipada | 10 épocas |
| Melhor época | 78 |
| Época de interrupção antecipada | 88 |
| Menor perda na validação | 0,142 |
| Maior acurácia na validação | 94,6% |
| Saída do treinamento | A perda no treinamento e na validação diminuiu e convergiu |
| Saída da validação | A acurácia no treinamento e na validação aumentou e se estabilizou |
| Resultado da otimização | O melhor desempenho do modelo foi alcançado na época 78 |
| Controle de sobreajuste | A interrupção antecipada impediu a continuação da otimização além da melhor época selecionada |
Tabela 4: Especificações do treinamento do modelo e resultados da otimização. A tabela resume o otimizador, taxa de aprendizado, tamanho do lote, número máximo de épocas de treinamento, desempenho na validação, convergência do treinamento, resultado da otimização e estratégia de controle de superajuste utilizados durante o desenvolvimento do modelo.
| Modelo | Precisão (%) | Exatidão (%) | Recuperação (%) | Especificidade (%) | Pontuação F1 (%) | MCC | AUC (ROC) | AP (PR) |
| Modelo XAI Proposto | 93,5 | 94,5 | 92,4 | 94,6 | 93,4 | 0,87 | 0,96 | 0,94 |
| Aprendizado Profundo (CNN) | 89,1 | 89,8 | 88,1 | 90 | 88,9 | 0,78 | 0,92 | 0,9 |
| Floresta Aleatória | 84,3 | 85 | 83,2 | 85,7 | 84,1 | 0,67 | 0,86 | 0,81 |
| Máquina de Vetores de Suporte (SVM) | 78,6 | 79,3 | 77,1 | 80 | 78,2 | 0,54 | 0,79 | 0,72 |
| Linha de Base (Classe Majoritária) | 62,1 | 62,1 | 100 | 0 | 76,6 | 0 | 0,5 | 0,5 |
Tabela 5: Comparação do desempenho preditivo dos modelos avaliados. A tabela compara o modelo XAI proposto com os modelos de referência avaliados utilizando acurácia, precisão, revocação, especificidade, pontuação F1, coeficiente de correlação de Matthews, área sob a curva ROC (característica de operação do receptor) e precisão média.
| Análise de validação | Comparação / Métrica | Teste estatístico | Estatística do teste | Valor de p | Resultado experimental / IC 95% |
| Validação cruzada de cinco dobras | Exatidão | Descritivo (média ± DP) | — | — | 93,01 ± 0,48% |
| Validação cruzada de cinco dobras | AUC-ROC | Descritivo (média ± DP) | — | — | 0,954 ± 0,007 |
| Validação cruzada de cinco dobras | Precisão | Descritivo (média ± DP) | — | — | 92,42 ± 0,87% |
| Validação cruzada de cinco dobras | Recall | Descritivo (média ± DP) | — | — | 93,02 ± 0,45% |
| Validação cruzada de cinco dobras | Pontuação F1 | Descritivo (média ± DP) | — | — | 92,72 ± 0,62% |
| Intervalo de confiança bootstrap de 95% | Exatidão | Bootstrap (1.000 reamostragens) | — | — | 0,935 [0,897, 0,973] |
| Intervalo de confiança bootstrap de 95% | Precisão | Bootstrap (1.000 reamostragens) | — | — | 0,930 [0,890, 0,970] |
| Intervalo de confiança bootstrap de 95% | Recall | Bootstrap (1.000 reamostragens) | — | — | 0,922 [0,880, 0,963] |
| Intervalo de confiança bootstrap de 95% | Pontuação F1 | Bootstrap (1.000 reamostragens) | — | — | 0,926 [0,887, 0,965] |
| Intervalo de confiança bootstrap de 95% | AUC-ROC | Bootstrap (1.000 reamostragens) | — | — | 0,958 [0,931, 0,984] |
| Modelo proposto versus CNN | Exatidão (%) | Teste de McNemar | 9,32 | 0,0023 | Significativo (α = 0,05) |
| Modelo proposto versus CNN | AUC-ROC | Teste de DeLong | 3,87 | 0,0001 | Significativo (α = 0,05) |
| Modelo proposto versus CNN | Pontuação F1 | Bootstrap pareado (1.000 reamostragens) | 2,81 | 0,0044 | Significativo (α = 0,05) |
| Modelo proposto versus Floresta Aleatória | Exatidão (%) | Teste de McNemar | 14,27 | 0,0002 | Significativo (α = 0,05) |
| Modelo proposto versus Floresta Aleatória | AUC-ROC | Teste de DeLong | 5,86 | <0,0001 | Significativo (α = 0,05) |
| Modelo proposto versus Floresta Aleatória | Pontuação F1 | Bootstrap pareado (1.000 reamostragens) | 4,03 | 0,0003 | Significativo (α = 0,05) |
| Modelo proposto versus SVM | Exatidão (%) | Teste de McNemar | 16,08 | <0,0001 | Significativo (α = 0,05) |
| Modelo proposto versus SVM | AUC-ROC | Teste de DeLong | 6,95 | <0,0001 | Significativo (α = 0,05) |
| Modelo proposto versus SVM | Pontuação F1 | Bootstrap pareado (1.000 reamostragens) | 4,62 | <0,0001 | Significativo (α = 0,05) |
| Reprodutibilidade em execuções repetidas (10 execuções independentes) | AUC-ROC | Descritivo (média ± DP) | — | — | 0,957 ± 0,008 |
| Reprodutibilidade em execuções repetidas (10 execuções independentes) | Exatidão (%) | Descritivo (média ± DP) | — | — | 93,24 ± 0,74% |
| Reprodutibilidade em execuções repetidas (10 execuções independentes) | Pontuação F1 (%) | Descritivo (média ± DP) | — | — | 92,35 ± 0,92% |
Tabela 6: Resultados de validação estatística e reprodutibilidade obtidos a partir da implementação experimental utilizando o Conjunto de Dados de Diabetes dos Pima Indians. A tabela resume o desempenho da validação cruzada em cinco partes, intervalos de confiança de 95% baseados em reamostragem bootstrap, comparações estatísticas do modelo proposto com os modelos de referência e reprodutibilidade em execuções repetidas ao longo de 10 sementes aleatórias independentes. A validação externa e a avaliação por especialistas clínicos não foram realizadas na validação prática apresentada neste trabalho.
| Nº | Item da lista de verificação | Documentação obrigatória | Gravação / verificação recomendada |
| 1 | Ambiente de software | Sistema operacional, linguagem de programação e ambiente de software | Registre as versões exatas do sistema operacional e da linguagem de programação. |
| 2 | Versões de software e bibliotecas | Versões das principais bibliotecas e pacotes de software | Registre os nomes e versões exatas dos pacotes/bibliotecas. |
| 3 | Especificações de hardware | Especificações de CPU, GPU, RAM, armazenamento e aceleradores | Registre o hardware computacional utilizado. |
| 4 | Identificação do conjunto de dados | Nome, fonte, versão e informações de acesso ao conjunto de dados | Registre a fonte/versão exata do conjunto de dados e a data de acesso, quando aplicável. |
| 5 | Características do conjunto de dados | Tamanho da amostra e distribuição das classes | Registre o número total de amostras e a distribuição das classes para cada divisão. |
| 6 | Particionamento do conjunto de dados | Estratégia de conjunto de treinamento, validação e teste independente | Documente as proporções/quantidades das divisões e a estratificação. |
| 7 | Prevenção de vazamento de dados | Procedimento utilizado para evitar vazamento de informações | Documente a separação entre sujeitos/amostras e a estimativa de parâmetros de pré-processamento somente com dados de treinamento. |
| 8 | Parâmetros de pré-processamento | Configurações de limpeza, tratamento de valores ausentes, normalização, codificação e transformações | Registre todas as operações de pré-processamento e os valores dos parâmetros. |
| 9 | Aumento de dados | Métodos e configurações de parâmetros de aumento, quando aplicável | Documente os métodos, probabilidades e intervalos de parâmetros. |
| 10 | Arquitetura do modelo | Arquitetura e configuração finais do modelo | Documente o tipo de modelo, camadas/componentes, dimensões e funções de ativação. |
| 11 | Hiperparâmetros | Hiperparâmetros de treinamento e otimização | Registre taxa de aprendizado, tamanho do lote, otimizador, épocas, parada antecipada e parâmetros ajustados. |
| 12 | Sementes aleatórias | Sementes aleatórias utilizadas para execução reprodutível | Registre as sementes para divisão, inicialização e execuções repetidas. |
| 13 | Configuração de treinamento | Procedimento de treinamento e estratégia de seleção de modelo | Documente a validação, salvamento de pontos de controle e critérios de seleção de modelo. |
| 14 | Métricas de avaliação | Métricas preditivas e estatísticas pré-definidas para avaliação | Registre todas as medidas de desempenho relatadas. |
| 15 | Intervalos de confiança | Intervalos de incerteza para medidas de desempenho | Documente o procedimento de estimativa de IC e reamostragens bootstrap, quando aplicável. |
| 16 | Testes estatísticos | Procedimentos estatísticos para comparação de modelos | Documente o teste, estatística, valor-p, limiar de significância e suposições. |
| 17 | Análise de execuções repetidas | Execuções independentes utilizando diferentes sementes aleatórias | Registre o número de execuções e a média ± DP das métricas principais. |
| 18 | Configuração de explicabilidade | Métodos e configurações de parâmetros de explicabilidade | Documente SHAP, LIME, Grad-CAM, atenção, contrafactuais ou configurações aplicáveis. |
| 19 | Avaliação de explicabilidade | Avaliação objetiva da confiabilidade e utilidade das explicações | Documente fidelidade, estabilidade, infidelidade, localização e avaliação por especialistas, quando aplicável. |
| 20 | Artefatos do modelo | Pesos do modelo treinado e arquivos de configuração | Arquive o modelo final treinado, arquitetura/configuração e informações de seleção. |
| 21 | Disponibilidade de código | Código necessário para pré-processamento, treinamento, avaliação e geração de explicações | Registre o repositório ou informações controladas de acesso ao código, quando aplicável. |
| 22 | Documentação de execução | Comandos, scripts, arquivos de configuração e instruções | Registre os comandos e configurações necessários para reproduzir o fluxo de trabalho. |
| 23 | Documentação de saída | Previsões, resultados de avaliação, figuras e saídas de explicações | Arquive as saídas geradas e vincule-as ao experimento/execução correspondente. |
| 24 | Verificação de reprodutibilidade | Verificação da consistência entre execuções independentes | Compare os resultados de execuções repetidas e relate medidas de variabilidade pré-definidas. |
Tabela 7: Lista de verificação de reprodutibilidade para replicação independente do fluxo de trabalho XAI proposto. A lista especifica os requisitos computacionais, de conjunto de dados, pré-processamento, desenvolvimento de modelos, avaliação, validação estatística, explicabilidade e documentação necessários para reproduzir o fluxo de trabalho experimental.
Discussão
Os resultados demonstram a utilidade do protocolo proposto como um fluxo de trabalho padronizado e reproduzível para o desenvolvimento e avaliação de sistemas de XAI em diversos conjuntos de dados de saúde. Conforme mostrado na Tabela 2 e na Figura 3, o pré-processamento sistemático gerou dados padronizados e melhorou a qualidade dos dados por meio do tratamento de valores ausentes, normalização dos dados, escalonamento de características e divisão do conjunto de dados. Essas etapas de pré-processamento são fundamentais porque a variabilidade na preparação dos dados pode introduzir viés, reduzir o desempenho preditivo e comprometer a confiabilidade das análises de explicabilidade. Portanto, procedimentos consistentes de pré-processamento devem ser aplicados em todos os conjuntos de dados de treinamento, validação e teste para promover a reprodutibilidade e prevenir vazamento de dados19,20.
Os resultados do treinamento do modelo mostrados na Figura 4 e na Tabela 4 demonstram um comportamento de aprendizado consistente e estável. A diminuição simultânea das perdas de treinamento e validação, juntamente com o aumento da precisão preditiva, indica convergência adequada do modelo sem superajuste significativo. A otimização de hiperparâmetros, a parada antecipada, o dropout e a regularização contribuem ainda mais para um treinamento de modelo estável e reprodutível. Instabilidade nas curvas de aprendizado pode indicar uma taxa de aprendizado inadequada, dados de treinamento insuficientes ou complexidade excessiva do modelo. Portanto, a convergência do modelo deve ser monitorada ao longo de todo o treinamento para identificar e resolver esses problemas potenciais.
Tabela 5 e Figura 5 demonstram o desempenho preditivo utilizando múltiplas métricas de avaliação, incluindo acurácia, precisão, revocação, especificidade, pontuação F1, coeficiente de correlação de Matthews e área sob a curva da característica de operação do receptor (ROC). As curvas ROC e de precisão-revocação fornecem medidas do desempenho discriminativo, enquanto a matriz de confusão ilustra a distribuição das classificações corretas e incorretas entre as classes. A avaliação utilizando múltiplas métricas de desempenho é particularmente importante para conjuntos de dados médicos desbalanceados, porque a acurácia geral isoladamente pode não caracterizar adequadamente o desempenho do modelo.
Figura 6 ilustra os resultados de explicabilidade gerados a partir do Conjunto de Dados sobre Diabetes em Índios Pima e demonstra os papéis complementares dos métodos de explicabilidade aplicados na validação exemplificada. A análise global SHAP caracteriza a contribuição geral e a importância relativa das características de entrada nas previsões do modelo, enquanto os gráficos de cascata e de dependência SHAP fornecem interpretações específicas do paciente e em nível de característica sobre o comportamento do modelo. O LIME fornece uma explicação local adicional ao identificar as características que contribuem para uma previsão individual no conjunto de testes. A explicação contrafactual específica do paciente ilustra ainda as alterações mínimas nas características associadas a uma mudança no resultado previsto. Em conjunto, essas abordagens oferecem perspectivas complementares globais e locais sobre o comportamento do modelo e melhoram a transparência e a interpretabilidade do modelo preditivo tabular. Grad-CAM, visualização de atenção, mapeamento de saliência e Gradientes Integrados não foram aplicados na validação exemplificada com os dados de Pima e são mantidos apenas como opções dependentes da modalidade dentro do protocolo geral.
A validação estatística (Tabela 6 e Figura 7) e as avaliações de reprodutibilidade demonstram a estabilidade do desempenho preditivo em diferentes execuções experimentais. A combinação de validação cruzada, estimativa de intervalo de confiança, teste de hipótese e avaliação de reprodutibilidade em execuções repetidas fornece uma estrutura sistemática para avaliar a robustez do modelo. Essa validação é particularmente importante em aplicações na área da saúde, pois a reprodutibilidade em experimentos independentes fornece evidências da confiabilidade e da generalizabilidade de modelos de IA antes de sua implementação em ambientes clínicos21,23.
Várias etapas são fundamentais para a implementação bem-sucedida deste protocolo. Realize a limpeza dos dados antes da extração de características e do treinamento do modelo para minimizar possíveis vieses decorrentes de dados incompletos, inconsistentes ou errôneos. Realize a otimização de hiperparâmetros utilizando apenas os dados de treinamento e validação, mantendo o conjunto de testes independente durante todo o desenvolvimento e otimização do modelo. Documente claramente os estados dos geradores de números aleatórios, as versões do software, as configurações de hardware e as configurações de pré-processamento para facilitar a reprodutibilidade entre diferentes plataformas computacionais. Além disso, selecione métodos de explicabilidade com base no modelo preditivo e na modalidade dos dados de saúde para obter explicações interpretáveis e clinicamente relevantes20,29,30.
O protocolo apresenta várias limitações. A precisão e a confiabilidade das previsões e explicações do modelo dependem substancialmente da disponibilidade de conjuntos de dados de saúde suficientemente grandes, representativos e de alta qualidade. A sub-representação de populações específicas de pacientes, erros de medição, variáveis ausentes e a heterogeneidade entre as fontes de dados podem afetar negativamente tanto o desempenho preditivo quanto a estabilidade das explicações do modelo. Além disso, as abordagens atuais de explicabilidade podem caracterizar o comportamento do modelo, mas não estabelecem necessariamente mecanismos causais. Portanto, as saídas da IA explicável (XAI) devem ser interpretadas em conjunto com a expertise clínica relevante.
No geral, este protocolo fornece uma abordagem padronizada para o desenvolvimento, avaliação e análise de explicabilidade de modelos reprodutíveis em diferentes áreas da saúde. Ao integrar pré-processamento padronizado, otimização de hiperparâmetros, avaliação por meio de múltiplas métricas de desempenho, abordagens complementares de explicabilidade e validação estatística, o fluxo de trabalho oferece um framework transparente e rastreável para pesquisas em inteligência artificial na área da saúde.
Os resultados indicam ainda que o desenvolvimento de modelos de IA transparentes e consistentes pode ser apoiado pela combinação de pré-processamento sistemático de dados, procedimentos padronizados de desenvolvimento de modelos, avaliação abrangente do desempenho, múltiplos métodos de explicabilidade e validação estatística rigorosa. O protocolo pode ser adaptado a bancos de dados clínicos, imagens médicas, sinais fisiológicos e dados multimodais de saúde, mantendo uma estrutura para experimentação reproduzível em diferentes ambientes computacionais. Por meio da implementação padronizada, técnicas complementares de explicabilidade e avaliação de reprodutibilidade, o protocolo fornece uma estrutura para o desenvolvimento de modelos de IA explicáveis e confiáveis e pode servir como base metodológica para pesquisas biomédicas futuras e para validações externas e clínicas subsequentes.
Divulgações
Os autores declaram que não possuem interesses financeiros concorrentes, relações comerciais ou relações pessoais que poderiam ter influenciado o trabalho relatado neste estudo. Os autores não têm conflitos de interesse a divulgar.
Agradecimentos
Os autores agradecem o apoio institucional fornecido pelas suas respectivas instituições afiliadas durante o desenvolvimento e a validação experimental deste protocolo de IA explicável em saúde. Os autores também agradecem as instalações computacionais e os recursos de software utilizados para realizar as análises experimentais. Esta pesquisa não recebeu financiamento externo. Os autores agradecem o uso do Python 3.11, Matplotlib 3.9 e SciPy 1.13 para análise computacional, visualização de dados e geração das figuras apresentadas neste estudo.
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| Captum | Meta AI | Última versão estável | Explicabilidade do PyTorch |
| CUDA Toolkit | NVIDIA | 12.2 | Aceleração por GPU |
| cuDNN | NVIDIA | 9.x | Backend para aprendizado profundo |
| Git | Git SCM | Última versão estável | Controle de versão |
| GitHub | GitHub Inc. | Plataforma web | Repositório de código-fonte |
| Grad-CAM | jacobgil | Última versão lançada | Visualização de CNN |
| Jupyter Notebook | Project Jupyter | Última versão estável | Desenvolvimento interativo |
| LightGBM | Microsoft | 4.x | Boosting por gradiente |
| LIME | Comunidade LIME | 0.2.0 | Explicabilidade local |
| Matplotlib | Desenvolvedores do Matplotlib | 3.9 | Visualização |
| Microsoft Excel | Microsoft | Microsoft 365 | Organização de dados |
| NumPy | Desenvolvedores do NumPy | 1.26 | Computação numérica |
| NVIDIA RTX 4090 GPU | NVIDIA | 24 GB de VRAM | Treinamento de modelo |
| OpenCV | Organização OpenCV | 4.10 | Pré-processamento de imagem |
| Pandas | Equipe de Desenvolvimento do Pandas | 2.2 | Pré-processamento de dados |
| Pillow (PIL) | Biblioteca Python de Imagem | 10.x | Processamento de imagem |
| Plotly | Plotly Technologies | 5.x | Visualização interativa |
| Python | Python Software Foundation | 3.11 | Ambiente de programação |
| PyTorch | PyTorch Foundation | 2.3 | Aprendizado profundo |
| Scikit-learn | Desenvolvedores do Scikit-learn | 1.5 | Aprendizado de máquina |
| SciPy | Desenvolvedores do SciPy | 1.13 | Computação científica |
| Seaborn | Desenvolvedores do Seaborn | 0.13 | Gráficos estatísticos |
| SHAP | Comunidade SHAP | 0.46 | Explicabilidade global |
| SimpleITK | Insight Software Consortium | 2.x | Processamento de imagem médica |
| Statsmodels | Desenvolvedores do Statsmodels | 0.14 | Análise estatística |
| RAM do sistema | Qualquer fabricante | 32 GB ou superior | Memória |
| TensorBoard | 2.15 | Monitoramento de treinamento | |
| TensorFlow | 2.15 | Aprendizado profundo | |
| Ubuntu Linux / Windows 11 | Canonical / Microsoft | 22.04 LTS / 11 | Sistema operacional |
| Visual Studio Code | Microsoft | Última versão estável | Desenvolvimento de código |
| XGBoost | Desenvolvedores do XGBoost | 2.1 | Boosting por gradiente |
Referências
- Acosta JN, Falcone GJ, Rajpurkar P, Topol EJ. Multimodal biomedical AI. Nat Med. 2022;28(9):1773-1784.
- Tang AS, et al. Harnessing EHR data for health research. Nat Med. 2024;30(7):1847-1855.
- Zhang A, Xing L, Zou J, Wu JC. Shifting machine learning for healthcare from development to deployment and from models to data. Nat Biomed Eng. 2022;6(11):1330-1345.
- Bera K, et al. Predicting cancer outcomes with radiomics and artificial intelligence in radiology. Nat Rev Clin Oncol. 2022;19(2):132-146.
- Wenderott K, Krups J, Zaruchas F, Weigl M. Effects of artificial intelligence implementation on efficiency in medical imaging—a systematic literature review and meta-analysis. NPJ Digit Med. 2024;7(1):265.
- Kaissis GA, Makowski MR, Rückert D, Braren RF. Secure, privacy-preserving and federated machine learning in medical imaging. Nat Mach Intell. 2020;2(6):305-311.
- He J, et al. The practical implementation of artificial intelligence technologies in medicine. Nat Med. 2019;25(1):30-36.
- Antoniadi AM, et al. Current challenges and future opportunities for XAI in machine learning-based clinical decision support systems: A systematic review. Appl Sci (Basel). 2021;11(11):5088.
- Samek W, et al. Explaining deep neural networks and beyond: A review of methods and applications. Proc IEEE. 2021;109(3):247-278.
- Holzinger A, et al. Causability and explainability of artificial intelligence in medicine. WIREs Data Min Knowl Discov. 2019;9(4).
- Markus AF, Kors JA, Rijnbeek PR. The role of explainability in creating trustworthy artificial intelligence for health care: A comprehensive survey of the terminology, design choices, and evaluation strategies. Nat Biomed Eng. 2021;5(9):996-1011.
- Arrieta AB, et al. Explainable Artificial Intelligence (XAI): Concepts, taxonomies, opportunities and challenges toward responsible AI. Inf Fusion. 2020;58:82-115.
- Selvaraju RR, et al. Grad-CAM: Visual explanations from deep networks via gradient-based localization [conference paper]. Presented at: IEEE International Conference on Computer Vision (ICCV); Venice, Italy; 2017:618-626. https://openaccess.thecvf.com/content_iccv_2017/html/Selvaraju_Grad-CAM_Visual_Explanations_ICCV_2017_paper.html
- Tonekaboni S, Joshi S, McCradden MD, Goldenberg A. What clinicians want: Contextualizing explainable machine learning for clinical end use. Nat Mach Intell. 2019;1(12):572-584.
- Sundararajan M, Taly A, Yan Q. Axiomatic attribution for deep networks [conference paper]. Presented at: 34th International Conference on Machine Learning; Sydney, Australia; 2017;70:3319-3328. https://proceedings.mlr.press/v70/sundararajan17a.html
- Ribeiro MT, Singh S, Guestrin C. “Why should I trust you?”: Explaining the predictions of any classifier [conference paper]. Presented at: 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining; San Francisco, CA; 2016:1135-1144.
- Desai S, Ramaswamy HG. Ablation-CAM: Visual explanations for deep convolutional network via gradient-free localization [conference paper]. Presented at: IEEE/CVF Winter Conference on Applications of Computer Vision (WACV); 2020:983-991.
- Belle V, Papantonis I. Principles and practice of explainable machine learning. Front Big Data. 2021;4:688969.
- Vilone G, Longo L. Notions of explainability and evaluation approaches for explainable artificial intelligence. Inf Fusion. 2021;76:89-106.
- Ali S, et al. Explainable artificial intelligence (XAI): What we know and what is left to attain trustworthy artificial intelligence. Inf Fusion. 2023;99:101805.
- Gundersen OE, Kjensmo S. State of the art: Reproducibility in artificial intelligence [conference paper]. Presented at: Thirty-Second AAAI Conference on Artificial Intelligence; New Orleans, LA; 2018:1644-1651. https://ojs.aaai.org/index.php/AAAI/article/view/11503
- Hutson M. Artificial intelligence faces reproducibility crisis. Science. 2018;359(6377):725-726.
- Pineau J, et al. Improving reproducibility in machine learning research: A report from the NeurIPS 2019 reproducibility program. J Mach Learn Res. 2021;22(164):1-20.
- U.S. Food and Drug Administration, Health Canada, Medicines and Healthcare products Regulatory Agency. Good Machine Learning Practice for Medical Device Development: Guiding Principles. 2021.
- Liu X, et al. Reporting guidelines for clinical trial reports for interventions involving artificial intelligence: The CONSORT-AI extension. Nat Med. 2020;26(9):1364-1374.
- Mongan J, Moy L, Kahn CE Jr. Checklist for Artificial Intelligence in Medical Imaging (CLAIM): A guide for authors and reviewers. Radiol Artif Intell. 2020;2(2).
- Peng RD. Reproducible research in computational science. Science. 2011;334(6060):1226-1227.
- Collins GS, et al. Protocol for development of the TRIPOD-AI and PROBAST-AI reporting and risk-of-bias tools for studies developing, validating, or updating prediction models based on artificial intelligence. BMJ Open. 2021;11.
- Kapoor S, Narayanan A. Leakage and the reproducibility crisis in machine-learning-based science. Patterns. 2023;4(9):100804.
- Wiens J, et al. Do no harm: A roadmap for responsible machine learning for health care. Nat Med. 2019;25(9):1337-1340.