Análises integradas de transcriptômica em grupo e de célula única identificaram seis biomarcadores diagnósticos relacionados ao metabolismo do heme para queloides. A validação experimental apoiou a desregulação do receptor 1 do vírus da leucemia felina do subgrupo C (FLVCR1) em fibroblastos de queloides, enquanto o encaixe molecular identificou a (+)-galocatequina como um composto potencialmente interativo com FLVCR1, exigindo investigação funcional adicional.
Artigo de investigação
Identificação de Biomarcadores Relacionados ao Metabolismo do Heme em Queloides Utilizando Análise Transcriptômica e Fibroblastos Humanos Cultivados
Neste artigo
Resumo
Resumo
O quelóide é uma desordem fibroproliferativa com alta recorrência e patogênese pouco clara, que carece de alvos terapêuticos eficazes. Evidências recentes sugerem que a reprogramação metabólica, particularmente no metabolismo do heme, pode impulsionar a fibrose. Este estudo investiga o papel do metabolismo do heme, com foco no receptor 1 do vírus da leucemia felina do subgrupo C (FLVCR1), na patogênese do quelóide e explora seu potencial diagnóstico e terapêutico. Analisamos conjuntos de dados de RNA-seq em massa e dados de RNA-seq de célula única (scRNA-seq). Modelos de expressão diferencial, operador de seleção e encolhimento absoluto mínimo (LASSO) e floresta aleatória (RF) identificaram biomarcadores diagnósticos relacionados ao metabolismo do heme. Foram realizadas análises de infiltração imune, mapeamento de células únicas, construção de rede de microRNA (miRNA) e acoplamento molecular com compostos da medicina tradicional chinesa. Seis biomarcadores relacionados ao metabolismo do heme foram identificados, formando um nomograma diagnóstico com alta precisão. O FLVCR1, enriquecido em células endoteliais e melanócitos, apresentou correlação negativa com células T auxiliares foliculares, sugerindo uma interação imunometabólica. A análise da rede reguladora de miRNA revelou cinco miRNAs que co-destinam todos os seis biomarcadores. O acoplamento molecular identificou a (+)-galocatequina como ligante do FLVCR1 com alta afinidade. Esses achados sugerem uma associação entre o metabolismo do heme relacionado ao FLVCR1 e alterações imunes na patogênese do quelóide. O painel de biomarcadores mostrou potencial diagnóstico exploratório, e a (+)-galocatequina foi identificada como um composto candidato que interage com o FLVCR1, necessitando de validação adicional. Este estudo redefine o quelóide dentro do espectro metabo-fibrótico e propõe a intervenção metabólico-imunológica como uma nova estratégia terapêutica.
Introdução
Cicatriz quelóide, uma desordem fibroproliferativa caracterizada pelo depósito excessivo de matriz extracelular que se estende para além dos limites da lesão cutânea original, afeta de 4 a 16% da população mundial, com prevalência significativamente maior entre indivíduos de origem africana, asiática e hispânica1,2. Apesar de sua natureza histologicamente benigna, a quelóide impõe consideráveis ônus físicos e psicossociais por meio de prurido persistente, dor, contratura funcional e desfiguração estética. As modalidades terapêuticas atuais, incluindo corticosteroides intralesionais, excisão cirúrgica, radioterapia e terapia a laser, permanecem subótimas, com taxas de recorrência superiores a 50% após monoterapia3,4,5. Esse impasse terapêutico evidencia uma lacuna fundamental em nosso entendimento da patogênese da quelóide, particularmente em relação aos fatores iniciais que desencadeiam e sustentam a cascata fibrótica para além da sinalização pró-fibrótica canônica.
A pesquisa contemporânea tem se concentrado predominantemente em vias canônicas, como a sinalização TGF-β/Smad e a ativação anômala de fibroblastos6,7,8. Embora a infiltração de células imunes—especialmente macrófagos polarizados para o fenótipo M2, células T reguladoras e células dendríticas desreguladas—tenha sido documentada em tecidos queloides9,10, essas investigações tratam amplamente as alterações imunes como consequências tardias da disfunção dos fibroblastos, e não como fatores reguladores iniciais. Criticamente, os programas metabólicos que podem ativamente moldar essa interação imunofibrótica permanecem completamente inexplorados na patogênese dos queloides11,12,13. Essa lacuna de conhecimento é notável, considerando os paradigmas emergentes em doenças fibróticas, nos quais a reprogramação metabólica atua como reguladora mestra da remodelação tecidual.
A reprogramação metabólica surgiu recentemente como um ponto central na fibrogênese em múltiplos sistemas orgânicos. Nas fibroses pulmonar e hepática, a homeostase disregulada do heme — por meio da expressão alterada de transportadores, escavengers ou enzimas biossintéticas — desencadeia estresse oxidativo, ferroptose e inflamação estéril que promovem diretamente o depósito de colágeno14. O acúmulo de heme ativa o inflamassoma NLRP3, induzindo a ativação de fibroblastos, enquanto a deficiência do receptor do vírus da leucemia felina do subgrupo C (FLVCR1) agrava a fibrose tecidual por meio da toxicidade persistente do heme. Essas descobertas posicionam o metabolismo do heme não meramente como um processo de manutenção celular, mas como um centro de sinalização dinâmico capaz de iniciar cascatas fibróticas — um paradigma ainda a ser testado em distúrbios cutâneos fibroproliferativos.
A plausibilidade da imunomodulação mediada por heme é ainda mais apoiada por evidências mecanicistas provenientes de modelos de câncer e inflamação crônica. O heme atua como uma molécula sinalizadora que modula diretamente o destino das células imunes: promove a polarização de macrófagos de M1 para M2 por meio da sinalização TLR4/NF-κB15, influencia a diferenciação de linfócitos T por meio da repressão transcricional mediada por Bach216 e regula criticamente a maturação de células dendríticas por meio da exportação de heme dependente de FLVCR117,18. Notavelmente, a FLVCR1, uma exportadora de heme da membrana plasmática essencial para a homeostase celular de heme, foi recentemente implicada no desenvolvimento de células imunes e na disfunção endotelial19. Essas evidências convergentes posicionam a FLVCR1 como um provável nexo molecular que liga a desregulação metabólica do heme à remodelação imunológica patológica — uma hipótese com implicações profundas para a patogênese dos queloides, dada sua microambiente caracteristicamente rico em componentes imunes.
Apesar dos avanços significativos no entendimento da interação entre heme e o sistema imunológico em outros contextos de doenças, ainda é completamente desconhecido se o metabolismo disregulado do heme atua como um fator desencadeador primário que inicia ou amplifica o cenário imunológico patológico nos queloides. Esta lacuna crítica no conhecimento exige investigação urgente por várias razões interligadas: os queloides compartilham características patológicas marcantes — incluindo inflamação persistente e estresse oxidativo — com distúrbios fibroticos impulsionados por alterações metabólicas, tais como fibrose pulmonar e hepática, sugerindo uma possível semelhança nos mecanismos regulatórios subjacentes. A maquinaria de exportação de heme centrada na FLVCR1 foi validada mecanisticamente em tecidos não cutâneos por regular diretamente funções imunológicas essenciais, como a polarização de macrófagos e a maturação de células dendríticas, fornecendo uma base teórica sólida para sua extrapolação à imunopatologia do quelóide20. Mais importante ainda, o direcionamento a este eixo metabólico-imunológico oferece uma oportunidade transformadora de ir além das terapias sintomáticas atuais, que meramente suprimem os efeitos fibroticos tardios, possibilitando intervenções precoces na origem metabólica da progressão da doença21.
Com base nesse raciocínio, formulamos a hipótese de que a desregulação centrada em FLVCR1 no metabolismo do heme remodela ativamente o microambiente imune, impulsionando a patogênese dos queloides. Para validar sistematicamente essa hipótese, integramos análises transcriptômicas em nível populacional e em nível de célula única em uma abordagem multinível: primeiramente, identificamos e validamos biomarcadores diagnósticos associados ao metabolismo do heme em tecidos queloides utilizando algoritmos de aprendizado de máquina e verificação em uma coorte independente; em seguida, resolvemos os padrões espaciais de expressão desses biomarcadores em diferentes compartimentos celulares — incluindo células endoteliais, fibroblastos, melanócitos e subpopulações imunes — por meio de mapeamento com resolução em nível de célula única; posteriormente, delineamos suas correlações quantitativas com populações específicas de células imunes para estabelecer conexões funcionais entre imunidade e metabolismo; e, por fim, construímos uma rede regulatória de microRNA (miRNA) centrada em FLVCR1 e realizamos acoplamento molecular com compostos da medicina tradicional chinesa para identificar pontos passíveis de intervenção farmacológica. Esta investigação abrangente não apenas revela um eixo imuno-metabólico do heme previamente não reconhecido na patogênese dos queloides, mas também fornece um painel de biomarcadores com relevância translacional, possuindo potencial dual para diagnóstico e terapia nessa doença fibroproliferativa de difícil tratamento.
Protocolo
A aprovação ética e o consentimento informado não foram aplicáveis a este estudo porque todos os dados foram obtidos de bancos de dados publicamente disponíveis, incluindo o Gene Expression Omnibus (GEO), e nenhum participante humano identificável ou sujeito animal foi diretamente envolvido.
Aquisição e pré-processamento de dados
Os genes associados ao metabolismo do heme foram obtidos do Molecular Signatures Database (MSigDB; consulte a Tabela de Materiais e a Tabela Suplementar S1), incluindo conjuntos de genes dos caminhos REACTOME_Heme_Biosynthesis, REACTOME_Heme_Degradation, Wikipathway_Heme_Biosynthesis, REACTOME_Scavenging_Heme_from_Plasma e HALLMARK_Heme_Metabolism. Todos os conjuntos de dados analisados neste estudo foram obtidos de fontes publicamente disponíveis. Dois conjuntos de dados de microarranjos de expressão gênica em massa foram recuperados do banco de dados Gene Expression Omnibus (GEO): GSE44270, composto por 18 amostras de queloides e 14 amostras de pele normal, e GSE7890, composto por 10 amostras de queloides e 9 amostras de pele normal. GSE44270 e GSE7890 foram gerados nas plataformas GPL6244 e GPL570, respectivamente. Os arquivos de matriz de séries e as informações correspondentes das amostras foram baixados e importados para o ambiente R. Como os valores de expressão nos arquivos de matriz de séries já haviam sido pré-processados e normalizados pelos submissores originais dos dados, nenhuma transformação adicional em log2 ou normalização entre amostras foi realizada. Os dois conjuntos de dados foram processados independentemente e não foram combinados, pois foram gerados em plataformas de microarranjo diferentes. Os conjuntos de dados foram pré-processados conforme descrito abaixo (consulte a Tabela de Materiais). As sondas gênicas foram mapeadas para seus respectivos símbolos gênicos, e as sondas que não possuíam anotações gênicas ou que correspondiam a múltiplos genes foram excluídas. Para genes com múltiplos conjuntos de sondas, o valor de expressão foi atribuído com base no nível mais alto de expressão detectado. Além disso, dados de sequenciamento de RNA de célula única (scRNA-seq) de GSE163973, contendo três amostras de queloides, foram baixados e processados seguindo os padrões de controle de qualidade definidos no estudo original.
Triagem e validação de marcadores diagnósticos relacionados ao metabolismo de heme em queloides
Para identificar genes associados ao metabolismo do heme diferencialmente expressos em queloides, o teste de soma de postos de Wilcoxon foi aplicado ao conjunto de dados GSE44270 utilizando a função wilcox.test do R, com um limiar de significância de P < 0,05. Para identificar marcadores diagnósticos potenciais para queloides, dois modelos de aprendizado de máquina foram empregados: floresta aleatória (RF) e regressão logística com operador de redução e seleção por módulo mínimo (LASSO). A análise de Floresta Aleatória foi realizada com uma semente aleatória igual a 1 para garantir reprodutibilidade (consulte a Tabela de Materiais). O modelo foi construído utilizando 500 árvores (ntree = 500), e a importância dos genes foi avaliada com base na diminuição média da impureza dos nós (IncNodePurity). Genes com valores de importância superiores a 0,3 foram selecionados como biomarcadores candidatos derivados da Floresta Aleatória. A regressão logística LASSO foi realizada com α = 1, e 50 valores de lambda foram avaliados durante o treinamento do modelo (consulte a Tabela de Materiais). O parâmetro de penalidade ótimo foi determinado utilizando validação cruzada de cinco dobras com a função cv.glmnet, com resposta binomial. Genes com coeficientes de regressão não nulos foram mantidos como candidatos selecionados pelo LASSO. Por fim, a intersecção dos genes identificados pela Floresta Aleatória e pela regressão LASSO foi considerada como a assinatura gênica diagnóstica final. A assinatura gênica diagnóstica final foi avaliada utilizando um modelo baseado em nomograma. Toda seleção de características e estimativa de parâmetros do modelo foi realizada exclusivamente na coorte de descoberta (GSE44270), e a assinatura final de seis genes foi posteriormente avaliada em uma coorte de validação independente (GSE7890). O desempenho diagnóstico do nomograma foi avaliado mediante o cálculo da área sob a curva da característica de operação do receptor (AUC). Para examinar a estabilidade do modelo, a análise incluiu validação cruzada de cinco dobras e 1.000 iterações de reamostragem bootstrap, a partir das quais foi derivada uma AUC corrigida para otimismo. A análise de curva de decisão (DCA) foi então utilizada para estimar o benefício líquido potencial do nomograma; entretanto, esse resultado foi interpretado com cautela devido ao tamanho reduzido da amostra.
Infiltração de células imunes e análise de correlação
O enriquecimento de células imunes foi avaliado por meio de análise de enriquecimento de conjunto de genes em amostra única (ssGSEA) (consulte a Tabela de Materiais). A matriz de assinatura de células imunes foi obtida de um estudo previamente publicado por Charoentong et al.22 e continha 782 genes marcadores representando 28 populações de células imunes inatas e adaptativas. A análise foi realizada utilizando um kernel gaussiano sobre os valores de expressão normalizados e contínuos de micromatrizes. Foi exigido um tamanho mínimo do conjunto de genes de 10 após o pareamento dos genes marcadores com a matriz de expressão, e os escores ssGSEA resultantes foram normalizados. Todos os demais parâmetros foram mantidos nos valores padrão. Coeficientes de correlação de Pearson foram posteriormente calculados para avaliar as relações entre os escores de enriquecimento de células imunes e a expressão gênica diagnóstica. A matriz de correlação resultante foi visualizada como um gráfico de correlação, e associações selecionadas foram adicionalmente exibidas como gráficos de pirulito (consulte a Tabela de Materiais).
Processamento e análise de dados de sequenciamento de RNA de célula única
Os dados de sequenciamento de RNA de célula única foram obtidos de GSE163973, e apenas as três amostras de queloides, KF1, KF2 e KF3, foram incluídas na presente análise. Os dados de expressão foram importados e processados conforme descrito abaixo (consulte a Tabela de Materiais). Foram excluídas células com menos de 200 ou mais de 6.000 contagens totais de identificadores moleculares únicos (UMI), e os dupletos previstos foram removidos. As contagens de expressão gênica para cada célula foram normalizadas pela expressão celular total, multiplicadas por um fator de escala de 10.000 e transformadas em log. A variação associada ao lote foi regressada durante a normalização dos dados, e os resíduos normalizados resultantes foram utilizados para análises posteriores. Os 2.000 genes altamente variáveis foram selecionados com base em sua expressão média e dispersão, e a análise de componentes principais foi realizada com base nesses genes. Os primeiros 15 componentes principais foram utilizados para construir um grafo de k-vizinhos mais próximos com base em distâncias euclidianas, que posteriormente foi convertido em um grafo de vizinhos mais próximos compartilhados. As células foram agrupadas com o algoritmo Louvain em uma resolução de 0,8, e a projeção por aproximação de variedade uniforme foi realizada utilizando os mesmos 15 componentes principais. Os tipos celulares foram anotados de acordo com as definições de tipo celular relatadas no estudo original, e as anotações resultantes foram registradas no campo de metadados. As anotações de tipos celulares e as atribuições de agrupamento foram visualizadas nas coordenadas da projeção por aproximação de variedade uniforme, e a expressão gênica diagnóstica foi exibida nas populações celulares anotadas.
Construção da rede regulatória miRNA–mRNA
A rede reguladora miRNA–mRNA foi construída conforme descrito abaixo (consulte a Tabela de Materiais). Homo sapiens foi selecionado como o organismo, e os identificadores gênicos foram fornecidos como Símbolos Gênicos Oficiais. Os genes candidatos foram submetidos ao módulo Interações Gene–miRNA, e o TarBase v9.0 foi selecionado como base de dados de interações. O TarBase contém interações reguladoras miRNA–gene validadas experimentalmente. Apenas interações miRNA–mRNA com suporte experimental envolvendo os genes candidatos de entrada foram mantidas para a construção da rede, enquanto interações previstas sem evidência experimental foram excluídas. Nenhum limite adicional de pontuação de confiança foi imposto.
Triagem virtual baseada em estrutura e análise de encaixe molecular
A triagem virtual foi realizada para priorizar ligantes candidatos a partir da biblioteca de compostos contra a FLVCR1 humana (proteína relacionada ao receptor do vírus da leucemia felina do subgrupo C 1; consulte a Tabela de Materiais) utilizando um fluxo de trabalho de triagem virtual baseada em estrutura (SBVS). A estrutura tridimensional da FLVCR1 humana foi obtida no Protein Data Bank (PDB ID: 8UBZ). Esta estrutura representa a FLVCR1 humana ligada à colina, determinada por microscopia crioeletrônica de partículas individuais com uma resolução global de 3,02 Å (acesso EMDB: EMD-42110). A estrutura determinada experimentalmente foi selecionada porque contém a conformação da FLVCR1 com substrato ligado e, portanto, fornece informações estruturais para definir a cavidade de ligação ao ligante fisiologicamente relevante. Durante a preparação do receptor, as moléculas de colina (CHT) e hemissuccinato de colesterol (Y01) resolvidas conjuntamente foram mantidas para preservar o ambiente estrutural ao redor da região de entrada do substrato e ligação do ligante. O espaço de busca para o encaixe molecular foi definido ao redor da cavidade de ligação ao substrato/ligante da FLVCR1, abrangendo a região de ligação à colina resolvida conjuntamente. A caixa de grade foi centralizada em x = 160,587 Å, y = 160,613 Å e z = 160,484 Å. As dimensões da caixa de encaixe foram definidas como [X × Y × Z Å] para garantir cobertura adequada da cavidade de ligação ao substrato e dos resíduos circundantes. Os compostos candidatos foram posteriormente encaixados nesta região de ligação pré-definida. As conformações de encaixe foram classificadas com base em suas afinidades de ligação previstas, sendo que escores de encaixe mais negativos indicam interações previstas entre o ligante e a FLVCR1 mais favoráveis. Os compostos com as melhores classificações foram selecionados para análises subsequentes do modo de ligação e das interações proteína-ligante.
Simulação de dinâmica molecular e cálculo da energia livre de ligação por MM/GBSA
A simulação de dinâmica molecular (MD) foi utilizada para examinar mais detalhadamente o complexo proteína–ligante previsto (veja a Tabela de Materiais). A topologia do ligante foi preparada atribuindo-se parâmetros do campo de força General Amber Force Field (GAFF) e incorporando cargas de potencial eletrostático restrito (RESP). O complexo foi então descrito com o campo de força Amber99SB-ILDN, colocado em um potencial intermolecular transferível com modelo de água de três pontos e neutralizado com três íons Na⁺. Após a minimização de energia pelo método do gradiente descendente, o sistema foi equilibrado por 100 ps sob o conjunto de número constante de partículas, volume e temperatura e por mais 100 ps sob o conjunto de número constante de partículas, pressão e temperatura, com 100.000 passos em cada fase. Uma simulação produtiva de 100 ns foi posteriormente realizada a 300 K e 1 bar, utilizando um passo de tempo de 2 fs. A trajetória resultante foi analisada quanto ao desvio quadrático médio (RMSD), flutuação quadrática média (RMSF), raio de giração (Rg), área de superfície acessível ao solvente (SASA), persistência de ligação de hidrogênio e energia livre de ligação pela mecânica molecular/área de superfície generalizada de Born (MM/GBSA).
Cultura celular
As linhagens celulares de fibroblastos dérmicos humanos normais (NHDF) e de fibroblastos primários de queloides (PKF) foram cultivadas em meio de crescimento para fibroblastos suplementado com 2% de soro bovino fetal, fator de crescimento fibroblástico básico recombinante humano (1 ng/mL) e insulina (5 µg/mL). Ambas as linhagens celulares foram mantidas em incubadora umidificada a 37 °C com 5% de CO₂ e subcultivadas ao atingirem 80–90% de confluência.
Análise de Western blot
Proteínas totais foram isoladas de células NHDF e PKF com um tampão de lise composto por ensaio de radioimunoprecipitação, fenilmetilsulfonilfluoreto, um coquetel de inibidores de protease e inibidores de fosfatase. A concentração proteica foi determinada por meio de um ensaio de ácido bicinconínico, após o qual quantidades iguais de proteína foram separadas por eletroforese em gel de poliacrilamida com dodecilsulfato de sódio e transferidas para uma membrana de fluoreto de polivinilideno. A membrana foi bloqueada por 90 min à temperatura ambiente com leite desnatado a 5% preparado em solução salina tamponada com Tween/Tris, e então incubada durante a noite a 4 °C com anticorpos primários contra FLVCR1 (coelho policlonal, 1:1.000) e GAPDH (rato monoclonal, 1:20.000). No dia seguinte, realizou-se a incubação com o anticorpo secundário por 90 min à temperatura ambiente. As intensidades das bandas foram medidas com o ImageJ, e os níveis relativos de proteína foram normalizados em relação ao controle interno GAPDH. Um mínimo de três réplicas biológicas independentes foi utilizado para cada ensaio de western blot.
Análise de PCR quantitativa reversa-transcritiva fluorescente em tempo real (qRT-PCR)
O RNA total foi preparado a partir de células NHDF e PKF com o kit referenciado. Em seguida, o cDNA foi gerado com o Referenced cDNA Synthesis Mix for qPCR (com dsDNase). A qRT-PCR foi realizada em um sistema de PCR em tempo real, e a expressão de FLVCR1 foi medida com o Referenced SYBR Green Fast Mix. O mRNA de GAPDH serviu como referência interna para normalização. Cada reação de qRT-PCR foi realizada em triplicata técnica, e os níveis relativos de mRNA foram calculados pelo método 2−ΔΔCt. Cada experimento foi realizado independentemente pelo menos três vezes, e as sequências dos iniciadores estão fornecidas na Tabela Suplementar S2.
Análise estatística
As diferenças entre grupos foram testadas com o teste de soma de postos de Wilcoxon, e os valores são apresentados como média ± desvio padrão (SD). As associações entre variáveis contínuas foram examinadas utilizando o coeficiente de correlação de Pearson. Resultados com P < 0,05 foram considerados estatisticamente significativos. Os níveis de significância foram indicados como ns, P > 0,05; *, P < 0,05; **, P < 0,01; ***, P < 0,001; e ****, P < 0,0001.
Resultados
Triagem de biomarcadores diagnósticos candidatos para queloides usando um algoritmo de aprendizado de máquina
Um total de 283 genes relacionados ao metabolismo do heme foi incluído neste estudo. A análise de expressão diferencial do conjunto de dados GSE44270, comparando tecidos de queloides e pele normal, identificou 25 genes diferencialmente expressos de forma significativa (Figura 1A e Tabela Suplementar S3). Para triagem adicional de biomarcadores associados à doença, a regressão LASSO identificou nove genes candidatos (Figura 1B,C e Tabela Suplementar S3), enquanto o algoritmo de floresta aleatória (RF) selecionou 11 genes com alta importância preditiva (Figura 1D e Tabela Suplementar S3). A intersecção entre os resultados do LASSO e do RF foi visualizada por meio de um diagrama de Venn, resultando em seis biomarcadores centrais, a saber, FLVCR1, TMCC2, EIF2AK1, XK, HPX e KEL (Figura 1E e Tabela Suplementar S3). A análise da curva característica de operação do receptor (ROC) na coorte GSE44270 demonstrou bom desempenho diagnóstico para os seis biomarcadores, com valores de AUC de 0,8016 para FLVCR1, 0,7063 para TMCC2, 0,7817 para EIF2AK1, 0,7460 para XK, 0,7500 para HPX e 0,7857 para KEL (Figura 1F). Com base nesses seis biomarcadores, um nomograma diagnóstico para queloides foi posteriormente construído utilizando o pacote rms no R (Figura 1G).
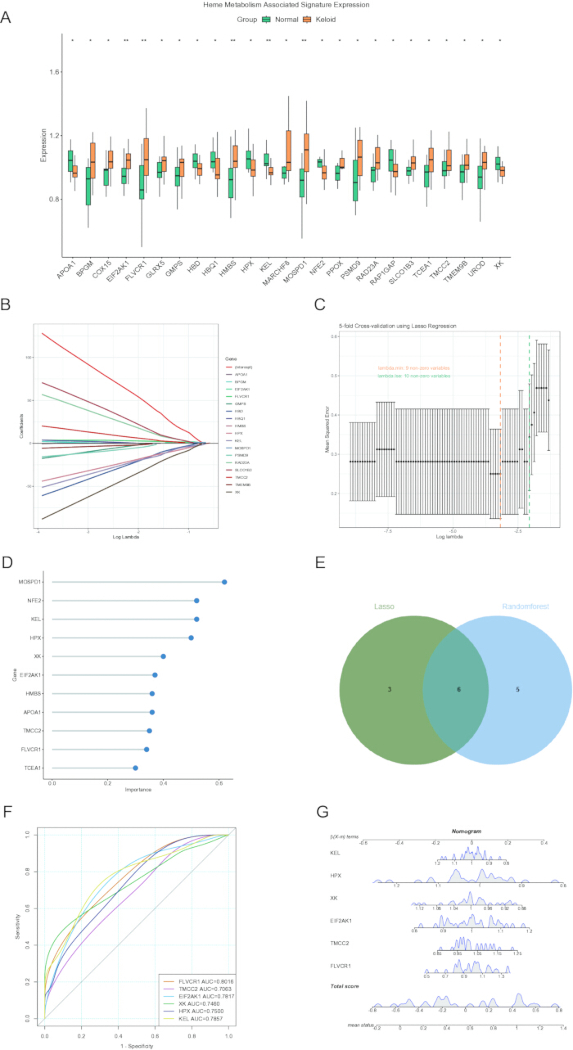
Figura 1: Identificação de genes candidatos relacionados ao metabolismo de heme associados ao quelóide utilizando algoritmos de aprendizado de máquina. (A) Gráfico de caixa ilustrando a expressão diferencial de genes relacionados ao metabolismo de heme entre tecidos queloides e normais. (B,C) Análise de regressão logística LASSO para triagem de marcadores diagnósticos candidatos. (D) Biomarcadores candidatos selecionados pelo algoritmo RF. (E) Diagrama de Venn mostrando os genes sobrepostos identificados pelos dois algoritmos de aprendizado de máquina. (F) Análise da curva ROC avaliando o desempenho diagnóstico dos biomarcadores candidatos. (G) Nômograma para predição de quelóide com base na assinatura de seis genes. Abreviaturas: LASSO, operador de redução e seleção absoluta mínima; RF, floresta aleatória; ROC, característica de operação do receptor. Significância estatística: ns, P > 0,05; *, P < 0,05; **, P < 0,01; ***, P < 0,001; e ****, P < 0,0001. Clique aqui para visualizar uma versão ampliada desta figura.
O desempenho preditivo do nomograma diagnóstico foi avaliado tanto na coorte de treinamento (GSE44270) quanto na coorte de validação (GSE7890). O modelo demonstrou excelente precisão diagnóstica, alcançando valores de AUC de 0,984 (IC 95%: 0,950–1,000) e 0,922 (IC 95%: 0,806–1,000), respectivamente (Figura 2A,D). Para avaliar mais a fundo a robustez e o possível superajuste da assinatura diagnóstica de seis genes, foram realizadas análises adicionais de validação interna na coorte de descoberta (GSE44270). A validação cruzada com cinco dobras demonstrou desempenho discriminativo consistente entre os subconjuntos, com uma AUC média de 0,925, indicando que o modelo manteve desempenho estável de classificação apesar das variações nas amostras de treinamento. Além disso, a validação por bootstrap com 1.000 iterações de reamostragem resultou em uma AUC média de 0,930 (IC 95%: 0,794–1,000). Após ajuste para o otimismo potencial causado pelo tamanho limitado da amostra, a AUC corrigida para otimismo permaneceu em 0,930, sugerindo que o desempenho diagnóstico da assinatura de seis genes foi relativamente estável após a validação interna. Além disso, a análise de curva de decisão (DCA) indicou que o nomograma apresentou um benefício líquido potencial mais alto do que estratégias diagnósticas alternativas em uma variedade de probabilidades limiares, embora esses achados devam ser interpretados com cautela devido ao tamanho limitado da amostra (Figura 2B,E). Adicionalmente, amostras de queloides apresentaram escores de risco significativamente mais altos do que os controles saudáveis nas coortes de treinamento e validação (Figura 2C,F), demonstrando ainda mais a estabilidade e confiabilidade do modelo diagnóstico.
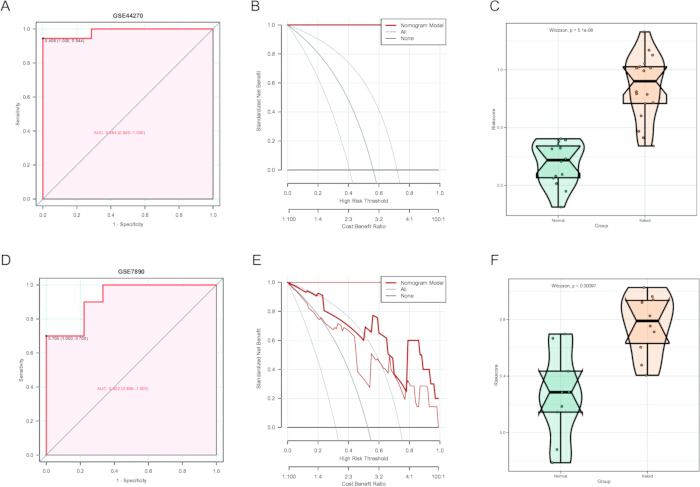
Figura 2: Validação do nomograma para predição de queloides. (A) Curva ROC avaliando o desempenho preditivo do nomograma no conjunto de dados GSE44270. (B) ACD avaliando a utilidade clínica do nomograma no GSE44270. (C) Distribuição do escore de risco comparando amostras de queloides e saudáveis no GSE44270. (D) Curva ROC avaliando o desempenho preditivo do nomograma no conjunto de dados independente GSE7890. (E) ACD avaliando a utilidade clínica do nomograma no GSE7890. (F) Distribuição do escore de risco comparando amostras de queloides e saudáveis no GSE7890. Abreviações: ROC = característica operacional do receptor; ACD = análise da curva de decisão. Clique aqui para visualizar uma versão maior desta figura.
Os biomarcadores diagnósticos estão associados às características imunológicas do quelóide
Para explorar a relação entre os seis biomarcadores diagnósticos e o microambiente imune, foi realizada uma análise de correlação para avaliar as associações entre a expressão dos biomarcadores e a infiltração de células imunes. Os resultados revelaram que os seis biomarcadores estavam significativamente associados a múltiplas populações de células imunes infiltrantes (Figura 3A). Especificamente, a expressão de FLVCR1 apresentou associação negativa com células T auxiliares foliculares (Figura 3B). TMCC2 mostrou correlações positivas com células natural killer e células dendríticas ativadas, enquanto apresentou correlação negativa com células dendríticas imaturas e células B imaturas (Figura 3C–F). Além disso, a expressão de EIF2AK1 apresentou associação negativa com células natural killer CD56dim (Figura 3G), enquanto XK apresentou associação negativa com eosinófilos (Figura 3H).
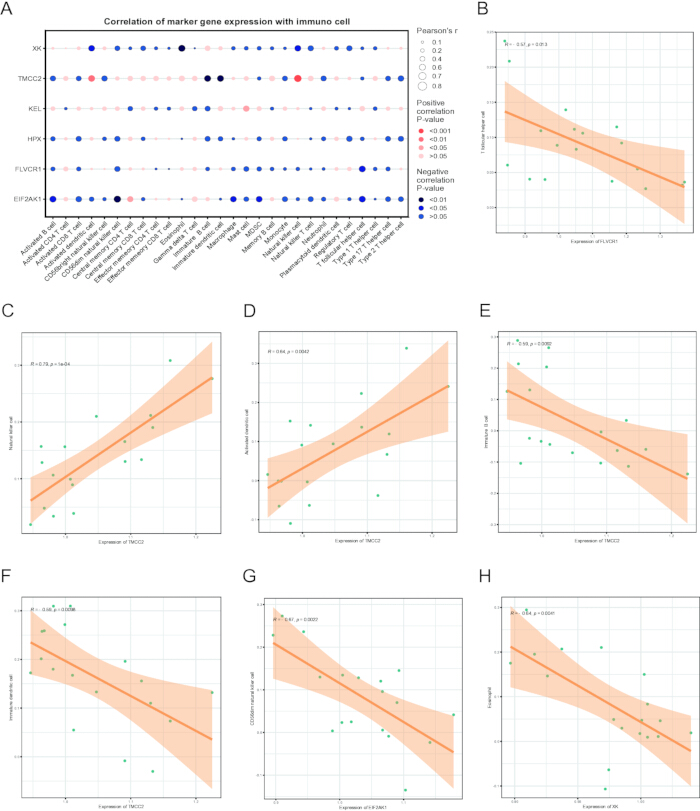
Figura 3Correlação entre genes candidatos relacionados ao metabolismo de heme e infiltração de células imunes. (AMapa de calor mostrando as correlações entre genes candidatos e populações de células imunes. O vermelho indica correlações positivas, enquanto o azul indica correlações negativas.B). Correlação entre FLVCR1 expressão e células T helper foliculares. (C-F) Correlações entre TMCC2 expressão e células assassinas naturais, células dendríticas ativadas, células dendríticas imaturas e células B imaturas, respectivamente. (G) Correlação entre EIF2AK1 expressão e células natural killer CD56dim.H). Correlação entre XK expressão e eosinófilos. Abreviações: FLVCR1 = receptor do vírus da leucemia felina do subgrupo C 1; TMCC2 = transmembrana e domínios em alfa-hélice 2; EIF2AK1 = quinase alfa do fator de iniciação da tradução em eucariotos 2; CD56dimensão = dimensão do cluster de diferenciação 56 Clique aqui para visualizar uma versão maior desta figura.
Análise de dados de transcriptoma de célula única
Para caracterizar os padrões de expressão dos biomarcadores diagnósticos identificados no microambiente do quelóide, analisamos o conjunto de dados de sequenciamento de RNA de célula única GSE163973. Após controle de qualidade e integração dos dados, 21.488 células de alta qualidade foram mantidas para análises posteriores. Excluímos células com menos de 200 ou mais de 6.000 contagens totais de identificadores moleculares únicos (UMI) e identificamos e removemos potenciais dupletos utilizando o pacote DoubletDetection. Selecionamos os 2.000 genes que exibiram maior variabilidade de expressão, seguido de redução de dimensionalidade e visualização com a projeção de aproximação uniforme de variedades (UMAP). Um total de 10 grandes populações celulares foi identificado, incluindo células endoteliais, fibroblastos, fibras musculares, queratinócitos, células imunes, células endoteliais linfáticas, células glandulares, células neurais, melanócitos e uma população celular não classificada (Figura 4A,B). O perfil de expressão revelou padrões distintos de distribuição específicos a cada tipo celular dos biomarcadores diagnósticos. FLVCR1 foi predominantemente expresso em células endoteliais e melanócitos, enquanto EIF2AK1 mostrou expressão relativamente alta em células neurais, células glandulares e fibroblastos. HPX foi principalmente enriquecido em melanócitos, enquanto KEL exibiu expressão predominante em células glandulares (Figura 4C,D).
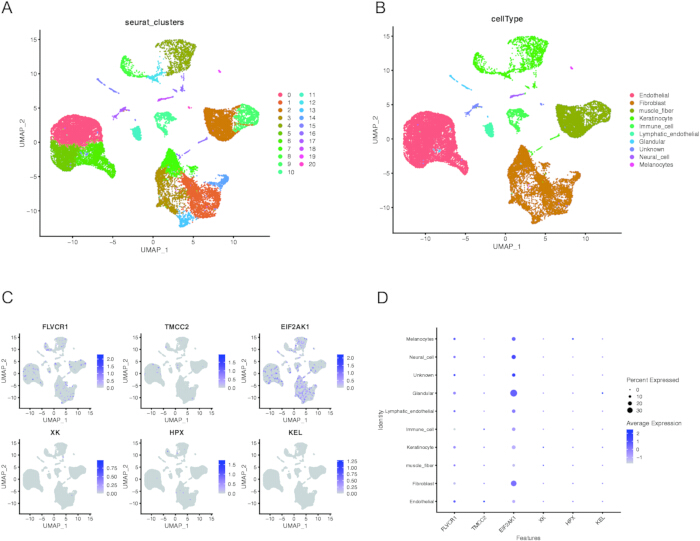
Figura 4: Distribuição de biomarcadores diagnósticos relacionados ao metabolismo do heme no transcriptoma de célula única de queloides. (A) Gráfico UMAP mostrando 21 agrupamentos celulares compostos por 21.488 células de amostras de queloides. (B) Anotações de tipos celulares com base nas anotações relatadas no estudo original. (C) Gráficos de características mostrando a expressão de biomarcadores diagnósticos relacionados ao metabolismo do heme em diferentes tipos celulares. (D) Gráfico de bolhas mostrando os níveis médios de expressão e as porcentagens de células que expressam os biomarcadores diagnósticos relacionados ao metabolismo do heme em diferentes tipos celulares. Abreviação: UMAP = aproximação e projeção de variedade uniforme. Clique aqui para visualizar uma versão maior desta figura.
Identificação e análise da rede de interação de biomarcadores diagnósticos candidatos
Para explorar os mecanismos regulatórios subjacentes aos biomarcadores diagnósticos candidatos, foi construída uma rede regulatória de miRNA–mRNA. Para melhorar a confiabilidade das interações previstas, foram identificados miRNAs sobrepostos que direcionam os biomarcadores candidatos. Um total de 282 miRNAs interagindo com os seis biomarcadores diagnósticos foi obtido, e a rede regulatória resultante é mostrada na Figura 5. Notavelmente, previu-se que hsa-miR-34a-5p, hsa-let-7a-5p, hsa-let-7d-5p, hsa-let-7e-5p e hsa-miR-26b-5p regulassem simultaneamente os seis biomarcadores candidatos.
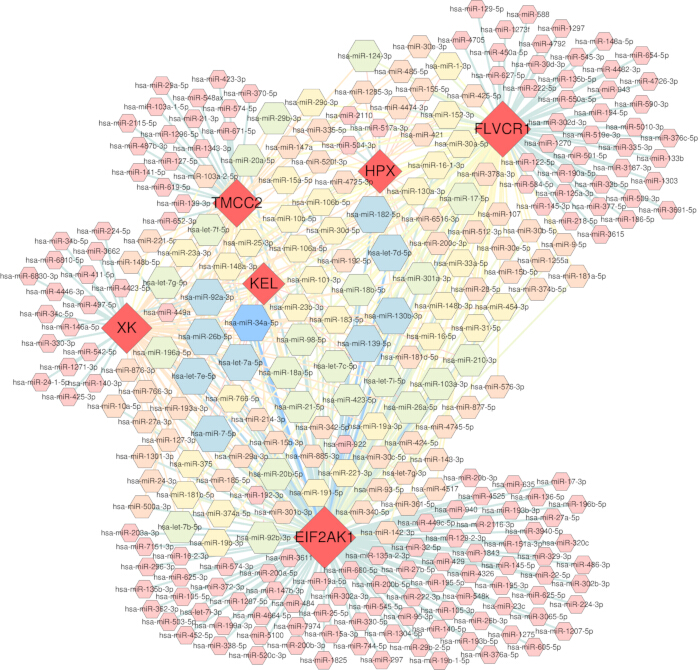
Figura 5: Rede reguladora de miRNA dos biomarcadores diagnósticos relacionados ao metabolismo do heme. A rede ilustra as relações regulatórias entre os seis genes biomarcadores diagnósticos (FLVCR1, HPX, TMCC2, KEL, XK e EIF2AK1) e seus miRNAs associados. Os nós gênicos representam os biomarcadores diagnósticos, enquanto os nós circundantes representam os miRNAs. As arestas indicam interações miRNA–mRNA com suporte experimental. Abreviações: FLVCR1 = receptor do vírus da leucemia felina do subgrupo C 1; HPX = hemopexina; TMCC2 = domínios transmembrana e com estrutura em alça 2; KEL = metaloendopeptidase Kell; XK = grupo sanguíneo X-linked Kx; EIF2AK1 = quinase 1 do fator de iniciação da tradução eucariótica 2 alfa; miRNA = microRNA; mRNA = RNA mensageiro. Clique aqui para visualizar uma versão maior desta figura.
Validação experimental da expressão de FLVCR1 e análise de docking molecular de compostos terapêuticos potenciais
Para validar as descobertas bioinformáticas e confirmar a relevância funcional do gene central identificado, avaliamos experimentalmente a expressão de FLVCR1 em PKF e NHDF. As análises de qRT-PCR e western blot demonstraram consistentemente que FLVCR1 estava significativamente superexpresso em fibroblastos de queloides em comparação com os controles normais (Figura 6A–C, Figura Suplementar S1 e Tabela Suplementar S4). Essa expressão celular elevada apoia o envolvimento potencial da desregulação metabólica do heme associada ao FLVCR1 na patogênese da queloides.
Dado o envolvimento potencial da FLVCR1 em alterações imunes associadas ao metabolismo do heme, em seguida buscamos identificar compostos terapêuticos potenciais que pudessem direcionar diretamente a FLVCR1 para interromper esse eixo patogênico. Foi realizada uma triagem virtual em alto rendimento utilizando uma biblioteca de compostos de medicina tradicional chinesa (MTC) e a estrutura proteica preparada. Os 20 compostos com os escores de encaixe mais favoráveis foram selecionados para avaliação adicional (Tabela Suplementar S5). De modo geral, uma energia de ligação mais baixa indica uma afinidade de ligação mais forte, e energias de encaixe abaixo de −5 kcal/mol são consideradas indicativas de interações estáveis entre ligante e proteína. Dentre os compostos triados, (+)-Galocatequina, (−)-Epicatequina, (−)-Galocatequina e Cianidina (cloreto) exibiram afinidades de ligação favoráveis à FLVCR1. Notavelmente, a (+)-Galocatequina mostrou a interação mais forte com FLVCR1, formando quatro ligações de hidrogênio com GLU214, ASN245, GLN246 e GLN471, sugerindo um modo de ligação estável entre ligante e proteína (Figura 6D–G). Esses achados destacam a (+)-galocatequina como um candidato promissor para intervenção terapêutica baseada em mecanismos que direcionam FLVCR1.
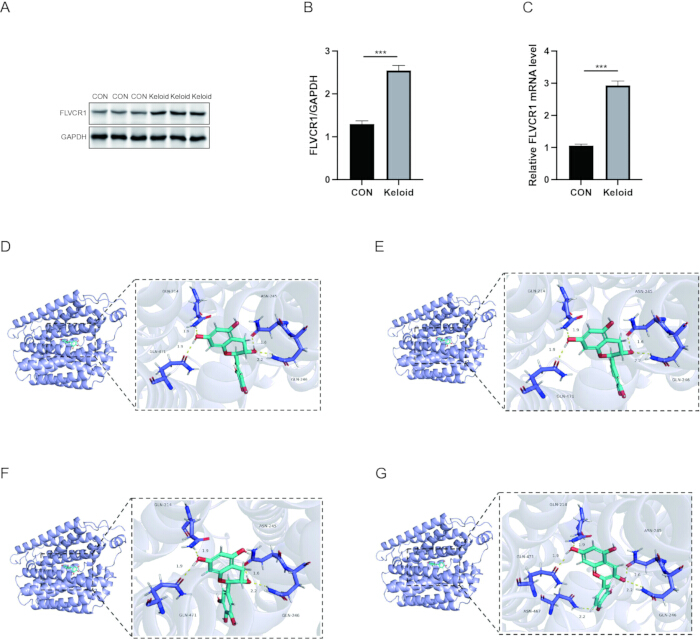
Figura 6: Validação experimental da expressão de FLVCR1 e encaixe molecular de compostos potenciais direcionados à FLVCR1. (A) Imagens representativas de western blot mostrando a expressão da proteína FLVCR1 em CON e queloides. GAPDH serviu como controle de carga. (B) Quantificação dos níveis proteicos de FLVCR1 normalizados em relação a GAPDH. (C) Os níveis relativos de expressão de mRNA de FLVCR1 em fibroblastos de CON e queloides foram determinados por qRT-PCR. GAPDH foi utilizado como referência interna. (D–G) Representações tridimensionais dos modos de ligação previstos entre FLVCR1 e compostos de pequenas moléculas selecionados: (D) (+)-Galocatequina. (E) (-)-Epicatequina. (F) (-)-Galocatequina. (G) Cianidina (Cloreto). Abreviações: FLVCR1 = receptor do vírus da leucemia felina do subgrupo C 1; CON, controle; GAPDH, desidrogenase gliceraldeído-3-fosfato; qRT-PCR, reação em cadeia da polimerase com transcrição reversa quantitativa; SD, desvio padrão. Os dados são apresentados como média ± SD. Significância estatística: ns, P > 0,05; *, P < 0,05; **, P < 0,01; ***, P < 0,001; e ****, P < 0,0001. Clique aqui para visualizar uma versão ampliada desta figura.
Confirmação da estabilidade do complexo FLVCR1–(+)-Galocatequina por meio de simulação de dinâmica molecular
Para examinar a confiabilidade do modo previsto de ligação entre ligante e proteína, foi realizada uma simulação de dinâmica molecular (MD) para o complexo FLVCR1–(+)-gallocatequina. A análise concentrou-se em determinar se o complexo permaneceu estruturalmente estável ao longo do tempo e se a ligação do ligante alterou o comportamento conformacional da proteína, utilizando RMSD, RMSF, raio de giração (Rg), SASA, análise de ligação de hidrogênio e cálculos MM/GBSA. A análise de RMSD (Figura 7A) mostrou que tanto a proteína apó quanto o complexo ligado ao ligante apresentaram flutuações iniciais nos primeiros 20 ns, seguidas por estabilização gradual, indicando que os sistemas atingiram o equilíbrio durante a simulação. Após o equilíbrio, o valor de RMSD do complexo FLVCR1–(+)-gallocatequina permaneceu abaixo de 0,2 nm, sugerindo que a ligação do ligante contribuiu para manter a estabilidade estrutural do FLVCR1. A análise de RMSF (Figura 7B) demonstrou que a maioria dos resíduos exibiu flutuações limitadas ao longo da simulação, indicando a preservação da integridade geral da proteína, enquanto algumas regiões flexíveis podem representar regiões em alça envolvidas na acomodação do ligante. Além disso, perfis estáveis de Rg e SASA (Figura 7C,D) indicaram que o complexo manteve uma conformação compacta, sem expansão estrutural evidente ou mudanças na exposição ao solvente. A análise de ligação de hidrogênio (Figura 7E) revelou que o complexo FLVCR1–(+)-gallocatequina manteve interações intermoleculares persistentes, com aproximadamente 3–4 ligações de hidrogênio formadas durante a simulação, o que apoia a estabilidade da associação entre ligante e proteína. A análise MM/GBSA mostrou ainda que o complexo FLVCR1–(+)-gallocatequina exibiu uma energia livre de ligação favorável (ΔGtotal = −34,87 ± 4,13 kcal/mol) (Tabela Suplementar S6). A análise de decomposição de energia indicou que as interações de van der Waals (ΔVDWAALS = −46,34 ± 2,16 kcal/mol) e as interações eletrostáticas (ΔEelec = −14,09 ± 3,45 kcal/mol) foram as principais contribuições favoráveis para a ligação, apesar da contribuição desfavorável da energia de solvatação polar (ΔGsolvation = 25,55 ± 0,74 kcal/mol) (Tabela Suplementar S6). Em conjunto, esses resultados de simulação de MD demonstraram que a (+)-gallocatequina formou um complexo estável com FLVCR1 e reforçaram a confiabilidade do modo de ligação previsto por docking.
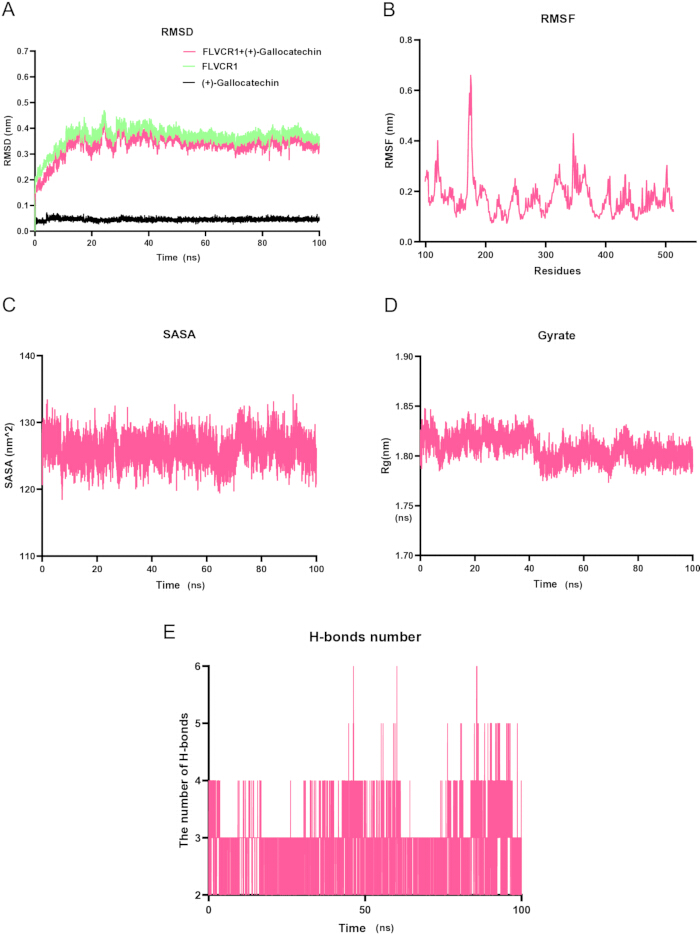
Figura 7: Análise por simulação de dinâmica molecular do complexo FLVCR1–(+)-Galocatequina. (A) Perfis de RMSD de FLVCR1 na forma apó e do complexo FLVCR1–(+)-Galocatequina durante a simulação de dinâmica molecular de 100 ns. (B) Perfil de RMSF mostrando flutuações ao nível dos resíduos de FLVCR1 durante a simulação. (C) Perfil de SASA mostrando alterações na área da superfície acessível ao solvente do complexo FLVCR1–(+)-Galocatequina. (D) Perfil de Rg avaliando a compactação do complexo FLVCR1–(+)-Galocatequina durante a simulação. (E) Análise de ligações de hidrogênio mostrando interações intermoleculares dinâmicas entre FLVCR1 e (+)-Galocatequina ao longo da simulação. Abreviações: FLVCR1 = receptor de leucemia felina do subgrupo C 1; RMSD = desvio quadrático médio; RMSF = flutuação quadrática média; SASA = área da superfície acessível ao solvente; Rg = raio de giração. Clique aqui para visualizar uma versão maior desta figura.
Disponibilidade de Dados:
Os conjuntos de dados transcriptômicos disponíveis publicamente analisados neste estudo podem ser acessados por meio do Gene Expression Omnibus (GEO) sob os números de acesso GSE44270, GSE7890 e GSE163973. Os dados brutos gerados neste estudo e que sustentam a validação experimental, incluindo medições de qRT-PCR, imagens originais de western blot e dados de quantificação de western blot, são fornecidos como Figura Suplementar S1, Tabela Suplementar S1, Tabela Suplementar S2, Tabela Suplementar S3 e Tabela Suplementar S4. Os resultados de docking molecular e os dados de energia livre de ligação MM/GBSA também são fornecidos nas Tabela Suplementar S5 e Tabela Suplementar S6.
Figura suplementar S1: Dados originais do western blot.Clique aqui para baixar este arquivo.
Tabela Suplementar S1: Genes relacionados ao metabolismo de heme.Clique aqui para baixar este arquivo.
Tabela Suplementar S2: Sequências de primers de genes selecionados. Clique aqui para baixar este arquivo.
Tabela Suplementar S3: Abordagens de aprendizado de máquina para identificar biomarcadores diagnósticos potenciais no quelóide. Clique aqui para baixar este arquivo.
Tabela Suplementar S4: Dados brutos que apoiam a validação experimental da expressão de FLVCR1. Clique aqui para baixar este arquivo.
Tabela Suplementar S5: Os 20 principais compostos candidatos identificados por docking molecular com FLVCR1.Clique aqui para baixar este arquivo.
Tabela Suplementar S6: Análise da energia livre de ligação MM/GBSA do complexo FLVCR1–(+)-Galocatequina.Clique aqui para baixar este arquivo.
Discussão
Este estudo identifica uma associação potencial entre o metabolismo disregulado do heme, a expressão de FLVCR1 e alterações no microambiente imune na formação de queloides. Ao integrar transcriptômica em massa e de célula única, estabelecemos FLVCR1 como um nexo molecular que liga a deficiência na exportação de heme à reprogramação imune patológica, posicionando o queloides dentro do espectro emergente de distúrbios "metabo-fibróticos"23,24,25. A importância potencial de FLVCR1 é apoiada por evidências convergentes de múltiplos níveis analíticos. A transcriptômica em massa revelou sua significativa superexpressão nos tecidos queloides, com alta capacidade diagnóstica, enquanto o mapeamento com resolução de célula única localizou sua expressão predominantemente em células endoteliais e melanócitos — dois tipos celulares criticamente implicados na patogênese do queloides por meio de angiogênese aberrante e hiperpigmentação, respectivamente26,27. De forma mais convincente, a expressão de FLVCR1 exibiu uma forte correlação negativa com células T foliculares auxiliares (Tfh), um subconjunto de linfócitos cada vez mais reconhecido por promover imunidade polarizada para Th2 e deposição de colágeno em microambientes fibróticos28. Estudos anteriores demonstraram que a exportação de heme mediada por FLVCR1 está envolvida na maturação de células dendríticas e na apresentação de antígenos29, sugerindo um vínculo potencial entre a homeostase do heme associada a FLVCR1 e a regulação imune. A superexpressão observada de FLVCR1 e sua correlação negativa com a infiltração de células Tfh podem, portanto, refletir alterações na homeostase imune, possivelmente envolvendo citocinas profibróticas associadas às células Tfh, como IL-4 e IL-1329,30,31.
Além disso, o acúmulo intracelular de heme resultante da disfunção da FLVCR1 provavelmente ativa o inflamassoma NLRP3 — um mecanismo bem documentado na fibrose hepática, onde o heme atua como um padrão molecular associado a dano (DAMP, na sigla em inglês) que desencadeia inflamação estéril32,33,34. Essa ativação do inflamassoma promoveria a liberação de IL-1β/IL-18, induzindo a polarização de macrófagos para o fenótipo M2 por meio da sinalização TLR4/NF-κB e criando um ciclo auto-sustentado de estresse oxidativo e ativação de fibroblastos35,36. Em conjunto, esses dados sustentam a FLVCR1 como um biomarcador candidato e possível contribuinte para as interações entre metabolismo do heme e sistema imunológico no quelóide; no entanto, a cascata mecanicista proposta exige validação funcional direta. A retenção intracelular de heme primeiramente induz dano oxidativo e ativa o inflamassoma, o que subsequentemente leva à disfunção de células dendríticas, promovendo desvio para células T auxiliares foliculares e respostas imunes do tipo Th2; essa alteração imunológica, por sua vez, impulsiona ainda mais a polarização de macrófagos para o fenótipo M2, resultando, por fim, na ativação de fibroblastos e na progressão da fibrogênese.
Além da atuação isolada da FLVCR1, a desregulação sinérgica dos seis biomarcadores revela um colapso coordenado da homeostase do heme em múltiplos nós regulatórios. A TMCC2, positivamente correlacionada com células dendríticas ativadas, mas negativamente associada a subconjuntos imaturos, pode representar um mecanismo compensatório que tenta restaurar a competência imunológica diante do estresse por heme37,38. A EIF2AK1, altamente expressa em fibroblastos queloides e células glandulares, atua como sensor molecular direto do excesso de heme, fosforilando a eIF2α para suprimir globalmente a síntese proteica enquanto aumenta seletivamente a expressão de genes de resposta ao estresse39,40,41. Isso posiciona a EIF2AK1 como a ligação crítica que traduz o acúmulo de heme na mudança fenotípica dos fibroblastos — o que potencialmente explica por que os fibroblastos queloides exibem resistência aumentada à apoptose e produção exagerada de colágeno42,43,44. A HPX, o principal eliminador plasmático de heme, mostrou expressão restrita em melanócitos, sugerindo uma tentativa autônoma da célula de amortecer a toxicidade do heme em compartimentos ricos em pigmento45,46,47. A desregulação simultânea da XK e da KEL envolve ainda mais os mecanismos de manuseio do heme da linhagem eritróide na patogênese do quelóide — um achado com implicações interessantes para entender por que os queloides frequentemente surgem em locais de trauma com micro-hemorragia. Em vez de considerar esses seis genes como marcadores independentes, interpretamos sua desregulação coletiva como evidência de uma falha sistêmica na compartimentalização do heme, na qual a exportação prejudicada (FLVCR1), a detecção (EIF2AK1), a eliminação (HPX) e o tráfego de membrana (XK, KEL) convergem para criar um microambiente pró-fibrótico e rico em heme.
Esse modelo metabólico-imunológico é ainda reforçado por uma camada epigenética marcante: identificamos uma rede ceRNA na qual a subexpressão de miRNAs específicos (por exemplo, a família let-7 e o miR-34a-5p) pode simultaneamente desreprimir vias relacionadas ao metabolismo do heme e vias fibróticas, embora esse modelo regulatório exija validação adicional23. A resolução espacial proporcionada pela análise de célula única ilumina a coreografia celular subjacente a esse processo, demonstrando como a disfunção metabólica em células estruturais semeia ativamente o microambiente rico em componentes imunes por meio de sinalização parácrina de heme, transformando assim nossa compreensão de uma perspectiva de "tecido em massa" para um modelo dinâmico de ecossistema celular48,49,50. O acúmulo de heme no endotélio pode promover vazamento vascular e extravasamento de leucócitos por meio da indução da heme oxigenase-1 e da superexpressão de moléculas de adesão, semeando, portanto, o microambiente rico em componentes imunes observado no quelóide51,52,53. Concomitantemente, a expressão de FLVCR1 em melanócitos está alinhada com observações clínicas de hiperpigmentação queloidal e sugere vulnerabilidades metabólicas compartilhadas entre as vias pigmentares e fibróticas — possivelmente mediadas por respostas ao estresse oxidativo54,55. Esse mapeamento espacial transforma nossa compreensão de uma perspectiva de "tecido em massa" para um modelo de ecossistema celular no qual a disfunção metabólica em células estruturais (endotélio, melanócitos) molda ativamente o comportamento das células imunes por meio de sinalização parácrina de heme.
Do ponto de vista translacional, nosso nomograma que integra os seis biomarcadores alcançou uma precisão diagnóstica quase perfeita, superando substancialmente qualquer marcador individual e demonstrando benefício clínico líquido claro por meio da análise da curva de decisão. De forma mais provocativa, o encaixe molecular identificou a (+)-galocatequina — um polifenol bioativo abundante no chá verde e em ervas medicinais tradicionais chinesas — como um ligante de alta afinidade para a FLVCR1, formando ligações de hidrogênio estáveis com GLU-214, ASN-245, GLN-246 e GLN-471. Esse achado é particularmente relevante dada a evidência prévia de que as catequinas suprimem a síntese de colágeno, inibem a secreção do fator de crescimento transformador beta 1 e atenuam o estresse oxidativo em fibroblastos de queloides56,57,58. Hipotetizamos que a (+)-galocatequina possa estabilizar a conformação da FLVCR1 para aumentar a capacidade de exportação de heme, interrompendo assim o gatilho metabólico da fibrose em sua origem — uma estratégia fundamentalmente distinta das terapias atuais, que meramente suprimem a produção de colágeno downstream. Se esse tipo de intervenção metabólica pode afetar a recorrência de queloides requer validação experimental e clínica adicional.
É claro que este estudo também apresenta limitações. Primeiro, nossas análises permanecem amplamente computacionais, e a associação observada entre a expressão de FLVCR1 e a infiltração de células T foliculares auxiliares (Tfh) não estabelece uma relação causal direta. São necessárias validação por citometria de fluxo das células Tfh e estudos funcionais envolvendo silenciamento ou superexpressão de FLVCR1 em fibroblastos de queloides, juntamente com ensaios de interação entre fibroblastos e células imunes ou com meio condicionado, para esclarecer o papel potencial de FLVCR1 na regulação imune. Segundo, o tamanho relativamente pequeno da amostra pode introduzir incerteza e otimismo na estimativa do desempenho da assinatura de seis genes. Embora tenha sido realizada validação interna, a avaliação confiável do desempenho diagnóstico e da calibração permanece limitada. Portanto, o painel de seis genes deve ser considerado uma assinatura molecular exploratória que exige validação adicional em coortes maiores e independentes. Terceiro, o conjunto de dados de sequenciamento de célula única precisa ser expandido para captar melhor a heterogeneidade entre pacientes e populações celulares raras. Quarto, a validação ao nível proteico da expressão dos biomarcadores e sua localização espacial por meio de imuno-histoquímica reforçaria a relevância clínica de nossos achados. Por fim, embora a simulação molecular sugira um possível ligante entre (+)-galocatequina e FLVCR1, ensaios de ligação in vitro e estudos de eficácia in vivo são necessários antes da translação clínica. Apesar dessas limitações, nossos achados fornecem uma estrutura multidimensional que associa o metabolismo de heme ligado a FLVCR1 às alterações imunes no queloides e identificam potenciais biomarcadores moleculares e candidatos terapêuticos para investigação adicional.
Divulgações
Os autores não têm conflitos de interesse a declarar.
Contribuições dos autores
Qiuyan Yang contribuiu para o planejamento do estudo. Jianping Zhang contribuiu para a coleta de dados. Qiuyan Yang e Xiaofang Sun contribuíram para a análise estatística. Qiuyan Yang e Jing Wang contribuíram para a elaboração de diagramas e conclusão do manuscrito. Todos os autores leram e aprovaram a versão final do manuscrito.
Agradecimentos
Agradecemos aos pesquisadores que geraram e compartilharam publicamente os conjuntos de dados GSE44270, GSE7890 e GSE163973 por meio do banco de dados Gene Expression Omnibus (GEO).
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| AmberTools | Amber Project | https://ambermd.org/AmberTools.php | Versão 22; Geração de parâmetros de ligante usando o campo de força GAFF |
| Anti-FLVCR1 | Proteintech | 26841-1-AP | |
| Anti-GAPDH | Proteintech | 60004-1-Ig | |
| AutoDock Vina | The Scripps Research Institute | https://vina.scripps.edu/ | Versão 1.2.3; Acoplamento molecular e predição da afinidade de ligação do ligante |
| AutoDockTools | The Scripps Research Institute | https://ccsb.scripps.edu/autodocksuite/adt/ | Versão 1.5.6; Preparação de ligante e receptor para acoplamento molecular |
| Kit de ensaio de proteína BCA | Servicebio | G2026 | |
| Mistura de síntese de cDNA para qPCR com dsDNase | UnionScript | Transcrição reversa para qRT-PCR | |
| ChemBio3D | PerkinElmer | https://revvitysignals.com/products/research/chemdraw | Versão 14.0; Otimização conformacional 3D e minimização de energia de ligantes |
| Sistema de imagem por quimioluminescência | Visualização de bandas de western blot | ||
| Pacote DoubletDetection | GitHub / JonathanShor | https://github.com/JonathanShor/DoubletDetection | Detecção e remoção de dupletos previstos na análise de scRNA-seq |
| Substrato quimioluminescente ECL | Detecção de sinal em western blot | ||
| Soro bovino fetal | Concentração final de 2%; Suplemento para meio de cultura de fibroblastos | ||
| Meio de Crescimento de Fibroblastos 2 | PromoCell | C-23020 | |
| Primers FLVCR1 e GAPDH | Tabela Suplementar S2 | Amplificação por qRT-PCR de genes alvo e de referência | |
| Gaussian | Gaussian, Inc. | https://gaussian.com/ | Gaussian 16W; Cálculo de cargas atômicas RESP para parametrização de ligantes |
| Aparelho de eletroforese em gel | Separção de proteínas por SDS-PAGE | ||
| Pacote GEOquery | Bioconductor | https://bioconductor.org/packages/GEOquery/ | Versão 2.68.0; Recuperação de expressão gênica e metadados do banco de dados GEO |
| Pacote ggplot2 | CRAN | https://cran.r-project.org/package=ggplot2 | Versão 4.0.2; Visualização de dados |
| Pacote glmnet | CRAN | https://cran.r-project.org/package=glmnet | Versão 4.1.10; Seleção de características por LASSO |
| GROMACS | Equipe de Desenvolvimento do GROMACS | https://www.gromacs.org/ | Versão 2022.3; Simulações de dinâmica molecular e análise de trajetórias |
| GS AntiQ qPCR SYBR Green Fast Mix (Universal) | Genesand | SQ410 | |
| GSE163973 | Banco de dados GEO | https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE163973 | 3 amostras de queloides; Análise de expressão unicelular |
| GSE44270 | Banco de dados GEO | https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE44270 | 18 amostras de queloides e 14 amostras normais; Expressão diferencial e triagem de biomarcadores |
| GSE7890 | Banco de dados GEO | https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE7890 | 10 amostras de queloides e 9 amostras normais; Validação independente de biomarcadores diagnósticos |
| Pacote GSVA | Bioconductor | https://bioconductor.org/packages/GSVA/ | Versão 1.48.3; Análise de infiltração de células imunes baseada em ssGSEA |
| HRP-conjugado de cabra anti-mouse IgG | Abcam | ab97040 | |
| HRP-conjugado de cabra anti-rabbit IgG | Abcam | ab97051 | |
| Incubadora umidificada de CO2 | 37 °C, 5% CO2; Manutenção de células NHDF e PKF | ||
| ImageJ | National Institutes of Health | https://imagej.nih.gov/ij/ | Quantificação da intensidade de bandas de western blot |
| Insulina | Concentração final de 5 μg/mL; Suplemento para meio de cultura de fibroblastos | ||
| Banco de Dados de Assinaturas Moleculares (MSigDB) | Broad Institute | https://www.gsea-msigdb.org/gsea/msigdb | Versão 2024.1.Hs; Fonte de conjuntos de genes associados ao metabolismo do heme |
| NetworkAnalyst | NetworkAnalyst | https://www.networkanalyst.ca/ | Versão 3.0; Construção da rede de interação miRNA-mRNA |
| NHDF | Procell | CP-H106 | |
| Leite desnatado em pó | Solução a 5%; Bloqueio de membrana para análise de western blot | ||
| Filme ou tampas de vedação óptica | Vedação de reações de qRT-PCR | ||
| PBS | Procell | PB180327 | |
| PDB ID: 8UBZ | RCSB PDB | https://www.rcsb.org/structure/8UBZ | Estrutura humana do FLVCR1; Fonte da estrutura proteica do FLVCR1 para triagem virtual baseada em estrutura |
| Inibidores de fosfatase | Suplemento para tampão de lise de proteína | ||
| PKF | Procell | GCP-H235 | |
| PMSF | Servicebio | G2008-1ML | |
| Pacote pROC | CRAN | https://cran.r-project.org/package=pROC | Versão 1.19.0.1; Análise de curva ROC e AUC |
| Cocktail de inibidores de protease | Roche | 4693124001 | |
| Aparelho de transferência de proteínas | Transferência de proteínas para membrana PVDF | ||
| Membrana PVDF | Millipore | IPVH08100 | |
| PyMOL | Schrödinger, LLC | https://pymol.org/ | Versão 2.6.1; Visualização e análise de poses de acoplamento proteína-ligante e interações moleculares |
| Placas ou tubos de qRT-PCR | Montagem da reação de qRT-PCR | ||
| R | R Foundation for Statistical Computing | https://www.r-project.org/ | Versão 4.3.1; Análises estatísticas e bioinformáticas |
| Pacote randomForest | CRAN | https://cran.r-project.org/package=randomForest | Versão 4.7.1.2; Seleção de características por floresta aleatória |
| REACTOME_HEME_BIOSYNTHESIS; REACTOME_HEME_DEGRADATION; WIKIPATHWAYS_HEME_BIOSYNTHESIS; REACTOME_SCAVENGING_HEME_FROM_PLASMA; HALLMARK_HEME_METABOLISM | Banco de Dados de Assinaturas Moleculares (MSigDB) | https://www.gsea-msigdb.org/gsea/msigdb | Versão 2024.1.Hs; 283 genes únicos após fusão; Definição de genes associados ao metabolismo do heme |
| Sistema de PCR em tempo real | Amplificação e detecção por qRT-PCR | ||
| Fator de crescimento de fibroblastos básico recombinante humano | Concentração final de 1 ng/mL; Suplemento para meio de cultura de fibroblastos | ||
| Tampão RIPA | Servicebio | G2002 | |
| Pacote rms | CRAN | https://cran.r-project.org/package=rms | Versão 6.7.1; Construção de nomograma |
| Reagentes ou géis pré-moldados de SDS-PAGE | Separção de proteínas por SDS-PAGE | ||
| Pacote Seurat | CRAN | https://satijalab.org/seurat/ | Versão 5.4.0; Pré-processamento, agrupamento e visualização de scRNA-seq |
| TarBase | DIANA Tools | https://carolina.imis.athena-innovation.gr/diana_tools/ | Versão 9.0; Fonte de interações miRNA-mRNA com suporte experimental |
| Kit Total RNA II | Omega | R6934-01 | |
| Biblioteca de compostos ativos de medicina tradicional chinesa | Fonte de compostos candidatos para triagem virtual | ||
| Tampão salino de Tris com Tween | Preparação do tampão de bloqueio e lavagem de membrana | ||
| UnionScript First-strand cDNA Synthesis Mix for qPCR (with dsDNase) | Genesand | SR511 |
Referências
- Dirand Z, et al. Macrophage phenotype is determinant for fibrosis development in keloid disease. Matrix Biol. 2024;128:79-92.
- Fang X, et al. Hypertrophic scarring and keloids: epidemiology, molecular pathogenesis, and therapeutic interventions. MedComm (2020). 2025;6(10):e70381.
- Adler R, et al. Pentoxifylline and long-term risk of keloid formation: a real-world 10-year outcomes study using TriNetX. J Am Acad Dermatol. 2026;94(5):1561-3.
- Banerjee P, et al. Anti-fibrotic properties of a decellularized extracellular matrix scaffold from porcine small intestinal submucosa in normal human and keloid fibroblasts. Int J Mol Sci. 2025;26(24):11764.
- Chang YH, McGrath JA, Hsu CK. Regression of extensive keloids during imatinib therapy for gastrointestinal stromal tumor. JAMA Dermatol. 2025;161(12):1293-4.
- Wang QR, et al. CCL17 drives fibroblast activation in the progression of pulmonary fibrosis by enhancing the TGF-β/Smad signaling. Biochem Pharmacol. 2023;210:115475.
- Higuchi Y, et al. Cavin-2 promotes fibroblast-to-myofibroblast trans-differentiation and aggravates cardiac fibrosis. ESC Heart Fail. 2024;11(1):167-78.
- Zhang H, et al. Plasma apolipoprotein E protein attenuates pulmonary fibrosis through LRP1 and PLAU dual receptor-mediated TGF-β/Smad inhibition. J Adv Res. 2025. doi:10.1016/j.jare.2025.12.045.
- Chen Q, et al. Immune imbalance drives keloid pathogenesis: emerging targets for precision immunotherapy. Adv Wound Care (New Rochelle). 2026:21621918261417702.
- Deng CC, et al. Single-cell RNA-seq reveals immune cell heterogeneity and increased Th17 cells in human fibrotic skin diseases. Front Immunol. 2024;15:1522076.
- Wang Q, et al. Weighted gene co-expression network analysis and machine learning identified the lipid metabolism-related gene LGMN as a novel biomarker for keloid. Exp Dermatol. 2024;33(1):e14974.
- Zhang W, et al. New insights into keloid pathogenesis: biomarker potential for CDK7 and DDB2. Front Cell Dev Biol. 2025;13:1718189.
- Li W, et al. Altered arginine metabolism affects proliferation and radiosensitivity of keloids. Exp Dermatol. 2025;34(3):e70077.
- Jiang J, et al. Ambient fine particulate matter induces cardiac fibrosis through triggering ferroptosis by heme degradation induced-iron overload. Ecotoxicol Environ Saf. 2025;297:118227.
- Lin W, et al. Heme oxygenase-1 overexpression activates the IRF1/DRP1 signaling pathway to promote M2-type polarization of spinal cord microglia. Drug Dev Res. 2024;85(8):e70033.
- Knez J, Kovačič B, Goropevšek A. The role of regulatory T-cells in the development of endometriosis. Hum Reprod. 2024;39(7):1367-80.
- Voltarelli VA, et al. Heme: the lord of the iron ring. Antioxidants (Basel). 2023;12(5):1074.
- Wilks A, Egoshi R. Heme trafficking and the importance of handling nature's most versatile cofactor. Chem Rev. 2025;125(23):11358-78.
- Bertino F, et al. Dysregulation of FLVCR1a-dependent mitochondrial calcium handling in neural progenitors causes congenital hydrocephalus. Cell Rep Med. 2024;5(7):101647.
- Kumar A, et al. Iron regulates the quiescence of naive CD4 T cells by controlling mitochondria and cellular metabolism. Proc Natl Acad Sci U S A. 2024;121(17):e2318420121.
- Jiang H, et al. Gut microbiota dysbiosis in diabetic nephropathy: mechanisms and therapeutic targeting via the gut-kidney axis. Front Endocrinol (Lausanne). 2025;16:1661037.
- Charoentong P, et al. Pan-cancer immunogenomic analyses reveal genotype-immunophenotype relationships and predictors of response to checkpoint blockade. Cell Rep. 2017;18(1):248-62.
- Chen Y, et al. 5-ALA photodynamic metabolite-powered zero-waste ferroptosis amplifier for enhanced hypertrophic scar therapy. Nat Commun. 2025;16(1):8321.
- Li X, et al. Hypericin-mediated photodynamic therapy promotes apoptosis and inhibits fibrosis by inducing HMOX1-mediated ferroptosis in hypertrophic scar fibroblasts. J Photochem Photobiol B. 2025;273:113303.
- Chen Y, et al. Functional transdermal nanoethosomes enhance photodynamic therapy of hypertrophic scars via self-generating oxygen. ACS Appl Mater Interfaces. 2021;13(7):7955-65.
- Oh S, et al. Revealing the pathogenesis of keloids based on the status: active vs inactive. Exp Dermatol. 2024;33(5):e15088.
- Zhao S, et al. New anti-fibrotic strategies for keloids: insights from single-cell multi-omics. Cell Prolif. 2025;58(6):e13818.
- Yasujima T, et al. The role of FLVCR1 and FLVCR2 in choline transport in the Caco-2 intestinal epithelial cell model and rat small intestine. Biochim Biophys Acta Mol Basis Dis. 2025;1871(6):167883.
- Zhang M, Chen H, Qian H, Wang C. Characterization of the skin keloid microenvironment. Cell Commun Signal. 2023;21(1):207.
- Wang Y, et al. FoxC1 activates Notch3 signaling to promote the inflammatory phenotype of keloid fibroblasts and aggravates keloid. Exp Cell Res. 2025;444(2):114402.
- Zhang J, et al. ERG transcriptionally activates SFRP1 to promote apoptosis of keloid fibroblasts and inhibit epithelial-mesenchymal transition and fibrosis through the Wnt3a/β-catenin pathway. Arch Dermatol Res. 2025;317(1):467.
- Ramos-Tovar E, Muriel P. NLRP3 inflammasome in hepatic diseases: a pharmacological target. Biochem Pharmacol. 2023;217:115861.
- Brahadeeswaran S, et al. NLRP3: a new therapeutic target in alcoholic liver disease. Front Immunol. 2023;14:1215333.
- Xiao Y, et al. STING mediates hepatocyte pyroptosis in liver fibrosis by epigenetically activating the NLRP3 inflammasome. Redox Biol. 2023;62:102691.
- Paolucci T, et al. Quantum molecular resonance inhibits NLRP3 inflammasome/nitrosative stress and promotes M1 to M2 macrophage polarization: potential therapeutic effect in osteoarthritis model in vitro. Antioxidants (Basel). 2023;12(7):1358.
- Wei J, et al. FERM domain containing kindlin 1 knockdown attenuates inflammation induced by intracerebral hemorrhage in rats via NLR family pyrin domain containing 3/nuclear factor kappa B pathway. Exp Anim. 2023;72(3):324-35.
- Tao L, Zhou Y, Wu L, Liu J. Comprehensive analysis of sialylation-related genes and construct the prognostic model in sepsis. Sci Rep. 2024;14(1):18110.
- Sun Q, et al. Identification of hub genes and key pathways associated with sepsis progression using weighted gene co-expression network analysis and machine learning. Int J Mol Sci. 2025;26(9):4433.
- Chen JJ. HRI protein kinase in cytoplasmic heme sensing and mitochondrial stress response: relevance to hematological and mitochondrial diseases. J Biol Chem. 2025;301(5):108494.
- Chakrabarty Y, Yang Z, Chen H, Chan DC. The HRI branch of the integrated stress response selectively triggers mitophagy. Mol Cell. 2024;84(6):1090-100.e6.
- Bora P, et al. Drug repurposing screen identifies an HRI activating compound that promotes adaptive mitochondrial remodeling in MFN2-deficient cells. Proc Natl Acad Sci U S A. 2025;122(48):e2517552122.
- Zhang C, et al. CaMKII suppresses proteotoxicity by phosphorylating BAG3 in response to proteasomal dysfunction. EMBO Rep. 2024;25(10):4488-514.
- Chaabani H, et al. Trifloxystrobin induces oxidative stress-dependent activation of the OMA1-DELE1-HRI integrated stress response leading to apoptosis in human neuroblastoma cells. Environ Pollut. 2026;390:127562.
- Das R, et al. CMT2A-linked MFN2 mutation, T206I promotes mitochondrial hyperfusion and predisposes cells towards mitophagy. Mitochondrion. 2024;74:101825.
- De Simone G, et al. Heme scavenging and delivery: the role of human serum albumin. Biomolecules. 2023;13(3):575.
- Turilli-Ghisolfi ES, Lualdi M, Fasano M. Ligand-based regulation of dynamics and reactivity of hemoproteins. Biomolecules. 2023;13(4):683.
- Zhang P, et al. Risk factors and prediction models for cardiotoxicity induced by anthracyclines in malignant chemotherapy. Cancer Chemother Pharmacol. 2025;95(1):73.
- Petrillo S, et al. Endothelial cells require functional FLVCR1a during developmental and adult angiogenesis. Angiogenesis. 2023;26(3):365-84.
- Fiorito V, Tolosano E. Unearthing FLVCR1a: tracing the path to a vital cellular transporter. Cell Mol Life Sci. 2024;81(1):166.
- Manco M, et al. FLVCR1a controls cellular cholesterol levels through the regulation of heme biosynthesis and tricarboxylic acid cycle flux in endothelial cells. Biomolecules. 2024;14(2):149.
- Shi X, et al. Increased melanin induces aberrant keratinocyte-melanocyte-basal-fibroblast cell communication and fibrogenesis by inducing iron overload and ferroptosis resistance in keloids. Cell Commun Signal. 2025;23(1):141.
- Khunger N, Dash A. Impact of air pollution on skin pigmentation: mechanisms and protective strategies. Int J Dermatol. 2025;64(10):1788-801.
- Ahuja K, Raju S, Dahiya S, Motiani RK. ROS and calcium signaling are critical determinant of skin pigmentation. Cell Calcium. 2025;125:102987.
- Dutta A, Chakraborty S, Roy A, Mittal A, et al. Tissue fibrosis in cardiorenal syndrome: crosstalk between heart and kidneys. Nephrol Dial Transplant. 2025;40(7):1273-83.
- Noah AA, et al. Reversal of fibrosis and portal hypertension by empagliflozin treatment of CCl4-induced liver fibrosis: emphasis on gal-1/NRP-1/TGF-β and gal-1/NRP-1/VEGFR2 pathways. Eur J Pharmacol. 2023;959:176066.
- Murakami T, Shigeki S. Pharmacotherapy for keloids and hypertrophic scars. Int J Mol Sci. 2024;25(9):4674.
- Jin J, Zheng Z. Gut microbiota-derived metabolites in keloid and hypertrophic scarring. Front Microbiol. 2025;16:1644758.
- Aubert A, et al. Potential implications of granzyme B in keloids and hypertrophic scars through extracellular matrix remodeling and latent TGF-β activation. Front Immunol. 2024;15:1484462.