Este fluxo de trabalho integra transcritômica em massa e de célula única com ensaios preliminares de tecido de pacientes para priorizar a MMP1 em úlceras de pé diabético. A MMP1 apresentou um padrão de expressão centrado em fibroblastos e maior abundância tecidual, sustentando uma associação com a remodelação da matriz, embora a causalidade e a utilidade clínica permaneçam indeterminadas.
Artigo de investigação
Transcriptômica Integrada em Grupo e de Célula Única com Validação Tecidual Prioriza MMP1 na Úlcera do Pé Diabético
* These authors contributed equally
Neste artigo
Resumo
Resumo
As fontes celulares de alterações transcritômicas reprodutíveis na úlcera do pé diabético (UPD) ainda não estão completamente definidas. Este estudo integrou análise de expressão diferencial, análise de rede de coexpressão gênica ponderada (WGCNA), triagem de genes associados à neuropatia periférica diabética (NPD), seleção exploratória de características por aprendizado de máquina, dois conjuntos externos de dados transcritômicos em grupo, análise de célula única, análise de rede da medicina tradicional chinesa (MTC), além de reação em cadeia da polimerase quantitativa (qPCR) e eletroforese em gel com transferência ocidental (western blotting) em tecidos de pacientes. No conjunto GSE199939 (10 amostras de UPD e 11 controles), identificaram-se 3.691 genes diferencialmente expressos, e o módulo azul da WGCNA mostrou forte associação com UPD (r = 0,97, p = 5 × 10-13). A intersecção entre os genes diferencialmente expressos, os genes centrais do módulo azul e 1.062 genes relacionados à NPD resultou em 77 candidatos. CCL7, CHEK1, MKI67, MMP1, MMP13 e TRPV2 foram apoiados por pelo menos dois métodos de seleção de características; a separação completa na eliminação recursiva de características por máquina de vetores de suporte levantou preocupações sobre sobreajuste na coorte de descoberta. MMP1 apresentou a maior alteração de expressão na coorte de descoberta (mudança no log2 = 9,854; p ajustado = 1,24 × 10⁻²⁹). Na matriz combinada GSE68183/GSE80178, MMP1 apresentou p ajustado de 0,0159 e área sob a curva característica de operação do receptor (AUC) de 0,981. No conjunto GSE134431, a expressão de MMP1 foi nominalmente maior na UPD do que na pele diabética sem úlcera (p = 0,0225; p ajustado = 0,135; AUC = 0,808). A análise de 69.944 células provenientes de 24 amostras mostrou a maior expressão média de MMP1 em fibroblastos, com maior expressão ao nível da amostra em fibroblastos, queratinócitos e células endoteliais de UPD. Ensaios em tecidos de pacientes mostraram maior abundância de mRNA de MMP1 em quatro pares emparelhados (teste pareado sobre ΔCq, p = 3,04 × 10⁻⁵) e maior abundância proteica em três pares emparelhados (teste pareado p = 0,0107). A replicação estatística foi incompleta. Os achados sugerem uma associação centrada em fibroblastos com remodelação da matriz, sujeita a limitações decorrentes da entrada em transcritos por milhão (TPM) na análise de descoberta baseada em contagem, registros incompletos de pré-processamento em análise de célula única e pequenas coortes nos ensaios com tecidos. A causalidade e a utilidade clínica ainda não foram estabelecidas.
Introdução
A úlcera do pé diabético é uma complicação grave e recorrente do diabetes que surge da convergência de neuropatia, carga mecânica repetitiva, doença arterial periférica, suscetibilidade a infecções e reparo tecidual prejudicado. Estimativas atuais indicam que milhões de pessoas são afetadas mundialmente a cada ano, e a cicatrização é frequentemente prolongada, com riscos substanciais de recorrência, hospitalização, amputação de membros inferiores e morte1. Assim, a prevenção e o tratamento dependem não apenas dos cuidados locais com a ferida, mas também da identificação da perda de sensibilidade protetora, da redução da pressão plantar, do tratamento da infecção e da isquemia, e da correção de fatores sistêmicos de risco1,2. A neuropatia periférica diabética é particularmente relevante porque a disfunção sensorial progressiva pode reduzir a percepção da pressão, trauma e rompimento tecidual, enquanto anormalidades motoras e autonômicas podem ainda alterar a biomecânica do pé e a integridade da pele2,3. No nível tecidual, a lesão neuropática pode coexistir com neuroinflamação, disfunção microvascular, estresse metabólico e reparo defeituoso, criando um ambiente de ferida no qual a lesão persiste apesar do tratamento convencional1,3.
A cicatrização cutânea bem-sucedida exige uma inflamação coordenada, reepitelização, angiogênese, ativação de fibroblastos, deposição da matriz extracelular (ECM) e subsequente remodelação da matriz. No diabetes, esses processos podem tornar-se temporariamente desorganizados: os sinais inflamatórios podem permanecer ativos, a migração de queratinócitos pode estar prejudicada, as respostas endoteliais podem ser insuficientes e os fibroblastos podem produzir ou organizar uma matriz anormal. Os fibroblastos são centrais na fase estromal da reparação, pois sintetizam proteínas da matriz, regulam a arquitetura do colágeno, comunicam-se com células imunes e epiteliais e contribuem para a contração da ferida. Estudos utilizando fibroblastos de úlceras de pé diabético (DFU) derivados de pacientes demonstraram anormalidades persistentes na transcrição relacionada à ECM e na montagem da matriz, reforçando a ideia de que o estado dos fibroblastos é um componente importante da biologia das feridas crônicas4. As metaloproteinases da matriz (MMPs) participam desse processo clivando substratos da ECM e permitindo a migração celular, a renovação tecidual e a remodelação; no entanto, seus efeitos dependem da localização, do momento, da disponibilidade de substratos e da regulação pelos inibidores teciduais das metaloproteinases (TIMPs)5. Um desequilíbrio entre proteólise e reposição da matriz pode, portanto, ser compatível com uma reparação prejudicada, mas o aumento da expressão de uma única MMP, por si só, não estabelece um papel prejudicial ou benéfico. A metaloproteinase da matriz 1 (MMP1), uma colagenase intersticial capaz de participar da renovação do colágeno fibrilar, tem sido relatada como alterada no tecido de DFU, e estudos clínicos anteriores associaram os perfis de MMP/TIMP ao estado da ferida ou às trajetórias de cicatrização6,7. Essas observações apoiam novas investigações sobre a MMP1 na DFU.
O perfilamento transcriptômico fornece uma abordagem sistemática para identificar programas moleculares associados às UDF, mas várias limitações metodológicas dificultam a interpretação. Os conjuntos de dados de tecido total médiam sinais provenientes de queratinócitos, fibroblastos, células endoteliais, células imunes e outros compartimentos, dificultando a determinação de se um candidato reflete alterações na expressão dentro de um tipo celular, mudanças na composição celular ou ambos. A comparabilidade entre conjuntos de dados também pode ser reduzida por diferenças nas plataformas, estratégias de normalização, locais de coleta do tecido, gravidade da úlcera, estado de infecção, estágio da doença e tecido de referência. É importante destacar que a pele diabética do pé sem úlcera representa um comparador tecidual diabético clinicamente relevante, mas não é intercambiável com pele saudável. O sequenciamento de RNA em única célula pode resolver parcialmente o problema da origem celular ao identificar populações celulares heterogêneas e seus estados transcricionais. Um estudo prévio com sequenciamento de única célula e transcriptômica espacial de UDF identificou populações distintas de fibroblastos e demonstrou que os programas de fibroblastos diferem conforme o contexto da ferida e o estado de cicatrização8. Esses achados apoiam o uso de análises resolvidas por célula para complementar dados transcriptômicos de tecido total.
Métodos de seleção de características podem ajudar a priorizar candidatos a partir de dados de expressão de alta dimensão, porém estudos biomédicos com pequenas amostras são particularmente suscetíveis a estimativas otimistas e seleção instável de genes. Quando o número de variáveis medidas excede em muito o número de amostras biológicas, pode ocorrer separação aparentemente perfeita, mesmo quando a informação preditiva generalizável é limitada. Reutilizar as mesmas observações para seleção de características, ajuste e avaliação de desempenho inflaciona ainda mais a AUC, tornando essenciais a validação cruzada aninhada, modelos travados e coortes de teste genuinamente independentes para avaliar o desempenho preditivo9,10. Essas preocupações são relevantes para estudos de UDF, pois coortes disponíveis publicamente são frequentemente pequenas e heterogêneas. Bancos de dados de ingredientes-alvos-ervas da medicina tradicional chinesa foram utilizados adicionalmente apenas para geração de hipóteses.
Este estudo integrou transcritômica em massa, WGCNA, triagem de genes relacionados à DPN, seleção de características por aprendizado de máquina, avaliação em conjuntos de dados externos, análise em nível de célula única, análise de rede de medicina tradicional chinesa e validação em tecidos de pacientes. Os genes candidatos identificados na coorte de descoberta foram avaliados em conjuntos adicionais de dados transcritômicos, e o principal candidato foi localizado em tipos celulares específicos utilizando dados de célula única. MMP1 foi então analisada nos níveis de mRNA e proteína em tecidos de pacientes por meio de qPCR e western blotting. Esta abordagem foi projetada para identificar um candidato associado à DFU reprodutível e caracterizar seu contexto celular e biológico.
Protocolo
Desenho do estudo e fontes de dados
O estudo, incluindo a coleta e o uso de espécimes de tecido humano para validação por qPCR e western blot, foi revisado e aprovado pelo Comitê de Ética do Hospital Quarto de Wuhan (número de aprovação KY2024-161-01). Todos os procedimentos envolvendo tecidos humanos foram conduzidos de acordo com o protocolo aprovado e os princípios éticos aplicáveis. O componente transcriptômico do estudo utilizou conjuntos de dados publicamente disponíveis e desidentificados. O consentimento informado por escrito foi obtido de todos os participantes cujos espécimes de tecido foram utilizados para a validação experimental. Os conjuntos de dados transcriptômicos de acesso público foram analisados em forma desidentificada, e os procedimentos de consentimento para os estudos originais que geraram os dados foram conduzidos pelas respectivas instituições.
Este estudo integrou transcritômica em massa, análise de rede, seleção de características, análise de única célula, predição de rede de MTC e validação em tecidos de pacientes. A coorte de descoberta foi o conjunto de dados Gene Expression Omnibus (GEO) GSE199939 (10 amostras de UDF e 11 amostras controle). A avaliação transcritômica em massa externa incluiu uma matriz mesclada GSE68183/GSE80178 (9 amostras de UDF e 6 amostras controle) e GSE134431 (13 amostras de UDF e 8 amostras de pele diabética sem úlcera [DFS]). A análise de única célula utilizou um objeto Seurat pré-processado e anotado com SingleR derivado do GSE165816, composto por 69.944 células provenientes de 24 amostras (14 UDF e 10 controles). A avaliação em tecidos incluiu quatro pares emparelhados de pacientes com UDF e tecido ao redor da úlcera para qPCR e três pares emparelhados para western blotting, com base em registros de ensaios recuperados e emparelhamento confirmado pelos autores. Todos os materiais e equipamentos utilizados neste estudo estão listados na Tabela de Materiais.
Construção do conjunto de genes relacionados à DPN
Genes relacionados à NPD foram recuperados do banco de dados Gene do Centro Nacional de Informação Biotecnológica (NCBI) utilizando o rentrez. Os termos de busca incluíram “neuropatia periférica diabética”, “neuropatia diabética”, “polineuropatia diabética”, “neuropatia diabética dolorosa” e “polineuropatia sensitivomotora diabética”, restritos a Homo sapiens. Os identificadores retornados foram mapeados para símbolos oficiais de genes, convertidos para letras maiúsculas, limpos e desduplicados. Os genes derivados do banco de dados foram combinados com uma lista de genes de NPD curada a partir da literatura e desduplicados, resultando em 1.062 genes relacionados à NPD. As cadeias completas de busca e o código de limpeza de identificadores estão incluídos nos scripts complementares; eles também incluem neuropatias diabéticas, diabetes combinada com polineuropatia distal simétrica ou neuropatia periférica, e o termo descritor MeSH “Neuropatias Diabéticas”. A componente derivada da literatura ainda requer comprovação em nível de citação.
Pré-processamento da coorte de descoberta e análise de expressão diferencial
A matriz de expressão GSE199939 foi alinhada à tabela de fenótipo pelo identificador de amostra. Identificadores de genes duplicados foram tornados únicos. A análise de descoberta arquivada arredondou os valores de expressão e ajustou um modelo binomial negativo utilizando o DESeq2 (versão 1.48.2), com grupo como fator de delineamento e DFU versus controle como contraste. Genes com valores de p ajustados ausentes foram excluídos. O controle de testes múltiplos foi realizado utilizando o procedimento de Benjamini–Hochberg (BH). A lista arquivada de genes diferencialmente expressos (GDE) utilizou uma mudança de razão log2 absoluta maior que 1 e p ajustado por BH < 0,05. A comparação com a fonte pública GEO confirmou que a entrada era TPM, e não contagens brutas de leituras. Arredondar TPM não atende ao requisito de contagens brutas do DESeq2. As estimativas originais foram mantidas, mas a validade das estatísticas de descoberta e dos resultados dependentes de WGCNA e seleção de características permanece indeterminada, aguardando uma reanálise apropriada. A comparação com a fonte está documentada no arquivo suplementar.
Para visualização, foi aplicada a transformação estabilizadora de variância do DESeq2 (VST) com blind = FALSE. A análise de componentes principais (PCA) foi realizada na matriz de expressão VST. O mapa de calor utilizou os escores z por linha para os 50 genes com os menores valores de p ajustados. A implementação do PCA centralizou e padronizou os valores transformados por gene utilizando prcomp com scale. = TRUE.
Análise de rede de coexpressão gênica ponderada
Para a WGCNA, genes com contagens superiores a 5 em pelo menos três amostras do GSE199939 foram mantidos. Os fatores de tamanho foram estimados com o DESeq2, a transformação VST foi aplicada com blind = TRUE, e os 5.000 genes com maior variância entre amostras foram selecionados. A qualidade das amostras e dos genes foi avaliada usando a função goodSamplesGenes, e a agrupamento hierárquico com ligação média foi utilizado para a avaliação da qualidade no nível das amostras.
Uma rede com sinal foi construída com o WGCNA (versão 1.74). Foram avaliadas potências candidatas de 1 a 10 e de 12 a 30 em incrementos de 2 utilizando o pickSoftThreshold; adotou-se um valor-alvo de ajuste à topologia livre de escala de 0,85, sendo a potência de limiarização suave selecionada igual a 18. Os módulos foram identificados com o blockwiseModules utilizando uma adjacência com sinal e uma matriz de sobreposição topológica com sinal, correlação de Pearson, tamanho mínimo do módulo de 30, altura de corte para fusão de 0,25, limiar de reassociação de 1 × 10⁻⁶, pamRespectsDendro = FALSE e tamanho máximo de bloco de 10.000.
Os eigengenes dos módulos foram correlacionados com um traço binário de DFU. Módulos não cinzentos com |r| > 0,5 e p < 0,05 foram considerados associados a DFU. Para cada módulo associado, a significância gênica (GS) foi definida como a correlação de Pearson entre a expressão gênica e o estado de DFU, e a pertinência ao módulo (MM) como a correlação de Pearson entre a expressão gênica e o eigengene correspondente do módulo. Os genes centrais (hub genes) foram definidos por |MM| > 0,8 e |GS| > 0,5. O módulo azul, que apresentou a associação positiva mais forte com DFU, foi selecionado para continuidade. Seus genes centrais foram intersectados com os DEGs e com o conjunto de genes relacionados a DPN. O limiar de hub relatado utiliza, portanto, os valores absolutos de MM e GS, independentemente do sinal da correlação.
Ordenação de características baseada em aprendizado de máquina
Os 77 genes compartilhados pelos conjuntos de genes DEG, hub do módulo azul e genes relacionados a DPN foram avaliados em GSE199939. Símbolos gênicos duplicados foram agrupados pela sua expressão média. A matriz de genes candidatos foi transformada por log2, sendo que quando o valor máximo excedia 50, as características com variância zero foram removidas e as características mantidas foram padronizadas. Utilizou-se uma semente aleatória de 123. A sequência implementada foi: triagem abrangente da coorte, agrupamento de símbolos duplicados, transformação logarítmica condicional, filtragem por variância zero, centralização e padronização da coorte completa e seleção de características específica ao algoritmo. A triagem DEG e WGCNA utilizou toda a coorte de descoberta antes da validação cruzada no nível do algoritmo. O fluxo de trabalho relatado, portanto, não estabelece uma validação aninhada livre de vazamento, e suas AUCs internas não podem ser utilizadas como estimativas não tendenciosas do desempenho preditivo.
Três procedimentos de seleção de características foram aplicados. Primeiro, foi ajustada uma regressão logística com operador de seleção e redução absoluta mínima (LASSO) utilizando o pacote glmnet (versão 5.0), família binomial, alpha = 1, erro de classificação como medida de validação cruzada, sem padronização adicional e validação cruzada de cinco dobras limitada pelo tamanho da classe menor. As características em lambda.1se foram selecionadas; lambda.min foi utilizada apenas se lambda.1se não selecionasse nenhum gene. Segundo, foi ajustada uma floresta aleatória com 1.000 árvores utilizando o pacote randomForest (versão 4.7-1.2); foram mantidos os genes com diminuição média no índice de Gini pelo menos tão elevada quanto a importância média entre os genes candidatos. Terceiro, foi implementada a eliminação recursiva de características por máquina de vetores de suporte linear (SVM-RFE) com o pacote e1071 (versão 1.7-17), classificando as características pelo quadrado do peso linear no coorte completo antes de avaliar subconjuntos progressivamente menores por meio da área sob a curva (AUC) da validação cruzada leave-one-out (LOOCV). A classificação não foi recalculada dentro de cada dobra de treinamento. O ajuste do SVM linear utilizou scale = FALSE e probability = TRUE, sem uma grade explícita de ajuste de custo. A seleção da penalidade LASSO utilizou sua validação cruzada interna, sem um loop externo de avaliação separado, e a importância na floresta aleatória foi calculada a partir do coorte completo.
Nenhum gene foi selecionado pelos três métodos; portanto, foram mantidos os genes apoiados por pelo menos dois métodos. O SVM-RFE produziu uma AUC de 1,00 em todos os tamanhos de subconjunto avaliados, e o menor subconjunto empatado foi selecionado. Como essa separação completa gerou preocupações sobre superajuste e avaliação otimista na pequena coorte de descoberta, a AUC do SVM-RFE não foi interpretada como uma estimativa do desempenho clínico. Nenhum modelo multigênico fixo foi testado em uma coorte externa; análises externas de curva ROC (receiver operating characteristic) avaliaram a expressão individual de genes candidatos. A inspeção do script de análise confirmou que o pré-processamento e a classificação de características pelo SVM não foram restritos às dobras de treinamento. Os mesmos resultados de LOOCV foram utilizados para escolher o tamanho do subconjunto, sem um loop externo de avaliação. Consequentemente, este fluxo de trabalho apresenta vazamento de informação e suporta apenas a priorização exploratória de características.
Análise de enriquecimento funcional
Análises de super-representação de Ontologia Genética (GO) e Enciclopédia de Quioto de Genes e Genomas (KEGG) foram realizadas no painel de seis genes. Os símbolos gênicos foram mapeados para identificadores Entrez com org.Hs.eg.db (versão 3.21.0). A análise de GO foi realizada com clusterProfiler (versão 4.16.0) nas ontologias de processo biológico, componente celular e função molecular. O enriquecimento KEGG utilizou o código do organismo humano (hsa). Termos significativos foram definidos como p nominal < 0,05 e p ajustado por BH < 0,05. Como apenas seis genes foram incluídos, a análise de enriquecimento foi usada principalmente para anotação funcional. O script KEGG utilizou anotações locais do KEGG.db com enrichKEGG(use_internal_data = TRUE); a versão da anotação deve ser documentada. Os scripts de GO e KEGG não forneceram um universo personalizado, portanto, as bases de dados de anotação definiram os fundos padrão.
Avaliação externa de transcriptoma em massa
Para a matriz mesclada GSE68183/GSE80178, os símbolos gênicos foram padronizados e os símbolos duplicados foram agrupados pela média de expressão nas linhas correspondentes. Os seis genes candidatos foram alinhados ao arquivo de fenótipo. Como os arquivos disponíveis não documentaram completamente o procedimento de mesclagem prévia e correção de lote, este conjunto de dados foi analisado conforme fornecido e interpretado com cautela. Consequentemente, não é possível estabelecer, a partir do registro de processamento fornecido, nem a remoção de efeitos de lote nem a independência do sinal do grupo em relação aos efeitos do estudo. Essa matriz fornece suporte exploratório entre conjuntos de dados, e não uma replicação definitiva.
Para o GSE134431, os seis genes candidatos foram extraídos da matriz de leituras por quilobase por milhão de leituras mapeadas (RPKM) e transformados como log2(RPKM + 1). O DFS foi usado como grupo de referência e o DFU como grupo de comparação. O DFS representa a pele diabética sem úlcera. O Figura 4C originalmente submetida representou os valores brutos de RPKM; o painel revisado utiliza a escala log2(RPKM + 1) indicada. Testes de Wilcoxon bicaudais com aproximação normal e correção de continuidade, bem como análises ROC orientadas automaticamente, foram verificados em ambas as escalas e resultaram em valores p e AUCs idênticos, pois a transformação é estritamente monotônica.
Em cada conjunto de dados de validação em massa, as diferenças de expressão entre grupos foram testadas utilizando testes de soma de postos de Wilcoxon bicaudais, e a correção de BH foi aplicada nos seis genes. Curvas ROC foram calculadas com o pROC (versão 1.19.0.1), utilizando direção selecionada automaticamente pelo pacote. AUCs e intervalos de confiança correspondentes de 95% (ICs) foram calculados para comparar padrões discriminatórios entre conjuntos de dados. A seleção automática da direção da ROC a partir de cada conjunto de dados de avaliação pode resultar em discriminação otimista; essas AUCs de gene único são descritivas e não validam um modelo de predição clínica pré-especificado.
Localização em nível de célula única e análise em nível de amostra
A análise de célula única utilizou o objeto Seurat salvo biofsci_SingleR_annotated_MMP1_analyzed.rds do GSE165816, contendo 22.889 genes e 69.944 células no ensaio de RNA. O ensaio de RNA manteve uma camada de contagens de inteiros não negativos e uma camada de dados gerada pela normalização logarítmica (LogNormalize) com um fator de escala de 10.000, seguida pela transformação log1p; esta última não foi TPM. O objeto continha 2.000 genes variáveis selecionados utilizando o método vst (loess.span = 0,3; 20 intervalos de largura igual), expressão padronizada para todos os genes mantidos (centralização e padronização ativadas; scale.max = 10) e 50 componentes principais calculados a partir das características variáveis com semente 42. O histórico de comandos salvo utilizou as dimensões do Harmony de 1 a 20 para a construção de vizinhos mais próximos e para a aproximação uniforme de variedades e projeção (UMAP). As configurações de vizinhança incluíram k = 20, Annoy com 50 árvores e distância euclidiana, e um limiar de poda de vizinhos mais próximos compartilhados (SNN) de 1/15. O agrupamento utilizou resolução 0,8, algoritmo 1, n.start = 10, n.iter = 10 e random.seed = 0. A UMAP utilizou a implementação uwot, 30 vizinhos, duas dimensões de saída, métrica de distância cosseno, min.dist = 0,3, spread = 1, learning.rate = 1 e semente 42. O objeto manteve uma redução Harmony, mas os cortes originais de controle de qualidade, a chamada completa RunHarmony incluindo as covariáveis de lote e as configurações de referência e anotação do SingleR para este objeto analisado não puderam ser recuperados. As etiquetas de tipo celular, etiquetas de grupo e identificadores de amostra foram armazenados em SingleR_label, Group e orig.ident, respectivamente. Dez tipos celulares anotados foram mantidos: linfócitos B, linfócitos T CD8+, células endoteliais, células epiteliais, fibroblastos, células-tronco hematopoiéticas, queratinócitos, macrófagos, monócitos e neurônios.
A expressão de MMP1 foi resumida por tipo celular. Células com expressão normalizada de MMP1 maior que zero foram classificadas como positivas para MMP1. Para a análise no nível da amostra, a expressão média normalizada foi calculada para cada combinação de amostra e tipo celular. As amostras de DFU e controle foram comparadas dentro de cada tipo celular utilizando testes de soma de postos de Wilcoxon bicaudais, seguidos pela correção de BH em todos os tipos celulares testados. O acesso da amostra no GEO, e não a célula individual, foi a unidade utilizada nessas comparações relatadas. Os 24 acessos não foram considerados como prova de 24 doadores independentes. O objeto salvo não continha um identificador de doador verificado, e a coleta repetida de tecido dentro dos mesmos doadores não foi modelada; assim, os testes no nível da amostra são interpretados como exploratórios. Esses resumos representam a média da expressão normalizada dentro de cada amostra e tipo celular; não são modelos pseudobulk de expressão diferencial baseados na soma de contagens.
Dez conjuntos funcionais de genes foram pontuados com o método Seurat AddModuleScore. Foram calculadas as correlações de Spearman entre a expressão de MMP1 por célula e as pontuações dos módulos, com correção de BH. Para a análise exploratória de MMP1-alta, foram selecionados os três tipos celulares com maior expressão média de MMP1 entre os tipos celulares que continham pelo menos 50 células. Um limite global foi definido como a mediana da expressão entre as células positivas para MMP1, quando estavam disponíveis mais de 10 células positivas; caso contrário, o script utilizou o percentil 75 geral. As células acima desse limite foram atribuídas ao grupo MMP1-alta e as demais células ao grupo MMP1-baixa. O FindMarkers utilizou um teste de Wilcoxon, logfc.threshold = 0,25 e min.pct = 0,1. Os genes regulados para cima com p ajustado < 0,05 foram submetidos à análise de enriquecimento de processos biológicos GO. Como os grupos foram definidos pela expressão de MMP1, esta análise foi usada para descrever vias associadas ao estado MMP1-alta. As correlações por célula, seus valores de p ajustados e o enriquecimento de MMP1-alta versus MMP1-baixa são descritivos, pois a dependência intra-amostra não foi modelada. As células individuais não foram interpretadas como réplicas biológicas independentes.
Previsão de ingrediente-alvo-erva na MTC
Os seis genes priorizados foram associados à coluna 4 da tabela local de interação químico-gene do Banco de Dados Comparativo de Toxicogenômica (CTD). Os registros foram restringidos a Homo sapiens na coluna 7. Os nomes dos ingredientes foram simplificados e normalizados para letras minúsculas para fins de correspondência, e foram removidos os mapeamentos duplicados de ingrediente-alvo e erva-ingrediente. Os ingredientes foram vinculados às ervas utilizando a tabela de referência erva-ingrediente. O enriquecimento do banco de dados utilizou p nominal < 0,05 e p ajustado < 0,05. Registros duplicados de erva-ingrediente-alvo foram removidos antes do resumo baseado em cobertura. O enriquecimento de ervas utilizou o clusterProfiler::enricher com o mapeamento erva-ingrediente como TERM2GENE, minGSSize = 1, maxGSSize = 500, pvalueCutoff = 1 e qvalueCutoff = 1, antes da aplicação dos limiares de significância nominal e ajustado por BH. Esses links de banco de dados podem descrever alterações na expressão ou atividade e não estabelecem ligação direta nem um sentido uniforme do efeito.
As plantas medicinais foram classificadas utilizando o seguinte escore de cobertura:
S = 3R + 5L +2T + 3C + 2I + N (1)
Aqui, R é a contagem de registros de MMP1, L é o número de ingredientes associados ao MMP1, T é o número de alvos abrangidos, C é a quantidade de ingredientes principais, I é o indicador do eixo da matriz e N é o número total de ingredientes.
Os ingredientes principais foram quercetina, luteolina e berberina. O indicador de eixo da matriz foi definido como 1 quando uma planta cobria tanto a MMP1 quanto a MMP13 e como 0 caso contrário. Exigia-se que as plantas candidatas contivessem pelo menos um registro associado à MMP1 e, adicionalmente, ou pelo menos dois ingredientes associados à MMP1 ou pelo menos quatro alvos mais um ingrediente principal. A pontuação foi utilizada para resumir a cobertura do banco de dados e não foi considerada uma medida de eficácia farmacológica. Os coeficientes definem uma regra personalizada e heurística de cobertura que enfatiza registros e ingredientes associados à MMP1, maior cobertura de alvos, os três ingredientes designados e a cobertura conjunta de MMP1/MMP13. Eles não foram ajustados com base em desfechos clínicos nem validados experimentalmente, e pesos alternativos poderiam alterar a classificação das plantas.
Coleta de tecido do paciente e avaliação preliminar por qPCR e western blot
Pacientes com úlceras do pé diabético clinicamente diagnosticadas que foram submetidos a desbridamento ou cirurgia clinicamente indicados no Hospital Quarto de Wuhan foram considerados elegíveis quando estava disponível tecido do pé e quando havia sido obtido consentimento informado por escrito. Os critérios de exclusão foram: presença de malignidade no local da amostragem, causa da úlcera não relacionada ao diabetes ou quantidade ou qualidade insuficiente do tecido para os ensaios planejados. O tecido de UPD e o tecido não ulcerado ao redor da ferida foram obtidos do mesmo paciente conforme protocolo de estudo aprovado. Este último serviu como controle pareado de tecido perilesional; não se tratava de pele saudável não diabética. A avaliação por qPCR compreendeu quatro pares pareados (quatro espécimes de UPD e quatro espécimes correspondentes perilesionais), e o ensaio de western blotting compreendeu três pares pareados. O pareamento foi confirmado pelos autores para cada ensaio; a identidade entre ensaios não foi utilizada nas comparações estatísticas. Cada paciente foi a unidade biológica, e as poças técnicas de PCR representaram medições repetidas dentro de um mesmo espécime. Esses ensaios preliminares tinham como objetivo avaliar a expressão tecidual de MMP1 e não foram concebidos para estabelecer desempenho diagnóstico, causalidade ou generalização entre fenótipos de UPD.
Para a validação por qPCR, o RNA total foi extraído de espécimes teciduais derivados de pacientes utilizando um reagente de extração de RNA total, conforme as instruções do fabricante. A concentração e pureza do RNA foram avaliadas espectrofotometricamente, e amostras com razão A260/A280 entre 1,8 e 2,1 foram utilizadas nas análises subsequentes. O RNA total (1 µg) foi transcrito reversamente utilizando um kit de transcrição reversa do vírus da leucemia murina de Moloney (M-MLV) em um volume final de reação de 20 µL. O projeto do instrumento disponível identifica um sistema de PCR em tempo real. A PCR quantitativa foi realizada utilizando mix mestra PCR SYBR Green 2x em uma reação de 20 µL contendo 10 µL da mix mestra SYBR Green 2x, 0,4 µL de cada iniciador (sentido e antissentido), 2 µL de DNA complementar (cDNA) e 7,2 µL de água livre de nucleases. O programa de amplificação consistiu em uma desnaturação inicial a 95 °C por 30 s, seguida por 40 ciclos de 95 °C por 5 s e 60 °C por 30 s. Uma análise de curva de dissociação foi realizada para verificar a especificidade da amplificação. A abundância de transcritos de MMP1 foi medida utilizando β-actina (ACTB) como gene de referência. As sequências dos iniciadores estão listadas na Tabela 1. Para a análise pareada revisada, as cinco réplicas técnicas por alvo dentro de cada espécime foram médias antes do cálculo de ΔCq, e a expressão relativa de MMP1 foi calculada utilizando o método 2-ΔΔCq , utilizando o grupo de tecido perilesional não ulcerado como calibrador. Os pares de amostras recuperados foram NC–DFU, NC1–DFU1, NC2–DFU2 e NC3–DFU3, confirmados pelos autores como quatro pares pareados de pacientes. O gráfico anterior de qPCR utilizou cinco valores técnicos apenas de NC e DFU; o gráfico revisado mostra um valor por espécime após a média das réplicas técnicas para cada um dos quatro pares. A inferência pareada utilizou ΔCq = média de Cq(MMP1) − média de Cq(ACTB), em vez de valores de mudança de dobra em nível de poço. O projeto de instrumento arquivado também difere do volume de reação e programa de ciclagem relatados, e sua correspondência com o experimento plotado permanece não resolvida.
Para validação por western blot (WB), espécimes de tecido foram homogenizados em tampão de radioimunoprecipitação gelado, suplementado com inibidores de protease. Os lisados foram incubados no gelo por 30 min e centrifugados a 12.000 x g durante 15 min a 4 °C. Os sobrenadantes foram coletados e as concentrações proteicas foram determinadas por ensaio de ácido bicinconínico. Quantidades iguais de proteína (20 µg por poço) foram separadas em géis de gradiente de dodecilsulfato de sódio-poliacrilamida de 4%–20% e transferidas para membranas de difluoreto de polivinilideno de 0,22 µm. As membranas foram bloqueadas com leite desnatado a 5% em solução salina tamponada com Tris contendo 0,1% de Tween-20 durante 1 h à temperatura ambiente e incubadas durante a noite a 4 °C com anticorpo policlonal contra MMP1 (1:1.000) e anticorpo policlonal contra cofilina (1:6.000). Após três lavagens com solução salina tamponada com Tris contendo 0,1% de Tween-20, as membranas foram incubadas com imunoglobulina G (IgG) de cabra conjugada à peroxidase de rábano picante (1:5.000) durante 1 h à temperatura ambiente. As bandas proteicas foram visualizadas utilizando um substrato quimioluminescente melhorado e imagens foram obtidas com um sistema de detecção de quimioluminescência usando o software operacional associado (versão 1.2.0), conforme registrado nos metadados da imagem. As bandas foram quantificadas utilizando o software ImageJ. A cofilina foi utilizada como controle de carga e a abundância da proteína MMP1 foi normalizada em relação à cofilina para comparação entre grupos.
Análise estatística e software
Todos os testes foram bicaudais, salvo indicação em contrário. O valor de p ajustado por BH < 0,05 foi utilizado como limiar principal para correção de múltiplos testes. Os tamanhos amostrais exatos variaram conforme o conjunto de dados e, para a análise em nível de amostra de célula única, conforme a presença de um determinado tipo celular em cada amostra. Os resumos contínuos de expressão são apresentados como observações individuais, com boxplots exibindo a mediana e o intervalo interquartil; as hastes se estendem até 1,5 vez o intervalo interquartil. Para o ensaio de western blot, as seis razões recuperadas de MMP1 em relação à cofilina foram analisadas utilizando um teste t pareado bicaudal em três pares de pacientes confirmados pelos autores (df = 2; p = 0,0107). Para a qPCR, cinco valores de Cq de ACTB e cinco de MMP1 foram médios separadamente dentro de cada espécime antes do cálculo de ΔCq. Um teste t pareado bicaudal comparou os valores de ΔCq de DFU e de pele perilesional pareada em quatro pares de pacientes confirmados pelos autores (df = 3; p = 3,04 × 10⁻⁵). A média de ΔCq perilesional foi utilizada como calibrador comum para a exibição da expressão relativa. A razão geométrica média de variação intra-paciente e seu IC de 95% foram obtidas por meio da transformação inversa da diferença média de ΔCq pareado e de seu IC baseado em t. As observações biológicas individuais são mostradas com linhas conectando tecidos pareados; poços técnicos não aumentam o tamanho da amostra biológica. Os valores de p por tecido-ensaio são nominais e exploratórios. Com três ou quatro pacientes, a normalidade das diferenças pareadas não pode ser avaliada de forma confiável, e os ensaios permanecem preliminares. As análises bioinformáticas e a geração de figuras foram realizadas em R 4.5.2 no Windows 11. As versões dos pacotes principais incluíram DESeq2 1.48.2, WGCNA 1.74, glmnet 5.0, randomForest 4.7-1.2, e1071 1.7-17, pROC 1.19.0.1, clusterProfiler 4.16.0, Seurat 5.5.0, SingleR 2.10.0, rentrez 1.2.4 e ggplot2 4.0.3. Um inventário consolidado de software, bases de dados e parâmetros está disponível em Supplementary Table 1.
Resultados
A transcrição por descoberta identifica um amplo programa de expressão associado à UDM
O conjunto GSE199939 serviu como a coorte de descoberta e incluiu 10 amostras de UDF e 11 amostras controle (Figura 1A). A análise de componentes principais da expressão normalizada por VST mostrou separação clara entre os grupos; os componentes principais 1 e 2 explicaram 34,8% e 15,1% da variância total, respectivamente (Figura 1B).
Utilizando |log2 da razão de expressão| > 1 e p ajustado por BH < 0,05, a análise de expressão diferencial identificou 3.691 genes diferencialmente expressos (GDEs), incluindo 1.247 genes superexpressos em DFU e 2.444 genes subexpressos em DFU (Figura 1C). Os 50 principais GDEs formaram um padrão de expressão fortemente estruturado por grupos (Figura 1D). Dentre os seis genes selecionados posteriormente, MMP1 apresentou a maior alteração na coorte de descoberta (log2 da razão de expressão = 9,854; p ajustado = 1,24 × 10⁻²⁹).
Um módulo de coexpressão associado a UDF converge com DEGs e genes relacionados à NDP
A WGCNA foi realizada nos 5.000 genes mais variáveis transformados por VST. Uma potência de limiarização suave de 18 foi selecionada para a rede sinalizada, equilibrando o ajuste à topologia livre de escala e a conectividade (Figura 2A). A clusterização hierárquica e a detecção dinâmica de módulos identificaram múltiplos módulos de coexpressão (Figura 2B). O módulo azul apresentou a associação positiva mais forte com DFU (Pearson r = 0,97, p = 5 × 10-13; Figura 2C). Resumos correspondentes de controle de qualidade da clusterização de amostras e do tamanho do módulo estão fornecidos na Figura Suplementar 1A,B.
Dentro do módulo azul, 689 genes atenderam aos critérios de hub |MM| > 0,8 e |GS| > 0,5 (Figura 2D). A interseção entre os 3.691 genes diferencialmente expressos (DEGs), os 689 genes centrais do módulo azul e os 1.062 genes relacionados à DPN resultou em 77 genes candidatos compartilhados (Figura 2E). Uma visualização simplificada da rede de genes centrais do módulo azul e as estatísticas de hub de maior classificação são apresentadas na Figura Suplementar 2A,B.
A seleção de características por múltiplos métodos prioriza seis genes, mas mostra superajuste na coorte de descoberta
Os 77 genes interseccionais foram analisados por LASSO, floresta aleatória e SVM-RFE. O LASSO manteve sete genes na penalidade selecionada: MMP1, MMP13, TRPV2, CCL7, AURKA, MKI67 e CHEK1 (Figura 3A). A filtragem por floresta aleatória manteve 41 genes com importância igual ou acima da média, incluindo cinco membros do painel final entre as características mais altamente classificadas (Figura 3B). O SVM-RFE produziu uma AUC de 1,00 para cada subconjunto aninhado avaliado; segundo a regra de empate de tamanho mínimo, CHEK1 foi selecionado como o subconjunto de um gene (Figura 3C), levantando preocupações sobre sobreajuste e avaliação otimista na coorte de descoberta. As expressões correspondentes na coorte de descoberta, bem como os mapas de calor e as curvas ROC, são mostrados na Figura Suplementar 3A–C.
Nenhum gene foi selecionado pelos três métodos. A retenção de genes apoiados por pelo menos dois métodos resultou em CCL7, CHEK1, MKI67, MMP1, MMP13 e TRPV2 (Figura 3D). A anotação GO desses seis genes destacou a desmontagem da matriz extracelular, processos catabólicos e metabólicos de colágeno, cromossomo condensado e funções relacionadas à metaloendopeptidase (todos com p ajustado por BH < 0,05; Figura 3E). A análise KEGG identificou sinalização da interleucina-17 (IL-17) (CCL7/MMP1/MMP13; p ajustado = 1,81 × 10⁻⁴) e sinalização da relaxina (MMP1/MMP13; p ajustado = 0,0175; Figura 3F). Esses resultados de enriquecimento foram utilizados para caracterizar as funções biológicas representadas pelo painel de seis genes.
Avaliação entre conjuntos de dados mostra apoio heterogêneo para MMP1
Na matriz combinada GSE68183/GSE80178 (9 UDC e 6 controles), CCL7, MMP1, e MMP13 diferiram entre os grupos após a correção de BH ao longo dos seis genes (ajustado p = 0,0168, 0,0159 e 0,0431, respectivamente; Figura 4A). CHEK1, MKI67, e TRPV2 não atingiu o limiar de significância ajustado (ajustado p = 0,259, 0,680 e 0,259). A análise ROC de um único gene produziu AUCs de 0,944 para CCL7 (95% IC, 0,825–1,000), 0,704 para CHEK1 (0,403–1,000), 0,574 para MKI67 (0,243–0,905), 0,981 para MMP1 (0,930–1,000), 0,870 para MMP13 (0,686–1,000) e 0,722 para TRPV2 (0.447–0.997; Figura 4B). Esses valores de ROC foram considerados exploratórios porque o procedimento de mesclagem e correção de lote não foi totalmente documentado.
Em GSE134431 (13 amostras de UDF e 8 amostras de SDF não ulceradas), a expressão de MMP1 foi maior em UDF do que em SDF no teste de Wilcoxon ao nível de significância nominal (p = 0,0225), embora essa associação não tenha permanecido significativa após correção BH (p ajustado = 0,135; Figura 4C). Os outros cinco genes não mostraram diferenças significativas entre os grupos. MMP1 também apresentou a maior AUC descritiva, com um valor de AUC de 0,808 (IC 95%, 0,589–1,000), enquanto as AUCs dos outros candidatos variaram de 0,529 a 0,635 (Figura 4D). No geral, MMP1 exibiu o padrão descritivo mais consistente entre os seis candidatos, mas a replicação estatística foi incompleta.
A análise de célula única localiza MMP1 predominantemente nos fibroblastos
O conjunto de dados de célula única continha 69.944 células provenientes de 24 amostras (14 úlceras do pé diabético e 10 controles) e compreendia 10 tipos celulares anotados (Figura 5A). A visualização de características por UMAP localizou a expressão de MMP1 em regiões celulares restritas, ao invés de mostrar uma expressão uniforme ao longo do atlas (Figura 5B). No geral, 3.799 células (5,43%) apresentaram expressão normalizada de MMP1 maior que zero. Os fibroblastos exibiram a maior expressão média normalizada (0,181) e a maior fração geral de células positivas para MMP1 (7,88%; Figura 5C).
No nível da amostra, a expressão média de MMP1 foi maior nas amostras de UDF do que nas amostras de controle em queratinócitos, fibroblastos e células endoteliais. Após a correção de BH em todos os tipos celulares testados, cada uma dessas comparações apresentou um valor p ajustado de 0,0214 (queratinócitos: 9 amostras de controle e 14 de UDF; fibroblastos: 10 e 14; células endoteliais: 10 e 14; Figura 5D). A fração positiva para MMP1 aumentou de 5,86% para 9,29% em fibroblastos, de 0,026% para 6,68% em queratinócitos e de 0,29% para 2,67% em células endoteliais (Figura 5E).
As correlações entre pontuações de módulos por célula foram modestas. A maior correlação positiva foi observada para a pontuação do módulo de senescência/fenótipo secretório associado à senescência (SASP) (rho de Spearman = 0,274), seguida pela remodelação da matriz extracelular (rho = 0,240), ferroptose (rho = 0,197) e ativação de fibroblastos (rho = 0,170; Figura 5F). A comparação entre fibroblastos MMP1-altos e MMP1-baixos mostrou enriquecimento em termos relacionados à organização da matriz extracelular, organização da estrutura extracelular, organização de fibrilas de colágeno, processamento de glicoproteínas e dobramento de proteínas (Figura 5G). Esses achados descritivos associaram o estado de fibroblastos MMP1-altos a processos relacionados à remodelação da matriz. São fornecidos, em Figura Suplementar 4A–C, UMAP em nível de grupo, resumos de amostras de todos os tipos celulares e contexto de pontuações funcionais. As associações em nível individual não foram consideradas evidência independente do doador.
A cobertura da rede prioriza ingredientes vinculados à MMP1 e ervas candidatas
A tabela filtrada de relações ingrediente-herbal-alvo continha 561 registros únicos associando 99 ervas, 14 ingredientes e cinco dos seis alvos candidatos. MMP1 foi o alvo mais frequente, com 156 registros, seguido por CHEK1 (120), MMP13 (102), MKI67 (100) e TRPV2 (83; Figura 6A). Entre os ingredientes, a quercetina e a luteolina apresentaram a maior cobertura de ervas, estando ligadas a 83 e 62 ervas, respectivamente. A berberina foi associada a 10 ervas; esses três ingredientes foram utilizados como ingredientes principais na regra de priorização (Figura 6B).
O escore de cobertura classificou Guanhuangbo, Mahuang e Niuxi conjuntamente nas posições mais altas (escore = 38 cada; Figura 6C). Cada um cobriu todos os cinco alvos disponíveis e continha dois ingredientes associados ao MMP1. A matriz ingrediente-alvo mostrou que a quercetina proporcionou a cobertura mais ampla entre os alvos analisados, enquanto a luteolina e a berberina forneceram conectividade adicional centrada no MMP1 (Figura 6D). Uma rede focada conectou as principais plantas medicinais aos ingredientes representativos e aos cinco alvos disponíveis (Figura 6E). Esses resultados identificaram combinações erva-ingrediente-alvo com alta cobertura no banco de dados para avaliação adicional. Matrizes complementares de cobertura erva-alvo e ingrediente principal são apresentadas na Figura Suplementar 5A,B.
Ensaios preliminares com tecidos pareados mostram maior abundância de mRNA e proteína da MMP1
A avaliação por Western blot mostrou maior abundância de MMP1 em espécimes de UDF do que em seus espécimes correspondentes de pele perilesional não ulcerada (Figura 7A,B). As três pares correspondentes apresentaram uma diferença média de 0,3553 no índice MMP1/cofilina (DFU menos perilesional) (IC 95%, 0,1959–0,5147; teste t pareado bicaudal, t(2) = 9,592, p = 0,0107). As medições pareadas de cada paciente estão apresentadas na Figura 7B. Após a média de cinco poços técnicos por gene por espécime, a qPCR mostrou maior abundância normalizada de mRNA de MMP1 em cada um dos quatro espécimes de UDF em comparação com seus espécimes perilesionais correspondentes (Figura 7C). A diferença média dentro do paciente no ΔCq (DFU menos perilesional) foi de −2,6035 (IC 95%, −2,8024 a −2,4046; teste t pareado bicaudal, t(3) = −41,663, p = 3,04 × 10⁻⁵), correspondendo a um aumento médio geométrico de 6,08 vezes (IC 95%, 5,30–6,98). Essas observações baseadas em pequenas amostras são preliminares e não estabelecem um efeito funcional.
Nas descobertas e nos conjuntos de dados externos em lote, MMP1 apresentou o padrão descritivo mais consistente entre os seis genes priorizados, embora a replicação estatística tenha sido incompleta. Os resumos de célula única mostraram a expressão média mais elevada em fibroblastos, e as medições pareadas de WB de três pacientes e medições pareadas de qPCR de quatro pacientes mostraram maior abundância de MMP1. Essas observações sustentam MMP1 como um candidato associado à UDF para investigação adicional. O fluxo de trabalho geral de avaliação computacional a tecidual é resumido na Figura Suplementar 6.
DISPONIBILIDADE DE DADOS:
Os conjuntos de dados transcriptômicos públicos estão disponíveis no NCBI Gene Expression Omnibus mediante os números de acesso GSE199939, GSE68183, GSE80178, GSE134431 e GSE165816. Os scripts disponíveis para análise e geração de figuras, tabelas de expressão e resultados processados, tabelas-fonte quantitativas para figuras, tabelas de saída estatística, a pasta original de qPCR e o projeto do instrumento, bem como as imagens fornecidas de western blot sem recorte estão incluídos no Arquivo Suplementar 1. O arquivo também contém metadados celulares extraídos e histórico de comandos do objeto de célula única recuperado, relatórios de verificação de tipo matricial e um manifesto de arquivos. O Arquivo Suplementar 1 mantém arquivos-fonte históricos e inclui uma pasta R2_Updates contendo as tabelas-fonte revisadas de ensaios pareados, saídas estatísticas, código para geração de figuras e inventário de parâmetros corrigido. O RDS completo analisado do Seurat é identificado na documentação do arquivo, mas não está incorporado neste ZIP suplementar. O histórico completo de mesclagem em lote, as configurações originais de filtragem e anotação de células únicas e os detalhes completos da subtração de fundo original nos blots e da quantificação por faixa não estão totalmente disponíveis; essas limitações são descritas no protocolo e na discussão. O RDS recuperado localmente não foi depositado em um repositório público.
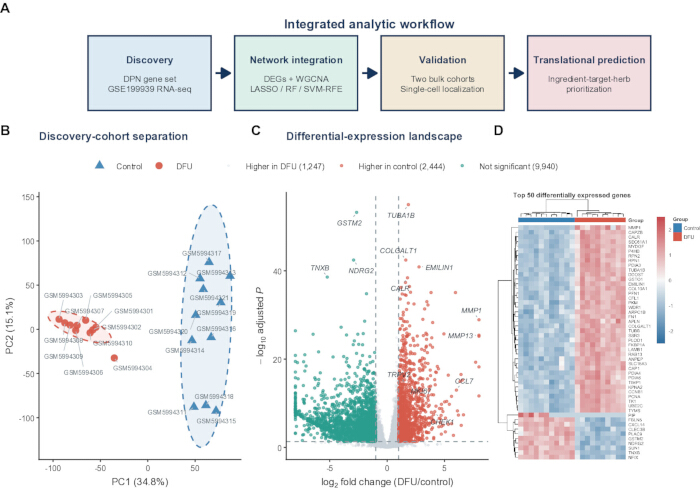
Figura 1: A transcriptômica de descoberta identifica um programa de expressão associado à UPD. (A) Visão geral do fluxo de trabalho computacional, compreendendo a construção do conjunto gênico DPN e a análise de descoberta em GSE199939, integração de rede e aprendizado de máquina, avaliação em massa e de célula única, e predição de ingredientes-alvo-ervas na MTC. (B) Análise de componentes principais de perfis de expressão com transformação estabilizadora da variância (GSE199939) provenientes de 10 amostras de UPD e 11 controles. As elipses indicam regiões de grupo com 90%; os percentuais denotam a variância explicada por cada componente. (C) Gráfico de vulcão com os resultados da análise de expressão diferencial pelo DESeq2 para UPD versus controle. Pontos vermelhos e ciano indicam genes superexpressos em UPD e controle, respectivamente, utilizando |log2 razão de variação| > 1 e p ajustado por BH < 0,05; pontos cinza não atenderam a ambos os limiares. (D) Mapa térmico de escores z por linha dos 50 genes com menores valores ajustados de p. As colunas são amostras biológicas e a barra de anotação indica o grupo. DEGs, genes diferencialmente expressos; UPD, úlcera do pé diabético; DPN, neuropatia periférica diabética; VST, transformação estabilizadora da variância. A avaliação experimental final é descrita no protocolo e na Figura 7. qPCR, reação em cadeia da polimerase quantitativa; MTC, medicina tradicional chinesa; RF, floresta aleatória; LASSO, operador de seleção e redução absoluta mínima; SVM-RFE, eliminação recursiva de características por máquina de vetores de suporte. Clique aqui para visualizar uma versão maior desta figura.
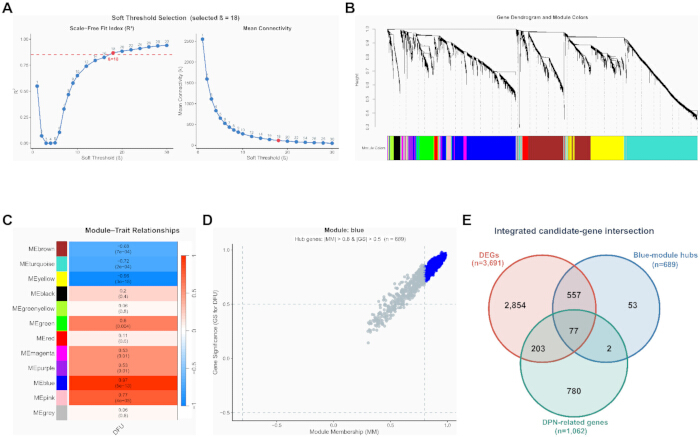
Figura 2: A WGCNA e o conhecimento prévio sobre DPN convergem em 77 genes candidatos. (A) Avaliação do limiar suave da rede com sinal para os 5.000 genes mais variáveis transformados por VST. A potência selecionada foi beta = 18; a linha tracejada marca o ajuste alvo de topologia livre de escala de 0,85. (B) Dendrograma gênico por ligação média com atribuições dinâmicas de cores por módulo. (C) Correlações de Pearson entre eigengenes dos módulos e a característica binária de DFU. Cada célula mostra o coeficiente de correlação e o valor p bicaudal correspondente; a cor indica direção e magnitude. (D) Significância gênica para DFU versus pertencimento ao módulo no módulo azul. Pontos azuis satisfazem |pertencimento ao módulo| > 0,8 e |significância gênica| > 0,5; n = 689 genes centrais. (E) Interseção entre três conjuntos: 3.691 DEGs, 689 genes centrais do módulo azul e 1.062 genes relacionados à DPN, resultando em 77 candidatos comuns. DFU, úlcera do pé diabético; DPN, neuropatia periférica diabética; GS, significância gênica; MM, pertencimento ao módulo; WGCNA, análise de rede de coexpressão gênica ponderada. A coorte de descoberta continha 21 amostras (10 DFU e 11 controles). A anotação da Figura 2D utiliza |MM| > 0,8 e |GS| > 0,5, compatível com o critério de valor absoluto verificado no código original de seleção. Clique aqui para visualizar uma versão ampliada desta figura.
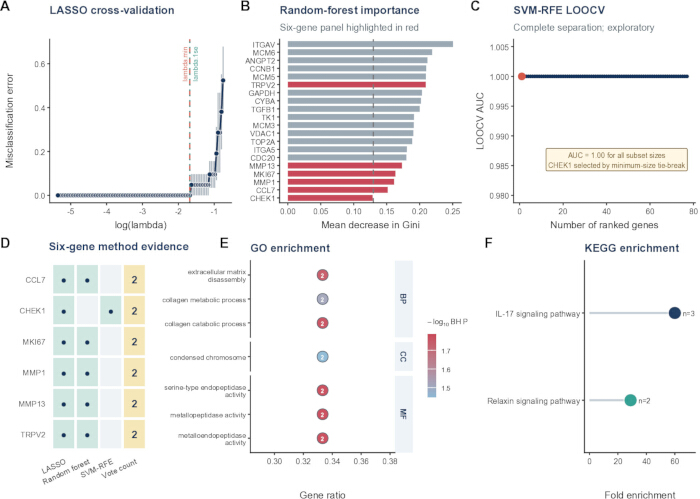
Figura 3: A priorização de características por múltiplos métodos resulta em um painel de seis genes. (A) Curva de validação cruzada cinco vezes para regressão LASSO binomial. Linhas tracejadas verticais indicam lambda.min e lambda.1se; as características não nulas selecionadas foram tomadas em lambda.1se, exceto quando essa penalidade não resultou em nenhuma característica. (B) Diminuição média no índice de Gini na floresta aleatória para os 20 genes mais bem classificados a partir de um modelo com 1.000 árvores. Barras vermelhas identificam membros do painel final de seis genes; a linha tracejada marca a importância média usada como limiar de retenção em todo o conjunto candidato. (C) AUC da validação cruzada leave-one-out (LOOCV) com SVM linear com eliminação recursiva de características (SVM-RFE) ao longo de subconjuntos aninhados de características. Todos os tamanhos de subconjunto produziram AUC = 1,00; CHEK1 foi selecionado pela regra do menor tamanho em caso de empate, indicando superajuste na coorte de descoberta. (D) Matriz de suporte dos métodos para CCL7, CHEK1, MKI67, MMP1, MMP13 e TRPV2. Pontos indicam seleção por LASSO, floresta aleatória ou SVM-RFE; a última coluna indica o número de métodos que os apoiaram. (E) Termos selecionados da Ontologia de Genes enriquecidos entre os seis genes. A posição do ponto mostra a razão gênica, as etiquetas dos pontos indicam o número de genes mapeados, a cor mostra -log10 do valor p ajustado por Benjamini-Hochberg (BH) e a faixa lateral denota a ontologia. (F) Vias KEGG enriquecidas entre os genes mapeados. A posição do ponto mostra o enriquecimento relativo, os rótulos do tamanho dos pontos indicam a contagem de genes mapeados e a cor distingue as vias. O enriquecimento exigiu valor p nominal < 0,05 e valor p ajustado por BH < 0,05. AUC, área sob a curva ROC; BH, Benjamini-Hochberg; BP, processo biológico; CC, componente celular; KEGG, Enciclopédia de Kyoto de Genes e Genomas; LOOCV, validação cruzada leave-one-out; SVM-RFE, eliminação recursiva de características por máquina de vetores de suporte. LASSO, operador de contração absoluta mínima e seleção. Os painéis A–D utilizam as 21 amostras de descoberta (10 úlceras de pé diabético e 11 controles). No painel A, as barras de erro indicam o erro padrão do erro de validação cruzada. Clique aqui para visualizar uma versão maior desta figura.
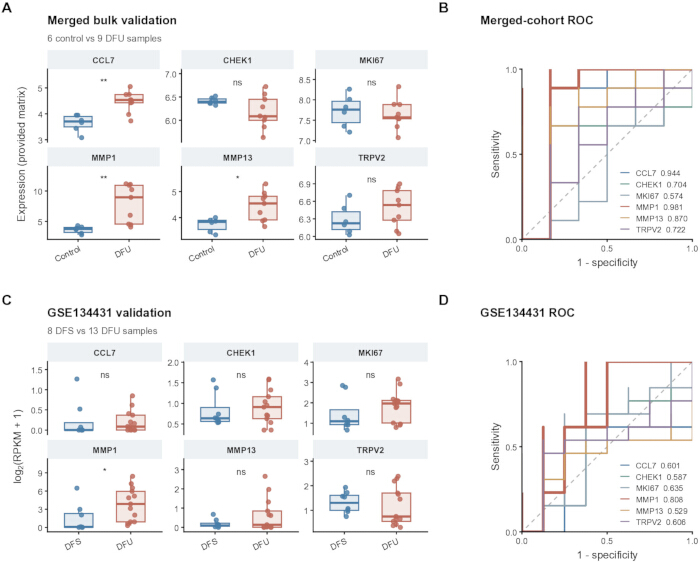
Figura 4: Avaliação transcriptômica em larga escala entre conjuntos de dados do painel de seis genes. (A) Expressão dos seis genes na matriz mesclada GSE68183/GSE80178 (6 controles e 9 amostras de DFU). (B) Curvas ROC correspondentes por gene individual com valores de AUC; os intervalos de confiança de 95% estão fornecidos na tabela de dados brutos. Como a mesclagem inicial e a correção de lote não foram totalmente documentadas, esses resultados foram interpretados como exploratórios. (C) Expressão log2(RPKM + 1) em GSE134431 (8 amostras de DFS diabético sem úlcera e 13 amostras de DFU). (D) Curvas ROC e valores de AUC correspondentes por gene individual. Em (A) e (C), as caixas indicam a mediana e o intervalo interquartílico, os traços (whiskers) se estendem até 1,5 vez o intervalo interquartílico e os pontos representam as amostras biológicas. Asteriscos indicam significância nominal pelos testes de soma de postos de Wilcoxon bicaudais (*p < 0,05, **p < 0,01); os valores de p ajustados por BH para os seis genes estão relatados no texto e na tabela de dados brutos. A direção ROC foi selecionada automaticamente pelo pROC. AUC, área sob a curva característica de operação do receptor; DFS, pele diabética do pé sem úlcera; DFU, úlcera do pé diabético; RPKM, leituras por quilobase por milhão de leituras mapeadas; ROC, característica de operação do receptor. Clique aqui para visualizar uma versão maior desta figura.
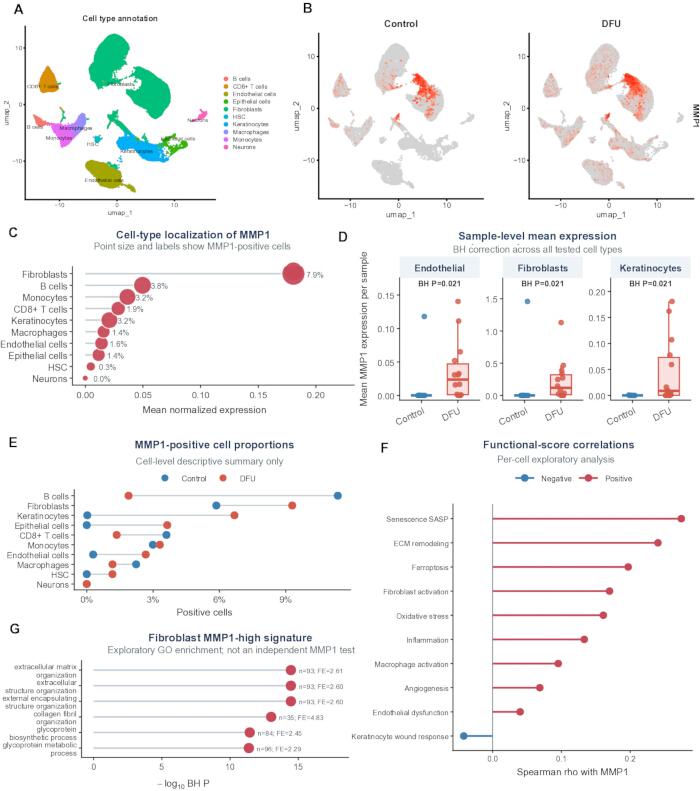
Figura 5: A localização em nível de célula única associa MMP1 a sinais de remodelamento por fibroblastos e da matriz. (A) UMAP de 69.944 células provenientes de 24 amostras (10 controles e 14 amostras de DFU), colorido conforme as 10 anotações de tipos celulares derivadas do SingleR. (B) Gráficos de características UMAP mostrando a expressão normalizada de MMP1 em células controle e DFU. (C) Resumo por tipo celular da expressão média normalizada de MMP1; o tamanho dos pontos e as legendas indicam a fração total de células positivas para MMP1, definida como expressão normalizada > 0. (D) Expressão média de MMP1 em nível de amostra em células endoteliais, fibroblastos e queratinócitos. As caixas indicam a mediana e o intervalo interquartil; os pontos representam as amostras biológicas. Testes de soma de postos de Wilcoxon bicaudais foram seguidos por correção BH em todos os tipos celulares testados. Os números disponíveis de amostras foram 10 controles e 14 DFU para células endoteliais e fibroblastos, e 9 controles e 14 DFU para queratinócitos. (E) Frações de células positivas para MMP1 por grupo e tipo celular. (F) Correlações de Spearman por célula entre a expressão de MMP1 e os escores de módulos funcionais. (G) Enriquecimento em processos biológicos GO entre genes superexpressos em fibroblastos com alta expressão de MMP1 versus fibroblastos com baixa expressão de MMP1. BH, Benjamini-Hochberg; DFU, úlcera do pé diabético; ECM, matriz extracelular; GO, Ontologia Genética; HSC, células-tronco hematopoiéticas; UMAP, projeção uniforme de variedade e aproximação de múltiplas dimensões. As correlações por célula e o enriquecimento condicionado à expressão nos painéis F e G são descrições exploratórias, sem inferência confirmatória ajustada para identificação de doadores. A independência em nível de amostra exige verificação dos identificadores de doadores. Clique aqui para visualizar uma versão maior desta figura.
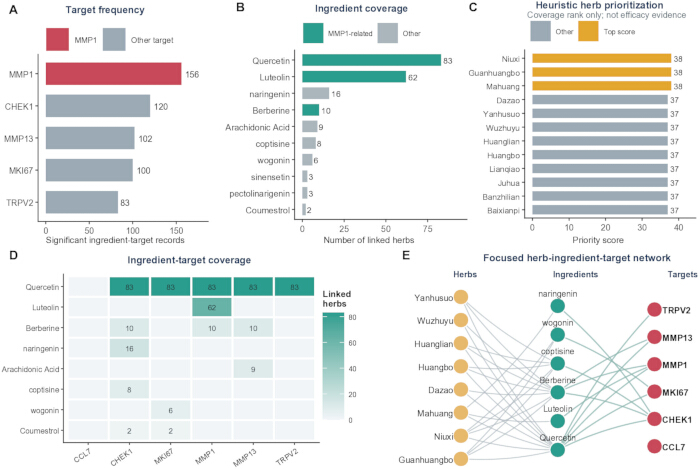
Figura 6: Previsão baseada em cobertura de ingrediente-alvo-erva da medicina tradicional chinesa centrada na MMP1. (A) Número de registros filtrados da base de dados de ervas-ingrediente-alvo para cada alvo candidato disponível. (B) Número de ervas ligadas aos ingredientes mais frequentes; o tom verde-azulado indica ingredientes ligados à MMP1. (C) Principais ervas classificadas pelo escore de cobertura; as barras douradas indicam os três maiores escores empatados. (D) Matriz ingrediente-alvo para ingredientes representativos de alta cobertura. Os valores nas células mostram o número de ervas ligadas; células vazias indicam ausência de registro na tabela de relações filtradas. (E) Rede detalhada conectando ervas, ingredientes e alvos candidatos representativos de alta classificação. A cor dos nós indica o tipo de entidade; as arestas cinzas entre erva e ingrediente indicam contenção e as arestas verde-azuladas entre ingrediente e alvo indicam ligações na base de dados. A tabela de relações filtradas continha 561 registros únicos, 99 ervas, 14 ingredientes e cinco alvos com ligações qualificadas; CCL7 é exibido como um sexto nó candidato isolado. TCM, medicina tradicional chinesa. Clique aqui para visualizar uma versão maior desta figura.
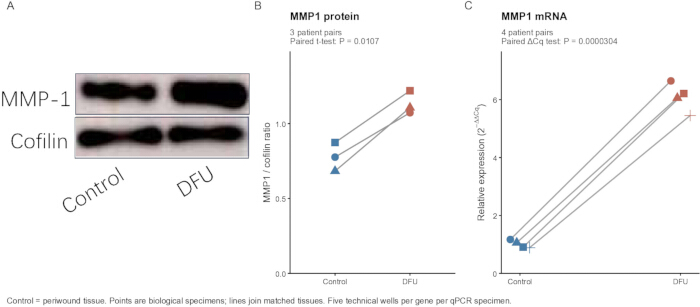
Figura 7: Avaliação preliminar por qPCR e western blot de tecidos de pacientes quanto à expressão de MMP1 em UFDC. (A) Western blot representativo previamente fornecido mostrando a abundância proteica de MMP1 em tecidos perilesionais não ulcerados e em UFDC, com cofilina como controle de carga. (B) Proporções de MMP1 em relação à cofilina recuperadas do projeto original de plotagem. Os símbolos indicam medições biológicas individuais de três pares de pacientes; linhas conectam espécimes perilesionais e de UFDC correspondentes. O teste t pareado bicaudal resultou em t(2) = 9,592 e p = 0,0107. (C) Abundância relativa de mRNA de MMP1 em quatro pares de pacientes confirmados pelos autores: NC–UFDC, NC1–UFDC1, NC2–UFDC2 e NC3–UFDC3. Cinco poços técnicos de ACTB e cinco poços técnicos de MMP1 foram médias separadamente dentro de cada espécime antes do cálculo de ΔCq. A expressão relativa foi calculada pelo método 2−ΔΔCq, utilizando a média de ΔCq perilesional como calibrador comum. Cada símbolo representa um espécime biológico; linhas conectam tecidos emparelhados. O teste t pareado bicaudal utilizou valores de ΔCq em nível de espécime (t(3) = −41,663; p = 3,04 × 10⁻⁵), não as mudanças de dobra em poços técnicos. Nenhum asterisco de significância foi utilizado. Poços técnicos não são réplicas biológicas. Controle denota tecido perilesional não ulcerado. Cq, ciclo de quantificação. Os valores de p para o tecido e ensaio são nominais e exploratórios. Clique aqui para visualizar uma versão maior desta figura.
| Gene | Acesso RefSeq | Primer direto de 5 linha a 3 linha | Primer reverso de 5 linha a 3 linha |
| MMP1 | NM_002421 | ATGAAGCAGCCCAGATGTGGAG | TGGTCCACATCTGCTCTTGGCA |
| ACTB | NM_001101.5 | CACCATTGGCAATGAGCGGTTC | AGGTCTTTGCGGATGTCCACGT |
Tabela 1: Sequências dos primers para validação da PCR quantitativa de MMP1. São apresentadas as sequências oligonucleotídicas direta e reversa (5′–3′) e os acessos aos transcritos RefSeq do NCBI para MMP1 humano (NM_002421) e ACTB (NM_001101.5). ACTB (β-actina) foi utilizada como gene de referência para a expressão relativa de MMP1.
Figura Suplementar 1: Resumos de controle de qualidade da WGCNA. (A) Agrupamento hierárquico por ligação média das amostras do GSE199939 com base nos 5.000 genes com maior variabilidade transformados para estabilização da variância. Os rótulos das amostras são coloridos por grupo; a linha horizontal tracejada representa o guia da altura do dendrograma no percentil 95, usado para avaliação visual de valores atípicos. (B) Número de genes atribuídos a cada módulo da WGCNA. As barras em verde-azulado indicam os oito módulos não cinzentos que atendem ao critério de associação com UFD; as barras cinzentas indicam os demais módulos. UFD, úlcera do pé diabético; VST, transformação para estabilização da variância; WGCNA, análise de rede de coexpressão gênica ponderada. Clique aqui para baixar este arquivo.
Figura Suplementar 2: Suporte à coexpressão do módulo azul. (A) Rede de coexpressão simplificada dos 25 genes centrais do módulo azul com as classificações mais altas. Entre as correlações aos pares com |r| > 0,70, a rede exibida contém a união dos dois vínculos mais fortes de cada gene. O tamanho do nó indica o grau dentro dessa rede exibida e esparsificada, e o preenchimento do nó indica a significância do gene para úlcera do pé diabético (DFU). (B) Significância do gene e pertencimento ao módulo azul para os 15 principais genes centrais. O subconjunto de arestas foi selecionado para melhorar a legibilidade e não representa todas as correlações qualificadas. DFU, úlcera do pé diabético; GS, significância do gene; MM, pertencimento ao módulo. Clique aqui para baixar este arquivo.
Figura Suplementar 3: Gráficos de aprendizado de máquina da coorte de descoberta interna. (A) Expressão padronizada de CCL7, CHEK1, MKI67, MMP1, MMP13 e TRPV2 na coorte de descoberta GSE199939. As caixas mostram a mediana e o intervalo interquartil, e os pontos representam as amostras biológicas. (B) Mapa de calor por amostra com escores z em linha para os mesmos seis genes. As etiquetas curtas das amostras estão associadas aos identificadores GEO na chave de dados de origem. (C) Curva ROC do modelo ajustado da coorte de descoberta multigênica. A AUC de 1,00 foi obtida ajustando e avaliando o modelo nas mesmas 21 amostras, indicando superajuste na coorte de descoberta. AUC, área sob a curva característica de operação do receptor; ROC, característica de operação do receptor. A coorte de descoberta continha 21 amostras (10 DFU e 11 controles). Clique aqui para baixar este arquivo.
Figura Suplementar 4: Contexto de expressão em nível de célula única. (A) UMAP de 69.944 células coloridas por grupo controle e DFU. (B) Expressão média de MMP1 no nível de amostra biológica em todas as 10 anotações de tipo celular; os pontos representam amostras, e o eixo x utiliza uma transformação de raiz quadrada para exibição. (C) Mapa de calor com escores de módulos funcionais resumidos ao longo das células dentro de cada tipo celular anotado e padronizados dentro de cada módulo. DFU, úlcera do pé diabético; UMAP, aproximação uniforme de variedade e projeção. Clique aqui para baixar este arquivo.
Figura Suplementar 5: Matrizes de cobertura de apoio da MTC. (A) Contagem de registros de herbáceas-alvo na base de dados para as 18 herbáceas com maior classificação com cobertura associada ao MMP1 e os cinco alvos candidatos representados na tabela de relações filtrada. (B) Contagem de registros na base de dados que associam as mesmas herbáceas aos ingredientes principais quercetina, luteolina e berberina. Os valores nas células indicam registros únicos na base de dados após a deduplicação. MTC, medicina tradicional chinesa. Clique aqui para baixar este arquivo.
Figura Suplementar 6: Fluxo de trabalho computacional e avaliação tecidual. O esquema resume a entrada para a descoberta, a interseção DEG/WGCNA, a seleção exploratória de características, a avaliação externa em bulk, o contexto em célula única, a extensão TCM e a avaliação da expressão tecidual pareada. A qPCR utilizou quatro pares de pacientes pareados e o western blotting utilizou três pares de pacientes pareados. As contagens de candidatos e os resultados computacionais relatados foram mantidos da análise original. A entrada em TPM no fluxo de trabalho de descoberta baseado em contagem, os registros incompletos de pré-processamento originais em célula única e os pequenos grupos de ensaios teciduais permanecem como limitações. O esquema não implica que as análises de descoberta tenham sido revalidadas. Clique aqui para baixar este arquivo.
Tabela Suplementar 1: Inventário de softwares, bancos de dados, parâmetros e limitações de análise. Esta pasta de trabalho documenta 26 etapas de análise, incluindo a etapa de análise, ferramenta ou banco de dados, versão informada, entrada, principais parâmetros, saída e informações ausentes ou limitações. Abrange transcriptômica de descoberta, WGCNA, triagem gênica e seleção de características, enriquecimento, análises externas de bulk e de célula única, análise de rede de MTC e relatórios de tecido-assay. A tabela registra as informações metodológicas disponíveis e não estabelece por si só reprodutibilidade independente. Clique aqui para baixar este arquivo.
Arquivo Suplementar 1: Dados, código de análise, fonte das figuras e arquivo de fonte do ensaio. Este arquivo contém os scripts disponíveis para análise e geração de figuras, tabelas de expressão e resultados processados, figuras quantitativas e dados brutos estatísticos, a pasta de trabalho original de qPCR e o projeto do instrumento, imagens brutas não recortadas de western blot fornecidas, metadados e histórico de comandos de célula única extraídos, relatórios de verificação em formato matricial e um manifesto de arquivos. Arquivos históricos são preservados; a pasta R2_Updates fornece a análise corrigida de ensaios pareados, fontes atualizadas das figuras e inventário revisado de parâmetros. Clique aqui para baixar este arquivo.
Discussão
Este fluxo de trabalho integrativo priorizou MMP1 a partir da transcriptômica em massa, WGCNA, triagem de genes relacionados a DPN e seleção exploratória de características, em seguida examinou-se o contexto celular e a expressão tecidual. Seis genes foram apoiados por pelo menos dois métodos de seleção, e MMP1 apresentou a maior alteração de expressão na coorte de descoberta. As evidências externas foram heterogêneas: MMP1 permaneceu significativo na matriz mesclada GSE68183/GSE80178, enquanto sua associação em GSE134431 foi nominal (p = 0,0225) e não sobreviveram à correção de BH (ajustado p = 0,135). A AUC de 0,808 na GSE134431 é descritiva, particularmente porque a direção da ROC foi selecionada dentro do conjunto de dados de avaliação. Assim, "mais consistente" descreve o padrão observado entre os seis candidatos e não implica replicação estatística completa ou um biomarcador diagnóstico validado.
O painel de candidatos foi anotado com base na renovação do colágeno, desmontagem da matriz extracelular (ECM), atividade de metaloendopeptidase e sinalização de IL-17 e relaxina. Essas anotações são compatíveis com a biologia de feridas crônicas, mas envolvem apenas alguns poucos genes. Estudos humanos anteriores relataram perfis alterados de MMP e seus inibidores em feridas diabéticas6, enquanto um estudo prospectivo sobre úlceras do pé diabético (DFU) associou uma maior razão entre MMP1 e inibidor tecidual de metaloproteinases 1 (TIMP1) à cicatrização7. Assim, o aumento da expressão de MMP1 não precisa indicar um efeito uniformemente prejudicial; sua relevância pode depender da fase da reparação, da disponibilidade de substrato e do equilíbrio com inibidores. Observações experimentais sobre MMP13, CCL7 e IL-17 fornecem contexto adicional11,12,13,14, mas não se pode presumir que suas funções sejam equivalentes em DFU humanas.
Os resumos de célula única localizaram a maior expressão média de MMP1 nos fibroblastos, com expressão em nível de amostra mais elevada nos fibroblastos de UDF, queratinócitos e células endoteliais. Esse padrão concorda com relatos de organização alterada da MEC em fibroblastos derivados de UDF4, estados heterogêneos de fibroblastos em estudos de célula única e espaciais8 e programas de fibroblastos associados à cicatrização mediada por macrófagos15. No entanto, os identificadores de amostra exigem verificação em nível de doador, e as correlações de pontuação de módulo em nível celular e o enriquecimento condicionado à expressão permanecem descritivos, pois a dependência intra-doador não foi modelada. Contribuições de populações epiteliais e endoteliais também contrariam um mecanismo exclusivamente autônomo dos fibroblastos. A transcriptômica espacial, hibridização in situ de RNA ou imunomarcação ofereceriam localização complementar16.
O valor metodológico reside na combinação de expressão diferencial, coexpressão, conhecimento prévio sobre genes, resumos resolvidos por célula e modalidades de ensaio independentes para priorizar candidatos. Ele não reside na precisão preditiva em coortes de descoberta. A triagem abrangente da coorte precedeu a validação cruzada no nível do algoritmo, e a AUC uniforme de 1,00 no SVM-RFE levanta preocupações sobre vazamento, superajuste e avaliação otimista. O painel deve, portanto, permanecer como um resultado de priorização de características. Seria necessário um pré-processamento, seleção e ajuste totalmente aninhados, seguidos por um teste independente fixo, para uma avaliação preditiva9,10. A entrada de descoberta foi verificada como TPM, apesar de seu uso em um modelo baseado em contagens; as estatísticas de descoberta resultantes e a seleção subsequente permanecem, portanto, não verificadas até uma reanálise apropriada. A matriz bulk combinada não possui seu histórico completo de pré-processamento. O objeto Seurat recuperado fornece as configurações de normalização, seleção de características variáveis, PCA, vizinhança, agrupamento e UMAP, embora seu filtro original, chamada completa do Harmony e referência de anotação permaneçam documentados de forma incompleta. A reprocessamento harmonizado a partir dos dados originais, avaliação documentada de efeitos de lote e análises pseudobulk ou de modelo misto com consideração ao doador são abordagens alternativas para avaliação adicional.
Ensaios com tecidos de pacientes fornecem evidência preliminar e ortogonal de maior abundância de MMP1. O comparador foi tecido perilesional não ulcerado dos mesmos pacientes, de modo que o contraste reflita diferenças locais associadas à úlcera dentro do tecido diabético, e não uma comparação com pele saudável. As medições de WB recuperadas de três pares de pacientes emparelhados e as medições de qPCR de quatro pares emparelhados confirmados pelos autores foram analisadas usando testes pareados, com as observações biológicas individuais exibidas. Para qPCR, as réplicas técnicas foram agrupadas dentro de cada espécime e a inferência utilizou ΔCq; as réplicas técnicas não ampliaram o tamanho da amostra biológica. A direção consistente das observações pareadas apoia uma comparação preliminar de expressão, mas as pequenas coortes não permitem estabelecer generalização ou avaliar com confiança as premissas distribucionais. A abundância em tecido bruto não estabelece a localização celular da proteína, atividade enzimática ou efeito causal na cicatrização. São necessárias coortes maiores e clinicamente caracterizadas. Outras limitações incluem covariáveis clínicas incompletas, tecidos comparadores distintos, um conjunto de genes DPN derivado da literatura e incompletamente documentado, e registros incompletos de subtração de fundo dos blotagens originais. Tecido saudável, tecido controle definido pelo estudo e pele diabética não ulcerada não devem ser tratados como intercambiáveis.
A rede TCM é uma extensão geradora de hipóteses. Seus pesos personalizados resumem a cobertura do banco de dados, e não o engajamento com alvos ou eficácia, e as classificações podem mudar conforme o conteúdo dos bancos de dados e as escolhas de pesos. A quercetina e a berberina também apresentam exposição sistêmica variável ou limitada17,18. Assim, os ingredientes e ervas candidatos exigem testes diretos de interação com alvos, resposta à dose, farmacocinética, toxicidade e função. Trabalhos futuros devem combinar coortes independentes bem documentados com localização espacial e perturbação de MMP1 em fibroblastos primários ou modelos multicelulares de ferida. Os achados atuais apoiam MMP1 como um candidato associado à DFU em um contexto de remodelação da matriz centrado em fibroblastos, sem estabelecer causalidade ou utilidade clínica.
Divulgações
Os autores declaram não haver conflitos de interesse.
Agradecimentos
Esta pesquisa foi apoiada pelo Projeto Municipal de Pesquisa Científica em Saúde de Wuhan (Projeto de Orientação, número do convênio WX23Z77), administrado pela Comissão Municipal de Saúde de Wuhan.
Os autores agradecem aos participantes que forneceram espécimes de tecido para este estudo e aos pesquisadores que geraram e depositaram os conjuntos de dados de acesso público no Gene Expression Omnibus do NCBI.
Materiais
| Nome | Empresa | Número de catálogo | Comentários |
|---|---|---|---|
| Fitas de tubos PCR transparentes de parede fina de 0,2 mL | Axygen / Corning | PCR-0208-C | URL: https://ecatalog.corning.com/life-sciences/b2b/TW/en/Genomics-%26-Molecular-Biology/PCR-Consumables/PCR-Tubes-and-Strip-Tubes/Axygen%C2%AE-PCR-Strip-Tubes/p/PCR-0208-C |
| Pontas de pipeta estéreis com filtro de 1.000-μL | Axygen / Corning | TF-1000-R-S | URL: https://ecatalog.corning.com/life-sciences/b2b/SEA/en/Liquid-Handling/Pipette-Tips-and-Accessories/Pipette-Tips/Axygen%C2%AE-Universal-Fit-Filter-Pipette-Tips/p/TF-1000-R-S |
| Tubos microcentrífugos estéreis de 1,5 mL, livres de DNase/RNase | Solarbio Life Sciences | YA0430 | URL: https://www.solarbio.com/goodsInfo?id=305429 |
| Pontas de pipeta estéreis com filtro de 10-μL | Axygen / Corning | TF-300-L-R-S | URL: https://ecatalog.corning.com/life-sciences/b2b/CALAOther/en/Liquid-Handling/Pipette-Tips-and-Accessories/Pipette-Tips/Axygen%C2%AE-Aerosol-Barrier-Tips/p/TF-300-L-R-S |
| Mastermix PCR com SYBR Green 2× | Solarbio Life Sciences | SR1110 | URL: https://www.solarbio.com/goodsInfo?id=994 |
| Solução tampão Tris-salina 20× | Solarbio Life Sciences | T1080 | URL: https://www.solarbio.com/goodsInfo?id=1309 |
| Pontas de pipeta estéreis com filtro de 200-μL | Axygen / Corning | TF-200-R-S | URL: https://ecatalog.corning.com/life-sciences/b2b/CALAOther/en/Liquid-Handling/Pipette-Tips-and-Accessories/Pipette-Tips/Axygen%C2%AE-Universal-Fit-Filter-Pipette-Tips/p/TF-200-R-S |
| Par de primers qPCR para ACTB | Solarbio Life Sciences (síntese personalizada de oligonucleotídeos) | Personalizado | RefSeq NM_001101.5; F: CACCATTGGCAATGAGCGGTTC; R: AGGTCTTTGCGGATGTCCACGT; URL: https://www.solarbio.com/ |
| Amersham Imager 600 | GE Healthcare Bio-Sciences AB, Uppsala, Suécia | Amersham Imager 600 | Modelo registrado em todos os 22 arquivos TIFF fornecidos; software operacional Ver.1.2.0; URL: https://cdn.cytivalifesciences.com/api/public/content/digi-17089-original |
| Kit de ensaio proteico por ácido bicinconínico | Solarbio Life Sciences | PC0020 | URL: https://www.solarbio.com/goodsInfo?id=64504 |
| clusterProfiler | Bioconductor | https://bioconductor.org/packages/clusterProfiler/ | Versão 4.16.0 |
| Anticorpo policlonal contra Cofilina (coelha anti-Cofilina) | Proteintech Group (Wuhan Sanying Biotechnology Co., Ltd., Wuhan, China) | 10960-1-AP | Diluição para WB usada neste estudo: 1:6.000; URL: https://www.ptgcn.com/; RRID:AB_2291830 |
| Base de Dados de Toxicogenômica Comparativa | CTD | https://ctdbase.org/ | Recurso de ingredientes-alvo |
| DESeq2 | Bioconductor | https://bioconductor.org/packages/DESeq2/ | Versão 1.48.2 |
| Água livre de DNase/RNase | Solarbio Life Sciences | R1600 | URL: https://www.solarbio.com/goods.php?id=1085 |
| e1071 | CRAN / autores do e1071 | https://cran.r-project.org/package=e1071 | Versão 1.7-17 |
| Substrato quimioluminescente ECL Plus | Solarbio Life Sciences | PE0010 | URL: https://www.solarbio.com/pdf/2-DBYMY/1-ZW/PE0010.pdf |
| Gene Expression Omnibus: GSE134431 | Centro Nacional de Informação Biotecnológica | GSE134431 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE134431 |
| Gene Expression Omnibus: GSE165816 | Centro Nacional de Informação Biotecnológica | GSE165816 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE165816 |
| Gene Expression Omnibus: GSE199939 | Centro Nacional de Informação Biotecnológica | GSE199939 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE199939 |
| Gene Expression Omnibus: GSE68183 | Centro Nacional de Informação Biotecnológica | GSE68183 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE68183 |
| Gene Expression Omnibus: GSE80178 | Centro Nacional de Informação Biotecnológica | GSE80178 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE80178 |
| Gene Ontology | Consortium Gene Ontology | https://geneontology.org/ | GO |
| ggplot2 | Desenvolvedores do ggplot2 | https://ggplot2.tidyverse.org/ | Versão 4.0.3 |
| glmnet | CRAN / autores do glmnet | https://cran.r-project.org/package=glmnet | Versão 5.0 |
| Tabela de referência herbínea-ingrediente | Fonte não relatada no manuscrito | Não relatado | Não documentado: nome exato do banco de dados/arquivo, versão/data e URL de acesso público |
| Anticorpo secundário conjugado com HRP, caprino anti-coelho IgG (H+L) | Proteintech Group (Wuhan Sanying Biotechnology Co., Ltd., Wuhan, China) | SA00001-2 | Diluição para WB usada neste estudo: 1:5.000; URL: https://www.ptgcn.com/products/HRP-conjugated-Goat-Anti-Rabbit-IgG-H-L-SA00001-2.htm; RRID:AB_2722564 |
| Espécimes de tecido humano de úlcera do pé diabético | Hospital Quarto de Wuhan, Wuhan, China | N/A | Espécimes de DFU emparelhados por paciente; qPCR n=4 espécimes; WB n=3 espécimes; protocolo aprovado KY2024-161-01 |
| Espécimes de tecido perilesional humano não ulcerado | Hospital Quarto de Wuhan, Wuhan, China | N/A | Comparador perilesional emparelhado por paciente; qPCR n=4 espécimes; WB n=3 espécimes; protocolo aprovado KY2024-161-01 |
| ImageJ | Institutos Nacionais de Saúde | https://imagej.net/ij/ | Versão não documentada |
| Enciclopédia de Kyoto de Genes e Genomas | KEGG | https://www.genome.jp/kegg/ | Código do organismo humano hsa |
| Lista de genes DPN curada pela literatura | Componente derivado da literatura; tabela de origem em nível gênico não totalmente documentada | Não relatado | Proveniência em nível gênico não totalmente documentada |
| Espectrofotômetro UV-visível de microvolume | Fabricante/modelo não relatado no manuscrito | Não relatado | Não documentado: fabricante exato, modelo e URL do produto; uso relatado: avaliação da concentração de RNA e razão A260/A280 |
| Anticorpo policlonal contra MMP1 (coelho anti-MMP1) | Proteintech Group (Wuhan Sanying Biotechnology Co., Ltd., Wuhan, China) | 10371-2-AP | Diluição para WB usada neste estudo: 1:1.000; URL: https://www.ptgcn.com/Products/MMP1-Antibody-10371-2-AP.htm; RRID:AB_2297741 |
| Par de primers qPCR para MMP1 | Solarbio Life Sciences (síntese personalizada de oligonucleotídeos) | Personalizado | RefSeq NM_002421; F: ATGAAGCAGCCCAGATGTGGAG; R: TGGTCCACATCTGCTCTTGGCA; URL: https://www.solarbio.com/ |
| NCBI Gene | Centro Nacional de Informação Biotecnológica | https://www.ncbi.nlm.nih.gov/gene/ | Banco de dados de Genes Humanos |
| Leite em pó desnatado, reagente bloqueador | Solarbio Life Sciences | D8340 | URL: https://www.solarbio.com/goodsInfo?id=1488 |
| org.Hs.eg.db | Bioconductor | https://bioconductor.org/packages/org.Hs.eg.db/ | Versão 3.21.0 |
| Gel SDS-PAGE pré-moldado, gradiente de 4%–20% | Solarbio Life Sciences | PG42010-S | URL: https://www.solarbio.com/goodsInfo?id=12646 |
| pROC | CRAN / autores do pROC | https://cran.r-project.org/package=pROC | Versão 1.19.0.1 |
| Mistura de inibidores de protease, 100× | Solarbio Life Sciences | P6730 | URL: https://www.solarbio.com/goodsInfo?id=25748 |
| Sistema de transferência de proteínas | Fabricante/modelo não relatado no manuscrito | Não relatado | Não documentado: fabricante exato, modelo e URL do produto; uso relatado: Transferência para membrana PVDF de 0,22-μm |
| Membrana PVDF, 0,22 μm | Solarbio Life Sciences | YA1690 | URL: https://www.solarbio.com/goodsInfo?id=228106 |
| R | Fundação R para Computação Estatística | https://www.r-project.org/ | Versão 4.5.2 |
| randomForest | CRAN / autores do randomForest | https://cran.r-project.org/package=randomForest | Versão 4.7-1.2 |
| Instrumento de PCR em tempo real | Roche Diagnostics | LightCycler 96 | versão do software não confirmada. Volume do projeto/ciclagem difere do protocolo relatado; vínculo exato do experimento permanece a ser verificado. |
| Microcentrífuga refrigerada | Fabricante/modelo não relatado no manuscrito | Não relatado | Não documentado: fabricante exato, modelo e URL do produto; uso relatado: 12.000 × g por 15 min a 4 °C |
| rentrez | CRAN / autores do rentrez | https://cran.r-project.org/package=rentrez | Versão 1.2.4 |
| Tampão de lise RIPA, alta concentração | Solarbio Life Sciences | R0010 | URL: https://www.solarbio.com/goodsInfo?id=1163 |
| Sistema de eletroforese SDS-PAGE | Fabricante/modelo não relatado no manuscrito | Não relatado | Não documentado: fabricante exato, modelo e URL do produto; uso relatado: Separação de proteínas em géis gradientes de 4%–20% |
| Seurat | Lab Satija / desenvolvedores do Seurat | https://satijalab.org/seurat/ | Versão 5.5.0 |
| SingleR | Bioconductor | https://bioconductor.org/packages/SingleR/ | Versão 2.10.0 |
| Homogeneizador de tecidos | Fabricante/modelo não relatado no manuscrito | Não relatado | Não documentado: fabricante exato, modelo e URL do produto; uso relatado: Homogeneização de tecidos em tampão de lise gelado |
| Reagente TriQuick para extração de RNA total | Solarbio Life Sciences | R1100 | URL: https://www.solarbio.com/goodsInfo?id=1083 |
| Tween-20 | Solarbio Life Sciences | T8220 | URL: https://www.solarbio.com/goodsInfo?id=102 |
| Tampas planas ultra-transparentes para fitas de tubos PCR de 0,2 mL | Axygen / Corning | PCR-2CP-RT-C | URL: https://ecatalog.corning.com/life-sciences/b2b/TW/en/Genomics-%26-Molecular-Biology/PCR-Consumables/PCR-Tubes-and-Strip-Tubes/Axygen%C2%AE-PCR-Strip-Caps/p/PCR-2CP-RT-C |
| Kit RT-PCR Universal (M-MLV) | Solarbio Life Sciences | RP1100 | URL: https://www.solarbio.com/goodsInfo?id=992 |
| WGCNA | CRAN / autores do WGCNA | https://cran.r-project.org/package=WGCNA | Versão 1.74 |
| Windows | Microsoft | https://www.microsoft.com/windows/windows-11 | Windows 11 |
Referências
- Armstrong DG, Tan TW, Boulton AJM, Bus SA. Diabetic foot ulcers: a review. JAMA. 2023;330(1):62–75.
- Bus SA et al. Guidelines on the prevention of foot ulcers in persons with diabetes (IWGDF 2023 update). Diabetes Metab Res Rev. 2024;40(3):e3651.
- Sloan G, Selvarajah D, Tesfaye S. Pathogenesis, diagnosis and clinical management of diabetic sensorimotor peripheral neuropathy. Nat Rev Endocrinol. 2021;17(7):400–20.
- Maione AG et al. Altered ECM deposition by diabetic foot ulcer-derived fibroblasts implicates fibronectin in chronic wound repair. Wound Repair Regen. 2016;24(4):630–43.
- Caley MP, Martins VLC, O'Toole EA. Metalloproteinases and wound healing. Adv Wound Care (New Rochelle). 2015;4(4):225–34.
- Lobmann R et al. Expression of matrix-metalloproteinases and their inhibitors in the wounds of diabetic and non-diabetic patients. Diabetologia. 2002;45(7):1011–6.
- Muller M et al. Matrix metalloproteinases and diabetic foot ulcers: the ratio of MMP-1 to TIMP-1 is a predictor of wound healing. Diabet Med. 2008;25(4):419–26.
- Theocharidis G et al. Single cell transcriptomic landscape of diabetic foot ulcers. Nat Commun. 2022;13(1):181.
- Vabalas A, Gowen E, Poliakoff E, Casson AJ. Machine learning algorithm validation with a limited sample size. PLoS One. 2019;14(11):e0224365.
- Lewis MJ et al. nestedcv: an R package for fast implementation of nested cross-validation with embedded feature selection designed for transcriptomics and high-dimensional data. Bioinform Adv. 2023;3(1):vbad048.
- Hattori N et al. MMP-13 plays a role in keratinocyte migration, angiogenesis, and contraction in mouse skin wound healing. Am J Pathol. 2009;175(2):533–46.
- Pang J, Maienschein-Cline M, Koh TJ. Monocyte/macrophage heterogeneity during skin wound healing in mice. J Immunol. 2022;209(10):1999–2011.
- Finley PJ et al. Diabetic wounds exhibit decreased Ym1 and arginase expression with increased expression of IL-17 and IL-20. Adv Wound Care (New Rochelle). 2016;5(11):486–94.
- Moon JY et al. IL-17A is increased in diabetic wounds and impairs keratinocyte function via histone demethylase JMJD3. Nat Commun. 2026;17(1):780.
- Xiao Y et al. Macrophages regulate healing-associated fibroblasts in diabetic wound. Mol Biol Rep. 2024;51(1):203.
- Theocharidis G et al. Integrated skin transcriptomics and serum multiplex assays reveal novel mechanisms of wound healing in diabetic foot ulcers. Diabetes. 2020;69(10):2157–69.
- Almeida AF et al. Bioavailability of quercetin in humans with a focus on interindividual variation. Compr Rev Food Sci Food Saf. 2018;17(3):714–31.
- Khoshandam A, Imenshahidi M, Hosseinzadeh H. Pharmacokinetic of berberine, the main constituent of Berberis vulgaris L.: a comprehensive review. Phytother Res. 2022;36(11):4063–79.