Это исследование было направлено на сравнение L1-L2-English и L1-L2 Portuguese, чтобы проверить, насколько влияние иностранного акцента влияет как на метрики, так и на просометрически-акустические параметры, а также на выбор целевого голоса в голосовой линейке.
Для просмотра этого контента требуется подписка на JoVE. Войдите или начните свой бесплатный пробный период.
Методическая статья
Иностранный акцент и криминалистическая идентификация диктора в голосовых рядах: влияние акустических особенностей на основе просодии
В этой статье
Краткое содержание
Аннотация
Это исследование направлено на изучение как просодических акустических особенностей, так и перцептивных коррелятов английского языка с иностранным акцентом и бразильского португальского с иностранным акцентом, а также на проверку того, как воспроизведение носителями иностранного и родного акцента коррелирует с восприятием слушателей. В рамках методики мы провели процедуру постановки речи с группой американских носителей бразильского португальского языка L2 и группой носителей бразильского английского языка L2, а также процедуру восприятия речи, в ходе которой мы выполнили голосовые расстановки для обоих языков. Для статистического анализа производства речи мы запустили обобщенные аддитивные модели, чтобы оценить влияние языковых групп на каждый класс (метрический или просодечно-акустический) признаков, контролируемых по эффекту сглаживания ковариат(ов) противоположного класса. Для статистического анализа восприятия речи мы провели тест Краскела-Уоллиса и апостериорный тест Данна, чтобы оценить влияние голосов составов на оценки, оцененные слушателями. Тем не менее, мы провели акустические (голосовые) тесты на сходство на основе косинусов и евклидовых расстояний. Результаты показали значительные акустические различия между языковыми группами с точки зрения вариабельности f0, длительности и качества голоса. Что касается составов, результаты показали, что просодические характеристики f0, интенсивности и качества голоса коррелируют с воспринимаемыми слушателями суждениями.
Введение
Акцент - это заметный и динамичный аспект общения и беглости, как на родном языке (L1), так и на иностранном языке (L2)1. Иностранный акцент представляет фонетические особенности L2 целевого языка, и он может меняться (со временем) в зависимости от опыта говорящего в L2, стиля речи, качества ввода, экспозиции и других переменных. Иностранный акцент может быть количественно выражен как (скалярная) степень различия между речью L2, произнесенной носителем иностранного языка, и местным или референсным акцентом целевого языка2,3,4,5.
Это исследование направлено на изучение как просодических акустических особенностей, так и перцептивных коррелятов английского языка с иностранным акцентом и бразильского португальского языка (BP) с иностранным акцентом, а также на проверку того, в какой степени воспроизведение носителями иностранного и родного акцента коррелирует с восприятием слушателей. Предыдущие исследования в области криминалистики продемонстрировали, что надежность гласных и согласных при идентификации иностранного акцента либо стабильна для долгосрочного анализа человека (The Lo Case6), либо указывает на высокую точность идентификации говорящего (The Lindbergh Case7). Тем не менее, исследование просодических акустических особенностей, основанных на длительности, основной частоте (f0, т.е. акустическом корреляте высоты тона), интенсивности и качестве голоса (VQ), привлекает все большее внимание8,9. Таким образом, выбор просодических акустических характеристик в этом исследовании представляет собой многообещающее направление в области судебной фонетики8,10,11,12,13.
Настоящее исследование подтверждается исследованиями, посвященными иностранным акцентам как форме маскировки голоса в судебно-медицинских делах14,15, а также при подготовке голосовых составов для распознавания говорящего16,17. Например, скорость речи играла важную роль в идентификации носителей немецкого, итальянского, японского и бразильского языков на английском языке18,19,20,21,22. Помимо скорости речи, долгосрочные спектральные функции и функции f0 бросают вызов носителям, владеющим L2, знакомым с изучаемым языком, потому что мозг и когнитивные основы страдают от дефицита памяти, внимания и эмоций, что отражается на фонетических характеристиках говорящего во время длинных речевых оборотов23. Взгляд на иностранные акценты в области криминалистики заключается в том, что определение того, что на самом деле звучит как иностранный акцент, во многом зависит от незнания слушателем незнакомости, а не от наличия крайней степени речи с иностранным акцентом24.
В области восприятия распространенным инструментом судебной экспертизы, используемым с середины 1990-х годов для распознавания преступников, является Voice Lineup (слуховое распознавание), которое является аналогом визуального распознавания, используемого для идентификации преступника на месте преступления16,25. В голосовой линейке голос подозреваемого представлен вместе с фольгированными голосами — голосами, схожими по социолингвистическим аспектам, таким как возраст, пол, географическое положение, диалект и культурный статус, — для идентификации очевидцем. Успех или неудача голосового состава будет зависеть от количества голосовых сэмплов и продолжительности выборки25,26. Кроме того, для реальных образцов считается, что качество звука постоянно влияет на точность распознавания голоса. Плохое качество звука может исказить уникальные характеристики voice27. В случае сходства голоса, мелкие фонетические детали, основанные на f0, могут запутать слушателя во время распознавания голоса28,29. Такие акустические характеристики выходят за рамки f0 и включают в себя элементы длительности, а также спектральные характеристики интенсивности и класса VQ30. Этот взгляд на множественные просодические особенности имеет решающее значение в контексте криминалистического сравнения голоса для обеспечения точной идентификации говорящего9,14,15,29,31.
В итоге, исследования в области судебной фонетики показали некоторые различия в идентификации иностранного акцента за последние десятилетия. С одной стороны, иностранный акцент, по-видимому, не влияет на процесс определения носителя sup32,33 (особенно если говорящий не знаком с целевым иностранным акцентом34). С другой стороны, есть выводы в обратном направлении12,34,35.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Протокол
Данная работа была одобрена комитетом по этике исследований с участием человека. Кроме того, от всех участников данного исследования было получено информированное согласие на использование и публикацию их данных.
1. Речепроизводство
ПРИМЕЧАНИЕ: Мы собрали речевые данные в ходе задания по чтению для обеих групп: «L1 английский — L2 бразильский португальский», полученные от Группа 1The Америцийамериканский Еанглийский (США) Sносителей языка (AmE-S), а также на записях «L1 BP-L2 English», созданных Группа 2: The Бразиллиан Sдинамики (Bra-S). См. Рисунок 1 для блок-схемы процесса продукции речи.

Рисунок 1: Схематическая блок-схема процесса продукции речи. Нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
- Участники
- Для каждой группы определите количество участников, язык (L1 английский, L2 бразильский португальский (BP); L1 BP, L2 английский), пол (женский или мужской), возраст (среднее значение, стандартное отклонение), характеристики группы (специалисты или студенты бакалавриата) и уровень владения L2 (продвинутый или высокий).
ПРИМЕЧАНИЕ: В данном исследовании обе группы (AmE-S и Bra-S) считались владеющими L2 на достаточном уровне (обе группы были квалифицированы как B2-C136). Группа AmE-S прожила в Бразилии два года к моменту проведения процедур. Группа Bra-S прожила в США более двух лет к моменту проведения процедур. Во время проживания за границей обе группы использовали L2 в учебных и рабочих целях не менее 6 дней в неделю примерно по 4-5 ч в день. - Разместите участников в комфортном и тихом помещении и предоставьте каждой группе материал для чтения.
- Для каждой группы определите количество участников, язык (L1 английский, L2 бразильский португальский (BP); L1 BP, L2 английский), пол (женский или мужской), возраст (среднее значение, стандартное отклонение), характеристики группы (специалисты или студенты бакалавриата) и уровень владения L2 (продвинутый или высокий).
- Сбор данных
ПРИМЕЧАНИЕ: Речевые данные должны быть собраны в ходе задания по чтению на следующих языках: L1-английский и L2-BP; L1-BP и L2-английский. При необходимости позвольте участникам заранее ознакомиться с текстами.- Процедуры записи
- Запишите речевые данные в тихом месте с соответствующими акустическими условиями.
- Используйте цифровой диктофон (см. Таблицу материалов)37 и однонаправленный электромагнитно-изолированный кардиоидный микрофон (см. Таблицу материалов)38.
- Записывайте аудиоданные в формате '.wav'.
- Установите частоту дискретизации 48 kHz и разрядность квантования 16 bits.
ПРИМЕЧАНИЕ: Аудиоформат и конфигурация частоты дискретизации и разрядности квантования, описанные в пунктах 1.2.1.3 и 1.2.1.4, применяются для обеспечения высокого качества и снижения шума с целью сохранения спектральных характеристик, используемых для последующего акустического анализа.
- Процедуры записи
- Акустический анализ
ПРИМЕЧАНИЕ: Разделите процедуры акустического анализа на три этапа: принудительное выравнивание (forced-alignment), повторное выравнивание (realignment) и извлечение акустических признаков.- Подготовьте лингвистическую транскрипцию (в файле '.txt') для каждого аудиофайла.
- Присвойте паре файлов '.txt'/'.wav' одинаковые имена (например, 'my_file.wav'/ 'my_file.txt').
ПРИМЕЧАНИЕ: Для повышения эффективности процедуры, описанной в разделе 1.3.7, настоятельно рекомендуется, чтобы первые три символа имен файлов «.txt/.wav» обозначали язык, диалект или акцент, а с четвертого по шестой символы обозначали пол (например, EL1FEM для English L1 Female — английский L1, женщина). Начиная с седьмого символа следует указать номер говорящего (например, 001 для первого говорящего). Таким образом, первая пара «.txt/.wav» будет иметь имя EL1FEM001. - Создайте папку для каждой языковой пары L1-L2.
ПРИМЕЧАНИЕ: Отдельная папка для L1-L2 английского и отдельная папка для L1-L2 BP. - Убедитесь, что все пары файлов одного языка находятся в одной папке.
- Выполните принудительное выравнивание.
- Перейдите в веб-интерфейс инструмента принудительного выравнивания Munich Automatic Segmentation (MAUS) (webMAUS)39 по адресу https://clarin.phonetik.uni-muenchen.de/BASWebServices/interface/Pipeline.
- Перетащите каждую пару файлов .wav / .txt из папки в пунктирный прямоугольник в разделе Files (или щелкните внутри прямоугольника, Рисунок 2A).
- Нажмите кнопку Upload , чтобы загрузить файлы в выравниватель (см. красную стрелку на Рисунке 2A).
- Выберите следующие параметры в меню Service options (Рисунок 2B): G2P-MAUS-PHO2SYL в поле Pipeline name; English (US) в поле Language для данных L1-L2 английского; Italian (IT) в поле Language для данных L1-L2 BP.
ПРИМЕЧАНИЕ: Мы выбрали «Italian» для данных BP, так как webMAUS не предоставляет предобученных акустических моделей для принудительного выравнивания BP. В фонетической литературе указывается, что итальянская фонология имеет схожий симметричный инвентарь из семи гласных, как и BP40, а также сходство в акустических характеристиках согласных41,42. - Оставьте параметры по умолчанию для «Output format» и «Keep everything».
- Установите флажок Run , чтобы принять условия использования (см. зеленую стрелку на Рисунке 2C).
- Нажмите кнопку Run Web Service, чтобы запустить обработку загруженных файлов.
ПРИМЕЧАНИЕ: Для каждого аудиофайла принудительный выравниватель MAUS возвращает объект Praat TextGrid (преформатированный файл «.txt» Praat, содержащий разметку слов, фонологических слогов и фонем на основе лингвистической транскрипции из файла «.txt», описанного в пункте 1.3.1). - Нажмите кнопку Download as ZIP-File, чтобы скачать файлы TextGrid в виде архива (Рисунок 2C).
ПРИМЕЧАНИЕ: Убедитесь, что архив с файлами TextGrid скачан в ту же папку, где находятся аудиофайлы. - Распакуйте файлы TextGrid для последующего повторного выравнивания в программе для фонетического анализа43.
- Выполните повторное выравнивание.
- Найдите и скачайте скрипт для Praat VVUnitAligner44 по адресу https://github.com/leonidasjr/VVunitAlignerCode_webMAUS/blob/main/VVunitAligner.praat.
- Убедитесь, что все пары файлов одного языка и скрипт VVUnitAligner находятся в одной папке.
ПРИМЕЧАНИЕ: Отдельная папка для файлов L1-L2 английского и VVunitAligner, и отдельная папка для файлов L1-L2 BP и VVunitAligner. - Откройте программу для фонетического анализа.
- Выберите Praat | Open Praat script…, чтобы вызвать скрипт из окна объектов.
- Нажмите кнопку Run один раз.
ПРИМЕЧАНИЕ: На экране появится форма Phonetic syllable alignment с настройками для использования скрипта (Рисунок 3A). - Нажмите кнопку Language и выберите один из языков: «English (US)», «Portuguese (BR)», «French (FR)» или «Spanish (ES)».
- Нажмите кнопку Chunk segmentation и выберите процедуру сегментации: «Automatic», «Forced (manual)» или «None».
- Установите флажок Save TextGrid files для автоматического сохранения новых файлов TextGrid.
- Нажмите кнопки Ok | Run для повторного выравнивания фонетических единиц из пункта 1.3.5.7.
ПРИМЕЧАНИЕ: Для каждого аудиофайла VVUnitAligner создаст новый файл TextGrid для раздела 1.3.7 (Рисунок 3B).
- Выполните автоматическое извлечение акустических признаков.
- Найдите и скачайте скрипт SpeechRhythmExtractor45 по адресу https://github.com/leonidasjr/SpeechRhythmCode/blob/main/SpeechRhythmExtractor.praat для автоматического извлечения просодико-акустических признаков.
- Создайте новую папку и поместите в нее SpeechRhythmExtractor вместе со всеми парами аудиофайлов/файлов TextGrid для всех языков.
- Откройте программу для фонетического анализа.
- Выберите Praat | Open Praat script…, чтобы вызвать скрипт из окна объектов.
- Нажмите кнопку Run только один раз.
ПРИМЕЧАНИЕ: На экране появится форма с настройками скрипта. В полях имен выходных файлов «.txt» переименуйте файлы соответствующим образом или оставьте имена по умолчанию. - Установите флажок voice quality parameters, чтобы сохранить выходной файл VQ для параметров качества голоса (Рисунок 3C).
ПРИМЕЧАНИЕ: Этот второй выходной файл (выходной файл VQ) содержит параметры разности между 1st и 2nd гармониками (H1-H2) и пик кепстральной выраженности (CPP)9. - Установите флажок Linguistic target и выберите одну из меток: «Language», «Dialect» или «Accent» (Рисунок 3C).
- Установите флажок Unit , чтобы выбрать признаки f0 в Hz или в полутонах (Semitones) (Рисунок 3C).
- Укажите значения в поле F0 threshold: минимальный и максимальный пороги f0 (Рисунок 3C).
ПРИМЕЧАНИЕ: Если исследование не имеет специфических целей или заранее установленных акустических признаков, настоятельно рекомендуется оставить параметры пункта 1.3.7.9 по умолчанию. - Нажмите Ok | Run для автоматического извлечения акустических признаков.
ПРИМЕЧАНИЕ: Скрипт SpeechRhythmExtractor возвращает текстовый файл «.txt» с разделителями-табуляциями (Output file/ Output file VQ), содержащий извлеченные акустические признаки говорящих.
- Статистический анализ
- Загрузите таблицу с акустическими признаками в среду R46 (или любое другое статистическое ПО/среду по выбору).
- Выполните непараметрический статистический анализ с использованием обобщенных аддитивных моделей (GAMs).
- Выполните GAMs в R.
- Введите следующие команды и нажмите Enter.
library(mgcv)
model = gam(the metric/prosodic-acoustic feature in analysis ~ the Language + s(the chosen metric feature, by = the Language) + other metric/prosodic-acoustic features, data = the data frame)
ПРИМЕЧАНИЕ: Мы решили проводить статистическую проверку протокола на языке программирования R из-за его растущей популярности среди фонетиков (и лингвистов) в академическом сообществе. R широко используется в полевых фонетических исследованиях47. Имейте в виду, что пункт 1.4.2.2 содержит псевдокод. Напишите код в соответствии с переменными вашего исследования.

Рисунок 2: Скриншот процесса фонетического выравнивания с использованием инструмента принудительного выравнивания MAUS. (A) Пунктирный прямоугольник предназначен для перетаскивания файлов 'my_file.wav'/' my_file.txt' или для нажатия внутри него с целью поиска таких файлов в папке; кнопка загрузки отмечена красной стрелкой. (B) Загруженные из панели A файлы (см. синюю стрелку), выбираемый конвейер обработки, язык для пар файлов, формат возвращаемого файла и кнопка «true/false» для сохранения всех файлов. (C) Флажок принятия условий использования (см. зеленую стрелку), кнопка Run Web Services и результаты (файлы TextGrid для скачивания). Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
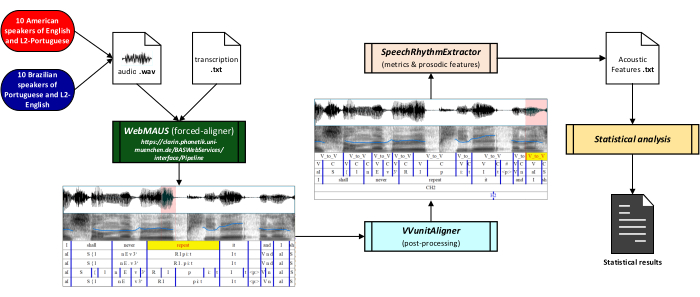
Рисунок 3: Скриншот процедуры перевыравнивания. (A) Форма входных настроек для процедуры перевыравнивания. (B) Фрагмент формы волны, широкополосная спектрограмма с контуром f0 (синим цветом) и шесть сегментированных (и размеченных) уровней: уровень 1: единицы от начала одного гласного до начала следующего гласного (V_to_V); начало гласного (V_to_V); уровень 2: единицы гласного (V), согласного (C) и паузы (#); уровень 3: фонические представления V_to_V; уровень 4: отдельные слова из текста; уровень 5: отдельные речевые фрагменты (CH) из текста; уровень 6: тональный уровень, содержащий самый высокий (H) и самый низкий (L) тон каждого речевого фрагмента, произнесенного женщиной с AmE-S. (C) Входные настройки для автоматического извлечения акустических признаков. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
2. Восприятие речи
ПРИМЕЧАНИЕ: Мы провели четыре серии голосовых опознаний на английском языке с американскими слушателями и четыре серии на бразильском варианте португальского (BP) с бразильскими слушателями. Схема восприятия речи представлена на рисунке 4.
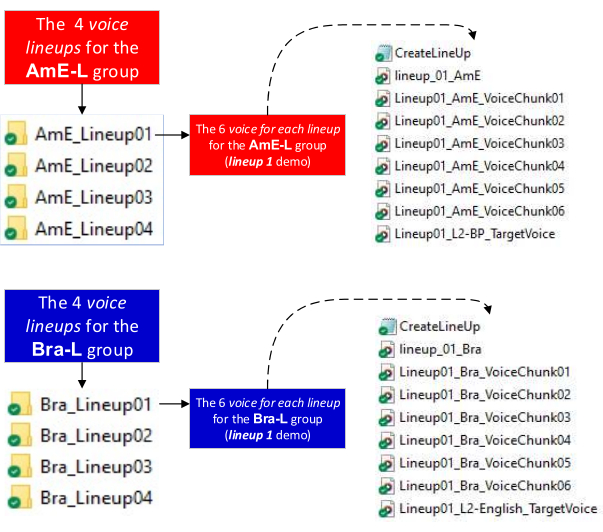
Рисунок 4: Схематичная блок-схема восприятия речи. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
- Участники
- Для каждой группы выберите участников, не принимавших участия в протоколе воспроизведения речи.
ПРИМЕЧАНИЕ: Для данной части протокола были отобраны две группы участников: Группа 1The Америцийамериканский Еанглийский (США) Лслушатели (амер. англ.), и Группа 2The Бразиллиан Лслушателей (Bra-L). В данном исследовании как AmE-L, так и Bra-L считались владеющими вторым языком на достаточном уровне (обе группы были квалифицированы как B2-C136 На момент проведения процедур представители группы AmE-L проживали в Бразилии в течение двух лет. Представители группы Bra-L проживали в США более двух лет на момент проведения процедур. Во время пребывания за границей обе группы использовали свой второй язык (L2) в учебных и рабочих целях (как минимум шесть дней в неделю примерно по 4–5 часов в день). - Определите количество участников, the язык (L1 английский, L2 бразильский португальский; L1 бразильский португальский, L2 английский), the пол (самка или самец), этот/эта/это возраст (среднее значение, стандартное отклонение), характеристики групп (специалистов или студентов бакалавриата) и Уровень владения вторым языком для каждой группы.
- Для каждой группы выберите участников, не принимавших участия в протоколе воспроизведения речи.
- Голосовое сопровождение
ПРИМЕЧАНИЕ: Разделите процедуры проведения голосовых опознаний на два разных этапа: подготовку и выполнение голосовых опознаний.- Подготовьте по четыре голосовых линейки для английского языка и для BP.
- Получите аудиофайлы от спикеров раздела 1: Речепроизношение.
- Убедитесь, что аудиофайлы для каждого языкового фактора находятся в отдельных папках.
- Случайным образом выберите шесть голосовых фрагментов на английском языке (L1 English) или на бразильском португальском языке (L1 BP).
ПРИМЕЧАНИЕ: Шесть голосов в ряду представляют один целевой голос и пять фольгированных пластин. - Выберите фрагмент голосовой записи на английском языке как втором (L2 English) или на бразильском португальском языке как втором (L2 BP) одного из спикеров, указанных в шаге 2.2.1.3.
ПРИМЕЧАНИЕ: Голосовой фрагмент в шаге 2.2.1.4 представляет собой эталонный голос8. Длина фрагментов должна составлять примерно 20 с. - Получите доступ к скрипту Praat CreateLineup и загрузите его48 из https://github.com/pabarbosa/prosody-scripts-CreateLineUp.
- Перед запуском скрипта CreateLineup убедитесь, что эталонный голос L2, фойлы L1 и целевой голос L1 находятся в одной папке (Рисунок 5).
- Откройте программное обеспечение для фонетического анализа.
- Из окно объекта, нажмите Praat | Открыть скрипт Praat… для вызова скрипта.
- Нажмите Запуск | Запуск.
ПРИМЕЧАНИЕ: Скрипт возвращает файл в следующем порядке: (эталонный голос L2) + (целевой голос L1 и дистракторы, распределенные случайным образом)Рисунок 5).
- Проведение голосового опознания
- Создайте онлайн-пространство для размещения списков на любой выбранной платформе (например, SurveyMonkey). См. Перечень материалов) для дистанционного проведения опознания по голосу.
- Перейдите по ссылке в онлайн-пространство.
- Загрузите файлы, полученные в результате работы скрипта CreateLineup, на платформу.
- Выполните процедуру перед участниками, чтобы протестировать каждый этап.
ПРИМЕЧАНИЕ: Рекомендуется заранее перейти по ссылке и запустить проверочные сценарии, чтобы убедиться в корректности работы всех функций.
- Подготовьте по четыре голосовых линейки для английского языка и для BP.
- Статистический анализ
- Загрузите таблицу с результатами оценок слушателей в среду R (или в любое другое выбранное вами статистическое программное обеспечение/среду).
- Выполните тест Краскела — Уоллиса в R.
- Введите следующие команды и нажмите Введите.
model = kruskal.test(заключения ~ каждый голосовой идентификационный ряд, данные = те фрейм данных)
- Выполните апостериорный критерий Данна.
- Выполнение теста Данна в R.
- Введите следующие команды и нажмите Введите.
library(FSA)
model = dunnTest(оценки ~ каждый голосовое опознание, data = data, method = "поправка Бонферрони")
ПРИМЕЧАНИЕ: Коды в шагах 2.3.1.2 и 2.3.2.2 являются псевдокодами (см. ПРИМЕЧАНИЕ 1.4.2.2).
- Загрузите таблицу с результатами оценок слушателей в среду R (или в любое другое выбранное вами статистическое программное обеспечение/среду).
- Анализ акустического сходства
- Выберите те наборы стимулов (см. ПРИМЕЧАНИЕ в шаге 2.2.1.3), в которых не было обнаружено значимых различий между целевым стимулом и любым из дистракторов.
- Повторите процедуры, описанные в шагах с 1.3.1 по 1.3.7.5 и с 1.3.7.8 по 1.3.7.10.
- Получите доступ к скрипту для Python и загрузите его49, АкустическоеСходство_косинусное_евклидово50 из https://github.com/leonidasjr/AcousticSimilarity/blob/main/AcousticSmilarity_cosine_euclidean.py.
ПРИМЕЧАНИЕ: Скрипт возвращает три матрицы (в форматах «.txt» и «.csv»): одна из них — для косинусного сходства51,52, одна для евклидова расстояния52,53и одна для значений преобразованного евклидова расстояния, а также попарное сравнение целевого голоса с каждым из контрольных образцов. - Убедитесь, что скрипт загружен в ту же папку, что и набор данных lineup.
- Нажмите на Открыть файл… кнопка для вызова скрипта
- Нажмите Запуск | Запуск без отладки кнопки
ПРИМЕЧАНИЕ: Второй Запуск кнопка может быть помечена как Запуск или Запуск без отладки или Запустить скрипт. Все они выполняют одни и те же команды. Это зависит исключительно от используемой среды Python. - Проведите тесты на сходство голосов на основе акустических признаков.
ПРИМЕЧАНИЕ: Косинусное сходство (или косинусное расстояние) — это метод, применяемый в искусственном интеллекте (ИИ), в частности в машинном обучении в системах автоматического распознавания речи (ASR). Оно представляет собой меру сходства в диапазоне от нуля до единицы. Значение косинусного сходства, близкое к единице, означает, что два голоса с большой вероятностью схожи. Значение косинусного сходства, близкое к нулю, означает, что голоса с большой вероятностью различаются.52Евклидово расстояние, которое часто называют евклидовым сходством, также широко используется в области ИИ, машинного обучения и автоматического распознавания речи (ASR). Оно представляет собой расстояние по прямой между двумя точками в евклидовом пространстве.53т. е. чем ближе расположены точки (тем меньше значения расстояния), тем более схожими являются голоса. Для более четкого понимания полученных результатов обоих методов мы преобразовали необработанные значения евклидова расстояния в значения от нуля (меньшая схожесть голосов) до единицы (большая схожесть голосов).54.

Рисунок 5Настройка каталогов для восприятия речи. Выровняйте папки. Каждая папка содержит шесть голосов L1, целевой голос L2, "Создать состав" скрипт и аудиофайл с записью голосов (полученный после запуска скрипта). Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Результаты
Результаты продукции речи
В данном разделе мы описали показатели статистически значимых просодико-акустических признаков и метрик ритма. К таким просодическим признакам относились темп речи, темп артикуляции и частота пауз, которые связаны с длительностью, а также шиммер, который связан с качеством голоса. Метриками ритма были стандартное отклонение (SD) длительности слога, SD согласного, SD вокализированной или консонантной длительности и коэффициент вариации длительности слога (см. Дополн...
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Обсуждение
Текущий протокол представляет собой новшество в области (судебной) фонетики. Он разделен на две фазы: одна основана на производстве (акустический анализ) и другая основана на восприятии (анализ суждений). Этап анализа продукции включает в себя подготовку данных и принудительное выравнивание, повторное выравнивание и автоматическое извлечение просодических акустических особенностей, помимо статистики. Этот протокол связывает этап сбора данных с анализом данных более быстрым и эффективным способом, чем традиционные протоко...
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Раскрытие информации
У авторов нет конфликта интересов, о котором можно было бы заявить.
Благодарности
Это исследование было поддержано Национальным советом по научно-техническому развитию - CNPq, грант No 307010/2022-8 для первого автора и грант No 302194/2019-3 для второго автора. Авторы выражают искреннюю благодарность участникам данного исследования за щедрое сотрудничество и неоценимый вклад.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Материалы
| Имя | Компания | Каталожный номер | Комментарии |
|---|---|---|---|
| CreateLineup | Личная коллекция | # | Скрипт для подготовки голосовых составов |
| Dell I3 (с твердотельным накопителем - SSD) | Dell | # | Laptop computer |
| Praat | Paul Boersma & Дэвид Вининк | # | Программное обеспечение для фонетического анализа |
| Python 3 | Python Software Foundation | # | Интерпретируемый, высокоуровневый, язык программирования общего назначения |
| R | The R Project for Statistical Computing | # | Programming language for stattistical computing |
| Shure Beta SM7B | Shure | # | Microphone |
| SpeechRhythmExtractor | Personal collection | # | Script for praat для автоматического извлечения акустических характеристик |
| SurveyMonkey | SurveyMonkey Inc. | # | Соберите бесплатные настраиваемые опросы, а также набор серверных программ, которые включают анализ данных, отбор выборки, устранение предвзятости и представление данных. |
| Tascam DR-100 MKII | Tascam | # | Цифровой диктофон |
| Мюнхенская автоматическая система сегментации MAUS | University of Munich | # | Принудительное выравнивание аудио (.wav) и лингвистической информации (.txt) файлов |
| VVUnitAligner | Личная коллекция | # | Скрипт для праата для автоматической перестройки и постобработки фонетических единиц |
Ссылки
- Moyer, A. Foreign Accent: The Phenomenon of Non-native Speech. , Cambridge University Press. (2013).
- Munro, M., Derwing, T. Foreign accent, comprehensibility and intelligibility, redux. J Second Lang Pronunciation. 6 (3), 283-309 (2020).
- Levis, J. Intelligibility, Oral Communication, and the Teaching of Pronunciation. , Cambridge University Press. (2018).
- Munro, M. Applying Phonetics: Speech Science in Everyday Life. , Wiley-Blackwell. (2022).
- Gut, U. Speaker Classification. Muller, C. , Springer-Verlag. 75-87 (2007).
- Rogers, H. Foreign accent in voice discrimination: a case study. Forensic Linguistics. 5 (2), 203-208 (1998).
- Solan, L., Tiersma, P. Hearing Voices: Speaker Identification in Court. Hastings Law Journal. 54, 373-436 (2003).
- Alcaraz, J. The long-term average spectrum in forensic phonetics: From collation to discrimination of speakers. Estudios de Fonética Experimental / Journal o Experimental Phonetics. 32, 87-110 (2023).
- Silva, L. Jr, Barbosa, P. A. Voice disguise and foreign accent: Prosodic aspects of English produced by Brazilian Portuguese speakers. Estudios de Fonética Experimental / Journal o Experimental Phonetics. 32, 195-226 (2023).
- Munro, M., Derwing, T. Modeling perceptions of the accentedness and comprehensibility of L2 speech. Studies in Second Language Acquisition. 23 (4), 451-468 (2001).
- Keating, P., Esposito, C. Linguistic Voice Quality. Working Papers in Phonetics. , 85-91 (2007).
- Niebuhr, O., Skarnitzl, R., Tylečková, L. The acoustic fingerprint of a charismatic voice -Initial evidence from correlations between long-term spectral features and listener ratings. Proceedings of Speech Prosody. , 359-363 (2018).
- Segundo San, E. International survey on voice quality: Forensic practitioners versus voice therapists. Estudios de Fonética Experimental. 29, 8-34 (2021).
- Farrús, M. Fusing prosodic and acoustic information for speaker recognition. International Journal of Speech, Language and the Law. 16 (1), 169(2009).
- Farrús, M. Voice disguise in automatic speaker recognition. ACM Computing Surveys. 51 (4), 1-2 (2018).
- Nolan, F. A recent voice parade. The International Journal of Speech, Language and the Law. 10 (2), 277-291 (2003).
- McDougall, K. Ear-catching versus eye-catching? Some developments and current challenges in earwitness identification evidence. Speaker Individuality in Phonetics and Speech Sciences. Bernardasci, C., Dipino, D., Garassino, D., Negrinelli, S., Pellegrino, E., Schmid, S. , Officinaventuno. 33-56 (2021).
- Gut, U. Rhythm in L2 speech. Speech and Language Technology. 14 (15), 83-94 (2012).
- Urbani, M. Pitch Range in L1/L2 English. An Analysis of F0 using LTD and Linguistic Measures. Coop. , Libraria Editrice Università di Padova. (2012).
- Gonzales, A., Ishihara, S., Tsurutani, C. Perception modeling of native and foreign-accented Japanese speech based on prosodic features of pitch accent. J Acoust Soc Am. 133 (5), 3572(2013).
- Silva, L. Jr, Barbosa, P. A. Speech rhythm of English as L2: an investigation of prosodic variables on the production of Brazilian Portuguese speakers. J Speech Sci. 8 (2), 37-57 (2019).
- Foreign accent and L2 speech rhythm of English a pilot study based on metric and prosodic parameters. Silva, L. Jr, Barbosa, P. A. Proceedings of the II Brazilian Conference on Prosody (Anais II Congresso Brasileiro de Prosódia), 1, 41-50 (2023).
- Costa, A. El cerebro bilingüe: La neurociencia del lenguaje. , Penguin Randon House. (2017).
- Eriksson, A. Tutorial on forensic speech science: Part I. Forensic Phonetics. , (2005).
- Harvey, M., Giroux, M., Price, H. Lineup size influences voice identification accuracy. Applied Cognitive Psychology. 37 (5), 42-89 (2023).
- Pautz, N., et al. Identifying unfamiliar voices: Examining the system variables of sample duration and parade size. Q J Exp Psychol (Hove). 76 (12), 2804-2822 (2023).
- McDougall, K., Nolan, F., Hudson, T. Telephone transmission and earwitnesses: Performance on voice parades controlled for voice similarity. Phonetica. 72 (4), 257-272 (2015).
- Nolan, F., McDougall, K., Hudson, T. Some acoustic correlates of perceived (dis) similarity between same-accent voices. Proceedings of the International Congress of Phonetic Sciences (ICPhS 2011). , 1506-1509 (2011).
- Sheoran, S., Mahna, D. Voice identification and speech recognition: an arena of voice acoustics. Eur Chem Bull. 12 (5), 50-60 (2023).
- Hudson, T., McDougall, K., Hughes, V. Forensic phonetics. The Cambridge Handbook of Phonetics. Knight, R. -A., Setter, J. , Cambridge University Press. 631-656 (2021).
- Eriksson, A. The disguised voice: Imitating accents or speech styles and impersonating individuals. Language and identities. Llamas, C., Watt, D. , Edinburgh University Press. 86-96 (2010).
- Köster, O., Schiller, N. Different influences of the native language of a listener on speaker recognition. Forensic Linguistics. 4 (1), 18-27 (1997).
- The influence of native-language background on speaker recognition. Köster, O., Schiller, N., Künzel, H. Proceedings of the International Congress of Phonetic Sciences (ICPhS 1995), , 306-309 (1995).
- Thompson, C. P. A language effect in voice identification. Applied Cognitive Psychology. 1, 121-131 (1987).
- San Segundo, E., Univaso, P., Gurlekian, J. Sistema multiparamétrico para la comparación forense de hablantes. Estudios de Fonética Experimental. 28, 13-45 (2019).
- Council of Europe. Common European Framework of Reference for Languages: Learning, Teaching, Assessment. , Press Syndicate of the University of Cambridge. (2001).
- How to use Tascam DR-100 MKII: Getting started. , https://www.youtube.com/watch?v=O2E72uV9fWc (2018).
- Getting the most from your Shure SM58 microphone. , https://www.youtube.com/watch?v=wweNufW7EXA (2020).
- Kisler, T., Reichel, U. D., Schiel, F. Multilingual processing of speech via web services. Computer Speech & Language. 45, https://clarin.phonetik.uni-muenchen.de/BASWebServices/interface/WebMAUSBasic 326-347 (2017).
- Escudero, P., Boersma, P., Rauber, A., Bion, R. A cross-dialect acoustic description of vowels: Brazilian and European Portuguese. J Acoust Soc Am. 126 (3), 1379-1393 (2009).
- Post-aspiration in standard Italian: some first cross-regional acoustic evidence. Stevens, M., Hajek, J. Proceedings 11th Conference of the International Speech Communication Association (INTERSPEECH 2010), , 1557-1560 (2011).
- Barbosa, P., Madureira, S. Manual de Fonética Acústica Experimental: aplicações a dados do português. , Cortez. (2015).
- Boersma, P., Weenink, D. Praat: Doing phonetics by computer. (Version 6.1.38) [Computer program]. , https://www.praat.org/ (1992-2021).
- Silva, L. Jr VVUnitAligner. [Computer program]. , https://github.com/leonidasjr/VVunitAlignerCode_webMAUS (2022).
- Silva, L. Jr, Barbosa, P. A. SpeechRhythmExtractor [Computer program]. , https://github.com/leonidasjr/VowelCode (2019-2023).
- R Core Team. A language and environment for statistical computing. R Foundation for Statistical Computing. , https://www.R-project.org/ (2023).
- Pigoli, D., Hadjipantelis, P. Z., Coleman, J. Z., Aston, J. The statistical analysis of acoustic phonetic data. Journal of the Royal Statistical Society. 67 (5), 1103-1145 (2018).
- Barbosa, P. A. CreateLineup [Computer program]. , https://github.com/pabarbosa/prosody-scripts-CreateLineUp (2021).
- Van Rossum, G., Drake, F. L. Python 3 Reference Manual. , CreateSpace. (2009).
- Silva, L. Jr AcousticSimilarity_cosine_euclidean. [Computer program]. , https://github.com/leonidasjr/AcousticSimilarity/blob/main/AcousticSmilarity_cosine_euclidean.py (2024).
- Automatic assessment of voice similarity within and across speaker groups with different accents. Gerlach, L., McDougall, K., Kelly, F., Alexander, A. Proceedings of the International Congress of Phonetic Sciences (ICPhS 2023), , 3785-3789 (2023).
- Gahman, N., Elangovan, V. A comparison of document similarity algorithms. International Journal of Artificial Intelligence and Applications. 14 (2), 41-50 (2023).
- San Segundo, E., Tsanas, A., Gómez-Vilda, P. Euclidean distances as measures of speaker similarity including identical twin pairs: A forensic investigation using source and Filter voice characteristics. Forensic Science International. 270, 25-38 (2017).
- Speaker's voice characteristics and similarity measurement using Euclidean distances. Singh, M. K., Singh, N., Singh, A. K. Proceedings of the International Conference on Signal Processing and Communication (ICSC 2019), , 317-322 (2019).
- Darling-White, M., Banks, W. Speech rate varies with sentence length in typically developing children. J Speech Lang Hear Res. 64 (6), 2385-2391 (2021).
- Barbosa, P. A. Incursões em torno do ritmo da Fala. , Pontes Editores. (2006).
- Golestani, N., Pallier, C. Anatomical correlates of foreign speech sound production. Cereb Cortex. 17 (4), 929-934 (2007).
- Trouvain, J., Fauth, C., Möbius, B. Breath and non-breath pauses in fluent and disfluent phases of German and French L1 and L2 read speech. Proceedings of Speech Prosody. , 31-35 (2016).
- Waaning, J. The Lombard effect: the effects of noise exposure and being instructed to speak clearly on speech acoustic parameters. [Master's thesis]. , Radboud University. (2021).
- Villegas, J., Perkins, J., Wilson, I. Effects of task and language nativeness on the Lombard effect and on its onset and offset timing. J Acoust Soc Am. 149 (3), 1855(2021).
- Differences between native and non-native Lombard speech in terms of pitch range. Proceedings of the 23rd International Congress on Acoustics(ICA 2019). Marcoux, K., Ernestus, M. , 5713-5720 (2019).
- Marcoux, K., Ernestus, M. Pitch in native and non-native Lombard speech. Proceedings of the International Congress of Phonetic Sciences (ICPhS 2019). , 2605-2609 (2019).
- Marcoux, K., Ernestus, M. Acoustic characteristics of non-native Lombard speech in the DELNN corpus. Journal of Phonetics. 102, 1-25 (2024).
- Gil, J., San Segundo, E. La cualidad de voz en fonética judicial [Voice quality in judicial phonetics]. Lingüística Forense: la Lingüística en el ámbito legal y policial. Garayzábal, M., Jiménez, M., Reigosa, M. , Euphonía Ediciones. 154-199 (2014).
- Gil, J., San Segundo, E. El disimulo de la cualidad de voz en fonética judicial: Estudio perceptivo de la hiponasalidad [Voice quality disguise in judicial phonetics: A perceptual study of hyponasality. Panorama de la fonética española actual. Penas-báñez, M. A. , Arco Libros. 321-366 (2013).
- Passeti, R., Madureira, S., Barbosa, P. What can voice line-ups tell us about voice similarity. Proceedings of the International Congress of Phonetic Sciences (ICPhS 2023). , 3765-3769 (2023).
- Nolan, F. The DyViS database: Style-controlled recordings of 100 homogeneous speakers for forensic phonetic research. International Journal of Speech Language and the Law. 16 (1), 31-57 (2009).
- Caroll, D. Psychology of Language. , Wadsworth. (1994).
- Ortega-Llebaria, M., Silva, L. Jr, Nagao, J. Macro- and micro-rhythm in L2 English: Exploration and Refinement of Measures. Proceedings of the International Congress of Phonetic Sciences (ICPhS 2023). , 1582-1586 (2023).
- Fernández-Trinidad, M. Hacia la aplicabilidad de la cualidad de la voz en fonética judicial. Loquens. 9 (1-2), 1-11 (2022).
- Brouwer, S. The role of foreign accent and short-term exposure in speech-in-speech recognition. Atten Percep Psychophys. 81, 2053-2062 (2019).
- Love, R., Wright, D. Specifying challenges in transcribing covert recordings: Implications for forensic transcription. Front Commun. 6, 1-14 (2021).
- Meer, P. Automatic alignment for New Englishes: Applying state-of-the-art aligners to Trinidadian English. J Acoust Soc Am. 147 (4), 2283-2294 (2020).
- Montreal Forced Aligner: trainable text-speech alignment using Kaldi. McAuliffe, M., Socolof, M., Mihuc, S., Wagner, M., Sonderegger, M. Proceedings 18th Conference of the International Speech Communication Association (INTERSPEECH 2017), , 498-502 (2017).
- Chodroff, E. Montreal Forced Aligner: MFA Tutorial. , https://zenodo.org/records/7591607 (2023).
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Перепечатки и разрешения
