Протеомные данные на основе масс-спектрометрии доступны в открытых базах данных и доступны с помощью бесплатных инструментов. Учитывая сложность поиска и описания баз данных, многим биологам не хватает знаний для использования этих наборов данных. Здесь мы предоставляем руководство по использованию бесплатных инструментов для базового протеомного поиска данных.
Для просмотра этого контента требуется подписка на JoVE. Войдите или начните свой бесплатный пробный период.
Методическая статья
Навигация по протеомным данным на основе масс-спектрометрии с помощью бесплатных вычислительных инструментов
В этой статье
Краткое содержание
Аннотация
Данные протеомики на основе масс-спектрометрии (МС), в том числе Data-Dependent Acquisition (DDA) и Data-Independent Acquisition (DIA), широко используются в биологических исследованиях. Тем не менее, применение этих наборов данных в валидационных исследованиях все еще ограничено из-за отсутствия четких демонстраций того, как эффективно искать и анализировать протеомные данные. Чтобы восполнить этот пробел, мы выбрали один набор данных DDA и один набор данных DIA, размещенные в репозитории данных PRoteomics IDEntifications Database (PRIDE), чтобы лучше проиллюстрировать рабочий процесс анализа протеомных данных и последующую постобработку результатов поиска белков. В демонстрационных целях мы использовали два бесплатных вычислительных инструмента: FragPipe (v22.0) для наборов данных DDA и DIA-NN (2.1.0) для наборов данных DIA. Этапы постобработки, такие как создание графиков вулканов и списков нерегулируемых белков, были продемонстрированы с использованием R-кода. В этом исследовании представлены основные протоколы для поиска и анализа протеомных данных, которые служат важным руководством для начинающих по эффективной работе с протеомными наборами данных. В рамках этой работы мы стремимся предоставить исследователям знания, необходимые для использования протеомных данных в их биологических исследованиях.
Введение
В области протеомики произошла революция благодаря широкому распространению репозиториев данных с открытым доступом и бесплатных программныхинструментов1, которые сыграли важную роль в развитии исследовательских возможностей и продвижении культуры обмена данными. Создание централизованных ресурсов, таких как PRIDE2, и разработка стандартизированных форматов данных в рамках Инициативы по стандартам протеомики (PSI) Организации протеомики человека (HUPO)3 создали беспрецедентную возможность для повторного использования и интеграции данных. Тем не менее, анализ и инт....
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Протокол
ПРИМЕЧАНИЕ: На рисунке 1приведен обзор рабочего процесса, а на Таблице материалов — подробное описание используемого программного обеспечения.
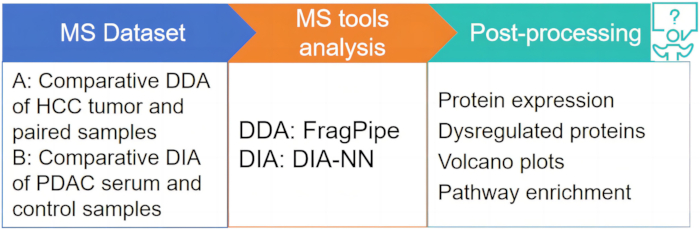
Рисунок 1: Обзор дизайна исследования. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Результаты
Чтобы лучше проиллюстрировать поиск протеомных наборов данных, мы выбрали два типа наборов данных для этого анализа. Стремясь продемонстрировать нерегулируемые белки в клиническом контексте, мы провели поиск в PRIDE по ключевым словам, таким как clinic. В частности, мы выбрали набор данных, подходящий для анализа DIA, от Консорциума по клиническому анализу протеомных опухолей (CPTAC)21, и еще один, подходящий для анализа DDA, от Китайского проекта протеома человека.......
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Обсуждение
Представленный протокол иллюстрирует протеомный анализ данных за счет интеграции бесплатных инструментов, таких как DIA-NN и FragPipe. Успех зависит от таких важных шагов, как точный выбор ионов прекурсоров и настройка точности массы для генерации спектральной библиотеки в DIA-NN (шаг 2.3)27, которые зависят от прибора и имеют решающее значение для полной идентификации пептидов. Аналогичным образом, тщательная настройка базы данных в FragPipe (шаг 3.4), включая ге.......
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Раскрытие информации
Ф.З. является основателем Molemuse Biotech Studio.
Благодарности
Проект реализуется при поддержке Molemuse Biotech Studio.
....Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Материалы
| Имя | Компания | Каталожный номер | Комментарии |
|---|---|---|---|
| .NET SDK версии 9.0.203 | Майкрософт | https://dotnet.microsoft.com/en-us/download | |
| DIA-NN версии 2.1.0 | https://github.com/vdemichev/DiaNN/releases/tag/2.0 | ||
| FragPipe v. 22.0 | https://github.com/Nesvilab/FragPipe/releases | ||
| MSFileReader v. 3.1 | Термо Фишер | https://github.com/thermofisherlsms/MSFileReader/blob/main/MSFileReader_x64.exe | |
| Версия 4.5.0 | https://cran.rstudio.com/bin/windows/base/R-4.5.0-win.exe | ||
| Rstudio v. 2024.12.1+563 | https://posit.co/download/rstudio-desktop/ |
Ссылки
- Pedrioli, P. G. A., et al. A common open representation of mass spectrometry data and its application to proteomics research. Nat Biotechnol. 22 (11), 1459-1466 (2004).
- Perez-Riverol, Y., et al. The PRIDE database at 20 years: 2025 update. Nucl ....
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Перепечатки и разрешения
