В данном исследовании рассматривается, улучшают ли факторы маркетинга отношений системы спортивных рекомендаций для фанатов Суперлиги Китая. Включение удовлетворения, доверия, приверженности и взаимности значительно повышает точность рекомендаций Top-N, особенно в условиях редких и длинных хвостов. Результаты показывают, что приверженность и взаимность стимулируют повторяющееся поведение с высокой вовлечённостью, тогда как удовлетворенность и доверие в основном поддерживают раннее вовлечение.
Для просмотра этого контента требуется подписка на JoVE. Войдите или начните свой бесплатный пробный период.
Исследовательская статья
Интеллектуальные рекомендательные системы для прогнозирования поведения болельщиков Китайской Суперлиги
В этой статье
Краткое содержание
Аннотация
Понимание и прогнозирование поведения болельщиков — центральная задача в профессиональном спорте, однако большинство рекомендательных систем в основном опираются на исторические взаимодействия и уделяют ограниченное внимание факторам маркетинга отношений, которые формируют вовлечённость болельщиков. Чтобы восполнить этот пробел, в этом исследовании разрабатывается MLP-PA (Многослойный перцептрон с пирамидным вниманием) и изучается, может ли включение реляционных состояний болельщиков — таких как удовлетворение, доверие, приверженность и взаимность — повысить эффективность рекомендаций в различных сценариях потребления среди болельщиков Китайской Суперлиги (CSL). Используя мульти-сценарийный набор данных, охватывающий билеты, товары, членство и цифровой контент, эмпирические результаты показывают, что рекомендации, сгенерированные MLP-PA, достигают значительно более высокой точности рейтинга Top-N, чем традиционные методы совместной фильтрации, с особенно заметными улучшениями в редких и длинных настройках. Анализ также показывает, что различные факторы взаимосвязи связаны с различными моделями потребления: приверженность и взаимность более тесно связаны с повторяющимися и высокововлечёнными поведением, тогда как удовлетворенность и доверие в основном влияют на начальные и краткосрочные реакции. Эти результаты показывают, что факторы маркетинга отношений играют существенную и дифференцированную роль в поведении болельщиков, предоставляя практические инсайты для персонализированных стратегий вовлечения и цифровых операций в профессиональном футболе.
Введение
В последние годы рекомендательные системы стали центральным компонентом цифровых платформ, позволяя согласовывать пользователей, продукты и контексты потребления через персонализацию, основанную на данных. Хотя технологии рекомендателей хорошо устоялись в таких сферах, как электронная коммерция и онлайн-медиа, их применение в профессиональном спорте остаётся сравнительнонедоразвитым 1. В таких лигах, как Китайская Суперлига (CSL), поведение болельщиков очень зависит от контекста и меняется на этапах до матча, в день матча и после матча, при этом решения о покупке тесно связаны с офлайн-посещаемостью, эмоциональной привязанностью и социальной идентичностью. Однако большинство существующих исследований спортивных рекомендаций в основном адаптируют совместную фильтрацию или техники контента из других областей и сосредоточены на краткосрочных сигналах взаимодействия, таких как клики или покупки. Эти подходы в значительной степени упускают из виду отношения отношения между болельщиками и клубами — такие как доверие, приверженность или взаимность — которые в исследованиях спортивного маркетинга определяют долгосрочное вовлечение и повторноепотребление 2. В результате современные модели с трудом объясняют, почему схожие поведенческие истории могут приводить к разным результатам потребления при разных реляционных состояниях. Этот пробел подчёркивает необходимость рекомендательных рамок, которые выходят за рамки частоты взаимодействия и явно учитывают механизмы, основанные на отношениях, при принятии решенийфанатом 3.
С точки зрения маркетинга отношений, удовлетворённость, доверие, приверженность и взаимность вместе составляют качество отношений и хорошо зарекомендуются как ключевые факторы для фанатов, включая посещаемость матчей, покупку мерча, продление членства и сарафанное радио 4,5,6. В отличие от этого, большинство существующих систем спортивных рекомендаций продолжают моделировать взаимодействие болельщика и предметов как в основном однородные поведенческие сигналы, уделяя мало внимания реляционному контексту, лежащему в основе этих взаимодействий. Это упрощение ограничивает их способность зафиксировать, как разные факторы отношений оказывают разные влияния на этапы потребления и интенсивность вовлечения, и помогает объяснить, почему модели, основанные исключительно на истории взаимодействия, часто не различают краткосрочные реакции от устойчивого, высокововлечённого поведения фанатов.
С инженерной точки зрения спортивные рекомендательные системы сталкиваются с дополнительными трудностями, включая асимметричную неявную обратную связь, выраженную разрежённость длинного хвоста и гетерогенные контексты мультитачовоговзаимодействия 7. Традиционные подходы к совместной фильтрации и модели с одиночной глубиной частотой часто демонстрируют ограниченную межконтекстную обобщённость в таких условиях и мало способствуют интерпретации для поддержки принятия решений в маркетинговых операциях.
Методологически предыдущие исследования рекомендательных систем предлагали ряд решений для решения проблем разреженности, гетерогенности и долгосрочной оптимизации. Модели на основе графов и внимания улучшили результаты обучения представления и ранжирования, перевзвешивая важность соседей и фиксируя взаимодействия высшегопорядка 8,9. Гибридные архитектуры, сочетающие совместные сигналы с глубоким обучением, показали успехи в масштабных рекомендательныхзадачах 10. Подходы, основанные на обучении с подкреплением, дополнительно расширяют оптимизацию к долгосрочным целям, а не к близорукости11. Эти достижения предоставляют ценные методологические основы для моделирования сложных взаимодействий при ограниченной обратной связи.
Тем не менее, большинство этих подходов остаются нейтральными к конструкциям маркетинга отношений и явно не включают такие переменные, как удовлетворение, доверие, приверженность или взаимность, в процесс рекомендации. Это ограничение особенно заметно в профессиональном футболе, где развиваются отношения между болельщиками и клубами, и где различные реляционные измерения доминируют в различных поведенческих результатах (например, первая покупка против повторной посещаемости)12,13,14,15.
Чтобы устранить этот пробел, мы предлагаем MLP-PA (Multi-Layer Perceptron with Pyramid Attention) — рекомендательные рамки, ориентированные на отношения, адаптированные к сценарию Китайской Суперлиги (CSL). Опираясь на архитектуру нейронной совместной фильтрации (NCF) с основой многоуровневого перцептрона (MLP), предлагаемая модель рассматривает удовлетворение, доверие, приверженность и взаимность как первоклассные реляционные признаки и внедряет их в априорный канал, основанный на внимании. Модуль внимания пирамидальных признаков затем используется для позднего слияния, чтобы селективно усилить заметные паттерны взаимодействия на нескольких масштабах при интеграции веерных, элементных и контекстных представлений. Явно моделируя переменные отношений вместе с нелинейными характеристиками взаимодействия, MLP-PA стремится повысить как точность предсказания, так и интерпретируемость в спортивных рекомендациях.
Эмпирическая оценка на самостоятельно созданном наборе данных CSL показывает, что предлагаемый подход стабильно превосходит классические базовые показатели, включая UserCF, ItemCF и MF-BPR, по показателям рейтинга Top-N. Дальнейший анализ вариантов моделей показывает, что включение внимания, осознанного к взаимоотношениям, помогает снизить разреженность длинного хвоста и контекстуальную гетерогенность. Результаты также выявляют дифференцированные роли реляционных факторов. Приверженность и взаимность чаще связаны с повторяющимися и высокововлечёнными поведением, тогда как удовлетворенность и доверие в первую очередь поддерживают реакции как впервые, так и краткосрочные раз.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Протокол
В данном исследовании используются неидентифицированные журналы взаимодействия фанат-элемент и анонимизированные данные анкеты, собранные исключительно для исследовательских целей. Никакая личная информация не была доступна, сохранена или обработана. Согласно институциональным и национальным рекомендациям, для этого исследования не требовалось официального одобрения этического комитета или индивидуального информированного согласия.
Подготовка набора данных и экспериментальная процедура
Шаг 1. Подготовка и предобработка данных
Подготовка наборов данных и экспериментальные процедуры были разработаны для преобразования необработанных поведенческих журналов и ответов опросов в единый, воспроизводимый экспериментальный набор данных, подходящий для обучения и оценки моделей. Процесс сосредоточен на очистке данных, анонимизации, построении признаков, нормализации и выравнивании записей взаимодействий с переменными, связанными с отношениями. Сначала были проверены необработанные журналы взаимодействия для удаления неполных записей и дублированных событий с целью обеспечения согласованности данных. Идентификаторы фанатов и идентификаторы предметов затем анонимизировались с помощью хэширования для защиты конфиденциальности пользователей. Различные формы взаимодействия, включая просмотр, клики, покупку и валидацию посещаемости, были сопоставлены с неявными сигналами обратной связи, при этом каждое наблюдаемое взаимодействие рассматривалось как положительный пример. Переменные, связанные с отношениями — удовлетворённость, доверие, приверженность и взаимность — были собраны из ответов анкеты и связаны с соответствующими идентификаторами фанатов. Недостающие значения анкеты были устранены с помощью импутации среднего внутри того же уровня членства для сохранения характеристик на уровне группы. Непрерывные признаки нормализовались с помощью минимально-максимального масштабирования до диапазона [0, 1], чтобы обеспечить сопоставимость между переменными. После предварительной обработки финальный набор данных хранился в структурированных файлах, включающих анонимные идентификаторы вентиляторов, идентификаторы элементов, временные метки, контекстные теги и нормализованные переменные отношений, которые затем использовались последовательно во всех экспериментальных настройках.
Ожидаемый результат:
В результате этого процесса выходы включают очищенную таблицу взаимодействия, нормализованную таблицу переменных отношений, выровнённую с идентификаторами вентиляторов, и статистическое сводное сводка, описывающее количество вентиляторов, элементов и взаимодействий в итоговом наборе данных.
Шаг 2. Сплит по обучению/валидации/тестированию и отрицательный отбор проб
Данные разделяются хронологически на уровне пользователя, чтобы избежать утечки информации. Для каждого вентилятора последнее взаимодействие предназначено для тестирования, второе — для валидации, а остальные — для тренировки. Отрицательные образцы генерируются путем равномерного отбора невзаимодействующих элементов из набора элементов. Для каждого положительного взаимодействия во время тренировки берётся фиксированное количество отрицательных образцов (отрицательное соотношение выборки = 1:5). Одна и та же конструкция кандидатов применяется последовательно во всех моделях.
Ожидаемый результат:
В результате этого этапа выходные данные включают хронологически разделенные наборы данных по обучению, валидации и тестированию, а также заранее сгенерированные списки отрицательных выборок, составленные в соответствии с указанным коэффициентом выборки.
Шаг 3. Программная среда и реализация
Все эксперименты реализованы на Python. Обучение и оценка модели проводятся с использованием PyTorch (версия ≥ 1.12). Оптимизация баесовских гиперпараметров выполняется с помощью Optuna (версия ≥ 3.0). Обучающие скрипты выполняются на рабочей станции с одной видеокартой NVIDIA (≥ 8 ГБ памяти). Конфигурационные файлы указывают пути наборов данных, параметры модели и настройки оптимизации для обеспечения воспроизводимости.
Шаг 4. Построение модели и спецификация параметров
Модель MLP-PA состоит из слоя вложения, многослойного основного перцептрона, канала взаимосвязи-внимание и модуля слияния внимания с пирамидой. Ключевые параметры задаются следующим образом: размерность вложения = 32; MLP скрытые слои = [64, 32]; функция активации = ReLU; оптимизатор = Адам с скоростью обучения 0,001 и затуханием веса 1e-5. Модуль внимания пирамиды использует три шкалы пула с размерами ядра {1, 2, 4} и шагом, равным размеру ядра. Коэффициент снижения внимания установлен на 4. Для предотвращения перенагона применяется дроп с коэффициентом 0.3. Раннее прекращение срабатывает, если валидационный NDCG@10 не улучшается в течение 10 последовательных эпох.
Шаг 5. Обучение и оптимизация гиперпараметров
Модель обучается с использованием попарного потерь по байесовскому персонализированному ранжированию (BPR). Во время обучения результаты валидации отслеживаются в конце каждой эпохи. Поиск с помощью байесовской гиперпараметрической оптимизации по скорости обучения, размеру вложения, частоте выпадения, отрицательному коэффициенту выборки и параметрам, связанным с вниманием. Цель оптимизации — валидация NDCG@10. Каждая кандидатская конфигурация обучается с ранней остановкой для снижения вычислительных затрат.
Ожидаемый результат:
В результате этого процесса выходные данные включают обученные контрольные точки модели, журналы производительности валидации и оптимальную конфигурацию гиперпараметров, выявленную с помощью байесовской оптимизации.
Шаг 6. Оценка и генерация результатов
После обучения на тестовом наборе оценивается наиболее эффективная модель (на основе валидационных NDCG@10). Для каждого вентилятора формируются списки лучших рекомендаций, а производительность измеряется с помощью HR@K и NDCG@K. Дополнительные анализы, включая абляционные исследования и фазово-обусловленное профилирование внимания, проводятся по тому же протоколу оценки для обеспечения сопоставимости.
Критерии завершения
Протокол считается завершённым при получении следующих результатов: 1) полностью обученная модель MLP-PA с оптимизированными гиперпараметрами; 2) Результаты тестового набора HR@K и NDCG@K для всех базовых и абляционных моделей; 3) Сохранённые контрольные точки модели, метрики оценки и воспроизводимые конфигурационные файлы. Эти выходы вместе обеспечивают независимое воспроизведение предлагаемого протокола рекомендательной системы.
Теория маркетинга на основе отношений обязательства и доверия
Теория обязательств и доверие определяет приверженность и доверие как ключевые факторы, определяющие качество отношений. Снижая транзакционную неопределённость и способствуя долгосрочной ориентации и намерению сотрудничества, эти факторы способствуют реляционной непрерывности и созданию ценности16. Доверие отражает веру болельщиков в компетентность, честность и доброжелательность клуба, что снижает воспринимаемый риск и информационную асимметрию. В результате более высокий уровень доверия способствует взаимодействию с персонализированными рекомендациями, авторизацией данных и процессами оплаты, поддерживая поведение на ранних стадиях и низкого уровня обязательств вдоль воронки click-to-shop. Обязательства, напротив, отражает готовность фанатов вкладывать время, финансовые ресурсы и эмоциональную привязанность, чтобы поддерживать отношения, несмотря на конкурирующие альтернативы или временноенедовольство 17. Поскольку приверженность тесно связана с согласованием идентичности, потраченными затратами и целенаправленными инвестициями, она обеспечивает более стабильную объяснительную силу для поведения с высокими затратами и высокой вовлечённостью, таких как повторные покупки, продление членства, посещаемость стадионов и сарафанное радио18.
Исходя из этих различий, мы выводим следующие гипотезы.
H1 (Доверие → поддерживающее поведение): Высокое доверие снижает трения при принятии решений и воспринимаемый риск, тем самым увеличивая вероятность поверхностного поведения, такого как клики, добавление в корзину и покупки с первого раза.
H2 (Относительное преимущество обязательств): Из четырёх измерений отношений обязательство обладает самой сильной предельной объяснительной силой для высоких затрат и долгосрочных поведений, включая повторные покупки, продление и офлайн-посещаемость, а его вклад в прогнозную эффективность превышает удовлетворённость и доверие.
Теория социального обмена
Теория социального обмена подчеркивает, что индивиды следуют нормам взаимности и справедливости при повторяющихсявзаимодействиях 19. Воспринимаемая взаимность означает, что болельщики чувствуют, что клуб взаимодействует с ценностными уступками, эмоциональными реакциями и распределением ресурсов. Когда взаимность воспринимается как подлинная и устойчивая, фанаты с большей вероятностью отвечают взаимностью через потребление и посещаемость, формируя положительную обратнуюсвязь 20. Удовлетворенность зависит от накопленного опыта относительно ожиданий. Через механизм ожидания и подтверждения он способствует краткосрочному соблюдению и положительному сарафанному радио, а также создаёт благодатную почву для развития доверия и обязательств21.
Соответственно, мы выводим:
H3 (Удовлетворение → поддерживающее поведение): Большее удовлетворение снижает сожаление и увеличивает оперативную реакцию, способствуя краткосрочным покупкам и участию.
H4 (Взаимность → конверсия и выкуп): В рамках повторной игры сигналы взаимности усиливают интенсивность обмена «Я получаю выгоду → отдаю обратно», значительно повышая коэффициенты конверсии и выкупа — особенно в ценочувствительных или дефицитных ситуациях.
Синтезируя обе теории, четыре измерения демонстрируют явную контекстуальную гетерогенность в своих путях влияния:
В условиях неопределённости или высокого воспринимаемого риска — новые продукты, динамическое ценообразование, авторизация/оплата с высокими ставками — доверие оказывает более сильное предельное влияние (поддерживает H1).
В долгосрочных/связанных с идентичностью условиях — сезонные абонементы, подряд домашние игры, продление членства — доминирует обязательство (поддерживает H2).
На основных узлах совпадения или при стимулах/дефиците — ограниченных льготах, повышениях — взаимность более сильно повышает конверсию и выкуп (поддерживает H4).
Удовлетворенность служит «базовой почвой», положительно влияя на краткосрочные поступки практически во всех контекстах (поддерживая H3) и косвенно укрепляя доверие и приверженность за счёт повышения качества опыта. Вместо того чтобы проверять эти гипотезы с помощью структурного моделирования уравнений, мы вводим четыре измерения в слой внимания, позволяя модели изучать контекстуализированные веса и подтверждать механизмы с помощью экспериментов с абляцией.
MLP
Многослойный перцептрон (MLP) служит основным учеником представления в нашем фреймворке.
(1) Слой ввода-отображения.
Исходный вектор признаков один раз линейно расширяется с помощью матрицы 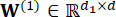 весов и смещения b(1), что даёт
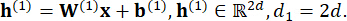 (1)
(2) Глубокий нелинейный слой.
Мы накладываем линейные, активационные и нормализационные слои. Линейное отображение использует полностью связное аффинное преобразование:
z = Wx + b, (2)
Где 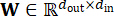 — матрица весов,
 — вектор смещения, x — выход предыдущего слоя, а z — линейный выход. Чтобы соответствовать характеристикам активации ReLU и поддерживать стабильные градиенты во время тренировки, мы применяем инициализацию He для W:
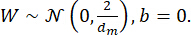 (3)
Функция активации — ReLU, что особенно подходит для глубоких архитектур22. При x>0 производная ReLU является константой, что эффективно облегчает проблему нулевого градиента, связанную с активацией сигмовидных элементов, и тем самым ускоряет обратное распространение исходимость 23. ReLU также вычислителен прост (без экспонентий) и естественно разрежён (выдает ноль для x<0), что снижает избыточные нейронные реакции и улучшает обобщение. Его определение —24
σ(x) = max(0,x), (4)
Применяя по элементам к линейному выходу, получаем:
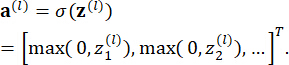 (5)
После каждой операции «линейной → активации» мы вводим пакетную нормализацию (BN) для стабилизации градиентов и ускорения сходимости. BN динамически стандартизирует особенности внутри каждой мини-партии, снижая внутренние сдвиги ковариатов, повышая стабильность обучения и снижая чувствительность к скорости обучения. BN также обладает лёгким эффектом регуляризации, похожим на шум впрыскивания, что помогает предотвратить перенагон, не снижая емкость модели.
Пусть текущий мини-пакетный выход будет 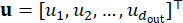 , BN-преобразование для j-го признака выглядит
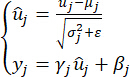 (6)
Где μj и σj2 — это пакетное среднее и дисперсия j-го признака, ε — малая константа для численной устойчивости, а γj, βj — обучаемые параметры масштаба и сдвигов, восстанавливающие нелинейную выразительность сети.
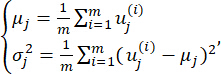 (7)
Здесь m — размер мини-пакета, ε — небольшая константа для численной устойчивости, а γj β j — изучаемые параметры масштаба/сдвиса, используемые для восстановления нелинейной выразительной способности сети после нормализации.
(3) Слой сжатия признаков
После глубокого извлечения признаков мы добавляем слой сжатия признаков в конце блока MLP, чтобы сохранять важную информацию, подавляя избыточность, снижать вычислительную нагрузку на последующие модули и обеспечивать слабую регуляризацию. Пусть входной вектор будет  . Сжатый выход равен
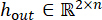 , с параметрами
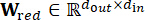 ,
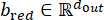 . Операция выглядит следующим образом:
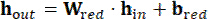 (8)
Механизм пирамидального внимания (PA)
Пусть последний выход слоя MLP будет  . Чтобы обеспечить явный отбор на нелинейных взаимодействиях высшего порядка, сначала мы перестраиваем
 по полю/каналу вматрицу 25:

 (9)
где C — количество каналов, а L — длина на канал.
(1) Многомасштабное построение элементов.
Вдоль оси признаков L примените 1D-пулирование с несколькими масштабами, чтобы получить26
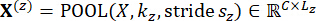 (10)
где ks и stride определяют s-ту шкалу.
(2) Канализировать внимание по шкале.
Для каждой шкалы постройте дескриптор канала, и вниманиевесит 27:
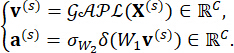 (11)
Где δ(⋅) — ReLU, σ(⋅) — сигмоид,
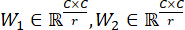 , r — коэффициент редукции.
Применяйте веса по каналам:
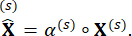 (12)
(3) Слияние и запись обратно.
Проектируйте каждую масштаб с GAPL в единое 1D-пространство и объединяйте их:
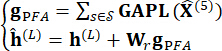 (13)
где P — это веса слияния, а Wr — обучаемая проекция, используемая в остаточном записе.
Итоговые очки:
 (14)
Где ⊙ обозначает произведение Адамара (по элементам) и  — векторную конкатенацию.
Формализация задачи на верхнем уровне и цель обучения
(1) Постановка проблем.
Пусть фан-сет будет F, а набор предметов I (билеты, мерч, бонусы членства и контент). Неявная обратная связь  указывает, взаимодействовал ли фанат
 с товаром
 (клик, покупка, посещаемость/валидация и т.д.). Положительные образцы в обучающем наборе следующие:
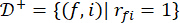 ,
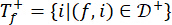 .
Мы вводим четыре переменных маркетинга отношений — удовлетворённость, доверие, приверженность, взаимность — как вектор: 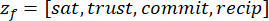 в уровень внимания, чтобы получить контекстно-ориентированное представление
 отношений , которое объединяется с вложениями
 фаната/предмета для получения оценки
 . Для каждой положительной пары
 мы выводим несколько отрицательных в фиксированном соотношении из
 в образ
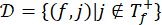 .
(2) Парная цель.
Для прямой оптимизации относительного ранжирования мы используем BPR (Bayesian Personalized Ranking) loss28:
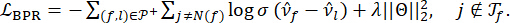 (15)
Здесь 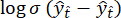 выражается вероятность того, что «положительный балл превышает отрицательный»;
 является L2 регуляризатором для контроля перенагона;
 обозначает все изучаемые параметры.
(3) Вывод и ранжирование.
Во время тестирования кандидат-множество — это 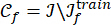 . Вычисляем оценки , и возвращаем списокTop-N 29:
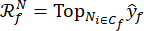 (16)
Проектирование рекомендательных алгоритмов
В этом разделе описывается полный рабочий процесс рекомендаций, использованный в этом исследовании, охватывающий сквозной конвейер — от предварительной обработки данных до обучения моделям и онлайн-вывода. Рабочий процесс объясняет, как сырые данные о взаимодействии фанат-элемент и переменные взаимоотношений преобразуются в персонализированные рейтинговые показатели посредством обучения представлению и моделирования на основе внимания. Подробная процедура изложена следующим образом.
Шаг 1: Подготовка и нормализация данных.
Логи взаимодействия вентилятора и элемента CSL преобразуются в неявные сигналы обратной связи. Отсутствующие значения обрабатываются, и четыре переменные отношений — удовлетворение, доверие, приверженность и взаимность — нормализуются. Данные разбиваются хронологически на наборы для обучения, валидации и тестирования, при этом для каждого положительного взаимодействия генерируется несколько отрицательных выборок.
Шаг 2: Кодирование отношений-внимания.
Четыре переменные отношений вводятся в модуль внимания для изучения контекстно-ориентированных весов важности, что приводит к компактному представлению веерных отношений для моделирования последующих этапов.
Шаг 3: Конструкция взаимодействия входов.
Вложения вентиляторов и предметов изучаются и объединяются с представлением отношений, формируя полный вектор признаков для каждого взаимодействия фан-элемент.
Шаг 4: Обучение репрезентации.
Признаки взаимодействия проходят через ветвь MLP для захвата нелинейных паттернов высокого порядка и генерации слитого латентного представления.
Шаг 5: Внимание к признакам пирамиды.
Многомасштабная пирамида объектов строится поверх выходных данных MLP. Применяется внимание по каналам и межмасштабное слияние, а улучшенные функции интегрируются через остаточные соединения для усиления выделенных каналов при подавлении избыточных.
Шаг 6: Оценка и результаты.
Линейная ветвь конкатенируется с улучшенным нелинейным представлением и подаётся в выходной слой для вычисления оценки предпочтений для каждой пары фан-элемент.
Шаг 7: Обучение и оптимизация.
Модель оптимизирована с помощью парной цели ранжирования. Адаптивный оптимизатор используется вместе с снижением веса, выпадением и ранней остановкой для улучшения обобщения и снижения перенагона.
Шаг 8: Байесовская гиперпараметрическая оптимизация.
Показатели валидационного ранжирования используются как цель для автоматического поиска ключевых гиперпараметров, включая размеры вложения, глубину и ширину сети, скорость обучения, отрицательный коэффициент выборки, частоту отсеваний, а также параметры, связанные с пирамидой и вниманием.
Шаг 9: Вывод и ранжирование.
Во время онлайн-вывода для каждого фаната рассчитываются баллы предпочтений по набору кандидатов для генерации рекомендаций Top-N, с необязательными стратегиями пост-ранжирования для учёта новизны, разнообразия и бизнес-ограничений.
Экспериментальная валидация
Набор данных и схема признаков
Мы оцениваем данные на собственном наборе данных, который объединяет (с помощью хешированных фанатских идентификаторов) деидентифицированные логи клубных информационных систем CSL о неявных взаимодействиях фанат-предмет с опросом одновременных отношений. Данные охватывают четыре бизнес-направления — билеты, мерч, членство и контент — и включают просматривание, клики, добавление в корзину/избранное, покупку/продажу билетов, а также мероприятия по валидации на стадионе, с временными метками, каналом контакта, контекстными тегами и промо-флагами. Продолжительность — ≥ один полный сезон; Масштаб примерно соответствует фанатам, предметам и событиям, достаточным для глубокого моделирования.
Схема признаков и кодировки: Items-ItemID, ItemType, TeamTag, PriceBand (вложения ID/категории); Фанаты — FanID, регион, уровень членства, срок работы (FanID изучается как вложение; другие категорические/числовые поля стандартизированы); Особенности RQ — Удовлетворение, Доверие, Обязательство, Взаимность масштабировано до [0,1] и подано в канал Внимание, затем объединяется с представлениями MLP через PA; Контекст — PhaseTag, Channel, PromoFlag, Hour, Weekday (категории как вложения; признаки времени с синусоидальным кодированием sin/cos).
Оптимизация гиперпараметров
Ключевые гиперпараметры MLP-PA настраиваются с помощью байесовской оптимизации в заранее заданном пространстве поиска, используя NDCG@10 на валидационном наборе в качестве основной цели (с HR@10 в качестве ссылки) и ранняя остановка для снижения перенагона. Каждая кандидатская конфигурация запускается под несколькими случайными сидами и усредняется. Окончательные развернутые настройки указаны в Таблице 1.
| Гиперпараметр | Описание | Диапазон поиска | Избранная стоимость |
| Размерность вложения | Размер вложения вентилятора/предмета | {32, 64, 128} | 64 |
| Скрытые слои MLP | Количество слоёв MLP | {2, 3, 4} | 3 |
| Скрытые юниты MLP | Единицы на скрытый слой | {64, 128, 256} | 128 |
| Процент отсева | Вероятность выбывания | [0.1, 0.5] | 0.3 |
| Скорость обучения | Начальная скорость обучения | [1e-4, 1e-2] | 1.00E-03 |
| Отрицательное отношение дискретизации | Отрицательные результаты на положительную выборку | {1, 3, 5, 10} | 5 |
Таблица 1: Окончательные настройки гиперпараметров модели MLP-PA
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Результаты
Сходимость и стабильность
Для оценки поведения сходимости и устойчивости обучения предлагаемой модели мы сравниваем её валидационную эффективность со стандартным рекомендатором на основе MLP без пирамидального внимания к признакам или взаимоотношения, который служит контрольной моделью. Все модели обучаются по одинаковым разделениям данных, настройкам оптимизации и критериям остановки для обеспечения справедливого сравнения.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Обсуждение
Концептуальные и методологические вклады
Это исследование концептуально вносит вклад, переосмысливая измерения отношений — удовлетворение, доверие, приверженность и взаимность — не как статические вспомогательные черты, а как контекстно-зависимые реляционные сигналы, влияние которых варьируется на разных этапах вовлечения. Предлагаемая структура реализует эту идею через механизм, основанный на внимании, который динамически перевзвешивает реляц...
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Раскрытие информации
У автора нет конфликта интересов, которые нужно заявлять.
Благодарности
Автор выражает благодарность анонимным рецензентам за их конструктивные комментарии и предложения, которые помогли повысить ясность и качество этой рукописи. Он также признает поддержку сотрудничающей организации в обеспечении доступа к данным, использованным в этом исследовании. Любые мнения, выводы и выводы, выраженные в этой статье, принадлежат автору и не обязательно отражают взгляды аффилированных организаций.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Материалы
| Имя | Компания | Каталожный номер | Комментарии |
|---|---|---|---|
| Python | https://www.python.org | 3.9.10 | |
| Deep learning framework | PyTorch | https://pytorch.org | >= 1.12 |
| Hyperparameter optimization library | Optuna | https://optuna.org | >= 3.0 |
| Hardware | NVIDIA GPU | https://www.nvidia.com | Один GPU, >= 8 ГБ памяти |
| Dataset | Созданный самостоятельно датасет CSL фанатов | N/A | Одна полная сезона или дольше; достаточный масштаб для глубокого моделирования |
| Interaction data | Логи неявных взаимодействий фанат-предмет | N/A | Не версионируется отдельно |
| Survey data | Данные опроса по отношениям | N/A | Не версионируется отдельно |
| Data preprocessing method | Анонимизация на основе хэша | N/A | Применяется к идентификаторам фанатов и предметов |
| Data preprocessing method | Среднее заполнение в пределах уровня членства | N/A | Применяется к пропущенным ответам в опроснике |
| Data preprocessing method | Нормализация минимум-максимум | N/A | Диапазон [0, 1] |
| Data splitting strategy | Хронологическое разделение на уровне пользователя | N/A | Самое свежее = тест; второе по свежести = валидация; оставшееся = обучение |
| Negative sampling | Равномерное отрицательное выборки | N/A | Соотношение положительное:отрицательное = 1:5 |
| Model backbone | MLP (Многослойный перцептрон) | https://pytorch.org/docs/stable/nn.html | Скрытые слои [128, 64, 32] (оптимизировано) |
| Attention module | Канал внимания к отношениям | N/A | Настраиваемый модуль |
| Fusion module | Пирамидальная атакция (PA) | N/A | Масштабы пулинга {1, 2, 4}, шаговая величина = размер ядра, соотношение сокращения = 4 |
| Optimizer | Adam | https://pytorch.org/docs/stable/generated/torch.optim.Adam.html | Скорость обучения 0.001, весовой распад 1e-5 |
| Regularization | Dropout | https://pytorch.org/docs/stable/generated/torch.nn.Dropout.html | Скорость 0.3 |
Ссылки
- Wang, L., et al. Drug combination recommendation model for systemic lupus erythematosus and antiphospholipid syndrome. Pharmaceutics. 18 (8), 1224(2025).
- Hu, X., Yuan, Z., Ma, Z. A robot control knowledge recommendation model PKGAT based on multimodal knowledge graph. Int J Softw Eng Knowl Eng. 35 (8), (2025).
- Ji, S. An intelligent recommendation model for disclosure of electricity market entities based on association rule mining algorithm. Electr Eng. , In press (2025).
- Xie, F., et al. Differential weighting and flexible residual GCN-based contrastive learning for recommendation. Symmetry. 17 (8), 1320(2025).
- Duan, J., et al. A deep recommendation model based on semantic information and correlation between items. J Intell Inf Syst. , In press (2025).
- Malakhatka, E., et al. Optimal time recommendation model for home appliances: HSB Living Lab dishwasher study. Energy Effic. 18 (1), 3(2024).
- Yuan, Q., Cong, G., Ma, Z., Sun, A., Magnenat-Thalmann, N. Time-aware point-of-interest recommendation. Proc Int ACM SIGIR Conf Res Dev Inf Retr, 36, 363-372 (2013).
- Alaoui, E. D., et al. Comparative study of filtering methods for scientific research article recommendations. Big Data Cogn Comput. 8 (12), 190(2024).
- Li, X., Hu, G. Design and implementation of an electronic journal resource recommendation system integrating user profile and knowledge graph. Front Comput Intell Syst. 10 (2), 74-78 (2024).
- Sami, A., et al. A deep learning-based hybrid recommendation model for internet users. Sci Rep. 14 (1), 29390(2024).
- Zhonghua, W. Intelligent recommendation model of tourist places based on collaborative filtering and user preferences. Appl Artif Intell. 37 (1), (2023).
- Wang, Q., Esquivel, A. J. Personalized movie recommendation system based on DDPG: Application and analysis of reinforcement learning in user preferences. Front Soc Sci Technol. 5 (18), (2023).
- Miao, L., et al. Study on two-tier EV charging station recommendation strategy under multi-factor influence. J Artif Intell. 5, 181-193 (2023).
- Yunni, X., et al. A quasi-Newton matrix factorization-based model for recommendation. Int J Web Serv Res. 20 (1), 1-15 (2023).
- Mourad, J., et al. Personalized PV system recommendation for enhanced solar energy harvesting using deep learning and collaborative filtering. Sustain Energy Technol Assess. 60, 103456(2023).
- Pfajfar, G., et al. Value of corporate social responsibility for multiple stakeholders and social impact: A relationship marketing perspective. J Bus Res. 143, 46-61 (2022).
- Khan, R. U., et al. The impact of customer relationship management and company reputation on customer loyalty: The mediating role of customer satisfaction. J Relatsh Mark. 21 (1), 1-26 (2022).
- Sheth, J. New areas of research in marketing strategy, consumer behavior, and marketing analytics: The future is bright. J Mark Theory Pract. 29 (1), 3-12 (2021).
- Mishra, M., Mund, P. Fifty-two years of consumer research based on social exchange theory: A review and research agenda using topic modeling. Int J Consum Stud. 48 (4), e13074(2024).
- Cook, K. S., Hahn, M. Social exchange theory: Current status and future directions. Theor Sociol. 50, 179-205 (2021).
- Naseer, A., Jalal, A. Multimodal objects categorization by fusing GMM and multilayer perceptron. Proc 5th Int Conf Adv Comput Sci (ICACS), , 1-7 (2024).
- Hussain, K., et al. Analyzing LULC transformations using remote sensing data: Insights from a multilayer perceptron neural network approach. Ann GIS. 30, 1-28 (2024).
- Mfetoum, I. M., et al. A multilayer perceptron neural network approach for optimizing solar irradiance forecasting in Central Africa with meteorological insights. Sci Rep. 14 (1), 3572(2024).
- Yu, Y., et al. Multi-scale spatial pyramid attention mechanism for image recognition: An effective approach. Eng Appl Artif Intell. 133, 108261(2024).
- Liu, H., et al. A deep convolutional neural network for the automatic segmentation of glioblastoma brain tumor: Joint spatial pyramid module and attention mechanism network. Artif Intell Med. 148, 102776(2024).
- Liu, M., et al. Vehicle object counting network based on feature pyramid split attention mechanism. Vis Comput. 40 (2), 663-680 (2024).
- Alvarado, O., et al. A systematic review of interaction design strategies for group recommendation systems. Proc ACM Hum-Comput Interact, 6 (CSCW2), 1-51 (2022).
- Zhao, Y. Design of garment style recommendation system based on interactive genetic algorithm. Comput Intell Neurosci. 2022, 9132165(2022).
- Nazer, L. H., et al. Bias in artificial intelligence algorithms and recommendations for mitigation. PLOS Digit Health. 2 (6), e0000278(2023).
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.