Текущее исследование описывает рабочий процесс секвенирования нанопор плазмид, когда хромосомная последовательность уже известна или не представляет интереса. Начальный этап обогащения плазмидной ДНК обеспечивает оптимальную глубину последовательности плазмиды и максимизирует количество образцов, которые можно секвенировать в каждой ячейке потока.
Методическая статья
Секвенирование и сборка плазмид с длинным чтением с использованием рабочих процессов на основе секвенирования нанопор
* These authors contributed equally
В этой статье
Краткое содержание
Аннотация
В данном исследовании описывается рабочий процесс секвенирования нанопор, направленный на максимизацию выхода плазмидной ДНК и точность секвенирования. Исследователи охватывают каждый этап процесса, который включает экстракцию плазмидной ДНК, подготовку библиотеки с быстрым штрих-кодированием и связыванием адаптеров, загрузку библиотеки на потоковую ячейку для секвенирования, вызов баз (в реальном времени или пост-хок) и сборку последовательностей с помощью Autocycler. Авторы также указывают требования к компьютеру, которые во многом зависят от того, осуществляется ли базовый вызов в реальном времени. Авторы секвенировали плазмиды, очищенные из десяти клинических штаммов, используя этот рабочий процесс. Чтобы исключить различия между штаммами хозяина и клетки как переменные, авторы также конъюгировали эти клинические штаммы с общим реципиентным штаммом и секвенировали трансконъюганты. В этих экспериментах были получены плазмидные сборки, соответствующие размерам плазмид, выведенным по мобильности геля, и которые в 2/3 случаев также совпадают с короткочитаемыми полированными сборками или находятся в пределах 0,05% парной последовательности. Обогащение последовательностей плазмидной ДНК также максимизирует эффективность секвенирования плазмид, позволяя параллельно секвенировать до 24 образцов с оптимальным покрытием. Этот протокол подходит для плазмид объёмом от 4 до 174 кб и переносит до 72% хромосомного загрязнения без снижения точности. Этот протокол идеален для ситуаций, когда хромосомная последовательность уже известна или не представляет интереса, например, для проверки последовательностей плазмид, повышения точности уже полученных последовательностей плазмид, полученных WGS, или секвенирования плазмид, захваченных с помощью сопряжения. Для иллюстрации этой работы используется организм Escherichia coli, который является представителем хозяев, используемых для экспрессии рекомбинантных генов и захвата плазмид через конъюгацію.
Введение
Плазмиды — это самовоспроизводящиеся фрагменты ДНК, повсеместно встречающиеся в бактериях. Их размер сильно варьируется — от <800 п.п. до 2,5 Мбит/п, и обычно имеют бимодальное распределение: меньший пик соответствует мультикопийным, неконъюгативным плазмидам, а больший пик — низкоскопируемым, часто конъюгативнымплазмидам 1,2. Плазмиды играют ключевую роль в микробной экологии, неся гены, которые помогают их хозяевам адаптироваться к экологическим вызовам или получать доступ к новым экологическим нишам. Плазмиды также служат платформами для ускоренной эволюции, обеспечивая повышенную генетическую пластичность и опосредуя горизонтальный перенос генов между штамами, видами, родами и дажесемействами 3,4. Сетевые и сравнительные геномные анализы подтвердили роль экологического резистома как постоянного резервуара клинически значимых генов резистентности к антибиотикам (ARG), тем самым облегчая их поддержание и распространение вэкологических условиях 5. Отслеживание плазмид и их груза генов устойчивости к антибиотикам и вирулентности помогает выявлять путипередачи 6. Поэтому идентификация и характеристика плазмид представляют большой интерес для различных областей общественного здравоохранения, клинической микробиологии и биотехнологических применений.
Внедрение технологий секвенирования следующего поколения (NGS), которые позволяют проводить высокопроизводительное секвенирование неизвестных шаблонов ДНК, открыло дверь к геномной характеристике микробных изолятов. Секвенирование целого генома (WGS) позволяет отслеживать появление, распространение и передачу новых патогенов, лекарственно-устойчивых штаммов и вариантов, избегающих вакцин. Он также всё чаще используется для выявления путей передачи во время клинических вспышек, что потенциально может помочь в планах будущей профилактикивспышек 7. Наконец, WGS позволяет профилировать ARG, что может принимать терапевтическиерешения 8, хотя связывание ARG с качественными и количественными фенотипами устойчивости к антибиотикам всё ещё находитсяв процессе 9.
Однако данные секвенирования с коротким чтением (SR), обычно получаемые WGS в масштабе, обычно находятся в диапазоне 400–500 п.п. Этот размер меньше большинства мобильных генетических элементов (MGE) и поэтому не может ихразрешить 10. Идентификация in silico последовательностей плазмид в данных WGS дополнительно осложняется неполным покрытием и общими последовательностями между плазмидами, а также между бактериальными хромосомами и другимиплазмидами 10. В результате сборки часто сильно фрагментированы и неполны, из-за чего их субгеномное расположение (хромосомное или плазмидное) невозможно определить10.
Технология секвенирования длинного чтения (LR) создаёт высоко смежные сборки, охватывающие больше повторов, что значительно облегчает получение полных плазмидных сборок. По сути, существует два типа технологий с длинным чтением и одной молекулы:11, 12. Один из таких подходов — секвенирование нанопор — становится популярным в микробной геномике благодаря низкой стоимости, быстрой готовности и пригодности для ограниченных ресурсов сред13,14.
Устройства для секвенирования нанопор используют потоковые клетки, содержащие массивы из тысяч нанопор. ДНК загружается в потоковую ячейку, открывается моторным белком с геликазной активностью и проходит через нанопору, приводимую в движение дифференциал тока. Когда нуклеотиды в одной цепи проходят через отдельные нанопоры, ток нарушается, создавая характерный сигнал, измеряемый электронным датчиком, подключённым к каждой поре. Этот сигнал декодируется с помощью алгоритмов вызова баз, а полученные данные собираются и анализируются дальше с помощью различных биоинформатических инструментов.
По сравнению с методами SR-секвенирования, секвенирование нанопор обычно приводит к более низкому качеству чтения (низкие Q-баллы) и генерирует вставки/делеции в последовательности гомополимеров при анализе данных электрических сигналов (basecalling)15. Также отмечено, что близкая метилирование в нативной ДНК может вызывать систематические ошибки вызова баз16. Широко распространённым решением стало включение коротких данных для коррекции ошибок после сборки. Однако этот процесс (известный как «полировка») увеличивает затраты и сложность17. Увеличение покрытия секвенирования также может повысить точность, но это не всегда технически достижимо.
В 2024 году было показано, что оксфордское нанопорное секвенирование (ONT) R10.4.1 потоковые клетки и химия V14 дают высококачественные и смежные сборки для G-бактерий, тогда как более тонкие анализы на уровнях однонуклеотида всё ещё выигрывают от данных SR-секвенирования18. Однако разрыв между точностью секвенирования LR и SR постепенно сокращается. Среди недавних усовершенствований — более точный процесс отбора проб данных с повышенной скоростью секвенирования, внедрение нового базового вызова, адаптированного для нативной бактериальной ДНК и метилирования, что позволило повысить точность базовыхвызовов 19, а также обновлённые инструменты анализа, такие как новые алгоритмы фазирования, вызова вариантов и звёздных аллелей. Также обратите внимание, что последний алгоритм Dorado V.0.9.0 ONT (2025) может использоваться для вызова перебазы сырых завиточных данных. Действительно, некоторые исследования WGS уже сообщают о формировании микробных геномов с помощью нанопорного секвенирования качества, для которого, как ожидается, короткое чтение не приведёт к значительному улучшению консенсуснойпоследовательности 20,21.
Плазмиды часто содержат основную часть генов приобретённой устойчивости, особенно в изолятах Enterobacteriaceae22. Таким образом, разрешение плазмидных последовательностей позволяет контекстуализировать гены AR, что является ключевым для отслеживания передачи AMR23,24. Секвенирование нанопор уже использовалось для изучения микроэволюции бла-KPC, содержащихплазмиды 25. Устройства MinION также использовались для настольного секвенирования плазмид в реальном времени и обнаружения генов резистентности в клинических изолятах вбольничных условиях 26. Тем не менее, допрос плазмид пока не является частью рутинной практики контроля инфекций.
Несмотря на значительное улучшение LR-секвенирования по сравнению с SR-секвенированием в способности спасать плазмиды изгеномной последовательности 27, некоторые проблемы остаются. Сборщики с длинным чтением, такие как Flye28,Canu 29 и Raven30 , создают хромосомные сборки высокого качества, но испытывают трудности с сборкой плазмидных последовательностей. Частично это связано с недостаточной глубиной покрытия, поскольку плазмидная ДНК недостаточно представлена в данных секвенированияWGS 31. Обратите внимание, что из-за их модульной структуры, большого количества вторичных структур и частого наличия повторов высококачественная сборка для последовательности плазмидной ДНК требует большего покрытия, чем хромосомная ДНК (глубиначтения 50x 32).
Обогащение образцов ДНК плазмидными последовательностями — эффективный способ увеличить глубину покрытия, однако выделение или обогащение плазмидной ДНК до секвенирования ДНК слишком дорого или трудоёмко для клинических диагностических применений и может привести к смещению из-за обогащения выбранных последовательностей. В 2017 году ДНК, обогащённая плазмидами, была использована для попытки полной сборки плазмидной ДНК в клинических образцах с целью обнаруженияARGs 24. Было секвенировано восемь изолятов из шести различных видов Enterobacteriaceae для максимизации разнообразия популяций и структур плазмид. После экспериментов нескольких сборщиков было показано, что Canu/Canu+Pilon явно превосходят другие; Эта исследовательская группа также опробовала метод мета-сборки, который обеспечивал разрешение дополнительных структур плазмид, что привело к полной сборке 78% всех известных плазмид в секвенированных образцах. Однако наличие крупных повторяющихся структур и (в меньшей степени) проблемы с экстракцией ДНК всё ещё создавали значительные трудности для обнаружения всех одноконтинговых плазмидныхсборок 24.
В последнее время адаптивное отбор проб как комплементарный подход к обогащению последовательностей плазмид с низким содержанием был изучен путём отклонения хромосомных последовательностей в образцах бактериальных изолятов, хотя для этого метода требуется известные эталонныепоследовательности 33.
Здесь авторы описывают протоколы секвенирования ONT, которые адаптируются для образцов, обогащённых плазмидной ДНК. Сочетая увеличенное представление плазмидной ДНК с современными протоколами подготовки библиотек, технологией потоковых клеток и инструментами сборки последовательностей, рабочий процесс создавал сборки, соответствующие размерам, выведенным по мобильности геля, и в 2/3 случаев либо совпадали с SR-секвенированием, либо находились в пределах 0,05% парной последовательности. Обогащение последовательностей плазмидной ДНК также максимизирует эффективность секвенирования плазмид, позволяя параллельно секвенировать до 24 образцов с оптимальным покрытием. Протоколы не предназначены для замены стандартных методов нанопорного WGS, а для максимизации точности и эффективности секвенирования плазмид в ситуациях, когда хромосомная последовательность уже известна или не представляет интереса.
Рабочий процесс включает экстракцию плазмидной ДНК, подготовку библиотеки с штрих-кодированием, переходную связку с моторным белком, проверку потоковой ячейки, загрузку библиотеки на ячейку потока для секвенирования, анализ данных электрических сигналов (в реальном времени или пост-хок), сборку последовательностей с помощьюAutocycler 34 и различные последующие анализы (рисунок 1).
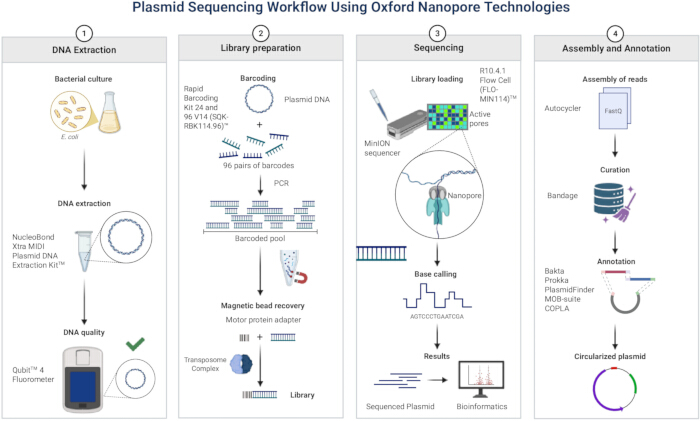
Рисунок 1: Рабочий процесс секвенирования плазмид с использованием Oxford Nanopore Technologies. Шаг 1: Экстракция ДНК; Шаг 2: подготовка к библиотеке; Шаг 3: Секвенирование; Шаг 4: сборка и аннотация. Создано в BioRender. Кортес, Г. (2026) https://BioRender.com/u3b15st. Пожалуйста, нажмите здесь, чтобы увидеть увеличенную версию этой фигуры.
Протокол
1. Экстракция плазмидной ДНК
ПРИМЕЧАНИЕ: Этот протокол использовался для извлечения плазмидной ДНК из клинического штамма Escherichia coli и соответствующих трансконъюгантов с помощью коммерческого набора для экстракции плазмиднойДНК 35. Подробные протоколы спряжения приведены встатье 36. Протокол подходит как для плазмид с высоким и низким уровнем копирования, объёмом от ~3 кб до ~200 кб. Крупные плазмиды требуют особого внимания, так как имеют низкое количество копий (всего 1–2 копии на клетку), что ограничивает выход ДНК. Для компенсации протокол рекомендует увеличить массу клетки и объёмы буферов лизиса и нейтрализации, чтобы обеспечить достаточное количество плазмидной ДНК для связывания столбцов. Плазмиды до 200 кб всё ещё можно восстановить с помощью этого протокола; однако его применимость к мегаплазмидам (>200 КБ) ограничена.
- Плазмидная экстракция
- День 1: Образцы на агарные пластины Лурия–Бертани (LB) с добавлением соответствующего антибиотика для выбора соответствующего маркера резистентности, переносимого плазмидой, и инкубировать при 37 °C в течение 24 часов.
ПРИМЕЧАНИЕ: Добавьте карбенициллин (или соответствующий антибиотик) в LB при конечной концентрации 100 мкг/мл, добавив 1 мкл стандартного раствора 100 мг/мл на мл среды. - День 2: Инокуляция 3–5 мл LB соответствующей антибиотиковой средой с одной изолированной колонией с первого дня. Инкубировать при встряхивании при 37 °C в течение ~8 час, или пока культура не достигнет OD₆₀₀ 1–2.
ПРИМЕЧАНИЕ: ИзмерениеOD 600: Опустите спектрофотометр свежим LB-средой с соответствующим антибиотиком, затем перенесите 1 мл посева в чистую кювету и измерите дозу на 600 нм. Если показания превышают линейный диапазон, разведите образец и измерите заново. - Инокулятируйте 400 мл LB с соответствующей антибиотиковой средой и 400 мкл стартерной культуры второго дня. Инкубировать при встряхивании при 37 °C в течение 8–12 часов, или покаOD 600 не достигнет 1–2 (как было описано ранее).
ПРИМЕЧАНИЕ: Увеличите объём посева выше 400 мл, если доз600 не достигает 1–2 в течение 12 часов. Чтобы снизить риск потери или перестройки плазмиды, максимально ограничить прохождение в культуре и поддерживать отбор антибиотиков на всех этапах роста. Увеличивайте объём культуры только тогда, когда требуется более высокий объём ДНК. - День 3: Переложите культуру в центрифужные бутылки, соответствующие объёму культуры. Центрифугуйте при 4200 x г в течение 10 минут, затем ресуспензируйте пеллет, используя рекомендованные производителем объёмы реагентов по следующей формуле:
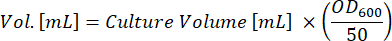
ПРИМЕЧАНИЕ: Пример: Для 400 мл низкоскопированной бактериальной культуры (OD 600 = 2), подлежащей лизированию, соответствующие объёмы буферов лизиса RES, LYS и NEU составляют по 16 мл каждый.
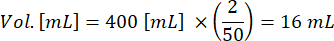
ПРИМЕЧАНИЕ: если объёмы реагентов для ресуспензии, лизиса или нейтрализации неправильно масштабированы с учетом общей биомассы культуры (OD 600 × объём или ODV), лизис может быть неполным, нейтрализацией неэффективным, а образование осадков — чрезмерным. Это может привести к снижению выхода плазмид, снижению чистоты и возможному засорению очистительных колонн. Пропорциональное масштабирование буферных объёмов с использованием формулы производителя (шаг 1.1.4) обеспечивает эффективный лизис, полную нейтрализацию и стабильное восстановление высококачественной плазмидной ДНК. - Проведите лизис клеток, фильтрацию с использованием соответствующего буфера и нейтрализацию по указаниям комплекта.
ПРИМЕЧАНИЕ: Если объём осадка велик, ставьте два фильтра, регулируя буфер пропорционально. Выполните дополнительные этапы центрифуга, если супернатант остаётся непрозрачным. После нейтрализации большой объём осадка может потребовать дополнительных этапов центрифуга. Это характерно для большинства клинических образцов E. coli, возможно, потому что они склонны образовывать биоплёнку вкультуре 37, которая включает секрецию толстойматрицы 38. Чрезмерный осадок в лизате может засорить колонку, продлить время слива и потенциально загрязнить образец белками. Если супернатант чистый, эти дополнительные шаги могут быть не нужны. - Центрифугуйте лизат при 4200 г в течение 30 минут. Перенесите супернатант в новую трубку и снова проведите центрифугу на 30 минут. Если после этих спинов супернатант остаётся непрозрачным (см. рисунок 2), выполните дополнительную центрифугировку при 4200 x g.
ПРИМЕЧАНИЕ: Перенос лисата в пробирку для культуры объемом 50 мл во время центрифугирования может облегчить удаление супернатантного вещества, так как осадок иногда может неправильно пелетировать и застревать у верхней части трубки. Из-за больших объёмов обработки один столбец может насыщаться и не сможет вместить дополнительные образцы. Для увеличения скорости фильтрации или максимизации выхода ДНК лизат можно разделить на две колонны. - Выполните этапы EQU, WASH и ELU согласно инструкциям набора.
- Осадить ДНК с помощью изопропанола.
ПРИМЕЧАНИЕ: Инкубировать при -20 °C в течение ~10 минут, если гранулы не видны. Однако, как правило, лучше аккуратно удалять супернатант, надеясь, что гранула останется приклеенной к стенкам трубы, даже если она не видна. - Промывайте ДНК этанолом, как указано. Сделайте дополнительное промывка, если белковый осадок сохраняется.
- Сухая ДНК при комнатной температуре (~20 °C) в течение 15–30 минут.
- Ресуспендировать ДНК в 100 мкл воды без нуклеаз; этот небольшой объём помогает максимизировать концентрацию для подготовки библиотеки нанопор.
ПРИМЕЧАНИЕ: Это удобная точка остановки. ДНК плазмиды может храниться в течение нескольких месяцев при -20 °C. Набор для экстракции, используемый в этом протоколе, разработан так, чтобы минимизировать загрязнение хромосомной (геномной) ДНК с помощью оптимизированной буферной химии, мягкого лизиса и этапов очистки лисата, хотя значительное загрязнение хромосомной ДНК исключено нельзя, и авторы обнаружили его в ходе подготовки (см. результаты).
- День 1: Образцы на агарные пластины Лурия–Бертани (LB) с добавлением соответствующего антибиотика для выбора соответствующего маркера резистентности, переносимого плазмидой, и инкубировать при 37 °C в течение 24 часов.
- Добыча ДНК и контроль качества
Количественно оценить ДНК и оценить её качество с помощью флуоресцентных красителей, которые обеспечивают большую специфичность и чувствительность к низким концентрациям ДНК по сравнению с методами поглощения ультрафиолета. В этом протоколе используйте устройство флюорометра для точной и удобной количественной оценки образцов ДНК, РНК илибелка 39.- Рабочий процесс с флюорометром
- Доведите образцы ДНК до комнатной температуры. Подготовьте пробирки для стандартов и образцов.
ПРИМЕЧАНИЕ: Рассчитайте подходящие объёмы красителя и буфера для включения в рабочий раствор, исходя из количества образцов. Для каждого стандарта и образца следует приготовить 200 мкл рабочего раствора, разбавляя краситель в буфере в соотношении 1:200. Устройство оснащено встроенным реагентным калькулятором, который также может использоваться для таких вычислений. - Подготовьте пробирные трубки согласно таблице 1.
- Проведите вихрь каждой трубки несколько секунд, а затем инкубировать 2 минуты при комнатной температуре.
- Калибруйте флуорометр по стандартам. Вставьте пробирки и записывайте показания. Подробные инструкции смотрите руководство пофлуорометру 39.
ПРИМЕЧАНИЕ: Для типичных плазмидных препаратов Midi ожидается выход ДНК от ~50 до 150 мкг на культуру объёмом 100–400 мл, в зависимости от размера плазмиды, количества копий и условий роста. Типичная длина чтения нанопор варьируется от ~2 кб до 20 кб, при этом медианные показания часто составляют около 5–10 кб для стандартных плазмид. Наборы на основе лигирования могут обеспечивать более длинные считывания (>20 кб медианы) для крупных плазмид, но быстрый набор обеспечивает более быструю подготовку за счёт немного более коротких чтений.
- Доведите образцы ДНК до комнатной температуры. Подготовьте пробирки для стандартов и образцов.
- Рабочий процесс с флюорометром
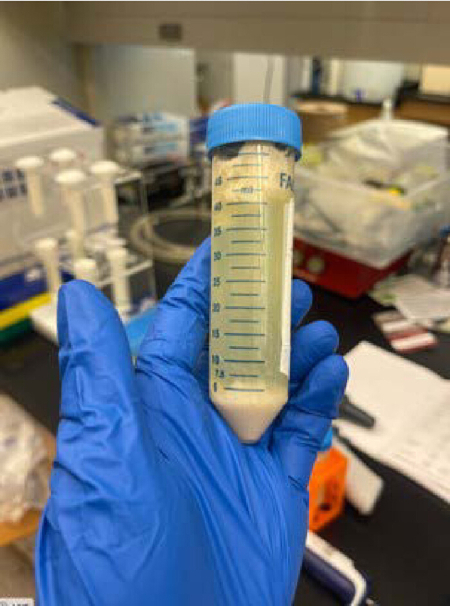
Рисунок 2: Мутный лизатный супернатант после одного этапа центрифугирования. Последовательное центрифугирование требуется до тех пор, пока супернатант не станет чистым, чтобы избежать засорения фильтрационной колонки. Пожалуйста, нажмите здесь, чтобы увидеть увеличенную версию этой фигуры.
| Стандартные пробиральные трубки | Пользовательские образцы пробирки | |
| Рабочий раствор (краситель и буфер, 1:200) | 190 мкл | 180–199 мкл |
| Стандарт (из набора) | 10 мкл | – |
| Пример пользователя | – | 1–20 мкл |
| Общий объём в каждой пробирке | 200 мкл | 200 мкл |
Таблица 1: Объёмы и количество реагентов для флюорометра. Показатели показаны для одной выборки; Пул может быть подготовлен на основе количества анализируемых образцов.
2. Метод 2: Подготовка библиотеки
ПРИМЕЧАНИЕ: Соображения. Подготовка библиотеки для секвенирования извлечённых плазмид проводилась согласно инструкциям, предоставленным в комплектештрих-кодирования 40. Этот протокол использует набор, основанный на транспоазе для одновременного фрагментирования и штрихкодирования ДНК, обеспечивая быстрый и упрощённый рабочий процесс, сокращая время работы и упрощая подготовку библиотеки.
- Подготовка ДНК
- День 1: Запрограммировать термальный циклер: 30 °C на 2 минуты, затем 80 °C на 2 минуты.
- Компоненты комплекта для разморозки при комнатной температуре, откручите вниз и смешайте по Таблице 2.
ПРИМЕЧАНИЕ: Если используете центрифугу, вращение вниз на низкой скорости не превышающей 330 x g. - Подготовка ДНК в воде без нуклеаз: Переместите 200 нг ДНК в ПЦР-пробирки объемом 0,2 мл и добавьте соответствующий объём безнуклеазной воды в каждый образец для достижения итогового объёма до 10 мкл. Смешайте аккуратно пипеткой 10–15 раз. Кратко опустите в микрофуге или центрифуге при 330 g для облегчения пипетирования в следующих шагах.
- Приготовьте смеси в ПЦР-трубках, как указано в Таблице 3.
- Смешивайте с помощью пипетки, затем ненадолго опустите вниз.
- Инкубировать ПЦР-трубки с помощью программы термического цикла из первого шага. Поставьте трубки на лёд для охлаждения.
- Ненадолго опустись вниз.
- Нативное лигирование штрихкодов
- Пробы с штрихкодом в чистой трубке Эппендорфа объёмом 1,5 мл. Убедитесь, что общий объём не превышает 1000 мкл.
- Подвесьте бусины, используя вихрь. Добавьте равный объём бусины к сэмплам с штрихкодом и смешайте, щелкая пальцами.
- Инкубировать трубки в течение 10 минут при комнатной температуре на микшере Hula.
- Приготовьте 2 мл этанола 80% в воде без нуклеаз.
- Вращите образец и гранулу, прижимая трубку к магниту. Держа трубку на магните, пипетку отключает супернатант как отходы.
ПРИМЕЧАНИЕ: Любой магнит соответствующей прочности и размера, включая неодимовые магниты, может служить эффективной альтернативой дорогой стойке для магнитов. Магниты с удерживающей силой примерно 5–12 фунтов и диаметром 0,3–1 дюйм обычно подходят для стандартных трубок объемом 0,2–1,5 мл, что позволяет чисто удалять супернатанты во время этапов очистки на основе шариков. - Промывайте шарики с 1 мл 80% этанола, находясь на магните. Удалите этанол. Повторяйте промывку.
ПРИМЕЧАНИЕ: Изменение положения трубки относительно магнита может облегчить удаление этанола. Используйте дополнительное низкоскоростное вращение, чтобы обеспечить полное гранулирование в случае случайного нарушения гранулы. - Ненадолго повернуть трубку вниз и вернуть трубку на магнит. Убрать остатки этанола. Сушите 30 секунд, но не сушите гранулы до трещины.
- Удалите магнит и снова подвесьте шарики в буфере элюирования. См. таблицу 4 для соответствующих томов EB в зависимости от количества используемых штрихкодов.
- Инкубировать трубку 10 минут при комнатной температуре.
- Верните трубку к магниту, пока элюат не станет чистым.
- Количественно определить концентрацию ДНК с помощью 1 мкл элюированного образца на флюорометре, чтобы убедиться, что подготовка библиотеки была успешно выполнена и не тратить Flow Cell на неисправную библиотеку.
- Переходная лигация
- Перенесите 11 мкл библиотеки ДНК в новую трубку и метку.
ПРИМЕЧАНИЕ: При необходимости храните дополнительную ДНК при -20 °C для будущих секвенирования. - Разбавьте размороженный Rapid Adapter в новой трубке согласно таблице 5 и подняйте и опустите пипетку для смешивания.
- Добавьте 1 мкл разбавленной РА в библиотеку ДНК с 11 мкл.
- Прокрутите лампу для смешивания, затем ненадолго опустите вниз, чтобы убедиться, что полный объём накопился на дне трубки.
- Инкубировать 5 минут на скамейке.
- Перенесите 11 мкл библиотеки ДНК в новую трубку и метку.
| Реагент | Оттаивание при комнатной температуре | Вращение вниз | Смешивание с помощью пипетирования |
| Быстрые штрихкоды | Не Холодное Сердце | ✓ | ✓ |
| Быстрый адаптер | Не Холодное Сердце | ✓ | ✓ |
| Бусины AMPure XP | ✓ | ✓ | Смешивайте с помощью пипетки или вихря непосредственно перед использованием |
| Буфер элюции | ✓ | ✓ | ✓ |
| Буфер адаптера | ✓ | ✓ | Смешивание с помощью вихря |
Таблица 2: Объемы и количество реагентов для подготовки библиотеки нанопор .Действия, которые нужно выполнить с каждым реагентом, отмечены как (✓).
| Реагент | Том/сэмпл |
| 10 мкл шаблонной ДНК (200 нг с предыдущего шага) | 10 мкл |
| 1,5 мкл быстрых штрихкодов, по одному на каждый образец | 1,5 мкл |
| Общий объём | 11,5 мкл |
Таблица 3: Реагенты и объёмы для быстрого штрихкодирования. Объёмы отображаются по каждому образцу ДНК; можно приготовить объединённую смесь и добавить ДНК отдельно.
| Штрихкоды 1-24 | 48 штрихкодов | 72 штрих-кода | 96 штрихкодов | |
| Объём буфера элюции | 15 мкл | 30 мкл | 45 мкл | 60 мкл |
Таблица 4: Объёмы буфера Elution, используемые для каждых 24 штрихкодов. Объёмы указываются в зависимости от количества штрихкодов.
| Реагент | Объём |
| Быстрый адаптер (RA) | 1,5 мкл |
| Буфер адаптера (ADB) | 3,5 мкл |
| Общий объём | 5μL |
Таблица 5: Реагенты и количество для адаптера. Объёмы можно корректировать в зависимости от количества образцов.
3. Пробег с потоковой ячейкой
ПРИМЕЧАНИЕ: При секвенировании небольшого числа плазмид с умеренным покрытием выбирайте ячейку со стандартным выходом. Nanopore рекомендует провести проверку потоковой ячейки для определения активного количества пор; Потоковые ячейки устройств Nanopore должны иметь не менее 800 активных пор согласно гарантийным критериям. Одна ячейка потока MinION обеспечивает достаточный выход для секвенирования нескольких образцов ДНК, обогащённых плазмидной ДНК (см. подробнее о мультиплексировании в разделе обсуждения), при этом предлагая более низкую стоимость и большую гибкость по сравнению с GRIDion или Promethean flow cell.
- Запуск и загрузка ячейки потока
ПРИМЕЧАНИЕ: Для разработки этого протокола использовались потоковые ячейки R10.4.1 (выпущенные в 2022 году). Эти потоковые ячейки имеют более длинные поры с двойной головкой считывателя, что приводит к улучшению секвенирования гомополимеров20,21. Этот протокол секвенирования и комплект штрих-кодирования несовместимы с другими ячейками потока. При проведении крупномасштабного мультиплексирования, стремлении к высокому покрытию или работе с крупными плазмидами или геномами, выбирайте потоковую ячейку с высоким выходом. Учитывайте количество выборок и целевой глубину, чтобы сбалансировать стоимость, пропускную способность и качество секвенирования.- Удалите реагенты из холодного хранилища, включая буфер секвенирования (SB), библиотечные шарики (LIB) или раствор библиотеки (LIS), альбумин из сыворотки крупного рогатого скота (BSA), трос потоковой ячейки (FCT) и промывку потоковой ячейки (FCF). Разморозить на льду при комнатной температуре. Когда реагенты растают, создайте вихрь для смешивания, быстрого вращения и хранения на льду.
- Подготовьте подготовку к проточной ячейке, смешивая свежую ДНК-пробирку с использованием реагентов, перечисленных в таблице 6. Смешивайте с помощью инверсии и пипетки.
- Поднимите крышку устройства и вставьте потоковый элемент. Мягко надавливайте, чтобы правильно расположить.
- Откройте порт грунта, сдвинув крышку в сторону.
- Проверьте наличие воздушных пузырьков внутри или рядом с портом запуска. Отнимите 20–30 мкл жидкости для удаления пузырьков.
ПРИМЕЧАНИЕ: Не удаляйте более 20–30 мкл буфера. Поры должны оставаться погружёнными в буфер всё время. Поры, открытые воздействию воздуха, могут стать непригодными для использования. Убедитесь, что буфер непрерывн по всему видимому каналу. - Наберите 800 мкл грунтовой смеси и подайте в порт грунта. Избегайте появления воздушных пузырьков. Дайте устройству постоять 5 минут.
- Подвесьте либ, подавляя вверх и вниз.
ПРИМЕЧАНИЕ: Подвесьте немедленно перед использованием, так как библиотека быстро успокаивается. - Смешайте библиотеку ДНК с соответствующим объёмом библиотечных бусинок в новой трубке, как указано в таблице 7.
ПРИМЕЧАНИЕ: Комплект для быстрого штрих-кодирования, который используют авторы, использует подход на основе транспозазы для фрагментирования ДНК и прикрепления штрихкодов без намеренного выбора размера, поэтому длина чтения в основном отражает исходную входную ДНК. В отличие от наборов на основе лигирований, таких как Native Barcoding Kits, комплект быстрого штрих-кодирования не включает отдельные буферы коротких или длинных фрагментов. Хотя длинная ДНК всё ещё может генерировать длинные чтения, распределение более вариативно и обычно короче, чем в библиотеках на основе лигации, которые используют буфер длинных фрагментов для обогащения длинных фрагментов. Отсутствие буферов упрощает рабочий процесс и сокращает время работы на практике, но даёт меньше контроля над распределением размера библиотеки, что может влиять на качество сборки. Наборы на основе лигации, селективно обогащая крупные фрагменты и удаляя короткие, обычно обеспечивают более высокую медианную длину чтения и улучшенную непрерывность сборки, особенно для de novo сборок и сложных геномов. - Отрегулируйте крышку порта образца, чтобы открыть порт. Загрузите 200 мкл смеси для запуска в порт запуска потоковой ячейки.
- Аккуратно перемешайте подготовленную библиотеку ДНК перед загрузкой.
- Введите 75 мкл из библиотеки ДНК с бусинами в порт образца, по одной капле за раз, давая каждой капле впитаться перед добавлением следующей.
- Заново поставьте крышку порта для сэмпла и закройте порт для запуска.
- Добавьте световой щит к ячейке потока, выстроив передний край экрана зажимом, а затем опустите остальную часть для покрытия ячейки. Не пытайтесь размещать световой экран под зажимом. Световой экран должен располагаться вокруг крышки, защищая всю верхнюю часть потоковой ячейки от воздействия света.
ПРИМЕЧАНИЕ: Установите световой экран на ячейку потока сразу после загрузки библиотеки для оптимального выхода последовательности. Оставляйте его включённым на последующих этапах, пока библиотека не будет удалена из ячейки потока. Световой экран не надёжно крепится к устройству; Обращайтесь с ним аккуратно, чтобы не вытеснить его. - Зафиксируйте крышку устройства и начните секвенирование.
- Начиная требования к вычислениям последовательности:
Минимум: 8-поточный процессор, 16 ГБ оперативной памяти, 1070 NVIDIA GPU, 500 ГБ SSD
Рекомендуемые: 16-поточный процессор, 32 ГБ оперативной памяти, видеокарта NVIDIA 2070, 1 ТБ SSD
ПРИМЕЧАНИЕ: Убедитесь, что и программное обеспечение, и компьютер обновлены и имеют как минимум 500 ГБ свободного хранилища для новых файлов. Обновления программного обеспечения и другие программы могут мешать запуску секвенирования. Убедитесь, что программа установлена либо на операционной системе Windows, либо на Ubuntu.- Установите лимит времени выполнения: в зависимости от количества мультиплексируемых плазмид, установите лимит запуска. По умолчанию — 48 час, максимальное время можно использовать 72 часа. Подробные инструкции смотрите в руководстве.
ПРИМЕЧАНИЕ: время выполнения зависит от мультиплексирования и размера плазмиды, а не от числа плазмид. Количество образцов или плазмид, которые можно мультиплексировать, зависит от желаемой глубины секвенирования и выхода ячейки потока. Для типичного секвенирования плазмид мультиплексирование 20–24 образцов на стандартную нанопоровую ячейку обычно обеспечивает достаточное покрытие для точной сборки и обнаружения вариантов, при условии размера плазмид менее ~200 кб. Более крупные плазмиды или более высокие требования к покрытию могут потребовать меньше образцов на одну ячейку потока. Более высокоэффективные потоковые ячейки могут поддерживать гораздо больше образцов (до 96 и более) за один пробег, что делает их подходящими для секвенирования плазмид с высокой пропускной способностью или проектов, требующих очень глубокого покрытия. Пользователям следует сбалансировать количество штрихкодов, размер плазмиды и глубину цели, чтобы каждая плазмида получала достаточные считывания для полной сборки. - Включите обрезку штрихкодов при демультиплексировании во время секвенирования.
ПРИМЕЧАНИЕ: Отслеживайте считывания по штрихкоду и останавливают запуск, когда будет достигнуто достаточного покрытия для сохранения срока службы потоковой ячейки. - Выберите режим супер-точного вызова баз.
ПРИМЕЧАНИЕ: Не выбирайте адаптивное сэмплирование/балансировку штрихкодов. Эта опция значительно снижает считывание-выход и быстрее ухудшает поры. Если у вас нет видеокарты, лучше подождать с вызовом баз после окончания забега. - Выберите подходящий набор для быстрых штрихкодов (24 или 96).
- Убедитесь, что устройство на уровне, и начните запуск секвенирования на стандартных настройках (минимальный балл Q 10).
ПРИМЕЧАНИЕ: Это удобная точка остановки. Устройство можно запускать всю ночь. - Пост-хок вызвание баз (на случай, если у компьютера нет достаточной ёмкости для живого вызова баз или для повышения точности вызова баз, повторный анализ исходных данных с помощью улучшенных аналитических инструментов): открыть завершённый запуск секвенирования в программном обеспечении
ПРИМЕЧАНИЕ: Следующие шаги применимы только если вы не выбрали live basecalling. - Выберите Basecalling и модель сверхточности (SUP).
- Выберите сырые данные FAST5/POD5 и установите каталог вывода.
- Начинайте звонить на базы.
- Установите лимит времени выполнения: в зависимости от количества мультиплексируемых плазмид, установите лимит запуска. По умолчанию — 48 час, максимальное время можно использовать 72 часа. Подробные инструкции смотрите в руководстве.
| Реагенты | Объём на ячейку потока |
| Промывка потоковой ячейки (FCF) | 1 170 мкл |
| Бычий сывороточный альбумин (BSA) при содержании 50 мг/мл | 5 мкл |
| Трос потоковой ячейки (FCT) | 30 мкл |
| Итоговый общий объём в лампе | 1 205 мкл |
Таблица 6: Реагенты и объёмы для подготовки и загрузки потоковой ячейки. Объёмы реагентов указаны на каждую ячейку потока.
| Реагенты | Объём на ячейку потока |
| Буфер секвенирования (SB) | 37,5 мкл |
| Библиотечные шарики (LIB) или библиотечное решение (LIS), если используются | 25,5 мкл |
| Библиотека ДНК | 12 мкл |
| Total | 75 мкл |
Таблица 7: Реагенты и тома для загрузки библиотеки. Для библиотеки ДНК показаны тома; Библиотечные бусины (BID) следует смешивать непосредственно перед использованием.
4. Метод 4: сборка с помощью автоциклера
ПРИМЕЧАНИЕ: Существует множество вариантов сборки чтений в континги. У каждого ассемблера есть свои плюсы и свои предвзятости. Этот протокол рекомендует использовать Autocycler, который использует множество различных сборок и объединяет их в одну сборку. Это более трудоёмко, и можно использовать один сборщик, чтобы сэкономить время. Пожалуйста, установите Conda в терминале для загрузки соответствующего программного обеспечения. Дополнительный документ команд содержит ссылку на файл окружения для настройки системы.
- Оценка качества забега: проверьте качество пробега из программного обеспечения Minknow или из отчёта .html файла забега, чтобы отметить метрики качества (доходность, Q-score, длина, распределение). По желанию оценить FASTQ-файлы с помощью NanoPlot для подтверждения распределения длины чтения, N50 и профилей оценки качества для каждого штрихкода. Продолжайте только если распределение по секвенированию выхода и длины считывания соответствуют ожидаемым размерам плазмид.
- Удаление штрихкодов: Определите, была ли включена обрезка штрихкодов во время последовательности. Если штрихкоды не удалялись, обрезать файлы FASTQ с помощью Porechop (v0.2.4) и проверить успешное удаление последовательностей адаптеров штрихкодов перед следующим анализом.
- Трим-считывания: Обрезайте длинные считывания с помощью Filtlong (v0.3.1), удаляя примерно 5–10% чтений самого низкого качества, сохраняя ~90% от общего выхода. Сгенерируйте отфильтрованный FASTQ-файл для ассемблера. Если последующие сборки образуют химерные континги, увеличьте плотность фильтрации, установив минимальный порог длины чтения ≥3 000 bp, и восстанавлите фильтрованные считывания.
- Подвыборы и сборка readsubsets: Считывайте подвыборы с помощью Autocycler в соответствии с рекомендуемыми настройками и собирайте каждое подмножество чтения с помощью Raven (v1.8.3), Flye (v2.9.6), Canu (v2.3.0), miniasm (v0.3.0), Myloasm (v0.2.0), NECAT (v0.0.1), Plassembler (v1.8.1) и любых других выбранных сборок. Обратите внимание на длину континга и статус циркуляризации для каждой сборки. Ассемблеры, сообщающие о циркуляризации (Raven, Flye, miniasm, Myloasm и Plassembler), должны отдавать приоритет для реконструкции плазмид. Для сборок Canu и NECAT определите кандидатные контиги плазмид на основе ожидаемого размера плазмиды из круговых контингов в предыдущих сборках.
- Инспектировать и курировать сборки: визуализировать каждый файл графа сборки (.gfa) с помощью Bandage (v0.9.0) и оценивать континги на круглость, согласованность размеров между сборщиками и наличие химерных соединений. Удалить линейные континги, не поддерживающие несколько сборщиков, и сохранить круговые контиги с согласованными оценками размера. Если многие сборки содержат химерные соединения, вернитесь к шагу 4.3 и увеличьте минимальный порог длины считывания (рекомендуемый ≥3 000 bp). В случаях, когда крупные плазмиды круглы, но остаются меньшие неподдерживаемые контиги, удаляйте незначительные контиги до консенсусного образования. Переходите к генерации консенсуса, и этапы полировки можно выполнять пакетно, после ручного курирования.
- Генерировать консенсус и окончательную сборку: после ручной кураторской обработки приступайте к генерации консенсуса Autocycler с использованием кураторских сборок. Выполните оставшиеся команды Autocycler, чтобы получить финальную последовательность консенсусных плазмид. Подробные командные инструкции и настройки параметров приведены в дополнительном материале.
- Полировка: После полировки сборки полировать сборку с помощью обрезанных длинных считываний с помощью Medaka (v2.1.1), чтобы значительно повысить консенсусную точность.
ПРИМЕЧАНИЕ: Хотя дополнительные полировочные патроны могут повысить консенсусную точность, они также могут создавать ошибки. Лучше всего использовать программу вроде DNAapler для вращения нового устройства перед полировкой; Команды можно найти в разделе дополнительных команд.
5. Метод 5: Аннотация
ПРИМЕЧАНИЕ: Существует множество эффективных инструментов аннотирования бактерий. Следующие программы рекомендуются для подробной аннотации.
- Бакта отлично подходит для протеомных анализов, поскольку сейчас активно поддерживается и служит духовным преемникомПрокки 41,42.
- Для типизации репликонов, типирования мобильности плазмид и конъюгационного типирования MOB-suite являетсянадёжным 6. MOB-suite может вывести филогения плазмид с помощью дистанции по каше и идентифицировать элементы последовательности вставки (IS) 43.
- COPLA также является полезным инструментом для таксономии плазмид. Уникальный подход Коплы, который классифицирует плазмиды по таксономическим единицам плазмид, рекомендуется в поле44.
ПРИМЕЧАНИЕ: Филогенез плазмид исторически представляла значительные трудности, поскольку модульная структура плазмид и высокая частота рекомбинации затрудняют выравнивание последовательностей. COPLA решает эти задачи, вычисляя средние нуклеотидные тождества (ANI).
Результаты
Клинические штаммы E. coli
Для иллюстрации использования ОНТ для секвенирования плазмид из клинических штаммов авторы секвенировали 10 штаммов — щедрый подарок доктора Стивена Салипанте из Университета Вашингтона. Эти штаммы были частью коллекции из 312 изолятов экстракишечного патогенного кишечного кишечника (ExPEC), полученных в ходе планового клинического лечения в Медицинском центре УниверситетаВашингтона 45.
Конъюгация и характеристика плазмид с помощью гелевого теста на мобильность
Исследователи также провели конъюгационный анализ с использованием штамма E. coli LMB100 в качестве реципиента. Конъюгация — это процесс, который приводит к переносу плазмиды, присутствующей в одной клетке (доноре), в другую клетку (называемую реципиентом)46. Перенос требует физического контакта между двумя клетками и обычно обнаруживается с помощью маркеров, указывающих на наличие конъюгативной плазмиды в клетках реципиента. Это позволило авторам исключить различия в штаммах хозяина как переменной и проиллюстрировать использование протокола для секвенирования плазмид, полученных с помощью захвата плазмид (метод профилирования плазмид из определённой экологической ниши). Все конъюгационные анализы производили транссоюганты, подтверждая наличие конъюгативной плазмиды у доноров. Протокол, которому следовали авторы, описан встатье 36. Группа идентифицировала плазмиды, присутствующие в донорских и реципиентных штаммах, и оценила их подвижность с помощью пульсно-полевой гель-электрофорез (PFGE). Список из десяти репрезентативных донорских штаммов приведён в таблице 8 , а предполагаемые размеры плазмид, присутствующих в них, приведены в третьем столбце. Плазмиды за пределами диапазона разрешения геля PFGE исключены из этой таблицы, но исследователям удалось собрать несколько меньших плазмид около ~4 кб (не показано).
| Донорский штамм | Плазмида | Оценочный размер PFGE | Длина сборки | Средняя глубина | bp Zero Depth | Процент покрытия | Изменения позиций | Процент точности до SR |
| blood_08 _0081 | pblood_08_ 0081_1 | 170000 | 171829 | 100 | 99.941803 | 54 | 0.0314 | 99.9686 |
| blood_08 _0081 | pBlood_08_ 0081_2 | 82000 | 85576 | 46.9 | 0 | 100 | 2 | 99.9977 |
| blood_d-08 _0094 | pBlood_d-08 _0094 | 179000 | 173334 | 382.6 | 3121 | 98.19943 | 2,347 | 98.646 |
| blood_08 _1447 | pBlood_08 _1447 | 97000 | 99624 | 36.2 | 0 | 100 | 0 | 100 |
| blood_10 _0913 | pBlood_10 _0913_1 | 70000 | 71788 | 49 | 4 | 99.994428 | 188 | 99.7381 |
| blood_10 _0913 | pBlood_10 _0913_2 | 112000 | 118727 | 41.2 | 126 | 99.893874 | 276 | 99.7675 |
| blood_1 1_184 | pBlood_11 _184_1 | 150000 | 146583 | 65.1 | 287 | 99.804206 | 134 | 99.9086 |
| blood_11_184 | pBlood_11 _184_2 | 75000 | 74263 | 82.1 | 0 | 100 | 32 | 99.9569 |
| blood_2011 _0238 | pBlood_ 2011_0238 | 170000 | 167286 | 110.9 | 0 | 100 | 0 | 100 |
| upec_108 | pUPEC_108 | 130500 | 131039 | 103.9 | 0 | 100 | 0 | 100 |
| upec_134 | pUPEC_134 | 160500 | 157829 | 169 | 0 | 100 | 0 | 100 |
| upec_271 | pUPEC_271 | 145500 | 144519 | 86 | 33311 | 76.950436 | 1,557 | 98.9226 |
| upec_90 | pUPEC_90 | 70000 | 74624 | 139.8 | 0 | 100 | 6 | 99.992 |
Таблица 8: Оценки размера плазмид и метрики точности секвенирования для панели из 10 донорских штаммов. Перечислены оценки размера плазмид, основанные на PFGE или собранных донорских плазмидных последовательностях ONT. Попарные сравнения плазмидных сборок только с ONT и SR-последовательностей также приводятся как индикатор точности. Метрики включают: длину сборки, среднюю глубину, области с нулевой глубиной, процент покрытия, изменённые позиции и процент точности до SR.
Выходные метрики секвенирования плазмид на основе ONT
Последовательность была запланирована на 24 часа. Всего было мультиплексировано 24 образца. Технические данные по каждой выборке, включая показатель качества (Q), длину и охват, приведены в таблице 9. Секвенирование нанопор обеспечивало достаточный выход считывания и качество для всех анализируемых образцов. Во всех библиотеках секвенирование генерировало в среднем 134 115 чтений на выборку, что соответствует среднему выходу 576,2 Мб. Средняя длина чтений составляла 8 797 bp со средним N50 3 693 bp, обеспечивая достаточную непрерывность чтения для сборки плазмид. Средний показатель качества чтения составлял Q16.0 с медианой Q16.6, а индивидуальные забеги варьировались от Q13.7 до Q18.0.
| Секвенированная деформация | Чтения (kb) | Базы (Mb) | Средняя длина | Максимальная длина | Длина мин. | N50 | Медианная длина | Средний Q | Медиана Q | |
| Blood_08_0081 донор | 109.8 | 261 | 5713 | 508418 | 78 | 2377 | 1351 | 14.5 | 15 | |
| Blood_08_0094 донор | 89.3 | 229 | 4177 | 114948 | 81 | 2565 | 1065 | 13.7 | 14 | |
| Blood_08_1447 донор | 87.5 | 246 | 5041 | 135147 | 75 | 2816 | 1609 | 15.1 | 15.7 | |
| Bblood_10_0913 донор | 247.7 | 1026 | 9260 | 174231 | 70 | 4143 | 1661 | 15.5 | 16.1 | |
| Blood_11_154 донор | 51.5 | 110 | 4172 | 91148 | 73 | 2127 | 1387 | 16.1 | 16.5 | |
| Blood_2011_0238 донор | 16.8 | 42 | 6707 | 104848 | 62 | 2534 | 845 | 15.3 | 15.2 | |
| UPEC_108 донор | 50.6 | 77 | 1915 | 90234 | 67 | 1525 | 1103 | 15.8 | 16.2 | |
| UPEC_134 донор | 50 | 143 | 7110 | 158393 | 72 | 2865 | 1133 | 16 | 16.2 | |
| UPEC_217 донор | 64 | 236 | 7512 | 144275 | 78 | 3678 | 1895 | 17.4 | 17.9 | |
| UPEC_90 донор | 52.9 | 157 | 5666 | 95944 | 72 | 2969 | 1593 | 16.8 | 17.2 | |
| Blood_08_0081 LMB100 трансконъюгант | 53.5 | 119 | 5162 | 225856 | 1 | 2232 | 1009 | 16 | 16.8 | |
| Blood_08_0094 LMB100 трансконъюгант | 160 | 442 | 7257 | 252176 | 1 | 2761 | 1083 | 17.3 | 18.2 | |
| Blood_08_1447 LMB100 трансконъюгант | 238 | 1029 | 10249 | 209221 | 1 | 4320 | 1857 | 17.7 | 18.7 | |
| Blood_10_0913 LMB100 трансконъюгант | 792.3 | 4341 | 11508 | 474325 | 1 | 5479 | 2731 | 17.7 | 18.8 | |
| Blood_11_184 LMB100 трансконъюгант | 42.5 | 281 | 17931 | 146626 | 87 | 6615 | 2448 | 16 | 16.7 | |
| Blood_2011_0238 LMB100 трансконъюгант | 147.7 | 585 | 9000 | 344203 | 1 | 3962 | 1781 | 18 | 18.9 | |
| UPEC_108 LMB100 трансконъюгант | 173.4 | 778 | 10127 | 168756 | 80 | 4485 | 2079 | 15.3 | 16.1 | |
| UPEC_134 Трансконъюгантный LMB100 | 105.4 | 667 | 17568 | 349230 | 71 | 6323 | 2232 | 15.5 | 16.3 | |
| UPEC_271 LMB100 трансконъюгант | 74.2 | 336 | 14521 | 342195 | 83 | 4520 | 1306 | 14.6 | 14.8 | |
| UPEC_90 LMB100 трансконъюгант | 75.2 | 418 | 15348 | 225661 | 83 | 5561 | 2016 | 15.7 | 16.4 | |
Таблица 9: Отчёт NanoQ о выходных метриках секвенирования для панели из 10 донорских штамм. Показатели выхода секвенирования перечислены. К ним относятся значения чтения, оснований, длины (среднего, медианного, максимального и минимального), длин, N50 и Q (среднее и медианное) от доноров и транссопряжентов.
Сборка плазмид и точность
Плазмидные последовательности собирались с помощьюAutocycler 34. Размеры собранных плазмидных последовательностей для 10 образцов приведены в таблице 8, четвёртый столбец, и во всех случаях они совпадали с оценками, основанными на мобильности PFGE (перечисленные в третьем столбце). Точность оценивалась путём сравнения сборок длинного чтения, отполированных Medaka, с сборками Medaka (версия 2.2.0) плюс полиполь (v0.6.1). Идентификация последовательности была рассчитана с использованием dnadiff из MUMmer (v3.2.4) (Таблица 8). Во всех анализируемых плазмидах (n = 12) сборки имели среднюю длину 120,4 кб и поддерживали среднюю глубину секвенирования 109x, при среднем покрытии 97,9% по последовательностям плазмид. До полировки сборки имели среднюю идентичность последовательности 99,74% по сравнению с полированной сборкой SR-последовательности.
Оценка загрязнения хромосом
Для оценки покрытия плазмидами и загрязнения хромосом риды были сопоставлены с собранными плазмидными последовательностями и с хромосомной последовательностью E. coli LMB100. Чтения Nanopore с базовыми названиями выравнивались с помощью minimap2 (v2.2.6). Полученные выравнивания обрабатывались с помощью SAMtools (v1.1.7) для генерации отсортированных файлов BAM и расчёта статистики отображения. Покрытие плазмид и средняя глубина оценивались с помощью покрытия SAMtools. Глубина секвенирования плазмид варьировалась между образцами, но оставалась значительно выше минимального покрытия, необходимого для точной сборки (50–70 x). Небольшая часть ридов отображалась на хромосому, что указывает на перенос ДНК хозяина во время экстракции плазмиды (Таблица 10).
| Плазмиды | Общее количество прочитанных | Хромосомные чтения | % хромосомных показаний | Среднее покрытие хромосом | Среднее покрытие плазмидами | Соотношение P:C |
| pBlood_08_0081_2 | 53491 | 20116 | 37.61% | 5 | 1068 | 236 |
| pBlood_d-08_0094 | 160024 | 74827 | 46.76% | 37 | 1618 | 44 |
| pBlood_08_1447 | 238031 | 127967 | 53.76% | 62 | 7842 | 127 |
| pBlood_10_0913_1 | 792263 | 221610 | 27.97% | 87 | 7801 | 90 |
| pBlood_10_0913_2 | 792263 | 221610 | 27.97% | 87 | 7772 | 89 |
| pBlood_11_184_1 | 42494 | 15919 | 37.46% | 7 | 1637 | 250 |
| pBlood_11_184_2 | 42494 | 15919 | 37.46% | 7 | 2188 | 335 |
| pBlood_2011_0238 | 147680 | 80526 | 54.53% | 56 | 2965 | 53 |
| pUPEC_108 | 173409 | 107884 | 62.21% | 61 | 4008 | 65 |
| pUPEC_134 | 105418 | 68645 | 65.12% | 29 | 3640 | 127 |
| pUPEC_271 | 74232 | 53554 | 72.14% | 34 | 1202 | 35 |
| pUPEC_90 | 75193 | 30052 | 39.97% | 16 | 4488 | 278 |
Таблица 10: Оценки загрязнения хромосомной ДНК. Загрязнение хромосом в плазмидах, очищенных от реципиентных штамм, количественно оценивалось как доля ридов, сопоставленных с хромосомной последовательностью LMB100 по сравнению с плазмидными считываниями. Для каждой плазмиды перечислены считывания плазмиды, общее считывание, хромосомные показания, среднее покрытие хромосом, среднее покрытие плазмид, а также соотношение P:C. Обратите внимание, что pBlood_08_0081_1 отсутствует, потому что его не удалось восстановить у получателя, и эти оценки проводились на реципиентах из-за их однородного хромосомного фона.
Загрязнение хромосом количественно оценивалось как доля чтений, сопоставленных с собранной хромосомной последовательностью LMB100, по сравнению с плазмидными считываниями. Уровень загрязнения хромосом варьировался от 72,1% до 28,0%, со средним показателем 46,9% (Таблица 10). Этот метод, вероятно, переоценивает загрязнение хромосом, поскольку отображения ридов как на плазмиду, так и на хромосому считаются только хромосомными, но всё равно указывает на значительную хромосомную переносность. Несмотря на этот хромосомный перенос, процесс сборки успешно восстановил полные плазмидные последовательности, которые всё ещё соответствовали размеру, предсказанному по мобильности PFGE для всех образцов (Таблица 8, третий и четвёртый столбцы).
Репрезентативные пары конъюгативных плазмид донор-реципиент
Штамм upec271 был выделен из образца мочи в период с 2011 по 2013 год и отнесён к филогруппе B2 и типу последовательности ST131. Анализ PFGE выявил наличие полосы, соответствующей плазмиде примерно 145 кб [Рисунок 3A, (Донор)]. Анализ последовательностей с коротким чтением выявил наличие репликона IncF.
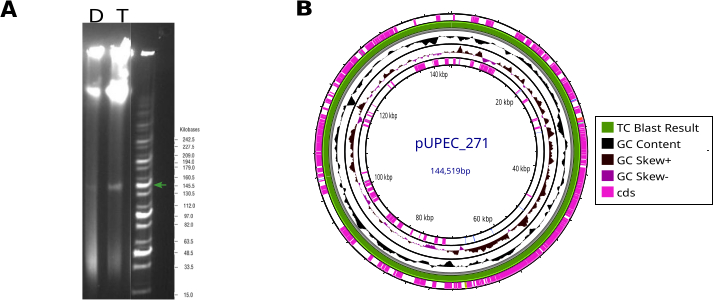
Рисунок 3: Характеристика pUPEC271. (A) PFGE донора и трансконъюганта. Показаны полосы PFGE для донора (D) и трансконъюгантного (T); зелёные стрелки обозначают полосу плазмид, соответствующую pUPEC271. Протокол, используемый для ПФГЕ, описан висследовании 36. (B) Карта pUPEC271. Трансконъюгант был выстрелен против донора, и консенсус (который на 100% идентичен) показан как зелёное кольцо. Это представление было сгенерировано с помощьюProksee 48. Внешнее кольцо показывает местоположение CDS, два внутренних кольца — содержимое GC и смещение, а внутреннее — расположение генов тРНК. Пожалуйста, нажмите здесь, чтобы увидеть увеличенную версию этой фигуры.
Перенос этой плазмиды, которую авторы назвали pUPEC271, была дополнительно подтверждена анализом PFGE с использованием протокола, ранее описанного встатье 36 [Рисунок 3A, T(трансконъюгант)]. Плазмидная ДНК, очищенная из донорского штамма upec271 (pUPEC271_donor), была секвенирована с помощью нанопоры. В соответствии с размером полоски на геле PFGE, последовательность pUPEC271_donor выявила плазмиду размером 144 519 bp (рисунок 3B). Эта плазмида имела репликон типа IncF и содержала гены устойчивости к шести различным классам антибиотиков (см. дополнительную таблицу 1). Авторы также очистили ДНК одного из трансконъюгантов (pUPEC271_TC) и получили последовательность, идентичную донорской. Итоговая сборка, сравниваемая с pUPEC271_donor, показана на рисунке 3B. Это подтвердило, что конъюгативная плазмида, присутствующая в доноре, была перенесена в трансконъюгантный штамм. Технические данные приведены в таблице 9.
Штамм Blood_10_0913 — пример штамма с несколькими плазмидами. Этот образец был собран из крови в период с 2008 по 2013 год, и короткое чтение показало наличие двух репликонов — IncF и IncY репликон. Анализ PFGE этого штамма выявил две плазмиды примерно 70 и 110 кб соответственно (рисунок 4A). Это было подтверждено секвенированием нанопор, которое дало две сборки размером 71 182 и 111 226 пп соответственно. Авторы назвали эти две плазмиды pBlood_10_0913_1 и pBlood_10_0913_2 (рисунок 4B). Однако изначально сборки не сталкивались с циркулярностью из-за обширной гомологии последовательностей в срезе плазмид, несущих механизм сопряжения (раздел обширной гомологии выделен на рисунке 4B). Схема неудачной сборки, созданная с помощьюBandage 47 , показана на рисунке 4C. Полная сборка двух плазмид стала возможной только после агрессивного отбора последовательностей с более коротким считыванием (< 3000 bp).
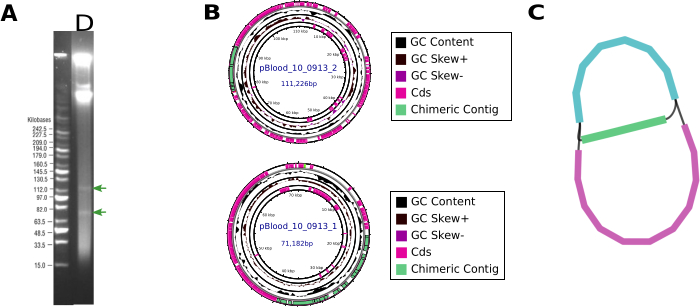
Рисунок 4: Идентификация и сборка плазмид Blood_10_0913 штамма. (A) PFGE. Зелёные стрелки обозначают плазмидные полосы. Протокол, используемый для PFGE, описан в сборкепоследовательностей 36 (B). Сборка двух меньших плазмид, присутствующих в pBlood_10_0913 образце — pBlood_10_0913_2 и pBlood_10_0913_2. (C) Неудачная сборка. Представление неудачи сборки из-за наличия общей последовательности между двумя различными сборками. Это представление было сгенерировано с помощьюBandage 47. Пожалуйста, нажмите здесь, чтобы увидеть увеличенную версию этой фигуры.
Дополнительная таблица 1: Гены устойчивости, переносимые pUPEC271. Показаны размер плазмиды, репликоны и гены устойчивости, связанные с pUPEC271. Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Дополнительные команды. Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Обсуждение
Идентификация и характеристика плазмид представляют большой интерес для общественного здравоохранения, клинической микробиологии и микробной экологии, поскольку они способствуют поддержанию и распространению адаптивных генов в экологическихусловиях 1,5 и служат платформами для ускореннойэволюции 4. Внедрение технологий NGS позволило проводить высокопроизводительное секвенирование геномов микробных изолятов и популяций, хотя идентификация полных плазмид или контигов, полученных из плазмид, обычно требует длинных последовательностей, поскольку данные секвенирования с коротким чтением не могут различать повторяющиеся области, превышающие размер считываний. ONT стал очень популярным подходом к секвенированию с длинным чтением, с применениями, выходящими за рамки секвенирования целого генома и метагеномики, включая верификацию последовательностей плазмид, обнаружение и характеристику эпигенетических модификаций, секвенирование РНК и оценку внутренней нестабильности тандемных генных массив (рассмотрено в12,49 годах).
Здесь исследователи представляют рабочий процесс для ОНТ-секвенирования плазмид, предназначенный для ситуаций, когда хромосомная последовательность уже известна или не представляет интереса. Причина в том, что экстракция плазмид трудоёмкая, дорогостоящая и трудоёмкая (поскольку популяция хозяина должна выращивать в культуре и обрабатываться), а секвенирование всего генома с использованием технологии нанопор часто достаточно для получения полных плазмидных сборок, сохраняя их геномный контекст. Примеры, когда протокол полезен, включают верификацию последовательности плазмид в контексте генной инженерии плазмид50,51, повышение точности последовательностей плазмид, уже полученных вWGS 24, или характеристику плазмид, взятых из клинических или экологических образцов путем конъюгации.
Извлечение ДНК из клинических и экологических образцов может потребовать некоторой адаптации. Здесь авторы сообщают, что некоторые клинические штаммы, которые они использовали, создавали биопленочную матрицу, которая засоряла фильтры, что требовало множества этапов гранулирования и иногда добавляло два фильтра. Кроме того, для секвенирования конъюгативных плазмид требуется больший объём культуры по сравнению с секвенированием многокопийных плазмид, поскольку естественные средне- и крупноразмерные плазмиды обычно имеют низкий номер копииплазмиды 2.
Протокол позволил секвенирование плазмид размером от 4 до 173 кб. Этот диапазон полностью соответствует спецификациям производителя (от 2 до 200 КБ). Недавно исследование изучало 23 000 плазмидных последовательностей, отложенных в NCBI, и выявило значительные различия в размерах в зависимости от источника: плазмиды человеческого происхождения имели наименьший медианный размер (76 кб), а почвенные и растительные плазмиды — самые большие (215 и 427 кб соответственно); Плазмиды из всех других источников имели медианный размер от 79 до 147 КБ, поэтому этот протокол должен охватывать большинство плазмид, что, возможно, исключение мегаплазмид52 и плазмид почвенногоили растительного происхождения 3.
Авторы включают этап обогащения плазмидной ДНК для повышения точности сборок плазмидной ДНК. Наличие большого количества хромосомной ДНК заполняет поры клетки секвенирующего потока нецелевыми считываниями, значительно снижая глубину плазмидной ДНК. Этап обогащения плазмидной ДНК уже был реализован для попытки полной сборки плазмидной ДНК в клинических образцах для обнаруженияARG 24. Это показало значительное улучшение эффективности завершения сборки плазмид с нанопорной последовательностью (78% полных сборок по сравнению с эталонным показателем). Другие примерыследовали за 50, 53, 54 годами.
Для повышения точности чтения два из этих исследований использовали технику, разработанную nanopore, под названием «парный базовый вызов на псевдопарных чтениях»50,53. Этот подход предполагает выравнивание необработанных электрических сигналов от сенсорных и антисмысловых цепочек одной и той же молекулы ДНК, что приводит к улучшению точности примерно на порядок. Парный базовый вызов на псевдопарных ридах совместим с мультиплексированием, при условии, что стратегия позволяет идентифицировать прямые и обратные цепи одной и той же молекулы. Таким образом, его нельзя использовать в плазмидах, очищенных из образцов неизвестного плазмидного комплемента или содержащих смесь плазмид. Обратите внимание, что количество плазмид в геноме обычно варьируется от 0 до 7 плазмид (особенно в клинических изолятах)2,55.
Исследователи отметили высокий уровень хромосомного загрязнения образцов (Таблица 10). Уровень загрязнения 10 проанализированных образцов варьировался от 28 до 72% согласно картографированию считывания. Однако, когда исследователи нормализовали эту последовательность до размера хромосомы относительно размера присутствующей плазмиды или плазмид, было установлено, что плазмидных последовательностей в среднем в 144 раза больше, чем хромосомных. Для перевода этого числа в уровень обогащения ДНК плазмиды потребуется знать количество копий плазмид в каждом образце.
Потоковые ячейки MinION обычно обеспечивают выход секвенирования ~30 ГБ, что теоретически позволяет секвенировать более 96 плазмид за один запуск. На практике мультиплексирование также ограничено лимитом в 96 штрихкодов, что делает 96 плазмид практической верхней границей на одну ячейку потока. Однако загрязнение хромосомной ДНК и естественный дисбаланс штрихкодов снижают эффективную глубину чтения на образец. Для обеспечения достаточной глубины считывания для каждого образца более консервативный подход — мультиплексировать примерно 24 плазмиды на каждую ячейку потока. Рекомендуемая глубина для точной сборки последовательности плазмид составляет от 50 до70x 32,56. В иллюстративных примерах, представленных в этой статье, авторы провели 21 мультиплексированный образец в одной ячейке потока и получили среднюю глубину (109x), которая хорошо совпадает с рекомендуемым оптимальным выборком на каждую ячейку потока.
Обратите внимание, что при избыточной глубине чтения разделы чтения pass/fail менее информативны для оценки общего качества чтения. Вместо этого метрики, полученные из распределения длины, дают более чёткое представление качества наборов данных. Одной из таких метрик является N50, определяемая как длина чтения, при которой чтения такой или более длины составляют 50% от общего числа оснований. Это значение очень чувствительно к этапам контроля качества. Например, фильтрация низкокачественных или коротких считываний с помощью таких инструментов, как Filtlong, удаляет значительную долю более короткого хвоста распределения, тем самым увеличивая N50. Этот эффект очевиден в таблице 9.
Авторы использовали набор Rapid Barcode от ONT, который использует транспосому для фрагментации ДНК плазмиды, поэтому не требует предварительного знания о схеме рестрикции плазмиды. Более раннее исследование показало, что для малых плазмид (<20 кб) ферментативная фрагментация необходима, поскольку маленькие плазмиды остаются круглыми при большинстве экстракций ДНК и, следовательно, не содержат свободных концов для адаптернойлигации 54. В этом исследовании не использовались штрих-коды, которые генерируют дополнительные свободные концы за счёт усиления ПЦР, так что в данном случае это, вероятно, не имеет значения. OnRamp, одна из продвинутых процедур рутинной валидации плазмид, избегает использования штрих-кодов, используя полноразмерные плазмидные считывания для сборки, что упрощает подготовкуобразца 54. В данном случае авторы выбрали штрихкоды по трём причинам. Первый — построить сборку независимо от длины плазмиды. Второй — это переносимость загрязнения хромосомной ДНК. Третий — это открывает возможность мультиплексирования нескольких выборок, как было сказано выше.
В более раннем исследовании отмечалось, что агрегация разных сборщиков улучшает итоговый результат, устраняя предвзятости, заложенные в отдельных платформахсборки 24. Этот метаанализ — функция, интегрированая в программу сборки, которую используют авторы — Autocycler34. По сравнению с предыдущей версией, названнойTrycycler 57, Autocycler немного более автоматизирован; Он использует несколько подмножеств чтений и (как уже упоминалось) выполняет сборки с несколькими ассемблерами для создания более точной консенсусной ассембли. Однако большинство ассемблеров, даже лучших, таких какFlye 28,Canu 29 иRaven 30, испытывают трудности с наличием плазмид с обширной гомологией последовательностей, ошибочным слиянием плазмидных последовательностей или генерацией нескольких копий одной плазмиды и склонны к отсутствию малыхплазмид 58,59 (см. также рисунок 4C). В таких случаях удаление чтений низкого качества и коротких считываний может привести к решению химерных контингов.
Чтобы установить общую точность протоколов секвенирования, авторы сравнили сборки только с ONT с сборками, отполированными путём сочетания длинного и короткого чтения, что (за исключением данных PacBio) является современным золотым стандартом. Авторы также имели гелевые данные, показывающие количество присутствующих плазмид и их оценочные размеры (Таблица 8, третий столбец). Исследователи успешно собрали все 13 плазмид, найденных в 10 образцах, и получили размеры, соответствующие собранным последовательностям. Это довольно успешно, поскольку сборщики LR-последовательностей часто не смогут собрать плазмиды с структурно сложными последовательностями. На более детальном уровне парные сравнения между двумя наборами последовательностей показывали переменный уровень точности (Таблица 8). Пять из плазмидных сборок имели области без покрытия в сборках ONT, предположительно результат артефактического добавления последовательностей при сборке только ONT. Из остальных семи три показали однонуклеотидные полиморфизмы с парными различиями от 0,0023 до 0,05%, а четыре показали идеальную конкордансность. Уровень точности, по-видимому, не коррелирует с уровнем обогащения ДНК плазмиды или глубиной секвенирования, но наличие более одной плазмиды в данном образце коррелирует, возможно, потому что наличие более одной плазмиды усиливает уровень сложности последовательностей (Таблица 8). В целом, рабочий процесс разработан для оптимизации выхода и точности последовательностей плазмид. Хотя он способен собирать плазмидные последовательности, он обеспечивает переменный уровень точности на уровне нуклеотидов. Протокол может использоваться для секвенирования плазмид широкого диапазона размеров, переносит не менее 72% загрязнения хромосомной ДНК и может вместить (в зависимости от размера плазмиды и состояния клетки потока) как минимум 24 плазмиды в одной потоковой ячейке.
Раскрытие информации
Авторам нечего раскрывать.
Благодарности
Мы очень благодарны Стиву Салипанте (Университет Вашингтона) за щедрое предоставление набором клинических штаммов E. coli , опубликованных в45 годах. Эта работа была частично поддержана финансированием исследовательской поддержки для назначения директора по инновациям и предпринимательскому развитию от UCSC до MC, а также грантом Калифорнийского университета Alianza MX «Геномное профилирование изолятов туберкулёза среди высокорискованных и уязвимых групп населения в Мексике: понимание передачи и лекарственной устойчивости» для MC.
Материалы
```html
```
| Имя | Компания | Каталожный номер | Комментарии |
|---|---|---|---|
| 1.5 mL Eppendorf DNA LoBind tube | Sigma Aldrich | EP022431081 | Может быть заменен на другую марку |
| 1.5 mL tube racks | Thermo Fisher Scientific | 22-313630 | Может быть заменен на другую марку |
| 15 mL conical tubes | FALCON | 352096 | Может быть заменен на другую марку |
| 15 mL tube racks | Thermo Fisher Scientific | 8850 | Может быть заменен на другую марку |
| 2.0 mL microcentrifuge tubes | Fisherbrand | 05-408-138 | Может быть заменен на другую марку |
| 250 mL sterile flasks | PYREX | 5320 | Может быть заменен на другую марку |
| Carbenicillin | GOLD BIOTECHNOLOGY | C-103-50 | Может быть заменен на другую марку |
| Centrifuge | Eppendorf | 5424R-PR-R | Может быть заменен на другую марку |
| Centrifuge | Eppendorf | 5810R-P-R | Может быть заменен на другую марку |
| Centrifuge bottles | Sigma Aldrich | B1283-4EA | Может быть заменен на другую марку |
| Disposable Inoculating Loops: 1 µL | Fisherbrand | 22-363-595 | Может быть заменен на другую марку |
| Electronic Digital Scale | Denver Instrument | APX-2001 | Может быть заменен на другую марку |
| Ethanol | Fisher Scientific | 04-355-720 | Может быть заменен на другую марку |
| Ethanol-resistant markers | Sharpie | 37001; 37002; 37003 | Может быть заменен на другую марку |
| Flow cell (R10.4.1) | Oxford Nanopore Technologies | FLO-MIN114 | |
| Flow Cell Wash Kit | Oxford Nanopore Technologies | EXP-WSH004 | |
| Gloves | X-GEN | 44-100M | Любые нитриловые перчатки подойдут |
| Ice bucket | Thermo Fisher Scientific | 432128 | Может быть заменен на другую марку |
| Isopropanol | Fisher Scientific | BP26184 | Может быть заменен на другую марку |
| MinION Sequencing Device | Oxford Nanopore Technologies | MIN-101B | |
| Native Barcoding Kit 96 V14 | Oxford Nanopore Technologies | SQK-NBD114.96 | |
| NucleoBond Xtra MIDI Plasmid DNA Extraction Kit | Takara | 740410.5 | |
| PCR tube racks | AXYGEN | R96PCRFSP | Может быть заменен на другую марку |
| PCR tubes: (0.2 mL) | AXYGEN | PCR-02-C | Может быть заменен на другую марку |
| Program autocycler v0.5.2 | Ryan Wick / University of Melbourne | ||
| Program bcftools v1.22 | Wellcome Sanger Institute (HTSlib / Samtools team) | ||
| Program bwa v0.7.19 | Heng Li, originally at the Broad Institute | ||
| Program canu v2.3 | University of California, Davis & Pacific Biosciences collaborators | ||
| Program flye v2.9.6 | University of California, San Diego (Pavel Pevzner lab) | ||
| Program medaka v2.1.1 | Oxford Nanopore Technologies | ||
| Program metamdbg v1.2 | INRIA | ||
| Program miniasm v0.3 | Heng Li | ||
| Program minimap2 v2.28 | Heng Li | ||
| Program minipolish v0.2.0 | Ryan Wick / University of Melbourne | ||
| Program porechop v0.2.4 | Ryan Wick / University of Melbourne | ||
| Program racon v1.5.0 | Genome Institute of Singapore | ||
| Program samtools v1.22.1 | Wellcome Sanger Institute (HTSlib / Samtools project) | ||
| Qubit® 4 Fluorometer | Invitrogen | Q33226 | |
| Qubit® Assay Tubes | Invitrogen | Q32856 | |
| Rapid Barcoding Kit 24 and 96 V14 | Oxford Nanopore Technologies | SQK-RBK114.96 | |
| Set of micropipettes that dispense between 1 – 10 µL (P10), 2 – 20 µL (P20), 20 – 200 µL (P200) and 200 – 1000 µL (P1000) | RAININ | 17008648; 17008650; 17008652; 17008653 | Микропипетки должны быть градуированы |
| Spectrophotometer | Thermo Scientific | 335905P | Может быть заменен на другую марку |
| Sterilized tips for 10 µL, 200 µL and 1000 µL | Eclipse | 1011-260-000-9; 1018-260-000; 1019-260-000-9 | |
| Thermal cycler C1000 Touch | Bio-Rad | 1851196 | Может быть заменен на другую марку |
| Water bath | Thermo Scientific | 51221052 | Может быть заменен на другую марку |
Ссылки
- Finks, S. S., Martiny, J. B. H. Plasmid-encoded traits vary across environments. mBio. 14 (1), e0319122(2023).
- Ramiro-Martinez, P., de Quinto, I., Lanza, V. F., Gama, J. A., Rodriguez-Beltran, J. Universal rules govern plasmid copy number. Nat Commun. 16 (1), 6022(2025).
- Redondo-Salvo, S., et al. Pathways for horizontal gene transfer in bacteria revealed by a global map of their plasmids. Nat Commun. 11 (1), 3602(2020).
- Rodriguez-Beltran, J., DelaFuente, J., Leon-Sampedro, R., MacLean, R. C., San Millan, A. Beyond horizontal gene transfer: the role of plasmids in bacterial evolution. Nat Rev Microbiol. 19 (6), 347-359 (2021).
- Castaneda-Barba, S., Top, E. M., Stalder, T. Plasmids, a molecular cornerstone of antimicrobial resistance in the one health era. Nat Rev Microbiol. 22 (1), 18-32 (2024).
- Robertson, J., Bessonov, K., Schonfeld, J., Nash, J. H. E. Universal whole-sequence-based plasmid typing and its utility to prediction of host range and epidemiological surveillance. Microb Genom. 6 (10), (2020).
- Conlan, S., et al. Single-molecule sequencing to track plasmid diversity of hospital-associated carbapenemase-producing Enterobacteriaceae. Sci Transl Med. 6 (254), 254ra126(2014).
- Zankari, E., et al. Identification of acquired antimicrobial resistance genes. J Antimicrob Chemother. 67 (11), 2640-2644 (2012).
- Eyre, D. W., et al. WGS to predict antibiotic MICs for Neisseria gonorrhoeae. J Antimicrob Chemother. 72 (7), 1937-1947 (2017).
- Arredondo-Alonso, S., Willems, R. J., van Schaik, W., Schurch, A. C. On the (im)possibility of reconstructing plasmids from whole-genome short-read sequencing data. Microb Genom. 3 (10), e000128(2017).
- Rhoads, A., Au, K. F. PacBio sequencing and its applications. Genomics Proteomics Bioinformatics. 13 (5), 278-289 (2015).
- Zhang, T., et al. Nanopore sequencing: flourishing in its teenage years. J Genet Genomics. 51 (12), 1361-1374 (2024).
- González, A., Fullaondo, A., Odriozola, A. Why are long-read sequencing methods revolutionizing microbiome analysis? Microorganisms. 13 (8), (2025).
- Wick, R. R., Holt, K. E. Polypolish: Short-read polishing of long-read bacterial genome assemblies. PLoS Comput Biol. 18 (1), e1009802(2022).
- Delahaye, C., Nicolas, J. Sequencing DNA with nanopores: Troubles and biases. PLoS One. 16 (10), e0257521(2021).
- Watson, M., Warr, A. Errors in long-read assemblies can critically affect protein prediction. Nat Biotechnol. 37 (2), 124-126 (2019).
- De Maio, N., et al. Comparison of long-read sequencing technologies in the hybrid assembly of complex bacterial genomes. Microb Genom. 5 (9), (2019).
- Lerminiaux, N., Fakharuddin, K., Mulvey, M. R., Mataseje, L. Do we still need Illumina sequencing data? Evaluating Oxford Nanopore Technologies R10.4.1 flow cells and the Rapid v14 library prep kit for Gram-negative bacteria whole genome assemblies. Can J Microbiol. 70 (5), 178-189 (2024).
- Dabernig-Heinz, J., et al. A multicenter study on accuracy and reproducibility of nanopore sequencing-based genotyping of bacterial pathogens. J Clin Microbiol. 62 (9), e0062824(2024).
- Sereika, M., et al. Oxford Nanopore R10.4 long-read sequencing enables the generation of near-finished bacterial genomes from pure cultures and metagenomes without short-read or reference polishing. Nat Methods. 19 (7), 823-826 (2022).
- Wick, R. R., Judd, L. M., Holt, K. E. Assembling the perfect bacterial genome using Oxford Nanopore and Illumina sequencing. PLoS Comput Biol. 19 (3), e1010905(2023).
- Paterson, D. L. Resistance in gram-negative bacteria: enterobacteriaceae. Am J Med. 119 (1), discussion S62-70 S20-S28 (2006).
- Peter, S., et al. Tracking of antibiotic resistance transfer and rapid plasmid evolution in a hospital setting by nanopore sequencing. mSphere. 5 (4), (2020).
- George, S., et al. Resolving plasmid structures in Enterobacteriaceae using the MinION nanopore sequencer: assessment of MinION and MinION/Illumina hybrid data assembly approaches. Microb Genom. 3 (8), e000118(2017).
- Dong, N., Yang, X., Zhang, R., Chan, E. W., Chen, S. Tracking microevolution events among ST11 carbapenemase-producing hypervirulent Klebsiella pneumoniae outbreak strains. Emerg Microbes Infect. 7 (1), 146(2018).
- Lemon, J. K., Khil, P. P., Frank, K. M., Dekker, J. P. Rapid nanopore sequencing of plasmids and resistance gene detection in clinical isolates. J Clin Microbiol. 55 (12), 3530-3543 (2017).
- Linde, J., et al. Comparison of Illumina and Oxford Nanopore Technology for genome analysis of Francisella tularensis, Bacillus anthracis, and Brucella suis. BMC Genomics. 24 (1), 258(2023).
- Bickhart, D. M., et al. Generating lineage-resolved, complete metagenome-assembled genomes from complex microbial communities. Nat Biotechnol. 40 (5), 711-719 (2022).
- Koren, S., et al. Canu: scalable and accurate long-read assembly via adaptive k-mer weighting and repeat separation. Genome Res. 27 (5), 722-736 (2017).
- Vaser, R., Sikic, M. Time-and memory-efficient genome assembly with Raven. Nat Comput Sci. 1 (5), 332-336 (2021).
- Lynch, M. D., Neufeld, J. D. Ecology and exploration of the rare biosphere. Nat Rev Microbiol. 13 (4), 217-229 (2015).
- Kruasuwan, W., et al. Comparative evaluation of commercial DNA isolation approaches for nanopore-only bacterial genome assembly and plasmid recovery. Sci Rep. 14 (1), 27672(2024).
- Ulrich, J. U., et al. Nanopore adaptive sampling effectively enriches bacterial plasmids. mSystems. 9 (3), e0094523(2024).
- Wick, R. R., Howden, B. P., Stinear, T. P. Autocycler: long-read consensus assembly for bacterial genomes. Bioinformatics. 41 (9), (2025).
- NucleoBond Xtra Plasmid DNA Purification User Manual. , Takara Bio USA. Available from: https://www.takarabio.com/documents/User%20Manual/NucleoBond%20Xtra%20Plasmid%20DNA%20Purification%20User%20Manual_Rev_15.pdf?srsltid=AfmBOorkdYVlr34yclNUgmBCn4imrn-gbvTafmkD2Yrnnch6fH-K_VwZ (2019).
- Mota-Bravo, L., et al. Detection of horizontal gene transfer mediated by natural conjugative plasmids in E. coli. J Vis Exp. (193), (2023).
- Hancock, V., Witso, I. L., Klemm, P. Biofilm formation as a function of adhesin, growth medium, substratum, and strain type. Int J Med Microbiol. 301 (7), 570-576 (2011).
- Hung, C., et al. Escherichia coli biofilms have an organized and complex extracellular matrix structure. mBio. 4 (5), e00645-e00713 (2013).
- Qubit 4 assays quick reference (Pub. No. MAN0017210 C.0). , Thermo Fisher Scientific. (2025).
- Rapid barcoding sequencing kit 96 v14. , Oxford Nanopore Technologies. Available from: https://store.nanoporetech.com/us/rapid-barcoding-sequencing-kit-96-v14.html (2026).
- Schwengers, O., et al. Bakta: rapid and standardized annotation of bacterial genomes via alignment-free sequence identification. Microb Genom. 7 (11), (2021).
- Seemann, T. Prokka: rapid prokaryotic genome annotation. Bioinformatics. 30 (14), 2068-2069 (2014).
- Singh, H., et al. Integrons: the hidden architects of bacterial adaptation, evolution, and the challenges of antimicrobial resistance. Antonie Van Leeuwenhoek. 118 (7), 90(2025).
- Redondo-Salvo, S., et al. COPLA, a taxonomic classifier of plasmids. BMC Bioinformatics. 22 (1), 390(2021).
- Salipante, S. J., et al. Large-scale genomic sequencing of extraintestinal pathogenic Escherichia coli strains. Genome Res. 25 (1), 119-128 (2015).
- Couturier, A., et al. Real-time visualisation of the intracellular dynamics of conjugative plasmid transfer. Nat Commun. 14 (1), 294(2023).
- Wick, R. R., Schultz, M. B., Zobel, J., Holt, K. E. Bandage: interactive visualization of de novo genome assemblies. Bioinformatics. 31 (20), 3350-3352 (2015).
- Grant, J. R., et al. Proksee: in-depth characterization and visualization of bacterial genomes. Nucleic Acids Res. 51 (W1), W484-W492 (2023).
- MacKenzie, M., Argyropoulos, C. An Introduction to nanopore sequencing: past, present, and future considerations. Micromachines (Basel). 14 (2), (2023).
- Emiliani, F. E., Hsu, I., McKenna, A. Multiplexed assembly and annotation of synthetic biology constructs using long-read nanopore sequencing. ACS Synth Biol. 11 (7), 2238-2246 (2022).
- Brown, S. D., Dreolini, L., Wilson, J. F., Balasundaram, M., Holt, R. A. Complete sequence verification of plasmid DNA using the Oxford Nanopore Technologies' MinION device. BMC Bioinformatics. 24 (1), 116(2023).
- Hall, J. P. J., Botelho, J., Cazares, A., Baltrus, D. A. What makes a megaplasmid? Philos Trans R Soc Lond B Biol Sci. 377 (1842), 20200472(2022).
- Brown Kav, A., Benhar, I., Mizrahi, I. A method for purifying high-quality and high-yield plasmid DNA for metagenomic and deep sequencing approaches. J Microbiol Methods. 95 (2), 272-279 (2013).
- Mumm, C., et al. Multiplexed long-read plasmid validation and analysis using OnRamp. Genome Res. 33 (5), 741-749 (2023).
- Balbuena-Alonso, M. G., et al. Genomic analysis of plasmid content in food isolates of E. coli strongly supports its role as a reservoir for the horizontal transfer of virulence and antibiotic resistance genes. Plasmid. 123-124, 102650(2022).
- Zhao, W., et al. Oxford nanopore long-read sequencing enables the generation of complete bacterial and plasmid genomes without short-read sequencing. Front Microbiol. 14, 1179966(2023).
- Wick, R. R., et al. Trycycler: consensus long-read assemblies for bacterial genomes. Genome Biol. 22 (1), 266(2021).
- Johnson, J., Soehnlen, M., Blankenship, H. M. Long read genome assemblers struggle with small plasmids. Microb Genom. 9 (5), (2023).
- Boostrom, I., Portal, E. A. R., Spiller, O. B., Walsh, T. R., Sands, K. Comparing long-read assemblers to explore the potential of a sustainable low-cost, low-infrastructure approach to sequence antimicrobial resistant bacteria with Oxford Nanopore sequencing. Front Microbiol. 13, 796465(2022).
Перепечатки и разрешения
