В данной работе предлагается метод мониторинга безопасности производственной линии, интегрирующий You Only Look Once версии 11 (YOLOv11) с сверточными нейронными сетями. Метод обеспечил среднюю точность при пороге пересечения над объединением 0,5 (mAP@0.5) на уровне 0,91, mAP@0.5:0.95 на уровне 0,82 и скорость 120 кадров в секунду на графическом процессоре, что превосходит показатели оцениваемых базовых моделей.
Для просмотра этого контента требуется подписка на JoVE. Войдите или начните свой бесплатный пробный период.
Методическая статья
Мониторинг безопасности производственной линии в режиме реального времени с использованием детектирования объектов и улучшения признаков на основе глубокого обучения
В этой статье
Краткое содержание
Аннотация
С развитием Индустрии 4.0 уровни автоматизации и интеллектуализации производственных линий значительно повысились, что предъявляет более высокие требования к производительности в реальном времени, точности и безопасности мониторинга. Традиционные системы мониторинга, основанные на ручных проверках или простых решениях на базе пороговых значений, обычно характеризуются медленным временем отклика, высоким уровнем ложных тревог и ограниченными интеллектуальными возможностями. В связи с этим в данной работе предлагается система мониторинга безопасности производственной линии, объединяющая You Only Look Once версии 11 (YOLOv11) с сверточной нейронной сетью (CNN). Сначала полученные изображения подвергались предварительной обработке. Затем с помощью YOLOv11 в реальном времени идентифицировались работники, оборудование и потенциальные опасности. Далее была представлена усовершенствованная сеть CNN с многомасштабным слиянием признаков и механизмами внимания для улучшения возможностей извлечения признаков для малых и перекрытых объектов. В завершение результаты детектирования объединялись с признаками, усиленными CNN, для оценки состояния безопасности. Эксперименты проводились с использованием собственного набора данных по безопасности производственных линий с применением оптимизатора стохастического градиентного спуска (SGD) с моментом 0.9, начальной скоростью обучения 0.01, затуханием весов 0.0005, косинусным отжигом скорости обучения, размером пакета 32 и обучением в течение 200 эпох. В качестве метрик оценки для сравнения с базовыми алгоритмами использовались mAP@0.5 и скорость детектирования в кадрах в секунду (FPS). Результаты показывают, что предложенная система достигла mAP@0.5 равного 0.91 и скорости детектирования 120 FPS. Она также продемонстрировала стабильную работу в сложных условиях, таких как затенение и переменное освещение, что подтверждает ее эффективность и потенциал практического применения в мониторинге безопасности производственных линий.
Введение
В современном промышленном производстве безопасность является краеугольным камнем обеспечения эффективности производства и благополучия персонала. Среда производственной линии обычно включает высокоскоростное механическое оборудование, сложные технологические процессы и совместные операции, охватывающие множество задач. Любая, даже незначительная потенциальная угроза безопасности может привести к серьезным производственным авариям, влекущим за собой значительные экономические потери и даже летальные исходы. Следовательно, для повышения безопасности промышленного производства крайне важно создать эффективную интеллектуальную систему мониторинга безопасности в режиме реального времени1,2.
Традиционные методы мониторинга безопасности в основном полагаются на ручное видеонаблюдение и различные датчики (такие как инфракрасные датчики, датчики дыма и вибрации)3. Ручной мониторинг не только неэффективен, но и подвержен пропускам обнаружения из-за усталости персонала, а также не может обеспечить непрерывный и всесторонний охват. Хотя датчики могут выполнять определенную функцию раннего предупреждения, их диапазон обнаружения ограничен, и они чувствительны к воздействиям окружающей среды, что приводит к серьезным проблемам с ложными срабатываниями4. Интеллектуальные системы мониторинга становятся объектом растущего исследовательского интереса. Анализ видеопотока в реальном времени с использованием алгоритма глубокого обучения позволяет автоматически идентифицировать аномальные события, небезопасное поведение и потенциальные опасности, что значительно повышает интеллектуальный уровень системы мониторинга4,5.
Детектирование объектов является основной технологией интеллектуального мониторинга. Алгоритмы серии You Only Look Once (YOLO), представляющие одноэтапные детекторы объектов, демонстрируют значительные преимущества. С YOLOv1 по YOLOv8 данная группа алгоритмов подвергалась непрерывному развитию, включая усовершенствование архитектуры сети, функций потерь и методологии обучения, среди прочего6,7. В частности, YOLOv11 позволила достичь более высокой точности детектирования при сохранении высокой частоты кадров, особенно при работе со сложным фоном и плотно расположенными целями8.
Однако, несмотря на отличные результаты в задачах общего детектирования объектов, YOLOv11 все еще сталкивается с трудностями в специфических сценариях мониторинга безопасности на производственных линиях9. Например, точность детектирования YOLOv11 может снижаться, когда работники частично перекрыты оборудованием или когда знаки безопасности имеют малый размер и по цвету очень близки к фону. Это требует от модели более мощных возможностей извлечения признаков и семантического понимания10.
Сверточные нейронные сети (CNN) обладают мощными возможностями извлечения признаков из изображений11. Благодаря проектированию более глубоких и сложных архитектур сетей, CNN могут изучать более богатые и абстрактные признаки изображений. Сочетание CNN с YOLOv11 позволяет использовать возможности быстрого обнаружения YOLOv11 и глубокое извлечение признаков CNN, что обеспечивает создание более надежной и интеллектуальной системы мониторинга безопасности.
На основании этого в данной работе предлагается система мониторинга безопасности производственной линии с использованием YOLOv11 и CNN. Инновационные аспекты данного исследования включают: (1) предложение архитектуры глубокого слияния YOLOv11 и улучшенной CNN; (2) внедрение многомасштабного слияния признаков и комбинированного механизма внимания для улучшения распознавания ключевых признаков безопасности; и (3) подтверждение преимуществ производительности модели на собственном наборе данных со сложными сценами.
Разработка алгоритмов серии YOLO
С момента первого представления алгоритма You Only Look Once (YOLO) компанией Redmon et al. в 2015 году12 он вызвал значительный интерес. В отличие от двухэтапных детекторов, опирающихся на предложения регионов, YOLO рассматривает обнаружение объектов как задачу регрессии. Напрямую предсказывая классы и положения объектов на изображении, YOLO заметно повышает скорость обнаружения, что делает его подходящим для использования в режиме реального времени13.
Как основополагающая работа в этой серии, YOLOv1 впервые реализует сквозное обнаружение целей14. Принцип работы YOLOv1 заключается в разделении входного изображения на сетку, где каждая ячейка сетки, обычно имеющая формат S × S, отвечает за обнаружение объектов, находящихся в ее границах.
В частности, выходные данные YOLOv1 представляют собой тензор. В структуре S × S × (B × 5 + C) прогноз для каждого ограничивающего прямоугольника содержит 5 элементов: координаты центральной точки (x,y), ширину w, высоту h и степень достоверности c. Процесс вычисления проиллюстрирован в уравнении (1):
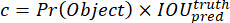 (1)
Среди них Pr(Объект) представляет собой вероятность наличия цели в сетке, и пересечение над объединением представляет собой отношение площади пересечения к площади объединения (IoU) между предсказанной ограничивающей рамкой и истинной рамкой (ground-truth). Каждая ячейка сетки также предсказывает набор вероятностей классов, Pr представляющий вероятность того, что цель принадлежит к i-го класса в присутствии целевого объекта. Функция потерь YOLOv1 состоит из трех основных компонентов: потерь при прогнозировании координат, потерь при оценке достоверности и потерь при прогнозировании категории15.
В YOLOv2 представлены пакетная нормализация (Batch Normalization), классификатор высокого разрешения и стратегия многомасштабного обучения, которые повышают стабильность и точность16. В YOLOv3 в качестве базовой сети используется Darknet-53, а для улучшения детектирования целей применяется концепция сети пирамидальных признаков (Feature Pyramid Network, FPN)17.
В YOLOv4 была проведена многочисленная оптимизация на базе YOLOv3; для дальнейшего повышения производительности модели были внедрены такие технологии, как Cross Stage Partial Network (CSPNet)18, Path Aggregation Network (PANet)19 и мозаичное дополнение данных (Mosaic data enhancement). YOLOv5 внесла значительный вклад в инженерную реализацию, предложив более эффективное и удобное в использовании исполнение20.
В последние годы серия YOLO продолжает развиваться, один за другим выходят такие версии, как YOLOv6, YOLOv7 и YOLOv8. Благодаря внедрению структуры Extended Efficient Layer Aggregation Network (E-ELAN) и методов репараметризации модели, YOLOv7 достигает новых прорывов как в скорости, так и в точности. Эти улучшения не только повышают эффективность обучения признаков, но и оптимизируют производительность вывода сети, позволяя YOLOv7 превзойти предыдущие версии и многие основные детекторы в различных задачах обнаружения объектов в режиме реального времени. YOLOv8 дополнительно оптимизирует структуру сети, использует безъякорный (anchor-free) дизайн, упрощает модель и повышает ее обобщающую способность21.
Основываясь на преимуществах предыдущих версий, модель YOLOv11, использованная в данном исследовании, была оптимизирована для сложных промышленных сценариев. Основные улучшения включают сеть извлечения признаков, более эффективный модуль слияния признаков и более надежный дизайн функции потерь. Эти доработки позволяют YOLOv11 лучше справляться с перекрытиями объектов, малыми целями и сложными фонами в условиях производства. YOLOv11 представляет собой версию серии YOLO, выпущенную компанией Ultralytics. По сравнению с YOLOv8, в ней усовершенствованы модуль C3K2 и путь слияния признаков, а также внедрена стратегия адаптивных якорных рамок (anchor box), что обеспечивает более высокую робастность детектирования в промышленных условиях.
Основы и развитие сверточных нейронных сетей (CNN)
Сверточная нейронная сеть (CNN) является ключевой моделью, которая оказала глубокое влияние на успех глубокого обучения в области компьютерного зрения. Её работа основана на извлечении локальных признаков изображения с помощью операций свертки и последующем снижении размерности признаков с помощью операций пулинга, что позволяет достичь иерархической абстракции изображения22.
Типичная СНС состоит из нескольких сверточных слоев, слоев пулинга и полносвязных слоев. Сверточный слой сканирует входное изображение с помощью ядра свертки, вычисляет скалярные произведения по локальным областям и формирует карту признаков. Процесс вычисления показан в уравнении (2):
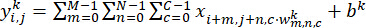 (2)
Где x — входное изображение, wk и bk — вес и смещение ядра свертки соответственно, а  — значения выходной карты признаков в позиции (i,j). В слое пулинга обычно используется Max Pooling (макспулинг) или Average Pooling (средний пулинг). Полносвязный слой отвечает за извлечение признаков и прогнозирование вероятностей классификации.
На основании этого в данной работе разработан модуль усиления признаков CNN для YOLOv11, который состоит из двух параллельных ветвей: ветви многомасштабной свертки, использующей ядра свертки 3 × 3 и 5 × 5 для извлечения многомасштабных признаков, и ветви внимания, в которой последовательно соединены модули канального внимания (Squeeze-and-Excitation) и пространственного внимания для усиления дискриминационных признаков ключевых объектов. Выходы двух ветвей объединяются путем поэлементного сложения; соответствующая функция потерь усиления признаков представлена в формуле (3):
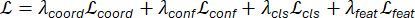 (3)
Lcoord — функция потерь регрессии координат ограничивающей рамки; Lconf — функция потерь целевой уверенности; Lcls — функция потерь классификации категорий; Lfeat — функция потерь усиления признаков, используемая для ограничения дискриминативных признаков малых и перекрытых целей, извлекаемых модулем усиления CNN; λcoord, λconf, λcls, λfeat — весовые коэффициенты соответствующих членов функции потерь. Для данной задачи установлено значение λfeat = 0.05, а остальные веса сбалансированы в соответствии с требованиями задачи детектирования.
Классические структуры CNN, такие как VGGNet23 и ResNet24, достигли больших успехов в задачах классификации изображений. Среди этих архитектур ResNet эффективно решает проблему затухающего градиента при обучении глубоких сетей, что облегчает создание более глубоких и сложных сетевых структур.
В задачах детектирования объектов CNN обычно используется в качестве экстрактора признаков (backbone). Например, Darknet, cross-stage partial Darknet (CSPDarknet) и другие архитектуры в серии алгоритмов YOLO построены на базе CNN25. Для расширения возможностей извлечения признаков исследователи предложили множество усовершенствованных структур CNN. Так, модуль Inception извлекает признаки параллельно с помощью многомасштабных сверточных ядер. DenseNet улучшает повторное использование признаков за счет плотных соединений. Сеть Squeeze-and-Excitation адаптивно регулирует значимость каналов признаков с помощью механизмов внимания26.
В данном исследовании мы разработали усовершенствованный модуль CNN для расширения возможностей извлечения признаков в YOLOv11. Этот модуль объединяет многомасштабное слияние признаков с механизмом внимания для более эффективного захвата ключевой информации о безопасности в сценариях производственных линий.
Применение глубокого обучения в мониторинге промышленной безопасности
Глубокое обучение получило значительное распространение в сфере мониторинга промышленной безопасности. Алгоритмы на базе CNN используются для определения правильности ношения защитных касок работниками, обнаружения несанкционированных проникновений в опасные зоны и мониторинга состояния неисправного оборудования27.
В области распознавания поведения 3D CNN и рекуррентные нейронные сети используются для анализа операционного поведения работников и выявления потенциально небезопасных действий. Например, путем анализа последовательностей поз работников можно определить, нарушают ли они правила техники безопасности28.
YOLO и Faster R-CNN широко используются для обнаружения персонала и оборудования в видеопотоках наблюдения в режиме реального времени. Например, в литературе была предложена система обнаружения защитных касок в реальном времени на базе YOLOv5, которая эффективно повышает интеллектуальный уровень управления безопасностью на строительных площадках29.
Несмотря на определенный прогресс в текущих исследованиях, ряд проблем остается нерешенным. Во-первых, для промышленных сцен типичны сложное освещение, окклюзия и помехи фона, что предъявляет строгие требования к робастности алгоритма. Во-вторых, ключевым требованием является работа в режиме реального времени, поэтому алгоритм должен обеспечивать высокую скорость вывода при сохранении точности. Наконец, существующие исследования сосредоточены преимущественно на обнаружении в рамках одной задачи и характеризуются недостаточным изучением слияния многоисточниковой информации и комплексного анализа30.
В данном исследовании предлагаемая комбинированная модель на базе YOLOv11 и CNN направлена на решение вышеупомянутых проблем и обеспечение комплексного мониторинга рисков безопасности на производственной линии в режиме реального времени за счет расширения возможностей извлечения и объединения признаков.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Протокол
Алгоритмы YOLOv11 и CNN
Общая архитектура системы
Система мониторинга безопасности производственной линии, предложенная в данной работе, основана на гибридной архитектуре, сочетающей YOLOv11 с усовершенствованной CNN для обеспечения высокоточного и высокоскоростного мониторинга безопасности в режиме реального времени. Как показано на Рисунке 1, система в основном состоит из модуля предварительной обработки входных данных, модуля детектирования объектов YOLOv11, модуля улучшения признаков CNN и модуля принятия совместных решений. Входное изображение сначала нормализуется и дополняется модулем предварительной обработки для повышения обобщающей способности модели. Затем с помощью базовой сети CSPDarknet извлекаются признаки, а модуль быстрого пространственного пирамидального пулинга (SPPF) расширяет поле восприятия. После апсэмплинга происходит слияние многомасштабных признаков, к которым последовательно применяются механизмы канального и пространственного внимания для дальнейшего усиления дискриминативного представления ключевых целей. Модуль улучшения признаков CNN встраивается после выходов слоев C3, C4 и C5 базовой сети YOLOv11, получая многомасштабные карты признаков размерами 80 × 80 × 256, 40 × 40 × 512 и 20 × 20 × 1,024 соответственно. Модуль улучшения признаков CNN дополнительно оптимизирует извлечение признаков для малых и перекрытых объектов. Наконец, модуль принятия совместных решений объединяет результаты детектирования YOLOv11 с признаками, улучшенными с помощью CNN, и совместно оптимизирует их с помощью специально разработанной функции потерь для вывода точного местоположения, категории и показателя достоверности цели.
Система детектирования YOLOv11
В YOLOv11 был представлен ряд критических улучшений, использующих преимущества одноэтапной архитектуры детектирования серии YOLO. Ее архитектура разделена на три основных компонента: базовую сеть (backbone), сеть слияния признаков и детектирующую головку. Базовая сеть использует усовершенствованную структуру CSPDarknet. Сеть слияния признаков включает в себя локальные межэтапные связи и глубинно-разделимые свертки, опираясь на принципы сетей пирамид признаков и сетей агрегации путей для эффективного объединения многомасштабных признаков.
Модуль улучшения признаков
Модуль улучшения признаков предназначен для повышения чувствительности модели к ключевым признакам безопасности. Он обрабатывает карты признаков, формируемые каждым слоем базовой сети YOLOv11, объединяя информацию на разных масштабах с помощью операций апсэмплинга (увеличения разрешения) и даунсэмплинга (уменьшения разрешения). В частности, многомасштабная ветвь фиксирует разнообразие пространственных масштабов, в то время как ветвь внимания динамически усиливает ключевые каналы и позиционные отклики. Эти две ветви действуют не независимо, а дополняют друг друга и объединяются посредством остаточных связей и рекалибровки признаков. Карта признаков, обработанная модулем улучшения на каждом масштабе, приводится в соответствие с количеством каналов исходной карты признаков с помощью свертки 1 × 1, а затем объединяется с исходной картой признаков YOLOv11 путем поэлементного сложения. Далее объединенная карта признаков подается в последующую сеть пирамиды признаков (FPN) для многомасштабного слияния, что формирует иерархическое представление признаков безопасности. Для обеспечения бесшовной интеграции между модулями применяется стратегия сквозного совместного обучения, при этом функция потерь состоит из потерь детектирования YOLOv11 и потерь улучшения признаков модуля CNN.
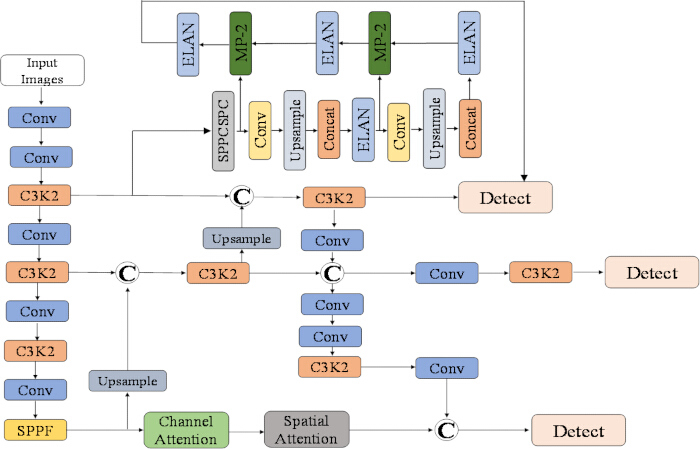
Рисунок 1. Алгоритм YOLOv11-CNN. Модуль улучшения признаков предназначен для повышения чувствительности модели к критическим признакам безопасности. Он обрабатывает карты признаков из различных слоев основной сети (backbone) YOLOv11, объединяя признаки разных масштабов с помощью операций повышения (upsampling) и понижения (downsampling) дискретизации. Кроме того, в него интегрированы механизмы канального и пространственного внимания. Для обеспечения бесшовной интеграции модулей YOLOv11 и CNN применяется стратегия совместного обучения. В процессе обучения параметры обоих модулей оптимизируются сквозным методом (end-to-end). Функция потерь объединяет потери детектирования YOLOv11 с потерями улучшения признаков модуля CNN. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Результаты
Для проверки эффективности предложенной комбинированной модели YOLOv11 и CNN в мониторинге безопасности производственной линии был сформирован набор данных, охватывающий различные сценарии опасных ситуаций. Данный набор содержит 12 000 изображений сцен на производственной линии, разделенных на обучающую, валидационную и тестовую выборки в соотношении 7:1,5:1,5 с фиксированным случайным числом (seed) 42. Он охватывает различные условия работы, включая стандартное освещение, недостаточное освещение, частичное перекрытие, с...
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Обсуждение
Экспериментальные результаты показывают, что предложенная комбинированная модель YOLOv11–CNN повышает точность детектирования и производительность в реальном времени при мониторинге безопасности производственных линий. Благодаря эффективному одноэтапному детектированию YOLOv11 и улучшению признаков с помощью модуля CNN, система идентифицировала рабочих, оборудование и опасные зоны в условиях сложного освещения и перекрытий. Многомасштабное слияние признаков и механизмы внимания расширили возможность фокусировки на ключев...
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Раскрытие информации
Авторы заявляют об отсутствии конфликта интересов.
Благодарности
Данная работа была частично профинансирована Фондом научных исследований для высококвалифицированных специалистов Университета Тайчжоу в рамках проекта «Исследование ключевых технологий прецизионного детектирования для интеллектуального производства» (TZXY2020QDJJ006).
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Материалы
| Имя | Компания | Каталожный номер | Комментарии |
|---|---|---|---|
| COCO API | Н/Д | Инструмент оценки, используемый для анализа точности обнаружения целей и статистического анализа. | |
| CUDA 11.4 | NVIDIA | Н/Д | Платформа параллельных вычислений, используемая с фреймворком PyTorch 1.12. |
| Edge TPU | Н/Д | Платформа развертывания, используемая для тестирования задержки и энергопотребления; зафиксированная задержка составила 18 ms, а энергопотребление — 15 W. | |
| Устройство граничных вычислений Jetson Xavier | NVIDIA | Устройство граничных вычислений, используемое для тестирования пропускной способности; зафиксированная скорость обработки составила 70 FPS с задержкой 99-го перцентиля в пределах 50 ms. | |
| Графический процессор NVIDIA Tesla V100 GPU | NVIDIA | GPU, используемый в сервере для обучения/оценки. | |
| PyTorch 1.12 | Н/Д | Фреймворк глубокого обучения, используемый для обучения и оценки модели. | |
| scikit-learn | Н/Д | Инструмент оценки/статистического анализа, используемый для оценки модели. | |
| Собственный набор данных по безопасности производственной линии | Н/Д | Н/Д | Набор данных из 12 000 изображений сцен производственной линии в формате VOC, охватывающий стандартное освещение, недостаточное освещение, частичное перекрытие, сильное перекрытие, размытие при движении и сложные фоны; шесть категорий аннотаций: рабочие, защитные каски, роботизированные манипуляторы, опасные зоны, инструменты и транспортные средства. |
| Сервер для обучения | Сервер, оснащенный графическим процессором NVIDIA Tesla V100 и операционной системой Ubuntu 20.04. | ||
| Операционная система Ubuntu 20.04 | Н/Д | Операционная система, используемая на сервере для обучения/оценки. | |
| Формат аннотаций VOC | Н/Д | Н/Д | Формат аннотации, используемый для собственного набора данных по безопасности производственной линии. |
| Модель обнаружения объектов YOLOv11 | Ultralytics | Н/Д | Модель обнаружения объектов, используемая для обнаружения рабочих, оборудования и потенциальных опасностей в режиме реального времени. |
Ссылки
- Ramadan MNA, Ali MAH, Jaber H, Alkhedher M. Blockchain-secured IoT-federated learning for industrial air pollution monitoring: a mechanistic approach to exposure prediction and environmental safety. Ecotoxicol Environ Saf. 2025;300:118442.
- Ahn J, et al. SafeFac: video-based smart safety monitoring for preventing industrial work accidents. Expert Syst Appl. 2023;215:119397.
- Natha S, et al. A scalable and generalized deep ensemble model for road anomaly detection in surveillance videos. Comput Mater Contin. 2024;81(3):3707-3729.
- Diallo AR, Homri L, Dantan JY. Reducing false alarms in fault detection: a comparative analysis between conformal prediction and classical methods applied to PCA and autoencoders. J Process Control. 2025;152:103495.
- Cheng X, Han Y, Zhang W. Development of intelligent monitoring system for soil erosion in pipeline engineering based on deep learning. Comput Electr Eng. 2025;126:110432.
- Yan H, et al. A global feature fusion and adaptive optimization method to enhance detection accuracy and computational efficiency based on YOLOv8. Alexandria Eng J. 2025;129:538-552.
- Samma H, Al-Azani S, El-Ferik S. UAV-based real-time face detection using YOLOv7. Transp Res Procedia. 2025;84:331-338.
- Gong X, Yu J, Zhang H, Dong X. AED-YOLO11: a small object detection model based on YOLO11. Digit Signal Process. 2025;166:105411.
- Li R, Xiao K, Lin S, Wu Z. Enhancing aquatic ecosystem monitoring through fish jumping behavior analysis and YOLOv5: applications in freshwater fish identification. J Environ Manage. 2025;391:126413.
- Zhang D, Gao Q, Chen Z, Lin Z. Semantic feature refinement of YOLO for human mask detection in dense crowded. J Vis Commun Image Represent. 2025;107:104399.
- Choi MJ, Ku DG, Lee SJ. Integrated YOLO and CNN algorithms for evaluating degree of walkway breakage. KSCE J Civ Eng. 2022;26(8):3570-3577.
- Li Y, et al. Underwater acoustic intelligent spectrum sensing with multimodal data fusion: an Mul-YOLO approach. Future Gener Comput Syst. 2025;173:107880.
- Jiang D, et al. Real-time tracker of chicken for poultry based on attention mechanism-enhanced YOLO-Chicken algorithm. Comput Electron Agric. 2025;237:110640.
- Yang X, et al. Automated concrete bridge damage detection using an efficient Vision Transformer-enhanced anchor-free YOLO. Engineering. 2025;51:311-326.
- Fuertes D, et al. People detection with omnidirectional cameras using a spatial grid of deep learning foveatic classifiers. Digit Signal Process. 2022;126:103473.
- Deepak GD, Bhat SK. Maximizing YOLOv2 efficiency: a study on multiclass detection of indoor objects. Results Eng. 2025;26:105405.
- Zhang C, et al. Personnel target detection in infrared environment based on YOLOv3-tinier network and its FPGA implementation. Infrared Phys Technol. 2025;150:106015.
- Zhou Y. A YOLO-NL object detector for real-time detection. Expert Syst Appl. 2024;238:122256.
- Asadollahpour E, Rahmannejad R, Asghari A, Abdollahipour A. Back analysis of closure parameters of Panet equation and Burger's model of Babolak water tunnel conveyance. Int J Rock Mech Min Sci. 2014;68:159-166.
- Anguchamy KK, Palanisamy V. Real-time object detection using improvised YOLOv4 and feature mapping technique for autonomous driving. Expert Syst Appl. 2025;280:127452.
- Khan AT, Jensen SM, Khan AR. Advancing precision agriculture: a comparative analysis of YOLOv8 for multi-class weed detection in cotton cultivation. Artif Intell Agric. 2025;15(2):182-191.
- Raushan R, Singhal V, Jha RK. Damage detection in concrete structures with multi-feature backgrounds using the YOLO network family. Autom Constr. 2025;170:105887.
- Zarboubi M, Bellout A, Chabaa S, Dliou A. CustomBottleneck-VGGNet: advanced tomato leaf disease identification for sustainable agriculture. Comput Electron Agric. 2025;232:110066.
- Xie F, et al. Wine variety traceability by data fusion of near-infrared spectroscopy and mid-infrared spectroscopy combined with GAF and ResNet. Chemom Intell Lab Syst. 2025;264:105468.
- Huang J, et al. Estimation of the orientation of potatoes and detection bud eye position using potato orientation detection you only look once with fast and accurate features for the movement strategy of intelligent cutting robots. Eng Appl Artif Intell. 2025;142:109923.
- Huang Y, et al. Human intrusion detection with distributed fiber optic data based on Squeeze-Excitation and hierarchical connection enhancement network. Opt Fiber Technol. 2025;94:104297.
- Qi R, et al. Mechanical fault diagnosis of on-load tap changers using time-frequency vibration analysis and a lightweight YOLO model. Measurement. 2025;256:118441.
- Yan J, Wang Z. YOLO V3+VGG16-based automatic operations monitoring and analysis in a manufacturing workshop under Industry 4.0. J Manuf Syst. 2022;63:134-142.
- Nazli NANM, et al. A real-time system for detecting personal protective equipment compliance using deep learning model YOLOv5. Procedia Comput Sci. 2024;245:647-656.
- Xiao Y, et al. The prediction of kiwi quality attributes based on multi-source data fusion comprehensive analysis model using HSI and FHSI. J Food Compos Anal. 2025;144:107645.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.