В данном исследовании представлена платформа для автоматизированного прототипирования пользовательских интерфейсов, объединяющая принципы когнитивного дизайна, перцептивное моделирование цвета и глубокое обучение. Система улучшает доступность, четкость макета, гармонию цветов и согласованность между различными экранами, что позволяет создавать целостные, ориентированные на пользователя интерфейсы.
Для просмотра этого контента требуется подписка на JoVE. Войдите или начните свой бесплатный пробный период.
Исследовательская статья
Фреймворк автоматизированного прототипирования пользовательского интерфейса, интегрирующий принципы когнитивного и визуального дизайна для повышения юзабилити и четкости макета
В этой статье
Краткое содержание
Аннотация
Эффективный дизайн пользовательского интерфейса (UI) требует гармоничного баланса между визуальной привлекательностью, когнитивным удобством и согласованностью макета. Однако современные подходы к автоматической генерации UI сосредоточены преимущественно на визуальном облике или детектировании компонентов и лишены единой структуры, которая объединяла бы когнитивные принципы, интеллектуальный подбор цвета и структурный анализ. Кроме того, существующие методы характеризуются ограниченной обобщающей способностью макета, низкой интерпретируемостью, статичным выбором цвета и несогласованностью поведения элементов на разных экранах. В связи с этим в данной работе предлагается платформа для автоматического прототипирования UI, которая объединяет детектирование компонентов на основе быстрой региональной сверточной нейронной сети (Faster R-CNN) и перцептивное моделирование цвета на базе однородного цветового пространства CIECAM02 (CAM02-UCS), дополненное когнитивными принципами и правилами визуального дизайна. Faster R-CNN используется для идентификации компонентов UI и вывода иерархических структур на основе масштабных наборов данных интерфейсов. Улучшенный модуль генерации цвета анализирует брендовые или эталонные изображения для создания перцептивно однородных, гармоничных и соответствующих требованиям юзабилити цветовых тем с использованием CAM02-UCS. Эти результаты дополнительно оптимизируются с помощью правил когнитивного дизайна, включая группировку по Гештальту, законы Фиттса и Хика, интервалы на основе внимания и моделирование визуальной иерархии, что позволяет автоматически генерировать доработанные, ориентированные на задачу макеты UI. Эксперименты, проведенные на наборах данных RICO, ENRICO и Guo’s UI Color, показывают, что предлагаемая система достигает точности детектирования компонентов 92,4%, повышает четкость макета и точность порядка чтения на 18,7%, а создаваемые цветовые палитры оцениваются дизайнерами как на 24,5% более гармоничные по сравнению с базовыми методами. Оценки пользователей также указывают на снижение воспринимаемой когнитивной нагрузки на 31% и увеличение согласованности дизайна между экранами на 28%. Эти результаты демонстрируют, что сочетание структурного анализа на базе глубокого обучения с перцептивным моделированием цвета и когнитивными принципами дизайна позволяет создавать прототипы UI, которые являются высокоэффективными, эстетически целостными и удобными для пользователя. Данная платформа представляет собой новый сквозной подход к интеллектуальному и человекоцентричному автоматизированному прототипированию UI.
Введение
Графические пользовательские интерфейсы (ГПИ) служат основным средством взаимодействия между человеком и компьютерными системами, оказывая значительное влияние на удобство использования, доступность и общий пользовательский опыт (UX)1,2. Современные программные системы опираются на интуитивно понятные и визуально привлекательные интерфейсы для привлечения и удержания пользователей. Традиционно проектирование пользовательского интерфейса включает создание графических макетов, которые затем переводятся инженерами в программный код фронтенда. Однако различия в протоколах конкретных платформ в разных операционных системах требуют повторной адаптации, что увеличивает сложность и трудозатраты при разработке. В связи с этим автоматическая генерация кода пользовательского интерфейса стала важным направлением исследований, позволяющим снизить объем ручного труда и повысить эффективность разработки.
Ранние подходы к автоматической генерации пользовательского интерфейса (UI) сочетали традиционные методы обработки изображений с моделями глубокого обучения для детектирования и классификации областей3,4. В настоящее время доминирующие стратегии генерации кода GUI используют методы компьютерного зрения для анализа изображений UI и их преобразования в структурированные фронтенд-представления5,6,7. В то время как методы обработки изображений опираются на признаки, созданные вручную, подходы на основе глубокого обучения извлекают иерархические представления из крупномасштабных наборов данных. В результате исследователи изучили гибридные подходы, сочетающие глубокое обучение со специфическими для данной области методами обработки изображений для повышения устойчивости и точности.
Цвет является еще одним критическим фактором в дизайне пользовательского интерфейса (UI), влияющим на восприятие пользователя, юзабилити и эстетическую привлекательность1. Обеспечение согласованности между содержимым изображения и цветовыми схемами UI становится сложной задачей, когда визуальные данные различаются по оттенку и контексту8,9,10. Вследствие этого значительная часть исследований была сосредоточена на автоматической генерации цветовых палитр и перцептивном моделировании цвета. Существующие методы генерации цвета включают техники, основанные на цветовом пространстве CIELAB11. Другие подходы используют алгоритмы кластеризации, такие как k-средних, для извлечения доминирующих цветов из изображений12. В результате в последних работах все чаще применяются подходы к моделированию цвета на основе данных и машинного обучения.
Параллельно с этим подходы глубокого обучения значительно улучшили детектирование компонентов пользовательского интерфейса (UI) и понимание макета. Нейронные сети позволили более точно проводить структурный анализ мобильных интерфейсов13. Однако эти методы сосредоточены преимущественно на точности детектирования и зачастую игнорируют такие аспекты высокого уровня, как когнитивная юзабилити, иерархия макета и эффективность взаимодействия. Также были предложены генеративные модели для синтеза макетов UI14,15, но они сталкиваются с трудностями в поддержании согласованности между разными экранами и обеспечении интерпретируемости проектных решений16. Другие подходы ориентированы на визуальное сходство или качество рендеринга, но в них отсутствует единая структура, объединяющая семантику компонентов, гармонию цветов и ограничения юзабилити17. Для понимания контента UI также важно распознавание текста. Такие методы, как сверточные рекуррентные нейронные сети (CRNN), позволяют точно распознавать сложные текстовые паттерны на экранах интерфейса18,19,20.
Для генерации кода пользовательского интерфейса (UI) из набросков или изображений было предложено несколько систем. Sketch2Code использует детектирование объектов для преобразования набросков в представления кода21,22, однако этот метод чувствителен к качеству изображения. REDRAW предоставляет автоматизированный конвейер для сбора данных и обучения моделей, объединяя сверточные и рекуррентные нейронные сети для генерации структурированных представлений UI23,24. В последующих работах были представлены улучшенные метрики оценки для анализа качества сгенерированных UI25. Более современные подходы включают модели на основе диффузии и трансформеров для генерации макетов, такие как диффузионные трансформеры макетов без использования методов автоэнкодеров, генерация макетов GUI с использованием графов расположения GUI на базе трансформеров, а также генерация макетов UI под руководством больших языковых моделей26,27,28. Сравнительный обзор этих подходов представлен в Таблице 1.
| Список литературы и основные метод(ы) | Цель | Преимущества | Недостатки |
| Автоматизированная генерация цветовых тем пользовательского интерфейса на основе изображений: извлечение доминирующих цветов + перцептивное моделирование цвета CAM02-UCS¹ | Автоматическая генерация цветовых тем пользовательского интерфейса на основе эталонных изображений с оптимизацией гармонии и юзабилити. | Сильное перцептивное обоснование (CAM02-UCS); явный баланс между гармоничностью и удобством использования (контраст и разнообразие); включает веб-реализацию и оценку дизайнерами. | Ориентирован исключительно на цвет/тему (а не на макет или структуру компонентов); основан на правилах/эвристиках, а не на сквозном обучении синтезу пользовательского интерфейса. |
| Объединение генерации макета с помощью разделенной диффузионной модели (LDGM)²⁵ | Единая гибкая генерация макетов для графических сцен и пользовательских интерфейсов. | Современный уровень разнообразия и управляемости при генерации макетов; поддержка условной генерации и множества типов атрибутов. | Результаты работы диффузионных моделей могут иметь проблемы с выравниванием или детализацией макета, если не использовать соответствующие ограничения; также характеризуются более высокой сложностью модели и затратами на логический вывод. |
| Трансформеры диффузионной компоновки без методов автокодировщика: трансформер + диффузия для генерации компоновки (без автокодировщика)²⁶ | Повышение точности и согласованности для бенчмарков генерации макетов (метрики FID, согласованности и перекрытия). | Более точный захват семантических корреляций между соседними объектами; высокие показатели по метрикам FID и выравнивания. | Основное внимание уделяется геометрии макета (положениям, размерам, категориям), а не семантике пользовательского интерфейса. |
| Генерация макета GUI с помощью моделей на базе трансформеров на основе графов расположения GUI (GUI-AGs)²⁷ | Создание макетов графического интерфейса пользователя (GUI) на основе позиционных и графовых ограничений для помощи дизайнерам. | Графовые представления фиксируют реляционные ограничения; трансформер обеспечивает гибкую генерацию с учетом этих ограничений. | Может потребоваться предоставление явных графов ограничений от проектировщиков; ограниченное внимание уделяется показателям цвета и удобства использования. |
| Генерация макетов пользовательского интерфейса с помощью LLM на основе грамматики интерфейса: большие языковые модели (LLM) + иерархическая грамматика пользовательского интерфейса²⁸ | Исследуйте использование больших языковых моделей (LLM) для генерации макетов и улучшите объяснимость и управляемость с помощью грамматических представлений. | Высокий уровень управляемости и интерпретируемости; возможность использования контекстного обучения (in-context learning) больших языковых моделей (типа GPT). | Работа на ранней стадии с ограниченным эмпирическим подтверждением; разработка грамматики и устойчивость в различных пользовательских интерфейсах |
Таблица 1: Сравнение существующих методов моделирования цвета и генерации макета пользовательского интерфейса. В таблице обобщены репрезентативные подходы к проектированию пользовательских интерфейсов, включая генерацию цветовых тем, генерацию макета на основе диффузионных моделей, методы на базе трансформеров и генерацию макета под управлением больших языковых моделей. Для каждого метода представлены используемая технология, цель, преимущества и ограничения, что позволяет выделить различия в перцептивном моделировании, возможностях генерации макета, управляемости и аспектах удобства использования.
Несмотря на эти достижения, основным ограничением остается то, что ни одна из существующих систем не объединяет в рамках единого сквозного механизма детектирование компонентов, перцептивное моделирование цвета, принципы когнитивного дизайна и согласованность макета для нескольких экранов1. Современные подходы обычно оптимизируют только один или два аспекта — например, детектирование, макет или цвет — без учета их взаимозависимости. Такая фрагментация указывает на критический пробел в исследованиях по разработке унифицированных человекоцентричных систем автоматического прототипирования пользовательских интерфейсов. В частности, принципы когнитивного дизайна, такие как законы Гештальта, закон Фиттса и закон Хика, часто рассматриваются концептуально, а не интегрируются формально в вычислительные модели.
Чтобы преодолеть эти ограничения, в данном исследовании предлагается сквозная автоматизированная среда прототипирования пользовательских интерфейсов (UI), которая объединяет детектирование компонентов, перцептивное моделирование цвета и когнитивные принципы дизайна в единую систему. Данная среда разработана для повышения качества макета, снижения когнитивной нагрузки, улучшения цветовой гармонии и повышения общей юзабильности. Эти улучшения подтверждены экспериментами на наборах данных RICO, ENRICO и Guo’s UI Color, что демонстрирует эффективность объединения структурных, перцептивных и когнитивных аспектов в рамках одного автоматизированного конвейера прототипирования UI. Выдвигается гипотеза, что интеграция детектирования компонентов на основе глубокого обучения, перцептивного моделирования цвета и когнитивных принципов дизайна в единую среду значительно повысит качество прототипов UI по сравнению с существующими подходами. В частности, гипотеза H1 предполагает, что среда улучшает качество макета, включая выравнивание, группировку и порядок чтения. H2 постулирует, что среда снижает когнитивную нагрузку на пользователя. H3 предполагает, что перцептивное моделирование цвета улучшает согласование цветов и визуальную гармонию. H4 утверждает, что общая юзабильность и эстетическое качество прототипов UI повышаются.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Протокол
В данном исследовании используются общедоступные наборы данных; участие людей или животных не предусматривалось.
Предлагаемая платформа для автоматизированного прототипирования пользовательских интерфейсов (UI) объединяет структурный анализ на основе глубокого обучения, перцептивно однородное моделирование цвета и принципы когнитивного дизайна для создания согласованных и ориентированных на пользователя прототипов интерфейса. Методология начинается с архитектуры Faster R-CNN, обученной на наборах данных RICO и ENRICO для обнаружения компонентов UI и извлечения их иерархических связей, что позволяет точно интерпретировать различные макеты экранов. Затем обнаруженные компоненты обрабатываются модулем цветового интеллекта, который извлекает цветовые подсказки на основе бренда или изображений, моделирует перцептивное сходство с помощью CAM02-UCS и создает гармоничные, контрастные и соответствующие требованиям доступности цветовые палитры. Впоследствии с помощью механизма когнитивной оптимизации применяются принципы когнитивного дизайна, включая законы группировки Гештальта, закон Фиттса, закон Хика, интервалы на основе внимания и ограничения визуальной иерархии, для уточнения пространственной организации и выравнивания компонентов. Наконец, слой логического вывода макета объединяет структурные, перцептивные и когнитивные ограничения для генерации согласованных многоэкранных прототипов UI, обеспечивающих баланс между юзабилити, эстетикой и функциональной ясностью. Этот интегрированный конвейер обеспечивает перцептивную целостность, снижает когнитивную нагрузку и соответствует принципам человекоориентированного проектирования. Полный рабочий процесс предлагаемого метода показан на рисунке 1.
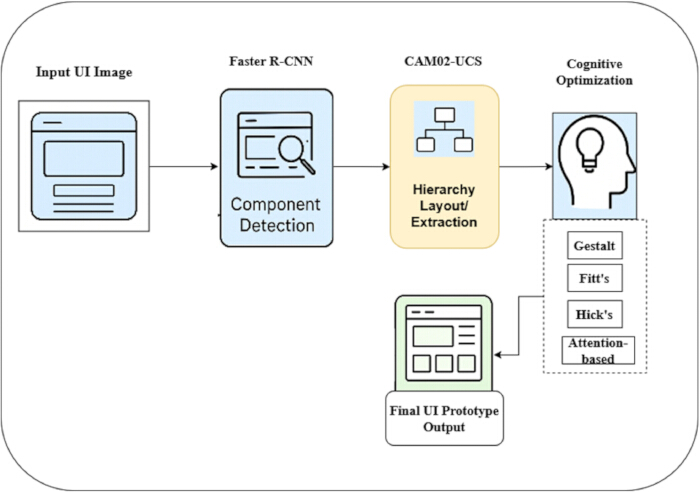
Рисунок 1. Общая архитектура предлагаемого фреймворка для автоматизированного прототипирования пользовательского интерфейса. На диаграмме показан полный конвейер обработки, начинающийся с входного изображения пользовательского интерфейса (UI). Детектирование компонентов выполняется с помощью Faster R-CNN для идентификации элементов интерфейса. Затем обнаруженные компоненты обрабатываются с использованием перцептивного моделирования на основе CAM02-UCS для извлечения иерархии и макета. Впоследствии применяется когнитивная оптимизация с использованием принципов Гештальта, закона Фиттса, закона Хика и корректировок на основе внимания. Стрелки указывают поток данных между модулями, результатом чего является итоговый прототип UI. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Обзор структуры
Рисунок 1 иллюстрирует полный рабочий процесс предлагаемой структуры автоматизированного прототипирования пользовательского интерфейса (UI), которая преобразует исходный скриншот интерфейса в когнитивно оптимизированный прототип. Процесс начинается с входного изображения UI, которое передается в модуль детектирования компонентов на базе Faster R-CNN. Этот модуль идентифицирует элементы интерфейса, такие как кнопки, иконки, текстовые поля и контейнеры, и выводит соответствующие им ограничивающие рамки и метки классов. Затем обнаруженные компоненты обрабатываются на этапе извлечения иерархии и макета. На основе пространственных отношений и структурных паттернов система выстраивает иерархическое дерево макета, которое отражает естественное восприятие пользователем организации экрана. Такое представление фиксирует визуальную группировку и структурные зависимости между элементами UI. Извлеченный макет впоследствии совершенствуется посредством когнитивной оптимизации путем применения принципов человекоцентричного дизайна. К ним относятся группировка по Гештальту для визуального кластерирования, закон Фиттса для оптимизации размера и доступности сенсорных целей, закон Хика для снижения сложности принятия решений и интервалы, основанные на внимании, для улучшения визуальной иерархии. В результате макет становится более интуитивным, читаемым и эффективным для взаимодействия с пользователем. Наконец, оптимизированный макет объединяется с перцептивным моделированием цвета для создания целостного прототипа UI. Полученный интерфейс является структурно точным, визуально гармоничным и соответствует ожиданиям пользователя в отношении юзабилити.
Программный каркас был реализован с использованием PyTorch 2.0 в ОС Ubuntu 22.04. Эксперименты проводились на системе, оснащенной графическим процессором NVIDIA RTX 4090 (24 GB VRAM). В модели Faster R-CNN в качестве базовой сети (backbone) использовалась ResNet-50, предварительно обученная на наборе данных ImageNet. Обучение выполнялось с использованием оптимизатора стохастического градиентного спуска (SGD) при скорости обучения 0.001, размере пакета 16 и до 60 эпох. Для предотвращения переобучения применялась процедура ранней остановки на основе валидационной выборки, составлявшей 20% данных. Хотя обучение было предусмотрено до 60 эпох, сходимость обычно достигалась раньше благодаря ранней остановке по значению функции потерь на валидационном наборе. Моментум и коэффициент затухания весов (weight decay) были установлены на значения 0.9 и 0.0005 соответственно. Аугментация данных включала нормализацию, случайное горизонтальное отражение, а также случайную обрезку и изменение размера.
Подготовка набора данных
Для поддержки предлагаемого фреймворка автоматизированного прототипирования пользовательского интерфейса (UI) были использованы три дополняющих друг друга набора данных: ENRICO29, RICO30 и набор данных цветов UI от Guo1. Набор данных RICO содержит 66 261 экран UI Android, собранных из 9 700 приложений, обеспечивая масштабное разнообразие для детектирования компонентов и извлечения иерархической разметки. ENRICO включает 1 464 высококачественных скриншота UI, вручную распределенных по 20 паттернам дизайна, что позволяет улучшить обобщение для структурного анализа и моделирования согласованности разметки. Набор данных цветов UI от Guo состоит из 128 отобранных изображений UI с аннотированными цветовыми темами, которые используются для перцептивного моделирования цвета и оценки палитры. Однако из-за относительно небольшого размера этот набор данных может вносить определенную вариативность в характеристики разметки. Для данного исследования был подготовлен комбинированный набор из 5 128 экранов для обучения и оценки. В частности, примерно 4 000 изображений из RICO были использованы для обучения модели Faster R-CNN для детектирования компонентов, 1 000 изображений из ENRICO — для изучения паттернов разметки и моделирования структурной согласованности, а 128 изображений из набора данных Guo — для задач оценки цвета. Все изображения были нормализованы до разрешения 480 × 800 пикселей, конвертированы в единое цветовое пространство sRGB и повторно аннотированы стандартными ограничивающими рамками (bounding boxes) и иерархическими метаданными для обеспечения совместимости между наборами данных. Обзор наборов данных, использованных в данном исследовании, представлен в Таблице 2. Набор данных RICO поддерживает крупномасштабное детектирование компонентов UI и структурный анализ, в то время как ENRICO расширяет возможности модели по распознаванию паттернов разметки и обеспечению согласованности между экранами. Набор данных цветов UI от Guo, несмотря на меньший объем, играет важную роль в оценке перцептивной цветовой гармонии и моделировании контрастности. В совокупности эти наборы данных обеспечивают комплексную и сбалансированную основу для обучения, валидации и оценки предлагаемого фреймворка автоматизированного прототипирования UI.
| Набор данных | Всего доступных изображений | Изображения, использованные в исследовании | Цель в предлагаемой структуре |
| Набор данных RICO30 | 66,261 | 4,000 | детектирование компонентов пользовательского интерфейса, извлечение структурного макета |
| Набор данных ENRICO29 | 1,464 | 1,000 | Обучение шаблонам проектирования, моделирование согласованности макета |
| Набор данных цветов пользовательских интерфейсов Го (Guo’s UI Color Dataset)1 | 128 | 128 | Извлечение цветовой темы, перцептивная оценка цвета |
| Общий итог | 67,853 | 5,128 | Комплексный набор данных для детектирования, анализа макета и цветового моделирования |
Таблица 2: Сводка наборов данных, использованных в предлагаемой структуре. В таблице представлены наборы данных, использованные для обучения и оценки, включая RICO, ENRICO и наборы данных UI Color от Guo. В ней указано общее количество доступных изображений, подмножество, использованное в данном исследовании, а также конкретная роль каждого набора данных в детектировании компонентов, моделировании макета и перцептивном анализе цвета в рамках предлагаемой структуры.
Для сохранения разнообразия компонентов пользовательского интерфейса (UI), структур макета и цветового распределения в наборах данных RICO, ENRICO и Guo использовалась стратегия стратифицированного отбора проб. Набор данных был разделен на обучающую (70%), валидационную (15%) и тестовую (15%) подвыборки с помощью стратифицированного семплирования. Изображения были нормализованы с использованием среднего значения (0.485, 0.456 и 0.406) и стандартного отклонения (0.229, 0.224 и 0.225). Аугментация данных, применяемая во время обучения, включала случайное горизонтальное отражение (вероятность = 0.5) и случайную обрезку (диапазон масштабирования: 0.8–1.0) с последующим изменением размера до 224 × 224 пикселей.
Аннотирование и предварительная обработка компонентов
Наборы данных RICO, ENRICO и UI Color Dataset от Guo в совокупности поддерживают три основных функциональных компонента предлагаемого фреймворка для автоматизированного прототипирования пользовательских интерфейсов (UI): детектирование компонентов, моделирование макета и перцептивная оптимизация цвета. Набор данных RICO содержит масштабную коллекцию из более чем 66 000 экранов мобильных интерфейсов и в первую очередь используется для обучения модуля детектирования компонентов. Его разнообразие позволяет модели Faster R-CNN формировать устойчивые представления общих элементов UI, таких как кнопки, изображения и текстовые поля, в широком спектре приложений. Это обеспечивает точное обнаружение и локализацию компонентов UI при различных условиях проектирования. Набор данных ENRICO предоставляет высококачественные экраны UI с размеченными паттернами для изучения структурных взаимосвязей и шаблонов макетов. Он позволяет системе понимать взаимосвязи между компонентами, иерархическую организацию и общепринятые шаблоны дизайна. Этот набор данных играет критическую роль в моделировании структур макетов и обеспечении согласованности между несколькими экранами, позволяя фреймворку генерировать макеты, соответствующие установленным конвенциям дизайна. В отличие от них, UI Color Dataset от Guo используется специально для перцептивного и когнитивного моделирования цвета. В отличие от RICO и ENRICO, которые сосредоточены на структурных аспектах, этот набор данных содержит курируемые изображения UI с аннотированными цветовыми темами. Эти аннотации используются для обучения модулей извлечения цвета и оценки гармонии. Путем отображения цветовых отношений в перцептивные цветовые пространства, такие как CAM02-UCS, фреймворк учится генерировать цветовые палитры, сбалансированные по контрасту, доступности и эстетической целостности. Вместе эти наборы данных образуют интегрированный конвейер: RICO поддерживает детектирование компонентов, ENRICO обеспечивает понимание паттернов макета и структурную согласованность, а набор данных Guo способствует перцептивной оптимизации цвета. Такая интеграция гарантирует, что созданные прототипы UI будут структурно точными, визуально гармоничными и когнитивно оптимизированными.
Нормализация выполнялась с использованием среднего значения [0.485, 0.456, 0.406] и стандартного отклонения [0.229, 0.224, 0.225]. Для улучшения обобщающей способности модели применялись методы аугментации данных, включая случайную обрезку, горизонтальное отражение и поворот. Кроме того, значения пикселей были масштабированы до диапазона [0, 1], а все изображения приведены к разрешению 480 × 800 pixels для обеспечения согласованности между наборами данных. Изображения, измененные до размера 224 × 224 pixels, используются для аугментации во время обучения, в то время как исходное разрешение 480 × 800 pixels сохраняется для анализа макета. Ограничивающие рамки (bounding boxes) были скорректированы для фильтрации нерелевантных аннотаций с использованием предопределенных пороговых значений. Для достижения единообразия между наборами данных все элементы пользовательского интерфейса (UI) были размечены вручную с помощью инструмента аннотирования LabelImg. Перед началом разметки была разработана предопределенная схема для классификации элементов UI по таким категориям, как кнопка, текст, изображение, иконка и контейнер. Для представления ограничивающих рамок применялась единая система координат, а иерархическая информация выстраивалась на основе пространственных отношений между элементами и их связей «родитель–потомок» в дереве макета. Кроме того, были установлены руководящие принципы для обеспечения согласованности разметки элементов, правильной обработки перекрывающихся компонентов и соблюдения минимальных порогов размера в наборах данных RICO, ENRICO и Guo.
Подробные математические формулировки для обучения детектированию компонентов и извлечения паттернов компоновки представлены в Дополнительном файле 1.
Модель Faster R-CNN была обучена с использованием метода SGD с моментом 0.9 и коэффициентом затухания весов 0.0005. Начальная скорость обучения была установлена на уровне 0.001 и корректировалась с помощью политики ступенчатого затухания на основе показателей валидации. Обучение проводилось в течение до 60 эпох с размером пакета 16. Для предотвращения переобучения применялась ранняя остановка с использованием валидационного набора, составляющего 20% от обучающих данных.
Функция сопоставления f(.) принимает на вход обнаруженные элементы пользовательского интерфейса (UI) и на выходе формирует иерархическое представление макета. Она вычисляет отношения смежности между элементами UI на основе пространственного расстояния и критериев выравнивания, а затем строит матрицу смежности для представления этих отношений. Затем применяется алгоритм кластеризации, такой как DBSCAN, для группировки связанных компонентов. Наконец, сгруппированные элементы организуются в иерархические структуры на основе отношений «родитель — потомок», формируя структурированное представление макета.
Подробные формулы для моделирования цветовой гармонии и единая целевая функция оптимизации представлены в Дополнительном файле 1.
Данная целевая функция математически формализует интеграцию структурного детектирования, анализа макета и перцептивного моделирования цвета, гарантируя, что все компоненты платформы совместно способствуют созданию согласованных и ориентированных на пользователя прототипов пользовательского интерфейса. Оптимизация выполняется модульно для каждого компонента платформы. Для обучения модуля детектирования компонентов используется SGD, тогда как при совместной оптимизации единой целевой функции применяется оптимизатор Adam. Комбинированная цель используется для управления общей производительностью системы. На этапах совместной оптимизации целевая функция минимизируется с помощью оптимизатора Adam со скоростью обучения 0.001 и размером пакета 16. Обучение проводится в течение максимум 60 эпох с применением ранней остановки, если изменение функции потерь на валидационной выборке составляет менее 10−4 на протяжении пяти последовательных эпох.
Детекция компонентов с использованием Faster R-CNN
Предложенная архитектура использует Faster R-CNN для автоматического обнаружения компонентов пользовательского интерфейса (UI), включая кнопки, иконки, текстовые поля, изображения и контейнеры. Faster R-CNN хорошо подходит для этой задачи, так как сочетает в себе высокую точность обнаружения объектов с эффективной генерацией предложений регионов, что крайне важно при работе со сложными макетами UI, содержащими плотно расположенные элементы. Модель использует основу ResNet-50, предварительно обученную на наборе данных ImageNet, для извлечения сверточных карт признаков с каждого экрана UI. В процессе обучения начальные слои были заморожены для сохранения общих визуальных признаков, в то время как более высокие слои (conv4_x и conv5_x) были дообучены (fine-tuned) для обнаружения специфических компонентов UI. Эти карты признаков фиксируют визуальные структуры, границы, текстуры и очертания компонентов. При обнаружении сеть предложений регионов (RPN) идентифицирует потенциальные области (анкоры), которые с высокой вероятностью содержат компоненты UI. Анкоры определяются с использованием нескольких масштабов (128, 256 и 512) и соотношений сторон (1:1, 1:2 и 2:1), чтобы охватить элементы UI различных размеров. Во время обучения анкоры, показатель пересечения над объединением (IoU) которых с истинными ограничивающими рамками (ground truth boxes) превышает 0,7, помечаются как положительные, тогда как анкоры с IoU менее 0,3 помечаются как отрицательные; анкоры с промежуточными значениями IoU игнорируются. Каждому анкору присваивается вероятность, указывающая на наличие компонента. Затем применяется подавление не-максимумов (NMS) для удаления избыточных и перекрывающихся предложений, что обеспечивает эффективную локализацию значимых элементов UI даже в перегруженных интерфейсах. После генерации потенциальных регионов каждое предложение классифицируется по предопределенным категориям компонентов, а координаты его ограничивающей рамки уточняются. Операция ROI Align извлекает представления признаков фиксированного размера для каждого предложения, которые затем обрабатываются полносвязными слоями для классификации и регрессии. Ветка классификации выдает вероятности классов, а ветка регрессии предсказывает точные координаты ограничивающей рамки. Вся модель Faster R-CNN обучается сквозным методом (end-to-end) путем оптимизации совместной функции потерь, которая объединяет потери RPN с финальными потерями обнаружения. Это позволяет системе не только точно распознавать компоненты UI, но и точно локализовать их в различных структурах интерфейса. Подробное описание обнаружения компонентов с помощью Faster R-CNN, включая этап RPN, классификацию ROI, уточнение ограничивающих рамок и конечную цель оптимизации, приведено в Дополнительном файле 1.
Алгоритм S1 содержит подробный рабочий процесс обнаружения компонентов и извлечения структуры (Дополнительный файл 1). В нем описывается полный процесс автоматического обнаружения компонентов пользовательского интерфейса (UI) и извлечения структуры из исходного изображения экрана. Сначала входное изображение проходит предварительную обработку и передается через базовую сеть CNN для извлечения глубоких визуальных признаков. Эти признаки используются RPN для генерации потенциальных ограничивающих рамок, которые затем уточняются с помощью классификации и регрессии. NMS удаляет избыточные обнаружения для обеспечения точной локализации. После обнаружения компоненты группируются по пространственной близости с использованием алгоритма плотностной пространственной кластеризации приложений с шумом (DBSCAN). Этот этап кластеризации позволяет построить иерархическое дерево UI, которое отражает отношения «родитель — потомок» и логические группировки компонентов. Данное иерархическое представление служит основой для последующего анализа макета и понимания UI. На Рисунке 2 проиллюстрирован процесс обнаружения компонентов с помощью Faster R-CNN на экране мобильного UI. Входной интерфейс (слева) содержит элементы UI, такие как кнопки и текстовые блоки, которые автоматически заключаются в ограничивающие рамки. Затем эти обнаруженные области классифицируются по категориям компонентов (например, «Кнопка» и «Текст»), что показано с помощью помеченных связей. Модуль обнаружения Faster R-CNN (справа) уточняет координаты ограничивающих рамок, присваивает семантические метки и выводит структурированную информацию на уровне компонентов. Этот этап служит критически важным фундаментом для последующих процессов, включая извлечение макета, когнитивную оптимизацию и генерацию прототипов UI, предоставляя точные и семантически значимые представления компонентов пользовательского интерфейса.
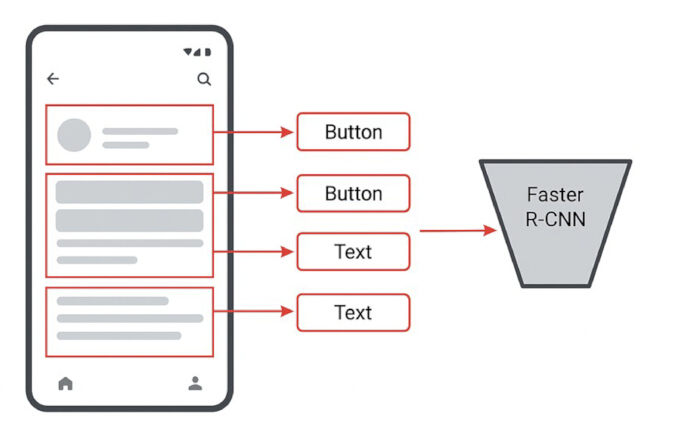
Рисунок 2. Обнаружение компонентов элементов пользовательского интерфейса с помощью Faster R-CNN. На рисунке показано обнаружение компонентов интерфейса на скриншоте входного интерфейса. Области интереса определяются с помощью ограничивающих рамок, а такие элементы, как кнопки и текстовые поля, классифицируются с помощью Faster R-CNN. Стрелки указывают на сопоставление обнаруженных компонентов с соответствующими семантическими метками. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Извлечение паттернов компоновки и иерархическое моделирование
После обнаружения компонентов с помощью Faster R-CNN каждый элемент пользовательского интерфейса (UI) представляется в виде ограничивающей рамки. Однако одних только ограничивающих рамок недостаточно для того, чтобы понять, как элементы структурно организованы в интерфейсе — например, какие из них относятся к заголовкам, навигационным панелям или сгруппированным областям контента. Чтобы преодолеть это ограничение, обнаруженные компоненты преобразуются в логическое дерево UI, в котором каждый компонент рассматривается как узел, а функционально или визуально связанные компоненты объединяются под общими родительскими узлами. Для выявления значимых групп макета применяются методы кластеризации, такие как DBSCAN или иерархическая агломеративная кластеризация. Эти методы анализируют пространственную близость и паттерны выравнивания компонентов для обнаружения взаимосвязей между элементами UI. По аналогии с практиками человеческого дизайна, система учится распознавать общие структурные паттерны, такие как заголовки, подвалы, сетки и блоки контента. После установления группировки анализируются дополнительные структурные свойства, включая выравнивание, организацию сетки и порядок чтения, для построения исчерпывающего представления макета. Например, компоненты, выровненные в колонках равной ширины, могут указывать на карточный макет, тогда как вертикально расположенные элементы могут свидетельствовать об интерфейсе на основе форм или ленты новостей. Интегрируя кластеризацию, пространственный анализ и правила выравнивания, платформа выстраивает иерархическое дерево UI, которое отражает как визуальную группировку, так и функциональные связи. Это иерархическое представление служит основой для последующего уточнения макета и моделирования согласованности между несколькими экранами, что позволяет системе создавать структурированные, связные и ориентированные на пользователя дизайны интерфейса.
Подробные формулы для расчета пространственного расстояния и сходства выравнивания приведены в Дополнительном файле 1.
Кластеризация для группировки макета (DBSCAN)
Для идентификации групп элементов интерфейса применяется алгоритм DBSCAN. DBSCAN использует два параметра: (1) ε = максимальное расстояние между соседними компонентами и (2) MinPts = минимальное количество компонентов, необходимых для формирования кластера. Для данного анализа параметры DBSCAN были выбраны эмпирически на основе нормализованного разрешения пользовательского интерфейса (480 × 800 пикселей). Параметр расстояния соседства был установлен на уровне ε = 50 пикселей для фиксации пространственной близости соседних компонентов интерфейса. Минимальное количество точек, необходимых для формирования кластера, было установлено как MinPts = 3, чтобы избежать создания незначительных или ложных групп компонентов интерфейса.
Подробная формулировка построения логического дерева пользовательского интерфейса представлена в Дополнительном файле 1.
Перцептивное моделирование цвета с помощью CAM02-UCS
Перцептивное моделирование цвета гарантирует, что цвета, используемые в генерируемом пользовательском интерфейсе (UI), гармоничны, легко читаемы и когнитивно эффективны. Доминирующие цвета извлекаются из входных источников, таких как изображения UI, с использованием методов кластеризации. В частности, для получения репрезентативных цветовых палитр применяется метод K-средних (K-means clustering) с инициализацией K-means++ в течение 300 итераций. Однако цветовое пространство RGB неточно отражает особенности человеческого зрительного восприятия, что означает, что численно близкие цвета могут восприниматься как разные. Чтобы устранить этот недостаток, все извлеченные цвета переводятся в CAM02-UCS, которое является перцептивно однородным. В этом пространстве равные расстояния соответствуют равным воспринимаемым различиям в цвете, что делает его подходящим для моделирования цветовой гармонии и контраста. После отображения в CAM02-UCS перцептивные различия цветов вычисляются с помощью евклидова расстояния, что позволяет системе количественно оценивать контраст, гармонию и вариативность между цветами. Слишком похожие цвета разделяются для улучшения читаемости, а чрезмерно контрастные — смягчаются во избежание визуального дискомфорта. Сгенерированная палитра также соответствует стандартам доступности, таким как WCAG AA и AAA, обеспечивая достаточный контраст между элементами переднего и заднего плана. Кроме того, цветовая гармония обеспечивается путем ограничения отношений в палитре комплементарными, аналогичными или триадными схемами в зависимости от предполагаемой темы UI. Это гарантирует, что resulting цветовая палитра будет не только визуально привлекательной, но и функционально доступной и когнитивно оптимизированной. Для дальнейшего уточнения палитры применяется процесс оптимизации с учетом ограничений перцептивного сходства, контраста, гармонии и соответствия бренду. Выбирается основной цвет (например, из фирменного стиля), а вторичные цвета корректируются по яркости и насыщенности для сохранения визуальной иерархии. Механизм оценки на основе правил анализирует кандидатные палитры на основе перцептивных расстояний и метрик доступности, сводя к минимуму когнитивную нагрузку при сохранении эстетического баланса. В результате разработанный фреймворк создает цветовые схемы UI, которые обладают профессиональным уровнем согласованности, читаемости и перцептивной целостности.
Подробные математические выражения для перцептивного моделирования цвета на основе CAM02-UCS представлены в Дополнительном файле 1.
Алгоритм S2 (Дополнительный файл 1) описывает рабочий процесс извлечения и оптимизации перцептивного цвета на основе CAM02-UCS с учетом ограничений гармонии и доступности. Сначала из исходного изображения извлекаются доминирующие цвета, которые затем преобразуются в CAM02-UCS, чтобы различие цветов соответствовало человеческому восприятию. Затем вычисляются перцептивные расстояния между цветами, которые ограничиваются заданными пределами для поддержания четкости и гармонии. После этого обеспечивается доступность путем оценки коэффициентов контрастности яркости в соответствии с рекомендациями WCAG. Итоговая палитра получается путем оптимизации комбинированной целевой функции, которая балансирует перцептивный интервал, требования к контрастности и ограничения цветовой гармонии. Это гарантирует, что созданные цветовые схемы пользовательского интерфейса будут не только визуально привлекательными, но также читаемыми, доступными и перцептивно согласованными.
Когнитивная оптимизация дизайна
Оптимизация когнитивного дизайна гарантирует, что автоматически созданные прототипы пользовательского интерфейса (UI) будут не только визуально согласованными, но также понятными и удобными в использовании. В данном модуле интегрированы ключевые принципы когнитивного дизайна, включая принципы Гештальта, закон Фиттса и закон Хика, для управления расположением, группировкой и интервалами между компонентами UI. Подробные математические формулировки для оптимизации когнитивного дизайна приведены в Дополнительном файле 1.
Интегрированная цель когнитивной оптимизации
Математическое выражение для интегрированной цели когнитивной оптимизации представлено в Дополнительном файле 1. Коэффициенты, представляющие значимость визуальной группировки, эффективности взаимодействия и сложности принятия решений, обозначены как альфа, бета и гамма соответственно. В данном исследовании значения альфа, бета и гамма были определены эмпирически с использованием валидационного набора данных. Для настоящего эксперимента коэффициенты были установлены следующим образом: α = 0.5, β = 0.3 и γ = 0.2. Такая конфигурация обеспечивает эффективный баланс между визуальной группировкой, эффективностью взаимодействия и простотой принятия решений.
Согласованность между несколькими экранами и генерация пользовательского интерфейса
Моделирование многоэкранной согласованности обеспечивает единую визуальную идентичность, структурную компоновку и паттерны взаимодействия для различных экранов внутри приложения. По мере перемещения пользователя между экранами у него формируются определенные ожидания относительно расположения элементов, типографики, интервалов и визуальной иерархии. Для соответствия этим ожиданиям система анализирует межэкранные паттерны с использованием шаблонов, полученных из наборов данных RICO и ENRICO. Эти шаблоны фиксируют распространенные структуры пользовательского интерфейса, такие как макеты «главный экран — детали», паттерны «список — детали», многошаговые формы и потоки панелей управления. Сравнивая расположение компонентов и принципы их группировки, система выстраивает межэкранный структурный профиль, который определяет, какие элементы должны оставаться неизменными, а какие могут варьироваться. После идентификации структурных паттернов платформа обеспечивает согласованность шкал типографики, коэффициентов отступов, сеточных макетов и навигационных якорей. Например, панели заголовков сохраняют одинаковую высоту, основные кнопки имеют единообразный размер и выравнивание, а блоки контента следуют предсказуемому визуальному порядку. Это достигается за счет процесса регуляризации макета, который оценивает каждый экран на соответствие глобальным структурным ограничениям. Если экран отклоняется от изученных шаблонов — например, из-за несоответствия внутренних полей или смещенных заголовков — система автоматически корректирует макет для восстановления целостности. Такие исправления помогают обеспечить бесшовный UX и снизить когнитивные затраты при переключении между экранами. Кроме того, платформа анализирует граф навигации между экранами для поддержания согласованности потока взаимодействия. Идентифицируются и внедряются общие навигационные паттерны, включая переходы «вперед/назад», вкладки и многошаговые рабочие процессы. Каждый переход проходит валидацию на соответствие ментальной модели пользователя, что повышает юзабилити и снижает вероятность возникновения путаницы. В результате модель многоэкранной согласованности минимизирует визуальный шум, повышает узнаваемость и способствует созданию единого опыта взаимодействия.
Подробные математические формулировки для обеспечения согласованности нескольких экранов и генерации пользовательского интерфейса представлены в Дополнительном файле 1.
Наконец, движок рендеринга создает визуальные результаты в таких форматах, как SVG-каркасы, HTML/CSS-прототипы или растровые макеты пользовательского интерфейса. Полученные экраны интерфейса демонстрируют правильный порядок чтения, гармоничные цветовые сочетания, точное выравнивание по сетке и согласованную визуальную иерархию на нескольких экранах.
Алгоритм S3 описывает рабочий процесс оптимизации когнитивно-визуального расположения элементов и обеспечения согласованности между несколькими экранами (Дополнительный файл 1). Алгоритм S3 описывает интегрированный процесс когнитивной и структурной оптимизации, используемый для создания удобных интерфейсных макетов (UI). Он объединяет в единой структуре оптимизации перцептивную группировку (принципы Гештальта), эффективность взаимодействия (закон Фиттса) и простоту принятия решений (закон Хика). Сначала оцениваются пространственные отношения между компонентами для установления перцептивных групп. Затем оптимизируется эффективность взаимодействия путем корректировки размера и расположения компонентов, а сложность принятия решений контролируется путем ограничения количества вариантов, предлагаемых пользователям. Кроме того, алгоритм обеспечивает согласованность между несколькими экранами, приводя каждый экран в соответствие с изученными шаблонами макетов, что гарантирует единообразие типографики, интервалов и структурной организации. Затем многокритериальная функция оптимизации совершенствует макет, балансируя выравнивание, интервалы и когнитивную нагрузку, что приводит к созданию интерфейса, который является одновременно визуально целостным и когнитивно эффективным. В целом, данный алгоритм гарантирует, что созданные многоэкранные макеты сохраняют высокий уровень визуальной согласованности, юзабилити и перцептивной ясности.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Результаты
Предложенный фреймворк для автоматизированного прототипирования пользовательского интерфейса (UI) был оценен с использованием интегрированного набора данных из 5 128 UI-экранов из трех источников: 4 000 изображений RICO, 1 000 экранов ENRICO и 128 цветовых аннотированных образцов UI из набора данных UI Color Dataset от Guo. Этот смешанный набор данных представляет собой сбалансированный эталон для оценки точности обнаружения компонентов, структурной ясности макета, согласованности между несколькими экранами и перцептивно...
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Обсуждение
Результаты демонстрируют статистически значимое улучшение юзабилити, структурной организации и перцептивного качества (p < 0.05), что подтверждает эффективность внедрения принципов когнитивного дизайна в автоматизированное прототипирование пользовательских интерфейсов (UI). В отличие от традиционных систем генерации UI, которые полагаются преимущественно на визуальное обнаружение или эвристики на основе правил, предлагаемый фреймворк интегрирует группировку по Гештальту, моделирование иерархии, ограничения по интерва...
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Раскрытие информации
Авторы не имеют конфликта интересов.
Благодарности
Авторы выражают благодарность за академическую и институциональную поддержку, оказанную Wuhan College of Foreign Languages & Министерство иностранных дел, Университет Кэимунг и Шанхайский институт торговли и иностранных языков в период завершения данного исследования.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Материалы
| Имя | Компания | Каталожный номер | Комментарии |
|---|---|---|---|
| ЦП (процессор) | AMD Ryzen 9 7950X (16 ядер, 32 потока, 4.5–5.7 GHz) | Advanced Micro Devices (AMD), США | Ryzen 9 7950X |
| CUDA Toolkit | Версия 11.8 | NVIDIA Corporation, США | CUDA Toolkit 11.8 |
| cuDNN | Версия 8.9 | NVIDIA Corporation, США | cuDNN v8.9 |
| Faster R-CNN | Модель обнаружения объектов (с сетью предложения регионов) | Meta AI Research / Detectron2 | Фреймворк Detectron2 |
| Matplotlib | Версия 3.7 | Команда разработчиков Matplotlib | v3.7.0 |
| ГП NVIDIA RTX 4090 | Видеокарта 24 GB GDDR6X | NVIDIA Corporation, Санта-Клара, Калифорния, США | RTX 4090 |
| NumPy | Версия 1.24 | Разработчики NumPy | v1.24.0 |
| OpenCV | Версия 4.8 | OpenCV Foundation | v4.8.0 |
| PyTorch | Версия 2.0 | PyTorch Foundation (Meta AI) | v2.0.0 |
| ResNet-50 с FPN | Базовая CNN с сетью пирамиды признаков | Microsoft Research / Detectron2 | ResNet-50-FPN |
| Scikit-learn | Версия 1.3 | Разработчики Scikit-learn | v1.3.0 |
| SciPy | Версия 1.10 | Сообщество SciPy | v1.10.0 |
| Системная память (ОЗУ) | 64 GB DDR5 | Corsair / Kingston (или эквивалент) | Комплект DDR5 64GB |
| Операционная система Ubuntu | Версия 22.04 LTS | Canonical Ltd., Великобритания | Ubuntu 22.04 LTS |
Ссылки
- Weingerl P. Automated image-based user interface color theme generation. Appl Sci. 2024;14:2850.
- Feng Z, Fang J, Cai B, Zhang Y. Guis2Code: Computer vision tool to generate code automatically from graphical user interface sketches. In: Proc Int Conf Artif Neural Netw; 2021; p. 53–65.
- Chen C, Zhang X, Yang Y, Li Y. GalleryDC: Design search knowledge discovery through auto-created GUI component gallery. Proc ACM Hum Comput Interact. 2019;3:1–22.
- Chen J, et al. Object detection for graphical user interface: Old-fashioned deep learning combination. In: Proc ACM Eur Softw Eng Conf Symp Found Softw Eng; 2020; p. 1202–1214.
- Xie M, et al. UIED: Hybrid tool for GUI element detection. In: Proc ACM Eur Softw Eng Conf Symp Found Softw Eng; 2020; p. 1655–1659.
- Gijsenij A, et al. Determining key colors from a design perspective using dE-means color clustering. Color Res Appl. 2023;48:69–87.
- Yuan LP, et al. InfoColorizer: Interactive recommendation of color palettes for infographics. IEEE Trans Vis Comput Graph. 2022;28:4252–4266.
- Cao Y, et al. Influences of color salience and location of website links on user performance and affective experience. Int J Hum Comput Interact. 2021;37:547–559.
- Liu W, Cao Y, Proctor RW. App icon color and border shape influence visual search efficiency and user experience. Int J Ind Ergon. 2021;84:103160.
- Yamin PAR, Park J, Kim HK, Hussain M. Effects of button colour and background on augmented reality interfaces. Behav Inf Technol. 2023;43:663–676.
- Deng L, Zhang ZR, Zhou FY, Liu RY. Effects of app icon border form and interface background color saturation. Adv Multimed. 2022;2022:1166656.
- Weingerl P, Hladnik A, Javoršek D. Machine learning model for extracting image prominent colors. Color Res Appl. 2020;45:409–426.
- Huang K, et al. WovenProbe: Probing possibilities for on-skin systems. In: Proc ACM Des Interact Syst Conf; 2021; p. 1193–1207.
- Dewez D, Guillemot C, Bailly G, Isenberg T. Dual body representations during an isomorphic 3D manipulation. IEEE Trans Vis Comput Graph. 2022;28:2047–2057.
- Kim J, Kim C, Nam KY. ThinkWrite: Design interventions for online petition deliberation. In: Proc CHI Conf Hum Factors Comput Syst Ext Abstr; 2022.
- Gao L, Wang Y, Müller S, Hudson SE. DataLev: Mid-air data physicalisation using acoustic levitation. In: Proc CHI Conf Hum Factors Comput Syst; 2023; p. 1–14.
- Khorsandi PM, Ogata M, Rekimoto J, Inami M. FabriCar: In-car media interactions using e-textile sensors. In: Proc ACM Des Interact Syst Conf; 2023; p. 764–776.
- Zhang Z, Ding Y, Huang C. Automatic front-end code generation via multi-head attention. In: Proc Int Conf Comput Eng Appl; 2023; p. 869–872.
- Jain V, et al. Sketch2code: Transformation of sketches to UI using deep neural network [preprint]. arXiv:1910.08930; 2019.
- Chai Y, et al. Dynamic prototype network for few-shot malware detection. IEEE Trans Knowl Data Eng. 2023;35:4754–4766.
- Qiu J, et al. AI security in 5G networks: Adversarial examples. IEEE Veh Technol Mag. 2020;15:95–100.
- Qiu J, et al. Automatic concept extraction from big data in smart city. IEEE Trans Comput Soc Syst. 2020;7:225–233.
- Xie M. UI2CODE: Computer vision-based reverse engineering of UI design [Internet]. GitHub; 2021. Available from: https://github.com
- Wang C, Bochkovskiy A, Liao HYM. CSPNet: Backbone enhancing learning capability of CNNs. In: Proc IEEE Conf Comput Vis Pattern Recognit Workshops; 2020; p. 1571–1580.
- Hui M, et al. Unifying layout generation with decoupled diffusion model. In: Proc IEEE Conf Comput Vis Pattern Recognit; 2023; p. 18434–18443.
- Wang Y, et al. Dolfin: Diffusion layout transformers without autoencoder. In: Proc Eur Conf Comput Vis; 2024; p. 513–530.
- Sobolevsky A, et al. GuiLGet: GUI layout generation with transformer [preprint]. arXiv:2304.09012; 2023.
- Lu Y, et al. UI layout generation with LLMs guided by UI grammar [preprint]. arXiv:2310.15455; 2023.
- Leiva LA, Hota A, Oulasvirta A. ENRICO: A dataset for mobile UI design modeling. In: Proc Int Conf Hum Comput Interact Mobile Devices Serv; 2020.
- Li G, et al. Learning to denoise mobile UI layouts. In: Proc CHI Conf Hum Factors Comput Syst; 2022; p. 1–15.
- Beltramelli T. pix2code: Generating code from a GUI screenshot. In: Proc ACM SIGCHI Symp Eng Interact Comput Syst; 2018.
- Zheng G, et al. LayoutDiffusion: Controllable diffusion model. In: Proc IEEE Conf Comput Vis Pattern Recognit; 2023; p. 18424–18433.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.