Этот протокол описывает разработку и оценку чат-бота поколения с дополненным поиском на основе рекомендаций, который извлекает и суммирует контент из веб-рекомендаций по клинической практике рака для генерации ответов на пользовательские запросы.
Для просмотра этого контента требуется подписка на JoVE. Войдите или начните свой бесплатный пробный период.
Методическая статья
Разработка чатбота с дополненным поиском на основе рекомендаций, ссылающегося на веб-руководства по клинической практике рака
В этой статье
Краткое содержание
Аннотация
Широкое распространение медицинской информации в Интернете улучшило доступ пациентов к медицинским знаниям; однако это также увеличило риск неточной медицинской информации. Лечение рака включает сложную информацию, что затрудняет пациентам выявление точных и основанных на доказательствах источников. Крупные языковые модели позволяют взаимодействовать с естественным языком, но часто вызывают галлюцинации, ограничивая их применение в передаче медицинской информации. Генерация, дополненная за счёт поиска (RAG), может снизить эти риски, закрепляя реакции на внешних источниках. В данном исследовании описывается разработка и оценка чат-бота RAG на основе рекомендаций, который использует общедоступные веб-рекомендации по клинической практике рака. Система извлекает URL-адреса из страниц оглавления руководства, обрабатывает текст страницы с помощью морфологического анализа и косинусного сходства на основе частоты терминов и обратной частоты документа, а также формирует справочную информацию на основе высокорелевантных страниц. Большая языковая модель использует эти ссылки для генерации ответов, ограниченных содержимым рекомендаций. Руководство JLCS для пациентов и их их семей с раком лёгких использовалось в качестве справочного руководства. Наборы вопросов включали как типы рака, охваченные руководством, так и внесферные типы рака для оценки контроля реакции. Медицинская информация была успешно извлечена из страниц оглавления, при этом 98% извлечённых URL содержали ссылаемый медицинский контент. Для вопросов внутри тематики чат-бот генерировал ответы, суммируя содержание рекомендаций, и при ручном рассмотрении галлюцинаций в условиях определённого теста не было выявлено. На вопросы, выходящие за рамки контекста, чат-бот постоянно отказывался отвечать и указывал, что доступной информации недостаточно. Веб-структура руководства способствовала эффективному сбору и организации референсного контента на уровне URL. Этот протокол предоставляет практические рекомендации по созданию систем искусственного интеллекта, которые предоставляют медицинскую информацию с использованием веб-рекомендаций клинической практики.
Введение
Широкое использование интернета и социальных сетей упростило пациентам доступ к медицинской информации 1,2. Информация о лечении рака часто бывает сложной и обширной, что особенно затрудняет пациентам определение точных, релевантных и основанных на научных доказательствахисточников 3. Хотя онлайн-ресурсы могут помочь понять пациента, они также содержат значительное количество неверноймедицинской информации 3, что может негативно повлиять на решения пациентов поуходу 4. Поскольку дезинформация, связанная с раком, может влиять на исходыпациентов 5, растёт потребность в системах искусственного интеллекта (ИИ), которые помогают отдельным пользователям искать, резюмировать и интерпретировать медицинскуюинформацию 6.
Крупные языковые модели (LLM) позволяют пользователям получать доступ к информации через разговор наестественном языке 7; Однако генерация дезинформации (то есть галлюцинаций) остаётся серьёзной проблемой вмедицине 8,9,10,11. Одним из ключевых источников дезинформации является качество и точность обучающих данных, используемых для разработки чат-бота. Кроме того, статический характер обучения моделей приводит к тому, что знания со временем могут устаревать, ограничивая способность LLM предоставлять актуальную и контекстно соответствующую информацию12,13. Эти ограничения подчёркивают важность эффективных стратегий управления знаниями, чтобы ответы чат-ботов оставались точными, актуальными и актуальными. В частности, в медицинских учреждениях, где рекомендации и стандарты ухода постоянно развиваются, являются системы, способные легко получать доступ и ссылаться на актуальные научно обоснованные ресурсы, такие как руководство клинической практики. Для решения этой проблемы всё больше внимания привлекает генерация с дополненным поиском (RAG), которая генерирует ответы путем включения информации из внешних источниковзнаний 10,13,14,15,16,17.
Хотя RAG всё чаще применяется к медицинским чат-ботам, мало внимания уделяется тому, как клинические рекомендации должны систематически внедряться в качестве источников справочнойинформации 18. Многие рекомендации по клинической практике доступны в интернете; однако остаётся неясным, может ли их существующая веб-структура напрямую служить рамкам для поиска системRAG 18. Кроме того, практические методы построения справочной информации без ручной разработки базы знаний не были хорошо развиты.
В этом исследовании мы стремились установить принципы проектирования систем ИИ с ссылкой на рекомендации в медицинской сфере, разработав и оценив чат-бота RAG на основе рекомендаций, который использует общедоступные веб-рекомендации по клинической практике рака, что обеспечивает простой и своевременный доступ к информации, основанной на рекомендациях. В качестве доказательства концепции мы оценили техническую осуществимость извлечения рекомендаций, генерации ответов и ограничения ответа, используя существующую веб-структуру общедоступных клинических рекомендаций с целью предложить воспроизводимый протокол разработки для систем RAG, ссылающихся на рекомендации.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Протокол
В этом исследовании не участвуют люди, которым требуется защита от рисков, связанных с исследованиями. Таким образом, он не требует рассмотрения институциональным экспертным советом согласно японским этическим рекомендациям для медицинских исследований с участием людей19. Данное исследование представлено в соответствии с рекомендациями Transparent Reporting of a Multivariable Model for Individual Prognosis or Diagnosis (TRIPOD)-LLM 20.
См. рисунок 1 для схемного обзора протокола чат-бота RAG на основе руководств.
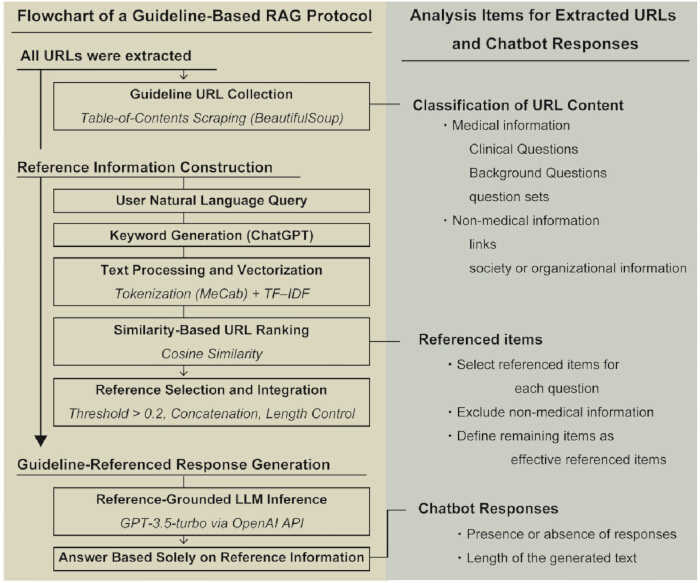
Рисунок 1. Рабочий процесс протокола чат-бота на основе рекомендаций (RAG). Схематический обзор рабочего процесса чат-бота RAG, основанного на рекомендациях. URL-адреса извлекаются со страницы оглавления веб-руководства клинической практики и используются для создания справочной информации. Пользовательские запросы преобразуются в ключевые слова, а содержимое веб-страницы обрабатывается с помощью токенизации, векторизации частоты терминов и обратной частоты документа и анализа косинусного сходства для выявления релевантных страниц с рекомендациями. Выбранная справочная информация интегрируется и предоставляется в большую языковую модель для генерации ответов исключительно на основе содержимого руководства. Правая панель обобщает элементы оценки, используемые для извлеченных URL, информации о ссылках и ответов чат-ботов. Пожалуйста, нажмите здесь, чтобы увидеть увеличенную версию этой фигуры.
1. Подготовка справочной информации на основе веб-рекомендаций
- Извлечь все URL-адреса из страниц оглавления целевых веб-руководств клинической практики с помощью BeautifulSoup 4 (библиотека HTML-парсинга), реализованной на языке программирования Python (версия 3.12).
ПРИМЕЧАНИЕ: Реализуйте скрипт извлечения URL с использованием языка программирования с помощью следующих пакетов: библиотека разбора HTML (версия 4.12.3) и запросы (библиотека поиска веб-страниц; версия 2.32.3). Устанавливайте пакеты с помощью pip. Полный исходный код для извлечения URL предоставлен в дополнительном файле 1. См. Таблицу материалов для получения информации о программном обеспечении. - Вручную проверяйте все извлеченные URL-адреса, чтобы подтвердить успешный доступ и релевантность целевого руководства клинической практики.
- Классифицируйте каждый URL как содержащий медицинскую или немедицинскую информацию. Выполните классификацию URL одним автором (S.N.).
ПРИМЕЧАНИЕ: Медицинская информация была определена как содержательное содержимое рекомендаций, включая клинические вопросы (CQ), вопросы по справочной информации и наборы вопросов. Немедицинская информация включала ссылки, страницы общества или организаций, а также другой вспомогательный контент, не подходящий для справки. - Скомпилируйте проверенные URL-адреса в рабочую книгу Microsoft Excel (.xlsx формате), где в строке записывается один URL. Сохраняйте полученный список URL как входный набор данных для последующего поиска текста, предварительной обработки и анализа сходства.
2. Генерация ключевых слов из пользовательских запросов
- Введите запрос на естественном языке в ChatGPT (Generative Pre-trained Transformer, версия 4o; модель генерации ключевых слов).
- Предложите модели извлечь два ключевых слова, соответствующих пользовательскому запросу.
- Используйте следующий запрос, написанный на японском языке, для генерации ключевых слов:
"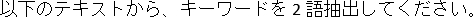 "
(Английский перевод: «Извлечь два ключевых слова из следующего текста.») - Добавьте к этой инструкции запрос пользователя на естественном языке и отправьте его в модель генерации ключевых слов для генерации ключевых слов.
- Не изменяйте параметры модели вручную. Выполните генерацию ключевых слов с использованием стандартных настроек модели генерации ключевых слов.
- Генерируйте два ключевых слова для каждого пользовательского запроса. Сохраняйте оба ключевых слова без дальнейших изменений, фильтрации или ручного выбора и используйте их для последующих вычислений сходства.
- Сохраняйте сгенерированные ключевые слова в рабочей тетраде Microsoft Excel (.xlsx формате). Для каждой записи храните исходный пользовательский запрос и соответствующие сгенерированные ключевые слова для последующего поиска по сходству.
3. Обработка текста и расчёт сходства
- Получите полный текст с каждого извлеченного URL с помощью библиотеки поиска веб-страницы и библиотеки HTML-разбора. Извлечь текстовое содержимое из исходного кода HTML с помощью функции BeautifulSoup get_text().
- Предварительно обработайте извлеченный текст веб-страницы и сгенерированные ключевые слова, удаляя HTML-теги и неяпонские символы.
- Проведите японский морфологический анализ с помощью MeCab (версия 0.996; японский морфологический анализатор) с стандартным словарем. Сохраняйте только существительные и объединяйте их в текстовую строку, ограниченную пробелом.
- Объедините сгенерированные ключевые слова в одну текстовую строку и примените те же процедуры предварительной обработки и токенизации, что и для текста веб-страницы.
- Генерируйте векторы по частоте и обратной частоте терминов (TF–IDF) из обработанного текста веб-страницы и ключевого слова с использованием реализации TfidfVectorizer в библиотеке scikit-learn (версия 1.6.1) с настройками параметров по умолчанию.
ПРИМЕЧАНИЕ: Все параметры TfidfVectorizer остались на своих значениях по умолчанию, и пользовательские настройки параметров не применялись. - Вычислите сходство косинуса между каждым вектором веб-страницы и вектором ключевого слова с помощью функции косинусного сходства.
- Ранжуйте URL в убывающем порядке согласно показателям косинуса сходства. Не применяйте дополнительные критерии для решения ничьих.
- Выберите страницы с показателем косинуса сходства ≥0,2 в качестве кандидатской справочной информации.
ПРИМЕЧАНИЕ: Порог сходства косинуса (0,2) был выбран эмпирически в ходе разработки системы с целью приоритизировать отзыв и избежать исключения потенциально релевантного содержимого рекомендаций. - Сохраняйте все страницы кандидатов, соответствующие порогу сходства.
4. Построение справочной информации
- Последовательно извлекайте текстовое содержимое выбранных страниц из верхней части рейтингового списка.
- Объедините извлечённые тексты в единый справочный документ.
- Перед отправкой в LLM замените новые строки и последовательные пробелы в справочном тексте на один пробел.
- Урезать связанный ссылочный текст до первых 4 096 символов перед передачей его в LLM.
ПРИМЕЧАНИЕ: Лимит усечения основывался на символах, а не на жетонах. Эмпирически было выбрано ограничение в 4 096 символов, чтобы объединённая информация о подсказках и ссылках оставалась в пределах входной способности модели генерации отклика GPT-3.5-turbo-16k.
5. Генерация ответов на основе ИИ
- Предоставить сконструированную справочную информацию и исходный пользовательский запрос модели генерации ответов через интерфейс программирования приложений (API).
- Инструктировать ИИ с помощью следующего запроса (полностью написанного на японском), чтобы ответы генерировались исключительно на основе предоставленной справочной информации:
«Вы — помощник медицинской информации, который консультирует пациентов с раком. Генерируйте ответы, опираясь исключительно на следующую справочную информацию, и не используйте свои общие знания или рассуждения. Ответы должны быть подробными и простыми для понимания, примерно 500 символов. Если в справочной информации недостаточно для ответа на вопрос, ответьте: «В тексте недостаточно информации», не используя предположения или общие знания.» - Предоставите информацию о ссылке и пользовательский запрос вместе в одном пользовательском сообщении. Структурируйте ввод так: «Справочная информация: [справочный текст]» с последующим «Вопрос: [пользовательский запрос]».
- Генерируйте ответы с помощью модели генерации отклика со следующими настройками: температура = 0,1, максимальная длина выхода = 1 024 жетона, n = 1 и стоп = отсутствует.
- Получите ответ, сгенерированный ИИ, для последующего рассмотрения.
ПРИМЕЧАНИЕ: Отправьте информацию о ссылке и пользовательский запрос в виде одного пользовательского сообщения. Предоставьте инструкции генерации ответа отдельно в виде системного сообщения.
6. Руководство по ссылкам и формулировка вопросов
- Выберите руководство JLCS для пациентов и их семей с раком лёгких (Руководство по легким)21, которое бесплатно доступно онлайн, в качестве справочной информации для чат-ботов RAG, основанной на рекомендациях.
- Создайте две категории вопросов для оценки на основе типа рака: тимусные опухоли, которые входят в область руководства, и детскую глиому, которая выходит за рамки указанной информации.
- Сформулируйте четыре вопроса, охватывающие диагностику и лечение каждого типа рака:
«Какие диагностические методы доступны для опухолей XX (например, тимической или детской глиомы)?»
«Каковы патологические диагностические подходы к опухолям XX?»
«Какие варианты лечения доступны для XX опухолей?»
«Каковы варианты хирургического лечения опухолей XX?» - Отправляйте вопросы, связанные с типами рака, охваченные указанными веб-руководствами, в чат-бот. Например, задайте вопрос о диагностике тимовой опухоли, используя справочник по лёгким в качестве справочной информации.
- Отправляйте чат-боту вопросы, выходящие за рамки рекомендаций, чтобы оценить его способность воздерживаться от использования внешней или не связанной информации. Например, задайте вопрос о детской глиоме, используя Руководство по легким в качестве справочной информации.
- Оценивайте каждый вопрос в независимом чате. Не переносите историю разговора между вопросами.
- Записывайте ответы, сгенерированные ИИ, для последующей оценки.
7. Оценка реакции
- Проведите ручной просмотр всех сгенерированных ответов.
- Оцените, содержит ли каждая реакция галлюцинации.
- Оцените, подтверждается ли каждый ответ информацией, содержащейся в справочном руководстве.
ПРИМЕЧАНИЕ: Галлюцинации определялись как ответы, содержащие несуществующие события, имена или термины, которые могут потенциально причинить медицинский вред14. Все полученные ответы были проверены на точность и отсутствие галлюцинаций одним автором с 8-летним опытом работы в университетской больнице, включая поддержку пациентов и медицинскую коммуникацию для пациентов с раком. Любая неопределённость в классификации ответов была решена в ходе обсуждения с врачом-соавтором, имеющим более 20 лет опыта в информационных службах по онкологии в Национальном онкологическом центре Японии. - Считайте, что ответ поддерживается только тогда, когда все клинически релевантные утверждения могут быть напрямую подтверждены из полученного руководства по ссылке без необходимости дополнительных знаний или необоснованных выводов.
- Классифицируйте каждый ответ с помощью заранее определённых меток результатов. Классифицировать ответы, содержащие только информацию, подтверждённую рекомендациями по ссылке, как «галлюцинация отсутствует». Классифицировать ответы, содержащие неподтверждённую или сфабрикованную информацию, как «присутствующую галлюцинацию».
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Результаты
Возможность получения медицинского контента через страницы содержания
Архитектура веб-скрейпинга собирала URL-адреса со страницы оглавления руководства. Из Руководства по лёгким было извлечено 106 URL-адресов со страницы оглавления, из которых 104 (98%) содержали медицинскую информацию (Дополнительная таблица 1). Эффективность ответов чат-ботов, основанных на страницах с содержанием рекомендаций, изложена в Таблице 1
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Обсуждение
В этом исследовании мы рассмотрели полезность чат-бота RAG на основе рекомендаций, который использовал веб-руководство по клинической практике — JLCS Guidebook for Lumng Cancer Patients and Families — в качестве источника справочной информации. Чат-бот генерировал ответы, основанные на содержании руководства, используя веб-структуру руководства и получая страницы на основе их сходства с пользовательскими запросами. Этот подход показал, что извлечение на основе сходства в сочетании с гене...
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Раскрытие информации
Авторы не заявляют о конкурирующих интересах.
Благодарности
Авторы благодарят Кеничи Иноуэ, доктора медицины, доктора философии (Центр молочной железы Мемориальной больницы Shonan Memorial) за его обширную техническую поддержку в разработке чат-бота поколения с дополненным поиском на основе рекомендаций. Авторы также благодарят Чикако Ямаки, доктора философии, и всех членов исследовательской команды Института контроля рака Национального онкологического центра Японии (Токио, Япония) за ценные советы по теме, рассматриваемой в этой статье. Кроме того, авторы благодарят Editage за редактирование на английском языке. Эта работа была поддержана грантом на исследования в области здравоохранения и труда (R6–Cancer Control–23EA1026).
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Материалы
```html
```
| Имя | Компания | Каталожный номер | Комментарии |
|---|---|---|---|
| Beautiful Soup 4 (версия 4.12.3) | Проект Beautiful Soup | N/A | Библиотека Python, используемая для извлечения URL и разбора HTML |
| ChatGPT версия 4o | OpenAI | N/A | Используется для генерации ключевых слов |
| GPT-3.5-turbo | OpenAI | N/A | Используется для генерации ответов |
| Руководство JLCS для пациентов с раком легкого и их семей | Общество рака легкого Японии | N/A | Веб-ориентированное руководство по клинической практике, используемое в качестве справочной информации |
| MeCab (версия 0.996) | Проект MeCab | N/A | Японский морфологический анализатор |
| API от OpenAI | OpenAI | N/A | Используется для генерации ответов на основе ИИ |
| Python (версия 3.12) | Фонд программного обеспечения Python | N/A | Программная среда |
| Requests (версия 2.32.3) | Проект Requests | N/A | Библиотека Python, используемая для получения веб-страниц |
| scikit-learn (версия 1.6.1) | Разработчики scikit-learn | N/A | Используется для векторизации TF–IDF и вычисления косинусной схожести. |
| urllib.parse | Фонд программного обеспечения Python | N/A | Библиотека Python, используемая для нормализации и объединения URL |
Ссылки
- Helft PR, Hlubocky F, Daugherty CK. American oncologists' views of internet use by cancer patients: a mail survey of American Society of Clinical Oncology members. J Clin Oncol. 2003;21(5):942-947.
- Chen X, Siu LL. Impact of the media and the internet on oncology: survey of cancer patients and oncologists in Canada. J Clin Oncol. 2001;19(23):4291-4297.
- Goto Y, et al. Differences in the quality of information on the internet about lung cancer between the United States and Japan. J Thorac Oncol. 2009;4(7):829-833.
- Ogasawara R, et al. Reliability of cancer treatment information on the internet: observational study. JMIR Cancer. 2018;4(2):e10031.
- Johnson SB, Park HS, Gross CP, Yu JB. Complementary medicine, refusal of conventional cancer therapy, and survival among patients with curable cancers. JAMA Oncol. 2018;4(10):1375-1381.
- Rajpurkar P, Chen E, Banerjee O, Topol EJ. AI in health and medicine. Nat Med. 2022;28(1):31-38.
- The Lancet Digital Health. ChatGPT: friend or foe? Lancet Digit Health. 2023;5(3):e102.
- Huang L, et al. A survey on hallucination in large language models: principles, taxonomy, challenges, and open questions. arXiv. 2023;2311.05232.
- Ji Z, et al. Survey of hallucination in natural language generation. ACM Comput Surv. 2023;55(12):248.
- Yang R, et al. Retrieval-augmented generation for generative artificial intelligence in health care. npj Health Syst. 2025;2(2).
- Zakka C, et al. Almanac—retrieval-augmented language models for clinical medicine. NEJM AI. 2024;1(2):AIoa2300068.
- Chow JCL, Li K. Developing effective frameworks for large language model-based medical chatbots: insights from radiotherapy education with ChatGPT. JMIR Cancer. 2025;11:e66633.
- Chow JCL, Li K. Large language models in medical chatbots: opportunities, challenges, and the need to address AI risks. Information. 2025;16(7):549.
- Nishisako S, Higashi T, Wakao F. Reducing hallucinations and trade-offs in responses in generative AI chatbots for cancer information: development and evaluation study. JMIR Cancer. 2025;11:e70176.
- Lewis P, et al. Retrieval-augmented generation for knowledge-intensive NLP tasks. Adv Neural Inf Process Syst. 2020;33:9459-9474.
- Gao Y, et al. Retrieval-augmented generation for large language models: a survey. arXiv. 2023;2312.10997.
- Jeong M, Sohn J, Sung M, Kang JJB. Improving medical reasoning through retrieval and self-reflection with retrieval-augmented large language models. Bioinformatics. 2024;40:i119-i129.
- Lewis M, et al. Grounding large language models in clinical evidence: a retrieval-augmented generation system for querying UK NICE clinical guidelines. arXiv. 2025;2510.02967.
- Ministry of Education, Culture, Sports, Science and Technology; Ministry of Health, Labour and Welfare; Ministry of Economy, Trade and Industry. Ethical guidelines for medical and biological research involving human subjects [Article in Japanese]. Ministry of Health, Labour and Welfare.
- Gallifant J, et al. The TRIPOD-LLM reporting guideline for studies using large language models. Nat Med. 2025;31:60-69.
- The Japanese Lung Cancer Society. JLCS Guidebook for Lung Cancer Patients and Families. Available at: https://www.haigan.gr.jp/public/guidebook/2024/. Accessed January 21, 2026.
- Liu M, et al. Evaluating the effectiveness of advanced large language models in medical knowledge: a comparative study using Japanese national medical examination. Int J Med Inform. 2025;193:105673.
- Kudo T, Yamamoto K, Matsumoto Y. Applying conditional random fields to Japanese morphological analysis. In: Proceedings of the 2004 Conference on Empirical Methods in Natural Language Processing. 2004:230-237.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.