В данной работе предлагается комплексная многомодальная структура анализа эмоций, использующая трансформерные кодировщики, распутанные представления эмоций и основанный на графах кросс-модальный механизм внимания с визуальным отображением для повышения точности распознавания эмоций на двух наборах данных.
Для просмотра этого контента требуется подписка на JoVE. Войдите или начните свой бесплатный пробный период.
Исследовательская статья
Визуальное картирование признаков мультимодальных эмоций для проектирования интеллектуального взаимодействия
В этой статье
Краткое содержание
Аннотация
Визуальное картирование мультимодальных признаков эмоций имеет решающее значение для проектирования интеллектуальных интерфейсов, позволяя машинам понимать, интерпретировать и реагировать на аффективные состояния человека. Тем не менее, современные алгоритмы мультимодального распознавания эмоций сосредоточены преимущественно на прогнозной эффективности, предоставляя мало данных об интерпретируемости, осведомленности о взаимодействии или кросс-модальных взаимодействиях на уровне признаков. В данной работе представлена платформа для визуального картирования аспектов мультимодальных эмоций, которая объединяет ориентированную на взаимодействие визуализацию, интерпретируемое обучение представлениям и прогнозирование эмоций. Для извлечения высокоуровневых эмбеддингов эмоций из текстовой, аудио- и визуальной модальностей без использования созданных вручную признаков применялись энкодеры на базе трансформеров. Для повышения робастности специфическая для эмоций и специфическая для модальности информация была разделена с помощью метода распутывания представлений (disentangled representation learning). Кроме того, была создана кросс-модальная сеть внимания на основе графов, использующая адаптивное взвешивание внимания для имитации тонких эмоциональных связей между модальностями. Для повышения прозрачности был разработан модуль многопроекционного визуального картирования, отображающий временные траектории эмоций, распределения кросс-модального внимания и латентные эмбеддинги эмоций. Для оценки предложенной платформы использовались набор данных Carnegie Mellon University Multimodal Opinion Sentiment and Emotion Intensity (CMU-MOSEI) и китайский набор данных для мультимодального анализа сентимента (CH-SIMS). Согласно результатам экспериментов, предложенная платформа обеспечила улучшенную интерпретируемость на уровне признаков и визуализацию с учетом взаимодействия, при этом стабильно превосходя репрезентативные базовые методы по точности, F1-мере, корреляции и средней абсолютной ошибке. Кроме того, модуль визуального картирования облегчил качественную интерпретацию мультимодальных представлений эмоций, кросс-модальных взаимодействий и временной динамики эмоций, поддерживая визуализацию и анализ с учетом взаимодействия.
Введение
Способность правильно идентифицировать и понимать человеческие эмоции стала крайне важной для улучшения взаимодействия между человеком и машиной. Помимо того, что анализ эмоций необходим для совершенствования человеко-компьютерного взаимодействия, он обладает потенциалом революционизировать ряд областей, включая предварительную медицинскую диагностику1, поведенческий анализ в учебных классах2, психологическое наблюдение за пациентами3, определение усталости водителей в транспортных средствах4 и интеллектуальное управление в системах «умный дом»5. Последние достижения в области аффективных вычислений и глубокого обучения6 усилили интерес к созданию систем реального времени, способных запечатлеть всю сложность человеческих эмоций.
Многие современные методы опираются преимущественно на унимодальные данные, такие как текстовые, графические или слуховые сигналы7,8,9. Такие подходы неоднократно оказывались неспособными распознать тонкие сигналы, например, сарказм или контекстуальные нюансы. В связи с этим исследования перешли к мультимодальной оценке эмоций, которая объединяет дополняющие друг друга данные из нескольких источников для преодоления этих ограничений10,11,12. Преимущества слияния нескольких модальностей были продемонстрированы на базовых моделях, таких как долгосрочная краткосрочная память с ранним слиянием (EF-LSTM)13, облегченные и FM глубокие нейронные сети (LF-DNN)14, тензорные сети слияния (TFN) и подходы к мультимодальному слиянию с низким рангом. Однако большинство этих методов опираются на офлайн-генерацию признаков и не подходят для динамических ситуаций в реальном мире.
С целью учета эмоциональных состояний за последние десять лет значительно развились исследования и приложения в области мультимодального распознавания эмоций15. Одной из наиболее сложных и значимых областей современных исследований является непрерывный мониторинг эмоциональных состояний с использованием различных источников данных16. Концепция мультимодальности возникла естественным образом с появлением столь разнообразных систем знаний, что привело к многим достижениям в применении анализа эмоций в таких областях, как аффективные вычисления, человеко-компьютерное взаимодействие (HCI), обучение, видеоигры, обслуживание клиентов, медицинский уход, оценка пользовательского опыта (UX) и т. д. Тем не менее, применение методов распознавания эмоций при оценке UX не всегда было простым процессом.
Одной из основных причин сосредоточиться на мультимодальном распознавании, а не на унимодальных методах, являются неотъемлемые недостатки использования единственного источника информации. Системы унимодального детектирования эмоций могут иметь более низкую точность из-за отсутствующих или нечетких данных, тогда как схемы MER более надежны и обеспечивают более всестороннее и глубокое понимание экспрессивных состояний за счет интеграции нескольких источников данных17. Например, одного только языка мимики может быть недостаточно для точной классификации чувств, особенно когда жесты сложны или неясны. Однако сочетание мимики с другими формами коммуникации, такими как речь или физические сигналы, может повысить точность распознавания чувств.
Обширные исследования в области распознавания эмоций проводились с использованием нескольких модальностей. Ранние работы были сосредоточены на выявлении отличительных признаков из различных модальностей, таких как графические, акустические или текстовые данные. Однако становится все более очевидным, что интеграция различных модальностей может обеспечить сбалансированную эмоциональную информацию, что ведет к более надежному и точному определению тональности. В данном разделе рассматриваются ключевые достижения в одномодальном и мультимодальном анализе эмоций с упором на базовые подходы, их недостатки и обоснование нашего метода.
Первоначальные исследования по распознаванию эмоций были сосредоточены преимущественно на одной модальности. В визуальной области новаторские исследования привели к категоризации прототипных мимических движений20. Последующие достижения включали методы захвата временной динамики, такие как анализ визуального движения21 и скрытые марковские модели22, в то время как лицевые реакции были разделены на единицы действия с помощью системы кодирования лицевых движений (FACS)23. LSTM и сверточные нейронные сети (CNN) успешно применялись для извлечения значимых признаков непосредственно из необработанных аудиосигналов; методологии идентификации эмоций на основе аудио эволюционировали от традиционной обработки сигналов до глубокого обучения24. Извлечение контекстуальных эмоциональных сигналов в текстовом анализе эмоций было значительно улучшено за счет рекуррентных нейронных сетей (RNN), включающих механизмы внимания, а в последнее время — за счет моделей на базе трансформеров. Несмотря на достигнутые успехи, унимодальные методы по своей сути неспособны точно отобразить всю сложность человеческих переживаний, так как в них отсутствует дополнительная информация, содержащаяся в других модальностях.
В 2021 году были предложены некоторые модели на основе механизмов внимания, такие как модель DialogXL25, предназначенные для сбора долгосрочных контекстных данных в области идентификации тональности диалогов. Kim и соавт.26 представили модель EmoBERTa в 2021 году для повышения точности ERC. Эта модель использует данные о говорящих для улучшения характеристик участников разговоров и их взаимодействия друг с другом. В 2022 году Li и соавт.27 представили метод CoG-BART. В данной структуре используется контролируемое контрастивное обучение для повышения способности модели интерпретировать релевантные данные. Следует отметить, что контролируемое обучение требует значительного объема размеченных данных.
Типичным примером такой работы является фреймворк Multimodal Interaction-Aware Representation (MIAR)28, в котором используются токены взаимодействия признаков и контрастивное выравнивание для улучшения обобщения между модальностями. MIAR улучшает выравнивание модальностей и демонстрирует высокую эффективность на нескольких наборах данных; однако он сосредоточен главным образом на точности прогнозирования, не затрагивая вопрос визуального отображения. Аналогично, модель Cross-Attentional Audio-Visual Fusion29 эффективно фиксирует детализированные аудиовизуальные взаимодействия для прогнозирования валентности и активации, но ограничена двумя модальностями и не обладает возможностями визуализации. Подходы к темпоральному моделированию на основе сетей LSTM и слияния автоэнкодеров успешно улавливают временную динамику эмоций, однако дают ограниченное представление о взаимодействиях модальностей и изученных эмоциональных представлениях. В последнее время методы на основе трансформеров, такие как Transformer-based Multimodal Fusion Network (TMFN)30, продемонстрировали высокую эффективность на наборах данных CMU-MOSI и CMU-MOSEI благодаря улучшенному мультимодальному слиянию и контрастивному обучению. Тем не менее, эти подходы остаются преимущественно ориентированными на производительность и предоставляют ограниченную поддержку интерпретируемости, анализа на уровне признаков и визуализации, ориентированной на взаимодействие.
Для улучшения интеграции текстовых, акустических и визуальных данных было предложено несколько методов мультимодального распознавания эмоций. Несмотря на то, что методы раннего слияния, такие как EF-LSTM и LF-DNN, не позволяли фиксировать сложные кросс-модальные взаимодействия, они продемонстрировали преимущества использования мультимодальной информации для анализа настроений и эмоций. Хотя модель TFN повысила эффективность на эталонных наборах данных, таких как CMU-MOSI и CMU-MOSEI, и ввела явное моделирование интермодальных взаимодействий, ее ограниченная интерпретируемость и высокая вычислительная сложность препятствовали ее практическому применению. Для улучшения выравнивания модальностей и динамического слияния признаков в более современных методах, таких как MIAR, моделях слияния на основе перекрестного внимания (cross-attentional fusion), TMFN и адаптивных мультимодальных трансформерах, стали использоваться топологии трансформеров и механизмы внимания. Эти методы были сосредоточены преимущественно на прогностической способности, предоставляя мало сведений о представлениях эмоций на уровне признаков и кросс-модальных зависимостях, несмотря на достижение конкурентоспособных результатов по общепринятым метрикам оценки, таким как точность (accuracy), F1-мера (F1-score) и средняя абсолютная ошибка (mean absolute error). Кроме того, лишь в немногих исследованиях были разработаны методы визуализации, способные раскрыть латентные эмбеддинги эмоций, распределение внимания и временную динамику эмоций, или была интегрирована модель интермодальных взаимодействий на основе графов. Предлагаемый подход включает многовидовое визуальное отображение, слияние кросс-модального внимания на основе графов и обучение распутанным представлениям (disentangled representation learning) для преодоления этих недостатков и повышения эффективности мультимодального распознавания эмоций.
Аналогичным образом, в Adaptive Multimodal Transformer32 предлагается объединение на основе обмена для адаптивного смягчения влияния зашумленной или недостающей модальной информации, что повышает эффективность классификации тональности. Хотя этот подход позволяет эффективно устранить расхождения в распределении модальной информации, его архитектура специфична для задачи анализа тональности и дает ограниченное представление об изученных эмоциональных репрезентациях. Другим значимым вкладом является Multimodal Fusion Model33, которая объединяет CNN, мультипликативные LSTM и внимание на базе трансформеров для распознавания мультимодальных эмоций в режиме реального времени. Модель выполняет полное слияние видео-, аудио- и текстовых модальностей и демонстрирует высокую стабильность распознавания. Тем не менее, как и другие существующие модели, она ориентирована преимущественно на точность прогнозирования и не имеет явных признаков для визуализации и интерпретируемости, ориентированной на взаимодействие.
В заключение следует отметить, что, хотя современные подходы к мультимодальному распознаванию эмоций достигли значительных успехов в улавливании кросс-модальных взаимодействий и повышении точности прогнозирования, большинство из них сосредоточено на задачах, ориентированных на распознавание. Мало внимания уделялось таким областям, как интерпретируемость на уровне признаков, визуализация эмоциональных представлений в пространстве изображений и внедрение предлагаемой структуры для проектирования интеллектуального взаимодействия. Именно с учетом этих проблем предлагается данная структура.
Большинство современных методов сосредоточены прежде всего на повышении прогностической точности, предлагая при этом слабую интерпретируемость выученных эмоциональных представлений и кросс-модальных взаимодействий, несмотря на значительные успехи в области мультимодального распознавания эмоций28,29. Сложные взаимодействия между текстовой, акустической и визуальной модальностями зачастую трудно моделировать с помощью текущих стратегий слияния, особенно при наличии расхождений между модальностями и нехватки информации 28,31. Хотя архитектуры на основе трансформеров и механизмы внимания улучшили обучение представлениям, их прозрачность и интерпретируемость часто снижаются из-за отсутствия явного разделения информации, специфичной для эмоций, и информации, специфичной для модальностей31,32,33. Кроме того, лишь в небольшом количестве исследований изучалось графовое моделирование интермодальных взаимодействий или создавались системы визуализации, способные раскрыть временную динамику эмоций, распределение внимания и эмбеддинги эмоций. Эти недостатки демонстрируют необходимость в интерпретируемой мультимодальной структуре для интеллектуального человеко-машинного взаимодействия, которая сочетала бы в себе ориентированное на взаимодействие визуальное картирование с эффективным кросс-модальным обучением.
В данной работе представлена интерпретируемая структура для визуального картирования мультимодальных аспектов эмоций при проектировании интеллектуальных интерфейсов. Система использует сквозное глубокое обучение для извлечения высокоуровневых эмоциональных представлений из текстовых, аудио- и визуальных модальностей без необходимости создания признаков вручную. Кросс-модальные эмоциональные взаимодействия моделируются с помощью механизма слияния на основе графового внимания, который разделяет специфичную для эмоций и специфичную для модальности информацию, что обеспечивает распутывающее обучение представлениям и повышает интерпретируемость и устойчивость. Кроме того, создан модуль многоракурсной визуализации для отображения временной динамики эмоций, паттернов кросс-модального внимания и эмбеддингов эмоций. Эффективность и применимость предложенной структуры в интеллектуальных системах взаимодействия человека и машины оцениваются путем валидации на эталонных наборах данных для мультимодального распознавания эмоций.
Данная работа предлагает уникальную структуру для визуального картирования мультимодальных аспектов эмоций, которая выходит за рамки традиционных подходов, ориентированных на прогнозирование, чтобы преодолеть недостатки моделирования кросс-модальных взаимодействий и ограниченную интерпретируемость в современных системах идентификации мультимодальных эмоций. В рамках единой архитектуры предлагаемый подход объединяет мультимодальное обучение представлениям на основе трансформеров, распутанное моделирование признаков с учетом эмоций, слияние кросс-модального внимания на основе графов и визуализацию, ориентированную на взаимодействие. В отличие от существующих подходов, которые в основном сосредоточены на показателях классификации, данная структура четко разделяет специфичные для эмоций и специфичные для модальностей представления для повышения интерпретируемости, робастности и кросс-модальной согласованности. Кроме того, представлен механизм внимания на основе графов, который позволяет осуществлять адаптивное моделирование интермодальных взаимодействий путем захвата детальной эмоциональной взаимозависимости между текстовой, аудио- и визуальной модальностями. Для повышения прозрачности создан модуль многоракурсного визуального картирования, раскрывающий временные траектории эмоций, паттерны кросс-модального внимания и латентные эмбеддинги эмоций, что дает интуитивное понимание процесса принятия решений моделью. Помимо обеспечения улучшенной визуализации и интерпретируемости мультимодальной эмоциональной динамики, экспериментальная оценка на эталонных наборах данных CH-SIMS и CMU-MOSEI показала конкурентоспособные результаты с точки зрения точности, F1-меры, средней абсолютной ошибки и корреляции.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Протокол
Предлагаемая работа направлена на совершенствование дизайна интеллектуального взаимодействия путем разработки интерпретируемой структуры для визуального отображения мультимодальных признаков эмоций. В данной работе использовались общедоступные базы данных CH-SIMS и CMU-MOSEI. Оба набора данных были получены из официальных источников и использовались в соответствии с правилами использования, стандартами исследований и условиями лицензирования, установленными их создателями. Мультимодальный контент наборов данных, включая текстовые, аудио- и видеоданные, был первоначально собран и аннотирован поставщиками данных в соответствии с полученными разрешениями участников и протоколами сбора данных. В данном исследовании не предусматривалось прямого взаимодействия с людьми, набора новых участников или сбора персональных данных. Весь анализ проводился с использованием общедоступных исследовательских наборов данных. Следовательно, наш вторичный анализ данных не потребовал дополнительного этического одобрения или рассмотрения Институциональным наблюдательным советом (IRB). Исследование было проведено в соответствии с соответствующими институциональными нормами, регулирующими использование общедоступных наборов данных, этическими процедурами исследования и применимыми политиками использования данных.
Для изучения характеристик эмоций в различных модальностях с использованием специфических для эмоций или модальностей признаков с целью улучшения понимания был применен механизм кросс-модального внимания на основе графов. Компонент многопроекционного визуального отображения используется для совершенствования интерактивного дизайна с учетом эмоций в режиме реального времени, а его эффективность оценивается для распознавания эмоций. Результаты показывают, что предлагаемый метод повышает как интерпретируемость, так и эффективность интеллектуальных пользовательских интерфейсов с учетом эмоций в реальных условиях. На рисунке 1 показана архитектурная схема предлагаемой работы. На рисунке 1 представлена полная схема предлагаемого фреймворка визуального отображения для обучения многомодальным признакам эмоций в контексте систем интеллектуального взаимодействия. Рабочий процесс начинается с трех синхронизированных входных модальностей, а именно текста, аудио и видео, которые фиксируют взаимодополняющую эмоциональную информацию из лингвистической, просодической модальностей и модальности мимики соответственно. Специфический для каждой модальности трансформер-энкодер обрабатывает каждую модальность для получения высокоуровневых представлений необработанных входных данных. Затем эти представления подаются в модуль обучения распутанным представлениям, где эмбеддинги, специфичные для эмоций, отделяются от признаков, специфичных для модальности, чтобы обеспечить согласованность выученных эмоций в гетерогенных источниках данных. Эмбеддинги специфических эмоций из каждой модальности затем агрегируются кросс-модальной сетью внимания на основе графов, которая моделирует межмодальные эмоциональные зависимости и присваивает динамические веса значимости каждой модальности в зависимости от контекста взаимодействия. Наконец, фреймворк предоставляет как результаты классификации эмоций, так и аналитические данные о взаимодействии, что способствует прозрачному принятию решений с учетом эмоций и адаптивному проектированию интеллектуального взаимодействия.
Мультимодальный сбор данных
Наборы данных CH-SIMS и CMU-MOSEI представляют собой два существующих общедоступных мультимодальных датасета, содержащих синхронизированные видео-, аудио- и текстовые данные. Набор данных CH-SIMS включает результаты мультимодальных исследований китайцев и состоит из 2 281 видеофрагмента, извлеченного из различных сегментов кинофильмов, телевизионных драм и развлекательных шоу. Добавление соответствующих аудио- и текстовых данных к этим видеофрагментам делает исследования по мультимодальному анализу эмоций более содержательными и практически реализуемыми. В свою очередь, одним из крупнейших мультимодальных наборов данных для анализа мнений, чувств и эмоций является датасет CMU-MOSEI, который был сформирован из более чем 23 000 видеоклипов с фразами, произнесенными более чем 1 000 говорящими на самые разные темы. Набор данных был случайным образом разделен на обучающую (70%), валидационную (15%) и тестовую (15%) выборки с сохранением распределения классов.
Текстовые транскрипции, аудиосигналы и видеокадры собираются и синхронизируются по временным меткам для достижения точного соответствия на детальном временном уровне. Интеграция на уровне кадров гарантирует, что предлагаемые механизмы обучения представлениям и слияния на основе графов могут совместно моделировать и использовать эмоциональный контент, исходящий из визуальных выражений, вокальных тонов и лингвистического содержания. Такой метод мультимодального сбора данных позволяет эффективно извлекать межмодальную эмоциональную динамику, что крайне важно для проектирования интеллектуального взаимодействия и понятного визуального отображения.
Таблица 1 представляет основные структуры мультимодальных наборов данных эмоций, использованных в предлагаемом методе. Для получения более широкого спектра связанных чувств, таких как произнесенные слова, интонации голоса и мимика, CH-SIMS и CMU-MOSEI интегрируют видео-, аудио- и текстовые модальности из этих наборов данных. Кроме того, в CH-SIMS доступно ограниченное количество образцов данных, что позволяет провести тщательный анализ взаимодействия модальностей и вариативности эмоций в Китае. С другой стороны, набор данных CMU-MOSEI имеет большее значение для оценки устойчивости обучения представлениям и соответствующих алгоритмов визуализации, рассмотренных в данной работе, поскольку он содержит большой объем данных на разных языках, по различным субъектам и с аннотированными уровнями эмоций. Кроме того, по сравнению с предыдущими исследованиями, он снижает трудности при выборе информации при тестировании моделей.
Мультимодальная предобработка и синхронизация
Временные метки из наборов данных CH-SIMS и CMU-MOSEI использовались для синхронизации текстовой, слуховой и визуальной модальностей, что обеспечило согласованное обучение мультимодальным представлениям. Каждое высказывание служило основной единицей анализа и было связано с соответствующими аудио- и видеосегментами в том же временном интервале. Выравнивание проводилось на уровне высказываний. Транскрипт был разделен на сегменты на основе временных меток начала и конца каждого высказывания. Соответствие между транскриптом, аудио и видео устанавливалось путем извлечения соответствующих видеокадров и аудиосигналов, попадающих в один и тот же временной интервал. В то время как аудиосегменты обрабатывались с помощью Wav2Vec 2.0 для получения акустических представлений, визуальные кадры из видеосегмента сэмплировались с заданной частотой и кодировались с использованием Vision Transformer (ViT). Для создания текстовых эмбеддингов из транскриптов высказываний использовался энкодер RoBERTa. Временная синхронизация была достигнута путем приведения признаков всех модальностей к единой границе высказывания, так как три модальности генерировали последовательности признаков различной длины. Для нормализации последовательностей разной длины использовался формат фиксированной длины. Более длинные последовательности укорачивались до максимально допустимой длины, а более короткие дополнялись нулями. В процессе обучения использовались маски внимания, чтобы отделить дополняющие элементы от фактических позиций признаков. Эмбеддинги конкретных модальностей проецировались в общее латентное пространство перед слиянием, чтобы преодолеть различие в длине последовательностей разных модальностей. Это гарантировало размерную согласованность и позволило механизму внимания на основе графов эффективно реализовать обучение кросс-модальному взаимодействию. Для сохранения качества данных и целостности синхронизации из исследований были исключены образцы с поврежденными файлами, отсутствующими аннотациями или неполной информацией по модальностям.
Извлечение признаков на основе трансформеров
Метод глубокого обучения используется для извлечения высокоуровневых признаков, учитывающих эмоциональную составляющую, из информации различных модальностей, таких как зрение, звук и текст, в сквозном режиме после выравнивания мультимодальных данных и выполнения необходимой предобработки. Благодаря использованию трансформерного энкодера для получения внутренне дискриминативных представлений признаков из необработанных мультимодальных данных, предлагаемый метод устраняет необходимость в ручном проектировании признаков. Для обеспечения согласованности между наборами данных, используемыми в предлагаемом подходе, для каждой модальности обучается эмбеддинг фиксированного размера. Например, для каждой из отдельных модальностей, включая изображения, аудио и текст, обучаются 768-мерные эмбеддинги признаков, которые в совокупности формируют единое пространство признаков, используемое во всем подходе, в частности, в методе извлечения признаков, примененном к предлагаемому набору данных CH-SIMS и набору данных CMU-MOSEI для изучения высокоуровневых признаков в данных различного объема.
Визуальная модальность: Vision-трансформер для создания эмбеддингов кадров с учетом эмоционального состояния
Для извлечения визуальной информации из кадров видео с целью получения пространственных представлений, релевантных эмоциям, была использована модель Vision Transformer (ViT-Base). Перед извлечением признаков кадры каждого видеосегмента были масштабированы до (224 × 224) пикселей и отобраны через регулярные временные интервалы. При размере патча 16 × 16 пикселей архитектура ViT-Base генерирует серию визуальных токенов, которые обрабатываются 12 слоями кодировщика трансформера. Полученные представления на уровне кадров были спроецированы в 768-мерное пространство эмбеддингов с использованием предобученной модели ViT в качестве визуального базового компонента (backbone). Эмбеддинги на уровне кадров объединялись с помощью среднего пулинга для создания итогового визуального представления для каждого сегмента. В процессе обучения для улучшения обобщающей способности применялись нормализация изображений и стандартные методы аугментации, такие как случайная обрезка и горизонтальное отражение. Затем предлагаемая структура мультимодального слияния была использована для объединения этих визуальных эмбеддингов с текстовыми и аудиопредставлениями.
Для сохранения временной динамики эмоций видеообразцы из наборов данных CH-SIMS и CMU-MOSEI будут подвергнуты равномерному семплированию для визуальной модальности. Кадры каждого видео, 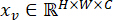 , могут быть разделены на N сегментов фиксированного размера, которые затем выравниваются и переносятся в обратном порядке в пространство латентных эмбеддингов с размерностью
 . Последовательность создается путем добавления позиционных эмбеддингов и обучаемого группового токена:
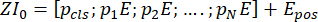 (1)
где  обозначает позиционное кодирование, а
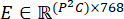 представляет собой матрицу вложения патчей.
Для обработки последовательности встроенных патчей используются стекированные слои энкодера трансформера, состоящие из сетей прямого распространения и многоголового механизма самовнимания. Преобразование на слое l описывается следующим образом:
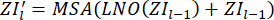 (2)
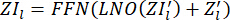 (3)
Для получения вектора визуальных признаков с учетом эмоций в качестве вектора признаков извлекается выходное значение, эквивалентное токену класса  . Чтобы обеспечить согласованность визуальных представлений эмоций, несмотря на различия в языке и содержании наборов данных, объединяются эмбеддинги на уровне кадров из каждого сегмента видео для фиксации мимики и эволюции эмоций.
Аудиомодальность с использованием Wav2Vec 2.0 для просодии и семантических акустических эмбеддингов Контекстуализированные эмбеддинги речи были получены с использованием предобученного энкодера Wav2Vec 2.0 в качестве акустической основы. Вектор акустических признаков фиксированной длины для каждой фразы был получен путем агрегирования выходных скрытых представлений с помощью среднего пулинга. Модель Wav2Vec 2.0 использовалась для извлечения акустических представлений из аудиосигналов с целью захвата контекстуальных и релевантных эмоциям характеристик речи. Перед извлечением признаков аудиозаписи были нормализованы и передискретизированы до 16 kHz. Для обеспечения синхронизации между текстовой и визуальной модальностями каждый аудиосегмент на уровне высказывания был выделен с использованием временных меток, предоставленных в аннотациях датасета. Предобученный акустический энкодер был донастроен в процессе обучения модели для улучшения адаптации к конкретной задаче, что позволило полученным представлениям более точно отражать эмоциональные аспекты речевых сигналов. Затем, с использованием итоговых аудиоэмбеддингов, было выполнено кросс-модальное слияние на основе графового внимания и обучение распутанным представлениям.
В аудиомодальности Wav2Vec-2.0 используется для моделирования речевых сигналов, полученных из исходной речевой информации в наборах данных CH-SIMS и CMU-MOSEI, что позволяет напрямую извлекать аудиопризнаки, связанные с эмоциями. Для каждого входного речевого сигнала  существует сверточное кодирование признаков:
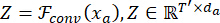 (4)
где Z обозначает низкоуровневые просодические признаки, такие как мелодика, тон и энергия. Контекстная сеть на базе трансформера дополняет вышеупомянутые структуры, представляя долгосрочные временные зависимости:
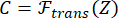 (5)
Просодические и семантические акустические данные, которые необходимы для выражения эмоций, включены в эти контекстуальные акустические представления. Эмбеддинг аудио определенной длины создается путем выполнения процедуры временного пулинга:
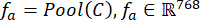 (6)
Данная архитектура исключает использование таких акустических признаков, как MFCC, и обеспечивает устойчивость за счет использования данных англоязычной речи из CMU-MOSEI и китайской речи из CH-SIMS путем простого извлечения представлений из форм волны.
Текстовая модальность с использованием RoBERTa для получения контекстных эмбеддингов эмоций
Для текстовой модальности к транскриптам речи из двух наборов данных применяется глубокий двунаправленный трансформер RoBERTa для генерации контекстуальной семантики и аффективного значения. Трансформерные энкодеры на базе RoBERTa использовались для извлечения текстовых представлений из данных транскриптов с целью захвата контекстуальной семантической и эмоциональной информации. Для англоязычного набора данных CMU-MOSEI использовалась предобученная модель RoBERTa, в то время как для китайского набора данных CH-SIMS применялся китайский вариант RoBERTa для более точного учета языковых особенностей. Предобработка текста включала токенизацию с помощью соответствующего токенизатора RoBERTa для каждого языка и нормализацию текста. Для обеспечения согласованности пакетной обработки входные последовательности преобразовывались в токен-эмбеддинги, после чего дополнялись или обрезались до заданной максимальной длины последовательности. В соответствии с форматом входных данных RoBERTa были введены специальные токены классификации и разделители. Текстовый эмбеддинг фиксированной длины был получен путем агрегирования контекстуализированных представлений токенов, созданных трансформерным энкодером, с использованием финального представления предложения, эквивалентного [CLS]. Для адаптации полученных представлений к задаче распознавания эмоций предобученные энкодеры RoBERTa были доработаны в процессе мультимодального обучения. Затем предложенная структура мультимодального слияния была использована для объединения текстовых эмбеддингов с аудио- и визуальными характеристиками.
Эмбеддинги токенов и позиционные кодировки могут быть объединены для каждого токенизированного входного элемента, 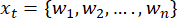 , чтобы создать входное представление в методе глубокого двунаправленного преобразования, известном как
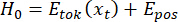 (7)
Эта форма представлена через слои L-трансформера, который использует механизм самовнимания (self-attention) для выявления контекстных зависимостей между словами:
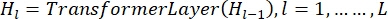 (8)
Контекстный эмбеддинг эмоций получается с использованием конечного скрытого состояния токена классификации:
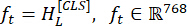 (9)
Полярность настроений, интенсивные эмоции и связанные с ними смыслы являются примерами лингвистических характеристик, относящихся к эмоциям, которые будут представлены этим эмбеддингом. RoBERTa упрощает языково-независимое моделирование. Это позволяет системе использовать одинаковый размер эмбеддинга как для английских текстов из набора данных CMU-MOSEI, так и для китайских текстов из набора данных CH-SIMS.
На предлагаемом этапе обучения глубокому представлению признаков извлекаются три специфичные для каждой модальности векторные характеристики размерностью 768: визуальная fv, аудио fa и текстовая ft . В дизайне интеллектуального взаимодействия эти полученные представления формируют единое мультимодальное пространство признаков, которое служит основой для визуального отображения на уровне признаков, кросс-модального слияния на основе графов и обучения распутанным представлениям.
Обучение распутанным представлениям
После получения глубокого представления признаков дополнительная обработка мультимодальных векторов признаков визуальной, слуховой и текстовой модальностей может позволить получить несвязное описание эмоций. Если специфические для каждой модальности вложения признаков слуховой, визуальной и текстовой модальностей, использованные на предыдущем этапе, представлены соответственно как fv, fa и ft, такие что  и
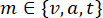 , целью данного этапа является факторизация всех признаков модальностей на два отдельных латентных описания, которые включают описания эмоций с учетом предшествующей семантики каждой из различных модальностей.
Это достигается путем подачи признаков каждой модальности, fm , в две параллельные проекционные сети: кодировщик эмоций  и кодировщик модальности
 , в которых формируются два кодирования.
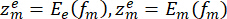 (10)
Где  скрытый признак, связанный с эмоцией, а
 представляет собой скрытый признак, специфичный для конкретной модальности. Это позволяет специфичным для эмоций эмбеддингам взаимодействовать с пространством многократно по нескольким входным данным, включая аудио-визуальные и текстовые, сохраняя при этом уникальные структурные данные, связанные с каждой модальностью.
Эффективное разделение обеспечивается за счет реконструкции с ограничениями независимости. Реконструкция признака исходной модальности определяется следующим образом:
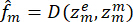 (11)
где  представляет собой сеть-декодер. Потеря при реконструкции сохраняет следующие данные:
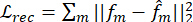 (12)
Кроме того, ортогональность или декорреляция между эмоциями и специфичными для модальности изображениями часто ограничивают перекрытие информации:
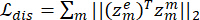 (13)
Достижение этих целей позволит модели выучить представления эмоций, которые будут надежными, понятными и устойчивыми к вариативности модальностей. Последующее кросс-модальное объединение на основе графов и функции визуального картирования, особенно для проектирования интеллектуального взаимодействия, в значительной степени опираются на интерпретируемые структурированные представления эмоций.
Согласованность эмоций между модальностями
Добавление согласованности эмоций явно повышает эффективность слияния модальностей. Это объясняется тем, что стратегии слияния больше не требуют учета значительных разрывов между двумя представлениями, так как специфичные для модальностей эмбеддинги эмоций разделяют общее латентное пространство. Комбинированная иллюстрация двух эмоций представлена следующим образом  . Взвешенное слияние будет более стабильным при согласованности специфичных для эмоций представлений, так как вариации между сигналами различных модальностей больше не будут влиять на результат.
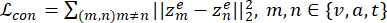 (14)
Путем обеспечения семантического выравнивания эмоциональной информации эта цель сводит к минимуму расхождения между модальностями и гарантирует, что восприятие эмоций остается неизменным независимо от модальности, используемой для их выражения. В результате создается целостное аффективное репрезентативное пространство путем проецирования эмоциональных признаков, полученных из речевых сигналов, мимики и лингвистического содержания.
Влияние на кросс-модальное слияние
Кросс-модальное слияние становится более эффективным при обеспечении согласованности эмоций между модальностями. Механизмы слияния больше не должны компенсировать значительные разрывы в межмодальных представлениях, поскольку специфичные для эмоций эмбеддинги выравниваются в общем латентном пространстве. Слитое представление эмоции определяется следующим образом:
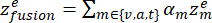 (15)
Где αm представляет собой вес внимания, уделяемого модальности m. Взвешенное слияние становится более стабильным и понятным, когда специфичные для эмоций представления согласуются, так как результат слияния демонстрирует взаимодополняющие эмоциональные признаки, а не противоречивые сигналы модальностей.
С математической точки зрения снижение  дисперсии между различными типами специфических для эмоций представлений по отношению к эквивалентно следующему:
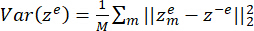 (16)
где  представляет среднее выражение эмоций. Снижение дисперсии приводит к тому, что входные модальности взвешиваются в соответствии с их точной эмоциональной значимостью, а не шумом модальности, что обеспечивает улучшенную сходимость сети и более точную оценку внимания.
Конечной целью обучения при визуализации распутанных эмоций является объединение фрагментации, реконструкции и однородности эмоций:
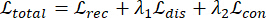 (17)
какие два гиперпараметра, λ1 и λ2, контролируют взаимосвязь между кросс-модальной надежностью эмоций и диссоциацией. Для достижения этой цели предлагаемая модель формирует модально-инвариантные, интерпретируемые и объединяемые эмоциональные представления, уделяя особое внимание созданию надежной основы для последующего слияния на основе графов и представления на уровне признаков при проектировании интеллектуальных интерфейсов.
Графовое кросс-модальное внимание для слияния данных
Для имитации детальных эмоциональных связей между модальностями была использована кросс-модальная сеть внимания на основе графов. Чтобы облегчить поток информации между модальностями был построен полностью связный мультимодальный граф, в котором каждый специфический для модальности эмбеддинг (текстовый, аудио- и визуальный) представлен в виде узла графа. Отношения между модальностями использовались для создания матрицы смежности графа, которая затем была оптимизирована с помощью обучаемого метода внимания. Общее латентное пространство было создано путем конкатенации и проекции выходов нескольких голов внимания. Затем было получено единое мультимодальное представление эмоций путем агрегирования представлений узлов с использованием пулинга с весами внимания. Это объединенное представление затем поступало в модули прогнозирования и визуализации для анализа с учетом взаимодействия и распознавания эмоций. Модуль слияния графов имел размерность скрытого представления 256 и два слоя внимания графа, каждый из которых содержал восемь голов внимания. Для определения относительной важности соседних модальностей рассчитывались коэффициенты внимания между связанными узлами, которые затем стандартизировались с помощью функции softmax. За каждым слоем внимания графа следовали нормализация слоя, остаточные связи (residual connections) и слой дропаута с коэффициентом 0,2 для повышения стабильности обучения и снижения переобучения. После конкатенации и проекции выходов нескольких голов внимания в общее латентное пространство представления узлов были объединены в единый мультимодальный эмбеддинг эмоций с помощью пулинга с весами внимания. После этого объединенное представление использовалось для многовидового визуального картирования и прогнозирования эмоций.
Разнообразные кросс-модальные взаимодействия регистрировались с помощью многоголового графового внимания. Для нормализации коэффициентов внимания между связанными узлами для каждого узла использовалась функция softmax. Для повышения стабильности обучения и предотвращения переобучения за стековыми слоями графового внимания модуля объединения графов следовали остаточные связи, послойная нормализация и регуляризация методом dropout.
Пусть обозначения по отдельности представляют собой представления, соответствующие конкретным эмоциям, собранным визуальным, аудио- и текстовым модальностями; каждый компонент находится в общем латентном пространстве  . Модели для узлов модальностей используют обозначение графа
 , где узлы совокупности
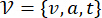 соответствуют трем узлам модальностей, чтобы эксплицитно усилить эмоциональные зависимости, общие для различных представлений модальностей.
После присвоения каждому узлу графа вектора признаков, специфичного для определенной эмоции, мы получаем следующее:
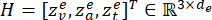 (18)
В отличие от традиционных методов слияния, в которых используются предопределенные или фиксированные веса слияния, предлагаемый метод позволяет определять адаптивные веса ребер на основе их значимости и взаимозависимостей как между каналами, так и между эмоциональными ситуациями.
Для кросс-модального слияния используется графовая сеть внимания (GAT). Коэффициент внимания вычисляется для каждого узла i и его соседних узлов, т. е. узла j:
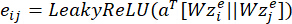 (19)
Эмоциональный эффект перехода от моды j к модальности i измеряется нормированными весами αij.
Затем вычисляемый объединенный вид каждого узла модальности определяется как взвешенная группировка его соседей:
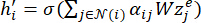 (20)
где функция активации  является нелинейной. В конечном итоге обновленные признаки каждого узла объединяются для получения глобального комбинированного представления эмоций:
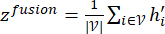 (21)
Это полезный метод для интерпретируемого моделирования эмоций и последующего визуального картирования, поскольку он позволяет извлекать дополняющую друг друга информацию из различных модальностей, сохраняя при этом сложные межмодальные связи.
Алгоритм 1 (Дополнительный файл 1) представляет собой общую схему реализации кросс-модального слияния на основе графов. Сначала создается граф, в котором специфические для каждой эмоции характеристики связаны с каждой из визуальной, аудио- и текстовой модальностей. Затем рассчитываются показатели внимания для каждой пары узлов графа, которые представляют собой комбинацию эмоциональной зависимости. После этого показатели внимания нормализуются для определения относительного вклада каждой модальности в заданный эмоциональный контекст, что позволяет обучать веса внимания. На заключительном этапе формируется общий вектор вложения эмоции путем агрегирования признаков, связанных с узлами графа. Таким образом, общее слияние мультимодальных признаков, связанных с определенными эмоциями, в данном алгоритме демонстрирует потенциал с точки зрения адаптивности, интерпретируемости и контекстуального интеллекта.
Рисунок 2 демонстрирует структуру и принцип работы предлагаемой сети кросс-модального внимания для мультимодального слияния признаков сентимент-анализа. Эмоциональные эмбеддинги, полученные независимо для текстовой, слуховой и видеомодальностей, сначала проходят через механизмы внимания на уровне модальностей, которые определяют относительную важность лингвистической, вокальной и мимической информации для данного эмоционального контекста. Затем представления модальностей, взвешенные с помощью внимания, объединяются для формирования единого эмоционального эмбеддинга, при этом матрица внимания фиксирует межмодальные зависимости и силу взаимодействия. Матрица внимания, обучаемая сетью, динамически модулирует вклад каждой модальности, позволяя системе фокусироваться на наиболее информативном канале, игнорируя зашумленные и менее значимые данные. Слитое эмоциональное представление обеспечивает точное распознавание эмоций и детальный анализ таких эмоциональных состояний, как нейтральное, объятие и беспокойство.
Модуль визуального картирования
С помощью раздела визуального картирования, созданного специально для этой цели, дизайнер интеллектуального взаимодействия может преобразовать унифицированное представление эмоционального состояния в понятную и легко воспринимаемую визуальную форму на основе графа после процесса кросс-модального слияния.
Для облегчения понимания латентных эмоциональных представлений для визуализации изученных мультимодальных эмбеддингов эмоций использовались методы снижения размерности. После снижения размерности признаков с сохранением большей части дисперсии с помощью метода главных компонент (PCA), эмбеддинги были спроецированы в двумерное пространство для отображения с использованием стохастического соседства с t-распределением (t-SNE). Для t-SNE использовались значение перплексии 30, скорость обучения 200 и 1 000 итераций оптимизации. С помощью полученных проекций были визуализированы специфические для эмоций кластеры и взаимосвязи между модальностями. Для создания тепловых карт внимания использовались нормализованные веса кросс-модального внимания, полученные с помощью графовой сети внимания. На этих тепловых картах отображен относительный вклад текстовой, аудио- и визуальной модальностей при прогнозировании эмоций. Изученные коэффициенты внимания использовались в качестве весов ребер для создания графов кросс-модального взаимодействия, что позволило визуально изучить межмодальные связи и информационные потоки внутри структуры слияния. Для анализа временной эмоциональной динамики были построены графики траекторий эмоций путем мониторинга развития латентных эмбеддингов эмоций в последовательных высказываниях. Эти траектории проясняют, как меняются эмоциональные состояния и вклад модальностей с течением времени. Для создания всех визуализаций использовались два пакета Python: Matplotlib и Scikit-learn. Для оценки интерпретируемости, формирования кластеров, вклада модальностей и временной динамики эмоций был проведен качественный анализ визуализаций эмбеддингов, графов взаимодействия и тепловых карт внимания.
Пусть переменная 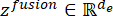 будет представлять собой объединенное представление эмоционального состояния, полученное с помощью функции графовой сети внимания. В отличие от визуализации графиков эмоционального состояния на уровне выходных данных, основной целью данного модуля является преобразование представлений эмоционального состояния и соответствующих весов механизма внимания в понятную визуальную форму.
С помощью полученных αji создается тепловая карта внимания для визуального анализа вклада каждой модальности. Затем входящие веса внимания суммируются для определения совокупного показателя значимости каждой модальности:
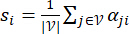 (22)
где si представляет собой относительный эмоциональный вклад модальности I. Для создания тепловой карты внимания полученные значения нормализуются и отображаются на цветовой карте, которая позволяет пользователю легко определить доминирующую модальность на различных временных этапах или в интерактивных состояниях. Благодаря различным визуальным, слуховым или текстовым модальностям ввода такой интерфейс помогает пользователю понять принципы работы механизма внимания системы.
Обучаемый граф специально моделируется как «взвешенный граф взаимодействий» для представления кросс-модальной зависимости человеческих эмоций. Сама модальность представлена каждым узлом графа, а сила взаимодействий, связанных с человеческими эмоциями, представлена весами в виде αji на ребрах, которые их соединяют. Приведенный выше взвешенный граф иллюстрирует интенсивность эмоциональных взаимодействий человека. Определения i и j следующие:
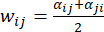 (23)
Благодаря этим весовым коэффициентам толщина линий или прозрачность визуализации графа отображаются надлежащим образом. Это облегчает понимание того, как взаимодействуют модальности. С помощью графов кросс-модального взаимодействия дизайнер может лучше понять, как эмоциональные индикаторы взаимодействуют в процессе слияния.
Объединенные эмбеддинги эмоций  на различных временных этапах переводятся в пространство меньшей размерности с помощью алгоритма снижения размерности, такого как PCA или t-SNE, для визуализации эволюции временных эмоций:
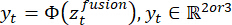 (24)
где функция проекции представлена  . Появление 2D/3D траекторий эмоций, которые демонстрируют переходы, интенсивность и стабильность эмоций в ходе взаимодействий, может быть интерпретировано как интуитивное изображение эволюции эмоциональных состояний во времени. Эти аспекты могут быть использованы для интеллектуального взаимодействия, принятия решений и мониторинга в режиме реального времени.
В отличие от традиционных систем распознавания эмоций, которые лишь сопоставляют данные с определенными классами или баллами, данная система ориентирована на демонстрацию механизмов формирования человеческих эмоций внутри нее. Она раскрывает процесс принятия решений, предоставляя визуализацию промежуточных признаков, включая весовые коэффициенты, взаимодействия между моделями и соответствующие пути их прохождения. Это позволяет пользователю понять, как каждый фактор — визуальный, вокальный или лингвистический — влияет на формирование ответов системы на человеческие эмоции.
Таким образом, сопоставление эмоций с понятными формами с помощью визуальных представлений может восполнить пробел между анализом эмоций с использованием методов глубокого обучения и их интеграцией в проектирование интеллектуальных интерфейсов. Данные, собранные обоими подходами, могут быть затем использованы для создания более точных пользовательских интерфейсов. Следовательно, предлагаемый подход может предоставить дизайнерам взаимодействия важную информацию для создания более точных пользовательских интерфейсов. Другими словами, понимание эмоций становится активной частью дизайна взаимодействия. Точность может повыситься только в том случае, если понимание эмоций будет активно внедрено в процесс проектирования взаимодействия.
Модуль визуального отображения обеспечивает интерпретируемость несколькими взаимосвязанными, но различными способами: интерпретируемость на уровне признаков раскрывает лежащие в основе представления эмоций, созданные DNN, что позволяет нам понять семантику, используемую для описания каждого признака, связанного с эмоциями; интерпретируемость на уровне модальности использует данные из графов взаимодействия и тепловых карт визуального внимания для описания того, как каждая модальность — визуальная, аудио- или текстовая — влияет на решения по выражению эмоций; и, наконец, траектории, полученные в результате вложения эмоций, позволяют понять, как каждая визуальная и текстовая модальность изменяется со временем с точки зрения динамического взаимодействия. Пожалуйста, обратитесь к Алгоритму 2 (Supplementary File 1).
Объединенные мультимодальные эмоциональные признаки отображаются на визуально значимые представления для проектирования интеллектуального взаимодействия с использованием предложенного алгоритма визуального отображения 2. Веса графового мультимодального внимания используются для количественной оценки различий между входными визуальными, аудио- и текстовыми элементами на каждом временном шаге. Затем эти различия отображаются на визуальные представления для выделения основных источников, влияющих на эмоции, с помощью визуальных элементов тепловой карты. Чтобы обеспечить детальный обзор взаимодействия между входными элементами и передать эволюцию эмоций, вызванную мультимодальными входными данными, затем вычисляются попарные интенсивности взаимодействия для создания весов мультимодального взаимодействия. Одновременно с этим создается представление эволюции эмоций путем отображения объединенных эмоциональных элементов, собранных за определенный период времени, в низкоразмерное пространство для получения непрерывной эволюции эмоционального элемента.
Прогнозирование эмоций и обратная связь при взаимодействии
Результат объединенного представления эмоций, выраженный как , затем используется в качестве функции как для обратной связи по взаимодействию, так и для прогнозирования эмоций. Кроме того, прогнозирование эмоций описывается как многозадачная модель, включающая задачу регрессии для распознавания непрерывной интенсивности эмоций и задачу классификации для распознавания дискретных эмоций. Для распознавания дискретных эмоций используется следующая классификационная модель на основе функции softmax:
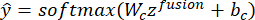 (25)
где  представляет собой ожидаемые вероятности классов эмоций, а Wc и bc являются обучаемыми ограничениями. Для улучшения цели классификации используется перекрестная энтропия:
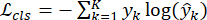 (26)
где yk — это истинная метка, а K — количество классов эмоций. Регрессионная ветвь используется для параллельной оценки интенсивности эмоций, создавая прогноз различных непрерывных аффективных атрибутов, включая валентность и возбуждение. Приведите следующее определение:
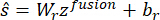 (27)
где ожидаемый показатель интенсивности эмоций обозначен как  . Для улучшения задачи регрессии используется функция потерь среднеквадратичной ошибки:
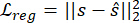 (28)
В целом, эти две задачи объединяются в целевой функции прогнозирования:
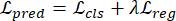 (29)
где цели регрессии и классификации сбалансированы с помощью λ. Это предполагает динамическую модификацию модуля визуализации на основе определенного эмоционального состояния для обеспечения такого типа обратной связи, учитывающей взаимодействие. Контекст взаимодействия в данный момент времени t представлен как ct. Ответ модуля визуализации определяется следующим образом:
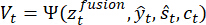 (30)
где функция адаптации визуализации представлена  . Это позволяет в режиме реального времени корректировать тепловые карты модальностей, графы взаимодействий и траектории эмоций на основе ожидаемых изменений и эмоциональных состояний. Это свидетельствует о том, что система, помимо высокой эффективности в прогнозировании эмоционального состояния, обеспечивает существенную поддержку обратной связи.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Результаты
В данной работе подтверждается эффективность предложенного фреймворка визуального картирования мультимодальных признаков эмоций с точки зрения как интерпретируемости с учетом взаимодействия, так и прогностической способности, с использованием двух эталонных наборов данных: CH-SIMS и CMU-MOSEI. Согласно результатам экспериментов, предложенный подход стабильно превосходит современные методы мультимодального распознавания эмоций по ряду показателей, включая корреляцию, точность, F1-меру и среднюю абсолютную ошибку (MAE). Ра...
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Обсуждение
Экспериментальные результаты показывают, что на наборах данных CH-SIMS и CMU-MOSEI предложенная структура визуального сопоставления для мультимодальных характеристик эмоций превосходит современные методы распознавания мультимодальных эмоций. По сравнению с моделями раннего и позднего объединения, такими как EF-LSTM и TFN, предложенный метод обеспечивает более высокую точность и значения F1-меры, что демонстрирует его устойчивость при обработке разнообразной эмоциональной информации. Улучшение метода можно объяснить распу...
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Раскрытие информации
Авторы не имеют конфликта интересов.
Благодарности
Авторы выражают благодарность за поддержку, оказанную Школой жилья, строительства и планирования Университета Sains Malaysia (Пенанг, Малайзия) и Школой дизайна и искусства Чаншаского университета естественных наук & Технологии, Чанша, Китай. Авторы также выражают благодарность Академии искусств и дизайна города Сямынь Университета Фучжоу, Сямынь, Китай, за академическую и исследовательскую поддержку на протяжении всей данной работы.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Материалы
| Имя | Компания | Каталожный номер | Комментарии |
|---|---|---|---|
| Адам | Библиотека оптимизаторов PyTorch | https://pytorch-optimizers.readthedocs.io/en/latest/ (Скорость обучения = 1 × 10⁻⁴) | Оптимизация параметров при обучении модели |
| CH-SIMS | Репозиторий исходного набора данных | Последний публичный выпуск | Эталонный набор данных для китайского мультимодального анализа сентимента/эмоций |
| CMU-MOSEI | Репозиторий CMU Multimodal SDK | https://github.com/CMU-MultiComp-Lab/CMU-MultimodalSDK (последний публичный релиз) | Эталонный набор данных для мультимодального распознавания настроений и эмоций |
| Дистиллированный энкодер эмоций | Индивидуальная реализация | Архитектура с двойным кодировщиком (Dual Encoder Architecture) | Разделение специфичных для эмоций и специфичных для модальности латентных представлений |
| Графовая сеть внимания (GAT) | PyTorch Geometric | Многоголовый GAT (https://pytorch-geometric.readthedocs.io/en/latest/) | Моделирование кросс-модальных эмоциональных связей и адаптивное слияние признаков |
| Слой кросс-модального внимания на основе графов | Индивидуальная реализация | Слияние с механизмом многоголового внимания | Изучение детальных эмоциональных зависимостей между модальностями |
| Matplotlib | Проект Matplotlib | 3.7+ | Построение графиков и визуальная аналитика |
| NetworkX | Проект NetworkX | 3.0+ | Построение и визуализация графов кросс-модального взаимодействия |
| GPU NVIDIA | NVIDIA Corporation | GPU с поддержкой CUDA | Ускорение обучения трансформеров и графовых нейронных сетей |
| Метод главных компонент (МГК) | Scikit-learn | sklearn.decomposition.PCA | Первичное снижение размерности многомерных эмбеддингов эмоций |
| Python | Python Software Foundation | 3.8+ | Основной язык программирования для реализации среды мультимодального анализа эмоций |
| PyTorch | PyTorch Foundation | 2.0+ | Разработка, обучение и оптимизация глубоких нейронных сетей |
| RoBERTa | Hugging Face Transformers | https://huggingface.co/docs/transformers/index (roberta-base, эмбеддинги размерности 768) | Извлечение контекстуальных лингвистических и семантических представлений эмоций |
| Seaborn | Проект Seaborn | 0.12+ | Построение карт внимания и статистическая визуализация |
| t-распределенное стохастическое вложение соседей (t-SNE) | Scikit-learn | scikit-learn.org (перплексия = 30, количество итераций = 1000) | Визуализация латентных кластеров и траекторий эмоций |
| Ubuntu Linux | Canonical Ubuntu | 20.04 LTS или более поздняя версия | Среда проведения эксперимента |
| Vision Transformer (ViT-Base) | Google Research Vision Transformer | ViT-Base/16, эмбеддинги размерности 768 | Извлечение визуальных представлений из видеокадров с учетом эмоционального состояния |
| Wav2Vec 2.0 | Исследовательский центр Meta AI | Базовая модель, 768-мерные эмбеддинги | Извлечение контекстных акустических признаков и признаков эмоциональной окраски речи |
Ссылки
- Zhu X, et al. EMVAS: End-to-end multimodal emotion visualization analysis system. Complex Intell Syst. 2025;11:1-15.
- Zhu X, et al. A client-server based recognition system: Non-contact single/multiple emotional and behavioral state assessment methods. Comput Methods Programs Biomed. 2025;260:108564.
- Lasri I, Riadsolh A, Elbelkacemi M. Facial emotion recognition of deaf and hard-of-hearing students for engagement detection using deep learning. Educ Inf Technol. 2023;28:4069-4092.
- Saibene A, Assale M, Giltri M. Expert systems: Definitions, advantages and issues in medical field applications. Expert Syst Appl. 2021;177:114900.
- Poria S, Cambria E, Bajpai R, Hussain A. A review of affective computing: From unimodal analysis to multimodal fusion. Inf Fusion. 2017;37:98-125.
- Chatterjee R, et al. Real-time speech emotion analysis for smart home assistants. IEEE Trans Consum Electron. 2021;67(1):68-76.
- Zhu X, Huang Y, Wang X, Wang R. Emotion recognition based on brain-like multimodal hierarchical perception. Multimed Tools Appl. 2024;83:56039-56057.
- Khan M, El Saddik A, Alotaibi FS, Pham NT. AAD-Net: Advanced end-to-end signal processing system for human emotion detection and recognition using attention-based deep echo state network. Knowl Based Syst. 2023;270:110525.
- Chaturvedi I, Chen Q, Cambria E, McConnell D. Landmark calibration for facial expressions and fish classification. Signal Image Video Process. 2022;16:377-384.
- Li D, Liu J, Yang Z, Sun L, Wang Z. Speech emotion recognition using recurrent neural networks with directional self-attention. Expert Syst Appl. 2021;173:114683.
- Zhu X, et al. A review of key technologies for emotion analysis using multimodal information. Cogn Comput. 2024;16:1504-1530.
- Wang R, et al. Multimodal emotion recognition using tensor decomposition fusion and self-supervised multitasking. Int J Multimed Inf Retr. 2024;13:39.
- Fan C, Lin J, Mao R, Cambria E. Fusing pairwise modalities for emotion recognition in conversations. Inf Fusion. 2024;106:102306.
- Williams J, Kleinegesse S, Comanescu R, Radu O. Recognizing emotions in video using multimodal DNN feature fusion. Proceedings of Grand Challenge and Workshop on Human Multimodal Language. Melbourne, Australia. 2018;10.18653/v1/W18-3302.
- Zhao Z, Wang Y, Wang Y. Multi-level fusion of Wav2Vec 2.0 and BERT for multimodal emotion recognition. arXiv. 2022;arXiv:2207.04697.
- Middya AI, Nag B, Roy S. Deep learning based multimodal emotion recognition using model-level fusion of audio-visual modalities. Knowl Based Syst. 2022;244:108580.
- Maithri M, et al. Automated emotion recognition: Current trends and future perspectives. Comput Methods Programs Biomed. 2022;215:106646.
- Wu Y, Mi Q, Gao T. A comprehensive review of multimodal emotion recognition: Techniques, challenges, and future directions. Biomimetics. 2025;10(4):418.
- Zheng S, Zhang X, Liu Y, Li Z. CMFF: A cross-modal multi-layer feature fusion network for multimodal sentiment analysis. Appl Soft Comput. 2025;184(Pt B):113868.
- Yan L, Shi Y, Wei M, Wu Y. Multi-feature fusing local directional ternary pattern for facial expressions signal recognition based on video communication system. Alex Eng J. 2023;63:307-320.
- Guo X, Zhang Y, Lu S, Lu Z. Facial expression recognition: A review. Multimed Tools Appl. 2024;83(8):23689-23735.
- Liu ZT, Han MT, Wu BH, Rehman A. Audio emotion recognition based on convolutional neural network with attention-based bidirectional long short-term memory network and multitask learning. Appl Acoust. 2023;202:109178.
- Mirsamadi S, Barsoum E, Zhang C. Automatic audio emotion recognition using recurrent neural networks with local attention. 2017 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP), New Orleans, LA, USA. 2017; 10.1109/ICASSP.2017.7952552.
- Gu T, He Z, Zhao H, Li M, Ying D. Aspect-based sentiment analysis with multi-granularity information mining and sentiment hint. Expert Syst Appl. 2024;252:124104.
- Shen W, Chen J, Quan X, Xie Z. DialogXL: All-in-one XLNet for multi-party conversation emotion recognition. Proc AAAI Conf Artif Intell. 2021;35(15):13789-13797.
- Kim T, Vossen P. EmoBERTa: Speaker-aware emotion recognition in conversation with RoBERTa. arXiv. 2021;arXiv:2108.12009.
- Li S, Yan H, Qiu X. Contrast and generation make BART a good dialogue emotion recognizer. Proc AAAI Conf Artif Intell. 2022;36(10):11002-11010.
- Zhu J, Yu J. MIAR: Modality interaction and alignment representation fusion for multimodal emotion. arXiv. 2026;arXiv:2601.02414.
- Praveen RG, Granger E, Cardinal P. Cross attentional audio-visual fusion for dimensional emotion recognition. 2021 16th IEEE International Conference on Automatic Face and Gesture Recognition (FG 2021), Jodhpur, India. 2021;10.1109/FG52635.2021.9667055.
- Salas-Cáceres J, López M, Martínez A, Rodríguez P. Multimodal emotion recognition based on a fusion of audio-visual information with temporal dynamics. Multimed Tools Appl. 2025;84:27327-27343.
- Fu J, Zhang Y, Wang L, Chen H. TMFN: A text-based multimodal fusion network with multi-scale feature extraction and unsupervised contrastive learning for multimodal sentiment analysis. Complex Intell Syst. 2025;11:133.
- Tuerhong G, Fu F, Wushouer M. Adaptive multimodal transformer based on exchanging for multimodal sentiment analysis. Sci Rep. 2025;15:27265.
- Gupta C, Sharma R, Patel S, Verma A. A multimodal fusion model for real-time environment emotion recognition using audio-visual-textual features. J Big Data. 2025;12:256.
- Yu W, Li X, Zhang H, Wang Z, Liu Z. CH-SIMS: A Chinese multimodal sentiment analysis dataset with fine-grained annotation of modality. Proceedings of the 58th Annual Meeting of the Association for Computational Linguistics. 2020; 10.18653/v1/2020.acl-main.343.
- Zadeh A, et al. Multimodal language analysis in the wild: CMU-MOSEI dataset and interpretable dynamic fusion graph. Proceedings of the 56th Annual Meeting of the Association for Computational Linguistics, Melbourne, Australia. 2018; 10.18653/v1/P18-1208.
- Zadeh A, Chen M, Poria S, Cambria E, Morency LP. Tensor fusion network for multimodal sentiment analysis. arXiv. 2017;arXiv:1707.07250.
- Tsai YHH, Bai S, Yamada M, Morency LP, Salakhutdinov R. Multimodal transformer for unaligned multimodal language sequences. Proceedings of the 57th Annual Meeting of the Association for Computational Linguistics, Florence, Italy. 2019; 10.18653/v1/P19-1656.
- Moreno M, Rioseco P, Van Den Bosch H. Spectrum of the linearized Vlasov–Poisson equation around steady states from galactic dynamics. arXiv. 2023;arXiv:2305.05749.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.