Этот протокол реализует U-образную сеть глубокого обучения, интегрирующую свёртку с вертушками, двойное внимание и многомасштабное слияние для сегментирования колоректальных полипов.
Для просмотра этого контента требуется подписка на JoVE. Войдите или начните свой бесплатный пробный период.
Методическая статья
Сеть сегментации полипов на основе свёртки с вертушкой и двойного внимания для диагностики колоректальных предраковых поражений
* These authors contributed equally
В этой статье
Краткое содержание
Аннотация
Точная сегментация колоректальных полипов крайне важна для ранней профилактики и диагностики колоректального рака. Однако из-за высокой гетерогенности полипов по форме, размеру и текстуре, а также сложности кишечной среды (такой как складки, зеркальные отражения и каловые остатки) существующие методы всё ещё сталкиваются с серьёзными трудностями в локализации границ и обнаружении мелких полипов. Для решения этих проблем в данной статье предлагается сеть сегментации полипов на основе свёртки с вертушками и двойного внимания (PWD-Net). Предлагаемая сеть использует U-образную архитектуру энкодер-декодер, где в качестве энкодера используется предварительно обученный ResNet для извлечения многоуровневых локальных признаков. В частности, модуль свёртки Вертушки (PCM) вводится на узком уровне для захвата глобальной геометрической структуры и многонаправленной контекстуальной информации полипов через ядра свёртки с несколькими углом вращения. Механизм двойного внимания (DAM), интегрирующий внимание канала и пространственное внимание, предназначен для адаптивного подавления фонового шума и усиления особенностей области полипов. Кроме того, применяется стратегия многомасштабного синтеза признаков (MSF) для объединения глубокой семантической информации с поверхностными граничными деталями, обеспечивая как полноту, так и точность результатов сегментации. Эксперименты, проведённые на наборах данных Kvasir-SEG и CVC-ClinicDB, показывают, что PWD-Net достигает средних коэффициентов кубиков 0,865 и 0,944, а также показателей IoU 0,765 и 0,892 соответственно, значительно превосходя существующие современные методы. Исследования абляции подтверждают эффективность каждого модуля, а кросс-наборы подтверждают высокую способность модели к обобщению. Это исследование предоставляет высокоточное и надёжное решение для клинической сегментации полипов, предлагая значительную ценность для ранней диагностики колоректальных предраковых поражений и поддерживая компьютерное вмешательство.
Введение
Колоректальный рак — одна из самых распространённых злокачественных опухолей в мире, с постоянно высокими показателями заболеваемости и смертности. Исследования показали, что большинство колоректальных раков развиваются из-за аденоматозных полипов, процесс, который обычно занимает 10–15 лет, что обеспечивает ценное временное окно для раннего выявления и вмешательства. Повышение уровня обнаружения аденомы (ADR) на 1% может снизить риск колоректального рака примерно на 3%, значительно снижая смертностьпациентов 1. Колоноскопия, считающаяся золотым стандартом скрининга колоректального рака, позволяет напрямую удалять полипы во время обследования, что эффективно снижает заболеваемость и смертность от рака.
Однако традиционная колоноскопия сильно зависит от опыта и уровня подготовки эндоскопистов. Такие факторы, как субъективное суждение, зрительная усталость и отвлечение, могут привести к проценту промахов от 20% до 30%, что напрямую влияет на эффективностьскрининга 2. Поэтому разработка систем автоматизированного обнаружения (CAD) для автоматической сегментации колоректальных полипов имеет большое значение для улучшения ADR и сокращения пропущенных диагнозов. Недавние клинические исследования ещё больше подчеркнули интерес к интеграции искусственного интеллекта в рабочие процессы оценки эндоскопических поражений, подчёркивая необходимость надёжных и воспроизводимых методовсегментации 3.
В последние годы глубокое обучение достигло значительных успехов в анализе медицинских изображений, особенно в сверточных нейронных сетях (CNN), которые демонстрируют сильные возможности в извлечении и представлении признаков для задач сегментацииизображений 4. Как классическая модель сегментации медицинских изображений, U-Net использует архитектуру симметричного энкодер-декодера и пропускные соединения для достижения точной сегментации на уровне пикселей, став эталоном в этойобласти. Опираясь на U-Net, было предложено множество улучшенных архитектур для решения сложных задач сегментации медицинских изображений. UNet++ сокращает семантический разрыв между отображением признаков кодировщика и декодера, вводя вложенные и плотные пропускающиесоединения 6. ResUNet++ интегрирует остаточные блоки, модули сжатия и возбуждения, расширенные свёртки и механизмы внимания, обеспечивая высокую производительность в сегментацииполипов 7. U2-Net использует двухуровневую вложенную U-образную структуру для сбора многомасштабной информации опризнаках 8. В последнее время была предложена сеть сегментации глубоких полипов на базе двойного энкодер-декодер, использующая параллельное кодирование и декодирование путей для дальнейшего повышения точностисегментации 9.
В то же время внедрение механизмов внимания открывает новые решения для усиления функций функций и подавления шума. Attention U-Net использует ворота внимания, чтобы сосредоточиться на целевых регионах, подавляя при этом нерелевантную фоновуюинформацию 10. Сеть двойного внимания (DANet) адаптивно взвешивает признаки как по каналу, так и попространственному измерениям 11, улучшая восприятие критически важных признаков. Triple Attention Networks (TANet) дополнительно повышают производительность сегментации за счёт адаптивного выбора многомасштабных функций12.
С успехом архитектур трансформеров в обработке естественного языка и компьютерномзрении 13 исследователи начали изучать их применение в сегментации медицинских изображений. TransUNet первым использовал трансформер в качестве энкодера для эффективного моделирования дальнихзависимостей 14. Swin-UNet использует чисто трансформерскую архитектуру и обеспечивает эффективную глобальную агрегацию информации с помощью механизма сдвиговогоокна 15. UTNet предлагает гибридную архитектуру, которая объединяет локальную возможность извлечения признаков CNN с глобальными возможностями моделированияTransformers 16.
В области сегментации полипов Polyp-PVT использует пирамидальный трансформер для захвата многомасштабной глобальной семантическойинформации 17, тогда как многомасштабный вложенный UNet улучшает контекстное понимание за счёт интеграцииTransformers 18. Недавние исследования также изучали стратегии обучения с отрицательной корреляцией для междоменной сегментацииполипов 19, усиления сегментации с дополнением поГомперцу 20 и архитектуры, основанные на внимание, с использованием пограничногоруководства 21. Хотя эти подходы в некоторой степени улучшают эффективность сегментации, сегментация полипов всё ещё сталкивается с рядом проблем. Во-первых, полипы демонстрируют высокую гетерогенность по морфологии, размеру и текстуре — от микрополипов размером меньше 5 мм до крупных полипов свыше 30 мм, с формами от круглых и эллиптических до сильно неправильных. Во-вторых, среда кишечника сложна и изменчива: слизистые складки, зеркальные отражения, каловые остатки и пищевые остатки создают сильные фоновые помехи. В-третьих, многие полипы имеют размытые границы, могут быть частично закрыты складками или погружаться в кишечные жидкости, что делает точную локализацию границ крайнесложной 22.
Существующие методы по-прежнему имеют явные ограничения в решении этих проблем. Традиционные CNN эффективно извлекают локальные текстурные и крайевые особенности; Однако ядра с фиксированной квадратной свёрткой плохо подходят для захвата различных геометрических форм23, особенно для сильно неправильных полипов, и не могут эффективно моделировать многонаправленные геометрические особенности. Методы на основе трансформаторов могут моделировать глобальные зависимости, но менее эффективны в захвате мелких локальных деталей и информации о границах. Кроме того, их высокая вычислительная сложность делает их менее подходящими для клинических приложений в реальномвремени 24. Современные подходы к сегментации полипов, такие как PraNet, использующий модули обратного внимания для уточнения ключевыхобластей 25, каскад внимания, ориентированные на границы, улучшающие экстракцию граничныхпризнаков 26, и CAFE-Net, объединяющий функции энкодера и декодера через механизмы перекрёстного внимания27, по-прежнему сталкиваются с недостаточным представлением признаков и неточной локализацией границ при работе с малымиполипами 28, размытые границы и сложные предыстории. Кроме того, большинство методов игнорируют геометрическую морфологию и не используют многонаправленную контекстную информацию, что приводит к неоптимальной сегментации неправильной формы полипов.
В заключение, современные методы на базе CNN не способны захватывать многонаправленные геометрические признаки из-за зависимости от ядра с фиксированной квадратной свёрткой. Подходы на основе трансформаторов предлагают глобальное моделирование, но жертвуют локальной точностью границ и требуют высоких вычислительных затрат. В то же время существующие стратегии слияния с повышенным вниманием и многомасштабного синтеза не были совместно оптимизированы в единой структуре, специально разработанной для сегментацииполипов 29. Эти пробелы мотивируют разработку метода, который одновременно охватывает геометрическое моделирование признаков, адаптивное шумоподавление и межмасштабную интеграцию признаков.
Для решения этих проблем этот протокол представляет сеть сегментации полипов, основанную на свертке Pinwheel и Dual Attention (PWD-Net). Предлагаемая сеть интегрирует геометрическое моделирование признаков, многомерное усиление внимания и многомасштабное слияние признаков, что позволяет точно сегментировать сложные полипы. Основные вклады этой работы обобщены следующим образом: модуль свёртки с вертушками (PCM), вдохновлённый структурой вертушки, предлагается новая конструкция ядра с вращающейся свёрткой, которая фиксирует многонаправленные геометрические особенности полипов посредством операций свёртки под несколькими углами (0°, 45°, 90°, 135°, 180°, 225°, 270° и 315°). Этот модуль заменяет традиционный слой свёртки на стадии узкого места, обеспечивая эффективное восприятие различных ориентаций краёв и значительно улучшая представление неправильной формы полипов. Механизм двойного внимания (DAM) устраняет фоновые шумы, такие как складки, отражения и калдыки кала на изображениях колоноскопии. Разработан модуль двойного внимания, интегрирующий внимание канала и пространственное внимание. Встроенный в пропускные соединения, этот модуль адаптивно подавляет фоновые интерференции и усиливает реакцию признаков в областях полипов, совместно определяя «что» важно (размер канала) и «место» расположения цели (пространственное измерение), обеспечивая, чтобы в последующее слияние участвовали только более тонкие элементы. Многомасштабная стратегия слияния признаков (MSF) сохраняет как глубокую семантическую информацию, так и поверхностные граничные детали с помощью иерархического механизма, введённого в декодере. Постепенно интегрируя функции энкодера с улучшенными DAM с апсемплированными функциями декодера, эта стратегия эффективно компенсирует потерю пространственных деталей, вызванную понижением дискретизации, обеспечивая точное обнаружение мелких полипов и точное определение границ.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Протокол
В данном исследовании используются только общедоступные, анонимизированные наборы изображений колоноскопии (Kvasir-SEG). Новых данных о людях не собиралось. Одобрение институциональной этики и информированное согласие пациента не требовались, что подтверждается политикой институционального обзора для ретроспективного анализа деидентифицированных публичных наборов данных.
1. Подготовка данных
- Скачайте набор данных Kvasir-SEG из официального репозитория33 (https://datasets.simula.no/kvasir-seg/). Набор данных содержит 1000 изображений полипов с соответствующими масками на уровне пикселей на уровне истины на земле.
- Случайным образом разделите наборы данных на обучающие (800 изображений), валидационные (100 изображений) и тестовые (100 изображений) с соотношением 8:1:1 с использованием фиксированного случайного сида (seed = 42). Проверьте, не перекрываются ли изображения между тремя подмножествами, чтобы предотвратить утечку данных.
- Измените размер всех изображений и соответствующих масок до 352 x 352 пикселей с использованием билинейной интерполяции для изображений и интерполяции для самых близких соседей для масок.
- Нормализуйте значения пикселей до [0, 1], деля на 255, затем примените среднее вычитание по каналам ImageNet (0,485, 0,456, 0,406) и стандартную нормализацию отклонения (0,229, 0,224, 0,225).
- Примените следующие преобразования дополнения только к обучающему набору (не к валидационным или тестовым наборам): случайный горизонтальный переворот (вероятность = 0,5); случайный вертикальный переворот (вероятность = 0,5); случайное вращение (диапазон: от −30° до +30°, вероятность = 0,5); Случайное многомасштабное изменение размера (коэффициент масштаба: 0,75–1,25, вероятность = 0,5)
ПРИМЕЧАНИЕ: Примените идентичные пространственные преобразования как к изображению, так и к соответствующей маске для поддержания выравнивания. Проверьте корректность аугментации, визуально осмотрев несколько пар аугментированного изображения–маска перед началом обучения.
2. Общая архитектура
ПРИМЕЧАНИЕ: См. рисунок 1 для макроуровневого энкодер-декодера основы PWD-Net и рисунок 2 для интеграции и взаимодействия основных модулей в потоке признаков. Общая архитектура выполнена по схеме U-образного энкодера-декодера для обработки изменений масштаба полипов и фоновых интерференций в изображениях колоноскопии.
- Магистраль и путь кодирования (рисунок 1)
- Используйте ResNet-50, предварительно обученный на ImageNet (полученный из официального зоопарка моделей PyTorch), в качестве основного энкодера30. Тонко настраивайте все слои энкодера во время обучения.
- Подайте входное изображение колоноскопии (уменьшенное до 352 x 352 пикселей) через пять этапов остаточных сверточных блоков для извлечения иерархических признаков. Пространственное разрешение карт объектов постепенно понижается от до на пяти этапах, а размеры канала соответственно увеличиваются (64 → 128 → 256 → 512 → 1024).
- В узком месте (самый глубокий слой энкодера) замените стандартный сверточный слой на модуль свёртки Pinwheel (PCM), описанный в разделе 3, чтобы захватить глобальную геометрическую морфологию и многонаправленную контекстную информацию с низким разрешением.
ПРИМЕЧАНИЕ: Пять стадий энкодера соответствуют стандартным группам слоев ResNet-50: conv1, layer1, layer2, layer3 и layer4. Предварительно обученные веса обеспечивают надёжную инициализацию признаков низкого и среднего уровня, сокращая время сходимости на небольших медицинских наборах данных.
- Ключевые компоненты и взаимодействие признаков (Рисунок 2 и Рисунок 3)
- Примените механизм двойного внимания (DAM, описанный в разделе 4) к выходу каждого каскада энкодера перед передачей его на декодер через пропускные соединения. Этот этап адаптивно подавляет фоновый шум, создаваемый складками кишечника и зеркальными отражениями, одновременно усиливая реакцию признаков в областях полипов. Только отфильтрованные признаки передаются на соответствующий слой декодера.
- В декодере постепенно восстанавливают пространственное разрешение с помощью билинейного апсэмплинга. На каждом слое декодера конкатенируйте апсэмплинговые элементы предыдущего этапа с усиленными DAM-энкодерами с тем же пространственным разрешением.
- Примените два последовательных сверточных слоя (каждый из которых сопровождается пакетной нормализацией и активацией ReLU) для слияния многомасштабной информации. Это и есть стратегия многомасштабного синтеза признаков (MSF), описанная в разделе 5.
ПРИМЕЧАНИЕ: Декодер переходит от глубоких к мелким слоям (этап 5 → стадия 1), обеспечивая эффективную интеграцию глубокой семантической локализации и детализации границ на каждом уровне.
- Генерация выхода
- Примените сверточный слой, а затем функцию активации Sigmoid к конечному выходу декодера для генерации маски предсказания.
- Бинаризуйте маску предсказания с порогом 0,5, чтобы получить итоговый результат сегментации, где пиксели с предсказанной вероятностью ≥ 0,5 классифицируются как полипы, а оставшиеся пиксели — как фон.
3. Модуль свертки с вертушками (рисунок 3)
- Модуль свёртки Pinwheel (PCM) заменяет стандартную свёртку узкого места для захвата многонаправленных геометрических особенностей полипов. Реализуйте этот модуль следующим образом:
- Определите базовое ядро свёртки W размером 3 x 3 с Cв входных каналах и Cна выходных каналах.
- Определим набор углов вращения Θ = {0°, 45°, 90°, ..., 315°}. Для каждого угла θ ∈ Θ генерируйте вращающееся ядро Wθ , применяя к W билинейное вращение на основе интерполяции. Все восемь вращающихся ядер имеют одинаковые базовые параметры; различается только пространственное расположение весов.
- Для каждого угла θ вычислите направление-специфическое отображение объектов:

где X — входная карта признаков. - Агрегируем восемь направлений отображений признаков попутным конкатенацией по каналу вдоль оси канала, получая тензор размерности (8 xC выход) x H x W. Затем примените свёртку 1 x 1, чтобы уменьшить размер канала обратно доC out, затем пакетную нормализацию и активацию ReLU31:

ПРИМЕЧАНИЕ: Вращение и интерполяция выполняются на весах ядра, а не на входной карте признаков. Такая конструкция позволяет эффективно использовать параметрически многонаправленное извлечение признаков без увеличения входного разрешения. В текущей реализации Cin = 1024 и Cout = 1024 на стадии узкого места, что соответствует размеру выходного канала слоя ResNet-50 4. Обратитесь к дополнительному пакету кода для полной реализации.
4. Механизм двойного внимания (рисунок 4)
ПРИМЕЧАНИЕ: Механизм двойного внимания (DAM) встроен в каждое пропускное соединение для подавления фонового шума и усиления особенностей области полипов как с точки зрения канала, так и пространственного измерения.
- Внимание канала
Раздел внимания канала определяет, какие функциональные каналы наиболее информативны. При заданном входном признаке F ∈R C×H×W:- Сжать пространственные измерения с помощью глобального среднего пула, чтобы получить дескриптор канала z ∈R C×1×1.
- Пропустите z через двухслойный MLP (полностью соединённые слои) с коэффициентом уменьшения r = 16. Первый слой уменьшает размерность с C до C/16 при активации ReLU; второй слой восстанавливает его с C/16 в C с активацией сигмовидной формы, чтобы получить вектор весаканала A c:
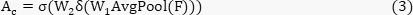
где δ обозначает ReLU, а σ — сигмоид.
- Пространственное внимание
Ветка пространственного внимания определяет место, где целевые области таковы:- Примените как максимальное пулирование, так и среднее пулирование вдоль размера канала для генерации двух двумерных карт признаков размером 1 x H x W.
- Соедините два отображения вдоль оси канала, чтобы получить тензор 2 x H x W. Примените сверточный слой размером 7 x 7 с последующим активацией сигмовидной формы, чтобы получить пространственное отображение веса As ∈ R1×H×W:
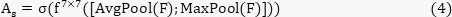
- Слияние признаков
- Объедините выходы канала и пространственного внимания с входной особенностью посредством умножения по элементам:

где α и β — это обучаемые коэффициенты баланса, оба инициализированы до 0,5 и обновляются совместно с параметрами сети с помощью оптимизации на основе градиента во время обучения.
ПРИМЕЧАНИЕ: См. дополнительный пакет кода (dam_module.py) для полной реализации.
- Объедините выходы канала и пространственного внимания с входной особенностью посредством умножения по элементам:
5. Многомасштабное слияние признаков
- Примените стратегию многомасштабного синтеза признаков (MSF) в декодере для устранения пространственных потерь деталей в глубоких объектах. На каждом этапе декодера выполняйте следующее:
- Увеличите карту признаков с предыдущего этапа декодера в 2 раза с помощью билинейной интерполяции.
- Объедините апдискретируемые характеристики с DAM-усиленными энкодировочными функциями соответствующего пространственного разрешения вдоль оси канала.
- Примените два последовательных сверточных слоя размером 3 x 3 (каждый сопровождается пакетной нормализацией и активациейReLU 32) для слияния конкатенированных признаков.
ПРИМЕЧАНИЕ: Это межуровневое слияние обеспечивает одновременное сохранение граничных деталей полипов (с помощью поверхностных признаков энкодера) и семантической локализации (обеспечиваемой глубокими признаками), что приводит к детализированным результатам сегментации.
6. Функция потери и конфигурация обучения
- Функция потерь
- Гибридная функция потерь L_total применяется для совместной оптимизации сети, устраняя повсеместный дисбаланс классов между передним и задним планом в сегментации полипов.
Бинарные потери перекрестной энтропии (LBCE) измеряют точность классификации на уровне пикселей:
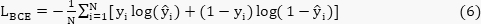
где N — общее число пикселей, y i ∈ {0,1} — метка основной истинности, а ŷi ∈ [0,1] — предсказанная вероятность. - Потеря кубиков (L) количественно определяет сходство множеств между предсказанной и основной областью истинности:


где ε — коэффициент сглаживания (установлен на 1 x 10⁻5), чтобы избежать деления на ноль.
Установить λ = 0,5 для балансировки вкладов двух убыточных условий.
- Гибридная функция потерь L_total применяется для совместной оптимизации сети, устраняя повсеместный дисбаланс классов между передним и задним планом в сегментации полипов.
- Конфигурация обучения
- Инициализуйте энкодер с помощью ImageNet-предобученных весов ResNet-50. Инициализуйте все слои декодера, параметры PCM и DAM с помощью единообразной инициализации Kaiming.
- Настройте оптимизатор и расписание обучения следующим образом. Используйте оптимизатор Адама с β₁ = 0,9 и β₂ = 0,999. Установите начальную скорость обучения на 1 x 10⁻⁴. Примените график обучения по косинусному отжигу сT max = 50 и ηmin = 1 x 10⁻⁶. Используйте размер партии 16 и обучайте модель для 50 эпох.
- Обучайте модель для 50 эпох на обучающем наборе (800 изображений). В конце каждой эпохи оценивайте модель на валидационном наборе (100 изображений), используя коэффициент кубиков в качестве основной метрики мониторинга.
- Сохраните контрольную точку модели, которая достигает максимального коэффициента кубика на валидационном наборе. Используйте эту контрольную точку как финальную модель для всех последующих оценок на тестовом наборе.
ПРИМЕЧАНИЕ: Раннее прекращение не применяется явно. Стратегия выбора контрольной точки с лучшей валидацией и кубиками служит критерием выбора модели. Все эксперименты проводятся с использованием аппаратной и программной среды, указанной в Таблице материалов. Обучение для 50 эпох на 800 изображениях занимает примерно 2 часа в описанной конфигурации. Все опубликованные результаты получаются в результате одного обучающего запуска с использованием указанного случайного семена (seed = 42). Обратитесь к дополнительному пакету кода для полного обучающего сценария.
7. Псевдокод
- Используйте Алгоритм 1 как полную карту рабочих процессов для PWD Net. Сопоставьте блоки PCM, DAM, основной архитектуры и обучающего конвейера в алгоритме с соответствующими файлами в дополнительном пакете кода.
- Реализуйте блок PCM, показанный в строках 4–12. Определите ядро свёртки с основанием 3 x 3 и генерируйте восемь вращающихся ядер под координатами 0°, 45°, 90°, 135°, 180°, 225°, 270° и 315° с использованием билинейной интерполяции.
- Сохраняйте одинаковые базовые параметры для всех вращаемых PCM-ядер. Для каждого угла вращения вычислите одну карту элементов, специфичную для конкретного направления.
- Объедините восемь PCM-карт объектов вдоль размера канала. Примените свёртку 1 x 1, пакетную нормализацию и активацию ReLU для восстановления исходного размера канала.
- Реализуйте блок DAM, показанный в строках 14–19. Примените глобальное среднее пулирование для генерации дескриптора канала, затем пропустите его через двухслойный MLP с коэффициентом редукции 16 для получения весов каналов.
- Сгенерируйте карту пространственного внимания, применяя по каналам среднее пулирование и максимальное пулирование к входной функции. Соедините эти две карты и обработайте их с помощью свёртки 7 x 7, после чего следует активация сигмоидной формы.
- Объедините канал DAM и выходы пространственного внимания с входной функцией с помощью умножения по элементам. Взвесьте две карты внимания с обучаемыми коэффициентами α и β, обе инициализованы до 0,5.
- Постройте основную архитектуру PWD Net, показанную в строках 21–32. Пропустите входное изображение через пять этапов предварительно обученного кодера ResNet 50, чтобы получить e1 до e5, при этом пространственное разрешение уменьшается с H x W до H/32 x W/32.
- Примените PCM к e5 в узком месте. Примените DAM к e1–e4 перед отправкой этих функций на декодер через пропускные соединения.
- Декодировать карту объектов от глубоких до мелких слоёв. На каждом уровне декодера апсэмплируйте предыдущую функцию, объедините её с соответствующей улучшенной функцией DAM и примените DoubleConv для объединения признаков.
- Генерируйте сегментационный выход с свёрткой 1 x 1, а затем активацией Sigmoid (Sigmoid Activation). Используйте полученную пиксельную вероятностную карту в качестве предсказанной маски.
- Реализуйте тренировочный цикл, показанный в строках 34–39. В каждой эпохе пропустите прямое распространение через PWD Net и вычислите предсказанную маску.
- Вычислите потери в тренировках как 0,5 x BCE потери плюс 0,5 x потеря кубиков. Обновите все изучаемые параметры с помощью оптимизатора Адама через обратное распространение.
Алгоритм 1: Сегментация полипов с ограниченным образованием (PWD-Net)
1: Ввод: Изображение колоноскопии I ∈ RH×W×3
2: Результат: Сегментационная маска M ∈ {0,1}(H×W)
3:
4: функция PCM(X) ▷ Модуль свёртки Вертушки
5: Определим базовое ядро W (3 x 3), углы Θ = {0°, 45°, ..., 315°}
6: для каждого θ ∈ Θ делают
7: Wθ ← БилинейныйВращать (W, θ) ▷ Вращать ядро
8: Yθ ← Conv2d(X,W θ) ▷ Особенности, специфичные для направления
9: конец для
10: Yout ← ReLU(BN(Conv1 x 1(Concat({Y θ})))) ▷ Aggregate
11: возвращение Yиз аут.
12: конечная функция
13:
14: функция DAM(F) ▷ Механизм двойного внимания
15: Ac ← Sigmoid(MLP(AvgPool(F))) ▷ Channel attention (r=16)
16: As ← Sigmoid(Conv7 x 7([AvgPool(F); MaxPool(F)])) ▷ Пространственное внимание
17: F' ← F ⊗ (α · A c + β · As) ▷ Слияние с обучаемым α, β (init=0.5)
18: возвращение F'
19: конечная функция
20:
21: функция PWD-Net(I)
22: Энкодер: e1,e 2,e 3, e4, e5 ← ResNet50_Stages(I) ▷ 5-ступенчатый предобученный энкодер
23: Узкое место: b ← PCM(e5) ▷ Применить PCM в узком месте
24: Пропуск соединений: si ← DAM(ei) для i = 1, 2, 3, 4 ▷ Функции фильтр-энкодера
25: Декодер:
26: d4 ← DoubleConv(Concat(Up(b), s4))
27: d3 ← DoubleConv(Concat(Up(d4), s3))
28: d2 ← DoubleConv(Concat(Up(d3), s2))
29: d1 ← DoubleConv(Concat(Up(d2), s1))
30: M ← Sigmoid(Conv1 x 1(d1))
31: возвращение M
32: конечная функция
33:
34: Обучение:
35: для каждой эпохи делают
36: M̂ ← PWD-Net(I)
37: L ← 0,5 · BCE(M̂,M gt) + 0,5 · DiceLoss(M̂,M gt) ▷ λ = 0.5
38: Обновление параметров через обратное распространение (Adamоптимизирует r)
39: конец для
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Результаты
Экспериментальная установка
Набор данных
Набор данных Kvasir SEG использовался для оценки сегментационного поведения PWD Net на изображениях колоноскопии с гетерогенными полипами. Набор данных содержит 1000-пиксельные аннотированные изображения полипов и включает вариации размера, формы, текстуры, освещения и сложности фона, что делает его подходящим для оценки обнаружения малых целей, локализации границ и устойчивости к визуальным помехам....
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Обсуждение
Ряд проектных решений в протоколе PWD-Net критически важны для достижения надежных результатов сегментации и требуют тщательного внимания при реализации. Во-первых, выбор и инициализация основной системы энкодера напрямую влияют на поведение сходимости и конечную производительность. Протокол использует кодировщик ResNet-50, предварительно обученный на ImageNet, который обеспечивает надёжную инициализацию функций на низком и среднем уровне. Это особенно важно для задач сегментации медицин...
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Раскрытие информации
Авторам нечего раскрывать.
Благодарности
Это исследование финансировалось Национальной программой ключевых исследований и разработок Китая (программы No 2022YFC3500200 и 2022YFC3500204).
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Материалы
| Имя | Компания | Каталожный номер | Комментарии |
|---|---|---|---|
| Adam Optimizer | — | — | Включено в PyTorch |
| Albumentations | Albumentations Team | v1.0+ | Библиотека для расширения данных |
| CUDA Toolkit | NVIDIA | v11.3+ | Ускорение GPU |
| Kvasir-SEG dataset | SimulaMet | — | https://datasets.simula.no/kvasir-seg/ |
| Matplotlib | Matplotlib Community | v3.4+ | Визуализация кривых обучения |
| NumPy | NumPy Community | v1.21+ | Числовые вычисления |
| NVIDIA Tesla P100 | NVIDIA | P100-PCIE-16GB | GPU для обучения и инференса |
| OpenCV | OpenCV Community | v4.5+ | Предобработка изображений |
| Python | Python Software Foundation | v3.8+ | Язык программирования |
| PyTorch | Meta Platforms | v1.12+ | Фреймворк для глубокого обучения |
| ResNet-50 pretrained weights | PyTorch Model Zoo | — | Предварительно обученные на ImageNet-1K |
| Ubuntu | Canonical | 18.04+ | Операционная система |