Протокол мета-обучаемого гибридного квантово-классического нейронного классификатора (ML-HQNC) объединяет квантово-вдохновленное когнитивное моделирование, предобработку данных, отбор признаков и гибридное нейронное обучение для определения интересов студентов инженерных специальностей. В данном протоколе представлен воспроизводимый рабочий процесс гибридного квантово-вдохновленного машинного обучения для образовательной аналитики, продемонстрированный на примере идентификации интересов студентов инженерных специальностей с использованием многомерных образовательных данных.
Исследовательская статья
Идентификация студенческих интересов на основе данных для интеллектуальных систем управления обучением в технических колледжах
В этой статье
Краткое содержание
Аннотация
В данном протоколе представлена вычислительная платформа на основе квантовых принципов для определения интересов студентов инженерных специальностей с использованием многомерных образовательных и поведенческих данных. Целью является обеспечение систематического и воспроизводимого рабочего процесса, который объединяет предварительную обработку данных, анализ поведенческих паттернов, отбор признаков и гибридное нейронное обучение для поддержки принятия образовательных решений и персонализированного обучения. Рабочий процесс начинается с применения метода робастного масштабирования межквартильного размаха Бокса-Кокса (BCRIS) для предварительной обработки и нормализации образовательных данных путем снижения семантического шума и повышения качества данных. Поведенческие особенности обучения студентов впоследствии анализируются с помощью квантовой модели когнитивного состояния (QCSM), которая представляет поведенческие переходы и меняющиеся предпочтения в обучении в условиях неопределенности. Затем с помощью алгоритма квантово-улучшенного роевого оптимизационного отбора признаков по методу китовых акул (QES-WOFS) выбираются соответствующие признаки для уменьшения избыточности и выявления информативных поведенческих характеристик. Наконец, мета-обучающий гибридный квантово-классический нейронный классификатор (ML-HQNC) интегрирует квантово-ориентированное обучение с глубокими нейронными сетями для классификации интересов студентов. Протокол был валидирован с использованием общедоступного набора образовательных данных. Эффективность модели оценивалась с помощью стандартных метрик, включая точность (accuracy), F1-меру и площадь под ROC-кривой (AUC), а также точность определения интересов (IDP), индекс стабильности квантовых паттернов (QPSI) и прирост кросс-доменной адаптивности (CDAG). Платформа достигла общей точности классификации 96.17% на оцениваемом наборе данных. Данный протокол предоставляет воспроизводимый вычислительный рабочий процесс для анализа многомерных образовательных данных в целях поддержки интеллектуального управления образованием и приложений для персонализированного обучения.
Введение
Системы управления образованием все чаще используются в образовательном секторе благодаря стремительному развитию информационных технологий и компьютерных сетей. Непрерывный рост высшего образования сопровождался увеличением числа студентов, особенно на инженерных специальностях, что привело к существенному росту объемов данных в системах управления образованием. Этот рост поддерживает устойчивое развитие образования, ускоряет информатизацию образовательного процесса и способствует созданию стандартизированных систем управления образованием, которые повышают согласованность и эффективность административного управления обучением. Машинное обучение (ML) предоставляет вычислительные методы, которые позволяют системам анализировать данные, выявлять закономерности и непрерывно улучшать прогностическую эффективность без явного программирования1,2.
Качество образования является фундаментальным компонентом высшего образования. В последние годы экзамены широко используются для оценки понимания студентами инженерных специальностей содержания курса и их способности приобретать новые знания, что способствует непрерывному повышению качества образования. Среда, ориентированная на учащегося, может быть создана за счет использования разнообразных образовательных ресурсов, доступных на онлайн-платформах, и применения различных теорий обучения для удовлетворения потребностей разных студентов. Эффективное преподавание играет ключевую роль в улучшении результатов обучения студентов инженерных специальностей в университетах и колледжах3,4. Более того, эффективное преподавание способствует созданию благоприятной среды обучения, поддерживает понимание студентами содержания курса и повышает академическую успеваемость. Качество образования оценивается с помощью множества показателей на протяжении всего процесса обучения, включая структуру учебного плана, обстановку в аудитории и содержание преподавания.
Высшее образование способствует интеллектуальному, личностному и социальному развитию студентов. В то же время вовлеченность студентов — включая поведенческий, эмоциональный и когнитивный аспекты — и академическая стойкость стали важными определяющими факторами результатов обучения. Высокий уровень вовлеченности студентов в значительной степени способствует долгосрочному академическому успеху5,6. Достижения в области образовательных технологий открыли новые возможности для образовательной аналитики на основе данных путем моделирования сложных нелинейных взаимосвязей между когнитивными, поведенческими и академическими характеристиками студентов с использованием методов машинного обучения (ML) и глубокого обучения (DL).
Серьезной проблемой остается эффективное наблюдение за динамикой в аудитории и ее оценка с учетом меняющегося поведения студентов. Традиционные подходы к оценке качества образования и анализу поведения студентов инженерных специальностей часто требуют больших временных затрат и подвержены субъективности человеческих суждений. Рассеянность внимания студентов во время занятий отрицательно сказывается на результатах обучения и академической успеваемости7,8. Однако поддержание устойчивого внимания у студентов инженерных специальностей остается сложной задачей из-за внутренних и внешних отвлекающих факторов, а также колебаний мотивации.
Оценка и повышение вовлеченности студентов стали все более важными задачами в связи с широким внедрением онлайн-обучения, «умных» классов и других интерактивных образовательных технологий. Обеспечение инклюзивности для различных групп студентов инженерных специальностей дополнительно подчеркивает необходимость создания комплексных структур, которые интегрируют технологические подходы в образовательную практику при соблюдении стандартов конфиденциальности и этики. Кроме того, ограниченная прозрачность моделей и проблемы, связанные с интеграцией технологий9,10, включая методологическую предвзятость и равенство в образовании, продолжают препятствовать разработке прогностических систем, способных поддерживать учащихся посредством непрерывного мониторинга.
Методы машинного обучения широко используются для решения образовательных задач, таких как прогнозирование рисков учащихся и показателей отсева. Эти подходы продемонстрировали способность выявлять студентов группы высокого риска, что позволяет внедрять меры поддержки для повышения академической успеваемости11. Также были разработаны системы управления образованием на базе искусственного интеллекта (ИИ) для оптимизации как административных, так и академических процессов в высших учебных заведениях. Образовательные наборы данных обычно включают академические записи, такие как оценки по курсам, данные о посещаемости и историю зачисления12.
В предыдущих исследованиях поведение студентов анализировалось с трех точек зрения: данных оценки, методов и результатов13,14. Для анализа поведенческих характеристик студентов колледжей были разработаны прогностические модели на основе информационной грамотности. Эти исследования в основном сосредоточены на оценке поведения учащихся с использованием методов глубокого обучения (Deep Learning, DL). Однако исследования в области интеллектуальной оценки поведения преподавателей все еще находятся на ранней стадии, что ограничивает прогресс в этой области. Для улучшения детектирования активности в аудитории к образовательным наборам данных применялись быстрые сверточные нейронные сети на основе регионов (Fast R-CNNs), что продемонстрировало значительное повышение эффективности по сравнению с традиционными методами15.
Модели двунаправленной долгой краткосрочной памяти (Bi-LSTM), включающие механизмы самомониторинга, также позволили повысить точность прогнозирования оценок студентов колледжей. Аналогичным образом, прогностические модели, разработанные с использованием наборов данных о поведении учащихся в процессе онлайн-обучения, продемонстрировали улучшенные показатели прогнозирования16,17,18. Кроме того, метод k-средних (KMC) применялся для определения характеристик различных групп студентов с помощью кластерного анализа, что позволило получить данные о поведении учащихся, способствующие совершенствованию преподавания, управления и процесса обучения. Для улучшения обнаружения и оценки поведения преподавателей в аудиториях также были предложены стратегии на основе глубокого обучения. В этих подходах признаки поведения в аудитории используются для установления связей между представлениями признаков и гиперплоскостями с помощью линейно разделимых начальных значений для метода опорных векторов (SVM)19,20. Тем не менее, такие проблемы, как перекрытие объектов (окклюзия), детализация поведенческих нюансов и внешние помехи, по-прежнему ограничивают точность распознавания поведения студентов технических специальностей в условиях учебной аудитории.
Глубокое обучение также применялось для оценки университетских курсов на основе результатов обучения, включая образовательную аттестацию в рамках политического и идеологического воспитания21,22Эффективность этих прогностических моделей была продемонстрирована с использованием общедоступных образовательных наборов данных. Для прогнозирования академической успеваемости учащихся на основе данных, собранных с онлайн-платформ обучения и систем управления обучением, применялись сети импульсных нейронов с прямой связью (FSNN). Как показано в Рисунок 1предлагаемый вычислительный рабочий процесс включает в себя набор данных образовательной оценки для определения интересов студентов инженерных специальностей через последовательные этапы предобработки данных, анализа поведенческих паттернов, выбора признаков и классификации. Таблица 123,24,25,26,27,28,29,30,31,32 в данном разделе обобщаются репрезентативные методы, описанные в предыдущих исследованиях, а также применяемые методики и связанные с ними ограничения по определению интереса учащихся в системах управления обучением.
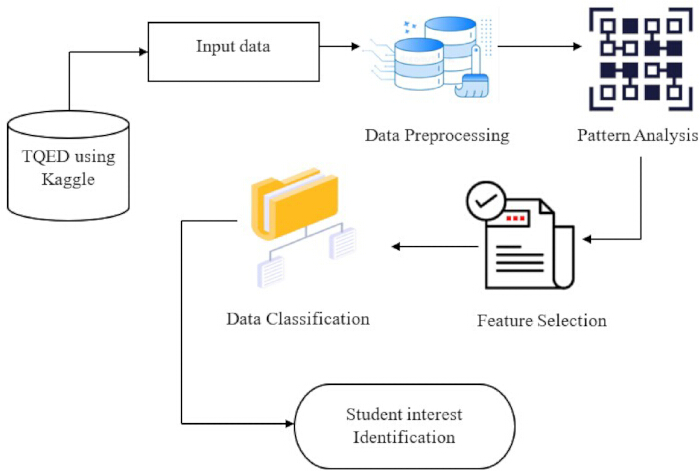
Рисунок 1: Структура определения интересов студентов. Общий рабочий процесс предлагаемой структуры определения интересов студентов инженерных специальностей, включающий сбор данных, предобработку, анализ поведенческих паттернов, отбор признаков и классификацию. Пожалуйста, нажмите здесь, чтобы просмотреть этот рисунок в более крупном размере.
Таблица 1: Анализ поведения студентов в управлении обучением.Обзор репрезентативных методов, подходов, наборов данных, метрик оценки и зарегистрированных ограничений для анализа поведения студентов в управлении обучением. Пожалуйста, нажмите здесь, чтобы скачать эту таблицу.
Swin Transformer и облегченная сеть пирамидальных признаков (FPN) были применены для детектирования поведения учащихся в классе за счет эффективной обработки многомасштабных карт признаков33. Кроме того, регулируемая рекуррентная нейронная сеть, оптимизированная методом поиска плодовых мушек (PFFO-ARNN), использовалась для анализа поведения студентов при онлайн-обучении и прогнозирования успеваемости по курсу34. Исследования, основанные на данных о поведении студентов, собранных из систем управления обучением в университетах, также выявили неэффективность и трудоемкость мониторинга поведения в классе с помощью традиционных методов глубокого обучения35. В таблице 236,37,38,39,40,41,42,43,44,45,46,47 обобщены репрезентативные методы классификации, наборы данных, метрики оценки и отмеченные ограничения для интеллектуальных систем управления обучением в инженерном образовании.
Таблица 2: Интеллектуальные системы управления обучением на основе глубокого обучения для инженерного образования. Сравнение репрезентативных систем управления обучением на базе глубокого обучения, наборов данных, метрик оценки и зарегистрированных ограничений. Пожалуйста, нажмите здесь, чтобы скачать эту таблицу.
В предыдущем исследовании48 была разработана модель оценки качества смешанного обучения на основе глубоких сетей доверия (Deep Belief Networks, DBNs) и предложена стратегия смешанной оценки для анализа качества преподавания в университетах. Предложенный подход превзошел традиционный генетический алгоритм (GA) как по точности классификации, так и по времени выполнения, достигнув точности более 95% менее чем за 5.4 ms. Модель была обучена с использованием размеченных образовательных наборов данных и проверена с помощью стратегии независимого тестирования49,50. Полученные результаты продемонстрировали высокую прогностическую способность с средней абсолютной ошибкой (MAE) 0.593% и среднеквадратической ошибкой (RMSE) 0.785%.
Современные архитектуры с улучшенным механизмом внимания, такие как KANFormer51, объединяют многоголовое самовнимание с сетями Колмогорова-Арнольда для повышения точности прогнозирования успеваемости учащихся за счет выявления сложных взаимодействий признаков. Модели отслеживания знаний на базе трансформеров также продемонстрировали повышенную точность прогнозирования и интерпретируемость, используя механизмы внимания для моделирования траекторий обучения учащихся52. Хотя архитектуры на основе трансформеров и механизмов внимания улучшили результаты в задачах образовательного прогнозирования за счет моделирования контекстуальных зависимостей и долгосрочных взаимодействий признаков, эти подходы сосредоточены преимущественно на прогнозировании успеваемости или отслеживании знаний, а не на идентификации интересов учащихся с учетом неопределенности с помощью квантового когнитивного моделирования, оптимизированного отбора признаков и гибридного мета-обучения.
Несмотря на последние достижения в области машинного и глубокого обучения для образовательной аналитики, существующие методы определения интересов студентов инженерных специальностей имеют ряд ограничений. Многие традиционные подходы сосредоточены преимущественно на точности прогнозирования, игнорируя многогранный характер поведения студентов, включая меняющиеся предпочтения в обучении, поведенческую неопределенность, контекстуальные связи и семантические взаимодействия. Кроме того, эти методы часто опираются на стандартное конструирование признаков и детерминированные стратегии обучения, которые могут недостаточно точно отражать нелинейные поведенческие паттерны или адаптироваться к динамическим образовательным средам. Следовательно, для улучшения анализа сложных образовательных данных необходима более комплексная структура, интегрирующая надежную предобработку данных, интеллектуальное моделирование поведения, адаптивный отбор признаков и гибридные методы обучения.
Чтобы устранить эти ограничения, предлагаемая структура объединяет надежную предварительную обработку данных, поведенческое моделирование на основе квантовых принципов, оптимизированный отбор признаков и гибридное квантово-классическое нейронное обучение в единый вычислительный рабочий процесс для определения интересов студентов инженерных специальностей. Благодаря сочетанию этих взаимодополняющих компонентов предлагаемый протокол обеспечивает систематический и воспроизводимый подход к анализу сложных образовательных данных для поддержки персонализированного обучения и принятия образовательных решений.
Целью данного исследования является разработка и валидация системы CQEI с использованием многомерных образовательных и поведенческих данных для определения интересов студентов инженерных специальностей. Система объединяет в себе надежную предварительную обработку данных, квантово-инспирированное моделирование когнитивных состояний, оптимизированный отбор признаков и гибридный квантово-классический нейронный классификатор с мета-обучением (ML-HQNC) для анализа поведения студентов в процессе обучения и обеспечения точной идентификации их интересов. Эффективность оценивается с помощью стандартных метрик, включая точность (accuracy), F1-меру и площадь под ROC-кривой (AUC), а также показатели точности определения интересов (IDP), индекса стабильности квантовых паттернов (QPSI) и прироста кросс-доменной адаптивности (CDAG). Благодаря интеграции этих взаимодополняющих компонентов в единый вычислительный рабочий процесс, предлагаемая система обеспечивает систематический подход к образовательной аналитике и интеллектуальному принятию решений в сфере образования.
Протокол
В данном исследовании использовался общедоступный анонимизированный набор данных, полученный из репозитория Kaggle. Участники-люди не привлекались и не участвовали в исследовании напрямую, персональные данные не собирались. Таким образом, одобрение институционального комитета по этике и информированное согласие не требовались. Инструменты исследования, использованные в данной работе, перечислены в Таблице материалов.
1. Обзор структуры CQEI
Предложенная структура концептуального образовательного интеллекта на основе квантовых вычислений (Quantum-Inspired Conceptual Education Intelligence, CQEI) объединяет предварительную обработку данных, анализ поведенческих паттернов, отбор признаков и классификацию для определения интересов студентов инженерных специальностей с использованием набора данных по оценке качества обучения, полученного из репозитория Kaggle. Сначала данные были предварительно обработаны с помощью метода робастного масштабирования межквартильного размаха Бокса — Кокса (Box–Cox Robust IQR Scaling, BCRIS) для снижения семантического шума и нормализации входных признаков. Затем поведенческие паттерны студентов были проанализированы с помощью квантовой модели когнитивного состояния (Quantum Cognitive State Model, QCSM). После этого был применен алгоритм отбора признаков на основе квантово-улучшенной роевой оптимизации китового алгоритма (Quantum-Enhanced Swarm–Whale Optimization Feature Selection, QES-WOFS) для выявления информативных признаков и снижения избыточности путем моделирования квантово-оптимального выбора, значимости обратной связи и переходных поведенческих вариаций. Наконец, гибридный квантово-классический нейронный классификатор с мета-обучением (Meta-Learning Hybrid Quantum-Classical Neural Classifier, ML-HQNC) объединил квантово-инспирированное обучение с глубокими остаточными семантическими слоями для определения интересов студентов.
Общий рабочий процесс предлагаемого фреймворка ML-HQNC проиллюстрирован на Рисунке 2. Протокол состоял из шести последовательных этапов, начиная с получения образовательного набора данных из репозитория Kaggle, за которым следовала предобработка данных с использованием метода масштабирования Box–Cox Robust IQR Scaling (BCRIS), преобразование признаков и поведенческое представление с помощью квантовой когнитивной модели состояний (QCSM), а также отбор признаков с использованием алгоритма квантово-улучшенной роевой оптимизации китами (QES-WOFS). Отобранные признаки впоследствии использовались для обучения и валидации модели с помощью мета-обучающего гибридного квантово-классического нейронного классификатора (ML-HQNC), и в итоге фреймворк был оценен с использованием точности (accuracy), F1-меры (F1-score), площади под ROC-кривой (AUC), точности обнаружения интереса (IDP), индекса стабильности квантовых паттернов (QPSI) и прироста кросс-доменной адаптивности (CDAG).
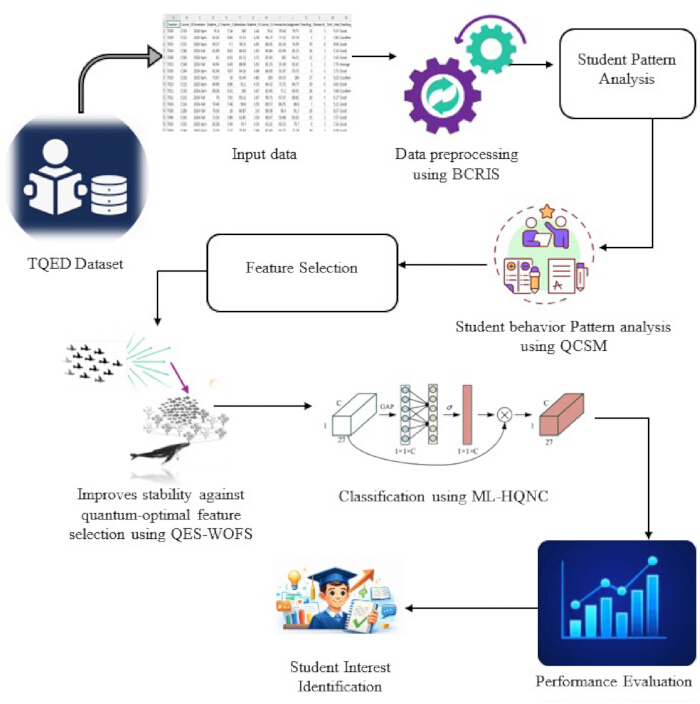
Рисунок 2: Структура гибридного квантово-классического нейронного классификатора с метаобучением (ML-HQNC). Общая архитектура предлагаемой структуры ML-HQNC, объединяющая робастное масштабирование IQR с преобразованием Бокса-Кокса (BCRIS) для предобработки данных, квантовую когнитивную модель состояния (QCSM) для анализа поведенческих паттернов, алгоритм выбора признаков на основе квантово-улучшенной оптимизации роем китов (QES-WOFS) и гибридное квантово-классическое нейронное обучение для классификации интересов учащихся. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
2. Набор данных для оценки качества обучения
Предложенная структура была разработана с использованием общедоступного набора данных для оценки качества обучения, полученного из репозитория Kaggle. Набор данных содержал 1 014 образовательных записей с 14 многомерными признаками, представляющими академическую успеваемость, баллы за аттестацию, посещаемость, характеристики обучения и поведенческие индикаторы учащихся, собранные с помощью комплексной платформы управления образованием (CEMP). Эти атрибуты предоставили многомерную образовательную информацию, необходимую для моделирования нелинейных зависимостей, связанных с определением интересов студентов инженерных специальностей.
Как показано на Рисунке 3, набор данных был разделен на обучающую (80%) и тестовую (20%) выборки. Всего для обучения предлагаемой модели было использовано 800 записей, а 200 были зарезервированы для оценки эффективности. Набор данных находится в открытом доступе по адресу: https://www.kaggle.com/datasets/ziya07/teaching-quality-evaluation-dataset. Обучающая и тестовая выборки были впоследствии обработаны с использованием предлагаемой структуры для построения модели обучения и повышения ее прогностической способности.
Несмотря на то, что используемый набор данных называется «Teaching Quality Evaluation Dataset» (набор данных для оценки качества преподавания), целью данного исследования было определение интересов студентов инженерных специальностей. Образовательные, поведенческие и методические атрибуты, содержащиеся в наборе данных, служили входными переменными для обучения и оценки предлагаемой структуры. Следовательно, все представленные результаты прогнозирования и показатели эффективности характеризуют эффективность структуры в определении интересов студентов инженерных специальностей, а не качество преподавания. Перед предварительной обработкой данных была проведена проверка импортированного набора данных, чтобы убедиться, что все 1 014 записей были успешно загружены, схема данных соответствует ожидаемому формату, а все пропущенные или дублирующиеся записи были выявлены и устранены.
3. Предварительная обработка данных с использованием робастного масштабирования IQR по методу Бокса-Кокса (BCRIS)
Метод робастного масштабирования IQR по методу Бокса-Кокса (BCRIS) использовался для предварительной обработки и нормализации образовательного набора данных путем сочетания преобразования Бокса-Кокса с робастным масштабированием на основе межквартильного размаха (IQR) для снижения влияния экстремальных значений. Коррекция симметрии вместе с нормализацией по медиане позволила создать статистически стабильные и масштабируемые представления признаков, подходящие для последующего анализа. В рамках предложенной системы образовательного интеллекта BCRIS преобразовал многомерные образовательные, инструктивные и поведенческие показатели в представления признаков с контролируемой дисперсией. Признаки, включая attendance_rate, interactive_sessions_percentage и связанные с ними образовательные переменные, были нормализованы для повышения согласованности обучающего и тестового наборов данных. Подробные математические пояснения приведены в Дополнительном файле 1 (раздел S1). Метод BCRIS обеспечил совместимую с квантовыми вычислениями стратегию предварительной обработки, которая нормализовала гетерогенные образовательные данные перед последующим статистическим анализом, сохраняя при этом базовые поведенческие характеристики, необходимые для дальнейшего моделирования. Перед проведением поведенческого анализа конвейер предварительной обработки был проверен, чтобы убедиться, что нормализованный набор данных не содержит недопустимых или пропущенных значений, семантический шум был снижен, а обработанные признаки пригодны для последующего поведенческого моделирования.
4. Преобразование признаков и поведенческое представление с использованием модели квантового когнитивного состояния (QCSM)
Модель квантового когнитивного состояния (QCSM) была внедрена для моделирования динамики интересов студентов инженерных специальностей с использованием вероятностных представлений, основанных на принципах квантовой механики. Интерес студента был представлен как перекрытие нескольких концептуальных состояний, отражающих иерархию когнитивных концептов, неопределенность, концептуальное перекрытие, одновременное изучение нескольких тем, нерешительность или колеблющееся поведение в процессе обучения, а также вероятность смены предпочтений в обучении. Многомерные показатели из набора данных оценки качества преподавания инженерных дисциплин, включая Student_Avg_Score, Attendance_rate и Student_Feedback_Rating, были представлены как амплитудно-взвешенные когнитивные переходы в нормализованном пространстве квантовых состояний. QCSM объединяла переходы между квантовыми состояниями с концептуальным выравниванием на основе интерференции для создания квантово-подобных когнитивных представлений, отражающих стабильность и эволюцию интереса студентов с течением времени. Подробные математические формулы приведены в Дополнительном файле 1 (Раздел S2). QCSM моделировала вероятностные когнитивные состояния для представления процесса приобретения знаний, концептуальных изменений, вовлеченности в обучение и интереса к предмету посредством нормализованных представлений квантовых состояний. Поведенческие представления были верифицированы по всем записям студентов, чтобы убедиться, что извлеченные признаки когнитивного состояния точно фиксируют поведение учащихся и переходы между темами.
5. Отбор признаков с использованием алгоритма селектора признаков на основе квантово-улучшенной роевой оптимизации китов (QES-WOFS)
Алгоритм селектора признаков на основе квантово-улучшенной роевой оптимизации китов (QES-WOFS) был использован для идентификации оптимального подмножества признаков и определения высокоинформативных поведенческих характеристик из многомерных образовательных данных. Механизмы поиска с квантовым вдохновением улучшили интеграцию стратегий глобального и локального поиска для оптимизации признаков. Образовательные переменные, включая interactive_sessions_percentage, assignments_time_percentage и course_completion_rate, оценивались в соответствии с их корреляцией с целевым результатом. Моделирование подмножеств потенциальных признаков осуществлялось с использованием представлений квантовой вероятности, в то время как механизм квантового туннелирования обеспечивал вероятностные переходы за пределы локальных оптимумов. Важность признаков оценивалась с помощью предельного правдоподобия для количественного определения вклада каждого признака в эффективность классификации и адаптивные состояния роя. Алгоритм QES-WOFS выбрал стабильные и поведенчески значимые признаки, что повысило устойчивость к шуму, вариациям от семестра к семестру и периодическим поведенческим колебаниям.
Чтобы преодолеть ограничения, связанные с независимым использованием алгоритма оптимизации китов (Whale Optimization Algorithm, WOA) или метода роя частиц (Particle Swarm Optimization, PSO), в алгоритме QES-WOFS была объединена глобальная разведка на основе PSO с локальной эксплуатацией на основе WOA. Механизм квантового туннелирования дополнительно обеспечил вероятностные переходы за пределы локальных оптимумов, тем самым увеличив разнообразие популяции, сократив избыточность признаков и улучшив сходимость к оптимальному подмножеству признаков для определения интересов студентов инженерных специальностей.
Подробные математические формулировки представлены в Дополнительный файл 1 (Раздел S3)Алгоритм QES-WOFS объединяет квантовое вероятностное кодирование признаков, стратегию изменения скорости, адаптированную под метод оптимизации роем частиц (PSO), и механизм спирального поиска, вдохновленный поведением китов, для выявления наиболее информативных образовательных признаков. Гиперпараметры были оптимизированы эмпирически с использованием обучающего набора данных. Кандидатные значения оценивались путем систематических экспериментов, и была выбрана комбинация, обеспечивающая наилучшие показатели на валидационном наборе. В частности, параметр преобразования Бокса — Кокса (λ = 0,25), маржа контрастивных потерь (m = 1,0) и коэффициенты квантового туннелирования (α = 0,7 и β = 0,3) были выбраны на основе точности валидации, F1-меры и характера сходимости. Перед обучением классификатора результаты отбора признаков были проверены, чтобы убедиться, что алгоритм QES-WOFS выбрал оптимальный подмножество признаков и удалил избыточные или малозначимые признаки.
6. Обучение и валидация модели с использованием гибридного квантово-классического нейронного классификатора на основе мета-обучения (ML-HQNC)
Гибридный квантово-классический нейронный классификатор на основе мета-обучения (ML-HQNC) был реализован путем объединения глубоких нейронных сетей с квантовыми вычислениями для определения интересов студентов инженерных специальностей. Многоголовые механизмы квантового внимания и глубокие остаточные семантические слои позволяли фиксировать сложные нелинейные зависимости в многомерных образовательных данных, представленных с помощью вариационных квантовых схем (VQCs). Признаки, производные от поведения, включая student_average_grade, attendance_rate и student_feedback_rating, проецировались в квантовое пространство состояний, где нормализованные входные данные преобразовывались в квантовые представления на основе амплитуд для моделирования перекрывающихся и вероятностных паттернов вовлеченности. Нормализованные векторы поведенческих признаков студентов рассчитывались согласно уравнениям, приведенным в Дополнительном файле 1 (Раздел S4). Впоследствии ML-HQNC классифицировал и определял интересы студентов инженерных специальностей.
Для обучения классификатора ML-HQNC использовалась стратегия эпизодического мета-обучения. Каждому эпизоду назначалась одна случайным образом выбранная задача мета-обучения из обучающего набора данных. При сохранении распределения классов обучающие данные были разделены на опорный набор (80%) и запросный набор (20%). Опорный набор использовался для адаптации параметров конкретной задачи через внутренний цикл оптимизации, в то время как запросный набор служил для оценки адаптированной модели и вычисления мета-потерь, используемых для обновления общих параметров. В каждом цикле обучения генерировалось в общей сложности 100 задач мета-обучения. Для адаптации во внутреннем цикле использовались пять шагов обновления градиента с внутренней скоростью обучения 0,001, а оптимизатор Adam с внешней скоростью обучения 0,0005 оптимизировал мета-параметры. Случайный выбор задач повторялся для каждой эпохи обучения, чтобы модель взаимодействовала с разнообразными поведенческими паттернами и улучшила обобщающую способность для ранее неизвестных профилей учащихся. Оценка потерь для квантового контрастивного выравнивания описана в Дополнительном файле 1 (уравнения 41–45). Обучение модели было проверено для подтверждения успешной сходимости без вычислительных ошибок, а также стабилизации кривых потерь при обучении и валидации на протяжении последующих эпох.
Результаты
Предложенная структура ML-HQNC была сопоставлена с Fast R-CNN, Bi-LSTM, CNN и XGBoost с использованием традиционных метрик классификации, включая точность (Accuracy), прецизионность (Precision), полноту (Recall), F1-меру и площадь под кривой рабочих характеристик приемника (AUC), а также предложенные метрики оценки: прецизионность обнаружения интереса (IDP), индекс стабильности квантовых паттернов (QPSI) и прирост кросс-доменной адаптивности (CDAG). Математические определения этих метрик приведены в Дополнительный файл 1 (раздел S5).
Для оценки устойчивости предлагаемой структуры все эксперименты были повторены пять раз с использованием различных случайных инициализаций. Представленные значения производительности указаны как среднее значение ± стандартное отклонение по пяти запускам. Статистическая значимость различий между предлагаемой структурой и базовыми моделями оценивалась с помощью парного t-критерия, при этом значения p < 0.05 считались статистически значимыми.
Как резюмировано в Дополнительной таблице 1, имитационные эксперименты были проведены с использованием набора данных оценки качества обучения, содержащего 1 014 записей. Всего 800 записей были использованы для обучения модели, а 200 записей были зарезервированы для тестирования. Предложенный фреймворк ML-HQNC и сравнительные модели были реализованы в среде Jupyter Notebook с использованием языка Python. Атрибут Teaching_Quality служил исходной целевой переменной в общедоступном наборе данных оценки качества обучения и состоял из двух классов: Good и Excellent. Эти метки использовались в качестве целей прогнозирования для обучения и оценки фреймворка ML-HQNC. Результаты категорий прогнозирования приведены в Таблице 3. В Дополнительной таблице 2 обобщены результаты валидации этапа предобработки с использованием робастного масштабирования IQR по методу Бокса-Кокса (BCRIS). Конвейер предобработки удалял пропущенные и дублирующие записи, снижал влияние выбросов, нормализовал распределения признаков и улучшал семантическую и поведенческую согласованность перед трансформацией признаков и обучением модели.
Таблица 3: Целевая переменная набора данных оценки качества обучения.Описание исходной целевой переменной Teaching_Quality и ее категорий классификации (Good и Excellent), использованных для обучения и оценки модели. Пожалуйста, нажмите здесь, чтобы скачать эту таблицу.
Дополнительная таблица 3 представляет репрезентативные признаки, сгенерированные с помощью квантовой когнитивной модели состояний (QCSM). Извлеченные признаки описывают поведение учащегося в процессе обучения, включая когнитивное состояние, вовлеченность, неопределенность, переходы между темами и поведенческую согласованность; они послужили входными данными для последующего этапа отбора признаков QES-WOFS. В Дополнительной таблице S4 приведены окончательные признаки, выбранные алгоритмом QES-WOFS, вместе с категориями признаков, уровнями их относительного влияния и функциональными ролями в предлагаемой структуре. Характеристики извлеченных многомерных поведенческих признаков обобщены в Дополнительной таблице 5. В Дополнительной таблице 6 представлены репрезентативные структуры ребер, созданные в процессе поведенного представления для двух классов прогнозирования (Good и Excellent).
Как показано на рисунке 4 и в таблице 4, предложенная структура ML-HQNC достигла самого высокого значения F1-меры (87,9%) среди оцениваемых методов. Соответствующие значения F1-меры для Fast R-CNN, Bi-LSTM, CNN и XGBoost составили 77,9%, 80,2%, 82,8% и 85,8% соответственно. Статистическая значимость оценивалась с помощью двустороннего независимого t-критерия (p < 0,05).
Рисунок 5 и Таблица 5 обобщают результаты точности обнаружения интереса (IDP). Предложенный фреймворк ML-HQNC достиг значения IDP 89,3%, по сравнению с 79,11%, 82,12%, 84,6% и 87,10% для Fast R-CNN, Bi-LSTM, CNN и XGBoost соответственно. Рисунок 6 и Таблица 6 представляют результаты индекса стабильности квантовых паттернов (QPSI). Предложенный фреймворк достиг значения QPSI 92,7%, в то время как Fast R-CNN, Bi-LSTM, CNN и XGBoost достигли 81,1%, 84,11%, 87,4% и 90,9% соответственно. Рисунок 7 и Таблица 7 обобщают результаты прироста кросс-доменной адаптивности (CDAG). Предложенный фреймворк ML-HQNC достиг самого высокого значения CDAG (0,95) по сравнению с Fast R-CNN (0,78), Bi-LSTM (0,83), CNN (0,80) и XGBoost (0,86). Как показано на Рисунке 8 и в Таблице 8, предложенный фреймворк ML-HQNC достиг наивысшей точности классификации (96,17%). Соответствующие показатели точности для Fast R-CNN, Bi-LSTM, CNN и XGBoost составили 85,10%, 87,21%, 90,14% и 93,19% соответственно. Рисунок 9 и Таблица 9 представляют время вычисления, потребовавшееся для каждого метода. Для предложенного фреймворка ML-HQNC потребовалось 9,02 ms, в то время как для Fast R-CNN, Bi-LSTM, CNN и XGBoost потребовалось 31,2 ms, 27,5 ms, 22,4 ms и 17,6 ms соответственно. Рисунок 10 представляет анализ рабочей характеристики приемника (ROC). Предложенный фреймворк ML-HQNC достиг значения AUC 0,944, что указывает на высокую долю истинно положительных результатов и низкую долю ложноположительных результатов во всем диапазоне оцениваемого порога классификации.
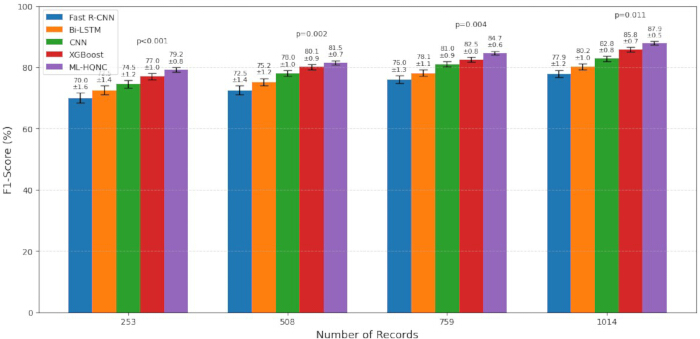
Рисунок 4: Сравнение F1-меры для различных размеров наборов данных. Сравнение F1-меры, достигнутой ML-HQNC и конкурирующими моделями при различных размерах наборов данных. Результаты представлены как среднее значение ± стандартное отклонение по пяти независимым экспериментальным запускам (n = 5). Планки погрешностей соответствуют одному стандартному отклонению. Статистическая значимость оценивалась с помощью двухстороннего независимого t-критерия (p < 0.05). Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Таблица 4: Сравнение F1-меры для наборов данных различного размера. Сравнение F1-меры, полученной с помощью ML-HQNC и конкурирующих моделей. Результаты представлены как среднее значение ± стандартное отклонение по пяти независимым экспериментальным запускам (n = 5). Пожалуйста, нажмите здесь, чтобы скачать эту таблицу.
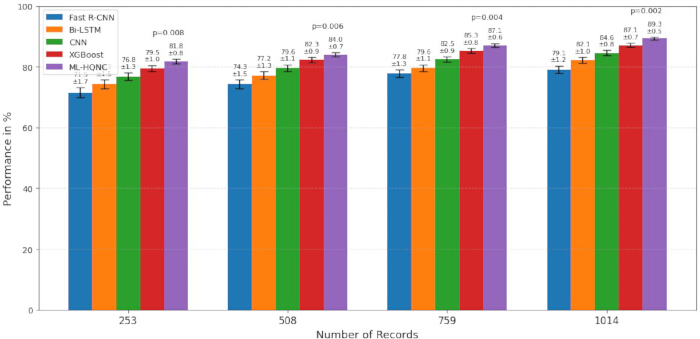
Рисунок 5: Сравнение точности обнаружения интереса (IDP) для различных размеров наборов данных. Сравнение точности обнаружения интереса (IDP), достигнутой с помощью ML-HQNC и конкурирующих моделей при различных размерах наборов данных. Результаты представлены как среднее значение ± стандартное отклонение по пяти независимым экспериментальным запускам (n = 5). Планки погрешностей соответствуют одному стандартному отклонению. Статистическая значимость оценивалась с помощью двустороннего независимого t-критерия (p < 0.05). Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Таблица 5: Сравнение точности детектирования интереса (IDP) для наборов данных разного размера.Сравнение точности детектирования интереса (IDP), полученной с помощью ML-HQNC и конкурирующих моделей. Результаты представлены в виде среднего значения ± стандартного отклонения по пяти независимым экспериментальным запускам (n = 5). Пожалуйста, нажмите здесь, чтобы скачать эту таблицу.
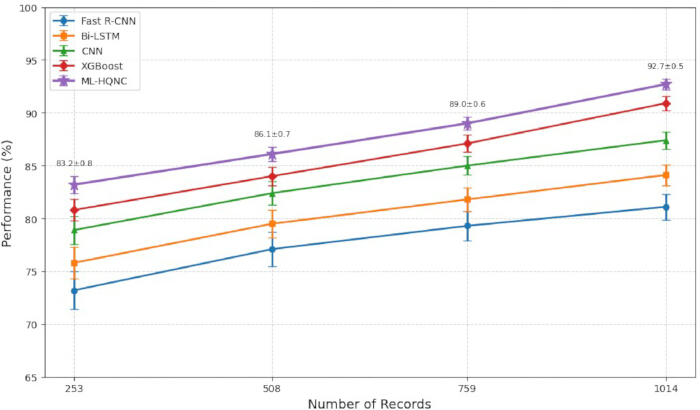
Рисунок 6: Сравнение индекса стабильности квантовых паттернов (QPSI) для различных объемов наборов данных. Сравнение индекса стабильности квантовых паттернов (QPSI), достигнутого с помощью ML-HQNC и конкурирующих моделей при различных объемах наборов данных. Результаты представлены как среднее значение ± стандартное отклонение по пяти независимым экспериментальным запускам (n = 5). Планки погрешностей соответствуют одному стандартному отклонению. Статистическая значимость оценивалась с помощью двухстороннего независимого t-критерия (p < 0.05). Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Таблица 6: Сравнение индекса стабильности квантовых паттернов (QPSI) для наборов данных разного размера.Сравнение индекса стабильности квантовых паттернов (QPSI), полученного с помощью ML-HQNC и конкурирующих моделей. Результаты представлены в виде среднего значения ± стандартного отклонения по пяти независимым экспериментальным прогонам (n = 5). Пожалуйста, нажмите здесь, чтобы скачать эту таблицу.
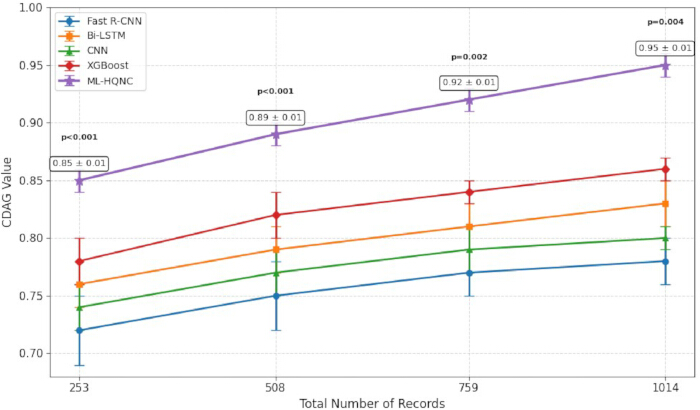
Рисунок 7: Сравнение коэффициента адаптивности к перекрестным доменам (CDAG) при различных размерах наборов данных. Сравнение коэффициента адаптивности к перекрестным доменам (CDAG), достигнутого ML-HQNC и конкурирующими моделями при различных размерах наборов данных. Результаты представлены как среднее значение ± стандартное отклонение по пяти независимым экспериментальным прогонам (n = 5). Планки погрешностей соответствуют одному стандартному отклонению. Статистическая значимость оценивалась с помощью двустороннего независимого t-критерия (p < 0.05). Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Таблица 7: Сравнение прироста адаптивности между доменами (CDAG) для наборов данных разного размера. Сравнение прироста адаптивности между доменами (CDAG), достигнутого моделью ML-HQNC и конкурирующими моделями. Результаты представлены в виде среднего значения ± стандартного отклонения по пяти независимым экспериментальным запускам (n = 5). Пожалуйста, нажмите здесь, чтобы скачать эту таблицу.
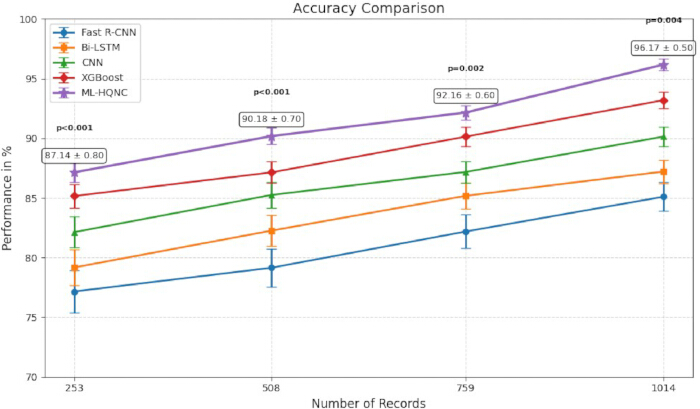
Рисунок 8: Сравнение точности классификации при различных размерах наборов данных. Сравнение точности классификации, достигнутой с помощью ML-HQNC и конкурирующих моделей, при различных размерах наборов данных. Результаты представлены как среднее значение ± стандартное отклонение по пяти независимым экспериментальным запускам (n = 5). Планки погрешностей представляют одно стандартное отклонение. Статистическая значимость оценивалась с помощью двухстороннего независимого t-критерия (p < 0.05). Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Таблица 8: Сравнение точности классификации при различных размерах набора данных.Сравнение точности классификации, достигнутой ML-HQNC и конкурирующими моделями. Результаты представлены в виде среднего значения ± стандартного отклонения по пяти независимым экспериментальным запускам (n = 5). Пожалуйста, нажмите здесь, чтобы скачать эту таблицу.
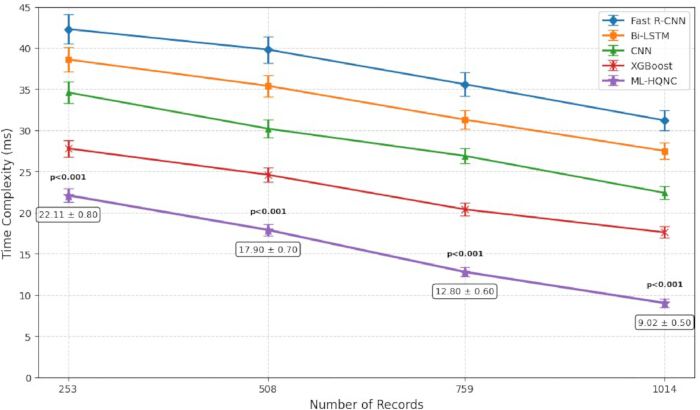
Рисунок 9: Сравнение времени вычислений для различных объемов наборов данных. Сравнение времени вычислительного выполнения ML-HQNC и конкурирующих моделей при различных объемах наборов данных. Результаты представлены как среднее значение ± стандартное отклонение по пяти независимым экспериментальным запускам (n = 5). Планки погрешностей соответствуют одному стандартному отклонению. Более низкие значения указывают на более короткое время вычислительного выполнения. Статистическая значимость оценивалась с помощью двухстороннего независимого t-критерия (p < 0.05). Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Таблица 9: Сравнение времени вычислений при различных размерах набора данных. Сравнение времени вычислительного выполнения ML-HQNC и конкурирующих моделей. Результаты представлены в виде среднего значения ± стандартного отклонения по пяти независимым экспериментальным запускам (n = 5). Более низкие значения указывают на более короткое время вычислительного выполнения. Пожалуйста, нажмите здесь, чтобы скачать эту таблицу.
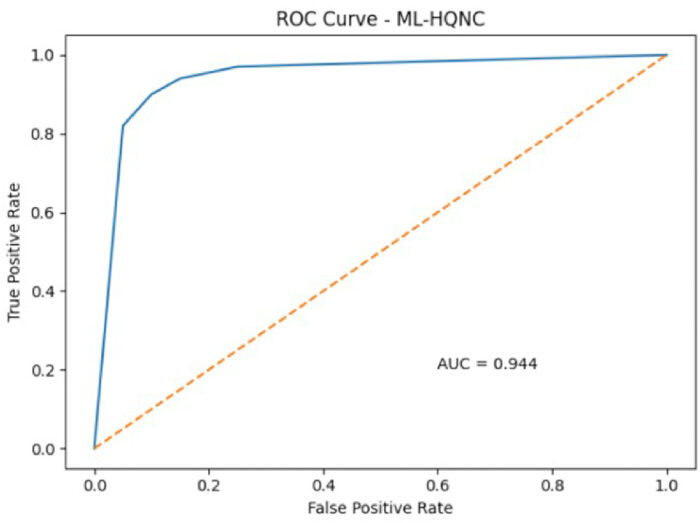
Рисунок 10: Сравнение площади под ROC-кривой (AUC). Сравнение AUC, достигнутых ML-HQNC и конкурирующими моделями для идентификации интересов студентов инженерных специальностей. Представленные значения AUC соответствуют одному экспериментальному запуску; следовательно, планки погрешностей и анализ статистической значимости не приводятся. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Дополнительный рисунок 1 представляет матрицу корреляции репрезентативных поведенческих переменных. Сильные положительные корреляции наблюдались между Avg_Score и Course_Completion_Rate (0,81), а также между Attendance_Rate и Course_Completion_Rate (0,75). Умеренные корреляции наблюдались между Avg_Score и Course_Completion (0,72) и между Attendance_Rate и Time_Assignment_Percentage (0,74). Дополнительные рисунки 2 и 3, наряду с Таблицей 10, обобщают карты точности обучения и тестирования. Предложенный фреймворк ML-HQNC достиг точности обучения 96,1% и точности тестирования 93,8%, что превышает показатели методов сравнения. Дополнительные рисунки 4 и 5, наряду с Таблицей 11, обобщают анализ сходимости. Предложенный фреймворк ML-HQNC продемонстрировал самые низкие потери при обучении (0,21) и тестировании (0,26) со стабильной сходимостью на протяжении всего процесса оптимизации.
Таблица 12 обобщает общие показатели эффективности предлагаемой структуры ML-HQNC и методов сравнения по всем метрикам оценки. Предложенная структура продемонстрировала самые высокие показатели точности (Accuracy), F1-меры (F1-score), AUC, IDP, QPSI и CDAG, потребовав при этом наименьшее время вычислений среди всех оцениваемых методов. В Таблице 13 представлен покомпонентный абляционный анализ предлагаемой структуры. Постепенное внедрение этапа предобработки BCRIS, поведенческого представления QCSM, алгоритма отбора признаков QES-WOFS и полного классификатора ML-HQNC приводило к поэтапному улучшению качества классификации, что подтверждает вклад каждого компонента в общую структуру.
Таблица 10: Сравнение точности обучения и тестирования. Сравнение точности обучения и тестирования, достигнутых моделью ML-HQNC и конкурирующими моделями. Приведенные значения соответствуют одному экспериментальному запуску. Пожалуйста, нажмите здесь, чтобы скачать эту таблицу.
Таблица 11: Сравнение потерь при обучении и тестировании.Сравнение потерь при обучении и тестировании, полученных с помощью ML-HQNC и конкурирующих моделей. Приведенные значения соответствуют одному экспериментальному прогону. Пожалуйста, нажмите здесь, чтобы скачать эту таблицу.
Таблица 12: Общее сравнение производительности. Сравнение ML-HQNC и конкурирующих моделей с использованием нескольких метрик оценки. Результаты представлены в виде среднего значения ± стандартного отклонения по пяти независимым экспериментальным запускам (n = 5). Пожалуйста, нажмите здесь, чтобы скачать эту таблицу.
ДОСТУПНОСТЬ ДАННЫХ:
Оригинальный набор данных Teaching Quality Evaluation Dataset, использованный в данном исследовании, находится в открытом доступе в репозитории Kaggle (https://www.kaggle.com/datasets/ziya07/teaching-quality-evaluation-dataset). Доступ к набору данных может потребовать аутентификации пользователя и регулируется условиями использования Kaggle. Для обеспечения воспроизводимости при соблюдении условий лицензирования оригинального набора данных ресурсы, созданные в ходе исследования, включая синтетический набор данных, исходный код, файлы реализации и конфигурации, описания признаков, рабочий процесс предобработки и вспомогательную документацию, необходимую для воспроизведения описанных экспериментов, были размещены в открытом репозитории Zenodo: https://doi.org/10.5281/zenodo.21393413.
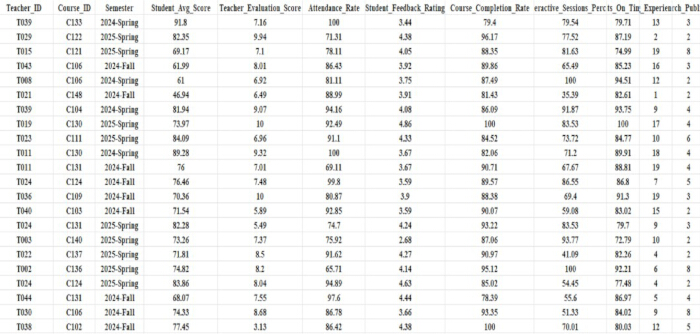
Рисунок 3: Сбор признаков набора данных по оценке качества преподавания. Структура и состав признаков набора данных по оценке качества преподавания, использованного для определения интересов студентов инженерных специальностей. Пожалуйста, нажмите здесь, чтобы просмотреть этот рисунок в большем размере.
Дополнительный рисунок 1: Матрица корреляции признаков. Матрица корреляции, отображающая попарные взаимосвязи между репрезентативными образовательными и поведенческими переменными, используемыми в предлагаемой платформе ML-HQNC. Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Дополнительный рисунок 2: Сравнение точности обучения. Сравнение точности обучения, достигнутой ML-HQNC и конкурирующими моделями в процессе обучения. Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Дополнительная фигура 3: Сравнение точности тестирования. Сравнение точности тестирования, достигнутой ML-HQNC и конкурирующими моделями в процессе тестирования. Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Дополнительный рисунок 4: Анализ потерь при обучении. Сравнение потерь при обучении, достигнутых ML-HQNC и конкурирующими моделями в процессе оптимизации моделей. Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Дополнительная figura 5: Анализ потерь при тестировании. Сравнение потерь при тестировании, достигнутых ML-HQNC и конкурирующими моделями в процессе оценки моделей. Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Дополнительная таблица 1: Параметры моделирования и экспериментальные настройки. Сводка параметров моделирования, среды реализации, разделения наборов данных и экспериментальных настроек, использованных для оценки предлагаемой архитектуры ML-HQNC. Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Дополнительная таблица 2: Результаты валидации этапа предобработки Box–Cox Robust IQR Scaling (BCRIS). Сравнение репрезентативных характеристик набора данных до и после предобработки, включая пропущенные значения, дублирующиеся записи, обработку выбросов, нормализацию признаков и согласованность данных. Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Дополнительная таблица 3: Репрезентативные признаки, созданные с помощью квантовой модели когнитивного состояния (QCSM). Репрезентативные поведенческие признаки, созданные с помощью QCSM после предварительной обработки данных, включая признаки когнитивного состояния, вовлеченности, неопределенности, смены темы и поведенческой согласованности. Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Дополнительная таблица 4: Признаки, отобранные с помощью алгоритма выбора признаков на основе квантово-усиленной оптимизации роем китов (QES-WOFS). Итоговый поднабор признаков, отобранный алгоритмом QES-WOFS, вместе с соответствующими категориями признаков, уровнями относительного влияния и функциональными ролями в рамках предложенной структуры. Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Дополнительная таблица 5: Категории прогнозирования качества преподавания. Описание категорий прогнозирования и репрезентативных поведенческих характеристик, используемых в предлагаемой структуре ML-HQNC. Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Дополнительная таблица 6: Анализ чувствительности границ.Краткое описание анализа чувствительности границ, использованного при оценке модели. Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Дополнительный файл 1: Дополнительные методы, математические формулировки, метрики оценки и дополнительные таблицы.Этот файл содержит подробные математические формулировки для методов Box–Cox Robust IQR Scaling (BCRIS), Quantum Cognitive State Model (QCSM), Quantum-Enhanced Swarm–Whale Optimization Feature Selection (QES-WOFS) и Meta-Learning Hybrid Quantum-Classical Neural Classifier (ML-HQNC), описанных в основном протоколе. Он также включает определения метрик оценки, параметров симуляции, экспериментальных настроек и дополнительные таблицы S1–S6, подтверждающие результаты, представленные в основной статье. Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Обсуждение
Предложенный фреймворк ML-HQNC продемонстрировал повышенную эффективность в определении интересов студентов инженерных специальностей за счет интеграции квантово-инспирированного поведенческого моделирования, адаптивного отбора признаков и мета-обучения в единый вычислительный рабочий процесс. По сравнению с Fast R-CNN, Bi-LSTM, CNN и XGBoost, фреймворк последовательно демонстрировал более высокие результаты как по общепринятым метрикам классификации, так и по предложенным метрикам оценки поведения. Эти результаты свидетельствуют о том, что сочетание квантово-инспирированного представления когнитивного состояния с адаптивной оптимизацией признаков улучшило способность фреймворка моделировать сложные образовательные паттерны поведения при сохранении стабильной точности классификации. Низкие затраты времени на вычисления и незначительная разница между показателями обучения и тестирования дополнительно указывают на стабильную оптимизацию и хорошую обобщающую способность модели.
Предложенные метрики оценки дополнили традиционные показатели классификации, предоставив дополнительную информацию о поведенческом моделировании. Точность определения интереса (Interest Detection Precision, IDP) количественно определяла точность идентификации интереса, индекс стабильности квантовых паттернов (Quantum Pattern Stability Index, QPSI) оценивал стабильность поведенческих представлений, основанных на принципах квантовых вычислений, а прирост кросс-доменной адаптивности (Cross-Domain Adaptability Gain, CDAG) оценивал способность системы к обобщению на различных разделах данных. В совокупности эти показатели обеспечили более широкую оценку эффективности модели, чем использование одних лишь традиционных метрик прогнозирования.
Покомпонентный анализ абляции (Таблица 13) дополнительно продемонстрировал вклад каждого этапа предлагаемого рабочего процесса. Включение этапа предобработки Box–Cox Robust IQR Scaling (BCRIS) повысило согласованность данных за счет снижения влияния выбросов и создания нормализованных представлений признаков. Модель квантового когнитивного состояния (QCSM) преобразовала многомерные образовательные переменные в поведенческие представления, отражающие неопределенность, вовлеченность и меняющиеся предпочтения в обучении. Последующий отбор признаков с использованием алгоритма Quantum-Enhanced Swarm–Whale Optimization Feature Selection (QES-WOFS) уменьшил избыточность признаков при сохранении информативных поведенческих характеристик. Наконец, интеграция этих компонентов в рамках Meta-Learning Hybrid Quantum-Classical Neural Classifier (ML-HQNC) повысила эффективность классификации и обобщающую способность по сравнению с базовыми моделями.
Предлагаемый протокол предназначен для определения интересов студентов в области инженерного дела с использованием многомерных образовательных и поведенческих данных, собранных в цифровых средах обучения. Данный вычислительный рабочий процесс может поддерживать персонализированное обучение, академическое консультирование, планирование учебных программ и интеллектуальное управление образованием, предоставляя систематический подход к анализу поведения студентов в процессе обучения и выявлению их развивающихся интересов. Эта структура особенно подходит для структурированных образовательных наборов данных, содержащих поведенческие, академические и контекстуальные переменные.
Успешная реализация зависит от наличия высококачественных образовательных данных и достаточных вычислительных ресурсов. Перед началом анализа образовательные наборы данных следует проверить на наличие пропущенных значений, дублирующих записей и несоответствий, поскольку качество данных напрямую влияет на предварительную обработку и последующее поведенческое моделирование. Стабильность представлений признаков также зависит от правильной предварительной обработки, преобразования признаков и оптимизации гиперпараметров. В процессе обучения модели необходимо контролировать сходимость по кривым потерь при обучении и валидации, а при необходимости корректировать параметры оптимизации для поддержания стабильного процесса обучения.
Несмотря на то, что разработанная структура продемонстрировала эффективность на оцениваемом наборе данных, следует учитывать несколько ограничений. Протокол был валидирован с использованием одного общедоступного образовательного набора данных; для дальнейшей оценки обобщающей способности необходимы дополнительные исследования с использованием более крупных, многоцентровых и более разнообразных образовательных наборов данных. Кроме того, гибридная квантово-вдохновленная система обучения требует больше вычислительных ресурсов, чем традиционные методы машинного обучения, из-за этапов предварительной обработки, оптимизации и компонентов гибридного обучения. Работа структуры также зависит от наличия качественно аннотированных образовательных данных, и на ее эффективность могут повлиять неполные, зашумленные или сильно несбалансированные наборы данных.
Будущая работа будет сосредоточена на расширении данной структуры для более детальной многоклассовой идентификации интересов учащихся, включении дополнительных модальностей образовательных данных, таких как текстовая обратная связь, временная динамика процесса обучения и логи активности в системе управления обучением в реальном времени, а также на оценке протокола в различных средах инженерного образования. Дальнейшая оптимизация вычислительного процесса может повысить масштабируемость и облегчить внедрение в крупномасштабные системы управления образованием.
Таким образом, предлагаемая платформа ML-HQNC представляет собой воспроизводимый вычислительный рабочий процесс для определения интересов студентов инженерных специальностей с использованием многомерных образовательных данных. Благодаря интеграции надежной предварительной обработки, поведенческого моделирования на основе квантовых принципов, адаптивного отбора признаков и гибридного квантово-классического нейронного обучения, платформа позволила повысить эффективность классификации при сохранении стабильной оптимизации и высокой скорости вычислений. Данные характеристики подтверждают потенциал её применения в интеллектуальной образовательной аналитике и управлении инженерным образованием.
Раскрытие информации
Автор заявляет об отсутствии конфликта интересов.
Благодарности
Автор благодарит Университет Бенбу (Бенбу, Китай) за предоставление академической поддержки и исследовательской среды, которые способствовали проведению данной работы. Эта работа была поддержана в рамках Ежегодного проекта по обеспечению качества на уровне школы Университета Бенбу на 2025 год (№ 2025zhkc1).
Материалы
| Имя | Компания | Каталожный номер | Комментарии |
|---|---|---|---|
| Базовые модели (Fast R-CNN, Bi-LSTM, CNN, XGBoost) | Реализации с открытым исходным кодом | Fast R-CNN (2015); реализация TensorFlow/Keras v2.16; XGBoost v2.1.1 | Эталонные модели, используемые для сравнительной оценки производительности. |
| Модуль предобработки BCRIS | Разработано в данном исследовании | Версия 1.0 | Специальный модуль предобработки, реализующий преобразование Бокса-Кокса и робастную нормализацию IQR. |
| Jupyter Notebook | Project Jupyter | Версия 7.2.2 | Интерактивная среда разработки, использованная для реализации, обучения и тестирования. |
| Классификатор ML-HQNC | Разработано в данном исследовании | Версия 1.0 | Предложенный гибридный квантово-классический нейросетевой классификатор с фреймворком мета-обучения. |
| Python | Python Software Foundation | Версия 3.11.9 | Язык программирования, использованный для разработки моделей и проведения экспериментов. |
| PyTorch | PyTorch Foundation | Версия 2.5.1 | Фреймворк глубокого обучения, использованный для реализации и обучения моделей. |
| Модель QCSM | Разработано в данном исследовании | Версия 1.0 | Предложенная квантовая когнитивная модель состояния (Quantum Cognitive State Model) для представления поведенческих паттернов. |
| Алгоритм QES-WOFS | Разработано в данном исследовании | Версия 1.0 | Предложенный алгоритм отбора признаков на основе квантово-улучшенной оптимизации роем китов (Quantum-Enhanced Swarm–Whale Optimization Feature Selection). |
| Scikit-learn | Scikit-learn Developers | Версия 1.6.1 | Библиотека машинного обучения, использованная для предобработки, отбора признаков и оценки. |
Ссылки
- Xu Q, Deng H. Research on education management system based on machine learning and multidimensional data modeling. Applied Mathematics and Nonlinear Sciences. 2024;9(1). https://dialnet.unirioja.es/servlet/articulo?codigo=9386765
- Li D. An interactive teaching evaluation system for preschool education in universities based on machine learning algorithm. Comput Hum Behav. 2024;157:108211. https://doi.org/10.1016/j.chb.2024.108211
- Chunhua H, Kaabar MKA, Qiuju X, Zhang G. Fuzzy comprehensive evaluation of students' classroom experience in online teaching. International Journal of Emerging Technologies in Learning. 2023;18(21):79-88.
- He Z, et al. Assessment of influencing factors of college and universities' teaching effects using fuzzy and deep learning techniques. Scientific Reports. 2026;16:5168. https://doi.org/10.1038/s41598-026-35940-5
- Liu J. Innovation and practice of educational management system in colleges and universities based on the concept of data analysis education. Applied Mathematics and Nonlinear Sciences. 2023;9(1). https://www.researchgate.net/publication/377568313
- Li C, Cao Z. Deep learning-based AI model for predicting academic success and engagement among physical higher education students. Scientific Reports. 2025;15:45471. https://doi.org/10.1038/s41598-025-29000-7
- Kong Y, Dong R, Zhang H. Classroom behavior analysis and digital teaching quality evaluation based on spatiotemporal graph neural network. Discover Artificial Intelligence. 2025;5:404. https://doi.org/10.1007/s44163-025-00623-z
- Zedan F, Jabali RR, Raiyn J. Detecting student inattention using deep learning and behavioral analysis. Journal of International Education Practice. 2026;9(1):1-17.
- Feng F. Deep learning-based model for analyzing student engagement in activities. Scientific Reports. 2025;16:2552. https://doi.org/10.1038/s41598-025-32521-w
- Turkmenbayev A, et al. The application of machine learning in predicting student performance in university engineering programs: A rapid review. Frontiers in Education. 2025;10:1562586. https://doi.org/10.3389/feduc.2025.1562586
- Albreiki B, Zaki N, Alashwal H. A systematic literature review of student performance prediction using machine learning techniques. Education Sciences. 2021;11(9):552. https://doi.org/10.3390/educsci11090552
- Lai Q. Research on the refinement of college student education management based on artificial intelligence. Discover Artificial Intelligence. 2026;6:31. https://doi.org/10.1007/s44163-025-00651-9
- Yuanyuan L, et al. Research on the application framework of intelligent technologies to promote teachers' classroom teaching behavior evaluation. Frontiers of Education in China. 2023;18(1):12–35. https://doi.org/10.3868/s110-008-023-0012-8
- Shi Y, Sun F, Zuo H, Peng F. Analysis of learning behavior characteristics and prediction of learning effect for improving college students' information literacy based on machine learning. IEEE Access. 2023;11:50447-50461.
- Liu S, Zhang J, Su W. An improved method of identifying learner's behaviors based on deep learning. Journal of Supercomputing. 2022;78(10):12861-12872.
- Yang J. Accurate prediction and analysis of college students' performance from online learning behavior data. IEIE Transactions on Smart Processing and Computing. 2023;12(3):404-411.
- Xie Y, Zhang S, Liu Y. Abnormal behavior recognition in classroom pose estimation of college students based on spatiotemporal representation learning. Traitement du Signal. 2021;38(6):1769-1778.
- Shen X, Yuan C. A college student behavior analysis and management method based on machine learning technology. Wireless Communications and Mobile Computing. 2021;2021:6611630. https://doi.org/10.1155/2021/6611630
- Li G, et al. A convolutional neural network-based approach for the recognition and evaluation of classroom teaching behavior. Scientific Programming. 2021;2021:5513886. https://doi.org/10.1155/2021/5513886
- Feng C, et al. IMRMB-Net: A lightweight student behavior recognition model for complex classroom scenarios. PLoS ONE. 2025;20(2):e0318817. https://doi.org/10.1371/journal.pone.0318817
- Zhang Y, Liu T, Ru B. Effect evaluation and student behavior design method of moral education in colleges and universities under the environment of deep learning. Scientific Programming. 2022;2022:6056117. https://doi.org/10.1155/2022/6056117
- Liu C, Wang H, Yuan Z. A method for predicting the academic performances of college students based on education system data. Mathematics. 2022;10(19):3737. https://doi.org/10.3390/math10193737
- Vora DR, Iyer KR. Deep learning in engineering education: performance prediction using cuckoo-based hybrid classification. In: Machine Learning and Deep Learning in Real-Time Applications. Studies in Computational Intelligence, Vol. 841, pp. 187-218. Springer; Singapore; 2020.
- Li H, Liu Z. An intelligent educational system: analyzing student behavior and academic performance using multi-source data. Electronics. 2024;14(16):3328. https://doi.org/10.3390/electronics14163328
- Zhang Y, Li J. Deep learning-based model for predicting student learning behavior: a pathway to early intervention and enhanced outcomes. Journal of Computational Methods in Sciences and Engineering. 2025;25(2):1169-1184.
- Jia Q, He J. Student behavior recognition in classroom based on deep learning. Applied Sciences. 2024;14(18):7981. https://doi.org/10.3390/app14187981
- Luo H. Prediction of student decision-making behaviour based on machine learning algorithms. Pakistan Journal of Life and Social Sciences. 2024;22(2):11045-11058.
- Abdi A, Sedrakyan G, Veldkamp B. Students' feedback analysis model using deep learning-based method and linguistic knowledge for intelligent educational systems. Soft Computing. 2023;27(38):14073-14094.
- Ning X. Behavior recognition of college students based on improved deep learning algorithm. International Journal of Web-Based Learning and Teaching Technologies. 2023;18(1):1-16.
- Sravya MN, Prashanth D, Saifa S, Reddy LS. A comprehensive analysis of learning behaviour characteristics and predictive modeling of learning outcomes to enhance college-level academic performance. International Journal of Pharmacy and Medical Sciences. 2025;5(2):94-100.
- Kalita E, et al. Predicting student academic performance using Bi-LSTM: a deep learning framework with SHAP-based interpretability and statistical validation. Frontiers in Education. 2025;10:1581247. https://doi.org/10.3389/feduc.2025.1581247
- Alias MAH, Hambali N, Aziz MAA. Feature selection techniques and classification algorithms for student performance classification: a review. International Journal of Electrical and Computer Engineering. 2024;14(3):3230-3242.
- Wang Z, et al. Students' classroom behavior detection system incorporating deformable DETR with Swin Transformer and lightweight feature pyramid network. Systems. 2023;11(7):372. https://doi.org/10.3390/systems11070372
- Zou X. Design of student behavior analysis and management system based on deep learning. International Journal of High Speed Electronics and Systems. 2024;33(1):2450005. https://doi.org/10.1142/S012915642450005X
- Zhang Q. The impact of machine learning-based student behaviour detection on teaching in classroom scenarios. Journal of Information and Knowledge Management. 2025;24(1):2450101. https://doi.org/10.1142/S021964922450101X
- Yu C, Wang Y. College student management system based on K-means clustering algorithm. Int J New Dev Educ. 2022;4(2):28-33.
- Chen J, Lu H. Evaluation method of classroom teaching effect under intelligent teaching mode. Mobile Networks and Applications. 2022;27(3):1262-1270.
- Han X, Chen X. The evaluation model of engineering practice teaching with complex network analytic hierarchy process based on deep learning. Scientific Reports. 2025;15:14733. https://doi.org/10.1038/s41598-025-14733-x
- Guo S, et al. The analysis of teaching quality evaluation for college sports dance by convolutional neural network model and deep learning. Heliyon. 2024;10(8):e36067. https://doi.org/10.1016/j.heliyon.2024.e36067
- Gao Y. Deep learning-based strategies for evaluating and enhancing university teaching quality. Computers and Education: Artificial Intelligence. 2025;8:100362. https://doi.org/10.1016/j.caeai.2025.100362
- Li Y, Lu B. Intelligent educational systems based on adaptive learning algorithms and multimodal behavior modeling. PeerJ Computer Science. 2025;11:e3157. https://doi.org/10.7717/peerj-cs.3157
- Geng F, John AD, Chinnappan CV. Analysis of the teaching quality using novel deep learning-based intelligent classroom teaching framework. Progress in Artificial Intelligence. 2023;12(2):147-162.
- Veluri RK, et al. Learning analytics using deep learning techniques for efficiently managing educational institutes. Materials Today: Proceedings. 2022;51(Part 8):2317-2320.
- Chen W, Min L. The evaluation model of physical education teaching performance based on deep learning algorithm. Scalable Computing: Practice and Experience. 2025;26(3):458-466.
- Zhang Y. A comprehensive evaluation system for physical education teaching effectiveness supported by multimodal machine learning. Discover Artificial Intelligence. 2026;6:75. https://doi.org/10.1007/s44163-026-00075-x
- Pei Y, Lu G. Design of an intelligent educational evaluation system using deep learning. IEEE Access. 2023;11:29790-29799.
- Ding J, Su Y. A teaching management system for physical education in colleges and universities using the theory of multiple intelligences and SVM. Soft Computing. 2024;28(2):685-701.
- Li Y, Zhang L, Tian Y, Qi W. Research on teaching practice of blended higher education based on deep learning route. Computational Intelligence and Neuroscience. 2022;2022:5751843. https://doi.org/10.1155/2022/5751843
- Jiang X, Du Y, Zheng Y. Evaluation of physical education teaching effect using Random Forest model under artificial intelligence. Heliyon. 2024;10(1):e23576. https://doi.org/10.1016/j.heliyon.2024.e23576
- Li S, Liu T. Performance prediction for higher education students using deep learning. Complexity. 2021;2021:6620684. https://doi.org/10.1155/2021/6620684
- Alnasyan B, Basheri M, Alassafi MO, Alnasyan K. Kanformer: An Attention-Enhanced Deep Learning Model for Predicting Student Performance in Virtual Learning Environments. Social Network Analysis and Mining. 2025;15:25. https://doi.org/10.1007/s13278-025-01446-7
- Lu Y, Tong L, Cheng Y. Advanced Knowledge Tracing: Incorporating Process Data and Curricula Information via an Attention-Based Framework for Accuracy and Interpretability. Journal of Educational Data Mining. 2024;16(2):58-84.