В данном протоколе описывается рабочий процесс глубокого обучения для семантической сегментации, реконструкции и синтеза художественного стиля узоров нематериального культурного наследия с использованием извлечения признаков на основе трансформеров, состязательной реконструкции и пространственно-адаптивной генерации изображений для поддержки цифрового сохранения и творческого применения объектов наследия.
Для просмотра этого контента требуется подписка на JoVE. Войдите или начните свой бесплатный пробный период.
Исследовательская статья
Реконструкция с использованием семантической сегментации и синтез художественного стиля паттернов нематериального культурного наследия на основе системы глубокого обучения
В этой статье
Краткое содержание
Аннотация
Цифровое сохранение и реконструкция узоров нематериального культурного наследия (НКН) привлекают все больше внимания по мере развития методов синтеза изображений на основе глубокого обучения. Существующие подходы на базе SegCycle-SPADE продемонстрировали потенциал для структурной сегментации и художественной реконструкции традиционных ремесленных узоров; однако сохраняются определенные ограничения, включая недостаточное разнообразие наборов данных, недостаточный учет культурной семантики и неадекватное сохранение структурных особенностей узоров при реконструкции. Для решения этих проблем в данной работе предлагается усовершенствованный фреймворк SegCycle-SPADE для семантической сегментации и художественной реконструкции типов узоров НКН. Модель сегментации SegFormer на базе архитектуры Transformer используется для точного определения границ мотивов и областей узора. Кроме того, введен модуль слияния культурных признаков на основе перекрестного внимания (Cross-Attention Cultural Feature Fusion Module) для усиления значимых культурных мотивов и улучшения представления признаков. Трансляция и реконструкция узоров выполняются с помощью CycleGAN, а пространственно-адаптивная денормализация (SPADE) используется для синтеза художественного стиля с целью поддержания семантической согласованности между картами сегментации и генерируемыми изображениями. Для улучшения обобщающей способности модели и художественного разнообразия фреймворк обучается с использованием набора данных культурных мотивов батика народа мяо и набора данных WikiArt. Результаты экспериментов показывают, что предлагаемый фреймворк SegCycle-SPADE с механизмом внимания повышает точность сегментации и эффективность реконструкции традиционных узоров по сравнению с существующими методами реконструкции на основе генеративно-состязательных сетей (GAN). Предложенный фреймворк представляет собой масштабируемое решение для документирования культурного наследия с помощью искусственного интеллекта, реконструкции и художественного возрождения традиционных дизайнерских узоров.
Введение
Культурное наследие, включающее как нематериальные элементы, такие как обычаи, языки и верования, так и материальные элементы, такие как произведения искусства, здания и письменные памятники, является фундаментальным проявлением человеческой истории, творчества и идентичности1. Сохранение наследия призвано дать сообществам возможность восстановить связь со своими истоками и позволяет будущим поколениям пользоваться преимуществами коллективной культурной памяти. Оно также способствует межкультурному взаимопониманию, признанию разнообразия традиций и обычаев, а также различных исторических повествований. Эти культурные ценности помогают нам понять ценности, взгляды и опыт предыдущих поколений и способствуют формированию современных социальных идентичностей и культурной преемственности. Основные принципы сохранения культурного наследия проиллюстрированы на Рисунке 1.
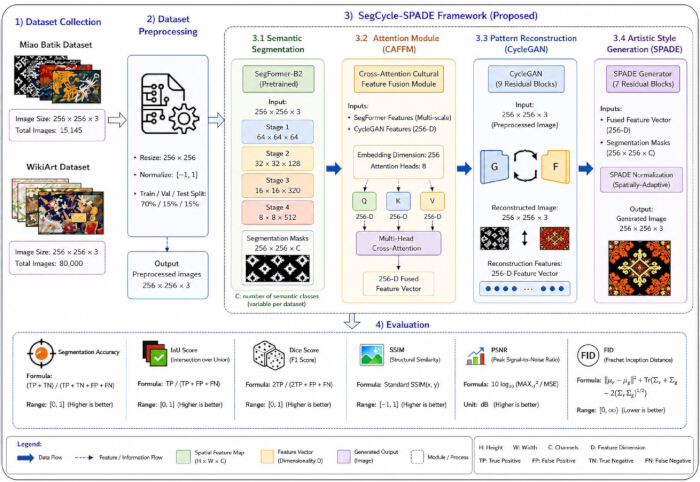
Рисунок 1. Концептуальный обзор реконструкции узоров культурного наследия с использованием фреймворка SegCycle-SPADE. Схематическая иллюстрация предлагаемого подхода для реконструкции и улучшения узоров нематериального культурного наследия. Рабочий процесс включает сбор наборов данных из датасетов Miao Batik и WikiArt, предобработку изображений, семантическую сегментацию с помощью SegFormer-B2, слияние признаков с использованием модуля слияния культурных признаков на основе перекрестного внимания (CAFFM), реконструкцию узоров с помощью CycleGAN, синтез художественного стиля с использованием SPADE и итоговую оценку с помощью метрик сегментации и реконструкции. Стрелки указывают поток данных и представлений признаков на протяжении всего фреймворка. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Коллективная память и культурное наследие человеческого общества воплощены в нематериальном культурном наследии (НКН), которое служит важным средством художественного выражения и культурной идентичности. Однако НКН сталкивается со значительными трудностями из-за процессов глобализации и цифровизации2,3,4. Многие исчезающие формы НКН требуют новых подходов к сохранению и развитию в связи с сокращением числа квалифицированных мастеров и ограниченной способностью к адаптации к современным рынкам5,6. Устойчивый дизайн, являясь важной областью исследований в сфере НКН, делает акцент на интегрированном развитии культуры, общества и окружающей среды, предлагая практический путь для дальнейшего сохранения НКН. Благодаря подходам устойчивого дизайна НКН может быть возрождено с одновременной адаптацией к потребностям современного общества7,8.
В данном исследовании термин «паттерны нематериального культурного наследия» относится к визуальным репрезентациям мотивов, которые передают и сохраняют лежащие в их основе нематериальные культурные ценности. Следовательно, предлагаемая концепция направлена на сохранение и документирование культурной информации, связанной с этими мотивами, при одновременном восстановлении их визуальных форм.
Вышивка и батик народа мяо являются значимыми формами нематериального культурного наследия Китая, отражающими историю, верования и традиции общины мяо через символические мотивы, такие как птицы, бабочки и родовые тотемы9. Эти мотивы глубоко укоренены в ритуальной одежде и праздничных обрядах, а также способствуют местному культурному и экономическому развитию10,11. Достижения в области цифровых технологий, в частности искусственного интеллекта (ИИ) и глубокого обучения (ГО), открыли новые возможности для сохранения, анализа, реконструкции и документирования культурного наследия. Батик мяо из провинции Гуйчжоу, являющийся одной из наиболее сохранившихся традиций батика в Китае, служит важным средством передачи культурных знаний, верований, обычаев и ритуалов народа мяо12,13,14,15,16.
Недавние исследования продемонстрировали потенциал глубокого обучения (DL) для сохранения культурного наследия и реконструкции узоров, обеспечив более высокую точность сегментации (точность по пикселям = 88.6%, средний коэффициент пересечения над объединением [IoU] = 78.1%) и качество реконструкции по сравнению с U-Net и DeepLabV3+1. Тем не менее, ряд проблем остается нерешенным. Существующие подходы на основе генеративно-состязательных сетей (GAN) часто с трудом сохраняют мелкие структурные детали в сложных узорах17, а ограниченное разнообразие наборов данных препятствует обобщающей способности моделей в различных культурных областях18. Кроме того, модели перевода из изображения в изображение, такие как CycleGAN, могут не обеспечивать семантическую согласованность между картами сегментации и сгенерированными изображениями19, а отсутствие механизмов внимания может привести к потере деталей культурно значимых мотивов в процессе реконструкции20. Следовательно, для эффективной реконструкции узоров нематериального культурного наследия (ICH) необходима усовершенствованная платформа, объединяющая сегментацию на основе трансформеров, обучение признаков с использованием механизмов внимания и обучение на нескольких наборах данных.
Цифровизация вышивки народа мяо и стремительное развитие генеративного ИИ открыли новые возможности для сохранения культурного наследия. Диффузионные модели, представляющие собой развивающийся класс глубоких генеративных моделей, продемонстрировали выдающиеся результаты в задачах компьютерного зрения благодаря своим мощным возможностям генерации контента21,22,23,24,25. В процессе обратной диффузии модель постепенно учится реконструировать исходные входные данные из зашумленных представлений26,27,28. В предыдущих исследованиях также изучалось применение технологий трехмерной реконструкции и автоматизированного проектирования (CAD) для сохранения и распространения культурного наследия.
Несмотря на то, что сверточные нейронные сети (CNN) и GAN хорошо справляются с генерацией изображений и сохранением признаков, они все еще сталкиваются с проблемами, связанными с ограниченными рецептивными полями, коллапсом моды и нестабильностью обучения29. Архитектуры на основе трансформеров, такие как SegFormer и Segmenter, отлично справляются с захватом глобального контекста и семантических связей, однако они требуют значительных вычислительных ресурсов и могут испытывать трудности с проработкой мелких деталей. Хотя диффузионные модели, такие как Stable Diffusion, демонстрируют высокие возможности генерации изображений, им часто не хватает точного контроля над структурными и художественными характеристиками создаваемых дизайнов. Кроме того, большинство существующих подходов используют стратегии независимого обучения, что ограничивает эффективный обмен информацией и совместную оптимизацию компонентов сегментации и генерации, приводя к компромиссу между структурной точностью и художественной подлинностью30.
Современные диффузионные модели, такие как латентная диффузия и Stable Diffusion, обеспечивают высококачественный синтез изображений, однако требуют итеративного шумоподавления, что приводит к увеличению вычислительных затрат и времени вывода. Более того, сохранение тонких культурных мотивов и структурной целостности остается сложной задачей без специализированных механизмов кондиционирования. Генеративные модели на базе трансформеров эффективно улавливают глобальные контекстуальные связи, но часто требуют крупномасштабных наборов данных и значительных вычислительных ресурсов. В отличие от них, предлагаемый фреймворк SegCycle-Spatially Adaptive Denormalization (SegCycle-SPADE) объединяет сегментацию на базе SegFormer, слияние признаков через перекрестное внимание (cross-attention), реконструкцию CycleGAN и синтез с использованием SPADE для обеспечения явного структурного руководства, что улучшает сохранение мотивов, семантическую согласованность и управляемую реконструкцию узоров культурного наследия.
Большинство современных методов семантической сегментации основаны на полностью сверточных нейронных сетях (FCNN) с U-образной архитектурой31. На этапе кодирования с помощью серии операций свертки и понижения дискретизации (downsampling) извлекаются глубокие признаки с большими рецептивными полями. На этапе декодирования пространственное разрешение постепенно восстанавливается путем повышения дискретизации (upsampling), что в конечном итоге обеспечивает семантическое прогнозирование на уровне пикселей. Компенсируя потерю пространственной информации при понижении дискретизации и повышая эффективность сегментации в широком спектре приложений, перекрестные связи (skip connections) позволяют напрямую интегрировать информацию высокого разрешения с разных уровней кодировщика в декодировщик32.
Хотя современные методы на основе GAN, CNN и диффузионных моделей демонстрируют многообещающие результаты в генерации изображений и реставрации культурного наследия, они часто с трудом поддерживают семантическую согласованность, сохраняют тонкие структурные мотивы и обеспечивают воспроизводимую реконструкцию различных культурных паттернов. Большинство существующих подходов рассматривают сегментацию, реконструкцию и синтез стиля как отдельные процессы, что может привести к потере культурно значимых элементов и противоречивым результатам. Для устранения этого методологического пробела в данном исследовании предлагается унифицированный фреймворк SegCycle-SPADE, объединяющий семантическую сегментацию на базе SegFormer, новый модуль слияния культурных признаков на основе перекрестного внимания (CAFFM), реконструкцию на базе CycleGAN и синтез стиля под управлением SPADE. Благодаря явной интеграции данных структурной сегментации с генеративным обучением признаков, предложенный фреймворк обеспечивает более надежную, семантически согласованную и воспроизводимую реконструкцию мотивов нематериального культурного наследия (ICH), сохраняя при этом как культурную аутентичность, так и художественное качество.
В данном исследовании выявлены три основных ограничения современных подходов к реконструкции объектов культурного наследия: (i) недостаточное сохранение мелких структурных мотивов в методах реконструкции на основе GAN; (ii) ограниченная обобщающая способность вследствие обучения на малых или узкоспециализированных наборах данных; и (iii) недостаточная семантическая согласованность между результатами сегментации и сгенерированными изображениями в архитектурах перевода из изображения в изображение. Кроме того, сегментация, реконструкция и синтез стиля обычно рассматриваются как отдельные процессы, что приводит к потере культурно значимых элементов в ходе реконструкции. Объединяя семантическую сегментацию на основе трансформеров, слияние признаков с перекрестным вниманием (cross-attention), реконструкцию с помощью CycleGAN и художественный синтез под управлением SPADE в рамках единой архитектуры, предлагаемый фреймворк SegCycle-SPADE устраняет эти недостатки и улучшает сохранение мотивов, семантическую согласованность и художественную аутентичность при реконструкции паттернов нематериального культурного наследия (ICH).
Основной целью данного исследования является разработка усовершенствованной архитектуры SegCycle-SPADE для художественной реконструкции узоров нематериального культурного наследия (ICH) с использованием семантической сегментации. В рамках данной архитектуры интегрированы SegFormer для точной сегментации культурных мотивов, CycleGAN для реконструкции узоров и SPADE для стилистически согласованного художественного синтеза. Для улучшения представления признаков и сохранения мелких структурных деталей введен модуль CAFFM, обеспечивающий эффективное взаимодействие между признаками сегментации и генеративными признаками. Предложенная архитектура, обученная на наборах данных Miao Batik и WikiArt, повышает аутентичность реконструкции, стилистическую согласованность и сохранность культурно значимых мотивов.
Объединяя семантическую сегментацию, управляемое вниманием слияние признаков, реконструкцию паттернов и синтез стиля в рамках единой архитектуры, данное исследование представляет новую платформу SegCycle-SPADE для художественной реконструкции паттернов нематериального культурного наследия (НКН). Основной вклад данной работы заключается в следующем. Во-первых, разработана новая платформа реконструкции под управлением семантической сегментации путем интеграции SegFormer, что обеспечивает точное извлечение и сохранение сложных культурных мотивов и структурных элементов. Во-вторых, внедрен новый модуль CAFFM для эффективного слияния признаков сегментации с генеративными представлениями, что позволяет модели фиксировать дальние связи между культурными мотивами и паттернами художественного стиля. В-третьих, предложенный CAFFM улучшает сохранность культурно значимых элементов, одновременно повышая визуальный реализм и структурную связность реконструированных паттернов наследия. В-четвертых, за счет интеграции CycleGAN для реконструкции культурных паттернов и SPADE для управляемого сегментацией художественного синтеза платформа обеспечивает как семантическую точность, так и стилистическую аутентичность генерируемых результатов. В-пятых, для повышения обобщающей способности и художественного разнообразия модель обучалась с использованием набора данных культурных мотивов батика народа мяо для изучения культурных паттернов и набора данных WikiArt для представления художественного стиля. WikiArt служит вспомогательным набором данных для оценки способности платформы к обобщению, устойчивости обучения признакам и эффективности управления стилем в различных визуальных контекстах, а не в качестве целевого стиля для прямого применения в продуктах культурного наследия мяо. Наконец, по сравнению с существующими методами реконструкции культурного наследия на базе GAN, результаты экспериментов демонстрируют, что предложенная платформа SegCycle-SPADE обеспечивает более высокую точность сегментации, качество реконструкции и стилистическую согласованность.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Протокол
Предложенная архитектура SegCycle-SPADE предназначена для реконструкции и улучшения традиционных узоров культурного наследия с помощью семантической сегментации, усиления признаков с использованием механизмов внимания, генеративной реконструкции и синтеза художественного стиля. В данном исследовании использовались общедоступные наборы данных изображений произведений искусства и культурного наследия, включая датасет Miao Batik и датасет WikiArt. В исследовании не принимали участия люди, не использовались данные пациентов, персональная информация, животные или клинические записи; следовательно, одобрение институционального комитета по этике и информированное согласие не требовались. Для начала оценки используются датасет культурных мотивов Miao Batik и датасет WikiArt. Датасет Miao Batik был описан в работе Quan et al. (2024)32 и содержит 15 148 аннотированных изображений традиционных мотивов батика мяо. Существующие аннотации, предоставленные создателями датасета, использовались напрямую; в данном исследовании дополнительные ручные аннотации не создавались. Затем выполняется предварительная обработка изображений, включающая изменение размера, нормализацию, шумоподавление и создание маски сегментации. Точные параметры предварительной обработки описаны в подразделе «Предварительная обработка данных». В предложенной архитектуре для семантической сегментации данных используется модель на основе трансформера под названием SegFormer-B2. Этот метод разработан для обнаружения ключевых областей культурных мотивов и изучения их структур. Затем сегментированные признаки усиливаются с помощью механизма внимания, при котором важная информация, относящаяся к культурным мотивам, выделяется, а иррелевантная информация отсеивается. Конфигурация механизма внимания описана в подразделе «CAFFM». После этого усиленные признаки передаются в CycleGAN, где поврежденные структуры реконструируются посредством циклического обучения. В процессе обучения образцы неполных мотивов создавались искусственно путем применения операций случайного маскирования и частичного перекрытия к оригинальным изображениям Miao Batik. Эти процедуры деградации имитировали отсутствие областей мотивов и структурные повреждения, часто наблюдаемые в ветхих артефактах культурного наследия. Полученные неполные изображения использовались в качестве входных данных для модуля реконструкции CycleGAN, а соответствующие оригинальные изображения служили целями реконструкции. Реконструированные узоры культурного наследия затем улучшаются с помощью SPADE, где художественное усиление выполняется на основе сгенерированных карт сегментации. Эффективность предложенной архитектуры оценивается с помощью количественных метрик сегментации и качества изображений, в то время как визуальная аутентичность реконструированных культурных мотивов оценивается качественно. Визуальная аутентичность оценивалась путем визуального осмотра сгенерированных культурных узоров и не использовалась в качестве независимой количественной метрики. Оценка была сосредоточена на сохранении мотивов, семантической согласованности, культурных особенностях, структурной когерентности и художественном виде относительно соответствующих эталонных культурных мотивов. Количественная оценка производительности модели проводилась с использованием таких показателей, как точность сегментации (Segmentation Accuracy), IoU, коэффициент Дайса (Dice Coefficient), индекс структурного сходства (SSIM), пиковое отношение сигнала к шуму (PSNR) и расстояние Фреше (FID). На рисунке 2 представлена общая схема рабочего процесса предложенной архитектуры SegCycle-SPADE и обобщены метрики оценки, использованные в данном исследовании.
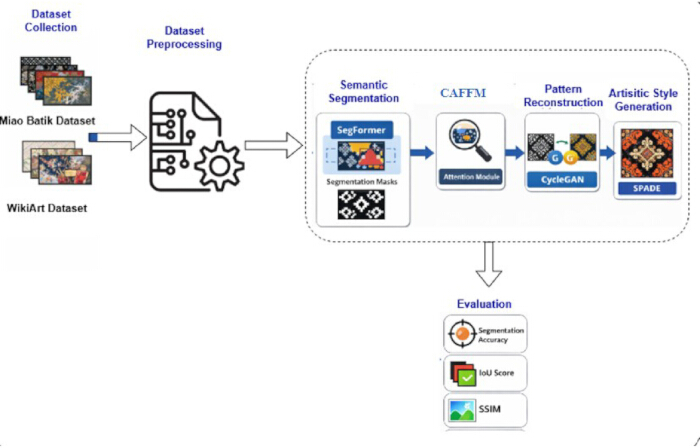
Рисунок 2. Общая архитектура рабочего процесса предлагаемого фреймворка SegCycle-SPADE. Обзор полного рабочего процесса SegCycle-SPADE. Изображения из наборов данных Miao Batik и WikiArt проходят предварительную обработку, после чего подвергаются семантической сегментации с помощью SegFormer-B2, усилению признаков с помощью CAFFM, реконструкции паттернов с помощью CycleGAN и генерации художественного стиля с помощью SPADE. Эффективность модели оценивается по показателям точности сегментации (Segmentation Accuracy), пересечения над объединением (IoU), коэффициента Дайса (Dice Coefficient), индекса структурного сходства (SSIM), PSNR и расстояния Фреше (FID), в то время как визуальная достоверность оценивается качественно. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Фреймворк SegCycle-SPADE для реконструкции паттернов культурного наследия разработан для интеграции нескольких компонентов глубокого обучения (DL) с целью точной сегментации, реконструкции и художественного улучшения мотивов, как показано на Рисунке 2. Для обеспечения разнообразия культурных паттернов и художественных стилей используются изображения из набора данных культурных мотивов Miao Batik и набора данных WikiArt. Первоначально изображения обрабатываются с помощью модуля семантической сегментации на базе SegFormer для идентификации и выделения культурных мотивов из фона. Общая архитектура состоит из четырех основных этапов. Во-первых, модель SegFormer извлекает карты семантической сегментации из изображений культурных паттернов. Во-вторых, CAFFM объединяет признаки сегментации с генеративными представлениями для улучшения обучения признаков. В-третьих, модуль CycleGAN реконструирует культурные паттерны, используя объединенные представления признаков. Наконец, модуль SPADE генерирует художественно улучшенные результаты, сохраняя структурную целостность за счет синтеза под управлением сегментации. Уточненные карты признаков впоследствии обрабатываются модулем реконструкции CycleGAN, который обучается восстанавливать неполные культурные мотивы путем сопоставления деградировавших паттернов с их соответствующими полными формами. Образцы неполных мотивов были созданы путем применения операций случайного маскирования и частичного перекрытия к оригинальным изображениям Miao Batik, имитируя тем самым отсутствующие области паттернов и структурную деградацию, часто наблюдаемую в поврежденных культурных артефактах. Каждое деградировавшее изображение было сопоставлено с соответствующим оригинальным изображением, которое служило целью реконструкции в процессе обучения. Эта стратегия позволила модулю CycleGAN освоить восстановление отсутствующих структур мотивов при сохранении семантической согласованности и культурно значимых характеристик. Наконец, генератор SPADE создает визуально улучшенные художественные результаты, обуславливая синтез изображений сгенерированными картами сегментации, тем самым поддерживая структурную целостность культурных мотивов на протяжении всего процесса художественного улучшения.
Предлагаемая структура SegCycle-SPADE включает в себя следующие этапы.
Шаг 1: Сбор наборов данных
Для достижения целей по изучению культурных паттернов и генерации художественных стилей использовались два набора данных. Набор данных культурных мотивов мяо-батика (Miao Batik Cultural Motif Dataset) использовался для получения информации о традиционных культурных паттернах. Данный набор данных общедоступен через Zenodo (https://doi.org/10.5281/zenodo.20807658) и содержит 15 148 аннотированных изображений традиционных мотивов мяо-батика. Существующие аннотации, предоставленные создателями набора данных, использовались напрямую; в данном исследовании дополнительные ручные аннотации не создавались. Набор данных WikiArt использовался для получения разнообразной информации о художественных стилях для генерации художественного стиля и был получен из общедоступного репозитория WikiArt (https://www.wikiart.org/).
Шаг 2: Предобработка данных
Все изображения прошли предобработку, включающую изменение размера, нормализацию и шумоподавление. Для поддержки этапа семантической сегментации использовались имеющиеся аннотации культурных мотивов, полученные из первоначальных источников набора данных. В рамках данного исследования дополнительные процедуры аннотирования или перемаркировки не проводились.
Шаг 3: Семантическая сегментация паттернов с помощью SegFormer
Для сегментации культурных мотивов использовалась модель SegFormer. Точные характеристики архитектуры (backbone) и стратегия инициализации SegFormer описаны в подразделе Семантическая сегментация паттернов с помощью SegFormer. В частности, для семантической сегментации мотивов применялась архитектура SegFormer-B2 с базовой моделью MIT-B2, предобученной на ImageNet. Данная модель эффективно фиксирует глобальную контекстную информацию, сохраняя при этом сложные структурные детали традиционных культурных паттернов.
Шаг 4: CAFFM
CAFFM объединяет признаки семантической сегментации с генеративными представлениями, что позволяет архитектуре изучать как характеристики структурных мотивов, так и информацию о художественном стиле. Подробности интеграции CAFFM приведены в подразделе CAFFM. Данный модуль расположен между этапом семантической сегментации на базе SegFormer и этапом генеративной реконструкции; в нем происходит слияние структурных признаков, полученных в результате сегментации, с признаками реконструкции посредством многоголового перекрестного внимания (multi-head cross-attention). Этот процесс улучшает сохранность культурных мотивов и повышает реалистичность реконструированных результатов.
Шаг 5: Реконструкция паттернов (CycleGAN)
Объединенные признаки затем обрабатываются модулем CycleGAN для реконструкции структур культурных паттернов. Архитектура CycleGAN и конфигурация обучения описаны в подразделе Реконструкция паттернов с помощью CycleGAN. Модуль реконструкции состоит из двух генераторов и двух дискриминаторов, использует архитектуру генератора на базе остаточной сети с девятью остаточными блоками, применяет дискриминатор PatchGAN и обучается с использованием состязательных потерь и потерь циклической согласованности. Такая конфигурация обеспечивает двунаправленное отображение доменов и способствует реконструкции неполных структур культурных паттернов.
Шаг 6: Генерация художественного стиля (SPADE)
Затем реконструированные паттерны обрабатываются модулем SPADE для синтеза художественного стиля с использованием сегментации. Конфигурация генератора SPADE описана в подразделе Artistic Style Generation Using SPADE. В модуле используются остаточные блоки SPADE, слои пространственно-адаптивной нормализации и семантическое обусловливание, полученное из карт сегментации SegFormer и функциональных представлений CAFFM. Благодаря обусловливанию генерации изображений на основе карт сегментации, синтезированные результаты сохраняют структурное соответствие оригинальным культурным мотивам, при этом включая характеристики художественного стиля.
Шаг 7: Оценка эффективности
Предложенная структура была оценена с помощью нескольких метрик сегментации и оценки качества изображений, включая точность сегментации (Segmentation Accuracy), IoU, коэффициент сходства Дайса (Dice), SSIM, PSNR и FID. Для оценки воспроизводимости экспериментов все опыты повторяли пять раз с использованием различных случайных значений seed, результаты представлены как среднее значение ± стандартное отклонение. Статистическая значимость оценивалась с помощью парного t-критерия с порогом значимости p < 0.05.
Сбор наборов данных
В предлагаемой структуре SegCycle-SPADE для понимания культурных паттернов и обучения стилям используются два набора данных. Первым набором данных, применяемым в предлагаемой структуре, является набор данных культурных мотивов батика народа мяо. Этот набор содержит культурные мотивы батика мяо, которые представляют собой изображения традиционного батика мяо с такими элементами, как животные, растения и геометрические фигуры, используемые в искусстве этнической группы мяо. Данный набор содержит изображения с богатой текстурной информацией, что в целом важно для сохранения культурного наследия. Вторым набором данных, используемым в предлагаемой структуре SegCycle-SPADE, является набор данных WikiArt. Этот набор содержит огромное количество произведений искусства, выполненных в различных стилях. Он применяется для обучения сложным стилям, что обычно полезно для улучшения художественных произведений. Данный набор состоит из 80 000 произведений искусства в высоком разрешении (HD) с 27 различными вариантами дизайна, что делает его более эффективным для задач генерации или трансформации стиля на основе глубокого обучения (DL).
Набор данных Miao Batik:
Набор данных Miao Batik (https://doi.org/10.5281/zenodo.20807658) включает 15 148 изображений узоров батика с культурно значимыми мотивами. Изображения содержат разнообразные традиционные дизайны, такие как анималистические мотивы (например, бабочки и рыбы), растительные орнаменты и геометрические мотивы, несущие культурный символизм. Данный набор данных является важным компонентом предлагаемой структуры, поскольку он предоставляет аутентичные культурные структуры, которые позволяют модулю сегментации точно определять и сохранять границы мотивов в процессе реконструкции узора (Таблица 1). В данном исследовании под культурно значимыми мотивами понимаются символические визуальные элементы, часто описываемые в литературе по культурному наследию народа мяо и представленные в аннотациях набора данных, включая птиц, бабочек, цветочные узоры и тотемы предков. Эти мотивы были выбраны на основании их документально подтвержденной культурной значимости и частого присутствия в традиционном батике и вышивке мяо, а не только исходя из частоты их появления или пространственной композиции. Аннотации мотивов и метки сегментации, созданные под руководством экспертов, были получены из исходного источника набора данных Miao Batik и использовались в данном исследовании напрямую. Авторы не проводили дополнительного ручного аннотирования, перемаркировки или процедур аннотирования под руководством экспертов. Существующие аннотации, предоставленные создателями набора данных, использовались для обучения и оценки семантической сегментации.
| Параметр | Описание |
| Название набора данных | Набор данных культурных узоров батика народа мяо |
| Источник набора данных | Репозиторий Zenodo (DOI: 10.5281/zenodo.20807658) |
| Область | Нематериальное культурное наследие (НКН) / Анализ текстильных орнаментов |
| Общее количество изображений | 15 148 изображений |
| Тип изображения | Цифровые изображения традиционных узоров текстиля батик народа мяо |
| Категории паттернов | Зооморфные мотивы, растительные мотивы и геометрические мотивы |
| Культурное происхождение | культура этнической группы мяо, провинция Гуйчжоу, Китай |
| Разрешение исходного изображения | Изображения высокого разрешения (обычно ≥ 1000 пикселей по короткой стороне), полученные в виде необработанных сканов или фотографий до проведения предварительной обработки |
| Разрешающая способность обучения | Изображения масштабированы до 256 × 256 пикселей в процессе предварительной обработки |
| Доступность аннотаций | Существующие аннотации сегментации, предоставленные создателями набора данных, использовались для обучения и оценки без изменений. В данном исследовании не проводилось дополнительное ручное аннотирование, перемаркировка или процедуры экспертного подтверждения. |
| Применение в данном исследовании | Сегментация культурных мотивов, извлечение признаков, сохранение мотивов и реконструкция паттернов |
Таблица 1: Характеристики набора данных культурных узоров батика народа мяо. Сводные данные набора культурных мотивов батика мяо, использованного для семантической сегментации, анализа культурных узоров и реконструкции мотивов. В таблице описаны источник набора данных, характеристики изображений, категории мотивов, культурное происхождение, разрешение изображений и роль набора данных в предлагаемой структуре SegCycle-SPADE.
Набор данных WikiArt:
Набор данных WikiArt [https://www.wikiart.org/] представляет собой популярный крупномасштабный цифровой репозиторий произведений искусства, который включает более 80 000 изображений, относящихся к 27 различным художественным стилям в Таблица 2Стили включают искусство Ренессанса, импрессионизм, кубизм и сюрреализм. Данный набор данных играет важную роль в предлагаемой структуре, так как он предоставляет знания, которые позволяют модулю SPADE создавать культурно обогащенные паттерны при сохранении структурной информации, полученной в процессе сегментации. Набор данных состоит из 56 000 изображений для обучения и 12 000 изображений для валидации и тестирования. Изображения в этом наборе данных способствуют эффективному обучению модели глубокого обучения.
| Параметр | Описание |
| Название набора данных | Набор данных WikiArt |
| Источник набора данных | Репозиторий WikiArt (https://www.wikiart.org/) |
| Область применения | Цифровое искусство и живопись |
| Общее количество изображений | Приблизительно 80 000 произведений искусства |
| Обучающие изображения | 56,000 |
| Валидационные изображения | 12,000 |
| Тестовые изображения | 12,000 |
| Художественные стили | 27 художественных стилей, включая Ренессанс, импрессионизм, кубизм, сюрреализм, экспрессионизм, реализм и абстрактное искусство |
| Разрешение исходного изображения | Исходное разрешение изображений варьируется в зависимости от произведений искусства и источников. В ходе предобработки изображения были приведены к единому разрешению 256 × 256 пикселей. |
| Разрешающая способность обучения | В процессе предварительной обработки перед обучением художественному стилю и синтезом изображений с использованием сегментации изображения были изменены до размера 256 × 256 пикселей. |
| Разбиение набора данных | Стратифицированное случайное разделение (70% — обучающая, 15% — валидационная и 15% — тестовая выборки) с использованием фиксированного случайного числа (seed) 42 |
| Стратегия семплирования стилей | Для сохранения распределения 27 художественных стилей в обучающей, валидационной и тестовой подвыборках использовался метод стратифицированного пропорционального отбора. |
| Применение в данном исследовании | Обучение художественному стилю, представление стиля и художественный синтез с использованием сегментации |
Таблица 2: Характеристики набора данных WikiArt. Сводка по набору данных WikiArt, использованному для обучения художественному стилю и синтеза изображений с учетом стиля. В таблице описаны источник набора данных, распределение изображений, охват художественных стилей, разделение набора данных, разрешение изображений и его применение в рамках предлагаемой структуры SegCycle-SPADE.
Набор данных Miao Batik содержит 15 148 изображений, представляющих традиционные культурные мотивы народа мяо.32 Набор данных общедоступен через Zenodo (https://doi.org/10.5281/zenodo.20807658). Перед обучением модели все изображения прошли визуальный осмотр, были приведены к размеру 256 × 256 пикселей, нормализованы и проверены на наличие поврежденных или дублирующих образцов. В результате контроля качества ни одно изображение не было исключено; таким образом, все 15 148 изображений были сохранены для последующего анализа. Набор данных был случайным образом разделен на обучающую (70%), валидационную (15%) и тестовую (15%) подвыборки с использованием фиксированного случайного числа (seed) 42 для обеспечения воспроизводимости разделения данных. Набор данных WikiArt был получен из официального репозитория WikiArt (https://www.wikiart.org/) и содержит более 80 000 произведений искусства, охватывающих 27 художественных стилей. Для экспериментов по изучению стилей 56 000 изображений использовались для обучения, 12 000 — для валидации и 12 000 — для тестирования.
Предобработка данных
Перед обучением предлагаемой структуры SegCycle-SPADE набор данных культурных мотивов Мяо Батик и набор данных WikiArt прошли несколько этапов предобработки для обеспечения единообразного качества изображений и точного представления признаков. К обоим наборам данных был применен один и тот же базовый конвейер предобработки, включающий гауссово шумоподавление, нормализацию, изменение размера до согласованного входного разрешения и проверку качества изображений. Однако наборы данных выполняли разные роли в рамках структуры. Набор данных WikiArt использовался для изучения и синтеза художественного стиля, тогда как набор данных Мяо Батик использовался преимущественно для сегментации и реконструкции культурных мотивов. Помимо этих специфических задач, никаких изменений в предобработке для конкретных наборов данных не вносилось. Для обеспечения согласованности обработки моделью DL изображения сначала были приведены к фиксированному разрешению. Этот шаг был необходим, так как изображения в обоих наборах данных имели разное разрешение в зависимости от источника. Изменение размера повысило вычислительную эффективность и предотвратило влияние размерных несоответствий на процесс обучения. Вторым этапом предобработки была нормализация, при которой значения пикселей были масштабированы до стандартного диапазона для стабилизации обновления градиентов во время обучения. Затем изображения обрабатывались с помощью фильтра Гаусса для уменьшения шума, который мог бы исказить структуры культурных мотивов. Для набора данных Мяо Батик существующие маски сегментации культурных мотивов, полученные непосредственно из исходного источника набора данных, использовались без изменений для обучения и оценки семантической сегментации. Новые маски сегментации специально для данного исследования не создавались.
Если не указано иное, уравнения, описывающие общепринятые методы, были адаптированы из предыдущих исследований и соответствующим образом процитированы. Уравнения, описывающие предлагаемый метод CAFFM и комбинированную структуру оптимизации SegCycle-SPADE, были разработаны авторами специально для данного исследования.
Пусть входное изображение из набора данных будет представлено в виде Уравнения 1:
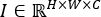 (1)
Здесь H, W и C обозначают высоту, ширину изображения и количество цветовых каналов соответственно. Все изображения масштабируются до фиксированного размера H′ × W′, как показано в Уравнении 2:
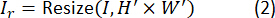
Здесь Ir — это изображение с измененным размером. Нормализованные значения пикселей вычисляются в соответствии с Уравнением 3:
 (3)
Это способствует стабилизации процедуры обучения. Фильтрация шума выполняется с использованием фильтра Гаусса, как показано в уравнении 4:
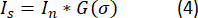
Здесь G(σ) — гауссовский фильтр, а * обозначает операцию свертки. Использовался гауссовский фильтр с ядром 5 × 5 и стандартным отклонением σ = 1.0. Для уменьшения краевых артефактов к граничным пикселям применялось зеркальное дополнение (reflective padding). Процесс шумоподавления выполнялся сразу после загрузки изображений, до их масштабирования и нормализации. Для обеспечения единообразия предварительной обработки во всем исследовании одна и та же конфигурация фильтра применялась к каждому изображению в наборах данных Miao Batik и WikiArt. Для набора данных Miao Batik маски сегментации создаются в соответствии с Уравнением 5:

Здесь M — это маска сегментации, используемая для управления моделью SegFormer.
Конвейер предварительной обработки начинается со сбора изображений из набора данных Miao Batik и набора данных WikiArt, как показано на Рисунке 3. Во время обучения методы аугментации данных не применялись. После предварительной обработки, которая включала изменение размера, нормализацию, гауссово шумоподавление и подготовку масок сегментации, изображения использовались напрямую для обучения, валидации и тестирования предложенной архитектуры SegCycle-SPADE. Первым этапом конвейера предварительной обработки является изменение размера изображений до фиксированного значения, что позволяет модели DL обрабатывать изображения более эффективно. Вторым этапом является нормализация, которая преобразует значения пикселей в стандартизированный числовой диапазон и способствует сходимости модели. Третий этап включает удаление шума, при котором изображения очищаются от нежелательных помех для улучшения распознавания образов. Кроме того, для набора данных Miao Batik аннотируются области культурных мотивов, что позволяет генерировать маски, используемые в модуле сегментации предложенной модели для обеспечения сохранности культурных мотивов в процессе генерации. Конечным результатом этого этапа является чистый набор данных, готовый для обучения модулей сегментации и генерации предложенной модели.
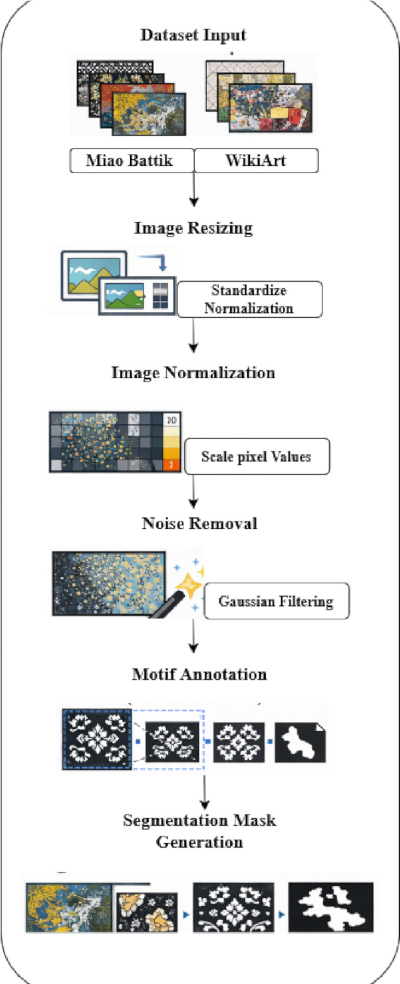
Рисунок 3. Конвейер предварительной обработки изображений объектов культурного наследия. Схема, иллюстрирующая процедуры предварительной обработки изображений, применяемые перед обучением модели. Конвейер включает сбор набора данных, изменение размера изображений, нормализацию, гауссово шумоподавление, аннотирование существующих культурных мотивов и подготовку масок сегментации. Полученные обработанные изображения и маски используются в качестве входных данных для семантической сегментации и реконструкции паттернов. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Перед обучением модели каждое изображение прошло процесс контроля качества. Набор данных Miao Batik содержал 15 148 изображений. Поврежденные, дублированные и низкокачественные образцы были предварительно обработаны создателями исходного набора данных, поэтому в ходе данного исследования при проверке качества дополнительные изображения не исключались. Следовательно, для анализа были сохранены все 15 148 изображений. На этапе предобработки изображения загружались в формате RGB и масштабировались до 256 × 256 пикселей с использованием билинейной интерполяции. Значения пикселей были масштабированы из диапазона [0, 255] в диапазон [0, 1] путем деления на 255. Затем была выполнена поканальная нормализация с использованием средних значений [0.485, 0.456, 0.406] и значений стандартного отклонения [0.229, 0.224, 0.225] для красного, зеленого и синего каналов соответственно. Конвейер предобработки включал загрузку изображений, преобразование в RGB, изменение размера, масштабирование значений пикселей, нормализацию и преобразование в тензоры. При необходимости изображения в градациях серого преобразовывались в трехканальный формат RGB для обеспечения совместимости с моделями глубокого обучения (DL). После предобработки изображения были разделены на обучающую, валидационную и тестовую выборки. На всех этапах работы фреймворка SegCycle-SPADE, включая семантическую сегментацию, слияние признаков, реконструкцию мотивов и художественный синтез на основе SPADE, использовалось единое входное разрешение 256 × 256 пикселей.
Семантическая сегментация паттернов с использованием SegFormer
После этого этапа предварительной обработки очищенные и нормализованные изображения из набора данных культурных мотивов Мяо Батик и набора данных WikiArt подаются в модуль семантической сегментации, основанный на предлагаемой архитектуре SegFormer-B2. Целью данного этапа является правильная идентификация и разделение культурных мотивов, присутствующих в традиционных паттернах. Предложенная архитектура SegFormer базируется на трансформерной архитектуре, которая включает иерархический энкодер-трансформер и легковесный MLP-декодер для точного захвата как глобальной контекстуальной информации, так и детальной структурной информации сложных традиционных паттернов. Сначала модель извлекает представления признаков на нескольких масштабах из входного изображения, после чего эти представления объединяются с помощью декодера для генерации точных сегментированных паттернов. Это обеспечивает правильную сегментацию паттернов на традиционном изображении по таким мотивам, как геометрические, растительные и символические узоры, отделяя их от фона при сохранении их структурной целостности. Полученная структурная информация впоследствии используется на более поздних этапах генерации паттернов в рамках архитектуры SegCycle-SPADE.
Пусть предварительно обработанное входное изображение будет представлено как Уравнение 6:
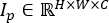 (6)
Энкодер SegFormer разделяет изображение на патчи и извлекает иерархические признаки с помощью слоев трансформера, как показано в Уравнении 71:
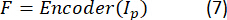
Здесь F обозначает многомасштабные карты признаков, полученные из трансформерного кодировщика. Эти признаки кодируют как локальные текстурные паттерны, так и глобальные контекстуальные связи между областями мотивов. Модель SegFormer извлекает карты признаков в разных масштабах, как определено в Уравнении 8:
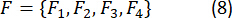
Использование многомасштабных представлений облегчает обнаружение паттернов различных размеров в культурных мотивах. Наконец, признаки объединяются с помощью MLP-декодера, как показано в Уравнении 91:
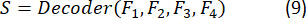
Здесь S обозначает итоговую прогнозируемую карту сегментации.
Базовая сеть SegFormer-B2 была инициализирована с использованием весов, предварительно обученных на ImageNet, и впоследствии дообучена на наборе данных Miao Batik для сегментации культурных мотивов. Контрольная точка предобученной модели была получена из официальной реализации SegFormer. В частности, для инициализации базовой сети SegFormer-B2 перед дообучением использовалась контрольная точка MIT-B2 (mit_b2.pth), предобученная на ImageNet-1K и предоставленная официальным репозиторием SegFormer. Предобученные веса соответствуют базовой сети MIT-B2, выпущенной авторами SegFormer, и служили моделью инициализации для обучения семантической сегментации. Остальные слои, специфичные для конкретной задачи, перед началом обучения были инициализированы с использованием стандартных процедур инициализации весов PyTorch.
В архитектуре используется четырехстадийный иерархический кодировщик Transformer с перекрывающимися эмбеддингами патчей. На начальном этапе размер патча был установлен на 7 × 7 с шагом 4. Для каждой из четырех стадий кодировщика размерности эмбеддингов составляли 64, 128, 320 и 512. На этих четырех стадиях использовалось 1, 2, 5 и 8 голов многоголового самовнимания (multihead self-attention), а соответствующая глубина кодировщика составляла 3, 4, 6 и 3 слоя. Многомасштабные признаки, полученные из кодировщика, объединялись с помощью легковесного декодера на базе MLP. Перед созданием итоговой карты сегментации декодер проецировал признаки с каждой стадии кодировщика в единое пространство эмбеддингов. Во всех блоках Transformer использовалась функция активации GELU (Gaussian Error Linear Unit). Для улучшения обобщающей способности и снижения переобучения в процессе обучения использовалась вероятность дропаута (dropout rate) 0.1.
На этапе обучения платформа SegFormer получает предварительно обработанные изображения из обоих наборов данных. Изображения из набора данных Miao Batik содержат области мотивов, которые служат метками для контролируемого обучения модели сегментации. Трансформерный энкодер обрабатывает всё изображение и фиксирует дальние связи между его компонентами, что особенно важно для традиционных узоров батика с пространственно распределенными мотивами. Механизм иерархического извлечения признаков одновременно фиксирует локальные структуры, такие как повторяющиеся геометрические текстуры. MLP-декодер обрабатывает эти извлеченные признаки и формирует маску сегментации, выделяющую области мотивов. Карты сегментации, созданные на этом этапе, впоследствии используются в качестве структурных входных данных для модуля внимания и этапа реконструкции паттернов, что способствует сохранению аутентичности генерируемых узоров.
Культурные мотивы были разделены на различные классы для семантической сегментации в соответствии с их визуальными и культурными характеристиками. Таксономия сегментации включала анималистические мотивы (например, бабочек, рыб, птиц и другую символическую фауну), растительные мотивы (например, цветы, листья, лозы и ботанические узоры), геометрические мотивы (например, повторяющиеся фигуры, бордюры и абстрактные геометрические структуры), а также области фона, представляющие зоны без мотивов. Маски сегментации на уровне пикселей использовались для присвоения каждому пикселю одного из предопределенных классов. Целочисленные метки были закодированы следующим образом: Метка 0 = фон, Метка 1 = анималистические мотивы, Метка 2 = растительные мотивы и Метка 3 = геометрические мотивы. Аннотации сегментации и метки мотивов были получены непосредственно из первоначального источника набора данных Miao Batik. В данном исследовании не проводилось дополнительного ручного аннотирования, перемаркировки, проверки границ или процедур экспертного подтверждения. Существующие аннотации, предоставленные создателями набора данных, использовались без изменений для обучения и оценки.
Модель SegFormer для сегментации культурных мотивов обрабатывает предварительно обработанные изображения из наборов данных Miao Batik и WikiArt, используя механизм на основе трансформера для точного обнаружения областей с культурными узорами, как показано на рисунке 4. Сначала в модель SegFormer подается входное изображение, содержащее традиционные культурные мотивы. Энкодер Transformer извлекает из фрагментов изображения как глобальную контекстную информацию, так и локальные структурные признаки. Полученные многомасштабные признаки передаются в декодер сегментации, который использует смешанную сеть прямого распространения (Mix Feed-Forward Network) для уточнения представлений признаков и улучшения обнаружения мотивов. Результатом работы модели SegFormer является маска сегментации, которая выделяет пиксели, соответствующие культурным узорам, подавляя при этом нерелевантную информацию фона. Выделенные культурные узоры затем служат структурным руководством для последующих этапов работы архитектуры SegCycle-SPADE.
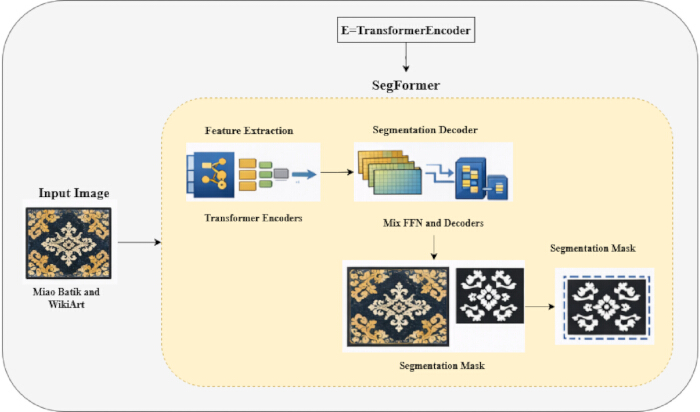
Рисунок 4. Семантическая сегментация культурных мотивов на основе SegFormer-B2. Архитектура модуля семантической сегментации SegFormer-B2, используемого для извлечения культурных мотивов и обученного исключительно на наборе данных Miao Batik. Структура состоит из кодировщика на базе Transformer для многомасштабного извлечения признаков и облегченного декодера сегментации для генерации масок мотивов. Модель предсказывает четыре семантических класса — животные, растения, геометрические фигуры и фон, при этом результирующие маски сегментации определяют области культурно значимых мотивов, подавляя иррелевантную информацию о фоне. Результаты этой сегментации служат структурным руководством для последующих этапов слияния признаков, реконструкции и художественного синтеза в предлагаемой структуре SegCycle-SPADE. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
В предлагаемой структуре нет необходимости создавать новые аннотации сегментации. Набор данных Miao Batik был получен из уже существующего открытого источника, а модель обучалась с использованием соответствующей информации о мотивах, предоставленной создателями набора данных. В процессе обучения модель SegFormer генерировала карты семантической сегментации. В результате в данном исследовании не потребовалось использование дополнительного программного обеспечения для ручной аннотации, разработка руководств по аннотированию или внедрение процедур контроля качества аннотаций.
CAFFM
Для улучшения взаимодействия между признаками семантической сегментации и представлениями генеративной реконструкции в исследовании также был предложен модуль CAFFM. Энкодер SegFormer-B2 передает семантические карты признаков в модуль CAFFM, в то время как этап реконструкции CycleGAN обеспечивает генеративные карты признаков. Сначала используются слои линейной проекции для отображения обоих потоков признаков в общее пространство вложений. Для вычисления перекрестного внимания (cross-attention) с использованием сгенерированных тензоров признаков создаются представления запроса (Q), ключа (K) и значения (V). Затем с помощью многоголового перекрестного внимания моделируются взаимосвязи между информацией о структурных мотивах и элементами художественного стиля. После этого к объединенным представлениям признаков применяются нормализация слоя, остаточные связи и полносвязные слои с активацией GELU. Этап синтеза на базе SPADE получает выходные данные модуля CAFFM, что позволяет сохранить культурно значимые темы без ущерба для художественной целостности.
Для обеспечения совместимости признаков входные признаки сначала проецируются с помощью слоев линейной проекции в общее пространство эмбеддингов с размерностью эмбеддинга 256. Взаимосвязи между семантической структурной информацией и репрезентациями генеративного стиля затем моделируются с помощью механизма MultiHead Cross-Attention с восемью головками внимания. Вычисление перекрестного внимания (cross-attention) использует векторы запроса (Query, Q), ключа (Key, K) и значения (Value, V), которые создаются специальными слоями линейного преобразования. Для повышения стабильности обучения и сохранения целостности признаков используются остаточные связи (residual connections) и нормализация слоев (Layer Normalization) для дальнейшего улучшения объединенных репрезентаций признаков. Нелинейное обучение признаков затем совершенствуется путем применения сети прямого распространения с функцией активации GELU (Gaussian Error Linear Unit). Модуль генерирует выходную репрезентацию признаков размерности 256, которая передается на другие этапы для творческого синтеза. CAFFM успешно объединяет данные о художественном стиле со структурами культурных мотивов, используя метод слияния на основе перекрестного внимания, что улучшает сохранность мотивов и визуальную целостность реконструированных узоров культурного наследия.
В предлагаемой системе структурные признаки извлекаются из набора данных Miao Batik, в то время как стилистические признаки изучаются на основе набора данных WikiArt. Пусть карта признаков, полученная с помощью сети сегментации SegFormer с использованием изображений из набора данных Miao Batik, будет обозначена как Fs, а карта признаков, полученная из ветви извлечения стилистических признаков с использованием изображений WikiArt, — как Fa. Предложенный модуль CAFFM объединяет два домена признаков с помощью механизма перекрестного внимания (cross-attention) для изучения как структурных, так и стилистических зависимостей культурных узоров. В Таблице 3 приведены все архитектурные характеристики, включая размерности эмбеддингов, слои нормализации, функции активации и конфигурацию голов внимания. Для входного изображения размером 256 × 256 пикселей энкодер SegFormer-B2 генерировал семантические карты признаков размером 64 × 64 × 128, а ветвь извлечения стилистических признаков — карты признаков размером 64 × 64 × 128. Обе карты признаков проецировались через обучаемые линейные слои в общее пространство эмбеддингов размерностью 256 перед слиянием посредством перекрестного внимания.
| Параметр | Конфигурация |
| Предлагаемая концепция | SegCycle-SPADE |
| Модель семантической сегментации | SegFormer-B2 |
| Стадии энкодера SegFormer | 4 |
| Инициализация весов | Предобученная на ImageNet-1K модель SegFormer-B2 (опорная сеть MIT-B2) |
| Источник контрольной точки | Официальный репозиторий NVIDIA SegFormer (https://github.com/NVlabs/SegFormer); контрольная точка: segformer.b2.512x512.ade.160k |
| Стратегия тонкой настройки | Сквозная тонкая настройка на наборе данных Miao Batik |
| Размер эмбеддинга патча | 7 × 7 |
| Шаг патча | 4 |
| Размерности эмбеддингов | 64, 128, 320 и 512 |
| Глубина кодировщика | 3, 4, 6 и 3 |
| Головы внимания | 1, 2, 5 и 8 |
| Тип декодера | Декодер на базе MLP |
| Функция активации | GELU (линейный единичный модуль с ошибкой Гаусса) |
| Доля выбывших | 0.1 |
| Модуль улучшения признаков | Модуль слияния культурных признаков на основе перекрестного внимания (CAFFM) |
| Размерность вложения CAFFM | 256 |
| Механизмы внимания CAFFM | 8 |
| Шкалы слияния CAFFM | 4 |
| Модель реконструкции | CycleGAN |
| Модель генерации стиля | SPADE |
| Культурный набор данных | Набор данных батика народа мяо |
| Набор данных по стилям | Набор данных WikiArt |
| Изображения батика народа мяо | 15,148 |
| Изображения WikiArt | Приблизительно 80 000 |
| Разрешение входного изображения | 256 × 256 пикселей |
| Формат цвета | RGB |
| Метод интерполяции | Билинейная интерполяция |
| Метод шумоподавления | Гауссова фильтрация |
| Размер ядра Гаусса | 5 × 5 |
| Сигма (σ) распределения Гаусса | 1 |
| Диапазон нормализации | [0, 1] |
| Размер серии | 16 |
| Количество эпох | 100 |
| Оптимизатор | Адам |
| Скорость обучения | 0.0002 |
| Параметры Adam | β₁ = 0,5, β₂ = 0,999, ε = 1 × 10⁻⁸, weight decay = 0 |
| Функции потерь | функция потерь при сегментации, адверсариальная функция потерь, функция потерь циклической согласованности, функция потерь при реконструкции, функция потерь при сохранении мотивов и функция потерь при согласованности стиля |
| Стратегия разделения набора данных | Обучение / Валидация / Тестирование |
| Обучающая выборка | 70% |
| Валидационный набор | 15% |
| Тестовый набор | 15% |
| Случайное число (Seed) | 42 |
| Метрики оценки | Точность сегментации, IoU, коэффициент Дайса, SSIM, PSNR и FID |
| Язык программирования | Python 3.8.10 |
| Фреймворк глубокого обучения | PyTorch 1.10.0 |
| Аппаратная платформа | ГП NVIDIA RTX 3090 (24 ГБ видеопамяти), Intel Core i7 (11-го поколения), 32 ГБ оперативной памяти |
| Рабочая среда | Ubuntu 20.04 LTS |
Таблица 3: Экспериментальная установка и конфигурация модели. Сводка архитектурных компонентов, конфигурации обучения, настроек предобработки, наборов данных, параметров оптимизации, метрик оценки и вычислительной среды, использованных для реализации и оценки предлагаемой структуры SegCycle-SPADE.
Модуль внимания сначала отображает карту признаков в представления запроса, ключа и значения с помощью Уравнения 10:
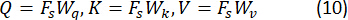
Здесь Втq, Wки Wv представляют собой обучаемые матрицы весов. Веса внимания рассчитываются на основе сходства между вектором запроса и вектором ключа с помощью Уравнение 1117:
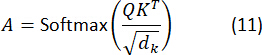
Здесь, дк является размерностью вектора ключей. Улучшенное представление признаков вычисляется путем перемножения весов внимания с матрицей значений с помощью Уравнение 12:
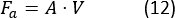
Здесь Fa представляет собой улучшенное представление признаков карты признаков. Улучшенное представление признаков вычисляется путем объединения исходных признаков сегментации с улучшенными признаками, полученными с помощью механизма внимания согласно Уравнению 13:
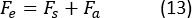
Здесь Fe — это улучшенная карта признаков, используемая для реконструкции паттерна. CAFFM расширен многомасштабным механизмом перекрестного внимания для извлечения признаков культурных мотивов в разных масштабах. Пусть Fsi обозначает признаки сегментации в масштабе i, а Faj — признаки художественного стиля в том же масштабе. Итоговое представление признаков определяется с помощью Уравнения 14:
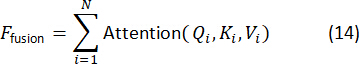
Здесь Qi, Ki и Vi представляют собой матрицы запросов (query), ключей (key) и значений (value) на масштабе i соответственно, а N обозначает количество масштабов признаков. В данном исследовании N = 4, что соответствует картам признаков, извлеченным при пространственных разрешениях 1/4, 1/8, 1/16 и 1/32 от размера входного изображения. Эти многомасштабные представления признаков объединялись с использованием обучаемых весов внимания перед реконструкцией и художественным синтезом. Приведенное выше расширение позволяет методу извлекать глобальные культурные мотивы и текстуры для реконструкции культурных узоров. Модуль CAFFM расположен между этапом сегментации на базе SegFormer и этапом креативного синтеза на базе SPADE в предлагаемой системе SegCycle-SPADE. Сначала, в то время как CycleGAN одновременно создает признаки реконструкции со стилистической и паттерн-зависимой информацией, SegFormer-B2 восстанавливает семантические карты признаков, описывающие структурные свойства культурных мотивов. Модуль CAFFM принимает эти два потока признаков и использует слияние на основе перекрестного внимания (cross-attention) для выявления взаимосвязей между структурными и художественными представлениями. Затем полученные объединенные карты признаков направляются в модуль SPADE для креативного синтеза под управлением сегментации, чтобы создать культурно аутентичные узоры при сохранении семантической согласованности и структурных особенностей.
Реконструкция узоров с помощью CycleGAN
После завершения этапа усиления признаков на основе механизма внимания карты признаков будут содержать усиленные структуры культурных мотивов. Однако на картах признаков все еще могут присутствовать неполные или поврежденные области узоров. Следовательно, для решения проблемы реконструкции узоров в предлагаемой архитектуре будет использоваться модель CycleGAN. В данной архитектуре двумя доменами будут являться оригинальные узоры культурных мотивов и реконструированные узоры культурных мотивов. Используя усиленные признаки с предыдущих этапов, модель CycleGAN восстановит культурные узоры, сохраняя при этом структурную целостность. Это гарантирует сохранение пространственного расположения таких элементов, как геометрические, цветочные и символические узоры. Оригинальные изображения батика народа мяо подвергались операциям случайного маскирования и частичного перекрытия для создания неполных или поврежденных культурных мотивов. Эти процедуры деградации имитировали отсутствие фрагментов узора и структурные повреждения, часто наблюдаемые в изношенных объектах культурного наследия. Деградированные изображения использовались в качестве входных данных для модуля реконструкции, а соответствующие оригинальные изображения служили эталонами для оценки эффективности и качества реконструкции. Такая стратегия позволила модели изучить восстановление недостающих структур мотивов при сохранении семантической согласованности и культурных особенностей.
Пусть X будет областью неполных культурных паттернов, а Y — областью реконструированных культурных паттернов. Два генератора обучаются выполнять двунаправленное отображение с использованием Уравнения 15:
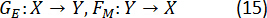
Здесь GE используется для реконструкции структур мотивов, а FM — для отображения паттернов обратно на исходный домен. Состязательная функция потерь используется для того, чтобы реконструированные паттерны были реалистичными (Уравнение 16)30
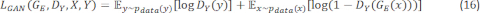
Здесь DY — это дискриминатор, используемый для разграничения реальных и реконструированных паттернов, а GE(x) обозначает сгенерированный реконструированный паттерн. CycleGAN также обеспечивает циклическую согласованность для сохранения структурного расположения культурных мотивов (Уравнение 17)30.
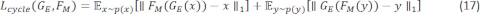
Итоговая функция потерь определяется с помощью Уравнение 1830:
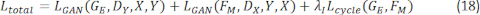
Здесь λi обозначает весовой коэффициент функции потерь циклической согласованности (cycle-consistency loss); в ходе обучения он был установлен на уровне 10, что соответствует оригинальной формулировке CycleGAN. Данное значение было выбрано для обеспечения баланса между состязательным обучением и согласованностью реконструкции между исходным и целевым доменами.
Модуль реконструкции CycleGAN состоит из двух генераторов и двух дискриминаторов для двунаправленного преобразования изображений. Каждый генератор построен на архитектуре остаточной сети (residual network), включающей начальный сверточный слой 7 × 7, за которым следуют два сверточных слоя понижения размерности (downsampling), девять остаточных блоков и два слоя повышения размерности (upsampling). Во всех операциях свертки используется размер ядра 3 × 3, за исключением входного слоя, где для улучшенного извлечения признаков применяется ядро 7 × 7. После каждого сверточного слоя применяется нормализация экземпляров (Instance Normalization) для повышения стабильности обучения, а во всей сети генератора используется функция активации ReLU. В выходном слое применяется функция активации Tanh для генерации нормализованных выходных изображений. Дискриминатор построен на архитектуре PatchGAN 70 × 70, состоящей из серии сверточных слоев с размером ядра 4 × 4 и прогрессивно увеличивающимся количеством каналов признаков. В дискриминаторе используются нормализация экземпляров и активация LeakyReLU (отрицательный наклон = 0.2) для улучшения дискриминации признаков и состязательного обучения. Модуль CycleGAN получает на вход предварительно обработанные изображения культурных мотивов и генерирует реконструированные представления паттернов, которые затем передаются в CAFFM для интеграции с признаками сегментации. Обучение CycleGAN проводилось с использованием оптимизатора Adam (β₁ = 0.5, β₂ = 0.999) с начальной скоростью обучения 0.0002. Скорость обучения поддерживалась постоянной в течение первых 100 эпох, после чего линейно снижалась до нуля на протяжении оставшегося периода обучения. Для стабилизации обучения дискриминатора использовался буфер воспроизведения (replay buffer), содержащий 50 ранее сгенерированных изображений. Обновление генераторов и дискриминаторов происходило с соотношением 1:1, при этом в каждой итерации обучения за одним обновлением генератора следовало одно обновление дискриминатора.
Процесс реконструкции в CycleGAN основан на улучшенных картах признаков, полученных с помощью механизма CAFFM, представленного на Рисунке 5. Карты признаков содержат усиленные культурные мотивы, полученные на предыдущих этапах сегментации и CAFFM. Эти карты признаков используются в качестве входных данных для первого генератора GE. Первый генератор GE изучает отображение, необходимое для реконструкции культурных паттернов. Затем выходные данные подаются на дискриминатор DY для разграничения реальных культурных паттернов и реконструированных. Дискриминатор DY помогает генератору GE создавать реалистичные результаты. Чтобы культурные паттерны не искажались в процессе реконструкции, второй генератор FM выполняет циклическое согласованное отображение (cycle-consistency mapping). Второй генератор FM отображает выходные данные обратно в исходную область. Затем результаты оцениваются дискриминатором для проверки их реалистичности. Итоговые выходные данные впоследствии передаются в модуль SPADE для генерации художественного стиля на следующем этапе предлагаемой структуры SegCycle-SPADE.
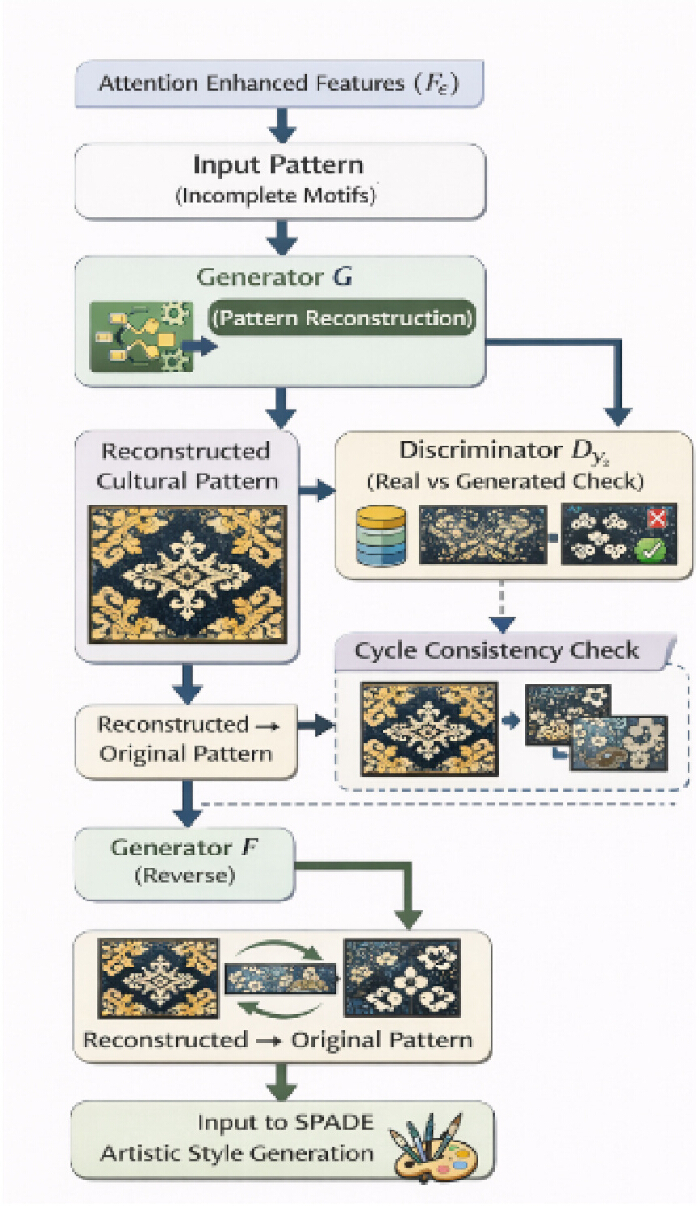
Рисунок 5. Схема реконструкции узоров на базе CycleGAN. Рабочий процесс модуля реконструкции CycleGAN. В качестве входных данных в сеть генератора подаются представления признаков с усиленным вниманием для реконструкции неполных культурных мотивов. Дискриминатор оценивает реконструированные результаты по отношению к эталонным узорам, в то время как отображение с циклической согласованностью сохраняет структурную целостность при двунаправленном преобразовании изображений. Реконструированные мотивы затем направляются в модуль SPADE для синтеза художественного стиля. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Генерация художественного стиля с использованием SPADE
Впоследствии реконструированные культурные мотивы подвергаются обработке модулем SPADE для генерации художественного стиля. Основная цель модуля SPADE заключается в добавлении более визуально насыщенных текстур художественного стиля к реконструированным культурным мотивам без ущерба для их структурного расположения. Модуль SPADE представляет собой метод условной генерации изображений, использующий концепцию сегментации изображений для создания новых изображений. Многоканальные семантические карты, соответствующие заранее определенным классам мотивов, были закодированы на основе масок семантической сегментации, полученных с помощью SegFormer-B2. Генератор SPADE получал эти закодированные карты в качестве условий. Параметры пространственно-адаптивного масштабирования (γ) и смещения (β) формировались путем обработки семантических карт через сверточные слои внутри каждого слоя SPADE. Таким образом, генератор мог сохранять границы мотивов, структурное расположение и семантическую информацию в процессе художественного синтеза, применяя эти параметры к нормализованным активациям признаков. Семантическое руководство могло влиять как на высокоуровневую структурную реконструкцию, так и на низкоуровневый синтез текстур, поскольку процесс кондиционирования осуществлялся на нескольких слоях генератора SPADE. В результате созданные художественные паттерны объединили в себе стилистические черты, полученные из набора данных WikiArt, при сохранении структур культурных мотивов, выявленных на этапе сегментации.
Набор данных WikiArt, включающий работы из 27 различных художественных категорий, таких как Ренессанс, импрессионизм, кубизм, экспрессионизм, сюрреализм, реализм и абстрактное искусство, использовался в качестве основного ресурса для анализа художественных стилей. Для ознакомления модели с разнообразными творческими особенностями и улучшения обобщения стиля в процессе обучения изображения стилей выбирались случайным образом из различных категорий. Чтобы уменьшить смещение в сторону определенных стилей, набор данных был разделен на обучающую, валидационную и тестовую подвыборки с сбалансированным представлением художественных категорий. Для обеспечения равного представительства всех 27 художественных категорий использовался стратифицированный отбор. Образцы из каждой категории пропорционально распределялись по обучающей, валидационной и тестовой подвыборкам с сохранением исходного распределения классов. Модуль CAFFM применялся для объединения стилистических аспектов, извлеченных из изображений WikiArt, с признаками реконструкции, созданными CycleGAN. Чтобы сеть синтеза могла переносить художественные качества, сохраняя при этом семантическую структуру и границы культурных мотивов, полученные из карт сегментации, итоговые объединенные представления подавались в качестве обуславливающей информации в генератор SPADE. Благодаря этому методу обуславливания стиля предложенная архитектура смогла создавать культурно аутентичные художественные паттерны с согласованными структурными и стилистическими представлениями.
SPADE также вводит пространственно-адаптивные параметры, которые зависят от карты сегментации. Параметры могут быть определены следующим образом, как показано в Уравнении 191:
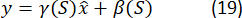
Здесь γ(S) представляет собой пространственно-изменяющийся параметр масштаба, а β(S) — пространственно-изменяющийся параметр смещения. Эти параметры помогают генератору создавать различные текстуры и стили в зависимости от семантической области на изображениях. Итоговое произведение культурного искусства может быть определено следующим образом, как показано в Уравнении 20:
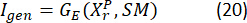
Здесь GE — генератор SPADE, XrP — реконструированный паттерн, а SM — карта сегментации. Конечная работа сохраняет структурную целостность культурных мотивов, одновременно улучшая художественный вид. Для оптимизации предлагаемой архитектуры SegCycle-SPADE была использована комбинированная функция потерь, которая балансирует точность семантической сегментации, сохранение культурных мотивов, качество реконструкции паттерна и согласованность художественного стиля. Общая цель обучения была установлена с помощью взвешенной смеси потерь сегментации (Lseg), состязательных потерь (Ladv), потерь циклической согласованности (Lcycle), потерь реконструкции (Lrecon), потерь сохранения мотивов (Lmotif) и потерь согласованности стиля (Lstyle). Общая функция потерь определена в уравнении 21:
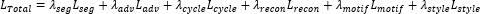 (21)
Для обеспечения структурного соответствия между входными и реконструированными культурными мотивами коэффициент функции потерь циклической согласованности был установлен на уровне 10. Для сохранения детализированных признаков мотивов и повышения визуальной точности коэффициент потерь при реконструкции был установлен на уровне 5. Чтобы подчеркнуть сохранение культурно значимых структурных паттернов в процессе художественного синтеза, для функции потерь сохранения мотивов был использован коэффициент 2. В целях содействия переносу художественного стиля без чрезмерного искажения семантических структур мотивов коэффициент потерь согласованности стиля был скорректирован до 1. Для поддержания сбалансированного вклада между созданием реалистичного изображения и точной сегментацией мотивов функциям потерь при сегментации и состязательным потерям были присвоены равные веса. Для расчета потерь согласованности стиля использовались стилевые представления на основе признаков из набора данных WikiArt. В частности, характеристики художественного стиля фиксировались с помощью корреляций матриц Грама, полученных из карт глубоких признаков. Разность норм Фробениуса между матрицами Грама целевого стилевого изображения и сгенерированного изображения использовалась для расчета потерь стиля, как показано в уравнении 22:
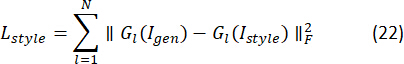
Здесь, Gл вычисляется ли матрица Грама на основе лth слой объектов, Iген обозначает сгенерированное художественное изображение, Iстиль обозначает целевое изображение стиля из набора данных WikiArt, и F обозначает норму Фробениуса. Такая формулировка позволяет предложенной архитектуре сохранять художественные особенности, поддерживая при этом структурную и семантическую целостность культурных мотивов.
Объединенные представления признаков, полученные модулем CAFFM, используются в качестве обусловливающих входных данных для модуля SPADE, который выполняет функцию компонента художественного синтеза в предлагаемой архитектуре. Генератор SPADE состоит из семи остаточных блоков SPADE с размерностью латентных признаков 256 каналов и генерирует выходные изображения с разрешением 256 × 256 пикселей. Карты семантической сегментации, полученные с помощью модуля SegFormer–CAFFM, используются в качестве обусловливающих входных данных на всех остаточных слоях SPADE. Слои SPADE применяются перед функциями активации внутри каждого остаточного блока, что обеспечивает семантическое обусловливание под управлением сегментации. Посредством последовательных операций повышения дискретизации (апсэмплинга) и свертки латентное представление признаков постепенно уточняется для создания художественных паттернов высокого разрешения при сохранении семантической согласованности и структуры мотивов. В генераторе повсеместно используются функции активации LeakyReLU, а на выходном слое применяется функция активации Tanh для получения нормализованных изображений.
Алгоритм и рабочий процесс
Фреймворк SegCycle-SPADE интегрирует семантическую сегментацию, слияние признаков, реконструкцию паттернов и синтез художественного стиля в рамках единого конвейера обучения. Рабочий процесс начинается со сбора и предобработки набора данных, включая изменение размера изображений, нормализацию, шумоподавление и подготовку масок сегментации. Предобработанные изображения затем обрабатываются с помощью сети сегментации SegFormer-B2 для извлечения семантических представлений мотивов. Полученные признаки сегментации объединяются с признаками реконструкции через CAFFM, что обеспечивает взаимодействие между структурной информацией о мотивах и представлениями художественных признаков. Объединенные карты признаков затем подаются в модуль реконструкции CycleGAN, который восстанавливает неполные структуры культурных мотивов, сохраняя при этом семантическую согласованность. Реконструированные паттерны впоследствии передаются генератору SPADE для направленного сегментацией художественного синтеза, что позволяет улучшить стилистику при сохранении границ мотивов и структурной аутентичности. В процессе обучения параметры модели оптимизируются с помощью комбинированной функции потерь, описанной в уравнениях 21 и 22, которая балансирует точность сегментации, сохранность мотивов, качество реконструкции и согласованность художественного стиля. Подробный пошаговый процесс реализации, включая загрузку набора данных, предобработку, инициализацию модели, итерации обучения, процедуры валидации, выбор контрольных точек и окончательную оценку, представлен в дополнительном файле 1 (Алгоритм 1). Полный алгоритмический процесс был реализован с размером пакета 16, скоростью обучения 0.0002 и 100 эпохами обучения. Для разделения набора данных, инициализации модели и всех экспериментов по обучению использовалось фиксированное случайное число (seed) 42. Это число последовательно применялось в генераторах случайных чисел Python, NumPy и PyTorch для обеспечения воспроизводимости. Оптимизатор Adam был настроен с параметрами β₁ = 0.5, β₂ = 0.999 и без затухания весов (weight decay = 0). Контрольные точки модели выбирались на основе самого высокого показателя IoU, достигнутого на валидационном наборе данных.
Оптимизация функции потерь
Для сохранения структур культурных мотивов в процессе реконструкции и художественного синтеза в предлагаемой архитектуре используется комбинированная цель оптимизации, объединяющая потери сегментации, состязательные потери, потери циклической согласованности, потери реконструкции, потери сохранения мотивов и потери согласованности стиля. Полная математическая формулировка, весовые коэффициенты и определение потерь стиля приведены в Уравнениях 21 и 22 в подразделе Artistic Style Generation using SPADE. Компонент сохранения мотивов штрафует структурные отклонения между предсказанными областями мотивов и соответствующими масками сегментации эталонных данных, тем самым способствуя сохранению культурно значимых структур паттернов на протяжении всего процесса реконструкции.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Результаты
Предложенная архитектура SegCycle-SPADE была оценена с использованием двух наборов данных: набора данных культурных мотивов Мяо Батик (Miao Batik) и набора данных WikiArt. Набор данных Мяо Батик содержит изображения традиционного культурного наследия и использовался преимущественно для задач семантической сегментации и структурной реконструкции, в то время как набор данных WikiArt содержит различные художественные стили и использовался для изучения и генерации художественного стиля. Изображения из обоих наборов данных бы...
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Обсуждение
Сохранение и цифровая реконструкция узоров нематериального культурного наследия (НКН) в последние годы привлекают все больше внимания в связи с постепенным исчезновением традиционных ремесел. В предыдущих исследованиях предпринимались попытки решить проблему утраты культурного наследия с помощью методов обработки изображений на базе глубокого обучения (DL). Например, Quan и др.32 предложили систему сохранения культурного наследия для культуры батика народа мяо в провинции Гуйчжоу, основанную на гр...
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Раскрытие информации
Конфликт интересов:
Авторы заявляют об отсутствии конфликтов интересов.
Благодарности
Авторы выражают благодарность за академическую и институциональную поддержку, оказанную Гуандунским инженерным политехническим институтом и Южно-Китайским нормальным университетом в ходе проведения данного исследования. Данная работа была поддержана общим проектом Национального фонда социальных наук на 2023 год (№ 23BH161) под названием «Музей цифровой регенерации: исследование по активизации и популяризации культурных реликвий классической китайской каллиграфии и живописи».
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Материалы
| Имя | Компания | Каталожный номер | Комментарии |
|---|---|---|---|
| Оптимизатор Adam | Библиотека оптимизаторов PyTorch | Adam | Алгоритм оптимизации, используемый при обучении модели. |
| CUDA Toolkit | NVIDIA Corporation | CUDA 11.3 | GPU-ускорение для вычислений глубокого обучения. |
| cuDNN | NVIDIA Corporation | cuDNN 8.2 | Библиотека ускорения глубоких нейронных сетей, используемая для ускорения обучения и инференса. |
| CycleGAN | Калифорнийский университет в Беркли / Open Source | Официальная реализация на PyTorch (https://github.com/junyanz/pytorch-CycleGAN-and-pix2pix) | Генеративно-состязательная сеть, используемая для реконструкции культурных мотивов. |
| Предобученные веса ImageNet | ImageNet / Open Source | mit_b2.pth (предобученный чекпоинт ImageNet-1K) | Используются для инициализации основы SegFormer-B2 перед тонкой настройкой на наборе данных Miao Batik. |
| Процессор Intel | Intel Corporation | Intel Core i7 (11-е поколение) | ЦП, используемый для предобработки изображений, поддержки обучения модели и инференса. |
| Matplotlib | Команда разработки Matplotlib | Matplotlib 3.5.1 | Визуализация кривых обучения и результатов оценки. |
| Набор данных Miao Batik | Репозиторий Zenodo | DOI: 10.5281/zenodo.20807658 | Набор данных культурных мотивов, содержащий 15 148 изображений, используемых для семантической сегментации и реконструкции паттернов. |
| NumPy | Разработчики NumPy | NumPy 1.21.5 | Численные вычисления и обработка наборов данных. |
| GPU NVIDIA | NVIDIA Corporation | NVIDIA RTX 3090 (24 GB VRAM) | Аппаратная платформа, используемая для обучения модели и инференса. |
| OpenCV | OpenCV Foundation | OpenCV 4.5.5 | Предобработка изображений, изменение размера, интерполяция и гауссово шумоподавление. |
| Операционная система | Canonical Ltd. | Ubuntu 20.04 LTS | Среда выполнения экспериментов. |
| Pillow (PIL) | Python Imaging Library | Pillow 8.4.0 | Загрузка и манипулирование изображениями. |
| Python | Python Software Foundation | Python 3.8.10 | Язык программирования, используемый для реализации и проведения экспериментов. |
| PyTorch | Meta AI | PyTorch 1.10.0 | Фреймворк глубокого обучения, используемый для обучения модели и инференса. |
| Случайное число (Seed) | Настройка эксперимента | 42 | Фиксированное значение, используемое для разделения набора данных, инициализации модели и воспроизводимости экспериментов. |
| Scikit-learn | Разработчики Scikit-learn | Scikit-learn 1.0.2 | Разделение набора данных, статистический анализ и метрики оценки. |
| Seaborn | Сообщество Open Source | Seaborn 0.11.2 | Статистическая визуализация данных. |
| SegFormer-B2 | NVIDIA Research / Open Source | SegFormer-B2 (основа MIT-B2) | Модель семантической сегментации на базе Transformer, используемая для сегментации культурных мотивов. |
| Маски сегментации / аннотации | Набор данных Miao Batik | Включены в набор данных | Метки семантической сегментации на уровне пикселей, используемые для классификации мотивов и обучения. |
| SPADE | NVIDIA Research / Open Source | Официальная реализация на PyTorch (https://github.com/NVlabs/SPADE) | Модель синтеза изображений с управлением сегментацией, используемая для генерации художественных паттернов. |
| TorchVision | Meta AI | TorchVision 0.11.1 | Средства обработки изображений и преобразования наборов данных, используемые с PyTorch. |
| Набор данных WikiArt | WikiArt | https://www.wikiart.org/ | Набор данных художественных стилей, содержащий более 80 000 произведений искусства в 27 художественных стилях, используемый для изучения и синтеза стилей. |
Ссылки
- Huang B, Mo L. SegCycle-SPADE: An end-to-end framework for semantic segmentation-based automated extraction and artistic reconstruction of traditional craft patterns using conditional GAN. PLoS ONE. 2025;20:e0329100.
- Yan Z, et al. Digital sustainability of heritage: Exploring indicators affecting the effectiveness of digital dissemination of intangible cultural heritage through qualitative interviews. Sustainability. 2025;17:1593.
- Yan Z, et al. Construction of digital dissemination effects evaluation indicator system of traditional techniques of intangible cultural heritage. npj Heritage Science. 2025;13:224.
- Imon SS. Intangible cultural heritage as a tourism product in the historic city of Macao. In: Sustainable Management of Historic Settlements in Asia: Role of Intangible Cultural Heritage. Springer Nature Singapore; Singapore. 2025. p.233-240.
- Buragohain D, et al. Digitalizing cultural heritage through metaverse applications: Challenges, opportunities, and strategies. Heritage Science. 2024;12:295.
- Ma Y. The ghostly ethics of mediatized shaping: Cultural memory creative transformation of Anhui’s ICH in reviving the craftsmanship. Journal of Current Social Issues Studies. 2025;2:240-249.
- Wanju T, Wang Z, Tu Y. ICH and e-commerce: Bridging tradition and modernity in cultural creative products. Journal of Economics, Management and Trade. 2025;31:1-8.
- Sun L, et al. Research on the redesign of China’s intangible cultural heritage based on sustainable livelihood—The case of Luanzhou shadow play empowering rural development. Sustainability. 2024;16:4555.
- Pan S, et al. Constructing a sustainable evaluation framework for AIGC technology in Yixing Zisha pottery: Balancing heritage preservation and innovation. Sustainability. 2025;17:910.
- Na Z, Sharul Azim SR. Research on innovative development of Miao embroidery intangible cultural heritage in Guizhou, China based on digital design. Journal of Business and Economic Review. 2024;9:85-94.
- Guo S, Canessa A. Ethnic elder poverty: Miao household livelihoods and elderly self-sufficiency practices in Midwest China. Culture, Agriculture, Food and Environment. 2023;45:55-68.
- Han D, Cong L. Miao traditional patterns: The origins and design transformation. Visual Studies. 2023;38:425-432.
- Dong B, et al. Spatial distribution and tourism competition of intangible cultural heritage: Take Guizhou, China as an example. Heritage Science. 2023;11:64-80.
- Chen Z, Ren X, Zhang Z. Cultural heritage as rural economic development: Batik production amongst China’s Miao population. Journal of Rural Studies. 2021;81:182-193.
- Zhennan LY, Yahaya SR. An aesthetic study on traditional batik design of Miao ethnicity in China. Kupas Seni. 2021;9:12-25.
- Fu X, Razmjooy N. Preserving and enhancing cultural heritage through art design using feature pyramid network optimized by modified builder optimization algorithm. Scientific Reports. 2025;15:42603.
- Liu X, Wan J, Wang N. Ancient painting inpainting with regional attention-style transfer and global context perception. Applied Sciences. 2024;14:8777.
- Xu Q, Iwasaki M. Image restoration model of wood-structured raw lacquer cultural relics based on diffusion generation network. Journal of Asian Architecture and Building Engineering. 2025:1-19.
- Cherian A, Sullivan A. Sem-GAN: Semantically-consistent image-to-image translation [conference presentation]. Presented at: IEEE Winter Conference on Applications of Computer Vision (WACV); 2019. doi: 10.1109/WACV.2019.00196.
- Rombach R, et al. High-resolution image synthesis with latent diffusion models [conference presentation]. Presented at: IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR); 2022. p.10684-10695. Available from: http://openaccess.thecvf.com/content/CVPR2022/papers/Rombach_High-Resolution_Image_Synthesis_With_Latent_Diffusion_Models_CVPR_2022_paper.pdf.
- Gendy GGH, Nabil S. Diffusion models for image super-resolution: State-of-the-art and future directions. Neurocomputing. 2025;617:128911.
- Kazerouni A, et al. Diffusion models in medical imaging: A comprehensive survey. Medical Image Analysis. 2023;88:102846.
- Yang L, et al. Diffusion models: A comprehensive survey of methods and applications. ACM Computing Surveys. 2023;56:1-39.
- Croitoru FA, Hondru V, Ionescu RT, Shah M. Diffusion models in vision: A survey. IEEE Transactions on Pattern Analysis and Machine Intelligence. 2023;45:10850-10869.
- Cao H, et al. A survey on generative diffusion models. IEEE Transactions on Knowledge and Data Engineering. 2024;36:2814-2830.
- Po R, et al. State of the art on diffusion models for visual computing. Computer Graphics Forum. 2024;43:e15063.
- Thampanichwat C, et al. Mindful architecture from text-to-image AI perspectives: A case study of DALL-E, Midjourney, and Stable Diffusion. Buildings. 2025;15:972.
- Li W. Enhanced automated art curation using supervised modified CNN for art style classification. Scientific Reports. 2025;15:7319.
- Chen C. Algorithm and tool development for creative generation of graphic design of folk houses and ancient buildings integrating cultural and creative elements. Scalable Computing: Practice and Experience. 2024;25:4729-4736.
- Liu B, Ji J, Gu L, Jiang Z. An integrated CycleGAN-diffusion approach for realistic image generation [conference presentation]. Presented at: International Conference on Signal Processing and Machine Learning; 2024. p.92-101. doi: 10.1117/12.3027121.
- Bao Q, Zhao J, Liu Z, Liang N. AI-assisted inheritance of Qinghua porcelain cultural genes and sustainable design using low-rank adaptation and stable diffusion. Electronics. 2025;14:725.
- Quan H, et al. Protection of Guizhou Miao batik culture based on knowledge graph and deep learning. Heritage Science. 2024;12:1-22.
- Sun H, et al. HRPGAN: A GAN-based model to generate high-resolution remote sensing images. IOP Conference Series: Earth and Environmental Science. 2020;428:012060.
- Ho J, Jain A, Abbeel P. Denoising diffusion probabilistic models [conference presentation]. Presented at: Advances in Neural Information Processing Systems (NeurIPS); 2020. Available from: https://proceedings.neurips.cc/paper/2020/file/4c5bcfec8584af0d967f1ab10179ca4b-Paper.pdf.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.