В данном исследовании изучаются процессы принятия решений и редактирования у студентов специальности «английский язык» при переводе повествовательных текстов о Китае; для выявления влияния текстовой значимости на когнитивные усилия и качество перевода интегрируются данные регистрации нажатий клавиш и корпус danmu.
Исследовательская статья
Процессы принятия решений и особенности редактирования при переводе с китайского языка на английский: данные исследования студентов специальностей «английский язык», переводящих нарративы о Китае
В этой статье
Краткое содержание
Аннотация
По мере того как нарративы, ориентированные на Китай, всё чаще проникают в международный оборот, перевод с китайского на английский язык становится пространством согласования смыслов, а не простым лингвистическим переносом. Для студентов-переводчиков основная трудность выходит за рамки лексического выбора; она заключается в определении того, как передать культурно насыщенные отсылки, оценочные позиции и нарративное позиционирование для читателей, находящихся вне исходного контекста. В данном исследовании изучаются процессы принятия решений в реальном времени и поведение при редактировании у 72 студентов, специализирующихся на английском языке, при переводе нарративов о Китае. Используя дизайн «процесс-продукт», исследование объединяет данные регистрации нажатий клавиш, собранные с помощью Translog-II, оценки результатов перевода и вспомогательный корпус danmu (синхронизированных по времени комментариев), рассматриваемый как слой значимости для аудитории, а не как прямой показатель лингвистической сложности сегмента. Процессы перевода анализировались по длительности пауз, частоте правок, месту внесения исправлений и распределению по этапам, в то время как качество готового продукта оценивалось с помощью экспертных рейтингов и целевого кодирования сегментов, связанных с культурой. Корпус из 18 642 комментариев danmu из 24 видео на Bilibili был использован для выявления общественно значимых нарративных тем и культурно чувствительных выражений. Результаты показывают, что культурно насыщенные и оценочно плотные сегменты вызывали более длительные паузы, увеличение числа рекурсивных правок и более интенсивные переформулировки в процессе работы. Более высокое качество перевода было связано с селективными, стратегически выверенными по времени правками на уровнях дискурса и культурной адаптации, а не с общим количеством исправлений. Пересечение между нарративными триггерами, значимыми в danmu, и сегментами перевода, потребовавшими больших усилий, интерпретируется как конвергентное доказательство значимости для аудитории и когнитивной нагрузки на переводчика, а не как доказательство причинно-следственной связи. Данное исследование развивает изучение процесса перевода, связывая поведение при редактировании с переводом культурно обусловленных нарративов, и предлагает рекомендации по подготовке переводчиков в области межкультурной коммуникации.
Введение
В последние годы перевод дискурса, связанного с Китаем, перестал быть узкоспециализированной задачей и стал центральным вопросом международной коммуникации1. В таком переводе речь идет не просто о передаче пропозиционального содержания, но о переформулировании публичных нарративов, которые несут в себе политическое позиционирование, культурное фреймирование и расчет на определенную аудиторию. Работы по переводу китайского политического дискурса делают этот тезис все более очевидным: при переводе текстов для читателей за пределами Китая выбор формулировок, модальности и текстовых акцентов становится выбором того, как Китай будет представлен и интерпретирован за рубежом2. Если рассматривать проблему в таком ключе, подход, ориентированный только на конечный продукт, становится недостаточным. Готовый перевод может показать, что было выбрано, но он не может продемонстрировать, в какой момент возникли сомнения, где начался процесс переформулирования и как тестировались и отбраковывались конкурирующие варианты3.
Эти ограничения помогают объяснить, почему эмпирические исследования процесса перевода стали важным направлением в переводоведении; в них используются инструменты отслеживания процесса для фиксации пауз, удалений, вставок и временной структуры принятия решений, вместо того чтобы делать косвенные выводы на основе итогового текста4. Это не вытесняет продуктивные, социологические, культурные или корпусные подходы, а скорее дополняет их данными о пошаговом формировании переводческих решений. Современные работы перешли от описания изолированных пауз к моделированию перевода как временно структурированной деятельности. Например, таксономия «колебание — ориентация — поток» рассматривает поведение переводчика как закономерное чередование неопределенности, поиска и беглого воспроизведения, объясняя, почему определенные участки задания становятся нестабильными и вызывают переформулирование5. Этот сдвиг особенно актуален для студенческого перевода, где владение языком, знание предмета и стратегический контроль все еще развиваются параллельно6.
Данные комбинированного айтрекинга и регистрации нажатий клавиш показывают, что начинающие переводчики распределяют внимание неравномерно и что процесс создания перевода часто становится основным источником когнитивной нагрузки при переводе с китайского языка на английский.7Следовательно, то, что кажется локальной проблемой формулировок в конечном продукте, на самом деле может отражать более масштабную реорганизацию внимания и усилий в процессе работы в режиме реального времени.8Последние данные также свидетельствуют о том, что тексты, созданные студентами-переводчиками, могут иметь схожую внешнюю приемлемость, при этом существенно различаясь по объему затраченных усилий, степени неуверенности и интенсивности самоконтроля. Удовлетворительный итоговый вариант перевода все еще может быть результатом нестабильного или неэффективного процесса принятия решений, который можно зафиксировать только с помощью методов, чувствительных к особенностям когнитивного процесса.9Кроме того, сравнительные исследования показывают, что экспертные навыки перевода включают стабильный метакогнитивный контроль над тем, когда следует сделать паузу, обратиться к поиску информации, продолжить составление черновика или вернуться к тексту для внесения правок.10.
Редактирование является тем самым моментом, когда этот скрытый когнитивный процесс становится наиболее заметным. Именно на этом этапе переводчики возвращаются к предыдущим формулировкам, пробуют альтернативные варианты и определяют, носит ли проблема лексический, синтаксический, дискурсивный или культурный характер. Следовательно, редактирование следует рассматривать не как заключительный этап полировки текста, а как ключевой показатель развития переводчика. Более качественные результаты связаны с тем, как альтернативы объединяются в процессе работы, что доказывает: эффективное редактирование является селективным, стратегически выверенным по времени и продиктованным общими требованиями к тексту, а не простым накоплением правок11,12,13.
Сложность процесса принятия решений и редактирования возрастает, когда исходный текст представляет собой повествование, сосредоточенное на Китае, а не нейтральный информационный отрывок. Такие тексты часто опираются на культурно насыщенные допущения, исторически обусловленные выражения и оценочные маркеры, значение которых зависит от общего контекста, а не от явного изложения14,15,16. Степень сложности текста меняет саму детализацию обработки; повествовательные тексты с высокой культурной или оценочной плотностью вынуждают переводчиков работать с более мелкими единицами, выполнять нелинейные операции и прибегать к многократной локальной реструктуризации8. Для студентов-переводчиков основной проблемой становится определение того, в каком объеме следует раскрыть или реорганизовать этот скрытый контекст для читателей, не принадлежащих к исходному дискурсивному сообществу, чтобы при этом не нивелировать культурную специфику.
Данное исследование обусловлено наличием трех специфических пробелов в знаниях. Во-первых, такие метрики процесса перевода, как длительность пауз, частота длинных пауз, прерывания курсора и обращение к словарю, часто изучаются отдельно от типологий ревизии, что затрудняет понимание того, как давление при принятии решений проявляется в последующем переформулировании. Во-вторых, культурно-специфическим категориям повествования уделялось меньше внимания с точки зрения процесса, чем общим академическим или экспозиционным текстам, несмотря на то, что повествования, ориентированные на Китай, часто требуют от переводчиков одновременной работы с культурной нагрузкой, оценочной плотностью и сжатыми фоновыми импликациями14,15,16. В данном исследовании под культурной нагрузкой понимается плотность культурно-обусловленных отсылок и общих пресуппозиций; под оценочной плотностью — явное или неявное выражение позиции, аффективная интенсивность и ценностно-ориентированное фреймирование; а под нарративным сжатием — степень, в которой фоновая информация, причинно-следственные связи или социальное позиционирование конденсированы в коротких текстовых отрезках. В-третьих, задания по переводу обычно разрабатываются исключительно на основе внутритекстового анализа, при этом мало учитывается, совпадают ли сегменты, определенные как сложные, с моментами, привлекающими внимание публики при цифровом распространении. Danmu (синхронизированные по времени видеокомментарии) могут функционировать как паратекст и партисипаторный дискурс, высвечивая то, что аудитория замечает, оспаривает и переосмысливает17,18; однако значимость danmu следует рассматривать как индикатор вовлеченности аудитории на семантическом уровне, а не как прямую замену лингвистической сложности на уровне сегмента.
Для устранения этих пробелов в настоящем исследовании изучается, как студенты, специализирующиеся на английском языке, принимают решения и вносят правки при переводе повествований о Китае с китайского языка на английский. Объединяя данные о процессе перевода и дискурс цифровой аудитории в рамках одного аналитического подхода, исследование стремится объяснить не только то, с какими трудностями сталкиваются студенты-переводчики, но и почему эти сложности концентрируются вокруг определенных типов нарративных значений.
В частности, в данном исследовании рассматриваются четыре исследовательских вопроса: (1) Какие паттерны принятия решений характеризуют перевод текстов о Китае с китайского на английский язык студентами, специализирующимися на английском языке? (2) Как меняется поведение при редактировании в сегментах с различным уровнем культурной нагрузки и нарративной плотности? (3) Какие аспекты поведения при редактировании связаны с более высоким качеством перевода? и (4) Совпадают ли культурно значимые моменты, выявленные в дискурсе danmu, с сегментами, требующими наибольших когнитивных усилий в процессе перевода?
Соответственно, в рамках одной аналитической последовательности в исследовании проверяются четыре взаимосвязанные гипотезы: H1 предполагает, что сегменты с более высокой культурной нагрузкой будут вызывать более длительные паузы, большую неопределенность при принятии решения и более частые правки, чем сегменты с низкой культурной нагрузкой; H2 разграничивает два пути, предсказывая, что оценочная плотность приведет к увеличению количества отложенных правок, в то время как нарративное сжатие увеличит частоту переформулирования на уровне дискурса; H3 предполагает, что качество перевода будет в большей степени объясняться избирательностью и временем внесения правок, чем только общим количеством правок; и H4 предсказывает, что сегменты, заметные в danmu, будут совпадать с сегментами, потребовавшими больших усилий при переводе, что станет проявлением ассоциативной конвергенции между значимостью для аудитории и когнитивной нагрузкой на переводчика.
Протокол
Все методы с участием людей проводились в соответствии с институциональными рекомендациями и были одобрены институциональным наблюдательным советом (IRB) или комитетом по этике исследований с участием людей Университета Ханшань. До начала эксперимента от всех участников было получено информированное согласие.
Концептуальная основа и дизайн исследования
В данном исследовании использовался дизайн исследования «процесс–продукт» с дополнительным дискурсивным уровнем для изучения того, как комментарии danmu, создаваемые аудиторией, влияют на перевод субтитров. Аналитическая база объединяла текстовые характеристики, показатели процесса перевода и результаты качества перевода. В частности, изучалось, направляло ли внимание аудитории, отраженное в плотности danmu, когнитивные ресурсы переводчиков на определенные текстовые особенности и влияло ли это распределение внимания впоследствии на качество перевода.
Для реализации данной концепции в исследовании сначала были определены текстовые признаки на уровне сегмента, основанные на четырех измерениях: культурной нагрузке, оценочной плотности, нарративном сжатии и значимости danmu. Под культурной нагрузкой понималось наличие культурно-специфических отсылок, требующих адаптации или пояснения. Оценочная плотность измеряла концентрацию эмоционально или аттитюдного окрашенной лексики в пределах сегмента. Нарративное сжатие отражало степень конденсации семантического содержания в условиях ограничений субтитров. Значимость danmu представляла собой степень внимания аудитории, направленного на каждый сегмент субтитров, которая количественно определялась объемом синхронизированных комментариев danmu. В отличие от традиционных показателей сложности перевода, значимость danmu отражала социально распределенное внимание, а не внутреннюю текстовую сложность. Сегмент, вызвавший широкий отклик аудитории, не обязательно был более трудным для перевода; напротив, он представлял собой точку повышенной коммуникативной значимости в процессе просмотра.
Аналитическая структура включала три взаимосвязанных набора данных. Набор данных на уровне участников содержал индивидуальные демографические характеристики и сведения об опыте перевода. Набор данных «процесс–продукт» связывал каждый сегмент субтитров с поведенческими показателями, полученными с помощью логгирования нажатий клавиш, а также с экспертными оценками качества перевода. Набор данных danmu содержал синхронизированные комментарии аудитории, соответствующие времени отображения субтитров, на основе которых были вычислены значения значимости danmu. Эти наборы данных были связаны через идентификаторы участников и сегментов, что позволило проводить одновременный анализ каждого переведенного сегмента субтитров в зависимости от характеристик переводчика, особенностей когнитивной обработки, внимания аудитории и результатов перевода. Итоговая интегрированная база данных включала 216 полных сессий перевода и 3 168 наблюдений типа «участник–текст–сегмент», что послужило эмпирической основой для последующего анализа взаимосвязи процесса и продукта.
Скрининг участников и составление профиля общих характеристик
Выборка состояла из 72 студентов специальности «английский язык», набранных в государственном университете на юге Китая и равномерно распределенных по второму, третьему и четвертому курсам бакалавриата (по 24 участника на каждом курсе). Все участники были носителями китайского языка, проходившими формальное обучение английскому письму и переводу. Для обеспечения сопоставимости группы стажеров-переводчиков из исследования были исключены лица, проживавшие в англоязычной стране более 6 месяцев или имевшие профессиональный сертификат переводчика. Участники не разделялись на отдельные экспериментальные группы по опыту перевода, степени знакомства с культурой или уровню владения вторым языком. Вместо этого были зафиксированы курс обучения, последние результаты тестов по уровню владения английским языком, ранее пройденные курсы по переводу, самооценка знакомства с культурными темами, связанными с Китаем, и среднее еженедельное время двуязычной практики; эти данные были включены в статистические модели в качестве ковариат на уровне участников. Данное уточнение также устраняет несоответствие в количестве участников, отмеченное в ходе экспертной оценки: и в рукописи, и в наборе данных для репликации указано 72 участника, 216 сессий выполнения заданий и 3 168 наблюдений на уровне сегментов.
Выбор исходного текста и построение задачи
Материалы для перевода состояли из трех современных повествовательных текстов о Китае, разработанных специально для данного исследования, чтобы отразить подлинный общественный дискурс и избежать использования материалов, защищенных авторским правом. Каждый текст содержал от 205 до 225 китайских иероглифов, но систематически различался по своим внутренним характеристикам. Текст A представляет собой повествование о возвращении домой на Праздник весны с умеренной культурной нагрузкой и относительно простым синтаксисом. Текст B описывает воспоминания о Празднике драконьих лодок и содержит более высокую плотность культурно-специфических выражений и скрытых фоновых знаний. Текст C описывает повествование о сельских прямых трансляциях и электронной коммерции, которое характеризуется насыщенным оценочным языком и сжатым повествовательным позиционированием.
Тексты были систематически разделены с использованием границ предложений, а затем границ смысловых единиц, что позволило выделить 44 единицы анализа по трем задачам перевода (Таблица 1). Перед формальным кодированием в руководстве по кодированию были определены культурная нагрузка, оценочная плотность и нарративное сжатие с использованием порядковых шкал от 1 до 5. Пилотное исследование с участием 12 студентов, не принимавших участия в основном эксперименте, подтвердило заданную калибровку сложности, ясность инструкций к заданиям и стабильность границ сегментов для выравнивания нажатий клавиш.
Построение вспомогательного корпуса и картирование значимости
Для выявления общественно значимых повествовательных маркеров был составлен вспомогательный корпус danmu на основе 24 видео с платформы Bilibili, загруженных в период с января 2023 г. по декабрь 2025 г. Видео включались в выборку только при условии, что они соответствовали одной из трех семантических областей, представленных в исходных текстах, имели более 50 000 просмотров, характеризовались интенсивным взаимодействием в danmu, а также позволяли экспортировать и проводить тематическое картирование синхронизированных по времени комментариев. После удаления дубликатов и фильтрации эмодзи, ономатопоэтических вставок и нерелевантных фрагментов окончательный корпус составил 18 642 комментария.
Контентные слова были стандартизированы и сгруппированы с использованием ключевых слов-якорей, относящихся к исходному тексту. Затем каждому сегменту исходного текста был присвоен непрерывный показатель значимости danmu, основанный на средневзвешенном композите нормализованной частоты кластеров ключевых слов, концентрации комментариев внутри соответствующего тематического кластера и средней интенсивности оценочных суждений. Эта процедура позволяет сравнивать трудозатраты переводчика и значимость для аудитории на уровне семантических кластеров, а не посредством прямого лексического сопоставления. Поскольку danmu отражает реакцию аудитории на онлайн-видео, а не на саму задачу экспериментального перевода, значимость danmu интерпретируется как внешний индикатор вовлеченности аудитории, а не как прямое свидетельство лингвистической сложности сегмента исходного текста.
Экспериментальная процедура и сбор данных
Сеансы перевода проводились индивидуально в контролируемой компьютерной лаборатории в стандартизированных условиях аппаратного и программного обеспечения, а также доступа к интернету (Рисунок 2). После пятиминутного инструктажа, в котором особое внимание уделялось созданию читабельного английского текста для международной аудитории, участники выполняли трехминутную разминку по печати на английском языке для минимизации эффекта привыкания к клавиатуре. Три задания по переводу выполнялись последовательно с использованием Translog-II, при этом порядок заданий был сбалансирован по схеме латинского квадрата для равномерного распределения возможной утомляемости и эффектов последовательности между участниками. На каждый текст участникам отводилось не более 20 минут, с пятиминутными перерывами между ними.
Хотя использование встроенного двуязычного словаря было разрешено, применение систем машинного перевода и внешних поисковых систем было запрещено. Все нажатия клавиш, паузы и перемещения курсора регистрировались автоматически; данные дополнялись синхронными записями экрана для проверки эпизодов нелинейного редактирования. После выполнения каждого задания участники проходили самооценку сложности, результаты которой использовались исключительно для помощи в интерпретации пограничных случаев кодирования.
Измерение показателей процесса и кодирование переменных
Записи нажатий клавиш были сопоставлены с заранее определенной структурой сегментов. Эпизод сопоставления начинался с первого нажатия клавиши на целевом языке, соответствующего сегменту, и заканчивался, когда участник окончательно переходил к следующему сегменту. Перекрывающиеся правки были переназначены с использованием записей отслеживания курсора с временными метками.
Поведение при принятии решений количественно оценивали с помощью пяти показателей: длительности первой паузы перед переводом начального сегмента, средней длительности пауз внутри сегмента, частоты пауз продолжительностью более двух секунд, количества обращений к словарю и количества прерываний с помощью курсора, указывающих на отступление от линейного черновика (Таблица 2). Поведение при редактировании классифицировали по двум параметрам: времени и функции. По времени разграничивали немедленные локальные правки и отложенные правки, внесенные после того, как работа над черновиком продвинулась дальше текущего сегмента. Функциональное кодирование разделяло правки на поверхностные (исправления на уровне формы без изменения смысла), смысловые (лексические или синтаксические модификации), правки на уровне дискурса (корректировка взаимосвязей между предложениями или связности текста) и правки по культурной адаптации (переформулирования, ориентированные на целевую аудиторию). Два обученных кодировщика независимо анализировали каждый эпизод редактирования перед вынесением окончательного решения и присваивали каждому событию одну основную функциональную категорию. Межэкспертная надежность была высокой по всем кодируемым показателям. Коэффициент каппа Коэна (ĸ) указал на значительное согласие при категориальном кодировании функций редактирования (ĸ = 0.84, p < 0.001). Для порядковых переменных текстового уровня коэффициенты внутриклассовой корреляции (ICC, двухфакторная модель со смешанными эффектами, абсолютное согласие) продемонстрировали высокую надежность для культурной нагрузки (ICC = 0.86), оценочной плотности (ICC = 0.78) и нарративного сжатия (ICC = 0.82). Все первоначальные расхождения в кодировании впоследствии устранялись путем совместного согласования.
Оценка качества перевода
Качество перевода оценивалось независимо от данных о процессе двумя экспертами со степенью доктора наук и обширным опытом преподавания перевода. Не имея доступа к именам участников и показателям процесса, эксперты использовали 100-балльную рубрику, равномерно распределенную по пяти критериям: семантическая точность, лингвистическая беглость, связность повествования, культурная адаптация и соответствие регистру (Таблица 3). Расхождения в оценках более чем в восемь баллов становились основанием для совместного анализа и достижения консенсуса при повторном оценивании, при этом итоговым показателем качества перевода служило согласованное среднее значение. Записи оценок до этапа согласования были сохранены для обеспечения прозрачности отчетности о надежности межэкспертной оценки в материалах для репликации.
Статистическое моделирование
Анализ проводился в три последовательных этапа. Сначала были рассчитаны показатели дескриптивной статистики для обобщения всех переменных по группам лет обучения и типам текстов. Во-вторых, трудозатраты на обработку на уровне сегментов были проанализированы с помощью моделей регрессии со смешанными эффектами, чтобы учесть вложенную структуру сегментов в текстах и повторные наблюдения отдельных участников. Зависимые переменные, включая длительность первой паузы и частоту правок, моделировались как функции культурной нагрузки, оценочной плотности, нарративного сжатия и значимости danmu при контроле уровня владения языком участников. Для повышения статистической прозрачности были приведены корреляции предикторов, диагностика инфляции дисперсии, 95% доверительные интервалы, оценки величины эффекта и индексы соответствия модели.
Наконец, было построено моделирование качества перевода для оценки прогностического вклада времени внесения правок и функции правки относительно общей частоты пересмотра. Перекрытие между сегментами, значимыми с точки зрения danmu, и сегментами перевода с высокими трудозатратами оценивалось с использованием верхнего квинтиля каждого распределения, стандартизированного композитного индекса трудозатрат и анализа случайного перекрытия. Эксплораторный факторный анализ или моделирование структурными уравнениями не проводились. Соответственно, прилагаемые рисунки представлены исключительно в виде концептуальных, описательных или основанных на регрессии сводок.
Результаты
Общий профиль сеансов перевода
Все 72 участника выполнили три задания по переводу в стандартизированных экспериментальных условиях, что позволило получить 216 полных сессий перевода. После выравнивания сегментов итоговый аналитический набор данных составил 3 168 наблюдений по схеме «участник-текст-сегмент». Среднее время выполнения задания по всей выборке составило 998,4 s на один текст, при этом наблюдались явные различия между курсами обучения и исходными текстами (Таблица 4; Рисунок 3). Соответственно, и в рукописи, и в сопроводительных данных последовательно указывается размер выборки n = 72 участника; любые графики, обобщающие подгруппы, должны четко идентифицировать эти подгруппы.
Студенты четвертого курса выполняли задания по переводу быстрее и с меньшим количеством перерывов, чем студенты второго курса. Эта разница не ограничивалась только скоростью обработки информации. У группы четвертого курса также наблюдались более короткие средние интервалы до первой паузы, меньшее количество длительных пауз и меньшее общее число правок, при этом они достигли самых высоких показателей качества перевода. Напротив, студенты второго курса совершали наибольшее количество правок, большинство из которых представляли собой поверхностные модификации и немедленные локальные исправления. Опытные студенты продемонстрировали более высокую долю отложенных правок и правок, связанных с культурной адаптацией, что указывает на то, что более высокая эффективность перевода была связана с селективными стратегиями редактирования, а не с большим объемом правок.
Различия между тремя исходными текстами были столь же выраженными. При работе с текстом A наблюдалось самое короткое время выполнения, наименьшее количество длительных пауз и самая низкая плотность правок. Тексты B и C предъявляли более высокие требования к обработке, хотя и за счет разных механизмов. Текст B вызвал наибольшее количество правок, связанных с культурными особенностями, тогда как в тексте C зафиксирована самая высокая частота правок на уровне дискурса и самая большая средняя продолжительность пауз внутри сегмента. Таким образом, причина затруднений при обработке различалась в зависимости от текста. В тексте B сложности были сосредоточены вокруг культурно-специфических отсылок и неявных фоновых предположений, тогда как в тексте C они были в основном связаны с нарративным сжатием и оценочным позиционированием.
Однофакторный дисперсионный анализ подтвердил наличие значимых различий между курсами обучения по общему качеству перевода, F (2, 69) = 31.84, p < 0.001, с большой величиной эффекта (η2 ≈ 0.48 на основе средних баллов участников). Апостериорные сравнения показали, что студенты четвертого курса достигли значительно более высоких результатов, чем студенты третьего курса, которые, в свою очередь, превзошли студентов второго курса. Та же закономерность наблюдалась для длительности первой паузы, частоты длинных пауз и коэффициента отложенного редактирования. В совокупности эти исходные данные позволяют сделать два важных вывода для последующего анализа. Во-первых, три исходных текста различались по сложности обработки, а не просто по тематическому содержанию. Во-вторых, более высокое качество перевода было связано с реорганизацией процессов перевода, а не с простым снижением когнитивных усилий при обработке.
Влияние текстовой выразительности на процесс принятия решений и поведение при редактировании
Чтобы определить, предсказывают ли текстовые свойства на уровне сегмента затраты на обработку, были рассчитаны модели со смешанными эффектами для длительности первой паузы, частоты длинных пауз, общей плотности ревизий и плотности отложенных ревизий. Культурная нагрузка, оценочная плотность, нарративное сжатие и значимость danmu были введены в качестве фиксированных эффектов, а участник и сегмент — в качестве случайных перехватов (Таблица 5; Рисунок 4). Скрининг предикторов подтвердил отсутствие проблемной мультиколлинеарности: все значения фактора инфляции дисперсии (VIF) были значительно ниже консервативного порога 2,5 (максимальный VIF = 1,45). Для оценки соответствия модели и доли объясненной дисперсии для всех моделей со смешанными эффектами были рассчитаны как маргинальные, так и кондициональные значения R2 (маргинальный R2 в диапазоне от 0,08 до 0,19; кондициональный R2 в диапазоне от 0,46 до 0,64). Полные компоненты дисперсии для случайных эффектов (перехваты участника и сегмента) и соответствующие индексы соответствия моделей подробно приведены в Таблице 5. Оценки коэффициентов интерпретируются совместно с их 95% доверительными интервалами, а не только на основании p-значений.
Культурная нагрузка оказала наиболее сильное и согласованное влияние во всех моделях. В модели первой паузы увеличение показателя культурной нагрузки на одну единицу было связано с увеличением длительности первой паузы на 0.91 s (b = 0.91, SE = 0.12, 95% CI [0.67, 1.15], p < 0.001). Культурная нагрузка также значимо увеличивала частоту длинных пауз (b = 0.19, SE = 0.04, 95% CI [0.11, 0.27], p < .001) и общую плотность ревизий (b = 0.27, SE = 0.06, 95% CI [0.15, 0.39], p < .001). Таким образом, сегменты с высокой культурной нагрузкой не только замедляли первоначальную обработку, но и повышали вероятность последующего переформулирования.
Сжатие повествования продемонстрировало столь же выраженный, но иной характер эффектов. Оно стало сильным предиктором ревизии на уровне дискурса (b = 0.31, SE = 0.07, 95% CI [0.17, 0.45], p < .001) и значительно увеличило среднюю продолжительность пауз внутри сегмента (b = 0.58, SE = 0.14, 95% CI [0.31, 0.85], p < .001). С практической точки зрения, сегменты, в которых значительный объем фоновой информации был сжат в короткие текстовые отрезки, с меньшей вероятностью вызывали немедленную лексическую замену и с большей вероятностью требовали более широкого структурного пересмотра.
Оценочная плотность также внесла значительный вклад, хотя ее основной эффект проявился в отложенном пересмотре, а не в латентном периоде принятия первоначального решения. В модели отложенного пересмотра оценочная плотность имела положительный коэффициент (b = 0.23, SE = 0.05, 95% CI [0.13, 0.33], p < .001). Ее влияние на длительность первой паузы было сравнительно скромным (b = 0.34, SE = 0.13, 95% CI [0.09, 0.59], p = 0.010). Эти результаты позволяют предположить, что оценочные признаки не всегда распознавались как «узкие места» в обработке данных при первоначальном переводе. Напротив, они часто становились проблематичными только после создания первого черновика, побуждая переводчиков вернуться к вопросам позиции, тона или повествовательной уместности.
Заметность danmu оставалась значимым предиктором после контроля текстовых внутренних переменных. Она достоверно предсказывала как продолжительность первой паузы (b = 0.36, SE = 0.14, 95% CI [0.09, 0.63], p = 0.011), так и общую плотность ревизий (b = 0.17, SE = 0.06, 95% CI [0.05, 0.29], p = 0.006). Несмотря на то, что величина этого эффекта была меньше, чем у культурной нагрузки и нарративного сжатия, его стабильный вклад указывает на то, что сегменты, привлекающие большее общественное внимание в корпусе danmu, также имеют тенденцию требовать больших когнитивных усилий при обработке во время перевода. Данный результат интерпретируется как конвергентное свидетельство семантической заметности, а не как доказательство того, что частота danmu напрямую вызывает трудности перевода.
Поведение при пересмотре и качество перевода
В последующем анализе изучалось, что лучше объясняет качество перевода: общее количество правок или их временные и функциональные характеристики. Модель качества (Таблица 5) выявила четкую закономерность результатов. Общее количество правок не было значимым предиктором качества перевода (b = 0.04, 95% CI [-0.06, 0.14], p = 0.412), в то время как время внесения правок и функция правок были значимыми предикторами. В частности, доля отложенных правок (b = 1.12, 95% CI [0.39, 1.85], p = 0.003), правки на уровне дискурса (b = 1.76, 95% CI [0.96, 2.56], p < 0.001) и правки по культурной адаптации (b = 2.04, 95% CI [1.14, 2.94], p < 0.001) положительно коррелировали с качеством перевода. Напротив, поверхностные правки продемонстрировали небольшую, но статистически значимую отрицательную связь (b = -0.63, 95% CI [-1.18, -0.08], p = 0.028).
Эти результаты указывают на то, что только количество правок не позволяет отличить продуктивную переработку текста от нестабильного черновика (Рисунок 5). Качественный анализ скриптов перевода подтвердил данную интерпретацию. В переводах с более низкими баллами правки, как правило, группировались вокруг локальных лексических замен и грамматических исправлений, не устраняя при этом более глубокие несоответствия между повествовательными маркерами китайского языка и риторическим оформлением английского языка. В переводах с более высокими баллами отложенные правки часто включали реорганизацию информационной структуры, введение селективной экспликации или корректировку оценочной лексики для повышения доступности текста для международной аудитории. Репрезентативные переведенные комментарии danmu — включая «это выражение очень по-китайски», «нужно объяснить контекст» и «иностранная аудитория может не понять эту отсылку» — иллюстрируют типы культурно значимых опасений относительно аудитории, связанных с соответствующими кластерами сегментов. Эти примеры представлены исключительно для облегчения интерпретации и не должны рассматриваться как свидетельство намерений участников.
Пересечение между значимостью данму и узкими местами трансляции
В ходе заключительного анализа проверялось, совпадают ли общественно значимые сегменты в корпусе danmu с теми, которые требовали наибольших когнитивных усилий при переводе. Для каждого сегмента был рассчитан комбинированный индекс усилий путем стандартизации и суммирования длительности первой паузы, частоты длительных пауз и плотности правок. Затем сегменты, вошедшие в верхние 20% по этому комбинированному индексу усилий, были сопоставлены с 20% сегментов, имеющих наивысший рейтинг значимости в danmu.
Перекрытие было существенным: шесть из девяти сегментов с наибольшими затратами усилий также оказались среди девяти наиболее значимых с точки зрения данму-комментариев сегментов, что соответствует коэффициенту перекрытия 66,7%. Поскольку сравнение верхнего квинтиля охватывало всего девять сегментов, доверительный интервал Уилсона был относительно широким (95% CI примерно 35,4%–87,9%). Тем не менее, анализ точного случайного перекрытия показал, что перекрытие шести или более сегментов было бы маловероятным при случайном распределении (p ≈ .001). На уровне сегментов значимость данму положительно коррелировала с композитным индексом усилий (ρ Спирмена = 0,41, p = 0,006). Большинство перекрывающихся сегментов встречались в текстах B и C и были сосредоточены на культурно обусловленных отсылках, цифровом предпринимательстве и оценочном позиционировании. Эти результаты позволяют предположить, что общественный дискурс служит внешним индикатором того, в каких местах нарративный смысл становится особенно значимым, хотя данная взаимосвязь остается корреляционной, а не причинно-следственной.
В совокупности эти результаты демонстрируют, что когнитивные усилия при переводе повествований, ориентированных на Китай, зависят от конкретного сегмента и определяются прежде всего культурной нагрузкой, сжатием повествования и оценочной плотностью. Качество перевода зависит не от общего объема правок, а от отложенных, чувствительных к дискурсу и культурно ориентированных стратегий ревизии. Наконец, наблюдаемое совпадение сегментов перевода с высокими трудозатратами и значимыми с точки зрения danmu моментами повествования подтверждает ассоциативную связь между значимостью для аудитории и когнитивными усилиями переводчика, не подразумевая при этом, что сама значимость в danmu является причиной трудностей перевода.
ДОСТУПНОСТЬ ДАННЫХ:
Все исходные данные, файлы логов нажатий клавиш, обработанные наблюдения на уровне сегментов, наблюдения на уровне сессий, метаданные видео с danmu и первые 5 000 отображаемых комментариев danmu представлены в рабочей книге набора данных для репликации. Полный файл с комментариями danmu содержит 18 642 комментария и прилагается к пакету данных. Набор данных доступен в репозитории Zenodo по адресу https://doi.org/10.5281/zenodo.19289665.
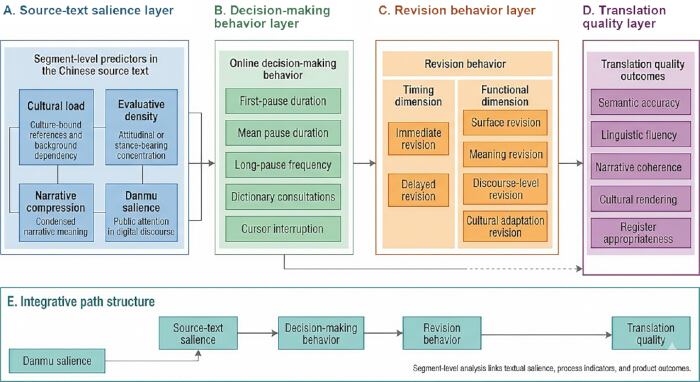
Рисунок 1: Концептуальная основа исследования. (A) Текстуальные предикторы на уровне сегмента, включая культурную нагрузку, оценочную плотность, нарративную компрессию и значимость danmu. (B) Индикаторы процесса, используемые для операционализации поведения при принятии решений в режиме онлайн, включая длительность первой паузы, среднюю длительность паузы, частоту длительных пауз, обращения к словарю и прерывания курсором. (C) Двумерная классификация поведения при правке в зависимости от времени и функции правки. (D) Пять аспектов, используемых для оценки качества перевода: семантическая точность, лингвистическая беглость, нарративная связность, передача культурных особенностей и соответствие регистру. (E) Общая аналитическая схема, показывающая взаимосвязь между значимостью исходного текста, процессом принятия решений, поведением при правке и качеством перевода, где значимость danmu служит внешним индикатором семантической выраженности для аудитории. В данном исследовании эксплораторный факторный анализ (EFA) или моделирование структурными уравнениями (SEM) не проводились и не представлены. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
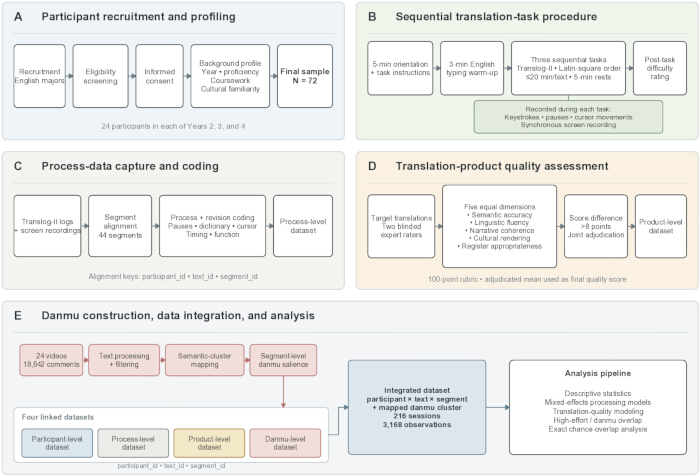
Рисунок 2: Рабочий процесс сбора и сопоставления данных. (A) Набор участников, проверка соответствия критериям включения, получение информированного согласия и сбор фоновой информации. (B) Выполнение трех заданий по переводу в системе Translog-II в стандартизированных экспериментальных условиях. (C) Сбор данных о процессе, включая нажатия клавиш, паузы, перемещения курсора, эпизоды правки и синхронизированные записи экрана. (D) Слепая экспертная оценка результатов перевода с последующим разрешением расхождений в оценках. (E) Создание вспомогательного корпуса danmu и его сопоставление с наборами данных на уровне участников, текстов, сегментов, процесса и продукта для формирования итогового интегрированного набора данных, использованного для статистического анализа. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
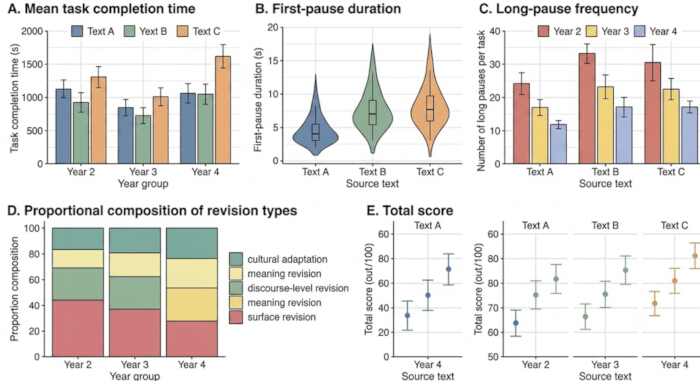
Рисунок 3: Распределение показателей процесса и продукта по учебным годам и исходным текстам. (A) Среднее время выполнения задания в зависимости от исходного текста и учебного года. (B) Распределение длительности первой паузы для трех исходных текстов. (C) Частота длительных пауз в зависимости от исходного текста и учебного года. (D) Пропорциональное распределение категорий правок по учебным годам, включая поверхностные правки, правки смысла, правки на дискурсивном уровне и правки культурной адаптации. (E) Общие баллы качества перевода по учебным годам для каждого исходного текста. В совокупности панели показывают, что более высокие уровни обучения связаны с меньшим количеством перерывов в обработке информации, более избирательными стратегиями правки и более высоким качеством перевода, в то время как тексты B и C предъявляют более высокие требования к обработке, чем текст A. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
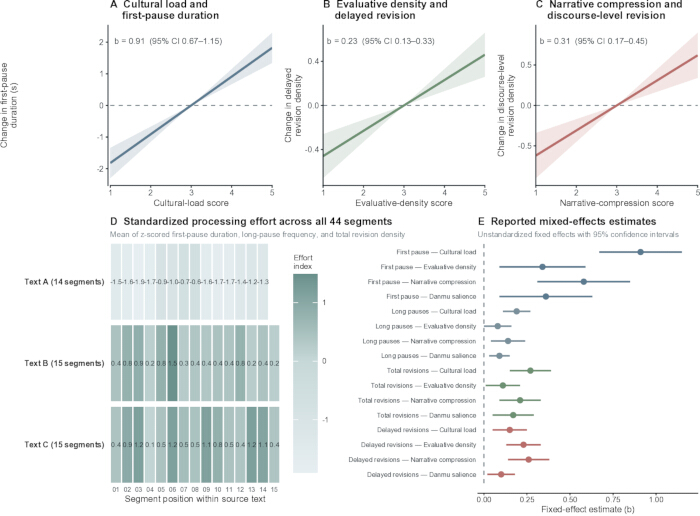
Рисунок 4: Влияние текстовой значимости на уровне сегмента на особенности процесса перевода. (A) Аппроксимированный предельный эффект культурной нагрузки на продолжительность первой паузы. (B) Аппроксимированный предельный эффект оценочной плотности на плотность отложенных ревизий. (C) Аппроксимированный предельный эффект нарративной компрессии на плотность ревизий на уровне дискурса. (D) Тепловая карта стандартизированного индекса когнитивных усилий по всем сегментам исходного текста, сгруппированная по исходным текстам. (E) Стандартизированные коэффициенты фиксированных эффектов, рассчитанные с помощью регрессионных моделей со смешанными эффектами. Рисунок демонстрирует, что различные текстовые характеристики активируют разные пути обработки информации, при этом культурная нагрузка, оценочная плотность и нарративная компрессия способствуют возникновению пауз и ревизий через частично различающиеся механизмы. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
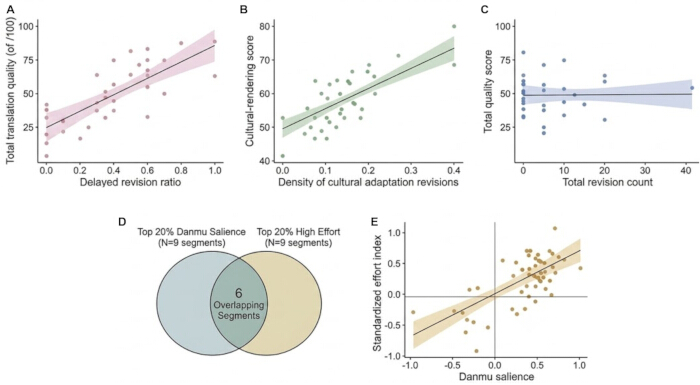
Рисунок 5: Взаимосвязь между процессом перевода, качеством перевода и значимостью danmu. (A) Связь между коэффициентом отложенной редактуры и общим баллом качества перевода. (B) Взаимосвязь между правками по культурной адаптации и баллом за передачу культурного контекста. (C) Связь между общим количеством правок и общим качеством перевода, демонстрирующая ограниченную прогностическую ценность одного лишь объема редактуры. (D) Пересечение 20% наиболее значимых сегментов danmu и 20% сегментов перевода с наибольшими затратами усилий. (E) Связь на уровне сегментов между значимостью danmu и стандартизированным индексом затраченных усилий при обработке. В совокупности панели показывают, что успешный результат перевода связан со стратегически выверенной по времени и функционально направленной редактурой, а не просто с объемом правок, и что общественно значимые повествовательные сегменты также имеют тенденцию совпадать с «узкими местами» перевода. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
| Идентификатор текста | Тема повествования | Китайские иероглифы | Количество сегментов | Балл культурной нагрузки (1–5) | Оценочный балл плотности (1–5) | Балл сжатия повествования (1–5) | Прогнозируемая сложность | Примечание по валидации |
| Текст A | Повествование о возвращении домой на Праздник весны | 212 | 14 | 3 | 2 | 3 | Умеренный | Проведено пилотное тестирование с участием 12 студентов, не являвшихся участниками основного исследования |
| Текст B | Повествование-воспоминание о Празднике драконьих лодок | 219 | 15 | 5 | 3 | 4 | Высокий | Проведено пилотное тестирование с участием 12 студентов, не принимавших участие в основном исследовании |
| Текст C | Сельские прямые трансляции и нарратив развития родного края | 223 | 15 | 4 | 5 | 4 | Высокий | Апробировано на группе из 12 студентов, не принимавших участия в основном исследовании |
Таблица 1: Профиль исходного текста и структура сегментов.
| Переменная | Уровень | Операциональное определение | Единица измерения |
| Длительность первой паузы | Сегмент | Время от начала сегмента до первого соответствующего нажатия клавиши на целевом языке | Секунды |
| Средняя продолжительность паузы внутри сегмента | Сегментация | Средняя продолжительность всех пауз внутри сегмента | Секунды |
| Частота длительных пауз | Сегмент | Количество пауз продолжительностью более 2 секунд | Подсчет |
| Консультации по словарю | Сегмент | Количество активаций окна словаря при обработке сегмента | Подсчет |
| Прерывания курсора | Сегмент | Количество отклонений курсора от линейного черчения до стабильного завершения | Подсчет |
| Немедленный пересмотр | Сегмент | Правка, внесенная до составления черновика, выходит за пределы текущей локальной области текста | Подсчет / плотность |
| Отсроченная ревизия | Сегмент | Внесение правки после того, как работа над черновиком перешла к последующему разделу текста | Подсчет / плотность |
| Ревизия поверхности | Функция пересмотра | Коррекция на уровне формы без семантического сдвига | Подсчет / плотность |
| Пересмотр значения | Функция пересмотра | Лексические или синтаксические изменения, влияющие на выражение значения | Подсчет / плотность |
| Редактирование на уровне дискурса | Функция пересмотра | Корректировка связей между предложениями, когерентности или порядка изложения информации | Подсчет / плотность |
| Пересмотр культурной адаптации | Функция редактирования | Переформулирование или экспликация культурно-специфических смыслов с учетом целевой аудитории | Подсчет / плотность |
| Композитный индекс усилий | Сегмент | Стандартизированный композитный показатель длительности первой паузы, частоты длинных пауз и плотности ревизий | z-показатель |
| Значимость данму | Сегмент / семантический кластер | Взвешенный прокси семантического кластера на основе нормированной частоты ключевых слов в кластере, концентрации комментариев и интенсивности оценок | Непрерывный показатель |
Таблица 2: Операционные определения переменных процесса.
| Размерность | Диапазон значений | Оценка фокуса |
| Семантическая точность | 1-20 | Точность передачи смысла оригинала, прецизионность передаваемого содержания и отсутствие существенных искажений |
| Лингвистическая беглость | 1-20 | Грамматическая правильность, естественность, идиоматичность и читабельность на уровне предложения |
| Связность повествования | 1-20 | Потоки информации, связь между предложениями, прогрессия и текстовая связность |
| Культурная адаптация | 1-20 | Работа с культурно-специфическими ссылками, экспликация, фрейминг и интерпретационная доступность |
| Соответствие регистру | 1-20 | Соответствие целевой аудитории, стилистическая уместность и контроль тона |
Таблица 3: Рубрика оценки качества перевода.
| Раздел | Переменная | 2-й год (n = 24), среднее ± стандартное отклонение | 3-й год (n = 24), среднее ± SD | 4-й год (n = 24), среднее ± SD |
| Профиль сессии на уровне участника | Время выполнения задания (сек) | 1070.84 ± 18.22 | 996.59 ± 20.08 | 927.76 ± 19.91 |
| Профиль сессии на уровне участника | Средняя продолжительность первой паузы (с) | 7.09 ± 0.50 | 6.65 ± 0.40 | 6.38 ± 0.41 |
| Профиль сессии на уровне участника | Частота длительных пауз на одну задачу | 21.04 ± 0.32 | 18.47 ± 0.30 | 16.31 ± 0.19 |
| Профиль сессии на уровне участника | Общее количество правок на одну задачу | 28.65 ± 2.87 | 26.24 ± 2.63 | 24.59 ± 2.42 |
| Конфигурация версии | Коэффициент отсроченной ревизии | 0.45 ± 0.01 | 0.54 ± 0.01 | 0.63 ± 0.01 |
| Конфигурация пересмотра | Коэффициент пересмотра на уровне дискурса | 0.37 ± 0.01 | 0.40 ± 0.01 | 0.45 ± 0.01 |
| Конфигурация пересмотра | Коэффициент пересмотра культурной адаптации | 0.38 ± 0.01 | 0.42 ± 0.00 | 0.48 ± 0.01 |
| Конфигурация ревизии | Коэффициент пересмотра поверхности | 0.04 ± 0.00 | 0.02 ± 0.00 | 0.00 ± 0.00 |
| Качество продукции | Общий показатель качества | 77.82 ± 4.65 | 84.03 ± 4.44 | 88.27 ± 4.56 |
| Качество продукции | Показатель культурной адаптации | 77.73 ± 4.49 | 83.95 ± 4.85 | 88.18 ± 4.86 |
Таблица 4: Описательная статистика переменных процесса и продукта.
| Результативная переменная | Предиктор | b | СЭ | 95% ДИ | т/з | p |
| Длительность первой паузы | Культуральная нагрузка | 0.91 | 0.12 | [0.67, 1.15] | 7.58 | < 0.001 |
| Длительность первой паузы | Оценочная плотность | 0.34 | 0.13 | [0.09, 0.59] | 2.62 | 0.01 |
| Длительность первой паузы | Сжатие повествования | 0.58 | 0.14 | [0.31, 0.85] | 4.14 | < 0.001 |
| Длительность первой паузы | Заметность данму | 0.36 | 0.14 | [0.09, 0.63] | 2.55 | 0.011 |
| Частота длительных пауз | Культурная нагрузка | 0.19 | 0.04 | [0.11, 0.27] | 4.75 | < 0.001 |
| Частота длительных пауз | Оценочная плотность | 0.08 | 0.04 | [0.00, 0.16] | 2 | 0.046 |
| Частота длительных пауз | Сжатие повествования | 0.14 | 0.05 | [0.04, 0.24] | 2.8 | 0.005 |
| Частота длительных пауз | Значимость данму | 0.09 | 0.03 | [0.03, 0.15] | 3 | 0.003 |
| Общая плотность ревизий | Культуральная нагрузка | 0.27 | 0.06 | [0.15, 0.39] | 4.5 | < 0.001 |
| Общая плотность ревизий | Оценочная плотность | 0.11 | 0.05 | [0.01, 0.21] | 2.2 | 0.028 |
| Общая плотность ревизий | Сжатие нарратива | 0.21 | 0.06 | [0.09, 0.33] | 3.5 | < 0.001 |
| Общая плотность ревизий | Заметность данму | 0.17 | 0.06 | [0.05, 0.29] | 2.75 | 0.006 |
| Плотность отсроченной ревизии | Культурная нагрузка | 0.15 | 0.05 | [0.05, 0.25] | 3 | 0.003 |
| Плотность отсроченной ревизии | Оценочная плотность | 0.23 | 0.05 | [0.13, 0.33] | 4.6 | < 0.001 |
| Плотность отсроченной ревизии | Сжатие повествования | 0.26 | 0.06 | [0.14, 0.38] | 4.33 | < 0.001 |
| Плотность отсроченной ревизии | Значимость данму | 0.1 | 0.04 | [0.02, 0.18] | 2.5 | 0.013 |
| Общий показатель качества | Полный объем исправлений | 0.04 | 0.05 | [-0.06, 0.14] | 0.82 | 0.412 |
| Общий показатель качества | Коэффициент отсроченных ревизий | 1.12 | 0.37 | [0.39, 1.85] | 3.03 | 0.003 |
| Общий показатель качества | Правки на уровне дискурса | 1.76 | 0.41 | [0.96, 2.56] | 4.29 | < 0.001 |
| Общий показатель качества | Корректировки по культурной адаптации | 2.04 | 0.46 | [1.14, 2.94] | 4.43 | < 0.001 |
| Общий показатель качества | Поверхностные правки | -0.63 | 0.28 | [-1.18, -0.08] | -2.25 | 0.028 |
| Общий показатель качества | Курс обучения | 3.48 | 0.69 | [2.13, 4.83] | 5.04 | < 0.001 |
Таблица 5: Модели со смешанными эффектами, прогнозирующие поведение процессов на уровне сегмента и качество перевода.
Обсуждение
Полученные результаты демонстрируют, что трудности при переводе повествований о Китае с китайского языка на английский распределены по тексту неравномерно. Напротив, они концентрируются в сегментах, где совпадают культурные отсылки, оценочные позиции и сжатые нарративные значения. Это подтверждает взгляд на трудности перевода как на процессный характер, а не как на следствие недостаточного словарного запаса. Эмпирические исследования процесса перевода подчеркивают, что перевод представляет собой временно организованную деятельность, в которой колебания, ориентация и продуцирование распределены неравномерно19. Концентрация усилий, наблюдаемая в данном исследовании, отражает то, как определенные сегменты создают большее интерпретационное давление, нарушая линейность чернового написания более существенно, чем другие. Результаты проверки гипотез можно резюмировать следующим образом: H1 была подтверждена, так как культурная нагрузка увеличивала частоту первоначальных колебаний и плотность правок; H2 была уточнена, так как оценочная плотность и нарративное сжатие действовали через разные пути редактирования; H3 была подтверждена, поскольку время и функция правок сильнее предсказывали качество, чем общее количество исправлений; и H4 была подтверждена как ассоциативное совпадение между значимостью danmu и сегментами, требующими больших усилий, а не как причинно-следственная связь.
Что касается особенностей редактирования, данные показывают, что общее количество правок не позволяет предсказать качество перевода; напротив, основным фактором повышения качества являются отложенные правки, а также исправления на уровне дискурса и культурная адаптация. Это различие указывает на то, что редактирование бывает продуктивным только тогда, когда оно осуществляется как структурированная переоценка, а не как повторяющееся локальное исправление ошибок. В соответствии с исследованиями с использованием айтрекинга и регистрации нажатий клавиш, которые показывают, что начинающие переводчики распределяют усилия иначе при усложнении задач, более сильные студенты в данном исследовании были не просто более активны7. Они выборочно прерывали работу над предварительными вариантами решений, пересматривали их на более поздних этапах и направляли правки на обеспечение повествовательного или культурного соответствия. Следовательно, одних лишь оценок за конечный продукт недостаточно для объяснения эффективности работы переводчика, так как сопоставимые итоговые баллы часто являются результатом совершенно разных траекторий процесса работы9.
Это явление лучше всего объясняется с точки зрения конверсии когнитивных усилий. В переводах с более низким баллом когнитивные усилия оставались на локальном уровне: студенты делали паузы, заменяли лексические единицы или корректировали артикли, но не могли устранить более глубокие несоответствия между подтекстом оригинала и структурой перевода. Напротив, в работах с более высоким баллом усилия конвертировались в структурные решения, которые оптимизировали текст для целевого читателя. Аналогично исследованиям эффективности пост-редактирования, данные результаты подтверждают, что процессуальные усилия не всегда приносят пользу автоматически; их ценность зависит от того, трансформируются ли они в интерпретируемое улучшение текста20.
Более того, различные текстовые свойства активируют разные механизмы обработки. Культурная нагрузка достоверно увеличивала частоту ранних колебаний и плотность правок, тогда как нарративное сжатие было сильным предиктором правок на уровне дискурса. Это различие объясняет, почему сложные сегменты проявляются по-разному в процессе перевода: одни нарушают когнитивный доступ на этапе первоначального формулирования, в то время как другие становятся проблемными только при поддержании связности на более широких участках дискурса. В соответствии с исследованиями, показывающими, что сложные тексты приводят к образованию более мелких единиц обработки и более частым прерываниям, эти результаты подчеркивают, как сжатые культурные и оценочные смыслы заставляют переводчиков колебаться между локальным выражением и общим нарративным фреймингом8.
Значимым методологическим вкладом данной работы является интеграция значимости danmu в качестве слоя аудиторного дискурса. Существенное пересечение сегментов перевода, потребовавших больших усилий, и сегментов, значимых с точки зрения danmu, указывает на то, что трудности, с которыми сталкиваются студенты, часто совпадают с моментами, привлекающими повышенное внимание аудитории при цифровом распространении. Это связывает сложность перевода с партисипаторным дискурсом, не сливая эти две концепции воедино. Комментарии danmu раскрывают, что именно аудитория замечает или оспаривает при распространении контента через видео, в то время как записи нажатий клавиш и правок показывают, как студенты-переводчики обрабатывают семантически связанные сегменты исходного текста. Таким образом, наиболее правдоподобной является интерпретация через общие стимулы: культурно нагруженные отсылки, сжатые фоновые допущения и оценочное позиционирование могут одновременно привлекать внимание аудитории и увеличивать когнитивную нагрузку на переводчика21.
С педагогической точки зрения такое пересечение указывает на то, что нарративы, ориентированные на Китай, распространяются в контекстах, где смыслы согласуются публично и быстро, под влиянием таких конкурирующих приоритетов, как оперативность, понятность и соответствие ожиданиям аудитории22. Следовательно, подготовка переводчиков должна сместиться от восприятия правки как общего этапа корректуры к акцентированию внимания на функциональных и временно-стратегических интервенциях. Наблюдаемые затруднения редко были вызваны одной лишь терминологией; они возникали там, где смысл повествования зависел от культурно обусловленных предпосылок, реляционного фрейминга и избирательного доступа аудитории. Подобно распространению китайской этнической повествовательной литературы, передача этих нарративов требует выхода за рамки лексической точности, чтобы определить, как локальный культурный смысл должен быть реструктурирован для более широкого глобального распространения23. Данный метод может быть применен в обучении переводчиков с использованием логов нажатий клавиш, записей экрана и примеров аудиторного дискурса, чтобы помочь студентам определить, когда сегмент требует экспликации, перестановки, культурного фрейминга или корректировки регистра, а не простой лексической замены.
Интерпретация данных результатов ограничена рядом факторов. Во-первых, значимость danmu является прокси-показателем семантических кластеров вовлеченности аудитории, а не прямой мерой лингвистической сложности, и текущий корреляционный дизайн не позволяет установить причинно-следственную связь между общественной значимостью и затратами усилий на перевод. В будущих работах для проверки причинно-следственных связей можно будет экспериментально варьировать культурную нагрузку, оценочную плотность и нарративное сжатие. Во-вторых, выборка ограничена студентами-переводчиками одного университета, а опыт участников, степень знакомства с культурой и уровень владения вторым языком контролировались статистически, а не с помощью полностью стратифицированной выборки. Репликация исследования с участием профессиональных переводчиков, студентов из разных вузов и представителей более широких уровней языковой компетенции позволила бы повысить обобщаемость результатов. В-третьих, исходные тексты были составлены исследователями и прошли пилотное тестирование для калибровки задания, однако в будущих исследованиях следует провести дополнительную валидацию с использованием аутентичных публичных текстов и независимых групп по разработке материалов. В-четвертых, кодирование культурной нагрузки, оценочной плотности, нарративного сжатия и функций правки зависит от прозрачности операционных определений, записей независимых кодировщиков и проверяемого коэффициента межэкспертного согласия наряду с итоговым файлом кодирования. В будущих исследованиях также может быть применено сочетание регистрации нажатий клавиш с айтрекингом, ретроспективными интервью, протоколами «размышления вслух» или задачами по постредактированию для триангуляции когнитивных механизмов, лежащих в основе решений о внесении правок.
В конечном счете, данное исследование проясняет процессуальную основу успеваемости студентов при переводе повествовательных текстов о Китае с китайского языка на английский. Сопоставление данных логгирования нажатий клавиш, оценки конечного продукта и дискурса цифровой аудитории показывает, что «узкие места» при переводе возникают в точках общественно значимых нарративных смыслов. Решающим фактором в межкультурном переводе является не общий объем правок, а способность переводчика выявлять сегменты, требующие интерпретационной перестройки, и стратегически откладывать завершение работы до тех пор, пока не будет сформулировано устойчивое и подходящее для аудитории решение.
Раскрытие информации
Авторы заявляют об отсутствии конфликта интересов.
Вклад авторов
Weijia Chen: концептуализация, методология, формальный анализ, исследование, написание первоначального варианта статьи.
Chunming Wu: планирование исследования, руководство по формальному анализу и процедурам обработки данных, а также рецензирование и предоставление отзывов по правкам в ответ на комментарии рецензентов.
Благодарности
Данное исследование было финансово поддержано двумя грантами Университета Ханшань. В частности, оно представляет собой поэтапный результат исследовательской работы в рамках программы первоклассных курсов для студентов бакалавриата 2023 года (очный первоклассный курс) по дисциплине «Теория и практика китайско-английского перевода II» (номер разрешения YHS [2023] 172). Кроме того, исследование было поддержано Проектом по качеству и реформированию преподавания 2025 года, в рамках которого курс «Китайско-английский перевод» был определен как модельный курс по идеологическому и политическому воспитанию на основе учебной программы (номер разрешения YHSJ〔2025〕126). Авторы выражают глубокую благодарность за институциональную поддержку, оказанную для завершения данного исследования.
Материалы
| Имя | Компания | Каталожный номер | Комментарии |
|---|---|---|---|
| Корпус данму Bilibili | Bilibili | 24 videos; 18,642 comments;https://www.bilibili.com | Создание вспомогательного корпуса данму и расчет значимости данму на уровне сегмента |
| Microsoft Excel | Microsoft Corporation | Excel 2021;https://www.microsoft.com/microsoft-365/excel | Очистка данных, организация кодирования и предварительное управление данными |
| R | R Foundation for Statistical Computing | R 4.3.1;https://www.r-project.org | Моделирование смешанных эффектов, корреляционный анализ и построение графиков |
| Программное обеспечение для записи экрана | Laboratory workstation | Local workstation utility; no catalog number | Верификация эпизодов нелинейного редактирования и резервное копирование данных процесса |
| SPSS | IBM Corporation | SPSS Statistics 27.0;https://www.ibm.com/products/spss-statistics | Описательная статистика, ANOVA и базовый статистический анализ |
| Translog-II | Copenhagen Business School / CRITT | Translog-II;https://sites.google.com/site/centretranslationinnovation/translog-ii | Регистрация нажатий клавиш, запись пауз, движений курсора и эпизодов редактирования при выполнении заданий по переводу |
Ссылки
- Valdeón RA, Li S. Political discourse translation in contemporary Chinese and Western contexts. Translator. 2024;30(4):1-14.
- Du L, Afzaal M. Analyzing modality-mediated ideology in translated Chinese political discourses: An ideological square model approach. Humanit Soc Sci Commun. 2024;11:956.
- Carl M. Empirical translation process research: Past and possible future perspectives. Transl Cogn Behav. 2024;6(2):252-274.
- Qassem M, Al Thowaini BM. Cognitive processes and translation quality: Evidence from keystroke-logging software. J Psycholinguist Res. 2023;52(5):1589-1604.
- Carl M, et al. Hesitation, orientation, and flow: A taxonomy for deep temporal translation architectures. Ampersand. 2024;12:100164.
- Swar O, Mohsen M. Students' cognitive processes in L1 and L2 translation: Evidence from a keystroke logging program. Interact Learn Environ. 2023;31(10):6247-6263.
- Wang Y, Li S, Rasmussen YZ. Translators' allocation of cognitive resources in two translation directions: A study using eye-tracking and keystroke logging. Appl Sci. 2025;15(8):4401.
- Wang F, Xu Q. Processing of translation units by student and semi-professional translators in translating texts with different levels of translation difficulty. PLoS One. 2025;20(4):e0320809.
- Chen X, Yan JX. Examining student translators' writing and translation products: Quality, errors, and self-perceived mental workload. Interpret Transl Train. 2024;18(3):465-485.
- Dong D, Chen ML. Metacognitive strategies in translation: A comparative study of student and professional translators. Humanit Soc Sci Commun. 2025;12:890.
- Chen X, Yan JX. Investigating the processing effort in translation students' L2 writing and L2 translating: Evidence from keylogging. Humanit Soc Sci Commun. 2025;12:1810.
- Cao L, Doherty S, Lee JF. The process and product of translation revision: Empirical data from student translators using eye tracking and screen recording. Interpret Transl Train. 2023;17(4):548-565.
- Van Egdom GW, Schrijver I, Verplaetse H, Segers W. The impact of collaborative processes on target text quality in translator training. Interpret Transl Train. 2024;18(3):486-506.
- Riondel A. How to teach revision: Tips from an interview study. Interpret Transl Train. 2024;18(3):507-522.
- Lu S, Chen X. An experimental study on viewing perception and gratification of danmu subtitled online video streaming. J Spec Transl. 2024;42:217-238.
- Lei Y, Peng M, Han Y. Mistaken presuppositions and the translation of cultural texts: A study of two English translations of The Classic of Tea. Perspectives. 2025. doi:10.1080/0907676X.2025.2599854.
- Kim HR. Danmu as paratext: An exploratory study of paratextual functions in Chinese fan-subtitled videos. J Transl Stud. 2025;26(3):197-231.
- Wu X, Fitzgerald R. The danmu discourse of user engagement with cross-posted broadcast interviews in Chinese social media. Journalism. 2025;26(3):733-751.
- Yamada M, Carl M, Schaeffer MJ. Introduction to the special Ampersand issue on empirical translation process research. Ampersand. 2024;12:100179.
- Peng X, Wang X, Li X. When student translators meet with machine translation: The impacts of machine translation quality and perceived self-efficacy on post-editing performance. SAGE Open. 2024;14(4):21582440241291624.
- Yang Y. Making sense of the raw meat: A social semiotic interpretation of user translation on the danmu interface. Discourse Context Media. 2021;44:100550.
- Zeng D. Danmu subtitling as a self-regulative practice: A descriptive discourse analysis of Bilibili danmu subtitles from ethical perspectives. Front Psychol. 2025;16:1577260.
- Li Y, Cai X. The translation of ethnic literature: An analysis of the Chinese and English translations of the Yi folk narrative poem Ashima and their dissemination. Perspectives. 2025. doi:10.1080/0907676X.2025.2502935.