В этом исследовании подробно описывается воспроизводимый рабочий процесс для извлечения поведенческих признаков и внедрения динамически скорректированных образовательных путей в виртуальных средах. Описанные процедуры позволяют педагогам разрабатывать адаптивные учебные программы виртуальной реальности и внедрять отслеживание поведения в реальном времени.
Для просмотра этого контента требуется подписка на JoVE. Войдите или начните свой бесплатный пробный период.
Исследовательская статья
Интеллектуальные методы обучения: интеграция виртуальной реальности и алгоритмов больших данных для улучшения традиционных образовательных платформ культурного образования
В этой статье
Краткое содержание
Аннотация
Современные традиционные учебные среды имеют ограниченное количество интерактивных элементов, что приводит к ограниченным показателям вовлечённости среди студентов, изучающих культурное наследие. Для решения этих проблем была разработана интеллектуальная обучающая платформа, интегрирующая высокоточный пространственный рендеринг движок в среды виртуальной реальности с многомодельной алгоритмической архитектурой. В рамках этой платформы модели трансформера и нейронной совместной фильтрации (NCF) обрабатывают поведенческие данные для генерации персонализированных путей обучения, в то время как глубокая Q-сеть (DQN) динамически корректирует сложность контента на основе обратной связи в реальном времени. Такое адаптивное образование отражает конструктивистские принципы обучения, при которых знания формируются через взаимодействие с контекстуализированной, отзывчивой средой, а не пассивно получается через статическое обучение. Новизна этого исследования заключается в интеграции пространственного рендеринга с многомодельной алгоритмической архитектурой для создания механизма адаптации поведения в реальном времени. Экспериментальные результаты показывают, что экспериментальная группа, использующая предложенную платформу интеллектуального обучения, имеет более высокие оценки обучения (низкие/средние/высокие группы — соответственно 69/79/93 балла) и более высокий уровень выполнения учебных заданий (93%/96%/98%), чем контрольная группа, использующая традиционную модель обучения. Дизайн интеллектуальной образовательной платформы обеспечивает сильную интерактивность, предоставляет персонализированные учебные пути для учеников с разнообразными индивидуальными отличиями и динамично корректируется в процессе обучения. Анализ времени отклика показывает среднюю задержку 0,496 с, обеспечивая быструю обратную связь по взаимодействиям. В конечном итоге предлагаемая платформа демонстрирует, что сочетание иммерсивной VR с алгоритмами, адаптивными к поведению, эффективно повышает как академические достижения, так и вовлечённость студентов бакалавриата в традиционное культурное образование.
Введение
Традиционное культурное образование играет важную роль в наследовании и развитии культуры. Однако современная традиционная модель культурного образования в основном опирается на статичные формы, такие как учебники, фотографии и видео, лишённая интерактивности и погружения, что затрудняет студентам по-настоящему понимание и ощущание очарования культуры. Кроме того, традиционные методы преподавания часто используют единую учебную программу, которая не учитывает полностью интересы, когнитивные способности и стили обучения учащихся, что приводит к низкой эффективности обучения и затрудняет стимулирование энтузиазма студентов к обучению. Это ограничение соответствует теории Зоны ближайшего развития (ZPD) Выготского, которая подчёркивает, что эффективное обучение должно быть адаптировано к текущим когнитивным уровням учащихся и строиться в соответствии с их индивидуальными траекториями развития. Существующая литература опирается на статические входные данные для педагогического моделирования. Интеграция непрерывного пространственного поведенческого отслеживания с глубоким подкреплением обучения остаётся неисследованной. Предлагаемый механизм объединяет мультисенсорные взаимодействия с алгоритмической перестройкой, чтобы преодолеть разрыв между фиксированными учебными путями и динамической контекстной адаптацией. Предлагаемая платформа реализует этот принцип, динамически корректируя сложность контента и последовательность на основе поведенческих индикаторов в реальном времени, тем самым интегрируя педагогическую теорию в алгоритмический дизайн. Алгоритмические механизмы адаптации фактически заменяют человеческую опору, обычно предоставляемую более способными коллегами. Это постоянное модулирование сложности задачи соответствует теории когнитивной нагрузки (CLT), предотвращая когнитивную перегрузку у начинающих и поддерживая вовлечённость в оптимальной зоне развития.
С развитием виртуальной реальности (VR) и алгоритмов данных, их применение в традиционном культурном образовании обеспечивает студентам более погружающий и интерактивный опыт обучения 1,2,3,4. Комплексные систематические обзоры приложений иммерсивной виртуальной реальности в высшем образовании дополнительно подчеркивают важность согласования элементов дизайна с конкретными педагогическимицелями 5.
Многие исследования пытались применить VR-технологии в культурном образовании. Hulusic и др. спроектировали и разработали виртуальный школьный музей с ощутимым пользовательским интерфейсом. В результате исследований с участием пользователей музей оказался хорошо спроектированным и хорошо развитым, и имеет потенциал для использования как учебный и образовательный инструмент в музеях, школах или самостоятельно. В ответ на проблему недостаточной интерактивности в средах дистанционного обучения Mubarok и др.7 разработали совместный метод сопоставления аргументов на основе VR для решения этой проблемы. Эксперименты показали, что этот метод лучше улучшает устное выражение английского у студентов, чем совместные методы составления аргументов, не основанные на VR. Сан и др. предложили стратегию дизайна иммерсивной VR-системы, сочетающей мультимодальное взаимодействие, геймификацию и повествование для отображения и развития цифрового культурного наследия. Они разработали иммерсивную VR-систему, которая восстановила фрески из Дуньхуана, предоставляя пользователям учебный, интерактивный и увлекательный опыт. Однако эти исследования всё ещё сталкиваются с проблемами, такими как слабая интерактивность в VR-сценах, медленные темпы обновления учебного контента и низкая адаптивность персонализированных рекомендательных алгоритмов, что делает невозможным точное удовлетворение потребностей разных учеников. Кроме того, некоторые исследования не смогли эффективно интегрировать глубокое обучение и обучение с подкреплением, что ограничило возможности персонализированных рекомендаций по корректировке в реальном времени.
Недавние достижения в области искусственного интеллекта способствовали развитию образовательных технологий. Исследования вводят адаптивные системы, использующие глубокое обучение для распознавания образов в поведении пользователя. Методологии, использующие алгоритмы когнитивного отслеживания, отражают динамические состояния приобретения знаний. Структурная оптимизация в нейронных сетях повышает точность рекомендаций в рамках умного обучения. Интеллектуальные агенты, интегрирующие сложные переменные окружающей среды, улучшают автоматизированные инструкционные ответы. Эти методологии опираются на изолированные потоки данных и статический исторический анализ. Предлагаемая платформа решает это ограничение, объединяя данные о пространственном взаимодействии с непрерывной алгоритмической корректировкой для обеспечения контекстной адаптации в реальном времени.
Недавние эмпирические исследования подтверждают, что алгоритмы глубокого обучения значительно повышают точность прогнозирования в моделировании успеваемости учащихся. Ouatik и др. внедрили систему для прогнозирования академических успехов и неудач учащихся. Они использовали личную информацию учащихся, академическую оценку и другие данные, а также применяли искусственный интеллект и методы анализа образовательных данных для прогнозирования их академических успехов. Для решения проблемы обработки данных была использована технология больших данных (BD) для распределения обработки, что сократило время вычислений без ущерба для эффективности алгоритма. Бхаскаран 10 разработал усовершенствованный рекомендаций векторного пространства для решения проблем в современных системах рекомендаций по обучению. Он автоматически отслеживает интересы, требования и уровень знаний учащихся. Он классифицирует и извлекает стили обучения учащихся с сервера, затем использует усовершенствованный алгоритм совместной фильтрации для вычисления сходств и создания более точного списка рекомендаций. Gupta 11 предложил метод глубокого обучения, который использует мимику для обнаружения вовлечённости онлайн-обучающихся в реальном времени, классифицирует их эмоции на протяжении всего процесса обучения, анализируя мимики учащихся, и корректируя их статус обучения на основе результатов обнаружения. Однако эти методы всё ещё имеют определённые ограничения.
Хотя существующие VR-образовательные решения обеспечивают захватывающий опыт, им отсутствуют возможности динамической адаптации. Пути обучения учеников часто фиксированы, а содержание и сложность нельзя оптимизировать в реальном времени на основе личного прогресса и обратной связи, что приводит к отсутствию участия. В то же время традиционные алгоритмы персонализированных рекомендаций в основном опираются на исторические данные или простые интересные теги и не интегрируют многомерные данные, такие как учебное поведение учащихся, когнитивный статус и эмоциональная обратная связь, для точного анализа. Отсутствие глубокого понимания процессов обучения учащихся мешает системе рекомендаций эффективно учитывать индивидуальные различия, что приводит к неоптимальному опыту обучения и неоптимальным результатам.
Поэтому для решения проблем недостаточного погружения и персонализации в традиционное культурное образование предлагается интеллектуальная образовательная платформа. Эта методология напрямую применима к гуманитарным курсам бакалавриата, требующим пространственной визуализации и индивидуальных метрик темпа. Для создания виртуальных обучающих сцен используются современные движки пространственного рендеринга и связанные с ними технологии пространственных вычислений. Виртуальные образовательные среды предоставляют учащимся самостоятельность выбора конкретных культурных модулей. Нейронная модель Transformer на основе нейронного внимания обрабатывает логи взаимодействия с временной меткой для создания компактного представления поведенческих паттернов. На основе извлечения характеристик учебного поведения у студентов используется модель нейронной совместной фильтрации (NCF) для дальнейшего изучения интересов студентов и создания персонализированных путей обучения. Модель Deep Q-Network (DQN) собирает обратную связь студентов в реальном времени и динамически корректирует учебный путь для оптимизации их опыта и эффекта обучения.
Что касается практического внедрения, предлагаемая платформа обладает конкретными преимуществами, но не является универсальной. Он очень подходит для учебных заведений, оснащённых специализированным вычислительным оборудованием, включающим дискретные графические процессоры и оборудование для иммерсивной пространственной визуализации, а также для учебных программ, которые значительно выигрывают от пространственной визуализации в архитектуре культурного наследия и археологии. В таких условиях динамическое поведенческое отслеживание эффективно устраняет индивидуальные различия в темпе. Напротив, этот метод в настоящее время неподходит для недофинансируемых образовательных сред без необходимой технологической инфраструктуры. Кроме того, не рекомендуется для крайне абстрактных, ориентированных на текст курсов, где трёхмерное погружение имеет незначительную педагогическую ценность по сравнению с традиционными методами обучения.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Протокол
Комитет по институциональной этике Университета международной торговли и коммерции Шэньси подтвердил исследовательский протокол по ссылке 2025-04A. Задокументированное информированное согласие было получено от всех участников до начала процедуры, что гарантирует, что все участники были осведомлены о протоколах отслеживания поведения и анонимизации данных. (Примечание: педагогические обоснования алгоритмов были перенесены в раздел Обсуждения для сохранения оперативной лаконичности.)
Шаг 1: Создание сцены виртуальной реальности
Интеграция активов
Цифровое моделирование культурных элементов осуществлялось с помощью универсального 3D-моделирования (см. Таблицу материалов для конкретного используемого программного обеспечения) для создания иммерсивных учебных сред12,13. Создавались цифровые ресурсы, назначались физически основанные текстуры рендеринга и импортировались в высокоточный пространственный движок рендеринга (Таблица материалов) без использования микроскопических методоввизуализации 14,15.
Рендеринг и конфигурация физики
В движке рендеринга была включена аппаратная технология трассировки лучей для оптимизации динамическогоосвещения 16,17:
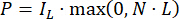 (1)
P символизирует интенсивность света в сцене. L обозначает положение источника света. IL обозначает интенсивность источника света, а N — нормальный вектор поверхности виртуального объекта.
Физический движок моделировал динамику объектов с помощью объектно-ориентированного программного интерфейса (C++). Использовалась формула реакции:
 (2)
F представляет динамическую реакционную силу, m — масса виртуального объекта, v — его скорость, а t — время.
Для обеспечения плавности была использована технология уровня детализации (LOD) для оптимизации сцены, что снизило ненужные вычисления и повысило эффективность рендеринга за счёт динамической настройки уровня детализации модели18,19. Для обработки изображений использовалось ускорение GPU:
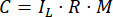 (3)
R — коэффициент отражения, M — отображение поверхности, C — итоговый отрисованный цвет.
Реализация взаимодействия
Пользовательские взаимодействия настраивались с использованием визуального узлового скриптового интерфейса, встроенного в пространственный движок рендеринга. С помощью пространственной аудиотехнологии звук был смоделирован в пространстве, чтобы ученики могли слышать разные звуковые эффекты в разных позициях. Кроме того, с помощью технологии тактильной обратной связи студенты могли получать физические реакции на соответствующее физическое прикосновение в виртуальнойсцене 20:
 (4)
Ft обозначает силу тактильной обратной связи, а k — коэффициент жесткости.
Обзор развертывания и оборудования
Среда была скомпилирована на специализированном аппаратном оборудовании пространственных вычислений, оснащённом двадцатичетырёхъядерным центральным процессором, шестидесятью четырьмя гигабайтами памяти с произвольным доступом и выделенным графическим процессором на двадцать четыре гигабайта. Виртуальные сцены размещались на стандартных иммерсивных пространственных визуализаторах, как подробно описано в Таблице материалов, с разрешением 1440 x 1600 пикселей на глаз и частотой обновления 90 Гц, обеспечивая оптимальную визуальную стабильность и минимизируя задержку между движением и фотоном. Пространственные границы были настроены так, чтобы ограничить продолжительность сессий 45 минутами для снижения визуально вызванной укачивания.
Таблица материалов обобщает конкретные используемые технологии. Все обозначенные аппаратные и вычислительные компоненты были стандартным коммерческим оборудованием и не зависели от одного проприетарного поставщика. Движок пространственного рендеринга и трассировка лучей обеспечивали динамическое освещение, а программное обеспечение для 3D-моделирования воспроизводило исторические места. Рисунок 1 приведён примером виртуальной обучающей сцены, подробно описывающей модульную панель управления для визуального увеличения, аудиомодуляции и движения.
Контрольная точка 1: полностью отрендеренная VR-среда с стабильной частотой обновления 90 Гц, минимизирующая задержку между движением и фотоном для обеспечения визуальной стабильности.
Шаг 2: Извлечение поведенческих данных (Transformer)
Логирование данных
Данные о поведении учащихся включали взаимодействие с VR-сценами, включая количество кликов, затраченное время, прогресс обучения и выполнение задач. В таблице 1 представлены данные об обучающей деятельности учащихся в различных VR-сценариях. Для этой интерактивной информации на платформе использовалось представление временных рядов:
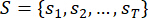 (5)
sτ представляет поведение ученика в момент времени t, а T — общая продолжительность времени. Каждое поведение образует высокомерный вектор:
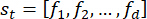 (6)
fi обозначает конкретное значение признака в измерении i, а d — общее количество измерений признаков.
Моделирование последовательностей
Модель Transformer использовалась для моделирования временныхрядов 21,22. С помощью механизма самовнимания поведенческие черты были извлечены путём вычисления корреляций между поведением учеников. При условии, что матрица вложения последовательности данных поведения учащегося — это X, запрос (Q), ключ (K) и значение (V). Матрицы впервые формировались путём умножения на обучаемые весовые матрицы WQ,W K и WV:
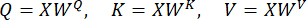 (7)
Расчёт внимания
Самосознание внутри трансформатора было рассчитанокак 23,24:
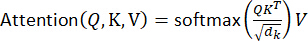 (8)
Среди них dk обозначает размерность ключевых векторов, которая использовалась как коэффициент масштабирования для предотвращения нулевого градиента. После вычисления формулы (8) был рассчитан вес внимания для измерения корреляции между обучающимися поведением:
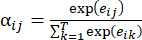 (9)
EIJ представляет собой исходный показатель энергии внимания между учебными поведениями. Взвешенная сумма этих весов использовалась для получения вектора контекста в текущий момент — потенциального вектора признаков студента:
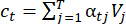 (10)
Контрольный пункт 2: Трансформерская модель выводит непрерывные латентные векторы признаков (ct). На секвестрированном валидационном наборе из 5000 логов взаимодействия модель достигла точности прогнозирования последовательностей 89,4%, при этом потеря перекрёстной энтропии сходилась до 0,12 после 50 эпох.
Шаг 3: Генерация персонализированного учебного пути (NCF)
Слияние признаков
Модель NCF была внедрена для изучения потенциальных интересов и потребностей учащихся и создала индивидуальные учебные пути25, 26, 27, 28. В NCF вектор признаков vk присваивался каждой культурной точке знаний, а потенциальный вектор признаков v u, извлеченный Трансформатором, и вектор точки знаний vk объединялись в новый совместный вектор признаков:
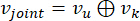 (11)
Архитектура сети и гиперпараметры:
Совместный вектор признаков вводился в многослойный перцептрон (MLP) в NCF дляобработки 29,30. Многослойный перцептрон использовал заранее определённую архитектуру с тремя скрытыми слоями по 64, 32 и 16 нейронам соответственно. Скорость обучения была установлена на уровне 0,001, при объёме партии 256. После нелинейного преобразования нескольких скрытых слоёв в MLP прогнозируемое значение интереса студентов к точкам знаний было получено:
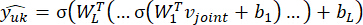 (12)
W1,W 2, ... , WL представляют матрицы веса нескольких скрытых слоёв. σ обозначает нелинейную активационную функцию, а b1,b 2, ... , bL — это смещённые члены соответствующих скрытых слоёв. Чем выше прогнозируемое значение выходного интереса, тем выше интерес студента к этому пункту знаний.
Обучение моделям
Сеть была оптимизирована с помощью решателя Адама (скорость затухания 0,01, скорость обучения 0,001, размер пакета 256). Среднеквадратичная ошибка (MSE) выполняет функциюпотерь 31,32:
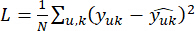 (13)
u, k представляет индекс вектора поведения ученика и вектора точки знаний. Минимизируя функцию потерь, модель постоянно обновляет потенциальные векторы признаков для студентов и точек знаний для повышения точности прогнозирования. Алгоритм обратного распространения использовался во время обучения для обновления матрицы весов в модели33,34.
Выход по пути
Конкретный подход заключался в сортировке по прогнозируемым значениям интереса и рекомендации к очкам знаний с наивысшими значениями интереса студентам:
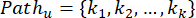 (14)
k k — это те точки знаний, которые больше всего интересуют студентов. Эти рекомендуемые знания не только удовлетворяют интересы студентов в обучении, но и помогают им эффективно учиться на уровне прогресса и сложности, который им подходит.
Рисунок 2 визуализирует этот процесс генерации.
Контрольный пункт 3: Модель NCF выводит нециклический массив последовательностей. Как подробно описано в таблице 2, точность рекомендаций, оценённая при отборе верхнего K, дала нормализованный дисконтированный кумулятивный прирост (NDCG) 0,82 и коэффициент попадания 0,88 при K = 10. Средний показатель обратного ранга стабилизировался на уровне 0,76.
Шаг 4: Динамическая настройка сложности (DQN)
Определение состояния и действия
Вводя DQN и используя обратную связь в реальном времени учащихся для динамической корректировки содержания и сложности, эффекты обучения студентовоптимизируются на 35,36. Пространство состояний модели DQN состоит из нескольких факторов:
 (15)
Среди них ts — это время, которое студенты тратят на текущее учебное задание, cp — выбор учеников в учебном пути (выбранные главы или точки знаний), m c — завершение текущего учебного задания студентами, а ef — эмоциональная обратная связь учеников (степень предпочтения и участия в конкретном учебном задании).
Расчёт вознаграждения
Агент подкрепляющего обучения использовал многослойную архитектуру перцептрона, состоящую из двух скрытых слоёв по 128 и 64 нейрона (стратегия эпсилонно-жадного исследования спадала с 1.0 до 0.05). Сначала была рассчитана вознаграждение, соответствующее каждому обучающему действию:
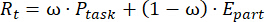 (16)
Среди них ω — это гиперпараметр веса, который управляет результатами обучения и участием в обучении. Задача P представляет результаты ученика в текущем учебном задании, а часть E — участие ученика в текущем учебном процессе.
Обновление Q-Value и выбор действия
После получения значения вознаграждения модель обновляла значение Q, чтобы выбрать оптимальное действие:
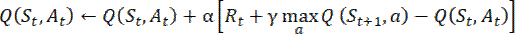 (17)
α представляет собой скорость обучения, контролирующую размер шага обновления, а γ Коэффициент дисконта определяет важность будущих вознаграждений.
Платформа выбрала оптимальное действие корректировки:
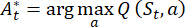 (18)
 — оптимальное действие корректировки, выбранное платформой на основе статуса обучения студента на момент T.
Корректировка выполнялась по следующим протоколам: (1) Сложность была повышена для повышения способности к обучению; (2) Были предоставлены подсказки / сложность снижалась за плохую производительность; (3) Содержание менялось в зависимости от изменений интересов; (4) Параметры поддерживались для сбалансированной работы.
Контрольный пункт 4: Агент DQN вычислял оптимальные действия (A t) для поддержания взаимодействия. Композитная эмоциональная обратная связь (ef) поддерживала коэффициент альфа-надёжности Кронбаха на уровне 0,85 во время тестирования.
Дисплей интерфейса платформы
Рисунок 3 демонстрирует интерфейс интеллектуальной образовательной платформы, разработанной в этой статье, которая поддерживает персонализированную генерацию путей. В этом интерфейсе студенты могли видеть свой индивидуальный учебный путь и учиться на нём. Завершённая часть учебного пути могла быть отмечена зелёным, а незавершённая — красным. Студенты могли наблюдать за своим прогрессом на пути обучения и соответственно перейти к следующему этапу. Экспериментальной когорте проводились опросы после взаимодействия с использованием стандартной шкалы удобства системы. Анализ показал средний балл удобства использования 84,5 из 100, что свидетельствует о том, что эргономика интерфейса и навигационная чёткость были весьма приемлемыми.
Экспериментальная конструкция
Участниками были 120 студентов бакалавриата (62 женщины, 58 мужчин; средний возраст 19,3 года ± 1,1 года), зачисленных на обязательный курс «Введение в китайскую традиционную культуру» в Университете международной торговли и коммерции Шэньси. Никто из них не имел опыта обучения на основе VR. Студентов парировали по результатам предварительного теста и случайным образом распределяли по экспериментальным или контрольным условиям с использованием компьютерной последовательности, обеспечивая исходную эквивалентность.
Дизайн этого эксперимента был направлен на проверку эффективности разработанной интеллектуальной образовательной платформы для повышения интереса учащихся к обучению, академической успеваемости и персонализированному образованию.
Экспериментальная и контрольная группы были созданы в эксперименте, а отбор учащихся следовал следующим принципам: (1) Это обеспечивало сходство студентов в экспериментальной и контрольной группах по базовым знаниям, способностям к обучению, интересам и т. д. (2) Студенты, изучающие традиционную культуру и имеющие схожие классы, могли быть отобраны для обеспечения единообразия содержания культурного образования и сопоставимости эксперимента. (3) Индивидуальные различия учащихся могут быть учтены, чтобы экспериментальная группа могла полностью использовать функцию персонализированной корректировки интеллектуальной образовательной платформы.
После отбора студентов они группируются, а студенты с похожими академическими достижениями, интересами и опытом распределяются соответственно в экспериментальную и контрольную группы для обеспечения соответствия по нескольким измерениям и повышения надёжности эксперимента.
Сравнивая результаты экспериментальных и контрольных групп, оценивалось влияние платформы, разработанной в этой статье, на студентов. Чтобы выделить педагогический вклад алгоритмов искусственного интеллекта, в исследовании были представлены три отдельных когорты: традиционная контрольная группа с использованием стандартных методов в классе, группа только с VR, взаимодействующая с фиксированными виртуальными средами без адаптивных алгоритмов, и экспериментальная группа, использующая полностью интегрированную интеллектуальную образовательную платформу. Студенты экспериментальной группы могли учиться в VR-сцене, а каждый мог генерировать персонализированные учебные пути на основе своих особенностей поведения в обучении с помощью интеллектуальной образовательной платформы, динамически корректируя содержание и сложность в ответ на обратную связь в реальном времени во время процесса. Контрольная группа получила культурное образование с помощью традиционных методов преподавания, таких как объяснения в классе, чтение учебников и видео. Контрольная группа получила стандартизированное культурное образование через лекции под руководством преподавателей, заданные материалы и линейные мультимедийные презентации. Это базовое обучение использовало идентичный информационный контент и сохраняло тот же темп, что и экспериментальная учебная программа.
Три гипотезы были разработаны для прояснения цели исследования: (1) Иммерсивная образовательная среда, предоставляемая VR-технологиями, может значительно повысить участие и интерес учащихся к обучению. (2) Персонализированный учебный путь от Transformer и NCF эффективно улучшил академические успеваемости студентов и снизил различия в освоении знаний между разными учениками. (3) Интеллектуальная образовательная платформа могла бы динамически корректировать содержание и сложность обучения на основе обратной связи студентов в реальном времени, что ещё больше улучшало их учебные результаты.
Экспериментальный процесс: (1) Был проведён предэкспериментальный тест культурных знаний на учащихся в экспериментальной и контрольной группах, чтобы обеспечить сходство начальных культурных уровней обеих групп и снижение экспериментальных ошибок. (2) Студенты экспериментальной группы использовали созданную VR-сцену и интеллектуальную образовательную платформу, провели месячное культурное исследование, а учебный контент динамически корректировался в соответствии с интеллектуальной образовательной платформой. Контрольная группа использовала традиционные методы обучения. Из-за логистических ограничений первоначального пилотного проекта вмешательство длилось четыре недели. Последующее лонгитюдное исследование, проведённое в течение полного 16-недельного семестра, завершилось тестом на отсрочку удержания на 20-й неделе. Оценка показала на 22% более высокое запоминание целевых исторических концепций в алгоритмически управляемой когорте по сравнению с традиционной группой обучения. Предварительные детали протокола были приведены в разделе ограничений, чтобы контекстуализировать текущие результаты как краткосрочные доказательства. (3) После эксперимента обеим группам студентов был проведён одинаковый тест на культурные знания для оценки их учебных результатов и выполнения задания.
Показатели оценки учащихся включали их академические успеваемости, выполнение учебных заданий и прогресс обучения. С помощью описательной статистики были обобщены соответствующие показатели оценки для экспериментальной и контрольной групп. Показатели оценки интеллектуальной образовательной платформы включали время отклика.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Результаты
Разделение данных, валидация и настройки воспроизводимости
Для этапа алгоритмического обучения набор данных поведенческого взаимодействия, содержащий 5000 журналов, был разделён на наборы обучения и валидации 80:20. Процедуры валидации использовали пятикратную схему кросс-валидации для оценки согласованности выделения признаков. Для обеспечения абсолютной экспериментальной воспроизводимости все инициализации веса сети, последовательности перемешивания наборов данных и...
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Обсуждение
Это исследование вносит вклад в образовательные технологии, переводя основные педагогические теории — а именно конструктивизм и зону ближайшего развития — в вычислительно реализованную интеллектуальную систему обучения. Интеграция погружения в VR с персонализацией, ориентированной на поведение, гарантирует, что технологические инновации служат явным образовательным целям, а не функционируют как самоцель. Как отмечается в методологии, создание персонализированных учебных путей является кл...
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Раскрытие информации
Авторы заявляют, что у них нет финансовых конфликтов интересов. Раскрытие инструментов искусственного интеллекта: При подготовке этой рукописи использовались крупные языковые модели исключительно для уточнения языка, уточнения специализированных терминологий и помощи в поиске академической литературы. Все результаты искусственного интеллекта были критически оценены, вручную сопоставлены с первичными рецензируемыми источниками и тщательно отредактированы авторами для обеспечения строгой научной точности и целостности данных.
Благодарности
Ни одного.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Материалы
| Имя | Компания | Каталожный номер | Комментарии |
|---|---|---|---|
| Высококачественный пространственный рендеринг движок | Unreal Engine 5 | Используется для интеграции сцен, динамического лучевого трассировки и физической симуляции. | |
| Лучевое трассировка | Лучевое трассировка | Технология симуляции освещения на основе физических принципов | |
| Программное обеспечение для 3D моделирования | Blender | Используется для создания многогранных моделей культурных артефактов и применения PBR текстур. | |
| Уровень деталей | Уровень деталей | Технология оптимизации сцены | |
| Пространственный звук | Пространственный звук | Симуляция характеристик распространения звука в трехмерном пространстве | |
| Гаптическая обратная связь | Гаптическая обратная связь | Симуляция сил обратной связи при взаимодействии с физикой | |
| Визуальное программирование & программный интерфейс | Blueprints & C++ | Используется для настройки взаимодействий пользователей и непрерывной регистрации данных о пространственном поведении. | |
| Головной дисплей (HMD) | HTC Vive Pro | Обеспечивает иммерсивную визуализацию, подачу пространственного звука и трекинг движения. |
Ссылки
- Rojas-Sanchez MA, Palos-Sanchez PR, Folgado-Fernandez JA. Systematic literature review and bibliometric analysis on virtual reality and education. Educ Inf Technol (Dordr). 2023;28:155-92.
- Rospigliosi P. Metaverse or simulacra? Roblox, Minecraft, Meta and the turn to virtual reality for education, socialisation and work. Interact Learn Environ. 2022;30:1-3.
- Quadir B, Chen NS, Isaias P. Analyzing the educational goals, problems and techniques used in educational big data research from 2010 to 2018. Interact Learn Environ. 2022;30:1539-55.
- Lutfiani N, Meria L. Utilization of big data in educational technology research. Int Trans Educ Technol. 2022;1:73-83.
- Radianti J, Majchrzak TA, Fromm J, Wohlgenannt I. A systematic review of immersive virtual reality applications for higher education: design elements, lessons learned, and research agenda. Comput Educ. 2020;147:103778.
- Hulusic V, Gusia L, Luci N, Smith M. Tangible user interfaces for enhancing user experience of virtual reality cultural heritage applications for utilization in educational environment. ACM J Comput Cult Herit. 2023;16:1-24.
- Mubarok H, Lin CJ, Hwang GJ. A virtual reality-based collaborative argument mapping approach in the EFL classroom. Interact Learn Environ. 2024;32:4978-96.
- Sun T, et al. Restoring Dunhuang murals: crafting cultural heritage preservation knowledge into immersive virtual reality experience design. Int J Hum Comput Interact. 2024;40:2019-40.
- Ouatik F, et al. Predicting student success using big data and machine learning algorithms. Int J Emerg Technol Learn. 2022;17:236-51.
- Bhaskaran S, Marappan R. Enhanced personalized recommendation system for machine learning public datasets: generalized modeling, simulation, significant results and analysis. Int J Inf Technol. 2023;15:1583-95.
- Gupta S, Kumar P, Tekchandani RK. Facial emotion recognition based real-time learner engagement detection system in online learning context using deep learning models. Multimed Tools Appl. 2023;82:11365-94.
- El-Wajeh YA, Hatton PV, Lee NJ. Unreal Engine 5 and immersive surgical training: translating advances in gaming technology into extended-reality surgical simulation training programmes. Br J Surg. 2022;109:470-1.
- Conde D, et al. LiDAR data processing for digitization of the castro of Santa Trega and integration in Unreal Engine 5. Int J Archit Herit. 2025;19:131-51.
- Rohe DP, Jones EM. Generation of synthetic digital image correlation images using the open-source Blender software. Exp Tech. 2022;46:615-31.
- Pradana MR, Setiawan D, Trinawati L. Efektivitas ilusi 3D animasi Blender pada curved LED billboard (AB Building Jl. Juanda Pekanbaru). JEKIN (Jurnal Teknik Informatika). 2023;3(2):1-10. Available from: https://pdfs.semanticscholar.org/e4fd/a249d78d46e24319e3a8f318e713f76c0cbd.pdf
- Wang Y, Zhao K, Zheng Z. An improved 3D indoor positioning study with ray tracing modeling for 6G systems. Mob Netw Appl. 2023;28:1162-75.
- Liu Y, et al. Intelligent ray-tracing-based simulation and emulation of channels. Chin J Radio Sci. 2024;39:1112-9.
- Weier P, et al. Neural prefiltering for correlation-aware levels of detail. ACM Trans Graph. 2023;42:1-16.
- Mercier C, et al. Moving level-of-detail surfaces. ACM Trans Graph. 2022;41:1-10.
- Zhu M, Sun Z, Lee C. Soft modular glove with multimodal sensing and augmented haptic feedback enabled by materials' multifunctionalities. ACS Nano. 2022;16:14097-110.
- Heng JJ, Teo DB, Tan LF. The impact of Chat Generative Pre-trained Transformer (ChatGPT) on medical education. Postgrad Med J. 2023;99:1125-7.
- Hung YC, et al. Comparison of patient education materials generated by chat generative pre-trained transformer versus experts: an innovative way to increase readability of patient education materials. Ann Plast Surg. 2023;91:409-12.
- Yang H, et al. CovidViT: a novel neural network with self-attention mechanism to detect Covid-19 through X-ray images. Int J Mach Learn Cybern. 2023;14:973-87.
- Kumar S, Solanki A. An abstractive text summarization technique using transformer model with self-attention mechanism. Neural Comput Appl. 2023;35:18603-22.
- Tapalova O, Zhiyenbayeva N. Artificial intelligence in education: AIEd for personalised learning pathways. Electron J e-Learn. 2022;20:639-53.
- Hashim S, et al. Trends on technologies and artificial intelligence in education for personalized learning: systematic literature. J Acad Res Progress Educ Dev. 2022;12:884-903.
- Lin W, et al. A deep neural collaborative filtering based service recommendation method with multi-source data for smart cloud-edge collaboration applications. Tsinghua Sci Technol. 2023;29:897-910.
- Ha J, Park S. NCMD: Node2vec-based neural collaborative filtering for predicting miRNA-disease association. IEEE/ACM Trans Comput Biol Bioinform. 2022;20:1257-68.
- Nuanmeesri S, et al. Improving dropout forecasting during the COVID-19 pandemic through feature selection and multilayer perceptron neural network. Int J Inf Educ Technol. 2022;12:851-7.
- Yilmaz O, Altun AA, Koklu M. Optimizing the learning process of multi-layer perceptrons using a hybrid algorithm based on MVO and SA. Int J Ind Eng Comput. 2022;13:617-40.
- Garcia Garcia C, Salmeron Gomez R, Garcia Perez J. A review of ridge parameter selection: minimization of the mean squared error vs. mitigation of multicollinearity. Commun Stat Simul Comput. 2024;53:3686-98.
- Thongsak N, Lawson N. Bias and mean square error reduction by changing the shape of the distribution of an auxiliary variable: application to air pollution data in Nan, Thailand. Math Popul Stud. 2023;30:180-94.
- Mohammed NA, Al-Bazi A. An adaptive backpropagation algorithm for long-term electricity load forecasting. Neural Comput Appl. 2022;34:477-91.
- Wright LG, et al. Deep physical neural networks trained with backpropagation. Nature. 2022;601:549-55.
- Bhimshetty S, Ikechukwu AV. Energy-efficient deep Q-network: reinforcement learning for efficient routing protocol in wireless internet of things. Indones J Electr Eng Comput Sci. 2024;33:971-80.
- Geng X, Zhang B. Deep Q-network-based intelligent routing protocol for underwater acoustic sensor network. IEEE Sens J. 2023;23:3936-43.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.