В данном протоколе представлен воспроизводимый рабочий процесс глубокого обучения с использованием данных многоканального циклирования и сконструированных признаков для прогнозирования состояния здоровья, остаточного полезного ресурса и характеристик энергоемкости литий-ионного аккумулятора.
Для просмотра этого контента требуется подписка на JoVE. Войдите или начните свой бесплатный пробный период.
Методическая статья
Воспроизводимый рабочий процесс глубокого обучения для прогнозирования характеристик литий-ионных аккумуляторов с использованием многоканальных данных циклического тестирования
В этой статье
Краткое содержание
Аннотация
В данном протоколе представлен воспроизводимый рабочий процесс глубокого обучения для прогнозирования характеристик литий-ионных аккумуляторов с использованием многоканальных данных циклирования. Для устранения ограничений существующих моделей на основе данных, связанных с интеграцией информации из нескольких источников и представлением признаков, в методе используются пять общедоступных наборов данных по аккумуляторам. Входные данные включают необработанные рабочие сигналы, такие как напряжение, ток, емкость, температура, внутреннее сопротивление, кулоновская и энергетическая эффективность, а также расчетные признаки, такие как прирост емкости, дифференциальное напряжение и энергопропускная способность. В протоколе подробно описаны стандартизированные процедуры предварительной обработки для построения временных тензоров на уровне аккумулятора в нескольких окнах наблюдения. Для повышения воспроизводимости в рабочем процессе оцениваются возможные архитектуры нейронных сетей, включая глубокие нейронные сети, сверточные нейронные сети (CNN), сети с долгой краткосрочной памятью (LSTM), комбинированные сети CNN–LSTM и модели на основе трансформеров, с использованием фиксированных случайных чисел (seeds), повторяющихся итераций оценки и отслеживания окружения. Репрезентативные результаты показали, что архитектура CNN–LSTM с интегрированными многоканальными данными и расчетными признаками обеспечила наиболее высокую прогностическую эффективность среди оцениваемых моделей. Выбранная конфигурация достигла средней абсолютной ошибки 0,024 и значения R2 0,955 при оценке состояния здоровья (state-of-health), сохраняя при этом высокую точность прогнозирования остаточного полезного срока службы и оценочной разряжаемой энергии. Анализ абляции и анализ устойчивости дополнительно продемонстрировали вклад интеграции многоканальных признаков и стабильность ориентированного на воспроизводимость рабочего процесса при повторных оценках. Данная стандартизированная методология предоставляет воспроизводимую основу для управления жизненным циклом аккумуляторов и прогностического моделирования в различных условиях эксплуатации.
Введение
Литий-ионные аккумуляторы играют ключевую роль в глобальном переходе к возобновляемым источникам энергии благодаря их высокой плотности энергии, длительному циклическому ресурсу и низким скоростям саморазряда в различных областях применения — от портативной электроники до систем хранения энергии сетевого масштаба. Однако длительная эксплуатация неизбежно приводит к постепенной деградации емкости и увеличению внутреннего сопротивления1. Это снижение производительности не только снижает экономическую эффективность, но и создает серьезные риски безопасности, включая тепловой разгон. Поскольку развертывание крупномасштабных систем хранения энергии продолжает ускоряться, управление жизненным циклом аккумуляторов становится все более сложным2. Традиционный мониторинг на основе пороговых значений и протоколы ручного осмотра недостаточны для динамических условий эксплуатации3. Более того, опора на один параметр является недостаточной для точного прогнозирования состояния здоровья (SOH) или остаточного полезного срока службы (RUL) аккумулятора при колебаниях скоростей заряда-разряда, температуры окружающей среды и изменений напряжения разряда4. Хотя текущий рабочий процесс был в основном подтвержден с использованием наборов данных циклического тестирования в контролируемых лабораторных условиях, многоканальная архитектура и структура временного моделирования могут способствовать будущей адаптации к динамическим условиям эксплуатации, встречающимся в электромобилях и изменчивых условиях окружающей среды.
Деградация аккумуляторных батарей представляет собой крайне сложный нелинейный электрохимический процесс, обусловленный ростом межфазного слоя твердого электролита, потерей активного лития и структурным разрушением материалов электродов. Исторически оценка состояния батарей основывалась на моделях эквивалентных схем или электрохимических физических дифференциальных уравнениях в частных производных (ДУЧП)5. Хотя эти физические модели дают ценное понимание механизмов процессов, они характеризуются значительными вычислительными затратами и сложностями при идентификации параметров при обработке многоканальных связанных сигналов. Следовательно, их внедрение в режиме реального времени в встроенные системы управления батареями (BMS) серьезно ограничено сложной кинетикой диффузии и переменностью условий окружающей среды при разряде с высокой скоростью6. Напротив, предлагаемый рабочий процесс глубокого обучения (DL) концентрирует основную вычислительную нагрузку на этапе автономного обучения, в то время как обученная модель выполняет сравнительно быстрый вывод во время эксплуатации. Таким образом, данный фреймворк может способствовать внедрению в будущем в BMS с ограниченными ресурсами и в среды граничных вычислений.
В последнее время подходы глубокого обучения (DL), основанные на данных, стали мощным инструментом благодаря их исключительным возможностям нелинейной аппроксимации. Тем не менее, существующие методологии DL имеют два основных недостатка. Во-первых, многие подходы опираются преимущественно на кривые деградации единичной емкости или специфические пороговые значения напряжения разряда, игнорируя присущие многоканальным откликам циклирования пространственно-временные корреляции, такие как напряжение, ток и температура. Это ограничение снижает робастность модели в сценариях эксплуатации при различных условиях7. Предыдущие исследования показали, что игнорирование тепловых состояний в ходе сложных операций может ускорить накопление ошибок прогнозирования8,9. Во-вторых, в прикладном машинном обучении (ML) сохраняется проблема воспроизводимости. Вариации экспериментальных условий, недостаточно описанные конвейеры предобработки и произвольно выбранные гиперпараметры нейронных сетей часто приводят к тому, что в остальном робастные модели оказываются несостоятельными при кросс-датасетной валидации10. Чтобы снизить риск утечки информации во время предобработки и прогнозирования ранних циклов, предлагаемый рабочий процесс выводит коэффициенты масштабирования нормализации и базовые линии спроектированных признаков исключительно из обучающих наборов данных перед проведением внешней валидации и кросс-датасетной оценки.
Для устранения этих критических пробелов общая цель данного протокола заключается в представлении автоматизированного, высоковоспроизводимого рабочего процесса глубокого обучения (DL) для прогнозирования энергоемкости литий-ионных аккумуляторов с использованием многоканальных данных циклирования. Обоснованием данного метода является явный учет сложных долгосрочных зависимостей, связанных с деградацией аккумулятора, путем интеграции кросс-модальных временных рядов данных в архитектуре многомерной нейронной сети. Ключевым преимуществом этого протокола по сравнению с существующими физическими методами и подходами DL является его комплексная стандартизация, которая устанавливает полный конвейер, охватывающий предобработку необработанных сигналов, проектирование признаков, обучение модели и оценку неопределенности. Хотя гибридные архитектуры нейронных сетей исследовались ранее, данный рабочий процесс делает акцент на стандартизированной многоканальной интеграции путем согласования переменных электрохимического циклирования с разработанными признаками деградации в рамках структуры обучения, ориентированной на воспроизводимость. В отличие от многих ранее описанных рабочих процессов, этот протокол включает стандартизированные конфигурации параметров, фиксированные случайные числа (random seeds), повторные запуски оценки и всесторонний мониторинг среды для повышения воспроизводимости на гетерогенных наборах данных аккумуляторов и в различных лабораторных условиях. Кроме того, рабочий процесс систематически сравнивает несколько архитектур нейронных сетей для оценки стабильности прогнозирования и производительности при различных конфигурациях входных данных. В рамках оцениваемых наборов данных и экспериментальных условий архитектура сверточной нейронной сети и долгой краткосрочной памяти (CNN–LSTM) продемонстрировала более благоприятную прогностическую эффективность по сравнению с оцениваемыми отдельными моделями CNN и моделями на основе трансформеров, сочетая извлечение локальных признаков с моделированием долгосрочных временных последовательностей при сохранении умеренной вычислительной сложности. Данный протокол хорошо подходит для исследователей и инженеров, стремящихся разработать воспроизводимые и адаптивные к среде прогностические модели для управления жизненным циклом аккумуляторов.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Протокол
Одобрение институционального комитета по этике для данного исследования не потребовалось, так как в работе использовались исключительно общедоступные наборы данных о циклировании литий-ионных аккумуляторов, и исследование не предполагало участия людей, животных или использования биологических образцов.
1. Сбор и организация данных
- Сбор многоканальных наборов данных циклического тестирования
- Загрузите наборы данных циклического тестирования литий-ионных аккумуляторов из общедоступных репозиториев аккумуляторов, содержащих записи циклов заряда-разряда. Получите наборы данных CALCE, SANYO, PANASONIC, KOKAM и GOTION непосредственно из соответствующих институциональных репозиториев открытого доступа или по ссылкам идентификаторов цифровых объектов (DOI) для обеспечения согласованности версий данных.
- Выберите образцы аккумуляторов, содержащие полные данные о количестве циклов, измерения емкости и как минимум одну непрерывную кривую заряда-разряда. Проверьте непрерывность, убедившись, что в течение одного цикла нет перерывов продолжительностью более двух часов и что фазы постоянного тока и постоянного напряжения зафиксированы полностью.
- Фильтрация необработанных записей циклов
- Отфильтруйте необработанные записи циклов, чтобы оставить образцы, содержащие измерения температуры, внутреннего сопротивления, кулоновской эффективности и энергоэффективности. Исключите из процесса анализа аккумуляторные ячейки, в которых отсутствуют эти обязательные каналы состояния, поскольку последующее многоканальное объединение признаков требует полного набора физических входных переменных.
- Удалите циклы, содержащие неполные записи, несогласованные временные метки, неопределенные процедуры тестирования или неясные условия прекращения заряда-разряда. Определите аномальные циклы как те, в которых наблюдается внезапное падение емкости более чем на 5% между соседними циклами, значения напряжения вне рабочего диапазона, специфичного для данной химии, или немонотонные интервалы временных меток.
- Создание временной базы данных аккумуляторов
- Организуйте сохраненные записи циклов в хронологическом порядке для создания базы данных временных рядов на уровне аккумулятора.
- Сохраните обработанные наборы данных в формате Hierarchical Data Format версии 5 (HDF5). Поддерживайте стандартизированную структуру каталогов, организованную по источнику набора данных, химической системе и индивидуальному идентификатору аккумуляторной ячейки.
- Присвойте уникальные идентификаторы отдельным аккумуляторным ячейкам перед разделением набора данных. При разделении данных на обучающую и тестовую выборки используйте группировку по идентификатору аккумуляторной ячейки, чтобы все последовательные циклы одного физического аккумулятора оставались исключительно в одном подмножестве данных.
ПРИМЕЧАНИЕ: Сохраните оригинальные необработанные наборы данных отдельно до проведения предварительной обработки, нормализации, ресемплирования или конструирования признаков.
- Определение окон наблюдения
- Сформируйте многоканальные окна наблюдения, используя первые 50 циклов, первые 100 циклов и первые 20% общего жизненного цикла аккумулятора. Рассчитайте порог в 20% жизненного цикла, умножив общий срок службы в циклах до достижения предела деградации емкости на 0.2.
- Перед построением тензора синхронизируйте измерения напряжения, тока, емкости, температуры, внутреннего сопротивления и эффективности внутри каждого окна наблюдения.
- Сформируйте окончательную входную структуру в виде трехмерного тензора, состоящего из длины окна наблюдения, 128 стандартизированных точек дискретизации внутри цикла и упорядоченного набора многоканальных признаков.
2. Предобработка данных и конструирование признаков
- Предварительная обработка необработанных данных циклирования
- Выполните единообразную предварительную обработку необработанных наборов данных циклирования для стандартизации качества данных из всех источников аккумуляторов. Все процедуры предварительной обработки, синхронизации и стандартизации выполняйте с помощью Python 3.10 с использованием библиотеки Pandas для работы с временными рядами и SciPy для численной интерполяции.
- Удалите выбросы, определите пропущенные значения, откалибруйте временные метки, идентифицируйте фазы заряда-разряда и нормализуйте частоту дискретизации перед последующим анализом. Для обнаружения аномалий примените модифицированный метод пороговой обработки Z-показателя с критерием отклонения более 3.0.
- Автоматически определите пропущенные значения с помощью идентификации флага NaN во всех числовых массивах. Разграничьте фазы заряда и разряда в соответствии с полярностью тока, присваивая положительные значения тока циклам заряда, а отрицательные — циклам разряда.
- Восстановите пропущенные сегменты сигнала с помощью кусочно-кубических интерполяционных полиномов Эрмита для сохранения электрохимической временной динамики при выравнивании фазовых переходов.
- Ресэмплинг кривых циклирования
- Выполните ресэмплинг кривых циклирования при обнаружении вариаций плотности дискретизации или дрейфа сигнала в наборах данных. Запускайте автоматический ресэмплинг всякий раз, когда интервал между последовательными измерениями отклоняется более чем на 10% относительно медианной частоты дискретизации соответствующей фазы циклирования.
- Стандартизируйте количество точек дискретизации в каждом цикле, чтобы уменьшить вариативность записи, зависящую от платформы. Перенесите все временные последовательности на фиксированную пространственную сетку с помощью одномерной линейной интерполяции.
- Сжимайте или расширяйте каждый профиль заряда-разряда ровно до 128 равноудаленных точек дискретизации перед построением тензора.
- Нормализация непрерывных переменных
- Нормализуйте все непрерывные переменные перед обучением модели для стабилизации сходимости сети и уменьшения смещения, связанного с масштабом. Примените Min-Max масштабирование, чтобы преобразовать все непрерывные переменные в числовой диапазон от 0 до 1.
- Вычисляйте все параметры нормализации исключительно на основе обучающего набора данных. Применяйте фиксированные параметры масштабирования к валидационным и тестовым наборам данных, чтобы снизить риск прямой утечки временных данных при прогнозировании ранних циклов.
- Построение многоканальных входных тензоров
- Разделите непрерывные записи циклирования для каждого аккумулятора на временные сегменты фиксированной длины. Структурируйте временные сегменты в соответствии с предопределенными окнами наблюдения, соответствующими первым 50 циклам, первым 100 циклам или первым 20% жизненного цикла аккумулятора.
- Выровняйте измерения напряжения, тока, емкости, температуры, внутреннего сопротивления и эффективности внутри каждого временного сегмента перед построением тензора.
- Объедините выровненные матрицы признаков в трехмерный тензор форматом (N × 128 × C), где N представляет длину окна наблюдения, 128 обозначает стандартизированные точки дискретизации внутри цикла, а C представляет общее количество каналов физических и синтетических признаков.
- Извлечение синтетических признаков
- Извлеките синтетические электрохимические признаки из необработанных сигналов циклирования для улучшения идентификации паттернов деградации. Рассчитайте признаки приращения емкости и дифференциального напряжения путем вычисления dQ/dV и dV/dQ по стандартизированной сетке дискретизации.
- Примените фильтрацию Савицкого–Голея для получения сглаженных кривых приращения емкости и дифференциального напряжения.
- Извлеките индикаторы деградации, включая сдвиги пикового напряжения, разности напряжений фазовых переходов и вариации энергопропускной способности от цикла к циклу, из отфильтрованных электрохимических признаков.
3. Построение и обучение модели глубокого обучения
- Создание моделей-кандидатов для прогнозирования
- Создайте стандартизированную среду обучения и оценки для всех моделей прогнозирования, представленных на Рисунке 1A. Реализуйте рабочий процесс глубокого обучения (DL) с использованием PyTorch версии 2.0 или выше.
- Выполните процесс обучения, используя модульные Python-скрипты для загрузки данных, инициализации модели, оптимизации и оценки.
- Подготовьте базовые модели традиционного машинного обучения (ML), включая линейную регрессию, случайный лес и модели градиентного бустинга над решающими деревьями. Настройте модель случайного леса, используя 100 деревьев и максимальную глубину 10.
- Настройте архитектуру градиентного бустинга над решающими деревьями с помощью библиотеки Scikit-learn, установив скорость обучения 0.1 и максимальную глубину дерева 5.
- Подготовьте архитектуры-кандидаты DL, включая многослойный перцептрон, одномерную CNN, сеть LSTM, CNN–LSTM и модели на основе трансформеров.
- Стандартизируйте основные гиперпараметры для всех архитектур DL, применив оптимизатор AdamW, функции активации GELU (Gaussian error linear unit), размерность скрытого слоя 128 и коэффициент дропаута 0.2.
- Конфигурация архитектуры CNN–LSTM
- Настройте архитектуру CNN–LSTM для объединения многоканальной информации о циклах из входных тензоров (Рисунок 1B). Сформируйте гибридную архитектуру, каскадировав сверточный экстрактор признаков в два стековых рекуррентных слоя, содержащих по 128 скрытых юнитов каждый.
- Завершите архитектуру тремя параллельными полносвязными регрессионными головками для одновременного прогнозирования SOH, RUL и доступной энергии разряда.
- Пропустите многоканальные входные тензоры через три последовательных одномерных сверточных слоя с размерами ядер 3, 5 и 7 для извлечения многомасштабных локализованных признаков.
- Применяйте пакетную нормализацию (batch normalization) после каждого сверточного слоя для повышения стабильности градиента в процессе оптимизации.
- Преобразуйте сверточные карты признаков в непрерывные временные последовательности перед моделированием последовательностей.
- Подайте закодированные временные последовательности в стековые рекуррентные слои для захвата долгосрочных зависимостей деградации в пределах заданных окон наблюдения.
- Разбиение наборов данных для обучения моделей
- Разделите обработанные наборы данных по аккумуляторным ячейкам на обучающую, валидационную и тестовую выборки в соотношении 70:15:15. Выполните разделение данных, используя фиксированное значение случайного зерна (random seed) 42.
- Примените стратифицированную выборку на основе химического состава аккумулятора для поддержания сбалансированного распределения деградации во всех подмножествах данных.
- Выполняйте разбиение наборов данных строго на уровне аккумуляторных ячеек, а не случайным образом по отдельным циклам, чтобы сохранить последовательные траектории деградации.
- Рассматривайте каждую аккумуляторную ячейку как неделимую единицу при разбиении, чтобы предотвратить утечку информации между наборами данных.
- Программным путем проверьте изоляцию наборов данных, вычислив пересечение идентификаторов аккумуляторных ячеек в обучающей, валидационной и тестовой выборках и подтвердив отсутствие перекрытий.
- Сформируйте внешний тестовый набор данных, используя полный набор данных литий-железо-фосфатных (LFP) аккумуляторов GOTION для оценки внераспределительного прогнозирования и анализа обобщающей способности между разными наборами данных.
- Разместите исходный код, файлы конфигурации среды и разделенные обработанные наборы данных в открытом доступе через специальный репозиторий GitHub для обеспечения методологической прозрачности и воспроизводимости.
- Инициализация обучения модели
- Перед началом обучения установите функцию потерь регрессии в виде среднеквадратичной ошибки. Вычислите общую целевую функцию обучения путем агрегирования значений потерь для каждой цели прогнозирования с использованием равных весов.
- Установите начальную скорость обучения 1 × 10⁻³ и выберите размер пакета (batch size) 32 или 64 в зависимости от размера набора данных.
- Используйте размер пакета 64 для наборов данных, содержащих более 5 000 циклов, для повышения эффективности использования оборудования. Используйте размер пакета 32 для меньших наборов данных для повышения стабильности оптимизации.
ПРИМЕЧАНИЕ: Подберите эти гиперпараметры с помощью предварительной оценки методом поиска по сетке (grid-search), чтобы сбалансировать скорость сходимости и стабильность градиента для различных окон наблюдения.
- Применение контроля обучения
- Примените динамический планировщик скорости обучения на основе изменений потерь на валидации. Снижайте скорость обучения в 0.5 раза, если потери на валидации не улучшаются в течение 5 последовательных эпох.
- Поддерживайте минимальный порог скорости обучения 1 × 10⁻⁵ в процессе оптимизации.
- Остановите обучение модели после максимум 100 эпох для уменьшения переобучения.
- Примените раннюю остановку, если потери на валидации не снижаются в течение 15 последовательных эпох. Восстановите веса модели, соответствующие итерации с наилучшим результатом на валидации.
- Ведение записей для воспроизводимости
- Установите фиксированное значение случайного зерна 42 перед инициализацией и обучением модели.
- Последовательно применяйте фиксированное случайное зерно в модуле random Python, NumPy и бэкенде PyTorch, отключив недетерминированные операции CUDA.
- Записывайте программную среду, версии зависимостей, настройки параметров, разделения данных и результаты обучения для каждого экспериментального прогона.
- Выполняйте все рабочие процессы DL в Ubuntu 22.04 с ускорением CUDA 11.8 на рабочей станции, оснащенной графическим процессором NVIDIA RTX 3090 или эквивалентным оборудованием.
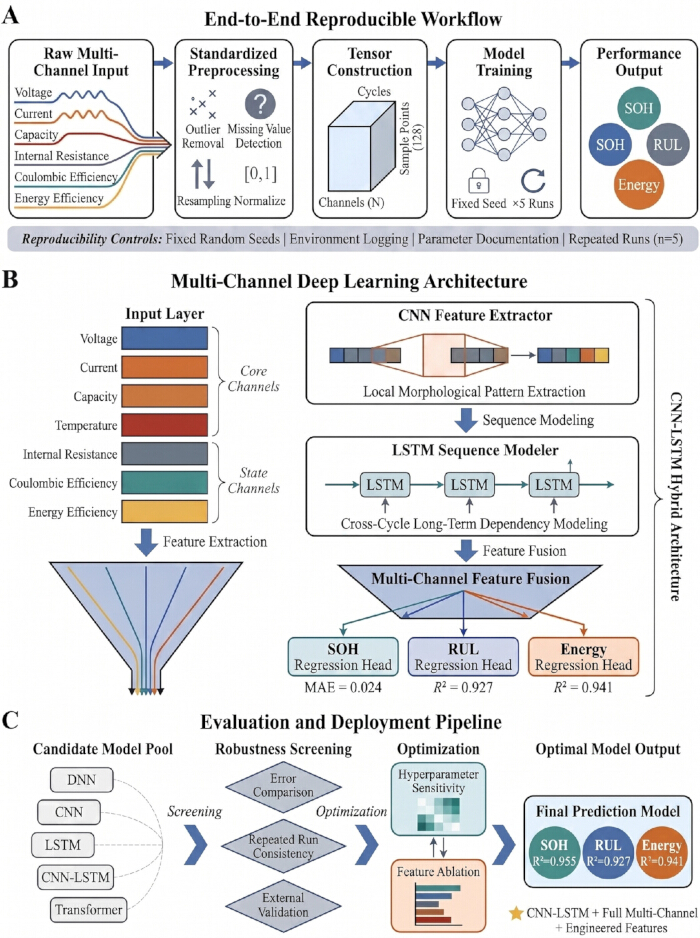
Рисунок 1. Воспроизводимый рабочий процесс глубокого обучения (DL) для прогнозирования характеристик многоканальных литий-ионных аккумуляторов. (A) Сквозной воспроизводимый рабочий процесс, иллюстрирующий многоканальный сбор данных, стандартизированную предобработку, построение тензоров, обучение модели и прогнозирование показателей эффективности аккумулятора. Контроль воспроизводимости включает фиксированные случайные числа (seed), повторные циклы обучения, отслеживание параметров и логирование среды. (B) Гибридная архитектура CNN–LSTM, используемая для многоканального извлечения признаков, моделирования временных последовательностей, слияния признаков и прогнозирования состояния здоровья (SOH), остаточного полезного ресурса (RUL) и разряжаемой энергии. (C) Конвейер оценки и развертывания, демонстрирующий скрининг моделей-кандидатов, оценку робастности, оптимизацию гиперпараметров и выбор окончательной модели. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
4. Оценка модели и предсказание мишеней
- Получение прогнозов модели
- Пропустите целевые наборы данных тестового пакета через каждую обученную модель. Перед выводом загрузите предварительно обработанные тестовые наборы данных в виде сериализованных тензоров PyTorch.
- Выполните прямой проход вывода, используя контекстный менеджер отключения градиентов, чтобы предотвратить непреднамеренное обновление параметров во время оценки.
- Сгенерируйте одновременные прогнозы для каждого показателя эффективности, используя обученные регрессионные головки.
- Извлеките одновременные выходные данные из трех параллельных регрессионных головок, настроенных для прогнозирования SOH, RUL и доступной энергии разряда.
- Расчет целевых показателей прогноза
- Рассчитайте SOH, сравнив текущую доступную емкость с начальной емкостью аккумулятора.
- Определите начальную емкость аккумулятора как максимальную емкость разряда, зафиксированную в течение первых трех стабилизационных циклов.
- Вычислите SOH как отношение емкости текущего цикла к установленному базовому значению начальной емкости.
- Оцените RUL, определив эксплуатационный порог, при котором стабильная емкость аккумулятора прекращается.
- Определите конец срока службы как номер цикла, при котором емкость аккумулятора необратимо снижается ниже 80% от номинальной расчетной емкости.
- Рассчитайте RUL как количество оставшихся циклов от текущей точки наблюдения до определенного порога окончания срока службы.
- Спрогнозируйте доступную энергию разряда на основе зафиксированных условий разряда.
- Вычислите истинное значение доступной энергии разряда путем численного интегрирования произведения напряжения и тока разряда на интервале разряда с использованием метода трапеций.
- Оценка прогностической эффективности
- Рассчитайте среднюю абсолютную ошибку (MAE), среднеквадратичную ошибку (RMSE), среднюю абсолютную процентную ошибку (MAPE) и коэффициент детерминации (R2) для каждого целевого показателя прогноза.
- Вычислите все метрики оценки с помощью модуля metrics библиотеки Scikit-learn, используя стандартные статистические формулы.
- Применяйте идентичные расчеты метрик для всех моделей, наборов данных и конфигураций входных данных для обеспечения согласованности оценки.
- Обобщите все метрики эффективности по всем объединенным образцам аккумуляторов в независимом тестовом наборе данных для оценки общей обобщающей способности модели.
- Отчет о стратифицированной эффективности
- Рассчитайте среднее значение и стандартное отклонение для каждой метрики оценки по повторяющимся экспериментальным прогонам.
- Получите отчетные статистические показатели на основе пяти независимых инициализаций модели.
- Укажите 95% доверительные интервалы вместе со средними метриками эффективности для количественной оценки неопределенности прогноза.
- Сравните эффективность модели при различной длине окна наблюдения и конфигурациях входных каналов.
- Проведите стратифицированный сравнительный анализ, используя окна наблюдения, соответствующие 50 циклам, 100 циклам и 200 циклам.
- Оцените прогностическую эффективность при различных конфигурациях входных данных: от вводов, содержащих только емкость, до полной интеграции многоканальных тензоров. См. Рисунок 1C для ознакомления с рабочим процессом оценки, проверки робастности и выбора для развертывания.
5. Анализ воспроизводимости, робастности и чувствительности
- Проверка воспроизводимости и робастности
- Соблюдайте идентичность разделения данных, рабочих процессов предобработки и экспериментальных процедур во всех оценках воспроизводимости, представленных на Рисунке 2A.
- Вычислите коэффициент вариации для основных метрик оценки в повторяющихся испытаниях для анализа согласованности воспроизводимости.
- Повторите все процедуры оценки, используя один и тот же стандартизированный рабочий процесс обучения и тестирования.
- Инициализируйте каждую повторную оценку с использованием рандомизированных весов сети, сохраняя при этом те же детерминированные процедуры загрузки и перемешивания данных.
- Проведение повторных экспериментов по обучению
- Неоднократно обучайте прогностические модели при идентичных экспериментальных условиях, используя предопределенные фиксированные значения случайных чисел (random-seed) для обеспечения воспроизводимой инициализации весов.
- Выполните пять независимых циклов обучения, используя идентичные разделения набора данных, чтобы снизить вариативность, обусловленную данными.
- Рассчитайте итоговые показатели эффективности путем усреднения метрик оценки, полученных в пяти повторных циклах обучения.
- Агрегируйте итоговые показатели робастности, используя усредненные баллы оценки, а не объединяя необработанные тензоры прогнозирования.
- Оценка чувствительности к гиперпараметрам
- В процессе анализа чувствительности по отдельности изменяйте скорость обучения, размер пакета (batch size), размерность скрытого слоя и коэффициент дропаута (dropout ratio).
- Оцените скорость обучения в диапазоне от 1 × 10⁻⁴ до 1 × 10⁻², размер пакета от 32 до 128, размерность скрытых слоев от 32 до 256 и коэффициент дропаута от 0,1 до 0,5.
- Записывайте соответствующие изменения точности прогнозирования после каждой корректировки гиперпараметра.
- Количественно определите вариативность прогностической эффективности с помощью RMSE и R2.
- Проведение анализа абляции признаков
- Исключите выбранные входные каналы, включая температуру, внутреннее сопротивление и векторы сконструированных признаков, из многоканального входного потока.
- Выполните абляцию признаков, используя стратегию исключения по одному (leave-one-out), удаляя по одной группе признаков за раз при сохранении оставшейся структуры многоканального входа.
- Сравните полученную прогностическую эффективность после каждого эксперимента по удалению признаков, чтобы оценить вклад отдельных групп признаков в стабильность и точность модели.
- Количественно определите относительный вклад каждой группы признаков, рассчитав процент увеличения средней абсолютной ошибки по сравнению с базовой моделью с полностью интегрированным многоканальным входом. См. Рисунок 2B для ознакомления с рабочим процессом оценки робастности и анализа чувствительности
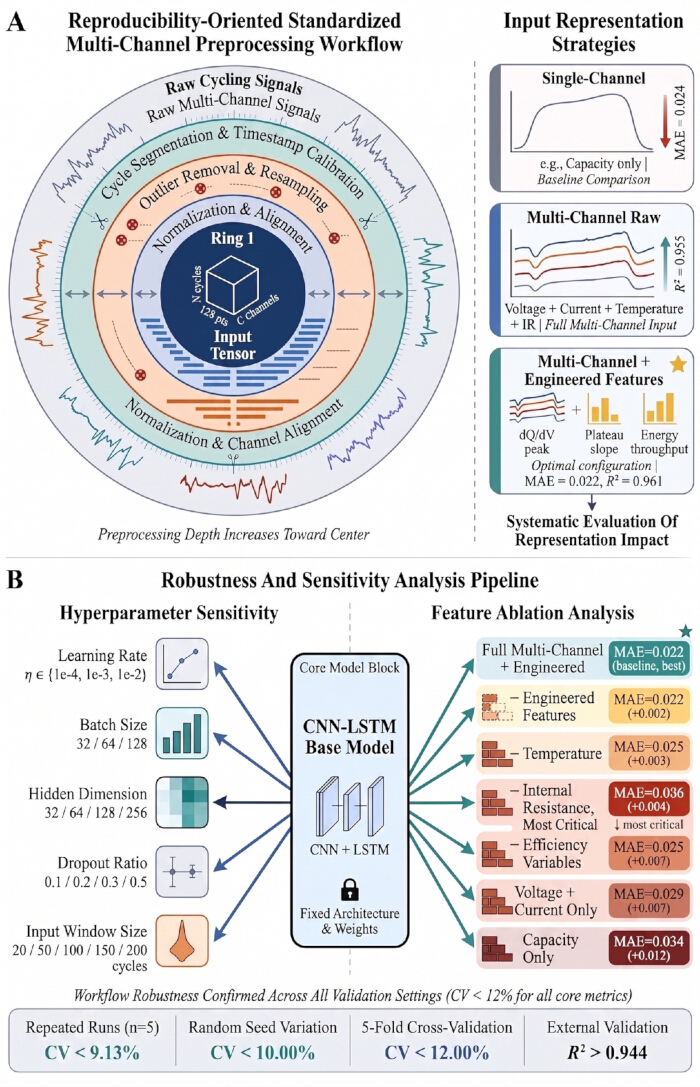
Рисунок 2. Стандартизированный рабочий процесс предобработки, оценки робастности и анализа чувствительности. (A) Стандартизированный рабочий процесс многоканальной предобработки, иллюстрирующий обработку необработанных циклических сигналов, калибровку временных меток, удаление выбросов, ресэмплинг, нормализацию, выравнивание каналов и построение тензора. Стратегии представления входных данных сравнивают одноканальные входные данные, многоканальные необработанные входные данные и многоканальные входные данные в сочетании с синтезированными признаками. (B) Конвейер анализа робастности и чувствительности, демонстрирующий систематическое возмущение гиперпараметров, оценку повторных запусков, анализ абляции признаков, перекрестную проверку и внешнюю валидацию рабочего процесса CNN–LSTM. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Результаты
Многоканальные циклические сигналы и распределение данных
Для характеристики поведения литий-ионных аккумуляторов в процессе циклирования были проанализированы репрезентативные многоканальные сигналы циклирования и распределения рабочих характеристик. В исследовании использовались пять наборов данных по литий-ионным аккумуляторам, представляющих несколько химических систем, включая кобальтированный оксид лития (LCO), никель-кобальт-алюминиевый оксид (NCA), никель-марганец-коба...
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Обсуждение
Воспроизводимый рабочий процесс глубокого обучения (DL), описанный в данном протоколе, продемонстрировал точное прогнозирование характеристик литий-ионных аккумуляторов с использованием многоканальных данных циклирования. В рамках оцениваемых экспериментальных условий данный рабочий процесс обеспечил среднюю абсолютную ошибку (MAE) на тестовой выборке 0,024 и значение R2 0,955 для оценки состояния здоровья (SOH), что подтверждает его потенциальную полезность для управления жизненным циклом аккумуляторов и прил...
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Раскрытие информации
Авторы заявляют об отсутствии конкурирующих финансовых интересов или конфликтов интересов.
Благодарности
Авторы выражают благодарность за институциональную поддержку кафедре физики Южного университета науки и технологий и колледжу Хомертон Кембриджского университета, которые обеспечили академическую среду и вычислительные ресурсы, необходимые для данного исследования. Авторы также благодарят исследовательские институты и участников, предоставивших открытый доступ к наборам данных по литий-ионным аккумуляторам, включая CALCE, SANYO, PANASONIC, KOKAM и GOTION, что позволило провести данный комплексный многоканальный анализ.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Материалы
| Имя | Компания | Каталожный номер | Комментарии |
|---|---|---|---|
| Набор данных по аккумуляторам CALCE | Центр передового проектирования жизненного цикла (CALCE), Мэрилендский университет | https://calce.umd.edu/battery-data | Источник многоканальных данных циклирования литий-ионных аккумуляторов для обучения и валидации моделей |
| CUDA Toolkit | NVIDIA | Версия 11.8 | GPU-ускорение для обучения моделей глубокого обучения (DL) |
| Набор данных GOTION IFP20100140A | Mendeley Data | https://doi.org/10.17632/vpw4t7ytbx.2 | Внешняя валидация и многоканальный анализ деградации аккумуляторов |
| Набор данных KOKAM SLPB533459H4 | Mendeley Data | https://doi.org/10.17632/7w4y4fzzbb.1 | Многоканальное моделирование и валидация деградации аккумуляторов |
| Matplotlib | Команда разработчиков Matplotlib | Версия 3.7.1 | Визуализация производительности модели, анализ чувствительности и результатов воспроизводимости |
| NumPy | Разработчики NumPy | Версия 1.24.3 | Численные вычисления и построение тензоров |
| Набор данных PANASONIC NCR18650BD | Mendeley Data | https://doi.org/10.17632/wykht8y7tg.1 | Источник многоканальных данных циклирования и извлечение сконструированных признаков |
| Pandas | Разработчики Pandas | Версия 2.0.3 | Организация данных, предобработка и управление табличными данными |
| PyTorch | PyTorch Foundation | Версия 2.0.1 | Построение и обучение архитектур глубокого обучения, включая модель CNN–LSTM |
| Python | Python Software Foundation | Версия 3.10.12 | Предобработка данных, проектирование признаков, обучение и оценка моделей |
| Набор данных SANYO UR18650E | Репозиторий прогностических данных NASA | https://ti.arc.nasa.gov/tech/dash/groups/pcoe/prognostic-data-repository/ | Источник многоканальных данных циклирования для оценки воспроизводимости и валидации моделей |
| Scikit-learn | Разработчики Scikit-learn | Версия 1.2.2 | Реализация базовых моделей, разделение наборов данных и расчет метрик производительности |
Ссылки
- Lu J, Xiong R, Tian J. Deep learning to estimate lithium-ion battery state of health without additional degradation experiments. Nat Commun. 2023;14:2760.
- Zhang H, Li Y, Zheng S. Battery lifetime prediction across diverse ageing conditions with inter-cell deep learning. Nat Mach Intell. 2025;7:270–7.
- Zhang Y, et al. State-of-health estimation for lithium-ion batteries via incremental energy analysis and hybrid deep learning model. Batteries. 2025;11(6):217.
- Liu C, et al. Deep learning for state of health estimation of lithium-ion batteries in electric vehicles: A systematic review. Energies. 2025;18(6):1463.
- Chen C, Wei J, Li Z. Remaining useful life prediction for lithium-ion batteries based on a hybrid deep learning model. Processes. 2023;11(8):2333.
- Chen B, et al. Lithium-ion battery state of health estimation based on feature reconstruction and Transformer-GRU parallel architecture. Energies. 2025;18(5):1236.
- Zhao W, Ding W, Zhang S, Zhang Z. Enhancing lithium-ion battery lifespan early prediction using a multi-branch vision transformer model. Energy. 2024;302:131816.
- Hu J, et al. Early prediction of lithium-ion battery degradation with a generative pre-trained transformer. Nat Commun. 2026;17:126.
- Li Y, et al. Accurate and adaptive state of health estimation for lithium-ion battery based on patch learning framework. Measurement. 2025;250:117083.
- Geng M, et al. Interpretable deep learning with uncertainty quantification for lithium-ion battery SOH estimation. Energy. 2025;335:138027.
- Li Y, et al. State-of-health prediction of lithium-ion batteries using feature fusion and a hybrid neural network model. Energy. 2025;319:135163.
- Zhou J, et al. Deep learning estimation of state of health for lithium-ion batteries using multi-level fusion features of discharge curves. J Power Sources. 2025;653:237781.
- Wang Y, et al. A comprehensive review of machine learning-based state of health estimation for lithium-ion batteries: Data, features, algorithms, and future challenges. Renew Sustain Energy Rev. 2025;224:116125.
- Severson KA, et al. Data-driven prediction of battery cycle life before capacity degradation. Nat Energy. 2019;4(5):383–91.
- Wu R, et al. Confidence-aware quantile Transformer for reliable degradation prediction of battery energy storage systems. Reliab Eng Syst Saf. 2025;260:111019.
- Yang H, et al. Privacy-preserving collaborative battery fault warning for massive electric vehicles by heterogeneous data from charging stations. Nat Commun. 2026;17:974.
- Liu Y, et al. A hybrid deep learning approach for remaining useful life prediction of lithium-ion batteries based on discharging fragments. Appl Energy. 2024;358:122555.
- Bockrath S, Lorentz V, Pruckner M. State of health estimation of lithium-ion batteries with a temporal convolutional neural network using partial load profiles. Appl Energy. 2023;329:120307.
- Zhang Z, et al. Multi-cycle charging information guided state of health estimation for lithium-ion batteries based on pre-trained large language model. Energy. 2024;313:133993.
- Li Z, Zhang X, Gao W. State of health estimation of lithium-ion battery during fast charging process based on BiLSTM-Transformer. Energy. 2024;311:133418.
- Bao X, et al. Hybrid deep neural network with dimension attention for state-of-health estimation of lithium-ion batteries. Energy. 2023;278:127734.
- He N, et al. Early prediction of battery lifetime based on graphical features and convolutional neural networks. Appl Energy. 2024;353:122048.
- Rieger LH, et al. Uncertainty-aware and explainable machine learning for early prediction of battery degradation trajectory. Digit Discov. 2023;2(1):112–22.
- Li H, et al. A cross-material lithium-ion battery state of health estimation method based on three-stage domain adaptation. Energy. 2025;139376.
- Han T, et al. Source-free dynamic weighted federated transfer learning for state-of-health estimation of lithium-ion batteries with data privacy. IEEE Trans Power Electron. 2024;39(11):15085–100.
- Rhyu J, et al. Systematic feature design for cycle life prediction of lithium-ion batteries during formation. Joule. 2025;9(5):101884.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.