Этот протокол описывает сетевой фармакологический процесс и молекулярное докирование для выявления потенциальных мишеней, сигнальных путей и взаимодействия соединения с мишенью Sishen Decoction при подагре.
Для просмотра этого контента требуется подписка на JoVE. Войдите или начните свой бесплатный пробный период.
Исследовательская статья
Интегрированный сетевой фармакологический анализ и молекулярный докинг сишеньского отвара выявляют потенциальные цели и пути при подагре
В этой статье
Краткое содержание
Аннотация
Подагра — это заболевание, характеризующееся гиперурикемией и отложением кристаллов уратов в суставах и мягких тканях, что приводит к рецидивирующему острому артриту. Растущая распространённость создаёт значительные клинические и социально-экономические нагрузки. Сишеньский отвар (SSD) применялся для лечения подагры, но его потенциальные молекулярные механизмы остаются неясными. В этом исследовании применялся интегрированный подход сетевой фармакологии и молекулярного докирования для выявления потенциальных мишень и сигнальных путей, связанных с SSD при подагре. Активные соединения и соответствующие мишени SSD были извлечены из базы данных традиционных китайских медицинских систем фармакологии (TCMSP), а связанные с подагрой мишени — из баз данных GeneCards и онлайн-менделевского наследования у человека (OMIM). Были выявлены перекрывающиеся мишени и использованы для построения сети препарат–компонент–мишень–болезни. Была создана сеть взаимодействия белков и белков (PPI) с использованием базы данных STRING Search Tool for the Retrieval of Interating Genes/Proteins. Были проведены анализы обогащения в Генной онтологии (GO) и Киотской энциклопедии генов и геномов (KEGG), после чего был проведен молекулярный стыковочный модуль с использованием модуля анализа сервера стыковки. Всего было связано 37 биоактивных соединений с 116 перекрывающимися целями, связанными с подагрою. Главными целями для узлов были TP53, IL6, IL1B, TNF, AKT1, EGFR, CASP3, JUN, BCL2 и MMP9. Анализ GO показал, что эти мишени участвуют в регуляции экспрессии генов и передаче сигналов. Анализ обогащения KEGG показал значимые связи с митоген-активированной протеинкиназой (MAPK), фосфоинозитид-3-киназой/протеинкиназой B (PI3K-Akt), интерлейкином-17 (IL-17) и сигнальными путями фактора опухолевой некрозы (TNF). Молекулярное стыковывание предсказывало благоприятные взаимодействия между ключевыми соединениями и мишенями хаба, при всех энергиях связи ≤−5 ккал/моль. Эти вычислительные результаты дают потенциальные механистические гипотезы о действии SSD при подагре и могут поддержать будущую экспериментальную валидацию.
Введение
Подагра — это заболевание, характеризующееся гиперурикемией и отложением кристаллов уратов в суставах и мягких тканях, что приводит к рецидивирующему остромуартриту 1. Его характерные черты включают повторяющиеся эпизоды сильной боли, покраснения, отёка и нарушения функциисуставов 2,3. Из-за основных пищевых факторов риска, таких как высокое потребление пурина и сахара, а также чрезмерное употребление алкоголя, распространённость подагры значительно выросла, что делает её серьёзной проблемой общественного здравоохранения, которая не только ухудшает качество жизни пациентов, но и накладывает значительные социально-экономическиенагрузки 4,5,6. Эффективное лечение подагры направлено как на устранение острых воспалительных обостряний, так и на долгосрочное снижение уровня мочевой кислоты всыворотке 7,8. Использование нестероидных противовоспалительных препаратов, колхицина или глюкокортикоидов для контроля острого воспаления подагры часто сопровождается рядом побочных эффектов, чаще всего — расстройствами желудочно-кишечноготракта 9,10. Кроме того, препараты для снижения урата, такие как бензбромарон, аллопуринол и фебуксостат, несут риск гепатотоксичности и гиперчувствительности, что ограничивает их более широкое клиническоеприменение 11,12. Поэтому изучение новых терапевтических стратегий, которые являются безопасными, эффективными и поддерживаются чётко определёнными механизмами, остаётся значительным клиническим значением.
Клиническая практика традиционной китайской медицины (ТКМ) в профилактике и лечении подагры имеет долгую историю. Практикующие из разных династий накопили обширный опыт применения ТКМ для лечения этого состояния с хорошо задокументированной терапевтической эффективностью. Благодаря целостной регуляции и многопутному вмешательству патологических процессов ТКМ демонстрирует особые терапевтическиепреимущества 13. Отвар Сышэн (SSD), происходящий из текста династии Цин «Недавно собранные проверенные формулы», состоит из пяти лекарственных трав: Astragalus membranaceus (Хуанци), Polygala tenuifolia (Юаньчжи), Achyranthes bidentata (Хуайнюси), Dendrobium nobile (Шиху) и Lonicera japonica (Цзиньиньхуа). Сообщается, что SSD снижает уровень мочевой кислоты и улучшает качество жизни пациентов с подаграй, усиливая жизненно важную ци, устраняя патогенные факторы и разблокируя сопутствующие вещества для облегченияболи 14,15. Эти терапевтические эффекты соответствуют целостным регуляторным принципам ТКМ. Её потенциальная активность может включать модуляцию сложной иммунно-метаболической нейроэндокринной сети, тем самым влияя на патологическую среду, связанную сподагрою16. Однако молекулярная основа, лежащая в основе терапевтического эффекта SSD при подагре, остаётся неясной. Кроме того, несмотря на предыдущие исследования SSD при других воспалительных заболеваниях, его потенциальные цели и пути при подагре не были систематически изучены с использованием интегрированного вычислительного подхода.
Сетевая фармакология, новая дисциплина, объединяющая системную биологию и полифармакологию, использует целостную стратегию «болезнь — ген — мишень — лекарство», которая естественным образом соответствует многокомпонентным и многоцелевым характеристикам формулТКМ 17,18. Молекулярное докингование дополняет этот подход, предсказывая способы связывания и аффинности между активными соединениями и целевые белки на молекулярном уровне, предоставляя тем самым подтверждающие доказательства предсказанныхвзаимодействий 19. Сочетание глобального скрининга на основе сетевой фармакологии и оценки мишени на основе молекулярного докирования может повысить надежность прогнозирования цели и снизить вероятность ложноположительных результатов, связанных с одним аналитическимметодом 20. Важно, что результаты, полученные этими вычислительными подходами, предоставляют проверяемые гипотезы, требующие последующего экспериментального подтверждения. Учитывая, что молекулярные механизмы SSD при подагре остаются слабо изученными, в данном исследовании использовалась интегрированная стратегия сетевой фармакологии и молекулярного докинга для выявления потенциальных мишеней, сигнальных путей и взаимодействий соединений с мишенью, связанных с SSD при подагре.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Протокол
Это вычислительное исследование на базе данных не включает участников на людях, эксперименты на животных или клинические образцы. Согласно статье 32 Китайских мер по этическому обзору наук о жизни и медицинских исследований с участием людей, исследования, использующие законно полученные публично доступные данные, не причиняющие вреда человеческим испытуемым, не содержащие чувствительной личной информации и не имеющие коммерческих интересов, подлежат освобождению от этической проверки. Поэтому этическое одобрение для этого исследования не требуется.
Экспериментальное проектирование и аналитический конвейер этого исследования иллюстрированы на блок-схеме (рисунок 1).
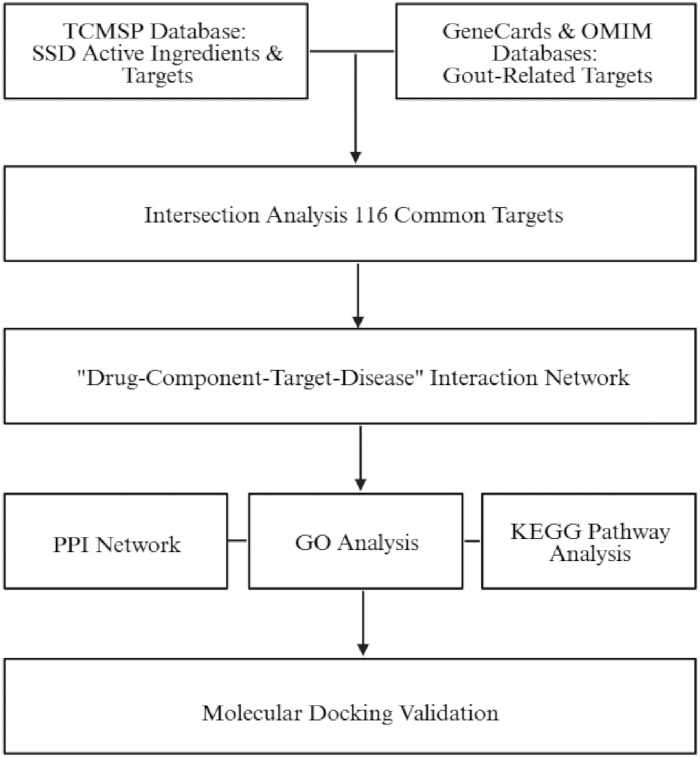
Рисунок 1: Общий рабочий процесс исследования . Блок-схема иллюстрирует последовательный рабочий процесс анализов фармакологии и молекулярного докинга, включая получение активных компонентов и мишень Сисеньского декокта (SSD), сбор мишеней, связанных с подагрою, выявление перекрывающихся мишеней, построение сети препарат–компонент–мишень–болезнь и сети взаимодействия белков (PPI), анализ обогащения Генной онтологии (GO) и Киотской энциклопедии генов и геномов (KEGG). а также молекулярные стыковочные симуляции. Пожалуйста, нажмите здесь, чтобы увидеть увеличенную версию этой фигуры.
Получение активных компонентов и целевых белков SSD
2 января 2026 года активные химические компоненты пяти трав, составляющих SSD — Хуанци, Юаньчжи, Хуайнюси, Шиху и Цзиньиньхуа — были извлечены из базы данных21 по фармакологии традиционных китайских медицинских систем (TCMSP). Были применены критерии скрининга, основанные на фармакокинетических свойствах: пероральная биодоступность (OB) ≥30% и похожие на лекарственные средства (DL) ≥0,1822. Компоненты, соответствующие этим критериям, рассматривались как потенциальные активные компоненты. Затем собирались соответствующие мишени для каждого компонента. Поскольку у TCMSP не было полных данных по Юаньчжи и Шиху, химические компоненты этих двух трав были дополнительно извлечены из базы данных Herb 2.0 в тот же день. После получения имён компонентов в TCMSP был выполнен обратный поиск с использованием имён компонентов и соответствующих номеров CAS в качестве ключевых слов для получения целевой информации. Для соединений, полученных из базы данных Herb, сохранялись только те, которые успешно сопоставили с записями в TCMSP по названию компонента или номеру CAS. Затем сопоставленные соединения подвергались тем же критериям фармакокинетического скрининга (OB ≥ 30% и DL ≥ 0,18) с использованием данных TCMSP, а соединения, не имеющие полной информации о OB или DL, были исключены. Все сопоставленные и отфильтрованные соединения были ручно проверены по оригинальным записям Herb 2.0, чтобы избежать ошибки. Впоследствии информация о целях, полученная из базы данных Herb, была объединена с данными оставшихся трав для создания полного набора активных ингредиентов для SSD.
Все полученные целевые белки были стандартизированы по официальным символам генов с использованием базы данных UniProt. Была установлена индивидуальная корреспонденция путём сохранения только работ, проверенных человеком (Swiss-Prot), и исключения непроверенных (TrEMBL) записей. Когда несколько изоформ соответствовали одному и тому же символу гена, выбиралась каноническая изоформа. Стандартизированный целевой набор данных сохранялся для последующего анализа пересекающихся генов.
Коллекция мишень, связанных с подагрой
2 января 2026 года были проведены систематические поиски в базе данных GeneCards и OMIM с использованием ключевого слова «подагра» в качестве заболевания для получения целевых целей, связанных с подагрою. Цели, полученные из двух баз данных, экспортировались в WPS Spreadsheets (версия 12.1.0). Столбец Gene Symbol из OMIM располагался рядом со столбцем GeneSymbol из GeneCards, а дублирующиеся цели удалялись с помощью функции «Remove Duplicates» на основе точного совпадения официальных символов генов без регистра. Целевые показатели из двух баз данных были объединены для создания комплексного набора целей, связанных с подагрою.
Выявление пересекающихся целей между лекарством и болезнью
Набор таргетов для лекарств, полученный при скрининге активных компонентов, и набор мишеней, связанных с подагрою, были помещены в одну папку проекта (D:\Venn). Было запущено программное обеспечение R (версия 4.4.0), а пакет readxl использовался для импорта файлов Excel (.xlsx с целевой таблицей. Пакет dplyr использовался для обработки данных, включая фильтрацию и переименование столбцов перед анализом пересечений. Два целевых набора затем преобразовывались в векторы символов, а перекрывающиеся цели были выявлены с помощью функции calculate.overlap() из пакета VennDiagram. Пакет VennDiagram устанавливался из CRAN с помощью команды install.packages("VennDiagram") и хранился в стандартном пути библиотеки R. Если появлялось сообщение о том, что пакет уже установлен, установка считалась успешной. Рабочая папка настраивалась с помощью команды setwd("D:\\Venn"), которая обозначала папку с входными файлами и служила выходной директорией. Затем был выполнен скрипт R для вычисления пересечения между набором целевых препаратов и набором мишеней, связанных с подагрою. Полученные перекрывающиеся мишени были определены как потенциальные терапевтические цели SSD для лечения подагры.
Создание сети «Лекарственные компоненты-таргет-болезни»
Пересекающиеся гены, выявленные в результате перекрытия между целями SSD и целями, связанными с подагрою, сохранялись в файле overlapping_targets.txt , а информация о активных компонентах SSD — в файле drug_components.txt . Оба файла помещались в папку проекта (D:\Network), которая служила рабочей директорией для анализа. Для обеспечения воспроизводимости этот анализ проводился с использованием R. Операции чтения, фильтрации и слияния данных выполнялись с использованием комбинации базовых функций R, включая read.table(), write.table() и merge(), а также пакет dplyr для обработки кадров данных. Команда setwd("D:\Network") выполнялась для явного определения рабочего каталога.
Функция graph_from_data_frame() использовалась как основная функция интеграции. Каждая строка drug_components.txt связывала активный компонент с соответствующим целевым геном с помощью официальных символов гена. Сохранялись только цели, присутствовавшие в overlapping_targets.txt , и дополнительной фильтрации не применялись сверх требования к пересечению. Полученный сетевой набор данных экспортировался в виде network.txt в формате edge-list. Каждая строка содержала два столбца (node1 и node2), где node1 представлял либо формулу SSD, либо активный компонент, а node2 — либо активный компонент, либо целевой ген. Узел болезни («подагра») был соединён с формулой SSD как отдельный край. Веса рёбер не присваивались, и все рёбра рассматривались одинаково (ширина рёбер = 0,8).
Файл network.txt был импортирован в программное обеспечение для визуализации сети Cytoscape (версия 3.7.2). Встроенный инструмент NetworkAnalyzer был использован через Tools → Network Analysis → Analyze Network для получения базовой структуры сети, и в качестве аналитической структуры была выбрана «Degree Distribution». Формы и цвета узлов были распределены в зависимости от типов узлов: синие ромбы — формулу SSD, синие прямоугольники — активные компоненты, оранжевые эллипсы — гены, связанные с болезнью, а красные восьмиугольники — сущность болезни подагры. Размер узла был установлен пропорционально степени узла (размер узла = 30 + градус × 5, максимальный размер = 100).
Построение сети взаимодействия белков и белков (PPI)
Фильтрованный набор пересекающихся целевых генов был импортирован в базу данных STRING (версия 12.0) 2 января 2026 года. Вид был ограничен Homo sapiens, минимальный порог доверия к взаимодействию был установлен на высоком уровне (0,700), разрозненные белки были скрыты, источники взаимодействия включали все доступные источники доказательств, а все остальные параметры сохранялись на своих настройках по умолчанию для получения известных и предсказуемых белок-белковых взаимодействий. Полученные сетевые данные экспортировались в формате значений с разделёнными вкладками (TSV) с использованием стандартных вариантов экспорта.
Экспортируемая сеть импортировалась в программное обеспечение визуализации сети для визуализации и топологического анализа. Свойства сети рассчитывались с помощью встроенного инструмента NetworkAnalyzer (Tools → Network Analysis → Analyze Network). Рассчитанные метрики включали степень, центральность промежуточности и центральность близости. Размеры узлов отображались в значения степеней с помощью функции непрерывного отображения (размер узла = 20 + степень × 3, максимальный размер = 80).
Цели хаба определялись путём ранжирования всех узлов по значениям степеней в убывающем порядке. Узлы с более высокими значениями степени считались более центральными в сети. Изолированные узлы (степень = 0) были исключены из визуализации. Схема сети была организована концентрическими кругами от центра наружу в соответствии с связностью узлов, а цвета узлов отображались с помощью градиента синего в циан, соответствующего возрастающим значениям градусов. Получившаяся сеть использовалась для выявления основных целей хаба, участвующих в потенциальном терапевтическом эффекте SSD против подагры.
Анализ обогащения генной онтологии (GO)
На основе выявленных перекрывающихся целевых генов был проведен функциональный анализ обогащения GO с использованием R. Необходимые пакеты биопроводников устанавливались в стандартный путь библиотеки R и загружались в среду анализа. Пересекающийся генный файл хранился в каталоге проекта (D:\GO), а рабочий каталог определялся с помощью функции setwd().
Преобразование и аннотация идентификаторов гена выполнялись с помощью org пакета Bioconductor. Hs.eg.db (версия 3.20.0). Официальные генные символы были преобразованы в идентификаторы генов Entrez с помощью функции bitr() в пакете анализа обогащения clusterProfiler (версия 4.21.0). Для дальнейших анализов сохранялись только гены с уникальными отображениями один к одному, тогда как неоднозначные или некартированные записи были исключены.
Анализ обогащения GO проводился с использованием пакета анализа обогащения. Функция enrichGO() использовалась с онтологическими категориями: Биологический процесс (BP), Клеточный компонент (CC) и Молекулярная функция (MF). Статистическая значимость определялась с помощью метода коррекции с множественным тестированием Бенджамини–Хохберга, при этом скорректированное P-значение < 0,05 считалось значимым.
Для каждой категории онтологий значительно обогащённые термины ранжировались по коэффициенту обогащения:
EF = (количество генов / общее количество фоновых генов) ÷ (размер термина / общий геном генома)
Для детального анализа были выбраны топ-10 терминов. При идентичных коэффициентах обогащения термины с более низкими скорректированными P-значениями ранжировались выше.
Результаты обогащения визуализировались с помощью ggplot2 (версия 3.5.1) и enrichplot (версия 1.24.0). Пузырьковые графики и столбчатые диаграммы генерировались с помощью функций dotplot() и barplot(). Размер пузыря отражал количество обогащённых генов, тогда как цвет соответствовал значимости обогащения, выраженной как −log10 (скорректированное P-значение). Параметры по умолчанию использовались на протяжении всего процесса.
Анализ обогащения путей KEGG
Анализ обогащения путей KEGG пересекающихся целей SSD и подагры был проведён с использованием R и ранее описанного пакета анализа обогащения. Генные символы преобразовывались в идентификаторы, совместимые с KEGG, с помощью функции bitr(), предоставляемой в пакете анализа обогащения, при этом KEGG служила ресурсом аннотаций. Анализ обогащения путей проводился с использованием функции enrichKEGG() на основе гипергеометрического теста. Статистическая значимость была определена с помощью метода коррекции с множественным тестированием Бенджамини–Хохберга (BH), а пути с скорректированным P-значением < 0,05 считались значительно обогащёнными.
Результаты обогащения экспортировались в совместимые с Microsoft Excel рабочие книги с использованием пакета openxlsx (версия 4.2.8.1) и функции write.xlsx() для последующего рассмотрения и подготовки рисунков.
Впоследствии с использованием программного обеспечения для визуализации сети была построена многоуровневая сеть взаимодействия целевой и публики. Сетевые данные импортировались с помощью File → Import → Network from File. Узлы состояли из целевых генных узлов и значительно обогащённых узлов пути KEGG (скорректированное по BH P-значение < 0,05), тогда как края представляли собой задокументированные ассоциации между целевые гены и обогащёнными путями, выявленными в ходе анализа обогащения. Визуализация сети проводилась с помощью панели Style программного обеспечения для визуализации сети, при этом целевые гены отображались в виде серых эллипсов, а пути — в виде циановых прямоугольников. Дополнительные плагины не использовались. Сеть генерировалась вручную из таблицы выхода обогащения для визуализации взаимосвязей между основными целями и значительно обогащёнными путями.
Валидация молекулярного стыковки
3D-структурные файлы (формат MOL2) десяти активных компонентов, ранжированных по целевой связности в сети «лекарство–компонент–цель–заболевание», были скачаны из базы данных TCMSP. Целевая связность определялась как степень узла (то есть количество прямых связей между активным компонентом и целевой генами в сети). Активные компоненты ранжировались в порядке убывания по значениям градусов, а топ-10 компонентов были выбраны для анализа молекулярного стыковки.
Кристаллические структуры топ-10 белков-мишеней, выявленных из сети PPI, были получены из Банка данных белков RCSB (PDB) 23 января 2026 года. Вид был ограничен Homo sapiens. Для каждого целевого белка предпочтительно выбиралась структура с самым высоким кристаллографическим разрешением (наименьшее значение Å), без мутаций и кокристаллизировавшейся с нативным лигандом или ингитором. Если несколько структур соответствовали этим критериям, выбиралась структура с самым высоким разрешением и полным покрытием белковых последовательностей. Использовались следующие структуры PDB: 1GKC (MMP9), 5WHH (BCL2), 2P33 (JUN), 1RHJ (CASP3), 1WT5 (EGFR), 7APJ (AKT1), 1DU3 (TNF), 1T4Q (IL1B), 4NI9 (IL6) и 9CKJ (TP53).
Симуляции молекулярного стыковки проводились с использованием онлайн-сервера CB-Dock 2 (веб-версия, доступ 23 января 2026 года), который использует AutoDock Vina в качестве стыковочного движка. Белковые структуры автоматически предварительно обрабатывались сервером, включая удаление гетероатомов и подготовку рецепторных структур. Лиганды загружались в формате MOL2. Использовалось обнаружение резонаторов, независимых от шаблона, при этом для каждой структуры белка автоматически определялись пять потенциальных связующих полости. Расчёты стыковки выполнялись с использованием стандартных параметров стыковочного двигателя: исчерпывающая мощность = 8, энергетический диапазон = 4 и максимальное количество режимов связки = 9.
Для каждой пары мишень–соединение стыковка выполнялась независимо внутри каждой из пяти обнаруженных полости. Позы стыковки оценивались с помощью функции оценки стыковочного двигателя, и поза с наименьшей энергией связи в каждой полости сохранялась как представительная конформация для этой полости. Из пяти представительных конформаций была выбрана поза стыковки с глобально самой низкой энергией связывания в качестве итогового результата стыковки для этой пары мишень–соединение и использована для последующих анализов.
Минимальное значение энергии связывания, полученное для каждого результата стыковки, фиксировалось в таблице и импортировалось в онлайн-платформу Weishengxin (доступ 23 января 2026 года) для создания тепловой карты с использованием стандартных параметров. Тепловая карта использовала цветовой градиент от жёлтого к красному, иерархическую кластеризацию по полным связям и евклидово расстояние в качестве метрики кластеризации.
Взаимодействия водородных связей автоматически идентифицировались модулем анализа сервера стыковки на основе геометрических критериев. Водородная связь определялась как взаимодействие с расстоянием донор–акцептор ≤ 3,5 Å и углом донор–водород–акцептор ≥ 120°. Водородные связи отображались пунктирными линиями как в двумерных, так и в трёхмерных диаграммах взаимодействия. Для детального анализа взаимодействия была выбрана целевой пара белок — активный компонент с глобально самой низкой энергией связи среди всех комбинаций стыковки. Этот отбор основывался на одной паре мишень–соединение, а не на индивидуальной позе стыковки, и был предназначен для выявления наиболее сильного прогнозируемого взаимодействия внутри сети. Для визуализации и анализа взаимодействия использовалась окончательная представительная поза стыковки, соответствующая этой паре мишень–соединение.
Трёхмерные и двумерные диаграммы взаимодействия были сгенерированы с использованием версий ChimeraX 1.5 и версии LigPlot+ 2.2 соответственно. В ChimeraX белки отображались с использованием стандартного мультяшного изображения, лиганды — в режиме стика, водородные связи — пунктирными линиями, а цветовая схема по умолчанию применялась. В LigPlot+ идентификация водородной связи проводилась с помощью алгоритма HBPLUS с порогом расстояния донор–акцептор 3,9 Å и пороговым углом 90°. Все остальные параметры визуализации остались на стандартных настройках.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Результаты
Терапевтические мишени SSD для подагры
Всего из базы данных TCMSP было извлечено 62 активных компонента SSD, соответствующих критериям скрининга, что соответствует 3 634 целям. Мишени, связанные с подагрой, были получены с помощью GeneCards и OMIM, и после удаления дубликатов было собрано всего 3 691 мишень. Пересечение мишеней, связанных с активными компонентами SSD, и мишенями, связанными с подаграй, дало 116 общих мишеней, которые рассматривались как потенциально т...
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Обсуждение
Подагра — это кристаллическая артропатия, вызванная отложением кристаллов уратов в суставах в результате гиперурикемии. Кристаллы мононатриевого урата (MSU) в полости сустава распознаваются рецепторами распознавания образов на поверхности макрофагов и нейтрофилов, что приводит к активации инфламмасомы семейства NOD-подобных рецепторов — 3 (NLRP3) с пириновым доменом и последующего высвобожденияIL-1β23. Этот процесс дополнительно запускает сигнальные пути, включая ...
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Раскрытие информации
Авторы не заявляют о конфликтах интересов.
Благодарности
Авторы заявляют, что финансовая поддержка для этой работы или её публикации не была получена.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Материалы
| Имя | Компания | Каталожный номер | Комментарии |
|---|---|---|---|
| AutoDock Vina | The Scripps Research Institute | Версия, интегрированная в веб-сервер CB-Dock 2 | Движок докинг-анализа, используемый для расчетов молекулярного докинга и оценки энергии связывания |
| CB-Dock 2 | Liu et al. (Nucleic Acids Research, 2022) | Веб-версия (выпущена в мае 2022 года); обращение 23 января 2026 года; URL: https://cadd.labshare.cn/cb-dock2 | Используется для моделирования молекулярного докинга между активными соединениями и целевыми белками |
| ChimeraX | UCSF Resource for Biocomputing, Visualization, and Informatics | Версия 1.5 | Используется для трехмерной визуализации докинг-комплексов |
| clusterProfiler | Bioconductor | Версия 4.21.0 | Используется для анализа обогащения GO и KEGG |
| Cytoscape | Cytoscape Consortium / Institute for Systems Biology | Версия 3.7.2 | Используется для построения сетей, визуализации и анализа PPI |
| dplyr | CRAN | Версия 1.2.1 | Используется для манипуляции данными и создания сетевых наборов данных |
| enrichplot | Bioconductor | Версия 1.24.0 | Используется для визуализации результатов обогащения GO и KEGG |
| GeneCards | Crown Human Genome Center, Weizmann Institute of Science | Версия 5.26; обращение 2 января 2026 года; URL: https://www.genecards.org | Используется для получения мишеней болезней, связанных с подагрой |
| ggplot2 | CRAN | Версия 3.5.1 | Используется для визуализации результатов обогащения GO |
| Herb Database | Fang et al. (Nucleic Acids Research, 2024) | Версия 2.0 (выпущена 15 марта 2023 года); обращение 2 января 2026 года; URL: http://herb.ac.cn/v2 | Используется для дополнения информации об активных соединениях для Yuanzhi и Shihu |
| LigPlot+ | European Bioinformatics Institute (EMBL-EBI) | Версия 2.2 | Используется для создания двухмерных диаграмм взаимодействия белок-лиганд |
| OMIM (Online Mendelian Inheritance in Man) | McKusick-Nathans Institute of Genetic Medicine, Johns Hopkins University School of Medicine | Обращение 2 января 2026 года; URL: https://omim.org | Используется для получения мишеней болезней, связанных с подагрой |
| openxlsx | CRAN | Версия 4.2.8.1 | Используется для экспорта и обработки электронных таблиц |
| org.Hs.eg.db | Bioconductor | Версия 3.20.0 | Пакет аннотации человеческого генома, используемый для конвертации и аннотации идентификаторов генов |
| Protein Data Bank (RCSB PDB) | RCSB PDB | Обращение 23 января 2026 года; URL: https://www.rcsb.org | Используется для получения кристаллических структур белков |
| R (The R Project for Statistical Computing) | R Foundation for Statistical Computing | Версия 4.4.0 | Используется для обработки данных, анализа обогащения и создания сетей |
| readxl | CRAN | Версия 1.5.0 | Используется для импорта электронных таблиц и обработки данных |
| STRING Database | EMBL / Szklarczyk et al. | Версия 12.0 (обращение 2 января 2026 года); URL: https://string-db.org | Используется для построения сети PPI |
| Traditional Chinese Medicine Systems Pharmacology Database and Analysis Platform (TCMSP) | Center for Bioinformatics, Northwest A&F University / Dalian University of Technology | Версия 2.3 (обращение 2 января 2026 года); URL: https://tcmsp-e.com | Используется для получения активных соединений и соответствующих мишеней |
| UniProt (Universal Protein Resource) | UniProt Consortium (EMBL-EBI / SIB / PIR) | Версия 202504 (обращение 2 января 2026 года); URL: https://www.uniprot.org | Используется для стандартизации мишеней и аннотации генов |
| VennDiagram | CRAN | Версия 1.7.3 | Используется для идентификации пересекающихся мишеней лекарств и болезней |
| Weishengxin Online Plotting Platform | Shanghai NewCore Biotechnology Co., Ltd. | Обращение 23 января 2026 года; URL: https://www.bioinformatics.com.cn | Используется для создания тепловых карт и визуализаций обогащения |
| WPS Spreadsheets | Kingsoft Office | Версия 12.1.0 | Используется для удаления дубликатов, управления электронными таблицами и обработки данных |