Предлагаемая архитектура MSCNN-LSTM объединяет многомасштабное извлечение пространственных признаков с моделированием временных последовательностей для распознавания действий в спортивных видеороликах, что позволяет фиксировать детализированные пространственные характеристики и паттерны временного движения, обеспечивая при этом высокую эффективность классификации на эталонных наборах данных спортивных действий.
Исследовательская статья
Распознавание действий в спортивных видео с использованием многомасштабных сверточных сетей с временным моделированием на основе долгой краткосрочной памяти (LSTM)
В этой статье
Краткое содержание
Аннотация
Распознавание действий на спортивных видеозаписях остается сложной задачей из-за комплексной динамики движения, окклюзии и высокой внутриклассовой вариативности. Хотя существующие подходы глубокого обучения, включая CNN-BiLSTM и модели на основе трансферного обучения, продемонстрировали эффективность в распознавании активности человека, их производительность может быть ограничена в спортивных сценариях с быстрыми и разнообразными движениями. Многие существующие методы опираются на одномасштабные сверточные фильтры, которые могут неэффективно захватывать одновременно как мелкозернистые, так и грубые характеристики движения. Чтобы устранить этот недостаток, в данном исследовании предлагается многомасштабная сверточная нейронная сеть (MSCNN), интегрированная с сетью долгой краткосрочной памяти (LSTM) для распознавания действий на спортивных видео. MSCNN извлекает пространственные представления в нескольких рецептивных полях с помощью параллельных сверточных ядер, что позволяет изучать как детальные, так и контекстные признаки движения. Затем эти признаки обрабатываются LSTM для захвата временных зависимостей и непрерывности движения в последовательных кадрах. Экспериментальная оценка проводилась на эталонных наборах данных UCF11, UCF Sports и JHMDB. Предложенная модель MSCNN-LSTM достигла точности классификации 98,3%, 95,4% и 81,7% соответственно, превзойдя сравнительные подходы, оцениваемые в данном исследовании. Исследование с удалением компонентов (ablation study) дополнительно продемонстрировало вклад многомасштабного извлечения признаков и временного моделирования в общую производительность. Эти результаты демонстрируют потенциал предложенной архитектуры по объединению пространственной и временной информации для распознавания действий на спортивных видеозаписях.
Введение
Распознавание действий человека находит широкое применение в различных реальных областях, включая интеллектуальное видеонаблюдение, обнаружение аномалий, аудиовизуальный поиск по действиям и мониторинг состояния пациентов в здравоохранении1,2. Распознавание действий, особенно в видеопотоках с систем наблюдения и платформ социальных сетей, обладает значительным потенциалом для обнаружения аномалий и понимания событий3. Действия человека идентифицируются при видеоанализе путем наблюдения за различными частями тела, такими как руки и ноги. В отличие от статических изображений, одного кадра часто недостаточно для представления действия4. Например, начальная поза при игре в футбол и прыжках через скакалку может выглядеть похоже на одном кадре. Различия между этими действиями становятся очевидными при наблюдении за последовательностью кадров, которые фиксируют паттерны движения и взаимодействие человеческого тела с окружающей средой5,6,7. Сокращения, используемые в данной работе, приведены в Таблице 1 для облегчения чтения и обеспечения согласованности терминологии.
| Сокращение | Полное наименование |
| AI | Искусственный интеллект |
| AUC | Площадь под кривой |
| BiLSTM | Двунаправленная долгая краткосрочная память |
| CNN | Сверточная нейронная сеть |
| CUDA | Compute Unified Device Architecture |
| F1-score | Гармоническое среднее точности и полноты |
| GPU | Графический процессор |
| HAR | Распознавание действий человека |
| JHMDB | Joint Human Motion DataBase |
| LSTM | Долгая краткосрочная память |
| mAP-T | Временная средняя средняя точность |
| MCC | Коэффициент корреляции Мэтьюса |
| MSCNN | Многомасштабная сверточная нейронная сеть |
| ROC | Рабочая характеристика приемника |
| TSI | Индекс временной стабильности |
| UCF | Центральный университет Флориды |
| VRAM | Видеопамять |
Таблица 1: Список сокращений, используемых в рукописи. Общие сокращения и акронимы, используемые в ходе исследования, и соответствующие им полные формы.
Быстрая и точная классификация спортивных видеороликов важна для широкого спектра приложений8,9,10, включая спортивную аналитику, обнаружение событий, поиск по содержимому и рекомендательные системы11,12,13. В связи с быстрым ростом объема видеоконтента, связанного со спортом, ограничения более ранних аналитических структур стали все более очевидными14. Следовательно, растет спрос на надежные подходы, способные справиться со сложностью и динамической природой спортивных мероприятий. Традиционные методы классификации спортивных видео в основном опирались на созданные вручную дескрипторы, такие как оптический поток и гистограмма ориентированных градиентов (HOG), для характеристики паттернов движения и действий в спортивных видеороликах15.
Сверточные нейронные сети (ConvNets), добившиеся значительных успехов в классификации статических изображений, также нашли применение в анализе видео. Однако распознавание действий остается более сложной задачей, так как видео содержат динамическую пространственно-временную информацию. Современные подходы на основе глубокого обучения в целом можно разделить на три группы: двухпотоковые сети16, 3D-сверточные сети и вычислительно эффективные архитектуры. Для извлечения временной информации из оптического потока двухпотоковые сети используют дополнительную ConvNet17,18, хотя такой подход является ресурсозатратным. В то время как 3D-сверточные архитектуры, такие как C3D, I3D и R3D, позволяют моделировать временную информацию напрямую, они существенно увеличивают количество параметров, что затрудняет оптимизацию. Вычислительно эффективные методы направлены на снижение сложности модели путем использования разложенных 3D-операций.
Более того, поскольку CNN способны извлекать локальные пространственные признаки, а LSTM — улавливать информацию о временном контексте, гибридные модели могут эффективно изучать пространственно-временные паттерны движения на основе данных с датчиков. Недавние исследования, сочетающие архитектуры CNN и рекуррентных нейронных сетей, дали обнадеживающие результаты18,19,20. Однако, так как LSTM сжимают информацию в процессе обработки последовательностей, шум, возникающий при извлечении признаков, может повлиять на точность распознавания. Чтобы решить эту проблему, в ряде исследований были внедрены механизмы внимания21,22. Механизмы внимания позволяют модели фокусироваться на признаках, наиболее значимых для задачи распознавания, тем самым повышая эффективность классификации.
Хотя глубокие двунаправленные модели LSTM в сочетании с извлечением признаков на основе CNN продемонстрировали многообещающие результаты в распознавании действий человека, при расширении этих структур для распознавания действий на спортивных видеозаписях сохраняется ряд проблем. Во-первых, существующие архитектуры CNN-LSTM часто используют одномасштабное сверточное извлечение признаков, что может ограничить их способность фиксировать действия, происходящие на нескольких пространственных и временных разрешениях, такие как одновременное движение игрока и объекта в спортивных сценах. Многомасштабные сверточные сети, включая 3D CNN23 и двухпотоковые CNN, продемонстрировали важность захвата пространственных признаков и признаков движения на разных масштабах, хотя эта концепция остается недостаточно изученной в гибридных системах на базе LSTM. Во-вторых, большинство предыдущих моделей CNN-BiLSTM24 сосредоточены преимущественно на краткосрочных временных зависимостях, в то время как непрерывность движения на длительных интервалах и взаимодействия между объектами, характерные для командных видов спорта, могут быть представлены недостаточно полно. Многие подходы на основе переноса обучения, такие как MobileNetV2 и ResNet, полагаются на признаки статических кадров и не в полной мере используют механизмы временного внимания или адаптивное многомасштабное слияние признаков25. Кроме того, большинство существующих моделей оценивались в основном на эталонных наборах данных, таких как UCF11 и JHMDB. Более современные специализированные спортивные наборы данных, фиксирующие сложные движения камеры и паттерны активности, такие как SoccerNet и FineGym, остаются недостаточно изученными. Эти ограничения подчеркивают необходимость создания системы многомасштабного сверточного извлечения признаков, интегрированной с модулями временной памяти, такими как сети LSTM или BiLSTM, для лучшего захвата как детальных пространственных представлений, так и долгосрочных временных зависимостей при распознавании действий на спортивных видеозаписях.
Кроме того, CNN способны извлекать локальные пространственные признаки, в то время как LSTM могут моделировать временной контекст. Таким образом, гибридные архитектуры CNN-RNN продемонстрировали многообещающие результаты в распознавании активности человека26,27. В последних исследованиях традиционные структуры CNN–LSTM были расширены за счет внедрения дополнительных стратегий обучения для улучшения распознавания человеческой активности. Например, были введены механизмы внимания (attention mechanisms), чтобы выделить релевантные задаче признаки и подавить менее информативные представления, тем самым повысив эффективность распознавания28. В других подходах применялось многозадачное обучение для совместной оптимизации задач распознавания действий и временной сегментации, что позволило повысить эффективность обучения и качество представления признаков29. Несмотря на эти достижения, существующие методы все еще могут иметь ограниченную способность различать визуально схожие действия, поскольку детальные пространственные и временные признаки не всегда захватываются эффективно. В Таблице 2 обобщены преимущества и недостатки существующих подходов30.
| Источник / Год | Используемый метод | Набор(ы) данных | Метрики эффективности | Основные преимущества | Ограничения |
| Hassan et al. (2024)1 | KFDI (Key Frame Dynamic Image) | UCF11 | Точность: 85.3% | Эффективный выбор ключевых кадров и улучшенное представление динамических изображений. | Чувствительность к ошибкам выбора кадров; ограниченное временное моделирование. |
| Zhou et al. (2023)24 | Dilated CNN + BiLSTM + Residual Block | UCF11, UCF Sports | Точность: UCF11: 89 и UCF Sports: 92.2% | Интеграция пространственного и временного обучения; захват многомасштабной информации. | Высокая вычислительная сложность; риск переобучения на малых наборах данных. |
| Ullah et al. (2025)34 | Local–Global Feature + QSVM | UCF11 | Точность: 82.6% | Сочетание созданных вручную и глубоких признаков для надежного распознавания. | Требуется ручная настройка; ограниченная масштабируемость. |
| Shin et al. (2025)25 | ViT-ReT (Vision Transformer + Recurrent Transformer) | UCF11, UCF50, UCF101 и JHMDB | Точность: UCF11: 97.73%; UCF50: 98.81%; UCF101: 98.46%; JHMDB: 83.38% | Захват долгосрочных пространственных и временных зависимостей. | Высокие вычислительные затраты и требования к объему данных. |
| Su et al. (2024)23 | 3D-CNN | UCF11 | Точность: 85.1% | Сквозное обучение пространственно-временных признаков. | Высокие требования к памяти и GPU. |
| Karuppannan et al. (2024)35 | Deep Autoencoder + CNN | UCF11 | Точность: 96.2% | Обучение компактным представлениям признаков. | Ограниченное долгосрочное временное моделирование. |
| Sahoo et al. (2020)36 | HAR-Depth | KTH, UCF sports, JHMDB, UCF101 и HMDB51 | Точность: KTH: 97.67%; UCF Sports: 95.00%; JHMDB: 73.13%; UCF101: 92.97%; HMDB51: 69.74% | Эффективное временное обучение на основе данных о глубине. | Требуется точная оценка глубины и обширная предварительная обработка. |
Таблица 2: Сравнение существующих методов глубокого обучения для распознавания действий на спортивных видеозаписях. Обзор репрезентативных подходов глубокого обучения, включая наборы данных, методологические характеристики, преимущества и ограничения, с указанием пробелов в исследованиях, которые устраняются предлагаемой структурой MSCNN-LSTM.
Предложена архитектура для анимации лица на основе аудиосинхронизации, объединяющая модель подавления шумов лица (Facial Denoiser Model, FDM) с локально-глобальной латентной диффузионной моделью (Local-to-global Latent Diffusion Model, LG-LDM) для создания эмоционально выразительной лицевой анимации. Для реконструкции детальной трехмерной геометрии лица и тонких вариаций мимики использовался эмоционально-центрированный векторно-квантованный вариационный автокодировщик (Emotion-centric Vector Quantized Variational Autoencoder, EVQ-VAE)31. Также была разработана архитектура роботизированного захвата с учетом окклюзии, использующая бинокулярное стереозрение для сегментации целей, локализации, вывода об окклюзии и оценки поз захвата нескольких целей в условиях частичного перекрытия32. Кроме того, представлена двухэтапная архитектура для извлечения поверхности земли из облаков точек с использованием сеточной проекции и адаптивного разделения на бины, где вероятности высоты и кривизны применялись для уточнения границ между землей и препятствиями после предварительного извлечения на основе анализа признаков в сетке33.
Несмотря на значительные успехи в распознавании действий на основе глубокого обучения, существующие методы по-прежнему с трудом справляются с высокой вариативностью и сложностью спортивных видео, включая резкие движения, перемещение камеры и взаимодействие нескольких игроков. Многие традиционные модели на базе CNN или LSTM работают в одном пространственном масштабе и поэтому могут оказаться недостаточно эффективными при одновременном захвате локальных и глобальных паттернов движения. Кроме того, сложной задачей остается поддержание временной когерентности в длительных последовательностях или при перекрывающихся действиях. Хотя методы трансферного обучения улучшили извлечение признаков, их адаптация к специализированным спортивным наборам данных остается относительно малоизученной.
Данное исследование направлено на разработку и оценку структуры многомасштабной сверточной нейронной сети с долгой краткосрочной памятью (MSCNN-LSTM) для распознавания действий на спортивных видеозаписях путем интеграции многомасштабного извлечения пространственных признаков с временным моделированием на базе LSTM для захвата как детальных пространственных характеристик, так и долгосрочных временных зависимостей. Предложенная структура использует взаимодополняющие сверточные ядра и многоуровневое слияние признаков для улучшения представления сложных спортивных действий в сложных условиях. Эффективность системы оценивалась на эталонных наборах данных UCF11, UCF Sports и JHMDB с использованием таких метрик, как точность (accuracy), прецизионность (precision), полнота (recall), F1-мера, средняя средняя точность во времени (mAP-T), индекс временной стабильности (TSI), коэффициент каппа Коэна (κ), коэффициент корреляции Мэтьюза (MCC) и площадь под ROC-кривой (AUC). Результаты экспериментов продемонстрировали конкурентоспособную эффективность по сравнению с методами, рассмотренными в данном исследовании, что подчеркивает потенциал данной структуры для спортивной аналитики, мониторинга показателей атлетов, автоматического обнаружения событий и анализа спортивного видеоконтента.
Протокол
В данном исследовании использовалась двухэтапная архитектура глубокого обучения для распознавания действий на спортивных видеозаписях, которая объединяет многомасштабную сверточную нейронную сеть (MSCNN) с сетью долгой краткосрочной памяти (LSTM). Для разработки и оценки модели использовались общедоступные эталонные наборы данных, а именно UCF11, UCF Sports и JHMDB. Новые данные от людей-участников не собирались, доступ к персональным данным не осуществлялся и их обработка не производилась. Поскольку исследование заключалось во вторичном анализе общедоступных анонимизированных наборов данных и не предполагало прямого участия людей, получение одобрения этического комитета учреждения и информированного согласия не требовалось.
Рабочий процесс включал выборку кадров и временную нормализацию с последующим извлечением признаков с помощью модуля MSCNN. Извлеченные признаки затем обрабатывались с использованием сети LSTM для временного моделирования и передавались на слой многоклассовой классификации. Наконец, модель была обучена и протестирована с использованием выбранных эталонных наборов данных. Рисунок 1 иллюстрирует общую архитектуру предлагаемой структуры.
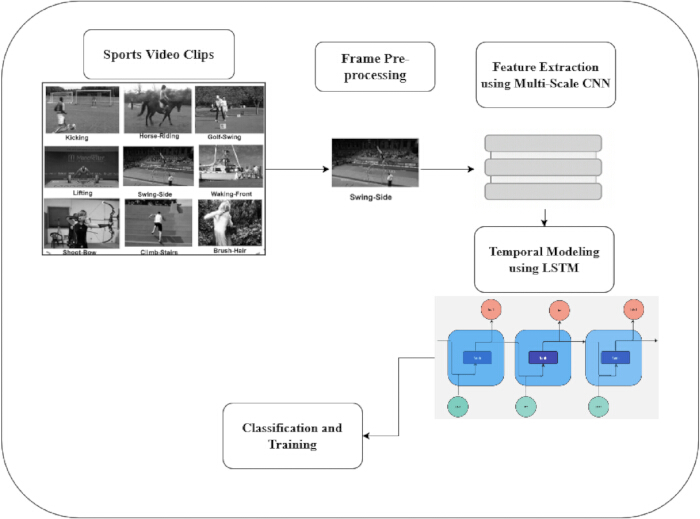
Рисунок 1: Предложенная архитектура MSCNN-LSTM для распознавания действий на спорческом видео. Общий рабочий процесс, иллюстрирующий предварительную обработку видео, многомасштабное извлечение пространственных признаков, обучение временным последовательностям и классификацию действий. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Рисунок 1 иллюстрирует рабочий процесс предлагаемой системы распознавания действий в спортивных видеороликах на основе гибридной архитектуры MSCNN-LSTM. Процесс начинается со спортивных видеоклипов, содержащих различные атлетические действия, включая удары по мячу, верховую езду и замах в гольфе. На этапе предобработки исходные видео были разложены на отдельные кадры, которые затем обрезались, стандартизировались и подготавливались для подачи на вход модели. Предобработанные кадры затем подавались в модуль MSCNN для извлечения признаков. Многомасштабная сверточная архитектура фиксирует пространственные признаки в различных рецептивных полях, что позволяет извлекать как локальную, так и контекстуальную информацию из кадров спортивного видео. Извлеченные векторы признаков затем обрабатывались сетью LSTM для моделирования временных зависимостей и эволюции движения в последовательных кадрах. Наконец, модуль классификации и обучения использовал изученные пространственно-временные представления для прогнозирования категории действия для каждого видеоклипа. Предложенная система состоит из четырех последовательных этапов, начиная со сбора и предобработки данных с использованием эталонных наборов данных UCF11 (YouTube Actions), UCF Sports и JHMDB. Каждое спортивное видео было преобразовано в последовательность кадров, которые были изменены по размеру, нормализованы и дополнены с помощью поворота, отражения и обрезки для повышения устойчивости к изменениям окружающей среды. Предобработанные кадры затем обрабатывались предлагаемой многомасштабной сверточной нейронной сетью (MSCNN), где параллельные сверточные ветви с ядрами 3 × 3, 5 × 5 и 7 × 7 извлекали взаимодополняющие локальные и контекстуальные пространственные признаки. Эти многомасштабные признаки объединялись и уточнялись с помощью пакетной нормализации и макс-пулинга для создания компактных представлений признаков. Полученные признаки на уровне кадров впоследствии передавались в сеть долгой краткосрочной памяти (LSTM) для моделирования временных зависимостей между последовательными кадрами. Конечные выходные данные LSTM выравнивались и проходили через полносвязные слои с активацией ReLU, после чего следовал классификатор Softmax для прогнозирования категории действия. Сеть обучалась с использованием оптимизатора Adam с функцией потерь перекрестной энтропии и регуляризацией dropout для уменьшения переобучения. Эффективность модели в итоге оценивалась на эталонных наборах данных UCF11, UCF Sports и JHMDB с использованием показателей точности (accuracy), прецизионности (precision), полноты (recall) и F1-меры (F1-score).
1. Сбор и предварительная обработка данных
В данном исследовании использовались три общедоступных эталонных набора данных (бенчмарка) для анализа спорта и действий человека. Эти наборы данных содержат реальные записи спортивных мероприятий с различными движениями камеры, ракурсами и сложностью фона. В частности, в работе использовался набор UCF11 (YouTube Actions) (https://www.crcv.ucf.edu/data/UCF_YouTube_Action.php), который включает 11 категорий действий, собранных из 1 168 видеороликов с YouTube, записанных примерно у 25 человек, с несколькими примерами для каждого действия. База данных совместно аннотированных движений человека (Joint-Annotated Human Motion Database, JHMDB)34,35 содержит 21 класс действий и 928 аннотированных видео. Набор данных UCF Sports состоит из 10 классов действий и 150 видеопоследовательностей, полученных из эфирных источников с разрешением 720 × 480 пикселей (https://www.crcv.ucf.edu/data/UCF_Sports_Action.php).
В совокупности эти наборы данных охватывают как индивидуальные, так и командные виды спорта и обеспечивают вариативность по временной продолжительности и визуальному масштабу для оценки предлагаемой структуры распознавания действий MSCNN-LSTM. В рамках процесса проверки качества данных наборы UCF11, UCF Sports и JHMDB были изучены на предмет поврежденных видео, дублирующих файлов и клипов с неполной аннотацией. Образцов, соответствующих этим критериям исключения, выявлено не было; следовательно, все доступные видео были сохранены для последующего анализа. Затем наборы данных были разделены на обучающую (70%), валидационную (15%) и тестовую (15%) подвыборки с использованием стратегии согласованного случайного разделения. На рисунке 2 представлены репрезентативные изображения, использованные для обучения и оценки.
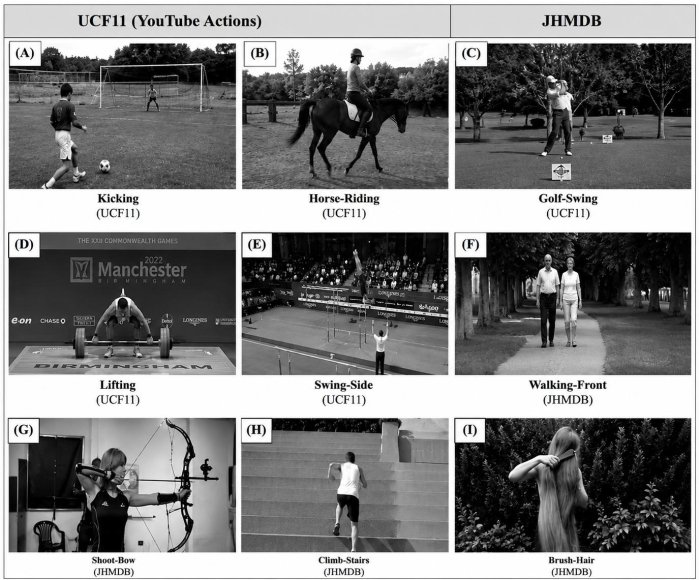
Рисунок 2: Репрезентативные кадры из эталонных наборов данных для распознавания спортивных действий. На панелях (A–D) представлены примеры из набора данных UCF11 (YouTube Actions), на панелях (E–H) — из набора данных UCF Sports, а на панелях (I–L) — из набора данных JHMDB. Кадры иллюстрируют вариации классов действий, ракурсов, фонов, условий освещения и сложности движения. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Предложенная модель распознавания действий была протестирована на эталонных наборах данных UCF11, UCF Sports и JHMDB, сведения о которых приведены в таблице 3. Эти наборы данных характеризуются разнообразными паттернами движения и сложными условиями окружающей среды. Набор данных UCF11 (YouTube Actions) содержит спортивные действия 11 классов, записанные при различном освещении, ракурсах и условиях фона. Набор данных UCF Sports состоит из 150 видеозаписей полевых видов спорта из профессиональных трансляций, содержащих реалистичные последовательности движений. Набор данных JHMDB предоставляет детальную разметку движений человека для 21 категории детальных действий и служит эталонным набором данных для пространственно-временного распознавания действий. В совокупности эти наборы данных использовались для оценки эффективности модели в сценариях спорта и действий человека. Сеть обучалась с использованием оптимизатора Adam в течение 100 эпох с размером пакета 32, начальной скоростью обучения 0.001 и функцией потерь перекрестной энтропии. Для окончательной оценки была выбрана модель с наименьшими потерями на валидационной выборке. Во всех экспериментах использовалось фиксированное случайное число (seed) 42. Для улучшения сходимости применялись ранняя остановка и снижение скорости обучения при выходе на плато, а во время обучения LSTM использовалось отсечение градиентов с порогом 5.0 для предотвращения их взрыва. Предложенная модель MSCNN-LSTM содержала примерно 15 миллионов обучаемых параметров. Конфигурация аппаратного и программного обеспечения, использованная при реализации, приведена в таблице 4. Поскольку распределение классов было достаточно сбалансированным, дополнительные процедуры взвешивания классов или ресэмплинга не применялись. Модели-конкуренты были реализованы с использованием гиперпараметров, указанных в их оригинальных исследованиях, при этом настройки обучения были гармонизированы там, где это было возможно. Значения эффективности представлены как среднее ± стандартное отклонение по результатам пяти независимых запусков с различными случайными инициализациями. Различия между предложенной моделью и моделями-конкурентами оценивались с помощью парных t-тестов при пороге значимости p < 0.05.
| Набор данных | Количество классов | Кол-во видео | Разрешение (пкс) | Пожалуйста, предоставьте исходный текст для перевода. | Описание |
| UCF11 (действия в YouTube) | 11 | 1168 | Переменное (≈ 320×240) | Центральный университет Флориды | Включает 11 видов действий человека в спорте (например, бросок в баскетболе, прыжки в воду, замах в гольфе, жонглирование мячом в футболе). Видеоматериалы собраны из YouTube и характеризуются значительным разнообразием освещения, ракурсов съемки и фонов. |
| Спортивные достижения UCF | 10 | 150 | 720×480 | Набор данных спортивных действий UCF | Содержит записи спортивных мероприятий, таких как прыжки в воду, верховая езда, замах в гольфе, бег и тяжелая атлетика, записанные из реальных телевизионных трансляций (BBC, ESPN). |
| JHMDB | 21 | 928 | 320×240 | Институт интеллектуальных систем Общества Макса Планка | Включает повседневную и спортивную деятельность, такую как ловля предметов, прыжки, расчесывание волос, стрельба и бег, с совместной разметкой для анализа движения и позы. |
Таблица 3: Характеристики эталонных наборов данных, использованных для обучения и оценки. Обзор наборов данных UCF11, UCF Sports и JHMDB, включая количество классов действий, видеообразцов, характеристики наборов данных, а также их роль в обучении, валидации и тестировании модели.
| Используемые параметры | Описание |
| Язык программирования | Python 3.8.18 [4] |
| Фреймворк глубокого обучения | TensorFlow 2.15.0 [1] |
| GPU-акселератор | NVIDIA GeForce RTX 3090 (24 ГБ видеопамяти) [1] |
| ЦП (центральный процессор) | Intel Core i9 @ 3,5 ГГц × 16 ядер |
| Операционная система | Windows 11 |
| Оперативная память (ОЗУ) | 64 ГБ DDR4 |
| Оптимизатор | Adam (скорость обучения = 0,001) |
| Размер партии | 32 |
| Количество эпох | 100 |
| Функции активации | ReLU (слои CNN), Softmax (выходной слой) |
| Доля выбывания | 0.5 |
Таблица 4: Симуляционная среда и конфигурация гиперпараметров предлагаемой модели MSCNN-LSTM. Технические характеристики оборудования, программная среда, настройки оптимизатора, скорость обучения, размер пакета, количество эпох, входные размерности и другие гиперпараметры, использованные при обучении и оценке модели.
2. Предварительная обработка
Перед обучением каждое исходное видео было преобразовано в упорядоченную по времени последовательность кадров, а затем нормализовано, подвергнуто временному сэмплированию и аугментации. Каждое входное видео V сначала преобразовывалось в последовательность кадров и представлялось в виде 4D-тензора V ∈ RT×H×W×C, где T — количество кадров, H × W i обозначает индекс кадра, а C — количество цветовых каналов (3 для RGB). Конвейер предобработки состоял из извлечения кадров, пространственного изменения размера с последующей центральной или случайной обрезкой до фиксированного разрешения (H′, W′), попиксельной нормализации интенсивности и опциональной аугментации данных, включая случайное отражение, масштабирование и цветовой джиттер, перед извлечением признаков. Конкретно, нормализация интенсивности была реализована либо как стандартная Z-нормализация, как в уравнении (1).
 (1)
где μ, σ — средние значения и стандартные отклонения по каналам, вычисленные на обучающей выборке, или же используется масштабирование min–max, как в уравнении (2).
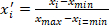 (2)
После нормализации каждый кадр представлялся как F̃t ∈ RH′×W′×C′, а результирующий видеотензор представлялся как V′ ∈ RT×H′×W′×C. В многомасштабном сверточном фронтенде несколько пространственных карт признаков с различными рецептивными полями получались путем применения нескольких 2D-сверток (или 3D-сверток для ранних пространственно-временных сверток) с разными размерами ядер; затем для каждого кадра или короткого видеоклипа формировалось временное представление признаков, которое передавалось в модуль LSTM. В оригинальной работе для временного моделирования использовались MobileNetV2, а затем Deep BiLSTM; вышеописанный конвейер предобработки полностью совместим с заменой на многомасштабную свертку + LSTM.
3. Отбор проб и временная нормализация
Поскольку длительность видео T различается между наборами данных и внутри них, мы проводим равномерную выборку или временной ресемплинг кадров, чтобы обеспечить многомасштабной свертке + LSTM фиксированную длину входных данных N в виде кадров или коротких фрагментов. Равномерные индексы кадров могут быть вычислены согласно уравнению (3),
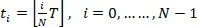 (3)
Таким образом, последовательность выбранных кадров представляет собой Vs = {F̃t0, …, F̃tN−1}. В случаях, когда требуется более высокая временная точность, выполняется линейная временная интерполяция: для любого передискретизированного дробного значения времени τ ∈ [0, T−1], вычисленного согласно уравнению (4).
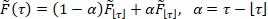 (4)
чтобы передискретизированная последовательность Vs содержала ровно N кадров и сохраняла плавность движения. В качестве альтернативы, дискретизация короткими непрерывными клипами (длина временного окна w с шагом s) дает набор тензоров клипов, где каждый клип Cj ∈ RT×H′×W′×C и j = 0, …, ⌊(T − w)/s⌋. Для временной нормализации внутри сети эффективен простой временной пулинг на нескольких масштабах: для последовательности временных признаков X = {x1, …, xN}, сгенерированной многомасштабными свертками, примените пулинг признаков, как показано в уравнении (5).
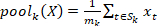 (5)
где Sк является ли временная поддержка для масштабирования к (например, Sк могут быть неперекрывающимися блоками или расширенными индексами) и мк = |Sк|.
Перед извлечением признаков все видео были масштабированы до 224 × 224 пикселей с частотой дискретизации 25 кадров в секунду. В каждом эксперименте использовалась постоянная длина последовательности, равная 32 кадрам. Методы аугментации данных включали случайную обрезку (масштаб = 0.8–1.0), случайный поворот (±15°), случайное горизонтальное отражение (вероятность = 0.5) и изменение яркости (±20%). Для стандартизации значений пикселей использовались средние значения ImageNet [0.485, 0.456, 0.406] и стандартные отклонения [0.229, 0.224, 0.225]. Для временной выборки в каждой видеопоследовательности применялся метод равномерного отбора кадров. Более длинные видео равномерно обрезались или подвергались выборке для сохранения постоянной длины последовательности, тогда как видео с количеством кадров менее 32 дополнялись нулями. Эти настройки неизменно использовались на протяжении всего процесса обучения и оценки.
4. Извлечение признаков с использованием MSCNN
Для улучшения пространственного представления действий в спортивных видеороликах была использована многомасштабная сверточная нейронная сеть (MSCNN). Традиционные сверточные нейронные сети, основанные на одном размере ядра, могут иметь ограниченные возможности при извлечении признаков в нескольких пространственных масштабах. Поскольку некоторые спортивные действия обладают схожими визуальными характеристиками, одномасштабной сверточной архитектуре может быть сложно одновременно фиксировать как локальные, так и глобальные признаки. Чтобы преодолеть это ограничение, в предлагаемой структуре используются сверточные ядра разных размеров для многомасштабного извлечения и слияния признаков.
В предлагаемой архитектуре сети использовались сверточные ядра 1 × 1 для организации информации по каналам и снижения размерности входных карт признаков. Кроме того, эти слои расширяют экспрессивные возможности сети за счет введения дополнительных преобразований признаков и нелинейных представлений. Сверточные ядра различных размеров позволяют извлекать пространственную информацию на нескольких масштабах. После взвешенного многомасштабного слияния признаков выполняется последовательная нормализация для повышения стабильности обучения. Чтобы смягчить проблемы затухания и взрыва градиентов при обучении глубокой сети, в предлагаемой архитектуре используются остаточные связи и временное моделирование на основе LSTM.
Многомасштабная архитектура расширяет возможности сети по захвату признаков при различных пространственных разрешениях и улучшает способность представления признаков. Кроме того, традиционное сверточное ядро N × N разлагается на операции свертки N × 1 и 1 × N. Свертки N × 1 и 1 × N, используемые в модуле MSCNN, предназначены для извлечения взаимодополняющих направленных и многомасштабных пространственных признаков из отдельных видеокадров. Эти операции свертки улучшают представление пространственных признаков за счет извлечения паттернов на разных масштабах рецептивного поля. Временные связи между последовательными кадрами впоследствии моделируются модулем LSTM, который обрабатывает последовательность признаков, извлеченных MSCNN, для изучения долгосрочных временных зависимостей с целью распознавания действий.
Каждое спортивное видео V = {F1, F2, …, FT} разлагается на T кадров. Для кодирования пространственных вариаций, например, позы игрока, размытия при движении, траектории мяча, используются сверточные ветви на трех различных масштабах s ∈ {1, 2, 3}, соответствующих размерам ядер 3 × 3, 5 × 5 и 7 × 7. Каждая ветвь извлекает карты признаков согласно уравнению (6):
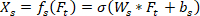 (6)
Где Ws и bs — веса и смещения свертки в масштабе s, а σ — функция активации ReLU. Слой многомасштабного слияния объединяет признаки согласно уравнению (7):
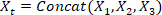 (7)
Этот объединенный тензор признаков включает в себя как детальные признаки движения, так и контекстную информацию по большим областям, такую как групповая активность. На Рисунке 3 показан только модуль извлечения признаков MSCNN. Слой LSTM (256 скрытых блоков), полносвязный слой (128 нейронов) и слой дропаута (0,5), используемые для временного моделирования и классификации, представлены отдельно на Рисунке 4.
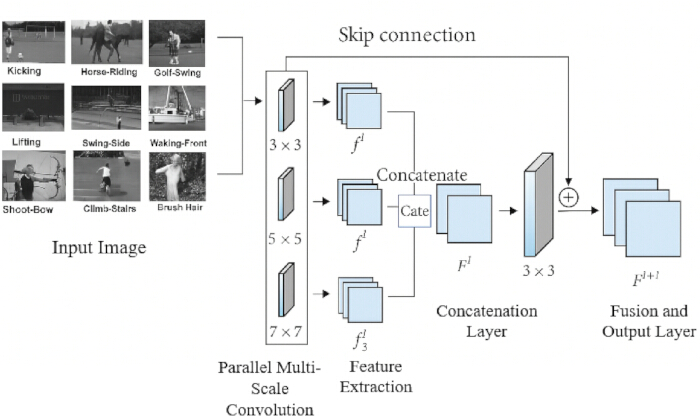
Рисунок 3: Предложенный модуль извлечения признаков многомасштабной сверточной нейронной сети (MSCNN). Три параллельные сверточные ветви с размерами ядер 3 × 3, 5 × 5 и 7 × 7 извлекают взаимодополняющие многомасштабные пространственные признаки, которые объединяются перед временным моделированием с помощью сети LSTM. Пожалуйста, нажмите здесь, чтобы просмотреть этот рисунок в большем размере.
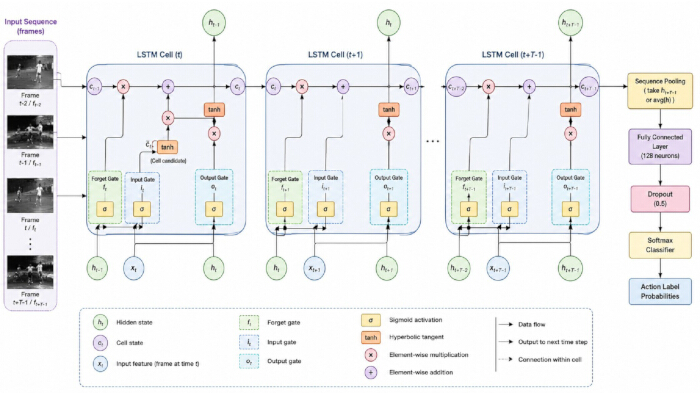
Рисунок 4: Предлагаемая архитектура LSTM для распознавания действий в спортивных видео. Модуль LSTM моделирует временные зависимости с помощью операций входного, забывающего и выходного гейтов в последовательных кадрах видео. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Рисунок 3 иллюстрирует предлагаемый модуль извлечения признаков на основе многомасштабной сверточной нейронной сети (MSCNN) для распознавания действий в спортивных видеороликах. Входные кадры видео обрабатывались параллельно тремя сверточными ветвями с размерами ядер 3 × 3, 5 × 5 и 7 × 7, каждая из которых содержала 64 фильтра для захвата взаимодополняющих мелкозернистых и крупнозернистых пространственных признаков. Результаты обрабатывались с помощью пакетной нормализации (Batch Normalization), функции активации ReLU и макспулинга 2 × 2, затем объединялись (конкатенировались) и объединялись с помощью свертки 1 × 1 со 128 фильтрами. Остаточная связь (residual skip connection) позволяла сохранить низкоуровневую пространственную информацию и улучшить поток градиентов. Объединенные карты признаков выравнивались и передавались на слой LSTM с 256 скрытыми блоками для временного моделирования, после чего следовал полносвязный слой со 128 нейронами, функцией активации ReLU и коэффициентом дропаута 0,5 перед финальной классификацией с использованием слоя Softmax. Многомасштабные карты признаков (f1l, f2l и f3l) конкатенировались для формирования объединенного представления (Fl), которое затем уточнялось с помощью свертки 3 × 3 для генерации выходной карты признаков для следующего слоя. Данная иерархическая архитектура позволила изучать взаимодополняющие пространственные признаки в нескольких рецептивных полях, что повысило эффективность распознавания спортивных действий.
5. Временное моделирование с использованием LSTM
Для моделирования временной эволюции по кадрам видео последовательность агрегированных признаков была подана в систему LSTM для фиксации динамических зависимостей и непрерывности движения. Для каждого входного видео мы сначала извлекали многомасштабные признаки CNN для каждого кадра. Пусть кадры видео будут I1, …, IT. Для каждого кадра t и каждого масштаба s многомасштабный сверточный кодировщик формирует вектор признаков ft(s) ∈ Rd. Затем масштабы объединяются в единый дескриптор кадра с помощью проекции + конкатенации или взвешенной суммы, как показано в уравнении (8):
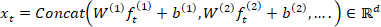 (8)
Затем подайте последовательность {xt}tT=1 в LSTM для моделирования временной динамики. В стандартном обозначении LSTM для момента времени t вентили и состояния определяются уравнениями (9)–(13):
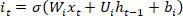 (9)
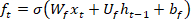 (10)
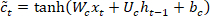 (11)
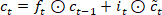 (12)
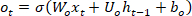 (13)
Здесь σ — сигмоидная функция активации, ⊙ — поэлементное умножение. Хотя для захвата временного контекста как прошлого, так и будущего могут быть использованы двунаправленные архитектуры LSTM, в предлагаемом фреймворке для моделирования временных зависимостей между последовательными кадрами видео используется стандартная LSTM. Данный выбор архитектуры соответствует структуре MSCNN-LSTM, представленной в настоящем исследовании. После обработки клипа было получено его представление (например, последнее скрытое состояние или временной пулинг): z = Poolt(vt).
Рисунок 4 иллюстрирует рабочий процесс предлагаемой архитектуры LSTM для распознавания спортивных действий. Сеть получала последовательность видеокадров или признаков, извлеченных с помощью CNN, и обрабатывала их на последовательных временных шагах (t−2, t−1 и t). Каждая ячейка LSTM состояла из входного вентиля, вентиля забывания и выходного вентиля, которые регулировали поток информации через сеть. Входной вентиль внедрял новую информацию в состояние ячейки, вентиль забывания удалял нерелевантную временную информацию, а выходной вентиль формировал скрытое состояние, передаваемое на последующий временной шаг. Состояние ячейки сохраняло долгосрочные временные зависимости, в то время как скрытое состояние фиксировало краткосрочную временную информацию. После последовательной обработки выходные данные LSTM объединялись (пулинг) для создания темпорального представления признаков, которое передавалось на полносвязный слой и классификатор Softmax для прогнозирования соответствующего спортивного действия. Сеть обучалась с использованием оптимизатора Adam в течение 100 эпох с размером батча 32, начальной скоростью обучения 0.001 и функцией потерь перекрестной энтропии. Для финальной оценки была выбрана модель с наименьшими потерями на валидации. Для обеспечения воспроизводимости все эксперименты проводились с использованием фиксированного случайного числа (seed) 42. Для улучшения сходимости применялись ранняя остановка и снижение скорости обучения при выходе на плато, а во время обучения LSTM использовалось отсечение градиентов с порогом 5.0 для предотвращения проблемы взрывающихся градиентов. Предложенная модель MSCNN-LSTM содержала приблизительно 15 миллионов обучаемых параметров.
Итоговые показатели классов и вероятности определяются с помощью линейного слоя и функции softmax, как показано в уравнении (14):
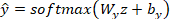 (14)
Обучение проводится путем минимизации перекрестной энтропии потерь по размеченным клипам, как показано в уравнении (15):
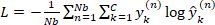 (15)
где Nb — размер пакета, C — количество классов, а y(n) — истинное значение в формате one-hot. Регуляризация (dropout для xt/выходов LSTM, weight decay). Для повышения стабильности при работе с длинными спортивными последовательностями применяется обрезка градиента (gradient clipping).
Результаты
Предложенная модель MSCNN-LSTM была обучена и протестирована на наборах данных UCF11 (YouTube Actions), UCF Sports и JHMDB, которые включали разнообразные спортивные действия, ракурсы съемки и паттерны движения. Поскольку распределение классов было достаточно сбалансированным, дополнительные процедуры взвешивания классов или ресэмплинга не применялись. Модели для сравнения были реализованы с использованием гиперпараметров, указанных в оригинальных исследованиях, при этом настройки обучения по возможности были гармонизированы. Результаты представлены в виде среднего значения ± стандартного отклонения по пяти независимым запускам с различными случайными инициализациями. Различия между предложенной и сравнительными моделями оценивались с помощью парных t-критериев при пороге значимости p < 0.05.
Рисунок 5 представляет сравнение точности классификации для трех наборов данных. Модель MSCNN-LSTM продемонстрировала наивысшую точность, достигшую 98.3% на UCF11, 95.4% на UCF Sports и 81.7% на JHMDB. Эти значения превысили показатели, полученные моделями Dilated CNN–BiLSTM, Two-Stream LSTM и ViT-ReT. Более низкая точность на JHMDB отражает бóльшую сложность распознавания детальных действий в видео с более низким разрешением.
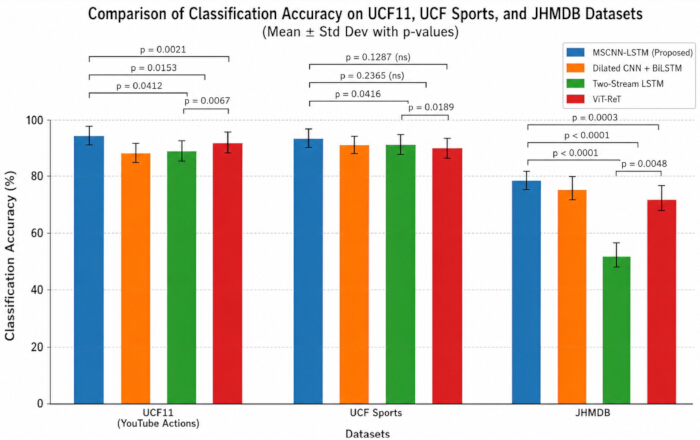
Рисунок 5: Сравнение точности классификации (%) различных моделей глубокого обучения на наборах данных видеороликов со спортивными событиями. Точность классификации MSCNN-LSTM, ViT-ReT, Two-Stream LSTM и Dilated CNN + BiLSTM на наборах данных UCF11, UCF Sports и JHMDB. Результаты представлены как среднее значение ± SD по пяти независимым запускам (n = 5). Планки погрешностей соответствуют одному стандартному отклонению. Статистическая значимость оценивалась с помощью двухсторонних парных t-критериев (p < 0.05). Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Предложенная модель также продемонстрировала самую высокую точность на всех наборах данных: значения составили примерно 96% для UCF11, 93% для UCF Sports и 78% для JHMDB (Рисунок 6). Показатели полноты составили приблизительно 95%, 94% и 77% соответственно (Рисунок 7), в то время как соответствующие значения F1-меры составили примерно 95,5%, 93,5% и 77,5% (Рисунок 8). Эти результаты указывают на то, что модель сохраняет оптимальный баланс между правильной идентификацией классов действий и ограничением количества ложноположительных прогнозов.
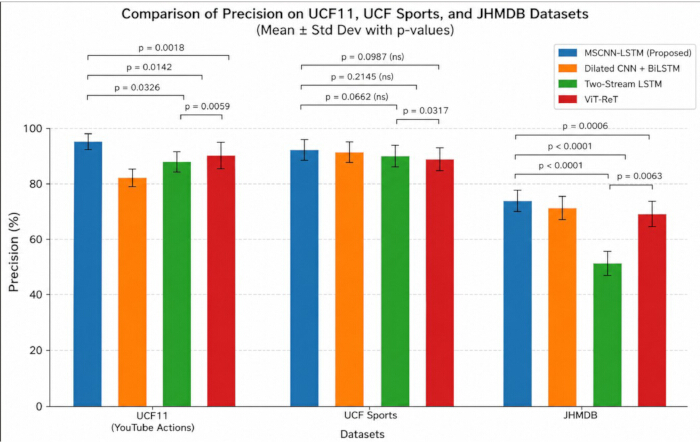
Рисунок 6: Сравнение точности (%) различных моделей глубокого обучения на наборах данных спортивных видео. Значения точности представлены как среднее ± SD по результатам пяти независимых запусков (n = 5). Планки погрешностей соответствуют одному стандартному отклонению. Статистическая значимость оценивалась с помощью двухсторонних парных t-критериев (p < 0.05). Пожалуйста, нажмите здесь, чтобы просмотреть этот рисунок в большем размере.
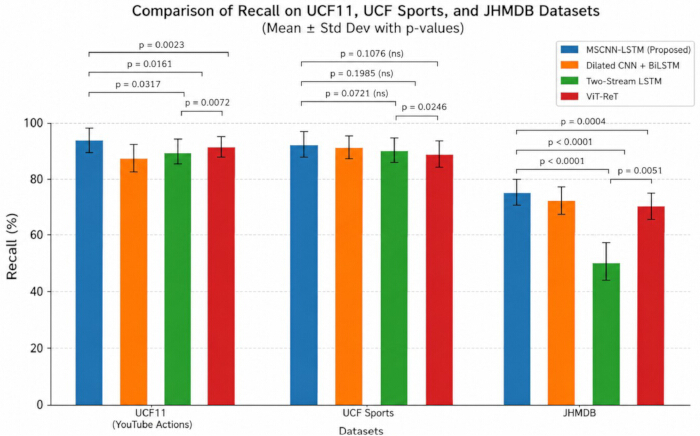
Рисунок 7: Сравнение полноты (%) различных моделей глубокого обучения на наборах данных спортивного видео. Значения полноты представлены как среднее ± SD по пяти независимым запускам (n = 5). Планки погрешностей соответствуют одному стандартному отклонению. Статистическая значимость оценивалась с помощью двухсторонних парных t-критериев (p < 0.05). Пожалуйста, нажмите здесь, чтобы просмотреть этот рисунок в большем размере.
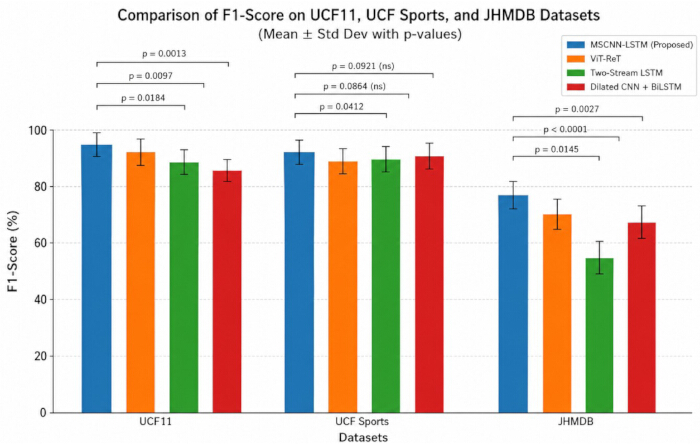
Рисунок 8: Сравнение F1-меры (%) различных моделей глубокого обучения на наборах данных спортивных видео. Значения F1-меры представлены как среднее ± SD по пяти независимым запускам (n = 5). Планки погрешностей соответствуют одному стандартному отклонению. Статистическая значимость оценивалась с помощью двухсторонних парных t-критериев (p < 0.05). Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Таблица 5 представляет результаты расчета каппы Коэна и корреляционного коэффициента Мэтьюза. На наборе данных UCF11 предлагаемая модель достигла κ = 0.96 и MCC = 0.96, по сравнению со значениями κ/MCC 0.92/0.92 для ViT-ReT, 0.90/0.90 для Two-Stream LSTM и 0.87/0.87 для Dilated CNN–BiLSTM. На наборе UCF Sports модель MSCNN-LSTM достигла κ = 0.95 и MCC = 0.94, превысив соответствующие значения, полученные для ViT-ReT (0.90/0.90), Two-Stream LSTM (0.88/0.89) и Dilated CNN–BiLSTM (0.84/0.85). На наборе JHMDB предлагаемая модель достигла κ = 0.83 и MCC = 0.84, по сравнению с 0.74/0.75 для ViT-ReT, 0.70/0.71 для Two-Stream LSTM и 0.71/0.72 для Dilated CNN–BiLSTM. Эти результаты продемонстрировали более высокую степень согласованности между прогнозируемыми и истинными метками для предлагаемой модели.
| Модель | Набор данных | Каппа Коэна (κ) | коэффициент корреляции Мэтьюза (MCC) |
| Разреженная CNN + BiLSTM [4] | UCF11 (действия в YouTube) | 0.87 ± 0.01 | 0.88 ± 0.01 |
| Спорт UCF | 0.84 ± 0.02 | 0.85 ± 0.02 | |
| JHMDB | 0.71 ± 0.03 | 0.72 ± 0.03 | |
| Двухпотоковый LSTM [38] | UCF11 (Действия в YouTube) | 0.90 ± 0.01 | 0.91 ± 0.01 |
| Спорт UCF | 0.88 ± 0.02 | 0.89 ± 0.02 | |
| JHMDB | 0.70 ± 0.03 | 0.71 ± 0.03 | |
| ViT-ReT (Vision Transformer + Recurrent Transformer) [6] | UCF11 (Действия в YouTube) | 0.92 ± 0.01 | 0.92 ± 0.01 |
| Спорт UCF | 0.90 ± 0.01 | 0.90 ± 0.01 | |
| JHMDB | 0.74 ± 0.02 | 0.75 ± 0.02 | |
| Предлагаемая модель MSCNN–LSTM | UCF11 (действия в YouTube) | 0.96 ± 0.01 | 0.96 ± 0.01 |
| Спорт UCF | 0.95 ± 0.01 | 0.94 ± 0.01 | |
| JHMDB | 0.83 ± 0.02 | 0.84 ± 0.02 |
Таблица 5: Сравнение каппа Коэна (κ) и коэффициента корреляции Мэтьюза (MCC) для различных моделей глубокого обучения. Сравнение производительности MSCNN-LSTM, ViT-ReT, Two-Stream LSTM и Dilated CNN + BiLSTM на наборах данных UCF11, UCF Sports и JHMDB. Более высокие значения указывают на более сильное соответствие между прогнозируемыми и истинными метками, а также на более высокую надежность классификации. Значения представлены как среднее ± SD по результатам пяти независимых запусков (n = 5).
Рисунок 9 представляет рабочие характеристики приемника (ROC-кривые). Предложенная модель MSCNN-LSTM достигла значений AUC 0,975 на UCF11, 0,961 на UCF Sports и 0,937 на JHMDB. Стабильно высокие значения AUC свидетельствуют о сильной дискриминации между классами действий в наборах данных различной сложности.
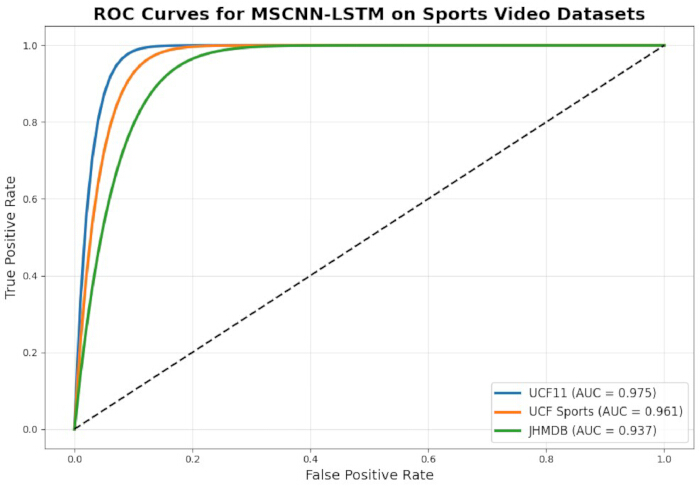
Рисунок 9: Операционные характеристики приемника (ROC-кривые) предложенной модели MSCNN-LSTM. ROC-кривые для наборов данных UCF11, UCF Sports и JHMDB, иллюстрирующие соотношение между долей истинно положительных и ложноположительных результатов. Площадь под кривой (AUC) обобщает дискриминационную способность модели при различных порогах классификации. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Результаты временной эффективности обобщены в Таблице 6. На наборе данных UCF11 предложенная модель достигла mAP-T 98.3%, точности на уровне кадра 96.5% и TSI 0.95. Для UCF Sports соответствующие значения составили 95.4%, 94.0% и 0.93. На JHMDB модель достигла mAP-T 81.7%, точности на уровне кадра 78.9% и TSI 0.88 (Таблица 7). Эти значения оказались выше показателей моделей для сравнения, что свидетельствует о повышенной временной когерентности и стабильности прогнозирования как для коротких, так и для длительных последовательностей действий.
| Метод | Набор данных | mAP-T (%) | Точность на уровне кадра (%) | Индекс временной стабильности (TSI) |
| Разреженная CNN + BiLSTM4 | UCF11 (Действия в YouTube) | 93.6 ± 0.8 | 91.8 ± 0.9 | 0.87 ± 0.01 |
| Спорт UCF | 90.2 ± 1.0 | 89.1 ± 1.1 | 0.83 ± 0.02 | |
| JHMDB | 72.4 ± 1.5 | 70.3 ± 1.7 | 0.78 ± 0.03 | |
| Двухпотоковая LSTM38 | UCF11 (Действия в YouTube) | 94.8 ± 0.7 | 92.6 ± 0.8 | 0.89 ± 0.01 |
| Спорт UCF | 91.3 ± 0.9 | 90.0 ± 1.0 | 0.85 ± 0.02 | |
| JHMDB | 73.8 ± 1.4 | 71.5 ± 1.6 | 0.79 ± 0.03 | |
| ViT-ReT (Vision Transformer + Recurrent Transformer)6 | UCF11 (Действия в YouTube) | 95.5 ± 0.6 | 93.4 ± 0.7 | 0.90 ± 0.01 |
| Спорт UCF | 92.4 ± 0.8 | 91.2 ± 0.9 | 0.87 ± 0.01 | |
| JHMDB | 74.6 ± 1.3 | 72.8 ± 1.4 | 0.81 ± 0.02 | |
| . | UCF11 (действия в YouTube) | 98.3 ± 0.5 | 96.5 ± 0.6 | 0.95 ± 0.01 |
| Спорт UCF | 95.4 ± 0.7 | 94.0 ± 0.8 | 0.93 ± 0.01 | |
| JHMDB | 81.7 ± 1.1 | 78.9 ± 1.3 | 0.88 ± 0.02 |
Таблица 6: Сравнение показателей временной эффективности для распознавания действий на спортивных видео. Экспериментальные результаты средней средней точности по временным сегментам (mAP-T), точности на уровне кадров и индекса временной стабильности (TSI) для различных моделей глубокого обучения на контрольных наборах данных. Значения представлены как среднее ± SD по пяти независимым запускам (n = 5).
| Конфигурация | Мультимасштабная CNN (MSCNN) | LSTM | Точность (%) | F1-мера (%) | mAP-T (%) |
| Базовая модель только с CNN | ✗ | ✗ | 90.4 ± 1.2 | 89.8 ± 1.3 | 88.9 ± 1.4 |
| CNN + LSTM | ✗ | ✓ | 93.1 ± 0.9 | 92.4 ± 1.0 | 91.7 ± 1.1 |
| Только MSCNN | ✓ | ✗ | 94.2 ± 0.8 | 93.6 ± 0.9 | 92.8 ± 1.0 |
| Предлагаемая модель MSCNN-LSTM | ✓ | ✓ | 98.3 ± 0.5 | 97.8 ± 0.6 | 97.1 ± 0.6 |
Таблица 7: Абляционный анализ предлагаемой архитектуры MSCNN-LSTM. Вклад компонентов MSCNN и LSTM в общую эффективность при идентичных настройках обучения и оценки. Значения представлены как среднее ± SD по результатам пяти независимых запусков (n = 5).
Рисунок 10, Рисунок 11, Рисунок 12 представляют собой нормализованные по строкам матрицы ошибок для UCF11, UCF Sports и JHMDB соответственно. Все три матрицы продемонстрировали выраженное доминирование на главной диагонали, что указывает на правильную идентификацию большинства классов действий. Незначительные внедиагональные ошибки возникали преимущественно между действиями со схожими визуальными или кинетическими характеристиками. Матрица JHMDB продемонстрировала сравнительно более выраженную путаницу классов, что согласуется с более низкими количественными показателями эффективности, наблюдаемыми на этом более сложном наборе данных.
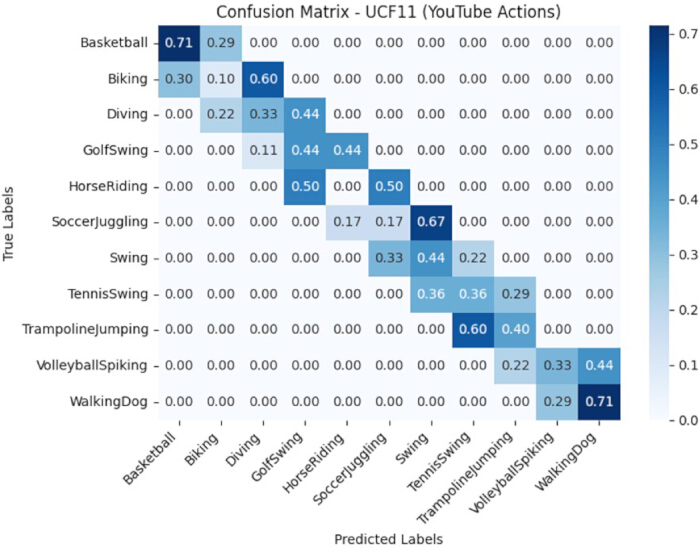
Рисунок 10: Нормированная по строкам матрица ошибок предлагаемой модели MSCNN-LSTM на наборе данных UCF11. Каждая строка нормирована до единицы, и диагональные элементы представляют полноту (recall) по классам, а не общую точность классификации, которая приводится отдельно. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
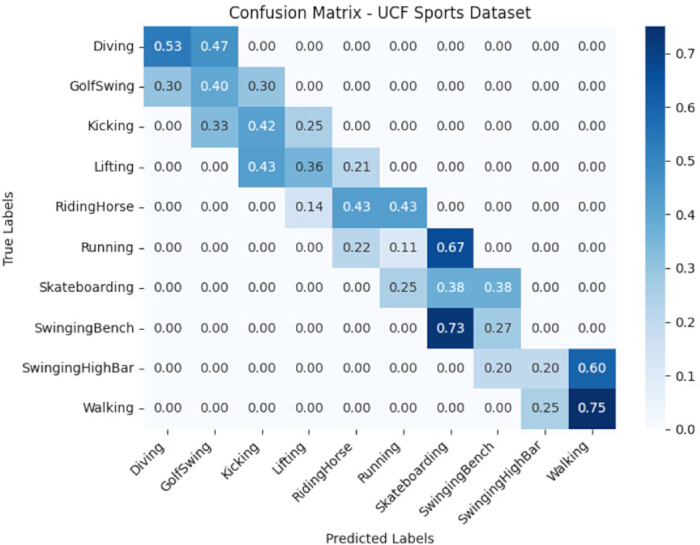
Рисунок 11: Нормализованная по строкам матрица ошибок предложенной модели MSCNN-LSTM на наборе данных UCF Sports. Каждая строка нормализована до единицы, а диагональные элементы представляют полноту (recall) по каждому классу, а не общую точность классификации, которая приводится отдельно. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
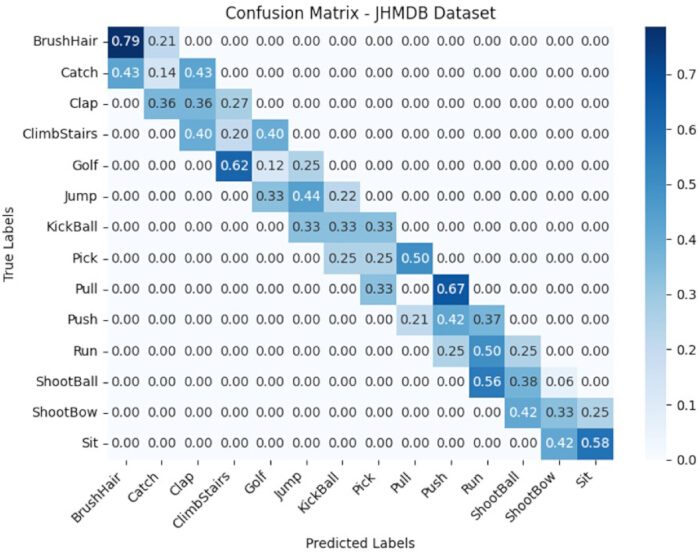
Рисунок 12: Нормированная по строкам матрица ошибок предлагаемой модели MSCNN-LSTM на наборе данных JHMDB. Каждая строка приведена к единице; диагональные элементы представляют полноту (recall) для каждого класса, а не общую точность классификации, которая приводится отдельно. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
В целом, предложенная архитектура MSCNN-LSTM последовательно демонстрировала лучшие результаты по сравнению с оцениваемыми моделями-компараторами по показателям классификации, согласованности, дискриминации и временной стабильности. Полученные данные подтвердили гипотезу о том, что сочетание многомасштабного извлечения пространственных признаков с временным моделированием на основе LSTM улучшает распознавание спортивных действий в наборах данных с различной сложностью движений, качеством изображений и условиями ракурса.
ДОСТУПНОСТЬ ДАННЫХ:
Наборы данных, проанализированные в ходе настоящего исследования, находятся в открытом доступе и доступны по следующим источникам: набор данных UCF11 (YouTube Actions) (https://www.crcv.ucf.edu/data/UCF_YouTube_Action.php) и набор данных UCF Sports (https://www.crcv.ucf.edu/data/UCF_Sports_Action.php). Для обеспечения воспроизводимости данного исследования конвейер предварительной обработки, разделение наборов данных (генерация обучающей, валидационной и тестовой выборок), файлы реализации, конфигурационные файлы и сопроводительная документация, использованные в экспериментах, были размещены в репозитории Zenodo и общедоступны по адресу https://doi.org/10.5281/zenodo.21020947.
Обсуждение
Предложенная архитектура MSCNN-LSTM последовательно превосходила оцениваемые подходы на эталонных наборах данных UCF11, UCF Sports и JHMDB. Предыдущие методы, основанные на архитектурах Dilated CNN–BiLSTM, Vision Transformer и 3D CNN, продемонстрировали эффективность в обучении пространственно-временным признакам, однако могут быть ограничены высокой вычислительной сложностью, значительными требованиями к обучению или недостаточным представлением детальных паттернов движения23,24,25. Напротив, предложенная архитектура объединила многомасштабное извлечение пространственных признаков с временным моделированием на базе LSTM, что позволило фиксировать как локальные детали движения, так и долгосрочные временные зависимости. Такая интеграция улучшила распознавание сложных спортивных действий, снизила межклассовую путаницу и повысила временную согласованность, особенно на более сложном наборе данных JHMDB. Эти результаты указывают на то, что предложенная архитектура обеспечила сбалансированное представление пространственной и временной информации по сравнению с оцениваемыми подходами на базе CNN, рекуррентных сетей и трансформеров.
С теоретической точки зрения, архитектура MSCNN-LSTM обеспечила унифицированный подход к многомасштабному слиянию признаков и последовательному временному обучению36,37. Использование иерархических рецептивных полей позволило извлекать пространственную информацию на разных масштабах, в то время как LSTM моделировала зависимости между последовательными кадрами видео. Такая конструкция расширила стандартный конвейер CNN-LSTM за счет сохранения локальной и контекстуальной пространственной информации перед временным моделированием. Стабильная эффективность на наборах данных, содержащих различные классы действий, паттерны движения и ракурсы камеры, дополнительно подтвердила устойчивость предложенной архитектуры.
С практической точки зрения, данная платформа продемонстрировала потенциал для автоматизированного спортивного анализа, оценки показателей спортсменов, детектирования событий и интерпретации спортивного видео. Тем не менее, перед внедрением требуется дальнейшая валидация в реальных условиях эксплуатации. Несмотря на то, что архитектура обеспечила высокую точность распознавания, ее пригодность для устройств с ограниченными ресурсами или облачных аналитических платформ должна быть подтверждена путем дополнительной оценки вычислительных затрат, времени вывода, требований к памяти и энергопотребления.
Абляционное исследование продемонстрировало взаимодополняющий вклад компонентов MSCNN и LSTM. MSCNN улучшил извлечение пространственных признаков за счет обучения представлениям на нескольких масштабах рецептивного поля, в то время как LSTM улучшил временное моделирование, фиксируя зависимости движения между последовательными кадрами. Полная конфигурация MSCNN-LSTM обеспечила наилучшую производительность, что указывает на то, что многомасштабное извлечение пространственных признаков и моделирование временных последовательностей совместно способствовали наблюдаемому улучшению распознавания действий.
В целом, предложенная структура MSCNN-LSTM эффективно объединила обучение пространственным и временным представлениям для распознавания действий в спортивных видео. Оценка на наборах данных UCF11, UCF Sports и JHMDB показала улучшение производительности по сравнению с рассмотренными подходами глубокого обучения. Эти результаты подтвердили гипотезу о том, что интеграция многомасштабных сверточных признаков с временным моделированием на основе LSTM улучшает распознавание сложных спортивных действий. Тем не менее, для установления обобщаемости и применимости в реальных условиях требуется валидация на более крупных, разнообразных и кросс-доменных наборах данных.
Следует учитывать несколько ограничений. Во-первых, оценка была ограничена общедоступными эталонными наборами данных и может не в полной мере отражать разнообразие и сложность реальных спортивных условий. Во-вторых, несмотря на использование фиксированных разделов для обучения, валидации и тестирования, нельзя полностью исключить систематическую ошибку наборов данных и непреднамеренную утечку данных. В-третьих, reported показатели эффективности могут варьироваться в зависимости от состава набора данных, инициализации модели, процедур предварительной обработки и параметров обучения. Кроме того, компоненты многомасштабного сверточного и временного моделирования увеличили требования к вычислительным ресурсам, что может повлиять на развертывание системы на устройствах с ограниченными ресурсами. Фреймворк также не оценивался с использованием внешних наборов данных или в сценариях реального времени.
Видеомодели на базе трансформеров демонстрируют высокую эффективность на крупномасштабных наборах данных для распознавания действий, однако зачастую требуют значительных вычислительных ресурсов и обширных обучающих данных. Предложенная архитектура MSCNN-LSTM представляет собой альтернативный подход, сочетающий многомасштабное извлечение пространственных признаков с рекуррентным временным моделированием. Будущие исследования должны быть сосредоточены на кросс-датасетной валидации, выводе в режиме реального времени, вычислительной оптимизации, оценке неопределенности, а также на создании гибридных архитектур, интегрирующих механизмы внимания на базе трансформеров с предложенной структурой многомасштабной CNN-LSTM38.
Раскрытие информации
Авторы заявляют об отсутствии конфликта интересов.
Благодарности
Данное исследование было проведено в Центре технологий искусственного интеллекта (CAIT) факультета информационных наук и технологий Национального университета Малайзии (Universiti Kebangsaan Malaysia). Авторы выражают глубокую благодарность за институциональную поддержку и предоставленную исследовательскую базу. Данная работа не получала специального финансирования от каких-либо государственных, коммерческих или некоммерческих финансирующих организаций.
Материалы
| Имя | Компания | Каталожный номер | Комментарии |
|---|---|---|---|
| GeForce RTX 3090 GPU | NVIDIA Corporation | RTX 3090, 24 GB VRAM | Используется для обучения моделей глубокого обучения и инференса |
| Intel Core i9 Processor | Intel Corporation | 16-Core, 3.5 GHz | Используется для предобработки данных и вычислений |
| Системная память | Generic | 64 GB DDR4 RAM | Обеспечивает обработку видео больших объемов |
| Язык программирования Python | Python Software Foundation | Version 3.8.18 | Основной язык программирования для реализации |
| TensorFlow | Version 2.15 | Фреймворк глубокого обучения, используемый для разработки модели | |
| Операционная система | Microsoft Corporation | Windows 11 | Разработка модели и проведение экспериментов |
| CUDA Toolkit | NVIDIA Corporation | CUDA 11.8 | GPU-ускорение для обучения модели |
| cuDNN | NVIDIA Corporation | cuDNN 8.9.7 | Библиотека ускорения глубоких нейронных сетей |
| OpenCV | Open Source | Version 4.8.1 | Извлечение видеокадров и предобработка |
| NumPy | Open Source | Version 1.24.4 | Численные вычисления и обработка массивов |
| Scikit-learn | Open Source | Version 1.3.2 | Оценка эффективности и статистический анализ |
| Matplotlib | Open Source | Version 3.7.5 | Визуализация результатов экспериментов |
| Набор данных UCF11 | University of Central Florida | Public Dataset | Эталонный набор данных для распознавания спортивных действий |
| Набор данных UCF Sports | University of Central Florida | Public Dataset | Эталонный набор данных для распознавания спортивных действий |
| Набор данных JHMDB | Max Planck Institute for Informatics | Public Dataset | Эталонный набор данных для распознавания движений и действий человека |
Ссылки
- Hassan N, Miah ASM, Shin J. A deep bidirectional LSTM model enhanced by transfer-learning-based feature extraction for dynamic human activity recognition. Appl Sci. 2024;14:603. https://doi.org/10.3390/app14020603
- Egawa R, et al. Dynamic fall detection using graph-based spatial temporal convolution and attention network. Electronics. 2023;12:3234. https://doi.org/10.3390/electronics12153234
- Riahi M, Eslami M, Safavi SH, Torkamani Azar F. Human activity recognition using improved dynamic image. IET Image Process. 2020;14:3223–3231. https://doi.org/10.1049/iet-ipr.2020.0372
- Muhammad K, et al. Human action recognition using attention-based LSTM network with dilated CNN features. Future Gener Comput Syst. 2021;125:820–830. https://doi.org/10.1016/j.future.2021.06.017
- Al-Obaidi S, Al-Khafaji H, Abhayaratne C. Making sense of neuromorphic event data for human action recognition. IEEE Access. 2021;9:82686–82700. https://doi.org/10.1109/ACCESS.2021.3085769
- Wensel J, Ullah H, Munir A. ViT-ReT: Vision and recurrent transformer neural networks for human activity recognition in videos. IEEE Access. 2023;11:72227–72249. https://doi.org/10.1109/ACCESS.2023.3293445
- Vrskova R, Hudec R, Kamencay P, Sykora P. Human activity classification using the 3DCNN architecture. Appl Sci. 2022;12:931. https://doi.org/10.3390/app12020931
- Ullah A, et al. Action recognition using optimized deep autoencoder and CNN for surveillance data streams of non-stationary environments. Future Gener Comput Syst. 2019;96:386–397. https://doi.org/10.1016/j.future.2019.01.041
- Jaouedi N, Boujnah N, Bouhlel MS. A new hybrid deep learning model for human action recognition. J King Saud Univ Comput Inf Sci. 2020;32:447–453. https://doi.org/10.1016/j.jksuci.2018.08.001
- Zebhi S, Al-Modarresi SMT, Abootalebi V. Converting video classification problem to image classification with global descriptors and pre-trained network. IET Comput Vis. 2020;14:614–624. https://doi.org/10.1049/iet-cvi.2020.0023
- Cust E, Sweeting AJ, Ball K, Robertson S. Machine and deep learning for sport-specific movement recognition: A systematic review. J Sports Sci. 2019;37:568–600. https://doi.org/10.1080/02640414.2018.1504613
- Cao S, Wang B, Zhang W, Ma L. Visual consensus modeling for video-text retrieval. In Proc AAAI Conf Artif Intell. 2022:167–175. https://doi.org/10.1609/aaai.v36i1.19890
- Yu H, et al. Fine-grained video captioning for sports narrative. In Proc IEEE Conf Comput Vis Pattern Recognit (CVPR). 2018:6006–6015. https://doi.org/10.1109/CVPR.2018.00628
- Browne P, Sweeting AJ, Woods CT, Robertson S. Methodological considerations for furthering the understanding of constraints in applied sports. Sports Med Open. 2021;7:22. https://doi.org/10.1186/s40798-021-00307-9
- Gao T, et al. Sports video classification method based on improved deep learning. Appl Sci. 2024;14:948. https://doi.org/10.3390/app14020948
- Dong Z, Xie M, Li X. Multi-scale receptive fields convolutional network for action recognition. Appl Sci. 2023;13:3403. https://doi.org/10.3390/app13063403
- Liu S, et al. Human memory update strategy: A multi-layer template update mechanism for remote visual monitoring. IEEE Trans Multimed. 2021;23:2188–2198. https://doi.org/10.1109/TMM.2020.3009234
- Liu S, Liu D, Muhammad K, Ding W. Effective template update mechanism in visual tracking with background clutter. Neurocomputing. 2021;458:615–625. https://doi.org/10.1016/j.neucom.2021.05.032
- Haque MN, et al. GRU-based attention mechanism for human activity recognition. In Proc ICASERT. 2019:1–6. https://doi.org/10.1109/ICASERT.2019.8934521
- Al-qaness MA, Dahou A, AbdElaziz M, Helmi A. Multi-ResAtt: Multilevel residual network with attention for human activity recognition using wearable sensors. IEEE Trans Ind Inform. 2022;19:144–152. https://doi.org/10.1109/TII.2022.3147850
- Duan F, et al. A multi-task deep learning approach for sensor-based human activity recognition and segmentation. IEEE Trans Instrum Meas. 2023;72:2514012. https://doi.org/10.1109/TIM.2023.3264512
- Gomes E, et al. Machine learning algorithms for activity-intensity recognition using accelerometer data. Sensors. 2021;21:1214. https://doi.org/10.3390/s21041214
- Su C, et al. A novel model for fall detection and action recognition combining lightweight 3D-CNN and ConvLSTM networks. Pattern Anal Appl. 2024;27:3. https://doi.org/10.1007/s10044-023-01234-5
- Zhou T, et al. Behavior recognition based on improved density clustering and context-guided Bi-LSTM model. Multimed Tools Appl. 2023;82:45471–45488. https://doi.org/10.1007/s11042-023-14678-9
- Shin J, et al. Video-based human activity recognition using hybrid deep learning model. Comput Model Eng Sci. 2025;143:3615. https://doi.org/10.32604/cmes.2025.058341
- Vrskova R, Hudec R, Kamencay P, Sykora P. A new approach for abnormal human activities recognition based on ConvLSTM architecture. Sensors. 2022;22:2946. https://doi.org/10.3390/s22082946
- Vijeikis R, Raudonis V, Dervinis G. Efficient violence detection in surveillance. Sensors. 2022;22:2216. https://doi.org/10.3390/s22062216
- Rendón-Segador F, et al. ViolenceNet: Dense multi-head self-attention with bidirectional ConvLSTM for detecting violence. Electronics. 2021;10:1601. https://doi.org/10.3390/electronics10131601
- Kalfaoglu E, Kalkan S, Alatan A. Late temporal modeling in 3D CNN architectures with BERT for action recognition. In Proc ECCV Workshops. 2020. https://doi.org/10.1007/978-3-030-66823-5_43
- Moaaz M, Mohamed E. Violence detection in surveillance videos using deep learning. Inf Bull Fac Comput Artif Intell. 2020;2:6.
- Song W, et al. Expressive 3D facial animation generation based on local-to-global latent diffusion. IEEE Trans Vis Comput Graph. 2024;30:7397–7407. https://doi.org/10.1109/TVCG.2024.3456213
- Li L, Cherouat A, Snoussi H, Wang T. Grasping with occlusion-aware ally method in complex scenes. IEEE Trans Autom Sci Eng. 2025;22:5944–5954. https://doi.org/10.1109/TASE.2024.3434610
- Li R, et al. UE-Extractor: A grid-to-point ground extraction framework for unstructured environments. IEEE Robot Autom Lett. 2025;10:5991–5998. https://doi.org/10.1109/LRA.2025.3563127
- Jhuang, H., Gall, J., Zuffi, S., Schmid, C., Black, M. J. Towards understanding action recognition. Proceedings of the IEEE International Conference on Computer Vision. 3192–3199, doi:10.1109/ICCV.2013.396 (2013).
- OpenMMLab. MMAction2: JHMDB dataset preparation. GitHub. https://github.com/open-mmlab/mmaction2/tree/main/tools/data/jhmdb (2026).
- Ullah W, Khalid YN, Khan SH. A novel deep hybrid framework with ensemble-based feature optimization for HAR. arXiv preprint arXiv:2508.18695. 2025. https://arxiv.org/abs/2508.18695
- Karuppannan K, Darmanayagam SE, Cyril SR. Human action recognition using fusion-based discriminative features and LSTM classification. Concurr Comput Pract Exp. 2022;34:e7250. https://doi.org/10.1002/cpe.7250
- Sahoo SP, et al. HAR-depth: A novel framework for human action recognition using sequential learning and depth estimated history images. IEEE Trans Emerg Top Comput Intell. 2020;5:813–825. https://doi.org/10.1109/TETCI.2020.3006543