В данном исследовании предлагается алгоритм, который тесно связывает иерархические визуальные особенности, захваченные кодировщиком трансформатора с сдвинутым окном, с аноминационной глубиной 3D-ограничивающего блока Манхэттена, сгенерируемой при обнаружении отрезков строки, что позволяет достигать высокоточной семантической реконструкции сложных внутренних сцен.
Для просмотра этого контента требуется подписка на JoVE. Войдите или начните свой бесплатный пробный период.
Исследовательская статья
Метод семантического разбора для изображений сцены в помещении, основанный на предварительных знаниях о структуре здания
В этой статье
Краткое содержание
Аннотация
Для решения семантических разрывов предсказания и физических искажений границ, вызванных окклюзией мебели в сложных внутренних сценах, в данной статье предлагается метод семантического разбора, использующий априоры структуры зданий. Схема использует иерархический трансформатор с сдвинутым окном для извлечения многомасштабных визуальных признаков и сочетает алгоритм определения сегментов линий с уклоном и согласованностью градиента для построения 3D-ограничивающего блока Манхэттена. Этот ограничивающий ящик преобразуется в знаковое поле расстояний (SDF) перед кодированием дискретных геометрических контуров в непрерывное физическое потенциальное поле. Механизм перекрёстного внимания, управляемый структурой, заставляет визуальные сигналы совпадать с реальными 3D-ортогональными геометрическими границами, восстанавливая непрерывность признаков в окклюзированных областях. Граф пространственной смежности, построенный из суперпиксельных узлов, приводит в движение графовую сверточную сеть (GCN) для агрегирования признаков, обеспечивая макроскопическую семантическую согласованность в пределах физической несущей плоскости. Сочетание потери перекрестной энтропии на уровне пикселей и специально разработанной структурной потери согласованности усиливает ограничения, наказывая прогнозы за пределы границ. Эксперименты с несколькими независимыми сериями показывают, что среднее пересечение по объединению (mIoU) достигает 68,7% при стандартном отклонении 0,2%, а оценка структурной границы F1 достигает 76,4% при стандартном отклонении 0,3%, что подтверждает надёжную работу предложенных модулей. При размере одного узла изображения 256 среднее время вывода оставалось 61 мс.
Введение
Семантический анализ изображения сцены в помещении занимает ключевое место в задачах трёхмерного пространственного познания и интеллектуального пространственногомышления 1,2. Визуальное извлечение признаков в реальной физической среде часто сильно затруднено сложнымипространственными планировками 3. Решение проблемы семантического разрыва и физических искажений границ фундаментной конструкции здания, вызванного крупномасштабной окклюзией мебели, важно для исследований пространственногопознания 4,5. Точное удаление помех от захламлённых объектов и восстановление физической непрерывности одной стены и пола напрямую определят точность трёхмерной реконструкции сцены и глобального пространственного логическогоанализа 6. Семантический разрыв, вызванный крупномасштабной окклюзией мебели, и эффект структурного ремонта предложенного руководства по строительству перед зданием иллюстрированы на рисунке 1, где вход окклюзированного красного, зелёного, синего (RGB) в таблице 1A, базового искажения маски на рисунке 1B и результат структуры-предшествующего ремонта на рисунке 1C сравниваются при одном и том же состоянии внутренней сцены.
Чтобы удовлетворить требования к точности пространственного логического мышления, современные основные пиксельные визуальные сети сталкиваются с множеством препятствий при работе со сложными внутреннимипомещениями 7,8. Внутренние помещения часто заполнены плотной мебелью и захламлённой мебелью, что приводит к значительной потере низкоуровневых визуальных пограничных сигналов наизображениях 9. Традиционные механизмы извлечения признаков чрезмерно опираются на локальные двумерные цветовые и текстурные реакции, не обладая макроскопическим пониманием жёстких ортогональных законов трёхмерных искусственных структур10. Это ограничение локального рецептивного поля делает распространение признаков легко прерываемым, затрудняя расширение глобальной топологии черезокклюзии 11. В настоящее время существует острая необходимость решить основную проблему семантических разрывов предсказания и серьёзных искажений физических границ, вызванных окклюзией иинтерференцией 12.
Для устранения конструктивных дефектов фундаментов зданий, вызванных окклюзией и помехами, академическое сообщество разработало ряд целенаправленных мервмешательства 13. Кроссмодальные сети агрегации признаков эффективно компенсируют присущие недостатки одной визуальной модальности в пространственном восприятии, вводя карты глубины или текстовые априоры для помощи при работе с изображениями красно-зелёно-синего(RGB) 14,15. Фреймворки восприятия границ и адаптивного выбора контекста внедряют стратегии усиления физических контуров в стадию декодирования признаков, что значительно улучшает подгонку краёв прогнозных результатов в сложныхсценах 16,17. Инференциальные модели, основанные на GCN и механизмах взаимодействия признаков, значительно улучшают плавность признаков и макросемантическую согласованность в однородных областях путём построения связей на уровнеузлов 18,19. Интеграция явных структурных априоров Манхэттена в конвейер визуального извлечения признаков обеспечивает геометрические границы согласованности, что решает проблемы разрывов признаков, вызванные обширной окклюзией объектов на переднемплане 20.
Для решения основной проблемы семантических ошибок предсказания и серьёзных искажений физических границ, связанных с инфраструктурой строительства, предлагается семантический парсинг-фреймворк на основе механизма замкнутого цикла связи, включающего архитектурные априоры. Эта концепция выходит за рамки наивных инженерных конвейеров, устанавливая двунаправленное выравнивание картографирования между непрерывными геометрическими полями потенциала и дискретными визуальными многообразиями признаков, формируя нетривиальную синергию, исправляющую ошибки окклюзии с помощью структурных законов. Эта схема опирается на многомасштабную визуальную магистральную сеть и алгоритм обнаружения линейных сегментов, основанный на оценке нулевой точки, чтобы получить локальные черты и ортогональные априоры ребер, представляющие 3D-ограничивающий блок Манхэттена параллельно, а затем преобразовать их в SDF. Алгоритм использует структурно ориентированный механизм перекрёстного внимания, используя визуальные признаки как векторы запроса и рассматривая особенности SDF как ключи и значения для вычислений точечного произведения, тем самым заставляя визуальный сигнал совпадать с реальной 3D-геометрической границей в пространстве признаков. Граф пространственной смежности, построенный из суперпиксельных узлов и пространственных копланарных краёв, подаётся в GCN для агрегации признаков между узлами и передачи сообщений. Процесс сквозной оптимизации параметров совместно использует кросс-энтропию на уровне пикселей и пользовательскую функцию потерь структурной согласованности, которая строго ограничивает и штрафует предсказанные пиксели, пересекающие границу здания-априор. Полный конвейер семантического разбора изложен на рисунке 2, который связывает RGB-ввод изображений, геометрическое априорное извлечение, выравнивание с перекрестным вниманием, рассуждение на суперпиксельных графах и декодирование семантической маски в единой архитектуре.
Ранние сети разбора сцен использовали сверточные операции для захвата локальных текстур внешнего вида, но из-за ограничений локальных рецептивных полей они демонстрировали недостаточную семантическую когерентность крупномасштабныхцелей 21,22. Предыдущие исследования применяли модуль самовнимания визуальной архитектуры Transformer для извлечения глобальной контекстной информации и построения признаков ассоциации пикселейна расстоянии 23,24. Кроссмодальные многофункциональные стратегии агрегации признаков извлекают трёхмерные геометрические пространственные особенности сцены, объединяя облака точек карты глубины и текстовые команды25,26. Гибридные механизмы внимания для слияния признаков, направленных на специфические домены, постепенно совершенствовались. Создавая мосты взаимодействия между признаками, они значительно снизили потери энергии и разреженность элементов при многомасштабной передаче визуальных сигналов, а также повысили устойчивость парсирования сложных структур. Передовые дизайны энкодеров совместно интегрируют и выводят пространственные детали высокочастотных доменов наряду с глобальными и локальными признаками, усиливая способность сети различать мелкозернистые семантические категории с высокой сходством и повышая точность внутреннего парсинга27,28. Недавние достижения в архитектурах семантической сегментации предоставляют ценные ориентиры для оптимизации вычислительной эффективности и пространственного восприятия. Модели, предназначенные для плотного прогнозирования и многомасштабной контекстной агрегации, извлекают мелкозернистые геометрические особенности из сложных фонов. Стратегии разделения признаков и синергетического слияния решают семантическую неоднозначность в пограничных областях. Лёгкие механизмы внимания и гейт-агрегационные модули оптимизируют распределение параметров, тем самым ускоряя вывод и сохраняя локальные структурные детали. Реализация этих эффективных архитектурных проектов предлагает теоретические рекомендации по снижению вычислительных накладных расходов на неевклидовские топологические операции вывода в разборе сцен внутри помещений.
Для коррекции локальных ошибок визуального разбора используются априоры структуры здания и оценка 3D-планировки29. Предыдущие исследования выделяли ортогональные и параллельные геометрические особенности внутренних зданий как ограничения на вывод для снижения смещения прогноза сети, вызванного перегруженными внутреннимифонами 30,31. Существующие схемы используют алгоритмы обнаружения линейных сегментов и методы анализа точек абляции изображений для создания 3D-ограничивающих коробок Манхэттена для картирования физических границ помещений и помощи в локализации визуальных объектов32. Совместная архитектура модуля осведомлённости границ и многомасштабного контекста неявно встраивает предшествующую структурную информацию в процесс декодирования высокомерных признаков, заставляя сеть выводить семантические маски, близкие к реальным физическим контурам, что эффективно улучшает зазубренность и размытие рёберобъектов 33. Широко изучены полуконтролируемые или слабо контролируемые функции потерь с свойствами усиления границ. Опираясь на строгие математические формулы для наказания независимого поведения классификации пикселей, нарушающего пространственные топологические правила, геометрическая гладкость и структурная целостность конечного результата сегментации гарантируются источником градиентнойоптимизации 34.
Некоторые исследования использовали графовые нейронные сети для кросс-доменной агрегации визуальных признаков и рассуждений о топологических отношениях в высокомерномпространстве 35. Алгоритм сегментации суперпикселей предварительно агрегирует соседние пиксельные блоки с похожими цветовыми характеристиками и текстурами в независимые связанные узлы. Алгоритм сегментации суперпикселей сжимает вычислительную избыточность структуры графа на уровне изображения и сохраняет базовую геометрическую топологию изображения36. GCN, построенный на высокомерном векторе признаков узла, а матрица смежности, представляющая пространственную близость, обеспечивает эффективную направленную передачу и интерактивное слияние многомасштабной визуальной информации вдоль физически связанного графа в пространственнойобласти 37,38. Применение модуля улучшения временной информации и гибридного многомасштабного механизма пропуска соединения подавляет чрезмерное сглаживание и гомогенизацию признаков узлов, возникающих в процессе многоуровневой глубокой передачисообщений 39. Технология многомасштабного графового вейвлет-преобразования и стратегия оптимизации обучения псевдометочных элементов оптимизируют механизм антифонового шума формулы обновления признаков узлов, так что признаки с одинаковыми семантическими атрибутами сохраняют кооперативный режим отклика в сложной сетевойтопологии 40. Механизм рассуждения на основе графов отображает правильные пиксельные сетки в неевклидовые топологические пространства для выполнения вычислений агрегации признаков неправильных строительных сооружений и внутреннихкомпонентов 41.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Протокол
Перед сетевым обучением были подготовлены наборы данных по RGB-сценам и их семантические аннотации. Крупномасштабный 3D-набор данных для внутренних помещений и RGB-D по внутренним сценам (см. Таблицу материалов) были получены из их официальных репозиториев. Сцены приобретения внутри помещений, включающие окклюзию мебели, вариации освещения, прерывание границ стен и сложные пространственные планировки, были сохранены для соответствия сценарию парсинга целей. Семантические метки были преобразованы в индексированные одноканальные PNG-аннотационные маски, а все RGB-изображения и семантические маски были изменены до 512 × 512 пикселей. Онлайн-дополнение данных применялось во время обучения: случайное горизонтальное переворот с вероятностью 0,5, случайное масштабирование яркости от 0,8 до 1,2 и случайное вращение между −10° и +10° для расширения структурного распределения. RGB-каналы были нормализованы со средними значениями 0,485, 0,456 и 0,406 и стандартными значениями отклонения 0,229, 0,224 и 0,225. Крупномасштабный внутренний 3D-бенчмарк последовал за официальным разделом релизов, использованным в этом исследовании: 1201 обучающая сцена и 312 валидационных сцен для разработки и валидации моделей. Бенчмарк RGB-D в помещении прошёл по официальному протоколу оценки: 795 обучающих и 654 тестовых изображений. Дополнительное процентное разделение не применялось к этим двум публичным ориентирам.
Визуальная магистральная сеть трансформатора с сдвинутым окном (см. Таблицу материалов) была инициализирована как магистраль кодера трансформатора с движущимися окнами. Размер вложения патча был настроен как 4 x 4 пикселя. Размеры вложения четырёх иерархических ступеней были установлены как 128, 256, 512 и 1024, а количество трансформаторных блоков в четырёх ступенях — 2, 2, 18 и 2. Размер локального окна внимания был установлен на 7 x 7, а количество головок внимания — 4, 8, 16 и 32 для четырёх иерархических этапов. Нелинейные функции непрерывной активации использовались во всех многослойных слоях перцептронов. Пространственное понижение дискретизации осуществлялось с помощью операций патч-слияния шагом 2 после каждого иерархического этапа. Архитектура ядра сети и гиперпараметры модуля сверточного вывода были обобщены в таблице 1.
Затем на входных картах выполнялась извлечение объектов с сдвиговым окном самовнимания. Каждая карта объектов была разделена на неперекрывающиеся локальные окна с пространственными размерами 7 × 7. Регулярное внимание окон и сдвигаемое внимание чередовались между соседними блоками трансформаторов с сдвинутыми окнами. Циклическое расстояние смещения было установлено на 3 пикселя, и в каждом локальном окне внимания применялось кодирование относительного позиционного смещения. Локальные визуальные особенности агрегировались с помощью многоголового самовнимания для создания иерархических, многомасштабных представлений признаков.
Структурные априоры Манхэттена были извлечены из RGB-изображений в помещении. Структурные сегменты кромки были обнаружены с помощью алгоритма определения линейных сегментов с уклоном и согласованностью градиента. Доминирующие структурные направления были сгруппированы с помощью алгоритма случайного консенсуса выборки (RANSAC) (см. Таблицу материалов) на основе оценки нуляющей точки. Три взаимно ортогональных направления Манхэттена были реконструированы для создания представления Манхэттенского трёхмерного ограничивающего ящика. Восстановленная структурная граница была преобразована в SDF-отображение путём вычисления минимального евклидового расстояния от каждого пикселя до ближайшего отрезка пограничной линии.
Структурно-ориентированные признаки перекрёстного внимания создавались после получения визуальных признаков и априоров SDF. Визуальное многообразие признаков отображалось в тензор запроса Q через линейную матрицу преобразования W sub Q элемента двойного удара R в матрицу формации W sub Q элемента двойного удара R в матрицу 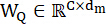 формации . Непрерывное поле расстояний перед отображалось в ключевой тензор K и тензор значений V через матрицы
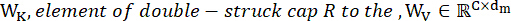 преобразования , а размерность модели была установлена в 512. Многоголовая модуляция делила проекционное пространство на 8 независимых подпространств, каждая из которых имела размерность 64. Пространственное расположение перед проектированием дискретных пиксельных координат в непрерывное потенциальное поле и генерировало структурную матрицу сродства S как явное аддитивное пространственное смещение для модуляции матрицы сходства с точечным произведением. Визуальный тензор признаков использовался в качестве источника запроса, поскольку семантический разбор требует от каждого визуального места активно извлекать структурно согласованные доказательства из геометрического априорного пространства. SDF prior использовался в качестве ключа и источника ценности, поскольку он хранит непрерывное расстояние границ и внутренние структурные сигналы, заимствованные из манхэттенской планировки. Термин с точным произведением измерял совместимость между семантическим видом и геометрическим априором, тогда как аддитивный структурный член λS смещал веса внимания в сторону пикселей на той же физической плоскости или близко к тому же архитектурному контуру. Коэффициент λ отражал доверие к извлеченному структурному априору и контролировал, насколько жёсткие ортогональные ограничения были включены в распределение внимания. Эта формула снизила диффузию пограничных признаков, вызванную окклюзией мебели, и сохранила адаптивную релаксацию в планировках вне Манхэттена. Распределение внимания, управляемое структурой, было рассчитано согласно уравнению 1.
Уравнение 1: 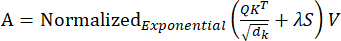
где A обозначает структурно ориентированную матрицу агрегации внимания, Q — тензор запроса, генерируемый визуальными признаками, K — ключевой тензор, порождённый априорными признаками SDF, V — тензор значений, порождённый структурными априорными представлениями, dk — размерность признаков ключевого тензора, λ — адаптивный структурный коэффициент веса, используемый для идентификации геометрической уверенности локальных областей и ослабления жёстких ортогональных ограничений в не-манхэттенском пространстве макетов, а S обозначает матрицу аффинности SDF. Деление на dk стабилизировало масштаб логиков внимания и предотвратило создание чрезмерно концентрированных весов внимания крупными размерами. Нормализованная экспоненциальная функция (см. Таблицу материалов) преобразовывала модулированные оценки сходства в нормированное пространственное распределение, позволяя каждому пикселю агрегировать структурную априорную информацию на основе семантической и геометрической согласованности. Этот дизайн объясняет, почему визуальный облик и априоры архитектурных границ объединены на уровне внимания, а не прямой конкатенацией признаков.
Граф топологии суперпикселей был построен на основе структурно-выровненной карты признаков. Карта объектов была сегментирована с помощью алгоритма генерации пространственных регионов. Число суперпикселя было установлено на 256, коэффициент компактности — на 10, коэффициент сглаживания по Гауссу — на 1,0, а число итераций — на 10. Ограничения на пространственную близость обеспечивались за счёт установки массового веса расстояния на постоянное отношение 1,0 к расстоянию между цветовым пространством признаков во время кластеризации, что сохраняло равномерную генерацию узлов на плотных границах помех. Пиксели с однородными семантическими ответами агрегировались в суперпиксельные узлы. Рёбра графов строились с учётом пространственных смежных отношений, силы аффинности SDF и копланарных геометрических согласованных ограничений. Процесс построения структурной матрицы аффинности и топологической связности показан на рисунке 3, где показано, как руководство SDF было преобразовано в пространственные отношения на уровне графов.
Формулировка графов была введена для преобразования плотных пиксельных рассуждений в пространственное мышление по узлам по однородным структурным областям. Каждый узел суперпикселя представлял локальную область с аналогичным семантическим откликом и пространственной непрерывностью, а каждое ребро представляло собой надёжный путь передачи признаков с учётом смежности, аффинности расстояния и поля и копланарной согласованности. Такая конструкция снижала влияние изолированных шумных пикселей и позволяла закрытым зонам стен, пола и потолка получать сообщения от физически соседних узлов. Конструкция рёбер, таким образом, служила математическим мостом между непрерывным наведением SDF и дискретным неевклидовым графовым рассуждением.
Была сконфигурирована трёхслойная графовая сверточная сеть с скрытыми размерами признаков 512, 256 и 128. Графовый сверточный слой выполнял сглаживание признаков по структуре графа на основе пространственных отношений узлов. Смежность с самопетлями сохраняла исходное состояние каждого узла при передаче сообщений, предотвращая стирание особенностей небольшой структурной области окружающими большими областями. Симметричная нормализация масштабировала элементы матрицы смежности на произведение обратных квадратных корней степеней узлов, так что узлы высокой и низкой степени вносили вклад при сопоставимых числовых величинах во время распространения. Прямое распространение осуществляло локализованную пространственную агрегацию, при которой каждое состояние узла поглощало высокомерные особенности из соседних копланарных кластеров до применения функции нелинейного выпрямления по элементам. Эта формулировка делала слой свёртки графа приближённым к семантической диффузии вдоль физически значимых внутренних плоскостей, а не к неограниченному сглаживанию по границам несвязанных объектов. Признаки узлов графа оценивались согласно уравнению 2.
Уравнение 2: 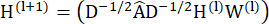
Проекция от плотных пиксельных признаков к суперпиксельным узлам, передача сообщений с графовой свёрткой и координатная обратная проекция представлены на рисунке 4, что уточняет путь агрегации признаков от регулярных сеток изображений к неевклидовой топологии и обратно к плотному семантическому представлению. Проекция от плотных пиксельных особенностей на рисунке 4A на суперпиксельные узлы на рисунке 4B, передача сообщения с графовой свёрткой на рисунке 4C и координатная обратная проекция на рисунке 4D проясняют путь агрегации признаков от регулярных сеток изображений к неевклидовской топологии и обратно к плотному семантическому представлению.
где H(l) обозначает тензор признаков узлов слоя свёртки l-го графа, Â — матрицу смежности с самопетляционными соединениями, D — матрицу степеней, соответствующую матрице смежности, W(l) — обучаемую матрицу весов слоя свёртки l-го графа, а σ — функцию активации ректифицированной линейной единицы. Термин ÂH(l) объединял признаки соседних суперпиксельных узлов, тогда как D−1/2 и D−1/2 уравновешивали вклад узлов с разной плотностью соединений. Обучаемая матрица W(l) проецировала агрегированные узловы в новое семантическое пространство, позволяя графовому слою отличать структурную согласованность от обычной пространственной близости. Нелинейная активация сохраняла разницу в ответах между копланарными и некопланарными областями после агрегации признаков.
Особенности семантической сегментации декодировались после рассуждения на основе графов. Декодер был построен с использованием трёх этапов билинейной интерполяции и операций синтеза с пропуском соединения между слоями. Поверхностные пространственные признаки кодировщика были объединены с высокоуровневыми семантическими декодерами посредством канального синтеза. Разрешение признаков было восстановлено до исходного размера изображения, а окончательная семантическая карта вероятностного прогнозирования была сгенерирована через слой свёртки 1 × 1.
Вся семантическая сеть парсинга была обучена с помощью разъединённого оптимизатора затухания веса (см. Таблицу материалов). Начальная скорость обучения была установлена на уровне 0,0001, коэффициент затухания веса — 0,01, а размер партии — 8 для обоих публичных бенчмарков. Скорость затухания первого момента была установлена на 0,9, во втором — на 0,999, а коэффициент эпсилона численной устойчивости — на 1 × 10⁻8. Потеря валидации отслеживалась в конце каждой эпохи, а контрольные точки сохранялись при увеличении mIoU на валидационном наборе. Сеть была обучена для 300 эпох с использованием стратегии затухания скорости полиномиального обучения с степенью затухания 0,9. Было проведено пять независимых обучающих запусков с использованием различных инициализаций случайного засея для установления статистически строгой базы оценки. Сеть была совместно оптимизирована с использованием потери кросс-энтропии на уровне пикселей и потери структурной согласованности. Все эксперименты проводились на вычислительной платформе, оснащённой аппаратным обеспечением для параллельных вычислений с высокой памятью, а подробная аппаратная информация была представлена в Таблице материалов.
Совместная оптимизация обеспечивала геометрическое выравнивание границ путём вычисления пространственной градиентной величины тензора вероятности класса. Потеря структурной согласованности использовалась как регуляризатор, умножая норму пространственных градиентов предсказания на непрерывные значения SDF. Математическое обоснование заключалось в том, что изменения семантических категорий должны сосредоточиться вблизи реальных архитектурных контуров, где SDF приближается к нулю, в то время как плоские стены, полы и потолочные интерьеры должны сохранять плавные семантические реакции. Когда большой градиент предсказания появлялся далеко от структурной границы, член поля расстояния увеличивал штраф и препятствовал ложным семантическим переходам внутри однородной физической плоскости. Когда градиент прогноза появлялся близко к нулевой линии, штраф оставался ограниченным и сохранял законные переходы классов вдоль архитектурных границ. Семантические переходные области были ограничены так, чтобы они совпадали с нулевой дистанцией SDF, как указано в уравнении 3.
Уравнение 3: 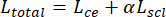
где Ltotal обозначает конечную функцию оптимизации,L ce — потерю на уровне пикселей на перекрестной энтропии, Lscl — штрафные потери структурной согласованности, а α — коэффициент веса структурных потерь. Термин кросс-энтропии обеспечивал семантический надзор на уровне пикселей с помощью аннотационных масок, тогда как термин структурной согласованности навязывал геометрическую регуляризацию с использованием архитектурных априоров. Коэффициент веса α сбалансированное распознавание категорий и выравнивание границ, предотвращая перенагонку в оптимизации как локальной точности маркировки, так и жёстких структурных контуров. Эта совместная цель связала визуальную семантику, физическую согласованность границ и обучаемые параметры сети в рамках единой цели оптимизации.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Результаты
Экспериментальная установка
В этом исследовании использовались два стандартных набора данных по разбору сцен в помещении — крупномасштабный 3D-набор для внутренней и RGB-D набор данных для внутренней сцены — для оценки производительности и настройки модели. Крупномасштабный внутренний 3D-набор данных содержит реалистично сканируемые, сложные сцены физического пространства и высококачественные RGB-виды, обеспечивая высокоточные пиксельно-пиксел...
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Обсуждение
Алгоритм этой статьи тесно связывает иерархические визуальные особенности, зафиксированные кодировщиком трансформатора с сдвинутым окном, с априорной глубиной 3D-ограничивающего блока Манхэттена, созданной при обнаружении отрезков строки, тем самым достигая высокоточной семантической реконструкции сложных внутренних сцен. Механизм перекрёстного внимания, управляемый структурой, заставляет визуальный сигнал выровняться с истинной геометрической границей, откалиброванной SDF, тем самым вос...
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Раскрытие информации
Авторы заявляют, что у них нет финансовых конфликтов интересов.
Благодарности
Финансирование: Ключевая программа исследований и разработок Шэньси (Программа No 2024CY2-GJHX-76).
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Материалы
| Имя | Компания | Каталожный номер | Комментарии |
|---|---|---|---|
| AdamW optimizer | PyTorch Contributors | https://pytorch.org/ | |
| CCANet | Zihao Z. et al. | https://doi.org/10.1109/TCDS.2024.3455356 | |
| CMPFFNet | Zhou W. et al. | https://doi.org/10.1109/TASE.2023.3332021 | |
| ConvNeXt | Meta AI Research | https://github.com/facebookresearch/ConvNeXt | |
| InternImage | OpenGVLab | https://github.com/OpenGVLab/InternImage | |
| Mask2Former | Meta AI Research | https://github.com/facebookresearch/Mask2Former | |
| MaskDINO | IDEA-Research | https://github.com/IDEA-Research/MaskDINO | |
| NYUv2 | http://cs.nyu.edu/~silberman/datasets/nyu_depth_v2.html | ||
| OneFormer | SHI Labs | https://github.com/SHI-Labs/OneFormer | |
| RANSAC algorithm | scikit-learn developers | https://scikit-learn.org/ | |
| ScanNet V2 | http://www.scan-net.org/ | ||
| SegFormer | NVIDIA | https://github.com/NVlabs/SegFormer | |
| SGCA_GCN | Authors of this study | Proposed method (N/A) | |
| Softmax function | PyTorch Contributors | https://pytorch.org/ | |
| Swin Transformer | Microsoft Research | https://github.com/microsoft/Swin-Transformer |
Ссылки
- Zhang Z et al. CCANet: cross-modality comprehensive feature aggregation network for indoor scene semantic segmentation. IEEE Trans Cogn Dev Syst. 2024;17:366–378.
- Cui Y et al. Improving the segmentation of confusable indoor structures using point convolution and sparse vector attention. Geospat Inf Sci. 2025:1–22.
- Yang L, Cai H. Cost-efficient image semantic segmentation for indoor scene understanding using weakly supervised learning and BIM. J Comput Civ Eng. 2023;37:04022062–04022082.
- Uckan T, Aslan C, Hark C. A comprehensive hybrid approach for indoor scene recognition combining CNNs and text-based features. Sensors. 2025;25(17):5350. doi:10.3390/s25175350.
- Sun R et al. Training indoor and scene-specific semantic segmentation models to assist blind and low-vision users in activities of daily living. IEEE Open J Eng Med Biol. 2025;6:533–539.
- Ye S, Hu Y, Lin M. Indoor scene reconstruction with fine-grained details using hybrid representation and normal prior enhancement. IEEE Trans Vis Comput Graph. 2024;31:5275–5287.
- Naseer A et al. Multimodal scene recognition using semantic segmentation and deep learning integration. PeerJ Comput Sci. 2025;11. doi:10.7717/peerj-cs.2858.
- Bae JH, Yu GH, Lee JH. Superpixel image classification with graph convolutional neural networks based on learnable positional embedding. Appl Sci. 2022;12:9176–9190.
- Zhang H, Zou J, Zhang L. EMS-GCN: an end-to-end mixhop superpixel-based graph convolutional network for hyperspectral image classification. IEEE Trans Geosci Remote Sens. 2022;60:1–16.
- Mu Y, Ou L, Chen W. Superpixel-based graph convolutional network for UAV forest fire image segmentation. Drones. 2024;8:142–158.
- Khatun Z, Jonsson H Jr, Tsirilaki M. Beyond pixel: superpixel-based MRI segmentation through traditional machine learning and graph convolutional network. Comput Methods Programs Biomed. 2024;256:108398–108412.
- Yongyin L, Caixia Y. Cross-attention swin transformer for detailed segmentation of ancient architectural color patterns. Front Neurorobot. 2024;18:1513488–1513508.
- Zhou X, Zhou L, Gong S. Swin transformer embedding dual stream for semantic segmentation of remote sensing imagery. IEEE J Sel Top Appl Earth Obs Remote Sens. 2023;17:175–189.
- Ning X, Jiang L, Li W. Swin-MGNet: swin transformer-based multiview grouping network for 3D object recognition. IEEE Trans Artif Intell. 2024;6:747–758.
- Ke A, Luo J, Cai B. UNet-like network fused swin transformer and CNN for semantic image synthesis. Sci Rep. 2024;14:16761–16779.
- Li Y et al. IED-GCN: an internal and external decoupled graph convolutional network for landslide susceptibility assessment. IEEE Trans Geosci Remote Sens. 2025;63:1–17.
- He T, Chen J. DC-GCN: a lightweight graph convolutional network integrating local and global context for semantic segmentation. IEEE J Sel Top Appl Earth Obs Remote Sens. 2025;18:28283–28299. doi:10.1109/JSTARS.2025.3626006.
- Imani M. Superpixel-based graph convolutional neural network for polarimetric synthetic aperture radar image classification. Sci Rep. 2026;16:4736. doi:10.1038/s41598-025-34965-6.
- Wang S, Feng S, Wang Z. Structural prior-guided and feature-enhanced transformer with masked image modeling pretraining for retinal layers and fluid segmentation in macular edema OCT images. Biomed Opt Express. 2025;16:5096–5117.
- Yuan Z et al. Structure-aware progressive multimodal fusion network for RGB-T crack segmentation. J Imaging. 2025;11(11):384. doi:10.3390/jimaging11110384.
- Xu S, Shen R, Liu E. A structure-prior-guided adaptive context selection network for remote sensing semantic segmentation. Electron Lett. 2025;61. doi:10.1049/ell2.70161.
- Minaee S, Boykov Y, Porikli F. Image segmentation using deep learning: a survey. IEEE Trans Pattern Anal Mach Intell. 2021;44:3523–3542.
- Zhou E, Murray AT, Baik J. Mapping 3D classroom seats based on partial object point cloud completion. Cartogr Geogr Inf Sci. 2024;51:404–420.
- Nishi T, Kawasaki S, Iewaki K. M3R-CNN: on effective multimodal fusion of RGB and depth cues for instance segmentation in bin picking. Adv Robot. 2023;37:1143–1157.
- Zhou W, Xiao Y, Yan W. CMPFFNet: cross-modal and progressive feature fusion network for RGB-D indoor scene semantic segmentation. IEEE Trans Autom Sci Eng. 2023;21:5523–5533.
- Zhou W, Xiao Y, Liu Y. FIMKD: feature implicit mapping knowledge distillation for RGB-D indoor scene semantic segmentation. IEEE Trans Artif Intell. 2024;5:6488–6499.
- Liu J, Jiang Z, Xu X. Multi-robot collaborative complex indoor scene segmentation via multiplex interactive learning. CAAI Trans Intell Technol. 2025;10:1646–1660.
- Zhang S, Xie M. MIPANet: optimizing RGB-D semantic segmentation through multimodal interaction and pooling attention. Front Phys. 2024;12:1411559–1411572.
- Li JW et al. Construction of a multiscale feature fusion model for indoor scene recognition and semantic segmentation. Sci Rep. 2025;15:14701. doi:10.1038/s41598-025-95465-1.
- Liang X et al. Indoor building structure segmentation in unorganized point clouds based on corner feature. Eng Constr Archit Manag. 2025. doi:10.1108/ECAM-10-2024-1433.
- Wu LF, Wei D, Xu CA. CFANet: the cross-modal fusion attention network for indoor RGB-D semantic segmentation. J Imaging. 2025;11(6):177. doi:10.3390/jimaging11060177.
- Fan L, Zhou Y, Liu H. Combining swin transformer with UNet for remote sensing image semantic segmentation. IEEE Trans Geosci Remote Sens. 2023;61:1–11.
- Wang Z, Liao Z, Zhou B. SwinURNet: hybrid transformer-CNN architecture for real-time unstructured road segmentation. IEEE Trans Instrum Meas. 2024;73:1–16.
- Zhang H et al. Frequency-domain-guided swin transformer and global-local feature integration for remote sensing images semantic segmentation. IEEE Trans Geosci Remote Sens. 2025;63:5612611. doi:10.1109/TGRS.2025.3535724.
- Li GY, Chen J, Jang SI. SwinCross: cross-modal swin transformer for head and neck tumor segmentation in PET-CT images. Med Phys. 2024;51:2096–2107.
- Tang Y, Hu X, Ke T. Semantic segmentation of high-resolution remote sensing imagery via an end-to-end graph attention network with superpixel embedding. IEEE J Sel Top Appl Earth Obs Remote Sens. 2025;18:7236–7252.
- Wang R, Nie Y, Geng J. Multiscale superpixel-guided weighted graph convolutional network for polarimetric SAR image classification. IEEE J Sel Top Appl Earth Obs Remote Sens. 2024;17:3727–3741.
- Li S, Wu K, Liu H. Hyperspectral image classification based on multiscale feature search graph convolutional network with meta pseudo-labels. IEEE J Sel Top Appl Earth Obs Remote Sens. 2025;18:23485–23504.
- Yang B, Cheng X, Guo J. Temporal information-enhanced graph convolutional network with superpixel-pixel gated knowledge dynamic selection for change detection in satellite time series. IEEE J Sel Top Appl Earth Obs Remote Sens. 2024;17:18399–18412.
- Zhang H, Ku J, Zhao J. Multi-scale graph wavelet convolutional network for hyperspectral image classification. Front Remote Sens. 2025;6:1637820. doi:10.3389/frsen.2025.1637820.
- Zhou Q, Wang L, Gao G. Boundary-guided lightweight semantic segmentation with multiscale semantic context. IEEE Trans Multimedia. 2024;26:7887–7900.
- Xu X, Yen GG, Zhao C. Boundary-based active domain adaptation for semantic segmentation under adverse conditions. IEEE Trans Neural Netw Learn Syst. 2025;36:14721–14734.
- Tang Y, Feng S, Zhao C. A semantic change detection network based on boundary detection and task interaction for high-resolution remote sensing images. IEEE Trans Neural Netw Learn Syst. 2025;36:17184–17198.
- Guan L, Yuan X. Dynamic weighting and boundary-aware active domain adaptation for semantic segmentation in autonomous driving environment. IEEE Trans Intell Transp Syst. 2024;25:18461–18471.
- Fenglei W, Xin G, Zongze Z. A boundary-enhanced semantic segmentation model for buildings. IEEE J Sel Top Appl Earth Obs Remote Sens. 2025;18:5733–5748.
- Shan K, Tan L, Li Y, Jia T. Multi-scale boundary-aware network for remote sensing image semantic segmentation. Sci Rep. 2026;16:3797. doi:10.1038/s41598-025-33943-2.
- Wu D, Guo Z, Li A. Conditional boundary loss for semantic segmentation. IEEE Trans Image Process. 2023;32:3717–3731.
- Li Y, Zhang C, Wang H. Boundaries matter: a novel multibranch semisupervised semantic segmentation method. IEEE Intell Syst. 2024;40:35–44.
- Wang JQ, Chen T, Zheng L. A multiscale remote sensing semantic segmentation model with boundary enhancement based on UNetFormer. Sci Rep. 2025;15:14737. doi:10.1038/s41598-025-99663-9.
- Jung H, Choi HS, Kang M. Boundary enhancement semantic segmentation for building extraction from remote sensed image. IEEE Trans Geosci Remote Sens. 2021;60:1–12.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.