В данном протоколе описывается внедрение совместимой веб-платформы, которая интегрирует клинические данные на базе FHIR с генерацией с дополненным поиском (Retrieval-Augmented Generation) и многоагентными большими языковыми моделями для поддержки принятия клинических решений. Описанный рабочий процесс обеспечивает воспроизводимое развертывание, стандартизированную интеграцию данных и оценку анализа медицинских данных с помощью искусственного интеллекта (ИИ).
Исследовательская статья
Интероперабельная веб-платформа на базе больших языковых моделей для анализа медицинских данных: протокол системы поддержки принятия клинических решений
В этой статье
Краткое содержание
Аннотация
Принятие клинических решений часто затруднено фрагментарностью электронных медицинских карт и ограниченной совместимостью разнородных информационных систем здравоохранения. В данной статье представлен пошаговый протокол внедрения совместимой веб-платформы, которая интегрирует клинические данные с помощью стандарта Fast Healthcare Interoperability Resources (FHIR) в сочетании с генерацией с дополненным поиском (RAG), большими языковыми моделями (LLM) и многоагентной структурой клинического рассуждения для поддержки анализа медицинских данных и принятия клинических решений. Протокол описывает полный рабочий процесс, включая настройку вычислительной среды, предварительную обработку наборов клинических данных, интеграцию данных на основе FHIR, создание векторной базы данных, настройку поиска, проектирование промптов, оркестрацию многоагентной системы и оценку системы. Репрезентативные результаты демонстрируют способность платформы генерировать клинически значимые и контекстуально согласованные ответы, одновременно улучшая семантическую совместимость между разнородными источниками данных. Производительность системы оценивалась с использованием дополнительных количественных и семантических метрик, включая BLEU, ROUGE, BERTScore и косинусное сходство. Качественная оценка была проведена с использованием общедоступных, полностью анонимизированных эталонных наборов данных здравоохранения для оценки воспроизводимости предлагаемого методологического процесса. Предложенная архитектура сочетает стандартизированную совместимость систем здравоохранения с языковыми моделями с улучшенным поиском для совершенствования контекстуального рассуждения, снижения галлюцинаций и поддержки воспроизводимых клинических рабочих процессов с помощью ИИ. Данный протокол предоставляет масштабируемую и воспроизводимую структуру для исследователей и разработчиков, стремящихся внедрить совместимые, конфиденциальные и интеллектуальные системы здравоохранения для поддержки принятия клинических решений, анализа медицинских данных и будущих трансляционных исследований.
Введение
Информация о состоянии здоровья регулярно создается в больницах, диагностических центрах, лабораториях и амбулаторных клиниках, зачастую оставаясь распределенной между гетерогенными информационными системами. Такая фрагментация ограничивает совместимость и затрудняет своевременный доступ к полным медицинским картам пациентов, что создает постоянные трудности для оказания клинической помощи, интеграции данных и управления здравоохранением1,2,3,4.
Последствия такой фрагментации становятся особенно очевидными в клинических рабочих процессах, которые зависят от своевременного доступа к информации о пациенте. Когда медицинские работники не могут получить полные и интегрированные медицинские записи, проведение клинической оценки затрудняется, что повышает риск принятия неполных решений и снижает эффективность оказания медицинской помощи, особенно в экстренных ситуациях5,6.
Последние достижения в области искусственного интеллекта (ИИ), в частности большие языковые модели (LLM), расширили спектр вычислительных подходов, доступных для применения в здравоохранении. Эти модели исследовались в таких задачах, как помощь в диагностике, клиническая сортировка пациентов и поддержка принятия решений. Например, Jahan и др.5 оценили использование LLM в биомедицинских задачах, а Taylor и др.7 изучили дообученные модели для цифрового скрининга психического здоровья, сообщив об обнадеживающих результатах в специализированных клинических условиях.
Применение LLM также расширилось и на более специализированные клинические области. Song и др. 49 исследовали их использование в диагностике пневмокониоза, в то время как Chien и др.8 применили эти модели для анализа структуры рабочей нагрузки неофициальных лиц, осуществляющих уход. В офтальмологии Xue и др.9 предложили систему ответов на вопросы для диагностики глаукомы, а Tan и др.3 и Wu и др.10 сообщили об использовании LLM в гибридных диагностических системах и при консультациях по традиционной китайской медицине.
Использование LLM не ограничивается прямым клиническим применением. Zhang и соавт.11 исследовали их применение для распознавания эмоций в сценариях охраны психического здоровья, в то время как Sarzaeim и соавт.12 изучили интеллектуальные системы полицейского надзора, которые также могут способствовать анализу вопросов общественного здравоохранения. Эти исследования иллюстрируют широкую применимость подходов на основе LLM в различных областях, связанных со здравоохранением.
Несмотря на то что большие языковые модели (LLM) расширили возможности применения в здравоохранении, их интеграция в клиническую среду по-прежнему сопряжена с серьезными техническими, организационными и нормативными проблемами. Практическое внедрение требует наличия соответствующей вычислительной инфраструктуры, эффективного управления данными и соблюдения нормативно-правовых актов, таких как Общий регламент по защите данных (GDPR) и Общий закон Бразилии о защите персональных данных (LGPD). Эти документы устанавливают требования к безопасной и этичной обработке конфиденциальной медицинской информации, решая вопросы, связанные с конфиденциальностью, надежностью и алгоритмической предвзятостью в системах здравоохранения с поддержкой ИИ13,14.
Интероперабельность различных гетерогенных источников данных здравоохранения, включая электронные медицинские карты (ЭМК), системы медицинской визуализации и устройства интернета вещей (IoT), по-прежнему представляет собой серьезную техническую проблему для внедрения решений в области здравоохранения с применением ИИ. В этом контексте стандартизированные структуры интероперабельности, такие как HL7 FHIR, предоставляют структурированный механизм обмена клинической информацией между различными системами при сохранении семантической согласованности и поддержке масштабируемой интеграции.
В данной работе представлена интероперабельная веб-платформа, которая объединяет большие языковые модели со стандартами интероперабельности в здравоохранении для поддержки анализа медицинских данных в гетерогенных клинических средах. Предложенная архитектура сочетает в себе интеграцию данных на основе HL7 FHIR с генерацией с дополненным поиском (RAG) и многоагентной структурой обработки для обеспечения контекстно-зависимого анализа с помощью ИИ при соблюдении применимых требований к защите данных, включая Общий закон Бразилии о защите персональных данных (LGPD).
В данном протоколе описывается функционально совместимая архитектура для интеграции гетерогенных клинических данных с использованием установленных стандартов интероперабельности в здравоохранении. Также подробно описывается реализация многоагентного конвейера обработки на основе больших и малых языковых моделей (LLM и SLM), а также система оценки, сочетающая количественные показатели и качественный анализ для оценки работы предлагаемой платформы.
Протокол
Данное исследование не предполагало привлечения людей в качестве участников, доступа к идентифицируемым записям пациентов или проведения экспериментов на животных. Протокол был разработан и оценен исключительно с использованием общедоступных и полностью анонимизированных наборов данных для методологической валидации. Доступ к персональной медицинской информации не осуществлялся, обработка таких данных не проводилась. Таким образом, одобрение Институционального наблюдательного совета (IRB) или Комитета по этике исследований не требовалось. Протокол был разработан в соответствии с применимыми принципами защиты данных, включая Общий закон Бразилии о защите персональных данных (LGPD), для поддержки будущих приложений, использующих клинические данные.
Выбор и предобработка набора данных
Предложенный протокол был оценен с использованием общедоступных и полностью анонимизированных клинических наборов данных, включающих структурированные электронные медицинские карты (ЭМК), данные клинических систем ответов на вопросы и наборы данных медицинских изображений для методологической валидации. Перед интеграцией в платформу наборы данных прошли стандартные процедуры предварительной обработки, включая нормализацию данных, удаление противоречивых или неполных записей, сопоставление с ресурсами HL7 FHIR, очистку текста, сегментацию на фрагменты для поиска и генерацию эмбеддингов для векторного индексирования. Эти этапы предварительной обработки обеспечили семантическую согласованность разнородных источников данных, что способствовало операционной совместимости и позволило воспроизвести предложенный рабочий процесс при соблюдении применимых принципов конфиденциальности данных.
Наборы данных были получены из общедоступных репозиториев эталонных данных, которые широко используются в исследованиях в области искусственного интеллекта и цифрового здравоохранения. Они были выбраны таким образом, чтобы представлять гетерогенную клиническую информацию, включая структурированные электронные медицинские карты (ЭМК), неструктурированные клинические записи, задачи по ответам на клинические вопросы и метаданные медицинских изображений. Вместо оценки конкретной клинической когорты данный протокол сосредоточен на демонстрации воспроизводимого рабочего процесса реализации, который может быть адаптирован к различным наборам данных здравоохранения. Разнообразие этих эталонных наборов данных позволяет проверить конвейер функциональной совместимости, генерацию с дополненным поиском (RAG) и многоагентную систему рассуждений для различных модальностей клинических данных.
Конфигурация экспериментальной среды
Экспериментальная среда была настроена для оценки функциональной совместимости платформы в контролируемых и воспроизводимых условиях. Архитектура включает модули сбора данных, уровни взаимодействия, большие языковые модели (LLM) и компоненты оценки, организованные в единый конвейер обработки для анализа медицинских данных. На Рисунке 1 представлена полная схема рабочего процесса: от сбора клинических данных до формирования диагностических результатов.
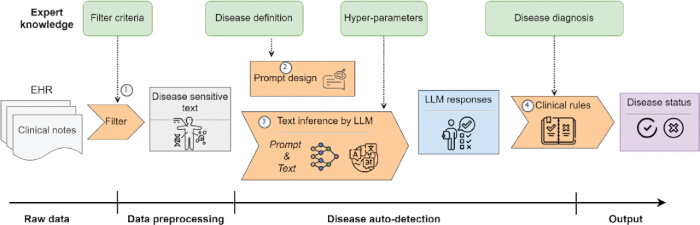
Рисунок 1: Общая схема работы системы, иллюстрирующая конвейер обработки от необработанных клинических данных до вывода о статусе заболевания. Процесс начинается со сбора электронных медицинских карт (ЭМК), за которым следует фильтрация и предварительная обработка данных для извлечения информации, имеющей значение для диагностики заболевания. Этап разработки структурированного промпта объединяет экспертные знания, определения заболеваний и гиперпараметры, обеспечивая эффективное взаимодействие с большой языковой моделью (LLM). LLM выполняет текстовый вывод для генерации контекстно-зависимых ответов, которые в дальнейшем оцениваются с помощью клинических правил для определения окончательного статуса заболевания. Схема подчеркивает интеграцию предварительной обработки данных, промптинга на основе знаний и логического вывода на базе ИИ для поддержки принятия клинических решений. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Архитектура операционной совместимости в здравоохранении
Инфраструктура серверной части имеет модульную архитектуру на базе RESTful API для обеспечения взаимодействия между компонентами платформы (Рисунок 2). Такая архитектура позволяет работать с разнородной клинической информацией, включая структурированные электронные медицинские карты (ЭМК), заметки врачей и метаданные, полученные из систем медицинской визуализации. Поскольку эти данные поступают из различных источников и в разных форматах, функциональная совместимость достигается за счет использования стандартизированных моделей данных, в частности, структуры Fast Healthcare Interoperability Resources (FHIR)15,16,17.. Внедрение FHIR поддерживает структурированный обмен информацией, обеспечивая при этом масштабируемость и гибкость в распределенных средах здравоохранения. Также были интегрированы механизмы связи на базе HL7 для облегчения интеграции с устаревшими клиническими системами, которые по-прежнему широко используются в медицинских учреждениях16,17.
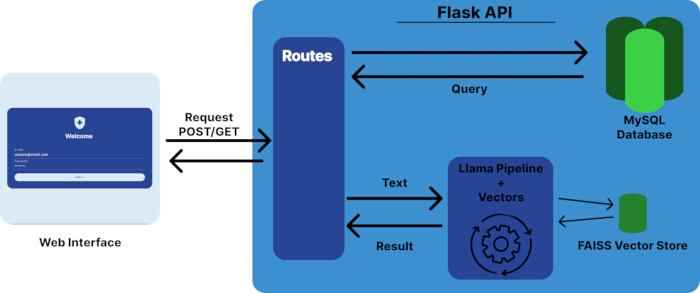
Рисунок 2: Архитектура предлагаемой интероперабельной платформы. Веб-интерфейс взаимодействует с бэкендом через Flask API с использованием HTTP POST/GET-запросов. API управляет маршрутизацией, обработкой запросов и взаимодействием как со структурированными, так и с неструктурированными источниками данных. База данных MySQL хранит структурированные клинические данные, в то время как векторное хранилище на базе FAISS обеспечивает поиск по сходству для операций извлечения. Конвейер на базе LLaMA обрабатывает текстовые входные данные и генерирует ответы с использованием векторных представлений, обеспечивая генерацию с дополненным поиском (RAG). Архитектура демонстрирует интеграцию веб-сервисов, управления базами данных, векторного поиска и вывода большой языковой модели в единую систему. Пожалуйста, нажмите здесь, чтобы просмотреть этот рисунок в большем размере.
Конфигурация многоагентного рабочего процесса
Мультиагентная архитектура состоит из специализированных функциональных агентов, ответственных за отдельные этапы рабочего процесса. Агент предварительной обработки выполняет нормализацию данных и сопоставление с FHIR, после чего вступает в работу агент поиска, отвечающий за семантический поиск в векторной базе данных. Агент рассуждения интегрирует извлеченный контекст с LLM для генерации ответов, а агент валидации проверяет согласованность и форматирование выходных данных перед выдачей окончательного ответа. Координация агентов осуществляется по стратегии последовательной оркестрации, при которой выходные данные каждого агента служат входными данными для следующего этапа, что обеспечивает воспроизводимость и модульность реализации.
Интеграция клинических данных
Уровень интеграции данных объединяет информацию из нескольких клинических источников и подготавливает ее для последующей обработки. Препроцессинг включает нормализацию данных, токенизацию и выравнивание сущностей для повышения семантической согласованности в гетерогенных наборах данных. Поскольку клиническая информация различается по структуре и качеству, эти операции помогают снизить уровень шума и облегчить взаимодействие с моделями ИИ. Также были применены стратегии структурированного сопоставления для гармонизации различных форматов данных и обеспечения совместимости с конвейером обработки, как показано на рисунке 315,16,17.
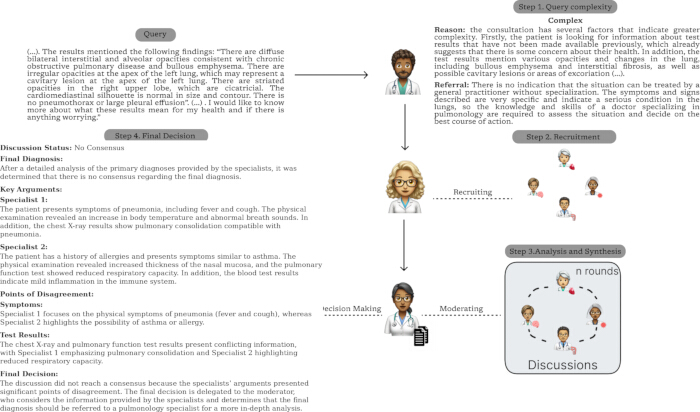
Рисунок 3: Подробный пример процесса многоагентного клинического рассуждения. На рисунке показано, как клинический запрос анализируется на нескольких этапах, включая оценку сложности, подбор специалистов, совместное обсуждение и принятие окончательного решения. Этот процесс демонстрирует способность системы динамически адаптировать стратегии рассуждения в зависимости от сложности запроса, что повышает как эффективность, так и диагностическую точность в сценариях поддержки принятия клинических решений. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Настройка конвейера генерации с дополненным поиском (RAG)
Генерация с дополненным поиском (Retrieval-Augmented Generation, RAG) внедрена для обеспечения контекстно-зависимого анализа путем объединения поиска информации с генеративными возможностями больших языковых моделей. Пользовательские запросы преобразуются в векторные представления с помощью моделей эмбеддинга и сопоставляются с векторной базой данных с использованием семантического поиска по сходству для извлечения наиболее релевантных контекстных фрагментов. Затем извлеченные документы объединяются с исходным запросом перед выводом LLM. Эта стратегия помогает предоставить контекстную информацию при генерации ответа и связана с повышением фактической точности и снижением уровня галлюцинаций в приложениях с интенсивным использованием знаний, включая здравоохранение18,19. Рисунок 1 и Рисунок 3 иллюстрируют общий рабочий процесс поиска и соответствующий процесс рассуждения.
Для каждого запроса пользователя итоговый промпт динамически формируется путем объединения исходного запроса с наиболее релевантными контекстными фрагментами, извлеченными из векторной базы данных. Извлеченная информация включается в качестве контекстуального обоснования перед этапом вывода, что позволяет языковой модели генерировать ответы, основанные на извлеченных знаниях в области здравоохранения, сохраняя при этом семантическую согласованность и сокращая количество необоснованных ответов.
Промпт-инжиниринг и многоагентный вывод
Протокол включает стратегии структурированного промптинга для улучшения контекстуальной интерпретации при генерации ответов. Эти методы промптинга в сочетании с передовыми механизмами вывода помогают направлять процесс рассуждения в сложных клинических сценариях и соответствуют последним разработкам, описанным в литературе20.
Архитектура включает многоагентный фреймворк, состоящий из специализированных модулей, которые выполняют отдельные функции в конвейере обработки, включая валидацию данных, фильтрацию контекста, поддержку клинического мышления и верификацию результатов. Модульная организация позволяет выполнять задачи последовательно или параллельно, обеспечивая гибкость в зависимости от различных требований к обработке (Рисунок 4). Распределение этих действий между несколькими агентами снижает зависимость от одной языковой модели и обеспечивает более надежный рабочий процесс обработки. Данная архитектурная стратегия соответствует современным разработкам в области распределенного искусственного интеллекта и проектирования интеллектуальных систем21,22.
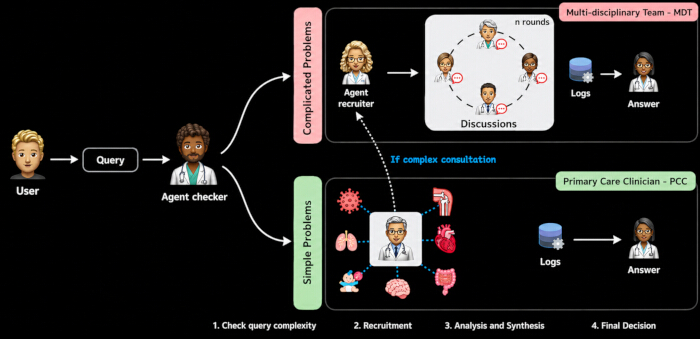
Рисунок 4: Многоагентная структура принятия решений для клинического мышления. Процесс начинается с пользовательского запроса, который оценивается агентом-контроллером, ответственным за определение сложности запроса. В сложных случаях система динамически привлекает многопрофильную команду (МПК) из специализированных агентов, которые проводят итерационные раунды обсуждений для анализа проблемы и синтеза знаний перед принятием окончательного решения. В более простых случаях запрос обрабатывается агентом врача первичного звена (PCC), что позволяет быстрее генерировать ответ. Эта адаптивная архитектура обеспечивает баланс между эффективностью и глубиной анализа, повышая качество принимаемых решений и масштабируемость системы в приложениях для здравоохранения. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Оценка эффективности
Эффективность системы оценивали с помощью взаимодополняющих метрик, которые позволяют определить как лингвистическое качество, так и семантическую согласованность сгенерированных результатов. Метрика BLEU применялась для измерения синтаксического сходства на основе перекрытия n-грамм23, в то время как ROUGE использовалась для оценки полноты и охвата содержания, особенно в задачах реферирования и извлечения информации24. Семантическое сходство оценивали с помощью BERTScore, которая использует контекстные эмбеддинги, полученные из моделей на базе трансформеров, для сравнения сгенерированных и эталонных текстов25. Дополнительный анализ включал определение перплексии и косинусного сходства для изучения уверенности модели и семантической когерентности соответственно26,27.
Выбранные метрики оценки обеспечивают взаимодополняющие представления о производительности системы за счет сочетания лексического и семантического анализов. Данная комбинация особенно актуальна для приложений в сфере здравоохранения, где контекстуальная интерпретация так же важна, как и лексическое сходство. Платформа оценивалась в контролируемой вычислительной среде, поддерживающей как облачное, так и локальное развертывание. Локальный запуск LLM был включен в качестве опции для обеспечения требований конфиденциальности данных и снижения зависимости от внешних сервисов при обработке конфиденциальной клинической информации. Такая стратегия развертывания совместима с нормативными базами по защите данных и может быть адаптирована к различным операционным средам4.
Результаты
Эффективность системы оценивали с помощью дополнительных количественных показателей в сочетании с качественным анализом, чтобы проверить как лингвистическую точность, так и семантическую согласованность сгенерированных результатов. Данная стратегия оценки сочетает лексические и семантические методы для обеспечения более широкой характеристики поведения модели при решении задач по генерации текстов в сфере здравоохранения.
Таблица 1 представляет количественные результаты, полученные с помощью BLEU, ROUGE и BERTScore. Эти метрики были выбраны, так как они оценивают взаимодополняющие аспекты сгенерированного текста, включая лексическое сходство, полноту охвата информации и семантическое соответствие, и широко используются в исследованиях по обработке естественного языка.
| Оцените | Запрос | Пирсон | СКОРМС (среднеквадратическая ошибка) | MAE (средняя абсолютная ошибка) | Частота попаданий |
| Mixtral | короткий | 0.098 | 1.779 | 1.346 | 6/28 |
| нулевой выбор (zero-shot) | 0.174 | 1.618 | 1.293 | 15/28 | |
| обучение на нескольких примерах | 0.475 | 1.673 | 1.367 | 9/28 | |
| LLaMA 3 | краткий | 0.485 | 1.617 | 1.314 | 11/28 |
| zero-shot (обучение без примеров) | 0.479 | 1.614 | 1.314 | 10/28 | |
| обучение по нескольким примерам | 0.425 | 1.652 | 1.339 | 13/28 | |
| LLaMA 3.1 | короткий | 0.349 | 1.621 | 1.318 | 06/28 |
| zero-shot (обучение с нулевым примером) | 0.68 | 1.614 | 1.307 | 12/28 | |
| обучение на нескольких примерах | 0.408 | 1.243 | 0.886 | 11/28 |
Таблица 1: Метрики количественной оценки предлагаемой системы.
Для количественной оценки синтаксического сходства на основе перекрытия n-грамм между сгенерированными результатами и эталонными текстами использовалась метрика BLEU23. Первоначально разработанная для машинного перевода, эта метрика также применяется в широком спектре задач генерации текста, поскольку она фиксирует структурное соответствие между текстами. В настоящем исследовании показатели BLEU указывают на то, что сгенерированные ответы сохраняют синтаксические характеристики, соответствующие эталонным результатам.
Для оценки сходства, ориентированного на полноту (recall), с акцентом на охват релевантной информации в сгенерированных текстах использовалась метрика ROUGE24. В приложениях для здравоохранения эта метрика особенно полезна, поскольку сохранение клинически значимой информации зачастую более важно, чем воспроизведение идентичных формулировок. Как показано в таблице 2, показатели ROUGE свидетельствуют о том, что сгенерированные ответы сохраняют соответствующее клиническое содержание во всех оцениваемых случаях.
| Эксперт | Промпт | ICC1 | ICC2 | ICC3 | ICC1k | ICC2k | ICC3K |
| Mixtral | короткий | 0.136 | 0.164 | 0.182 | 0.32 | 0.37 | 0.4 |
| zero-shot | 0.28 | 0.353 | 0.507 | 0.539 | 0.621 | 0.755 | |
| few-shot | 0.224 | 0.323 | 0.522 | 0.463 | 0.588 | 0.766 | |
| LLaMA3 | короткий | 0.234 | 0.331 | 0.532 | 0.479 | 0.597 | 0.773 |
| zero-shot | 0.244 | 0.34 | 0.551 | 0.492 | 0.607 | 0.786 | |
| few-shot | 0.218 | 0.321 | 0.531 | 0.456 | 0.587 | 0.772 | |
| LLaMA3.1 | короткий | 0.521 | 0.525 | 0.537 | 0.766 | 0.768 | 0.777 |
| zero-shot | 0.246 | 0.343 | 0.56 | 0.495 | 0.611 | 0.792 | |
| few-shot | 0.599 | 0.597 | 0.589 | 0.817 | 0.816 | 0.811 |
Таблица 2: Показатели согласованности оценок разных экспертов (ICC).
Для оценки семантического сходства с использованием контекстных эмбеддингов, полученных на основе моделей-трансформеров, была применена метрика BERTScore25. В отличие от BLEU и ROUGE, эта метрика сравнивает тексты по контекстуальному значению, а не по лексическому перекрытию, что делает её подходящей для оценки генерации клинического языка. Значения BERTScore, полученные в данном исследовании, указывают на высокую степень семантического соответствия между сгенерированными ответами и соответствующими эталонными текстами.
Дополнительные анализы включали определение перплексии и косинусного сходства для дополнения основных показателей оценки. Перплексия рассчитывалась для оценки предсказуемости сгенерированных выходных данных, при этом более низкие значения указывали на меньшую неопределенность при генерации текста26. Косинусное сходство использовалось для количественной оценки соответствия между векторами эмбеддингов, полученными из сгенерированных и эталонных текстов, что обеспечило дополнительный показатель семантической когерентности27.
В совокупности метрики оценки предоставляют взаимодополняющую информацию о синтаксических, семантических и контекстуальных характеристиках сгенерированных ответов. На рисунке 5 обобщены результаты распределения оценок по всем исследованным метрикам, что дает общее представление о производительности системы в протестированных условиях.
Результаты оценки согласуются с ожидаемым поведением генерации с дополненным поиском (Retrieval-Augmented Generation, RAG) в приложениях, требующих доступа к внешним источникам знаний. Благодаря включению найденных документов в процесс генерации ответа, архитектура предоставляет дополнительную контекстную информацию, которая обеспечивает клинически значимые ответы в сценариях, требующих глубоких знаний18,19. Структурированные стратегии промптинга используются в качестве дополнительных механизмов для управления процессом рассуждения и контекстуальной интерпретации, что соответствует подходам, описанным в последних исследованиях20.
Качественный анализ дополнил количественную оценку путем изучения интерпретируемости и клинической значимости полученных результатов. Репрезентативные примеры ответов системы для различных типов клинических запросов представлены на Рисунке 3. Эти примеры иллюстрируют, как платформа генерирует контекстуально связные ответы в рамках оцениваемых сценариев, включая случаи, содержащие более сложную клиническую информацию.
Мультиагентная архитектура распределяет задачи обработки между специализированными модулями, отвечающими за взаимодополняющие функции в рамках рабочего процесса. Такая организация снижает зависимость от одной языковой модели и позволяет реализовать несколько этапов обработки информации и проверки выходных данных, что соответствует современным мультиагентным подходам, описанным в литературе21,22. На рисунке 5 обобщены результаты оценки, полученные с использованием различных стратегий промптинга и языковых моделей, рассмотренных в данном исследовании.
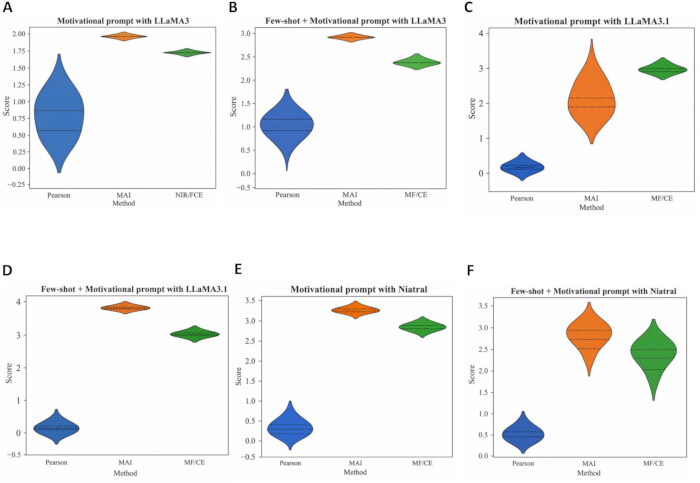
Рисунок 5: Распределение производительности предлагаемой системы при использовании различных стратегий промптинга и языковых моделей. (A–F) Скрипичные диаграммы иллюстрируют вариации качества ответов для коротких подсказок, а также подходов zero-shot и few-shot с использованием моделей LLaMA3, LLaMA3.1 и Mixtral. Результаты подчеркивают влияние дизайна промпта на согласованность и качество выходных данных, демонстрируя, что структурированные стратегии промптинга имеют тенденцию давать более стабильные и точные ответы при решении клинических задач. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Результаты оценки согласуются с недавними исследованиями, в которых рекомендуется сочетать лексические и семантические метрики для оценки производительности больших языковых моделей4,12. В частности, метрики на основе эмбеддингов становятся все более важными для фиксации контекстуального сходства при генерации текстов в сфере здравоохранения, где семантическая интерпретация выходит за рамки лексического соответствия28,29.
В целом, проведенная оценка показывает, что предлагаемая платформа объединяет стандарты функциональной совместимости, генерацию с дополненной выборкой (RAG) и многоагентную обработку в рамках единой структуры для анализа данных здравоохранения. Количественные и качественные результаты, представленные в данном исследовании, подтверждают осуществимость предложенного рабочего процесса в исследованных экспериментальных условиях и создают основу для дальнейшей валидации в реальных клинических условиях.
ДОСТУПНОСТЬ ДАННЫХ
Наборы данных, использованные в данном исследовании, находятся в открытом доступе. Набор данных рентгенограмм грудной клетки был получен из коллекции рентгенограмм грудной клетки Университета Индианы (Open-i, Национальная медицинская библиотека США), включая файлы indiana_reports.csv и indiana_projections.csv, доступные по адресу https://openi.nlm.nih.gov/. Контрольный набор данных MedQA общедоступен через его официальный репозиторий. В данном исследовании не использовались проприетарные или позволяющие идентифицировать пациентов клинические данные. Все процедуры предварительной обработки описаны в разделе «Протокол» для обеспечения воспроизводимости.
Обсуждение
Оценка, представленная в данном исследовании, представляет собой методологическую валидацию, проведенную с использованием общедоступных и полностью анонимизированных эталонных наборов данных здравоохранения. Проспективная клиническая валидация с участием медицинских работников или привлечением пациентов не проводилась, так как целью данной работы является демонстрация воспроизводимого протокола реализации, а не клиническая эффективность.
Результаты данного исследования позволяют предположить, что сочетание стандартов функциональной совместимости систем здравоохранения с большими языковыми моделями создает практическую основу для интеграции гетерогенной клинической информации. Предложенная архитектура объединяет механизмы обмена структурированными данными, включая FHIR и HL7, с обработкой языка на базе ИИ в рамках единого рабочего процесса, который соответствует современным тенденциям развития цифровых систем здравоохранения15,16,17.
Важным аспектом предлагаемого рабочего процесса является интеграция генерации с дополненным поиском (Retrieval-Augmented Generation, RAG) в рамках многоагентной архитектуры. В данной конфигурации извлеченные документы предоставляют дополнительную контекстную информацию при генерации ответа, что обеспечивает поддержку клинических задач, требующих глубоких специальных знаний. Такой архитектурный подход согласуется с результатами последних исследований, в которых механизмы на основе поиска описываются как стратегия повышения точности контекстуального обоснования и надежности ответов в приложениях на базе больших языковых моделей18,19.
В предлагаемый рабочий процесс были включены стратегии структурированного промптинга для обеспечения контекстуальной интерпретации при генерации ответов. В предыдущих исследованиях сообщалось, что промпт-инжиниринг и методы структурированного рассуждения могут повысить эффективность больших языковых моделей при решении сложных задач по принятию решений20. Подход, принятый в данном протоколе, соответствует этим разработкам и обеспечивает структурированную основу для обработки клинического языка.
С точки зрения оценки, использование взаимодополняющих метрик позволило изучить различные аспекты производительности системы. В то время как BLEU и ROUGE предоставляют информацию о синтаксическом сходстве и охвате контента23,24, метрики на основе эмбеддингов, такие как BERTScore, фиксируют семантические связи, которые могут не отражаться одним лишь лексическим перекрытием25. Эта многомерная стратегия оценки согласуется с недавними сравнительными исследованиями, в которых рекомендуется сочетать лексические и семантические показатели при оценке больших языковых моделей в приложениях для здравоохранения4,12.
Предложенный рабочий процесс представляет собой воспроизводимую методологическую основу для внедрения совместимых систем поддержки принятия клинических решений на базе ИИ. Вместо сравнительного анализа различных архитектур искусственного интеллекта данное исследование сосредоточено на документировании полного процесса внедрения, архитектуры системы, механизмов функциональной совместимости и методологии оценки для обеспечения воспроизводимости и последующего применения. Сравнительный анализ с использованием обычных LLM, конфигураций с отключенным RAG, дообученных моделей или традиционных подходов машинного обучения выходит за рамки данного методологического вклада и представляет собой важное направление для будущих исследований.
Последующее внедрение предлагаемой структуры в реальную клиническую практику потребует дополнительной валидации с участием медицинских работников, а также соблюдения применимых нормативных и этических требований. В зависимости от области применения такие системы могут подпадать под действие правил регулирования программного обеспечения как медицинского изделия (SaMD) и должны соответствовать требованиям, установленным регулирующими органами, включая Управление по санитарному надзору за качеством пищевых продуктов и медикаментов США (FDA) и Регламент Европейского союза по медицинским изделиям (MDR). Кроме того, для обеспечения безопасного и ответственного развертывания в условиях здравоохранения первостепенное значение будут иметь надежное управление данными, кибербезопасность, прозрачность и методы обеспечения клинической безопасности.
Качественный анализ дополнил количественную оценку, иллюстрируя характеристики сгенерированных ответов в репрезентативных клинических сценариях. Представленные примеры показывают, что платформа была способна создавать контекстуально связные ответы в исследуемых условиях, что позволило глубже понять интерпретируемость ответов помимо количественных показателей. Аналогичные наблюдения были зарегистрированы в исследованиях по применению больших языковых моделей в клинической практике, включая помощь в диагностике и взаимодействие с пациентами28,29,30,31.
Предложенная архитектура распределяет задачи по обработке между специализированными модулями, отвечающими за взаимодополняющие функции, включая валидацию данных, контекстную фильтрацию, поддержку клинического мышления и верификацию результатов. Такая модульная организация снижает зависимость от одной языковой модели и позволяет реализовать последовательные этапы обработки информации в рамках рабочего процесса. Аналогичные архитектурные стратегии описывались в недавних исследованиях распределенных систем ИИ и многоагентных структур, разработанных для сред с процессами принятия сложных решений21,22.
Некоторые аспекты реализации могут способствовать воспроизводимости и внедрению предлагаемого протокола. Последовательное сопоставление клинической информации со стандартом HL7 FHIR помогает сохранить семантическую совместимость на протяжении всего конвейера обработки данных. Аналогичным образом, предварительная обработка документов, стратегии разбиения на фрагменты (чанкинг), генерация эмбеддингов и векторная индексация влияют на работу процесса генерации с дополненным поиском (Retrieval-Augmented Generation) и должны быть настроены и проверены в соответствии с характеристиками целевого приложения. Проектирование промптов и оркестрация нескольких агентов также могут уточняться итеративно с использованием предметных знаний и отзывов экспертов для улучшения контекстуальной обоснованности при генерации ответов. Эти методы реализации соответствуют последним достижениям в области надежного искусственного интеллекта и языковых моделей с расширенным поиском18,19,20.
Следует признать некоторые ограничения данного исследования. Хотя оценка сочетала в себе взаимодополняющие количественные и качественные показатели, эти меры могут не в полной мере отражать все аспекты клинического мышления. Данное наблюдение согласуется с результатами предыдущих исследований, в которых рекомендуется использовать специализированные системы оценки для приложений в сфере здравоохранения12. Кроме того, платформа оценивалась в контролируемых условиях с использованием общедоступных и анонимизированных эталонных наборов данных, которые могут не в полной мере представлять вариативность и сложность реальных клинических условий.
Предложенная платформа была разработана в соответствии с установленными стандартами функциональной совместимости систем здравоохранения. Применение стандартов HL7 и FHIR обеспечивает структурированный обмен данными между гетерогенными информационными системами здравоохранения, предоставляя стандартизированную основу для интеграции клинической информации из нескольких источников. Данный архитектурный подход согласуется с текущими усилиями по разработке совместимых систем ИИ для распределенных сред здравоохранения15,16,17.
Успешная реализация предлагаемого рабочего процесса зависит от нескольких критических методологических этапов. Во-первых, клинические данные должны быть последовательно сопоставлены со стандартизированными ресурсами HL7 FHIR для обеспечения семантической совместимости между гетерогенными системами здравоохранения15,17. Во-вторых, предварительная обработка документов, включая нормализацию, стратегию разбиения на фрагменты (chunking) и генерацию эмбеддингов, должна быть тщательно настроена, поскольку эти этапы напрямую влияют на качество поиска в конвейере генерации с дополненным поиском (RAG)19,32,33. В-третьих, векторную базу данных следует пересобирать при каждом обновлении базы знаний для поддержания согласованности между индексируемыми документами и результатами поиска. Наконец, промпт-инжиниринг и многоагентная оркестрация должны проходить итерационную валидацию с использованием репрезентативных клинических сценариев для повышения контекстуальной точности, минимизации галлюцинаций и повышения воспроизводимости рабочих процессов поддержки принятия клинических решений с помощью ИИ4,3,20,31.
С точки зрения поиска и устранения неисправностей, распространенные проблемы при внедрении включают неполное сопоставление ресурсов FHIR, снижение производительности поиска, связанное с индексацией документов или конфигурацией векторной базы данных, а также ответы, на которые повлияло недостаточное количество контекстной информации или субоптимальный промпт-инжиниринг. Эти проблемы могут быть решены путем валидации ресурсов совместимости, оптимизации параметров поиска, периодического обновления или пересборки векторной базы данных после внесения изменений в базу знаний, а также непрерывной оценки с использованием дополнительных лексических и семантических метрик. Данные методы обеспечивают стабильную работу системы и облегчают развертывание и сопровождение рабочих процессов поддержки принятия клинических решений с помощью ИИ4,12,25,23..
С практической точки зрения, внедрение больших языковых моделей в среду здравоохранения требует учета вычислительных ресурсов и требований к инфраструктуре. Хотя предлагаемая архитектура поддерживает как облачное, так и локальное исполнение, могут потребоваться дополнительные стратегии оптимизации в зависимости от масштаба развертывания и доступных вычислительных ресурсов, особенно в условиях ограниченных ресурсов4.
Будущие исследования могут расширить предлагаемый рабочий процесс путем оценки платформы на реальных клинических наборах данных и в рамках рутинных процессов медицинского обслуживания. Дополнительные изыскания также могут быть направлены на изучение стратегий доменной тонкой настройки и интеграцию методов объяснимого ИИ для повышения интерпретируемости моделей и обеспечения прозрачности при поддержке принятия клинических решений. Эти направления могут способствовать более широкой оценке платформы в условиях практического здравоохранения.
В целом, данная работа представляет собой воспроизводимую структуру для интеграции стандартов функциональной совместимости в здравоохранении, генерации с дополненным поиском (Retrieval-Augmented Generation, RAG) и многоагентных архитектур языковых моделей в единый рабочий процесс обработки клинических данных. Предложенный протокол обеспечивает структурированный подход к внедрению и оценке систем анализа медицинских данных с помощью ИИ и может служить ориентиром для будущих разработок в области функционально совместимых систем поддержки принятия клинических решений.
Раскрытие информации
Авторы заявляют об отсутствии конкурирующих финансовых интересов или личных отношений, которые могли бы повлиять на работу, представленную в данной рукописи. Инструменты генеративного искусственного интеллекта (ИИ) использовались исключительно для помощи в редактировании языка, исправлении грамматики и повышения читабельности текста. Все научное содержание, дизайн исследования, методология, анализ данных, интерпретация результатов и редакционные решения были разработаны, проверены и утверждены авторами, которые несут полную ответственность за содержание данной рукописи.
Благодарности
Авторы хотели бы поблагодарить Лабораторию встраиваемых и распределенных систем (LESC) Федерального университета Сеары (UFC) за предоставление условий для проведения исследований и технические дискуссии, которые способствовали разработке данной работы. Авторы также выражают признательность разработчикам и сопровождающим программное обеспечение с открытым исходным кодом, стандарты функциональной совместимости и общедоступные наборы данных, использованные в данном исследовании.
Материалы
| Имя | Компания | Каталожный номер | Комментарии |
|---|---|---|---|
| FAISS | Meta Platforms Inc. | Version 1.8.0 | Векторная база данных, используемая для поиска сходства в конвейере генерации с дополненным поиском (RAG). |
| FHIR Standard | HL7 International | Release 4 (R4) | Стандарт функциональной совместимости в здравоохранении, принятый для структурированного обмена клиническими данными. |
| Flask | Pallets Projects | Version 3.0.3 | Веб-фреймворк Python, используемый для реализации RESTful API бэкенда. |
| HL7 Standard | HL7 International | Version 2.x | Устаревший протокол обмена сообщениями, используемый для обеспечения совместимости с госпитальными информационными системами. |
| HTTP REST API | Custom Implementation | N/A | Слой RESTful-коммуникации между фронтендом, бэкендом, базой данных и сервисами ИИ. |
| LangChain | LangChain Inc. | Version 0.3.x | Фреймворк, используемый для интеграции LLM, промпт-инжиниринга и рабочих процессов генерации с дополненным поиском. |
| LangGraph | LangChain Inc. | Version 0.2.x | Фреймворк, используемый для оркестрации многоагентного рабочего процесса клинического рассуждения. |
| LLaMA 3.1 8B Instruct | Meta Platforms Inc. | Version 3.1 | Большая языковая модель, применяемая для клинического рассуждения и генерации естественного языка. |
| MySQL Community Server | Oracle Corporation | Version 8.0 | Реляционная база данных, используемая для хранения структурированных клинических данных. |
| Ollama | Ollama Inc. | Version 0.9.x | Локальный движок инференса, используемый для выполнения больших языковых моделей с соблюдением конфиденциальности пациентов. |
| Python | Python Software Foundation | Version 3.11 | Язык программирования, использованный для реализации всей платформы. |
| PyTorch | Linux Foundation | Version 2.4 | Фреймворк глубокого обучения, используемый для инференса больших языковых моделей. |
| Retrieval-Augmented Generation (RAG) Pipeline | Custom Implementation | N/A | ИИ-фреймворк, объединяющий семантический поиск с инференсом LLM для генерации контекстно-зависимых ответов. |
| Sentence Transformers | Hugging Face Inc. | all-MiniLM-L6-v2 | Модель эмбеддингов, используемая для генерации плотных векторных представлений для семантического поиска документов. |
| Ubuntu Linux | Canonical Ltd. | Version 24.04 LTS | Операционная система, используемая для разработки и экспериментальной оценки. |
| Visual Studio Code | Microsoft Corporation | Version 1.100 | Интегрированная среда разработки, используемая для реализации программного обеспечения и отладки. |
Ссылки
- Chukwu E, Garg L. A systematic review of blockchain in healthcare: frameworks, prototypes, and implementations. IEEE Access. 2020;8:21196-21214. doi:10.1109/ACCESS.2020.2969881.
- Al-Nbhany WANA, Zahary AT, Al-Shargabi AA. Blockchain-IoT healthcare applications and trends: a review. IEEE Access. 2024;12:4178-4212. doi:10.1109/ACCESS.2023.3349187.
- Tan Y, et al. MedChatZH: a Chinese medical large language model. Comput Biol Med. 2024;172:108290.
- OLLAMA TEAM. Ollama: Run Large Language Models locally. Version 0.x. San Francisco: Ollama, 2024.
- Jahan I, Laskar MTR, Peng C, Huang JX. A comprehensive evaluation of large language models on benchmark biomedical text processing tasks. Comput Biol Med. 2024;171:108189. doi:10.1016/j.compbiomed.2024.108189.
- Liu X, Zhou Y, Wang Z, et al. Disease topic modeling of users' inquiry texts: a text mining-based PQDR-LDA model for analyzing the online medical records. IEEE Trans Eng Manag. 2023.
- Taylor N, Kormilitzin A, Lorge I, Nevado-Holgado A, Cipriani A, Joyce DW. Model development for bespoke large language models for digital triage assistance in mental health care. Artif Intell Med. 2024;157:102988.
- Song M, et al. PneumoLLM: a large language vision model for pneumonia diagnosis. Med Image Anal. 2024;97:103248.
- Chien SC, Yen CM, Chang YH, Chen YE, Liu CC, Hsiao YP, et al. Using large language model (LLM) to identify high-burden informal caregivers in long-term care. Comput Methods Programs Biomed. 2024;255:108329. doi:10.1016/j.cmpb.2024.108329.
- Xue X, Zhang D, Sun C, et al. Xiaoqing: a Q&A model for glaucoma based on LLMs. Comput Biol Med. 2024;174:108399.
- Wu D, Nie L, Mumtaz RA, Agarwal K. A LLM-based hybrid-transformer diagnosis system in healthcare. IEEE J Biomed Health Inform. 2024.
- Zhang Y, et al. LLM-enhanced multi-teacher knowledge distillation for modality-incomplete emotion recognition in daily healthcare. IEEE J Biomed Health Inform. 2024.
- Sarzaeim P, Mahmoud QH, Azim A. A framework for LLM-assisted smart policing system. IEEE Access. 2024;12:74915-74929. doi:10.1109/ACCESS.2024.3404862.
- Leme RS, Blank M. Lei Geral de Proteção de Dados e segurança da informação na área da saúde. Cad Ibero-Am Direito Sanit. 2020;9(3):210-224. doi:10.17566/ciads.v9i3.690.
- Zaganelli MV, Binda Filho DL. O sigilo médico e os dados sensíveis na telemedicina à luz da Lei Geral de Proteção de Dados. RECIIS. 2023;17(3):729-740. doi:10.29397/reciis.v17i3.3689.
- Tabari P, Costagliola G, De Rosa M, Boeker M. State-of-the-art Fast Healthcare Interoperability Resources (FHIR)-based data model and structure implementations: systematic scoping review. JMIR Med Inform. 2024.
- Martinez T, et al. HL7 systems and interoperability ecosystems in modern healthcare. IEEE Rev Biomed Eng. 2024.
- Chen L, et al. HL7 integration and semantic interoperability in distributed healthcare networks. IEEE J Biomed Health Inform. 2024.
- Liu W, Li W, Huang W, Gao Y. Security framework for medical data sharing. Telemed E-Health. 2024.
- Basile LJ, Carbonara N, Panniello U, Pellegrino R. How can technological resources improve the quality of healthcare service? IEEE Trans Eng Manag. 2024;71:5771-5781. doi:10.1109/TEM.2022.3192405.
- Singh A, et al. Prompt engineering in large language models: a survey using SWOT analysis [preprint]. arXiv. 2024
- Chen L, Chen Y, Liang W, Li X, Li KC, Wang J, Xiong N. MASS: a multiattribute sketch secure data sharing scheme for IoT wearable medical devices based on blockchain. IEEE Internet Things J. 2025;12(2):1990-2001. doi:10.1109/JIOT.2024.3468733.
- Autoridade Nacional de Proteção de Dados (BR). Diretrizes para agentes de tratamento de pequeno porte. Brasília (DF): ANPD; 2021.
- Patel R, Kim H. Interoperability in EHR. IEEE Transactions on Biomedical Engineering, v. 70, n. 8, p. 2341-2354, ago. 2023. DOI: 10.1109/TBME.2023.3241567.
- Zhang T, Kishore V, Wu F, Weinberger KQ, Artzi Y. BERTScore: evaluating text generation with BERT. In: International Conference on Learning Representations (ICLR); 2020.
- Chen X, Lu X, Li Q, Li D, Zhu F. Integration of LLM and Human-AI Coordination for Power Dispatching With Connected Electric Vehicles Under SAGVNs. IEEE Trans Veh Technol. 2025;74(2):1992-2002. doi:10.1109/TVT.2024.3434969
- Zhou S, Chen C, Gu HH. Testing and evaluating SNOMED CT web browsers' textual search feature. In: Proceedings of the IEEE International Conference on Bioinformatics and Biomedicine (BIBM); 2019.
- McPeak G, Sautmann A, George O, Hallal A, Simal EA, Schwartz AL, Abaluck J, Ravi N, Pless R. An LLM's medical testing recommendations in a Nigerian clinic: potential and limits of prompt engineering for clinical decision support. In: Proceedings of the 2024 IEEE 12th International Conference on Healthcare Informatics (ICHI); 2024.
- LLAMA TEAM, AI @ META. The Llama 3 Herd of Models. arXiv preprint arXiv:2407.21783, 2024. Disponível em: https://arxiv.org/abs/2407.21783.
- Conselho Nacional de Saúde (BR). Resolução nº 466, de 12 de dezembro de 2012. Aprova as diretrizes e normas regulamentadoras de pesquisas envolvendo seres humanos. Brasília (DF): Ministério da Saúde; 2012.
- Singhal K, Azizi S, Tu T, et al. Large language models encode clinical knowledge. Nature. 2023;620:172-180. doi:10.1038/s41586-023-06291-2.
- Sahoo P, et al. A systematic survey of prompt engineering in large language models [preprint]. arXiv. 2024. Available from: https://arxiv.org/abs/2402.07927
- Yan Y, Hou Y, Xiao Y, Zhang R, Wang Q. KNOWNET: guided health information seeking from LLMs via knowledge graph integration. IEEE Trans Vis Comput Graph. 2024.