В данном исследовании представлена двухэтапная схема классификации земельного покрова по гиперспектральным данным и данным LiDAR, использующая извлечение признаков с помощью MetaFormer и двунаправленное сопоставление потоков (bidirectional flow matching) для кросс-модального выравнивания перед слиянием. Оценка на трех общедоступных эталонных наборах данных демонстрирует конкурентоспособную эффективность классификации при соблюдении фиксированных протоколов тестирования.
Исследовательская статья
Непрерывное кросс-модальное обучение векторных полей для классификации земельного покрова на основе гиперспектральных данных и данных LiDAR
В этой статье
Краткое содержание
Аннотация
Мультимодальная классификация данных дистанционного зондирования играет важную роль в таких приложениях, как картирование городских территорий и мониторинг окружающей среды. Однако гетерогенное распределение признаков в разных модальностях зондирования может привести к смещению признаков и семантической несогласованности, что ограничивает эффективность мультимодального слияния. Существующие подходы к мультимодальному слиянию, включая сверточные, графовые, основанные на механизмах внимания, контрастивные, транспортные и последовательные методы, позволяют использовать взаимодополняющую информацию, но могут недостаточно точно выравнивать распределения признаков, специфичные для каждой модальности. В данном исследовании предлагается FlowErs — двухэтапный фреймворк мультимодальной классификации, который решает эту проблему с помощью мультимодального сопоставления потоков (flow matching). Рабочая гипотеза заключается в том, что уменьшение расхождений между парными распределениями признаков перед их слиянием повышает точность классификации земельного покрова при фиксированных протоколах тестирования. На первом этапе специфичные для каждой модальности энкодеры MetaFormer извлекают иерархические представления из данных гиперспектральной съемки (HSI) и данных лидара (LiDAR). Затем модуль мультимодального сопоставления потоков обучается временным полям скоростей для переноса парных распределений признаков к общему латентному представлению с использованием двунаправленной целевой функции среднеквадратической ошибки. На втором этапе предобученный модуль выравнивания используется повторно для согласования мультимодальных представлений перед тем, как легковесная головка слияния выполнит попиксельную классификацию. Оценка на трех общедоступных наборах эталонных данных продемонстрировала максимальную общую точность (OA) 97,56% при фиксированном разделении выборок. Результаты варьировались в зависимости от конкретных классов земельного покрова, и в исследовании обсуждаются ограничения по отдельным классам, а также влияние дисбаланса классов на совокупные метрики. Текущая оценка ограничена экспериментами с фиксированным разделением выборок без статистического анализа повторных запусков или профилирования вычислительных затрат. Будущие работы будут направлены на исследование статистической устойчивости, вычислительной эффективности и обобщающей способности для различных регионов.
Введение
Точная классификация землепользования и почвенного покрова (LULC) с использованием данных дистанционного зондирования имеет решающее значение для широкого спектра практических приложений, включая городское развитие, экологический мониторинг, ликвидацию последствий стихийных бедствий и устойчивое развитие1. В последние годы стали более доступными мультимодальные данные дистанционного зондирования, включая гиперспектральные изображения (HSI), данные лидара (LiDAR) и радиолокационного синтезирования апертуры (SAR). Эта доступность существенно расширила возможности дистанционного зондирования для детальной классификации почвенного покрова2. Данные методы зондирования фиксируют различные, но дополняющие друг друга характеристики земной поверхности. HSI предоставляет богатую спектральную информацию для определения состава материалов, тогда как LiDAR обеспечивает точные структурные данные и сведения о высоте3. Интеграция этих гетерогенных источников данных позволяет создавать более дискриминативные, устойчивые к шумам и семантически полные представления признаков, чем при использовании любой из модальностей по отдельности4.
Тем не менее, эффективное использование мультимодальных данных остается давней проблемой5. Основная сложность заключается в присущей модальностям сенсоров неоднородности, которые различаются по пространственному разрешению, характеристикам шума, статистическим распределениям и семантике признаков6. Например, один и тот же объект земного покрова может быть представлен как многомерная спектральная сигнатура в HSI и как разреженные геометрические структуры в LiDAR7. Следовательно, признаки конкретных модальностей часто находятся в разных многообразиях признаков, что делает прямое объединение признаков неэффективным или потенциально ошибочным. Более того, многие существующие подходы к мультимодальному слиянию, включая методы на основе сверток, механизмов внимания и трансформеров, неявно предполагают, что признаки, извлеченные из разных датчиков, уже пространственно и семантически выровнены8. Однако в практических приложениях это предположение часто оказывается неверным. Простое объединение признаков (конкатенация) или попиксельное слияние не позволяют адекватно учесть кросс-модальные несоответствия, что может привести к нестабильной оптимизации и снижению обобщающей способности. Кроме того, хотя методы слияния на основе внимания улучшают взаимодействие признаков, они могут обеспечить ограниченное моделирование дальних кросс-модальных зависимостей, необходимых для крупномасштабной или высокоразрешающей классификации земного покрова9. Таким образом, эффективное выравнивание неоднородных представлений признаков остается главной проблемой в мультимодальном дистанционном зондировании, поскольку несовместимые эмбеддинги могут ограничить интеграцию дополняющей информации.
Для решения этой задачи кросс-модальное выравнивание формулируется как проблема условного переноса признаков. Сопоставление потоков (flow matching) предоставляет математически обоснованную структуру для изучения непрерывных и обратимых отображений между гетерогенными распределениями признаков10. Метод переносит одно распределение в другое через зависящее от времени поле скоростей, параметризованное обыкновенным дифференциальным уравнением (ОДУ), что способствует непрерывным преобразованиям между многообразиями признаков11. В отличие от диффузионных моделей, которые полагаются на стохастические шумовые возмущения или неявное сопоставление распределений посредством состязательного обучения, сопоставление потоков изучает детерминированные биективные преобразования между структурированными пространствами признаков12. Эти характеристики делают сопоставление потоков подходящим для мультимодального дистанционного зондирования, где HSI, LiDAR и SAR представляют собой многомерные многообразия признаков, фиксирующие взаимодополняющие свойства земной поверхности13. Соответственно, сопоставление потоков обеспечивает принципиальный подход к установлению кросс-модальной корреспонденции посредством непрерывного переноса признаков, поддерживая при этом геометрическую согласованность в процессе выравнивания признаков. При соответствующих предположениях о регулярности поток ОДУ может обеспечить обратимое отображение; однако точная обратимость и физическая интерпретируемость в данном исследовании эмпирически не оценивались. Рабочая гипотеза заключается в том, что уменьшение расхождений между парными распределениями признаков перед их объединением улучшает совокупную классификацию земельного покрова при фиксированных вариантах разделения эталонных выборок.
Исходя из этих соображений, предлагаемая архитектура FlowErs включает этап выравнивания на основе потоков в рамках двухэтапной структуры. На первом этапе обучается двунаправленная потоковая сеть для выравнивания многообразий признаков каждой модальности. В частности, специфичные для модальностей магистральные сети MetaFormer извлекают иерархические вложения признаков, а целевая функция сопоставления потоков оптимизируется для переноса выборок между распределениями признаков конкретных модальностей. Этот процесс обеспечивает гладкое и обратимое преобразование между пространствами признаков, что способствует более тесному выравниванию репрезентаций, относящихся к одному семантическому классу, в рамках общего латентного домена. На втором этапе предварительно обученный выравниватель потоков замораживается, и новые мультимодальные входные данные преобразуются перед объединением с помощью легковесного классификатора. Такая стратегия раздельного обучения отделяет геометрическое выравнивание от семантической классификации, позволяя двум этапам оптимизировать взаимодополняющие задачи. Модуль выравнивания предназначен для уменьшения расхождений в распределении признаков перед их слиянием и не претендует на доказанную гарантию сохранения объема. Кроме того, FlowErs предоставляет явную формулировку переноса признаков для мультимодального слияния, хотя устойчивость к ошибкам регистрации в данной работе отдельно не оценивалась.
Основные результаты данного исследования резюмированы следующим образом. Представлена FlowErs — двухэтапная структура для мультимодальной классификации земельного покрова. В предлагаемой структуре признаки каждой модальности сначала извлекаются с помощью кодировщиков MetaFormer, а затем выравниваются через модуль на основе потоков перед облегченным слиянием признаков. Такой раздельный дизайн обеспечивает эффективную оптимизацию при сохранении гибкости для различных модальностей дистанционного зондирования. Кроме того, в данной работе исследуется условное сопоставление потоков (conditional flow matching) как механизм переноса признаков для парного кросс-модального выравнивания признаков в мультимодальном дистанционном зондировании. Двунаправленный модуль потока предсказывает противоположные целевые значения скорости для парных представлений признаков перед их слиянием, обеспечивая тем самым явную стратегию выравнивания перед мультимодальной интеграцией. Далее предлагаемая структура была протестирована на трех открытых эталонных наборах данных, достигнув максимальной общей точности (OA) 97,56% при использовании предоставленных фиксированных разбиений. Также подробно задокументированы ограничения на уровне классов и область проведения текущей оценки.
Последние достижения в области сопоставления потоков (flow matching) утвердили этот метод в качестве мощного фреймворка генеративного моделирования, объединяющего диффузионные модели, модели на основе энергии и транспортные модели. Вместо симуляции стохастических траекторий, как в диффузионных моделях, flow matching обучает детерминированное обыкновенное дифференциальное уравнение (ОДУ), которое переносит простое априорное распределение, такое как гауссов шум, в целевое распределение данных через обучаемое поле скоростей15. Такая формулировка напрямую связывает оценку скора (score estimation) с эволюцией плотности, что приводит к более плавным траекториям вероятностей и более стабильной динамике обучения. Ключевым преимуществом flow matching является его детерминированная и вычислительно эффективная формулировка. Модели ректифицированного потока (rectified flow)16 еще больше упрощают транспортные траектории, превращая их в почти прямые пути, что повышает численную стабильность и позволяет генерировать высококачественные образцы за относительно небольшое количество шагов интегрирования. Последующие исследования, включая модели согласованности (consistency models)17, интегрировали цели, вдохновленные диффузией, в компактные фреймворки на основе потоков для достижения сопоставимого или более высокого качества образцов при эффективном выводе. Кроме того, обучение на основе потоков может использовать предобученные диффузионные базовые модели (backbones), что облегчает использование крупномасштабных генеративных априорных знаний при одновременном снижении затрат на семплирование. В недавних работах метод flow matching был расширен на широкий спектр приложений. Например, Hu и соавторы18 исследовали трансформерные архитектуры и манипуляции в латентном пространстве для управляемого и комбинируемого редактирования изображений с помощью flow matching. Другие области применения включают синтез изображений19, диагностику неисправностей подшипников20, а также многоцелевую многошовную роботизированную сварку21. В совокупности эти исследования демонстрируют, что flow matching применим не только для синтеза высокоразрешенных и условных изображений, обеспечивая при этом прочную теоретическую базу с потенциалом для обобщения на разные домены. Обучая непрерывные детерминированные транспортные отображения, flow matching обеспечивает баланс между эффективностью, управляемостью и точностью генерации. Его формулировка на основе ОДУ предлагает единый взгляд на современное генеративное моделирование и создает теоретическую основу для приложений, включающих мультимодальное представление данных и выравнивание признаков.
Мультимодальная классификация при дистанционном зондировании направлена на преодоление ограничений отдельных методов зондирования путем интеграции дополняющей информации из гиперспектральных изображений (HSI), мультиспектральных изображений, данных LiDAR и SAR. Подходы раннего слияния опирались на вручную созданные признаки или алгоритмы на основе ядер, такие как метод опорных векторов (SVM), однако они были ограничены высокой размерностью и недостаточным кросс-модальным взаимодействием22. Достижения в области глубокого обучения позволили реализовать структурированные стратегии слияния, включая раннее, промежуточное и позднее слияние, при этом слияние на уровне признаков обеспечивает практический баланс между интеграцией информации и вычислительной сложностью23. Сверточные нейронные сети (CNN) эффективно улавливают локальную пространственно-спектральную информацию, в то время как архитектуры на основе трансформеров моделируют дальние зависимости при более высоких вычислительных затратах24. Следовательно, гибридные архитектуры CNN–Transformer становятся все более популярными, поскольку они объединяют взаимодополняющие преимущества обоих подходов. Характерными примерами являются методы слияния соседних масштабов, которые расширяют контекстуальную информацию за счет межмасштабных взаимодействий25, и многоуровневые структуры, объединяющие поверхностные признаки CNN с глубокими представлениями трансформеров с помощью адаптивных механизмов внимания26. В совокупности эти исследования подчеркивают важность эффективного межмасштабного и кросс-модального взаимодействия для снижения избыточности признаков и улучшения семантического представления.
В последнее время также изучались дополнительные стратегии для мультимодального обучения. Например, методы низкорангового представления, такие как структура на основе кривой Эббингауза, позволяют уменьшить переобучение за счет сохранения структуры многообразия при одновременном подавлении избыточной информации27. Параллельно с этим исследовалось распределенное мультимодальное обучение для решения проблем конфиденциальности и ограничений связи в практических приложениях. Например, FedFusion проецирует поверхностные признаки в низкоранговые подпространства для обеспечения федеративного мультимодального обучения28. В совокупности эти исследования иллюстрируют три взаимодополняющих направления: гибридные архитектуры CNN–Transformer для баланса между локальным и глобальным моделированием признаков, низкоранговое обучение для уменьшения избыточности и шума, а также распределенное обучение для масштабируемого и обеспечивающего конфиденциальность развертывания. Тем не менее, остаются важные проблемы, включая дисбаланс модальностей, ограниченную доступность размеченных данных и компромисс между сжатием модели и точностью классификации. Эти трудности стимулировали дальнейшие исследования легковесных, обобщающих фреймворков мультимодального слияния. Современные подходы к мультимодальному выравниванию также включают в себя кросс-модальное внимание, контрастивное обучение, слияние на основе графов, адаптацию домена и стратегии сопоставления распределений. В отличие от них, FlowErs формулирует мультимодальное выравнивание как парный, обусловленный временем перенос признаков и представляется как дополнительная стратегия выравнивания, а не как универсальная замена существующим подходам.
Протокол
В данном исследовании для классификации земного покрова по данным дистанционного зондирования использовались исключительно общедоступные эталонные наборы данных (Houston2013, Augsburg и MUUFL). Участие людей, эксперименты на животных или сбор новых биологических образцов не проводились. Таким образом, одобрение институционального комитета по этике не требовалось.
Обзор исследования
Предлагаемая архитектура FlowErs осуществляет мультимодальную классификацию земельного покрова с помощью двухэтапной стратегии обучения. Общий рабочий процесс показан на Рисунке 1A–C. Архитектура состоит из трех основных компонентов: (i) энкодеров на базе MetaFormer, которые извлекают иерархические представления признаков из гетерогенных модальностей дистанционного зондирования, (ii) модуля мультимодального сопоставления потоков (MFM), который эксплицитно выравнивает распределения признаков разных модальностей, и (iii) легковесной классификационной головы, которая предсказывает категории земельного покрова на основе объединенных представлений признаков. Общий рабочий процесс сначала извлекает признаки, специфичные для каждой модальности, затем выравнивает эти признаки в общем латентном пространстве с помощью условного сопоставления потоков и, наконец, выполняет попиксельную классификацию земельного покрова с использованием выровненных мультимодальных представлений.
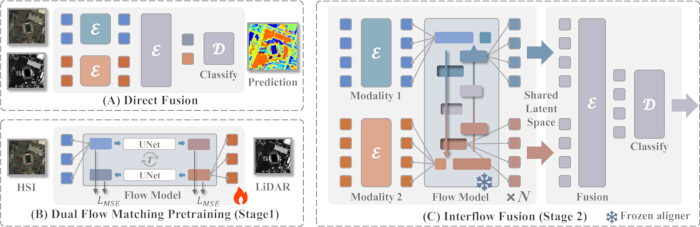
Рисунок 1: Обзор предлагаемой структуры FlowErs для мультимодальной классификации земельного покрова. (A) Традиционное прямое слияние признаков, при котором специфичные для каждой модальности признаки, извлеченные из гиперспектральных изображений (HSI) и данных лидара (LiDAR), объединяются напрямую перед классификацией. (B) Этап 1: Двунаправленное предварительное обучение с сопоставлением мультимодальных потоков. Обучаемая U-Net с временным условием изучает непрерывный двунаправленный перенос признаков между специфическими представлениями модальностей, используя функцию потерь среднеквадратической ошибки для выравнивания гетерогенных распределений признаков. (C) Этап 2: Слияние межпотоков. Предобученный модуль сопоставления потоков замораживается и используется повторно для выравнивания специфических представлений признаков модальностей перед облегченным слиянием признаков и попиксельной классификацией земельного покрова. E — энкодер; D — декодер; T — временное вложение; , функция потерь среднеквадратической ошибки; S — общее латентное представление. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Предлагаемая структура разделяет выравнивание признаков и семантическую классификацию с помощью двухэтапной стратегии обучения. На первом этапе модуль MFM обучается осуществлять двунаправленный перенос признаков между многообразиями признаков, специфичными для каждой модальности. На втором этапе предварительно обученный модуль выравнивания потока замораживается и используется повторно для выравнивания мультимодальных представлений признаков перед облегченным слиянием признаков и классификацией. Такой раздельный дизайн позволяет модулю выравнивания и сети классификации оптимизировать взаимодополняющие цели, одновременно сокращая расхождения в распределении признаков перед мультимодальным слиянием.
Теоретический обзор
Сопоставление потоков (flow matching) представляет собой недавно предложенную парадигму генеративного моделирования, которая изучает непрерывное детерминированное преобразование между двумя распределениями вероятностей. В отличие от диффузионных моделей, в которых стохастичность вносится за счет шумовых возмущений, сопоставление потоков напрямую параметризует обучаемое поле скоростей, которое непрерывно переносит одно распределение вероятностей в другое. Такая формулировка непрерывного переноса обеспечивает выравнивание признаков с помощью обыкновенного дифференциального уравнения (ODE), позволяя парным представлениям признаков из различных модальностей сенсоров развиваться вдоль общей траектории перед объединением признаков. В настоящем исследовании используется условное сопоставление потоков для изучения двунаправленного переноса признаков между специфичными для каждой модальности эмбеддингами, извлеченными кодировщиками MetaFormer. Модель обучается с использованием целевой функции условного сопоставления потоков, которая минимизирует расхождение между предсказанным и целевым полями скоростей для интерполированных представлений признаков. Полная математическая формулировка, теоретический вывод, определяющие уравнения и целевая функция обучения представлены в Дополнительном файле 1.
Постановка задачи
Классификация почвенно-растительного покрова на основе мультимодальных данных дистанционного зондирования предполагает обучение семантическим представлениям из гетерогенных модальностей зондирования, таких как HSI и LiDAR. Эти модальности обладают различными характеристиками зондирования. HSI позволяет получать богатую спектральную информацию с сотнями каналов ( ), в то время как LiDAR предоставляет детальную структурную информацию с относительно небольшим количеством каналов (
 ). Такой дисбаланс между спектральным богатством и структурной разреженностью создает значительный доменный разрыв в распределении признаков, что делает прямое объединение признаков субоптимальным и потенциально нестабильным.
Формально, при наличии пары мультимодальных входных данных, 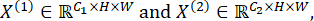 целью является прогнозирование посемельной семантической карты в соответствии с Уравнением 1:
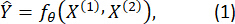
Здесь 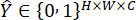 — тензор меток с одноканальным кодированием (one-hot encoding), C обозначает общее количество категорий земельного покрова, а θ представляет все обучаемые параметры модели. Набор данных Houston2013 имеет размер изображения 349 × 1905 пикселей со 144 гиперспектральными (HSI) каналами и 1 каналом LiDAR. Набор данных Augsburg имеет размер изображения 1152 × 480 пикселей с 224 HSI-каналами и 1 каналом LiDAR. Набор данных MUUFL имеет размер изображения 325 × 220 пикселей с 64 HSI-каналами и 2 каналами LiDAR. Для всех наборов данных входные фрагменты изображений перед обучением были изменены до размера 32 × 32 пикселей.
Традиционные мультимодальные подходы объединяют признаки конкретных модальностей с помощью конкатенации или механизмов внимания, косвенно предполагая, что разные модальности находятся в совместимом пространстве признаков. Однако это предположение редко оказывается верным для данных дистанционного зондирования, поскольку статистические распределения и пространственно-спектральные характеристики каждой модальности существенно различаются.
Для явного устранения этого несоответствия вводится модуль сопоставления потоков (flow matching module),  . Модуль параметризуется
 и обучается непрерывным двунаправленным преобразованиям между многообразиями признаков, специфичными для каждой модальности. В частности (Уравнение 2),
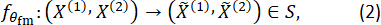
Здесь S обозначает общее латентное пространство, в котором геометрически выровнены специфичные для каждой модальности представления признаков. Впоследствии выровненные представления признаков объединяются и классифицируются в соответствии с Уравнением 3 следующим образом:
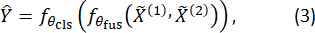
Здесь  и
 обозначают модули объединения признаков и классификации соответственно. Данная формулировка определяет общую структуру FlowErs. Вместо того чтобы полагаться исключительно на неявное статистическое объединение признаков, предлагаемая структура вводит явный механизм выравнивания на основе потоков, который непрерывно переносит специфические для каждой модальности представления признаков в общее латентное пространство перед мультимодальным объединением признаков и семантическим прогнозированием.
Энкодер MetaFormer
FlowErs выполняет кросс-модальное выравнивание признаков с использованием облегченных модально-специфичных кодировщиков, которые извлекают информативные и геометрически согласованные представления признаков из каждой модальности зондирования. Как показано на Рисунке 2, каждая модальность обрабатывается независимым кодировщиком на базе архитектуры MetaFormer. MetaFormer обобщает фундаментальный дизайн Transformer, отделяя перемешивание токенов от преобразования каналов без явного вычисления собственного внимания. Такая архитектура обеспечивает эффективную обработку многомерных HSI, оставаясь при этом адаптируемой к модальностям с малым количеством каналов, таким как LiDAR.
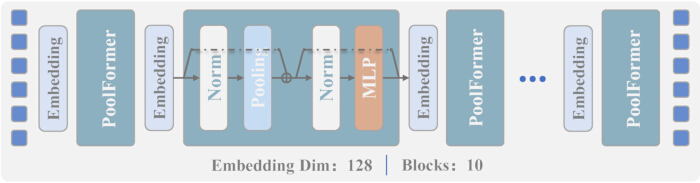
Рисунок 2: Архитектура специфичного для модальности кодировщика MetaFormer, используемого в предлагаемом фреймворке FlowErs. Кодировщик преобразует входные данные конкретной модальности в иерархические представления признаков с помощью повторяющихся блоков вложения (embedding) и блоков PoolFormer. Каждый блок PoolFormer состоит из нормализации, смешивания токенов на основе пулинга, остаточного суммирования, нормализации и многослойного перцептрона (MLP). Полученные иерархические представления признаков передаются в мультимодальный модуль сопоставления потоков (flow-matching) для кросс-модального выравнивания признаков. Norm — нормализация; MLP — многослойный перцептрон. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Для каждой модальности  кодировщик MetaFormer
 , преобразует входные данные
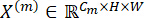 в иерархию представлений латентных признаков (Уравнение 4):
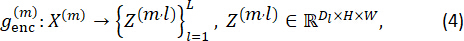
Здесь L обозначает общее количество этапов кодировщика, а Dl — размерность эмбеддинга на этапе l. Кодировщик MetaFormer состоит из трех этапов (N = 3) с размерностями эмбеддинга 64, 128 и 256 соответственно. Соответствующее количество блоков PoolFormer на каждом этапе составляет 2, 6 и 2, что соответствует прогрессивной иерархической архитектуре, описанной в рукописи.
Каждый кодер начинается с операции свертки 1 × 1, которая проецирует входные каналы в общее пространство вложений (Уравнение 5):
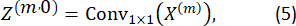
За этим проекционным слоем следуют L стекированных блоков MetaFormer. Каждый блок состоит из двух остаточных операций: (i) смешивания токенов посредством пространственного пулинга для агрегирования контекстной информации и (ii) преобразования каналов с помощью многослойного перцептрона (MLP) для уточнения спектрально-пространственных представлений признаков. Эти операции выражены с помощью уравнений 6 и 7 следующим образом:
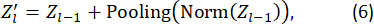

Здесь Pooling(·) обозначает агрегацию пространственного контекста на основе среднего пулинга, а MLP(·) — двухслойную сверточную сеть прямого распространения, включающую активацию GELU и регуляризацию методом dropout.
Энкодер имеет иерархическую архитектуру, в которой размерность эмбеддинга постепенно увеличивается на последующих этапах (например, 64  128 256). Такая прогрессивная структура позволяет более глубоким слоям кодировать все более насыщенную пространственно-спектральную информацию, одновременно расширяя репрезентативную способность извлекаемых признаков. В реализации используется ядро пулинга 3 × 3, размерность скрытого слоя MLP 128 и вероятность дропаута 0.1. Все сверточные слои в энкодере MetaFormer используют ядра 1 × 1 с шагом 1 и без дополнения (padding). Оператор пулинга представляет собой усредняющий пулинг 3 × 3 с шагом 1 и дополнением 1. На протяжении всего энкодера используется пакетная нормализация (BatchNorm2d). MLP имеет размерность скрытого слоя 128, использует функцию активации GELU и вероятность дропаута 0.1. Три этапа энкодера содержат 2, 6 и 2 блока PoolFormer соответственно; данные архитектурные настройки единообразно применяются на всех этапах.
По сравнению с энкодерами на базе Transformer, энкодер MetaFormer устраняет квадратичные вычислительные затраты, связанные с механизмом self-attention, одновременно снижая модально-специфичное смещение при извлечении признаков. Его токенизатор на основе пулинга эффективно агрегирует локальный пространственный контекст, в то время как кросс-модальное выравнивание впоследствии осуществляется модулем flow matching. Следовательно, представления признаков самого высокого уровня, создаваемые энкодером, обеспечивают семантически информативные и геометрически согласованные входные данные для мультимодального выравнивания признаков.
Мультимодальное сопоставление потоков
Основной проблемой после извлечения признаков является согласование гетерогенных представлений признаков, полученных из различных модальностей сенсоров, которые расположены на разных многообразиях признаков. Прямая конкатенация  и
 часто дает плохие результаты из-за несогласованности распределений признаков и смещений, специфичных для конкретной модальности. FlowErs решает эту задачу путем внедрения модуля MFM, который изучает непрерывные двунаправленные преобразования между двумя пространствами признаков, что концептуально показано на Рисунке 1B.
Позвольте 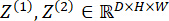 обозначают представления признаков, извлеченные энкодерами MetaFormer. Непрерывное поле потока, параметризованное временем интерполяции
 определяется с помощью Уравнение 8 следующим образом:
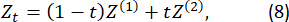
Здесь t = 0 соответствует исходной модальности, а t = 1 соответствует целевой модальности.
Модель сопоставления потоков (flow matching), , реализована в виде обусловленной временем сети U-Net, которая предсказывает мгновенное поле скоростей, определяющее преобразование вдоль этой траектории интерполяции. Каждый предиктор потока состоит из трех блоков понижения дискретизации (64 128 256 512) и трех соответствующих блоков повышения дискретизации (512 256 128 64) с использованием сверток 3 × 3, пакетной нормализации (batch normalization) и функции активации ReLU (rectified linear unit). Промежуточные временные эмбеддинги имеют размерности 128, 256, 512, 256 и 128 соответственно. Для временного эмбеддинга используется фиксированное синусоидальное позиционное кодирование. Интегрирование ОДУ выполняется методом прямого Эйлера с фиксированным шагом. При обучении количество шагов интегрирования было установлено равным 6, тогда как при инференсе по умолчанию использовалось 5 шагов интегрирования. Фактическое количество итераций цикла интегрирования вычисляется как 
Прогнозируемое поле скоростей определяется Уравнением 9 следующим образом:
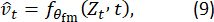
Здесь  обозначает предсказанную мгновенную скорость. Модель обучается аппроксимировать смещение
 , что способствует непрерывным преобразованиям между пространствами признаков конкретных модальностей. Целевая функция обучения сформулирована как зависящая от времени двунаправленная среднеквадратическая ошибка (MSE) следующим образом (Уравнение 10):
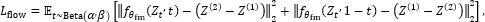 (10)
Сэмплирование t из заданной бета-распределения подвергает модель промежуточным состояниям интерполяции, но не обеспечивает точную циклическую согласованность. В отличие от методов выравнивания на основе диффузии, предлагаемая формулировка сопоставления потоков (flow matching) является детерминированной, не требует стохастического сэмплирования при выводе и может быть обучена как на размеченных, так и на неразмеченных данных.
Обученная модель потока в дальнейшем служит детерминированным оператором выравнивания, который проецирует специфичные для модальности представления признаков в общее латентное пространство S. Выровненные представления получаются следующим образом (Уравнение 11):
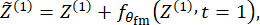
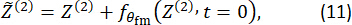
Здесь  и
 обозначают выровненные представления признаков. Выравнивание на основе потоков применяется к промежуточным представлениям признаков первых двух этапов энкодера (Этапы 1 и 2) с размерностями эмбеддинга 64 и 128 соответственно. Признаки энкодера самого высокого уровня (Этап 3, размерность эмбеддинга 256) не обрабатываются модулем сопоставления потоков. Вместо этого данные признаки конкатенируются напрямую и передаются в классификатор для мультимодального прогнозирования.
Этот механизм двунаправленного выравнивания постепенно переносит специфические для каждой модальности представления признаков в общее латентное пространство посредством непрерывного поля потока. В результате признаки становятся более согласованными перед слиянием мультимодальных признаков, что обеспечивает семантически последовательные и геометрически совместимые представления признаков для последующей классификации.
Конвейер обучения
Метод FlowErs использует как размеченные, так и неразмеченные данные, обеспечивая стабильное кросс-модальное выравнивание с помощью двухэтапной стратегии обучения, которая показана на Рисунке 1(B,C). На первом этапе с помощью функции соответствия потоков (flow matching) без учителя обучается модуль модально-инвариантного выравнивания. На втором этапе выполняется контролируемая классификация с использованием выровненных латентных представлений при повторном использовании предварительно обученного модуля выравнивания потоков.
Этап 1: Неконтролируемое предварительное обучение потока
Для данных мультимодальных пар изображений  специфические для модальности представления признаков
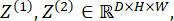 извлекаются с помощью кодировщиков MetaFormer. Промежуточные представления признаков генерируются с использованием интерполяции, определенной в Уравнении 8, где
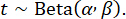 Модуль сопоставления потоков (flow matching),
 , оптимизируется путем минимизации двунаправленной функции цели с учетом времени, определенной в Уравнении 10, без использования меток классов. На этом этапе обновляются только параметры сопоставления потоков
 , что позволяет модели изучать геометрически согласованные соответствия как на размеченных, так и на неразмеченных образцах перед контролируемой классификацией. Этап 1 (предварительное обучение сопоставлению потоков) выполнялся с использованием оптимизатора AdamW со скоростью обучения 1 × 10⁻4, весовым затуханием (weight decay) 1 × 10⁻2 и графиком изменения скорости обучения по методу косинусного отжига. Для наборов данных Houston2013 и Trento использовался размер пакета 16, в то время как для наборов Augsburg и MUUFL размер пакета составлял 32. Модуль сопоставления потоков предварительно обучался в течение 2 000 эпох с использованием как размеченных, так и неразмеченных образцов. Случайный seed был зафиксирован на значении 3407. Все эксперименты проводились с использованием PyTorch на одном графическом процессоре NVIDIA A100 (80 GB памяти).
Этап 2: Обучаемая классификация с использованием общего выравнивателя
Предобученный модуль сопоставления потоков повторно используется в ходе контролируемого обучения и применяется к первым двум этапам кодировщика, а не ко всем уровням признаков. Выровненные представления признаков впоследствии объединяются с помощью классификационной головки для генерации попиксельных предсказаний. Контролируемая оптимизация минимизирует маскированную перекрестную энтропию потерь (Уравнение 12):
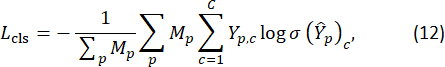
Здесь M обозначает маску меток, Y обозначает истинные метки в формате one-hot кодирования, а σ(·) обозначает функцию softmax. На Этапе 2 (обучение с учителем) предобученный модуль flow-matching оставался полностью замороженным и служил фиксированным оператором кросс-модального выравнивания. Его предобученные веса были загружены в начале Этапа 2 и не обновлялись в ходе обучения с учителем. Оптимизировались только параметры энкодера MetaFormer и классификатора. Обучение с учителем проводилось с использованием оптимизатора AdamW с искомыми для каждого набора данных скоростями обучения: 1 × 10⁻4 (Houston2013), 1 × 10⁻3 (Augsburg), 1 × 10⁻2 (MUUFL) и 1 × 10⁻5 (Trento). Коэффициент затухания весов (weight decay) был установлен на уровне 1 × 10⁻2 для всех наборов данных, кроме MUUFL, для которого использовалось значение 5 × 10⁻2. В зависимости от набора данных использовались размеры батча 16 или 32. Модели обучались в течение 100 эпох (Houston2013 и MUUFL), 200 эпох (Augsburg) и 20 эпох (Trento) с использованием графика изменения скорости обучения по методу косинусного отжига. В качестве функции потерь использовалась CrossEntropyLoss со средним сокращением (mean reduction). Ранняя остановка не применялась; вместо этого в качестве финальной модели выбиралась контрольная точка модели, достигшая наивысшей общей точности (OA) на тестовом наборе. Полный рабочий процесс реализации двухэтапной процедуры обучения обобщен в Дополнительном файле S1 (Алгоритм S1).
Эта стратегия разделенного обучения отделяет геометрическое выравнивание от семантической дискриминации. На этапе 1 модель изучает непрерывные двунаправленные отображения признаков, используя целевую функцию сопоставления потоков (flow-matching). На этапе 2 предварительно обученный модуль выравнивания обеспечивает общую операцию переноса признаков перед мультимодальным слиянием признаков, в то время как сеть классификации изучает классо-дискриминантные представления в выровненном латентном пространстве. Повторное использование предварительно обученного модуля выравнивания способствует согласованному выравниванию признаков перед слиянием, однако это не представляется как независимая гарантия улучшения обобщающей способности.
Экспериментальные наборы данных
Предложенная структура была оценена с использованием трех репрезентативных эталонных наборов данных мультимодального дистанционного зондирования: Houston201329, Augsburg30 и MUUFL31.
Набор данных Houston2013 был выпущен в рамках конкурса IEEE GRSS Data Fusion. Он представляет собой разнообразный городской ландшафт Хьюстона, США, и содержит 15 классов наземного покрова, включая жилые районы, дороги, растительность и водные объекты. Набор данных включает гиперспектральные изображения (HSI) со 144 спектральными каналами, охватывающими диапазон от видимого до ближнего инфракрасного спектра, а также одноканальную цифровую модель поверхности (DSM), полученную с помощью LiDAR, с пространственным разрешением 2.5 m. Сложные городские текстуры и значительная внутриклассовая спектральная вариативность делают этот набор данных сложным для точной классификации наземного покрова.
Набор данных Augsburg был получен над плотно застроенным городским районом в Германии. Он включает гиперспектральные изображения с 224 спектральными каналами в диапазоне длин волн 400–1000 nm, а также совмещенные данные высот LiDAR. Набор данных содержит 17 аннотированных классов земного покрова, включая застроенные территории, открытый грунт, асфальт, растительность и тени, с пространственным разрешением 2 m. По сравнению с Houston2013, данные Augsburg демонстрируют более сильные спектральные корреляции и большее разнообразие классов, что представляет собой сложный эталон для оценки выравнивания кросс-модальных признаков и обобщающей способности.
Набор данных MUUFL Gulfport был собран на территории университетского кампуса и представляет собой полугородскую среду с обильной растительностью и небольшими искусственными сооружениями. Набор данных включает очищенные от шума 64-канальные гиперспектральные изображения, а также двухдиапазонные измерения LiDAR, содержащие информацию о высоте и интенсивности. Он включает 11 классов земного покрова и характеризуется высокой пространственной детализацией, наличием смешанных пикселей и различными условиями освещения, что делает его подходящим для оценки мультимодального слияния признаков при классификации малоразмерных объектов.
В совокупности эти три эталонных набора данных охватывают значительные вариации пространственного разрешения (1–2.5 m), спектральной размерности (64–224 bands), сложности сцены и состава растительного покрова. Следовательно, они представляют собой разнообразную базу для оценки эффективности и обобщающей способности методов мультимодальной классификации земного покрова. Основные характеристики наборов данных обобщены в Таблице 1. Разделение на обучающую и тестовую выборки для всех трех наборов данных соответствует официальным разбиениям, предоставленным первоначальными поставщиками данных. В частности, для набора данных Houston2013 используется официальное разделение из конкурса IEEE GRSS Data Fusion Contest 2013 года, включающее 2 832 обучающих образца и 12 197 тестовых образцов. Для набора данных Augsburg используются официально предоставленные аннотации mask_train и mask_test, что дает 4 538 обучающих образцов и 47 896 тестовых образцов. Для набора данных MUUFL используется официальное разделение train_test_gt.mat, содержащее 28 645 обучающих образцов и 24 283 тестовых образца. Для каждого набора данных фрагмент изображения размером 32 × 32-pixel с центром в каждом размеченном пикселе извлекался в качестве отдельного обучающего или тестового образца. Дополнительного разделения или ресемплирования данных не проводилось.
| Свойство | Хьюстон2013 | Аугсбург | MUUFL |
| Размер изображения HSI (пиксели) | 349 × 1905 | 1152 × 480 | 325 × 220 |
| Размер изображения LiDAR (пиксели) | 349 × 1905 | 1152 × 480 | 325 × 220 |
| Спектральные диапазоны HSI | 144 | 224 | 64 |
| Диапазоны LiDAR | 1 | 1 | 2 |
| Диапазон длин волн HSI | 0.38–1.05 µm | 0.40–1.00 µm | 375–1050 нм |
| Диапазон длин волн LiDAR | Неприменимо | Неприменимо | Неприменимо |
| Пространственное разрешение (ГСИ) | 2,5 м | 2,0 м | 0,54 м × 1,00 м |
| Пространственное разрешение (LiDAR) | 2,5 м | 2,0 м | 0,60 м × 0,78 м |
| Количество классов растительного покрова | 15 | 17 | 11 |
Таблица 1: Характеристики трех мультимодальных эталонных наборов данных дистанционного зондирования, использованных для оценки. В таблице приведены размеры изображений, спектральные характеристики, пространственное разрешение и количество классов земного покрова для эталонных наборов данных Houston2013, Augsburg и MUUFL, использованных для оценки предлагаемого фреймворка FlowErs.
Детали реализации
Фреймворк FlowErs был реализован на PyTorch; обучение и оценка проводились с использованием графического процессора (GPU) с объемом памяти 80 GB. Обучение осуществлялось в течение 100 эпох с размером пакета 16. Использовался оптимизатор AdamW с начальной скоростью обучения 1 × 10⁻⁴ и коэффициентом затухания весов 1 × 10⁻². Для обновления скорости обучения на протяжении всего процесса обучения применялся планировщик с косинусным отжигом (cosine annealing). Для улучшения обобщающей способности модели и снижения переобучения была применена вероятность исключения (dropout) 0,1. Для контролируемой оптимизации использовалась функция перекрестной энтропии. Для обеспечения воспроизводимости все эксперименты были инициализированы с использованием фиксированного случайного зерна (seed) 3407. Предоставленные обучающие и тестовые выборки использовались без создания дополнительного валидационного набора. Перед обучением каждый входной патч был изменен в размере до 32 × 32 пикселей. Аугментация данных, явная коррекция регистрации изображений или дополнительная нормализация загрузчика данных не применялись. Пиксели, связанные с отрицательными метками, были исключены из расчета функции потерь при контролируемом обучении. Обработка отсутствующих или зашумленных пикселей отдельно не оценивалась.
Метрики оценки
Для оценки эффективности классификации были использованы три широко применяемые метрики: OA, средняя точность (AA) и коэффициент Каппа (k). OA определяет долю правильно классифицированных образцов среди всех образцов, AA представляет собой среднюю точность классификации по всем классам почвенно-растительного покрова, а коэффициент Каппа количественно определяет степень согласия между прогнозируемой и эталонной классификациями с учетом случайного совпадения. Более высокие значения всех трех метрик свидетельствуют о более высокой эффективности классификации. Все значения, приведенные в Таблицах 2–6, являются точечными оценками при фиксированном разделении выборки, полученными с использованием случайного числа (seed) 3407. Доверительные интервалы, тесты на статистическую значимость или p-значения не приводятся.
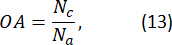
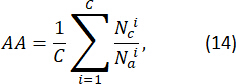
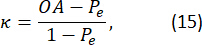
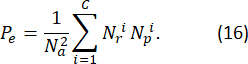
Здесь Nc и Na обозначают общее количество правильно классифицированных образцов и общее количество оцениваемых образцов соответственно.  и
 обозначают количество правильно классифицированных образцов и общее количество образцов для i-го класса соответственно. При расчете коэффициента Каппа Pe обозначает вероятность случайного совпадения, а
 и
 обозначают количество эталонных и прогнозируемых образцов для i-го класса соответственно.
Результаты
Общая схема рабочего процесса оценки предлагаемой платформы FlowErs представлена на Рисунок 1, в которой обобщена двухэтапная стратегия мультимодальной классификации. Процесс извлечения признаков для каждой модальности на основе энкодера MetaFormer показан на Рисунок 2, а основные характеристики трех эталонных наборов данных, использованных для оценки, приведены в Таблица 1Эффективность классификации впоследствии была оценена на эталонных наборах данных MUUFL, Houston2013 и Augsburg с использованием общей точности (OA), точности по каждому классу (AA) и коэффициента Каппа (κ), определенные в разделе «Протокол».
Сравнение с другими методами
Для обеспечения всестороннего сравнения предлагаемой структуры были включены несколько эталонных сетей мультимодальной классификации. DFINet32 объединяет гиперспектральную и мультиспектральную информацию с помощью модуля глубинной перекрестной внимания (depth-wise cross-attention) для улучшения взаимодействия признаков посредством нескольких функций потерь. DSHFNet33 внедряет стратегию динамического иерархического слияния, которая последовательно объединяет представления с мелким и крупным масштабом. MDL-Middle34 использует стратегию слияния признаков на промежуточном слое для балансировки информации от нескольких модальностей зондирования. CMCL35 рассматривает данные HSI и LiDAR как взаимодополняющие представления одной и той же сцены и применяет контрастивное обучение вместе с двойной тонкой настройкой для улучшения выравнивания признаков. Two-Branch36 использует двухпутевую сверточную архитектуру, которая независимо обрабатывает каждую модальность перед слиянием признаков. ExViT37 выполняет мультимодальную обработку патчей с использованием параллельных ветвей Transformer с модулями кросс-модального внимания. DSymFuse38 расширяет двухветвевую архитектуру Transformer за счет иерархического слияния локальных и глобальных признаков. CTPMSN39 сочетает сверточные архитектуры и Transformer с выравниванием текстово-визуальных подсказок (prompt alignment) для повышения семантической согласованности и дискриминации классов. Сравнительные значения были получены из цитируемых публикаций или описанных в них протоколов оценки и не создавались с использованием единой реализации или общей экспериментальной базы. Следовательно, данные сравнения следует интерпретировать как описательное сравнение с эталонами, а не как контролируемую прямую оценку.
Набор данных MUUFL
Результаты классификации, полученные для набора данных MUUFL Gulfport, обобщены в Таблице 2, а репрезентативные карты классификации представлены на Рисунке 3A–J. На указанном фиксированном эталонном разбиении предлагаемая структура достигла OA 95.24% и коэффициента Kappa 93.69% по сравнению с 93.99% и 92.03% соответственно для CTPMSN. Эффективность на уровне классов варьировалась в зависимости от категории земного покрова. По сравнению с CTPMSN, предлагаемая структура обеспечила более высокую точность классификации для классов Trees, Mostly Grass и Mixed Surface — на 2.73%, 3.16% и 1.86% соответственно. Напротив, класс Yellow Curb оставался проблемным из-за ограниченного количества доступных образцов, и его зарегистрированная точность была ниже, чем у нескольких сравниваемых методов. Соответственно, наблюдаемое улучшение совокупных показателей не следует интерпретировать как превосходство по каждому отдельному классу земного покрова. Качественное сравнение на Рисунке 3A–I демонстрирует карты классификации, созданные оцениваемыми методами, в то время как на Рисунке 3J представлена соответствующая эталонная карта истинных значений, иллюстрирующая пространственное распределение классов земного покрова в наборе данных MUUFL Gulfport.
| Класс | DFINet | DSHFNet | MDL-Middle | CMCL | Two-Branch | ExVit | DSymFuse | CTPMSN | FlowErs |
| Деревья | 89.2 | 74.91 | 87.31 | 84.86 | 91.32 | 92.64 | 91.24 | 95.55 | 98.28 |
| Преимущественно трава | 72.98 | 84.63 | 76.38 | 86.54 | 80.65 | 77.48 | 79.57 | 88.92 | 92.08 |
| Смешанное покрытие | 69.22 | 34.77 | 68.33 | 54.75 | 67.92 | 82.07 | 82.23 | 87.92 | 89.78 |
| Грунт/песок | 76.68 | 87.06 | 78.74 | 84.45 | 78.32 | 93.74 | 89.17 | 97.27 | 93.55 |
| Дорога | 86.68 | 81.09 | 83.76 | 86.25 | 84.34 | 90.35 | 85.6 | 94.52 | 95.94 |
| Вода | 100 | 99.25 | 88.52 | 98.53 | 100 | 99.38 | 100 | 100 | 97.56 |
| Тень | 83.29 | 90.65 | 92.12 | 97.72 | 84.89 | 91.47 | 91 | 95.98 | 90.54 |
| Здание | 93.26 | 90.22 | 89.69 | 97.54 | 93.76 | 89.27 | 96.29 | 96.29 | 98.26 |
| Тротуар | 57.34 | 53.09 | 77.06 | 77.98 | 71.32 | 73.54 | 79.62 | 88.07 | 79.61 |
| Желтый бордюр | 84.28 | 1.03 | 96.75 | 80.62 | 81.41 | 93.72 | 91.57 | 97.37 | 48.91 |
| Тканевые панели | 97.92 | 92.79 | 99.41 | 98.41 | 99.21 | 99.41 | 100 | 99.41 | 93.13 |
| Общая точность (OA) | 83.87 | 74.29 | 83.54 | 82.45 | 85.61 | 89.94 | 88.78 | 93.99 | 95.24 |
| Средняя точность (AA) | 82.76 | 73.23 | 84.37 | 85.9 | 85.1 | 90.12 | 89.54 | 94.68 | 88.88 |
| Коэффициент каппа (κ × 100) | 79.82 | 67.92 | 78.84 | 78.37 | 81.22 | 85.37 | 85.37 | 92.03 | 93.69 |
Таблица 2: Эффективность классификации (%) различных методов на эталонном наборе данных MUUFL. Эффективность классификации по каждому классу вместе с общей точностью (OA), средней точностью (AA) и коэффициентом Каппа (κ), полученными с помощью предлагаемой структуры FlowErs и конкурирующих методов на эталонном наборе данных MUUFL.
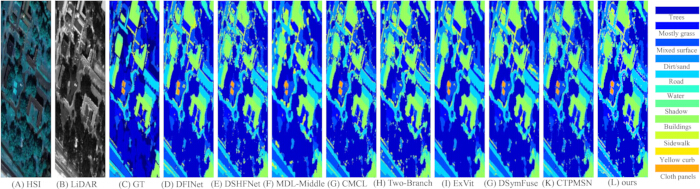
Рисунок 3: Репрезентативные результаты классификации почвенного покрова для набора данных MUUFL. (A) Гиперспектральное изображение (HSI). (B) Изображение, полученное методом лазерного сканирования (LiDAR). (C) Эталонная карта истинных значений (GT). (D–L) Карты классификации, созданные с помощью DFINet, DSHFNet, MDL-Middle, CMCL, Two-Branch, ExVit, DSymFuse, CTPMSN и предлагаемого фреймворка FlowErs соответственно. Цветовая легенда определяет классы почвенного покрова, представленные на каждой карте классификации.Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Набор данных Houston2013
Результаты классификации, полученные для набора данных Houston2013, представлены в Таблице 3, а репрезентативные карты классификации показаны на Рисунке 4A–J. На стандартном фиксированном разбиении данных предлагаемая архитектура достигла OA 97.56% и коэффициента Kappa 97.39%. По сравнению с опубликованными результатами CTPMSN, предлагаемая архитектура продемонстрировала OA примерно на 3.8 процентных пункта выше. Улучшения также наблюдались для классов Residential и Highway, при этом показатели увеличились примерно на 2.4 и 0.5 процентных пункта соответственно. Однако класс Commercial оставался относительно сложным и продемонстрировал более низкую точность классификации, чем несколько конкурирующих методов, что может быть следствием спектрального и пространственного сходства с другими категориями городского земельного покрова. В целом, совокупные результаты указывают на повышение эффективности классификации на данном эталоне, при этом демонстрируя вариативность показателей для отдельных классов. Качественное сравнение на Рисунке 4A–I демонстрирует карты классификации, созданные с помощью оцениваемых методов, в то время как на Рисунке 4J представлена соответствующая эталонная карта (ground-truth), иллюстрирующая пространственное распределение классов земельного покрова в наборе данных Houston2013.
| Класс | DFINet | DSHFNet | MDL-Middle | CMCL | Two-Branch | ExVit | DSymFuse | CTPMSN | FlowErs |
| Здоровая трава | 82.39 | 85.58 | 83.1 | 82.91 | 80.31 | 81.67 | 80.06 | 96.96 | 100 |
| Поврежденная трава | 100 | 94.65 | 85.06 | 95.68 | 92.44 | 100 | 78.67 | 94.27 | 96.94 |
| Искусственная трава | 100 | 98.12 | 99.6 | 94.93 | 99.23 | 99.01 | 99.41 | 99.41 | 99.84 |
| Дерево | 100 | 93.09 | 91.57 | 93.37 | 98.75 | 98.96 | 95.55 | 96.21 | 99.6 |
| Почва | 98.76 | 99.91 | 98.86 | 99.43 | 99.2 | 99.91 | 98.67 | 99.43 | 100 |
| Вода | 94.5 | 93.1 | 100 | 97.3 | 95.32 | 100 | 95.8 | 100 | 97.6 |
| Жилая застройка | 87.5 | 66.65 | 97.64 | 92.58 | 90.87 | 93.28 | 87.22 | 86.86 | 99.29 |
| Коммерческая застройка | 91.53 | 76.29 | 88.13 | 87.96 | 95.31 | 89.27 | 85.85 | 94.61 | 84.07 |
| Дорога | 84.19 | 36.29 | 85.93 | 80.76 | 82.63 | 89.42 | 93.29 | 88.07 | 92.73 |
| Шоссе | 69.32 | 89 | 74.42 | 57.41 | 66.69 | 71.33 | 67.95 | 81.66 | 99.74 |
| Железная дорога | 96.76 | 94.78 | 84.54 | 79.57 | 93.44 | 92.88 | 79.13 | 97.7 | 99.72 |
| Парковка 1 | 83.27 | 88.39 | 95.39 | 52.83 | 85.67 | 89.63 | 91.07 | 93.28 | 95.42 |
| Парковка 2 | 85.36 | 96.46 | 87.37 | 92.42 | 86.17 | 89.47 | 84.21 | 95.09 | 99.18 |
| Теннисный корт | 100 | 97.3 | 95.14 | 83.04 | 98.72 | 97.89 | 100 | 100 | 99.72 |
| Беговая дорожка | 99.21 | 100 | 100 | 97.02 | 100 | 97.97 | 100 | 100 | 99.83 |
| Общая точность (OA) | 91.21 | 85.02 | 89.55 | 83.87 | 90.01 | 91.57 | 87.57 | 93.74 | 97.56 |
| Средняя точность (AA) | 92.42 | 87.55 | 91.05 | 85.76 | 90.98 | 92.32 | 89.09 | 94.9 | 97.58 |
| Коэффициент Каппа (κ × 100) | 91.09 | 83.59 | 87.59 | 82.76 | 89.1 | 90.85 | 85.29 | 93.21 | 97.39 |
Таблица 3: Эффективность классификации (%) различных методов на эталонном наборе данных Houston2013. Эффективность классификации по каждому классу, а также общая точность (OA), средняя точность (AA) и коэффициент Каппа (κ), полученные с помощью предлагаемого фреймворка FlowErs и конкурирующих методов на эталонном наборе данных Houston2013.
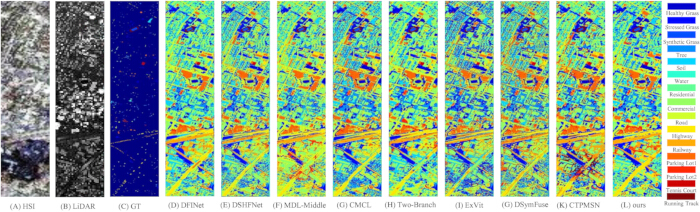
Рисунок 4: Репрезентативные результаты классификации земельного покрова для эталонного набора данных Houston2013. (A) Гиперспектральное изображение (HSI). (B) Изображение, полученное с помощью лидара (LiDAR). (C) Эталонная карта наземных истинных значений (GT). (D–L) Карты классификации, созданные с помощью DFINet, DSHFNet, MDL-Middle, CMCL, Two-Branch, ExVit, DSymFuse, CTPMSN и предлагаемого фреймворка FlowErs соответственно. Цветовая легенда определяет классы земельного покрова, представленные на каждой карте классификации. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Набор данных Аугсбурга
Результаты классификации, полученные для набора данных Augsburg, обобщены в таблице 4, а репрезентативные карты классификации представлены на рисунке 5A–J. Данный набор данных характеризуется значительной внутриклассовой вариативностью и сложной структурой фона. На указанном фиксированном контрольном разбиении предложенная архитектура обеспечила OA 97,56% и AA 89,21%. По сравнению с перечисленными контрольными методами, предложенная архитектура показала более высокую точность классификации для классов Industrial и Commercial примерно на 14 и 45 процентных пунктов соответственно. Разница между OA и AA указывает на то, что на общую эффективность повлияла частота классов, в то время как AA отражает среднюю эффективность по всем классам. Соответственно, полученный показатель OA следует интерпретировать совместно с результатами по каждому классу, поскольку эффективность классификации варьировалась между отдельными категориями земного покрова. Качественное сравнение на рисунке 5A–I демонстрирует карты классификации, созданные с помощью оцениваемых методов, в то время как на рисунке 5J представлена соответствующая эталонная карта (ground-truth), иллюстрирующая пространственное распределение классов земного покрова в наборе данных Augsburg.
| Класс | DFINet | DSHFNet | MDL-Средний | CMCL | двухветвевой | ExVit | DSymFuse | CTPMSN | FlowErs |
| Деревья | 96.41 | 98.21 | 91.72 | 94.27 | 95.85 | 93.64 | 90.58 | 93.36 | 99.57 |
| Жилой | 96.88 | 42.08 | 95.19 | 69.84 | 92.75 | 97.71 | 96.32 | 97.37 | 98.97 |
| Промышленный | 58.2 | 47.29 | 62.61 | 35.22 | 72.66 | 65.82 | 72.45 | 64.6 | 86.41 |
| Низкорослые растения | 92.22 | 51.75 | 87.76 | 80.27 | 88.9 | 84.88 | 89.65 | 96.72 | 99.58 |
| Распределение | 55.87 | 95.94 | 50.86 | 89.33 | 72.86 | 46.85 | 62.91 | 58.69 | 91.22 |
| Коммерческий | 10.98 | 50.91 | 24.24 | 45.59 | 20.32 | 24.49 | 17.22 | 29.73 | 74.3 |
| Вода | 22.87 | 67.78 | 29.04 | 54.87 | 36.82 | 24.49 | 13.27 | 15.53 | 74.39 |
| Общая точность (OA) | 88.78 | 56.59 | 87.74 | 75.94 | 87.29 | 87.72 | 88.35 | 91.56 | 97.56 |
| Средняя точность (AA) | 62.29 | 65.47 | 63.06 | 67.61 | 67.78 | 62.56 | 63.2 | 65.14 | 89.21 |
| Коэффициент каппа (κ × 100) | 84.32 | 46.78 | 82.69 | 67.83 | 82.58 | 82.49 | 83.36 | 87.88 | 96.48 |
Таблица 4: Эффективность классификации (%) различных методов на эталонном наборе данных Augsburg. Эффективность классификации по каждому классу вместе с общей точностью (OA), средней точностью (AA) и коэффициентом Каппа (κ), полученными с помощью предлагаемого фреймворка FlowErs и конкурирующих методов на эталонном наборе данных Augsburg.
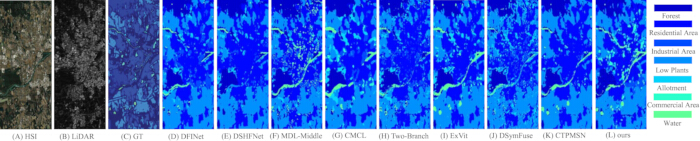
Рисунок 5: Примеры результатов классификации земельного покрова для эталонного набора данных Augsburg. (A) Гиперспектральный снимок (HSI). (B) Изображение, полученное с помощью лидара (LiDAR). (C) Референсная карта истинных значений (GT). (D–L) Карты классификации, созданные с помощью DFINet, DSHFNet, MDL-Middle, CMCL, Two-Branch, ExVit, DSymFuse, CTPMSN и предлагаемого фреймворка FlowErs соответственно. Цветовая легенда определяет классы земельного покрова, представленные на каждой карте классификации. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Для более детального визуального сравнения сложных областей на рисунке 6 представлены увеличенные изображения репрезентативных областей интереса (ROI) из наборов данных MUUFL, Houston2013 и Augsburg. Эти увеличенные виды позволяют четче видеть границы объектов и мелкомасштабные пространственные структуры, которые менее заметны на картах классификации всей сцены, показанных на рисунках 3–5, что служит дополнительным качественным подтверждением эффективности классификации для трех эталонных наборов данных.
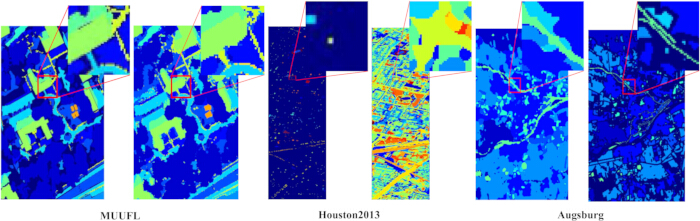
Рисунок 6: Увеличенные изображения репрезентативных областей интереса (ROI) из наборов данных MUUFL, Houston2013 и Augsburg. Репрезентативные ROI из наборов данных MUUFL, Houston2013 и Augsburg увеличены для облегчения визуального сравнения деталей классификации на мелком масштабе. Красные рамки указывают на выбранные области, а соответствующие увеличенные виды подчеркивают границы объектов, мелкие структуры и другие сложные участки, которые трудно рассмотреть на картах классификации всей сцены, представленных на рисунках 3–5. Эти увеличенные изображения обеспечивают дополнительную качественную оценку результатов классификации. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Абляционное исследование
Эффект модуля многомодального сопоставления потоков:
Для оценки вклада модуля MFM были проведены эксперименты по абляции с использованием трех конфигураций модели: полной структуры FlowErs (Baseline), модели без модуля MFM (w/o MFM) и упрощенной модели, использующей однонаправленное выравнивание потока (Single Flow). Соответствующие количественные результаты представлены в Таблице 5.
| Метод | MUUFL | Хьюстон2013 | Аугсбург | ||||||
| ОА (%) | АК (%) | κ × 100 | ОА (%) | АК (%) | κ × 100 | ОА (%) | АК (%) | κ × 100 | |
| Исходный уровень | 95.24 | 88.88 | 93.69 | 97.56 | 97.58 | 97.39 | 97.56 | 89.21 | 96.48 |
| без МСМ | 92.87 | 86.02 | 91.05 | 95.31 | 95.28 | 94.97 | 95.12 | 87.06 | 93.98 |
| Одиночный поток | 94.38 | 87.43 | 92.72 | 96.58 | 96.47 | 96.22 | 96.47 | 88.36 | 95.47 |
Таблица 5: Абляционное исследование предложенного фреймворка FlowErs на контрольных наборах данных MUUFL, Houston2013 и Augsburg. Показатели эффективности классификации представлены для полной модели (Baseline) и двух абляционных вариантов с использованием общей точности (OA), средней точности (AA) и коэффициента Каппа (κ).
По сравнению с базовой моделью, удаление модуля MFM привело к снижению значений OA, AA и коэффициента Kappa на всех трех эталонных наборах данных. Конфигурация Single Flow продемонстрировала промежуточные результаты между полной моделью и моделью без MFM, что указывает на то, что однонаправленное выравнивание признаков сохранило часть наблюдаемого прироста производительности, не достигнув при этом совокупных показателей двунаправленной реализации. Эти наблюдения позволяют предположить, что модуль двунаправленного выравнивания потоков внес вклад в заявленную производительность в условиях оцениваемых эталонных настроек. Представленные различия представляют собой точечные оценки при фиксированном разделении выборки, полученные с использованием одного случайного значения seed, и поэтому должны интерпретироваться описательно, а не как доказательство статистической значимости.
По трем эталонным наборам данных наибольшие совокупные различия в производительности между базовой моделью (Baseline) и моделями с абляцией наблюдались на наборе данных MUUFL, в то время как на наборе Houston2013 различия были сравнительно меньше. По сравнению с конфигурациями с абляцией для полной модели наблюдалось улучшение как OA, так и AA, что указывает на более высокую совокупную эффективность классификации вместе с улучшением средних показателей по классам при оцениваемых вариантах разделения эталонных данных. Эти результаты согласуются с гипотезой исследования о том, что выравнивание признаков перед мультимодальным слиянием может повысить эффективность классификации; однако в настоящем исследовании повторные эксперименты и статистический анализ не проводились.
Влияние количества шагов интегрирования потока:
Для дальнейшей оценки влияния количества шагов интеграции потока в модуле MFM число шагов интеграции варьировали от 2 до 10. Соответствующие результаты классификации обобщены в таблице 6. Параметр шага интеграции контролирует дискретизацию непрерывного процесса переноса признаков при мультимодальном выравнивании, где меньшие значения соответствуют более грубой дискретизации, а большие — более точной. Как показано в таблице 6, самые высокие оценки фиксированных точек разделения по всем оцениваемым метрикам были получены при количестве шагов интеграции, равном 6. В целом эффективность повышалась при увеличении числа шагов интеграции с 2 до 6, после чего зарегистрированная эффективность оставалась относительно стабильной или немного снижалась на трех эталонных наборах данных. Эти наблюдения указывают на то, что номинальная настройка из шести шагов интеграции обеспечила наивысшую совокупную эффективность в условиях оцениваемого бенчмарка. Поскольку представленные результаты основаны на одном случайном seed-значении и фиксированном разделении наборов данных, эти различия следует интерпретировать описательно, а не как доказательство статистически значимых различий в эффективности.
| Этапы интеграции потоков | MUUFL | Хьюстон2013 | Аугсбург | ||||||
| ОА (%) | АА (%) | κ × 100 | ОА (%) | АК (%) | κ × 100 | ОА (%) | АК (%) | κ × 100 | |
| 2 | 92.37 | 84.63 | 90.12 | 95.73 | 96.12 | 95.64 | 94.86 | 85.73 | 92.76 |
| 3 | 93.58 | 85.47 | 90.98 | 96.32 | 96.48 | 96.01 | 95.61 | 86.48 | 93.51 |
| 4 | 94.31 | 86.51 | 91.76 | 96.88 | 96.92 | 96.57 | 96.18 | 87.34 | 94.12 |
| 5 | 94.92 | 87.62 | 92.54 | 97.18 | 97.22 | 97.05 | 96.89 | 88.02 | 95.07 |
| 6 | 95.24 | 88.88 | 93.69 | 97.56 | 97.58 | 97.39 | 97.56 | 89.21 | 96.48 |
| 7 | 95.12 | 88.56 | 93.5 | 97.49 | 97.44 | 97.31 | 97.34 | 88.84 | 96.21 |
| 8 | 94.95 | 88.22 | 93.2 | 97.31 | 97.29 | 97.17 | 96.98 | 88.46 | 95.82 |
| 9 | 94.63 | 87.75 | 92.85 | 97.09 | 97.03 | 96.88 | 96.45 | 87.92 | 95.28 |
| 10 | 94.21 | 86.97 | 92.18 | 96.77 | 96.81 | 96.61 | 95.87 | 87.03 | 94.61 |
Таблица 6: Влияние количества шагов интеграции потока на эффективность классификации для эталонных наборов данных MUUFL, Houston2013 и Augsburg. Эффективность классификации представлена в виде общей точности (OA), средней точности (AA) и коэффициента Каппа (κ) для различного количества шагов интеграции потока. Шесть шагов интеграции соответствуют конфигурации, использованной в окончательной структуре FlowErs.
Среди оцениваемых наборов данных набор MUUFL продемонстрировал наибольшую вариативность производительности при изменении количества шагов интеграции, в то время как набор Houston2013 показал сравнительно меньшие изменения, достигнув при этом своих максимальных зарегистрированных показателей при шести шагах интеграции. Набор Augsburg продемонстрировал аналогичную тенденцию с относительно умеренной вариативностью производительности при различных настройках количества шагов. В совокупности эти наблюдения позволяют предположить, что умеренное количество шагов интеграции потока обеспечило наилучшую зарегистрированную точность классификации для исследуемых наборов данных. Настоящий анализ не включает повторные эксперименты, оценки неопределенности, вычислительный профилинг, анализ устойчивости к отсутствующим модальностям или зашумленным входным данным, а также обобщающую способность для разных регионов, в связи с чем выводы по этим аспектам не приводятся.
Оценка на трех эталонных наборах данных продемонстрировала конкурентоспособную совокупную эффективность классификации при использовании указанных фиксированных разделений данных, с максимальным значением OA 97,56%. Эксперименты по абляции показали, что полная конфигурация двунаправленного сопоставления потоков (bidirectional flow-matching) стабильно обеспечивала более высокую совокупную эффективность, чем соответствующие абляционные модели во всех оцениваемых наборах данных. Поклассовый анализ показал, что эффективность классификации варьировалась в зависимости от категорий растительного покрова, при этом миноритарные классы и спектрально схожие категории оставались сравнительно сложными для определения, что способствовало наблюдаемой разнице между OA и AA на несбалансированных наборах данных. Данная оценка основана на точечных оценках фиксированного разделения, полученных с использованием одного случайного значения (seed), и не включает оценки неопределенности при повторных запусках, проверку статистической значимости, вычислительный профилинг, анализ чувствительности к пространственной расстройке, устойчивости к отсутствующим или зашумленным модальностям или обобщающей способности для различных регионов. Эти аспекты заслуживают дальнейшего изучения в будущих исследованиях.
Доступность данных:
Общедоступные эталонные наборы данных, использованные в данном исследовании, доступны от их первоначальных поставщиков. Материалы реализации, карты прогнозов и результаты оценки находятся в открытом доступе в репозитории Zenodo по адресу https://doi.org/10.5281/zenodo.21395701.
Дополнительный файл 1: Математическая формулировка и алгоритм обучения фреймворка FlowErs. В данном дополнительном файле приведена полная математическая формулировка, лежащая в основе предлагаемого фреймворка FlowErs, включая формулировку непрерывного потока (уравнения S1–S2), уравнение вероятностного потока (уравнение S3), оптимальный путь потока (уравнения S4–S5), целевую функцию обучения с условным сопоставлением потоков (уравнение S6) и соответствующие теоретические свойства. Файл также содержит Алгоритм S1, в котором обобщен полный двухэтапный рабочий процесс обучения, состоящий из предварительного обучения с ненадзорванным сопоставлением потоков с последующей контролируемой мультимодальной классификацией.
Обсуждение
В данной работе представлен FlowErs — мультимодальная платформа дистанционного зондирования, которая разделяет кросс-модальное выравнивание признаков и семантическую классификацию с помощью двухэтапной стратегии обучения. Вместо прямого слияния гетерогенных признаков, специфичных для каждой модальности, предлагаемая платформа сначала выравнивает представления признаков с использованием условного сопоставления потоков (conditional flow matching) перед мультимодальным слиянием и классификацией. Такой подход решает давнюю проблему гетерогенности распределения признаков между HSI и LiDAR, где различия в механизмах зондирования часто ограничивают эффективность традиционных стратегий слияния, основанных на конкатенации или механизмах внимания23,26,35,36,37,38,39. Формулируя мультимодальное выравнивание как непрерывный перенос признаков, FlowErs переносит последние достижения в области сопоставления потоков из генеративного моделирования в сферу обучения представлениям для мультимодального дистанционного зондирования15,16,17,18,19,20,21. В условиях оцениваемых эталонных тестов предлагаемая платформа продемонстрировала конкурентоспособную общую точность классификации на наборах данных Houston2013, Augsburg и MUUFL, а сопровождающее исследование по абляции дополнительно подтвердило вклад модуля двунаправленного потокового выравнивания в полученные показатели при фиксированном разделении данных.
Полученные результаты позволяют предположить, что явное выравнивание признаков перед мультимодальным слиянием может улучшить совместимость гетерогенных представлений признаков, извлеченных из различных модальностей сенсоров. Предыдущие методы мультимодального дистанционного зондирования опирались преимущественно на сверточные сети, архитектуры на базе Transformer, механизмы внимания, контрастивное обучение или слияние с использованием подсказок (prompt-guided fusion) для усиления взаимодействия признаков23,26,35,36,37,38,39. Хотя эти подходы продемонстрировали высокую эффективность классификации, в большинстве из них предполагается, что специфичные для каждой модальности эмбеддинги могут быть напрямую объединены после извлечения признаков. В отличие от них, FlowErs вводит промежуточный этап геометрического выравнивания, который непрерывно переносит специфичные для модальностей признаки в общее латентное пространство перед классификацией. Оценка по классам показывает, что совокупное улучшение показателей было распределено неравномерно по всем категориям почвенно-растительного покрова. Например, несколько миноритарных классов и спектрально схожих городских категорий оставались сравнительно трудными для классификации, а наблюдаемая разница между OA и AA, особенно для набора данных Augsburg, отражает влияние дисбаланса классов вместе с вариативностью эффективности на уровне отдельных классов. Соответственно, представленные совокупные метрики следует интерпретировать вместе с результатами по классам, а не как свидетельство единообразного улучшения во всех категориях.
Эксперименты по абляции дополнительно подтверждают предложенную архитектуру. Удаление модуля многомодального сопоставления потоков (flow matching) привело к снижению совокупной точности классификации на всех трех эталонных наборах данных, в то время как вариант с однонаправленным потоком последовательно демонстрировал результаты, промежуточные между полной моделью и моделью без выравнивания потоков. Эти наблюдения согласуются с рабочей гипотезой о том, что двунаправленный перенос признаков может улучшить кросс-модальную соответствуемость перед слиянием признаков в условиях оцениваемых бенчмарков. Аналогично, анализ интеграции потока показал, что промежуточная дискретизация выученной траектории переноса обеспечила самую высокую совокупную производительность, при этом шесть шагов интеграции представляли собой номинальную рабочую точку в данной реализации. Прирост производительности стал незначительным или слегка снизился при увеличении числа шагов интеграции, что позволяет предположить, что все более тонкая дискретизация может давать убывающую отдачу в оцениваемых экспериментальных условиях. Вопрос о том, обобщается ли эта рабочая точка на другие наборы данных, модальности сенсоров или архитектуры сетей, остается открытым для исследования.
При интерпретации полученных результатов следует учитывать ряд ограничений. Во-первых, оценка была ограничена тремя общедоступными эталонными наборами данных с использованием фиксированных разделений на обучающую/тестовую выборки и одного случайного значения seed. Следовательно, неопределенность при повторных запусках, доверительные интервалы, проверка статистической значимости и межзапускная вариабельность не оценивались. Во-вторых, методы сравнения были взяты из соответствующих публикаций, а не реализованы заново в рамках единой экспериментальной среды; поэтому представленные сравнения следует интерпретировать описательно, а не как контролируемые прямые воспроизведения. В-третьих, не исследовалась устойчивость к отсутствию модальностей, зашумленным наблюдениям, пространственному несоответствию (мисрегистрации) и обобщающей способности между различными регионами. Кроме того, хотя сопоставление потоков (flow matching) обеспечивает теоретическую основу для непрерывного и потенциально обратимого переноса признаков15,16,17, точная обратимость, сохранение топологии и физическая интерпретируемость изученных преобразований не были эмпирически подтверждены в данной работе. Вычислительные характеристики, включая время вывода, потребление памяти и сложность операций с плавающей запятой, также не профилировались отдельно.
Альтернативные подходы к изучению мультимодального выравнивания продолжают развиваться. В последних исследованиях изучались контрастивное обучение, слияние на основе графов, обучение низкоранговым представлениям, мультимодальное обучение с использованием подсказок (prompt-guided learning), федеративное обучение и гибридные сверточно-трансформерные архитектуры для улучшения интеграции мультимодальных признаков23,26,27,28,35,36,37,38,39. Эти стратегии остаются взаимодополняющими, а не взаимоисключающими, и в будущих работах могут быть исследованы комбинации явного переноса признаков на основе потоков с этими существующими парадигмами выравнивания. Помимо классификации земельного покрова, непрерывное выравнивание признаков может быть применимо и к другим связанным задачам мультимодального дистанционного зондирования, включая семантическую сегментацию, обнаружение изменений, распознавание объектов, экологический мониторинг, оценку последствий стихийных бедствий, точное земледелие и городское картирование, где все чаще становятся доступны дополнительные модальности зондирования2,3,4,5,6,7,8,9,23.
В будущих исследованиях следует оценить предложенную структуру в более разнообразных экспериментальных условиях, включив статистический анализ повторных запусков, вычислительный профилинг, устойчивость к отсутствующим или зашумленным модальностям, чувствительность к ошибкам пространственной привязки и оценку переноса между регионами. Дополнительные исследования, изучающие альтернативные параметризации потока, различные архитектуры кодировщиков и более крупные мультимодальные наборы эталонных данных, позволили бы дополнительно прояснить обобщающую способность и практическую применимость предложенной методологии. В совокупности настоящие результаты указывают на то, что явное выравнивание признаков с помощью условного сопоставления потоков представляет собой перспективную дополнительную стратегию для мультимодальной классификации данных дистанционного зондирования, одновременно выделяя несколько возможностей для дальнейшего методологического развития и комплексной оценки.
Раскрытие информации
Конфликт интересов:
Авторы заявляют об отсутствии конфликта интересов.
Благодарности
This work was financially supported by the Scientific Research Fund Project of Shaanxi A&F University (Grant No. ZK25-38) and the Education Department of Shaanxi Province (Grant No. 24JK0734).
Материалы
| Имя | Компания | Каталожный номер | Комментарии |
|---|---|---|---|
| Оптимизатор AdamW | PyTorch Foundation | Включено в PyTorch | Использовалось для оптимизации модели. Использовалась PyTorch 2.5.0. |
| эталонный набор данных Augsburg | Hu J и др. (Earth System Science Data, 2022); Технологии дистанционного зондирования, LMU Munich | https://doi.org/10.5281/zenodo.7185498 | Общедоступный мультимодальный набор эталонных данных дистанционного зондирования, используемый для оценки моделей. |
| CUDA Toolkit | NVIDIA | CUDA Toolkit 12.4; https://developer.nvidia.com/cuda-12-4-0-download-archive | Используется для обучения и инференса моделей с ускорением на GPU. |
| Графический процессор (GPU) | NVIDIA Corporation | NVIDIA A100 80 GB PCIe | Используется для обучения и оценки модели. |
| эталонный набор данных Houston2013 | Конкурс по объединению данных Общества геонаук и дистанционного зондирования IEEE | http://www.grss-ieee.org/community/technical-resources/data-fusion/2013-grss-data-fusion-contest/ | Общедоступный эталонный набор данных гиперспектральных изображений и данных LiDAR, используемый для оценки моделей. |
| эталонный набор данных MUUFL Gulfport | Флоридский университет (Gader P et al., технический отчет REP-2013-570) | https://github.com/GatorSense/MUUFLGulfport | Общедоступный эталонный набор данных гиперспектральных изображений и данных LiDAR, используемый для оценки моделей. |
| Операционная система | Canonical Ltd. | Ubuntu 22.04 LTS; https://ubuntu.com | Вычислительная среда, использованная для разработки, обучения и оценки модели. |
| PyTorch | PyTorch Foundation | PyTorch 2.5.0; https://pytorch.org/get-started/previous-versions/#v250 | Фреймворк глубокого обучения, использованный для реализации, обучения и оценки модели FlowErs. |
| Python | Python Software Foundation | Python 3.11; https://www.python.org/downloads/release/python-3110/ | Язык программирования, использованный для реализации и выполнения вычислительного рабочего процесса. |
Ссылки
- Geng X, et al. Fast and effective: Progressive hierarchical fusion classification for remote sensing images. IEEE Trans Multimed. 2024;26:9776–89.
- Tian F, et al. HireNet: Hierarchical-relation network for few-shot remote sensing image scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–10.
- Ye Z, et al. A multiscale incremental learning network for remote sensing scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–15.
- Li Q, Chen Y, He X, Huang L. Co-training transformer for remote sensing image classification, segmentation, and detection. IEEE Trans Geosci Remote Sens. 2024;62:1–18.
- Qin A, et al. Deep updated subspace networks for few-shot remote sensing scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–14.
- Wang S, et al. Personalized multiparty few-shot learning for remote sensing scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–15.
- Yang JY, et al. Multifrequency graph convolutional network with cross-modality mutual enhancement for multisource remote sensing data classification. IEEE Trans Geosci Remote Sens. 2024;62:1–14.
- Zhou G, Qian L, Gamba P. A novel iterative self-organizing pixel matrix entanglement classifier for remote sensing imagery. IEEE Trans Geosci Remote Sens. 2024;62:1–21.
- Zhu J, et al. MVP: Meta visual prompt tuning for few-shot remote sensing image scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–13.
- Gat I, et al. Discrete flow matching. Adv Neural Inf Process Syst. 2024;37:133345–85.
- Miller BK, Chen RT, Sriram A, Wood BM. FlowMM: Generating materials with Riemannian flow matching [Internet]. 2024 [cited 2026 Jul 6]. Available from: https://arxiv.org/abs/2406.04713
- Xin Y, et al. Confidence-weighted dual-teacher networks with biased contrastive learning for semi-supervised semantic segmentation in remote sensing images. IEEE Trans Geosci Remote Sens. 2024;62:1–16.
- He Y, et al. IGroupSS-Mamba: Interval group spatial-spectral Mamba for hyperspectral image classification. IEEE Trans Geosci Remote Sens. 2024;62:1–14.
- Liao D, Wang Q, Lai T, Huang H. Joint classification of hyperspectral and LiDAR data based on Mamba. IEEE Trans Geosci Remote Sens. 2026;19:11445–61.
- Lipman Y, et al. Flow matching for generative modeling [conference paper]. Presented at: 11th International Conference on Learning Representations (ICLR); 2023. Available from: https://openreview.net/forum id=PqvMRDCJT9t
- Liu X, et al. Flow straight and fast: Learning to generate and transfer data with rectified flow [conference paper]. Presented at: 11th International Conference on Learning Representations (ICLR); 2023. Available from: https://openreview.net/forum id=XVjTT1nw5z
- Geng Z, et al. Consistency models made easy [conference paper]. Presented at: 13th International Conference on Learning Representations (ICLR); 2025. Available from: https://openreview.net/forum id=1x7sJYh37d
- Hu VT, et al. Latent space editing in transformer-based flow matching [conference paper]. Presented at: AAAI Conference on Artificial Intelligence; 2024;38:2247–55. Available from: https://doi.org/10.1609/aaai.v38i3.28014
- Jeong J, Kim K, Kim W, Kim NJ. Real-time person image synthesis using a flow matching model [Internet]. 2025 [cited 2026 Jul 6]. Available from: https://arxiv.org/abs/2505.03562
- Kakesh MH, et al. An efficient data generation method based on flow matching for bearing fault diagnosis under imbalanced data conditions. IEEE Trans Energy Convers. 2026;1–11.
- Chu Z, et al. End-to-end seam tracking with flow matching-based diffusion policy [conference paper]. Presented at: International Conference on Machine Intelligence and Nature-Inspired Computing (MIND); Xiamen, China; 2025. p. 304–9. Available from: https://doi.org/10.1109/MIND67540.2025.11351867
- Melgani F, Bruzzone L. Classification of hyperspectral remote sensing images with support vector machines. IEEE Trans Geosci Remote Sens. 2004;42:1778–90.
- Li J, et al. Deep learning in multimodal remote sensing data fusion: A comprehensive review. Int J Appl Earth Obs Geoinf. 2022;112:102926.
- Vaswani A, et al. Attention is all you need [Internet]. 2017 [cited 2026 Jul 6]. Available from: https://arxiv.org/abs/1706.03762
- Zhuang Y, Chen M, Zhu D. UWASR-GAN: An attention-guided multi-scale residual framework for underwater image enhancement in underwater Internet of Things applications. IEEE Internet Things J. 2026;12:29452–71.
- Ma X, Zhang X, Pun MO, Liu M. A multilevel multimodal fusion transformer for remote sensing semantic segmentation. IEEE Trans Geosci Remote Sens. 2024;62:1–15.
- Xie W, Lu Y, Li D, Li Y. Ebbinghaus-curve guided low-rank component-induced attention for multisource remote sensing classification. IEEE Trans Geosci Remote Sens. 2024;62:1–12.
- Li D, Xie W, Li Y, Fang L. FedFusion: Manifold-driven federated learning for multi-satellite and multi-modality fusion. IEEE Trans Geosci Remote Sens. 2023;62:1–13.
- Debes C, et al. Hyperspectral and LiDAR data fusion: Outcome of the 2013 GRSS data fusion contest. IEEE J Sel Top Appl Earth Obs Remote Sens. 2014;7:2405–18.
- Hu J, et al. MDAS: A new multimodal benchmark dataset for remote sensing. Earth Syst Sci Data Discuss. 2022:1–26.
- Gader P, et al. MUUFL Gulfport hyperspectral and LiDAR airborne data set. University of Florida; Gainesville (FL); Technical Report REP-2013-570; 2013.
- Gao Y, et al. Hyperspectral and multispectral classification for coastal wetland using depthwise feature interaction network. IEEE Trans Geosci Remote Sens. 2021;60:1–15.
- Feng Y, Song L, Wang L, Wang X. DSHFNet: Dynamic scale hierarchical fusion network based on multiattention for hyperspectral image and LiDAR data classification. IEEE Trans Geosci Remote Sens. 2023;61:1–14.
- Hong D, et al. More diverse means better: Multimodal deep learning meets remote-sensing imagery classification. IEEE Trans Geosci Remote Sens. 2020;59:4340–54.
- Feng Z, et al. Cross-modal contrastive learning for remote sensing image classification. IEEE Trans Geosci Remote Sens. 2023;61:1–13.
- Xu X, et al. Multisource remote sensing data classification based on convolutional neural network. IEEE Trans Geosci Remote Sens. 2017;56:937–49.
- Yao J, et al. Extended vision transformer (ExViT) for land use and land cover classification: A multimodal deep learning framework. IEEE Trans Geosci Remote Sens. 2023;61:1–15.
- Chang H, et al. Deep symmetric fusion transformer for multimodal remote sensing data classification. IEEE Trans Geosci Remote Sens. 2024;63:1–15.
- Wang A, et al. CTPMSN: Enhancing multimodal remote sensing classification with composite text prompts. IEEE J Sel Top Appl Earth Obs Remote Sens. 2025;18:27960–27978.