Данный протокол в области поведенческих наук и психологической оценки стандартизирует процедуру проведения онлайн-анкетирования, подсчета баллов, проверки качества данных и воспроизводимого анализа для оценки интернет-зависимости и трудностей в регуляции эмоций среди студентов университетов.
Для просмотра этого контента требуется подписка на JoVE. Войдите или начните свой бесплатный пробный период.
Методическая статья
Стандартизированный протокол анкетирования для оценки интернет-зависимости и эмоциональной регуляции у студентов университетов
В этой статье
Краткое содержание
Аннотация
Использование интернета глубоко интегрировано в университетскую жизнь, однако проблемное использование интернета невозможно адекватно оценить только по времени пребывания в сети. Данные свидетельствуют о том, что дезадаптивные или компульсивные модели использования интернета связаны с трудностями в регуляции эмоций, однако несоответствия в порядке опросников, критериях отбора, порогах скрининга, процедурах подсчета баллов и аналитической отчетности продолжают ограничивать сопоставимость различных исследований. В данной статье по методологии представлен стандартизированный протокол опроса для исследований в области поведенческих наук и психологической оценки, изучающих интернет-зависимость и трудности регуляции эмоций среди студентов университетов. Рабочий процесс включает фиксированную последовательность опросников, заранее определенные критерии отбора, настройки обязательных ответов, пороги времени заполнения на основе пилотного исследования, последовательный скрининг качества данных, стандартизированный подсчет баллов по тесту интернет-зависимости и 16-пунктовой шкале трудностей регуляции эмоций, а также воспроизводимый описательный, корреляционный и многофакторный регрессионный анализы. Протокол также предусматривает архивирование необработанных ответов, логов скрининга, файлов README/кодовых книг и окончательного набора данных, готового к анализу. Для демонстрации выполнения протокола, а не для валидации инструментов или установления распространенности, приводится пример реализации. В ходе этой реализации было приглашено 520 студентов, получено 480 заполненных опросников. После последовательного исключения дубликатов, слишком быстрых ответов, ошибок в тестах на внимательность, однообразных ответов, логических противоречий и отсутствия основных данных было сохранено 452 валидных опросника. В рамках предопределенного аналитического примера изучалась взаимосвязь между общим баллом по тесту интернет-зависимости и общим баллом по шкале трудностей регуляции эмоций. В отобранной выборке средний общий балл по тесту интернет-зависимости составил 51,94, а средний общий балл по шкале трудностей регуляции эмоций — 35,95. Трудности регуляции эмоций возрастали по мере увеличения степени тяжести интернет-зависимости, и эта связь оставалась значимой после корректировки с учетом демографических и поведенческих ковариат. Данный протокол обеспечивает прозрачный рабочий процесс, который может быть повторен, проверен и адаптирован для будущих одномоментных, повторных или лонгитюдных исследований в университетских популяциях.
Введение
Использование интернета стало обыденной частью университетской жизни, включая академическую работу, социальное общение, развлечения, поиск информации и эмоциональную адаптацию. По этой причине поведение студентов в интернете не следует интерпретировать просто как время воздействия экрана или время пребывания в сети. Более ранние данные показали, что проблематичное использование интернета уже наблюдалось среди молодежи и студентов до того, как современная среда мобильных платформ стала повсеместной1. Более поздние исследования в университетской среде дополнительно указывают на то, что проблематичное использование интернета встречается достаточно часто, чтобы требовать систематической оценки, а не просто неформального описания2.
Студенты университетов представляют собой особенно значимую популяцию для стандартизированной оценки, поскольку академическое давление, социальная адаптация, переход к самостоятельному проживанию и повышение автономности часто происходят на одном и том же этапе развития. Эти требования зачастую регулируются с помощью тех же цифровых устройств и платформ, которые сами могут стать объектами трудного контроля. Метааналитический обзор показал, что проблемное использование интернета среди студентов связано с многочисленными последствиями для психического здоровья, что подтверждает интерпретацию данной проблемы как более широкого поведенческого и психологического вопроса, а не узкоспециализированной проблемы использования технологий3. Субъективный стресс также был связан с паттернами интернет-зависимости у студентов колледжей, что указывает на необходимость учета эмоционального и контекстуального давления при разработке исследований на основе опросников в данной области4.
В настоящем протоколе термин «интернет-зависимость» используется применительно именно к конструкту, измеряемому с помощью теста на интернет-зависимость, и его установленным категориям баллов. Более широкий термин «проблемное использование интернета» используется при обсуждении общей литературы, касающейся дезадаптивного, чрезмерного или функционально нарушающего использование интернета. Термин «компульсивное использование интернета» применяется только в тех случаях, когда в цитируемой литературе акцентируется внимание на потере контроля, навязчивых влечениях или повторяющемся использовании, несмотря на негативные последствия. Таким образом, эти термины взаимосвязаны, но не считаются полностью взаимозаменяемыми. При реализации протокола с использованием теста на интернет-зависимость термин «интернет-зависимость» сохраняется как специфическая терминология данного инструмента; при использовании альтернативных или пересмотренных инструментов терминология должна быть приведена в соответствие с названиями конструктов и диагностическими допущениями выбранного метода измерения.
Регуляция эмоций представляет собой обоснованную психологическую точку входа для понимания того, почему некоторые студенты переходят от частого использования интернета к его дезадаптивному использованию. Годовое проспективное исследование показало, что трудности в регуляции эмоций были значимы как для последующего возникновения, так и для ремиссии интернет-зависимости среди студентов колледжей5. Этот вывод важен для разработки протокола, поскольку регуляция эмоций является не просто дополнительным коррелятом; она может влиять на то, как студенты используют интернет, чтобы избежать, уменьшить или контролировать дистресс. В то же время социальное функционирование остается актуальным фактором. Проблематичное использование интернета было связано с социальными навыками студентов университетов, что указывает на необходимость оценки межличностных и эмоциональных факторов наряду с переменными цифрового использования6. В период пандемии COVID-19 проблематичное использование интернета у китайских студентов университетов также сопровождалось более широкими психологическими трудностями, что дополнительно подтверждает необходимость структурированной оценки в университетской среде7.
Дополнительной сложностью является гетерогенность цифрового поведения. Студенты могут использовать цифровые платформы для учебы, социального общения, развлечений, получения информации о здоровье или временного эмоционального облегчения, и не каждое высокочастотное использование является вредным. Систематический обзор цифрового использования, связанного с психическим здоровьем студентов университетов, показал, что взаимодействие с цифровой средой может служить нескольким психологическим целям8. Следовательно, в данной области необходимы процедуры, позволяющие отличить обычное высокочастотное использование от проблемного или нерегулируемого. Последние данные о проблемном использовании смартфонов студентами университетов аналогично указывают на то, что риск зависит от поведенческого паттерна, функции и контекста, а не только от продолжительности использования9. По этой причине настоящий протокол объединяет продолжительность использования интернета, использование в ночное время, основную онлайн-активность и стандартизированную оценку симптомов вместо того, чтобы полагаться на один индикатор воздействия.
Методы измерения являются еще одним основным источником несогласованности данных. Тест на интернет-зависимость остается одним из наиболее широко используемых инструментов для оценки симптомов зависимости от интернета, однако его размерность и интерпретация различались в зависимости от условий применения. Систематические психометрические данные указывают на то, что этот инструмент активно используется, но при этом продолжают возникать вопросы относительно факторной структуры и интерпретации баллов10. Аналогичные опасения были отмечены в выборках студентов колледжей, где широкое применение шкалы не позволило полностью устранить неопределенность в отношении измеряемого конструкта11. Исследования по валидации в популяциях студентов университетов Испании и Перу также показывают, что инструмент может работать адекватно, однако его психометрические характеристики следует рассматривать с учетом целевой популяции, в которой он применяется12,13.
Таким образом, данный протокол разработан таким образом, чтобы обеспечить стабильность рабочего процесса при возможности адаптации в выборе инструментов. Тест на интернет-зависимость используется здесь в силу его исторического применения, наличия установленных пороговых значений и сопоставимости с предыдущими исследованиями студентов университетов. Тем не менее, протокол не требует использования теста на интернет-зависимость в качестве предпочтительного инструмента бессрочно. Если диагностические критерии изменятся или если для конкретной популяции станут более подходящими новые инструменты, можно сохранить тот же рабочий процесс, заменив модуль конкретной шкалы, диапазон баллов, пороги тяжести, записи в кодовой книге и документацию README. Любая такая замена должна быть произведена до начала официального сбора данных и отражена как модификация протокола, а не как ситуативное аналитическое изменение.
Методологическая проблема, рассматриваемая в данной статье, заключается не просто в том, что исследования интернет-зависимости и эмоциональной регуляции приводят к разным выводам. Скорее, многие исследования различаются в последовательности опросников, критериях отбора участников, настройках платформы опроса, методах обработки дублирующих ответов, процедурах проверки внимания, порогах времени заполнения, правилах обработки пропущенных данных, верификации подсчета баллов и представлении файлов, готовых к анализу. Эти различия затрудняют сравнение, воспроизведение и включение результатов в последующий синтез доказательств. Настоящий протокол восполняет этот пробел, фиксируя последовательность проведения, логику скрининга, структуру подсчета баллов и аналитический путь таким образом, чтобы их можно было повторять, проверять и прозрачно модифицировать. Таким образом, вклад данной работы носит протокольно-ориентированный характер: она предоставляет воспроизводимый рабочий процесс для обсервационных исследований в области поведенческих наук и психологической оценки в студенческих популяциях, а не предлагает новый психологический конструкт или представляет исследование распространенности в качестве основного результата.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Протокол
Исследование под названием «Стандартизированный протокол анкетирования для оценки интернет-зависимости и эмоциональной регуляции у студентов университетов» было рассмотрено и одобрено Комитетом по этике и академическим вопросам Университета экономики и бизнеса города Чжэнчжоу (номер одобрения 20260113004) до начала набора участников14. В исследовании использовался дизайн одномоментного анонимного онлайн-анкетирования с участием студентов университетов очной формы обучения в возрасте 18–24 лет; работа проводилась в соответствии с требованиями институциональной этики и Хельсинкской декларацией. Перед предоставлением доступа к анкете было получено электронное информированное согласие. Участники получили информационный лист в электронном виде с описанием целей исследования, процедур, добровольного характера участия и мер по защите данных; они имели право отказаться от участия в любое время без каких-либо последствий. В основном файле опроса не собиралась никакая лично идентифицируемая информация, включая имя, номер студенческого билета, точный адрес, номер телефона, личный адрес электронной почты или аккаунт в социальных сетях. Идентификаторы, генерируемые платформой, использовались только для отсеивания дубликатов ответов и были удалены перед анализом набора данных. Все данные хранились в безопасном месте и анализировались в обезличенной форме. Данный рабочий процесс анкетирования не был зарегистрирован проспективно до начала набора участников. Тем не менее, все основные компоненты протокола, включая заблокированную версию анкеты, файл README/кодовую книгу, журнал скрининга, правила подсчета баллов, синтаксис анализа и файлы рабочего процесса, готовые к анализу, были заархивированы и предоставлены в качестве дополнительных материалов к рабочему процессу для обеспечения воспроизводимости и возможности аудита.
Идентификаторы ответов, созданные платформой, а также технические идентификаторы устройств или учетных записей использовались только для выявления дублирующих ответов и были удалены из окончательного анонимизированного аналитического набора данных. Основные переменные и правила начисления баллов приведены в Таблице 1, а полный словарь переменных представлен в Дополнительной таблице 1. Файлы опросника, кодовая книга, журнал скрининга, план вывода и материалы рабочего процесса, готовые к анализу, представлены в Дополнительном файле 1.
| Область применения | Переменная | Кодирование/оценка | Роль в протоколе |
| Критерии соответствия | Возраст | Годы; допустимый диапазон 18–24 | Переменная соответствия критериям и ковариата |
| Демографические данные | Пол | 1 = мужской; 2 = женский; 3 = предпочитаю не отвечать | Описательная переменная и ковариата регрессии |
| Демографические данные | Учебный год | 1 = первый курс; 2 = второй курс; 3 = третий курс; 4 = четвертый курс и старше; 5 = аспирантура | Описательная переменная |
| Демографические данные | Категория дисциплины | 1 = гуманитарные и общественные науки; 2 = естественные науки и инженерное дело; 3 = бизнес и менеджмент; 4 = искусство и дизайн; 5 = другое | Описательная переменная |
| Демографические характеристики | Тип жилья | 1 = общежитие при кампусе; 2 = арендное жилье вне кампуса; 3 = дом семьи; 4 = другое | Описательная переменная |
| Демографические данные | Ежемесячные расходы на проживание | 1 = <1 000 CNY; 2 = 1 000–1 999 CNY; 3 = 2 000–2 999 CNY; 4 = ≥3 000 CNY | Описательная переменная |
| Поведение при использовании интернета | Использование интернета в будние дни | 1 = <2 ч; 2 = 2–3,9 ч; 3 = 4–5,9 ч; 4 = ≥6 ч | Поведенческая ковариата |
| Поведение при использовании интернета | Использование интернета в выходные дни | 1 = <2 ч; 2 = 2–3,9 ч; 3 = 4–5,9 ч; 4 = ≥6 ч | Поведенческая ковариата |
| Поведение пользователей Интернета | Основная активность в сети | 1 = учеба; 2 = социальные сети; 3 = игры; 4 = развлечения/видео; 5 = покупки; 6 = смешанное использование; 7 = другое | Описательная переменная |
| Поведение пользователей интернета | Основное устройство доступа | 1 = смартфон; 2 = планшет; 3 = ноутбук/стационарный компьютер; 4 = смешанные устройства | Описательная переменная |
| Поведение пользователей Интернета | Использование в ночное время после 23:00 | 1 = никогда; 2 = реже одного раза в неделю; 3 = 1–2 ночи в неделю; 4 = 3–5 ночей в неделю; 5 = почти каждую ночь | Поведенческая ковариата и переменная скрининга на логическую согласованность |
| Основная шкала | общий балл IAT | Сумма 20 пунктов; каждый пункт оценивается от 1 до 5; общий диапазон 20–100 | Основная независимая переменная |
| Основная шкала | Группа по степени тяжести IAT | 20–39 = нормальное употребление; 40–69 = проблемное употребление; 70–100 = тяжелое проблемное употребление | Группирующая переменная |
| Основная шкала | общий балл по шкале DERS-16 | Сумма 16 пунктов после необходимого реверсивного кодирования; общий диапазон 16–80 | Основная зависимая переменная |
| Основная шкала | субшкалы DERS-16 | Рассчитано в соответствии с фиксированным ключом оценивания DERS-16 | Дескриптивные показатели результатов регуляции эмоций |
| Ковариата | Продолжительность сна | 1 = <6 ч; 2 = 6–6,9 ч; 3 = 7–7,9 ч; 4 = ≥8 ч | Корректирующая переменная |
| Ковариата | Еженедельная физическая активность | 0 = нет; 1 = 1–2 сеанса; 2 = 3–4 сеанса; 3 = ≥5 сеансов | Регулирующая переменная |
| Ковариата | Академический стресс | 1 = низкий; 2 = умеренный; 3 = высокий | Корректирующая переменная |
| Контроль качества | Проверка внимания | 1 = пройдено; 0 = не пройдено | Критерий исключения |
| Контроль качества | Время завершения | Продолжительность выполнения в секундах | Переменная скрининга на основе времени |
| Контроль качества | Количество ответов с длинными строками | Максимальная длина серии идентичных ответов по 36 оцениваемым пунктам шкалы | Переменная скрининга с шаблонным ответом |
| Контроль качества | Внутрииндивидуальное СКО | Внутрииндивидуальное стандартное отклонение по 36 оцениваемым пунктам шкалы | Переменная скрининга с инвариантным ответом |
| Контроль качества | Флаг логической согласованности | 0 = несоответствие отсутствует; 1 = обнаружено несоответствие | Переменная скрининга на логическую согласованность |
Таблица 1: Основные переменные, структура кодирования и правила подсчета баллов, используемые в протоколе стандартизированного опросника.В этой таблице обобщены основные переменные соответствия критериям, демографические данные, показатели использования интернета, шкалы, ковариаты и переменные контроля качества, используемые в основном рабочем процессе. В ней указаны значения кодирования, диапазоны баллов, правила подсчета и роль основных переменных, используемых при проведении опроса, скрининге, подсчете баллов и анализе. Сокращения: IAT = тест на интернет-зависимость; DERS-16 = 16-пунктовая шкала трудностей эмоциональной регуляции. Пожалуйста, нажмите здесь, чтобы скачать эту таблицу.
1. Формирование исследуемой популяции, структуры опросника и схемы проведения опроса
- Определите целевую популяцию и репрезентативную выборку
- Привлеките студентов бакалавриата и магистратуры/аспирантуры в возрасте от 18 до 24 лет, которые могут самостоятельно заполнить анкету с помощью мобильного телефона или компьютера. Зафиксируйте языковую версию анкеты и используйте версии шкал, которые были валидированы или надлежащим образом адаптированы для целевой группы студентов.
- Если в исследовании участвуют иностранные студенты, студенты с ограниченными возможностями здоровья или многоязычные группы студентов, необходимо задокументировать любые меры по обеспечению доступности или модификации языка до начала сбора данных.
- Ограничьте участие одним заполненным ответом на одного участника. При наличии такой возможности используйте функции платформы опроса по ограничению доступа по устройству, учетной записи, файлам cookie или по аутентифицированной ссылке.
ПРИМЕЧАНИЕ: если один и тот же аккаунт участника генерирует ответы с нескольких устройств, выявите и объедините такие записи в ходе проверки на дубликаты, используя идентификатор, ограниченный областью действия аккаунта, временную метку, статус заполнения анкеты и сходство паттернов ответов. - Установите минимальный размер итоговой валидной выборки на уровне 450 анкет и продолжайте набор участников до тех пор, пока объем очищенного набора данных после скрининга не превысит этот порог.
ПРИМЕЧАНИЕ: если основной целью анализа является выявление серьезных проблем с использованием интернета или другая малочисленная подгруппа, установите более высокую цель по набору участников до начала сбора данных. - Зафиксируйте количество приглашенных лиц, количество полученных ответов, количество исключенных лиц на каждом заранее определенном этапе скрининга и итоговое число участников, чтобы в дальнейшем можно было обобщить схему движения участников в Рисунок 1.
- Составьте анкету в фиксированном порядке
- Расположите вопросы анкеты в следующей последовательности: информированное согласие, демографические данные, особенности использования интернета, Тест на интернет-зависимость, краткая форма шкалы трудностей регуляции эмоций, продолжительность сна, еженедельная физическая активность и субъективная оценка академического стресса. Сохраняйте этот порядок неизменным для всех участников. Не рандомизируйте последовательность основных шкал.
- Зафиксируйте возраст, пол, курс обучения, категорию дисциплины, тип жилья и ежемесячные расходы на проживание, используя закрытые категории ответов. Обозначьте все демографические пункты как обязательные для заполнения.
ПРИМЕЧАНИЕ: В качестве вариантов пола укажите: мужской, женский и «предпочитаю не отвечать». Сохраняйте вариант «предпочитаю не отвечать» в описательном анализе. В регрессионном анализе кодируйте пол с помощью индикаторных переменных, где мужской пол будет являться референтной категорией; при этом введите отдельные индикаторы для женского пола и варианта «предпочитаю не отвечать». Не исключайте участников из исследования только на основании выбора варианта «предпочитаю не отвечать». - Зафиксируйте продолжительность использования интернета в будние дни, продолжительность использования интернета в выходные дни, основной вид деятельности в сети, основное устройство доступа и использование интернета в ночное время после 23:00. Присвойте коды использованию интернета в ночное время следующим образом: 1 — никогда, 2 — реже одного раза в неделю, 3 — 1–2 ночи в неделю, 4 — 3–5 ночей в неделю, 5 — почти каждую ночь.
- Зафиксируйте академический период, в течение которого проводилось анкетирование. В данной реализации опрос проводился во время обычного учебного семестра, вне недель итоговых экзаменов, а именно на 6–7-й неделях семестра.
- Проведите тестирование с использованием основных инструментов и оцените результаты
- Проведите тест на интернет-зависимость, состоящий из 20 вопросов, в качестве обязательной шкалы; оцените каждый пункт по шкале от 1 до 5. Суммируйте баллы по всем 20 пунктам для получения общего балла в диапазоне от 20 до 100, затем классифицируйте результаты следующим образом: 20–39 — нормальное использование, 40–69 — проблемное использование, 70–100 — тяжелая форма проблемного использования.15.
- Используйте термин «интернет-зависимость» при представлении результатов на основе шкалы IAT и групп по степени тяжести. Термин «проблематичное использование интернета» следует использовать только при ссылках на более широкую литературу или конструкты, не связанные с IAT.
- Сразу после проведения теста на интернет-зависимость проведите опрос с использованием краткой формы шкалы трудностей регуляции эмоций (Difficulties in emotion regulation scale short form), состоящей из 16 пунктов; каждый пункт оценивается по шкале от 1 до 5. Перед суммированием выполните обратное кодирование пунктов 1, 6 и 8, затем рассчитайте общий балл в диапазоне от 16 до 80, где более высокие значения указывают на бóльшие трудности в регуляции эмоций.16.
- Рассчитайте пять показателей по субшкалам: неодобрение (nonacceptance), цели (goals), импульсивность (impulse), стратегии (strategies) и ясность (clarity) после проверки обратного кодирования.
- Перед расчетом общих баллов и баллов по субшкалам повторно проверьте направление кодирования всех обратных пунктов. Используйте один и тот же ключ подсчета баллов DERS-16 для каждого участника и зафиксируйте этот ключ в файле README/кодовой книге.
- При использовании пересмотренного или альтернативного инструмента оценки интернет-зависимости замените модуль, специфичный для данной шкалы, до начала сбора данных и обновите названия пунктов, диапазон баллов, пороги тяжести, синтаксис подсчета баллов, файл README/кодовую книгу, скриншоты опросника и Таблица материалов.
- Добавьте ковариаты и один пункт для проверки внимания
- Зафиксируйте продолжительность сна как <6 ч, 6–6,9 ч, 7–7,9 ч и ≥8 ч. Зафиксируйте еженедельную частоту физической активности как 0, 1–2, 3–4 или ≥5 занятий. Зафиксируйте субъективно воспринимаемый академический стресс как низкий, умеренный или высокий. Определите одно занятие физической активностью как ≥20 минут умеренной или интенсивной нагрузки.
- Вставьте один вопрос для проверки внимания с заданным ответом в поведенческий раздел и потребуйте от участника выбрать один конкретный вариант ответа. В репрезентативной реализации использовался следующий вопрос для проверки внимания: «Чтобы подтвердить, что вы внимательно читаете, пожалуйста, выберите для данного пункта вариант "3 = иногда"». Любую анкету, в которой этот пункт выполнен неверно, отметьте для исключения в процессе очистки данных.17.
КРИТИЧЕСКИЙ ЭТАП: После начала официального сбора данных запрещается изменять формулировки пунктов, варианты ответов, порядок шкал, пороги исключения, настройки платформы опроса, правила кодирования или правила статистического анализа.
ПРИМЕЧАНИЕ: Обобщите основные переменные, значения кодирования, диапазоны баллов и правила подсчета баллов в Таблица 1Предоставьте полный словарь переменных, поля статуса файлов, флаги скрининга, поля технических идентификаторов, переменные отслеживания наборов данных, имена файлов и версии программного обеспечения в Дополнительная таблица 1 а также файл README/кодовую книгу.
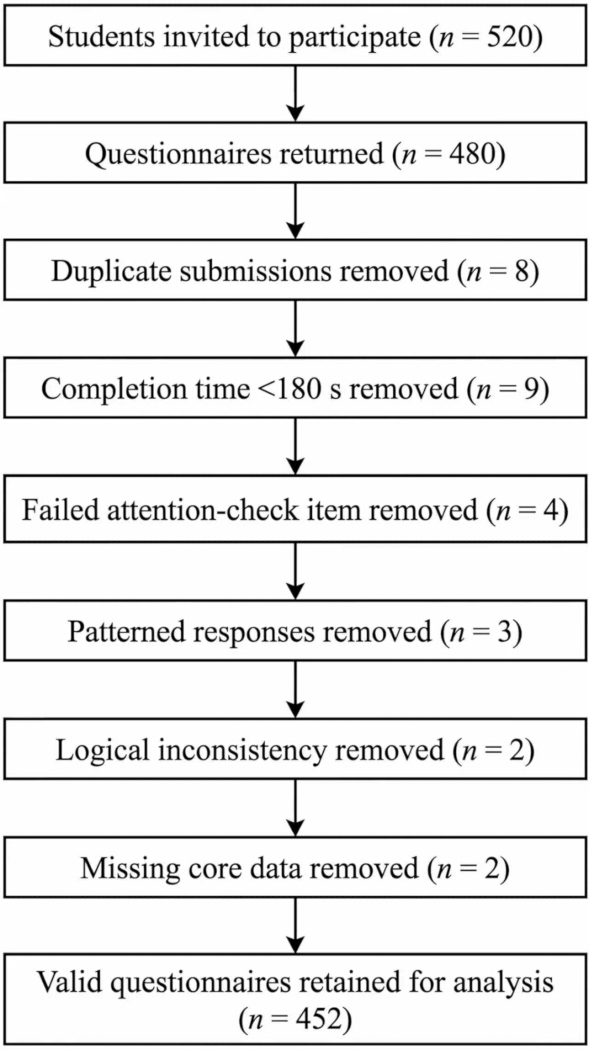
Рисунок 1: Схема процесса заполнения опросников для набора, скрининга, исключения и окончательного анализа данных.Эта блок-схема демонстрирует переход от приглашенных студентов к возвращенным опросникам, через последовательный скрининг качества данных и исключение по заранее определенным критериям, до окончательного отбора валидных опросников для анализа. На рисунке представлено количество приглашенных студентов, возвращенных опросников, исключенных записей на каждом этапе скрининга и итоговая аналитическая выборка. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
2. Пилотное тестирование опросника и утверждение окончательного полевого варианта
- Пилотное тестирование полного опросника
- Проведите полное анкетирование 20–30 студентов, которые соответствуют формальным критериям включения, но не будут включены в итоговый набор данных.
- Зафиксируйте время заполнения и письменные отзывы о ясности формулировок, нагрузке при ответах, техническом доступе, порядке вопросов, понятности контрольных вопросов на внимательность, а также любые неясности в вариантах ответов по демографическим или поведенческим характеристикам.
- Зафиксируйте размер пилотной выборки, медианное время заполнения, межквартильный размах, минимальное и максимальное время заполнения, а также все изменения в формулировках, внесенные после пилотного тестирования.
- В репрезентативной реализации пилотное тестирование включало 25 студентов; медианное время заполнения составило 540 s, а ожидаемое время заполнения было установлено на уровне 6–8 min.
- Исправьте двусмысленные формулировки, дублирование смыслов, неясные варианты ответов или проблемы отображения в программном обеспечении, выявленные в ходе пилотного тестирования, после чего утвердите окончательную версию опросника перед официальным выпуском.
ПРИМЕЧАНИЕ: Если исследование включает многоязычных студентов, пожилых людей, подростков или студентов с ограниченными возможностями, проведите дополнительное когнитивное тестирование или пилотное тестирование подгрупп перед официальным выпуском.
- Настройка операционных параметров и правил экспорта
- Создайте новый проект опроса на выбранной платформе для онлайн-опросов. Установите страницу согласия в качестве первой страницы и назначьте пункт о согласии обязательным элементом ветвления.
- Настройте опрос таким образом, чтобы участники, не предоставившие согласие, автоматически выходили из опроса, не видя основного содержания опросника.
- Введите все вопросы по демографии, использованию интернета, IAT, DERS-16, ковариаты и контрольные вопросы на внимательность, используя утвержденные формулировки и варианты ответов. Установите все основные пункты как обязательные.
- Активируйте автоматическую запись времени начала, времени окончания, общей продолжительности заполнения, статуса ответа и идентификатора ответа, генерируемого платформой.
- Включите средства контроля «один ответ на одного участника», если они доступны, включая аутентифицированные ссылки на опрос, ограничение по устройству, предотвращение повторов на основе файлов cookie, предотвращение повторов на основе учетной записи или настройки проверки дублирующихся ответов. Зафиксируйте включенные средства контроля в README/кодовой книге.
- Отключите сбор ненужных прямых идентификаторов. Если платформа по умолчанию записывает IP-адрес, отключите хранение IP или замените его полем для проверки дубликатов, не позволяющим идентифицировать личность, если это разрешено политикой учреждения.
ПРИМЕЧАНИЕ: Если IP-адреса или метаданные устройств временно сохраняются для проверки дубликатов, храните их только в зашифрованном исходном файле, ограничьте доступ только аналитиком исследования и удалите их перед созданием итогового аналитического набора данных. - Укажите, разрешена ли приостановка и возобновление опроса. В данном протоколе формальная функция сохранения и возврата между разными сессиями не активирована. Участники могут делать паузы только в рамках одной открытой сессии браузера, и зафиксированное время заполнения включает общее время elapsed time.
- По завершении опроса экспортируйте исходный файл ответов в форматах электронной таблицы и CSV (значения, разделенные запятыми)18. Также экспортируйте файл «опрос-документ» или копию в формате PDF/A, содержащую окончательные формулировки вопросов, порядок пунктов, настройки ветвления, настройки обязательных пунктов и структуру кодирования. Сохраните эти файлы с именами, имеющими контроль версий.
- Рассчитайте медианное время заполнения в пилотном исследовании и установите минимальный порог допустимого времени заполнения примерно на уровне одной трети этого значения. Установите окончательный нижний порог на уровне 180 s и применяйте его единообразно во время основного скрининга.
- Поскольку этот порог получен на основе пилотной выборки, пересмотрите его при реализации протокола на существенно иной популяции, платформе, языковой версии или в другом институциональном окружении.
ПРИМЕЧАНИЕ: Сохраните скриншоты окончательного опросника, экспорт окончательного опросника, README/кодовую книгу, лог пилотного тестирования, формулировки контрольных вопросов на внимательность, шаблон лога скрининга, настройки экспорта и статистический синтаксис в качестве дополнительных или аудиторских файлов.
3. Рассылка анкеты и сохранение исходного набора данных
- Набор участников через установленные каналы
- Разошлите одно стандартизированное приглашение через группы общения студентов, каналы классов или рассылочные списки учебного заведения в течение фиксированного 14-дневного окна сбора данных.
- Укажите цель исследования, ожидаемое время заполнения (6–8 мин), анонимность обработки данных, добровольный характер участия, а также отсутствие академических санкций или вознаграждений за неучастие как в тексте приглашения, так и на странице согласия.
- Отображайте страницу согласия до появления любых пунктов опросника и требуйте активного подтверждения перед входом. Не допускайте доступа к основному телу опросника без положительного ответа на запрос о согласии.
- Укажите на странице согласия, что участники могут прекратить заполнение до окончательной отправки и что неполные ответы не будут использоваться в итоговом анализе.
- Используйте одну и ту же заблокированную версию опросника во всех каналах набора. Если используется несколько каналов набора, фиксируйте канал только в том случае, если он предварительно определен как переменная исследования.
- Сохранение исходного файла ответов
- Сохраняйте все полученные записи, включая неполные и впоследствии исключенные ответы, в исходном файле экспорта. Экспортируйте полный набор данных сразу после закрытия опроса и сохраните его под именами raw_returns_YYYYMMDD.csv и raw_returns_YYYYMMDD.xlsx.
- Сохраняйте в исходном файле время отправки, длительность заполнения, статус ответа, идентификатор ответа, созданный платформой, а также технический идентификатор устройства или учетной записи. Не перезаписывайте эти поля в процессе последующей очистки данных.
- Сохраните одну копию исходных данных в режиме «только для чтения» до начала скрининга. Храните исходный файл, журнал скрининга и итоговый аналитический набор данных в разных папках. Ограничьте доступ к исходному файлу, содержащему технические идентификаторы, только уполномоченным персоналом исследования.
ПРЕДОСТЕРЕЖЕНИЕ: Не собирайте в основном файле опроса информацию, позволяющую напрямую идентифицировать личность, такую как полное имя, номер студенческого билета, точный адрес в общежитии, личный номер телефона, личный адрес электронной почты или аккаунт в социальных сетях.
ПРИМЕЧАНИЕ: Приостановите рабочий процесс после экспорта исходных данных, сохраните одну копию исходного набора данных в режиме «только для чтения» и возобновите очистку данных только на основе этой сохраненной копии.
4. Проверка полученных опросников и создание окончательного аналитического набора данных
- Применяйте последовательность скрининга в строго определенном порядке
- Отсортируйте все полученные записи по идентификатору устройства, идентификатору учетной записи (если доступен), временной метке, статусу заполнения опросника и сходству ответов. Сначала выявите дубликаты заявок. Если от одного участника в течение одного цикла сбора данных поступило две или более заявок, оставьте самую раннюю полную запись.
- Если обнаружено несколько заявок с одной и той же аутентифицированной учетной записи, но с разных устройств, расценивайте их как дубликаты от одного участника. Оставьте самую раннюю полную запись и исключите последующие полные записи. Если самая ранняя запись неполная, а последующая запись полная, оставьте самую раннюю полную запись.
- Четвертым этапом удалите записи со временем заполнения <180 s, проверьте записи, заполненные за 180–240 s, и удалите записи, в которых был провален контрольный вопрос на внимательность с заданным ответом. Задокументируйте количество удаленных записей на каждом этапе в файле screening_log_v1.xlsx19.
- Для записей, заполненных за 180–240 s, проведите ручную проверку, используя результат контроля внимания, флаг ответов по длинным сериям (long-string responding), внутрииндививидуальное стандартное отклонение и флаг логической согласованности.
- Оставляйте запись с пограничной скоростью заполнения только в том случае, если отсутствуют дополнительные флаги низкого качества данных. Каждое решение по записям с пограничной скоростью фиксируйте в журнале скрининга.
- Удалите шаблонные, противоречивые или неполные записи
- Удалите все опросники с признаками ответов по длинным сериям, которые определяются как 18 или более последовательных идентичных ответов по 36 оцениваемым пунктам шкалы, или как внутрииндививидуальное стандартное отклонение ≤0.25 по этим пунктам.
- Удалите любые опросники с невозможными поведенческими комбинациями. Определите «наивысшую категорию ответов почти по всем пунктам теста на интернет-зависимость» как балл 5 не менее чем по 18 из 20 пунктов IAT.
ПРИМЕЧАНИЕ: Правило логической несогласованности срабатывает, если респондент указывает использование интернета в будние и выходные дни в самой низкой категории длительности (<2 h в день), использование интернета поздно ночью как «почти каждую ночь» и балл 5 не менее чем по 18 из 20 пунктов IAT. Применяйте это правило только после завершения скрининга на дубликаты, время заполнения, внимательность и шаблонные ответы. - Удалите все опросники с пропущенными значениями в любом пункте IAT, любом пункте DERS-16 или любом заранее определенном ковариате.
ПРИМЕЧАНИЕ: Это правило полного анализа случаев (complete-case rule) используется, так как в онлайн-опросе применяются обязательные основные пункты и поскольку репрезентативная регрессионная модель требует фиксированного набора ковариат. Если количество пропущенных данных по ковариатам превышает 5%, используйте заранее определенный альтернативный метод обработки пропущенных данных, например, множественную импутацию. - Присвойте каждой сохраненной записи один анонимный ID исследования и сохраните оставшийся файл как analytic_dataset_v1.csv и analytic_dataset_v1.xlsx.
- Удалите из итогового аналитического набора данных идентификаторы ответов, созданные платформой, идентификаторы устройств, идентификаторы учетных записей, IP-адреса (если они сохранялись во время скрининга), временные метки и текстовые заметки по результатам проверки. Оставьте только анонимный ID исследования и переменные анализа.
КРИТИЧЕСКИЙ ЭТАП: Применяйте последовательность скрининга в одном и том же порядке к каждой записи и не возвращайте ранее исключенные случаи на более поздних этапах. Назначайте первый сработавший критерий исключения в качестве основной причины исключения, а вторичные флаги записывайте только как примечания в журнале скрининга.
ПРИМЕЧАНИЕ: Обобщите итоговое количество исключений по причинам в Таблице 2; эти данные должны совпадать с потоком участников, представленным позже на Рисунке 1.
| Порядок скрининга | Объект скрининга | Операционное правило | Действие при скрининге | Правило документирования |
| Шаг 1 | Сохранение исходного экспорта | Экспортировать все полученные записи сразу после закрытия опроса и сохранить их как raw_returns_YYYYMMDD.csv и raw_returns_YYYYMMDD.xlsx | Сохранить одну копию только для чтения до начала какой-либо очистки | Архивировать в папке raw-data |
| Шаг 2 | Проверка согласия и доступа | Выявить записи без активного электронного информированного согласия перед доступом к анкете | Исключить записи без согласия из аналитического рабочего процесса | Занести исключенные или недоступные записи в screening_log_v1.xlsx, если они сохранены в экспорте платформы |
| Шаг 3 | Скрининг дубликатов | Выявить записи с одинаковым идентификатором устройства или идентификатором учетной записи в рамках одного цикла сбора, совпадающие по полу, возрасту, курсу обучения и имеющие как минимум 80% идентичных ответов в анкете | Оставить самую раннюю полную запись и исключить все последующие дубликаты | Записать количество исключенных записей и значения затронутых raw_record_id в screening_log_v1.xlsx; присвоить основную причину исключения (exclusion_reason) = 1 |
| Шаг 4 | Сопоставление дубликатов с разных устройств | Выявить несколько полных ответов от одной аутентифицированной учетной записи участника с разных устройств | Рассматривать эти записи как повторяющиеся ответы; оставить самую раннюю полную запись | Записать идентификатор учетной записи и сохраненный raw_record_id в screening_log_v1.xlsx; присвоить последующим записям основную причину исключения (exclusion_reason) = 1 |
| Шаг 5 | Скрининг времени заполнения | Выявить все анкеты со временем заполнения <180 s | Автоматически исключить все такие записи | Записать количество исключенных записей в screening_log_v1.xlsx; присвоить основную причину исключения (exclusion_reason) = 2 |
| Шаг 6 | Проверка пограничной скорости | Выявить все анкеты со временем заполнения 180–240 s | Вручную проверить каждую запись с помощью проверок внимания, поиска повторяющихся строк, внутрисубъектного SD и логических флагов; оставить только в случае отсутствия дополнительных флагов | Отметить каждый случай как retained_after_manual_review = 1 или excluded_after_manual_review = 1 в screening_log_v1.xlsx |
| Шаг 7 | Скрининг проверок внимания | Выявить все записи, в которых не пройден пункт проверки внимания с заданным ответом | Исключить все записи с ошибками, которые не были исключены на предыдущих этапах | Записать количество исключенных записей в screening_log_v1.xlsx; присвоить основную причину исключения (exclusion_reason) = 3 |
| Шаг 8 | Скрининг шаблонных ответов | Выявить записи с 18 или более последовательными идентичными ответами среди 36 оцениваемых пунктов шкалы или с внутрисубъектным SD ≤0.25 по этим пунктам | Исключить все такие записи, которые не были исключены на предыдущих этапах | Записать количество исключенных записей в screening_log_v1.xlsx; присвоить основную причину исключения (exclusion_reason) = 4 |
| Шаг 9 | Скрининг логической согласованности | Выявить записи, демонстрирующие заранее определенную невозможную комбинацию поведения: weekday_internet_use и weekend_internet_use оба закодированы как <2 h, late_night_use закодирован как «почти каждую ночь» и оценка 5 по крайней мере в 18 из 20 пунктов IAT | Исключить все такие записи, которые не были исключены на предыдущих этапах | Записать количество исключенных записей и примечание к проверке в screening_log_v1.xlsx; присвоить основную причину исключения (exclusion_reason) = 5 |
| Шаг 10 | Скрининг основных пропусков | Выявить записи с любым пропущенным значением в IAT_1–IAT_20, DERS_1–DERS_16, age, sex, weekday_internet_use, weekend_internet_use, sleep_duration, physical_activity или academic_stress; вариант «предпочитаю не отвечать» для пола рассматривается как действительный ответ, а не как пропуск | Исключить все такие записи, которые не были исключены на предыдущих этапах | Записать количество исключенных записей в screening_log_v1.xlsx; присвоить основную причину исключения (exclusion_reason) = 6 |
| Шаг 11 | Присвоение основной причины исключения | Выявить записи, соответствующие более чем одному критерию исключения | Присвоить первый сработавший критерий в заранее определенной последовательности скрининга в качестве основной причины исключения | Записывать второстепенные флаги только в примечаниях к проверке; не присваивать несколько основных причин |
| Шаг 12 | Удаление технических идентификаторов | Выявить сгенерированные платформой идентификаторы ответов, идентификаторы устройств, идентификаторы учетных записей, временные метки и любые временно сохраненные технические метаданные в очищенном файле | Удалить эти поля из окончательного аналитического набора данных после завершения скрининга | Задокументировать удаление в screening_log_v1.xlsx |
| Шаг 13 | Окончательный отбор | Оставить все записи, прошедшие все предыдущие этапы скрининга | Присвоить каждой сохраненной записи один анонимный ID исследования | Сохранить как analytic_dataset_v1.csv и analytic_dataset_v1.xlsx |
| Шаг 14 | Итоги скрининга | Подсчитать количество удаленных записей на каждом этапе и итоговое количество сохраненных записей | Обобщить итоговые данные для представления в рукописи | Обеспечить идентичность данных в Таблице 2 и на Рисунке 1 |
| Шаг 15 | Сохранение аудиторского следа | Сохранить исходный файл, журнал скрининга и окончательный аналитический набор данных в виде отдельных файлов | Не перезаписывать, не объединять и не редактировать вручную архивированные исходные файлы | Хранить отдельно в папках raw-data, screening и analytic |
Таблица 2: Предварительно определенная последовательность скрининга, пороги исключения, действия по скринингу и правила документирования при очистке данных опросников.В этой таблице обобщен фиксированный порядок скрининга, используемый для очистки возвращенных опросников, включая проверку согласия и доступа, выявление дубликатов, сверку данных с нескольких устройств, скрининг по времени заполнения, анализ граничных скоростей, проверку сбоев контроля внимания, выявление шаблонных ответов, логическую несогласованность, отсутствие основных данных, удаление технических идентификаторов, окончательный отбор и сохранение журнала аудита. Сокращения: IAT = тест на интернет-зависимость; DERS-16 = 16-пунктовая шкала трудностей при регуляции эмоций. Пожалуйста, нажмите здесь, чтобы скачать эту таблицу.
5. Рассчитайте значения переменных, проверьте надежность и подготовьте файл для анализа
- Расчет общих баллов, баллов по субшкалам и производных категориальных переменных
- Просуммируйте баллы по 20 пунктам IAT для получения общего показателя интернет-зависимости, затем сохраните в файле для анализа как непрерывный показатель, так и класс степени тяжести с тремя уровнями.
- Выполните обратное кодирование пунктов 1, 6 и 8 опросника DERS-16, рассчитайте общий балл и баллы по пяти субшкалам, и добавьте все производные переменные в тот же набор данных на уровне участников.
- Проведите проверку диапазона значений перед расчетом баллов. Подтвердите, что все значения пунктов IAT и DERS-16 находятся в пределах 1–5, все значения с обратным кодированием находятся в пределах 1–5, общие баллы IAT находятся в пределах 20–100, а общие баллы DERS-16 — в пределах 16–80. Занесите результаты проверки диапазона в журнал подсчета баллов.
- Перекодирование ковариат в фиксированные аналитические категории
- Перекодируйте продолжительность использования интернета в будние и выходные дни следующим образом: <2 ч, 2–3.9 ч, 4–5.9 ч и ≥6 ч. Перекодируйте использование интернета в ночное время как: никогда, <1 ночи/нед, 1–2 ночи/нед, 3–5 ночей/нед и почти каждую ночь.
- Перекодируйте продолжительность сна, частоту физической активности и воспринимаемый академический стресс, используя заранее определенные правила категоризации, описанные в разделе 1.4, и сохраните перекодированные значения под фиксированными именами переменных в том же наборе данных.
- Перекодируйте пол для регрессионного анализа, используя две индикаторные переменные: «женский» против «мужского» и «предпочитаю не отвечать» против «мужского». Укажите схему кодирования в сноске к таблице и в файле README/кодовой книге.
- Проверка целостности подсчета баллов и внутренней согласованности
- Рассчитайте альфу Кронбаха для общего балла IAT и общего балла DERS-16 перед проведением инференциального анализа. Повторно проверьте кодирование пунктов, обратное кодирование и недопустимые диапазоны значений пунктов, если какое-либо из значений альфы будет <0.7020. Укажите значения альфы Кронбаха в разделе «Репрезентативные результаты».
- Рассчитайте корреляции пунктов с общим баллом или значения «альфа при удалении пункта», если какая-либо из шкал демонстрирует неожиданно низкую внутреннюю согласованность. Не удаляйте пункты шкалы из основного анализа, если удаление пунктов не было предусмотрено заранее или если исследование эксплицитно разработано как исследование психометрической валидации.
- Сохраните окончательный набор данных, готовый к анализу, вместе с файлом README, содержащим имена переменных, правила кодирования, пороги исключения, имена файлов, версии программного обеспечения, версию опросника, синтаксис подсчета баллов, спецификацию регрессионной модели и процедуры, необходимые для воссоздания того же набора данных.
6. Анализ данных и обеспечение воспроизводимости результатов
- Рассчитайте описательную статистику и проведите сравнение групп
- Представьте непрерывные переменные в виде среднего значения ± стандартного отклонения, а категориальные переменные — в виде частоты и процента. Обобщите демографические характеристики, особенности использования интернета и баллы по шкалам, используя предопределенную структуру вывода.
- Указывайте размер выборки для каждого анализа. В качестве знаменателя используйте окончательную аналитическую выборку, если в таблице явно не указано иное.
- Сравните общие баллы и баллы по субшкалам DERS-16 в трех группах по степени тяжести IAT; для основных анализов используйте двустороннее тестирование с α = 0.05. При необходимости укажите стандартизированные размеры эффекта.
ПРИМЕЧАНИЕ: При сравнении групп указывайте η2 или частичную η2 для дисперсионного анализа или эквивалентный непараметрический размер эффекта, если используется непараметрический критерий. Осторожно интерпретируйте результаты сравнения подгруппы с тяжелой формой проблемного использования, если размер этой подгруппы невелик. - Рассчитайте корреляцию Пирсона между общим баллом IAT и общим баллом DERS-16, если обе переменные демонстрируют приемлемое распределение; в противном случае используйте корреляцию Спирмена в качестве анализа чувствительности. Укажите n, r или ρ, 95% доверительный интервал (если он сгенерирован статистическим ПО), значение p и интерпретацию величины эффекта.
- Постройте скорректированную регрессионную модель и архивируйте результаты
- Используйте общий балл DERS-16 в качестве зависимой переменной, а общий балл IAT — в качестве основной независимой переменной. Введите возраст, пол, использование интернета в будние дни, использование интернета в выходные дни, продолжительность сна, физическую активность и воспринимаемый академический стресс в качестве ковариат. Данная модель является предопределенной аналитической демонстрацией стандартизированного рабочего процесса.
- Перед интерпретацией скорректированной регрессионной модели оцените допущения регрессии и стабильность модели. Проверьте графики остатков в зависимости от прогнозируемых значений на линейность и гомоскедастичность, изучите график Q-Q или проведите тест на нормальность распределения остатков, а также рассчитайте факторы инфляции дисперсии (VIF) для оценки мультиколлинеарности.
- Представьте эти диагностические данные в разделе «Репрезентативные результаты» или в дополнительных результатах анализа.
- При обнаружении гетероскедастичности остатков укажите стандартные ошибки, устойчивые к гетероскедастичности, в качестве анализа чувствительности.
- При наличии влиятельных наблюдений укажите, остается ли основной коэффициент для общего балла IAT существенно неизменным после диагностики влияния. Не удаляйте влиятельные наблюдения, если не соблюдено заранее определенное правило контроля качества данных.
- Для скорректированной модели укажите нестандартизированные коэффициенты, стандартные ошибки, стандартизированные коэффициенты, значения p , R2 модели, скорректированный R2, F-статистику модели и диапазон VIF. Укажите размер выборки в заголовке или сноске таблицы.
- Если тестируются взаимодействия, эффекты подгрупп или пути медиации, определите эти анализы до сбора данных или пометьте их как исследовательские. Основной протокол не требует тестирования взаимодействий, если только различия между подгруппами не являются заранее определенной целью исследования.
- Сохраните весь статистический синтаксис, выходные таблицы, графики остатков, результаты VIF, результаты анализа надежности и созданные рисунки под именами файлов с контролем версий. Генерируйте все отчетные данные непосредственно из файла analytic_dataset_v1, а не из файлов, отредактированных вручную.
ПРИМЕЧАНИЕ: Текст протокола должен быть сосредоточен на воспроизведении рабочего процесса. Подробную репрезентативную статистику, рисунки по подгруппам, диагностику регрессии, оценку мультиколлинеарности и результаты модели представьте в разделе «Репрезентативные результаты».
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Результаты
Схема исследования и итоговое удержание для анализа
Результаты демонстрируют выполнение стандартизированного рабочего процесса опроса, а не независимую валидацию теста на интернет-зависимость или DERS-16. В течение 14-дневного окна опроса к участию были приглашены 520 студентов университета, из которых было получено 480 заполненных анкет. Скрининг проводился в заранее определенном порядке. Сначала были удалены 8 дублирующих заявок, затем 9 анкет с временем заполнения менее 180...
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Обсуждение
Основным вкладом данной статьи является стандартизированный рабочий процесс заполнения опросников, а не выявленная репрезентативная связь между интернет-зависимостью и трудностями регуляции эмоций. Практическая реализация показала, что в выборке студентов университета может быть выполнена фиксированная последовательность действий: получение электронного согласия, сбор демографических данных, анализ поведения при использовании интернета, подсчет баллов по IAT, подсчет баллов по DERS-16, сбор ковариат, последовательный скр...
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Раскрытие информации
Авторы не заявляют о наличии конфликта интересов.
Благодарности
Данная работа была поддержана проектом «Мягкой науки» провинции Хэнань на 2025 год «Исследование влияния и путей оптимизации изменений численности населения школьного возраста на высококачественное развитие частного высшего образования в провинции Хэнань» (проект № 252400410490), а также проектом Докторского исследовательского фонда Университета экономики и бизнеса города Чжэнчжоу на 2025 год «Исследование механизма формирования и механизма управления общественными настроениями в сетевом кластерном поведении студентов колледжей». Автор благодарит Университет экономики и бизнеса города Чжэнчжоу за институциональную поддержку.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Материалы
| Имя | Компания | Каталожный номер | Комментарии |
|---|---|---|---|
| Набор данных, готовый к анализу | Внутренний документ по конкретному исследованию | analytic_dataset_v1.csv и analytic_dataset_v1.xlsx | Окончательный анонимизированный набор данных, использованный для всех представляемых в отчете описательных анализов, анализа надежности, корреляционного и регрессионного анализов |
| Синтаксис анализа | Внутренний документ по конкретному исследованию | analysis_syntax_v1.R или эквивалентный файл со скриптом | Используется для воспроизведения проверки подсчета баллов, анализа надежности, описательной статистики, корреляционного анализа, регрессионного моделирования, расчета VIF и диагностического вывода |
| Формулировка пунктов для проверки внимания | Внутренний документ по конкретному исследованию | attention_check_v1.txt | Фиксированная формулировка контрольного вопроса на проверку внимания с направленным ответом, использовавшегося при проведении опроса |
| Опросник DERS-16 | Оригинальная шкала или авторизованная/адаптированная версия опросника | Краткая форма шкалы трудностей эмоциональной регуляции из 16 пунктов | Используется для оценки трудностей регуляции эмоций; подсчет баллов осуществляется в соответствии с фиксированным ключом оценки DERS-16, описанным в кодовой книге |
| Электронный информационный листок и страница согласия | Внутренний документ по конкретному исследованию | consent_form_v1.pdf или страница согласия на платформе | Используется для предоставления информации об исследовании и получения электронного информированного согласия перед предоставлением доступа к опроснику |
| Лист правил именования файлов | Внутренний документ по конкретному исследованию | соглашение_о_именовании_файлов_v1.xlsx | Используется для стандартизации наименований исходных, очищенных, аналитических файлов, журналов скрининга, кодовых книг и выходных файлов |
| Скриншоты финального опросника | Внутренний документ по конкретному исследованию | скриншоты_анкеты_v1.pdf | Используется для документирования заблокированного отображения опроса, порядка пунктов, якорей ответов и настроек обязательных пунктов |
| Интегрированная среда разработки | Постулировать | RStudio Desktop | Используется для управления скриптами, логами и воспроизводимыми рабочими процессами анализа |
| Опросник теста на интернет-зависимость | Оригинальная шкала или авторизованная/адаптированная версия опросника | Тест на интернет-зависимость из 20 пунктов | Используется для оценки симптомов интернет-зависимости и классификации уровней использования: нормальное использование, проблемное использование и выраженное проблемное использование |
| Платформа для проведения онлайн-опросов | Qualtrics | Платформа XM; институциональный или лицензионный аккаунт | Используется для создания анкеты, обеспечения обязательного заполнения пунктов, управления доступом на основе согласия, ограничения повторных отправлений (если эта функция включена) и экспорта данных ответов |
| Дополнительный статистический пакет с интерфейсом управления через меню | IBM | SPSS Statistics | Используется, когда для расчета описательной статистики, проверки надежности или регрессионного анализа требуется рабочий процесс анализа на основе графического интерфейса пользователя (GUI) |
| файл README/кодовая книга | Внутренний документ по конкретному исследованию | README_v1.txt или codebook_v1.xlsx | Используется для документирования имен переменных, правил кодирования, диапазонов баллов, правил обратного кодирования, пороговых значений исключения, имен файлов и версий программного обеспечения |
| Архивная копия только для чтения | Формат переносимых документов | PDF/A или утвержденный учреждением архивный PDF | Используется для сохранения заблокированного инструмента опроса, страницы информированного согласия и документов, поддерживающих протокол |
| Журнал регистрации скрининга | Внутренний документ по конкретному исследованию | журнал_скрининга_v1.xlsx | Используется для документирования проверки на дубликаты, проверки времени выполнения, ошибок в контрольных вопросах на внимательность, шаблонных ответов, логических несоответствий, пропусков данных, решений по результатам ручного анализа и итогового количества включенных участников |
| Программное обеспечение для работы с электронными таблицами | Microsoft | Формат книги Microsoft Excel (.xlsx) | Используется для журналов скрининга, словаря переменных, записей ручного анализа и подготовки дополнительных рабочих тетрадей |
| Среда статистических вычислений | R Foundation / CRAN | R 4.5.3 | Используется для проверки подсчета баллов, расчета описательной статистики, проверки надежности, корреляционного анализа, регрессионного анализа, вычисления VIF и диагностического вывода |
| Дополнительный файл 1 | Дополнительный файл к исследованию | Дополнительный файл 1.xlsx | Содержит материалы по рабочему процессу анкетирования, кодовую книгу, журнал скрининга, план вывода данных и материалы по рабочему процессу, готовые к анализу |
| Дополнительная таблица S1 | Дополнительная таблица к конкретному исследованию | Дополнительная таблица S1 | Содержит полный словарь переменных, сведения о наличии файлов, структуру кодирования, поля технических идентификаторов, переменные скрининга и поля отслеживания набора данных |
| Документ экспорта опроса | Qualtrics | Экспорт опроса в Word или экспорт в PDF | Используется для архивирования окончательной формулировки вопросов анкеты, порядка пунктов, настроек ветвления, настроек обязательных пунктов и кодировки ответов |
| Формат экспорта опроса | Qualtrics | Экспорт в CSV | Используется для сохранения исходных данных и экспорта данных, готовых к анализу |
Ссылки
- Moreno MA, et al. Problematic internet use among US youth: a systematic review. Arch Pediatr Adolesc Med. 2011;165:797-805.
- Ramón-Arbués E, et al. Prevalence and factors associated with problematic internet use in a population of Spanish university students. Int J Environ Res Public Health. 2021;18:7620.
- Cai Z, et al. Associations between problematic internet use and mental health outcomes of students: a meta-analytic review. Adolesc Res Rev. 2023;8:45-62.
- Gong Z, Wang L, Wang H. Perceived stress and internet addiction among Chinese college students: mediating effect of procrastination and moderating effect of flow. Front Psychol. 2021;12:632461.
- Tsai JK, et al. Relationship between difficulty in emotion regulation and internet addiction in college students: a one-year prospective study. Int J Environ Res Public Health. 2020;17:4766.
- Romero-López M, Pichardo C, De Hoces I, García-Berbén T. Problematic internet use among university students and its relationship with social skills. Brain Sci. 2021;11:1301.
- Xie X, et al. Problematic internet use was associated with psychological problems among university students during COVID-19 outbreak in China. Front Public Health. 2021;9:675380.
- Montagni I, et al. Mental health-related digital use by university students: a systematic review. Telemed J E Health. 2020;26:131-146.
- Candussi CJ, Kabir R, Sivasubramanian M. Problematic smartphone usage, prevalence and patterns among university students: a systematic review. J Affect Disord Rep. 2023;14:100643.
- Moon SJ, Hwang JS, Kim JY, Shin AL, Bae SM, Kim JW. Psychometric properties of the Internet Addiction Test: a systematic review and meta-analysis. Cyberpsychol Behav Soc Netw. 2018;21:473-484.
- Jelenchick LA, Becker T, Moreno MA. Assessing the psychometric properties of the Internet addiction test in US college students. Psychiatry Res. 2012;196:296-301.
- Tafur-Mendoza AA, Acosta-Prado JC, Zárate-Torres RA, Ramírez-Ospina DE. Assessing the psychometric properties of the Internet addiction test in Peruvian university students. Int J Environ Res Public Health. 2020;17:5782.
- Fernández-Villa T, Molina AJ, García-Martín M, Llorca J, Delgado-Rodríguez M, Martín V. Validation and psychometric analysis of the Internet addiction test in Spanish among college students. BMC Public Health. 2015;15:953.
- World Medical Association. World Medical Association Declaration of Helsinki: ethical principles for medical research involving human subjects. JAMA. 2013;310:2191-2194.
- Wei Z, Hassan NC, Hassan SA, Ismail N, Gu X, Dong J. Psychometric validation of Young’s Internet addiction test among Chinese undergraduate students. PLoS One. 2025;20:e0320641.
- Bjureberg J, et al. Development and validation of a brief version of the Difficulties in emotion regulation scale : the DERS-16. J Psychopathol Behav Assess. 2016;38:284-296.
- Muszyński M. Attention checks and how to use them: review and practical recommendations. ASK: Research and Methods. 2023;32:3-38.
- Broman KW, Woo KH. Data organization in spreadsheets. Am Stat. 2018;72:2-10.
- Leiner DJ. Too fast, too straight, too weird: non-reactive indicators for meaningless data in internet surveys. Surv Res Methods. 2019;13:229-248.
- Taber KS. The use of Cronbach’s alpha when developing and reporting research instruments in science education. Res Sci Educ. 2018;48:1273-1296.
- Gioia F, Rega V, Boursier V. Problematic Internet use and emotional dysregulation among young people: a literature review. Clin Neuropsychiatry. 2021;18:41-54.
- Chen M, Zhang X. Factors influencing internet addiction among university students: the mediating roles of self-control and anxiety. Acta Psychol (Amst). 2024;250:104535.
- Akbari M, Seydavi M, Sheikhi S, Spada MM. Problematic smartphone use and sleep disturbance: the roles of metacognitions, desire thinking, and emotion regulation. Front Psychiatry. 2023;14:1137533.
- Wang S, Cheng Y, Yang Y, Lu B. The impact of physical activity on internet addiction among college students: the chain mediation role of rumination and mindfulness. BMC Public Health. 2025;25:3643.
- Struminskaya B, Sakshaug JW. Ethical considerations for augmenting surveys with auxiliary data sources. Public Opin Q. 2023;87:619-633.
- Yin J, et al. Associations between both smartphone addiction and objectively measured smartphone use and sleep quality and duration among university students: a cross-sectional study. JMIR Ment Health. 2025;12:e77796.
- Hainagiu SM, Neagu SN. Caught in the Web—emotional regulation difficulties and internet addiction among Romanian medical and technical university students: a pilot cross-sectional study. Healthcare (Basel). 2025;13:2528.
- Guo C, Chen M, Ji X, Li J, Ma Y, Zang S. Association between internet addiction and sleep quality in medical students: a longitudinal study. Front Psychol. 2025;16:1517590.
- Barker M, Chue Hong NP, Katz DS, Lamprecht AL, Martinez-Ortiz C, Psomopoulos F, et al. Introducing the FAIR Principles for research software. Sci Data. 2022;9:622.
- Nosek BA, Alter G, Banks GC, Borsboom D, Bowman SD, Breckler SJ, et al. Promoting an open research culture. Science. 2015;348:1422-1425.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.