В данном исследовании представлен воспроизводимый биоинформатический конвейер, объединяющий транскриптомику, машинное обучение и анализ иммунной инфильтрации для выявления потенциальных диагностических биомаркеров и регуляторных сетей при хронической обструктивной болезни легких (ХОБЛ).
Исследовательская статья
UPP1 как диагностический биомаркер: данные интегративного биоинформатического анализа и анализа иммунной инфильтрации при ХОБЛ
* These authors contributed equally
В этой статье
Краткое содержание
Аннотация
ХОБЛ представляет собой прогрессирующее респираторное заболевание, характеризующееся стойким ограничением воздушного потока и хроническим воспалением, однако роль модификации РНК N4-ацетилцитидина (ac4C) в его патогенезе остается в значительной степени неизученной. Целью данного исследования был систематический скрининг генов, связанных с ac4C (ac4C-RG), на основе опубликованной базы данных и исследование их регуляторных сетей при ХОБЛ для идентификации потенциальных биомаркеров для дальнейших механистических исследований без предположения о наличии прямой регуляторной связи между каким-либо конкретным геном и модификацией ac4C. Дифференциально экспрессируемые гены (DEG) были определены на основе транскриптомных профилей, а для выявления ключевых модулей коэкспрессии применялся анализ сетей коэкспрессии генов с использованием весовых коэффициентов (WGCNA). Был проведен перекрестный анализ DEG, значимых модулей и ac4C-RG. Скрининг ключевых генов осуществлялся с помощью регрессии LASSO, алгоритмов XGBoost и случайного леса (random forest), после чего была построена диагностическая модель на основе логистической регрессии. Эффективность модели оценивалась с помощью анализа кривой рабочей характеристики приемника (ROC-кривой), площади под кривой (AUC) с 95% доверительными интервалами, анализа калибровочной кривой и анализа кривой принятия решений (DCA). Всего было выявлено 160 перекрывающихся генов, и шесть центральных генов (PTRF, PRKCDBP, UPP1, TOR3A, FAM168B и B4GALT2) были последовательно выбраны всеми тремя алгоритмами машинного обучения. Диагностическая модель продемонстрировала хорошие дискриминационные показатели: AUC составили 0,766, 0,759 и 0,723 в обучающей, внутренней тестовой и внешней валидационной выборках соответственно. Анализ регуляторных сетей выявил потенциальные оси ceРНК и взаимодействия с транскрипционными факторами, а профилирование иммунной инфильтрации показало значимые корреляции между ключевыми генами и множеством подмножеств иммунных клеток. Анализ взаимодействия лекарственных средств с генами и молекулярный докинг указали на то, что фторурацил, капецитабин и 5-бензилацилуридин могут обладать благоприятной прогнозируемой аффинностью связывания с UPP1. В заключение, PTRF, PRKCDBP, UPP1, TOR3A, FAM168B и B4GALT2 были определены как потенциальные связанные с ac4C биомаркеры при ХОБЛ, возможно, участвующие в иммунной и метаболической регуляции, что создает основу для будущих функциональных исследований и терапевтического поиска.
Введение
ХОБЛ представляет собой хроническое гетерогенное респираторное заболевание, характеризующееся прогрессирующим ограничением воздушного потока, возникающим вследствие аномалий структур альвеол и дыхательных путей1,2. Дисбаланс протеаз-антипротеаз, окислительный стресс, хроническое воспаление и клеточное старение составляют основные патофизиологические механизмы ХОБЛ, приводя к структурному разрушению и функциональному нарушению легочной ткани3,4. Кроме того, на развитие ХОБЛ влияет множество факторов риска, включая длительное курение, загрязнение окружающей среды, профессиональные вредности, респираторные инфекции и генетическую предрасположенность5,6. ХОБЛ накладывает значительное бремя на мировую экономику; по прогнозам, в период с 2020 по 2050 год ежегодные потери составят 0,111% мирового ВВП7. Несмотря на то, что современные терапевтические стратегии, такие как применение бронходилататоров, ингаляционных кортикостероидов, pulmonary rehabilitation и длительная кислородотерапия, позволяют облегчить симптомы, остановить прогрессирование заболевания по-прежнему сложно. Из-за выраженной клинической гетерогенности исходы заболевания у пациентов существенно различаются8. Следовательно, существует острая необходимость в новых диагностических биомаркерах и прогностических индикаторах для оптимизации ведения пациентов с ХОБЛ и повышения выживаемости.
Модификация РНК представляет собой химическое изменение молекул РНК, которое может влиять на структуру и функцию РНК для регуляции экспрессии генов9,10. К распространенным модификациям РНК относятся N6-метиладенозин (m6A), псевдоуридин (Ψ), 5-метилцитозин (m5C) и ac4C11. Модификация ac4C играет ключевую роль в поддержании стабильности мРНК и стимуляции трансляции мРНК12,13. NAT10 является единственным известным эукариотическим ферментом, катализирующим модификацию ac4C, и его активность необходима для формирования этой модификации14. Исследования показали сильную корреляцию между окислительным стрессом, клеточным старением, воспалением и модификацией ac4C. Например, Т-лимфоциты CD4+ в тканях толстой кишки лиц с воспалительными заболеваниями кишечника (ВЗК) характеризуются заметно повышенными уровнями NAT1015. NAT10 усиливает ацетилирование ac4C хемокинов CCL2 и CXCL1, тем самым способствуя инфильтрации макрофагов и нейтрофилов и усугубляя воспалительное повреждение16. Клеточный ответ на окислительный стресс может быть связан с модификацией ac4C, о чем свидетельствует выраженное повышение уровней ac4C при окислительном стрессе. Кроме того, NAT10 способствует развитию индуцированного PM2.5 легочного фиброза, стабилизируя мРНК TGFB1 посредством модификации ac4C, что запускает эпителиально-мезенхимальный переход17. Однако роль модификации ac4C при ХОБЛ остается в значительной степени неизученной, что подчеркивает необходимость дальнейших исследований в этой области.
В данном исследовании использовалась база данных GEO для выявления дифференциально экспрессируемых генов (DEG) у пациентов с ХОБЛ и в контрольной группе. Затем опубликованный список ac4C-RGs, составленный на основе мультиомиксных данных18, был сопоставлен с DEG для поиска перекрывающихся кандидатов. Поскольку известно, что модификация ac4C влияет на воспаление и окислительный стресс — ключевые процессы при ХОБЛ, — мы предположили, что гены, связанные с регуляторной сетью ac4C, могут быть дисрегулированы при ХОБЛ. При этом перекрывающиеся гены рассматривались не как прямые субстраты NAT10 или гены, напрямую регулируемые ac4C, а как кандидаты, связанные с сетью ac4C. Скрининг ключевых генов проводился с использованием нескольких алгоритмов машинного обучения с последующим построением и валидацией диагностической модели. Впоследствии были определены соответствующие пути, участвующие в патогенезе ХОБЛ, и предсказаны потенциальные таргетные препараты. Наконец, были проведены анализы RT-qPCR для подтверждения уровней экспрессии ключевых генов, что позволило получить предварительные данные о патофизиологии ХОБЛ и возможных направлениях терапевтического поиска.
Протокол
Заявление институционального обзора
Данное исследование было проведено в соответствии с Хельсинкской декларацией. Протокол был одобрен Комитетом по этике больницы традиционной китайской медицины района Луху города Шэньчжэнь (номер одобрения 2024-LHQZYYYXLL-KY-039), и от всех участников было получено письменное информированное согласие перед включением в исследование. Подробная информация об инструментах и материалах, использованных в данном протоколе, представлена в Таблице материалов.
Источник и обработка данных
Наборы данных об экспрессии генов, связанных с ХОБЛ, были получены из базы данных Gene Expression Omnibus (GEO). Набор данных GSE54837 использовался в качестве набора данных транскриптома, а набор данных GSE112811 служил валидационным набором (Таблица 1). Список ac4C-RGs был собран на основе литературных данных18. Дифференциально экспрессируемые гены (ДЭГ) между группами с ХОБЛ и контрольной группой были определены с помощью пакета лимма (limma) для языка R. ДЭГ считались статистически значимыми при |log2FC| > 0 и p < 0,05. Для визуализации общего распределения изменений экспрессии генов были построены графики «вулкан» (volcano plots).
Построение WGCNA
Для выявления модулей, связанных с ХОБЛ, был проведен анализ WGCNA набора данных GSE54837 с использованием языка R. Перед построением сети были выявлены и удалены образцы-выбросы с помощью иерархического кластерного анализа с использованием функции hclust с методом среднего сцепления (average linkage) и метрикой евклидова расстояния. Для достижения индекса соответствия безмасштабной топологии R2 ≥ 0.85 при балансе между безмасштабной топологией и средней связностью была выбрана оптимальная мощность мягкого порога (β = 10). Была построена матрица смежности, которая затем была преобразована в матрицу топологического перекрытия (TOM). Генетические модули были определены с помощью алгоритма динамического разрезания дерева (deepSplit = 2, minClusterSize = 50). Модули с корреляцией собственных генов > 0.75 впоследствии были объединены с помощью функции mergeCloseModules. Затем собственные гены модулей были сопоставлены с клиническими признаками (наличие ХОБЛ, возраст, пол и статус курения) с использованием коэффициентов корреляции Пирсона для выявления модулей, ассоциированных с ХОБЛ, для последующего анализа.
Скрининг, анализ обогащения и анализ сети PPI для перекрывающихся генов
Для выявления общих генов среди дифференциально экспрессируемых генов (DEGs), генов модуля MEsalmon и ac4C-RGs с помощью пакета ggvenn для языка R была построена диаграмма Венна. Функциональный анализ обогащения общих генов проводили с использованием баз данных Gene Ontology (GO) и Kyoto Encyclopedia of Genes and Genomes (KEGG) с помощью пакета clusterProfiler для R. Информацию о белок-белковых взаимодействиях (PPI) получали из базы данных STRING (https://string-db.org/) для анализа взаимодействий на уровне белков между общими генами. Для визуализации полученной сети PPI использовали программное обеспечение Cytoscape.
Идентификация ключевых генов с помощью машинного обучения
Были применены три метода машинного обучения: регрессия методом наименьших абсолютных отклонений (LASSO), экстремальный градиентный бустинг (XGBoost) и случайный лес (RF). Регрессия LASSO была реализована с использованием пакета glmnet с 10-кратной кросс-валидацией для определения оптимального параметра штрафа λ. Параметр type.measure был установлен на "deviance", а параметр family — на "binomial". Оптимальное значение λ было выбрано по критерию λmin, который минимизирует отклонение при кросс-валидации, что позволило выделить 17 генов. XGBoost выполнялся с использованием пакета xgboost со следующими гиперпараметрами: nrounds = 100, max_depth = 6, eta = 0.3, subsample = 0.8, colsample_bytree = 0.8 и eval_metric = "logloss". Важность признаков ранжировалась по метрике gain, и были отобраны 30 наиболее значимых генов. Случайный лес был реализован с помощью пакета randomForest с ntree = 200. Важность признаков ранжировалась по среднему снижению индекса Джини, и были выбраны 30 наиболее значимых генов. Гены, отобранные тремя методами машинного обучения, были подвергнуты пересечению для выявления ключевых генов для последующего анализа.
Построение и оценка модели логистической регрессии для прогнозирования риска
Набор данных GSE54837 был случайным образом разделен на обучающую выборку (70%) и тестовую выборку (30%). На основе обучающей выборки была построена модель логистической регрессии с использованием функции glm из пакета MASS, где в качестве входных признаков использовались уровни экспрессии ключевых генов. Эффективность модели оценивали с помощью ROC-кривых, построенных с помощью пакета pROC. 95% доверительные интервалы для AUC были рассчитаны с помощью 2 000 бутстрэп-репликаций. Калибровку модели оценивали с помощью калибровочных кривых, построенных на основе 1 000 бутстрэп-выборок (пакет rms). Для оценки чистой клинической выгоды при различных пороговых значениях вероятности был проведен анализ кривой принятия решений (DCA) с использованием пакета dca. Для облегчения индивидуальной оценки риска с помощью функции nomogram из пакета rms была построена номограмма.
Уравнение регрессии имело следующий вид:
logit(P) = 0.5823 + 0.6010 × UPP1 - 0.6563 × PTRF + 0.3853 × B4GALT2 - 0.3972 × FAM168B + 0.1848 × PRKCDBP - 0.4787 × TOR3A. (1)
Здесь P представляет собой прогнозируемую вероятность ХОБЛ, а каждый коэффициент отражает вклад соответствующего значения экспрессии гена в логарифмический шанс развития ХОБЛ.
Анализ экспрессии, сеть GeneMANIA и молекулярная регуляторная сеть
Уровни экспрессии генов в группах с ХОБЛ и контрольной группе в наборе данных GSE54837 сравнивали с помощью критерия суммы рангов Вилкоксона. Для визуализации распределения уровней экспрессии с помощью пакета ggplot2 строили диаграммы размаха (box plots), на которых отображали медиану, межквартильный размах (IQR) и отдельные точки данных. Для построения генных сетей и прогнозирования функциональных взаимодействий использовали GeneMANIA. Поиск проводили с параметрами по умолчанию: вид = Homo sapiens, максимальное число связанных генов = 20. Полученную сеть загружали и визуализировали, при этом цвета ребер указывали на типы взаимодействий. Для изучения механизмов посттранскрипционной регуляции была построена сеть конкурентных эндогенных РНК (ceRNA). МикроРНК (miRNA), нацеленные на шесть ключевых генов, предсказывали с использованием двух независимых баз данных: DIANA-microT (score ≥ 0.8) и miRanda (score ≥ 140, энергия ≤ −20 kcal/mol). Пересечение микроРНК, выявленных обеими базами данных, использовали для построения пар miRNA-mRNA. Впоследствии с помощью базы данных StarBase предсказывали длинные некодирующие РНК (lncRNA), нацеленные на эти микроРНК. Регуляторная сеть lncRNA-miRNA-mRNA была построена и визуализирована с помощью Cytoscape. Транскрипционные регуляторные связи предсказывали с помощью ChIP-X Enrichment Analysis Version 3 (ChEA3). Для каждого ключевого гена с предсказанными TF выбирали 10 транскрипционных факторов с наивысшими показателями обогащения. В Cytoscape была построена регуляторная сеть TF-мишень.
Анализ обогащения наборов генов и оценка инфильтрации иммунных клеток
Анализ обогащения наборов генов (GSEA) был выполнен с помощью пакета clusterProfiler для изучения биологических функций каждого ключевого гена. Для каждого ключевого гена образцы были разделены на группы с высокой и низкой экспрессией на основе медианного значения. Анализ дифференциальной экспрессии между двумя группами проводили с помощью limma, и полученный список генов был ранжирован по знаковому log₂ fold-change. GSEA проводили с использованием функции gseGO для терминов биологических процессов GO и функции gseKEGG для путей KEGG со следующими параметрами: minGSSize = 10, maxGSSize = 500, pvalueCutoff = 0.05 и nPerm = 1,000. Относительная численность 28 типов иммунных клеток оценивали с помощью анализа обогащения наборов генов для одного образца (ssGSEA), реализованного в пакете GSVA. Курируемая матрица сигнатур наборов генов, включающая маркерные гены для 28 типов иммунных клеток, была получена из предыдущих публикаций19. Для каждого образца применяли функцию gsva с параметрами method = "ssgsea", ssgsea.norm = TRUE и kcdf = "Gaussian". Коэффициенты корреляции Спирмена между показателями обогащения ssGSEA и уровнями экспрессии шести ключевых генов рассчитывали с помощью функции cor.test. Значения p были скорректированы с учетом множественного тестирования по методу Бенджамини-Хохберга. Матрица корреляции была визуализирована в виде тепловой карты с помощью пакета pheatmap.
Прогнозирование лекарственных препаратов, молекулярный докинг и анализ ассоциации с заболеваниями
С помощью базы данных DrugBank были определены потенциальные терапевтические соединения, воздействующие на ключевые гены. В программе Cytoscape была построена сеть взаимодействий «ключевой ген — таргетный препарат» для визуализации прогнозируемых взаимодействий между лекарственными средствами и генами. Для оценки аффинности связывания был проведен молекулярный докинг с использованием платформы CB-Dock2. Трехмерная структура белка UPP1 человека была получена из Protein Data Bank (PDB ID: 7B8T). Молекулярные структуры препаратов (в формате SMILES) были взяты из PubChem. Докинг выполнялся с помощью движка AutoDock Vina, а результаты ранжировались по свободной энергии связывания (ΔG, в kcal/mol). Комплексы докинга были визуализированы с помощью PyMOL. Связи между ключевыми генами и заболеваниями человека, связанными с воздействием факторов окружающей среды, исследовались с использованием базы данных Comparative Toxicogenomics Database (CTD). По каждому гену был проведен отдельный поиск, после чего десять наиболее сильно связанных с ними заболеваний были извлечены и визуализированы с помощью лепестковых диаграмм.
Протокол ОТ-кПЦР
Образцы периферической венозной крови были собраны у восьми пациентов с ХОБЛ и восьми здоровых добровольцев (контрольная группа) в Шэньчжэньской больнице традиционной китайской медицины района Луоху. Диагноз ХОБЛ ставили в соответствии с критериями Глобальной инициативы по хронической обструктивной болезни легких (GOLD), определяемыми как ОФВ1/ФЖЕЛ после применения бронхолитиков < 0,70. Контрольная группа состояла из здоровых добровольцев соответствующего пола и возраста без заболеваний дыхательных путей в анамнезе и с нормальными результатами тестов функции легких (ОФВ1% от должного ≥ 80% и ОФВ1/ФЖЕЛ ≥ 0,70). Исходные данные пациентов представлены в Таблице 2. Общую РНК экстрагировали из образцов крови пациентов с ХОБЛ с помощью набора для выделения РНК из крови. Для синтеза кДНК 500 ng общей РНК подвергли обратной транскрипции с использованием набора для синтеза кДНК с удалением геномной ДНК согласно прилагаемому протоколу. Полученную кДНК развели до концентрации 150 ng/μL.
RT-qPCR проводили с использованием мастер-микса для qPCR на основе SYBR Green на системе ПЦР в реальном времени. Каждая реакция объемом 10 μL содержала 5 μL 2x мастер-микса SYBR Green, по 0,5 μL прямого и обратного праймеров (10 μM), 1 μL разведенной кДНК (15 ng/μL) и 3 μL воды, свободной от нуклеаз. Условия циклирования включали начальную денатурацию при 95 °C в течение 5 min, затем 40 циклов: 95 °C в течение 10 s и 60 °C в течение 30 s, с последующим анализом кривых плавления от 60 °C до 95 °C для проверки специфичности амплификации. Все реакции проводили в трех технических повторностях. В качестве внутреннего референсного гена использовали β-actin. Эффективность праймеров для каждого целевого гена была подтверждена с использованием серий разведений по стандартной кривой и находилась в диапазоне от 90% до 110%. Уровни экспрессии генов нормировали по β-actin, а относительную экспрессию рассчитывали методом 2-ΔΔCt. Статистическое сравнение групп с ХОБЛ и контрольной группы проводили с помощью U-критерия Манна-Уитни.
Статистический анализ
Визуализация сетей была создана с помощью Cytoscape, а статистический анализ выполнялся с использованием программного обеспечения R. Если не указано иное, для данных с ненормальным распределением использовался U-критерий Манна-Уитни, а для данных с нормальным распределением — t-критерий Стьюдента для сравнения двух групп. Значение p < 0,05 считалось статистически значимым.
Результаты
Идентификация перекрывающихся генов, анализ обогащения и построение сети белок-белковых взаимодействий (PPI)
На основе набора данных GSE54837 было выявлено 3 371 ДЭГ, включая 1 675 гены с повышенной экспрессией и 1 696 гены с пониженной экспрессией. Топ-10 генов с наиболее значимым повышением и понижением экспрессии показаны на рисунке 1A. Была выполнена иерархическая кластеризация данных GSE54837 (дополнительный рисунок 1A), и для обеспечения безмасштабной топологии сети была применена степень мягкого порога 10 (рисунок 1B). Модули коэкспрессии генов были построены с использованием метода динамического отсечения дерева с минимальным размером модуля 50 генов, и каждому модулю был присвоен отдельный цвет (дополнительный рисунок 1B). Модули с корреляцией собственных генов > 0,75 были впоследствии объединены (дополнительный рисунок 1C, рисунок 1C), в результате чего было получено 14 отдельных модулей. На основании анализа корреляции Пирсона между собственными генами модулей и клиническими характеристиками модуль MEsalmon (состоящий из 5 226 генов) продемонстрировал наиболее значимую положительную корреляцию с ХОБЛ (r = 0,35, p = 7 x 10⁻8, рисунок 1D). Анализ диаграммы Венна выявил 160 перекрывающихся генов среди 3 371 ДЭГ, 5 226 генов модуля MEsalmon и 2 118 ac4C-RG (рисунок 1E). Функциональный анализ обогащения этих 160 генов показал, что значимые термины GO включали связывание одноцепочечной РНК, регуляцию метаболических процессов мРНК и сигнальный путь RIG-I (рисунок 1F). Кроме того, анализ KEGG продемонстрировал, что эти гены были преимущественно обогащены в процессах Fc gamma R-опосредованного фагоцитоза, пути контроля мРНК и фокальной адгезии (рисунок 1G). Сеть PPI перекрывающихся генов содержала 118 узлов и 196 ребер (рисунок 1H).
Идентификация шести ключевых генов при ХОБЛ
Для дальнейшего выявления потенциальных ключевых генов среди 160 перекрывающихся кандидатов были применены три алгоритма машинного обучения. Сначала была использована LASSO-регрессия, при этом для определения оптимального параметра штрафа (λ) ≈ 0.091 применялась кросс-валидация (Рисунок 2A). График профиля коэффициентов показал, что при оптимальном значении λ было сохранено 17 генов (Рисунок 2B). Анализ XGBoost позволил выявить 30 генов с наибольшим приростом (gain), среди которых PTRF, WBP11 и LDOC1L продемонстрировали высокую прогностическую ценность (Рисунок 2C). Алгоритм RF аналогичным образом ранжировал 30 лучших генов в соответствии с показателями важности Джини (Gini importance), при этом PTRF, RFX5 и PRKCDBP оказались одними из наиболее прогностически значимых (Рисунок 2D). Анализ пересечения генов, отобранных тремя методами, позволил выявить шесть ключевых перекрывающихся генов: PTRF, PRKCDBP, UPP1, TOR3A, FAM168B и B4GALT2 (Рисунок 2E).
Построение диагностической модели и анализ экспрессии ключевых генов
Используя 70% набора данных GSE54837 в качестве обучающей выборки, была построена модель логистической регрессии, включающая шесть ключевых генов. Анализ ROC-кривых показал умеренную диагностическую эффективность: значения AUC составили 0,766 (95% ДИ: 0,691–0,8417), 0,759 (95% ДИ: 0,6368–0,8817) и 0,723 (95% ДИ: 0,6085–0,8596) для обучающей, внутренней тестовой и внешней валидационной выборок соответственно (Рисунок 3A–C). Калибровочный анализ подтвердил высокую надежность, а DCA продемонстрировал выраженную чистую клиническую пользу в широком диапазоне пороговых вероятностей как в обучающей выборке (Рисунок 3D–E), так и в валидационных выборках (Рисунок 3F–G). Для визуализации вклада каждого гена и облегчения индивидуальной оценки риска была построена номограмма (Рисунок 3H). Анализ экспрессии показал, что B4GALT2, PRKCDBP и UPP1 были значительно повышены в образцах с ХОБЛ, тогда как экспрессия FAM168B, PTRF и TOR3A была снижена (Рисунок 3I).
Регуляторная сеть и функциональный анализ ключевых генов при ХОБЛ
С помощью анализа GeneMANIA была построена сеть функциональных взаимодействий, включающая 20 наиболее тесно связанных с выявленными хаб-генами генов (Рисунок 4A). Большинство связей пришлось на физические взаимодействия, за которыми следуют корреляции коэкспрессии и общие белковые домены. Функциональная аннотация указала на значительное обогащение таких процессов, как катаболический процесс малых молекул, содержащих нуклеиновые основания, катаболический процесс нуклеозидов и рафты плазматической мембраны. Посттранскрипционная регуляция исследовалась путем пересечения прогнозов miRNA из баз данных DIANA-microT и miRanda, что позволило выявить восемь перекрывающихся miRNA (Рисунок 4B). Впоследствии была построена регуляторная ось lncRNA-miRNA-mRNA. Согласно диаграмме Санки, две из выявленных miRNA, обе связанные с регуляцией FAM168B, по прогнозам, являются мишенями семи lncRNA; для остальных пяти хаб-генов подобных регуляторных взаимодействий выявлено не было (Рисунок 4C). Транскрипционная регуляция дополнительно изучалась с помощью платформы ChEA3, которая предсказала вышестоящие факторы транскрипции (TF) для B4GALT2, UPP1, FAM168B и TOR3A. Для построения регуляторной сети TF-мишень были выбраны десять наиболее значимых TF для каждого гена (Рисунок 4D). Для исследования биологических функций шести ключевых генов был проведен анализ GSEA. UPP1 был значительно обогащен в таких биологических процессах, как метаболический процесс диацилглицерина и биосинтетический процесс пуриновых нуклеозидтрифосфатов, а также в путях, включающих протеасому и метаболизм ксенобиотиков цитохромом P450 (Рисунок 4E–F). Результаты обогащения для остальных пяти ключевых генов представлены на Дополнительном рисунке 2A–J.
Иммунная инфильтрация UPP1 и прогнозирование мишеней лекарственных препаратов при ХОБЛ
С помощью алгоритма ssGSEA были оценены уровни инфильтрации 28 типов иммунных клеток в контрольной группе и группе с ХОБЛ. У пациентов с ХОБЛ наблюдались значимо более высокие показатели обогащения B-клеток памяти, миелоидных супрессорных клеток и активированных дендритных клеток. Напротив, Т-хелперы 1 типа, активированные B-клетки и незрелые B-клетки продемонстрировали значимо более низкие показатели обогащения (Рисунок 5A). Следует отметить, что ssGSEA предоставляет относительные оценки обогащения иммунных клеток на основе транскриптомных данных, а не прямые измерения пропорций иммунных клеток. Корреляционный анализ показал, что шесть ключевых генов демонстрировали различные паттерны связи с подмножествами иммунных клеток. В частности, UPP1, PRKCDBP и B4GALT2 положительно коррелировали с уровнями инфильтрации B-клеток памяти, активированных дендритных клеток и миелоидных супрессорных клеток (Spearman ρ > 0.4, p < 0.05), в то время как PTRF, TOR3A и FAM168B показали отрицательную корреляцию с Т-хелперами 1 типа и активированными B-клетками (Spearman ρ < −0.3, p < 0.05). Полная корреляционная матрица представлена на тепловой карте (Рисунок 5B). Анализ предсказания лекарственных взаимодействий определил UPP1 как единственный ген из шести кандидатов с предсказанными взаимодействиями с малыми молекулами. В базе данных были выявлены три соединения, включая фторурацил, капецитабин и 5-бензилацилуридин, в качестве потенциальных соединений, взаимодействующих с UPP1 (Рисунок 5C). Эти соединения в основном используются в онкологии или в экспериментальных целях, и их значимость при ХОБЛ требует дальнейшего изучения. Расчеты свободной энергии связывания показали, что 5-бензилацилуридин обладает наивысшим сродством к связыванию, что указывает на относительно более высокую предсказанную аффинность связывания (Таблица 3). Визуализация молекулярного докинга для всех трех соединений указала на благоприятные предсказанные конформации связывания с UPP1, что согласуется с результатами компьютерного докинга, а не с экспериментальной валидацией (Рисунок 5D–F). Кроме того, анализ CTD показал, что все шесть ключевых генов тесно связаны с различными фенотипами заболеваний, включая отсроченные эффекты пренатального воздействия, потерю веса, гепатомегалию и воспаление (Рисунок 5G–L).
Валидация ключевых диагностических генов в клинических образцах с помощью RT-qPCR
Для подтверждения уровней экспрессии ключевых генов были собраны образцы крови восьми пациентов с ХОБЛ и восьми лиц из контрольной группы; данный анализ считался предварительной валидацией в связи с ограниченным размером выборки. Как показано на Рисунке 6A–F, в образцах с ХОБЛ наблюдалось значимое снижение экспрессии PTRF, TOR3A и FAM168B, в то время как экспрессия PRKCDBP и UPP1 была значительно повышена, что согласуется с тенденциями, выявленными в ходе биоинформатического анализа. Напротив, значимых различий в экспрессии B4GALT2 между двумя группами обнаружено не было. Это расхождение может быть связано с ограниченным размером выборки или различиями в типах образцов между наборами данных и клиническими специменами.
ЗАЯВЛЕНИЕ О ДОСТУПНОСТИ ДАННЫХ:
Все данные секвенирования РНК были получены из базы данных Gene Expression Omnibus (GEO, https://www.ncbi.nlm.nih.gov), при этом GSE54837 был выбран в качестве обучающей выборки, а GSE112811 — в качестве валидационной выборки. Код, использованный в данном анализе, можно получить по адресу https://doi.org/10.5281/zenodo.21771476.
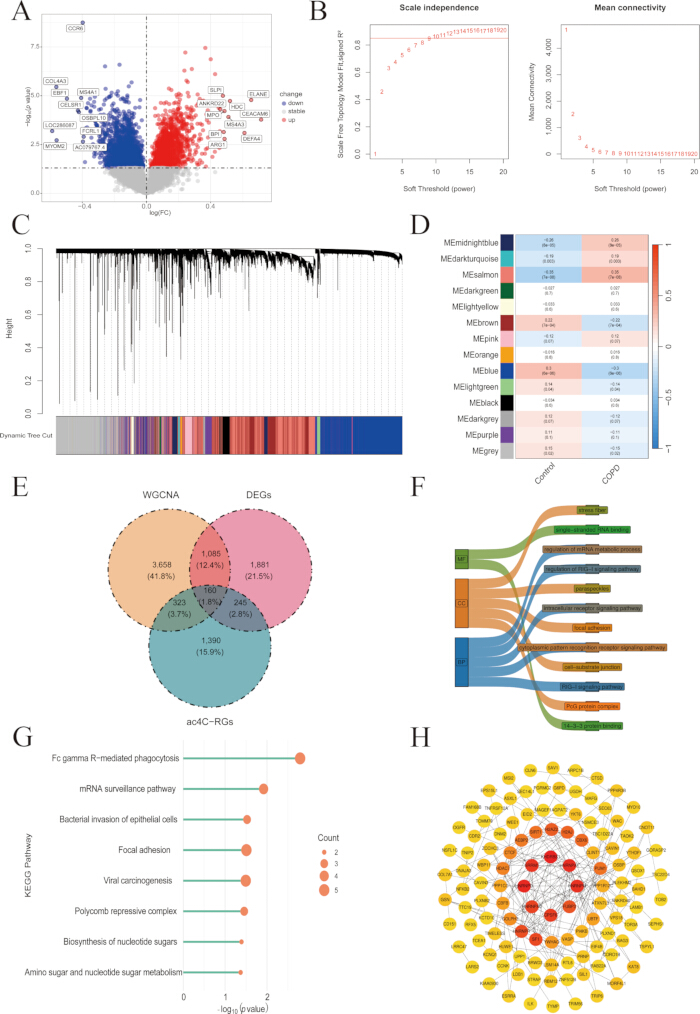
Рисунок 1: Идентификация перекрывающихся генов, анализ обогащения и построение сети PPI. (A) График вулканов (volcano plot) дифференциально экспрессируемых генов (DEGs) в наборе данных GSE54837. (B) Скрининг мягкого порога. (C) Дендрограмма кластеризации модулей (после слияния). (D) Тепловая карта корреляции между модулями и признаками. (E) Диаграмма Венна для идентификации перекрывающихся генов. (F) Диаграмма Mulberry анализа обогащения GO, показывающая основные результаты обогащения пересекающихся генов в категориях MF, CC и BP. (G) Леденцовая диаграмма (lollipop diagram) анализа обогащения сигнальных путей KEGG, где размер пузырька представляет количество обогащенных генов. (H) Сеть PPI перекрывающихся генов; узлы представляют белки, а ребра — белок-белковые взаимодействия. Сокращения: DEGs = дифференциально экспрессируемые гены; PPI = белок-белковое взаимодействие; GO = Gene Ontology; MF = молекулярная функция; CC = клеточный компонент; BP = биологический процесс; KEGG = Киотская энциклопедия генов и геномов; ac4C-RGs = гены, связанные с N4-ацетилцитидином. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
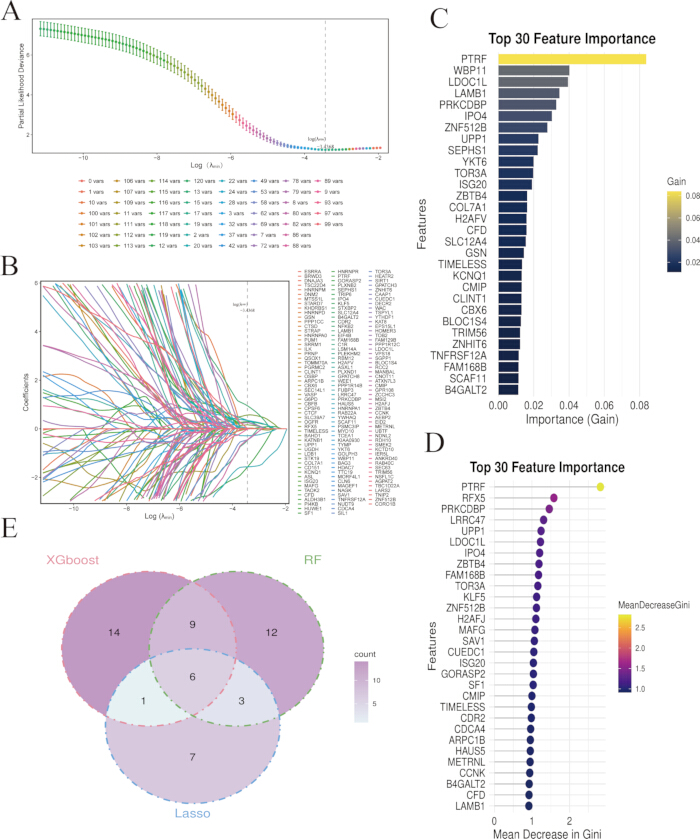
Рисунок 2: Идентификация шести ключевых генов при ХОБЛ. (A) Кривая кросс-валидации LASSO. (B) Диаграмма траекторий коэффициентов регрессии LASSO. С увеличением λ коэффициенты неважных генов стремятся к 0. (C) Рейтинг важности признаков XGBoost. Ось X представляет значение прироста (gain), ось Y — название гена, а глубина цвета отражает степень важности. (D) Рейтинг важности признаков RF. Ось X представляет среднее снижение индекса Джини (mean decrease in Gini). (E) Диаграмма Венна перекрывающихся генов, полученных в результате перекрестного анализа трех алгоритмов. Сокращения: LASSO = метод наименьшего абсолютного сжатия и отбора; XGBoost = экстремальный градиентный бустинг; RF = случайный лес. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
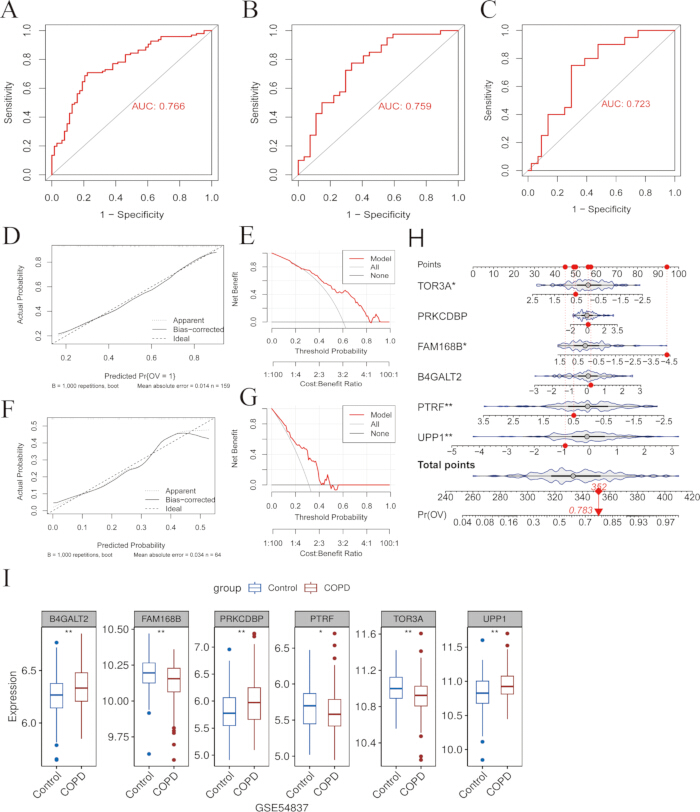
Рисунок 3: Построение диагностической модели и анализ экспрессии ключевых генов. (A) ROC-кривая обучающей выборки. (B) ROC-кривая внутренней тестовой выборки. (C) ROC-кривая внешней валидационной выборки. (D) Калибровочная кривая обучающей выборки. (E) DCA обучающей выборки. (F) Калибровочная кривая внешней валидационной выборки. (G) DCA внешней валидационной выборки. (H) Номограмма шести ключевых генов. Для прогнозирования индивидуального риска ХОБЛ каждому гену присваивается соответствующий балл. (I) Анализ экспрессии шести ключевых генов в образцах с ХОБЛ и контрольных образцах из набора данных GSE54837. Сокращения: ROC = операционная характеристика приемника; AUC = площадь под кривой; DCA = анализ кривой принятия решений; ХОБЛ = хроническая обструктивная болезнь легких. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
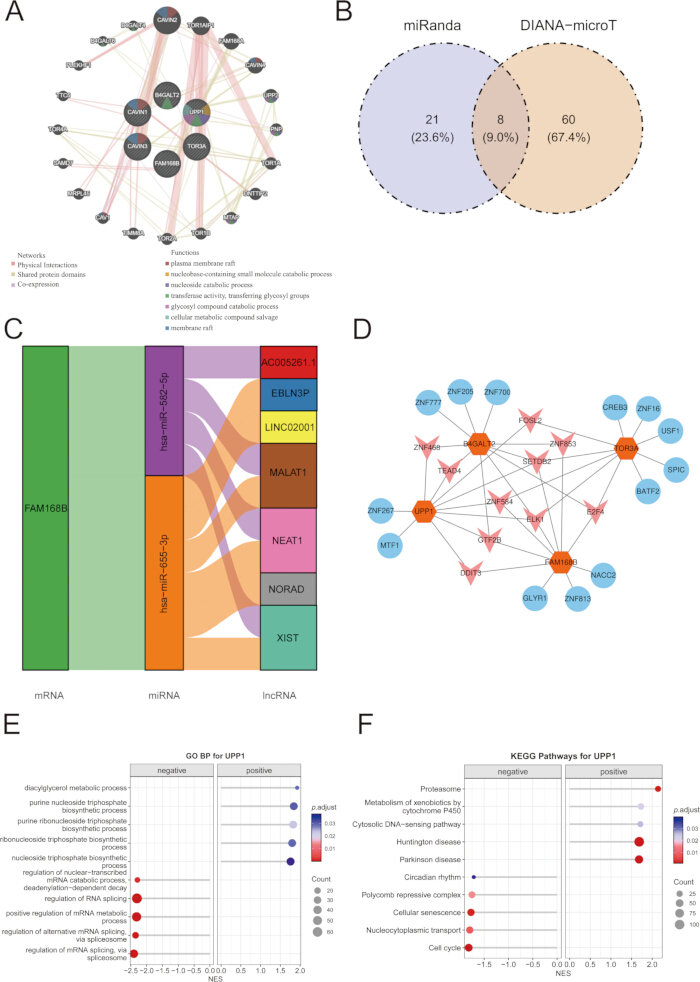
Рисунок 4: Регуляторная сеть и функциональная значимость ключевых генов при ХОБЛ. (A) Результаты анализа 6 ключевых генов в GeneMANIA. Цвет линий указывает на корреляцию между генами, а цвет узлов — на различные функциональные категории. (B) Диаграмма Венна перекрестного анализа баз данных DIANA-microT и miRanda. (C) Диаграмма Санки регуляторной сети ceRNA. (D) Потенциальная регуляторная сеть факторов транскрипции. Синие узлы представляют факторы транскрипции, оранжевые узлы — гены-мишени. (E) Анализ обогащения GSEA для одного гена UPP1, включая GO. (F) Анализ обогащения GSEA для одного гена UPP1, включая KEGG. Сокращения: GO = Gene Ontology; KEGG = Kyoto Encyclopedia of Genes and Genomes. Пожалуйста, нажмите здесь, чтобы просмотреть этот рисунок в большем размере.
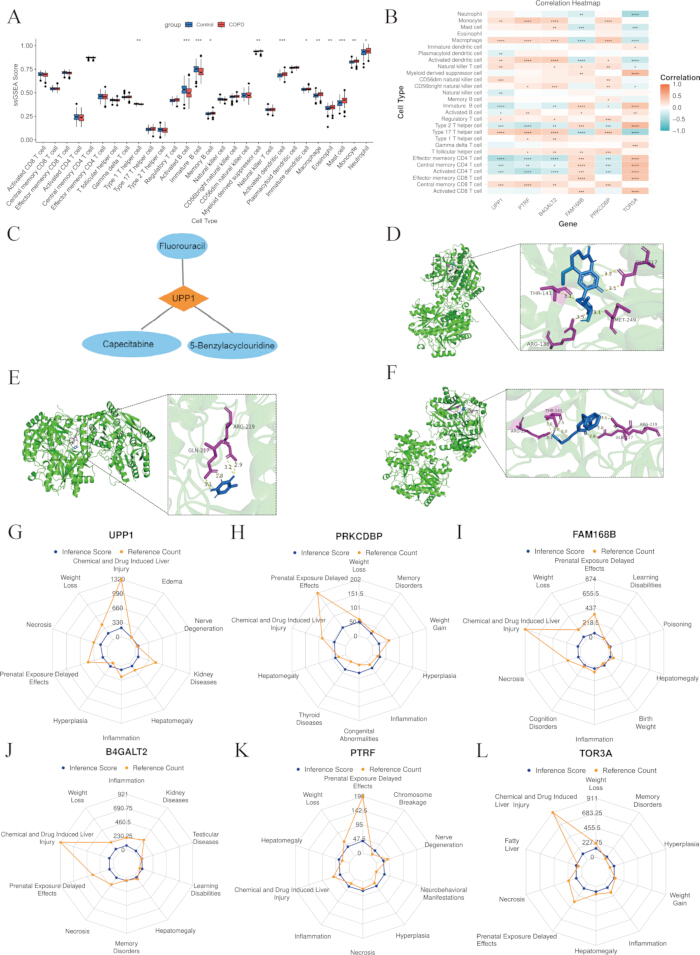
Рисунок 5: Иммунная инфильтрация ключевых генов и прогнозирование мишеней лекарственных препаратов при ХОБЛ. (A) Различия в обилии иммунных клеток между группами. (B) Тепловая карта корреляции между иммунными клетками и ключевыми генами. (C) Сеть взаимодействий между ключевыми генами и прогнозируемыми препаратами. (D) Молекулярный докинг фторурацила с UPP1. (E) Молекулярный докинг капецитабина с UPP1. (F) Молекулярный докинг 5-бензилацилуридина с UPP1. Для каждого соединения на левом изображении показана общая конформация докинга, на правом — локальные взаимодействия при связывании. (G) CTD-анализ B4GALT2. (H) CTD-анализ FAM168B. (I) CTD-анализ PRKCDBP. (J) CTD-анализ PTRF. (K) CTD-анализ TOR3A. (L) CTD-анализ UPP1. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
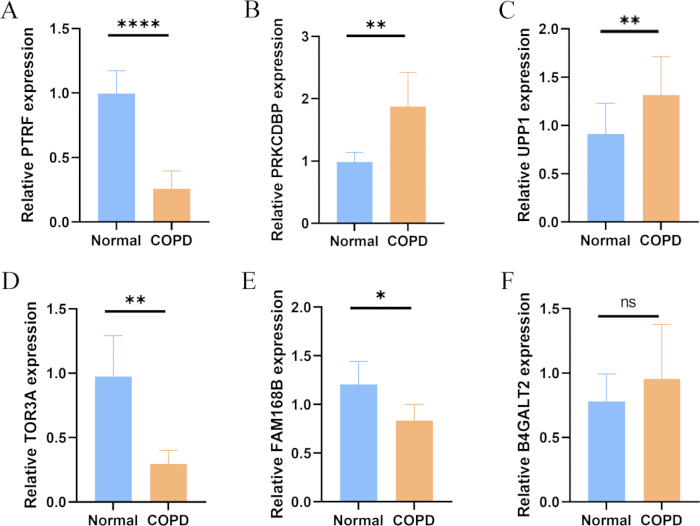
Рисунок 6: Валидация экспрессии ключевых генов методом RT-qPCR в образцах при ХОБЛ и контрольных образцах. (A) Относительная экспрессия PTRF. (B) Относительная экспрессия PRKCDBP. (C) Относительная экспрессия UPP1. (D) Относительная экспрессия TOR3A. (E) Относительная экспрессия FAM168B. (F) Относительная экспрессия B4GALT2. ns = статистически не значимо, p > 0.05; * p < 0.05; ** p < 0.01; *** p < 0.001; **** p < 0.0001. Сокращение: RT-qPCR = количественная полимеразная цепная реакция с обратной транскрипцией. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Дополнительный рисунок 1: Образцы набора данных GSE54837 и кластеризация генных модулей. (A) Диаграмма кластеризации образцов набора данных GSE54837. (B) Дендрограмма кластеризации модулей до объединения. Гены были сгруппированы с использованием метода динамического разреза дерева для идентификации отдельных модулей. (C) Дендрограмма иерархической кластеризации собственных генов модулей. Модули с похожими паттернами экспрессии были кластеризованы на основе сходства их собственных генов.Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Дополнительная фигура 2: Анализ обогащения GSEA. (A) GO-анализ PRKCDBP. (B) KEGG-анализ PRKCDBP. (C) GO-анализ PTRF. (D) KEGG-анализ PTRF. (E) GO-анализ TOR3A. (F) KEGG-анализ TOR3A. (G) GO-анализ FAM168B. (H) KEGG-анализ FAM168B. (I) GO-анализ B4GALT2. (J) KEGG-анализ B4GALT2. Сокращения: GO = Gene Ontology (генная онтология); KEGG = Kyoto Encyclopedia of Genes and Genomes (Киотская энциклопедия генов и геномов).Пожалуйста, нажмите здесь, чтобы скачать этот файл.
| Набор данных | Контроль | Пациенты | Платформа для секвенирования |
| GSE54837 | 90 | 136 | GPL570 |
| GSE112811 | 44 | 20 | GPL570 |
Таблица 1: Наборы данных экспрессии генов, использованные в исследовании. Характеристики наборов данных GSE54837 и GSE112811, использованных соответственно для разработки/внутреннего тестирования модели и внешней валидации.
| Пациент | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 |
| Пол (Ж/М) | М | М | М | F | М | М | M | М |
| Возраст (лет) | 69 | 72 | 75 | 73 | 68 | 70 | 69 | 71 |
| Статус курения | Да | Да | Отказ от курения (2 года) | Нет | Да | Да | Да | Отказ от курения (5 лет) |
| Пачка-лет | 20 в день / 30 лет | 15 в день / 35 лет | 20 в день / 50 лет | 20 в день / 40 лет | 30 в день / 40 лет | 15 в день / 40 лет | 20 в день / 30 лет | |
| Группа ХОБЛ | 2 | 3 | 3 | 2 | 2 | 3 | 2 | 3 |
Таблица 2: Исходные характеристики участников исследования.Исходные демографические и клинические характеристики пациентов с ХОБЛ и здоровых лиц из контрольной группы, включенных в валидацию методом RT-qPCR.
| Название молекулы | Ген | Балл (ккал/моль) |
| 5-бензилацилуридин | UPP1 | -9.6 |
| Капецитабин | UPP1 | -6.1 |
| Флуороурацил | UPP1 | -5.5 |
Таблица 3: Результаты молекулярного докинга UPP1 и соединений-кандидатов.
Предполагаемые результаты молекулярного докинга при взаимодействии UPP1 с фторурацилом, капецитабином и 5-бензилацилуридином, включая их аффинность связывания.
Обсуждение
Консервативная модификация РНК ac4C, которая преимущественно происходит в матричной РНК (мРНК) и транспортной РНК (тРНК), повышает стабильность мРНК и эффективность трансляции20. NAT10 является единственной известной РНК-ацетилтрансферазой, опосредующей модификацию ac4C21. Исследования показали, что экспрессия NAT10 повышена в эпителиальных клетках легких пациентов с ХОБЛ. Нокдаун NAT10 нарушает митохондриальную функцию и транскриптомные ответы22. На основе комплексного мультиомного анализа в данном исследовании были выявлены шесть ключевых генов, тесно связанных с ХОБЛ, и разработана диагностическая модель, которая продемонстрировала умеренную диагностическую эффективность и потенциальную ценность для дальнейших исследований. Дальнейший анализ выявил ключевую роль этих генов в транскрипционной регуляции, сетях ceRNA и иммунном микроокружении. Кроме того, были предсказаны потенциальные таргетные препараты, что дает представление о патогенезе ХОБЛ и способствует разработке стратегий персонализированного прецизионного лечения. С помощью WGCNA и анализа дифференциальной экспрессии мы идентифицировали гены, которые были как дифференциально экспрессированы при ХОБЛ, так и присутствовали в ранее опубликованном списке генов, связанных с ac4C. Важно отметить, что эти гены были выбраны на основании их связи с регуляторной сетью ac4C, а не на основании доказанных механистических связей с NAT10 или ацетилированием ac4C; в итоге было получено 160 генов-кандидатов. Посредством алгоритмов машинного обучения были определены шесть ключевых генов (PTRF, PRKCDBP, UPP1, TOR3A, FAM168B и B4GALT2). Среди них PTRF играет критическую роль в воспалении дыхательных путей, индуцированном домашним пылевым клещом (HDM), регулируя некроптоз макрофагов, опосредованный путем IL-33-ZBP1, что позволяет предположить его участие в хронических воспалительных заболеваниях легких, таких как ХОБЛ23. Lai и соавт.24 продемонстрировали, что введение экзогенного уридина подавляет ферроптоз в макрофагах через путь Nrf2/SLC7A11/GPX4, облегчая тем самым острое повреждение легких, вызванное сепсисом. Хотя в тканях легких при моделях острого повреждения легких наблюдалось повышение экспрессии UPP1, ключевого фермента метаболизма уридина, его точная роль — и является ли это повышение защитной реакцией или следствием повреждения тканей — требует дальнейшего выяснения. Тем не менее, этот результат позволяет предположить, что UPP1 может иметь потенциальную связь с патофизиологическими процессами воспалительных заболеваний легких, таких как ХОБЛ, что обосновывает необходимость дальнейших исследований. Остальные четыре ключевых гена менее изучены при заболеваниях легких, но на основании их функций при других патологиях и наших текущих данных мы выдвигаем гипотезу о потенциальных путях, посредством которых они могут способствовать патогенезу ХОБЛ.
На основе шести ключевых генов мы построили диагностическую модель ХОБЛ и подтвердили её высокую прогностическую эффективность. Анализ экспрессии показал, что UPP1, B4GALT2 и PRKCDBP были значительно повышены, тогда как экспрессия FAM168B, PTRF и TOR3A была заметно снижена при ХОБЛ. Хотя при анализе набора данных B4GALT2 был идентифицирован как повышенный, при валидации методом RT-qPCR значимых различий обнаружено не было. Это расхождение может быть связано с ограниченным размером выборки, гетерогенностью когорты и различиями в источниках образцов между общедоступными наборами данных и клиническими образцами крови. Анализ обогащения наборов генов показал, что эти ключевые гены были значительно обогащены в процессах сплайсинга РНК и процессинга мРНК, а также в таких путях, как клеточный цикл и никотиновая зависимость. Необратимая остановка клеточного цикла признана основным механизмом клеточного старения, который может вносить существенный вклад в патофизиологию ХОБЛ25,26. Дальнейший анализ показал, что ассоциированный со старением секреторный фенотип (SASP), индуцированный повреждением ДНК, может способствовать постоянному прогрессированию ХОБЛ, поддерживая хроническое воспаление и усугубляя повреждение легочной ткани27. В предыдущем исследовании также рассматривались генетические связи, лежащие в основе никотиновой зависимости и ХОБЛ28. Хотя курение является основным фактором риска ХОБЛ, болезнь развивается лишь у небольшой части курильщиков, что позволяет предположить, что генетические факторы играют важную роль как в развитии ХОБЛ, так и в никотиновой зависимости. Liu et al.29 обобщили роль РНК-связывающих белков (RBP) при ХОБЛ и легочной гипертензии (ЛГ), подчеркнув их участие в ремоделировании легочных сосудов и воспалительных реакциях посредством регуляции сплайсинга мРНК и посттранскрипционной экспрессии генов, что указывает на их потенциал в качестве биомаркеров и терапевтических мишеней. Таким образом, ключевые гены и связанные с ними пути, выявленные в данном исследовании, не только углубляют наше понимание патогенеза ХОБЛ, но и создают надежную основу для разработки будущих диагностических биомаркеров и стратегий таргетной терапии.
Сеть ceRNA включает различные виды РНК, в том числе lncRNAs, circRNAs и mRNAs, которые конкурентно связываются с общими miRNAs, формируя тем самым взаимные регуляторные связи и влияя на экспрессию генов30. Эта сложная сеть участвует в многочисленных физиологических и патологических процессах и способствует пониманию механизмов регуляции генов и патогенеза таких заболеваний, как рак и хронические воспалительные расстройства. Например, Wang и др. построили сеть коэкспрессии ceRNA, состоящую из 11 lncRNAs, пяти miRNAs и 16 mRNAs, в которой основной подсетке соответствовали изменения пропорций иммунных клеток и функции легких при ХОБЛ31. Аналогичным образом, Zhang и др.32 разработали сеть ceRNA типа circRNA-miRNA-mRNA на основе мононуклеарных клеток периферической крови мужчин, курящих сигареты, выявив дисрегулированные circRNAs и ключевые пути, связанные с ХОБЛ. Наш анализ сети коэкспрессии показал, что ключевые гены преимущественно устанавливали функциональные связи посредством физических взаимодействий, коэкспрессии и общих белковых доменов, а также были значительно обогащены в многочисленных метаболических путях. На основании этих результатов мы дополнительно построили регуляторную сеть «транскрипционный фактор (TF) — мишень» и регуляторную ось miRNA-lncRNA-mRNA. Эти данные свидетельствуют о том, что ключевые гены могут совместно регулироваться посредством многоуровневых механизмов с участием lncRNAs, транскрипционных факторов и miRNAs при ХОБЛ.
Иммунная инфильтрация отражает иммунный статус, указывая на распределение и активность иммунных клеток в тканях или крови. На этой основе с помощью компьютерного скрининга были предсказаны потенциальные препараты-кандидаты, после чего было проведено молекулярное докирование для оценки аффинности связывания и стабильности взаимодействия с белками-мишенями. Совокупно эти анализы облегчают поиск новых терапевтических агентов и позволяют глубже понять механизмы заболевания. В данном исследовании шесть ключевых генов положительно коррелировали с большинством типов инфильтрации иммунных клеток. В результате предсказания лекарств были выявлены потенциальные взаимодействия между UPP1 и фторурацилом, капецитабином и 5-бензилацилуридином, при этом последний продемонстрировал наиболее сильную аффинность связывания, что было дополнительно подтверждено молекулярным докированием. Примечательно, что фторурацил и капецитабин в основном используются в качестве противоопухолевых средств и были выявлены в данном исследовании как соединения, взаимодействующие с UPP1 согласно предсказаниям баз данных, а не как валидированные варианты терапии ХОБЛ. В предыдущих исследованиях сообщалось, что местное введение фторурацила может улучшить проходимость дыхательных путей при тяжелой обструкции33. Однако другие данные указывают на то, что фторурацил и капецитабин могут вызывать легочную токсичность, особенно у пациентов с предшествующими заболеваниями легких34. Следовательно, их потенциальная значимость при ХОБЛ требует дальнейшей экспериментальной проверки и подтверждения безопасности. Кроме того, анализ CTD показал, что все шесть ключевых генов связаны с множественными патологическими процессами. В целом, комплексный анализ иммунной инфильтрации, предсказания лекарств и молекулярного докирования позволяет выявить новые молекулярные мишени и создает теоретическую базу для прецизионного лечения ХОБЛ, способствуя тем самым разработке и клиническому внедрению соответствующих препаратов.
Тем не менее, следует признать наличие ряда ограничений. Исследование опиралось на общедоступные наборы данных с относительно ограниченным количеством источников образцов, что может привести к возникновению батч-эффектов и потенциальному переобучению модели. Валидация методом RT-qPCR проводилась на небольшой когорте, а наблюдаемая несогласованность экспрессии B4GALT2 указывает на возможную гетерогенность когорты. Кроме того, анализ иммунной инфильтрации и прогнозирование ответа на препараты носили вычислительный характер и требуют дальнейшего экспериментального подтверждения. Более того, поскольку данная биоинформатическая работа представляет собой этап поиска, наша диагностическая модель оценивалась преимущественно с использованием значений AUC с 95% доверительными интервалами. Комплексные показатели эффективности, такие как чувствительность, специфичность, прогностическая значимость и детальная калибровочная статистика, не были полностью оценены из-за ретроспективного характера общедоступных наборов данных и ограниченного размера выборок. Следовательно, нашу модель следует рассматривать как инструмент подтверждения концепции, а ее клиническая полезность требует дальнейшей валидации на более крупных проспективных когортах.
С помощью комплексного биоинформатического анализа и методов машинного обучения в данном исследовании были выявлены шесть ключевых генов, значимо связанных с ХОБЛ. Была разработана надежная диагностическая модель, продемонстрировавшая стабильную прогностическую эффективность в нескольких когортах. Функциональный анализ показал, что эти гены участвуют в критических регуляторных сетях, включающих транскрипционную и посттранскрипционную регуляцию, инфильтрацию иммунных клеток, а также пути, связанные с никотиновой зависимостью и клеточным циклом. Анализ прогнозирования лекарственных средств и молекулярный докинг выделили UPP1 как перспективную терапевтическую мишень, при этом несколько соединений-кандидатов продемонстрировали сильное сродство к связыванию. В целом, эти результаты углубляют понимание патофизиологии ХОБЛ и предоставляют ценные молекулярные мишени для будущей разработки терапевтических средств и стратегий персонализированной медицины.
Раскрытие информации
Авторы заявляют об отсутствии конфликта интересов. От всех участников исследования было получено информированное согласие.
Благодарности
Мы выражаем благодарность больнице традиционной китайской медицины района Луоху в Шэньчжэне за предоставление клинической базы и административную поддержку, необходимые для данного исследования. Наконец, мы благодарны всем пациентам и здоровым добровольцам, принявшим участие в этом исследовании; их вклад был незаменимым для этой работы. Данная работа была поддержана проектом Sanming Project of Medicine в Шэньчжэне (№ SZZYSM202401018), фондами приоритетных специальностей района Луоху (№ LX202402021) и фондами приоритетных специальностей района Луоху (№ LX202302064).
Материалы
| Имя | Компания | Каталожный номер | Комментарии |
|---|---|---|---|
| βпраймеры к $\beta$-актину | Цинке | Поскольку исходный текст не был предоставлен, я не могу выполнить перевод. Пожалуйста, введите текст, который необходимо перевести на русский язык. | Прямой: 5’-CATGTACGTTGCTATCCAGGC-3’ Обратное: 5’-CTCCTTAATGTCACGCACGAT-3’ |
| праймеры к B4GALT2 | Цинке | Поскольку исходный текст отсутствует (N/A), пожалуйста, предоставьте текст для перевода. Я готов перевести ваши материалы JoVE на русский язык, строго соблюдая академический стиль, научную терминологию и точность протоколов. | Прямой: 5’-GGGCAGACTGCTGATCGAG-3’ Обратный ход: 5’-CCGGTGTCTAAAGGGGATGAT-3’ |
| CB-Dock2 | LabShare | Онлайн | Молекулярный докинг |
| clusterProfiler | Bioconductor | v4.14.6 | Анализ обогащения |
| Cytoscape | Консорциум Cytoscape | v3.8.3 | Визуализация сети |
| DrugBank | Альбертский университет | Онлайн | Прогнозирование действия лекарственных препаратов |
| праймеры к FAM168B | Цинке | Поскольку исходный текст не был предоставлен, пожалуйста, введите текст, который необходимо перевести. Я готов выполнить профессиональный перевод вашего научно-образовательного контента JoVE на русский язык в соответствии со всеми указанными требованиями. | Прямой: 5’-TCTGGGGTTCCCTATGCAAAT-3’ Обратное: 5’-GTAGGATTCGCTCCAGGATACA-3’ |
| glmnet | CRAN | v4.1 | LASSO-регрессия |
| GSVA (анализ вариации набора генов) | Bioconductor | v1.52.3 | анализ ssGSEA |
| Супермикс для синтеза первой цепи кДНК Hifair III | YEASEN | 11141ES | синтез кДНК |
| Hieff RTPCR SYBR Green Master Mix | YEASEN | 11201ES | Амплификация методом кПЦР |
| limma | Bioconductor | v3.54.0 | Дифференциальная экспрессия |
| Система LightCycler 480 II | Roche | LightCycler 480 II | ПЦР в реальном времени |
| праймеры для PTRF | Цинке | Данные отсутствуют | Прямой: 5’-GGGCCGTAGACCAGATCCA-3’ Обратное: 5’-CTTGCTCACCGTATTGCTCGT-3’ |
| праймеры к PRKCDBP | Цинке | Пожалуйста, предоставьте исходный текст для перевода. | Прямой: 5’-CACGTTCTGCTCTTCAAGGAG-3’ Реверс: 5’-TGTACCTTCTGCAATCCGGTG-3’ |
| программное обеспечение R | R Foundation | v4.4.2 | Статистические вычисления |
| случайный лес | CRAN | v4.7 | Случайный лес |
| Набор для выделения РНК из крови MolPure Blood RNA Kit | YEASEN | 19241ES50 | Экстракция РНК |
| база данных STRING | EMBL | Онлайн | сеть белок-белковых взаимодействий |
| праймеры TOR3A | Цинке | Поскольку исходный текст отсутствует (N/A), я готов приступить к переводу, как только вы предоставите контент. Пожалуйста, отправьте текст, который необходимо перевести на русский язык. | Прямой: 5’-CCCTTGCTCTGTCGTTCCAC-3’ Обратная связь: 5’-CCCGTCCCGATACAGGTTC-3’ |
| праймеры к UPP1 | Цинке | Поскольку исходный текст не был предоставлен, пожалуйста, введите текст, который необходимо перевести. | Прямой: 5’-CTGTCAGTCATGGTATGGGCA-3’ Обратное: 5’-GAGCACCGGGCATAGTACA-3’ |
| WGCNA (анализ сетей ко-экспрессии генов с использованием взвешенного анализа сетей) | CRAN | v1.72 | Сеть коэкспрессии |
| XGBoost | CRAN | v1.7 | Алгоритм XGBoost |
Ссылки
- Hogg JC. Pathophysiology of airflow limitation in chronic obstructive pulmonary disease. Lancet. 2004;364(9435):709-21.
- Baraldo S, Turato G, Saetta M. Pathophysiology of the small airways in chronic obstructive pulmonary disease. Respiration. 2012;84(2):89-97.
- Fischer BM, Pavlisko E, Voynow JA. Pathogenic triad in COPD: oxidative stress, protease-antiprotease imbalance, and inflammation. Int J Chron Obstruct Pulmon Dis. 2011;6:413-21.
- Pandey KC, De S, Mishra PK. Role of proteases in chronic obstructive pulmonary disease. Front Pharmacol. 2017;8:512.
- Wang L, Xie J, Hu Y, Tian Y. Air pollution and risk of chronic obstructed pulmonary disease: the modifying effect of genetic susceptibility and lifestyle. EBioMedicine. 2022;79:103994.
- Elonheimo HM, et al. Environmental substances associated with chronic obstructive pulmonary disease-a scoping review. Int J Environ Res Public Health. 2022;19(7):3945.
- Chen S, et al. The global economic burden of chronic obstructive pulmonary disease for 204 countries and territories in 2020-50: a health-augmented macroeconomic modelling study. Lancet Glob Health. 2023;11(8):e1183-e93.
- Rutten-van Mölken MP, et al. Costs and effects of inhaled corticosteroids and bronchodilators in asthma and chronic obstructive pulmonary disease. Am J Respir Crit Care Med. 1995;151(4):975-82.
- Ontiveros RJ, Stoute J, Liu KF. The chemical diversity of RNA modifications. Biochem J. 2019;476(8):1227-45.
- Roundtree IA, Evans ME, Pan T, He C. Dynamic RNA modifications in gene expression regulation. Cell. 2017;169(7):1187-200.
- Wang C, et al. RNA modification in cardiovascular disease: implications for therapeutic interventions. Signal Transduct Target Ther. 2023;8(1):412.
- Zhang W, et al. ac4C acetylation regulates mRNA stability and translation efficiency in osteosarcoma. Heliyon. 2023;9(6):e17103.
- Qiu L, Jing Q, Li Y, Han J. RNA modification: mechanisms and therapeutic targets. Mol Biomed. 2023;4(1):25.
- Luo J, Cao J, Chen C, Xie H. Emerging role of RNA acetylation modification ac4C in diseases: current advances and future challenges. Biochem Pharmacol. 2023;213:115628.
- Li H, et al. RNA cytidine acetyltransferase NAT10 maintains T cell pathogenicity in inflammatory bowel disease. Cell Discov. 2025;11(1):19.
- Wang JN, et al. NAT10 exacerbates acute renal inflammation by enhancing N4-acetylcytidine modification of the CCL2/CXCL1 axis. Proc Natl Acad Sci U S A. 2025;122(17):e2418409122.
- Shenshen W, et al. NAT10 accelerates pulmonary fibrosis through N4-acetylated TGFB1-initiated epithelial-to-mesenchymal transition upon ambient fine particulate matter exposure. Environ Pollut. 2023;322:121149.
- Liu J, et al. Unveiling ac4C modification pattern: a prospective target for improving the response to immunotherapeutic strategies in melanoma. J Transl Med. 2025;23(1):287.
- Su F, et al. Multimodal single-cell analyses outline the immune microenvironment and therapeutic effectors of interstitial cystitis/bladder pain syndrome. Adv Sci (Weinh). 2022;9(18):e2106063.
- Schiffers S, Oberdoerffer S. ac4C: a fragile modification with stabilizing functions in RNA metabolism. RNA. 2024;30(5):583-94.
- Jiao L, et al. Emerging role of N-acetyltransferase 10 in diseases: RNA ac4C modification and beyond. Mol Biomed. 2025;6(1):46.
- Zheng N, et al. Regulatory roles of NAT10 in airway epithelial cell function and metabolism in pathological conditions. Cell Biol Toxicol. 2023;39(4):1237-56.
- Du J, et al. PTRF-IL33-ZBP1 signaling mediating macrophage necroptosis contributes to HDM-induced airway inflammation. Cell Death Dis. 2023;14(7):432.
- Lai K, et al. Uridine alleviates sepsis-induced acute lung injury by inhibiting ferroptosis of macrophage. Int J Mol Sci. 2023;24(6):5093.
- Kumari R, Jat P. Mechanisms of cellular senescence: cell cycle arrest and senescence associated secretory phenotype. Front Cell Dev Biol. 2021;9:645593.
- Ogrodnik M, Salmonowicz H, Jurk D, Passos JF. Expansion and cell-cycle arrest: common denominators of cellular senescence. Trends Biochem Sci. 2019;44(12):996-1008.
- Kumar M, Seeger W, Voswinckel R. Senescence-associated secretory phenotype and its possible role in chronic obstructive pulmonary disease. Am J Respir Cell Mol Biol. 2014;51(3):323-33.
- Pérez-Rubio G, et al. Role of genetic susceptibility in nicotine addiction and chronic obstructive pulmonary disease. Rev Invest Clin. 2019;71(1):36-54.
- Liu Y, Wang R, Jiang T. RNA-binding proteins as a molecular link between COPD and pulmonary hypertension. Int J Med Sci. 2025;22(8):1979-91.
- Marques TM, Gama-Carvalho M. Network approaches to study endogenous RNA competition and its impact on tissue-specific microRNA functions. Biomolecules. 2022;12(2):332.
- Wang J, Xia B, Ma R, Ye Q. Comprehensive analysis of a competing endogenous RNA co-expression network in chronic obstructive pulmonary disease. Int J Chron Obstruct Pulmon Dis. 2023;18:2417-29.
- Zhang J, et al. Construction of a ceRNA network and screening of potential biomarkers and molecular targets in male smokers with chronic obstructive pulmonary disease. Front Genet. 2024;15:1376721.
- Celikoğlu F, Celikoğlu SI. Intratumoural chemotherapy with 5-fluorouracil for palliation of bronchial cancer in patients with severe airway obstruction. J Pharm Pharmacol. 2003;55(10):1441-8.
- Chan AK, Choo BA, Glaholm J. Pulmonary toxicity with oxaliplatin and capecitabine/5-fluorouracil chemotherapy: a case report and review of the literature. Onkologie. 2011;34(8-9):443-6.