Данный протокол объединяет многомерные транскриптомные данные с методами машинного обучения для идентификации генов, связанных со старением и митохондриями, при дилатационной кардиомиопатии с целью поиска биомаркеров и молекулярного субтипирования.
Исследовательская статья
Идентификация ключевых генов, связанных со старением и митохондриями, при дилатационной кардиомиопатии
В этой статье
Краткое содержание
Аннотация
Дилатационная кардиомиопатия (ДКМП) характеризуется дилатацией левого желудочка и систолической дисфункцией, а также связана с митохондриальной дисфункцией и иммунно-воспалительной активацией. Однако молекулярные признаки, связанные со старением, и пути регуляции митохондрий при ДКМП остаются изученными не полностью. В данном исследовании были проанализированы шесть наборов данных объемного транскриптомного анализа и один набор данных секвенирования РНК единичных клеток из базы данных Gene Expression Omnibus. После нормализации данных, коррекции пакетного эффекта и аннотации типов клеток были выявлены гены-кандидаты, связанные со старением и митохондриями, с помощью анализа дифференциальной экспрессии, анализа сетей коэкспрессии генов с весовыми коэффициентами (WGCNA) и построения сетей белок-белковых взаимодействий. Отбор ключевых генов проводился далее с использованием регрессии LASSO, случайного леса (random forest) и метода рекурсивного исключения признаков на основе опорных векторов (SVM-RFE). Для характеристики иммунного микроокружения сердца при ДКМП были проведены анализы инфильтрации иммунных клеток, межклеточного взаимодействия и молекулярного субтипирования. В общей сложности с ДКМП были связаны 66 генов, связанных со старением, и 16 генов, связанных с митохондриями; они были преимущественно обогащены в путях сигнализации фактора, индуцируемого гипоксией-1, окислительного фосфорилирования и путях, связанных с синтазой оксида азота. Методы машинного обучения и анализ секвенирования РНК единичных клеток позволили определить SERPINE1, TGFB2, CYBB и TLR2 в качестве ключевых генов. CYBB и TLR2 высоко экспрессировались в моноцитах и макрофагах, тогда как SERPINE1 и TGFB2 преимущественно экспрессировались в стромальных клетках. Анализ иммунного ландшафта показал усиление активации провоспалительных макрофагов и изменение межклеточного взаимодействия в образцах с ДКМП. На основании экспрессии ключевых генов образцы с ДКМП были разделены на два молекулярных подтипа, связанных с сигнализацией фактора роста эндотелия сосудов и биосинтезом первичных желчных кислот соответственно. Данный протокол предоставляет комплексную основу для идентификации потенциальных биомаркеров и молекулярных подтипов при ДКМП.
Введение
Дилатационная кардиомиопатия (ДКМП) представляет собой заболевание миокарда, характеризующееся расширением левого желудочка и нарушением систолической функции. Это третья по частоте причина сердечной недостаточности и основное показание к трансплантации сердца во всем мире1. Согласно популяционным исследованиям, распространенность заболевания составляет примерно 1 случай на 250 взрослых, при этом более высокая частота наблюдается у мужчин, а значительная доля случаев обусловлена моногенными вариантами2. Эти данные свидетельствуют о том, что как генетическая предрасположенность, так и факторы окружающей среды способствуют возникновению и прогрессированию ДКМП.
Патогенез DCM включает взаимосвязанные процессы, в том числе воспалительную активацию, окислительный стресс, апоптоз кардиомиоцитов и нарушение профибротической сигнализации. Генетические полиморфизмы, связанные с воспалением, в том числе варианты промотора фактора некроза опухоли-α, были ассоциированы с предрасположенностью к вирусной форме DCM3. Повышенный окислительный стресс также связывают с гибелью кардиомиоцитов и дисфункцией левого желудочка при различных подтипах DCM у человека4. Кроме того, аберрантная активация сигнальных путей Wnt/β-catenin и кальциневрин/ядерный фактор активированных Т-клеток способствует гипертрофии миокарда и интерстициальному фиброзу, тем самым способствуя прогрессированию заболевания5,6. Митохондриальная дисфункция является еще одним важным компонентом DCM, поскольку кардиомиоциты имеют высокую потребность в энергии. Нарушение биогенеза митохондрий, гомеостаза кальция, митофагии и целостности митохондриальной ДНК может привести к нарушению окислительного фосфорилирования и способствовать прогрессирующей сердечной дисфункции7,8,9,10.
Несмотря на эти данные о механизмах, остаются важные пробелы в знаниях. В частности, временные и причинно-следственные связи между структурным ремоделированием митохондрий и биоэнергетической дисфункцией при инициации и прогрессировании DCM не были полностью определены11. Было исследовано несколько терапевтических стратегий. Терапия стволовыми клетками продемонстрировала регенеративный потенциал за счет паракринных, цитопротекторных и иммуномодулирующих эффектов, однако по-прежнему необходима оптимизация источников клеток, путей их доставки и выживаемости после трансплантации12. Подходы генной терапии, включая доставку на основе аденоассоциированных вирусов и редактирование генома с помощью коротких палиндромных повторов, регулярно расположенных группами, также предлагают потенциальные стратегии прецизионного лечения. Тем не менее, ограничения, связанные с кардиальным тропизмом, иммуногенностью векторов и долгосрочной безопасностью, остаются нерешенными13.
Общедоступные транскриптомные наборы данных из таких репозиториев, как Gene Expression Omnibus (GEO), широко используются для поиска биомаркеров при DCM. Эти ресурсы обеспечивают доступ к многоцентровым клиническим когортам, поддерживают экономически эффективные и воспроизводимые исследования, а также позволяют повысить статистическую мощность за счет интеграции различных наборов данных14. Транскриптомное профилирование также позволяет проводить общегеномный скрининг генов-кандидатов, молекулярное субтипирование и анализ на уровне метаболических путей15. Однако общедоступные наборы данных имеют внутренние ограничения, включая технические батч-эффекты, клиническую и этиологическую неоднородность, ограниченные возможности для установления причинно-следственных связей, а также неполную лонгитюдную или прогностическую информацию16. Следовательно, результаты, полученные на основе общедоступных транскриптомных наборов данных, наиболее пригодны для формулирования гипотез и приоритизации биомаркеров-кандидатов и требуют валидации в независимых когортах и экспериментальных моделях.
Многие биоинформатические исследования DCM опираются преимущественно на анализ дифференциальной экспрессии, который может приводить к ложноположительным результатам и не позволяет полностью охарактеризовать сети коэкспрессии генов или клеточную гетерогенность в сердечной ткани. Чтобы устранить эти ограничения, в настоящем исследовании была применена интегрированная аналитическая стратегия, сочетающая взаимодополняющие методы. Общий транскриптомный анализ (bulk transcriptomic analysis) позволяет получить профили экспрессии на уровне ткани, подходящие для сравнения основной и контрольной групп. Взвешенный анализ сетей коэкспрессии генов (WGCNA) позволяет выявить модули генов, связанные с фенотипическими признаками, и дает возможность приоритизировать функционально связанные наборы генов, а не отдельные дифференциально экспрессируемые гены. Анализ сетей белок-белковых взаимодействий (PPI) выявляет высокосвязанные гены на основе топологии сети. Для поиска потенциальных биомаркеров в интегрированных наборах данных¹⁷ были использованы три алгоритма машинного обучения: регрессия LASSO (least absolute shrinkage and selection operator), случайный лес (random forest) и метод исключения признаков на основе опорных векторов (support vector machine-recursive feature elimination). Затем с помощью секвенирования РНК единичных клеток (scRNA-seq) были изучены паттерны экспрессии, специфичные для конкретных типов клеток, и сети межклеточного взаимодействия18.
Хотя митохондриальная дисфункция и связанные со старением молекулярные изменения по отдельности изучались при DCM, их совокупная связь с транскрипционными изменениями, связанными с заболеванием, остается недостаточно исследованной. В настоящем исследовании были интегрированы несколько наборов данных bulk-транскриптомики и scRNA-seq для выявления хаб-генов, связанных со старением и митохондриями, при DCM, характеристики иммунного микроокружения сердца и изучения молекулярных подтипов на основе выявленных генов. Данный интегрированный подход был использован для приоритизации потенциальных биомаркеров и создания основы для последующих механистических и валидационных исследований.
Протокол
Все процедуры с животными были рассмотрены и одобрены Комитетом по этике работы с лабораторными животными Второй аффилированной больницы Хэнаньского университета китайской медицины (номер одобрения HNSZYYYJS2023011150). Все процедуры проводились в соответствии с Руководством по этической экспертизе благополучия лабораторных животных (GB/T 35892-2018) и принципами 3R: заменой (Replacement), сокращением (Reduction) и совершенствованием (Refinement). Реагенты, базы данных, программное обеспечение и оборудование, использованные в данном исследовании, перечислены в Таблице материалов.
1. Ресурсы данных и экспериментальные материалы
В качестве модельной группы использовали трансгенных самцов мышей линии CTNTR141W (класс SPF) со спонтанным фенотипом дилатационной кардиомиопатии (ДКМП) и массой тела 25 ± 2 g. В качестве контрольной группы использовали самцов мышей линии C57BL/6J (класс SPF) того же возраста с массой тела 25 ± 2 g. В каждой группе было по 12 мышей. Все животные были получены из учреждений, имеющих действующие лицензии на разведение лабораторных животных, и содержались в условиях SPF-барьера при температуре 22 ± 2 °C и относительной влажности 40%–60% с 12-часовым циклом свет/темнота, при свободном доступе к стерильному корму и воде. После 1 недели акклиматизации всех мышей содержали в тех же условиях еще в течение 4 недель перед оценкой функции сердца и сбором образцов. В начале эксперимента возраст мышей составлял 6–8 недель. Мышей подвергали глубокой анестезии и эвтаназировали путем вывиха шейного позвонка.
Из базы данных Gene Expression Omnibus (GEO)19 были получены семь общедоступных транскриптомных наборов данных тканей миокарда левого желудочка пациентов с DCM. Эти наборы включали шесть наборов данных объемного транскриптома (bulk transcriptomics) и один набор данных секвенирования РНК единичных клеток (scRNA-seq) — GSE145154. В анализ были включены как CD45-положительные, так и CD45-отрицательные фракции. Обе фракции клеток, CD45-положительные и CD45-отрицательные, были объединены перед кластеризацией. Идентификатор образца использовался в качестве основной переменной пакета (batch variable) для интеграции с помощью Harmony. Были включены образцы левого желудочка нормы и левого желудочка с DCM из набора GSE145154, в частности GSM4307515, GSM4307516, GSM4307520 и GSM4307521. В данном исследовании использовались наборы данных GSE145154, GSE5406, GSE42955, GSE57338, GSE79962, GSE116250 и GSE141910. Все образцы, кроме DCM, были исключены; были оставлены только контрольные образцы (группа Control) и образцы с DCM (группа DCM). После контроля качества образцы не удалялись. Информация об included наборах данных GEO приведена ниже: GSE5406 содержал 102 образца (16 контрольных и 86 образцов DCM); GSE42955 содержал 17 образцов (5 контрольных и 12 образцов DCM); GSE57338 содержал 231 образец (136 контрольных и 95 образцов DCM); GSE79962 содержал 20 образцов (11 контрольных и 9 образцов DCM); GSE116250 содержал 51 образец (14 контрольных и 37 образцов DCM); и GSE141910 содержал 322 образца (161 контрольный и 161 образец DCM).
2. Предобработка данных объемного транскриптома
Матрицы экспрессии в сыром виде и файлы клинических аннотаций для шести наборов данных объемного транскриптома были загружены с помощью пакета GEOquery20. Для наборов данных микрочипов Affymetrix были получены исходные CEL-файлы, а для наборов данных RNA-seq — матрицы необработанных подсчетов. Коррекция фона, квантильная нормализация и расчет экспрессии для данных микрочипов выполнялись с использованием алгоритма робастного усреднения по массивам (RMA), реализованного в пакете affy21.
Данные подсчета RNA-seq были нормализованы методом усеченного среднего M-значений (trimmed mean of M-values) с использованием пакета edgeR22 и преобразованы в значения количества прочтений на миллион (counts per million) с логарифмическим преобразованием по основанию 2 (log₂). Идентификаторы зондов были заменены на официальные символы генов с использованием файлов аннотации конкретной платформы. В случаях, когда несколько зондов соответствовали одному гену, рассчитывалось среднее значение экспрессии.
Технические пакетные эффекты (batch effects) между наборами данных были устранены с помощью алгоритма ComBat из пакета sva23. Источник набора данных и платформа детекции были указаны в качестве факторов пакета. Для оценки эффективности удаления пакетных эффектов до и после коррекции был проведен анализ главных компонент.
3. Предобработка данных транскриптома отдельных клеток и аннотирование клеток
Матрица экспрессии генов из GSE145154 была импортирована в Seurat для создания объекта Seurat с использованием Seurat версии 524. Низкокачественные клетки были исключены с использованием следующих пороговых значений: от 200 до 6 000 детектированных генов на клетку, общее количество уникальных молекулярных идентификаторов более 500 и процент митохондриальных генов ниже 25%. Клетки, не соответствующие этим порогам контроля качества, были исключены как низкокачественные или разрушенные. Мы исключали низкокачественные клетки исключительно на основании описанных выше порогов контроля качества.
Логарифмическая нормализация была выполнена с помощью функции NormalizeData с коэффициентом масштабирования 10 000. С помощью функции FindVariableFeatures с методом vst были отобраны 3 000 наиболее вариабельных генов. Данные были масштабированы с помощью ScaleData, после чего для линейного снижения размерности был проведен анализ главных компонентов.
Эффекты батча были скорректированы с помощью алгоритма Harmony25 посредством функции RunHarmony, при этом в качестве группирующей переменной был указан идентификатор образца. Для кластеризации клеток с использованием функций FindNeighbors и FindClusters были использованы первые 15 главных компонент. Кластеризация проводилась с помощью алгоритма Leiden при разрешении 0,15. Нелинейное снижение размерности и визуализация были выполнены с помощью метода аппроксимации и проекции однообразного многообразия (UMAP).
Аннотирование типов клеток проводили с использованием канонических маркерных генов, а также с помощью автоматического аннотирования с использованием пакета SingleR26. Маркерные гены были следующими: B-клетки — IGKC, MS4A1 и CD79A; кардиомиоциты — TNNI3, MYL2 и ACTC1; эндотелиальные клетки — VWF, PECAM1 и EGFL7; макрофаги — C1QC, C1QB и C1QA; моноциты — S100A8, S100A9 и G0S2; натуральные киллеры — NKG7, GNLY и CCL5; гладкомышечные клетки — MYL9, TAGLN и ACTA2; стромальные клетки — FBLN1, LUM и DCN; и T-клетки — CD3E, CD3G и CD3D.
4. Анализ дифференциальной экспрессии и оценка обогащения наборов генов
Для сравнения экспрессии генов между группами с DCM и здоровым контролем была построена линейная модель с использованием пакета limma27. Гены со значением P < 0.05 и абсолютным изменением кратности (fold change) более 1,5, что соответствует абсолютному значению log₂ fold change более 0,58, были определены как статистически значимо дифференциально экспрессируемые.
Для расчета показателей обогащения наборов генов, связанных со старением и митохондриями, в каждом образце был проведен анализ обогащения наборов генов для одного образца (single-sample gene set enrichment analysis)28. Различия в показателях обогащения между группами с DCM и здоровым контролем оценивали с помощью критерия суммы рангов Вилкоксона; статистически значимым считали значение P < 0.05.
На уровне отдельных клеток показатели старения и митохондриальных модулей были рассчитаны с помощью функции AddModuleScore в Seurat. Различия в показателях модулей между группами оценивали с помощью критерия суммы рангов Уилкоксона.
Генные сигнатуры, связанные со старением, были извлечены из базы данных CellAge (https://genomics.senescence.info/cells/), а наборы генов, связанных с митохондриями, были получены из GeneCards (https://www.genecards.org/). Полные списки генов, использованные для оценки, представлены в Дополнительном файле 1.
5. Построение взвешенной сети коэкспрессии генов
Для построения сети были отобраны 5000 белок-кодирующих генов с наибольшей вариабельностью экспрессии в данных массового транскриптомного анализа. Функция pickSoftThreshold была использована для расчета индекса соответствия безмасштабной топологии при различных степенях мягкого порога. Оптимальный порог был определен как минимальная степень, обеспечивающая получение безмасштабной сети со значением R2 выше 0,9. Таким образом, для последующего сетевого анализа была принята степень мягкого порога β = 5.
С использованием функции blockwiseModules была построена знаковая взвешенная сеть коэкспрессии с минимальным размером модуля 30. Коэффициенты корреляции Пирсона рассчитывались между эйгенгеном каждого модуля и показателем обогащения, связанным со старением или митохондриями. Модули с абсолютным коэффициентом корреляции более 0,4 и P < 0,001 считались статистически значимо связанными модулями.
Гены в модулях со значимой взаимосвязью были сопоставлены с дифференциально экспрессируемыми генами для выявления генов-кандидатов старения, связанных с DCM, и генов-кандидатов митохондрий, связанных с DCM.
6. Анализ функционального обогащения
Анализ функционального обогащения, включая анализ генных онтологий (GO) и путей Kyoto Encyclopedia of Genes and Genomes (KEGG), был проведен для генов-кандидатов с использованием пакета clusterProfiler29. Обогащение GO охватывало три стандартные категории: биологический процесс, клеточный компонент и молекулярная функция.
Все анализы проводились с использованием аннотации для человека, коррекцией P-значения по методу ложноположительных результатов (FDR) и пороговым значением q-value 0,05. Размер наборов генов был ограничен диапазоном от 10 до 500 генов, а термины с FDR < 0,05 были определены как статистически значимые. Наконец, результаты анализа обогащения GO были визуализированы посредством для отображения данных использовали сгруппированные столбчатые диаграммы, а результаты анализа обогащения KEGG представляли в виде пузырьковых диаграмм.
7. Построение сети PPI и скрининг хаб-генов
Гены-кандидаты были введены в базу данных STRING версии 11.530 с выбором организма Homo sapiens и порогом достоверности взаимодействия, соответствующим комбинированному показателю более 0.7. Несвязанные узлы были скрыты, а данные о взаимодействиях экспортированы в формате значений, разделенных табуляцией.
Данные о взаимодействиях были импортированы в Cytoscape версии 3.9.1 для визуализации31. Топологические показатели узлов были рассчитаны с помощью плагина CytoHubba32 с использованием трех алгоритмов: Degree (степень), maximum neighborhood component (максимальный компонент окрестности) и maximal clique centrality (центральность максимальной клики).
Основные функциональные модули внутри сети были определены с помощью плагина MCODE33 со следующими параметрами по умолчанию: порог степени (degree cutoff) — 2; k-ядро (k-core) — 2; порог оценки узла (node score cutoff) — 0,2; максимальная глубина — 100. Гены, вошедшие в топ-10 по всем трем топологическим алгоритмам, были сопоставлены с генами в основной подсети MCODE для выявления итоговых хаб-генов белок-белкового взаимодействия.
8. Отбор основных генов на основе машинного обучения и построение диагностической модели
Для обеспечения воспроизводимости и сбалансированной репрезентативности интегрированный набор данных объемного транскриптомного анализа был случайным образом разделен на обучающую и валидационную выборки в соотношении 7:3 с использованием фиксированного случайного числа (seed = 123456). Разделение было стратифицировано по группе заболевания (DCM против контроля) для поддержания одинаковых пропорций классов в обеих выборках. Перед разделением пакетные эффекты (batch effects) из разных источников данных были скорректированы с помощью пакета sva, а интегрированные образцы рассматривались как единая когорта в процессе случайного распределения.
Для скрининга генов-кандидатов были применены три алгоритма машинного обучения. Сначала была выполнена логистическая регрессия LASSO посредством функция cv.glmnet в пакете glmnet34Была построена модель бинарной классификации с 5-кратной перекрестной проверкой, в качестве метрики оценки которой использовался показатель AUC. Гены с ненулевыми коэффициентами при значении lambda.min были отобраны в качестве генов-кандидатов.
Во-вторых, с помощью пакета randomForest35 была построена модель классификации случайного леса с 500 решающими деревьями. Количество переменных, выбираемых для каждого разделения, было установлено равным квадратному корню из общего количества признаков. Значимость генов количественно определяли на основе коэффициента Джини, и были отобраны 10 генов с самыми высокими показателями значимости.
В-третьих, анализ SVM-RFE был реализован с использованием функции rfe пакета caret36. Количество признаков было установлено в диапазоне от 1 до 10, а для обучения модели применялась 5-кратная перекрестная проверка. В конечном итоге был выбран поднабор генов с оптимальной точностью перекрестной проверки.
Гены, выявленные всеми тремя алгоритмами, были определены как окончательный набор основных генов, связанных со старением и митохондриями при DCM. Затем были построены диагностические модели с использованием 10 алгоритмов классификации: дерева решений, градиентного бустинга, бустированного обобщенного линейного моделирования, метода k-ближайших соседей, логистической регрессии, нейронной сети, метода частичных наименьших квадратов, случайного леса, метода опорных векторов и экстремального градиентного бустинга.
Кривые рабочих характеристик приемника (ROC-кривые) были построены с использованием пакета pROC37. Для оценки диагностической эффективности в обучающей и валидационной выборках были рассчитаны площадь под кривой (AUC), точность, чувствительность и специфичность.
Для расчета вклада каждого основного гена в прогнозы модели был проведен анализ SHapley Additive exPlanations38. Были построены сводные графики и водопадные графики для каждого образца. Окончательная диагностическая модель с площадью под кривой (AUC) более 0,8 в валидационном наборе считалась обладающей хорошей диагностической эффективностью.
9. Анализ межклеточных взаимодействий
Сети межклеточных взаимодействий в микроокружении сердца были реконструированы с помощью пакета CellChat39. Объект CellChat был создан с использованием базы данных CellChatDB.human. Дифференциально экспрессируемые лиганды и рецепторы были определены с помощью функции identifyOverExpressedGenes, а значимые пары взаимодействий были отобраны с помощью функции identifyOverExpressedInteractions.
Вероятности взаимодействия между типами клеток были рассчитаны с помощью функции computeCommunProb. Глобальная сеть взаимодействий на уровне типов клеток была агрегирована с помощью функции aggregateNet. Количество взаимодействий и интенсивность коммуникации между каждой парой типов клеток были количественно определены и визуализированы с помощью тепловых карт и столбчатых диаграмм.
10. Количественная оценка инфильтрации иммунных клеток
Показатели обогащения для 28 типов иммунных клеток были рассчитаны для каждого общего образца с использованием анализа обогащения наборов генов для одного образца28 и набора сигнатурных генов иммунных клеток40. Для сравнения показателей обогащения иммунных клеток между группами с DCM и здоровым контролем использовался критерий суммы рангов Уилкоксона. Значение P < 0,05 считалось статистически значимым.
Для оценки взаимосвязи между уровнями экспрессии основных генов и показателями обогащения иммунными клетками был проведен корреляционный анализ Пирсона. Все корреляции с P < 0.05 считались статистически значимыми.
11. Консенсусная кластеризация для молекулярного субтипирования
Неконтролируемая консенсусная кластеризация образцов DCM была выполнена с использованием профилей экспрессии основных генов посредством пакет ConsensusClusterPlus41Параметры кластеризации были установлены следующим образом: максимальное количество кластеров — 6, количество итераций ресемплирования — 1000, доля ресемплирования — 0,8. Для кластеризации был использован метод разбиения вокруг медиоидов (PAM) с евклидовым расстоянием; для обеспечения воспроизводимости результатов использовалось фиксированное случайное число (seed).
Оптимальное количество подтипов было определено на основании графика дельты площади (delta area plot) и показателей стабильности консенсусного кластера, в результате чего было установлено, что K = 2. Далее был проведен анализ главных компонент для подтверждения четкого разделения двух молекулярных подтипов.
Для расчета показателей обогащения путей KEGG для каждого отдельного образца был применен анализ вариации наборов генов (Gene set variation analysis)42. Для выявления дифференциальной активации путей между подтипами использовался пакет limma27, при этом статистически значимым считалось значение P менее 0,05.
12. Эхокардиографическая оценка сердечной функции
Мышей подвергли анестезии посредством внутрибрюшинно вводили 1% раствор пентобарбитала натрия (30 мг/кг), после чего животное фиксировали в положении на спине на термостатическом операционном столе. После удаления шерсти с грудной клетки на прекордиальную область равномерно наносили ультразвуковой контактный гель.
Эхокардиография в M-режиме под контролем двухмерного изображения проводилась на уровне папиллярных мышц левого желудочка с использованием ультразвуковой системы для мелких животных. Были зарегистрированы три последовательных стабильных сердечных цикла для измерения конечно-диастолического и конечно-систолического диаметров левого желудочка, фракции выброса и фракционного сокращения. Все эхокардиографические исследования проводились профессиональным специалистом по УЗИ в слепом режиме.
Из каждой группы было случайным образом отобрано по три мыши для проведения эхокардиографического исследования; в общей сложности эти 6 животных были впоследствии забиты для сбора тканей миокарда и проведения анализа ELISA. Остальные экспериментальные животные прошли дополнительные параллельные лабораторные исследования, данные которых не были включены в настоящее исследование.
13. Сбор тканей миокарда, экстракция белка и иммуноферментный анализ
После эхокардиографической оценки мышей усыпляли под глубоким наркозом. Ткани сердца быстро извлекали путем срединной торакотомии, и миокард левого желудочка препарировали на льду. Изолированные ткани тщательно промывали ледяным фосфатно-солевым буферным раствором для удаления остатков внутрисердечной крови. После удаления излишков жидкости стерильной фильтровальной бумагой образцы немедленно подвергали шоковой заморозке в жидком азоте и хранили при −80 °C для последующей экстракции белка, строго избегая повторных циклов замораживания-оттаивания.
Замороженные ткани миокарда взвешивали и на льду разрезали на фрагменты размером примерно 1 мм3. Ткани лизировали в ледяном буфере для лизиса RIPA, содержащем ингибиторы протеаз и фосфатаз, в стандартном соотношении 100 µL буфера на 10 mg ткани. Образцы полностью гомогенизировали механически на льду и инкубировали в течение 30 min до достижения полного лизиса клеток.
Лизаты центрифугировали при 12,000 × g в течение 15 мин при 4 °C. Полученные супернатанты собирали в пробирки, не содержащие ферментов, и определяли общую концентрацию белка с помощью набора для белкового анализа с бицинхониновой кислотой согласно протоколам производителя. Все образцы доводили до одинаковой концентрации белка с помощью буфера для лизиса.
Уровни экспрессии белков четырех хаб-генов в лизатах миокарда измеряли с помощью соответствующих наборов для иммуноферментного анализа (ELISA). Серийно разведенные стандарты и нормализованные лизаты тканей добавляли в двух повторах (100 µL на лунку) в предварительно покрытые микропланшеты. Планшеты инкубировали в течение 2 h при комнатной температуре и тщательно промывали промывочным буфером, входящим в состав набора.
В каждую лунку добавляли антитела, конъюгированные с ферментом, и инкубировали в течение 1 h при комнатной температуре, после чего проводили тщательную промывку. Затем добавляли раствор хромогенного субстрата и инкубировали планшеты в течение 20 min при комнатной температуре в темноте. Цветовой реакцию останавливали с помощью стоп-реагента, и значения оптической плотности измеряли при 450 nm (референсная длина волны: 570 nm) с использованием микропланшетного ридера с полным спектром сканирования.
14. Статистический анализ
Весь статистический анализ и визуализация данных были выполнены с использованием R версии 4.2.3. Для измерений концентрации каждого целевого гена (TGFB2, SERPINE1, CYBB, TLR2) методом ELISA сначала применялся тест Шапиро-Уилка для оценки нормальности распределения данных в группах Control и DCM по отдельности. Затем с помощью F-теста оценивалась гомогенность дисперсий между двумя группами. Метод межгруппового сравнения определялся в соответствии с результатами теста на гомогенность дисперсий: если дисперсии были однородными (P ≥ 0.05), для сравнения средних значений между группами использовался непарный t-критерий Стьюдента; если дисперсии были неоднородными (P < 0.05), для анализа применялся скорректированный t-критерий Уэлча. Все тесты были двусторонними, а порог статистической значимости был установлен на уровне P < 0.05. Данные были визуализированы в виде диаграмм размаха («ящиков с усами») с наложением отдельных точек данных. Значения P для всех тестов и тип использованного t-критерия были подробно указаны на каждом графике.
Результаты
Предварительная обработка данных и анализ дифференциальной экспрессии
Все шесть наборов данных общего транскриптома прошли стандартизированную предварительную обработку и коррекцию эффекта серии перед последующим анализом. Данные микрочипов были нормализованы с использованием алгоритма робастного среднего по нескольким массивам (robust multi-array average), в то время как данные подсчетов РНК-секвенирования нормализовали методом усеченного среднего M-значений (trimmed mean of M-values). Для устранения технических эффектов серии, связанных с источником набора данных и платформой детекции, применялся алгоритм ComBat. Анализ главных компонентов показал, что до коррекции образцы группировались по источнику набора данных, но после коррекции распределялись более равномерно, без видимого разделения по сериям.
Анализ дифференциальной экспрессии между группой с дилатационной кардиомиопатией (DCM) и группой здорового контроля (HC) проводили с использованием пакета limma. Тепловая карта 20 наиболее значимо дифференциально экспрессируемых генов продемонстрировала разделение профилей экспрессии между двумя группами (Рисунок 1A). Всего было выявлено 1 473 дифференциально экспрессируемых гена с использованием пороговых значений P value < 0.05 и |log₂ fold change| > 0.58. Из них 819 генов были активированы (upregulated), а 654 — подавлены (downregulated) в образцах миокарда при DCM (Рисунок 1B).
Затем был проведен анализ обогащения наборов генов для одного образца (single-sample gene set enrichment analysis) для расчета показателей обогащения наборов генов, связанных со старением и митохондриями, в каждом образце. Оба показателя существенно различались между группами с DCM и HC (Рисунок 1C).
Взвешенный анализ сетей коэкспрессии генов
Взвешенный анализ сетей коэкспрессии генов был проведен для выявления генных модулей, связанных с показателями старения и обогащения митохондрий. Для построения сети были использованы 5 00 белок-кодирующих генов с наибольшей дисперсией экспрессии в общем наборе данных. При значении мягкого порога β = 5 индекс соответствия безмасштабной топологии превысил R2 = 0,9, что соответствует критерию безмасштабной сети (Рисунок 1D).
Иерархическая кластеризация и объединение модулей позволили выделить три генных модуля. Все три модуля значительно коррелировали с показателем старения. Бирюзовый модуль продемонстрировал наиболее сильную корреляцию с показателем старения (r = 0.69, P < 0.01). Что касается митохондриального показателя, значимая корреляция наблюдалась для синего и серого модулей, при этом наиболее сильная связь была выявлена у синего модуля (r = 0.56, P < 0.01; Рисунок 1E). Таким образом, бирюзовый модуль был выбран для скрининга генов, связанных со старением, а синий модуль — для скрининга генов, связанных с митохондриями.
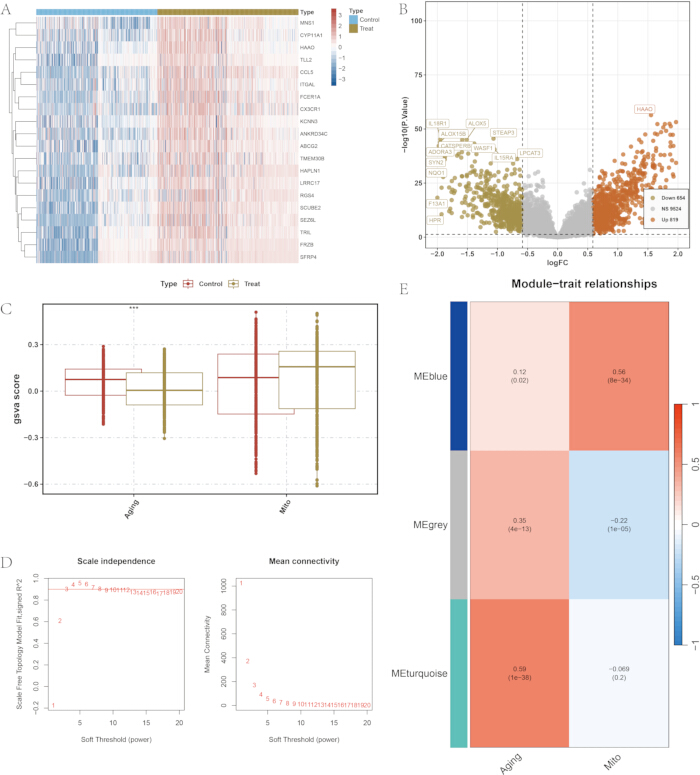
Рисунок 1Анализ дифференциальной экспрессии и построение взвешенной сети коэкспрессии генов. (A) Тепловая карта 20 наиболее значимо дифференциально экспрессируемых генов между группами с дилатационной кардиомиопатией (ДКМ) и здоровым контролем (ЗК). (B) График вулкана (volcano plot) всех дифференциально экспрессируемых генов. Красным цветом обозначены гены с повышенной экспрессией, зеленым — гены с пониженной экспрессией, серым — статистически не значимые гены. Пороговые значения P-value < 0,05 и |log₂ кратности изменения| > 0.58. (C) Диаграммы размаха показателей анализа обогащения наборов генов (GSEA) для отдельных образцов для наборов генов, связанных со старением и митохондриями. (D) Выбор мягкого порога для анализа взвешенных сетей коэкспрессии генов, демонстрирующий индекс соответствия безмасштабной топологии и среднюю связность при различных степенях мягкого порога. (Е) Тепловая карта корреляций между собственными генами модулей и показателями старения и митохондриальной функции. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Идентификация генов-кандидатов, связанных со старением и митохондриями
Гены-кандидаты были определены путем пересечения списков дифференциально экспрессируемых генов, генов в выбранных модулях анализа сетей ко-экспрессии генов с учетом весов и соответствующих референсных наборов генов. В результате этого анализа было выявлено 6 генов-кандидатов, связанных со старением при DCM (Рисунок 2A), и 16 генов-кандидатов, связанных с митохондриями при DCM (Рисунок 2B).
Анализ обогащения генных онтологий (Gene Ontology) показал, что гены-кандидаты, связанные со старением, были обогащены в биологических процессах, включая биосинтез синтазы оксида азота и организацию содержащего коллаген внеклеточного матрикса (Рисунок 2C). Гены-кандидаты, связанные с митохондриями, были обогащены по терминам, связанным с энергетическим обменом митохондрий, включая внутреннюю мембрану митохондрий и дыхательный цепной комплекс (Рисунок 2D).
Анализ с использованием базы данных Kyoto Encyclopedia of Genes and Genomes показал, что кандидатные гены, связанные со старением, были обогащены в сигнальных путях фактора, индуцибельного гипоксией-1, фосфоинозитид-3-киназы — протеинкиназы B и рецептора конечных продуктов гликирования к конечным продуктам гликирования (Рисунок 2E). Кандидатные гены, связанные с митохондриями, были обогащены в таких путях, включая окислительное фосфорилирование (Рисунок 2F).
Различия в паттернах экспрессии 6 потенциальных генов, связанных со старением, между группами с DCM и HC были визуализированы с помощью тепловой карты экспрессии (Рисунок 2G). Паттерны экспрессии 16 потенциальных генов, связанных с митохондриями, были визуализированы с помощью диаграмм размаха (Рисунок 2H).
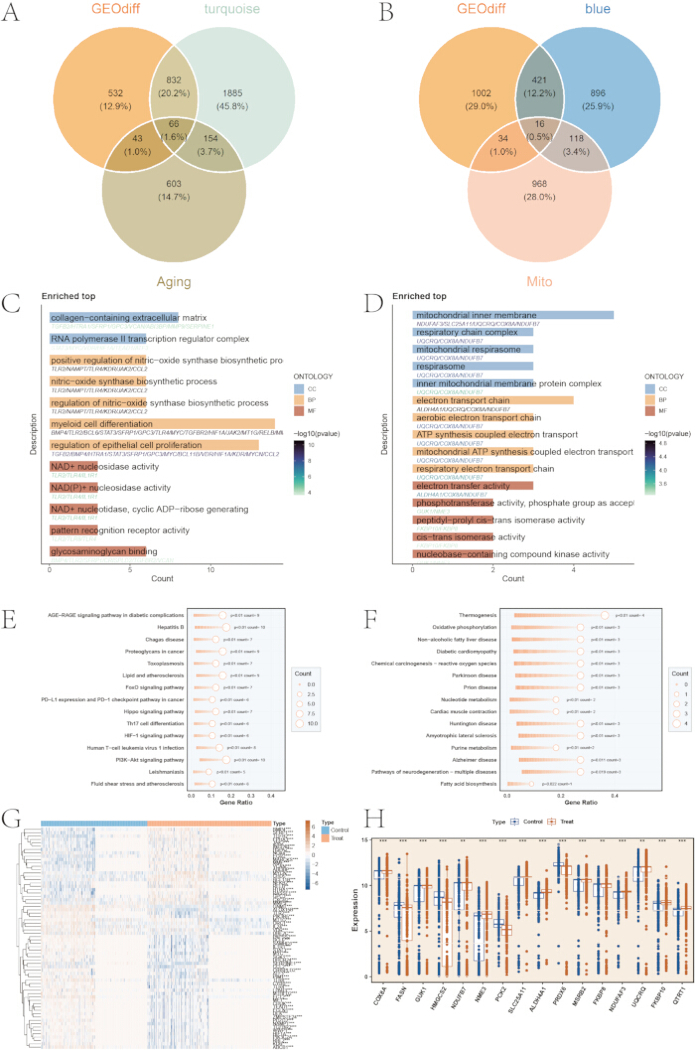
Рисунок 2Скрининг и функциональное обогащение генов-кандидатов. (A) Диаграмма Венна, показывающая пересечение дифференциально экспрессируемых генов, генов модуля анализа сети коэкспрессии генов с учетом весов и эталонного набора генов, связанных со старением. (B) Диаграмма Венна, демонстрирующая пересечение дифференциально экспрессируемых генов, генов модулей анализа сети коэкспрессии генов с учетом весов и набора референсных генов, связанных с митохондриями. (C) Анализ обогащения генных онтологий для генов-кандидатов, связанных со старением. (D) Анализ обогащения генных онтологий для кандидатных генов, связанных с митохондриями. (Е) анализ обогащения путей Kyoto Encyclopedia of Genes and Genomes для кандидатных генов, связанных со старением. (F) анализ обогащения путей Kyoto Encyclopedia of Genes and Genomes для кандидатных генов, связанных с митохондриями. (G) Тепловая карта экспрессии 6 кандидатных генов, связанных со старением, в группах с DCM и HC. (H) Диаграммы размаха экспрессии 16 потенциальных генов-кандидатов, связанных с митохондриями, в группах с ДКМ и в контрольной группе здоровых добровольцев. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Аннотация типов клеток набора данных секвенирования РНК единичных клеток
Набор данных секвенирования РНК единичных клеток GSE145154 был использован для валидации с разрешением до одной клетки. После фильтрации по критериям контроля качества, логарифмической нормализации и коррекции пакетного эффекта с помощью Harmony клетки из разных образцов распределились в пространстве аппроксимации и проекции однородного многообразия без видимого разделения по образцам. С использованием первых 15 главных компонентов и разрешения кластеризации 0,15 клетки были разделены на 9 кластеров (Рисунок 3A).
Канонические маркерные гены и автоматическая аннотация с помощью SingleR позволили идентифицировать 9 основных типов клеток: макрофаги, естественные киллеры, Т-клетки, В-клетки, эндотелиальные клетки, гладкомышечные клетки, моноциты, стромальные клетки и кардиомиоциты (Рисунок 3B). Профили экспрессии специфических для каждого типа клеток маркерных генов подтвердили эти аннотации (Рисунок 3C).
Баллы митохондриального модуля были рассчитаны для каждой клетки с помощью функции AddModuleScore и значительно различались между группами с дилатационной кардиомиопатией и здоровым контролем (P < 2.22 × 10⁻16; Рисунок 3D). Баллы модуля, связанного со старением, также значительно различались между двумя группами (P < 2.2 × 10⁻16; Рисунок 3E). Проекция митохондриальных баллов на пространство одномерного многообразия и проекции (UMAP) показала, что высокие баллы наблюдались преимущественно в кардиомиоцитах (Рисунок 3F). Напротив, высокие баллы, связанные со старением, преобладали в макрофагах (Рисунок 3G).
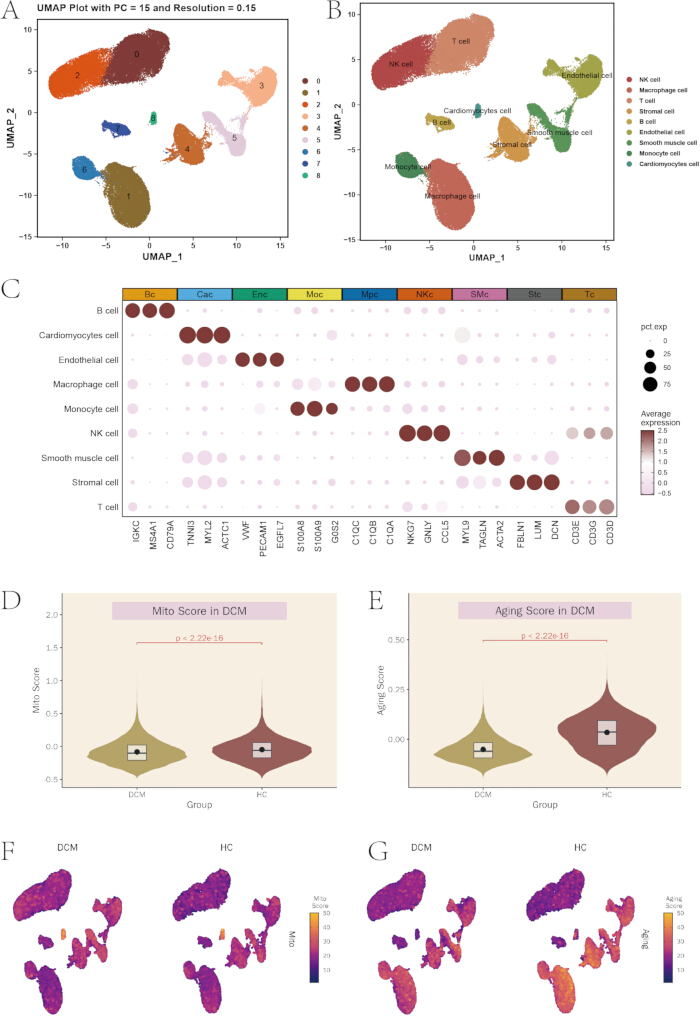
Рисунок 3Аннотация транскриптома единичных клеток и анализ показателей модулей. (A) График однообразного аппроксимационного и проекционного отображения (UMAP) клеточных кластеров, построенный с использованием первых 15 главных компонент и разрешения кластеризации 0,15. (B) График однообразного многообразия аппроксимации и проекции (UMAP) аннотированных типов клеток. (С) Пузырьковая диаграмма, демонстрирующая экспрессию канонических маркеров-генов в различных типах клеток. (D) Скрипичный график показателей митохондриального модуля в группах DCM и HC. (Е) Скрипичный график показателей модулей, связанных со старением, в группах DCM и HC. (F) График одномерного приближения и проекции многообразия (UMAP), демонстрирующий распределение показателей митохондриального модуля по клеткам. (G) График однородного многообразия аппроксимации и проекции (UMAP), демонстрирующий распределение показателей модулей, связанных со старением, по отдельным клеткам. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Построение сети белок-белковых взаимодействий
Объединенный набор из 6 кандидатных генов, связанных со старением, и 16 генов, связанных с митохондриями, был введен в базу данных STRING версии 1.5 для построения сети белок-белковых взаимодействий с использованием порога высокой достоверности комбинированного показателя > 0.7. Сеть была импортирована в Cytoscape для визуализации и топологического анализа (Рисунок 4A).
Для выявления высокосвязанных узлов и основных подсетей использовались анализы степени, центральности максимального клика, максимального компонента окрестности и MCODE. Подсети, выявленные с помощью этих методов, показаны на рисунке 4B–E.
Пересечение списков из 10 наиболее значимых генов, ранжированных по степени (Degree), центральности максимальной клики и максимальному компоненту соседства, с генами в основной подсети MCODE позволило выявить 10 генов-кандидатов: TGFB2, TLR2, SERPINE1, CYBB, KDR, TLR4, HIF1A, CCL2, MMP9 и CXCR2.
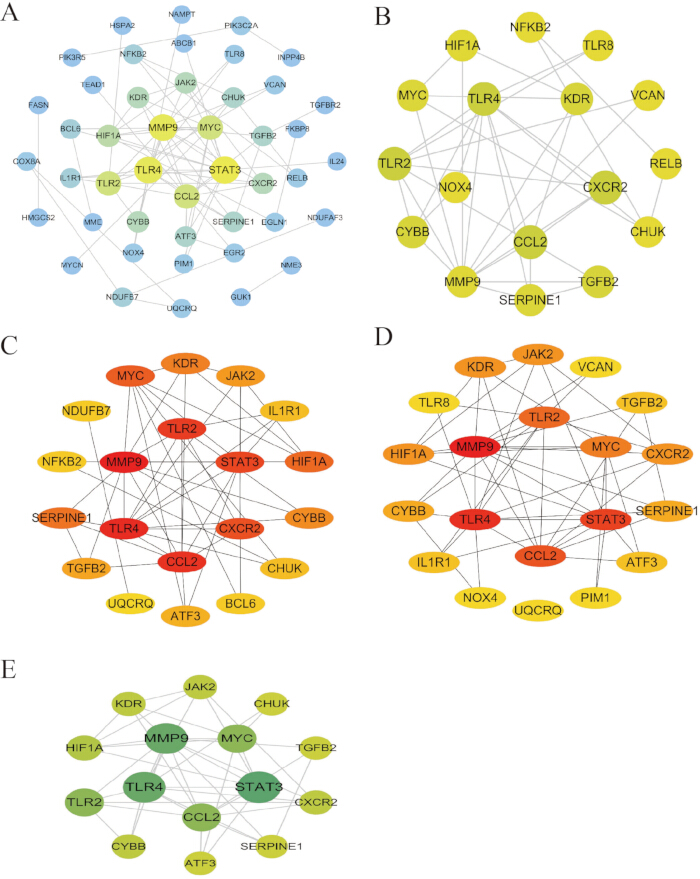
Рисунок 4Построение сети белок-белковых взаимодействий и скрининг генных хабов.
(A) Общая сеть белок-белковых взаимодействий кандидатных генов. (B) Основная подсеть, идентифицированная с помощью MCODE. (С(C) Основная подсеть, определенная с помощью центральности максимальной клики. (D) Основная подсеть, определенная с помощью максимального компонента соседства. (E) Основная подсеть, определенная с помощью степени узла. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Скрининг хабовых генов на основе машинного обучения
Для поиска хабовых генов среди 10 кандидатов, участвующих в белок-белковых взаимодействиях, были применены три алгоритма машинного обучения: логистическая регрессия с методом LASSO (least absolute shrinkage and selection operator), случайный лес (random forest) и рекурсивное исключение признаков на основе метода опорных векторов (support vector machine-recursive feature elimination). Все анализы проводились с использованием фиксированного случайного зерна (set.seed(12345)) и 5-кратной перекрестной проверки. В модели LASSO в качестве кандидатов были сохранены гены с ненулевыми коэффициентами при оптимальном значении лямбда (lambda.min) (Рисунок 5A).
В модели метода опорных векторов с рекурсивным исключением признаков максимальная точность перекрестной проверки 0,859 была достигнута при включении 10 признаков (Рисунок 5B), при этом соответствующий минимальный уровень ошибки составил 0,141 (Рисунок 5C). Модель случайного леса с 50 решающими деревьями продемонстрировала стабильную сходимость уровня ошибки out-of-bag (Рисунок 5D). Ранжирование значимости генов на основе коэффициента Джини позволило отнести TGFB2, TLR2, SERPINE1 и CYBB к числу наиболее значимых генов (Рисунок 5E). Пересечение генов, отобранных всеми тремя алгоритмами, позволило выявить четыре конечных hub-гена: CYBB, SERPINE1, TGFB2 и TLR2 (Рисунок 5F).
Для оценки вклада каждого хабового гена в прогнозы модели был проведен анализ SHapley Additive exPlanations (SHAP). TGFB2 имел наибольшее среднее абсолютное значение SHapley Additive exPlanations, равное 0,249, за ним следовали SERPINE1 с 0,103, CYBB с 0,083 и TLR2 с 0,078 (Рисунок 6A). На сводном графике (summary plot) было показано распределение и направление вклада генов в различных образцах (Рисунок 6B). Графики зависимости (dependence plots) иллюстрировали взаимосвязь между значениями отдельных генов и их вкладом в модель (Рисунок 6C), в то время как водопадные графики (waterfall plots) для каждого образца демонстрировали вклад каждого гена в индивидуальные прогнозы (Рисунок 6D).
Впоследствии были построены диагностические классификационные модели на основе четырех хабовых генов с использованием 10 алгоритмов классификации. В обучающей выборке большинство алгоритмов достигли значений площади под кривой выше 0,85 (Рисунок 6E). В наборе для внутренней валидации большинство алгоритмов достигли значений площади под кривой выше 0,78 (Рисунок 6F).
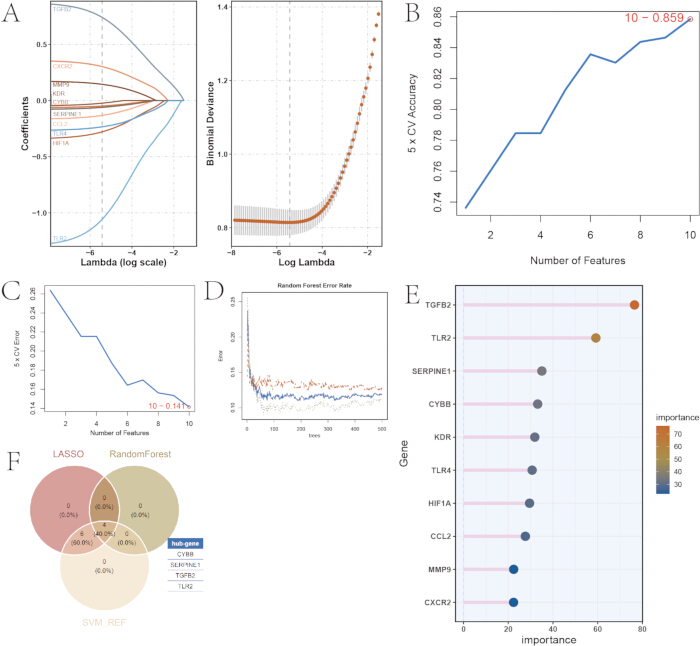
Рисунок 5Скрининг хаб-генов на основе машинного обучения. (A) Траектория коэффициентов регрессии метода LASSO (least absolute shrinkage and selection operator) и выбор оптимального значения лямбда. (B) Кривая точности перекрестной проверки для модели метода опорных векторов с рекурсивным исключением признаков. (C) Кривая ошибки перекрестной проверки для модели метода опорных векторов с рекурсивным исключением признаков. (D) Кривая доли ошибок вне выборки (out-of-bag error rate) для модели случайного леса. (Е) Ранжирование значимости генов на основе коэффициента Джини в модели случайного леса. (F) Диаграмма Венна, демонстрирующая хаб-гены, выявленные тремя алгоритмами машинного обучения. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
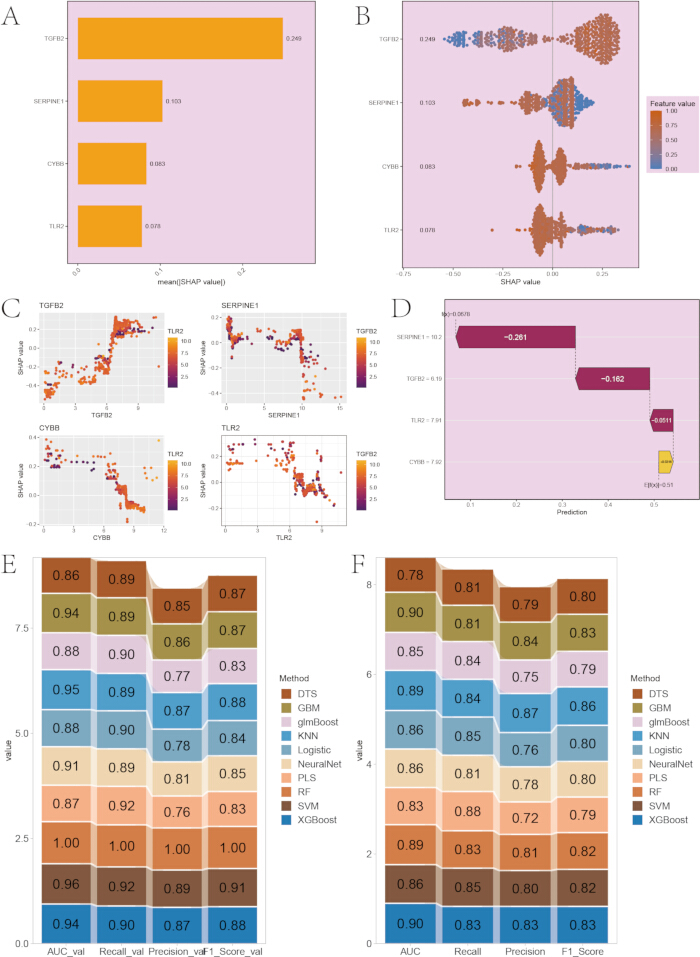
Рисунок 6Оценка диагностической модели и анализ с помощью аддитивных объяснений Шепли (SHapley Additive exPlanations). (A) Средние абсолютные значения SHapley Additive exPlanations для четырех хабовых генов. (B) Сводный график SHapley Additive exPlanations, демонстрирующий распределение и направление вклада генов. (C) графики зависимости SHapley Additive exPlanations для каждого генного хаба. (D) Водопадный график SHapley Additive exPlanations для репрезентативной выборки. (Е) Тепловая карта диагностической эффективности 10 алгоритмов классификации в обучающей выборке. (F) Тепловая карта диагностической эффективности 10 алгоритмов классификации в валидационной выборке. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Валидация на уровне отдельных клеток и анализ межклеточного взаимодействия
Паттерны экспрессии четырех центральных генов были оценены на уровне отдельных клеток. Анализ распределения типов клеток показал, что CYBB и TLR2 высоко экспрессировались в моноцитах и макрофагах, тогда как SERPINE1 и TGFB2 экспрессировались преимущественно в стромальных клетках (Рисунок 7A).
Скрипичные диаграммы показали, что экспрессия CYBB существенно различалась между группами с дилатационной кардиомиопатией и здоровым контролем (Рисунок 7B). Экспрессия SERPINE1 (Рисунок 7C), TGFB2 (Рисунок 7D) и TLR2 (Рисунок 7E) также имела значимые различия между группами. Все четыре гена были значительно активированы в группе с дилатационной кардиомиопатией по сравнению со здоровым контролем, при P < 0.01 для каждого сравнения.
Сети межклеточных взаимодействий в микроокружении сердца были реконструированы с помощью CellChat и базы данных лигандов и рецепторов. Количество и общая интенсивность межклеточных взаимодействий различались между группой с дилатационной кардиомиопатией и контрольной группой (Рисунок 7F). Также наблюдалась дифференциальная интенсивность коммуникации между различными типами клеток (Рисунок 7G). Основными участниками коммуникационной сети были моноциты, макрофаги, кардиомиоциты и стромальные клетки.
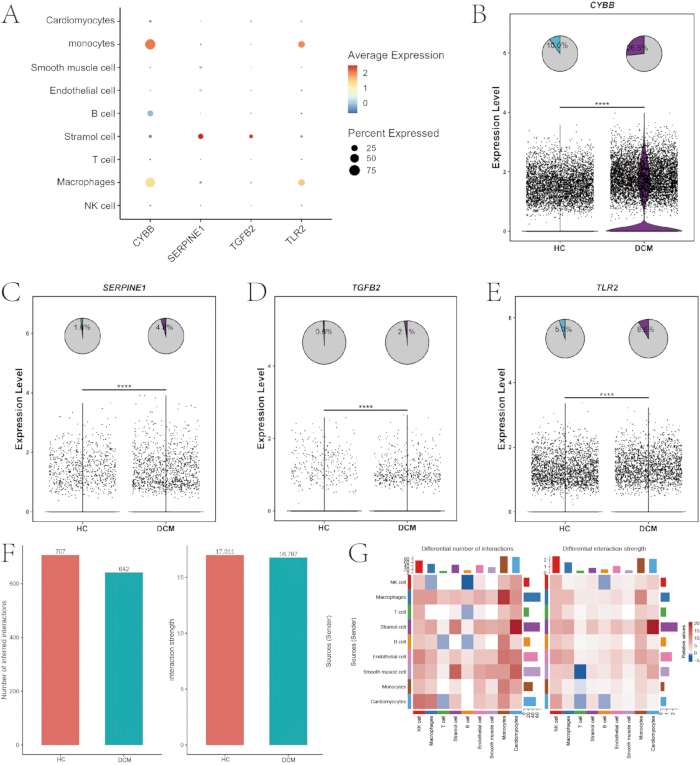
Рисунок 7Валидация хабовых генов на уровне отдельных клеток и анализ межклеточного взаимодействия. (A) Пузырьковая диаграмма, демонстрирующая экспрессию четырех хабовых генов в различных типах клеток. (B) Скрипичный график экспрессии CYBB в группах DCM и HC. (C) Скрипичный график экспрессии SERPINE1 в группах DCM и HC. (D) Скрипичная диаграмма экспрессии TGFB2 в группах с DCM и HC. (Е) Скрипичный график экспрессии TLR2 в группах с DCM и HC. (F) Столбчатая диаграмма, показывающая количество и общую силу межклеточных взаимодействий. (G) Тепловая карта, демонстрирующая различие в интенсивности межклеточного взаимодействия между группами. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Анализ инфильтрации иммунных клеток
Для каждого общего образца (bulk sample) с помощью анализа обогащения наборов генов в одном образце (single-sample GSEA) были рассчитаны показатели обогащения для 28 подмножеств иммунных клеток. Обилие большинства типов иммунных клеток значимо различалось между группами с дилатационной кардиомиопатией и здоровым контролем (Рисунок 8A).
Затем был проведен анализ корреляции Пирсона для оценки взаимосвязи между экспрессией хабовых генов и показателями обогащения иммунными клетками. Экспрессия CYBB была значимо коррелировала с обилием нескольких типов иммунных клеток (Рисунок 8B). Аналогичные корреляции наблюдались для SERPINE1 (Рисунок 8C), TGFB2 (Рисунок 8D) и TLR2 (Рисунок 8E). CYBB, SERPINE1 и TLR2 продемонстрировали положительную корреляцию с несколькими популяциями клеток врожденного иммунитета, включая моноциты и макрофаги.
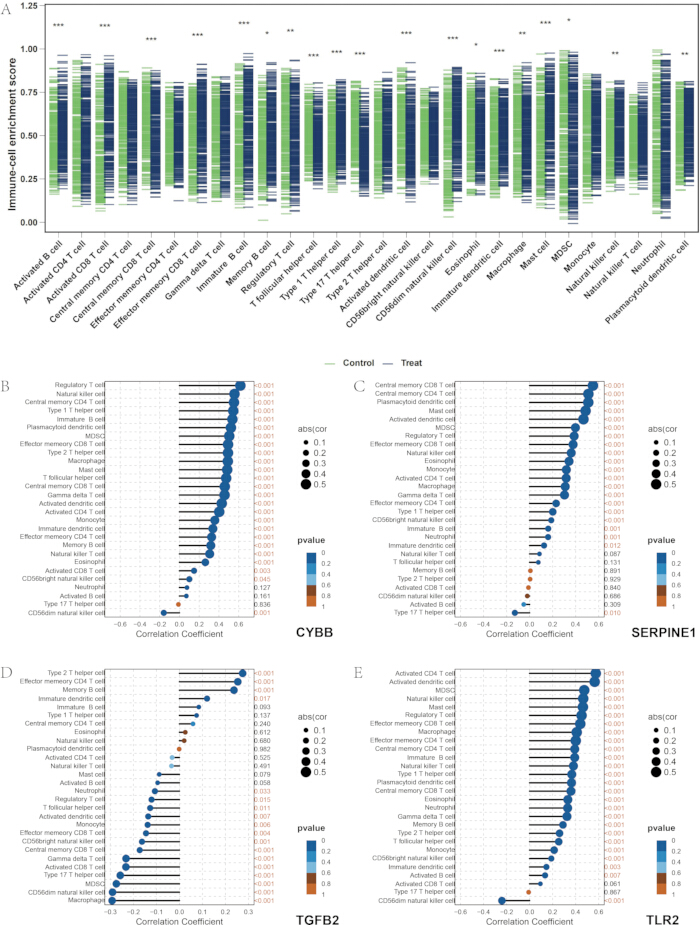
Рисунок 8Инфильтрация иммунными клетками и корреляционный анализ. (A) Диаграммы размаха показателей обогащения для 28 типов иммунных клеток в группах DCM и HC. (B) Диаграмма-леденец, демонстрирующая корреляцию между экспрессией CYBB и численностью иммунных клеток. (C) Диаграмма-леденец, демонстрирующая корреляции между экспрессией SERPINE1 и численностью иммунных клеток. (D) График-леденец, демонстрирующий корреляции между экспрессией TGFB2 и обилием иммунных клеток. (Е) Диаграмма-леденец, демонстрирующая корреляции между экспрессией TLR2 и количеством иммунных клеток. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Молекулярное субтипирование дилатационной кардиомиопатии
Неконтролируемая консенсусная кластеризация образцов с дилатационной кардиомиопатией проводилась на основе профилей экспрессии четырех хабовых генов. Матрица консенсусной кластеризации подтвердила разделение при K = 2 (Рисунок 9A). График изменения площади (delta area plot) дополнительно подтвердил, что K = 2 является оптимальным количеством кластеров, разделяя образцы на два молекулярных подтипа, C1 и C2 (Рисунок 9B).
Уровни экспрессии CYBB, SERPINE1 и TLR2 значительно различались между двумя подтипами (Рисунок 9C). Численность множества подмножеств иммунных клеток также различалась между подтипами (Рисунок 9D). Анализ вариации наборов генов показал относительную активацию сигнального пути фактора роста эндотелия сосудов в подтипе C1, в то время как биосинтез первичных желчных кислот и биосинтез гликосфинголипидов были обогащены в подтипе C2 (Рисунок 9E). Анализ главных компонент показал разделение образцов, отнесенных к двум подтипам (Рисунок 9F).
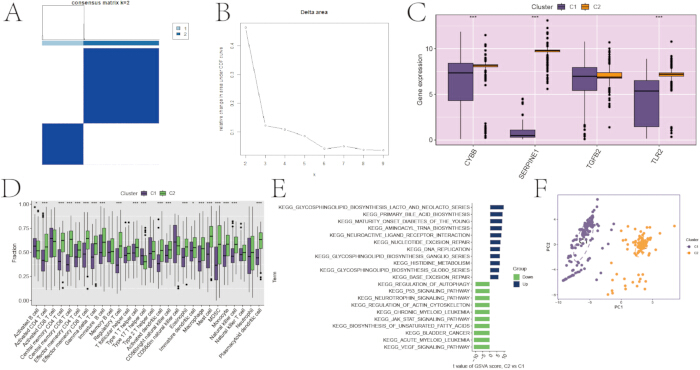
Рисунок 9Консенсусная кластеризация для молекулярного субтипирования дилатационной кардиомиопатии. (A) Матрица консенсусной кластеризации при K = 2. (B) График дельты площадей, используемый для определения оптимального количества кластеров. (C) Диаграммы размаха экспрессии хабовых генов в двух молекулярных подтипах. (D) Диаграммы размаха уровней содержания иммунных клеток в двух молекулярных подтипах. (Е) Тепловая карта дифференциально обогащенных путей Kyoto Encyclopedia of Genes and Genomes между двумя молекулярными подтипами. (F) График анализа главных компонент, демонстрирующий разделение двух молекулярных подтипов. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
In vivo-валидация на мышиной модели дилатационной кардиомиопатии
Для валидации in vivo были использованы трансгенные мыши CTNTR141W со спонтанным фенотипом дилатационной кардиомиопатии. По сравнению с контрольными мышами дикого типа C57BL/6J соответствующего возраста, у трансгенных мышей наблюдалось значительное увеличение конечного диастолического размера левого желудочка и снижение фракции выброса левого желудочка, что соответствует дилатации желудочков и систолической дисфункции (Рисунок 10A).
Общий белок был экстрагирован из тканей миокарда левого желудочка, и концентрации белков, кодируемых четырьмя центральными (hub) генами, были измерены с помощью иммуноферментного анализа (ELISA) после нормализации общего белка методом с бицинхониновым реагентом. Все анализы проводились в дубликатах. Коэффициенты корреляции (R2) стандартных кривых составили ≥ 0,9, а коэффициенты вариации между дубликатными лунками были ниже 10%. Статистическая значимость различий между группами Контроля и DCM оценивалась с помощью t-критерия Стьюдента или t-критерия Уэлча, в зависимости от равенства дисперсий, определенного с помощью F-теста (нормальность распределения была подтверждена тестом Шапиро-Уилка). Уровни белков миокарда, соответствующих всем четырем центральным генам, были значительно повышены у мышей с дилатационной кардиомиопатией (DCM) по сравнению с контрольной группой (Рисунок 10B). Для валидации методом ELISA в каждой группе было использовано 3 биологических повтора (отдельные мыши). Для валидации методом ELISA в каждую группу было включено три независимых биологических повтора. Эти результаты следует считать предварительными; они требуют подтверждения на более крупной когорте.
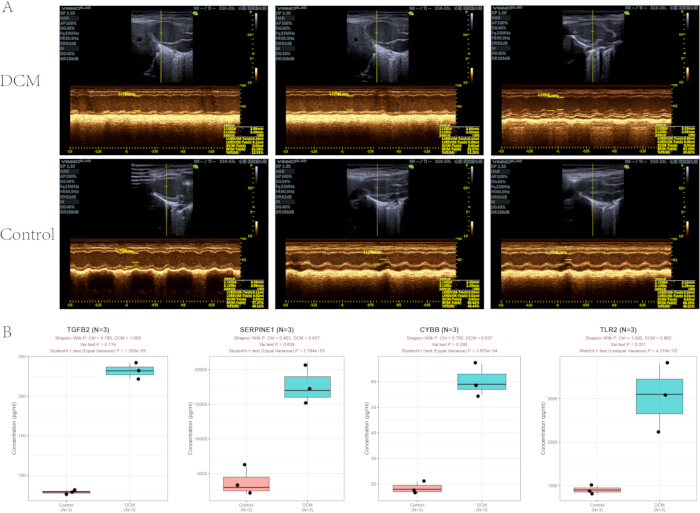
Рисунок 10: In vivo валидация на трансгенной модели дилатационной кардиомиопатии мышей CTNTR141W. (A) Репрезентативные эхокардиографические изображения в M-режиме трансгенных мышей с DCM CTNTR141W и мышей контрольной группы дикого типа. (B) Количественное определение методом ИФА четырех белков, производных от хабовых генов, в тканях миокарда левого желудочка мыши. На диаграммах «ящик с усами» представлены концентрации белков для групп контроля и DCM (n = 3 биологических повтора на группу). Для каждой диаграммы: сплошная горизонтальная линия внутри ящика обозначает медиану; верхняя и нижняя границы ящика представляют 75-й и 25-й перцентили (межквартильный размах, IQR); верхний и нижний «усы» extending до максимального и минимального значений данных, не являющихся выбросами в пределах 1,5 × IQR; отдельные черные сплошные точки соответствуют независимым биологическим повторам от отдельных животных. Ось y указывает абсолютную концентрацию белка: пг/мл для TGFB2 и CYBB, нг/мл для TLR2 и SERPINE1. Статистическое сравнение двух групп проводили с помощью t-критерия Стьюдента (при равной дисперсии) или t-критерия Уэлча (при неравной дисперсии); нормальность распределения проверяли с помощью теста Шапиро-Уилка, а однородность дисперсии — с помощью F-теста. Заявление об ограничениях: результаты ИФА, полученные на n = 3 повторах, являются предварительными поисковыми данными; для их подтверждения в будущем требуется валидация с увеличенным размером выборки. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Доступность данных:
Шесть наборов данных объемного транскриптомного анализа и один набор данных секвенирования РНК единичных клеток, проанализированные в данном исследовании, находятся в открытом доступе в базе данных Gene Expression Omnibus под номерами доступа GSE5406, GSE4295, GSE57338, GSE7962, GSE116250, GSE141910 и GSE145154. Анализ единичных клеток включал образцы GSM4307515, GSM4307516, GSM4307520 и GSM4307521 из набора GSE145154. Все остальные данные, полученные или проанализированные в ходе этого исследования, вместе с вычислительным кодом, представлены в данной опубликованной статье и ее дополнительных информационных файлах. В частности, Дополнительный файл 1 содержит полные списки генов, связанных со старением и митохондриями, иммунную сигнатуру из 28 клеток, специализированные аналитические скрипты, матрицы нормализованных транскриптомных данных, исходные данные для анализов ELISA и необработанные исходные данные, на которых основаны все рисунки рукописи.
Дополнительный файл 1: Наборы генов, связанных со старением и митохондриями, иммунные сигнатуры, скрипты для анализа, нормализованные транскриптомные данные и исходные данные для рисунков. Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Обсуждение
Интегрированный многоуровневый рабочий процесс сочетал в себе метаанализ общих транскриптомных данных, построение взвешенной сети коэкспрессии генов, ансамблевое машинное обучение, валидацию на уровне отдельных клеток и верификацию на животных моделях in vivo. Четыре связанных со старением и митохондриями центральных гена CYBB, SERPINE1, TGFB2 и TLR2 были определены в качестве потенциальных диагностических биомаркеров дилатационной кардиомиопатии (ДКМ). Интеграция шести независимых транскриптомных наборов данных левого желудочка из репозитория Gene Expression Omnibus, включая платформы микрочипов и секвенирования РНК, позволила снизить смещение, характерное для одного набора данных, и расширить статистическую базу анализа43,44,45. Анализ взвешенных сетей коэкспрессии генов в сочетании с предопределенными наборами генов, связанных со старением и митохондриями, позволил выявить функциональные модули, связанные с признаком, вместо того чтобы полагаться исключительно на анализ дифференциальной экспрессии46. Ансамблевое машинное обучение позволило снизить специфическое смещение алгоритмов, связанное с отдельными методами отбора признаков47,48, в то время как анализ SHapley Additive exPlanations позволил количественно оценить вклад каждого центрального гена в прогнозы модели49. Валидация на общих транскриптомах миокарда, транскриптомах отдельных клеток и трансгенной модели мышей позволила дополнительно охарактеризовать клеточное распределение и уровни белков выбранных генов в миокарде50.
Коррекция пакетного эффекта была критически важным этапом интегрированного анализа, поскольку остаточная вариативность, специфичная для набора данных, могла повлиять на анализ дифференциальной экспрессии и ассоциации между модулями и признаками. Поэтому источник набора данных и платформа детектирования были включены в модель ComBat в качестве факторов пакетного эффекта. Остаточная кластеризация в зависимости от набора данных на графиках анализа главных компонентов указывала бы на неполную коррекцию и потенциальную систематическую ошибку44. Параметр мягкого порога также имел важное значение для построения взвешенной сети коэкспрессии генов. Было выбрано минимальное значение, обеспечивающее индекс соответствия безмасштабной топологии R2 > 0.9, что дало β = 5. Более низкое значение может привести к фрагментации или созданию функционально неинформативных модулей, тогда как более высокое значение может ослабить связность генов и снизить статистическую мощность корреляционного анализа «модуль-признак»46. Пороги контроля качества для одноклеточного анализа были адаптированы для сердечной ткани, так как кардиомиоциты обладают высокой метаболической активностью. Для удаления разорванных и низкокачественных клеток при сохранении кардиомиоцитов была внедрена строгая стратегия фильтрации с порогом содержания митохондриальных генов ниже 25% и диапазоном обнаруженных генов от 200–6,00050. Для разделения наборов данных, обучения моделей и кросс-валидации использовалось фиксированное случайное число (seed), заданное как set.seed(12345), чтобы уменьшить вариативность при повторных анализах с применением машинного обучения47.
Подтверждение генотипа, стандартизированные условия содержания и единообразное проведение эхокардиографических измерений имели важное значение для поддержания фенотипической стабильности в экспериментах на животных. У трансгенных мышей CTNTR141W развивается дилатация левого желудочка и систолическая дисфункция после установленного периода акклиматизации и кормления51. Верификация генотипа перед распределением по группам необходима для исключения нетрансгенных животных и предотвращения ошибочной классификации фенотипа. Эхокардиографические измерения следует последовательно проводить на уровне папиллярных мышц левого желудочка, при этом результаты усредняются по трем последовательным стабильным сердечным циклам. Изменение положения при визуализации или глубины анестезии может увеличить вариабельность показателей фракции выброса левого желудочка51. Качество иммуноферментного анализа оценивали по коэффициентам корреляции стандартного графика, R2 ≥ 0,99, и коэффициентам вариации < 10% между дубликатными лунками. Низкая линейность стандартного графика или несоответствие результатов дубликатных измерений могут привести к систематической ошибке при определении концентрации белка.
При реализации рабочего процесса могут возникнуть некоторые аналитические проблемы. Сохраняющееся разделение по партиям после коррекции ComBat может отражать коллинеарность между переменными партий и клиническими факторами, недостаточную фильтрацию генов с низкой экспрессией или неучтенную техническую вариабельность. При наличии соответствующих данных в качестве защищенных переменных могут быть включены клинические ковариаты, такие как возраст и пол, а гены с нулевой экспрессией в более чем 70% образцов могут быть удалены для снижения уровня шума44. В случае сохранения остаточного разделения может быть рассмотрена дополнительная коррекция с помощью removeBatchEffect. Неожиданно большое или малое количество дифференциально экспрессируемых генов может потребовать оценки гетерогенности образцов, нормализации, наличия выбросов и выбора пороговых значений27. Низкая корреляция между модулями и признаками может быть устранена путем пересмотра порога дисперсии, степени мягкого порога (soft-thresholding power) и экстремальных значений признаков. Расширение набора с 5 000 до 7 500 наиболее вариабельных генов или замена анализа обогащения наборов генов для одного образца (single-sample GSEA) анализом вариации наборов генов (GSVA) может улучшить обнаружение модулей46. Избыточное количество изолированных узлов в сети белок-белковых взаимодействий может потребовать корректировки порога достоверности STRING или расширения набора генов-кандидатов30. Низкая эффективность машинного обучения может отражать различия в распределении между обучающей и валидационной выборками, избыточность признаков или дисбаланс групп. Стратифицированная выборка, сокращение избыточных признаков или избыточная выборка (oversampling) миноритарного класса могут уменьшить эти эффекты47. Неоднозначная кластеризация единичных клеток может потребовать пересмотра коррекции Harmony, выбора главных компонентов и аннотации маркерных генов50.
Следует учитывать несколько ограничений. Транскриптомные наборы данных были получены ретроспективно из открытых репозиториев, поэтому контролировать исходный дизайн исследований и клинические искажающие факторы (конфаундеры) было невозможно. Клинические аннотации в наборах данных были неполными, и в большинстве из них отсутствовала детальная информация об этиологии, истории приема лекарственных препаратов, возрасте пациентов и долгосрочных исходах. Эти ограничения не позволили оценить связь между выбранными генами и прогнозом, ответом на лечение или хронологическим старением52. Несмотря на коррекцию пакетного эффекта, может сохраняться остаточная техническая вариабельность. Анализ основывался преимущественно на экспрессии матричной РНК и не включал интегрированные эпигеномные, протеомные или метаболомные данные. Следовательно, активность белков, посттрансляционная регуляция и вышестоящие механизмы не могли быть определены. Был включен только один набор данных секвенирования единичных клеток, что ограничивает оценку клеточной гетерогенности при различных этиологиях DCM50. Трансгенная модель CTNTR141W в основном представляет наследственную форму DCM, связанную с мутацией сердечного тропонина T, и может не воспроизводить идиопатические, вирусные или ишемические формы заболевания51. Межвидовые различия между мышами и людьми также ограничивают прямую клиническую трансляцию. Валидация на уровне белков была ограничена тканями миокарда мышей; не проводились исследования на крупных клинических когортах и сравнения с установленными биомаркерами. Четыре хабовых гена не являются специфичными для DCM и могут быть изменены при других сердечно-сосудистых или воспалительных заболеваниях. Кроме того, отбор кандидатов основывался на заранее определенных наборах генов, связанных со старением и митохондриями. Эта стратегия, основанная на гипотезе, могла исключить гены, не входящие в выбранные эталонные наборы, а поиск пересечений между тремя алгоритмами машинного обучения мог привести к пропуску генов, выявленных только одним методом48.
Данная аналитическая платформа может быть использована в будущих исследованиях по молекулярному субтипированию, валидации биомаркеров и мультиомиксном анализе при DCM. Панель из четырех генов может быть протестирована в независимых когортах образцов периферической крови или миокарда перед ее применением в качестве инструмента диагностики или субтипирования. Субтипы C1 и C2 продемонстрировали различные профили иммунных и метаболических путей, что создает основу для последующей валидации специфических биологических особенностей каждого субтипа15. Выбранные гены также могут быть изучены с помощью молекулярного докинга, а также в клеточных и функциональных исследованиях. TLR2 и CYBB связаны с воспалительной сигнализацией и выработкой активных форм кислорода, в то время как TGFB2 и SERPINE1 связаны с фиброзом и ремоделированием сердца53. Интеграция с данными протеомики, метаболомики, эпигеномики, полногеномного поиска ассоциаций и менделевской рандомизации может помочь в оценке регуляторных взаимосвязей и потенциальных причинно-следственных связей54. Данный рабочий процесс может быть адаптирован для транскриптомных исследований гипертрофической кардиомиопатии, ишемической кардиомиопатии и сердечной недостаточности путем замены специфических для заболевания наборов данных и референсных наборов генов45. Последующее внедрение одноклеточных методов анализа, таких как секвенирование открытого хроматина с помощью транспозазы и пространственная транскриптомика, может предоставить дополнительные сведения о клеточной регуляции и пространственной экспрессии. Наблюдаемое обогащение сигнатурами старения в макрофагах и митохондриальными сигнатурами в кардиомиоцитах согласуется с предыдущими данными о воспалительных и митохондриальных процессах при заболеваниях сердца55,56,57.
Данное исследование имеет несколько ограничений, которые следует учитывать. В частности, коммерческие наборы ELISA, использованные для количественного определения белков, были официально валидированы для обнаружения целевых белков в образцах сыворотки крови. В настоящем исследовании в качестве матрицы для детекции вместо сыворотки были использованы лизаты тканей миокарда. Несмотря на то, что на протяжении всего анализа строго соблюдались единообразные процедуры предварительной обработки образцов и проведения экспериментов для обеспечения надежности и сопоставимости экспериментальных данных, отсутствие официальной валидации данных наборов ELISA производителем для образцов лизатов тканей миокарда может привести к потенциальным незначительным отклонениям в результатах количественного определения белков. Таким образом, применение специфических для сыворотки наборов ELISA к лизатам тканей миокарда представляет собой методологическое ограничение данного исследования.
Раскрытие информации
Автор заявляет об отсутствии конфликта интересов.
Благодарности
Авторы выражают благодарность за предоставление общедоступных данных из базы данных Gene Expression Omnibus. Также выражается благодарность рецензентам и редакторам за их конструктивные замечания к рукописи. Данная работа была поддержана Провинциальным научно-исследовательским проектом департаментского уровня (грант № 2021JDZX2026) по теме «Механизм действия формулы Yiqi Huoxue в ослаблении атеросклеротического ремоделирования сосудов посредством KLF2-Nrf2-опосредованной воспалительной регуляции».
Материалы
| Имя | Компания | Каталожный номер | Комментарии |
|---|---|---|---|
| Ультразвуковой гель Aquasonic Clear | Parker Laboratories, Inc. | Mar-34 | Используется для эхокардиографической визуализации мелких животных. |
| Набор для определения содержания белка методом BCA | Thermo Fisher Scientific | 23227 | Детекция при 562 nm; диапазон 20–2 000 µg/mL; используется для количественного определения общего белка в лизатах сердца мыши. |
| База данных CellAge | Human Ageing Genomic Resources | https://genomics.senescence.info/cells/ | Источник генных сигнатур, связанных со старением. |
| CytoHubba, плагин для Cytoscape | Cytoscape App Store | Версия 0.1 | Используется для оценки топологии узлов в сетях белок-белковых взаимодействий. |
| Cytoscape | Cytoscape Consortium | Версия 3.9.1 | Используется для визуализации сетей белок-белковых взаимодействий. |
| Полноспектральный ридер микропланшетов | Thermo Fisher Scientific | Multiskan FC | Используется для измерения оптической плотности в анализах ELISA. |
| Gene Expression Omnibus | National Center for Biotechnology Information | https://www.ncbi.nlm.nih.gov/geo/ | Публичный репозиторий, используемый для получения транскриптомных наборов данных. |
| GeneCards | Weizmann Institute of Science | https://www.genecards.org/ | Источник наборов генов, связанных с митохондриями. |
| Коктейль ингибиторов протеаз и фосфатаз Halt, 100×, без ЭДТА | Thermo Fisher Scientific | 78441 | Хранить при 4 °C; добавлять в буфер RIPA в концентрации 10 µL/mL непосредственно перед использованием. |
| Жидкий азот | Местный поставщик лабораторных газов | Не применимо | Используется для мгновенного замораживания ткани миокарда. |
| Самцы мышей линии C57BL/6J (класс SPF), возраст 6–8 недель, вес 25 ± 2 g | Beijing Vital River Laboratory Animal Technology Co., Ltd. | Не применимо | Лицензия на производство животных № SCXK (Jing) 2021-0006; использовались в качестве нормального контроля. |
| Самцы трансгенных мышей с DCM (линия CTNTR141W, класс SPF), возраст 6–8 недель, вес 25 ± 2 g | Institute of Laboratory Animal Science, Chinese Academy of Medical Sciences | Не применимо | Лицензия на производство животных № SCXK (Jing) 2021-0065; использовались в качестве спонтанной модели DCM. |
| MCODE, плагин для Cytoscape | Cytoscape App Store | Версия 2.0.2 | Используется для идентификации основных функциональных подсетей в сетях белок-белковых взаимодействий. |
| Набор ELISA для определения CYBB у мышей | Biogradetech | A-QEK09250-96wells | Использовался в данном исследовании для измерения уровня CYBB в лизатах ткани миокарда мыши. |
| Набор ELISA для определения PAI-1 у мышей | EK-BIO | ML30970 | Использовался в данном исследовании для измерения уровня PAI-1 (белка, кодируемого геном SERPINE1) в лизатах ткани миокарда мыши. |
| Набор ELISA для определения TGF-β2 у мышей | ElaBoX | SEKM-0036 | Использовался в данном исследовании для измерения уровня TGF-β2 в лизатах ткани миокарда мыши. |
| Набор ELISA для определения TLR-2 у мышей | Solarbio | SEKM-0163 | Использовался в данном исследовании для измерения уровня TLR-2 в лизатах ткани миокарда мыши. |
| Фосфатно-солевой буфер, pH 7.4, без кальция и магния | Biological Industries | 02-024-1ACS | Стерильный 1× раствор; хранить при 4 °C; используется для промывки тканей и разведения. |
| Пакет R: caret | CRAN | Версия 6.0-94 | Используется для рекурсивного исключения признаков методом опорных векторов. |
| Пакет R: CellChat | Разработчики CellChat | Версия 1.6.1 | Используется для анализа межклеточного взаимодействия на основе данных секвенирования РНК единичных клеток. |
| Пакет R: clusterProfiler | Bioconductor | Версия 4.8.3 | Используется для анализа функционального обогащения. |
| Пакет R: ConsensusClusterPlus | Bioconductor | Версия 1.64.0 | Используется для неконтролируемой консенсусной кластеризации. |
| Пакет R: edgeR | Bioconductor | Версия 3.42.4 | Используется для нормализации данных секвенирования РНК методом усеченного среднего M-значений. |
| Пакет R: GEOquery | Bioconductor | Версия 2.68.0 | Используется для загрузки данных из Gene Expression Omnibus. |
| Пакет R: glmnet | CRAN | Версия 4.1-8 | Используется для логистической регрессии методом LASSO. |
| Пакет R: limma | Bioconductor | Версия 3.56.2 | Используется для анализа дифференциальной экспрессии и статистического моделирования. |
| Пакет R: pROC | CRAN | Версия 1.18.5 | Используется для анализа ROC-кривых. |
| Пакет R: randomForest | CRAN | Версия 4.7-1.2 | Используется для машинного обучения методом случайного леса. |
| Пакет R: Seurat | CRAN | Версия 5.0.1 | Используется для анализа данных секвенирования РНК единичных клеток. |
| Пакет R: SingleR | Bioconductor | Версия 2.2.0 | Используется для автоматической аннотации типов клеток. |
| Пакет R: sva | Bioconductor | Версия 3.48.0 | Используется для коррекции пакетного эффекта методом ComBat. |
| Охлаждаемая центрифуга | Sigma-Aldrich | SIGMA 3-K | Используется для центрифугирования лизатов ткани миокарда. |
| Буфер для лизиса и экстракции RIPA | Thermo Fisher Scientific | 89900 | Готовый к использованию 1× раствор; хранить при 4 °C; перед использованием дополняется ингибиторами протеаз и фосфатаз. |
| Система ультразвуковой визуализации для мелких животных | VINNO Technology Co., Ltd. | VINN06LAB | Используется для эхокардиографической оценки сердечной функции. |
| Пентобарбитал натрия | Sinopharm Chemical Reagent Co. | 20040428 | Приготовлен в виде 1% раствора (10 mg/mL) в стерильном физрастворе; используется для внутрибрюшинной анестезии в дозе 30 mg/kg. |
| База данных STRING | STRING Consortium | Версия 11.5 | Используется для построения сетей белок-белковых взаимодействий. |
| Гомогенизатор тканей TGrinder H24 | TIANGEN | OSE-TH-01 | Используется для гомогенизации ткани миокарда мыши в буфере RIPA при скорости 6.0 m/s в течение 30–60 s в течение 2–3 циклов. |
| Термостатическая платформа для животных / подогреваемый операционный стол для мелких животных | Shanghai Yuyan Scientific Instrument Co., Ltd. | T-30350 | Используется для поддержания температуры тела мышей при 37 °C во время эхокардиографии; рабочий диапазон: от комнатной температуры до 50 °C. |
Ссылки
- Pinto YM et al. Proposal for a revised definition of dilated cardiomyopathy, hypokinetic non-dilated cardiomyopathy, and its implications for clinical practice: a position statement of the ESC working group on myocardial and pericardial diseases. Eur Heart J. 2016;37(23):1850-1858. https://doi.org/10.1093/eurheartj/ehv727
- Newman NA, Burke MA. Dilated Cardiomyopathy: A Genetic Journey from Past to Future. Int J Mol Sci. 2024;25(21):11460. https://doi.org/10.3390/ijms252111460
- Mishra B et al. Tumour necrosis factor-alpha promoter polymorphism and its association with viral dilated cardiomyopathy in Indian population: a pilot study. Indian J Med Microbiol. 2015;33(1):16–20. https://doi.org/10.4103/0255-0857.148368
- Frustaci A et al. Oxidative myocardial damage in human cocaine-related cardiomyopathy. Eur J Heart Fail. 2015;17(3):283-290. https://doi.org/10.1002/ejhf.219
- Ni B et al. The role of β-catenin in cardiac diseases. Front Pharmacol. 2023;14:1157043. https://doi.org/10.3389/fphar.2023.1157043
- Kuwahara K et al. TRPC6 fulfills a calcineurin signaling circuit during pathologic cardiac remodeling. J Clin Invest. 2006;116(12):3114-3126. https://doi.org/10.1172/JCI27702
- He SL et al. Mitochondrial-related gene expression profiles suggest an important role of PGC-1alpha in the compensatory mechanism of endemic dilated cardiomyopathy. Exp Cell Res. 2013;319(17):2604–2616. https://doi.org/10.1016/j.yexcr.2013.07.017
- Luczak ED et al. Mitochondrial CaMKII causes adverse metabolic reprogramming and dilated cardiomyopathy. Nat Commun. 2020;11(1):4416. https://doi.org/10.1038/s41467-020-18165-6
- Li E et al. BMAL1 regulates mitochondrial fission and mitophagy through mitochondrial protein BNIP3 and is critical in the development of dilated cardiomyopathy. Protein Cell. 2020;11(9):661–679. https://doi.org/10.1007/s13238-020-00713-1
- Alila-Fersi O et al. First description of a novel mitochondrial mutation in the MT-TI gene associated with multiple mitochondrial DNA deletion and depletion in family with severe dilated mitochondrial cardiomyopathy. Biochem Biophys Res Commun. 2018;497(4):1049-1054. https://doi.org/10.1016/j.bbrc.2018.02.162
- Ramaccini D et al. Mitochondrial Function and Dysfunction in Dilated Cardiomyopathy. Front Cell Dev Biol. 2020;8:624216. https://doi.org/10.3389/fcell.2020.624216
- Yang J et al. Stem cells in the treatment of myocardial injury-induced cardiomyopathy: mechanisms and efficient utilization strategies. Front Pharmacol. 2025;16:1600604. https://doi.org/10.3389/fphar.2025.1600604
- Van Linthout S et al. State of the art and perspectives of gene therapy in heart failure. A scientific statement of the Heart Failure Association of the ESC, the ESC Council on Cardiovascular Genomics and the ESC Working Group on Myocardial & Pericardial Diseases. Eur J Heart Fail. 2025;27(1):5–25. https://doi.org/10.1002/ejhf.3516
- Alimadadi A, Munroe PB, Joe B, Cheng X. Meta-Analysis of Dilated Cardiomyopathy Using Cardiac RNA-Seq Transcriptomic Datasets. Genes (Basel). 2020;11(1):60. https://doi.org/10.3390/genes11010060
- Verdonschot J et al. Clustering of Cardiac Transcriptome Profiles Reveals Unique Subgroups of Dilated Cardiomyopathy Patients. JACC Basic Transl Sci. 2023;8(4):406–418. https://doi.org/10.1016/j.jacbts.2022.10.007
- Zhu T et al. Identification and Verification of Feature Biomarkers Associated With Immune Cells in Dilated Cardiomyopathy by Bioinformatics Analysis. Front Genet. 2022;13:874544. https://doi.org/10.3389/fgene.2022.874544
- Li H et al. Identification of Centrosome Duplication-Related Biomarkers in Hypertrophic Cardiomyopathy Through Integrative Multi-Omics, Single-Cell Transcriptomics, and Experimental Validation. J Am Heart Assoc. 2026;15(12):e047416. https://doi.org/10.1161/JAHA.125.047416
- Ni L et al. Dissecting and validation the biomarker of heart failure progression in patients with atherosclerosis by single-cell sequencing, bioinformatics, and machine learning. Front Genet. 2025;16:1587274. https://doi.org/10.3389/fgene.2025.1587274
- Barrett T et al. NCBI GEO: archive for functional genomics data sets--update. Nucleic Acids Res. 2013;41(Database issue):D991–D995. https://doi.org/10.1093/nar/gks1193
- Davis S, Meltzer PS. GEOquery: a bridge between the Gene Expression Omnibus (GEO) and BioConductor. Bioinformatics. 2007;23(14):1846-1847. https://doi.org/10.1093/bioinformatics/btm254
- Irizarry RA et al. Exploration, normalization, and summaries of high density oligonucleotide array probe level data. Biostatistics. 2003;4(2):249-264. https://doi.org/10.1093/biostatistics/4.2.249
- Robinson MD, McCarthy DJ, Smyth GK. edgeR: a Bioconductor package for differential expression analysis of digital gene expression data. Bioinformatics. 2010;26(1):139–140. https://doi.org/10.1093/bioinformatics/btp616
- Leek JT et al. The sva package for removing batch effects and other unwanted variation in high-throughput experiments. Bioinformatics. 2012;28(6):882–883. https://doi.org/10.1093/bioinformatics/bts034
- Butler A et al. Integrating single-cell transcriptomic data across different conditions, technologies, and species. Nat Biotechnol. 2018;36(5):411-420. https://doi.org/10.1038/nbt.4096
- Korsunsky I et al. Fast, sensitive and accurate integration of single-cell data with Harmony. Nat Methods. 2019;16(12):1289-1296. https://doi.org/10.1038/s51592-019-0619-0
- Aran D et al. Reference-based analysis of lung single-cell sequencing reveals a transitional profibrotic macrophage. Nat Immunol. 2019;20(2):163-172. https://doi.org/10.1038/s41590-018-0276-y
- Ritchie ME et al. limma powers differential expression analyses for RNA-sequencing and microarray studies. Nucleic Acids Res. 2015;43(7):e47. https://doi.org/10.1093/nar/gkv007
- Barbie DA et al. Systematic RNA interference reveals that oncogenic KRAS-driven cancers require TBK1. Nature. 2009;462(7269):108-112. https://doi.org/10.1038/nature08460
- Yu G et al. clusterProfiler: an R package for comparing biological themes among gene clusters. OMICS. 2012;16(5):284-287. https://doi.org/10.1089/omi.2011.0118
- Szklarczyk D et al. STRING v11: protein-protein association networks with increased coverage, supporting functional discovery in genome-wide experimental datasets. Nucleic Acids Res. 2019;47(D1):D607–D613. https://doi.org/10.1093/nar/gky1131
- Shannon P et al. Cytoscape: a software environment for integrated models of biomolecular interaction networks. Genome Res. 2003;13(11):2498-2504. https://doi.org/10.1101/gr.1239303
- Chin CH et al. cytoHubba: identifying hub objects and sub-networks from complex interactome. BMC Syst Biol. 2014;8(Suppl 4):S11. https://doi.org/10.1186/1752-0509-8-S4-S11
- Bader GD, Hogue CW. An automated method for finding molecular complexes in large protein interaction networks. BMC Bioinformatics. 2003;4:2. https://doi.org/10.1186/1471-2105-4-2
- Friedman J, Hastie T, Tibshirani R. Regularization Paths for Generalized Linear Models via Coordinate Descent. J Stat Softw. 2010;33(1):1-22. https://doi.org/10.18637/jss.v033.i01
- Touw WG et al. Data mining in the Life Sciences with Random Forest: a walk in the park or lost in the jungle. Brief Bioinform. 2013;14(3):315-326. https://doi.org/10.1093/bib/bbs034
- Chicco D. Ten quick tips for machine learning in computational biology. BioData Min. 2017;10:35. https://doi.org/10.1186/s13040-017-0155-3
- Robin X et al. pROC: an open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics. 2011;12:77. https://doi.org/10.1186/1471-2105-12-77
- Lundberg SM et al. From Local Explanations to Global Understanding with Explainable AI for Trees. Nat Mach Intell. 2020;2(1):56-67. https://doi.org/10.1038/s42256-019-0138-9
- Jin S et al. Inference and analysis of cell-cell communication using CellChat. Nat Commun. 2021;12(1):1088. https://doi.org/10.1038/s41467-021-21246-9
- Charoentong P et al. Pan-cancer Immunogenomic Analyses Reveal Genotype-Immunophenotype Relationships and Predictors of Response to Checkpoint Blockade. Cell Rep. 2017;18(1):248–262. https://doi.org/10.1016/j.celrep.2016.12.019
- Wilkerson MD, Hayes DN. ConsensusClusterPlus: a class discovery tool with confidence assessments and item tracking. Bioinformatics. 2010;26(12):1572–1573. https://doi.org/10.1093/bioinformatics/btq170
- Hänzelmann S, Castelo R, Guinney J. GSVA: gene set variation analysis for microarray and RNA-seq data. BMC Bioinformatics. 2013;14:7. https://doi.org/10.1186/1471-2105-14-7
- Zheng Y et al. Exploring Key Genes to Construct a Diagnosis Model of Dilated Cardiomyopathy. Front Cardiovasc Med. 2022;9:865096. https://doi.org/10.3389/fcvm.2022.865096
- Johnson WE, Li C, Rabinovic A. Adjusting batch effects in microarray expression data using empirical Bayes methods. Biostatistics. 2007;8(1):118-127. https://doi.org/10.1093/biostatistics/kxj037
- Koslow M, Mondaca-Ruff D, Xu X. Transcriptome studies of inherited dilated cardiomyopathies. Mamm Genome. 2023;34(2):312-322. https://doi.org/10.1007/s00335-023-09978-z
- Zhang B, Horvath S. A general framework for weighted gene co-expression network analysis. Stat Appl Genet Mol Biol. 2005;4:Article17. https://doi.org/10.2202/1544-6115.1128
- Lin M et al. Machine learning and multi-omics integration: advancing cardiovascular translational research and clinical practice. J Transl Med. 2025;23(1):388. https://doi.org/10.1186/s12967-025-06425-2
- Climente-González H et al. Interpretable machine learning leverages proteomics to improve cardiovascular disease risk prediction and biomarker identification. Commun Med (Lond). 2025;5(1):170. https://doi.org/10.1038/s43856-025-00872-0
- Shah P et al. Predicting cardiovascular risk with hybrid ensemble learning and explainable AI. Sci Rep. 2025;15(1):17927. https://doi.org/10.1038/s41598-025-01650-7
- Chaffin M et al. Single-nucleus profiling of human dilated and hypertrophic cardiomyopathy. Nature. 2022;608(7921):174-180. https://doi.org/10.1038/s41586-022-04817-8
- Juan F et al. The changes of the cardiac structure and function in cTnTR141W transgenic mice. Int J Cardiol. 2008;128(1):83-90. https://doi.org/10.1016/j.ijcard.2008.03.006
- Russell-Hallinan A et al. Single-Cell RNA Sequencing Reveals Cardiac Fibroblast-Specific Transcriptomic Changes in Dilated Cardiomyopathy. Cells. 2024;13(9):752. https://doi.org/10.3390/cells13090752
- Knowlton KU. Dilated Cardiomyopathy. Circulation. 2019;139(20):2339-2341. https://doi.org/10.1161/CIRCULATIONAHA.119.040037
- Smith GD, Ebrahim S. Mendelian randomization: prospects, potentials, and limitations. Int J Epidemiol. 2004;33(1):30-42. https://doi.org/10.1093/ije/dyh132
- Chen R et al. Macrophages in cardiovascular diseases: molecular mechanisms and therapeutic targets. Signal Transduct Target Ther. 2024;9(1):130. https://doi.org/10.1038/s41392-024-01840-1
- Liu R et al. Tead1 is essential for mitochondrial function in cardiomyocytes. Am J Physiol Heart Circ Physiol. 2020;319(1):H89-H99. https://doi.org/10.1152/ajpheart.00732.2019
- Sharma S et al. SOD2 deficiency in cardiomyocytes defines defective mitochondrial bioenergetics as a cause of lethal dilated cardiomyopathy. Redox Biol. 2020;37:101740. https://doi.org/10.1016/j.redox.2020.101740