В данном исследовании представлен RareCode — фреймворк глубокого обучения без учителя, который выявляет аномалии на гистопатологических изображениях колоректального рака путем анализа редкости активации кодовой книги (Codebook Activation Rarity, CAR), что открывает возможности для помощи в предварительном скрининге без использования размеченных обучающих данных.
Исследовательская статья
RareCode: фреймворк глубокого обучения без учителя для обнаружения аномалий на гистопатологических изображениях колоректального рака
В этой статье
Краткое содержание
Аннотация
Неконтролируемое обнаружение аномалий на гистопатологических изображениях широко исследовалось с использованием подходов на основе реконструкции, измеряющих ошибки восстановления, однако эти методы часто не позволяют зафиксировать тонкие патологические изменения на семантическом уровне из-за присущей текстурам тканей неоднородности. Чтобы преодолеть этот недостаток, в данной работе представлен RareCode — фреймворк на основе векторного квантования, который расширяет парадигму обнаружения, выходя за рамки реконструкции на уровне пикселей и включая анализ активации кодовой книги на семантическом уровне. Основным нововведением является оценка редкости активации кодовой книги (Codebook Activation Rarity, CAR), которая профилирует частоту активации каждой записи кодовой книги в процессе обучения исключительно на нормальных образцах и помечает редкие активации как индикаторы аномалий при выводе, дополняя таким образом ошибки реконструкции семантической дискриминацией. На базе этого одномасштабного механизма CAR дополнительно внедрен модуль многомасштабной иерархической кодовой книги (Multi-scale Hierarchical Codebook, MHC), использующий кодовые книги различных размеров с обучаемыми весами слияния для захвата патологических паттернов: от грубых структур на уровне ткани до мелких деталей на клеточном уровне. Благодаря многомасштабному дизайну на каждом уровне гранулярности кодовой книги создаются иерархические тепловые карты аномалий, предоставляя патоморфологам интерпретируемые многомерные визуальные подсказки по локализации, указывающие, где и на каком структурном уровне возникают аномалии. Пятикратная перекрестная проверка на наборе данных гистопатологических изображений колоректального рака с клинической аннотацией, полученном из больницы Шэньчжэня (Shenzhen People's Hospital), демонстрирует, что RareCode достигает площади под кривой (AUC) 96,82%, превосходя базовые методы. Поклассовый анализ показал более высокую эффективность при обнаружении рака (AUC = 99,44%, специфичность = 94,21%), чем при обнаружении воспаления (AUC = 94,30%, специфичность = 60,44%). Эти результаты свидетельствуют о том, что анализ CAR может стать перспективным неконтролируемым подходом для обнаружения аномалий в гистопатологии, потенциально способствуя клиническому предварительному скринингу при диагностике колоректального рака.
Введение
Надежный гистопатологический скрининг колоректального рака по-прежнему ограничен необходимостью экспертной аннотации и ручного анализа, особенно в случаях, когда воспалительные поражения и злокачественные новообразования имеют схожую морфологию1,2. Эти ограничения стимулируют разработку методов обучения без учителя, которые позволяют анализировать нормальные ткани, не требуя при этом исчерпывающего набора аннотаций патологических изменений3,4.
Клиническая необходимость автоматизированного гистопатологического скрининга подчеркивается растущим дисбалансом между спросом на диагностику и доступным опытом патологоанатомов: за одно десятилетие диагностическая нагрузка на одного патологоанатома в США выросла более чем на 40%, в то время как численность персонала продолжала сокращаться5. При колоректальном раке (КРР) организованные программы скрининга были связаны со снижением смертности на 29-68%6, однако возможности ручного патоморфологического анализа остаются ограниченными из-за нехватки специалистов. Автоматизированная система предварительного скрининга, которая надежно выявляет подозрительные случаи для приоритетного анализа, могла бы помочь облегчить эту нагрузку и сократить время получения результатов диагностики. Однако внедрение таких систем требует как высокой чувствительности для предотвращения пропуска истинно положительных случаев, так и достаточной специфичности для исключения чрезмерного количества ложных тревог7.
Неконтролируемое обнаружение аномалий (UAD) становится все более актуальным в анализе медицинских изображений8, поскольку оно позволяет моделировать распределение нормальных тканей, не требуя меток патологий для обучения3,9,10. Модели, основанные на реконструкции, включая автокодировщики, вариационные автокодировщики, генеративно-состязательные сети и варианты с расширенной памятью, выявляют аномалии по ошибкам реконструкции, однако декодеры с большой емкостью все еще могут восстанавливать аномальные области с высокой точностью11,12,13,14,15,16,17. Методы, основанные на признаках, такие как PatchCore и PaDiM, используют предобученные представления, хотя признаки, извлеченные из изображений природного мира, могут не в полной мере отражать микроскопическую атипию в гистопатологии18,19,20,21. Специализированные базовые модели для патологии и детекторы аномалий на основе диффузии представляют собой мощную альтернативу, однако требования к данным или вычислительные затраты могут ограничить их прямое применение в высокопроизводительном скрининге22,23. Современные автоматизированные и эволюционные методы, такие как EvoAAE24 и MoARNN-AM25, дополнительно иллюстрируют ценность адаптивной оптимизации моделей для обнаружения аномалий, хотя контексты их применения отличаются от анализа гистопатологических изображений. В отличие от них, методы на основе векторного квантования (VQ) накладывают дискретные ограничения кодовой книги, что может снизить вероятность идентичного отображения; тем не менее, существующие подходы на базе VQ по-прежнему полагаются преимущественно на пространственные ошибки реконструкции и недостаточно используют семантическую информацию, содержащуюся в паттернах активации кодовой книги26,27.
Хотя вышеупомянутые методы демонстрируют многообещающие результаты в общих областях, их применение к сложным гистопатологическим сценариям сталкивается с определенными трудностями. Гистопатологические изображения характеризуются сложной гетерогенностью тканей на нескольких структурных уровнях28. На практике анализ изображений обычно проводится на локальных патчах, извлеченных из срезов тканей, а патологоанатомический диагноз по своей сути носит многомасштабный характер: патологоанатомы оценивают морфологию желез и тканей при малом увеличении, одновременно изучая ядерный плеоморфизм и фигуры митоза при большом увеличении29. Мы выделяем три основных ограничения современных подходов: во-первых, патологические аномалии и нормальные ткани обладают высоким сходством низкоуровневых визуальных признаков, таких как стиль окрашивания и локальная текстура, из-за чего методы, основанные на реконструкции, оказываются неспособны обнаруживать едва заметные аномалии, так как как нормальные, так и аномальные образцы могут демонстрировать схожее качество реконструкции на семантическом уровне. Во-вторых, большинство существующих методов используют одномасштабное извлечение признаков, что затрудняет одновременный захват аномальных признаков как на тканевом, так и на клеточном уровнях30,31. В-третьих, хотя основные методы позволяют генерировать тепловые карты на уровне пикселей, они часто не могут интуитивно отобразить иерархические атрибуты аномалий, что ограничивает полезность таких моделей в качестве средств клинической диагностики.
Для решения вышеуказанных проблем мы предлагаем RareCode — фреймворк для обнаружения аномалий (UAD), который исследует паттерны активации кодовой книги и иерархическое представление признаков на нескольких уровнях абстракции. Фреймворк включает три основных компонента: (1) механизм оценки редкости активации кодовой книги (Codebook Activation Rarity, CAR), который вычисляет показатели редкости на основе частоты активации записей, обученных исключительно на нормальных образцах, что позволяет отличать нормальные образцы от аномальных на семантическом уровне и предоставляет дополнительные дискриминационные сигналы по сравнению с традиционными ошибками пространственной реконструкции. (2) Архитектуру слияния многомасштабной иерархической кодовой книги (Multi-scale Hierarchical Codebook, MHC), которая фиксирует патологические признаки на разных уровнях детализации — от грубых структурных паттернов до детальных клеточных особенностей — за счет использования кодовых книг с различной емкостью, при этом адаптивное слияние достигается с помощью обучаемых весов. (3) Модуль иерархической интерпретируемой локализации, который использует многомасштабную архитектуру для генерации тепловых карт аномалий с разной степенью детализации, предоставляя патоморфологам многомасштабные семантически интерпретируемые диагностические ориентиры.
Основная гипотеза данного исследования заключалась в том, что профили частоты активации кодовых книг, полученные из кодовых книг, обученных исключительно на нормальных гистопатологических изображениях колоректального рака, будут кодировать семантическую информацию, релевантную для выявления аномалий, помимо ошибки реконструкции на уровне пикселей, и что многомасштабная интеграция этих дополняющих друг друга сигналов улучшит дифференциацию изображений, содержащих раковые или воспалительные ткани, от нормальных изображений по сравнению с репрезентативными методами UAD, что оценивалось преимущественно по показателю AUC. Для проверки этой гипотезы мы оценили работу RareCode с использованием 5-кратной перекрестной проверки на клинически аннотированном наборе данных CRC, а также провели абляционный анализ и анализ локализации для изучения вклада и интерпретируемости его основных компонентов.
Протокол
Настоящее исследование было одобрено Комитетом по этике клинических исследований Шэньчжэньского муниципального's Hospital (номер одобрения: LL-KY-2025300-01). Этический комитет освободил от требования предоставления информированного согласия, поскольку данное ретроспективное исследование использовало существующие гистопатологические изображения и клинические материалы без прямого контакта с пациентами и вмешательства в их лечение. Все клинические данные и гистопатологические изображения были деперсонализированы до анализа, и в ходе исследования не использовалась никакая персонально идентифицируемая информация. Все данные, использованные в исследовании, обрабатывались в соответствии с этическими стандартами институциональных и национальных исследовательских комитетов.
Обзор платформы
Общая архитектура предложенной рамочной платформы UAD, RareCode, показана на Рисунок 1Фреймворк использует параллельную двухветвевую архитектуру. Для каждого входного изображения размером 512 × 512 извлекаются неперекрывающиеся патчи размером 32 × 32 и 64 × 64 в качестве входных данных мелкого и крупного масштаба соответственно. Патчи размером 64 × 64 изменяют размер до 32 × 32 перед подачей в сеть, чтобы обе ветви имели одинаковый размер входных данных для энкодера-декодера, сохраняя при этом различные рецептивные поля. Энкодеры каждой ветви отображают извлечённые признаки в латентное пространство, где модуль MHC накладывает ограничения на дискретизацию. Затем декодеры восстанавливают изображение из квантованных признаков для вычисления ошибок восстановления в пространственной области. Механизм CAR оценивает степень семантической аномалии путём анализа частот активации кодовой книги. Наконец, модель объединяет оценки восстановления и оценки CAR с помощью взвешенной комбинации для получения оценок аномалий на уровне изображения. Фреймворк RareCode обучается «с конца до конца» только на нормальных образцах, не требуя аннотаций аномалий. Двухветвевая архитектура была использована для захвата как локальных клеточных признаков, так и более крупных структур желез. Модуль MHC применялся для моделирования этих признаков с помощью кодовых книг различной ёмкости.
Архитектура кодировщик-декодировщик
RareCode создает структурно независимые кодировщики и декодировщики для ветвей мелкого и крупного масштаба. Каждая ветвь использует один и тот же дизайн кодировщика-декодировщика, но не разделяет параметры. Кодировщик состоит из четырех сверточных блоков, каждый из которых включает свертку 3 × 3, нормализацию по пакетам, функцию активации ReLU и dropout. Количество каналов увеличивается от 64 до 128, затем до 256, а конечная карта признаков преобразуется в одномерный вектор и проецируется в 64-мерное латентное представление. Декодировщик зеркально повторяет структуру кодировщика и включает полносвязный проекционный слой, за которым следуют четыре слоя транспонированной свертки, восстанавливающие каждый фрагмент до исходного размера входных данных сети. Ошибка реконструкции вычисляется как среднеквадратичная ошибка между входными и реконструированными фрагментами. Комбинируя эту архитектуру кодировщика-декодировщика с дискретными ограничениями кодовой книги, RareCode обучается компактным представлениям нормальной ткани и измеряет отклонения в ходе инференса.
Многоуровневый иерархический кодобук
Для фиксации патологических признаков на нескольких уровнях абстракции—от широких тканевых паттернов до локализованных клеточных вариаций—модуль MHC использует K дискретных кодовых книг  с различной ёмкостью н1, n2, ..., nKВ окончательной конфигурации FourScales каждая ветвь содержит четыре кодовые книги с 64, 128, 256 и 512 элементами соответственно, причём каждый элемент кодовой книги представляет собой 64-мерное встраивание. Для каждого закодированного признака фрагмента ближайший элемент кодовой книги выбирается на основе евклидова расстояния. Квантованные выходы из различных кодовых книг затем объединяются с использованием обучаемых весов, нормализованных по кодовым книгам. Предполагается, что более мелкие кодовые книги, из-за более сильных ограничений сжатия, кодируют обобщённые типичные паттерны, игнорируя локальные вариации, тогда как более крупные кодовые книги сохраняют детализированные признаки, отражающие более специфические структурные особенности. Для каждой кодовой книги
 , где ek(i)
 Rd обозначает i-й вектор встраивания в k-м кодовом книге, непрерывные признаки отображаются в дискретное пространство кодовой книги посредством поиска ближайшего соседа (уравнение 1 и 2):
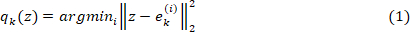

Для достижения адаптивного объединения многомасштабных признаков мы вводим обучаемые веса. После нормализации с помощью softmax выполняется взвешенное суммирование квантованных выходов из каждого кодбука (уравнение 3):
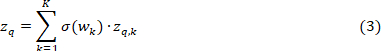
где σ(·) обозначает функцию softmax, гарантирующую, что веса удовлетворяют условию Σk σ(wk) = 1. Такая конструкция позволяет модели автоматически корректировать доли участия кодовых таблиц на различных уровнях детализации в зависимости от семантического содержания входных признаков.
Для оптимизации обучения кодовой книги мы используем стандартную функцию потерь векторного квантования (уравнение 4):
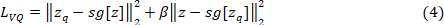
где sg[·] обозначает операцию остановки градиента, и β = 0,25 — это коэффициент веса потери привязанности. Первый член способствует смещению векторов кодовой книги в сторону выходных данных энкодера, в то время как второй член способствует сохранению согласованности выходных данных энкодера с соответствующими векторами кодовой книги. Полный механизм многомасштабного векторного квантования (VQ) проиллюстрирован в Рисунок 2.
Оценка редкости активации кодов
CAR оценивает аномалии на семантическом уровне на основе статистики активации кодовой книги, оценённой по нормальным обучающим выборкам. После обучения модели все нормальные обучающие изображения были пропущены через энкодер и модуль MHC без увеличения данных. Для каждой ветви и каждой кодовой книги был зафиксирован индекс назначения каждого признака участка, а также подсчитано количество назначений каждому элементу кодовой книги. Полученные значения подсчитывания затем нормализовали, чтобы получить распределение частоты активации для данной кодовой книги (уравнение 5):

На этапе вывода каждое тестовое изображение обрабатывалось с использованием одной и той же процедуры извлечения фрагментов, кодирования и присвоения ближайшего соседа из кодовой книги. Для каждой присвоенной записи кодовой книги значение редкости рассчитывается как отрицательный логарифм частоты её активации в обучающей выборке нормальных образцов (уравнение 6):

где ε является небольшой константой, используемой для численной устойчивости. Таким образом, элемент кодовой книги низкой частоты получает более высокий показатель редкости, что указывает на меньшую согласованность соответствующего признака участка с изученным распределением нормальной ткани. Показатели редкости на уровне участков усреднялись в пределах каждого изображения и по ветвям мелкого и крупного масштабов для получения отклика редкости на уровне изображения.
Для дополнения редкости по частоте активации мы также вычисляем оценку расстояния на основе процентильной квантизации (уравнение 7):
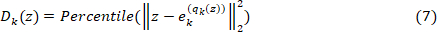
Этот показатель рассчитывается на основе евклидова расстояния между каждым закодированным вектором признаков и ближайшим элементом кодовой книги. Распределение расстояний оценивается по нормальным обучающим образцам, а расстояния тестовых образцов преобразуются в процентильные баллы. Более высокие процентильные баллы указывают на то, что закодированный признак труднее представить с помощью изученных прототипов нормальной кодовой книги.
Окончательный показатель CAR объединяет редкость активации и расстояние квантования по всем кодовым книгам с использованием обучаемых весов кодовых книг (уравнение 8):
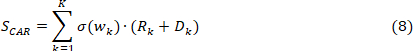
Те же нормализованные веса кодовой книги, которые используются для объединения признаков на нескольких масштабах, применяются также при объединении на уровне оценок, что обеспечивает согласованность между обучением представлений и оценкой аномалий. Результирующий показатель CAR рассчитывается на уровне изображения, после чего объединяется с показателем реконструкции для получения окончательного показателя аномалии. Общий механизм оценки CAR проиллюстрирован на Рисунок 3.
Окончательное вычисление показателя аномалии
Мы объединяем ошибки реконструкции в пространственной области с оценками CAR на семантическом уровне. Перед объединением обе оценки отдельно нормализуются с использованием мини-макс-нормализации на основе перцентилей, чтобы уменьшить влияние экстремальных выбросов. Окончательная аномальная оценка на уровне изображения определяется следующим образом (уравнение 9):
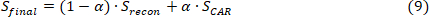
где Sрекон обозначает нормированную среднеквадратичную ошибку реконструкции, отражающую качество реконструкции образца в пиксельном пространстве; SCAR является оценкой CAR, описанной выше, которая отражает степень семантического отклонения. Гиперпараметр α [0,1] регулирует относительное взвешивание между двумя компонентами, причём оптимальные значения определяются на валидационных наборах данных.
Цель обучения
Фреймворк RareCode обучается сквозным способом с использованием только нормальных образцов. Общая функция потерь при обучении включает следующие компоненты (уравнение 10):

Каждый термин определяется следующим образом: Потеря реконструкции: 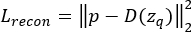 , измеряя среднеквадратичную ошибку между входными участками p и реконструированные участки D(zq) после квантования. Эта потеря применяется отдельно к 32 × 32 патч-ветвь (
 ) и 64 × 64 patch branch
 для обеспечения эффективного обучения признакам на обоих пространственных масштабах.
Описание набора данных
Для оценки RareCode были проведены эксперименты на клинически аннотированном наборе гистопатологических изображений РРК, включающем изображения срезов ткани толстой кишки, окрашенных гематоксилином и эозином (H&E)&E), полученный из Шэньчжэньского народа's Больницы. Все изображения в этом наборе данных получены из реальных клинических случаев. Изображения были оцифрованы при увеличении 40x с исходным разрешением 1024 × 1024 пикселей. Для обеспечения надежности и качества аннотаций все метки категорий образцов совместно проверялись и подтверждались двумя или более старшими профессиональными патологоанатомами в соответствии с протоколом двойного слепого исследования.
На основании гистопатологических характеристик набор данных был разделён на три класса: нормальная ткань (1226 изображений), рак (1215 изображений) и воспаление (1214 изображений). В условиях бинарной задачи обнаружения аномалий (UAD) образцы рака и воспаления рассматривались как аномальные, а нормальные образцы служили опорным распределением. Такая постановка задачи отражает целевую задачу сортировки — разделение случаев, требующих дополнительного патологического анализа, от тех, которые морфологически нормальны.
Все H&Изображения, окрашенные с помощью E, были изменены до размера 512 × 512 пикселей перед использованием в качестве входных данных сети. Для оценки использовали стратифицированное перекрёстное валидирование с пятью фолдами. В каждом фолде нормальные образцы сначала разделяли на обучающую, валидационную и независимую тестовую подвыборки. RareCode обучали только на нормальных образцах обучающей подвыборки. Валидационную подвыборку, в которую также входили только нормальные образцы, использовали для выбора модели, настройки гиперпараметров и определения веса объединения αКонтрольный набор данных, состоящий из незнакомых нормальных образцов и образцов с аномалиями, включая рак и воспаление, использовался исключительно для окончательной оценки эффективности и не применялся при обучении модели, подборе гиперпараметров или α выборке. Представительные категории, структура набора данных и протокол проверки показаны в Рисунок 4.
Детали реализации
Предложенный фреймворк RareCode и базовые методы сравнения были реализованы с использованием PyTorch. Все эксперименты проводились на рабочей станции, оснащённой одним графическим процессором NVIDIA GeForce RTX 4060 Ti (16 ГБ). Для конфигурации архитектуры сети, с целью извлечения признаков на различных пространственных масштабах, двухветвевая архитектура обрабатывает неперекрывающиеся фрагменты на двух масштабах: 32 × 32 пикселя (меньшее поле рецепции, фиксирующее локальные текстурные паттерны) и 64 × 64 пикселя (более крупное поле восприятия, охватывающее более широкий пространственный контекст) соответственно. Размерность непрерывного встраивания признаков, формируемая кодировщиками обеих ветвей, единообразно установлена равной 64. В модуле MHC мы настраиваем по четыре кодовые книги с разной ёмкостью для каждой ветви, с количеством дискретных прототипов 64, 128, 256 и 512 соответственно.
В ходе оптимизации сеть обучалась сквозным способом в течение 50 эпох с размером пакета 8. Для обновления весов мы используем оптимизатор AdamW с начальной скоростью обучения 5 × и коэффициент регуляризации весов выбраны так, чтобы предотвратить переобучение. Кроме того, для обеспечения плавной сходимости обучения использовался график понижения скорости обучения по косинусоидальному закону, что позволило достичь более точной оптимизации на последних этапах обучения. Размеры фрагментов и размеры кодовых книг были подобраны с учётом баланса между представлением на нескольких масштабах и вычислительными затратами. Окончательная конфигурация FourScales была обоснована анализом исключения компонентов, и α был выбран на контрольной выборке до оценки на тестовой выборке.
Для анализа влияния сложности декодера был реализован вариант с комплексным декодером на основе конфигурации FourScales. Данный вариант использовал одинаковый разбиение данных, размеры кодовых книг, количество эпох обучения, оптимизатор, скорость обучения, основанную на валидации α выбора и метрик оценки, как модель FourScales. Базовый декодер был заменён на декодер в стиле EMCAD, содержащий блоки свёртки с несколькими масштабами и модули внимания к свёрточным блокам (CBAM). После каждого из первых трёх этапов апсемплирования с транспонированной свёрткой — параллельные 3 × 3, 5 × 5 и 7 × Было применено 7 свёрток по глубине, за которыми следовала 1 × 1 точечное объединение, пакетная нормализация, активация ReLU, остаточное соединение и внимание CBAM. CBAM включает канальное внимание на основе дескрипторов среднего и максимального пулинга и пространственное внимание с использованием 7 × 7 свёрток. Заключительный этап использовал транспонированную свёртку и сигмоидальную активацию для реконструкции 32 × 32 патча.
Результаты
Сравнение с базовыми методами
Для оценки фреймворка RareCode в качестве базовых методов были выбраны несколько репрезентативных методов UAD, охватывающих методы на основе реконструкции (CAE32, VAE12, SAE33, MAE34, PatchSAE35), реконструкцию с дополненной памятью (MemAE36), дистилляцию знаний (STFPM37), генерацию синтетических аномалий (DRAEM38) и извлечение предварительно обученных признаков (PatchCore18). Выбор базовых методов был сосредоточен на подходах, которые могут быть обучены или применены при сопоставимых вычислительных затратах и предположениях о данных (доступ только к неразмеченным нормальным обучающим образцам), что гарантирует, что различия в производительности отражают методологический вклад, а не разницу в масштабе данных для предварительного обучения. Для обеспечения справедливого сравнения все методы оценивались с использованием одних и тех же 5-кратных разделений данных, конвейера предобработки, метрик оценки и вычислительной среды. Модели обучались в соответствии с одним и тем же протоколом UAD, используя только нормальные обучающие образцы, при этом гиперпараметры и пороги выбирались на валидационном наборе, а окончательная производительность оценивалась только на отдельном тестовом наборе. В Таблице 1 обобщены результаты 5-кратной кросс-валидации, а на Рисунке 5 представлены сравнения на многомерных лепестковых диаграммах.
Как показано в Таблице 1 и на Рисунке 5, RareCode обеспечивает высокую эффективность детектирования и статистическую стабильность на наборе данных CRC. С точки зрения AUC, RareCode (96,82 ± 0,23%) превосходит несколько базовых моделей, основанных на реконструкции, включая MemAE (94,97 ± 0,81%). Статистический анализ подтверждает, что RareCode превосходит все базовые модели на основе реконструкции (парные t-критерии, p < 0,05), при этом улучшение по сравнению с MemAE достигает статистической значимости (p < 0,01). RareCode демонстрирует низкую вариативность показателей (стандартное отклонение 0,23%), что указывает на стабильность при перекрестной проверке. Ограниченная эффективность DRAEM, основанного на синтетических аномалиях, вероятно, отражает тот факт, что простые стратегии наложения текстур не могут адекватно имитировать сложные патологические атипии.
Что касается специфичности, RareCode достигает 58.24 ± 5.99%, превосходя все сравниваемые методы в снижении частоты ложноположительных результатов. Это представляет собой улучшение примерно на 25 процентных пунктов по сравнению с базовым уровнем только реконструкции (NoCAR, 33.76%), что демонстрирует вклад механизма CAR в снижение количества ложноположительных срабатываний. Более низкая специфичность STFPM и PatchCore, которые полагаются на признаки, предобученные на естественных изображениях, может частично отражать разрыв в доменах между естественными и гистопатологическими изображениями. Примечательно, что STFPM и DRAEM демонстрируют высокую вариативность специфичности (±33.53% и ±7.09%), при этом специфичность для каждого фолда варьируется от почти нулевого до умеренного уровня, что вызывает опасения относительно надежности их применения.
Эффективность детектирования по классам
Анализ по классам проводился путем раздельного сравнения образцов с раком и воспалением с нормальными образцами (Таблица 2). RareCode продемонстрировал более высокую эффективность при детектировании рака (AUC = 99.44 ± 0.12%, полнота = 98.13 ± 0.29%, специфичность = 94.21 ± 2.22%), чем при детектировании воспаления (AUC = 94.30 ± 0.44%, полнота = 96.55 ± 0.78%, специфичность = 60.44 ± 4.34%). Эти результаты позволяют предположить, что RareCode может обеспечивать более выраженную дискриминацию злокачественных новообразований, чем воспалительных изменений, в то время как граница между воспалением и нормой, по-видимому, вносит существенный вклад в снижение общей специфичности.
Абляционное исследование
Для изучения вклада ключевых компонентов структуры RareCode были проведены абляционные эксперименты по оценке влияния механизма CAR и модуля MHC на эффективность детектирования. Результаты подробно представлены в Таблице 3. Как показано на Рисунке 6A, добавление CAR к базовой модели, использующей только реконструкцию, повысило AUC с 92,81% до 95,92%, а многомасштабное слияние кодовых книг (codebook fusion) привело к дальнейшему увеличению AUC до 96,82%. На Рисунке 6B видно, что CAR также повысил специфичность, увеличив ее с 33,76% в базовой модели NoCAR до 58,24% в полной модели FourScales. Эти результаты подтверждают взаимодополняющую значимость редкости активации кодовых книг и многомасштабного слияния.
Кроме того, было проведено исследование влияния сложности декодера (абляция) с использованием конфигурации FourScales. Как показано в Таблице 3, вариант с комплексным декодером, содержащим многомасштабные блоки глубинной свертки и модули внимания сверточного блока (CBAM), продемонстрировал более низкое значение AUC по сравнению с базовой моделью FourScales (95,17 ± 0,44% против 96,82 ± 0,23%). Этот результат говорит о том, что в рамках данной настройки RareCode на базе VQ-AE увеличение мощности декодера не привело к улучшению эффективности обнаружения аномалий и может снизить эффективность представления с ограниченным кодовым словарем.
Иерархический анализ пространственного отклика
Для изучения пространственных откликов, генерируемых RareCode, ошибки реконструкции на уровне патчей и карты редкости кодовой книги были агрегированы на уровне изображений и сравнены между нормальными и аномальными образцами. Для количественной оценки разделения откликов на уровне изображений использовались отношение энергии, d Коэна и AUC. Подробные результаты представлены в Таблице 4, на Рисунке 7 и Рисунке 8.
Результаты показывают, что показатели редкости кодовой книги на всех масштабах демонстрируют повышение отклика на аномальных образцах (отношение энергии > 1). Кодовые книги меньшей емкости (Codebook 64) обеспечивают более сильную дискриминацию на уровне локализации (AUC 78,79%), что согласуется с ожиданием того, что более высокие степени сжатия способствуют изучению более абстрактных прототипных паттернов, которые более чувствительны к отклонениям от архетипов нормальной ткани. Одна только ошибка реконструкции обеспечивает значительную способность к выявлению аномалий (AUC 93,31%), в то время как показатели CAR дают дополнительные сигналы из измерения семантической частоты.
Качественный анализ Рисунка 7 показал, что повышенный отклик в образцах рака совпадал с наличием неправильных и скученных желез, увеличением ядер, гиперхромией, псевдостратификацией и потерей полярности эпителия. В воспалительных образцах более сильный отклик наблюдался вокруг деформированных крипт и плотных инфильтратов воспалительных клеток. Кодовые книги меньшей емкости имели тенденцию к захвату более широких архитектурных отклонений, тогда как кодовые книги большей емкости давали более локализованные ответы на клеточном уровне. Эти результаты обеспечивают качественную морфологическую интерпретацию, но не являются валидацией на уровне пикселей.
Анализ параметров слияния
Вес слияния α балансирует вклад ошибки пространственной реконструкции и показателя CAR в итоговый показатель аномалий. Оптимальные значения α для каждого фолда были определены с помощью поиска по сетке (шаг 0.05) на валидационных наборах; результаты представлены в Таблице 5 и Рисунке 9. Оптимальные значения α в основном сосредоточены в диапазоне 0.85-0.95 при среднем значении 0.90 ± 0.05. При оптимальных конфигурациях модель достигает среднего значения AUC 96.82 ± 0.23% на тестовых наборах. Более высокие оптимальные веса (приблизительно 0.90) указывают на то, что показатели CAR вносят больший вклад в окончательное детектирование, чем ошибка реконструкции, в то время как ошибка реконструкции обеспечивает дополнительные локальные ограничения. По сравнению с настройкой α = 0 в анализе чувствительности (AUC = 93.29%), выбранная на этапе валидации настройка слияния улучшила AUC примерно на 3.53 процентных пункта.
Подводя итог, в данной работе представлен фреймворк RareCode для обучения без учителя при детектировании аномалий на гистопатологических изображениях, целью которого является смягчение проблемы тождественного отображения (identity-mapping), характерной для традиционных генеративных моделей. Механизм CAR снижает чрезмерную зависимость от ошибок реконструкции на уровне пикселей, в то время как модуль MHC обеспечивает иерархические представления признаков на различных уровнях детализации, что позволяет осуществлять взаимодополняющую дискриминацию аномалий на разных уровнях абстракции. Эксперименты на наборе данных CRC демонстрируют, что RareCode достигает значения AUC 96,82%, при этом анализ по классам показывает эффективное детектирование рака (AUC = 99,44%) и более сильную дискриминацию рака по сравнению с воспалением, что указывает на то, что перекрытие признаков воспаления и нормы остается основной проблемой. Исследования с абляционным анализом подтверждают, что интеграция дискретных семантических признаков VQ с многомасштабными морфологическими представлениями тканей повышает эффективность детектирования. Высокая полнота (recall = 98,40%) и умеренная специфичность (58,24%) RareCode указывают на его потенциал в качестве инструмента предварительного скрининга для приоритизации подозрительных гистопатологических изображений; однако его реальное влияние на рабочую нагрузку патологоанатомов потребует проспективной оценки рабочего процесса.
Доступность данных:
Набор данных гистопатологических изображений CRC, использованный в данном исследовании, был получен из больницы Шэньчжэня (Shenzhen People's Hospital) при наличии одобрения институционального комитета по этике (номер одобрения LL-KY-2025300-01). В связи с соблюдением конфиденциальности пациентов и политикой учреждения по обмену данными, набор данных не находится в открытом доступе. Доступ может быть предоставлен по обоснованному запросу к автору, ответственному за переписку, при условии одобрения институтом и заключения соглашений об использовании данных. Исходный код платформы RareCode доступен в открытом доступе по адресу https://github.com/XL-alg/RareCode.
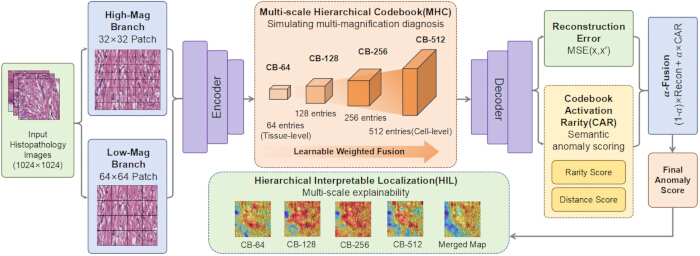
Рисунок 1Общая архитектура и поток данных платформы RareCode. A 512 × 512 H&Гистопатологическое изображение, окрашенное гематоксилином и эозином, разделено на 32 неперекрывающихся × 32 и 64 × 64 патча в качестве входных данных с мелким и крупным масштабом. Две ветви кодируют патчи в латентные эмбеддинги, применяют дискретизацию с использованием многомасштабного иерархического кодового словаря (MHC) и реконструируют патчи для вычисления показателей ошибки реконструкции. Параллельно механизм редкости активации кодового словаря (CAR) оценивает семантическую редкость на основе профилей частоты активации кодового словаря, полученных при обучении на нормальных образцах. Затем нормализованные показатели реконструкции и CAR объединяются для генерации итогового показателя аномальности на уровне изображения, в то время как отклики на уровне патчей проецируются обратно на плоскость изображения для иерархической локализации. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
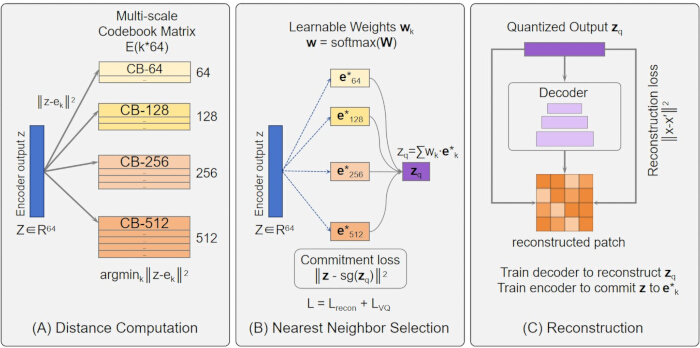
Рисунок 2: Механизм многомасштабного векторного квантования. (A) Вычисление расстояния между выходными признаками энкодера и векторами вложения книги кодов. (B) Выбор ближайшего соседа и взвешенное слияние по книгам кодов с емкостью 64, 128, 256 и 512. (C) Реконструкция из квантованных признаков с помощью транспонированного сверточного декодера. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
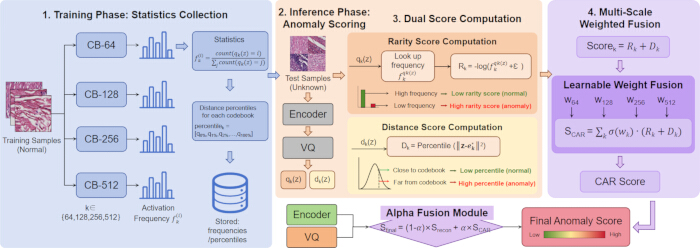
Рисунок 3: Механизм оценки CAR. На данном рисунке проиллюстрированы четыре этапа: Этап 1: статистика частоты активации вычисляется исключительно на нормальных обучающих выборках. Этап 2: тестовые образцы получают индексы активации и расстояния с помощью кодировщика и векторного квантования. Этап 3: показатели редкости и показатели расстояния вычисляются на основе профилей частоты обучающего набора. Этап 4: показатели из каждой шкалы кодовых книг объединяются с помощью обучаемых весов для получения итогового показателя CAR. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
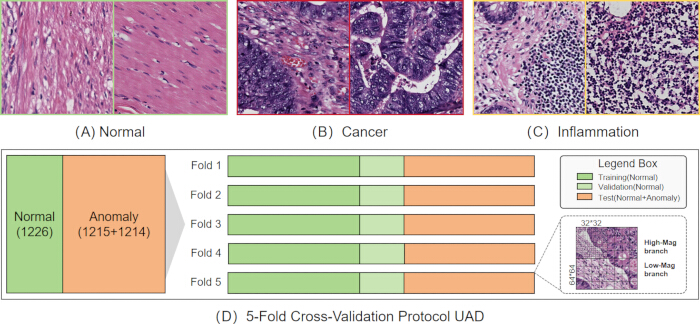
Рисунок 4Состав набора данных по КРР и протокол эксперимента. (A–C) Репрезентативный H&Гистопатологические изображения нормальной ткани толстой кишки, колоректального рака и воспаления толстой кишки, окрашенные гематоксилином и эозином. (D) Протокол 5-кратной перекрестной проверки для UAD, в котором нормальные образцы использовались для обучения и валидации, а отдельные нормальные и аномальные образцы — для тестирования. Изображения были оцифрованы при 40-кратном увеличении и разделены на патчи размером 32 x 32 и 64 x 64 пикселя. Зеленый, светло-зеленый и оранжевый цвета обозначают обучающую, валидационную и тестовую выборки соответственно. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
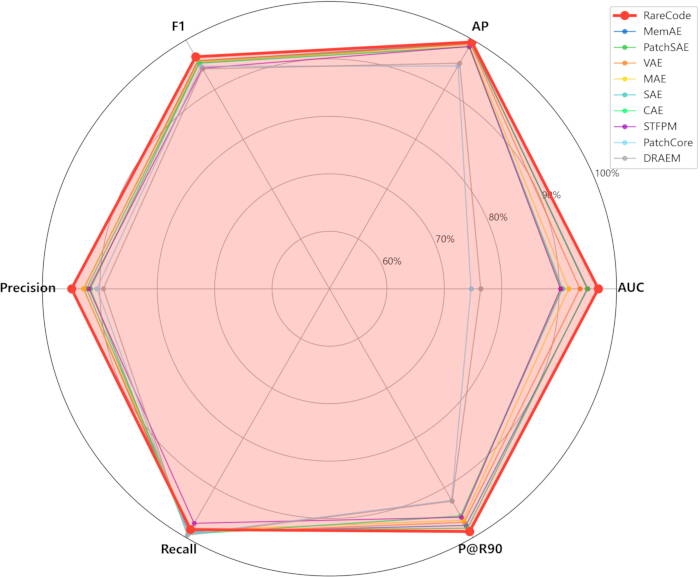
Рисунок 5: Радарная диаграмма многометрического сравнения методов обнаружения аномалий. Радарная диаграмма, сравнивающая RareCode с базовыми методами по показателям AUC, средней точности (AP), F1-меры, точности (precision), полноты (recall) и точности при полноте 90% (P@R90). Все значения представляют собой среднюю производительность по результатам 5-кратной перекрестной проверки. Пожалуйста, нажмите здесь, чтобы просмотреть этот рисунок в большем размере.
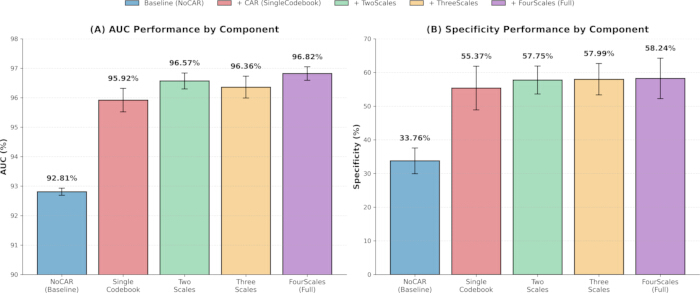
Рисунок 6: Анализ инкрементального вклада компонентов исследования абляции. (A) Сравнение показателей AUC, демонстрирующее постепенное улучшение от базового варианта с использованием только реконструкции (NoCAR) до конфигураций с одним кодовым словарем и многомасштабных конфигураций. (B) Сравнение показателей специфичности, демонстрирующее влияние механизма CAR на снижение количества ложноположительных результатов. Все планки погрешностей представляют собой стандартное отклонение (SD) при 5-кратной перекрестной проверке. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
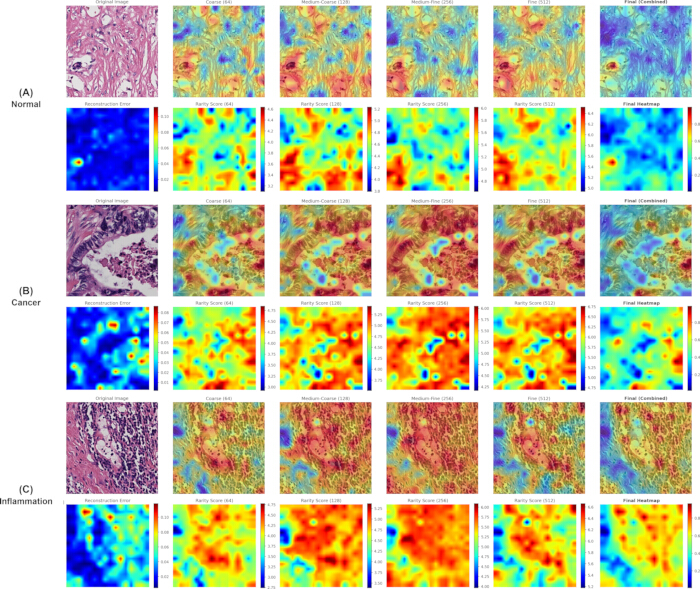
Рисунок 7: Тепловые карты иерархической локализации многомасштабного кодового словаря. Представлены репрезентативные примеры для образцов (A) нормы, (B) рака и (C) воспаления. Каждый ряд включает исходное изображение, наложение, карту ошибки реконструкции, карты показателей редкости из кодовых словарей разной емкости (64, 128, 256 и 512) и итоговую совмещенную карту локализации. Кодовые словари меньшей емкости выделяют крупнозернистые паттерны за счет более сильной компрессионной абстракции, в то время как кодовые словари большей емкости сохраняют более тонкие структурные детали. Области с высоким откликом качественно соответствуют гистопатологическим признакам рака или воспаления, однако они не были валидированы с помощью экспертных аннотаций на уровне пикселей. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
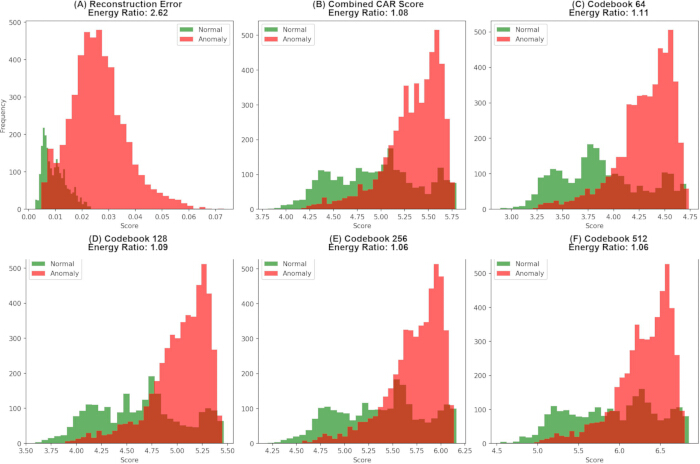
Рисунок 8: Гистограммы распределения различных типов показателей. На гистограммах представлено сравнение распределения показателей для нормальных и аномальных образцов для (A) ошибки реконструкции, (B) комбинированного показателя CAR, (C) Codebook 64, (D) Codebook 128, (E) Codebook 256 и (F) Codebook 512. Зеленые и красные гистограммы соответствуют нормальным и аномальным образцам соответственно. Пожалуйста, нажмите здесь, чтобы просмотреть этот рисунок в большем размере.
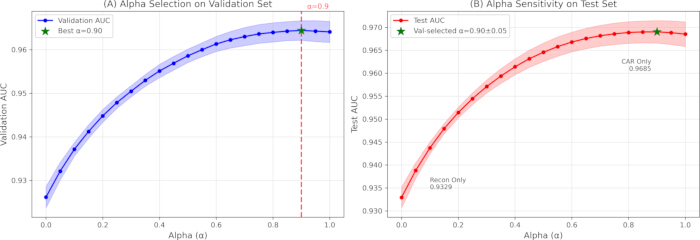
Рисунок 9: Анализ чувствительности параметра альфа. (A) AUC валидационного набора, использованный для выбора α. (B) AUC тестового набора при различных значениях α. Выбранные по валидационному набору значения α варьировались от 0.85 до 0.95 со средним значением 0.90 ± 0.05, что согласуется с Таблицей 5. Вариация AUC оставалась ниже 0.5% при изменении α в диапазоне [0.70, 1.00], что указывает на стабильную эффективность в широком диапазоне параметров. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
| Метод | AUC (%) | AP (%) | F1 (%) | Точность (%) | Полнота (%) | Специфичность (%) | P@R90 (%) |
| CAE | 90.37 ± 0.94 | 98.62 ± 0.18 | 95.34 ± 0.15 | 91.64 ± 0.40 | 99.35 ± 0.22 | 28.14 ± 3.88 | 95.66 ± 0.32 |
| SAE | 90.58 ± 0.94 | 98.66 ± 0.18 | 95.34 ± 0.15 | 91.67 ± 0.40 | 99.32 ± 0.24 | 28.46 ± 3.97 | 95.71 ± 0.30 |
| VAE | 93.60 ± 0.82 | 99.13 ± 0.12 | 95.86 ± 0.19 | 92.81 ± 0.49 | 99.12 ± 0.29 | 39.07 ± 4.70 | 96.94 ± 0.43 |
| MAE | 91.65 ± 2.75 | 98.76 ± 0.50 | 95.61 ± 0.60 | 92.87 ± 1.56 | 98.55 ± 0.55 | 39.74 ± 14.32 | 96.55 ± 0.97 |
| MemAE | 94.97 ± 0.81 | 99.35 ± 0.11 | 95.78 ± 0.33 | 92.82 ± 1.07 | 98.95 ± 0.60 | 39.15 ± 9.99 | 97.57 ± 0.33 |
| PatchSAE | 94.86 ± 0.36 | 99.34 ± 0.05 | 95.39 ± 0.13 | 92.32 ± 0.27 | 98.67 ± 0.12 | 34.91 ± 2.57 | 98.13 ± 0.24 |
| STFPM | 90.23 ± 3.05 | 98.70 ± 0.44 | 94.32 ± 0.21 | 91.90 ± 3.51 | 97.14 ± 3.38 | 29.82 ± 33.53 | 95.93 ± 1.96 |
| DRAEM | 76.34 ± 2.82 | 95.34 ± 0.90 | 94.19 ± 0.07 | 89.39 ± 0.65 | 99.56 ± 0.65 | 6.19 ± 7.09 | 92.69 ± 0.57 |
| PatchCore | 74.64 ± 1.82 | 94.76 ± 0.55 | 94.73 ± 0.05 | 90.52 ± 0.15 | 99.36 ± 0.12 | 17.49 ± 1.54 | 92.54 ± 0.15 |
| RareCode | 96.82 ± 0.23 | 99.59 ± 0.03 | 96.63 ± 0.15 | 94.93 ± 0.67 | 98.40 ± 0.48 | 58.24 ± 5.99 | 98.80 ± 0.10 |
Таблица 1: Результаты сравнения с базовыми методами (5-кратная перекрестная проверка). Эффективность обнаружения RareCode и девяти базовых методов UAD на наборе данных CRC. Метрики включают AUC, среднюю точность (AP), полноту, специфичность, F1-меру, точность при полноте 90% (P@R90) и точность. Все значения представляют собой среднее значение ± SD по результатам 5-кратной перекрестной проверки. Жирным шрифтом выделены лучшие показатели для каждой метрики.
| Категория | AUC (%) | AP (%) | F1 (%) | Полнота (%) | Специфичность (%) |
| Рак | 99.44 ± 0.12 | 99.86 ± 0.03 | 98.34 ± 0.17 | 98.13 ± 0.29 | 94.21 ± 2.22 |
| Воспаление | 94.30 ± 0.44 | 98.48 ± 0.12 | 93.44 ± 0.29 | 96.55 ± 0.78 | 60.44 ± 4.34 |
Таблица 2: Эффективность детектирования по классам для различных подтипов аномалий. Отдельная оценка эффективности детектирования RareCode для образцов с раком и воспалением по сравнению с нормальными образцами. Метрики по классам, включая AUC, AP, F1-score, полноту (recall) и специфичность, были рассчитаны с использованием оптимальных пороговых значений для каждого класса.
| Вариант | Конфигурация кодовой книги | CAR (химерный антигенный рецептор) | AUC (%) | АП (%) | F1 (%) | Специфичность (%) | P@R90 (%) |
| NoCAR |  | | 92.81 ± 0.12 | 99.05 ± 0.02 | 95.30 ± 0.08 | 33.76 ± 3.82 | 96.72 ± 0.12 |
| Единый кодовый словарь | [256] |  | 95.92 ± 0.40 | 99.47 ± 0.05 | 96.25 ± 0.14 | 55.37 ± 6.51 | 98.31 ± 0.43 |
| Две шкалы | [128, 512] | | 96.57 ± 0.27 | 99.56 ± 0.04 | 96.45 ± 0.12 | 57.75 ± 4.14 | 98.75 ± 0.12 |
| ThreeScales | [128, 256, 512] | | 96.36 ± 0.37 | 99.53 ± 0.05 | 96.52 ± 0.17 | 57.99 ± 4.65 | 98.60 ± 0.23 |
| FourScales | [64, 128, 256, 512] | | 96.82 ± 0.23 | 99.59 ± 0.03 | 96.63 ± 0.15 | 58.24 ± 5.99 | 98.80 ± 0.10 |
| FourScales + комплексный декодер | [64, 128, 256, 512] | | 95.17 ± 0.44 | 99.39 ± 0.06 | 95.32 ± 0.20 | 53.83 ± 21.45 | 98.40 ± 0.37 |
Таблица 3: Результаты анализа вклада компонентов (абляционного исследования). Сравнение эффективности конфигураций RareCode при последовательном добавлении компонентов: базовый вариант только с реконструкцией (NoCAR), CAR с одним кодовым словарем (SingleCodebook) и многомасштабные конфигурации (TwoScales, ThreeScales, FourScales). Также включен дополнительный анализ влияния сложности декодера с использованием конфигурации FourScales. Метрики включают AUC, среднюю точность (AP), F1-меру, специфичность и точность при полноте 90% (P@R90).
| Тип оценки | Коэффициент энергии | d Коэна | AUC (%) |
| Ошибка реконструкции | 2.623 | 2.006 | 93.31 |
| Комбинированный CAR | 1.078 | 1.002 | 74.85 |
| Codebook 64 | 1.109 | 1.207 | 78.79 |
| Codebook 128 | 1.085 | 1.067 | 76.19 |
| Codebook 256 | 1.065 | 0.916 | 72.80 |
| Codebook 512 | 1.064 | 0.833 | 70.38 |
Таблица 4: Анализ ответов на уровне изображений, полученных на основе локализации. Среднеизображенческая ошибка реконструкции и ответы на редкость книги кодов сравнивались между нормальными и аномальными образцами с использованием отношения энергии, d-коэфициента Коэна и AUC.
| Складывание | Оптимальный α | Val AUC (%) | Тестовая AUC (%) |
| 1 | 0.95 | 96.22 | 96.91 |
| 2 | 0.9 | 96.38 | 96.39 |
| 3 | 0.85 | 96.71 | 96.82 |
| 4 | 0.85 | 96.22 | 96.93 |
| 5 | 0.95 | 96.72 | 97.05 |
| Среднее значение | 0.90 ± 0.05 | 96.45 ± 0.23 | 96.82 ± 0.23 |
Таблица 5: Оптимальные значения альфа по всем фолдам. Оптимальный вес слияния альфа, определенный с помощью сеточного поиска (шаг 0,05) на валидационных наборах для каждого фолда перекрестной проверки, со статистикой среднего значения и стандартного отклонения (SD).
Обсуждение
Результаты позволяют предположить, что паттерны активации кодовой книги могут предоставлять дополнительную информацию по сравнению с ошибками пространственной реконструкции. Улучшение показателей при переходе от NoCAR к полной модели FourScales подтверждает потенциальный вклад оценки CAR, в то время как выбранные веса объединения указывают на то, что семантическая редкость может играть важную роль в итоговой оценке аномальности. Одним из возможных объяснений является то, что отклонения, связанные с CRC, могут охватывать различные морфологические масштабы — от ядерного атипизма до нарушения архитектуры желез, и поэтому могут извлекать выгоду из представлений признаков на нескольких уровнях детализации14. Текущая модель фиксирует различные пространственные охваты, используя патчи 32 × 32 и 64 × 64 при одном и том же уровне увеличения; дальнейшая интеграция с фреймворками обработки полнослойных изображений (WSI) может дополнительно расширить возможности иерархического анализа на уровне всего препарата39.
С клинической точки зрения RareCode лучше рассматривать как инструмент предварительного скрининга и сортировки, а не как автономную диагностическую систему. Его высокая полнота (98,40%) указывает на относительно низкий риск пропуска аномальных случаев40, в то время как умеренная специфичность (58,24%), вероятно, отражает сложность дифференциации воспалительных изменений и нормальной ткани в условиях отсутствия контроля. Более высокая специфичность для рака (94,21%) дополнительно свидетельствует о том, что ложные срабатывания могут быть менее частыми для наиболее критического с клинической точки зрения подтипа. Эти рабочие характеристики подтверждают потенциал использования RareCode в качестве инструмента предварительного скрининга для приоритизации случаев, требующих экспертной оценки, и оптимизации патологоанатомического анализа5,6.
Результаты по отдельным классам могут дополнительно подтвердить потенциальную роль RareCode в сортировке пациентов. Относительно более высокая эффективность при выявлении рака по сравнению с воспалением может отражать более выраженные архитектурные и цитологические отклонения, часто наблюдаемые в злокачественных тканях, включая потерю полярности, ядерный плеоморфизм и стромальную десмоплазию14,39. Напротив, воспалительные изменения могут сильнее перекрываться с вариациями доброкачественных тканей, что может частично объяснить более низкую специфичность при выявлении воспаления. Следовательно, к общей специфичности следует относиться с осторожностью, рассматривая обнаружение рака как клинически значимый вариант применения, а не как окончательный автономный диагноз.
Потенциальные ошибки RareCode следует интерпретировать в контексте его задачи обучения на одном классе. Поскольку модель изучает паттерны нормальной ткани, а не категории конкретных заболеваний, ненеопластические изменения, такие как регенеративный эпителий, фиброз, некроз или выраженное воспаление, также могут получить высокие показатели аномальности. Напротив, слабая дисплазия или высокодифференцированная карцинома с почти нормальной архитектурой желез могут вызвать менее выраженный ответ. Технические факторы, включая вариативность окрашивания, складки ткани, артефакты среза, расфокусировку и сжатие изображений, также могут влиять на ошибки реконструкции и частоту активации кодовой книги. Эти соображения указывают на то, что внедрение в клиническую практику потребует контроля качества изображений, гармонизации окрашивания, калибровки с учетом особенностей сканера и многоцентровой валидации39,41.
Объем базовых сравнений. Экспериментальная оценка в данном исследовании сосредоточена на методах, функционирующих при сопоставимых данных и вычислительных допущениях — в частности, на методах, которые могут быть обучены сквозным образом (end-to-end), используя только небольшие выборки неразмеченных нормальных образцов, без необходимости использования внешних корпусов для предварительного обучения. Этот объем охватывает основные парадигмы в области обучения без учителя для детектирования аномалий: методы на основе реконструкции (CAE, VAE, SAE, MAE, PatchSAE), методы с дополненной памятью (MemAE), дистилляцию знаний (STFPM), синтетическую аугментацию (DRAEM) и сопоставление предобученных признаков (PatchCore). Мы признаем, что две категории методов не были включены в качестве прямых базовых линий. Во-первых, специализированные базовые модели для патологии (UNI, CONCH, CTransPath) используют предварительное обучение на миллионах курируемых патоморфологических изображений, и преимущества в их производительности в первую очередь обусловлены масштабом и разнообразием данных предобучения, а не механизмом детектирования аномалий; таким образом, прямое сравнение привело бы к смешиванию вклада данных предобучения с вкладом методологии детектирования. Субоптимальная производительность STFPM и PatchCore — оба из которых используют бэкбоны, предобученные на ImageNet — эмпирически иллюстрирует влияние разрыва в доменах при применении предобученных признаков общего назначения к гистопатологическим сценариям и позволяет предположить, что специализированное предобучение в области патологии может восполнить этот разрыв. Во-вторых, методы детектирования аномалий на основе диффузии, несмотря на свою перспективность, создают значительно более высокие вычислительные затраты во время инференса (обычно требуя сотен итеративных шагов шумоподавления), что ограничивает их применимость в высокопроизводительных рабочих процессах клинического скрининга, где эффективность обработки является практическим требованием. Будущие работы будут направлены на изучение того, может ли включение специализированных предобученных энкодеров для патологии в архитектуру RareCode — взамен текущего сквозного обученного энкодера — дополнительно улучшить производительность детектирования при сохранении преимуществ интерпретируемости механизма CAR.
Следует признать ряд ограничений. Во-первых, валидация была ограничена набором данных по КРР одного центра, и необходима дальнейшая многоцентровая оценка с использованием данных из различных учреждений, разных сканеров и протоколов окрашивания. Во-вторых, хотя специфичность по отношению к раку была обнадеживающей, общая специфичность оставалась подверженной влиянию границы между воспалительными и нормальными тканями. В-третьих, экспертные аннотации на уровне пикселей отсутствовали; следовательно, расчет коэффициентов Дайса (Dice) и IoU был невозможен, а оценка локализации ограничивалась качественной визуализацией и анализом агрегированных пространственных откликов на уровне изображений. В-четвертых, все еще необходимы формальные исследования с участием специалистов, чтобы определить, могут ли иерархические тепловые карты повысить диагностическую точность или эффективность анализа. Наконец, RareCode в настоящее время выполняет анализ на уровне патчей и изображений, и развертывание на уровне WSI потребует интеграции с дополнительными программными комплексами для обработки данных39,41,42.
В будущих работах следует оценить RareCode на общедоступных бенчмарках и многоцентровых когортах после интеграции с платформами для обработки WSI. Проспективные исследования с участием врачей могут помочь оценить потенциальное влияние метода на точность диагностики, время анализа и уровень согласия между наблюдателями42. Дополнительные направления включают повышение вычислительной эффективности, расширение модели для многоклассового субтипирования аномалий и интеграцию обучения на множественных экземплярах (multiple-instance learning) для постановки диагноза на уровне всего слайда28,39.
Раскрытие информации
Авторы заявляют, что у них нет известных конкурирующих финансовых интересов или личных отношений, которые могли бы повлиять на работу, представленную в данной статье. При подготовке данной работы мы использовали ChatGPT для улучшения языка и удобочитаемости рукописи, а также для помощи в создании кода для визуализации данных. После использования этого инструмента мы проверили и отредактировали содержимое по мере необходимости и берем на себя полную ответственность за опубликованную статью.
Благодарности
Данное исследование было поддержано рабочей станцией академика Юна Дая (Диагностические технологии для аутоиммунных заболеваний) (Wan Ke Science and Technology [2023] № 317), проектом Фонда инноваций аспирантов совместного исследовательского центра медицины труда и здоровья Национального исследовательского центра наук о здоровье в Хэфэе, открытый фонд (№ OMH-2023-04), а также проектом по клиническим и трансляционным исследованиям провинции Аньхой (№ 202427610020132).
Материалы
| Имя | Компания | Каталожный номер | Комментарии |
|---|---|---|---|
| ГПУ GeForce RTX 4060 Ti | NVIDIA | Нет данных | 16 ГБ видеопамяти (VRAM); для всех экспериментов использовался один графический процессор (GPU) (RRID:SCR_022858) |
| Matplotlib | Команда разработчиков Matplotlib | Версия 3.8.4 | Визуализация данных и создание графиков (RRID:SCR_008624) |
| NumPy | Разработчики NumPy | Версия 1.26.4 | Численные вычисления и операции с массивами (RRID:SCR_008633) |
| pandas | команда разработчиков pandas | Версия 2.2.3 | Организация данных и табличная обработка результатов (RRID:SCR_018214) |
| Подушка | Участники разработки Python Imaging Library / Pillow | Версия 10.3.0 | Загрузка и предварительная обработка изображений |
| Python | Python Software Foundation | Версия 3.12.3 | Язык программирования, использованный для разработки модели и анализа данных (RRID:SCR_008394) |
| PyTorch | Meta Platforms, Inc. | Версия 2.7.0+cu118 | Фреймворк глубокого обучения, использованный для реализации и обучения модели (RRID:SCR_018536) |
| scikit-learn | Разработчики scikit-learn | Версия 1.4.2 | Перекрестная проверка, разделение на обучающую и тестовую выборки и метрики оценки (RRID:SCR_002577) |
| SciPy | Разработчики SciPy | Версия 1.13.1 | Статистический анализ (RRID:SCR_008058) |
| torchvision | Проект PyTorch | Версия 0.22.0+cu118 | Предварительная обработка изображений и преобразование данных |
| tqdm | Разработчики tqdm | Версия 4.66.4 | Мониторинг процесса обучения и оценки |
Ссылки
- Fan J, Sun Q, Di Y, et al. DIPathMamba: A domain-incremental weakly supervised state space model for pathology image segmentation. Med Image Anal. 2025;103:103563.
- Nan T, Zheng S, Qiao S, et al. Deep learning quantifies pathologists' visual patterns for whole slide image diagnosis. Nat Commun. 2025;16(1):5493.
- Lagogiannis I, Meissen F, Kaissis G, et al. Unsupervised pathology detection: a deep dive into the state of the art. IEEE Trans Med Imaging. 2024;43(1):241-252.
- Tian Y, Liu F, Pang G, et al. Self-supervised pseudo multiclass pre-training for unsupervised anomaly detection and segmentation in medical images. Med Image Anal. 2023;90:102930.
- Metter DM, Colgan TJ, Leung ST, et al. Trends in the US and Canadian pathologist workforces from 2007 to 2017. JAMA Netw Open. 2019;2(5):e194337.
- Shaukat A, Levin TR. Current and future colorectal cancer screening strategies. Nat Rev Gastroenterol Hepatol. 2022;19(8):521-531.
- Ancker JS, Edwards A, Nosal S, et al. Effects of workload, work complexity, and repeated alerts on alert fatigue in a clinical decision support system. BMC Med Inform Decis Mak. 2017;17(1):36.
- Litjens G, Kooi T, Ehteshami Bejnordi B, et al. A survey on deep learning in medical image analysis. Med Image Anal. 2017;42:60-88.
- Stepec D, Skocaj D. Unsupervised detection of cancerous regions in histology imagery using image-to-image translation. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition Workshops. 2021:3785-3792.
- Li Y, Lao Q, Kang Q, et al. Self-supervised anomaly detection, staging and segmentation for retinal images. Med Image Anal. 2023;87:102805.
- Hinton GE, Salakhutdinov RR. Reducing the dimensionality of data with neural networks. Science. 2006;313(5786):504-507.
- Kingma DP, Welling M. Auto-encoding variational Bayes. In: Proceedings of the 2nd International Conference on Learning Representations (ICLR). 2014.
- Goodfellow IJ, Pouget-Abadie J, Mirza M, et al. Generative adversarial nets. In: Advances in Neural Information Processing Systems. 2014;27:2672-2680.
- Lu S, Zhang W, Zhao H, et al. Anomaly detection for medical images using heterogeneous auto-encoder. IEEE Trans Image Process. 2024;33:2770-2782.
- Yang Z, Zhang T, Soltani Bozchalooi I, et al. Memory-augmented generative adversarial networks for anomaly detection. IEEE Trans Neural Netw Learn Syst. 2022;33(6):2324-2334.
- Huyan N, Quan D, Zhang X, et al. Unsupervised outlier detection using memory and contrastive learning. IEEE Trans Image Process. 2022;31:6440-6454.
- Jézéquel L, Beaudet J, Histace A, et al. Unified anomaly detection via multi-scale contrasted memory. IEEE Trans Image Process. 2026;35:2802-2815.
- Roth K, Pemula L, Zepeda J, et al. Towards total recall in industrial anomaly detection. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2022:14298-14308.
- Defard T, Setkov A, Loesch A, et al. PaDiM: a patch distribution modeling framework for anomaly detection and localization. In: International Conference on Pattern Recognition. Cham: Springer; 2021:475-489.
- Zingman I, Stierstorfer B, Lempp C, et al. Learning image representations for anomaly detection: application to discovery of histological alterations in drug development. Med Image Anal. 2024;92:103067.
- Jiang Y, Cao Y, Shen W. Prototypical learning guided context-aware segmentation network for few-shot anomaly detection. IEEE Trans Neural Netw Learn Syst. 2025;36(7):12016-12026.
- Wang X, Zhao J, Marostica E, et al. A pathology foundation model for cancer diagnosis and prognosis prediction. Nature. 2024;634(8035):970-978.
- Frotscher A, Kapoor J, Wolfers T, et al. Unsupervised anomaly detection in medical imaging using aggregated normative diffusion. Med Image Anal. 2026;109:103895.
- Zeng GQ, Yang YW, Lu KD, et al. Evolutionary adversarial autoencoder for unsupervised anomaly detection of industrial Internet of Things. IEEE Trans Reliab. 2025;74(3):3454-3468.
- Lu KD, Zhang BX, Xu Y, et al. MoARNN-AM: multi-objective automated recurrent neural network with attention mechanism for cyber-attack detection of UAV. IEEE Trans Consum Electron. 2026;72(1):1738-1749.
- van den Oord A, Vinyals O, Kavukcuoglu K. Neural discrete representation learning. In: Advances in Neural Information Processing Systems. 2017;30:6306-6315.
- Ghafourian A, Shui H, Upadhyay D, et al. Targeted collapse regularized autoencoder for anomaly detection: black hole at the center. IEEE Trans Neural Netw Learn Syst. 2025;36(6):10348-10358.
- Gao Z, Mao A, Dong Y, et al. SMMILe enables accurate spatial quantification in digital pathology using multiple-instance learning. Nat Cancer. 2025;6(12):2025-2041.
- Wang X, Liu H, Zhang Y, et al. Joint modeling histology and molecular markers for cancer classification. Med Image Anal. 2025;102:103505.
- Jin H, Shen J, Cui L, et al. Dynamic graph based weakly supervised deep hashing for whole slide image classification and retrieval. Med Image Anal. 2025;101:103468.
- Schmitz R, Madesta F, Nielsen M, et al. Multi-scale fully convolutional neural networks for histopathology image segmentation: from nuclear aberrations to the global tissue architecture. Med Image Anal. 2021;70:101996.
- Masci J, Meier U, Ciresan D, et al. Stacked convolutional auto-encoders for hierarchical feature extraction. In: International Conference on Artificial Neural Networks. Berlin: Springer; 2011:52-59.
- Ng A. Sparse autoencoder. CS294A Lecture Notes. 2011;72:1-19.
- He K, Chen X, Xie S, et al. Masked autoencoders are scalable vision learners. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2022:16000-16009.
- Lim H, Choi J, Choo J, et al. Sparse autoencoders reveal selective remapping of visual concepts during adaptation. In: Proceedings of the 13th International Conference on Learning Representations (ICLR). 2025.
- Gong D, Liu L, Le V, et al. Memorizing normality to detect anomaly: memory-augmented deep autoencoder for unsupervised anomaly detection. In: Proceedings of the IEEE/CVF International Conference on Computer Vision. 2019:1705-1714.
- Wang G, Han S, Ding E, et al. Student-teacher feature pyramid matching for anomaly detection. In: Proceedings of the 32nd British Machine Vision Conference (BMVC). 2021.
- Zavrtanik V, Kristan M, Skocaj D. DRAEM: a discriminatively trained reconstruction embedding for surface anomaly detection. In: Proceedings of the IEEE/CVF International Conference on Computer Vision. 2021:8330-8339.
- Niazi MKK, Parwani AV, Gurcan MN. Digital pathology and artificial intelligence. Lancet Oncol. 2019;20(5):e253-e261.
- Raab SS, Grzybicki DM, Janosky JE, et al. Clinical impact and frequency of anatomic pathology errors in cancer diagnoses. Cancer. 2005;104(10):2205-2213.
- Schömig-Markiefka B, Pryalukhin A, Hulla W, et al. Quality control stress test for deep learning-based diagnostic model in digital pathology. Mod Pathol. 2021;34(12):2098-2108.
- Steiner DF, MacDonald R, Liu Y, et al. Impact of deep learning assistance on the histopathologic review of lymph nodes for metastatic breast cancer. Am J Surg Pathol. 2018;42(12):1636-1646.