В данном протоколе представлен структурированный и поддающийся аудиту рабочий процесс обработки анонимизированных данных опросов студентов бакалавриата о благополучии: от первичного экспорта и скрининга ответов до подсчета баллов по шкалам, проверки надежности, регрессионной диагностики, верификации источников данных для рисунков и подготовки аналитических результатов для визуализации.
Методическая статья
Структурированный рабочий процесс для скрининга, оценки и визуализации данных опроса о благополучии студентов бакалавриата
В этой статье
Краткое содержание
Аннотация
Исследования на основе анкетирования широко используются для изучения благополучия студентов, однако процедурный путь от необработанных ответов до анализируемых переменных, статистических таблиц и визуальных результатов часто документируется недостаточно. В данном протоколе представлен структурированный и проверяемый рабочий процесс обработки анонимизированных данных анкет о благополучии студентов бакалавриата, собранных с помощью нескольких разделов на основе шкал типа Лайкерта. Рабочий процесс начинается с получения этического одобрения, документирования согласия, настройки анкеты и экспорта необработанных данных, после чего следуют этапы скрининга ответов, проверки дубликатов, обработки пропущенных данных, кодирования пунктов, присвоения обратных баллов, оценки надежности, описательного анализа, корреляционного анализа, контрастивного сравнения групп, регрессионного моделирования, диагностической проверки и подготовки источников для визуализации. В примере анкеты используются документированные и адаптированные для исследования разделы шкал, основанные на Depression Anxiety Stress Scales-21, шкале прокрастинации Такмана (Tuckman Procrastination Scale), шкале психологического чувства принадлежности к школе (Psychological Sense of School Membership Scale), литературе по измерению мышления высшего порядка и документации по шкалам субъективного благополучия. Отрицательные эмоции, академическая прокрастинация, чувство принадлежности к учебному заведению, мышление высшего порядка и субъективное благополучие используются в качестве примеров переменных на уровне шкал, чтобы показать, как ответы на уровне отдельных пунктов могут быть преобразованы в прослеживаемые аналитические результаты. Типичные результаты включают таблицу потока скрининга, демографическую сводку, описательную статистику и статистику проверки диапазонов, оценки внутренней согласованности, корреляционную матрицу, результаты контрастивного сравнения, коэффициенты регрессии, диагностику остатков и влияния, а также файлы источников для рисунков. В протоколе особое внимание уделяется заранее определенным правилам принятия решений, связанной карте шкал, логу скрининга перед анализом, проверке присвоения обратных баллов и верификации числовых источников для графиков. Вместо предложения новой психометрической шкалы, валидации измерительной модели или установления причинно-следственных связей, данный метод предоставляет практическую и проверяемую процедуру для исследователей, которым необходимо проводить скрининг, подсчет баллов, анализ и визуализацию данных о благополучии студентов бакалавриата, полученных с помощью анкетирования. Этот рабочий процесс может быть адаптирован для смежных исследований на основе анкетирования при условии, что карта шкал, этическое одобрение, правила подсчета баллов, пороги скрининга ответов и файлы источников для визуализации определены до начала анализа.
Введение
Субъективное благополучие является важным показателем в исследованиях студентов, поскольку оно отражает то, как учащиеся оценивают свою жизнь, эмоциональный опыт, социальные отношения и повседневное функционирование в образовательной среде. В высшем образовании благополучие студентов носит многомерный характер и не ограничивается лишь удовлетворенностью жизнью или психологическим дистрессом1. Таким образом, данные анкетирования остаются полезными, когда исследователям необходимо изучить эмоциональный, поведенческий, социальный, когнитивный опыт и аспекты благополучия в рамках единой аналитической структуры.
Ценность данных анкетирования зависит не только от выбранных конструктов, но и от того, как необработанные ответы преобразуются в аналитические переменные. Во многих исследованиях приводятся баллы по шкалам, корреляционные матрицы, сравнения групп или регрессионные модели без описания промежуточных решений, связывающих первичные записи с итоговыми таблицами и рисунками. Пропущенные ответы могут обрабатываться непоследовательно, пункты с обратной шкалой могут быть закодированы неправильно, дубликаты ответов могут остаться в наборе данных, а невнимательные ответы могут быть приняты за достоверные наблюдения. Поэтому решения по обработке пропущенных данных должны планироваться, документироваться и описываться, а не рассматриваться как невидимый этап post hoc2. Данные онлайн-анкетирования также требуют четких правил оценки качества ответов, поскольку слишком высокая скорость заполнения, выбор одного и того же варианта ответа во всех пунктах («straight-lining»), противоречивые ответы и другие паттерны низкого качества могут исказить дескриптивную статистику, оценки надежности и наблюдаемые взаимосвязи3.
Новизна данного протокола заключается в создании связанного контрольного журнала (audit trail), который позволяет проследить путь от исходного экспорта данных опросника до конечных статистических и визуальных результатов. В частности, рабочий процесс включает в себя заполненную карту шкал, журнал предварительного отсева (скрининга) перед анализом, контрольную точку для обратного кодирования, журнал проверки подсчета баллов, проверку числовых источников для графиков и контрольный след, связывающий каждую таблицу или рисунок с исходным файлом. Это отличает данный метод от стандартных практик очистки данных опросов, подсчета баллов по шкалам, тестирования надежности или визуализации. Вместо того чтобы просто констатировать факт очистки и анализа данных опросника, протокол точно определяет, какой файл заблокирован, какой файл проходит скрининг, какие правила применяются, какие баллы по шкалам вычисляются и какая проверенная числовая таблица используется для создания каждого визуального результата.
Рабочий процесс продемонстрирован на примере анонимизированных данных опроса студентов колледжа, содержащих пять переменных шкального уровня: негативные эмоции, академическую прокрастинацию, чувство принадлежности к учебному заведению, мышление высокого порядка и субъективное благополучие. Эти конструкты были выбраны для того, чтобы представить эмоциональные, поведенческие, контекстуальные (школьные), когнитивные и результативные примеры в рамках одного структурированного и проверяемого рабочего процесса. Академическая прокрастинация была связана с последующими проблемами с психическим здоровьем у студентов университетов, включая депрессию, тревожность и стрессовые состояния4. Чувство принадлежности к учебному заведению и субъективное благополучие также тесно взаимосвязаны в студенческой среде, что обосновывает включение показателей принадлежности и благополучия в одну систему обработки данных опроса5. Однако в данном протоколе эти конструкты используются для демонстрации рабочего процесса, а не для установления причинно-следственной психологической модели.
Центральной особенностью данного протокола является отделение решений по обработке данных от содержательной интерпретации. Карта шкал подготавливается до начала анализа, критерии качества ответов фиксируются до присвоения баллов по шкалам, проверка обратного кодирования завершается до статистического тестирования, а рисунки создаются только после проверки соответствующих исходных численных таблиц. Такая последовательность важна, поскольку шкалы ответов типа Ликерта требуют тщательного согласования формулировок пунктов, опорных точек ответов, направления кодирования и статистической обработки6. Протокол также отдает приоритет прозрачной предварительной обработке и проверке кодирования перед сложностью моделей. Прогностические или многофакторные модели могут быть полезны в студенческих исследованиях7, а графические сводки могут улучшить интерпретацию, если они остаются привязанными к проверенным численным матрицам8, однако и то, и другое зависит от прозрачной подготовки входных переменных. По этой причине в рабочем процессе корреляционный анализ, контрастивное сравнение групп, регрессионное моделирование, диагностическая проверка и визуализация используются в качестве примеров модулей, а не как обязательные содержательные утверждения.
Данный протокол предназначен для исследователей, которым необходим практический рабочий процесс обработки анкет с анонимизированными данными о благополучии студентов. Он применим в случаях, когда ответы на вопросы анкеты экспортируются с онлайн-платформы, необходимо вычислить переменные на уровне шкал на основе пунктов типа Ликерта, а целью является получение прозрачных результатов для дескриптивного, корреляционного, группового, регрессионного и диагностического анализа, а также данных для визуализации. Протокол не предназначен для установления причинно-следственных связей, валидации новых шкал, замены конфирматорного факторного анализа, тестирования инвариантности измерений или замены моделирования с использованием теорииResponses (IRT) или моделирования латентных переменных. Его вклад заключается в процедурном аспекте: он делает путь от записей анкет к представленным таблицам и рисункам наглядным, воспроизводимым и проверяемым. Такой подход соответствует современным требованиям к качеству данных онлайн-опросов9, проверке регрессии и влиятельных значений10, а также к аудируемым рабочим процессам анализа на основе анкетирования11.
Протокол
Данное исследование с участием людей было рассмотрено и одобрено Комитетом по этике Колледжа авиации Университета Гуйчжоу (регистрационный номер GZOU-EDU-2024-015). Комитет определил, что исследование подлежит освобождению от этического контроля, поскольку в нем использовались процедуры анонимного добровольного анкетирования, которые не представляли для участников более чем минимального риска. Все участники предоставили электронное информированное согласие перед заполнением анкеты и могли прекратить ответы в любое время без каких-либо последствий. Поскольку ряд пунктов касались отрицательных эмоций, стресса, одиночества, беспомощности, неудовлетворенности или сопутствующего состояния благополучия, на странице согласия и на финальной странице анкеты была указана контактная информация исследователя и учреждения для участников, ощутивших дискомфорт. Набор данных, использованный в данном протоколе, был анонимизирован перед проведением скрининга, подсчетом баллов, анализом и визуализацией. Полный текст анкеты представлен в Дополнительном файле 1.
1. Подготовка опросника, материалов по этике и артефактов рабочего процесса
- Определите подходящую популяцию, условия исследования, конструкты опросника и планируемые результаты анализа перед программированием опросника.
- Подготовьте заявку на этическую экспертизу, охватывающую целевую популяцию, каналы рекрутинга, содержание опросника, расчетное время заполнения, защиту анонимности, хранение данных, процедуру отказа от участия, информацию по поддержке участников и планируемый анализ.
- Сохраните документ об этическом одобрении или освобождении от него, формулировку согласия, текст для рекрутинга, версию опросника, информацию по поддержке участников и планируемый рабочий процесс в папке проекта до начала сбора данных.
- Определите целевую популяцию как студентов бакалавриата очной формы обучения в возрасте не менее 18 лет, в настоящее время зачисленных в высшее учебное заведение, способных понять содержание опросника и предоставить информированное согласие.
- Определите критерии исключения до начала рекрутинга. Исключайте респондентов, которые отклонили согласие, не соответствуют определению целевой популяции, отправили дублирующие ответы, превысили порог пропущенных данных или соответствуют комбинированным критериям недействительных ответов, описанным в шаге 1.4.
- Разместите форму информированное согласие в начале опросника. Укажите цель исследования, добровольный характер участия, приблизительное время заполнения (12 min), защиту анонимности, право на отзыв согласия, план использования данных, контактную информацию исследователя и информацию по поддержке.
- Не собирайте информацию, позволяющую напрямую идентифицировать личность, включая идентификационные номера студентов, государственные идентификационные номера, номера мобильных телефонов, личные адреса электронной почты, адреса общежитий или другие персональные идентификаторы.
- Расположите разделы опросника в следующем порядке: информированное согласие, демографическая информация, пункты по негативным эмоциям, пункты по академической прокрастинации, пункты по чувству принадлежности к учебному заведению, пункты по мышлению высокого порядка и пункты по субъективному благополучию.
- Выберите исходные инструменты до программирования опросника. В данном протоколе негативные эмоции оценивались с помощью шкалы Depression Anxiety Stress Scales-21 (21 пункт), академическая прокрастинация — с помощью шкалы Tuckman Procrastination Scale (16 пунктов), чувство принадлежности к учебному заведению — с помощью шкалы Psychological Sense of School Membership Scale (18 пунктов), мышление высокого порядка — с помощью набора из 20 пунктов, адаптированного из опубликованной литературы по измерению мышления высокого порядка, а субъективное благополучие — с помощью 20-пунктовой шкалы субъективного благополучия для исследований студентов колледжей12,13,14,15,16.
- Подготовьте утвержденную карту шкал перед программированием опросника. Включите название конструкта, исходное название шкалы, исходную цитату, языковую версию, статус разрешения или авторизации, процедуру перевода или адаптации, код пункта, формулировку пункта, диапазон ответов, якоря ответов, направление подсчета баллов, статус пункта с обратной шкалой, итоговую переменную уровня шкалы и правило подсчета баллов.
- Описывайте набор пунктов как валидированную шкалу только в том случае, если задокументированы исходный инструмент, цитата, доказательства валидации и статус адаптации или перевода. Укажите любые наборы пунктов, разработанные автором или специально для данного исследования, в Table 1 и Supplementary File 1.
- Утвердите систему измерений до начала сбора данных. Для переведенных или адаптированных инструментов завершите перевод, рецензирование, согласование и пилотную проверку до начала рекрутинга.
- Подготовьте пакет аудита рабочего процесса, который включает утвержденный файл опросника, карту шкал, контрольный список экспорта необработанных данных, журнал скрининга, журнал верификации подсчета баллов, журнал анализа, шаблон таблицы источников рисунков, а также файл синтаксиса или скрипт анализа.
- Используйте версии в именах файлов для всех артефактов рабочего процесса.
- Определите необходимые столбцы для каждого файла аудита.
- Журнал скрининга включает ID записи, критерий скрининга, статус флага, статус исключения, причину исключения, дату принятия решения и инициалы рецензента.
- Карта шкал включает название конструкта, источник шкалы, код пункта, формулировку пункта, диапазон ответов, якоря ответов, статус обратного подсчета, название итоговой переменной, правило подсчета баллов и статус разрешения или адаптации.
- Журнал верификации подсчета баллов включает код пункта, исходный диапазон значений, перекодированный диапазон значений, формулу обратного подсчета, результат проверки диапазона, статус расхождения, внесенную правку и дату правки.
- Таблица источников рисунков включает номер рисунка, номер панели, исходную таблицу, построенные переменные, отображаемую статистику, размер выборки и статус верификации.
- Определите аналитический рабочий процесс до программирования опросника: проведение опроса, экспорт необработанных данных, скрининг ответов, подсчет баллов по шкалам, оценка надежности, дескриптивный анализ, корреляционный анализ, сравнение групп с высокими и низкими показателями, регрессионное моделирование, диагностические проверки и подготовка визуализации17.
- Структурируйте протокол вокруг решений, операций и результатов верификации, а не путей в меню программного обеспечения.
- Предоставьте ресурсы рабочего процесса, если это разрешено политикой учреждения и журнала, включая файл опросника, карту шкал, шаблон журнала скрининга, шаблон журнала подсчета баллов, файл синтаксиса или скрипт анализа и таблицы источников рисунков.
ПРИМЕЧАНИЕ: На Figure 1 показан путь от подготовки опросника до экспорта необработанных данных, скрининга ответов, подсчета баллов по шкалам, статистического анализа, диагностических проверок и получения результатов визуализации. В Table 1 приведены исходный инструмент, количество пунктов, диапазон ответов, система подсчета баллов, правило обратного подсчета, статус разрешения или адаптации и итоговая переменная уровня шкалы для каждого конструкта.
2. Настройка и распространение опросника
- Убедитесь, что платформа для анкетирования поддерживает ограничение доступа до получения согласия, обязательные для заполнения пункты, проверку на повторную подачу заявок, фиксацию временных меток и запись продолжительности заполнения ответов.
- Создайте анкету с помощью платформы для онлайн-опросов, указанной в Таблице материалов. Спрограммируйте анкету в соответствии с утвержденной картой шкал.
- Перед публикацией ссылки на опрос проведите построчный сравнительный анализ запрограммированной анкеты и утвержденной карты шкал. Запишите все внесенные корректировки в журнал исследования.
- Установите пункт об информированном согласии в качестве первого обязательного пункта. Настройте автоматическое прекращение анкетирования, если участник выбирает вариант «Я не согласен на участие».
- Спрограммируйте разделы демографических данных и психологических шкал в порядке, зафиксированном на этапе 1.8. Используйте коды пунктов, соответствующие карте шкал.
- Устанавливайте пункты психологических шкал как обязательные только в тех случаях, когда это разрешено этическим одобрением или исключением, и когда участники могут отказаться от участия без каких-либо санкций. Если принудительные ответы не разрешены, зафиксируйте правило обработки пропущенных данных до начала сбора данных.
- Отображайте опорные значения ответов перед каждым разделом шкалы и соблюдайте единообразие опорных значений внутри каждой шкалы18.
- Отключите возможность повторной подачи ответов, если платформа для опросов предоставляет такую функцию. Сохраняйте любые анонимные идентификаторы устройства, браузера, платформы или отправки, необходимые для анализа дубликатов ответов.
- Включите автоматическую запись времени отправки и продолжительности заполнения.
- Установите период работы анкеты в 7 календарных дней или используйте окно сбора данных, утвержденное комитетом по этике.
- Отправьте ссылку на анкету через утвержденный институциональный канал рекрутинга. Предоставьте всем участникам одинаковые письменные инструкции.
- Закройте доступ к анкете после завершения заранее определенного окна сбора данных.
ПРИМЕЧАНИЕ: Сохраните в журнале исследования текст приглашения, ссылку на анкету, даты открытия и закрытия, настройки платформы, текст согласия, финальную версию анкеты и настройки экспорта данных из платформы.
3. Экспорт и сохранение исходных данных
- Сразу после закрытия окна сбора данных экспортируйте ответы из заполненного опросника в файл электронной таблицы.
- Сохраните первый экспортированный файл в качестве заблокированного набора исходных данных. Не редактируйте этот файл.
- Создайте одну рабочую копию для скрининга, подсчета баллов и анализа. Назовите файл, указав дату, номер версии и идентификатор проекта.
- Убедитесь, что экспортированный файл содержит по одной строке на каждого респондента и по одному столбцу на каждую демографическую переменную, пункт опросника, переменную временной метки, переменную платформы или производное поле платформы.
- Храните заблокированный набор исходных данных, рабочую копию, карту шкал, файл опросника, журнал исследования, журнал скрининга, журнал проверки подсчета баллов, журнал анализа, таблицы-источники рисунков, а также файл синтаксиса или скрипта в папке проекта, защищенной паролем.
- Проверьте, не содержит ли набор данных информации, позволяющей напрямую идентифицировать личность. Перед началом анализа удалите из рабочей копии любые неожиданно появившиеся идентифицирующие поля и зафиксируйте в журнале исследования название поля, причину удаления, дату удаления и данные ответственного рецензента.
- Перед совместным использованием или публикацией данных на уровне участников проверьте возможность косвенной идентификации. Проанализируйте малые демографические группы, сформированные комбинациями пола, возраста, курса обучения, категории учебного заведения и категории академической специальности. Если группа содержит менее пяти респондентов, объедините категории, скройте данные по этой группе или предоставьте только агрегированные данные.
- Зафиксируйте статус доступности данных в журнале исследования, включая информацию о том, доступны ли данные на уровне участников, ограничены ли они требованиями этики или конфиденциальности или заменены агрегированным набором данных рабочего процесса.
- Перед очисткой данных создайте журнал скрининга. Зафиксируйте исходный размер выборки, критерий скрининга, количество отмеченных записей, количество удаленных записей, количество сохраненных записей, причину исключения, дату принятия решения и инициалы рецензента.
- Перед проведением статистического анализа создайте файл трассировки анализа. Зафиксируйте название программного обеспечения, версию ПО, операционную систему, имена файлов, версию данных, версию скрипта или синтаксиса, а также дату каждого запуска анализа.
ПРИМЕЧАНИЕ: Используйте заблокированный набор исходных данных только для верификации. Весь скрининг, подсчет баллов и анализ проводите с использованием рабочей копии.
4. Скрининг ответов и формирование аналитического набора данных
- Примените заранее определенные правила исключения и контроля качества перед расчетом любого балла на уровне шкалы.
- Примените правила скрининга к рабочей копии в следующем порядке: статус согласия, соответствие критериям включения, дубликаты заявок, пропущенные данные, продолжительность ответа, однообразные ответы (straight-line responding), значения вне допустимого диапазона и комбинированные показатели качества ответов.
- После каждой операции скрининга фиксируйте в журнале скрининга количество помеченных, удаленных и сохраненных записей. Не перезаписывайте предыдущие версии рабочего файла.
- Удалите все записи, в которых пункт об информированном согласии отмечен как «Нет» или остался без ответа.
- Удалите все записи, которые не соответствуют критериям включения, определенным на шаге 1.4.
- Проведите проверку на наличие дубликатов заявок, используя анонимные идентификаторы ответов, время подачи, флаги платформы о дублировании заявок и повторяющиеся паттерны ответов.
- При обнаружении дубликатов сохраняйте первую полную заявку, если только документально подтвержденная причина не обосновывает сохранение более позднего полного ответа.
- Исправьте все ошибки, связанные с правилами качества ответов, перед расчетом баллов по шкалам. В Таблице 2 обобщены пороги исключения, пороги маркировки, обоснование, литературная поддержка и план анализа чувствительности, используемые в рабочем процессе.
- Проведите проверку на наличие пропущенных данных. Исключите респондента, если пропущено более 20% всех пунктов шкалы. Замените единичный пропущенный пункт средним баллом респондента по этой же шкале только в том случае, если заполнено не менее 80% данной шкалы. Не проводите импутацию демографических переменных, за исключением случаев, когда переменная не используется ни в одном анализе.
- Зафиксируйте количество респондентов, исключенных из-за пропуска более 20% пунктов шкалы, и количество респондентов, для которых была проведена импутация средним значением внутри шкалы. В текущем наборе данных 4 респондента были исключены из-за пропуска более 20% пунктов шкалы, и для 21 респондента была проведена импутация средним значением внутри шкалы для 37 единичных пропущенных пунктов.
- Проведите проверку продолжительности ответа. Пометьте ответы, завершенные менее чем за 180 s. Рассматривайте это значение как флаг слишком быстрого заполнения (speeding flag), а не как автоматическое правило исключения.
- Проведите проверку на однообразные ответы. Пометьте ответ, если один и тот же вариант выбран более чем в 90% всех пунктов шкалы Лайкерта. Рассматривайте это значение как флаг паттерна ответов, а не как автоматическое правило исключения.
- Проверьте дополнительные индикаторы низкого качества усилий, включая признаки дублирования заявок, невозможные временные метки, повторяющиеся строки ответов в разных заявках или противоречия между метаданными платформы и содержанием анкеты.
- Удаляйте помеченный ответ только в том случае, если как минимум два индикатора контроля качества указывают на недостоверность ответов, например, крайне короткое время заполнения в сочетании с однообразными ответами, признаки дублирования заявок или невозможные метаданные платформы19.
- Регистрируйте все помеченные записи, даже если они сохранены. В текущем наборе данных 19 ответов были помечены из-за продолжительности заполнения < 180 s, 8 ответов — из-за однообразных ответов >90%, и 13 записей были исключены, так как они соответствовали двум или более индикаторам качества ответов.
- Проверьте значения на выход за пределы допустимого диапазона. Подтвердите, что пункты по отрицательным эмоциям находятся в диапазоне 1–4, пункты по академической прокрастинации, чувству принадлежности к школе и мышлению высокого порядка — в диапазоне 1–5, а пункты по субъективному благополучию — в диапазоне 1–6.
- Исправляйте значение только в том случае, если исходный экспорт четко указывает на ошибку форматирования. Не изменяйте достоверные психологические баллы только потому, что они кажутся необычно высокими или низкими.
- Создайте таблицу потока скрининга, в которой будут указаны: поданные анкеты, исключения по согласию и соответствию критериям, исключения дубликатов, исключения из-за пропущенных данных, флаги качества ответов, комбинированные исключения по контролю качества, импутации единичных пунктов, сохраненные аналитические случаи и итоговый размер аналитической выборки.
- Заполните таблицу потока скрининга, используя заблокированный журнал скрининга, и сохраните экспортированную аудиторскую запись о решениях по скринингу. В текущем наборе данных поток скрининга был следующим: поданные анкеты, n = 448; исключения по согласию или соответствию критериям, n = 6; удалены дубликаты заявок, n = 5; записи, исключенные из-за >20% пропущенных пунктов шкалы, n = 4; записи, исключенные по двум или более индикаторам качества ответов, n = 13; итоговый аналитический набор данных, n = 420.
- Сохраните отобранные записи как аналитический набор данных. Используйте новое имя файла с указанием версии и храните журнал скрининга вместе с аналитическим набором данных.
ПРИМЕЧАНИЕ: Сохраняйте достоверные экстремальные баллы, если только не выявлена документально подтвержденная проблема с качеством ответов.
5. Подсчет баллов по психологическим шкалам
- Преобразуйте ответы по отдельным пунктам в переменные уровня шкалы только после завершения скрининга ответов и сохранения аналитического набора данных.
- Присвойте коды всем пунктам типа Ликерта в соответствии с якорями ответов в заблокированном опроснике и правилами подсчета баллов в карте шкал.
- Оставьте исходные переменные пунктов без изменений. Создайте отдельные производные переменные для перекодированных пунктов или пунктов с обратным счетом.
- Рассчитайте баллы по каждой шкале в соответствии с заблокированной картой шкал и соответствующим исходным инструментом или руководством по подсчету баллов.
- Примените обратный счет для назначенных пунктов субъективного благополучия перед расчетом общего балла субъективного благополучия. Для шкалы ответов 1–6 рассчитывайте каждый инвертированный пункт как 7 минус исходный балл и добавляйте _R к названию производной переменной.
- При расчете субъективного благополучия используйте переменные с обратным счетом, а не исходные переменные.
- Рассчитайте каждый балл уровня шкалы как среднее значение по сохраненным пунктам: отрицательные эмоции, академическая прокрастинация, чувство принадлежности к школе, мышление высокого порядка и субъективное благополучие.
- Назовите итоговые переменные уровня шкалы следующим образом: Negative emotion, Academic procrastination, School belongingness, Higher-order thinking и Subjective well-being.
- Сверьте минимальное и максимальное значения каждой переменной уровня шкалы с её теоретическим диапазоном ответов. Повторно проверьте кодирование, обратный счет и обработку пропущенных значений, если какой-либо балл выходит за пределы ожидаемого диапазона.
- Перед проведением инференциального анализа проверьте направление каждой шкалы по карте шкал. Более высокие баллы должны отражать предполагаемое направление конструкта.
- Перед анализом проведите аудит обратного счета. Пересчитайте пункты с обратным счетом для случайной выборки записей или для всех таких пунктов, если это возможно, и занесите результат аудита в журнал проверки подсчета баллов.
- При обнаружении ошибки в подсчете исправьте производную переменную, заново рассчитайте затронутый балл шкалы, обновите журнал проверки подсчета баллов и повторно выполните все последующие анализы и таблицы-источники рисунков на основе исправленного аналитического набора данных.
ПРИМЕЧАНИЕ: Рассматривайте обратный счет и проверку диапазонов как обязательные контрольные этапы перед корреляционным анализом, сравнением групп, регрессионным моделированием или визуализацией.
6. Оценка внутренней согласованности и дескриптивных свойств
- Рассчитайте внутреннюю согласованность, исправленные корреляции пункта с итогом и дескриптивную статистику для каждой шкалы, используя переменные пунктов, определенные в заблокированной карте шкал.
- Зафиксируйте значения альфа Кронбаха, номер пункта, размер валидной выборки, исправленные корреляции пункта с итогом и значения альфа при удалении пункта для каждой шкалы.
- Используйте значение альфа Кронбаха 0.70 в качестве минимально приемлемого порога надежности для данного рабочего процесса. Прежде чем удалять какой-либо пункт, проверьте формулировку пункта, направление оценки, обратное кодирование, соответствие конструкту и документацию к исходному инструменту20.
- Рассчитайте омегу Макдональда в качестве дополнительного показателя надежности, если это поддерживается средой анализа. Приводите значение омеги вместе с альфой Кронбаха, если эти две оценки приводят к разным интерпретациям надежности.
- Проанализируйте любой пункт с отрицательной или очень низкой исправленной корреляцией пункта с итогом перед рассмотрением вопроса о его удалении. В первую очередь рассматривайте это как возможную проблему кодирования, обратного подсчета баллов или несоответствия конструкту.
- Не удаляйте пункт только с целью повышения значения альфа Кронбаха. Удаление пункта должно быть обосновано руководством по подсчету баллов, формулировкой пункта, исправленной корреляцией пункта с итогом, концептуальным соответствием и документально подтвержденной верификацией подсчета.
- Рассчитайте дескриптивную статистику для всех пяти переменных уровня шкалы, включая среднее значение, стандартное отклонение, минимум, максимум, асимметрию и эксцесс.
- Проверьте наличие эффекта пола или потолка, зафиксировав долю респондентов с минимальными и максимальными возможными баллами для каждой шкалы.
- Запишите оценки надежности, результаты диагностики пунктов, дескриптивную статистику и любые решения по подсчету баллов в журнал анализа.
ПРИМЕЧАНИЕ: Альфа Кронбаха используется в качестве контрольной точки надежности, а не как полная процедура психометрической валидации. Когда требуется формальная оценка измерений, дополните данный рабочий процесс расчетом омеги Макдональда, подтверждающим факторным анализом, тестированием инвариантности измерений, моделированием ответов на пункты или другими методами анализа латентных переменных.
7. Проведение корреляционного анализа
- Используйте пять проверенных переменных уровневого масштаба: отрицательные эмоции, академическую прокрастинацию, чувство принадлежности к школе, мышление высшего порядка и субъективное благополучие.
- Перед расчетом корреляций Пирсона изучите распределения и двумерные диаграммы рассеяния для каждой пары переменных уровневого масштаба.
- Оцените, демонстрируют ли переменные приблизительно непрерывную вариацию баллов, сильную асимметрию, нелинейные зависимости или наличие влиятельных выбросов.
- Рассчитайте коэффициенты корреляции Пирсона и двусторонние значения p для всех пар переменных уровневого масштаба, если допущения приемлемы для дескриптивного анализа ассоциаций.
- Зафиксируйте коэффициент корреляции, значение p, размер выборки и направление ассоциации для каждой пары переменных.
- Приведите коэффициенты корреляции с точностью до трех десятичных знаков.
- Сравните направление каждого коэффициента с картой шкал. Перепроверьте подсчет баллов по пунктам, если коэффициент противоречит предполагаемому направлению конструкта.
- Сохраните проверенную корреляционную матрицу в качестве исходной числовой таблицы для тепловой карты корреляций в разделе «Репрезентативные результаты».
- Если распределения заметно асимметричны, требуется чувствительность к порядковой шкале или если диаграммы рассеяния указывают на монотонные, но нелинейные ассоциации, повторите анализ, используя корреляцию Спирмена, и сравните направление и относительную величину ассоциаций.
- Отметьте, привели ли результаты Пирсона и Спирмена к одной и той же содержательной интерпретации.
ПРИМЕЧАНИЕ: Используйте корреляционный анализ как для проверки дескриптивных ассоциаций, так и для аудита направления подсчета баллов.
8. Формирование групп с высоким и низким уровнем субъективного благополучия
- Используйте очищенный и оцененный аналитический набор данных. Для формирования групп не возвращайтесь к исходному экспорту.
- В качестве основного показателя для регрессионного моделирования используйте непрерывную оценку субъективного благополучия. Группировку «высокий-низкий» используйте только для сравнительного анализа профилей.
- Отсортируйте респондентов по оценке субъективного благополучия от самой высокой к самой низкой.
- Примените заранее определенное правило 27% для крайних групп, чтобы выделить группы с высоким и низким субъективным благополучием. Обоснуйте выбор этого порога в Таблице 2 и в журнале анализа.
- Назначьте респондентов из верхних 27% в группу с высоким субъективным благополучием, а респондентов из нижних 27% — в группу с низким субъективным благополучием.
- Оставьте средние 46% в полном аналитическом наборе данных для расчета описательной статистики, корреляционного анализа, сравнения по полу и регрессионного моделирования, но исключите эти случаи из контрастного анализа «высокий-низкий».
- Создайте переменную группировки под названием «Группа субъективного благополучия». Присвойте верхней группе код «Высокая», нижней группе — «Низкая», а остальным респондентам — «Средняя».
- Подтвердите, что группы с высоким и низким показателями содержат ожидаемое количество случаев. При наличии одинаковых баллов на границе 27% примените заранее определенное правило обработки совпадений и зафиксируйте принятое решение в журнале анализа.
- Проведите проверку на чувствительность, если граница 27% приводит к нестабильности состава групп из-за одинаковых баллов или малого размера выборки. Используйте альтернативное заранее определенное правило, например, группировку по тертилям, и укажите, изменилась ли интерпретация результатов.
ПРИМЕЧАНИЕ: Группировка «высокий-низкий» является процедурой описательного контраста. Она не должна заменять непрерывную оценку субъективного благополучия в основной регрессионной модели.
9. Сравнение групп с высоким и низким уровнем субъективного благополучия
- Отфильтруйте аналитический набор данных, чтобы оставить только тех респондентов, которые были закодированы как «Высокий» (High) или «Низкий» (Low) в переменной группировки субъективного благополучия.
- Сравните группы с высоким и низким показателями по параметрам отрицательных эмоций, академической прокрастинации, чувства принадлежности к школе и мышления высокого порядка.
- Перед сравнением групп проверьте распределения внутри каждой группы, размеры выборок и равенство дисперсий для каждой переменной.
- Используйте t-критерий для независимых выборок, если допущения о распределении и дисперсии соблюдены. Используйте t-критерий Уэлча, если допущение о равенстве дисперсий не подтверждается.
- Зафиксируйте средние значения групп, стандартные отклонения, разность средних, значения t, число степеней свободы, значения p и 95% доверительные интервалы.
- Рассчитайте d-коэффициент Коэна для каждой разности между группами и интерпретируйте величину эффекта вместе со значением p.
- Проверьте, соответствует ли направление каждой разности между группами определениям конструктов и корреляционной матрице.
- Сохраните проверенную таблицу сравнения групп в качестве числового источника для любой визуализации сравнения групп.
- Представьте результаты этого анализа как контраст между экстремальными профилями субъективного благополучия.
ПРИМЕЧАНИЕ: Не интерпретируйте сравнение «высокий-низкий» как доказательство причинно-следственной связи.
10. Исследование половых различий
- Удалите фильтр групп с высоким и низким показателем и вернитесь к полному аналитическому набору данных.
- Используйте пол в качестве описательной группирующей переменной, а не как причинный фактор воздействия.
- Сравните ответы женщин и мужчин по показателям отрицательных эмоций, академической прокрастинации, чувства принадлежности к школе, мышления высшего порядка и субъективного благополучия.
- Перед проведением сравнения проверьте объемы выборок для каждой группы, наличие пропусков, распределения и равенство дисперсий.
- Используйте t-критерий для независимых выборок, если допущения соблюдены. Используйте t-критерий Уэлча, если допущение о равенстве дисперсий не подтверждается.
- Зафиксируйте средние значения по группам, стандартные отклонения, разность средних, значения t, число степеней свободы, значения p, 95% доверительные интервалы и значения d Коэна.
- Интерпретируйте половые различия описательно и укажите величину эффекта вместе со значениями p.
- Не используйте результаты сравнения по полу для обоснования исключения данных post hoc, модификации шкал или причинной интерпретации.
ПРИМЕЧАНИЕ: Сравнения по полу включены в данный рабочий процесс анализа одномоментного опроса в качестве описательных проверок подгрупп.
11. Оценка регрессионной модели
- В качестве зависимой переменной используйте показатель субъективного благополучия.
- В качестве одновременных предикторов на уровне шкал используйте отрицательные эмоции, академическую прокрастинацию, чувство принадлежности к школе и мышление высокого порядка21.
- Используйте непрерывные переменные на уровне шкал, полученные в процессе подсчета баллов по шкалам. Не заменяйте непрерывный показатель субъективного благополучия переменной группировки «высокий-низкий».
- Постройте основную модель, используя множественную линейную регрессию с одновременным вводом предикторов.
- Зафиксируйте нестандартизированные коэффициенты, стандартизированные коэффициенты, стандартные ошибки, значения t, значения p, 95% доверительные интервалы, R2, скорректированный R2, толерантность и фактор инфляции дисперсии.
- Используйте значения фактора инфляции дисперсии ниже 5,00 в качестве порога отсутствия выраженной мультиколлинеарности.
- Изучите двумерные диаграммы рассеяния, графики частичной регрессии или графики компонентов и остатков, чтобы оценить, являются ли связи между предикторами и субъективным благополучием приблизительно линейными.
- Оцените независимость остатков с помощью статистики Дарбина-Уотсона.
- Оцените нормальность распределения остатков с помощью Q-Q графика остатков и формального теста на нормальность, если это применимо для данного объема выборки.
- Оцените гомоскедастичность с помощью графика зависимости стандартизированных остатков от стандартизированных прогнозируемых значений.
- Сохраните стандартизированные остатки, стандартизированные прогнозируемые значения, значения рычага (leverage) и расстояние Кука для проведения диагностической проверки.
- Рассчитайте дополнительную скорректированную модель, включающую четыре психологических предиктора и демографические переменные, указанные в описании выборки (пол, возраст, курс обучения, категория учебного заведения и категория академической специальности), если эти переменные доступны и имеют адекватное распределение.
- Сравните основную модель с дополнительной скорректированной моделью. Зафиксируйте, остаются ли направление, величина и статистическая интерпретация четырех психологических предикторов стабильными после демографической корректировки.
- Сохраните проверенные стандартизированные коэффициенты и 95% доверительные интервалы основной модели в качестве числовой исходной таблицы для построения графика коэффициентов в разделе «Репрезентативные результаты»22.
ПРИМЕЧАНИЕ: Интерпретируйте коэффициенты регрессии как условные связи, а не как причинно-следственные эффекты. Модель с демографической корректировкой используется в анализе чувствительности, чтобы оценить, остаются ли выводы рабочего процесса стабильными после учета имеющихся фоновых переменных.
12. Диагностика регрессионной модели
- Проверьте стандартизированные остатки построенной регрессионной модели. Отметьте случаи, в которых абсолютное значение стандартизированного остатка превышает 3,00.
- Оцените значения рычага (leverage) и расстояние Кука для выявления влиятельных наблюдений.
- Отметьте наблюдения с расстоянием Кука более 4/n как потенциально влиятельные, где n — размер аналитической выборки. Рассматривайте расстояние Кука более 1,00 как порог сильного влияния, а не как единственный критерий отсева.
- Изучите график остатков в зависимости от прогнозируемых значений на предмет нелинейности, неоднородности дисперсии и необычной кластеризации.
- Проанализируйте график Квантиль-Квантиль (Q-Q plot) остатков и результат теста на нормальность распределения остатков. Зафиксируйте, подтверждает ли оценка нормальности возможность использования линейной модели для дескриптивного анализа ассоциаций.
- Запишите значение статистики Дарбина-Уотсона и определите, является ли независимость остатков приемлемой.
- Сверьте все отмеченные случаи с журналом скрининга, журналом проверки оценок и критериями соответствия.
- Сохраняйте отмеченные случаи, если они представляют собой достоверные наблюдения и не являются следствием ошибок ввода данных, ошибок оценивания, дублирующих заявок, нарушений критериев соответствия или задокументированных проблем с качеством ответов.
- Исправляйте или удаляйте отмеченный случай только в том случае, если в ходе аудита выявлена задокументированная процедурная ошибка, ошибка соответствия, кодирования, оценивания или ввода данных.
- После любого задокументированного исправления повторно запустите регрессионную модель и сравните коэффициенты, доверительные интервалы, R2, скорректированный R2 и результаты диагностических тестов с исходной моделью.
- Проведите проверку чувствительности к влиянию, повторно построив модель после исключения случаев с расстоянием Кука более 4/n. Укажите, изменилась ли содержательная интерпретация результатов.
- Занесите окончательное диагностическое решение в журнал анализа, включая количество случаев, отмеченных по стандартизированным остаткам, количество случаев с расстоянием Кука более 4/n, максимальное расстояние Кука, статистику Дарбина-Уотсона, а также заключение по проверкам нормальности остатков и линейности.
ПРИМЕЧАНИЕ: Не удаляйте влиятельные случаи исключительно с целью улучшения соответствия модели. Удаление или исправление должны основываться на задокументированной причине, зафиксированной в ходе аудита.
Результаты
Аналитический набор данных, сформированный после скрининга ответов
В результате рабочего процесса скрининга ответов был сформирован аналитический набор данных, содержащий 420 анонимизированных записей студентов из 448 представленных анкет. В журнале скрининга были зафиксированы все этапы принятия решений. Шесть записей были удалены из-за отсутствия согласия или несоответствия критериям отбора, пять дублирующих заявок были удалены, четыре записи были исключены, поскольку более 20% всех пунктов шкал отсутствовали, и 13 записей были исключены, так как они соответствовали двум или более показателям качества ответов. Девятнадцать ответов были отмечены из-за продолжительности заполнения <180 s, восемь ответов были отмечены из-за >90% однотипных ответов (straight-line responding), и для 21 респондента была выполнена импутация средним значением по шкале для 37 единичных пропущенных пунктов. Итоговый аналитический набор данных не содержал прямой идентифицирующей информации об участниках, ни одна из сохраненных записей не превышала порог исключения по пропущенным данным, и все сохраненные ответы на пункты находились в пределах заранее определенных диапазонов. Схема скрининга приведена в Таблице 3.
В итоговую выборку вошли 275 женщин и 145 мужчин, что составило 65,5% и 34,5% аналитического набора данных соответственно. Средний возраст составил 20,1 ± 1,2 года. Респонденты были распределены по четырем курсам бакалавриата: с 1-го по 4-й курс, которые составили 27,1%, 27,4%, 25,5% и 20,0% выборки соответственно. Набор данных также включал три категории учебных заведений и пять категорий академических специальностей. После пересмотра категорий ни одна опубликованная демографическая группа не содержала менее пяти респондентов. Демографические характеристики аналитического набора данных обобщены в Таблице 4.
Построение шкал, проверка диапазонов и примеры субоптимальных рабочих процессов
После кодирования пунктов и присвоения обратных баллов были вычислены пять переменных на уровне шкал: отрицательные эмоции, академическая прокрастинация, чувство принадлежности к школе, мышление высшего порядка и субъективное благополучие. Каждый показатель остался в пределах своего теоретического диапазона ответов. Показатели отрицательных эмоций варьировались от 1.048 до 3.143 по шкале от 1 до 4. Академическая прокрастинация, чувство принадлежности к школе и мышление высшего порядка варьировались от 1.312 до 4.250, от 2.333 до 4.444 и от 2.350 до 4.850 по соответствующим шкалам от 1 до 5. Субъективное благополучие варьировалось от 2.000 до 5.300 по шкале от 1 до 6. Проверка обратного кодирования не выявила расхождений между полученными переменными с обратными баллами и закрепленным правилом подсчета баллов в окончательном аналитическом наборе данных. Эти проверки подтвердили, что кодирование пунктов, присвоение обратных баллов, обработка пропущенных пунктов и агрегирование баллов были выполнены без обнаружимых ошибок в диапазонах.
В рамках данного рабочего процесса также были созданы примеры субоптимального аудита, иллюстрирующие способы обнаружения ошибок или сомнительных результатов перед финальным анализом. Во время одного из сеансов аудита было выявлено неправильно рассчитанное значение субъективного благополучия с обратной шкалой, так как в логе проверки подсчета сравнивались исходное значение, ожидаемая формула «обратный балл = 7 - исходный балл», производное значение и итоговый диапазон шкалы. Производная переменная была исправлена, показатель субъективного благополучия перерассчитан, а все последующие результаты описательного анализа, корреляции, сравнения, регрессии, диагностические данные и исходные данные для графиков были сформированы заново. В другом промежуточном рабочем файле в ходе проверки диапазонов было обнаружено значение пункта, выходящее за допустимые пределы; было установлено, что ошибка возникла при работе с электронной таблицей, а не в заблокированном исходном экспорте. Рабочая копия была исправлена и задокументирована без изменения каких-либо корректных экстремальных ответов. Также было рассмотрено предупреждение о надежности, когда один пункт показал более низкую скорректированную корреляцию «пункт-итог», чем остальные пункты той же шкалы; поскольку формулировка пункта, направление оценки и соответствие конструкту были верными, пункт был сохранен. Было выявлено несоответствие в предварительной визуализации, когда рисунок не совпадал с проверенной числовой исходной таблицей; рисунок был повторно создан на основе проверенной таблицы, а запись о источнике рисунка обновлена. Эти примеры демонстрируют, что данный рабочий процесс не только генерирует корректные результаты, но и позволяет обнаруживать ошибки кодирования, проблемы с диапазонами, предупреждения о надежности, несоответствия между рисунками и источниками, а также вопросы качества ответов с помощью контрольного журнала аудита.
Описательные характеристики и внутренняя согласованность
Пять переменных шкального уровня продемонстрировали приемлемую вариативность. Средний балл отрицательных эмоций составил 2.099 ± 0.391, а средний балл академической прокрастинации — 2.639 ± 0.484. Чувство принадлежности к школе и мышление высшего порядка показали умеренно высокие средние значения: 3.343 ± 0.390 и 3.627 ± 0.418 соответственно. Средний балл субъективного благополучия составил 3.784 ± 0.543. Ни одна из шкал не продемонстрировала выраженного эффекта пола или потолка, а доля респондентов с теоретическим минимумом или максимумом составила менее 2.0% для каждой шкалы.
Внутренняя согласованность была приемлемой для всех пяти шкал. Значения альфа Кронбаха варьировались от 0,834 до 0,899, что превышало заранее установленный порог 0,70. Наивысшая внутренняя согласованность наблюдалась для показателя отрицательных эмоций (альфа Кронбаха 0,899), за которым следовал показатель субъективного благополучия (0,895). Значения омега Макдональда варьировались от 0,842 до 0,906, и оценки омеги не изменили интерпретацию надежности. Анализ исправленной корреляции пунктов с итогом не выявил пунктов, требующих удаления. Описательная статистика и оценки надежности представлены в Таблице 5.
Структура корреляций между переменными на уровне шкал
Корреляционная матрица использовалась в качестве описательного показателя взаимосвязи и для проверки направления подсчета баллов. Перед расчетом коэффициентов корреляции Пирсона были изучены распределения шкал и двумерные диаграммы рассеяния. Ни одна из переменных не продемонстрировала сильной асимметрии или эксцесса, и ни на одном двумерном графике не было выявлено выраженного нелинейного паттерна, который мог бы сделать описательный корреляционный анализ Пирсона некорректным. Субъективное благополучие отрицательно коррелировало с негативными эмоциями (r = -0,496) и академической прокрастинацией (r = -0,294) и положительно коррелировало с чувством принадлежности к школе (r = 0,481) и мышлением высокого порядка (r = 0,386). Остальные взаимосвязи соответствовали той же логике подсчета баллов: негативные эмоции положительно коррелировали с академической прокрастинацией (r = 0,270) и отрицательно коррелировали с чувством принадлежности к школе (r = -0,346) и мышлением высокого порядка (r =-0,205); академическая прокрастинация отрицательно коррелировала с чувством принадлежности к школе (r = -0,222) и мышлением высокого порядка (r = -0,134); а чувство принадлежности к школе положительно коррелировало с мышлением высокого порядка (r = 0,310). Полная корреляционная матрица Пирсона представлена в Таблице 6.
Проверка чувствительности с помощью коэффициента Спирмена дала одинаковую интерпретацию направления связи для всех пар переменных. Корреляции Спирмена между субъективным благополучием и четырьмя предикторами составили: ρ = -0,502 для отрицательных эмоций, ρ = -0,301 для академической прокрастинации, ρ = 0,477 для чувства принадлежности к школе и ρ = 0,392 для мышления высокого порядка. Проверенная матрица Пирсона была использована в качестве исходной числовой таблицы для визуализации. На рисунке 2A представлена полная тепловая карта корреляций для пяти переменных на уровне шкал. На рисунке 2B показаны четыре корреляции с субъективным благополучием.
Контрастная демонстрация с использованием групп с высоким и низким уровнем субъективного благополучия
Правило группировки по 27% использовалось в качестве демонстрации контрастного рабочего процесса, а не как содержательная классификация реальных профилей благополучия. В результате применения этого правила были сформированы две группы равного размера: 113 респондентов в группе с высоким субъективным благополучием и 113 в группе с низким субъективным благополучием. Оставшиеся 194 респондента из средней части выборки были сохранены в полном аналитическом наборе данных, но исключены из данного контрастного сравнения. Случаев совпадения значений на границе групп, которые могли бы изменить распределение по группам, не наблюдалось.
В данном модуле было показано, что этот рабочий процесс позволяет создавать заданную переменную группировки, фильтровать аналитический набор данных, рассчитывать описательную статистику для конкретных групп, проводить сравнения групп с учетом соответствующих допущений и экспортировать проверенную исходную таблицу для визуализации. В группе с высоким уровнем субъективного благополучия наблюдался более низкий уровень негативных эмоций по сравнению с группой с низким уровнем субъективного благополучия (1.864 ± 0.358 против 2.335 ± 0.343; средняя разность = -0.472) и более низкий уровень академической прокрастинации (2.455 ± 0.476 против 2.801 ± 0.483; средняя разность = -0.346). Чувство принадлежности к школе и мышление высокого порядка были выше в группе с высоким уровнем субъективного благополучия, при этом средние разности составили 0.454 и 0.351 соответственно. Все четыре сравнения были значимыми (p < 0.001), при этом значения d Коэна составили -1.346 для негативных эмоций, -0.722 для академической прокрастинации, 1.279 для чувства принадлежности к школе и 0.860 для мышления высокого порядка. T-критерий Уэлча использовался в случаях, когда допущение о равенстве дисперсий не подтверждалось; в противном случае применялся стандартный t-критерий для независимых выборок. Эти результаты не следует интерпретировать как доказательство того, что выбранные предикторы определяют реальные профили благополучия учащихся, поскольку группы были сформированы на основе зависимой переменной, а затем сравнивались по коррелирующим переменным. Сравнение групп с высоким и низким уровнями представлено в Таблице 7.
Описательное сравнение по полу
Пол был исследован как описательная группирующая переменная. У женщин средний показатель отрицательных эмоций был несколько выше, чем у мужчин (2,129 ± 0,380 против 2,042 ± 0,407). Эта разница была статистически значимой, но имела небольшую величину (p = 0,033; d Коэна д = 0,224). Академическая прокрастинация, чувство принадлежности к школе, мышление высокого порядка и субъективное благополучие не продемонстрировали значимых гендерных различий. Средние показатели субъективного благополучия у респондентов женского и мужского пола были практически идентичны (3,781 ± 0,521 против 3,789 ± 0,583; p = 0,887; коэффициент Коэна д = -0,015). Критерий Уэлча t-проверки чувствительности тестов не изменили интерпретацию результатов сравнения по полу. Результаты различий по полу представлены в Таблица 8.
Регрессионная модель как пример построения модели и диагностической проверки
Модель множественной линейной регрессии была использована в качестве примера построения, диагностики и проверки модели на основе данных количественной оценки опросников. В качестве зависимой переменной был введен показатель субъективного благополучия, в то время как отрицательные эмоции, академическая прокрастинация, чувство принадлежности к школе и мышление высокого порядка были одновременно введены как предикторы на уровне шкалы. Целью данного модуля была демонстрация извлечения коэффициентов, проверки на мультиколлинеарность, диагностики остатков, оценки влияния, анализа чувствительности с поправкой на демографические данные, а также подготовки рисунков и источников.
Модель объяснила умеренную долю дисперсии субъективного благополучия, при этом R2 = 0.411 и скорректированный R2 = 0.406. Отрицательные эмоции продемонстрировали наибольший отрицательный стандартизированный коэффициент (B = -0.450, стандартизированный β = -0.324). Академическая прокрастинация также показала отрицательный коэффициент (B = -0.130, стандартизированный β = -0.116). Чувство принадлежности к школе и мышление высокого порядка продемонстрировали положительные стандартизированные коэффициенты β = 0.275 и β = 0.218 соответственно. Все четыре предиктора были статистически значимыми в подогнанной модели: отрицательные эмоции, чувство принадлежности к школе и мышление высокого порядка при p < 0.001, а академическая прокрастинация при p = 0.004. Мультиколлинеарность не была выявлена, так как все значения коэффициента усиления дисперсии (VIF) были ниже 1.24. Данные результаты регрессии представляют собой примеры проверки модели, а не окончательное психологическое объяснение благополучия студентов. В Таблице 9 приведены полные результаты регрессионного анализа.
Дополнительная модель с поправкой на демографические показатели была рассчитана путем добавления пола, возраста, курса обучения, категории учебного заведения и категории основной специальности к четырем психологическим предикторам. Скорректированная модель объяснила схожую долю дисперсии: R2 = 0.427 и скорректированный R2 = 0.414. Направление и статистическая интерпретация четырех психологических предикторов остались неизменными после учета демографических поправок. Модель чувствительности с поправкой на демографические показатели обобщена в Таблице 10. На Рисунке 3A представлены стандартизированные коэффициенты и 95% доверительные интервалы для четырех предикторов. На Рисунке 3B представлен диагностический график на основе стандартизированных прогнозируемых значений, стандартизированных остатков и расстояния Кука.
Диагностика регрессии и сохранение модели
Диагностика регрессии не выявила, что построенная модель определяется одним единственным влиятельным наблюдением. На графиках бивариативной и частичной регрессии не было обнаружено выраженной нелинейности. График остатков в зависимости от предсказанных значений не показал сильной гетероскедастичности или необычной кластеризации. Статистика Дарбина-Уотсона составила 1.93, что подтверждает приемлемую независимость остатков. График квантиль-квантиль (Q-Q plot) остатков не выявил серьезных отклонений от нормального распределения. Формальный тест на нормальность остатков оказался статистически значимым, W = 0.992, p = 0.031, однако Q-Q plot и размер выборки позволили сохранить линейную модель для дескриптивного анализа ассоциаций.
Две записи имели абсолютные стандартизированные остатки более 3,00. Ни одна запись не имела расстояния Кука более 1,00. Используя более чувствительный порог расстояния Кука >4/нгде n = 420 и 4/n = 0,0095; 17 записей были отмечены как потенциально влиятельные. Наибольшее расстояние Кука составило 0,037. Отмеченные случаи с остатками и влиянием были проверены по журналу скрининга, журналу верификации баллов и критериям соответствия. Ни в одном из них не было обнаружено признаков ошибок ввода данных, неправильного подсчета баллов, дублирующих ответов, несоответствия критериям отбора или задокументированных проблем с качеством ответов; следовательно, данные случаи были сохранены в окончательной модели. Проверка чувствительности к влиянию, исключающая случаи с расстоянием Кука >4/n, что привело к такой же интерпретации рабочего процесса, как и в основной модели. Максимальное абсолютное изменение стандартизированных коэффициентов составило 0,026, а скорректированный R2 изменилось с 0,406 до 0,405. Результаты диагностики и чувствительности обобщены в Таблица 11.
Внутренняя верификация аналитического конвейера
Рабочий процесс был повторен для очищенного и оцененного аналитического набора данных с использованием тех же правил оценки, порогов принятия решений и файла трассировки анализа. Были повторно проведены анализ внутренней согласованности, расчет описательной статистики, корреляционный анализ, сравнение групп с высокими и низкими показателями, сравнение по полу, регрессионное моделирование, диагностическая проверка и подготовка исходных данных для визуализации. Повторно полученные результаты совпали с исходными данными описательной статистики, корреляционной матрицей, значениями сравнения групп, коэффициентами регрессии, результатами диагностики и исходными файлами визуализации. Это подтвердило вычислительную стабильность аналитического конвейера при применении к одному и тому же фиксированному аналитическому набору данных. Данная проверка не является независимым подтверждением процедурной воспроизводимости, которая потребовала бы от независимого аналитика применить весь рабочий процесс к фиксированному необработанному экспорту данных и получить те же задокументированные результаты.
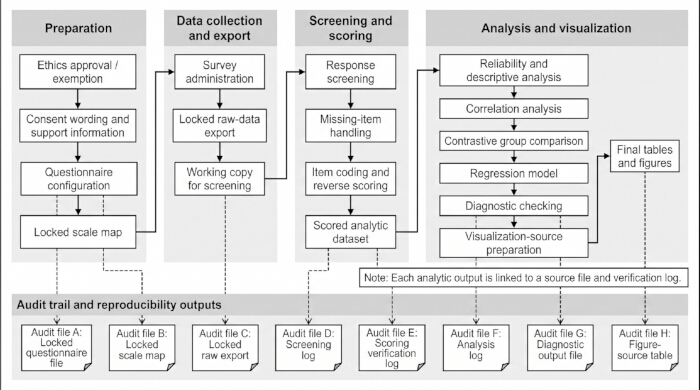
Рисунок 1: Рабочий процесс обработки данных о субъективном благополучии, полученных с помощью опросников. На схеме представлена последовательность протокола и основные результаты аудита, включая подготовку этических аспектов, настройку опросника, проведение опроса, экспорт необработанных данных, карту шкал, журнал скрининга, итоговый аналитический набор данных с баллами, верифицированные таблицы анализа, диагностику регрессии, исходные файлы рисунков и результаты визуализации. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
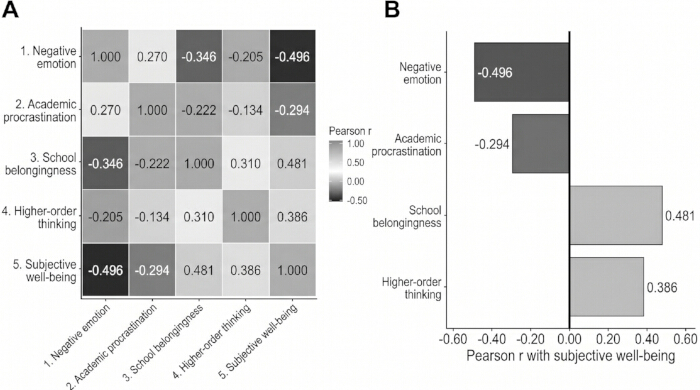
Рисунок 2: Структура корреляций между переменными на уровне шкал. (A) Тепловая карта корреляции Пирсона, построенная на основе проверенной корреляционной матрицы в Таблице 6. (B) Профиль корреляций с центром на субъективном благополучии, построенный на основе той же проверенной исходной таблицы. Представлены все пять переменных на уровне шкал: отрицательные эмоции, академическая прокрастинация, чувство принадлежности к школе, мышление высокого порядка и субъективное благополучие. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
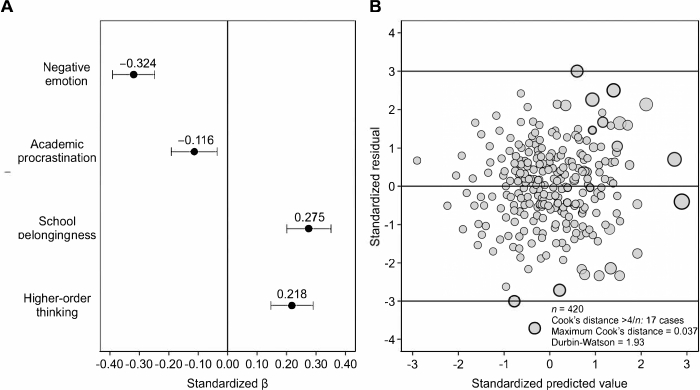
Рисунок 3: Визуализация коэффициентов регрессии и диагностических показателей. (A) Стандартизированные коэффициенты регрессии и 95% доверительные интервалы, полученные на основе основных результатов регрессионного анализа в Таблице 9. (B) Диагностический график регрессии, построенный по стандартизированным прогнозируемым значениям, стандартизированным остаткам и значениям расстояния Кука, обобщенным в Таблице 11. Более высокие значения расстояния Кука указывают на наблюдения, которые могут оказывать большее влияние на подогнанную модель. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Таблица 1: Структура опросника и система подсчета баллов по шкале.В этой таблице обобщена система измерений, включая название конструкта, исходный инструмент, ссылку на источник, статус адаптации или документации, номер пункта, диапазон ответов, направление оценки, необходимость обратного подсчета баллов, метод подсчета, итоговую переменную уровня шкалы и роль в протоколе. Пожалуйста, нажмите здесь, чтобы скачать эту таблицу.
Таблица 2: Критерии скрининга ответов и принятия аналитических решений.В данной таблице перечислены заранее определенные критерии для проверки согласия, отбора подходящих участников, анализа дублирующих ответов, обработки пропущенных данных, маркировки длительности ответов, выявления однообразных ответов, диапазонов допустимых значений, оценки надежности, классификации групп с высокими и низкими показателями, диагностики регрессии и проверок чувствительности. Пожалуйста, нажмите здесь, чтобы скачать эту таблицу.
Таблица 3: Схема отбора от поданных анкет до окончательного аналитического набора данных. В этой таблице указано количество поданных анкет, помеченных записей, удаленных записей, сохраненных записей и источников верификации на каждом этапе отбора. Продолжительность заполнения и однотипные ответы рассматривались как признаки качества ответов, а не как критерии автоматического исключения. Пожалуйста, нажмите здесь, чтобы скачать эту таблицу.
Таблица 4: Демографические характеристики аналитического набора данных.В этой таблице обобщены сохраненные анонимизированные записи студентов после скрининга ответов, включая пол, возраст, курс обучения в бакалавриате, категорию учебного заведения и категорию основной специальности. Перед представлением данных ячейки с демографическими сведениями были проверены на риск косвенной идентификации личности. Пожалуйста, нажмите здесь, чтобы скачать эту таблицу.
Таблица 5: Описательная статистика, проверка диапазона и внутренняя согласованность пяти переменных на уровне шкал. В данной таблице представлены номер пункта, теоретический диапазон, наблюдаемый диапазон, среднее значение, стандартное отклонение, альфа Кронбаха, омега Макдональда, а также концентрация пола/потолка для отрицательных эмоций, академической прокрастинации, чувства принадлежности к школе, мышления высокого порядка и субъективного благополучия. Пожалуйста, нажмите здесь, чтобы скачать эту таблицу.
Таблица 6: Матрица корреляции Пирсона для переменных на уровне шкал. В этой таблице представлены коэффициенты корреляции Пирсона между отрицательными эмоциями, академической прокрастинацией, чувством принадлежности к школе, мышлением высшего порядка и субъективным благополучием. Матрица использовалась для описательного анализа взаимосвязей и в качестве этапа проверки направления подсчета баллов. Пожалуйста, нажмите здесь, чтобы скачать эту таблицу.
Таблица 7: Контрастивное сравнение групп с высоким и низким уровнем субъективного благополучия. В данной таблице сравниваются показатели отрицательных эмоций, академической прокрастинации, чувства принадлежности к школе и мышления высокого порядка у респондентов, вошедших в верхние 27% и нижние 27% по показателям субъективного благополучия. Данное сравнение демонстрирует рабочий процесс группировки и сопоставления, а не содержательную классификацию профилей благополучия. Пожалуйста, нажмите здесь, чтобы скачать эту таблицу.
Таблица 8: Описательное сравнение по полу. В данной таблице представлены результаты описательного сравнения показателей негативных эмоций, академической прокрастинации, чувства принадлежности к школе, мышления высокого порядка и субъективного благополучия в зависимости от пола. Пол рассматривался как описательная группирующая переменная. Пожалуйста, нажмите здесь, чтобы скачать эту таблицу.
Таблица 9: Основная модель множественной линейной регрессии для прогнозирования субъективного благополучия. В данной таблице представлена основная регрессионная модель, в которой субъективное благополучие было зависимой переменной, а отрицательные эмоции, академическая прокрастинация, чувство принадлежности к школе и мышление высокого порядка были введены одновременно в качестве предикторов на уровне шкал. Приведены значения стандартной ошибки, доверительного интервала и фактора инфляции дисперсии. Пожалуйста, нажмите здесь, чтобы скачать эту таблицу.
Таблица 10: Регрессионная модель анализа чувствительности с поправкой на демографические данные для прогнозирования субъективного благополучия. В этой таблице представлены четыре психологических предиктора после корректировки по полу, возрасту, курсу обучения в бакалавриате, категории учебного заведения и категории академической специальности. Категориальные демографические переменные были введены с использованием фиктивного кодирования. Включены значения стандартной ошибки, доверительного интервала и фактора инфляции дисперсии. Пожалуйста, нажмите здесь, чтобы скачать эту таблицу.
Таблица 11: Диагностика регрессии и проверка чувствительности влияния. В данной таблице обобщены результаты анализа остатков, влияния и диагностики модели, включая стандартизированные остатки, расстояние Кука > 1,00, расстояние Кука > 4/n, максимальное расстояние Кука, статистику Дарбина-Уотсона, график Q-Q остатков, тест на нормальность остатков, график зависимости остатков от прогнозируемых значений, проверку линейности и анализ чувствительности влияния. Пожалуйста, нажмите здесь, чтобы скачать эту таблицу.
Дополнительный файл 1: Структура опросника, происхождение шкал и документация по подсчету баллов.В данном дополнительном файле представлены порядок проведения опроса, формулировка информированного согласия, демографические переменные, документация по исходным инструментам, коды пунктов, опорные значения ответов, информация об адаптации и статусе документации, направление подсчета баллов, правила обратного подсчета, построение итоговых переменных на уровне шкал, правила обработки пропущенных пунктов, поля связи с качеством ответов, правила проверки диапазонов и справочные связи для пяти конструктов опросника. Файл служит дополнением к опроснику/кодовой книге для документального оформления программирования шкал, подсчета баллов и верификации в рабочем процессе. Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Обсуждение
Данный протокол стандартизирует распространенный, но часто недостаточно подробно описываемый процесс в исследованиях благополучия на основе опросников: переход от необработанных записей ответов к отфильтрованным данным, вычисленным значениям шкал, статистическим результатам и файлам, готовым для визуализации. Вклад этой работы заключается не в разработке новой теории субъективного благополучия или предложении каузальной модели. Вместо этого рабочий процесс обеспечивает проверяемый путь настройки опросника, скрининга ответов, подсчета баллов по шкалам, проверки надежности, дескриптивного анализа, анализа ассоциаций, диагностики регрессии и верификации источников данных для графиков. Это разграничение важно, поскольку проверяемость исследований на основе опросов зависит от процедурных решений, которые часто принимаются до начала статистической интерпретации, включая определение того, какие записи будут сохранены, как обрабатываются пропущенные пункты, каким образом обрабатываются пункты с обратной шкалой и как числовые исходные таблицы связаны с визуальными результатами. Смещение этих решений в область явных определений позволяет сократить количество сомнительных практик измерения в исследованиях на основе шкал23 и способствует формированию более прозрачной культуры исследований24.
Центральной особенностью протокола является использование конкретных артефактов аудита, а не только словесного описания. Пересмотренный рабочий процесс связывает каждый конструкт с исходным инструментом, диапазоном пунктов, якорями ответов, направлением оценки, правилом обратного подсчета баллов, итоговой переменной уровня шкалы, а также информацией об адаптации или статусе документации. Контрольный журнал (audit trail) включает заблокированный файл опросника, заблокированную карту шкал, заблокированный файл необработанного экспорта, журнал скрининга, журнал проверки подсчета баллов, журнал анализа, файл диагностического вывода и таблицу источников рисунков. Эти файлы позволяют уточнить, какая версия опросника применялась, какие записи были исключены или сохранены, каким образом рассчитывались баллы и какая проверенная таблица использовалась для создания каждого рисунка. В случаях, когда данные на уровне участников не могут быть опубликованы, синтетический набор данных с той же структурой переменных и заполненными журналами скрининга/подсчета баллов позволяет читателям протестировать вычислительный процесс без доступа к идентифицируемым или косвенно идентифицируемым записям. Такая структура, основанная на артефактах, соответствует принципу FAIR, согласно которому повторно используемые результаты исследований требуют четкого определения происхождения, структуры и условий доступа25.
Представленные результаты следует рассматривать как примеры результатов рабочего процесса, а не как содержательные доказательства психологических детерминант благополучия студентов. Сравнение высокого и низкого уровней субъективного благополучия было включено для того, чтобы продемонстрировать, как может быть реализовано, проверено и описано заранее определенное правило группировки; его не следует интерпретировать как реальную классификацию профилей благополучия. Аналогично, регрессионная модель демонстрирует, как можно моделировать данные опросников в виде баллов, проверять их на мультиколлинеарность, оценивать с помощью диагностики остатков и влияния, а также связывать с проверенной таблицей источников рисунков. Она не устанавливает, что отрицательные эмоции, академическая прокрастинация, чувство принадлежности к школе или мышление высокого порядка причинно определяют субъективное благополучие. Поскольку все основные переменные были собраны с помощью одного и того же опросника самоотчета в один момент времени, нельзя исключить влияние систематической ошибки общего метода, эффектов стиля ответов и общего контекста измерения26.
Данный рабочий процесс также не заменяет полноценную психометрическую валидацию. Альфа Кронбаха, омега Макдональда, проверка наблюдаемого диапазона, анализ взаимосвязи пунктов с итоговым баллом и проверка реверсивного кодирования являются полезными этапами контроля качества для проверяемого процесса подсчета баллов, однако они не устанавливают факторную валидность, инвариантность измерений, свойства ответов на пункты или сопоставимость между группами. В исследованиях, в которых опросник используется для существенного тестирования теории, следует проводить подтверждающий факторный анализ, тестирование инвариантности измерений в соответствующих демографических или институциональных группах, а также дополнительные проверки валидности, когда это уместно27. Таким образом, настоящий протокол следует рассматривать как проверяемую структуру обработки данных и отчетности, а не как полное валидационное исследование включенных конструктов.
Рабочий процесс был продемонстрирован на примере одного студента бакалавриата с использованием данных самоотчета из опросника, собранных в один момент времени, без внешней валидации. Не следует предполагать возможность его прямого переноса на другие популяции, дисциплины, учреждения, языки и культурные среды. При повторном использовании рабочего процесса в другом контексте карту шкал следует создать заново, а не копировать механически. Исследователям необходимо проверить происхождение пунктов, статус перевода или адаптации, культурную и контекстуальную зависимость пунктов благополучия, якоря ответов, правила обратного подсчета баллов, интерпретацию показателей и местные этические требования. Процедуры перевода и адаптации требуют четкого документирования, а не неформального изменения формулировок28, а интерпретация результатов образовательных и психологических тестов должна оставаться связанной с доказательствами применимости для предполагаемого использования и конкретной популяции29.
На практике данный протокол наиболее полезен в качестве проверяемой основы для обработки данных и отчетности в исследованиях благополучия, основанных на использовании опросников. Он помогает исследователям сделать процессы очистки, подсчета баллов, диагностики и визуализации прозрачными до начала интерпретации. В будущих работах следует протестировать этот рабочий процесс на независимых выборках, в различных институциональных условиях, при использовании лонгитюдных дизайнов и с привлечением независимых групп аналитиков для репликации. Внешняя валидация, предварительная регистрация правил принятия решений, использование общих синтетических наборов данных, предоставление заполненных примеров журналов скрининга/подсчета баллов и независимая репликация аналитиками дополнительно повысят переносимость и достоверность данного рабочего процесса.
Раскрытие информации
Авторы заявляют об отсутствии конфликта интересов.
Благодарности
Авторы благодарят студентов колледжа, принявших участие в анкетировании, за поддержку в процессе сбора данных. Авторы также благодарят соответствующих преподавателей и научных сотрудников за помощь в распространении анкет, систематизации данных, проверке результатов, а также в подготовке таблиц и рисунков. Данная работа не получила специального финансирования.
Материалы
| Имя | Компания | Каталожный номер | Комментарии |
|---|---|---|---|
| broom R package | CRAN | R package | Используется для преобразования результатов регрессии в структурированные таблицы коэффициентов и сводки моделей. |
| car R package | CRAN | R package | Используется для проверки коэффициента инфляции дисперсии (VIF) и диагностической поддержки регрессии. |
| Depression Anxiety Stress Scales-21 source documentation | Psychology Foundation of Australia | Lovibond and Lovibond, 1995 | Исходная документация для раздела отрицательных эмоций. В рабочем процессе использовались адаптированные для исследования формулировки, соответствующие современным методам оценки отрицательных эмоциональных состояний. |
| dplyr R package | CRAN | R package | Используется для фильтрации, перекодирования, группировки данных, создания сводок по потоку отбора участников и подготовки аналитических таблиц. |
| ggplot2 R package | CRAN | R package | Используется для построения тепловой карты корреляций, графика корреляции субъективного благополучия, графика коэффициентов регрессии и диагностических диаграмм. |
| Higher-order thinking measurement source documentation | Springer Nature | DOI: 10.1038/s41598-024-70908-3 | Исходная документация для раздела мышления высокого порядка. В рабочем процессе использовался адаптированный для исследования набор пунктов, соответствующих аналитическому, оценочному, рефлексивному, интегративному и доказательному мышлению. |
| IBM SPSS Statistics | IBM Corp. | Version 29.0.2.0 | Используется для расчета описательной статистики, альфа Кронбаха’, корреляции Пирсона, t-критериев для независимых выборок и критерия Уэлча’, множественной линейной регрессии, статистики Дарбина-Уотсона, стандартизированных остатков, значений рычага, дистанции Кука’ и коэффициентов инфляции дисперсии. |
| psych R package | CRAN | R package | Используется для психометрических сводок, проверки альфа Кронбаха’ и омега Макдональда’. |
| Psychological Sense of School Membership Scale source documentation | Wiley | Psychol Sch. 1993;30(1):79-90 | Исходная документация для раздела принадлежности к школе. В рабочем процессе использовались адаптированные для исследования формулировки, соответствующие субъективному ощущению принятия, связи, поддержки и принадлежности в школьной среде. |
| R statistical environment | R Foundation for Statistical Computing | Version 4.4.2 | Используется для вторичной аналитической проверки, расчета омега Макдональда’, проверки чувствительности по Спирмену, подготовки результатов регрессии, подготовки диагностических данных и создания исходных данных для визуализации. |
| readxl R package | CRAN | R package | Используется для импорта экспортированных данных опросников из электронных таблиц в рабочий процесс проверки в R. |
| Subjective Well-being Scale for Chinese Citizens source documentation | Scientific & Academic Publishing | DOI: 10.5923/j.ijap.20190905.01 | Исходная документация для раздела субъективного благополучия. В рабочем процессе использовались адаптированные для исследования формулировки и пункты с обратной шкалой оценки, соответствующие удовлетворенности жизнью, смыслу, поддержке, прогрессу, неудовлетворенности, беспомощности и опыту благополучия, связанному со стрессом. |
| Supplementary File 1: Questionnaire structure and scale documentation | Authors | Supplementary File 1 | Содержит структуру проведенного опроса, порядок конструктов, происхождение шкал, коды пунктов, якоря ответов, направление подсчета баллов, правила обратного кодирования, построение баллов на уровне шкал и информацию о статусе документации. |
| Tuckman Procrastination Scale source documentation | SAGE Publications | Educ Psychol Meas. 1991;51(2):473-480 | Исходная документация для раздела академической прокрастинации. В рабочем процессе использовались адаптированные для исследования формулировки, соответствующие академическим задержкам и поведению по откладыванию задач. |
| Wenjuanxing online questionnaire platform | Changsha Ranxing Information Technology Co., Ltd. | Web-based platform | Используется для получения электронного согласия, программирования опросника, сбора ответов, фиксации меток времени, записи длительности заполнения, проверки дубликатов заявок и экспорта первичных ответов. |
Ссылки
- 1. Khatri P et al. Student well-being in higher education: scale development and validation with implications for management education. Int J Manag Educ. 2024;22(1):100933.
- Mirzaei A, Carter SR, Patanwala AE, Schneider CR. Missing data in surveys: key concepts, approaches, and applications. Res Social Adm Pharm. 2022;18(2):2308-16.
- Gummer T, Roßmann J, Silber H. Using instructed response items as attention checks in web surveys: properties and implementation. Sociol Methods Res. 2021;50(1):238-64.
- Johansson F et al. Associations between procrastination and subsequent health outcomes among university students in Sweden. JAMA Netw Open. 2023;6(1):e2249346.
- Li X, Kuo YL, Huggins TJ. Perceived feedback and school belonging: the mediating role of subjective well-being. Front Psychol. 2024;15:1450788.
- Sönning L. Ordinal response scales: psychometric grounding for design and analysis. Res Methods Appl Linguist. 2024;3(3):100156.
- Song P et al. Predictive analysis of college students’ academic procrastination behavior based on a decision tree model. Humanit Soc Sci Commun. 2024;11:869.
- Dudáš A. Graphical representation of data prediction potential: correlation graphs and correlation chains. Vis Comput. 2024;40(10):6969-82.
- Niessen ASM, Meijer RR, Tendeiro JN. Detecting careless respondents in web-based questionnaires: which method to use? J Res Pers. 2016;63:1-11.
- Parsons J, Bao L. A unified approach for outliers and influential data detection: the value of information in retrospect. Stat. 2022;11(1):e442.
- Donche V et al. Careless responding in online student learning surveys: profiles and impact on data quality. Frontline Learn Res. 2026;13(3):1-14.
- Lovibond SH, Lovibond PF. Manual for the Depression Anxiety Stress Scales. 2nd ed. Psychology Foundation; Sydney; 1995.
- Tuckman BW. The development and concurrent validity of the Procrastination Scale. Educ Psychol Meas. 1991;51(2):473-80.
- Goodenow C. The psychological sense of school membership among adolescents: scale development and educational correlates. Psychol Sch. 1993;30(1):79-90.
- Li D, Fan X, Meng L. Development and validation of a higher-order thinking skills (HOTS) scale for major students in the interior design discipline for blended learning. Sci Rep. 2024;14:20287.
- Huang L, Xing Z. A nationwide study on Subjective Well-being Scale for Chinese Citizens (SWBS-cc). Int J Appl Psychol. 2019;9(5):117-27.
- DeSimone JA, Harms PD, DeSimone AJ. Best practice recommendations for data screening. J Organ Behav. 2015;36(2):171-81.
- Revilla MA, Saris WE, Krosnick JA. Choosing the number of categories in agree-disagree scales. Sociol Methods Res. 2014;43(1):73-97.
- Muszyński M. Attention checks and how to use them: review and practical recommendations. ASK Res Methods. 2023;32(1):3-38.
- McNeish D. Thanks coefficient alpha, we’ll take it from here. Psychol Methods. 2018;23(3):412-33.
- Romeo I, Stanislaw H, McCreary J, Hawley M. The importance of belonging for well-being in college students. PLOS Ment Health. 2024;1(1):e0000057.
- Kastellec JP, Leoni EL. Using graphs instead of tables in political science. Perspect Polit. 2007;5(4):755-71.
- Flake JK, Fried EI. Measurement schmeasurement: questionable measurement practices and how to avoid them. Adv Methods Pract Psychol Sci. 2020;3(4):456-65.
- Nosek BA et al. Promoting an open research culture. Science. 2015;348(6242):1422-5.
- Wilkinson MD et al. The FAIR Guiding Principles for scientific data management and stewardship. Sci Data. 2016;3:160018.
- Podsakoff PM, MacKenzie SB, Lee JY, Podsakoff NP. Common method biases in behavioral research: a critical review of the literature and recommended remedies. J Appl Psychol. 2003;88(5):879-903.
- Vandenberg RJ, Lance CE. A review and synthesis of the measurement invariance literature: suggestions, practices, and recommendations for organizational research. Organ Res Methods. 2000;3(1):4-70.
- van de Vijver FJR, Hambleton RK. Translating tests: some practical guidelines. Eur Psychol. 1996;1(2):89-99.
- American Educational Research Association, American Psychological Association, National Council on Measurement in Education. Standards for educational and psychological testing. American Educational Research Association; Washington, DC; 2014.