В данном исследовании представлена концепция киберфизического взаимодействия в рамках Индустрии 5.0 на базе объяснимого ИИ, в которой для обнаружения акустических аномалий в промышленности на наборе данных MIMII используются CNN-трансформер и SHAP. Интеграция граничных вычислений обеспечивает интерпретируемое, ориентированное на человека прогностическое техническое обслуживание.
Для просмотра этого контента требуется подписка на JoVE. Войдите или начните свой бесплатный пробный период.
Исследовательская статья
Киберфизическое взаимодействие с поддержкой объяснимого ИИ для устойчивого производства в рамках Индустрии 5.0
В этой статье
Краткое содержание
Аннотация
В данном исследовании мы представляем инновационный подход к устойчивому производству промышленных деталей с использованием системы киберфизического взаимодействия на базе объяснимого искусственного интеллекта (XAI) для Индустрии 5.0. Было установлено, что современные киберфизические человеческие системы (CPHS) интегрируют ИИ лишь в ограниченной степени и зачастую лишены объяснимости. Следовательно, существует необходимость повышения их масштабируемости и гибкости в соответствии с принципами Индустрии 5.0: устойчивостью, долгосрочной жизнеспособностью и человекоцентричностью. Чтобы устранить эти недостатки, мы предлагаем архитектуру, которая интегрирует глубокое обучение и объяснимый ИИ в экосистему киберфизических систем (CPS) для обеспечения интеллектуального и объяснимого принятия решений. В частности, для обнаружения неисправностей оборудования по акустическим сигналам мы используем набор данных Malfunctioning Industrial Machine Investigation and Inspection (MIMII). Аудиосигналы подвергаются спектральному преобразованию для генерации изображений-спектрограмм, которые затем обрабатываются сверточной нейронной сетью (CNN) для извлечения пространственных признаков и трансформерным кодировщиком для временных признаков. Для повышения прозрачности и содействия взаимодействию по принципу «человек в контуре управления» (human-in-the-loop) используется подход на основе аддитивных объяснений Шепли (SHAP), который помогает операторам понять процесс принятия решений системой, выделяя входные признаки, влияющие на прогнозы модели. Кроме того, разработанная структура применяется в киберфизической системе на базе граничных вычислений (edge computing) для обеспечения низкой задержки и низкого энергопотребления при предоставлении своевременных ответов, что способствует созданию устойчивой производственной среды. Экспериментальные результаты показывают, что предложенная архитектура CNN-Transformer достигает точности 98,5% и превосходит существующие системы CPHS, сохраняя при этом низкую задержку. Использование объяснимого ИИ в такой системе киберфизического взаимодействия значительно повышает доверие оператора и обеспечивает бесшовное взаимодействие человека и машины.
Введение
Переход от Индустрии 4.0, в которой основной акцент делался на технологиях, механизации и коммуникациях, к новой модели Индустрии 5.0, сочетающей технологический прогресс с адаптивностью, устойчивым развитием и человекоцентричностью, повлиял на динамическую эволюцию промышленных систем1,2. Европейская комиссия определяет Индустрию 5.0 как парадигму, ориентированную не только на производительность и эффективность, но и на три столпа: человекоцентричность, устойчивость и жизнестойкость. Важно отметить, что недавние исследования указали на роль систем ИИ, взаимодействия человека и машины, а также устойчивого производства в качестве основных движущих сил среды Индустрии 5.03,4. Традиционные методы технического обслуживания более не являются достаточными в этой развивающейся промышленной среде. Чтобы обеспечить жизнестойкость в сложных, нестабильных контекстах, техническое обслуживание должно эволюционировать в более адаптивную и системную форму5. С 2011 года Индустрия 4.0 была доминирующей моделью промышленной трансформации в Европе, стимулируя цифровую трансформацию предприятий для оптимизации операций и максимального использования имеющихся ресурсов4. Таким образом, крайне важно повышать эффективность, не исключая человеческий труд из производства и обеспечивая при этом охрану здоровья и безопасность работников. В связи с этим бизнес и академическое сообщество начали определять принципы парадигмы Индустрии 5.05,6,7, отчасти опираясь на японскую концепцию Общества 5.08,9,10,11. Несмотря на повышенное внимание к устойчивому техническому обслуживанию в современной литературе, большинство существующих систематических оценок остаются фрагментарными или ограниченными конкретной областью, в них отсутствует комплексная структура, объединяющая жизнестойкость, устойчивость и ИИ. Например, авторы исследуют методы устойчивого технического обслуживания для конкретных систем или стратегий, включая устойчивое полное продуктивное обслуживание (STPM), в то время как другие исследователи говорят о внедрении аспектов устойчивости в методы технического обслуживания12,13,14. Автор провел комплексную оценку критериев внедрения устойчивого развития и выделил технологические факторы, которые позволяют производству оказывать положительное устойчивое воздействие15. Тем не менее, в рамках парадигмы Индустрии 5.0 устойчивость, жизнестойкость и принятие решений на основе ИИ не полностью интегрированы ни в одной из этих работ. В результате вопросы устойчивого развития часто решаются с помощью отдельных методов технического обслуживания. SHAP выделяется среди других методов объяснимого искусственного интеллекта (XAI) благодаря своему теоретически обоснованному методу атрибуции признаков16,17,18.
Принятие решений на основе данных стало возможным благодаря ИИ, однако для создания точных моделей часто требуются большие объемы данных. Традиционные методы машинного обучения (ML), такие как деревья решений, логистическая регрессия и линейная регрессия, часто демонстрируют низкую эффективность в ситуациях с высокой степенью нелинейности, поскольку они предполагают относительно простое распределение данных19. Глубокие нейронные сети (DNN) обходят эти ограничения за счет изучения сложных представлений признаков из массивных наборов данных20. Согласно исследованиям21, более глубокие сети часто справляются со сложными задачами принятия решений лучше, чем неглубокие структуры, однако увеличение их глубины и сложности параметров делает модель менее интерпретируемой22.
Киберфизическая система (КФС) является важнейшей вспомогательной технологией для производства в рамках Индустрии 5.0, поскольку она объединяет распределенный интеллект, встроенные компьютеры, физические процессы и связь. Для обеспечения гибких, интеллектуальных и оперативных промышленных операций современные КФС активно интегрируют граничные вычисления, граничный ИИ и «зеленый» интернет вещей (G-IoT)23,24. В последних исследованиях по техническому обслуживанию 4.0 (Maintenance 4.0) и «умному» техническому обслуживанию особое внимание уделялось устойчивости и жизнестойкости. В то время как в более ранних работах изучалась значимость технологий Maintenance 4.0 для устойчивого производства и предлагались модели для обеспечения устойчивого технического обслуживания, библиометрические и систематические исследования были посвящены оценке технологий «умного» технического обслуживания25,26,27,28. Дальнейшие исследования были направлены на интеграцию устойчивого технического обслуживания в среду Индустрии 4.0 и ориентированные на устойчивость производственные системы29,30,31,32. Концепция Оператора 4.033, человекоцентричные структуры Индустрии 5.034 и социально-экономические перспективы35 привлекли значительное внимание к человекоцентричному техническому обслуживанию. Кроме того, в последних исследованиях подчеркиваются достижения в области цифрового технического обслуживания36, прогностического и прескриптивного обслуживания37,38, а также стратегий устойчивого технического обслуживания39,40. Несмотря на эти успехи, исследования остаются разрозненными, и лишь немногие из них предлагают целостную парадигму, объединяющую объяснимый ИИ, устойчивость, жизнестойкость и человекоцентричное киберфизическое взаимодействие. Киберфизические системы (КФС) не достигли полной автономности, несмотря на их растущее внедрение, и парадигма Индустрии 5.0 не стремится к этому. Напротив, Индустрия 5.0 делает больший акцент на человеческом надзоре, сотрудничестве и принятии решений. Расширяя традиционные КФС, кибер-человеческие системы, такие как КФС с участием человека в контуре (HiLCPSs)41, человекоцентричные КФС (HCPSs)42,43 и киберфизические человеческие системы (CPHSs)44, интегрируют человеческое мышление и взаимодействие в киберфизические процессы. Эта интеграция повышает адаптивность, прозрачность, безопасность и жизнестойкость за счет обеспечения взаимодействия в режиме реального времени между интеллектуальными системами и операторами-людьми45,46.
Методы обнаружения аудиоаномалий в промышленности значительно улучшились благодаря новым архитектурам, включая Vision Transformer (ViT), Audio Spectrogram Transformer (AST), Conformer и самообучение; однако их интеграция в объяснимые киберфизические системы для Индустрии 5.0 остается ограниченной. Без объединения объяснимости, развертывания на периферии (edge deployment) и поддержки принятия решений с участием человека в рамках единой структуры, современные исследования сосредоточены преимущественно на точности классификации или на интерпретируемости на основе XAI post hoc. В данном исследовании предлагается новая киберфизическая архитектура совместной работы на базе CNN-Transformer с поддержкой объяснимого ИИ, которая объединяет периферийные вычисления, моделирование временных зависимостей, объяснимость на основе SHAP, обучение пространственным признакам и человекоориентированную поддержку принятия решений, что позволяет обеспечить устойчивое производство в рамках Индустрии 5.0 и преодолеть эти ограничения.
Таким образом, сохраняется значительный пробел в исследованиях. Современные методы обнаружения акустических аномалий на базе CNN/Transformer ориентированы на показатели классификации, но в них отсутствует киберфизическое взаимодействие и интерпретируемость. В то время как концепции Индустрии 5.0 предлагают человекоцентричные модели, которые не объединяют интерпретируемое глубокое обучение, граничные вычисления и принятие решений с участием оператора в единую систему, методы прогностического обслуживания на основе XAI повышают прозрачность, но функционируют независимо от архитектур CPHS. Следовательно, до сих пор отсутствует единая киберфизическая человеческая система Индустрии 5.0, которая интегрировала бы точное обнаружение слуховых аномалий, интерпретируемость на основе SHAP, развертывание на граничных устройствах и взаимодействие по принципу «человек в контуре управления».
В данной работе предлагается новая парадигма киберфизического взаимодействия на базе CNN-Transformer с поддержкой объяснимого ИИ для Индустрии 5.0, призванная преодолеть эти ограничения. Предложенная архитектура объединяет развертывание граничных вычислений, извлечение пространственных признаков на основе CNN, изучение временных зависимостей на основе Transformer, объяснимость на базе SHAP и поддержку принятия решений с участием человека в единую структуру CPHS. В отличие от существующих методов, в которых эти элементы рассматриваются независимо, предлагаемая структура представляет собой комплексное решение, которое одновременно повышает эффективность обнаружения аномалий, прозрачность модели, операционную эффективность и человекоцентричное взаимодействие для устойчивого производства.
Основной целью данной работы является создание киберфизической системы с участием человека (CPHS) на базе объяснимого искусственного интеллекта (XAI) для обеспечения устойчивого производства в рамках концепции «Индустрия 5.0». Это достигается путем объединения интерпретируемости на основе метода SHAP, граничных вычислений (edge computing) и поддержки принятия решений с участием человека с гибридным подходом к обнаружению акустических аномалий на базе архитектуры CNN-Transformer. В частности, предлагаемая структура направлена на повышение точности обнаружения аномалий при обеспечении четких и понятных прогнозов, что облегчает эффективное развертывание на граничных устройствах и способствует совместному принятию решений интеллектуальными системами и операторами-людьми. Благодаря одновременному достижению высокой производительности детектирования, объяснимости, работы с низкой задержкой и человекоцентричного киберфизического взаимодействия, эта интегрированная архитектура устраняет недостатки существующих систем обнаружения акустических аномалий, прогностического обслуживания на базе XAI и структур CPHS.
Предлагаемая архитектура представляет собой единую киберфизическую человеческую систему (CPHS) с поддержкой объяснимого ИИ (Explainable AI) для Индустрии 5.0, в отличие от современных методов обнаружения акустических аномалий, которые сосредоточены преимущественно на точности классификации. В рамках единой архитектуры объединяются извлечение пространственных признаков на базе CNN, временное моделирование на базе Transformer, объяснимость на базе SHAP, граничные вычисления (edge computing) и поддержка принятия решений с участием человека (human-in-the-loop). Предлагаемая архитектура решает ключевые проблемы прозрачности, помощи оператору и киберфизического взаимодействия, объединяя точное обнаружение аномалий с понятным процессом принятия решений и развертыванием на граничных устройствах в режиме реального времени. Основным научным вкладом данной работы является интеграция на системном уровне, что отличает предлагаемый подход от предыдущих исследований, сосредоточенных исключительно на обнаружении аномалий, объяснимом ИИ или концепциях Индустрии 5.0.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Протокол
Предлагаемая методология основана на системном подходе Кибер-физической человеческой системы (CPHS) в рамках Индустрии 5.0, который сочетает в себе объяснимое глубокое обучение с платформой кибер-физического взаимодействия на базе граничных вычислений для обеспечения устойчивых производственных процессов. Сначала проблема рассматривается через анализ определенных ограничений современных решений CPHS, таких как недостаток интеллекта на базе ИИ, объяснимости и человекоцентричного взаимодействия. Для решения этих задач в предлагаемом подходе используется набор данных MIMII для мониторинга состояния промышленного оборудования с помощью обработки акустических сигналов.
Предложенная структура начинается с подачи сгенерированных спектрограмм в модель CNN, которая извлекает пространственные признаки путем распознавания значимых частотных паттернов, связанных с различными состояниями оборудования. Извлеченные пространственные признаки преобразуются в последовательности и подаются в модуль энкодера трансформера для захвата временных зависимостей с помощью механизма self-attention. Преобразованное представление признаков затем передается в модуль полносвязного классификатора для классификации состояний оборудования как нормальных или аномальных. Кроме того, для обеспечения прозрачности и содействия принятию решений с участием человека используется подход к объяснимости SHAP, который позволяет обосновать прогнозы путем выбора значимых временно-частотных областей в выходных данных модели. Разработанная модель будет реализована в среде CPS с поддержкой периферийных вычислений, что обеспечит вывод в реальном времени с низкой вычислительной задержкой и низким энергопотреблением. Дополнительно будет интегрирована схема с участием человека (human-in-the-loop), позволяющая операторам проводить валидацию на основе результатов объяснимости. Эффективность подтверждается с использованием показателей точности (accuracy), прецизионности (precision), полноты (recall) и F1-меры, а также других системных метрик, таких как задержка и энергоэффективность.
Предложенная структура представляет собой механизм CPHS на базе XAI для устойчивого производства в контексте Индустрии 5.0; ее рабочий процесс представлен в виде конвейера от сбора данных до принятия интеллектуальных решений и их реализации, как показано на Рисунке 1. На начальном этапе процедуры сбора данных звуковые сигналы регистрируются с оборудования таких промышленных объектов, как двигатели, насосы и подшипники, с использованием наборов данных, включая MIMII. Полученные сигналы передаются на следующий этап, называемый предварительной обработкой данных, где они подвергаются фильтрации, нормализации и сегментации. Наконец, сегментированные сигналы данных преобразуются в спектрограмму с помощью коротковременного преобразования Фурье (STFT) на уровне представления признаков.
Затем слой модели ИИ использует изображения спектрограмм для извлечения признаков с помощью модуля CNN, выявляя пространственные закономерности и аномалии. После этого извлеченные признаки преобразуются по форме и подаются в кодировщик-трансформер, который изучает временные зависимости и долгосрочные связи с помощью механизмов самовнимания. Полученные векторы признаков классифицируются как нормальные или аномальные с помощью слоя классификации. Для обеспечения прозрачности процесса прогнозирования слой интерпретируемости использует SHAP для выделения значимых временно-частотных областей на спектрограмме.
Кроме того, предусмотрен процесс с участием оператора (human-in-the-loop), в ходе которого специалисты интерпретируют результаты работы модели и предоставляют обратную связь. На уровне развертывания модель функционирует на базе периферийной инфраструктуры CPHS, что обеспечивает высокую скорость вывода и низкое энергопотребление, с возможностью опционального взаимодействия с облачными системами для хранения данных или проведения расширенной аналитики. В совокупности данная архитектура обеспечивает точное обнаружение неисправностей, интерпретируемость результатов и эффективную работу в режиме реального времени в соответствии с требованиями Индустрии 5.0.
Определение проблемы и анализ требований
Киберфизические человеческие системы (CPHS) в условиях Индустрии 5.0 обещают обеспечить интеллект, устойчивость и человекоцентричность. Тем не менее, современные структуры для создания CPHS ограничены отсутствием расширенных возможностей на базе ИИ, объяснимости и адекватной поддержки человеко-машинного взаимодействия. Действительно, традиционные CPHS основаны на моделях на базе правил или неинтерпретируемых моделях, что препятствует адаптации к меняющимся промышленным условиям и ограничивает доверие операторов к автоматизации. Более того, традиционные CPHS не могут эффективно анализировать высокосложные данные, такие как промышленные акустические сигналы, содержащие как пространственные (т. е. частотные), так и временные компоненты, которые важны для предиктивного технического обслуживания. Следовательно, необходимо создать структуру, способную с высокой точностью обнаруживать аномалии в работе оборудования, предоставлять объяснения и функционировать на периферии, тем самым обеспечивая работу CPS.
Здесь x(t) — входной акустический сигнал, S(f,t) — спектрограммное представление сигнала,  — метка, а θ — набор параметров архитектуры CNN-Transformer. Символы, используемые в последующих уравнениях, вводятся сразу после их первого появления для обеспечения математической корректности.
С математической точки зрения данную задачу можно формализовать как проблему обучения с учителем. Пусть промышленный акустический сигнал обозначается как x(t). Кратковременное преобразование Фурье (STFT) для x(t) вычисляется по следующей формуле:
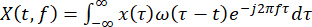 (1)
где ω(.) — оконная функция, а f — частота. Сгенерированная спектрограмма 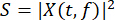 служит входными данными для алгоритма глубокого обучения. Целью является обучение функции отображения
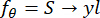 (2)
где — это метка класса (норма или патология), S — входной спектрограмма, y — предсказанная выходная метка, а θ — набор обучаемых параметров архитектуры CNN-Transformer. Задача оптимизации формулируется как минимизация потерь классификации:
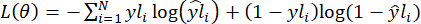 (3)
с учетом ограничений по минимальной задержке  , энергоэффективности
 и интерпретируемости, при этом объяснение ∅(SHAP) отражает значимость признаков в процессе прогнозирования,
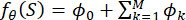 (4)
где  — это вклад каждого отдельного признака. В соответствии с вышеизложенным, требования к проектированию включают следующее: (i) надежное обнаружение аномалий на основе гибридного глубокого обучения, (ii) интерпретируемые результаты для возможности человеческого вмешательства и (iii) реализация в структуре CPS с расширенными граничными возможностями.
Сбор и предварительная обработка данных
В связи с этим для оценки предлагаемой структуры CPHS на основе объяснимого искусственного интеллекта (Explainable AI) был выбран набор данных MIMII13. Данный набор данных является широко используемым эталоном для обнаружения аномалий в промышленном оборудовании с помощью акустических сигналов. Эта база данных содержит звукозаписи работы различных механизмов, таких как направляющие, вентиляторы, насосы и клапаны, как в нормальных, так и в условиях возникновения неисправностей. Для каждой машины записи варьируются в зависимости от различных настроек и шумовой обстановки. Это делает данный набор данных подходящим для обучения и оценки моделей в условиях промышленной эксплуатации в режиме реального времени.
В то время как набор данных MIMII широко используется в исследованиях по обучению без учителя для обнаружения аномалий, где при обучении опираются исключительно на нормальные образцы, он содержит явные аннотации как нормальных, так и аномальных состояний оборудования. Задача сформулирована как задача контролируемой бинарной классификации для проверки способности предложенной архитектуры CNN-Transformer на базе объяснимого ИИ (Explainable AI) разделять исправные и неисправные состояния оборудования. В частности, используются официальные метки MIMII, где нормальным образцам присваивается метка класса 0, а аномальным — метка класса 1.
В таблице 1 приведены подробные сведения о наборе данных. В данном исследовании рассматриваются примерно 12 000 записей акустических сигналов, включая как нормальную, так и некорректную работу оборудования. Согласно требованиям, все записи в этом исследовании были выполнены с частотой дискретизации 16 kHz и имеют длительность 10 s. Несмотря на то что набор данных содержит около 12 000 записей, для визуализации матрицы ошибок был выбран сбалансированный по классам подмножество из 2 000 тестовых записей. Все представленные показатели эффективности были рассчитаны с использованием полного тестового набора (примерно 2 400 записей). Кроме того, обучающие и тестовые выборки разделены в соотношении 80:20 для обучения модели. Эта база данных хорошо подходит для приложений Индустрии 5.0, поскольку она учитывает условия шума в режиме реального времени. Распределение записей, использованное в данном исследовании, приведено в таблице 2. Из этого набора данных для экспериментов по контролируемой бинарной классификации с разделением на обучающую и тестовую выборки в соотношении 80:20 было выбрано примерно 12 000 записей, охватывающих все типы машин и условия отношения сигнал/шум (SNR); в таблице указаны типы промышленных машин, соответствующие идентификаторы машин, общее количество нормальных и аномальных акустических записей, условия SNR и экспериментальное разделение на обучающую и тестовую выборки, использованное для контролируемой бинарной классификации.
Эксперимент проводился с использованием набора данных MIMII (Malfunctioning Industrial Machine Investigation and Inspection) версии 1.0, который включает четыре типа промышленного оборудования: вентиляторы, насосы, клапаны и направляющие. Данные были собраны для различных идентификаторов машин (ID00–ID06, в зависимости от типа оборудования) и условий работы. База данных MIMII содержит данные, полученные при отношениях сигнал/шум (SNR) −6 dB, 0 dB и +6 dB. Нормальные данные соответствуют исправному состоянию промышленного оборудования, в то время как аномальные данные соответствуют состоянию с неисправностью. Классы были обозначены на основе аннотаций базы данных: нормальные данные помечены как класс 0, а аномальные — как класс 1.
Для обеспечения объективности процедуры оценки разделение на обучающую и тестовую выборки должно было быть произведено на уровне исходных аудиозаписей до этапов сегментации, аугментации или создания спектрограмм. Таким образом, аудиофрагменты из одной и той же записи не могли одновременно присутствовать в обучающем и тестовом наборах. В оценочном эксперименте использовались записи с различными значениями отношения сигнал/шум (−6 dB, 0 dB и +6 dB), что позволило оценить предложенную архитектуру в различных промышленных условиях.
Для предотвращения утечки данных разделение на обучающую и тестовую выборки было выполнено на основе исходных аудиофайлов до проведения какой-либо сегментации или генерации спектрограмм. Сегменты из одной и той же 10 s аудиозаписи назначались исключительно либо в обучающий, либо в тестовый набор, так что ни один сегмент не присутствовал в обоих наборах одновременно. После этого спектрограммы генерировались и дополнялись отдельно для каждого набора данных. Таким образом была решена проблема утечки данных, что позволило избежать излишне оптимистичной оценки эффективности.
Предварительная обработка набора данных
Необработанные акустические сигналы из набора данных MIMII затем подвергаются обработке для повышения качества сигнала и обеспечения эффективного извлечения признаков. Входной сигнал обозначается как x(t), где t — время. Первым этапом является фильтрация шума, при которой фоновые шумы отфильтровываются с помощью функции фильтрации следующим образом:
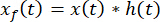 (5)
где ∗ обозначает процесс свертки, а h(t) — импульсный отклик фильтра. Этот процесс повышает четкость акустического сигнала и сводит к минимуму воздействие шумов, часто присутствующих в промышленных условиях. Нормализация сигнала используется для того, чтобы амплитуды всех аудиосигналов были сопоставимы перед их подачей в модель глубокого обучения. Нормализованный сигнал, обозначаемый как xn(t), рассчитывается следующим образом:
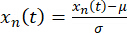 (6)
где μ и σ — это среднее значение и стандартное отклонение входного сигнала соответственно. Благодаря данной процедуре гарантируется, что все входные сигналы имеют нулевое среднее значение и единичную дисперсию. Наконец, для обработки нормализованный входной сигнал разделяется на множество коротких фрагментов. С учетом того, что общая длина сигнала составляет T, он разбивается на N перекрывающихся кадров длиной L с помощью функции скользящего окна:
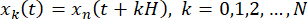 (7)
где H — размер шага. Спектрограмму можно определить с помощью следующей формулы:
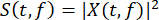 (8)
Полученные таким образом спектрограммы подаются в архитектуру на базе CNN-трансформера для извлечения пространственных и временных признаков с целью успешного обнаружения аномалий. На рисунке 2 показана схема предварительной обработки данных.
Рисунок 2 иллюстрирует вертикальный конвейер предварительной обработки, который может быть использован для акустических данных, полученных в промышленности. Сначала необработанные аудиосигналы извлекаются из набора данных MIMII и поступают на этап удаления шума для снижения уровня помех. Затем следует нормализация сигнала для устранения несоответствий амплитуды, что обеспечивает однородность сигнала. Впоследствии сигнал разделяется на более короткие перекрывающиеся сегменты. После сегментации к данным применяется преобразование STFT для перевода сигналов из временной области в область время-частота. Затем, в рамках генерации спектрограммы сигнала, вычисляется энергетический спектр. Таким образом, результатом данного процесса являются предварительно обработанные спектрограммы, которые будут использоваться в предлагаемой модели CNN-transformer.
Генерация спектрограммы
После нормализации и сегментации данных акустические сигналы переводятся в частотно-временное представление с помощью кратковременного преобразования Фурье (STFT). Полученная спектрограмма дает наглядное представление об изменениях частотного состава в течение периода анализа. В промышленных условиях неисправности оборудования обычно проявляются в виде частотных паттернов, что делает спектрограммы более эффективными для обнаружения аномалий в работе машин.
Таким образом, полученные обработанные данные преобразуются в спектрограммы для разграничения нормальных и аномальных состояний оборудования. Аудиоданные будут преобразованы в несколько спектрограмм, чтобы модель обучения могла анализировать локальные частотные компоненты и временные изменения в процессе работы машины. Эти изображения используются в качестве входных данных для модели CNN-Transformer, где CNN обрабатывает пространственные (частотные) паттерны, а трансформеры — временные взаимосвязи.
Алгоритм 1: Генерация спектрограммы из акустических сигналов
Вход: необработанный аудиосигнал x(t)
Результат: Спектрограмма S(t, f)
Шаг 1: Загрузка аудиосигнала x(t)
Шаг 2: Примените фильтрацию шума
Шаг 3: Нормализация сигнала xn(t)
Шаг 4: Сегментация сигнала на кадры:
для k = 1 до N выполнить
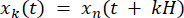
конец цикла
Шаг 5: Примените оконную функцию w(t) к каждому сегменту
Шаг 6: Вычисление STFT:
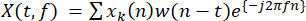 (9)
Шаг 7: Вычислите величину:
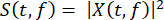 (10)
Шаг 8: Сохраните спектрограмму S(t, f)
Шаг 9: Возврат набора данных спектрограммы
Процесс создания спектрограмм начинается с получения исходного аудиосигнала, за которым следуют этапы предварительной обработки, такие как шумоподавление и нормализация сигнала, для обеспечения его целостности и качества. После этого нормализованный аудиосигнал разделяется на несколько перекрывающихся окон для фиксации временных характеристик как длительных, так и краткосрочных периодов. Чтобы предотвратить спектральную утечку, каждый фрагмент умножается на оконную функцию перед подачей на короткопреобразование Фурье (STFT). Затем преобразованный сигнал представляется в виде комплексной функции в частотной области, и значения его амплитуд возводятся в квадрат. Таким образом, энергия частот за определенный промежуток времени представляется в виде спектрограмм. На заключительном этапе они сохраняются в виде данных, подобных изображениям, и подаются в нейронную сеть для обучения.
Извлечение пространственных признаков с помощью CNN
После процесса создания спектрограмм полученные время-частотные изображения используются в качестве входных данных и подаются на вход сверточной нейронной сети (CNN). Принимая входную спектрограмму за  , где H — частотная область, а W — временная область. Целью использования CNN в данном случае является извлечение дискриминативных пространственных признаков из входной спектрограммы. Эти дискриминативные пространственные признаки помогут отличить нормальное поведение оборудования от аномального в условиях промышленной среды.
Базовой операцией, выполняемой сверточной нейронной сетью (CNN), является свертка. Свертка с заданным фильтром  вычисляется следующим образом:
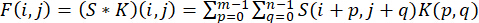 (11)
Описанная выше операция позволяет нейронной сети идентифицировать локальные пространственные признаки в спектрограмме, такие как границы, частоты и гармонический состав. Это осуществляется с помощью множественных операций фильтрации, которые создают различные представления признаков, формируя несколько карт признаков. За сверткой следует нелинейная функция активации, как показано ниже:
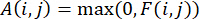 (12)
Эта нелинейность позволяет сети улавливать и представлять сложные взаимосвязи между переменными. Следующий этап в сверточной нейронной сети включает применение операций пулинга. Распространенный метод max pooling математически выражается следующим образом:
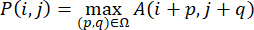 (13)
где Ω обозначает окно пулинга. Пулинг помогает достичь трансляционной инвариантности и сохранить только релевантную информацию, отсеивая избыточность. С помощью сверточной нейронной сети можно иерархически извлекать признаки более высокого уровня: от низкоуровневых переменных, таких как частоты, до сложного поведения машины. Следовательно, карты признаков могут быть использованы для описания итогового выходного сигнала сети:
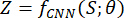 (14)
где представляет собой обучаемые параметры CNN. Карты признаков содержат богатую пространственную информацию и преобразуются в последовательности, которые служат входными данными для энкодера трансформера на следующем этапе. Описанный выше процесс извлечения пространственных признаков имеет решающее значение для того, чтобы модель могла обнаруживать мельчайшие аномалии в промышленных акустических сигналах.
Рисунок 3 демонстрирует процесс горизонтального извлечения пространственных признаков из входной спектрограммы с помощью модели CNN. Процесс начинается с входной спектрограммы, в которой временно-частотные характеристики аудиосигнала представлены в виде изображения. Затем входная спектрограмма проходит через сверточный слой, где фильтры различных типов извлекают пространственные признаки, такие как частотные полосы, границы и текстуры, формируя карты признаков. После этого извлеченные карты признаков подвергаются воздействию нелинейной функции активации — линейной функции выпрямления (ReLU), что позволяет нейронной сети выявлять зависимости во входных данных. Затем карты признаков проходят через слой пулинга (субдискретизации), где размер карты уменьшается с сохранением ее наиболее значимых характеристик. Этот цикл сверточных слоев, функций активации и слоев пулинга повторяется многократно, создавая иерархию представления признаков, которая начинается с простых элементов и развивается в сторону более сложных структур, связанных с работой оборудования.
Временное моделирование с использованием трансформерного энкодера
После извлечения пространственных признаков с помощью CNN следующим шагом является получение карт признаков высокого уровня, которые фиксируют частотные паттерны, изученные на основе спектрограммы. Полученные карты признаков затем выравниваются и преобразуются в последовательности для захвата временной информации в акустическом сигнале. Предполагая, что карты признаков представлены как 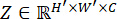 , где H', W', и C — это соответственно высота, ширина и количество каналов, выводится следующая последовательность:
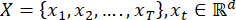 (15)
где T обозначает длину последовательности, а d — размерность признака. Затем Transformer использует вышеуказанную последовательность для моделирования долгосрочных зависимостей с помощью механизма самовнимания (self-attention). Модель Transformer, в отличие от традиционных рекуррентных моделей, обрабатывает каждый элемент последовательности параллельно и использует веса внимания для определения относимой значимости каждой части. Механизм внимания работает с использованием векторов запроса (Query) Q, ключа (Key) K и значения (Value) V , которые генерируются для каждого входного xt следующим образом:
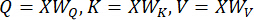 (16)
в то время как WQ, WK, WV являются обучаемыми весами. Сходство между элементами определяется следующим образом:
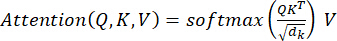 (17)
dk — это размерность важных векторов. Данная процедура упрощает модели процесс изучения зависимостей между удаленными временными шагами в сигнале и позволяет сосредоточиться только на значимых временных сегментах. Для повышения обучающей способности сети используется многоголовое внимание (multihead attention), которое представляет собой процесс, при котором несколько голов внимания параллельно изучают входные данные:
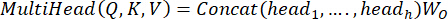 (18)
Каждая головка обрабатывает определенные признаки временной входной последовательности. Далее следуют сети прямого распространения и остаточные связи:
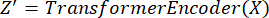 (19)
Полученная закодированная последовательность фиксирует как пространственные, так и временные характеристики входных данных. Эта последовательность передается на слой классификатора для обнаружения аномалий.
Рисунок 4 демонстрирует общий процесс временного моделирования с использованием трансформерного кодировщика (Encoder) на признаках, извлеченных с помощью CNN. Сначала используются карты признаков, извлеченные из CNN; они содержат пространственную информацию из спектрограммы. Карты признаков выравниваются в последовательность, где каждый элемент соответствует определенной временной метке. После этого последовательность проходит через линейное преобразование, которое отображает данные в векторы заданной размерности. Поскольку трансформерные модели не обладают способностью улавливать временные зависимости, к векторам эмбеддингов также добавляется позиционное кодирование для сохранения временной структуры последовательности. Наконец, последовательность проходит через трансформерный кодировщик, состоящий из стека нескольких слоев, в которых используется механизм многоголового самовнимания (multi-head self-attention), позволяющий модели изучать связи между временными метками в последовательности. Полносвязная нейронная сеть (feed-forward neural network) дополнительно улучшает эти эмбеддинги, в то время как остаточные связи (residual connections) обеспечивают эффективное распространение градиентов. Этот процесс повторяется в слоях стека трансформерного кодировщика, которые фиксируют все более сложные временные взаимодействия. В итоге эмбеддинги последовательности объединяются в представление фиксированной длины с помощью пулинга (например, среднего пулинга или токена классификации (CLS)), в результате чего получается глобальное представление временных признаков.
Классификационный слой
После временного кодирования с помощью трансформерного кодировщика на выходе будет получена последовательность закодированных векторов, каждый из которых содержит признаки, относящиеся как к пространственным, так и к временным аспектам входного сигнала. Первым шагом к классификации на основе закодированных выходных данных является объединение всех этих признаков в один вектор. Это достигается либо путем применения усредняющего пулинга (mean pooling) к последовательности векторов признаков, либо путем использования так называемого «классификационного токена». Предположим, что выходом трансформера является 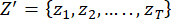 , где каждый
 . Агрегированный признак h вычисляется следующим образом:
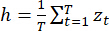 (20)
Затем агрегированный вектор признаков h представляет собой входные данные в компактной форме и служит входным сигналом для классификатора. Часть классификации состоит из одного или нескольких плотных слоев, которые преобразуют полученное представление в выходное пространство. Плотный слой реализует преобразование, которое определяется следующим образом:
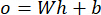 (21)
где o — это выход (логиты), b — вектор смещения, а W — матрица весов. Последние представляют собой оценки классов в ненормированном виде. Для внесения нелинейности в модель часто используются функции активации, такие как ReLU. Наконец, к логитам применяется функция активации softmax для получения вероятности для каждого класса:
 (22)
где C представляет собой количество классов (C = 2; нормальный и аномальный). Предсказание класса будет основываться на максимальном значении вероятности. В процессе обучения оптимальные значения параметров модели определяются путем минимизации перекрестной энтропии потерь между фактическими и предсказанными метками, что позволяет добиться точной классификации состояний оборудования. Таким образом, слой классификации выполняет важнейшую функцию преобразования извлеченных временных признаков, полученных с помощью архитектуры Transformer, в практические решения. Благодаря правильной дифференциации исправных и неисправных состояний оборудования в рамках парадигмы Индустрии 5.0 становится возможным обнаружение аномалий и принятие интеллектуальных решений.
Рисунок 5 демонстрирует работу классификационного слоя, который следует за энкодером трансформера. Процесс начинается с выходной закодированной последовательности, в которой каждый вектор содержит временную информацию, извлеченную из входных данных. Эти векторы объединяются в один вектор, называемый глобальным вектором признаков. Следующим шагом является передача глобального вектора признаков через несколько полносвязных слоев нейронной сети. В каждом полносвязном слое выполняются операции матричного умножения для создания линейных комбинаций входных данных. После этого может быть применена нелинейная функция активации, такая как ReLU, для повышения гибкости при обучении решающим границам. На выходе последнего полносвязного слоя формируются логиты для каждого класса. Эти логиты используются в функции Softmax для расчета вероятностей принадлежности к каждому классу. Полученные значения вероятности позволяют определить, относится ли входной сигнал к Классу 0 (Норма) или к Классу 1 (Патология).
Интерпретируемость с использованием SHAP
После классификации входных сигналов модель генерирует прогнозы о том, работает ли оборудование в нормальном или аномальном режиме. Тем не менее, в условиях Индустрии 5.0 недостаточно просто получать прогнозы; система также должна обеспечивать прозрачность и интерпретируемость для поддержки принятия решений человеком. В данной структуре используется SHAP — модель на основе теории игр, которая количественно оценивает значимость каждого признака при формировании прогноза. Таким образом, SHAP присваивает веса признакам, что позволяет оценить относительную важность различных участков входной спектрограммы для общего прогноза.
Математическая формулировка SHAP основана на разложении модели f(x):
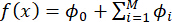 (23)
где ∅0 — это базовое значение (средний выход модели), ∅i — эффект i-го признака, а M — количество входных признаков. В целях данного исследования признаками являются частотно-временные интервалы спектрограммы. Значения SHAP положительны, если они способствуют вероятности аномального состояния, и отрицательны в противном случае. Такая формулировка гарантирует уникальное, локально согласованное объяснение для каждого прогноза. Метод SHAP может быть применен к обученной модели CNN-transformer для получения объяснения на основе важности признаков. Визуальное представление покажет наиболее важные частотно-временные интервалы в спектрограмме, которые влияют на процесс принятия решения. Например, аномальное поведение оборудования может привести к появлению определенных высокоэнергетических частотных полос, которые система SHAP идентифицирует как важные факторы в процессе принятия решения.
Кроме того, SHAP может способствовать сотрудничеству между человеком и машиной в киберфизической среде. Это возможно благодаря тому, что прогнозы могут быть объяснены с помощью интуитивно понятных визуальных средств, что позволяет операторам и системам принятия решений проверять прогнозы, анализировать проблему и предпринимать соответствующие шаги. Это не только повышает уровень доверия, но и делает производственные процессы на базе ИИ надежными и подотчетными. Интегрируя алгоритмы глубокого обучения, соответствующие современным стандартам производительности, с SHAP, обеспечивающим интерпретируемость, предлагаемая архитектура отвечает требованиям Индустрии 5.0.
Алгоритм 2: Интерпретируемость прогнозов модели на основе SHAP
Входные данные: обученная модель f(x), входная спектрограмма S
Результат: значения SHAP  и карта объяснений
Шаг 1: Подайте спектрограмму S на вход обученной модели
Шаг 2: Вычислите прогноз: y = f(S)
Шаг 3: Инициализация эксплейнера SHAP, ориентированного на глубокое обучение
Шаг 4: Вычисление значений SHAP:
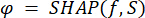
Шаг 5: Для каждого признака i в S:
Рассчитайте вклад 
Шаг 6: Построение карты объяснений:
Выделите области с высоким значением 
Шаг 7: Визуализация важности признаков (тепловая карта)
Шаг 8: Возврат значений SHAP и карты интерпретации
Алгоритм объяснимости на основе SHAP начинается с получения в качестве входных данных предварительно обработанного изображения спектрограммы, которое подается в обученную архитектуру CNN-трансформера для формирования прогнозов (например, о нормальном или аномальном состоянии оборудования). После получения прогнозов с помощью обученной архитектуры применяется метод SHAP для интерпретации модели. В частности, для каждого входного признака вычисляются значения SHAP (ϕ), чтобы определить, какие частотно-временные компоненты входных данных вносят наибольший вклад в прогноз. Для расчета этих значений необходимо сравнить выходные данные модели для входных сигналов с определенными признаками и без них.
После расчета значений SHAP для каждого признака его влияние на прогноз можно оценить по знаку и величине значения SHAP. Например, признаки с более высокими значениями SHAP с большей вероятностью влияют на результат, а положительный или отрицательный знак указывает на то, что признак смещает прогноз в сторону класса «норма» или «патология» соответственно. На основании полученных результатов можно составить карту интерпретации в виде тепловой карты.
Наконец, алгоритм выводит как значения SHAP, так и визуализации, что позволяет понять, каким образом человек может анализировать решения модели. Данный метод делает процесс более прозрачным и позволяет специалистам участвовать в принятии решений, обеспечивая таким образом точность прогнозов и надежность алгоритма в условиях промышленного применения ИИ. Для повышения достоверности анализа объяснимости были выбраны репрезентативные тестовые образцы из точно диагностированных аномальных случаев для различных типов оборудования. В то время как глобальный анализ важности признаков SHAP проводился путем агрегирования значений SHAP по всему тестовому набору данных для выявления стабильно влиятельных частотно-временных локаций, для этих репрезентативных случаев были созданы локальные объяснения SHAP. Данный комплексный локальный и глобальный анализ, не требующий экспертной аннотации, обеспечивает надежную интерпретацию прогнозов модели.
Интеграция CPS с поддержкой граничных вычислений
Предлагаемое решение используется в рамках киберфизической системы (КФС) с поддержкой граничных вычислений, целью которой является обеспечение эффективности, устойчивости и промышленного управления в режиме реального времени. После обучения модели CNN-трансформер будет развернут с использованием подхода граничных вычислений. Соответствующий уровень граничных вычислений расположен рядом с устройствами промышленного интернета вещей (IIoT), включая датчики и оборудование. Вместо передачи всех собранных данных в облако, граничное устройство выполняет логический вывод (инференс) поступающего акустического сигнала без предварительной передачи данных. Таким образом, система может обнаруживать неисправности оборудования почти мгновенно и предпринимать необходимые меры до дальнейшего ухудшения ситуации. Еще одним преимуществом данного подхода с поддержкой граничных вычислений является снижение задержки и повышение эффективности, так как данные анализируются вблизи места их генерации. Другими словами, в отличие от облачного подхода, где время инференса Tinf
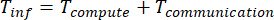 (24)
Задержка в целом будет значительно снижена за счет уменьшения Tcommunication. Другим преимуществом является снижение потребления пропускной способности и затрат энергии при непрерывной передаче данных. Таким образом, данная система является масштабируемой и устойчивой для крупных промышленных предприятий с большим количеством подключенных устройств. Кроме того, CPS обеспечивает взаимодействие с физическим уровнем (машинами), ИИ (вычислительным уровнем) и человеческим уровнем.
Сотрудничество с участием человека в контуре управления
Ключевым компонентом предлагаемой киберфизической системы (КФС) для Индустрии 5.0, в которой операторы-люди активно участвуют в процессе принятия решений наряду с моделями ИИ, является взаимодействие по принципу «человек в контуре» (human-in-the-loop). А именно, согласно разработанной структуре, система не становится автономным «черным ящиком», а позволяет операторам взаимодействовать с ней и наблюдать интерпретируемые результаты прогнозирования в виде объяснений SHAP. Рассматриваемые прогнозы относятся к результатам (норма/аномалия), которые сопровождаются визуализацией фрагментов спектрограмм, использованных для их получения.
Такое взаимодействие помогает операторам лучше понять, как именно формируется прогноз и какие факторы влияют на него. Участие человека подразумевает проверку результатов работы системы и возможность пересмотрения ими в случае необходимости, основываясь на профессиональном суждении оператора. Сотрудничество с операторами-людьми делает систему более заслуживающей доверия, эффективной, безопасной и надежной, помогая предотвратить ошибки.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Результаты
Представленная система киберфизического взаимодействия с интеграцией объяснимого ИИ была экспериментально протестирована на примерно 12 000 аудиозаписях из набора данных MIMII, содержащего записи как нормальных, так и аномальных состояний оборудования. Обучающий набор данных состоял примерно из 9 600 записей, в то время как тестовый набор включал около 2 400 аудиообразцов. Согласно полученным результатам, предложенная модель CNN-transformer достигла точности классификации 98,5% на тестовом наборе данных (0,97–0,98). Это ...
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Обсуждение
Экспериментальные результаты показывают, что предложенная архитектура CNN-transformer превосходит отдельные алгоритмы за счет эффективной интеграции обучения пространственным и временным признакам. Согласно результатам исследования с удалением компонентов (ablation study), в то время как CNN извлекает частотные дискриминационные признаки из спектрограмм, трансформер-энкодер повышает производительность модели, фиксируя долгосрочные временные зависимости в акустических сигналах. Более того, матрица ошибок демонстрирует оче...
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Раскрытие информации
Инструмент ИИ (ChatGPT) использовался исключительно для редактирования языка, улучшения грамматики, ясности и удобочитаемости текста. Инструменты ИИ не применялись для генерации научных данных, проведения экспериментов, анализа результатов, интерпретации полученных сведений или формулирования научных выводов. Все научное содержание, анализ данных, интерпретация и окончательная версия рукописи были независимо проверены, подтверждены и одобрены авторами, которые несут полную ответственность за точность и целостность работы. Авторы заявляют об отсутствии конфликта интересов.
Благодарности
ФИНАНСИРОВАНИЕ: Данная работа была поддержана в рамках Ключевого проекта по реформированию преподавания в высших учебных заведениях провинции Шэньси (проект № 23BG053), Фондом научных исследований для высококвалифицированных специалистов Политехнического университета Шэньси (проект № BSJ-2023-08), а также Научно-исследовательским проектом Политехнического университета Шэньси (проект № 2024YKYB-006). Авторы искренне благодарят Политехнический университет Шэньси (Сяньян, Китай) и Университет транспортного машиностроения Сиань (Сиань, Китай) за предоставление оборудования и институциональную поддержку, которые сделали возможным проведение данного исследования.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Материалы
| Имя | Компания | Каталожный номер | Комментарии |
|---|---|---|---|
| Шкала социальной поддержки | Опубликованная академическая шкала; первоначально разработана Park, впоследствии пересмотрена и дополнена Kim | версия из 25 пунктов; 5-балльная шкала Лайкерта; без коммерческого каталожного номера | Оценка воспринимаемой социальной поддержки будущих педагогов дошкольного образования по четырем направлениям: эмоциональная поддержка, информационная поддержка, материальная поддержка и оценочная поддержка. Общий коэффициент альфа Кронбаха’s alpha = 0,96. |
| Шкала самоэффективности учителя | Опубликованная академическая шкала; первоначально разработана Энокс и Риггсом; версия исследования, адаптированная для Китая | версия из 25 пунктов; 5-балльная шкала Лайкерта; без номера в коммерческом каталоге | Оценивает эффективность педагогов в контексте подготовки будущих специалистов по дошкольному образованию в Китае по показателям общей педагогической самоэффективности и личностной педагогической самоэффективности. Общий коэффициент альфа Кронбаха’s alpha = 0,96. |
| Шкала взаимодействия учителя и ребенка | Опублизированная академическая шкала; разработана Ли и рецензирована экспертной группой исследования для использования в Китае | вариант из 30 пунктов; 5-балльная шкала Лайкерта; без коммерческого каталожного номера | Оценивает самоотчет о компетенции взаимодействия учителя и ребенка, а не наблюдаемое качество взаимодействия в классе. Включает эмоциональное взаимодействие, вербальное взаимодействие и поведенческое взаимодействие; общий коэффициент Кронбаха’s альфа = 0,94. |
| Форма демографических данных | Исследовательская группа, сотрудничество Сычуаньского университета искусств и наук и Университета Тэгу | Раздел индивидуального опросника исследования; без коммерческого каталожного номера | Были собраны характеристики участников, включая пол, уровень образования, профессиональную категорию, место прохождения стажировки, продолжительность стажировки, тип стажировки и тип детского сада. |
| Информационный листок участника и текст формы информированного согласия | Исследовательская группа; одобрено Комитетом по этике исследований Университета Тэгу | Номер этического одобрения: XXX; для подтверждения см. запись о местном одобрении | Используется перед рассылкой опросника для разъяснения целей исследования и содержания опроса, а также для получения информированного согласия от участников — студентов педагогических специальностей, готовящихся к преподаванию в дошкольном образовании. |
| Пакет материалов опросника для пилотного исследования | Исследовательская группа и экспертная комиссия | Пилотная версия, использованная 1 июня–5, 2024; номер в коммерческом каталоге отсутствует | Проведена апробация ясности и уместности Шкалы профессионального восприятия, Шкалы социальной поддержки, Шкалы самоэффективности учителя, Шкалы взаимодействия учителя и ребенка, а также демографических показателей на группе из 50 будущих педагогов дошкольного образования. |
| Процедура экспертного рецензирования | Исследовательская группа; экспертная панель в составе двух профессоров в области дошкольного образования, одного директора детского сада, трех руководителей стажировок и исследовательской группы | Рецензирование контента на основе консенсуса; без указания коммерческого номера модели | Используется для пересмотра пунктов шкалы на предмет двусмысленности, уместности, семантической ясности, соответствия уровню развития и культурной релевантности перед проведением официального опроса. |
| Распечатанные формы опросников для заполнения на месте | Исследовательская группа; расходные материалы для проведения опроса на базе местного учреждения | Бумажные формы опросов; без коммерческого каталожного номера | Использовалось для проведения опроса на месте. В итоговой выборке было получено 336 заполненных анкет, собранных на месте, которые затем были объединены с онлайн-анкетами. |
| Tencent | Мобильное приложение WeChat; версию необходимо проверить в записях устройства/приложения, использовавшихся в июне–Июль 2024 г. | Использовался в качестве канала онлайн-распространения для проведения анкетирования; с помощью онлайн-канала/WeChat было собрано 27 заполненных онлайн-анкет. | |
| Процедура набора участников по телефону и при личной встрече | Исследовательская группа | Стандартизированная процедура набора; номер в коммерческом каталоге отсутствует | Используется для связи с учреждениями/участниками, разъяснения целей исследования и содержания опроса, а также для получения информированного согласия перед проведением анкетирования. |
| SPSS Statistics | IBM | Версия 27.0 | Используются для описательной статистики, расчета коэффициентов корреляции Пирсона, коэффициента Кронбаха’анализ надежности с помощью коэффициента альфа Кронбаха, проверка нормальности распределения с использованием показателей асимметрии и эксцесса, а также тест Хармана’однофакторный тест на систематическую ошибку общего метода. |
| SPSS Amos | IBM | Версия 26.0 | Используется для подтверждающего факторного анализа, моделирования структурными уравнениями, проверки инвариантности измерений в нескольких группах, бутстреп-тестирования косвенных эффектов и сравнения альтернативных моделей. |
| Microsoft Excel | Microsoft | Microsoft 365 Excel или локально установленная версия Excel; перед отправкой проверьте точный номер сборки локальной версии | Рекомендуется использовать в качестве рабочей среды для организации закодированных данных опроса, словаря данных, дополнительных таблиц и таблицы материалов JoVE. Авторам следует проверить точную локальную версию. |
| Критерии индексов соответствия в моделировании структурными уравнениями | Опубликованное методическое руководство; в рукописи приведены ссылки на работы Schreiber et al. и Kline | Коммерческий номер каталога отсутствует; критерии, примененные в плане статистического анализа | Определяет и представляет индексы соответствия модели, включая критерий хи-квадрат, значение хи-квадрат, деленное на число степеней свободы, индекс Таккера-Льюиса, сравнительный индекс соответствия, скорректированный индекс согласия, индекс приращения соответствия, среднеквадратичную ошибку аппроксимации и стандартизированный среднеквадратичный остаток. |
| Процедура бутстреп-тестирования медиации | SPSS Amos / план статистического анализа исследовательской группы | 5000 бутстрэп-выборок; 95% доверительные интервалы с коррекцией смещения | Использовалось для проверки косвенных связей через эффективность преподавателя. Косвенные эффекты считались значимыми, если 95%-ный доверительный интервал с поправкой на смещение не включал ноль. |
| Процедура проверки инвариантности измерений | SPSS Amos / план статистического анализа исследовательской группы | Многогрупповой конфирматорный факторный анализ; ΔCFI &< .010 и ΔRMSEA (среднеквадратичная ошибка аппроксимации) &критерий < 0,015 | Использовалось для оценки конфигурационной, метрической и скалярной инвариантности по полу, типу программы, продолжительности стажировки и учебному заведению перед интерпретацией объединенных оценок модели структурных уравнений (SEM). |
Ссылки
- Fraga-Lamas P, Barros D, Lopes SI, Fernández-Caramés TM. Mist and edge computing cyber-physical human-centered systems for Industry 5.0: A cost-effective IoT thermal imaging safety system. Sensors (Basel). 2022;22(21):8500.
- Breque M, De Nul L, Petridis A. Industry 5.0: Towards a sustainable, human-centric and resilient European industry. Brussels: European Commission; 2021:https://research-and-innovation.ec.europa.eu/knowledge-publications-tools-and-data/publications/all-publications/industry-50-towards-sustainable-human-centric-and-resilient-european-industry_en.
- Sariişik G, Demir S. Industry 5.0: A human-centric paradigm for sustainable and resilient industrial transformation. Journal of Social Perspective Studies. 2025;2(2):50–66.
- Liu X et al. Evaluating the interactions of multi-dimensional value for sustainable product-service systems with a grey DEMATEL-ANP approach. J Manuf Syst. 2021;60:449–458.
- Di Nardo M et al. The maintenance in Industry 4.0: Assistance and implementation [conference paper]. Presented at: 32nd European Safety and Reliability Conference; Dublin, Ireland; 2022. p. 2286–2292. https://hdl.handle.net/20.500.12607/48222.
- Kagermann H, Lukas WD, Wahlster W. Industrie 4.0: Mit dem Internet der Dinge auf dem Weg zur 4. industriellen Revolution. VDI Nachrichten. 2011;(13):2–3. https://www.dfki.de/fileadmin/user_upload/DFKI/Medien/News_Media/Presse/Presse-Highlights/vdinach2011a13-ind4.0-Internet-Dinge.pdf.
- Council for Science, Technology and Innovation. Report on the Fifth Science and Technology Basic Plan. Tokyo: Cabinet Office, Government of Japan; 2015:https://www8.cao.go.jp/cstp/kihonkeikaku/5basicplan_en.pdf.
- Nahavandi S. Industry 5.0—A human-centric solution. Sustainability (Basel). 2019;11(16):4371.
- Paschek D, Mocan A, Draghici A. Industry 5.0—The expected impact of the next industrial revolution [conference paper]. Presented at: MakeLearn and TIIM International Conference; Piran, Slovenia; 2019. p. 125–132. https://toknowpress.net/ISBN/978-961-6914-25-3/papers/ML19-017.pdf.
- Maddikunta PKR et al. Industry 5.0: A survey on enabling technologies and potential applications. J Ind Inf Integr. 2022;26:100257.
- Longo F, Padovano A, Umbrello S. Value-oriented and ethical technology engineering in Industry 5.0: A human-centric perspective for the design of the factory of the future. Appl Sci (Basel). 2020;10(12):4182.
- Gong Y, Chung YA, Glass J. AST: Audio Spectrogram Transformer [conference paper]. Presented at: Interspeech 2021; Brno, Czech Republic; 2021. p. 571–575. https://www.isca-archive.org/interspeech_2021/gong21b_interspeech.html.
- Purohit H et al. MIMII dataset: Sound dataset for malfunctioning industrial machine investigation and inspection [conference paper]. Presented at: 4th Workshop on Detection and Classification of Acoustic Scenes and Events; New York, NY; 2019. p. 209–213. https://dcase.community/documents/workshop2019/proceedings/DCASE2019Workshop_Purohit_21.pdf.
- Hallioui A et al. A review of sustainable total productive maintenance. Sustainability (Basel). 2023;15(16):12362.
- Vasić S et al. Identification of criteria for enabling the adoption of sustainable maintenance practice: An umbrella review. Sustainability (Basel). 2024;16(2):767.
- Barredo Arrieta A et al. Explainable artificial intelligence: Concepts, taxonomies, opportunities, and challenges toward responsible AI. Inf Fusion. 2020;58:82–115.
- Lundberg SM, Lee SI. A unified approach to interpreting model predictions [conference paper]. Presented at: 31st International Conference on Neural Information Processing Systems; Long Beach, CA; 2017. p. 4765–4774. https://papers.nips.cc/paper/7062-a-unified-approach-to-interpreting-model-predictions.
- Du M, Liu N, Hu X. Techniques for interpretable machine learning. Commun ACM. 2020;63(1):68–77.
- Sarker IH. Machine learning: Algorithms, real-world applications and research directions. SN Comput Sci. 2021;2(3):160.
- Saxe A, Nelli S, Summerfield C. If deep learning is the answer, what is the question? Nat Rev Neurosci. 2021;22(1):55–67.
- Piccialli F et al. A survey on deep learning in medicine: Why, how and when? Inf Fusion. 2021;66:111–137.
- Li Z et al. A survey of convolutional neural networks: Analysis, applications, and prospects. IEEE Trans Neural Netw Learn Syst. 2022;33(12):6999–7019.
- Gil M, Albert M, Fons J, Pelechano V. Engineering human-in-the-loop interactions in cyber-physical systems. Inf Softw Technol. 2020;126:106349.
- Krugh M, Mears L. A complementary cyber-human systems framework for Industry 4.0 cyber-physical systems. Manuf Lett. 2018;15:89–92.
- Jasiulewicz-Kaczmarek M et al. Recent advances in smart and sustainable maintenance [invited-session proposal]. Presented at: 10th IFAC Conference on Manufacturing Modelling, Management and Control; Nantes, France; 2022. https://hub.imt-atlantique.fr/mim2022/wp-content/uploads/2021/12/7a519.pdf.
- Jasiulewicz-Kaczmarek M, Gola A. Maintenance 4.0 technologies for sustainable manufacturing—An overview. IFAC-PapersOnLine. 2019;52(10):91–96.
- Saihi A, Ben-Daya M, As’ad RA. Maintenance and sustainability: A systematic review of modeling-based literature. J Qual Maint Eng. 2023;29(1):155–187.
- Bastas A. Sustainable manufacturing technologies: A systematic review of the latest trends and themes. Sustainability (Basel). 2021;13(8):4271.
- Franciosi C, Iung B, Miranda S, Riemma S. Maintenance for sustainability in the Industry 4.0 context: A scoping literature review. IFAC-PapersOnLine. 2018;51(11):903–908.
- Franciosi C et al. Measuring maintenance impacts on the sustainability of manufacturing industries: From a systematic literature review to a framework proposal. J Clean Prod. 2020;260:121065.
- Vrignat P, Kratz F, Avila M. Sustainable manufacturing, maintenance policies, prognostics and health management: A literature review. Reliab Eng Syst Saf. 2022;218:108140.
- Durán O, Aguilar J, Capaldo A, Arata A. Fleet resilience: Evaluating maintenance strategies in critical equipment. Appl Sci (Basel). 2021;11(1):38.
- Ciccarelli M, Papetti A, Germani M. Exploring how new industrial paradigms affect the workforce: A literature review of Operator 4.0. J Manuf Syst. 2023;70:464–483.
- Madzik P et al. Human-centricity in Industry 5.0—Revealing hidden research topics by unsupervised topic modeling using latent Dirichlet allocation. Eur J Innov Manag. 2025;28(1):113–138.
- Farivar F, Klarin A, Kanani-Moghadam V. Industry 5.0: A socio-technical system perspective on human agency and institutional legitimacy. J Manag Organ. 2026;32(4):1168–1189.
- Karki BR, Porras J. Digitalization for sustainable maintenance services: A systematic literature review. Digit Bus. 2021;1(2):100011.
- Santiago RAdF et al. Data-driven models applied to predictive and prescriptive maintenance of wind turbines: A systematic review of approaches based on failure detection, diagnosis, and prognosis. Energies (Basel). 2024;17(5):1010.
- Carvalho JN, Silva FR, Nascimento EGS. Challenges of the biopharmaceutical industry in the application of prescriptive maintenance in the Industry 4.0 context: A comprehensive literature review. Sensors (Basel). 2024;24(22):7163.
- Santos ACdJ, Cavalcante CAV, Wu S. Maintenance policies and models: A bibliometric and literature review of strategies for reuse and remanufacturing. Reliab Eng Syst Saf. 2023;231:108983.
- Orošnjak M, Brkljač N, Ristić K. Fostering cleaner production through the adoption of sustainable maintenance: An umbrella review with a questionnaire-based survey analysis. Clean Prod Lett. 2025;8:100095.
- Ji Z, Zhou Y, Wang B, Zang J. Human–cyber–physical systems in the context of new-generation intelligent manufacturing. Engineering (Beijing). 2019;5(4):624–636.
- Wang B et al. Toward human-centric smart manufacturing: A human–cyber–physical systems perspective. J Manuf Syst. 2022;63:471–490.
- Jiao J, Zhou F, Gebraeel NZ, Duffy V. Towards augmenting cyber-physical-human collaborative cognition for human–automation interaction in complex manufacturing and operational environments. Int J Prod Res. 2020;58(16):5089–5111.
- Yilma BA, Panetto H, Naudet Y. Systemic formalisation of cyber-physical-social systems: A systematic literature review. Comput Ind. 2021;129:103458.
- Zhou Y, Yu FR, Chen J, Kuo YH. Cyber-physical-social systems: A state-of-the-art survey, challenges and opportunities. IEEE Commun Surv Tutor. 2020;22(1):3
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.