В данном исследовании предлагается гибридная модель прогнозирования затрат для энергосетей, которая сочетает физические квоты затрат с динамическими макроэкономическими/технологическими корректировками и компенсацией остатков на основе XGBoost. При достижении MAPE 2,34% модель обеспечивает баланс между точностью и интерпретируемостью, отвечая требованиям регуляторной прозрачности при установлении тарифов.
Для просмотра этого контента требуется подписка на JoVE. Войдите или начните свой бесплатный пробный период.
Исследовательская статья
Ретроспективное прогнозирование с использованием данных провинциальной сети и гибридной физико-интеллектуальной модели на основе квот
В этой статье
Краткое содержание
Аннотация
Глобальный энергетический переход и текущие реформы рынка электроэнергии требуют от предприятий электросетевого хозяйства обеспечения баланса между надежностью электроснабжения и все более строгими правилами регулирования тарифов на передачу и распределение энергии. Традиционные методы бюджетирования, основанные на исторической экстраполяции, часто не отражают физическую основу эксплуатации активов, в то время как модели машинного обучения на основе данных обеспечивают высокую точность прогнозирования, но лишены прозрачности, необходимой для регуляторной верификации затрат. Чтобы решить проблему компромисса между точностью прогнозирования и интерпретируемостью, в данном исследовании предлагается гибридная модель прогнозирования затрат, основанная на квотах затрат. В данной структуре в качестве физической базы бюджетирования используются стандартизированные эксплуатационные квоты, а также внедрен динамический механизм эволюции квот, обусловленный макроэкономическими условиями и технологическим прогрессом. Для выявления нелинейных остатков, выходящих за рамки оценок на основе квот, применяется метод Extreme Gradient Boosting (XGBoost), а для интерпретации вклада ключевых факторов затрат используется метод SHAP (Shapley Additive exPlanations). Модель была оценена с использованием анонимизированных эксплуатационных данных за 16 лет из провинциальной электросети Китая. Была достигнута средняя абсолютная ошибка в процентах (MAPE) на уровне 2.34%, что позволило снизить ошибки прогнозирования на 61.8%, 46.6% и 34.1% по сравнению с моделями SARIMAX, автономным XGBoost и Attention-LSTM соответственно. Предложенная структура объединяет инженерные принципы квотирования затрат с объяснимым искусственным интеллектом, обеспечивая как точные долгосрочные прогнозы затрат, так и прозрачный инструмент поддержки принятия решений для верификации допустимых регуляторных затрат.
Введение
Глобальный энергетический переход меняет подходы к управлению активами и операционную практику в электросетях за счет интеграции распределенной возобновляемой генерации, учащения экстремальных погодных явлений и повсеместного внедрения технологий IoT, что требует большей операционной гибкости и дополнительных ресурсов для технического обслуживания с целью обеспечения надежности системы1,2. В то же время органы регулирования электроэнергетики ужесточили надзор за тарифами на передачу и распределение электроэнергии с помощью таких механизмов, как RIIO в Великобритании и обзоры нормы прибыли Федеральной комиссии по регулированию энергетики США, уделяя особое внимание прозрачности обоснования затрат3. Китай аналогичным образом внедрил механизм регулирования по принципу «допустимые затраты плюс разумная прибыль», требующий от коммунальных служб демонстрации четкой связи между инженерно-техническими мероприятиями и финансовыми расходами4. Однако электросетевым компаниям зачастую не хватает прозрачных количественных инструментов, связывающих эксплуатацию физических активов с прогнозами затрат, что ограничивает эффективность регуляторной проверки расходов5.
Существующие подходы к прогнозированию имеют серьезные ограничения в данной среде6. Традиционные методы, включая инкрементальное бюджетирование и модели на основе ARIMA, предполагают относительную стабильность исторических закономерностей и часто демонстрируют низкую эффективность при структурных изменениях, вызванных экономическими колебаниями или экстремальными погодными условиями7. С другой стороны, современные модели машинного обучения, такие как архитектуры LSTM и Transformer, обеспечивают высокую точность краткосрочного прогнозирования, но им не хватает инженерной интерпретируемости, необходимой для принятия регуляторных решений8,9. Хотя современные гибридные подходы к прогнозированию сочетают методы статистики и машинного обучения, они, как правило, игнорируют стандартизированные инженерные квоты затрат, лежащие в основе систем учета энергосетей10. Для устранения этих ограничений в данной работе предлагается гибридная структура прогнозирования на основе квот, которая сочетает динамическую эволюцию квот с коррекцией остатков на базе машинного обучения, что позволяет сохранить инженерную интерпретируемость при повышении точности прогнозирования.
Одно из основных направлений исследований вытекает из регулирования стимулов в отраслях с естественной монополией, включая механизм RPI-X в Великобритании и систему верификации допустимых затрат в Китае11. В этих работах операционная эффективность оценивается преимущественно с помощью анализа оболочки данных (DEA) и стохастического анализа границы (SFA)12. В предыдущих исследованиях изучались долгосрочные взаимосвязи между капитальными затратами (CAPEX), операционными расходами (OPEX) и эффективностью затрат для обоснования тарифного регулирования13,14. Хотя такие подходы дают ценную макроэкономическую информацию, их результаты обычно выражаются в виде показателей относительной эффективности, а не в виде денежных прогнозов, пригодных для ежегодного бюджетного планирования15,16. Кроме того, граничные модели обычно предполагают относительно стабильную структуру физических активов и условий эксплуатации, что ограничивает их способность фиксировать резкие изменения затрат, вызванные старением активов, заменой инфраструктуры или стремительным ростом спроса17,18.
Второе направление исследований сосредоточено на моделях прогнозирования на основе статистики и искусственного интеллекта. В ранних работах для прогнозирования затрат применялись множественная линейная регрессия и модели авторегрессионного интегрированного скользящего среднего с экзогенными переменными (ARIMAX)19. В последнее время модели регрессии на основе метода опорных векторов, случайные леса, XGBoost, LSTM и трансформеры значительно повысили точность прогнозирования за счет использования нелинейных зависимостей и многомерных пространств признаков20,21,22. В этих подходах часто учитываются такие макроэкономические показатели, как спрос на электроэнергию, индексы цен производителей (PPI) и климатические переменные23. Однако эксплуатационные расходы электросетей обусловлены инженерной деятельностью, износом активов, графиками технического обслуживания и управленческими решениями, а не только макроэкономическими переменными24. Следовательно, чисто эмпирические модели, основанные на данных, часто функционируют как «черные ящики», что затрудняет обоснование прогнозируемых затрат в ходе регуляторных проверок или верификации разрешенных расходов25,26.
Управление нормами инженерных затрат предлагает потенциальное решение этой проблемы27. Метод расчета затрат по видам деятельности (ABC) долгое время опирался на стандартизированные эксплуатационные нормы для оценки потребностей в трудовых ресурсах, материалах, оборудовании и техническом обслуживании при проведении рутинных операций в электросетях28. Крупные китайские коммунальные предприятия разработали комплексные базы данных норм, охватывающие деятельность по осмотру, техническому обслуживанию, испытаниям, ремонту и замене оборудования. Тем не менее, эти инженерные стандарты используются преимущественно для расчета окончательной стоимости проектов и аудита, а не для динамического долгосрочного прогнозирования29,30. Более того, нормы стандартов обычно пересматриваются лишь раз в несколько лет, что делает их недостаточно гибкими в условиях меняющихся цен на сырье, технологического прогресса и изменения эксплуатационной практики31. Применение систем норм для миллионов распределенных активов также создает значительные вычислительные сложности при крупномасштабном прогнозировании32.
Несмотря на значительные успехи в области статистического прогнозирования, машинного обучения и управления инженерными затратами, на сегодняшний день не существует структуры, которая эффективно объединяла бы стандартизированные квоты инженерных затрат, динамическую макроэкономическую корректировку и объяснимое машинное обучение в единую прогностическую модель для верификации нормативных затрат. Была выдвинута гипотеза, что сочетание динамически изменяющихся квот затрат с остаточным обучением на базе XGBoost позволит повысить точность долгосрочного прогнозирования, сохраняя при этом инженерную прозрачность, необходимую для принятия регуляторных решений. Для проверки этой гипотезы была разработана гибридная структура прогнозирования на основе квот, интегрирующая физическое моделирование затрат, механизмы макроэкономической и технологической корректировки, компенсацию остатков с помощью XGBoost и интерпретацию модели на основе SHAP. Предложенный подход направлен на обеспечение как точных долгосрочных прогнозов затрат, так и прозрачных доказательств для подтверждения допустимых затрат в условиях современного регулирования рынка электроэнергии.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Протокол
В данном исследовании использовались анонимизированные операционные и финансовые данные, собранные в провинциальной электросети на востоке Китая. Все данные были агрегированы и обезличены перед анализом; персональная информация или конфиденциальные данные на индивидуальном уровне не включались. Таким образом, этическое одобрение не требовалось. Доступ к данным и их анализ осуществлялись в соответствии с применимыми правилами защиты данных и институциональными соглашениями, регулирующими информацию в электроэнергетическом секторе.
Обзор структуры прогнозирования
Для интеграции подходов к прогнозированию на основе физических моделей и анализа данных была разработана гибридная система прогнозирования, сочетающая инженерные квоты затрат с машинным обучением. Вместо простого объединения нескольких алгоритмов, данная система основана на принципе, согласно которому физические модели формируют базовый прогноз, в то время как машинное обучение компенсирует остаточные ошибки. Такая архитектура гарантирует, что процесс прогнозирования опирается на физические механизмы, лежащие в основе процессов производства и эксплуатации энергосистемы, а не основывается исключительно на экстраполяции исторических затрат.
В рамках данной структуры сначала устанавливается иерархическое соответствие между активами энергосистемы, стандартизированными операционными действиями и счетами финансовых затрат. Затраты на производство и эксплуатацию рассматриваются как денежное выражение ресурсов, потребляемых физическими активами — включая подстанции, линии электропередачи, распределительные фидеры, приборы учета и оборудование для цифрового контроля — в ходе выполнения таких рутинных работ, как осмотр, техническое обслуживание, испытания, ремонт и замена. Нормативы затрат служат связующим звеном между измеримым объемом инженерных работ и соответствующими финансовыми расходами.
Как показано на Рисунке 1, квоты затрат функционируют как стандартизированные учетные единицы, интегрированные во весь процесс эксплуатации и технического обслуживания активов, а не как абстрактные правила распределения финансовых средств. Рабочие нагрузки по активам нижнего уровня преобразуются в стандартизированные эксплуатационные квоты и в дальнейшем сопоставляются с категориями затрат, включая трудозатраты, материалы, строительную технику, сторонние услуги и аварийные запасы. Такое иерархическое сопоставление обеспечивает инженерную интерпретируемость и нормативную прослеживаемость на протяжении всего процесса прогнозирования, а также создает физическую основу для построения статической базовой модели квот.
Обзор методологического процесса
Предлагаемая структура прогнозирования состоит из трех последовательных этапов: (1) построение физической базы с использованием квот рабочей нагрузки на уровне активов, (2) динамическое изменение квот затрат посредством макроэкономических и технологических корректировок и (3) компенсация остатков на основе машинного обучения для учета систематических нелинейных эффектов. Как показано на Рисунке 1, данная структура устанавливает иерархическое отображение от активов нижнего уровня и стандартизированных операционных действий к прогнозам затрат на производство и эксплуатацию. Детали реализации каждого этапа описаны в следующих подразделах.
Модель базовой физической стоимости на основе рабочих нагрузок на уровне активов
Затраты на производство и эксплуатацию энергосистемы, Ctotal, включают расходы, связанные с многочисленными видами хозяйственной деятельности, в том числе с эксплуатацией подстанций, техническим обслуживанием линий электропередачи, управлением распределительными сетями, обслуживанием клиентов и вспомогательными системами. В данном исследовании предполагается, что базовые эксплуатационные расходы определяются объемом работ, создаваемым каждым стандартизированным видом операционной деятельности, и соответствующей квотой затрат.
Статическая базовая стоимость рассчитывается следующим образом:
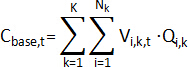 (1)
где Vi,k,t обозначает объем работ, связанный с i-м активом или операционной задачей в рамках бизнес-категории k в период t, а Qi,k представляет соответствующую стандартизированную единичную стоимость, определенную системой инженерных квот затрат. Бизнес-категория включает основные операционные функции, такие как техническое обслуживание подстанций, инспекция линий электропередачи, эксплуатация распределительных сетей и обслуживание клиентов. Двойное суммирование объединяет затраты на все стандартизированные операционные действия для оценки теоретического базового уровня расходов, необходимых для поддержания нормального функционирования энергосети.
Уравнение (1) устанавливает физическую взаимосвязь между инженерным объемом работ и финансовыми затратами путем прямого сопоставления стандартизированных операционных действий с соответствующими счетами затрат. В отличие от чисто статистических моделей прогнозирования, данная формулировка обеспечивает интерпретируемую инженерную базу, которая служит основой для последующей динамической корректировки квот и исправления остаточных отклонений на основе машинного обучения. Уравнение было разработано на основе операционной практики и системы стоимостных квот, используемых предприятиями провинциальных электросетей Китая. В Таблице 1 приведены обозначения, используемые в уравнении (1), включая объем работ (Vi,k,t), стандартизированную единичную стоимость (Qi,k), количество операционных задач (Nk) и индекс категории бизнеса (k).
Механизм динамической эволюции квот при внешних воздействиях окружающей среды
Стандартизированные квоты затрат (Qi,k) обеспечивают физически интерпретируемую базовую линию, однако они не учитывают изменения макроэкономических условий или технологический прогресс. Для повышения их долгосрочной применимости был внедрен механизм динамической эволюции для корректировки базовых квот в ответ как на ценовую инфляцию, так и на рост эффективности, обусловленный технологическим развитием.
Первая корректировка учитывает изменения затрат на закупки, вызванные макроэкономической инфляцией. Эксплуатация и техническое обслуживание электросетей в значительной степени зависят от основных материалов, включая медь, алюминий и электротехническую сталь, цены на которые тесно связаны с колебаниями индекса цен производителей (PPI). Поскольку  представляет собой индекс с базовым значением 100, он сначала преобразуется в стандартизированный уровень инфляции:
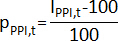 (2)
На этом основании функция коррекции цены  определяется следующим образом:
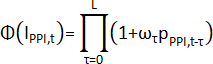 (3)
где  — вектор груза-противовеса длиной L, удовлетворяющий
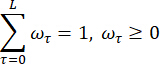
Структура лага представляет собой отложенную передачу макроэкономической инфляции на затраты по закупкам в цепочке поставок электросетевого хозяйства. Преобразование индекса PPI в стандартизированный уровень инфляции позволяет сохранить кумулятивный эффект изменения цен, избегая при этом систематической ошибки масштабирования, связанной с прямым использованием значений индекса. Уравнения (2) и (3) адаптированы из общепринятых моделей корректировки макроэкономической инфляции, при этом структура лага откалибрована с учетом циклов закупок в энергетическом секторе33,34.
Технологический прогресс был учтен с помощью коэффициента снижения затрат, который отражал повышение операционной эффективности в результате внедрения таких достижений, как инспекции с помощью беспилотных летательных аппаратов, интеллектуальная робототехника и технологии цифрового технического обслуживания. Коэффициент технологической корректировки определяется следующим образом:
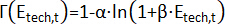 (4)
В данной части α и β представляют собой эмпирические коэффициенты эластичности, оцененные на основе исторических панельных данных с помощью метода нелинейных наименьших квадратов. Чтобы фактор технологического прогресса всегда соответствовал обоснованному снижению удельных затрат по квоте, процесс оценки параметров ограничивает значение 0 < Γ(Etech,t) ≤ 1. Следует отметить, что этот фактор в первую очередь отражает долгосрочное повышение эффективности, resulting from замены технологий на более зрелые. Уравнение (4) является оригинальным для данной работы и адаптирует концепцию кривой обучения из литературы по стоимости энергетических технологий35,36 к операциям по техническому обслуживанию электросетей. Дополнительные затраты, которые могут возникнуть на раннем этапе внедрения цифрового оборудования, такие как параллельная работа старых и новых систем, интеграция платформ, тестирование связи и дополнительное техническое обслуживание, не вычитаются принудительно из базовой квоты; вместо этого они определяются последующим модулем компенсации остатков на основе машинного обучения:
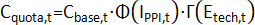 (5)
где Cbase,t обозначает статическую базовую стоимость, рассчитанную на основе рабочих нагрузок активов нижнего уровня и стандартизированных квот на эксплуатационные расходы; отражает эффект передачи макроэкономических колебаний цен на стоимость материалов, оборудования и внешних услуг; а Γ(Etech,t) отражает снижение удельных затрат на эксплуатацию и техническое обслуживание за счет повышения эффективности после достижения технологической зрелости. Благодаря вышеописанному механизму динамической эволюции базовая квота перестает быть статическим бухгалтерским показателем и может адаптивно корректироваться при изменении экономических условий и технологических факторов. Уравнение (5) является оригинальным для данной работы и представляет собой новую интеграцию ценовых и технологических поправок в структуру базовой квоты.
Систематический захват нелинейных остатков при наличии квотных ограничений
Несмотря на сложные эволюционные корректировки, модель квотирования неизбежно вызывает систематические отклонения при возникновении непредсказуемых погодных сбоев, связанных с катастрофами, и внезапных политических директив, таких как увеличение затрат на обработку жалоб клиентов в периоды временного снижения тарифов. Это отклонение формирует остаточный член по обе стороны уравнения:
Rt=Cactual,t-Cquota,t (6)
Поскольку традиционные физические законы не могут объяснить этот аспект, для преодоления данных ограничений может быть использовано машинное обучение. Чтобы избежать «проклятия размерности», вызванного многомерными признаками, в данном исследовании для моделирования нелинейной зависимости Rt37,38 используется алгоритм XGBoost, основанный на ансамблях деревьев решений. Определена матрица признаков сильного возмущения Xt, включающая такие метеорологические признаки, как количество дней с экстремальными морозами в году Dice , а также интенсивность макроэкономической политики.
Для нелинейного компенсатора, состоящего из деревьев регрессии, логика генерации прогнозируемого остатка  может быть выражена следующим образом39:
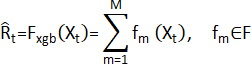 (7)
где F обозначает пространство всех возможных структур деревьев классификации и регрессии. Для обеспечения баланса между точностью подгонки и предотвращением переобучения на m-й итерации строится и минимизируется регуляризованная целевая функция, содержащая член штрафа за структурную сложность:
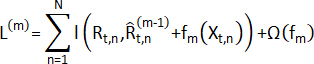 (8)
где  представляет собой выпуклую функцию потерь, измеряющую разницу между истинным и прогнозируемым остатком. В данной работе используется функция потерь Хубера (Huber Loss) для повышения устойчивости модели к аномальным пикам расходов. Регуляризационный член
 используется для ограничения сложности структуры дерева и определяется следующим образом:
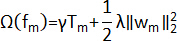 (9)
где Tm представляет собой количество листовых узлов в m-ом дереве, wm представляет соответствующий вектор весов листьев, а γ и λ обозначают коэффициент штрафа за количество листовых узлов и коэффициент регуляризации весов соответственно.
Итоговое уравнение прогнозирования имеет следующий вид:
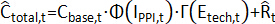 (10)
Дальнейшая расшифровка:
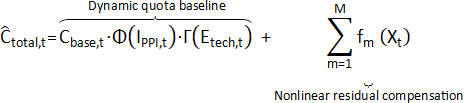 (11)
Приведенная выше формула математически представляет структуру с замкнутым контуром предлагаемой модели прогнозирования. Итоговый спрос на затраты на производство и эксплуатацию не генерируется моделью машинного обучения напрямую; вместо этого он получается путем наложения нелинейной компенсации остатков, определенной модулем машинного обучения, на динамическую базовую линию квоты. Среди этих компонентов ценовые и технологические факторы в первую очередь отражают динамическую эволюцию базовой линии квоты, в то время как факторы, которые трудно эксплицитно охарактеризовать с помощью правил, такие как климатические потрясения, политические сбои и резкое увеличение количества случаев ремонта, фиксируются модулем компенсации остатков на основе машинного обучения. Уравнения (10) и (11) являются оригинальными для данной работы и объединяют физическую базовую линию с захватом остатков на базе ML в единую структуру прогнозирования.
Рисунок 2 показывает, что результаты прогнозирования предлагаемой модели демонстрируют четкую иерархическую логику генерации. С одной стороны, базовая квота обеспечивает стабильный, прозрачный и проверяемый физический фундамент для спроса на затраты; с другой стороны, корректировка цен, технологические эффекты и остатки внешних шоков позволяют модели адаптироваться к динамическим изменениям в сложных условиях. По сравнению с моделями «черного ящика», которые напрямую выдают прогнозируемые значения, такая структура декомпозиции позволяет четко выявить причины роста или снижения затрат, тем самым повышая интерпретируемость результатов модели при анализе бюджета и регулировании тарифов на передачу и распределение электроэнергии.
Источники данных и процедуры сбора
Теоретические модели должны проходить строгую валидацию с помощью эмпирических данных для подтверждения их практической полезности. Поскольку основные финансовые данные энергетического сектора содержат конфиденциальную информацию, касающуюся функционирования национальной инфраструктуры, в данном исследовании используются высокоточные анонимизированные ежемесячные данные бухгалтерского учета типичной провинциальной электросети в восточном Китае (для удобства именуемой E-Grid), охватывающие 16 последовательных календарных лет с 2010 по 2025 год. В этой провинции наблюдался типичный экономический цикл перехода от роста, стимулируемого традиционной тяжелой промышленностью, к высокотехнологичному производству, при этом совокупный среднегодовой темп роста масштаба активов сети достиг 7,4%. Таким образом, сложная эволюция структуры ее затрат может иметь значение для других быстроразвивающихся сетевых систем. Данные получены из трех основных источников: (1) внутренних журналов эксплуатации и технического обслуживания, в которых фиксируются объемы работ на уровне активов, частота осмотров и случаи ремонта; (2) систем финансового учета, предоставляющих ежемесячные отчеты о затратах на оплату труда, материалы, оборудование и сторонние услуги; и (3) внешних баз данных об окружающей среде, включая метеорологические записи Метеорологической администрации Китая и макроэкономические показатели Национального бюро статистики.
Контроль качества и обработка пропущенных данных
Для более чем 130 исходных показателей, интегрированных из многоисточниковых систем, была внедрена строгая процедура контроля качества. Пропуски в данных, составляющие менее 3% от общего объема наблюдений, обрабатывались с помощью линейной интерполяции для непрерывных переменных с временными трендами и импутации модой для категориальных показателей. Выбросы определялись методом межквартильного размаха (IQR); значения, превышающие верхний квартиль более чем на 3,0 IQR, подвергались винзоризации до 99-го процентиля для сохранения целостности данных и минимизации искажений, вызванных экстремальными значениями.
Обоснование размера выборки
Набор данных состоит из 192 ежемесячных наблюдений (январь 2010 г. – декабрь 2025 г.), из которых 156 наблюдений (2010–2022 гг.) распределены для обучения и валидации, а 36 наблюдений (2023–2025 гг.) зарезервированы для тестирования на выборке вне обучающего набора. Хотя такой размер выборки относительно невелик для приложений глубокого обучения, он подходит для алгоритма XGBoost, который специально разработан для эффективной работы с табличными данными малого и среднего объема благодаря механизмам регуляризации и прунинга деревьев. Для минимизации рисков переобучения были применены следующие меры: (1) строгие штрафы регуляризации (γ = 0.1, λ = 1.0), (2) ранняя остановка с параметром patience = 50 раундов и (3) консервативные ограничения глубины дерева (max depth = 5). В совокупности эти меры обеспечивают стабильность и обобщающую способность модели, несмотря на ограниченный размер выборки.
Сегментация данных и гетерогенная интеграция из нескольких источников
Для строгого тестирования данные с января 2010 по декабрь 2022 года были отнесены к интервалу обучения-валидации, содержащему 156 наблюдений, который используется для обучения факторов эволюции квот и остаточной сети компенсации квот. Период с января 2023 по декабрь 2025 года зарезервирован в качестве отложенного внешней выборки для тестирования, содержащей 36 наблюдений. Почему этот период был выбран в качестве финального полигона для тестирования? Причина заключается в том, что эти три года совпали с ускорением строительства энергосистем нового типа, что было осложнено масштабными экстремальными высокотемпературными явлениями, связанными с Эль-Ниньо, а также быстрым и неравномерным ростом распределенной генерации из возобновляемых источников энергии. Энергосистема столкнулась с беспрецедентным давлением в цепочках поставок материалов и распределении ремонтного персонала.
Научный отбор и количественное определение факторов, влияющих на стоимость, являются основой для обеспечения того, чтобы остаточная сеть машинного обучения могла эффективно фиксировать систематические колебания. Основываясь на логике управления стандартными эксплуатационными расходами в энергосистемах, в данном исследовании преодолевается одномерность традиционного финансового прогнозирования, которое опирается только на исторические денежные потоки; вместо этого проектирование признаков перестраивается на базе четырех основных границ: масштаба физических активов, условий эксплуатации и технического обслуживания, макроэкономической эволюции и внешней климатической среды с использованием оригинальных эксплуатационных журналов и внешних системных реестров. В процессе фактического моделирования для более чем 130 исходных показателей, полученных в результате интеграции многоисточниковых систем, в данном исследовании используются тесты корреляции Пирсона для исключения высококоллинеарных избыточных переменных с пороговым значением |r| > 0.85. На основе априорных знаний ведущих экспертов по электросетям для формирования матрицы признаков Xt в конечном итоге были выбраны 42 основные входные характеристики. Для наглядного представления базовой структуры данных и распределения входного тензора в Таблице 2 выбраны 12 репрезентативных основных признаков из четырех вышеупомянутых измерений оценки и обобщены их описательные статистики за период наблюдения.
Для дальнейшей иллюстрации пространственно-топологической основы многоисточниковой системы признаков на рисунке 3 представлена анонимизированная схематическая топология исследуемой провинциальной энергосистемы. На рисунке наложены подстанции различных уровней напряжения, коридоры линий электропередачи, кластеры распределенных возобновляемых источников энергии, центры нагрузки и репрезентативные зоны воздействия факторов окружающей среды. Топология помогает объяснить, почему затраты на производство и эксплуатацию совместно зависят от масштаба активов, структуры сети, интенсивности аварийно-восстановительных работ и внешних климатических воздействий. Она также служит основой для пространственной интерпретации переменных, определяющих остатки, которые используются в модуле компенсации XGBoost.
Таблица 2 показывает, что объясняющие переменные по различным бизнес-измерениям имеют заметно различающиеся статистические формы. Переменные физических активов, представляющие эндогенную динамику развития предприятия, такие как мощность подстанций и протяженность линий, имеют относительно стабильные значения стандартного отклонения и коэффициента асимметрии в диапазоне от 0,1 до 0,8. Их общая структура данных приближена к нормальному распределению, что объективно отражает характеристику устойчивого развития энергосистемы в цикле строительства инфраструктуры. Резким контрастом выступают переменные метеорологических и внешних факторов окружающей среды в нижней части таблицы. Например, совокупное количество дней с предупредительным уровнем высокой температуры за последние 90 дней и индекс воздействия отключений линий демонстрируют крайне сильную правостороннюю асимметрию с коэффициентами асимметрии 2,15 и 2,45 соответственно. Такое типичное распределение с «тяжелыми хвостами» подтверждает объективную проблему, которую нельзя игнорировать при фактической эксплуатации и техническом обслуживании энергосистемы: хотя экстремальные погодные катастрофы происходят относительно редко в годовом исчислении, при их возникновении часто наблюдается экспоненциальный рост затрат трудовых ресурсов на ремонт и расхода запасных частей. С другой стороны, высокая неоднородность и асимметрия экстремальных значений в распределении этих многоисточниковых признаков выявляют теоретические ограничения традиционных линейных моделей временных рядов, таких как ARIMAX, которые основаны на предположениях о нормальности и гомоскедастичности при отслеживании сложных затрат энергосистемы. Это не только дополнительно обосновывает целесообразность внедрения модуля машинного обучения сверх базового физического учета, но и обеспечивает серьезную статистическую поддержку выбору в данной работе древовидной модели XGBoost, которая способна эффективно обрабатывать разреженные распределения признаков и нелинейные отображения для аппроксимации остатков затрат.
Настройка системы оптимизации гиперпараметров и оценки
После определения пространства входных признаков настройка гиперпараметров модели напрямую влияет на эффективность аппроксимации в сети остаточного приближения. Поскольку компенсационная сеть XGBoost включает множество параметров, в том числе глубину дерева (max depth), скорость обучения и штрафные члены регуляризации, которые имеют нелинейные взаимодействия, традиционный поиск по сетке не только обладает высокой вычислительной сложностью, но и склонен к попаданию в локальные минимумы в многомерных пространствах. Поэтому в процессе настройки параметров в данной работе используется метод байесовской оптимизации — древовидный парзеновский оцениватель (Tree-structured Parzen Estimator, TPE). Алгоритм TPE может динамически направлять последующий отбор выборок, используя обратную связь по функции потерь из предыдущих итераций. Путем построения апостериорной оценки ядерной плотности (KDE) целевой переменной он адаптивно сужает пространство поиска параметров, что позволяет модели приблизиться к глобально оптимальной конфигурации гиперпараметров без чрезмерных вычислительных затрат. Целью оптимизации TPE была минимизация RMSE на валидационной выборке в течение 100 итераций с применением ранней остановки после 50 раундов без улучшения результата.
После завершения оптимизации параметров на внутреннем валидационном наборе данных, для объективной оценки итоговой эффективности каждой модели на внешней тестовой выборке и в соответствии с требованиями регуляторов по количественной оценке для верификации затрат, в данном исследовании используется средняя абсолютная процентная ошибка (MAPE) для количественного определения относительного отклонения в прогнозируемой последовательности. В то же время, для решения практической задачи по контролю критических ошибок прогнозирования затрат в операционной деятельности, также вводится среднеквадратическая ошибка (RMSE), чтобы обеспечить более строгий штраф за более крупные ошибки. Наконец, коэффициент детерминации, R2, количественно определяет общую объясняющую способность регрессии относительно истинной дисперсии целевой переменной.
Математические определения показателей следующие:
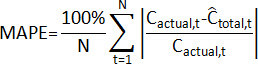 (12)
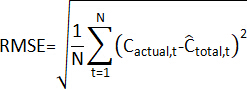 (13)
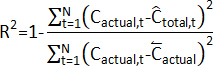 (14)
где  представляет собой фактические затраты на производство и эксплуатацию в периоде t,
 представляет собой стоимость, предсказанную моделью,
 представляет собой средние фактические затраты в тестовой выборке, а N — количество образцов в тестовом наборе.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Результаты
Панорамное сравнение точности прогнозирования с использованием снижения размерности
При оценке всех моделей, оптимизированных с помощью алгоритма Tree-structured Parzen Estimator (TPE), на вневыборочном тестовом наборе данных за 2023–2025 гг., который включал колебания в период постпандемийного восстановления и экстремальные высокотемпературные явления, стало возможным объективно сравнить эффективность основных алгоритмов прогнозирования. Для обеспечения строгого и всесторонне...
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Обсуждение
Данное исследование демонстрирует, что интеграция промышленных квот на затраты с методами машинного обучения обеспечивает интерпретируемую и точную основу для долгосрочного прогнозирования затрат в электросетях. Результаты показывают, что климатические переменные, в частности количество дней с экстремально высокими температурами и индексы влияния отключений линий, являются доминирующими факторами остаточных затрат, что подчеркивает растущее влияние внешних воздействий на расходы коммунальных служб. Эти выводы позволяют п...
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Раскрытие информации
Все авторы заявляют об отсутствии конфликта интересов.
ВКЛАД АВТОРОВ:
Xiaohui Wang разработала концепцию и дизайн исследования, разработала методологию, провела формальный анализ и подготовила черновик рукописи. Tong Li участвовал в курировании данных, реализации программного обеспечения и валидации. Yanchao Lu внес вклад в разработку методологии, проведение исследования и интерпретацию данных. Quanfeng Lv предоставил ресурсы, контролировал сбор данных и провел критический обзор рукописи. Fan Liu руководил проектом, участвовал в концептуализации и интерпретации результатов, обеспечил финансирование и критически переработал рукопись. Все авторы ознакомились с окончательным вариантом рукописи и одобрили его
Благодарности
Данная работа была поддержана технологическим проектом Государственной электросетевой корпорации Китая под названием «Исследование анализа распределения производственных и эксплуатационных затрат и технологии асинхронной оптимизации» (номер проекта: 520600250029-183-ZN).
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Материалы
| Имя | Компания | Каталожный номер | Комментарии |
|---|---|---|---|
| Анонимизированный ежемесячный набор данных бухгалтерского учета E-Grid | Провинциальная энергосеть в восточном Китае | Н/П | Анонимизированный набор данных по ежемесячному производству и эксплуатационным расходам (2010–2025), включающий 192 наблюдения, в том числе данные о физических активах, эксплуатации и техническом обслуживании, макроэкономические и экологические данные. Использовался для разработки модели (156 наблюдений) и вневыборочного тестирования (36 наблюдений). |
| Библиотека для построения графиков Matplotlib | Команда разработчиков Matplotlib | 3.5.2 | Использовалась для создания рисунков к рукописи и графических результатов, включая графики эффективности модели, визуализации топологии, диагностику остатков, лепестковые диаграммы и визуальные сводки на основе SHAP. |
| Библиотека для численных вычислений NumPy | Разработчики NumPy | 1.22.3 | Использовалась для операций с числовыми массивами, матричных вычислений и контроля воспроизводимости. В соответствующих случаях применялся фиксированный случайный seed 42. |
| Библиотека для манипулирования данными Pandas | Команда разработчиков pandas | 1.4.2 | Использовалась для импорта, интеграции, реструктуризации, фильтрации и предобработки данных, включая импутацию пропущенных значений, выравнивание временных рядов и подготовку входных переменных модели. |
| Среда программирования Python | Python Software Foundation | 3.9.13 | Среда программирования, использованная для реализации полного рабочего процесса прогнозирования, включая предобработку данных, проектирование признаков, обучение модели, оптимизацию гиперпараметров, прогнозирование, статистическое тестирование и оценку эффективности. |
| Библиотека машинного обучения Scikit-learn | Контрибьюторы scikit-learn | 1.0.2 | Использовалась для предобработки данных, разделения на обучающую и валидационную выборки, вспомогательной оценки модели и статистических процедур, включая корреляционный анализ Пирсона и расчет выбранных показателей эффективности. |
| Библиотека для научных вычислений SciPy | Контрибьюторы SciPy | 1.9.0 | Использовалась для статистических вычислений, включая корреляционный анализ Пирсона и вспомогательные процедуры обработки выбросов и винзоризации. |
| Реализация метода Tree-structured Parzen Estimator | Контрибьюторы Optuna | 3.1.0 | Реализация байесовской оптимизации, использованная для настройки гиперпараметров XGBoost, включая максимальную глубину дерева, скорость обучения и параметры регуляризации. Tree-structured Parzen Estimator был реализован с помощью пакета с открытым исходным кодом Optuna. |
| Программная библиотека XGBoost | Контрибьюторы DMLC / XGBoost | 1.7.1 | Библиотека ансамблевого обучения на основе деревьев решений, использованная для нелинейной компенсации остатков. В модели была реализована регуляризованная целевая функция с функцией потерь Хьюбера и штрафами за сложность дерева, как описано в уравнениях 7–9. |
Ссылки
- Rao H, Li J, Sun X. Demand forecasting and allocation optimization of green power grid supply chain based on machine learning algorithm: A study based on the whole-process data of power grid materials. Sustainability. 2025;17(3):1247.
- Huang C, et al. Demand response for industrial micro-grid considering photovoltaic power uncertainty and battery operational cost. IEEE Trans Smart Grid. 2021;12(4):3043-3055.
- Phuangpornpitak N, Prommee W. A study of load demand forecasting models in electric power system operation and planning. GMSARN Int J. 2016;10:19-24.
- Nasir J, et al. A hybrid LMD–ARIMA–machine learning framework for enhanced forecasting of financial time series: Evidence from the NASDAQ Composite Index. Mathematics. 2025;13(15):2389.
- Matos C, et al. Model for integrating the electricity cost consumption and power demand into aggregate production planning. Appl Sci. 2022;12(15):7577.
- Valenzuela J, Mazumdar M, Kapoor A. Influence of temperature and load forecast uncertainty on estimates of power generation production costs. IEEE Trans Power Syst. 2000;15(2):668-674.
- Khan F, et al. A hybrid vector autoregressive model for accurate macroeconomic forecasting: An application to the US economy. Mathematics. 2025;13(11):1706.
- Fatema I, Kong X, Fang G. Electricity demand and price forecasting model for sustainable smart grid using comprehensive long short-term memory. Int J Sustain Eng. 2021;14(6):1714-1732.
- Singh AK, Ibraheem SK, Muazzam M, Chaturvedi DK. An overview of electricity demand forecasting techniques. Netw Complex Syst. 2013;3(3):38-48.
- Iftikhar H, et al. A novel hybrid framework for forecasting stock indices based on nonlinear time series models. Comput Stat. 2025;40(8):4163-4186.
- Jiang P, Li R, Lu H, Zhang X. Modeling of electricity demand forecast for power system. Neural Comput Appl. 2020;32(11):6857-6875.
- Chan SC, et al. Load/price forecasting and managing demand response for smart grids: Methodologies and challenges. IEEE Signal Process Mag. 2012;29(5):68-85.
- Hernandez L, et al. A survey on electric power demand forecasting: Future trends in smart grids, microgrids and smart buildings. IEEE Commun Surv Tutor. 2014;16(3):1460-1495.
- Zareipour H, Canizares CA, Bhattacharya K. Economic impact of electricity market price forecasting errors: A demand-side analysis. IEEE Trans Power Syst. 2009;25(1):254-262.
- Botterud A. Forecasting renewable energy for grid operations. In: Renewable Energy Integration. Academic Press; 2017:133-143.
- Mirowski P, Chen S, Ho TK, Yu CN. Demand forecasting in smart grids. Bell Labs Tech J. 2014;18(4):135-158.
- Sobu A, Wu G. Optimal operation planning method for isolated micro grid considering uncertainties of renewable power generations and load demand. In: IEEE PES Innovative Smart Grid Technologies [conference proceedings]. IEEE; 2012. Available at: https://ieeexplore.ieee.org/
- Han B, et al. Optimal design of an on-grid microgrid considering long-term load demand forecasting: A case study. Distrib Gener Altern Energy J. 2020;35:345-362.
- Tripathy SC. Demand forecasting in a power system. Energy Convers Manag. 1997;38(14):1475-1481.
- Adshead NS, Price DH. Demand forecasting and cost performance in a model of a real manufacturing unit. Int J Prod Res. 1987;25(9):1251-1265.
- Gellert A, et al. A study on forecasting electricity production and consumption in smart cities and factories. Int J Inf Manage. 2019;49:546-556.
- Hernández L, et al. A multi-agent system architecture for smart grid management and forecasting of energy demand in virtual power plants. IEEE Commun Mag. 2013;51(1):106-113.
- Klingler AL, Teichtmann L. Impacts of a forecast-based operation strategy for grid-connected PV storage systems on profitability and the energy system. Sol Energy. 2017;158:861-868.
- Ghalehkhondabi I, Ardjmand E, Weckman GR, Young WA. An overview of energy demand forecasting methods published in 2005–2015. Energy Syst. 2017;8(2):411-447.
- Aderibigbe AO, et al. Enhancing energy efficiency with AI: A review of machine learning models in electricity demand forecasting. Eng Sci Technol J. 2023;4(6):341-356.
- Arumugham V, et al. An artificial-intelligence-based renewable energy prediction program for demand-side management in smart grids. Sustainability. 2023;15(6):5453.
- Dudek G, Piotrowski P, Baczyński D. Intelligent forecasting and optimization in electrical power systems: Advances in models and applications. Energies. 2023;16(7):3024.
- Liu N, et al. A hybrid forecasting model with parameter optimization for short-term load forecasting of micro-grids. Appl Energy. 2014;129:336-345.
- Mohammad AA, et al. Mathematical and statistical modelling of electricity demand forecasting using artificial neural networks and SARIMA: Implications for energy supply chain planning. Alex Eng J. 2026;139:98-108.
- Singh AR, et al. A blockchain-enabled multi-agent deep reinforcement learning framework for real-time demand response in renewable energy grids. Energy Strateg Rev. 2025;62:101905.
- Lu R, et al. Data-driven real-time price-based demand response for industrial facilities energy management. Appl Energy. 2021;283:116291.
- Kondaiah VY, Saravanan B, Sanjeevikumar P, Khan B. A review on short-term load forecasting models for micro-grid application. J Eng. 2022;2022(7):665-689.
- Lee BL, Wilson C, Simshauser P, Majiwa E. Deregulation, efficiency and policy determination: An analysis of Australia's electricity distribution sector. Energy Econ. 2021;98:105210.
- Wang Y, et al. Transmission network expansion planning considering wind power and load uncertainties based on multi-agent DDQN. Energies. 2021;14(19):6073.
- Ding Q, Zhao H. Study on e-commerce logistics cost control methods in the context of COVID-19 prevention and control. Soft Comput. 2021;25(18):11955-11963.
- Duan Y, Xu Z, Chen H, Wang Y. Novel machine learning approach for enhanced smart grid power use and price prediction using advanced Shark Smell-tuned flexible support vector machine. Sci Rep. 2025;15(1):20909.
- Chen T, Guestrin C. XGBoost: A scalable tree boosting system. In: Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining [conference proceedings]. San Francisco, CA, USA; 2016. Available at: https://doi.org/10.1145/2939672.2939785
- Lin KY, et al. Predictive maintenance in industrial systems: An XGBoost-based approach for failure time estimation and resource optimization. J Ind Prod Eng. 2025;42(8):876-899.
- Ajayi OO, Kurien AM, Djouani K, Dieng L. A proactive predictive model for machine failure forecasting. Machines. 2025;13(8):663.
- Lundberg SM, et al. From local explanations to global understanding with explainable AI for trees. Nat Mach Intell. 2020;2(1):56-67.
- Chen H, Gao T, Wang L, Guo P. Explainable machine learning methods for predicting electricity consumption in a long-distance crude oil pipeline. Sci Rep. 2025;15(1):43305.
- Neubauer A, Brandt S, Kriegel M. Explainable multi-step heating load forecasting: Using SHAP values and temporal attention mechanisms for enhanced interpretability. Energy AI. 2025;20:100480.
- Ahmad T, Chen H. Potential of three variant machine-learning models for forecasting district-level medium-term and long-term energy demand in smart grid environment. Energy. 2018;160:1008-1020.
- Masa-Bote D, et al. Improving photovoltaics grid integration through short-time forecasting and self-consumption. Appl Energy. 2014;125:103-113.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.