Этот протокол описывает воспроизводимый квантово-классический гибридный рабочий процесс для классификации болезни Паркинсона по человеческим голосовым записям, включая предварительную обработку данных, реализацию квантовых схем, обучение модели и кросс-валидацию для независимой репликации.
Для просмотра этого контента требуется подписка на JoVE. Войдите или начните свой бесплатный пробный период.
Исследовательская статья
Воспроизводимый квантово-классический гибридный протокол для классификации болезни Паркинсона по записям человеческого голоса
В этой статье
Краткое содержание
Аннотация
Болезнь Паркинсона — это прогрессирующее нейродегенеративное заболевание, для которого доступные и недорогие методы скрининга остаются ограниченными. Записи длительного гласного голоса содержат измеримые акустические биомаркеры, связанные с дисфонией, связанной с заболеваниями, которые можно получить без специализированного оборудования. Этот протокол описывает четырёхкубитную гибридную сверточную нейронную сеть (QI-HCNN), которая сочетает параметризованную квантовую схему с неглубоким классическим классическим слоем классификации для классификации болезни Паркинсона с использованием размерно-уменьшенных акустических голосовых признаков. Протокол также сравнивает предлагаемый подход с классическими нейронными сетями, соответствующими размерностям, и деревьными классификаторами с усилением градиента, обученными как на уменьшенном, так и на полном наборе признаков. Используя общедоступный, деидентифицированный набор данных, включающий 195 голосовых записей от 31 человека, QI-HCNN достиг площади под кривой операционной характеристики приёмника 0,78 с помощью трёхкратной стратифицированной кросс-валидации, по сравнению с 0,87 для согласованной классической нейронной сети и 0,94–0,95 для градиентно-бустированных базовых линий, обученных соответственно на уменьшенном и полном наборе признаков. Анализ контролируемой абляции показал, что одна из двух операций запутанности в цепи не может по конструкции повлиять на измеренный выход, тогда как остальная операция запутанности снижала, а не улучшала характеристики классификации по сравнению с незапутанным вариантом. Кросс-валидация по группам пациентов также показала, что оценки эффективности существенно различаются в зависимости от назначенных в тестовый набор пациентов, что отражает ограниченный размер когорт. Таким образом, этот протокол обеспечивает полностью определённую и независимо воспроизводимую квантово-классическую базу вместе с обоснованной оценкой сильных и ограниченных сторон текущей схемы, обеспечивая методологическую основу для будущих исследований, а не подтверждающую заявления о диагностической готовности.
Введение
Болезнь Паркинсона — это хроническое нейродегенеративное заболевание, вызванное прогрессирующей потерей дофаминергических нейронов в черной субстанции, затрагивающее более 10 миллионов человек по всему миру и представляющее значительное и растущее бремя для общественного здоровья1. Заболевание вызывает как моторные симптомы, включая тремор, скованность и брадикинезию, так и немоторные симптомы, такие как нарушение сна и аносмия. Клиническая диагностика в основном основана на неврологическом обследовании с использованием стандартизированных моторных оценочных шкал, дополняемых, где это возможно, с помощью визуализации транспортёров дофамина; Однако оба подхода требуют специализированной экспертизы и инфраструктуры, которые не являются единообразно доступными, а клиническая оценка на ранних стадиях остаётсясубъективной 2. Поскольку в настоящее время нет терапии, модифицирующей заболевание, раннее выявление ценно прежде всего потому, что позволяет более раннее лечение симптомов и продольный мониторинг. Эта потребность стимулировала разработку недорогих, масштабируемых и неинвазивных методов скрининга, которые могут дополнять, а не заменять клиническую оценку.
Нарушение голоса — одно из самых ранних измеримых изменений, связанных с болезнью Паркинсона, и часто предшествует явным моторнымсимптомам 3. Устойчивая фонация удерживаемого гласного обеспечивает контролируемый сигнал, из которого можно извлечь акустические особенности, включая джиттер, шиммер, соотношение гармоники к шуму, энтропию плотности периода рекурренции и анализ детрендовых флуктуаций. Неоднократно было доказано, что эти функции содержат диагностически значимую информацию и могут быть получены с помощью потребительского оборудования для записи 4,5. Общедоступный набор бенчмарков, полученный на основе таких записей, стал стандартным испытательным платформой для этой задачи, и классические методы машинного обучения, применяемые к всему набору функций, включая поддерживающие векторные машины, случайные леса и деревья с градиентным усилением, сообщают о значениях площади под приёмником-операционной-характеристичной кривой, приближающихся к 0.99 6,7,8, что говорит о том, что задача классификации близка к решению при использовании полного набора признаков и соответствующих стратегий для работы с дисбалансом классов. Квантовое машинное обучение стало альтернативной вычислительной парадигмой для задач биомедицинской классификации, в которой параметризованные квантовые схемы используют суперпозицию и запутанность для представления взаимодействий признаков с относительно небольшим числом обучаемых параметров, а градиенты схем могут вычисляться аналитически с использованием правила смещения параметров, а не приближений конечныхразностей 9. Однако многие опубликованные исследования, описывающие «квантовые» или «квантово-вдохновлённые» нейронные сети для биомедицинских приложений, реализуют полностью классические архитектуры, которые используют математические формализмы, вдохновлённые квантом, без выполнения реальной параметризованной квантовой схемы ни на симуляторе, ни на квантовомаппарате. Недавние достижения в области обнаружения болезни Паркинсона также включают гибридные архитектуры сверточных нейронных сетей-трансформаторов11, методы глубокого обучения на основе внимания для магнитно-резонансной томографии (МРТ)12 и лёгкие сверточные нейронные сети, разработанные для вычислительной эффективностидиагностики 13, иллюстрирующие быстрое расширение подходов искусственного интеллекта в различных модальностях данных. В более широком смысле, неинвазивная компьютерная диагностика успешно распространилась на другие биомедицинские приложения, включая гибридное машинное обучение и глубокое обучение для медицинскойвизуализации 14. Сравнительные оценки архитектур глубокого обучения на одном и том же публичном голосовом наборе данных дополнительно демонстрируют высокую производительность, достижимую с использованием традиционных полнофункциональных классическихмоделей 15.
Эти разработки подчёркивают специфическую методологическую необходимость воспроизводимой модели квантово-классической гибридной сверточной нейронной сети (QI-HCNN), которая (i) выполняет подлинную, полностью заданную параметризированную квантовую схему; (ii) тестируется с использованием идентичных входных признаков как с архитектурно согласованной классической нейронной сетью, так и с сильной классической базовой линией; и (iii) оценивается с помощью протокола, который явно исследует основные источники предвзятости в небольших биомедицинских наборах данных, включая классовый дисбаланс, демографическое замешательство и утечку данных на уровне пациентов во время перекрёстной валидации.
Общая цель этого протокола — обеспечить полностью воспроизводимый рабочий процесс QI-HCNN для классификации болезни Паркинсона с использованием голосовых записей человека. Протокол описывает четырёхкубитную параметризованную квантовую схему с использованием кодирования углов, два управляемых слоя запутанности на основе NOT и обучаемый вариационный слой, оптимизированный с использованием правила смещения параметров, в сочетании с неглубокой классической головкой классификации и применяемом к четырёхкомпонентному главному компонентному представлению общедоступного набора данных для записи голоса. Рабочий процесс определяет, на уровне, достаточном для независимой репликации, все процедуры предварительной обработки, полную конструкцию схемы, классическую обучающую конфигурацию и процедуры оценки, включая сравнения с классической нейронной сетью с сопоставлением размерности, базовые линии деревьев с градиентным усилением размерности и полнофункциональные характеристики, управляемые абляции компонентов схем, кросс-валидацию по группе пациентов для оценки чувствительности к оставшимся участникам и явную статистику Тестирование значимости. Вместо того чтобы показывать только благоприятные результаты, протокол разработан так, чтобы прозрачно отчитываться, когда отдельные компоненты схемы не улучшают производительность измеримого уровня, тем самым обеспечивая воспроизводимую методологическую основу, которая может повлиять на будущую разработку архитектуры QI-HCNN для задач биомедицинской классификации малых когорт.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Протокол
Этот протокол использует общедоступный, деидентифицированный, сторонний набор данных для записи голоса. Авторы не собирали новых данных о людях и испытуемых, и для этого исследования не требовалось дополнительное одобрение от институционального экспертного совета (IRB). Набор данных, описанный в подразделе «Сбор наборов данных и обработка данных на уровне участников », был изначально собран по институциональному этическому одобрению Литтл и др.3, не содержит напрямую идентифицирующей информацию об участниках (только анонимные идентификаторы записи) и является публично доступным для исследовательского использования. Подтвердите, согласно вашим институциональным политикам, требует ли вторичный анализ этого общедоступного набора данных этического пересмотра. В учреждении авторов ретроспективный вторичный анализ этого полностью деидентифицированного, публично архивированного набора данных был признан освобождённым от полного рассмотрения IRB.
Сбор наборов данных и обработка данных на уровне участников
Набор данных по классификации болезни Паркинсона (UCI Machine Learning Repository, Dataset ID 174), изначально описанный Литтлом и др. 3, был загружен. Набор данных содержал 195 записей с устоятельными гласными /a/ фонацией от 31 человека (23 диагностированы болезнью Паркинсона и 8 здоровых контрольных групп; возрастной диапазон 46–85 лет). Поскольку репозиторий не предоставляет версионный DOI, точная дата загрузки была зафиксирована и указана в Таблице материалов. Набор данных предоставлялся в виде файла с разделёнными значениями (CSV) (parkinsons.csv). Не требовалась декомпрессия или конвертация файлов, а файл импортировался напрямую с помощью функции read_csv из библиотеки Pandas (см. таблицу материалов).
Загруженный набор данных был проверен как содержащий 195 строк и 24 столбца, включающих один столбец идентификатора записи (формат: phon_R01_S  субъект
 _ запись), 22 непрерывных столбца акустических признаков (Таблица 1) и один двоичный столбец с меткой класса (статус: 1 = болезнь Паркинсона; 0 = здоровый контроль). Таблица 1 использовалась как ориентир для всех акустических признаков и категорий признаков на протяжении всего протокола.
| Категория | Репрезентативные особенности | Клиническое значение |
| Основная частота | MDVP:Fo(Hz), MDVP:Fhi(Hz), MDVP:Flo(Hz) | Средняя, максимальная и минимальная основная частота фонации; отражает стабильность вибрации голосовых связок. |
| Джиттер (частотное возмущение) | MDVP:Jitter(%), MDVP:Jitter(Abs), MDVP:RAP, MDVP:PPQ, Jitter:DDP | Колебания периода тональности от цикла к циклу, отражающие нарушенное управление гортанной моторикой. |
| Шиммер (амплитудное возмущение) | MDVP:Shimmer, MDVP:Shimmer(dB), Shhimmer:APQ3, Shhimmer:APQ5, MDVP:APQ, Shimmer:DDA | Колебания амплитуды сигнала от цикла к циклу, отражающие дыхательные или нестабильные фонации. |
| Измерения шума | NHR, HNR | Соотношение шума к гармоническим (тональным) компонентам голосового сигнала. |
| Нелинейная динамика / фрактальное масштабирование | RPDE, D2, DFA, spread1, spread2, PPE | Измерения нелинейной вокальной динамики, периодичности и долгосрочных временных корреляций, связанных с вибрацией голосовых связок. |
Таблица 1: Категории акустических признаков, используемых для классификации болезни Паркинсона. 22 акустических голосовых признака, извлечённых из набора данных по классификации болезни Паркинсона, сгруппированы в пять категорий: фундаментальная частота, джиттер, шиммер, шумовые меры и нелинейная динамика. Для каждой категории перечислены репрезентативные признаки вместе с их соответствующей клинической значимостью. MDVP, многомерная голосовая программа; RAP — относительное среднее возмущение; PPQ, коэффициент возмущения периода высоты высоты; APQ, коэффициент амплитудного возмущения; DDP — различие между периодами; DDA — средняя абсолютная разница амплитуд; NHR, соотношение шум к гармоникам; HNR — соотношение гармоник к шуму; RPDE — энтропия плотности периода рецидивирования; D2, корреляционная размерность; DFA — анализ колебаний с детрендом; СИЗ, энтропия периода высоты.
Идентификатор участника извлекался для каждой записи путём анализа подстроки перед финальной подчёркивающей в названии записи. Например, phon_R01_S01_1 и phon_R01_S01_2 были назначены участнику S01. Идентификаторы участников, а не идентификаторы записи, впоследствии использовались для всех процедур проверки с группой или исключения одного участника, описанных в подразделе Протокола оценки , поскольку записи, полученные от одного участника, акустически коррелированы. После извлечения была создана и проверена частотная таблица идентификаторов, чтобы подтвердить, что все 195 записей были присвоены ровно 31 уникальному участнику, что ни одна запись не осталась неприсвоенной, и что количество записей на одного участника совпадает с документацией исходного набора данных.
Распределение классов было зафиксировано как на уровне записи (147 записей болезни Паркинсона, 75,4%; 48 записей здорового контроля, 24,6%), так и на уровне участников (23 из 31 участника, 74,2%, диагностированы болезнью Паркинсона). Оба распределения были зафиксированы потому, что дисбаланс классов уровня записи и участников не идентичны и влияют на дальнейшую оценку.
Отсутствие групп по болезни Паркинсона и здорового контроля по возрасту или полу в исходном наборе данных было задокументировано как ограничение исследования и перенесено в обсуждение, поскольку эта характеристика отражает исходный сбор данных и не может быть исправлена с помощью предварительной обработки.
Конвейер предварительной обработки
Все процедуры предварительной обработки выполнялись независимо в каждом обучающем этапе процедуры перекрёстной валидации, описанной в подразделе «Протокол оценки ». Оба шага нормализации Min–Max и анализ главных компонентов (PCA) были оснащены только обучающим разделением каждого сгиба. Впоследствии соответствующие преобразования применялись к соответствующему удерживаемому тестовому разделу без перенастройки, чтобы предотвратить утечку информации из тестового раздела в параметры предварительной обработки.
22 сырых акустических признака в каждом обучающем разделе нормализовались с помощью скалера Min–Max с выходным диапазоном [0, π]. Затем фит-скейлер применялся как к обучающему, так и к тестовому разбиению соответствующего сгиба (Уравнение 1). Уравнение 1 следует стандартной формулировке нормализации Min–Max и было определено для настоящего протокола. Нормализация Min–Max выполнялась с использованием класса MinMaxScaler из scikit-learn (версия 1.8.0) с feature_range=(0, π), copy=True и clip=False.
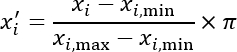 (1)
Модель PCA с n_components = 4 была оснащена только нормализованными обучающими данными. Затем адаптированное преобразование PCA применялось как к учебному, так и к тестовому разделам. Доля общей дисперсии, объясняемая четырьмя сохранившимися главными компонентами, фиксировалась для каждого складка. В анализах, представленных здесь, четыре основных компонента объясняли 81,5% общей дисперсии (50,3%, 16,3%, 9,4% и 5,5% соответственно). PCA выполнялся с использованием класса PCA с n_components=4, svd_solver=«полный», whiten=False и random_state=42.
Поскольку PCA может генерировать оценки компонентов с отрицательными значениями, был установлен второй масштабер Min–Max с диапазоном выхода [0, π] с использованием обучающего раздела, преобразованного PCA. Впоследствии установленный масштабер применялся как к учебному, так и к тестовому разделам. Любое преобразованное значение тестового раздела, выходящее за пределы интервала [0, π], обрезалось до ближайшей границы, потому что масштабер был установлен только с использованием обучающего раздела. В наборе данных не было признаков нулевой дисперсии. Диапазон каждого материала на всех 195 записях был строго положительным; следовательно, условие деления на ноль не возникало. Это было подтверждено проверкой того, что масштабированный выход не содержит ни NaN, ни бесконечные значения.
Четыре перенормированных главных компонента были последовательно назначены как углы вращения для кубитов 0, 1, 2 и 3 в ходе процедуры кодирования углов, описанной в подразделе «Конструкция квантовых схем». Первый главный компонент был назначен кубиту 0, второй — кубиту 1, третий — кубиту 2, а четвёртый — кубиту 3. Это завершило конвейер предобработки и перенесло обработанные классические признаки в квантовую схему. После второго шага масштабирования Min–Max все выходные значения подтверждались как находящиеся в интервале [0, π]. Значения тестового раздела, немного выходящие за пределы этого диапазона из-за округления с плавающей точкой, были обрезаны до ближайшей границы с помощью функции клипа из NumPy (версия 2.4.4). Эта процедура гарантировала, что все четыре входа в слой кодирования углов являются допустимыми углами вращения в интервале [0, π].
Конструкция квантовой схемы
Схема из четырёх кубитов была построена с использованием симулятора вектора состояния, указанного в Таблице материалов , и последовательности элементов, описанной ниже. Дополнительный кодировочный файл 1 использовался как полная реализация исполняемой схемы, включая все вспомогательные функции для построения вентилей и вычисления градиентов по сдвигам параметров. Рисунок 1 показывает полный рабочий процесс от предварительной обработки голосовой записи через четыре уровня цепи, классическую постобработку и итоговую классификацию.
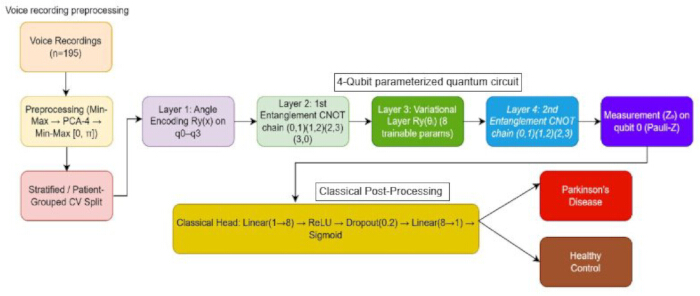
Рисунок 1. Архитектура системы и рабочий процесс квантовых схем . Рабочий процесс классификации болезни Паркинсона на основе голосовых записей человека. Диаграмма показывает предварительную обработку голосовой записи, стратифицированную или группированную по пациентам кросс-валидацию, выполнение квантовой схемы с параметрами на четыре кубита, измерение Паули-Z для кубита 0, классическую постобработку и окончательную бинарную классификацию как болезнь Паркинсона или здоровый контроль. CNOT, управляемый — НЕ гейт; PCA, анализ основных компонентов; ReLU — выпрямленная линейная единица. Пожалуйста, нажмите здесь, чтобы увидеть увеличенную версию этой фигуры.
Четырёхкубитный регистр инициализировался в вычислительном базном состоянии ∣0000.
Для слоя кодирования углов к кубиту i применялся элемент вращения Ry (xi), где i = 0,1,2,3, используя четыре угла, полученные конвейером предварительной обработки (Уравнение 2). Уравнение 2 описывает стандартную процедуру кодирования по углам, используемую в параметризованных квантовых схемах, соответствующую параметризованной структуре обучения квантовым схемам Mitarai et al.9, и применяется здесь в конкретной конфигурации из четырёх кубитов, определённой для настоящего протокола.
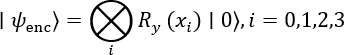 (2)
Для первого слоя запутанности была применена круглая цепочка управляемых элементов NOT в следующем порядке управляющих-целевых элементов: (0,1), (1,2), (2,3) и (3,0).
Для вариационного слоя восемь обучаемых параметров отw 0 до w 7 инициализировались независимой выборкой из нормального распределения со средним значением 0 и стандартным отклонением 0,3. Случайное семя было записано в Таблице материалов. Восемь вариационных квантовых параметров инициализировались с помощью numpy.random.default_rng(42 + fold_index).normal(0, 0.3, размер = 8), где fold_index — нулевое число fold, обеспечивающее специфические для fold, но воспроизводимые инициализации. Для каждого кубита i = 0, 1, 2 и 3 применялся элемент Rz(wi), за которым следовал элемент Ry(w i+4) (Уравнение 3). Уравнение 3 описывает вариационный (обучаемый) квантовый слой, согласованный с общей параметризованной структурой обучения квантовых схем, введённой Митараи и др.9, и была реализована здесь с использованием специфической последовательности и параметризации элементов, определённых для настоящего протокола.
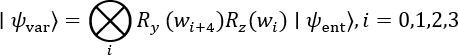 (3)
Для второго слоя запутанности была применена открытая цепочка управляемых элементов NOT в следующем порядке управляющего и целевого порядка: (0,1), (1,2) и (2,3). Эта цепь не была закрыта обратно к кубиту 0.
Математическое значение оператора Паули только для кубита 0,  , вычислялось с помощью внутреннего произведения вектора состояния. Выполнение схемы использовало пользовательский симулятор вектора состояния, реализованный с использованием стандартных числовых операций массива (Supplementary Coding File 1; qhcnn.py). Комплекс 128 precision (numpy.complex128) использовался на протяжении всего процесса. Значения ожидания вычислялись аналитически из произведения вектора состояния; поэтому выборка на основе кадров не проводилась. Сторонняя квантовая вычислительная структура не требовалась. Если бы вместо симулятора вектора состояния использовался симулятор на основе выборки или квантовое устройство, проводились бы повторные вычислительные измерения кубита 0, и полученные битовые частоты были бы преобразованы в ожидаемое значение (Уравнение 4). Уравнение 4 — это стандартная квантовомеханическая формула ожидаемого значения, которое здесь применялось к однокубитной наблюдаемой Паули-наблюдаемой, определённой для данного протокола. Поскольку отбор проб на основе выстрелов не проводился, не требовалось снижение ошибок измерения. Симулятор использовал индексирование кубитов big-endian, где кубит 0 соответствовал наибольшему значительному биту индекса statevector. Эта конвенция была явно учтена при построении наблюдаемой Паули для правильного измерения ожидаемого значения.
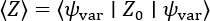 (4)
Градиент по каждому из восьми вариационных параметров вычислялся с помощью правила смещения параметров. Схема оценивалась дважды для каждого параметра при каждом градиентном вычислении: один раз при θ + π/2 и один раз при θ - π/2 (уравнение 5). Уравнение 5 — это стандартное правило смещения параметров, введённое Митараем и др.9 , и применённое здесь без изменений.
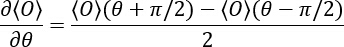 (5)
Второй слой запутанности, как указано выше, никогда не применял управляемый элемент NOT с кубитом 0 в качестве цели. Поскольку управляемый элемент НЕ оставляет редукциированное состояние управляющего кубита неизменным, второй слой запутанности не может изменяться независимо от обучаемых значений параметров. Чтобы второй слой запутанности мог влиять на измеряемый выход в модифицированном протоколе, кубит 0 должен быть включён в цель, например, замкнув цепочку дополнительным (3,0) управляемым элементом NOT, либо измерить мультикубитную наблюдаемую величину вместо одного кубита ожидания. Изначально указанный второй слой запутанности был сохранён в этом протоколе, а его измеряемый вклад был явно представлен в разделе «Результаты », а не скорректирован молча, поскольку такое поведение цепи является частью текущих данных.
Классический слой постобработки
Классическая стадия постобработки представляла собой прямую нейронную сеть, реализованную с использованием стандартных числовых операций на основе массива, перечисленных в Таблице материалов. Выход одной скалярной схемы,  , отображался на восемь скрытых блоков с использованием полностью связанного слоя, за которым следовала активация ректифицированной линейной единицы (ReLU). Во время обучения применялся слой dropout с вероятностью удержания 0,8 (процент выброса = 0,2). Восемь скрытых единиц затем отображались в один выходной блок с использованием второго полностью связанного слоя, и для генерации конечной вероятности класса применялась сигмовидная функция активации — ŷ (Уравнение 6). Уравнение 6 определяет специфическую классическую архитектуру постобработки, используемую в данном протоколе, и включает стандартные линейные, выпрямленные линейные единицы (ReLU) и сигмоидные операции.
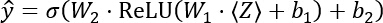 (6)
Матрицы веса первого и второго слоёв инициализировались независимой выборкой из нормального распределения со средним значением 0 и стандартным отклонением 0,5, тогда как все смещённые члены инициализировались как 0. Тот же экземпляр генератора случайных чисел и семя, используемые для инициализации квантовых вариационных параметров, также использовались для классического слоя для обеспечения воспроизводимости от run-to-run. В частности, классические матрицы веса инициализировались с помощью numpy.random.default_rng(42 + fold_index).normal(0, 0.5, size=...), тогда как все смещённые члены инициализировались с нулем. Один экземпляр генератора случайных чисел, инициализированный с 42 + fold_index, создавался в начале каждого кросс-валидационного склода и использовался последовательно для инициализации квантовых параметров, классической инициализации по весу, мини-пакетного тасовки и генерации дропаут-маски, вместо использования отдельных независимых потоков для каждого процесса.
Во время обучения дроп-аут применялся путём генерации новой выборки двойной маски при каждом прохождении с использованием конвенции инвертированного дропаута, при которой выжившие единицы масштабировались на 1/0,8. Во время валидации и тестирования dropout был полностью отключен, и для вывода использовалась полная, масштабируемая сеть.
Объединённая модель QI-HCNN содержала 33 обучаемых параметра: восемь квантовых вариационных параметров из квантовой схемы и 25 классических параметров. Классическая компонента состояла из восьми весов и восьми смещений в первом полностью связном слое, а также восьми весов и одного смещения во втором полностью связном слое. Размеры тензора веса и смещения были 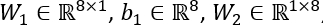 и
 . Классический уровень постобработки был полностью реализован с использованием стандартных числовых операций с массивами без дополнительного фреймворка машинного обучения. Все классические вычисления выполнялись с использованием арифметики float64 (двойной точности).
Обучение моделям
Квантовая схема, описанная в подразделе «Конструкция квантовых схем», и классический слой постобработки, описанный в подразделе «Классический слой постобработки», были объединены в единую сквозную обучаемую модель. Все 33 обучаемых параметра были оптимизированы совместно с помощью оптимизатора Адама с начальной скоростью обучения 0,01 и затуханием веса, реализованным как L2-штраф , применяемым только к классическим матрицам весов. Оптимизатор Адама был реализован вручную с использованием стандартных числовых операций массива со следующими настройками: скорость обучения = 0,01, β1 = 0,9,β 2 = 0,999, ∈ = 1 × 10⁻⁸ и затухание веса = 1 × 10⁻⁴, применялись только к классическим матрицам весов, а не к смещениям или квантовым вариационным параметрам.
В качестве функции потерь использовалась бинарная кросс-энтропия. Для процедуры балансировки классов после разделения, описанной в подразделе Протокола оценки, вклад каждого обучающего образца в потери взвешен обратной частотой его класса в обучающей разбиении текущего свордка. Для несбалансированного протокола присваивались равномерные веса выборки. Бинарная кросс-энтропия рассчитывалась как средняя потеря по всем образцам в каждой мини-партии с использованием стандартной бинарной кросс-энтропии.
Модель тренировалась для 30 эпох с использованием мини-партий по 16 образцов. Обучающие выборки случайным образом перемешивались в начале каждой эпохи с использованием numpy.random.default_rng(42 + fold_index).permutation(n) для получения случайного порядка выборки. Когда количество обучающих образцов не делилось равномерно на 16, последняя меньшая мини-партия сохранялась и обрабатывалась в реальном размере, а не выбрасывалась.
Во время обучения применялся расписание с частотой обучения. Скорость обучения умножалась на 0,7 после каждых 10 завершённых эпох, особенно в начале 11 и 21 эпох.
Градиенты для восьми квантовых вариационных параметров вычислялись с использованием правила смещения параметров, описанного в подразделе «Конструкция квантовых схем». Градиенты для 25 классических параметров вычислялись с помощью стандартной обратно-модовой дифференцировки только через классический слой. Выход квантовой схемы , и его градиенты смещения параметров служили интерфейсом между квантовой схемой и классическим слоем. Все 33 параметра были обновлены с помощью одного и того же экземпляра оптимизатора Адама.
Раннее остановка на основе валидации не использовалась. Каждая модель обучалась для фиксированного графика из 30 эпох, а результаты тестового раздела отражались после завершения финальной эпохи. Все параметры модели (квантовые вариационные параметры, классические матрицы весов и смещенные члены) переинициализировались независимо в начале каждого кросс-валидационного фолда с использованием специфичного для fold случайного семена (42 + fold_index). Параметры не были общими между сгибами или базовыми пробежками.
Вычислительная среда, включая процессор, память, версии программного обеспечения и приблизительное время обучения по настенным часам на склад, была зафиксирована в Таблице материалов.
Протокол оценки
Производительность модели оценивалась с использованием процедур перекрестной валидации на уровне записи и участников, а также с использованием базовых сравнений моделей, анализа балансировки классов, экспериментов по абляции цепей, статистического тестирования значимости и анализа важности признаков.
Для первичной оценки 195 голосовых записей были разделены на три стратифицированных сверчки с использованием фиксированного случайного семя, при этом при этом соотношение болезни Паркинсона к здоровому контролю на уровне записи составляет 75,4%/24,6% в каждом складке. Модель, описанная в предыдущих разделах, была обучена с использованием двух сгибов и оценивалась на оставшейся выдерживаемой сгибке, и эта процедура повторялась до тех пор, пока каждая складка не служила тестовым разбиением. Точность, точность, отзыв, F1-балл и площадь под кривой рабочей характеристики приёмника (AUC–ROC) рассчитывались для каждого склона и отражались как среднее ± стандартное отклонение по трём сгибам. Первичная трёхкратная стратифицированная кросс-валидация была реализована с использованием класса StratifiedKFold с n_splits=3, shuffle=True и random_state=42.
Прогнозы бинарных классов были получены путём применения фиксированного порога вероятности 0,50 к предсказанной вероятности класса ŷ, созданной классическим слоем постобработки. Точность, точность, запоминание и F1-балл рассчитывались на основе этих пороговых прогнозов, тогда как AUC–ROC рассчитывался напрямую из непрерывных значений вероятности без порогового значения. Точность, воспоминание и F1-балл вычислялись с помощью метрических функций с zero_division=0, присваивая значение 0,0 любой неопределённой метрике. Во время описанных экспериментов такого неопределённого состояния не наблюдалось.
Базовые модели оценивались с использованием идентичных разбиений fold и идентичного предобработанного четырёхкомпонентного представления признаков, созданных конвейером предварительной обработки. Классический многослойный перцептрон, содержащий один скрытый слой из восьми единиц, активированных ReLU, архитектурно соответствующий классическому компоненту гибридной модели, но без квантовой схемы, тренировался с помощью оптимизатора Адама с штрафом L2 1 × 10⁻⁴. Классификатор дерева с градиентным усилением также обучался с использованием того же четырёхкомпонентного представления с 200 деревьями, максимальной глубиной дерева 3, скоростью обучения 0,1 и взвешенностью классов, равным обратной частоте классов в каждом обучающем складке. Кроме того, второй классификатор дерева с усилением градиента был обучен с использованием полного представления из 22 признаков, сгенерируемых после начальной нормализации Min–Max, без применения PCA или квантового кодирования признаков. Эта модель использовала 300 деревьев, максимальную глубину дерева 4, скорость обучения 0,05 и ту же обратную стратегию взвешивания классов с обратным размножением. Классическая многослойная перцептроновая база была реализована с помощью MLPClassifier с hidden_layer_sizes=(8,), активацией="relu", solver="adam", alpha=1 × 10⁻4, batch_size="auto", learning_rate_init=0,001, max_iter=500, early_stopping=False, shuffle=True, и random_state=42. Использовалась стандартная инициализация с равномерным весом Glorot (Xavier), предоставляемая реализацией. Базовые линии дерева с градиентным усилением были реализованы с помощью XGBoost 3.3.0 с целью = "бинарный:логистичный", eval_metric = "логлосс", tree_method = "авто", подвыборка = 1,0, colsample_bytree = 1,0, reg_alpha = 0, reg_lambda = 1 и random_state = 42.
Для оценки эффекта балансировки классов после разделения первичная процедура перекрёстной валидации была повторена для модели QI-HCNN с включенным взвешиванием выборки. Балансирующие веса рассчитывались исключительно на основе обучающего разбиения каждого сгибателя после разделения тренировки/теста и не вычислялись из соответствующего тестового разбиения.
Эксперименты по абляции компонентов схемы проводились путём четырёхкратного повторения полного процесса предварительной обработки, обучения и оценки, при этом изменяя только два слоя запутанности квантовой цепи. Четыре варианта схем включали: (i) полную цепь, содержащую оба слоя запутанности; (ii) цепь с первым слоем запутанности и сохранением второго; (iii) цепь с первым слоем запутанности сохраненным и удаленным вторым; и (iv) цепи с удаленными обоими слоями запутанности. Одинаковые разбиения складок, случайные семена и обучающие конфигурации сохранялись во всех четырёх экспериментах, чтобы любые наблюдаемые различия в производительности можно было отнести исключительно к конфигурации слоя запутанности.
В качестве оценки надёжности кросс-валидация по группам участников проводилась путём разделения 31 участника вместо 195 записей на пять групп по шесть-семь участников каждая. Во время каждой итерации модель обучалась на записях участников из четырёх групп и оценивалась по записям участников оставшейся группы, чтобы гарантировать, что ни один участник не внес записи как в обучающую, так и в тестовую часть одной и той же сворочки. Точность, точность, воспоминание, F1-балл и AUC–ROC были представлены как среднее ± стандартное отклонение по пяти группированным участникам для модели QI-HCNN, классического многослойного перцептрона и четырёхпризначной базовой линии с градиентным усилением. Кросс-валидация с группированием участников была реализована с использованием класса GroupKFold с n_splits=5, где идентификаторы участников выступали в роли группирующей переменной. Поскольку GroupKFold не тасует группы, участники назначались согласно детерминированному порядку реализации, в результате чего складки содержат по шесть или семь участников каждая.
Статистическая значимость оценивалась путём применения парных тестов Уилкоксона с знаковым рангом к пократным значениям AUC–ROC, полученным для первичной оценки и базовой моделей. Точные p-значения и соответствующее количество парных наблюдений были представлены, поскольку статистическая мощность этого теста ограничена, когда доступно лишь небольшое количество складок. Было определено четыре парных сравнения AUC–ROC: (1) QI-HCNN против классического многослойного перцептрона; (2) QI-HCNN против PCA-согласованной древесной базы с градиентным усилением; (3) классический многослойный перцептрон по сравнению с PCA-согласованной градиентно-усиленной древесной базовой линией; и (4) несбалансированная модель QI-HCNN против модели QI-HCNN после сплит-сбалансированной QI-HCNN. Коррекция с множественными сравнениями не применялась, поскольку анализы были исследовательскими, а ограниченное количество складок существенно снижало статистическую мощность.
Анализ важности признаков проводился с использованием градиентно-усиленного деревьевого классификатора, обученного на полном представлении из 22 признаков. Были извлечены и ранжированы оценки по важности функций по усилению для всех оригинальных акустических элементов. Отдельно PCA был включён в полный набор данных только для целей отчетности и не использовался при оценке модели. Для каждого оригинального акустического элемента суммировались абсолютные нагрузки между четырьмя сохранившимися основными компонентами, и характеристики ранжировались по этим значениям. Были зафиксированы оба метода ранжирования и их пересечения. Для анализа важности признаков на основе усиления реализация дерева с градиентным усилением давала уникальные значения усиления с плавающей точкой, и равенства не возникало. Для рейтингов загрузки по главным компонентам равенства в суммарных абсолютных значениях нагрузки разрешались согласно исходному порядку признаков и столбцов в наборе данных.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Результаты
Все числовые значения, указанные в тексте, сверяются и идентичны тем, что представлены на рисунках 2–8 и таблицах 2–4. Каждая цифра генерировалась непосредственно из кода, предоставленного в Дополнительном файле кодирования 1 , а не готовилась вручную, обеспечивая согласованность между числовыми значениями и отображаемыми данными.
Первичная кросс-валидация
В рамках несбалансированного прото...
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Обсуждение
Этот протокол определяет полностью воспроизводимую архитектуру QI-HCNN для классификации болезни Паркинсона из голосовых записей, в которой каждый элемент, выбор инициализации параметров, шаг предварительной обработки и процедура оценки описываются на уровне, достаточном для независимой реализации. Предлагаемая схема тестируется с использованием идентичных входных признаков и идентичных кросс-валидационных фолд-разбиений с архитектурно согласованным классическим многослойным перцептроном...
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Раскрытие информации
Конфликт интересов:
Авторы заявляют, что у них нет конкурирующих финансовых или нефинансовых интересов, связанных с этой работой.
Благодарности
Эта работа не финансировалась ни одним агентством или организацией, ни технически, ни финансово. Авторы выражают благодарность сопровождающим Репозитория машинного обучения UCI за предоставление публичного доступа к набору данных для голосовой записи, использованном в этом исследовании.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Материалы
| Имя | Компания | Каталожный номер | Комментарии |
|---|---|---|---|
| Adam optimizer | Стандартная реализация числового оптимизационного алгоритма | Пользовательская реализация; NumPy 2.4.4 | Совместная оптимизация квантовых и классических параметров; Обучение модели |
| Реализация функции потерь бинарной кресс-энтропии | Пользовательская реализация с использованием NumPy | NumPy 2.4.4; функция потерь средняя (среднее значение) по каждому мини-батчу | Функция потерь при обучении; Обучение модели |
| Градиентно-бустированный деревьевый классификатор | Библиотека градиентного бустинга с открытым исходным кодом XGBoost | XGBoost 3.3.0; objective="binary:logistic"; eval_metric="logloss"; tree_method="auto"; random_state=42 | Классический этаплон, совпадающий с PCA, и полные функции; Протокол оценки |
| Библиотека машинного обучения | Библиотека машинного обучения с открытым исходным кодом scikit-learn | scikit-learn 1.8.0 | Масштабирование MinMax, главный анализ компонент, стратифицированное перекрестное исследование, перекрестное исследование с группированием участников, базовая модель многослойного перцептрона и метрики оценки |
| Библиотека для численных вычислений | Библиотека для численных вычислений с открытым исходным кодом NumPy | NumPy 2.4.4 | Основные операции с массивами, симуляция состояний, инициализация параметров и ручное вычисление градиента |
| Датасет для классификации болезни Паркинсона | Little, McSharry, Roberts, Costello и Moroz; распространяется через репозиторий машинного обучения UCI | ID датасета UCI 174; 195 записей от 31 участника; доступ 19 июня 2025 | Источник датасета записи голоса с долгим гласным; https://archive.ics.uci.edu/dataset/174 |
| Библиотека для научных вычислений | Библиотека для научных вычислений с открытым исходным кодом SciPy | SciPy 1.17.1 | Статистическое тестирование значимости по ранговому знаково-ранговому критерию Уилкоксона; Протокол оценки |
| Симулятор состояний | Пользовательский симулятор состояний (Дополнительный код в файле qhcnn.py) | Чистая реализация на основе NumPy; точность complex128 (двойная); внешний бекенд не требуется | Выполнение квантового четырехкубитного контура; Построение квантового контура |
| Библиотека для работы с табличными данными | Библиотека для анализа данных с открытым исходным кодом Pandas | Pandas 3.0.2 | Загрузка датасета, инспекция и манипуляции с таблицами |
| Вычислительная среда на рабочей станции | Локальная рабочая станция с CPU (контейнер Linux в облаке) | x86_64 CPU; Ubuntu Linux; Python 3; GPU или квантовое оборудование не используется; приблизительное время обучения, замеренное часами, составляет 30–60 секунд на каждый раздел | Вычислительная среда, используемая для всех процессов обучения и оценки; Симуляция состояний на CPU; GPU или квантовое оборудование не требуется |
Ссылки
- Rabie H, Akhloufi MA. A review of machine learning and deep learning for Parkinson's disease detection. Discov Artif Intell. 2025;5:24.
- Devi SVA, et al. Hybrid deep learning methods for enhancing Parkinson's disease early detection [conference presentation]. Presented at: 4th International Conference on Smart Applications, Data and Living (ICSADL); 2025; Bhimdatta, Nepal. IEEE. p. 1462-1469. Available from: https://doi.org/10.1109/ICSADL65848.2025.10933259.
- Little MA, et al. Exploiting nonlinear recurrence and fractal scaling properties for voice disorder detection. Biomed Eng Online. 2007;6:23.
- Costantini G, et al. Artificial intelligence-based voice assessment of patients with Parkinson's disease off and on treatment. Sensors (Basel). 2023;23(4):2293.
- Gunduz H. Deep learning-based Parkinson's disease classification using vocal feature sets. IEEE Access. 2019;7:115540-115551.
- Naeem I, et al. Voice biomarkers as prognostic indicators for Parkinson's disease using machine learning techniques. Sci Rep. 2025;15:12129.
- Ebrahimzadeh E, et al. Explainable machine learning for early detection of Parkinson's disease in aging populations using vocal biomarkers. Front Aging Neurosci. 2025;17:1672971.
- Alishah S. An explainable ensemble and deep learning framework for accurate and interpretable Parkinson's disease detection from voice biomarkers. Diagnostics (Basel). 2025;15(22):2892.
- Mitarai K, Negoro M, Kitagawa M, Fujii K. Quantum circuit learning. Phys Rev A. 2018;98(3):032309.
- Alissa M, et al. Parkinson's disease diagnosis using convolutional neural networks and figure-copying tasks. Neural Comput Appl. 2022;34(2):1433-1453.
- Kumari GRP, Ravi Kanth M, Kamal MV. Parkinson's disease early detection using hybrid attentive CNN-transformer model. Neural Comput Appl. 2025;37(32):26523-26543.
- Palakayala R, Kuppusamy P. AttentionLUNet: a hybrid model for Parkinson's disease detection using MRI brain. IEEE Access. 2024;12:91752-91769.
- Wang X, et al. A light-weight CNN model for efficient Parkinson's disease diagnostics [conference presentation]. Presented at: IEEE International Symposium on Computer-Based Medical Systems (CBMS); 2023; L'Aquila, Italy. IEEE. p. 616-621. Available from: https://doi.org/10.1109/CBMS58004.2023.00289.
- Haq I, et al. Lung nodules localization and report analysis from computerized tomography (CT) scan using a novel machine learning approach. Appl Sci. 2022;12(24):12614.
- Alzaidi A, et al. Comparative study of deep learning models for Parkinson's disease detection using the UCI vocal dataset. TBench. 2025;5(2):10021
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.