В данной работе исследуется алгоритм оптимизации динамического планирования, объединяющий Transformer и обучение с подкреплением PPO, с акцентом на частые конфликты ресурсов и задержки отклика при планировании деятельности профсоюзов.
Для просмотра этого контента требуется подписка на JoVE. Войдите или начните свой бесплатный пробный период.
Исследовательская статья
Алгоритм динамического планирования и оптимизации ресурсов для деятельности профсоюзов путем интеграции трансформера и обучения с подкреплением
В этой статье
Краткое содержание
Аннотация
Для решения проблемы снижения организационной эффективности, вызванной частыми конфликтами при распределении ресурсов и задержками в планировании при управлении деятельностью профсоюзов, в данной работе предлагается алгоритм динамического планирования, объединяющий Transformer и PPO (Proximal Policy Optimization). В рамках конкретной реализации сначала разрабатывается унифицированная структура моделирования сценария планирования для преобразования состояний мероприятий, персонала и ресурсов в тензорные входные данные, что позволяет обеспечить интеграцию многомерных ограничений. Затем механизм многоголового внимания Transformer используется для кодирования временных рядов исторических запросов на проведение мероприятий и статусов ресурсов, извлечения многомерных пространственно-временных признаков и усиления восприятия рисков возникновения конфликтов. Впоследствии, на основе результатов кодирования и стратегической сети PPO, генерируются действия по планированию из текущего состояния для повышения адаптивности стратегии к сложным условиям. Наконец, за счет обновления путем прунинга и механизма коррекции функции преимущества гарантируются стабильность стратегии в процессе итераций и улучшение показателей планирования. Эксперименты показали, что при плотности задач 1000 среднее время принятия решения алгоритмом планирования составляет 0,72 s, а средняя задержка отклика — 1,59 s, что свидетельствует о высокой скорости отклика и эффективности принятия решений. Для семи типов мероприятий и уровней сложности коэффициент конфликтов ресурсов составляет 0,05–0,12; средний коэффициент использования ресурсов — 0,75–0,86; а индекс стабильности планирования — 0,8–0,91, что эффективно снижает частоту конфликтов при распределении ресурсов и обеспечивает высокую стабильность планирования. В условиях высокой конкурентности индекс баланса ресурсов и индекс робастности переноса стратегии составляют 0,88 и 0,85 соответственно, что указывает на хорошую адаптивность к нагрузкам при параллельном выполнении задач.
Введение
Деятельность профсоюзов связана с комплексным планированием множества задач и ресурсов, что требует от системы эффективных возможностей динамического реагирования1,2. Требования к мероприятиям часто меняются, а распределение персонала и площадок носит сложный характер, что может легко привести к конфликтам в расписании и нерациональному использованию ресурсов3,4. Точная фиксация истории мероприятий и статуса ресурсов в режиме реального времени, а также повышение способности выявлять потенциальные конфликты и реагировать на них, являются ключевыми факторами повышения операционной эффективности организации5,6. Интеграция передовых технологий моделирования временных рядов и алгоритмов обучения с подкреплением позволяет достичь глубокого понимания и интеллектуальной оптимизации в сложных условиях планирования, что помогает максимизировать использование ресурсов, ускорить реагирование при составлении графиков и способствовать интеллектуальной модернизации управления деятельностью профсоюзов.
Однако существующие на практике подходы к планированию в значительной степени основаны на статических правилах и не способны адаптироваться к частым изменениям задач и колебаниям ресурсов, что часто приводит к увеличению времени отклика и серьезным конфликтам ресурсов. При планировании деятельности профсоюзов типы задач крайне разнообразны; использование ресурсов строго ограничено и часто меняется, а зависимости между мероприятиями и конкуренция за ресурсы формируют сложную карту планирования7,8. На практике график мероприятий не может быть эффективно согласован с доступными временными окнами таких ресурсов, как персонал и помещения9,10, что часто приводит к конфликтам, снижающим общую согласованность организационных операций11,12. Перед системой планирования стоит не одна цель оптимизации, а задача достижения баланса между многомерными показателями, такими как минимизация конфликтов ресурсов, максимизация скорости отклика, стабильность стратегии планирования и уровень выполнения задач13,14, что характеризует типичную многокритериальную оптимизацию. Кроме того, деятельность профсоюзов имеет выраженные фазы и циклы, поэтому стратегии планирования должны динамически адаптироваться к изменяющейся структуре спроса на ресурсы на разных этапах выполнения задач. Статические планы, созданные один раз, не могут поддерживать среду исполнения с высокой частотой изменений15,16. В существующей логике планирования отсутствует глубокое изучение поведения задач в прошлом и закономерностей изменения состояния ресурсов. Она не способна обеспечить точное прогнозирование и вывод стратегий на будущее17,18. Стратегия планирования системы медленно реагирует на внезапно возникающие задачи и временные изменения в ресурсах, что влияет на общую устойчивость функционирования19,20. Создание системы планирования, обладающей прогностической способностью, гибкостью и стабильностью, стало ключевым техническим требованием в практических приложениях. Это требует от модели высокого уровня восприятия многомерной информации, памяти последовательностей и способностей к миграции стратегий, а также поддержания устойчивого принятия решений и ресурсного баланса в многозадачной среде, что позволит обеспечить интеллектуальную оптимальную координацию планирования деятельности профсоюзов.
В многочисленных исследованиях предлагались различные решения проблемы динамического планирования. Среди них сочетание глубокого обучения и обучения с подкреплением продемонстрировало высокую адаптивность и возможности оптимизации. Некоторые ученые используют LSTM (долгую краткосрочную память)21,22 для моделирования данных временных рядов в сочетании со стратегиями обучения с подкреплением для оптимизации поведения при планировании, чего удалось достичь с определенными результатами. Другой тип исследований основан на эвристическом методе с использованием жадного алгоритма, где основной акцент делается на простоте и эффективности принятия решений по планированию, что подходит для сценариев с четко определенными правилами23,24. В других работах изучалось применение глубокой Q-сети (DQN) для планирования, что позволило улучшить стратегии за счет аппроксимации функции ценности25,26. Однако данные методы имеют такие недостатки, как недостаточное выявление долгосрочных зависимостей, нестабильное обновление стратегий и значительные задержки отклика при работе в сложных и меняющихся сценариях совместной деятельности, что затрудняет удовлетворение потребностей планирования при высокой плотности и разнообразии задач. Таким образом, создание алгоритма планирования с эффективным извлечением признаков и стабильным обновлением стратегий стало «узким местом», которое необходимо преодолеть в современных исследованиях.
В исследованиях многодоменного планирования архитектура Transformer применялась для различных задач прогнозирования временных рядов и оптимизации планирования благодаря механизму многоголового самовнимания, который эффективно улавливает долгосрочные временные зависимости27,28. При сочетании с алгоритмом PPO в обучении с подкреплением стратегия обновляется стабильно и эффективно за счет обрезки целевой функции; этот подход продемонстрировал хорошие результаты в таких областях, как управление роботами и интеллектуальное производство29,30,31. В некоторых исследованиях предпринимались попытки интегрировать Transformer с обучением с подкреплением для сложного планирования ресурсов32. Однако при динамическом планировании деятельности профсоюзов мало исследований затрагивают сочетание различных типов деятельности и сложных ресурсных ограничений. В ряде работ использовались графовые нейронные сети для моделирования взаимосвязи между ресурсами и задачами, что позволило повысить точность идентификации конфликтов33,34. Некоторые ученые оптимизировали планирование ресурсов на основе граничных вычислений для повышения эффективности и производительности модели35,36. Тем не менее, такие методы все еще обладают ограниченными возможностями моделирования временного контекста. На основании этого в данной работе предлагается использовать Transformer для кодирования последовательностей исторической деятельности и состояний ресурсов в сочетании с политической сетью PPO, чтобы обеспечить высокую чувствительность к рискам конфликтов и стабильное обновление стратегий планирования для удовлетворения меняющихся и сложных потребностей в планировании деятельности профсоюзов.
В более современных исследованиях оптимизация планирования ресурсов рассматривалась с различных ракурсов, таких как консолидация VM для повышения энергоэффективности в облачных вычислениях37, алгоритмы аутентификации в сотовых сетях38, улучшенная консолидация VM с живой миграцией для устойчивых облачных вычислений39, оптимизация трафика с использованием прогнозирования времени ожидания и эволюционных алгоритмов40, а также облачные хранилища на базе блокчейна с улучшенной оптимизацией и сохранением целостности данных41. Хотя эти работы содержат ценные сведения об алгоритмах распределения и оптимизации ресурсов, они в первую очередь ориентированы на облачную инфраструктуру, телекоммуникации или системы хранения данных и не учитывают специфику ограничений по видам деятельности, динамические конфликты ресурсов между персоналом и площадками, а также требования к планированию в режиме реального времени, характерные для управления деятельностью профсоюзов. Данное различие дополнительно подчеркивает необходимость создания специализированного механизма планирования, адаптированного к организационному контексту деятельности профсоюзов.
Существующие методы планирования деятельности профсоюзов часто не позволяют учитывать долгосрочные пространственно-временные зависимости и поддерживать стабильность стратегии в условиях динамических изменений, что приводит к медленному времени отклика и возникновению многочисленных конфликтов за ресурсы. Чтобы восполнить эти пробелы в исследованиях, в данной работе предлагается модель оптимизации планирования, основанная на принципе, согласно которому многоголовое внимание Transformer может эффективно кодировать исторические последовательности для прогнозирования конфликтов, а оптимизация проксимальной политики (PPO) с ограниченной целевой функцией обеспечивает стабильное и адаптивное обновление стратегии. В частности, Transformer применяется для кодирования последовательностей состояний мероприятий и ресурсов, извлекая ключевые пространственно-временные признаки для улучшения прогнозирования конфликтов, а PPO используется для эффективной генерации действий по планированию и стабильных обновлений. Разработана единая матрица ограничений для сопоставления мероприятий, персонала и помещений, что улучшает распознавание сложных зависимостей. Основные инновации данной работы включают: (1) интеграцию временного кодирования и обучения с подкреплением специально для планирования деятельности профсоюзов; (2) механизм внимания с учетом конфликтов, который приоритизирует восприятие рисков; и (3) обновление с прунингом и коррекцией функции преимущества для обеспечения устойчивости стратегии при высокой степени параллелизма. Обширные эксперименты при различной плотности и сложности задач подтверждают превосходство данной модели над существующими методами по скорости отклика, использованию ресурсов и стабильности, что представляет собой практичное и масштабируемое интеллектуальное решение для управления деятельностью профсоюзов.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Протокол
Рисунок 1 демонстрирует структуру системы планирования совместной деятельности, которая объединяет моделирование временных рядов и обучение с подкреплением. Входной слой интегрирует графики мероприятий, доступность ресурсов и информацию о временных окнах персонала, а затем с помощью модуля графа ограничений формирует многомерную матрицу конфликтов между задачами и ресурсами. Трансформер выполняет кодирование с многоголовым вниманием (multi-head attention) по исторической последовательности состояний действий и ресурсов, создавая скрытые состояния с временными зависимостями. Модуль стратегии использует результаты кодирования для генерации распределений действий и оценки состояния, после чего принимает решения по планированию путем сэмплирования действий. Результаты выполнения передаются обратно в среду, что обновляет статус ресурсов и генерирует мгновенные награды. На этой основе модуль оптимизации выстраивает целевую функцию отсечения (clipping objective function), оценивает функцию преимущества и корректирует оценку сети ценности, чтобы ограничить дрейф стратегии и обеспечить стабильное обновление алгоритмов планирования. Между модулями формируется замкнутый цикл данных для обеспечения высокой чувствительности к конфликтам ресурсов и адаптивного обновления стратегий в динамических средах, что повышает способность к интеллектуальному реагированию и эффективность распределения ресурсов системы планирования совместной деятельности в многозадачных и жестко ограниченных сценариях.
Моделирование сценариев планирования деятельности объединения
Все запросы на осуществление деятельности в системе планирования организованы в виде дискретных последовательностей планирования на основе временных шагов. Каждое мероприятие определяется четким временем начала и окончания, категориями ресурсов, этапами и уровнями приоритета. Статус использования площадки моделируется как двумерная матрица временных слотов, где горизонтальная ось представляет стандартизированную единицу времени, а вертикальная ось — номер пространственного ресурса. Статус ресурса отмечается как «доступен» или «занят», что формирует карту начального распределения ресурсов со статической структурой. Информация о графике работы персонала расширяется в измерении «время-личность» для построения непрерывного вектора временных окон, в каждом из которых фиксируется статус персонала (выполнение задачи или простой) и номер отдела. Вся входная информация интегрируется в трехмерную тензорную структуру, где обозначает дискретный временной шаг, обозначает количество ресурсных единиц, а обозначает соответствующий код атрибута использования ресурса (например, занятость, номер мероприятия, приоритет использования и т. д.). Такая структура позволяет системе планирования считывать конфигурацию ресурсов в любой момент времени, обеспечивая унифицированное представление различных типов статусов ресурсов.
После привязки информации о задаче к модели устанавливается вектор интенсивности задачи на основе приоритета активности и периода использования ресурсов. Комбинации задач, которые могут вызвать конфликт, отмечаются с помощью метода обнаружения перекрытия временных окон. Конфликтные комбинации преобразуются в наборы узлов, а наборы ребер строятся на основе общих типов ресурсов и периодов для явного представления неявных зависимостей. Итоговый построенный граф задач содержит граничную информацию о временной последовательности, перекрытии ресурсов или конфликте ограничений, обеспечивая структурную основу для последующего обнаружения конфликтов и формирования стратегии планирования. Эта структура сохраняет динамическую природу планирования задач и непрерывные изменения статуса ресурсов, а также поддерживает восприятие изменений в ограничениях планирования в режиме реального времени.
Для обнаружения конфликтов в качестве исходных условий для анализа используются разреженные перекрывающиеся области временного и ресурсного измерений в тензорной структуре. Для пар задач с перекрывающимися целями планирования применяется статическое кодирование отношений. Построение графовой структуры G=(V,E,C), где V представляет собой множество активных узлов, E — ребра, созданные на основе ресурсных конфликтов, а C — матрицу кодирования весов конфликтов для ребер. Функция веса конфликта определяется в следующем виде:
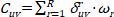 (1)
Среди них Cuv — вес конфликта между операциями u и v; u, v — индексы операций; R — общее количество типов ресурсов; δuvr ∈ {0,1} указывает, перекрываются ли временные окна операций u и v на ресурсе r; ωr — вес чувствительности к конфликтам для ресурса r. Данная функция вычисляет взвешенную сумму интенсивностей конфликтов, учитывая различия в значимости ресурсных конфликтов для результатов планирования, при этом сохраняя количественное выражение распределения силы конфликтов.
Приведенная выше структура графа конфликтов преобразуется в матрицу граничных ограничений с помощью представления в виде разреженной матрицы. Каждый элемент матрицы содержит степень конфликта ресурсов. Матрица встроена в процесс принятия решений по планированию для определения возможности параллельного выполнения задач, в то время как логика экранирования действий (action-shielding) реализована в сети стратегий. Для борьбы с периодической агрегацией активности и высокоплотными всплесками задач внедрен механизм динамического обновления, который отслеживает изменения статуса задач и модифицирует содержимое матрицы в режиме реального времени по мере освобождения или добавления ресурсов, обеспечивая непрерывность и согласованность границ планирования на протяжении всего процесса эволюции задач.
Применение данной структуры графа конфликтов позволяет системе планирования визуально моделировать потенциальные «узкие места» ресурсов и паттерны перекрытия задач, что повышает эффективность декуплирующего анализа сложных сценариев ограничений в сети принятия решений. Поведение планировщика больше не опирается на логическое сопоставление на основе правил. Вместо этого система ищет оптимальный путь в пространстве ограничений, что расширяет возможности динамического балансирования локальных ресурсных конфликтов с глобальной картой задач. Система способна поддерживать стабильность планирования и когерентность задач в условиях колебания ресурсов, а также частого добавления или удаления задач.
Рисунок 2 представляет собой схему структуры сети, основанную на весовых отношениях конфликтов задач. Каждый узел на рисунке представляет задачу, подлежащую планированию, а линии между узлами указывают на конфликты в использовании ресурсов. Толщина ребра отражает вес конфликта: чем серьезнее конфликт, тем толще линия. Расчет веса объединяет перекрытие ресурсов и учитывает чувствительность различных ресурсов к конфликтам для формирования совокупной интенсивности конфликта между задачами. Структура графа показывает, что некоторые задачи образуют области с плотными связями, что указывает на значительную конкуренцию за использование ресурсов. Подобный феномен локальной агрегации конфликтов является основным источником узких мест в ресурсах и задержек задач в процессе планирования, что позволяет алгоритму планирования соответственно определять цели приоритизации. Для расположения узлов используется стратегия силового алгоритма (force-directed layout) для автоматической агрегации задач с высоким уровнем конфликта, что позволяет системе планирования идентифицировать ключевые группы задач и оптимизировать распределение стратегий, тем самым повышая общую согласованность планирования и координацию ресурсов.
Кодирование последовательности исторических состояний
На основании построенного графа конфликтов и матрицы ограничений следующим шагом является кодирование исторических последовательностей действий и состояний ресурсов, чтобы временные паттерны, лежащие в основе этих ограничений, могли быть извлечены для последующего принятия решений. Основная информация в сценарии планирования состоит из запросов на выполнение действий, изменений статуса ресурсов и записей об обратной связи по задачам. Эта информация представляет собой несколько гетерогенных временных рядов, соответствующих таким атрибутам, как временные точки событий, идентификаторы использования ресурсов и статус выполнения действий. Для унификации структуры обработки каждый тип входных данных кодируется в виде последовательности векторов равной длины и устанавливается единый временной индекс для обеспечения выравнивания состояний при временной синхронизации. Входной блок в каждый момент времени представляется в виде конкатенации трех наборов векторов признаков: вектор признаков действия определяет тип задачи, приоритет и номер этапа; вектор признаков ресурсов фиксирует текущую занятость ресурсов, оставшуюся мощность и положение доступного окна; вектор признаков обратной связи описывает, было ли выполнение задачи в предыдущий момент времени успешным, а также произошли ли события конфликта ресурсов или задержки.
Все признаки подвергаются линейному преобразованию и отображаются в одно и то же размерное пространство для получения стандартизированной матрицы эмбеддингов X ∈ ℝT×d, где T — количество временных шагов, а d — единая размерность эмбеддинга. Для сохранения временной структуры входная матрица поэлементно складывается с матрицей позиционного кодирования P для формирования входных данных с учетом позиционной информации:
Z = X + P (2)
Z представляет собой итоговую входную последовательность, которая служит входными данными для последующего механизма внимания. В архитектуре позиционного кодирования используется фиксированный шаблон синусоидальной и косинусоидальной функций, чтобы предотвратить утечку информации из будущего и обеспечить строгое соблюдение причинно-следственных ограничений в процессе кодирования. Описанная выше структура позволяет модели одновременно воспринимать характеристики задачи, состояние ресурсов и временную позицию. Она формирует полноценную основу памяти состояний, предоставляя высокоразрешенную унифицированную структуру для последующего механизма внимания.
Модуль внимания обрабатывает входную последовательность для выявления потенциальных взаимосвязей между несколькими временными шагами. Для раздельной обработки последовательности используются несколько групп голов внимания, что повышает чувствительность модели к различным типам путей эволюции состояний. Каждая голова внимания формирует на основе входной последовательности матрицу запросов Q, матрицу ключей K и матрицу значений V, вычисляет матрицу распределения весов и генерирует взвешенное представление. Выход одноголового внимания определяется следующим образом:
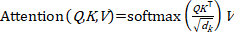 (3)
дк — это количество размерностей признаков на одну головку. В данной формуле QK⊤ представляет собой сходство между моментами, √дк используется для численной стабильности, а функция softmax обеспечивает нормализацию весов. Различные головки внимания фокусируются на разных комбинациях временных шагов, и фиксируемые ими динамические зависимости также разнообразны, что помогает выявить скрытые закономерности, такие как предвестники конфликтов задач, паттерны потребления ресурсов и аномальные тенденции обратной связи.
Все выходы голов внимания объединяются и пропускаются через слой линейного преобразования для создания единой кодирующей последовательности, которая служит входным состоянием для сети генерации стратегии планирования. Эта последовательность кодирует траекторию поведения задач, характеристики изменения ресурсов и влияние предыдущих отклонений при выполнении в текущем окне планирования, что эффективно решает проблему высокой исторической зависимости в поведении планирования и разреженного выражения признаков. В выходной слой кодирования включены модули остаточных связей и нормализации слоя для повышения стабильности обучения и возможностей сохранения экспрессии глубокой сети.
Выходная последовательность скрытых состояний не только сохраняет информацию о временной эволюции, но и реагирует на изменения, вызванные внезапными задачами или временным несоответствием ресурсов, демонстрируя высокую адаптивность. Такая структурная схема позволяет избежать явного определения правил, обеспечивает структурированное моделирование динамических сред планирования и помогает последующим модулям принятия решений генерировать варианты расписания с глобальной согласованностью и локальной адаптивностью в многокритериальных условиях.
Генерация стратегии динамического планирования
Закодированные последовательности скрытых состояний, которые объединяют как временные зависимости, так и информацию о конфликтах ресурсов, затем подаются в сеть стратегий для генерации действий по планированию, адаптирующихся к текущей среде. Последовательность скрытых состояний, выводимая модулем кодирования, используется в качестве входных данных для сети стратегии планирования. Набор векторов состояний в каждый момент времени составляет выражение наблюдения за текущей средой, охватывающее эволюцию характеристик задач, тенденции использования ресурсов и траектории исторической обратной связи. Размерность представления состояния и длина временного окна фиксированы, а непрерывность изменений состояния фиксируется с помощью механизма скользящего обновления. Перед отправкой вектора состояния в сеть стратегий он нормализуется и подвергается реорганизации признаков, чтобы входные данные сохраняли стабильное численное распределение в многомерном пространстве, тем самым снижая риск взрыва градиента и колебания сходимости.
Структура сети стратегии использует двухветвевой выходной модуль, где одна ветвь генерирует распределение действий, а другая выводит оценку функции ценности состояния. Пространство действий включает в себя все планируемые задачи и распределяемые ресурсы. Механизм отбора кандидатов отфильтровывает недопустимые или избыточные комбинации операций для формирования ограниченного набора допустимых действий. Ветвь стратегии выводит распределение вероятностей π(at|st), где at представляет действие по планированию на данном шаге по времени, а st — текущее входное состояние. Для выбора действий из распределения в целях фактического планирования используется стандартная стратегия гауссового или softmax-сэмплирования. Другим выходом является оценка функции ценности состояния, которая представляет собой ожидаемое долгосрочное вознаграждение в данном состоянии и используется для оценки и обновления стратегии.
В сети политик скрытый слой применяет функции активации и пакетную нормализацию для повышения нелинейной выразительности и ускорения сходимости сети. В процессе принятия решений приоритет выполнения, стоимость планирования ресурсов и историческая производительность различных задач рассматриваются как факторы внимания и применяются к механизму выбора действий через специальную весовую матрицу для формирования адаптивно регулируемой структуры вывода политики. Такая архитектура позволяет избежать зависимости от фиксированных правил, тем самым повышая гибкость стратегии при возникновении внезапных конфликтов и структурных «узких мест».
Стратегия планирования использует механизм случайной выборки для генерации фактической последовательности действий. В каждом цикле планирования из текущего распределения действий выбирается исполняемое действие, после чего обновляются статус ресурсов и метка узла задачи. После выполнения действия система рассчитывает мгновенное вознаграждение обратной связи на основе изменений ресурсов и результатов выполнения задачи, чтобы оценить влияние данного раунда планирования на общую цель. Дизайн вознаграждения учитывает несколько измерений, включая скорость завершения задач, эффективность использования ресурсов и степень подавления конфликтов. С помощью комплексных показателей обеспечивается обратная связь с модулем обновления стратегии.
Весь процесс планирования представляет собой построение цепи марковских решений и использует метод эмпирического сэмплирования траекторий для записи последовательности состояние-действие-награда, обозначаемой как (st, at, rt, st+1). Оптимизация стратегии основана на построении функции преимущества, где оценка преимущества определяется в следующем виде:
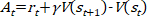 (4)
At представляет собой значение преимущества, rt — текущее мгновенное вознаграждение, γ — коэффициент дисконтирования вознаграждения, а V(st) и V(st+1) — значения функции состояния в текущем и следующем состояниях соответственно. Функция преимущества отражает степень превосходства текущего действия по сравнению со средним показателем эффективности стратегии. Она используется для последующего улучшения стратегии. Если At > 0, это означает, что текущее действие лучше среднего ожидаемого результата, и вероятность его выбора должна быть увеличена; в противном случае тенденция к его выбору должна быть снижена.
В процессе обновления стратегии, чтобы избежать осцилляций, вызванных избыточной амплитудой обновлений, применяется механизм усечения целевого распределения для ограничения диапазона изменений между новой и старой стратегиями, что обеспечивает непрерывность и стабильность выходных данных сети. Между распределением действий и обратной связью по вознаграждению устанавливается тесная связь, позволяющая стратегии мгновенно реагировать на изменения в сложных ограничениях. Данный механизм поддерживает стабильность принятия решений и рациональное распределение ресурсов в ситуациях с частой сменой задач или внезапным несоответствием ресурсов, эффективно предотвращая такие проблемы, как дублирующее распределение, перегрузка ресурсов или заторы в очереди задач. Система планирования способна поддерживать оптимальное рабочее состояние при различной плотности задач и дефиците ресурсов, демонстрируя высокую адаптивность.
Итерация стратегии и механизм стабильного обновления
Для того чтобы созданные стратегии планирования оставались стабильными и их эффективность не снижалась в ходе многократных раундов обучения, в данном подразделе представлен механизм итеративного обновления с применением клиппирования и коррекции преимущества. Устанавливается интервал обновления усечения между старой и новой стратегиями, а функция цели клиппирования используется для ограничения дрейфа стратегии с целью предотвращения шока планирования в процессе обновления стратегии. Сеть оценки корректируется в сочетании с функцией преимущества для повышения точности долгосрочного планирования.
Распределение вероятностей выходных действий сети стратегии склонно к резким колебаниям в ходе итераций непрерывного планирования, что может привести к нестабильному поведению или нарушению распределения ресурсов. Чтобы смягчить эффект «планировочного шока», вызванного дрейфом стратегии, разработан усеченный интервал обновления для контроля диапазона изменений между новой и старой стратегиями, а также введен ограничивающий член для уточнения целевой функции. Вероятность исторической стратегии фиксируется в раунде выборки, после чего на основе текущей вероятности стратегии формируется коэффициент отношения. Целевая функция обновления стратегии определяется следующим образом:
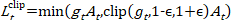 (5)
Здесь gt = πθ(at|st)/πθold(at|st) обозначает отношение вероятностей между новой и старой стратегиями; ε — порог отсечения, ограничивающий диапазон обновления стратегии. Если отношение превышает этот порог, вместо него используется значение отсечения, чтобы предотвратить возникновение избыточных градиентов из-за экстремальных выборок, обеспечивая тем самым корректировку параметров сети в пределах заданного диапазона. Такая структура динамически ограничивает диапазон изменений выходной стратегии для каждого раунда планирования, поддерживая плавность и согласованность выходных данных стратегии при плотном распределении задач и значительно снижая уровень осцилляции поведения планировщика.
Целевая функция стратегии дополняется членами регуляризации и вознаграждения за энтропию в процессе обновления для повышения разнообразия распределения действий и предотвращения преждевременной сходимости. Каждый раунд обновлений стратегии использует несколько пакетов выборок траекторий опыта для циклического обучения, что позволяет поддерживать широту охвата пространства состояний. При сравнении распределения вероятностей выходной последовательности действий до и после обновления рассчитывается степень отклонения распределения, а жесткий порог отсекает недопустимый диапазон возмущений стратегии. Этот механизм обеспечивает граничный контроль при переносе стратегий планирования между циклами, подавляя тем самым переобучение, вызванное резкими изменениями состояния ресурсов.
Обновление стратегии опирается на оценку состояния, предоставляемую функцией ценности. Отклонения в оценке ценности состояния могут напрямую влиять на правильность функции преимущества, тем самым изменяя направление итерации стратегии. Для повышения точности оценки разработан механизм обратного распространения по нескольким временным рядам, при котором для корректировки текущей ценности состояния используется дисконтированная кумулятивная ценность будущих вознаграждений. Для вознаграждения при обратном распространении используется структура обобщенного оценивания преимущества (Generalized Advantage Estimation, GAE), которая определяется следующим образом:
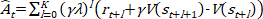 (6)
Ât — скорректированное значение преимущества; λ — коэффициент баланса обратного распространения; rt+l представляет собой мгновенное вознаграждение на (t+l-м) шаге; V(st+l) — значение состояния, выводимое оценочной сетью. Данная структура объединяет краткосрочную мгновенную обратную связь и долгосрочные ожидания состояния для коррекции отклонений в предсказаниях отклика стратегии при будущих конфликтах ресурсов, пиковых нагрузках и накоплении задач. λ регулирует глубину обратного распространения и автоматически настраивается в периоды резких колебаний динамики ресурсов для повышения устойчивости отклика оценочной сети к внезапным событиям.
Многомасштабная зависящая от времени структура, встроенная в функцию преимущества, позволяет оценочной сети моделировать долгосрочные тенденции ресурсов. Для обнаружения отклонения выходных данных стратегии используется индекс согласованности поведения стратегии, который позволяет оценить, не проявляет ли сеть чрезмерную реакцию на ошибку оценки. Остаточные члены разности обратной связи контролируют поведение обновления стратегии, при этом целевой показатель обучения и амплитуда обновления весов функции ценности динамически корректируются. Сеть ценности и сеть стратегии оптимизируются совместно, чтобы оценка ценности не отклонялась от цели завершения задачи, предотвращая при этом ошибочное определение статуса ресурсного конфликта при высокочастотном планировании.
Данный механизм стабильного обновления политики позволяет эффективно поддерживать управляемость и согласованность обновлений поведения политики в высокоразмерной динамической среде задач, повышая эффективность охвата задач и гибкость использования ресурсов, а также формируя непрерывно итерируемую структуру интеллектуального планирования. Поведение планирования предотвращает попадание в локальный оптимум при долгосрочной эволюции и повышает общую адаптивность к изменениям паттернов задач и колебаниям циклов ресурсов.
Рисунок 3A демонстрирует тенденцию изменения значения целевой функции в зависимости от количества итераций обучения при различных условиях порога отсечения. Горизонтальная ось представляет количество итераций обучения, а вертикальная — числовое значение ограниченной целевой функции. ε установлено на уровнях 0.1, 0.2 и 0.3, что соответствует различным степеням интенсивности контроля дрейфа стратегии. Кривая, соответствующая меньшему значению ε, характеризуется меньшими колебаниями, и целевая функция остается стабильной. При ε = 0.1 общее значение целевой функции находится в диапазоне от 0.8 до 1, что свидетельствует о постепенности и стабильности обновления стратегии. Однако большее значение ε приводит к выраженным колебаниям. При ε = 0.3 общее значение целевой функции находится в пределах от 0.65 до 0.95, а кривая целевой функции демонстрирует большую амплитуду осцилляции, что отражает риск серьезного отклонения в процессе обновления стратегии. Чем меньше порог, тем стабильнее стратегия, что подходит для сред планирования с жесткими ограничениями. Рисунок 3B показывает изменения обобщенной оценки преимущества (generalized advantage estimate) при различных коэффициентах балансировки обратного хода. λ установлено на значения 0.8, 0.9 и 1.0 соответственно для управления глубиной обратного хода будущих вознаграждений. Кривая показывает, что чем выше λ, тем меньше колебания GAE, тем более плавным является долгосрочный тренд и тем точнее фиксируется потенциальное влияние поведения планирования через несколько шагов. Кривая при λ = 0.8 демонстрирует выраженные периодические колебания, что указывает на ее большую чувствительность к мгновенным вознаграждениям и лучшую пригодность для краткосрочных внезапных задач. Напротив, λ = 1.0 больше ориентировано на моделирование долгосрочных тенденций и подходит для сценариев с периодическими задачами.
Анализ вычислительной сложности и масштабируемости
Вычислительная сложность предлагаемой архитектуры Transformer-PPO определяется двумя основными компонентами: энкодером Transformer и оптимизацией стратегии PPO.
Для энкодера Transformer с L слоями, H голов вниманием, размерностью эмбеддинга d и длиной входной последовательности T (историческим временным окном) временная сложность одного прямого прохода составляет O(L·T2·d + L·T·d2), где член T2 обусловлен механизмом самовнимания. В данной реализации L = 3, H = 4, d = 128, а T зафиксировано на уровне 100 временных шагов, что обеспечивает приемлемые вычислительные затраты. При увеличении исторических окон квадратичный член T2 становится доминирующим фактором; однако на практике планирование деятельности профсоюзов обычно предполагает ограниченные исторические горизонты (например, скользящие окна за один квартал или один год), а разрешение временного шага может быть скорректировано для баланса между точностью и эффективностью.
Для компонента PPO сеть стратегий и сеть ценности представляют собой облегченные многослойные перцептроны MLP (256 и 128 нейронов в скрытом слое), сложность вывода которых составляет O(d·m), где m — количество скрытых блоков, что ничтожно мало по сравнению с энкодером Transformer. Обновление стратегии в процессе обучения включает несколько эпох градиентных обновлений мини-батчей со сложностью O(B·E·d2), где B — размер батча, а E — количество эпох обновления.
С точки зрения масштабируемости, данная архитектура обладает тремя преимущественными свойствами. Во-первых, механизм внимания может быть распараллелен по временным шагам, что обеспечивает эффективное ускорение с помощью GPU. Во-вторых, размер модели не зависит от количества действий или ресурсов, поскольку матрица ограничений конструируется динамически для каждого шага планирования, а не встроена в виде фиксированных параметров. Это позволяет развертывать одну и ту же обученную модель в объединениях разного масштаба без необходимости повторного обучения. В-третьих, для сценариев с чрезвычайно большим масштабом можно сократить длину окна истории T и размерность эмбеддинга d в качестве компромисса, либо использовать вариант с разреженным вниманием для снижения сложности с O(T2) до O(T log T) или O(T).
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Результаты
Экспериментальные данные
Для всесторонней оценки эффективности представленного в данной работе алгоритма динамического планирования Transformer-PPO в качестве эталонного набора данных используются данные по управлению мероприятиями крупного профсоюза предприятия за последние три года. Этот набор данных содержит более 5 000 записей о мероприятиях различных типов, включая собрания, тренинги и развлекательные мероприятия, с информацией о планировании нескольких ресурсов, таких как помещения, оборудовани...
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Обсуждение
Экспериментальные результаты демонстрируют, что предложенный алгоритм Transformer-PPO стабильно превосходит базовые методы (LSTM-PPO, жадный поиск и DQN) по всем показателям оценки. Столь высокая эффективность может быть обусловлена двумя ключевыми факторами. Во-первых, механизм многоголового самовнимания (multi-head self-attention) архитектуры Transformer эффективно улавливает долгосрочные временные зависимости в последовательностях действий и состояний ресурсов, что позволяет проактивно выявлять потенциальные конфликты...
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Раскрытие информации
Авторы заявляют об отсутствии финансовых конфликтов интересов.
Благодарности
Нет данных
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Материалы
| Имя | Компания | Каталожный номер | Комментарии |
|---|---|---|---|
| Python 3.9 | Python Software Foundation | https://www.python.org/downloads/release/python-390/ | Основной язык программирования |
| PyTorch 1.12 | Meta AI | https://pytorch.org/get-started/previous-versions/ | Фреймворк глубокого обучения (реализация Transformer/PPO) |
| NumPy 1.23 | NumPy Developers | https://numpy.org/doc/stable/release/1.23.0-notes.html | Библиотека для численных вычислений |
| Matplotlib 3.5 | Matplotlib Development Team | https://matplotlib.org/stable/users/installing.html | Визуализация результатов |
| Набор данных о планировании деятельности профсоюза | Внутренняя база данных сотрудничающего предприятия (анонимизированная) | Недоступно публично в связи с соглашением о конфиденциальности; исследователи могут обратиться к автору для получения доступа | Более 5 000 записей о мероприятиях (собрания, обучение, досуг) профсоюза крупного предприятия за три года |
| NVIDIA A100 GPU | |||
| PyTorch |
Ссылки
- Bosire RK, Muya J, Matula D. Employee recognition programs and employee output as moderated by workers’ union activities: evidence from Kenyatta National Hospital (KNH), Kenya. Saudi J Bus Manag Stud. 2021;6(3):61-70.
- Carneiro B, Costa HA. Digital unionism as a renewal strategy? Social media use by trade union confederations. J Ind Relat. 2022;64(1):26-51.
- Geelan T. Introduction to the special issue: the internet, social media and trade union revitalization—still behind the digital curve or catching up? New Technol Work Employ. 2021;36(2):123-39.
- Hennebert MA, Pasquier V, Lévesque C. What do unions do…with digital technologies? An affordance approach. New Technol Work Employ. 2021;36(2):177-200.
- Panagiotopoulos P. Digital audiences of union organising: a social media analysis. New Technol Work Employ. 2021;36(2):201-18.
- Wang W, Seifert R. Trade-union-engendered employee trust in senior management: a case study of digitalisation. Ind Relat J. 2024;55(6):472-91.
- Katsabian T. Collective action in the digital reality: the case of platform-based workers. Mod Law Rev. 2021;84(5):1005-40.
- Holgate J. Trade unions in the community: building broad spaces of solidarity. Econ Ind Democr. 2021;42(2):226-47.
- Ovi RP, Rana MS, Jodder PK, Sarkar B. Performance evaluation of e-service delivery of union digital centers at the local level using composite indexing method: a study of Batiaghata upazilla in Khulna district. Inf Dev. 2024;40(4):620-34.
- Crossan J, et al. Colours of democracy: trade union banners and the contested articulations of democratic spatial practices. Trans Inst Br Geogr. 2023;48(1):23-38.
- Victor C, Kavishe AM. The challenges faced by trade unions in improving employee welfare and strategies to address them: a case of the Tanzania Union of Government and Health Employees (TUGHE) at the National Health Insurance Fund (NHIF). Afr J Empir Res. 2025;6(1):189-200.
- Rogalewski A. Trade unions challenges in organising Polish workers: a comparative case study of British and Swiss trade union strategies. Eur J Ind Relat. 2022;28(4):385-404.
- Pacetti V, Rossi P, Romens AI. Remotizzare, o non remotizzare: questo è il dilemma. Imprese e sindacati di fronte alla remotizzazione ibrida del lavoro. Stato Merc. 2023;43(3):421-49.
- Hunt T, Connolly H. COVID-19 and the work of trade unions: adaptation, transition and renewal. Ind Relat J. 2023;54(2):150-66.
- Joyce S, Stuart M, Forde C. Theorising labour unrest and trade unionism in the platform economy. New Technol Work Employ. 2023;38(1):21-40.
- Dupuis M. Algorithmic management and control at work in a manufacturing sector: workplace regime, union power and shopfloor conflict over digitalisation. New Technol Work Employ. 2025;40(1):81-101.
- Suryadevara S. Real-time task scheduling optimization in WirelessHART networks: challenges and solutions. Int J Adv Eng Technol Innov. 2022;1(3):29-55.
- Roşu D, Cojanu F, Ştefănică V, et al. Experimental management of work collectives through social and socialization activities. J Phys Educ Sport. 2022;22(7):1742-47.
- Ahmed AAA, et al. Multi-project scheduling and material planning using Lagrangian relaxation algorithm. Ind Eng Manag Syst. 2021;20(4):580-87.
- Gao H, et al. TBDB: token bucket-based dynamic batching for resource scheduling supporting neural network inference in intelligent consumer electronics. IEEE Trans Consum Electron. 2024;70(1):1134-44.
- Ouhame S, Hadi Y, Ullah A. An efficient forecasting approach for resource utilization in cloud data centers using a CNN-LSTM model. Neural Comput Appl. 2021;33(16):10043-55.
- Valarmathi K, Kanaga Suba Raja S. Resource utilization prediction technique in the cloud using a knowledge-based ensemble random forest with an LSTM model. Concurr Eng. 2021;29(4):396-404.
- Yang Y, Shen H. Deep reinforcement learning enhanced greedy optimization for online scheduling of batched tasks in cloud HPC systems. IEEE Trans Parallel Distrib Syst. 2022;33(11):3003-14.
- Tang B, Luo J, Obaidat MS, Vijayakumar P. Container-based task scheduling in a cloud-edge collaborative environment using a priority-aware greedy strategy. Cluster Comput. 2023;26(6):3689-705.
- Zhang Y, Zou YH, Zhang XD. Manufacturing resource scheduling based on a deep Q-network. Wuhan Univ J Nat Sci. 2022;27(6):531-38.
- Mangalampalli S, et al. DRLBTSA: deep reinforcement learning-based task-scheduling algorithm in cloud computing. Multimed Tools Appl. 2024;83(3):8359-87.
- Wang Y, Wang Q, Chu X. Energy-efficient online scheduling of transformer inference services on GPU servers. IEEE Trans Green Commun Netw. 2022;6(3):1649-59.
- Liu L, et al. Dynamic sparse attention for scalable transformer acceleration. IEEE Trans Comput. 2022;71(12):3165-78.
- He X, et al. Channel assignment and power allocation for throughput improvement with PPO in B5G heterogeneous edge networks. Digit Commun Netw. 2024;10(1):109-16.
- Liu H, et al. A new multi-domain cooperative resource scheduling method using proximal policy optimization. Neural Comput Appl. 2024;36(9):4931-45.
- Jin J, Xu Y. Optimal policy characterization enhanced proximal policy optimization for multitask scheduling in cloud computing. IEEE Internet Things J. 2022;9(9):6418-33.
- Chavva M, Veera S. Dynamic cost-aware language models: a real-time framework for optimizing cloud resource recommendations. Int J Mach Learn Sustain Dev. 2023;5(2):1-15.
- Zhao Z, et al. Link scheduling using graph neural networks. IEEE Trans Wirel Commun. 2023;22(6):3997-4012.
- Zhang Z, et al. A resource optimization scheduling model and algorithm for heterogeneous computing clusters based on GNN and RL. J Supercomput. 2024;80(16):24138-72.
- Chai F, et al. Joint multi-task offloading and resource allocation for mobile edge computing systems in satellite IoT. IEEE Trans Veh Technol. 2023;72(6):7783-95.
- Luo Q, et al. Resource scheduling in edge computing: a survey. IEEE Commun Surv Tutor. 2021;23(4):2131-65.
- Gupta A, Namasudra S, Kumar P. An enhanced strategy for energy-efficient cloud computing environment through VM consolidation. In: Dagur A, Singh K, Mehra PS, Shukla DK, editors. Intelligent Computing and Communication Techniques. Boca Raton (FL): CRC Press; 2025. p. 330–34. https://doi.org/10.1201/9781003530176-46
- Sombo B, Apeh ST, Edeoghon IA. Review on authentication algorithms in cellular communication networks. Cloud Comput Data Sci. 2025;6(1):54-66.
- Gupta A, Kumar P, Namasudra S. Sustainable cloud computing: an enhanced energy-efficient VM consolidation approach using live migration. Iran J Comput Sci. 2026;9:27. doi:10.1007/s42044-025-00385-y.
- García F, et al. Traffic optimization through waiting prediction and evolutive algorithms. Int J Interact Multimed Artif Intell. 2025;9(3):96-103.
- Sharma P, Namasudra S, Lorenz P. Blockchain-based cloud storage system with enhanced optimization and integrity preservation. Presented at: IEEE International Conference on Communications (ICC); Rome, Italy; 2023. p. 3744-49.
- Ding F, et al. Transformer-enhanced DQN approach for energy- and cost-efficient large-scale dynamic workflow scheduling in a heterogeneous environment. IEEE Internet Things J. 2024;11(22):37351-67.
- Yu H, Tang N, Zhu Z, Guo Z. Flexible job-shop scheduling via gated recurrent unit and deep reinforcement learning. Knowl Based Syst. 2025;330:114734. doi:10.1016/j.knosys.2025.114734.
- Do KH, et al. Graph Neural PPO for joint user association and resource allocation in Open RAN [conference paper]. Presented at: 40th International Conference on Information Networking (ICOIN); Hanoi, Vietnam; 2026. p. 37-42.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.