В данном исследовании изучаются биомаркеры электроэнцефалографии для дифференциации болезни Альцгеймера, лобно-височной деменции и здорового контроля. Модели случайного леса (Random Forest), использующие среднеквадратичное значение, спектральную плотность мощности и признаки энтропии, были интерпретированы с помощью объяснимого искусственного интеллекта и анализа величины эффекта. Удаление малозначимых признаков энтропии позволило повысить эффективность классификации, обеспечив точность тестирования 94%.
Исследовательская статья
Слияние многодоменных биомаркеров электроэнцефалографии для классификации деменции на основе машинного обучения
В этой статье
Краткое содержание
Аннотация
Электроэнцефалография (ЭЭГ) изучается как неинвазивный подход для характеристики активности мозга при нейродегенеративных состояниях. В данном исследовании оценивалось, могут ли многодоменные биомаркеры ЭЭГ дифференцировать болезнь Альцгеймера (БА), лобно-височную деменцию (ЛВД) и здоровый контроль (ЗК). Общедоступный набор данных содержал записи ЭЭГ в состоянии покоя с закрытыми глазами от 88 участников, включая 36 человек с БА, 23 с ЛВД и 29 человек из группы здорового контроля. Для классификации методами машинного обучения были извлечены многодоменные биомаркеры ЭЭГ и демографические признаки. Признаки, полученные на основе ЭЭГ, включали среднеквадратичное значение (RMS), спектральную плотность мощности (PSD) и показатели энтропии. Классификатор Random Forest был обучен с использованием комбинированного набора признаков и интерпретирован с помощью объяснимого искусственного интеллекта. Для оценки вклада признаков были проведены анализ стабильности признаков и анализ величины эффекта d Коэна, после чего последовал абляционный анализ. Признаки на основе энтропии продемонстрировали наименьший вклад в классификацию. Полная многодоменная модель достигла точности 96% при обучении и 92% при тестировании. После удаления признаков энтропии точность тестирования увеличилась до 94%. Эти результаты описывают эффективность классификации выбранных многодоменных признаков ЭЭГ и демографических данных в рамках модели Random Forest.
Введение
Болезнь Альцгеймера (БА) представляет собой прогрессирующее неврологическое заболевание, сопровождающееся ухудшением когнитивных и двигательных функций. Распространенность этого заболевания существенно возрастает с возрастом, и деменция является основной причиной заболеваемости и смертности среди пожилых людей1,2,3,4,5. Поскольку диагностика и классификация заболевания остаются сложными задачами, анализ сигналов мозга исследуется как способ характеристики нейрофизиологических изменений, связанных с деменцией.
Электроэнцефалография (ЭЭГ) представляет собой неинвазивный метод регистрации электрической активности мозга и изучалась при болезни Альцгеймера и других неврологических расстройствах6,7,8,9,10,11. Сигналы ЭЭГ отражают электрические потенциалы, генерируемые нейронной активностью, и регистрируются неинвазивно в нескольких точках на поверхности скальпа12,13,14. Активность мозга обычно характеризуют с помощью дельта-, тета-, альфа-, бета- и гамма-диапазонов частот15. Болезнь Альцгеймера связывают с замедлением ЭЭГ, снижением сложности сигнала и нарушением синхронизации16. Спектральный анализ показал повышение дельта- и тета-активности наряду со снижением альфа- и бета-активности у лиц с БА по сравнению со здоровым контролем17,18,19. В предыдущих исследованиях по классификации ЭЭГ сообщалось о высокой эффективности дифференциации БА от здорового контроля (ЗК) и лобно-височной деменции (ЛВД) от ЗК. Напротив, дифференциация между БА и ЛВД в целом оказывалась более сложной задачей10,11.
Методы машинного обучения применялись для выявления паттернов в сигналах ЭЭГ, связанных с неврологическими заболеваниями20,21. Таким образом, извлечение признаков является важным компонентом классификации на основе ЭЭГ. В предыдущих исследованиях изучались спектральные, временные признаки, признаки сложности и функциональной связности в сочетании с моделями машинного обучения3,15,22,23. Спектральные признаки особенно значимы, поскольку они количественно определяют частотно-зависимые изменения активности мозга, включая снижение альфа-активности и повышение тета-активности, отмечаемые при болезни Альцгеймера23,24,25,26.
В нескольких исследованиях на основе ЭЭГ оценивались различные комбинации признаков, классификаторов и стратегий валидации. Анализ связности использовался для дифференциации БА, МПД и ЗК, при этом сообщаемая эффективность классификации варьировалась в зависимости от проводимого сравнения и процедуры отбора признаков27. Также оценивались признаки на основе преобразования Фурье для различения БА, умеренных когнитивных нарушений (УКН) и здорового контроля, хотя ограничениями стали недостаточная предобработка и возможный переобучающий эффект, связанный со стратегией валидации28. Меры нелинейной сложности ЭЭГ продемонстрировали дискриминационный потенциал для классификации БА, при этом некоторые из них достигли высокой точности, чувствительности и специфичности, хотя их применимость к УКН и дифференциации стадий заболевания остается ограниченной21.
Методы глубокого обучения, основанные на частотно-временных представлениях ЭЭГ, также исследовались для многоклассовой классификации болезни Альцгеймера (БА), умеренных когнитивных нарушений (УКН) и здорового контроля (ЗК)29. Несмотря на сообщения о высокой точности классификации, к ограничениям относятся малые или отобранные когорты, дисбаланс классов, неоднородность степени тяжести заболевания, отсутствие внешней валидации и низкая интерпретируемость моделей29. Стратегия валидации также является важным методологическим аспектом. Подходы, независимые от конкретного участника, показали, что традиционная перекрестная проверка на уровне эпох может привести к завышению показателей точности, если эпохи одного и того же участника оказываются как в обучающей, так и в тестовой выборках30. Это ограничение особенно актуально при сравнении результатов классификации в исследованиях, использующих разные схемы валидации.
Меры сложности и связности также оценивались с использованием классификаторов на базе метода опорных векторов, при этом фазовая связность и многомасштабная энтропия продемонстрировали разный уровень дискриминационной способности31,32. В других работах, использующих признаки, полученные с помощью преобразований Фурье и вейвлет-преобразований, сообщалось о вариативности эффективности при сравнении БА, УКН и группы здорового контроля, при этом многоклассовая классификация в целом оставалась более сложной задачей, чем бинарная классификация14. Подходы, основанные на энтропии и синхронности, дополнительно продемонстрировали возможность разграничения групп с БА и контрольных групп, хотя характеристики контрольной популяции могут влиять на наблюдаемый размер эффекта2.
В данном исследовании оценивается многодоменный набор признаков, включающий среднеквадратичное значение (RMS), спектральную плотность мощности (PSD) и показатели энтропии, извлеченные из частотных диапазонов ЭЭГ, а также возраст как демографическую переменную. RMS характеризует амплитуду сигнала в каждом частотном диапазоне, тогда как PSD представляет мощность в частотной области. Энтропия включена в качестве меры сложности сигнала. Эти признаки обеспечивают взаимодополняющее описание активности ЭЭГ и оцениваются с помощью классификатора Random Forest. Кроме того, в исследовании анализируются важность признаков, стабильность признаков, объяснимый искусственный интеллект и размер эффекта для оценки относительного вклада извлеченных признаков. В данной работе исследуется эффективность многодоменных признаков ЭЭГ, включая спектральные, временные показатели и меры сложности, при различении болезни Альцгеймера (AD), лобно-височной деменции (FTD) и здорового контроля (HC) с использованием машинного обучения. Также изучается, какие признаки частотных диапазонов ЭЭГ вносят наибольший вклад в классификацию при использовании показателей спектральной плотности мощности (PSD), среднеквадратичного значения (RMS) и энтропии. Кроме того, в исследовании сравнивается вклад признаков, основанных на мощности (включая PSD и RMS), с вкладом признаков на основе энтропии, и оценивается роль возраста в модели классификации.
Протокол
Схематический обзор процесса предобработки ЭЭГ, извлечения признаков и классификации представлен на Рисунке 1. Материалы и программное обеспечение, использованные в исследовании, перечислены в Таблице материалов.
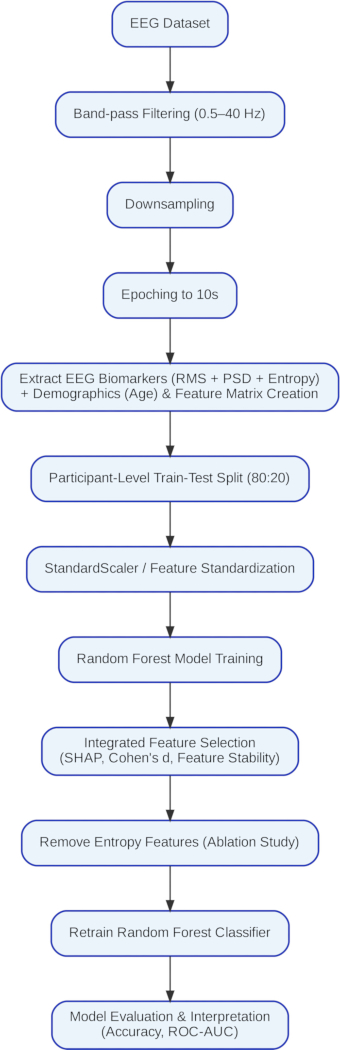
Рисунок 1: Рабочий процесс конвейера предварительной обработки ЭЭГ, извлечения признаков и классификации. Схематический обзор рабочего процесса исследования, включая верификацию данных ЭЭГ, полосовую фильтрацию и переопределение референта, извлечение признаков среднеквадратичного значения (RMS), спектральной плотности мощности (PSD) и энтропии, добавление возраста, разделение на обучающую и тестовую выборки, разработку модели Random Forest, анализ стабильности признаков, SHAP-анализ, анализ величины эффекта d Коэна, комплексный выбор признаков, абляцию признаков энтропии, переобучение модели и оценку эффективности. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
1. Сбор данных
Общедоступный набор данных ЭЭГ в состоянии покоя был получен из репозитория OpenNeuro (набор данных ds004504, версия 1.0.9)33. Метки участников и демографическая информация были проверены. Набор данных включал 88 участников, в том числе 36 человек с болезнью Альцгеймера (AD), 23 с фронтотемпоральной деменцией (FTD) и 29 здоровых добровольцев (HC).
2. Импорт записей ЭЭГ
Для каждого участника запись ЭЭГ загружалась с помощью библиотеки MNE-Python. Каждый файл ЭЭГ проверялся на доступность, возможность успешного импорта и наличие корректного идентификатора участника. Записи с отсутствующими или поврежденными файлами исключались. На данном этапе сохранялась исходная частота дискретизации ЭЭГ 500 Hz. Сигналы подвергались даунсэмплингу для снижения вычислительной нагрузки при сохранении всей клинически значимой информации ЭЭГ для данного исследования.
3. Полосовая фильтрация
Непрерывные записи ЭЭГ фильтровали с помощью полосового фильтра четвертого порядка с нижней граничной частотой 0.5 Hz и верхней граничной частотой 40 Hz.
4. Общее усреднение по опорному электроду и эпоширование
К отфильтрованным записям ЭЭГ было применено общее усреднение по опорному электроду (CAR). Для каждого временного отсчета вычислялось среднее значение сигнала по всем доступным каналам ЭЭГ, которое затем вычиталось из каждого канала. Полученные реферированные сигналы ЭЭГ были сохранены для последующего анализа. Каждая реферированная запись ЭЭГ была разделена на эпохи фиксированной длины с помощью функции make_fixed_length_epochs() в MNE-Python. Использовалась длительность эпохи 10 s без перекрытия (0 s).
5. Валидация эпох
Для каждого участника были сохранены только полные эпохи продолжительностью 10 s. Любые оставшиеся сегменты ЭЭГ короче 10 s в конце записи были отсечены. Каждая сохраненная эпоха впоследствии использовалась как отдельный образец для извлечения признаков.
6. Подготовка признаков
Несмотря на наличие данных краткой шкалы оценки психического статуса (MMSE) в исходном наборе данных, они были исключены из настоящего анализа. Извлеченные признаки ЭЭГ были объединены с демографической информацией участников, включая возраст и диагностические метки, полученные из файла метаданных participants.csv. В качестве общего ключа использовался идентификатор участника; были сохранены только те участники, для которых имелись как записи признаков ЭЭГ, так и соответствующая демографическая информация.
Многодоменная матрица признаков включала пять признаков среднеквадратичного значения (RMS) (delta_rms, theta_rms, alpha_rms, beta_rms и gamma_rms), пять признаков спектральной плотности мощности (PSD) (delta_psd, theta_psd, alpha_psd, beta_psd и gamma_psd) и пять признаков энтропии (delta_entropy, theta_entropy, alpha_entropy, beta_entropy и gamma_entropy). Возраст был включен в качестве дополнительной демографической переменной. Поскольку распределение по возрасту может различаться в разных диагностических группах, нельзя полностью исключить влияние демографических факторов. В качестве целевой метки была назначена диагностическая группа, определенная как AD, HC или FTD.
7. Предобработка данных и разделение на обучающую и тестовую выборки
В ходе предобработки частота дискретизации записей была снижена с 500 Hz до 250 Hz для уменьшения вычислительных затрат при сохранении интересующей частотной информации ЭЭГ.
Набор данных был разделен на обучающую (80%) и тестовую (20%) подвыборки на уровне субъектов с использованием стратегии группового разделения. Предсказания на уровне субъектов впоследствии были получены путем мажоритарного голосования по предсказанным эпохам, относящимся к каждому участнику. Для основной оценки использовалось групповое разделение на обучающую и тестовую выборки на уровне субъектов, чтобы исключить попадание эпох одного и того же участника в обе подвыборки. Предсказания на уровне субъектов были получены путем мажоритарного голосования по предсказанным эпохам, относящимся к каждому участнику. Набор данных был проверен на наличие пропущенных значений; пропущенные наблюдения были удалены или восполнены соответствующим образом. Диагностические метки были закодированы. На обучающих данных был построен StandardScaler, который затем был применен как к обучающему, так и к тестовому наборам данных.
8. Разработка модели случайного леса
Классификатор Random Forest был инициализирован с использованием 80 деревьев, максимальной глубины дерева 10, максимального количества признаков 4, минимального количества образцов на лист 5 и случайного состояния (random state) 42. Классификатор был обучен на стандартизированном обучающем наборе данных.
9. Оценка модели
Для обучающего и тестового наборов данных были предсказаны метки классов. Была построена матрица ошибок, а также рассчитаны точность (accuracy), прецизионность (precision), полнота (recall) и F1-мера вместе с отчетом о классификации. Были зафиксированы показатели точности на обучающей и тестовой выборках.
Для оценки по каждому отдельному участнику убедитесь, что все эпохи конкретного участника были назначены исключительно либо в обучающую, либо в тестовую подвыборку. Классификатор Random Forest был обучен с использованием тех же гиперпараметров, что и в основном анализе.
10. Перекрестная проверка
В качестве дополнительной процедуры оценки модели была выполнена пятикратная стратифицированная перекрестная проверка с параметрами shuffle = True и random_state = 30. Были рассчитаны средняя точность и стандартное отклонение по пяти блокам. Данный анализ рассматривался отдельно от основной оценки на отложенной выборке на уровне субъектов.
11. Анализ стабильности признаков
Стабильность признаков оценивали путем 10-кратного повторения обучения Random Forest с использованием случайных значений seed от 0 до 9. Для каждого запуска регистрировали точность тестирования и показатели важности признаков. Для каждого предиктора рассчитывали среднее значение и стандартное отклонение показателя важности по всем 10 запускам, после чего предикторы ранжировали в соответствии с их стабильностью. Данный анализ использовался для оценки согласованности ранжирования признаков, а не для замены основной оценки на уровне субъектов.
12. Анализ с помощью объяснимого искусственного интеллекта
Для обученной модели Random Forest был применен метод SHAP TreeExplainer. Для оценки вклада каждого признака в прогнозы модели были рассчитаны значения SHAP. Для каждого признака было вычислено среднее абсолютное значение SHAP, после чего признаки были ранжированы в соответствии с их вкладом по SHAP. Были выявлены признаки со стабильно низкими значениями SHAP, которые затем были сопоставлены с результатами анализа стабильности признаков и коэффициента d Коэна. Признаки, демонстрирующие стабильно низкий вклад, были отобраны для последующей абляции и переобучения модели.
13. Статистический анализ величины эффекта
Для каждого ЭЭГ-биомаркера был рассчитан d-показатель Коэна для сравнений БА versus ЗК, БА versus ЛБД и ЛБД versus ЗК. Величину эффекта интерпретировали, используя пороговые значения 0,20 для малого эффекта, 0,50 для среднего эффекта и 0,80 для большого эффекта.
14. Комплексный отбор признаков
Результаты анализа важности признаков методом Random Forest, анализ SHAP и анализ d-критерия Коэна были сопоставлены. Предикторы, которые последовательно демонстрировали низкую важность признака, низкий вклад SHAP и малый размер эффекта, были определены как кандидаты на удаление.
15. Абляция признаков
Признаки энтропии были оценены в ходе эксплораторного анализа абляции, и была построена сокращенная матрица признаков, содержащая RMS, PSD и возраст. Классификатор Random Forest был переобучен с использованием тех же гиперпараметров. Обучение модели, тестирование, кросс-валидация и анализ рабочих характеристик приемника (ROC-анализ) были повторены с использованием сокращенного набора признаков.
16. ROC-анализ
Вероятности классов были получены с помощью оптимизированного классификатора Random Forest. Многоклассовые ROC-кривые были построены с использованием метода one-в сравнении с—стратегия отдыха. Были рассчитаны значения площади под кривой (AUC) для каждого конкретного класса и среднее значение AUC.
17. Сравнение эффективности
Эффективность полной модели признаков была compared с эффективностью сокращенной модели признаков, полученной после абляции признаков по энтропии.
Результаты
Модель Random Forest достигла точности 96% при обучении и 92% при тестировании. Макро-усредненная F1-мера составила 92%, в то время как средневзвешенная F1-мера также составила 92%, что указывает на сопоставимую эффективность для трех классов. Самые высокие показатели классификации были достигнуты для класса болезни Альцгеймера (AD), тогда как класс лобно-височной деменции (FTD) продемонстрировал сравнительно более низкие результаты, как показано в Таблице 1.
Для оценки разделения классов по различным порогам классификации использовался анализ рабочей характеристики приемника (ROC-анализ). Как показано на рисунке 2, площадь под ROC-кривой (AUC) превысила 0,98 для всех трех классов, что свидетельствует о высокой степени разделимости групп с БА, МПД и здоровым контролем (ЗК).
Для оценки вклада признаков в модель классификации Random Forest был проведен анализ SHAP с использованием TreeExplainer. Сводная столбчатая диаграмма на рисунке 3 продемонстрировала относительный вклад спектральной плотности мощности (PSD), среднеквадратичного значения (RMS), энтропии и демографических признаков. Признаки с более высокими абсолютными значениями SHAP оказывали более сильное влияние на прогнозы модели, в то время как признаки, связанные с энтропией, показали сравнительно низкий вклад.
Анализ стабильности признаков проводили путем повторного обучения Random Forest с использованием указанных случайных значений (seeds). Для каждого запуска регистрировали точность тестирования и показатели значимости признаков, после чего рассчитывали среднее значение и стандартное отклонение значимости признаков. В данном анализе модель достигла средней точности классификации 95% со стандартным отклонением 0,17%. Эти повторные запуски использовались в первую очередь для оценки согласованности ранжирования признаков и рассматривались отдельно от основной оценки на отложенной выборке на уровне субъектов. Возраст занял высокое место в анализе стабильности признаков, как показано в Таблице 2. Признаки theta_psd и theta_rms также имели высокие ранги, в то время как alpha_psd, alpha_rms, beta_psd и beta_rms продемонстрировали умеренную значимость.
Для оценки величины межгрупповых различий был рассчитан коэффициент d Коэна, результаты которого представлены в Таблице 3. Наибольшие зарегистрированные различия между участниками с AD и здоровым контролем наблюдались при затухании альфа-ритма (alpha_rms, d = 0.97; alpha_psd, d = 0.87) и повышении тета-активности (theta_rms, d = 0.72). Эти данные согласуются с замедлением корковой активности, описанным в ЭЭГ-исследованиях деменции34. Признаки, основанные на энтропии, показали сравнительно меньшие величины эффекта. Сравнение AD и FTD выявило преимущественно малые или умеренные величины эффекта.
Характеристики альфа-диапазона продемонстрировали большие размеры эффекта при сравнении групп AD и HC, а также FTD и HC. Для сравнения AD и HC зарегистрированные размеры эффекта составили −0,87 для alpha_psd и −0,97 для alpha_rms. Для сравнения FTD и HC затухание в альфа-диапазоне составило −0,73. Характеристика theta_psd показала размер эффекта 0,61 для AD и HC, в то время как для theta_rms размер эффекта составил 0,72. Менее выраженные различия наблюдались при сравнении AD и FTD.
Характеристики бета-диапазона продемонстрировали преимущественно малые или умеренные величины эффекта для групп. Величины эффекта beta_psd составили −0.35 для AD по сравнению с HC и −0.41 для AD по сравнению с FTD, в то время как beta_rms показал в основном малые эффекты. Характеристики гамма-диапазона продемонстрировали умеренные эффекты для некоторых сравнений. Величина эффекта gamma_psd составила 0.47 для FTD по сравнению с HC и 0.20 для AD по сравнению с HC, тогда как gamma_rms показал величину эффекта 0.50 для FTD по сравнению с HC.
Значения Delta PSD и RMS продемонстрировали небольшие положительные размеры эффекта для БА в сравнении с ЗК (0,29 и 0,34 соответственно) и ЛВД в сравнении с ЗК (0,25 и 0,25 соответственно). Размеры эффекта для БА в сравнении с ЛВД были близки к нулю. Delta entropy показала небольшие размеры эффекта во всех трех сравнениях (0,08, 0,20 и −0,11).
Анализы стабильности признаков, SHAP и величины эффекта показали сравнительно низкий вклад признаков энтропии. Следовательно, был проведен анализ абляции путем исключения признаков энтропии и сохранения RMS, PSD и возраста. После абляции признаков модель Random Forest достигла точности 96% на обучающей выборке и 94% на тестовой выборке. Этот результат был интерпретирован как предварительное сравнение в рамках оцениваемой системы отбора признаков. Точность (precision), полнота (recall), F1-мера и поддержка для классов AD, HC и FTD представлены в Таблице 4.
Сравнение эффективности до и после абляции признака энтропии приведено в Таблице 5. Точность тестирования увеличилась с 92% до 94% после удаления энтропии. Изменения по классам представлены в Таблице 6. Для FTD точность (precision) увеличилась на 4%, а F1-мера — на 2%. Полнота (recall) для группы HC увеличилась на 4%, в то время как точность снизилась на 2%. Показатели макроусреднения (macro-average) и взвешенного усреднения (weighted-average) увеличились примерно на 1%–2% после абляции признаков.
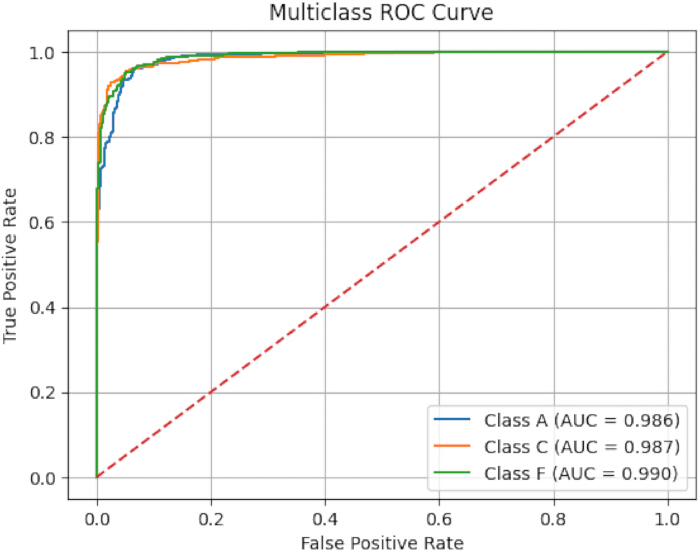
Рисунок 2ROC-кривые для болезни Альцгеймера, фронтотемпоральной деменции и здорового контроля. Многоклассовые рабочие характеристики приемника (ROC-кривые), построенные с использованием метода «один против...»в сравнении с—стратегия покоя для пациентов с болезнью Альцгеймера (класс A), лобно-височной деменцией (класс F) и здоровых добровольцев (контрольная группа, класс C). Для каждого класса была рассчитана площадь под кривой (AUC). Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
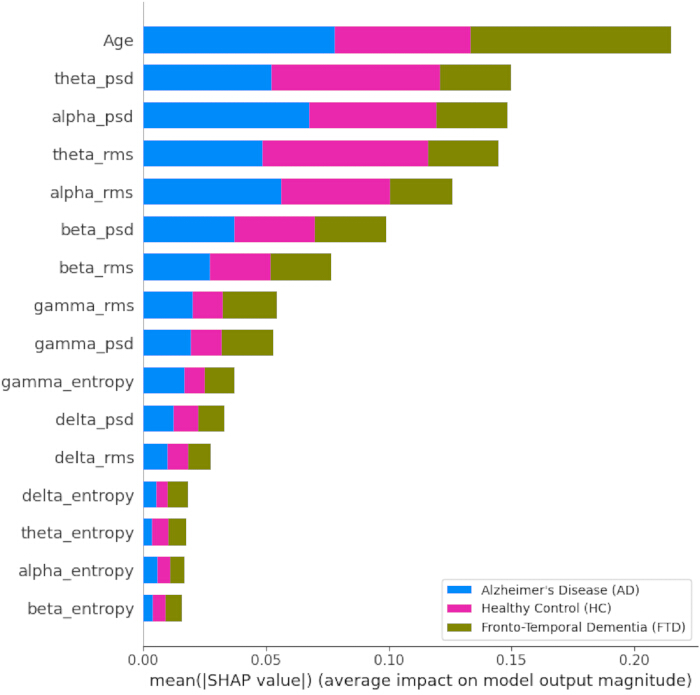
Рисунок 3: Сводный анализ SHAP обученной модели Random Forest. Сводный столбчатый график, показывающий относительный вклад демографических признаков и признаков, полученных на основе ЭЭГ, в модель классификации Random Forest. Для ранжирования вкладов среднеквадратичного значения (RMS), спектральной плотности мощности (PSD), энтропии и возраста использовались средние абсолютные значения SHAP. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
| Точность (Precision) | Полнота (Recall) | F1-мера | Поддержка (Support) | |
| Болезнь Альцгеймера | 0.92 | 0.95 | 0.94 | 579 |
| Контроль | 0.93 | 0.92 | 0.93 | 480 |
| Лобно-височная деменция | 0.93 | 0.87 | 0.9 | 314 |
| Макроусреднение | 0.93 | 0.92 | 0.92 | 1373 |
| Взвешенное усреднение | 0.93 | 0.92 | 0.92 | 1373 |
Таблица 1: Отчет о классификации на тестовых данных. Точность, полнота, F1-мера и поддержка для классов болезни Альцгеймера, здорового контроля и лобно-височной деменции в тестовом наборе данных, а также показатели макро-усреднения и взвешенного среднего.
| Особенность | Среднее значение | Стандартное отклонение |
| Возраст | 0.1966 | 0.0017 |
| спектральная_плотность_мощности_тета_ритма | 0.0936 | 0.0027 |
| theta_rms | 0.0911 | 0.0023 |
| альфа-ПСД | 0.0824 | 0.0022 |
| alpha_rms | 0.0824 | 0.0024 |
| бета-ПСП (спектральная плотность мощности) | 0.0638 | 0.0013 |
| бета-СКО (среднеквадратичное отклонение) | 0.0629 | 0.0012 |
| гамма_psd | 0.0534 | 0.001 |
| гамма_СКВМ | 0.0527 | 0.0014 |
| дельта_ПСД | 0.0403 | 0.0007 |
| delta_rms | 0.0359 | 0.001 |
| гамма-энтропия | 0.0326 | 0.0008 |
| альфа-энтропия | 0.0325 | 0.0006 |
| бета-энтропия | 0.0283 | 0.0009 |
| тета-энтропия | 0.0258 | 0.0004 |
| дельта-энтропия | 0.0255 | 0.0005 |
Таблица 2: Ранжирование признаков по стабильности модели Random Forest. Средние значения важности признаков и соответствующая вариабельность, полученные в результате многократного обучения Random Forest с использованием случайных значений (seed) от 0 до 9. Признаки были ранжированы в соответствии с их стабильностью между запусками.
| Особенность | Болезнь Альцгеймера в сравнении с ГК (Глюкокортикоид) | БАС в сравнении с Лоборно-височная дегенерация | Лобно-височная деменция в сравн. с ГК (глюкокортикостероиды) |
| Дельта-PSD (изменение спектральной плотности мощности) | 0.293 | -0.069 | 0.253 |
| Спектральная плотность мощности тета-ритма | 0.612 | 0.23 | 0.355 |
| Альфа-ПСД | -0.869 | -0.219 | -0.64 |
| Бета-PSD | -0.352 | -0.408 | 0.201 |
| Гамма-PSD | 0.201 | -0.326 | 0.468 |
| Изменение энтропии | 0.081 | 0.199 | -0.111 |
| Тета-энтропия | 0.208 | 0.033 | 0.163 |
| Альфа-энтропия | -0.061 | 0.071 | -0.137 |
| Бета-энтропия | -0.37 | -0.042 | -0.332 |
| Гамма-энтропия | -0.338 | 0.047 | -0.391 |
| Среднеквадратичное отклонение Delta (Delta RMS) | 0.342 | 0.041 | 0.251 |
| Среднеквадратичное значение тета-ритма | 0.718 | 0.354 | 0.318 |
| Alpha RMS | -0.977 | -0.205 | -0.73 |
| Бета-СКО (среднеквадратичное отклонение) | -0.494 | -0.365 | 0.015 |
| Среднеквадратичное значение гамма-излучения | 0.187 | -0.33 | 0.5 |
Таблица 3: Сравнение величины эффекта d Коэна по диагностическим группам. Значения d Коэна для ЭЭГ-биомаркеров при сравнении болезни Альцгеймера против здорового контроля, болезни Альцгеймера против лобно-височной деменции и лобно-височной деменции против здорового контроля.
| Точность | Полнота (Recall) | F1-мера | Поддержка | |
| Болезнь Альцгеймера | 0.94 | 0.95 | 0.94 | 579 |
| Контроль | 0.91 | 0.96 | 0.94 | 480 |
| Лобно-височная деменция | 0.97 | 0.89 | 0.92 | 314 |
| Макро-среднее значение | 0.94 | 0.93 | 0.93 | 1373 |
| Средневзвешенное значение | 0.94 | 0.94 | 0.94 | 1373 |
Таблица 4: Отчет о классификации после абляции признаков. Точность (precision), полнота (recall), F1-мера (F1-score) и поддержка (support) для классов болезни Альцгеймера, здорового контроля и лобно-височной деменции после удаления признаков энтропии и переобучения модели Random Forest.
| Метрика | До абляции | После абляции | Изменение |
| Точность обучения | 0.96 | 0.96 | 0% изменений |
| Проверка точности | 0.92 | 0.94 | улучшение на 2% |
| Макропрецизионность | 0.93 | 0.94 | улучшение на 1% |
| Макро-отзыв | 0.92 | 0.93 | улучшение на 1% |
| Макро-усредненная F1-мера | 0.92 | 0.93 | улучшение на 1% |
| Взвешенная точность | 0.93 | 0.94 | улучшение на 1% |
| Взвешенная полнота | 0.92 | 0.94 | улучшение на 2% |
| Взвешенная F1-мера | 0.92 | 0.94 | улучшение на 2% |
Таблица 5: Сравнение эффективности до и после абляции признаков. Сравнение метрик эффективности модели для полного набора многодоменных признаков и сокращенного набора признаков, полученного после удаления признаков энтропии.
ДОСТУПНОСТЬ ДАННЫХ:
Обработанный набор данных в формате CSV, использованный для разработки и анализа модели, представлен в Дополнительном файле 1. Код для предобработки доступен в блокноте Python по адресу https://colab.research.google.com/drive/1PwidMZCbbIHdthDhat5OEZa7ya6f0-aC?usp=sharing, а код для построения модели и анализа доступен по адресу https://colab.research.google.com/drive/1q8wYJjQpofAqZGYxz9xHKB0emGF4YGwM?usp=sharing. Обработанный набор данных CSV также может быть повторно сгенерирован с помощью предоставленного кода предобработки
| Класс | Метрика | До | После | Изменение |
| Болезнь Альцгеймера | Точность | 0.92 | 0.94 | 0.02 |
| Полнота (Recall) | 0.95 | 0.95 | Без изменений | |
| F-мера | 0.94 | 0.94 | Без изменений | |
| Контроль | Точность | 0.93 | 0.91 | −2% |
| Полнота | 0.92 | 0.96 | 0.04 | |
| F-мера | 0.93 | 0.94 | 0.01 | |
| ЛВД (Лобно-височная деменция) | Точность | 0.93 | 0.97 | 0.04 |
| Полнота (Recall) | 0.87 | 0.89 | 0.02 | |
| F-мера | 0.9 | 0.92 | 0.02 |
Таблица 6: Изменения показателей эффективности по классам до и после абляции признаков. Изменения точности (precision), полноты (recall) и F1-меры для классов болезни Альцгеймера, здорового контроля и лобно-височной деменции после удаления признаков энтропии.
Дополнительный файл 1: Обработанный набор признаков ЭЭГ на уровне эпох, использованный для разработки и анализа модели. Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Обсуждение
Классификатор Random Forest использовался для распределения образцов электроэнцефалографии (ЭЭГ) по группам: болезнь Альцгеймера (БА), лобно-височная деменция (ЛВД) и здоровый контроль (ЗК) с использованием многодоменных признаков, включая спектральную плотность мощности (PSD), среднеквадратичное значение (RMS) и показатели энтропии. Возраст был включен в качестве дополнительной демографической переменной. Поскольку распределение по возрасту могло различаться между диагностическими группами, демографический конфаундинг не мог быть полностью исключен, и, следовательно, сообщаемые показатели эффективности отражали совокупный вклад демографической и электрофизиологической информации. В ходе анализа изучалась способность многодоменных признаков ЭЭГ дифференцировать группы БА, ЛВД и ЗК, а также оценивался вклад признаков дельта-, тета-, альфа-, бета- и гамма-диапазонов в классификацию35. Анализ стабильности признаков и величины эффекта показал, что признаки, основанные на мощности, включая PSD и RMS, вносят более значительный вклад, чем признаки, основанные на энтропии. Извлеченные биомаркеры ЭЭГ также отражали паттерны, связанные с замедлением ритмов и снижением альфа-активности.
В предыдущих исследованиях оценивались признаки ЭЭГ на основе энтропии, спектральной плотности мощности (PSD) и среднеквадратичного значения (RMS) с использованием различных подходов машинного обучения2,14,27,28,36,37. Энтропия использовалась для характеристики сложности и нерегулярности ЭЭГ, в то время как PSD применялась для количественной оценки спектральных характеристик2,14,27,28,36. RMS также оценивалась как признак частотного диапазона37. В предыдущей работе с использованием того же базового набора данных применялась бинарная классификация на основе PSD с валидацией по методу исключения одного субъекта (leave-one-subject-out)33. В настоящем анализе, напротив, RMS, энтропия и PSD в альфа-, бета-, гамма-, тета- и дельта-диапазонах были объединены в рамках многоклассовой классификации. На том же наборе данных была протестирована облегченная модель EEG transformer с использованием стратегии бинарной классификации по методу исключения одного субъекта. Облегченная модель EEG transformer, протестированная на том же наборе данных с использованием стратегии бинарной классификации по методу исключения одного субъекта, показала точность 83.28%. Прямое численное сравнение с настоящими результатами следует интерпретировать с осторожностью, поскольку задача классификации и процедуры валидации различались38.
Признаки альфа-диапазона продемонстрировали наибольшие размеры эффекта при дифференциации БА от ЗК и ЛВД от ЗК, а повышенная тета-активность также способствовала разграничению БА и ЗК. Признаки бета-диапазона показали меньшие эффекты во всех группах, тогда как признаки на основе энтропии имели сравнительно ограниченную дискриминационную значимость. Признаки гамма-диапазона продемонстрировали умеренные эффекты для некоторых сравнений, включая ЛВД versus ЗК. В предыдущих исследованиях сообщалось о снижении мощности альфа-ритма и изменении тета-активности при БА и в соответствующих диагностических сравнениях23,25,39. Энтропия также описывалась как потенциально информативный биомаркер нейродегенеративных заболеваний36, что указывает на то, что ее вклад может варьироваться в зависимости от набора данных, определения признака и аналитического подхода.
Метод опорных векторов часто использовался в предыдущих исследованиях по классификации ЭЭГ3,21,24,37. Классификатор Random Forest, использованный в данном анализе, позволил получить оценки важности признаков и был применим к структурированному набору признаков, использованному в этом исследовании40,41. После абляции признаков энтропии точность обучения и тестирования составила 96% и 94% соответственно. Удаление признаков энтропии было связано с улучшением производительности модели, что подтверждает более низкий относительный вклад этих признаков, наблюдаемый при анализе стабильности, SHAP и величины эффекта. Для классификации ЭЭГ также применялись методы глубокого обучения и подходы на основе трансформеров, хотя такие подходы обычно требуют больших наборов данных и предназначены для более многомерных или последовательных представлений27,39,42,43,44,45.
Сигналы ЭЭГ характеризуются зашумленностью и нестационарностью, а ансамблевые модели на основе деревьев решений могут обеспечить устойчивость при анализе структурированных представлений признаков. В настоящем исследовании среднеквадратичное значение (RMS), спектральная плотность мощности (PSD), энтропия и возраст оценивались в качестве дополнительных входных данных для модели Random Forest. RMS отражала амплитуду сигнала в частотных диапазонах, PSD — спектральную мощность, а энтропия — сложность сигнала. Результаты показали, что в рамках оцениваемой системы PSD и RMS вносили более значимый вклад в классификацию, чем энтропия. Возраст также повлиял на модель, хотя его включение создало вероятность демографического смешивания факторов. В будущих исследованиях можно оценить дополнительные демографические переменные, а также альтернативные подходы машинного или глубокого обучения на более крупных наборах данных для дальнейшей оценки обобщающей способности и эффективности классификации.
Раскрытие информации
Конфликтов финансовых интересов, личных или финансовых отношений, а также иной деятельности, которые могли бы повлиять на результаты данной работы, не заявлено.
Благодарности
Авторы выражают признательность за общедоступный набор данных ЭЭГ, использованный в данном исследовании, а также за вклад исследователей, сделавших этот набор данных доступным для исследовательских целей. Специальное финансирование из государственных, коммерческих или некоммерческих источников не получалось.
Материалы
| Имя | Компания | Каталожный номер | Комментарии |
|---|---|---|---|
| Google Colab | [подтвердить среду]colab runtime | Облачная вычислительная среда, используемая для запуска блокнотов с анализом | |
| MNE-Python | MNE-Python project | 1.12.1 | Используется для предобработки ЭЭГ, пересчета референта, фильтрации и сегментации на эпохи |
| NumPy | NumPy project | (2.0.2) | Используется для численных вычислений и операций с массивами |
| OpenNeuro EEG dataset | OpenNeuro | ds004504, (1.0.9) | Общедоступный набор данных ЭЭГ в состоянии покоя, содержащий записи пациентов с БА, МПД и здоровым контролем |
| Python | Python Software Foundation | [3.12.13 (main, Mar 4 2026, 09:23:07) [GCC 11.4.0]] | Среда программирования, используемая для обработки данных и разработки моделей |
| scikit-learn | scikit-learn project | 1.6.1 | Используется для предобработки, группированного разделения данных, классификации методом случайного леса и оценки эффективности |
| SciPy | SciPy project | (1.16.3) | Используется для обработки сигналов и статистических вычислений |
| SHAP | SHAP project | 0.52.0 | Используется для анализа объяснимого искусственного интеллекта с помощью TreeExplainer |
Ссылки
- Rodrigues PM, et al. Early prediction of Alzheimer's with the electroencephalogram. Procedia Comput Sci. 2016;100:865–71. https://doi.org/10.1016/j.procs.2016.09.236
- Houmani N, et al. Diagnosis of Alzheimer's disease with electroencephalography in a differential framework. PLoS One. 2018;13(3):e0193607. https://doi.org/10.1371/journal.pone.0193607
- Tripanpitak K, et al. Biomarkers for Alzheimer's disease and mild cognitive impairment: recent advances in task-based EEG. J Alzheimers Dis. 2025 [Epub ahead of print].
- Kung HC, Hoyert DL, Xu J, Murphy SL. Deaths: final data for 2005. Natl Vital Stat Rep. 2008;56(10):1-120.
- Falk TH, Fraga FJ, Trambaiolli L, Anghinah R. EEG amplitude modulation analysis for semi-automated diagnosis of Alzheimer's disease. EURASIP J Adv Signal Process. 2012;2012(1):192. https://doi.org/10.1186/1687-6180-2012-192
- Lehmann C, et al. Application and comparison of classification algorithms for recognition of Alzheimer's disease in electrical brain activity (EEG). J Neurosci Methods. 2007;161(2):342–50. https://doi.org/10.1016/j.jneumeth.2006.10.023
- Campanharo AS, Doescher E, Ramos FM. Automated EEG signals analysis using quantile graphs. In: Ferrández Vicente JM, Álvarez-Sánchez JR, de la Paz López F, Adeli H, editors. International Work-Conference on Artificial Neural Networks (IWANN 2017). Cham: Springer; 2017. p. 95–103. https://doi.org/10.1007/978-3-319-59147-6_9
- Adeli H, Ghosh-Dastidar S, Dadmehr N. Alzheimer's disease: models of computation and analysis of EEGs. Clin EEG Neurosci. 2005;36(3):131–40. https://doi.org/10.1177/155005940503600303
- Zheng H, Xiong X, Zhang X. Multi-threshold recurrence rate plot: a novel methodology for EEG analysis in Alzheimer's disease and frontotemporal dementia. Brain Sci. 2024;14(6):565. https://doi.org/10.3390/brainsci14060565
- Zheng X, et al. Diagnosis of Alzheimer's disease via resting-state EEG: integration of spectrum, complexity, and synchronisation signal features. Front Ageing Neurosci. 2023;15:1288295. https://doi.org/10.3389/fnagi.2023.1288295
- Abd Rahman F, Othman MF, Shaharuddin NA. Analysis methods of EEG signals: a review in EEG applications for brain disorders. J Teknol. 2015;72(2):41-6.
- Jackson AF, Bolger DJ. The neurophysiological bases of EEG and EEG measurement: a review for the rest of us. Psychophysiology. 2014;51(11):1061–71. https://doi.org/10.1111/psyp.12283
- Fouad IA, Labib FEZM. Identification of Alzheimer's disease from central lobe EEG signals utilising machine learning and a residual neural network. Biomed Signal Process Control. 2023;86:105266. https://doi.org/10.1016/j.bspc.2023.105266
- Fiscon G, et al. Combining EEG signal processing with supervised methods for Alzheimer's patients' classification. BMC Med Inform Decis Mak. 2018;18(1):35. https//doi.org/10.1186/s12911-018-0613-7
- Dauwels J, Vialatte F, Cichocki A. Diagnosis of Alzheimer's disease from EEG signals: where are we standing? Curr Alzheimer Res. 2010;7(6):487–505. https://doi.org/10.2174/156720510792231720
- Jelic V, Kowalski J. Evidence-based evaluation of diagnostic accuracy of resting EEG in dementia and mild cognitive impairment. Clin EEG Neurosci. 2009;40(2):129-42.
- Coben LA, Danziger WL, Berg L. Frequency analysis of the resting awake EEG in mild senile dementia of Alzheimer type. Electroencephalogr Clin Neurophysiol. 1983;55(4):372–80. https://doi.org/10.1016/0013-4694(83)90124-4
- Cibils D. Dementia and qEEG (Alzheimer's disease). Suppl Clin Neurophysiol. 2002;54:289-94.
- Ramírez-Arias FJ, et al. Evaluation of machine learning algorithms for the classification of EEG signals. Technologies. 2022;10(4):79. https://doi.org/10.3390/technologies10040079
- Hosseini MP, Hosseini A, Ahi K. A review on machine learning for EEG signal processing in bioengineering. IEEE Rev Biomed Eng. 2021;14:204–18. https://doi.org/10.1109/RBME.2020.2969915
- Vicchietti ML, Ramos FM, Betting LE, Campanharo AS. Computational methods of EEG signals analysis for Alzheimer's disease classification. Sci Rep. 2023;13(1):8184.
- Rahimi P, Noroozian M, Hatami J, Sadeghi M. Differential role of electroencephalography between mild cognitive impairment and Alzheimer disease during spatial working memory task. Iran J Neurodevelop Disord. 2025;4(1):101-10.
- Wang J, et al. Alzheimer's disease diagnosis using rhythmic power changes and phase differences: a low-density EEG study. Front Aging Neurosci. 2025;16:1485132. https://doi.org/10.3389/fnagi.2024.1485132
- Senkaya Y, Kurnaz C, Ozbilgin F. Enhancing Alzheimer's diagnosis with machine learning on EEG: a spectral feature-based comparative analysis. Diagnostics (Basel). 2025;15(17):2190. https://doi.org/10.3390/diagnostics15172190
- McBride JC, et al. Spectral and complexity analysis of scalp EEG characteristics for mild cognitive impairment and early Alzheimer's disease. Comput Methods Programs Biomed. 2014;114(2):153–63. https://doi.org/10.1016/j.cmpb.2014.01.019
- Al-Nuaimi AH, Jammeh E, Sun L, Ifeachor E. Changes in the EEG amplitude as a biomarker for early detection of Alzheimer's disease. In: 2016 38th Annual International Conference of the IEEE Engineering in Medicine and Biology Society (EMBC); 2016; Orlando, FL, USA. Piscataway: IEEE; 2016. p. 993–6. https://doi.org/10.1109/EMBC.2016.7590869
- Ma Y, Bland JKS, Fujinami T. Classification of Alzheimer's disease and frontotemporal dementia using electroencephalography to quantify communication between electrode pairs. Diagnostics (Basel). 2024;14(19):2189. https://doi.org/10.3390/diagnostics14192189
- Fiscon G, et al. Alzheimer's disease patients classification through EEG signals processing. In: 2014 IEEE Symposium on Computational Intelligence and Data Mining (CIDM); 2014; Orlando, FL, USA. IEEE; 2014. p. 105–12. https://doi.org/10.1109/CIDM.2014.7008655
- Fouladi S, et al. Efficient deep neural networks for classification of Alzheimer’s disease and mild cognitive impairment from scalp EEG recordings. Cogn Comput. 2022;14(4):1247–68. https://doi.org/10.1007/s12559-022-10022-y
- Miltiadous A, et al. Alzheimer’s disease and frontotemporal dementia: A robust classification method of EEG signals and a comparison of validation methods. Diagnostics. 2021;11(8):1437. https://doi.org/10.3390/diagnostics11081437
- Nobukawa S, et al. Classification methods based on complexity and synchronization of electroencephalography signals in Alzheimer’s disease. Front Psychiatry. 2020;11:255. https://doi.org/10.3389/fpsyt.2020.00255
- Huggins CJ, et al. Deep learning of resting-state electroencephalogram signals for three-class classification of Alzheimer’s disease, mild cognitive impairment and healthy ageing. J Neural Eng. 2021;18(4):046087. https://doi.org/10.1088/1741-2552/ac1a80
- Miltiadous A, et al. DICE-net: a novel convolution–transformer architecture for Alzheimer detection in EEG signals. IEEE Access. 2023;11:71840–58. https://doi.org/10.1109/ACCESS.2023a.3294618
- Miller R. Theory of the normal waking EEG: from single neurones to waveforms in the alpha, beta and gamma frequency ranges. Int J Psychophysiol. 2007;64(1):18–23. https://doi.org/10.1016/j.ijpsycho.2006.07.009
- Thomas JS, Thivakaran TK. Data mining algorithms and statistical techniques for identification of schizophrenia: A survey. In: 2020 International Conference on Smart Technologies in Computing, Electrical and Electronics (ICSTCEE); 2020; Bengaluru, India. IEEE; 2020. p. 246–51. https://doi.org/10.1109/ICSTCEE49637.2020.9276856
- Cacciotti A, et al. EEG entropy insights in the context of physiological aging and Alzheimer's and Parkinson's diseases: a comprehensive review. Geroscience. 2024;46(6):5537–57. https://doi.org/10.1007/s11357-024-01200-5
- Subhashree S, Eric PV. A unique EEG-Hyfusion fully automated stacked model for classification of Alzheimer's disease and frontotemporal dementia. J Vis Exp. 2026;(228):e69762.
- Miltiadous A, et al. A dataset of scalp EEG recordings of Alzheimer's disease, frontotemporal dementia and healthy subjects from routine EEG. Data (Basel). 2023;8(6):95. https://doi.org/10.3390/data8060095
- Malakouti SM, Menhaj MB, Suratgar AA. Enhanced epilepsy detection using discrete wavelet transform and bandpass filtering on EEG data: integration of ART-based and LVQ models. Clin eHealth. 2025. https://doi.org/10.1016/j.ceh.2025.02.001
- Durga P, et al. An ensemble model for detection of Parkinson's disease by comparing numerous machine learning models and XGBoost based on vocal features. Clin eHealth. 2025. https://doi.org/10.1016/j.ceh.2025.01.001
- Behnamian A, et al. A systematic approach for variable selection with random forests: achieving stable variable importance values. IEEE Geosci Remote Sens Lett. 2017;14(11):1988–92. https://doi.org/10.1109/LGRS.2017.2745049
- Macia G, Liddell A, Doyle V. Conversational AI with large language models to increase the uptake of clinical guidance. Clin eHealth. 2024;7:147–52. https://doi.org/10.1016/j.ceh.2024.07.001
- Zhao W. Research on the deep learning of small sample data based on transfer learning. AIP Conf Proc. 2017;1864(1):020018. https://doi.org/10.1063/1.4992835
- Hassan U, Singhal A. Convolutional neural network framework for EEG-based ADHD diagnosis in children. Health Inf Sci Syst. 2024;12(1):44. https://doi.org/10.1007/s13755-024-00303-x
- Jeong T, Park U, Kang SW. Novel quantitative electroencephalogram feature image adapted for deep learning: verification through classification of Alzheimer’s disease dementia. Front Neurosci. 2022;16:1033379. https://doi.org/10.3389/fnins.2022.1033379