В данном исследовании определены восемь прогностических генов, связанных с митотической катастрофой (PDGFB, LDHA, ZEB2, H2AX, FKBP4, DMD, ANXA2, S100B), при аденокарциноме легкого; создана модель риска с приемлемой прогностической эффективностью, а также выявлены отчетливые различия в характеристиках иммунного микроокружения между группами риска.
Для просмотра этого контента требуется подписка на JoVE. Войдите или начните свой бесплатный пробный период.
Исследовательская статья
Идентификация прогностических генов, связанных с митотической катастрофой при аденокарциноме легкого, с помощью транскриптомного анализа
В этой статье
Краткое содержание
Аннотация
Аденокарцинома легкого (LUAD), наиболее распространенный подтип рака легкого, характеризуется неблагоприятным прогнозом. Хотя в клетках LUAD может быть индуцирована митотическая катастрофа, приводящая к гибели клеток, прогностическая и биологическая значимость генов, связанных с митотической катастрофой (MCRGs), при этом заболевании остается неясной. Дифференциально экспрессируемые гены (DEGs), связанные с LUAD, были отобраны из когорты TCGA-LUAD, а перекрывающиеся гены определены путем пересечения DEGs с MCRGs. Кандидатные прогностические гены были отобраны с помощью машинного обучения, после чего была построена многогенная прогностическая модель. Была создана сигнатура из восьми кандидатных прогностических генов, включающая PDGFB, LDHA, ZEB2, H2AX, FKBP4, DMD, ANXA2 и S100B, продемонстрировавшая приемлемую прогностическую надежность в обучающей выборке с показателями площади под кривой (AUC) для 2-летнего, 3-летнего и 5-летнего прогноза, равными 0,723, 0,715 и 0,625 соответственно (C-индекс с коррекцией методом бутстрепа: 0,699, 95% CI: 0,657-0,742) и соответствующей валидацией в GSE31210 (AUC: 0,812, 0,766 и 0,814). Пациенты с низким риском демонстрировали значительно лучшие показатели выживаемости, усиленную иммунную инфильтрацию, более высокие иммунные и стромальные баллы, повышенные иммунофеноскоры и более активные циклы противоопухолевого иммунитета. Значительные различия в бремени мутаций опухоли и чувствительности к препаратам наблюдались между группами высокого и низкого риска. Количественная полимеразная цепная реакция (qPCR) подтвердила транскриптомные профили шести кандидатных генов, связанных с исходом заболевания, в клинических образцах. Номограмма, включающая показатель риска и клиническую стадию, показала хорошие прогностические результаты. Эти данные свидетельствуют о том, что восемь кандидатных генов, связанных с MCRG, обладают высоким потенциалом для прогнозирования исходов у пациентов и стратификации риска при LUAD, при этом группы риска характеризуются различными особенностями иммунного микроокружения.
Введение
Рак легкого остается одним из наиболее распространенных и смертоносных видов рака во всем мире1,2. В структуре немелкоклеточного рака легкого (НМРЛ) преобладает аденокарцинома легкого (LUAD), на которую приходится около 40% всех случаев рака легкого3,4. Несмотря на значительный прогресс в области оперативных вмешательств, молекулярно-таргетной терапии, ингибиторов контрольных точек иммунного ответа и комбинированных режимов лечения, клинический прогноз для пациентов с LUAD остается неблагоприятным5,6. Хотя патологоанатомические и визуализационные методы диагностики широко используются при LUAD, они имеют внутренние ограничения в отношении выявления гетерогенности опухоли и ее молекулярных характеристик. Напротив, анализ тканей опухоли на основе молекулярных биомаркеров может предоставить более полную информацию о биологии опухоли и может способствовать прогностической оценке и разработке индивидуальных стратегий лечения7. Таким образом, поиск надежных молекулярных биомаркеров остается важным для улучшения прогностического прогнозирования и биологического понимания LUAD.
Митоз, важнейший механизм клеточной репликации, обеспечивает точное распределение реплицированных хромосом между двумя дочерними клетками8. Нарушение регуляции митотических процессов может способствовать неконтролируемой пролиферации клеток, геномной нестабильности и прогрессированию опухоли. Митотическая катастрофа (МК) представляет собой путь гибели клеток, запускаемый при невозможности завершения митоза, что обычно является следствием повреждения веретена деления или дефектов контрольных точек клеточного цикла9. На морфологическом уровне МК проявляется клеточными аномалиями, включая многоядерность, наличие микроядер, многополярные конфигурации веретена деления и полиплоидизацию10. Являясь механизмом элиминации клеток с тяжелыми митотическими дефектами, МК может способствовать подавлению прогрессирования опухоли9. Делеция p53 в клетках A549 LUAD может индуцировать митотическую катастрофу и, в конечном итоге, гибель клеток11, что указывает на потенциальную связь между МК и клеточными процессами, связанными с LUAD. Тем не менее, прогностическая значимость и биологические функции генов, связанных с митотической катастрофой (MCRGs), при LUAD остаются недостаточно изученными.
В данном исследовании с использованием данных TCGA и GEO была проведена систематическая оценка прогностической значимости и предполагаемой биологической релевантности MCRGs при LUAD. Кандидатные MCRGs были первоначально определены с помощью анализа дифференциальной экспрессии и анализа пересечений. С помощью нескольких подходов машинного обучения был проведен скрининг кандидатных генов и создана прогностическая сигнатура риска, которая в дальнейшем прошла внешнюю валидацию. Для повышения точности прогнозирования выживаемости была разработана номограмма, объединяющая показатель риска с клиническими характеристиками. Кроме того, для изучения биологического значения и клинической полезности выявленных генов были проведены характеристика иммунного микроокружения, оценка соматических мутаций и анализ химиочувствительности. В совокупности эти результаты демонстрируют прогностический потенциал MCRGs при LUAD и могут быть использованы для разработки биомаркеров и индивидуального подбора терапии.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Протокол
Исследование проводилось в соответствии с Хельсинкской декларацией, а протокол был одобрен Комитетом по этике больницы грудных заболеваний провинции Аньхой (K2025-007) 22 апреля 2025 года. От всех участников исследования было получено информированное согласие.
Извлечение и нормализация данных
Транскриптомные профили и соответствующие клинические наборы данных для LUAD были получены из когорт TCGA и GEO. Набор данных TCGA-LUAD был назначен в качестве обучающей выборки, а GSE72094, GSE31210 и GSE26939 служили когортами для внешней валидации (Таблица 1). Кроме того, 900 MCRGs были собраны из предыдущего исследования12(Дополнительная таблица 1). Данные транскриптома были аннотированы с использованием GENCODE v36 или соответствующих файлов аннотации платформы GPL. Идентификаторы зондов были преобразованы в символы генов, дублирующиеся гены были объединены с помощью функции avereps, и для создания матриц экспрессии на уровне генов были оставлены только белок-кодирующие гены. Для обучающей выборки TCGA-LUAD были отфильтрованы гены с количеством фрагментов на килобазу экзонной модели на миллион картированных фрагментов (FPKM) < 1 в более чем 50% образцов, а оставшиеся значения экспрессии были подвергнуты log2-преобразованию (log2[FPKM+1]). Для валидационных когорт GEO были загружены необработанные данные экспрессии, идентификаторы зондов были сопоставлены с символами генов с использованием соответствующих файлов аннотации платформ, а несколько зондов, соответствующих одному и тому же гену, были объединены путем усреднения их значений экспрессии. Эти наборы данных были подвергнуты log2-преобразованию при необходимости. Коррекция пакетного эффекта между платформами TCGA и GEO не применялась, так как была принята стратегия стандартизации для каждой когорты отдельно для обеспечения относимой сопоставимости. В частности, как для обучающей, так и для валидационных когорт значения экспрессии генов были центрированы и масштабированы (z-преобразование) с использованием среднего значения и стандартного отклонения каждого набора данных по отдельности. Затем те же коэффициенты регрессии Кокса, полученные из обучающей выборки, использовались для расчета показателей риска для всех когорт. Чтобы сохранить клиническую применимость и избежать переобучения под любой валидационный набор, медианный показатель риска обучающей когорты использовался в качестве фиксированного порога для стратификации пациентов на группы высокого и низкого риска во всех внешних валидационных когортах. Была извлечена имеющаяся клиническая информация, включая возраст, пол, патологическую стадию, стадию Tumor-Node-Metastasis (TNM), гистологический тип, время выживаемости, статус выживаемости и тип ткани. Конечной точкой была общая выживаемость (OS). Образцы с неполной информацией о выживаемости или временем выживаемости < 30 дней были исключены. Время выживаемости было переведено в годы, а статус выживаемости был закодирован как 0 для живых и 1 для умерших.
Идентификация и функциональный анализ генов-кандидатов
Пакет Limma использовался для идентификации дифференциально экспрессируемых генов (ДЭГ) между образцами опухоли LUAD и нормальными образцами в обучающей выборке13. ДЭГ определялись по следующим критериям: |log2FC| > 0.5 и скорректированное значение p < 0.05. Впоследствии для разделения ДЭГ на отдельные кластеры экспрессии применялся алгоритм нечеткой кластеризации mfuzz из R-пакета ClusterGVis. Анализ биологических процессов Gene Ontology (GO-BP) проводился для пяти наиболее репрезентативных генов в каждом кластере на основе их показателей принадлежности. Набор общих генов был получен путем нахождения пересечения ДЭГ с MCRG. Для оценки биологической значимости перекрывающихся генов проводился функциональный анализ обогащения с использованием Gene Ontology/Киотской энциклопедии генов и геномов (GO/KEGG). Сети белок-белковых взаимодействий (PPI) были построены на основе базы данных STRING14. Для повышения надежности сети были оставлены только взаимодействия с показателем достоверности > 0.7.
Скрининг прогностических генов
Для проведения одномерного регрессионного анализа Кокса с целью выявления вероятных генов, связанных с общей выживаемостью при LUAD, использовался пакет Survival15. Гены со значением p < 0,05 рассматривались как потенциальные прогностические показатели. Обучающая когорта TCGA-LUAD включала 500 пациентов с полными данными о выживаемости, из которых у 216 (43,2%) в период последующего наблюдения наступила смерть. Соотношение количества генов-кандидатов (n = 108) к количеству событий (n = 216) составило примерно 1:2, что является приемлемым для регрессионного анализа Кокса. Впоследствии для дальнейшего отбора признаков применялся регрессионный анализ LASSO (Least Absolute Shrinkage and Selection Operator) и модель XGBoost (Extreme Gradient Boosting). Модели пропорциональных рисков Кокса строились с параметром family = "cox" с помощью функции cv.glmnet пакета glmnet. Оптимальный параметр регуляризации определялся с использованием 10-кратной перекрестной проверки; в качестве оптимального значения λ было выбрано значение λ.min, соответствующее минимальной ошибке перекрестной проверки. В качестве потенциальных признаков были извлечены гены с ненулевыми коэффициентами регрессии. Для модели XGBoost время выживания и статус выживаемости были объединены в целевую переменную, при этом события смерти обозначались положительными значениями, а цензурированные случаи — отрицательными. Параметры были установлены следующим образом: objective = "survival: cox" и eval_metric = "cox-nloglik", при 100 итерациях и скорости обучения 0,1. После обучения модели показатели значимости генов рассчитывались с использованием значений прироста признака (feature gain). После сортировки показателей значимости в порядке убывания были отобраны 20 наиболее значимых генов для снижения размерности признаков и сложности модели. Гены, совпадающие в результатах LASSO и XGBoost, были определены как гены-кандидаты для прогноза.
Построение и оценка прогностической модели
Прогностическая модель была разработана с использованием многофакторного регрессионного анализа Кокса для выявленных генов-кандидатов. Показатели риска рассчитывались индивидуально следующим образом:
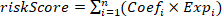 .
где Coefi обозначает коэффициент для гена i, а Expi указывает соответствующее значение экспрессии гена. Впоследствии пациенты были разделены на две группы: высокого и низкого риска, используя медианное значение показателя риска в качестве порогового значения. Затем были построены зависящие от времени ROC-кривые (receiver operating characteristic). Для оценки вероятности переобучения была проведена внутренняя бутстреп-валидация с 1 000 итерациями ресемплирования для расчета скорректированного на смещение C-индекса и зависящих от времени значений AUC с 95% доверительными интервалами. Для оценки соответствия между прогнозируемой и наблюдаемой вероятностью выживаемости через 2, 3 и 5 лет были построены калибровочные кривые. Кроме того, с использованием пакета ggDCA в среде R был проведен анализ кривых принятия решений (DCA) для оценки клинической чистой выгоды модели во временных точках 2, 3 и 5 лет, что позволило количественно определить потенциальную ценность показателя риска при принятии клинических решений при различных пороговых вероятностях. Различия в выживаемости между группами с разным уровнем риска и в других клинических категориях сравнивали с помощью кривых выживаемости Каплана-Мейера (KM) и логрангового критерия. Кроме того, для выяснения вклада отдельных генов в эффективность модели использовался анализ Shapley Additive exPlanations (SHAP) для апостериорной интерпретации результатов.
Разработка и внешняя валидация номограммы
Для оценки клинической применимости модели с помощью тестов Уилкоксона или Краскела-Уоллиса изучались взаимосвязи между рассчитанными показателями риска и различными клиническими характеристиками (включая пол, возраст и стадию по системе TNM). Чтобы определить, является ли показатель риска независимым прогностическим фактором, клинические переменные вместе с показателем риска были включены в многофакторное регрессионное моделирование Кокса. Затем с помощью пакета regplot для языка R была построена прогностическая номограмма, объединяющая независимые клинические факторы риска (например, стадию) и генетический показатель риска, для индивидуализации прогнозов вероятности выживаемости. Калибровочные кривые использовались для оценки соответствия вероятности выживаемости, предсказанной номограммой, фактическим исходам выживаемости. Наконец, итоговая прогностическая способность и обобщаемость интегрированной системы номограмм были строго подтверждены с помощью зависимых от времени ROC-кривых и комплексного анализа клинических подгрупп по методу KM во всех когортах.
Анализ иммунной инфильтрации и иммунных подтипов
Для оценки относительной доли 22 типов иммунных клеток и анализа их инфильтрации у пациентов с LUAD использовали метод CIBERSORT с матрицей сигнатур лейкоцитов (LM22). Взаимосвязь между прогностическими уровнями экспрессии генов и иммунологической инфильтрацией оценивали с помощью корреляционного анализа Спирмена. Показатели иммунного компонента, стромального компонента, чистоты опухоли и общий балл ESTIMATE были получены с помощью алгоритма ESTIMATE, а различия между группами риска оценивали с помощью критерия Вилкоксона. Пациенты с LUAD были распределены по шести иммунным подтипам с использованием пакета ImmuneSubtypeClassifier16. Также применяли критерий Вилкоксона для сравнения распределения иммунных подтипов в различных группах риска.
Анализ контрольных точек иммунитета, иммунофеноскора и цикла противоопухолевого иммунитета
В данном исследовании для оценки экспрессии 21 гена иммунных контрольных точек17 в группах с разным уровнем риска, с целью характеристики иммунного ландшафта LUAD, использовался критерий суммы рангов Уилкоксона. Корреляция по Спирмену позволила связать потенциальные прогностические гены с генами иммунных контрольных точек. Чтобы оценить различия в ответе на ингибиторы иммунных контрольных точек (ICI) у пациентов с LUAD разного уровня риска, данные иммунофеноскора (IPS) для терапии анти-PD-1 и анти-CTLA-4 были получены из Атласа иммуномов рака (The Cancer Immunome Atlas, TCIA)18, а база данных Tracking Tumor Immunophenotype (TIP)19 была использована для оценки активности цикла «рак — иммунитет» путем сравнения соответствующих баллов между группами риска.
Анализ соматических мутаций и чувствительности к препаратам
С помощью инструмента анализа мутаций TCGA были получены профили соматических мутаций для случаев TCGA-LUAD с целью изучения вариаций в паттернах мутаций в разных группах риска. Пакет maftools использовался для обработки и визуализации данных о мутациях. Для каждого образца определялся уровень опухолевой нагрузки мутациями (TMB), который затем сравнивался между двумя категориями риска. Фармакогеномный анализ чувствительности проводился с использованием пакета pRRophetic на основе базы данных Genomics of Drug Sensitivity in Cancer (GDSC)20. Для каждого пациента с LUAD были предсказаны значения полумаксимальной ингибирующей концентрации (IC50) противоопухолевых препаратов, а различия между группами риска оценивались с помощью рангового суммарного критерия Вилкоксона.
Оценка уровней экспрессии прогностических генов
Каждый набор данных использовался для оценки уровней экспрессии выбранных генов-кандидатов, связанных с исходом заболевания. Для установления связи между экспрессией генов и прогнозом пациентов оптимальные пороговые значения были определены с помощью функции surv_cutpoint пакета survminer для языка R. На основании этих порогов случаи LUAD были разделены на подгруппы с высоким и низким уровнем экспрессии для последующего анализа выживаемости.
Кроме того, в больнице грудной клетки провинции Аньхой были получены образцы пяти пар соответствующих опухолей LUAD и прилегающих нормальных тканей, после чего была проведена валидация методом qPCR. Каждый участник предоставил письменное информированное согласие. Для валидации методом qPCR были выбраны шесть потенциальных прогностических генов (PDGFB, LDHA, ZEB2, FKBP4, DMD и S100B). РНК экстрагировали из гомогенизированных образцов тканей с использованием реагента для экстракции РНК с последующей экстракцией хлороформом и осаждением изопропанолом. С помощью спектрофотометра измеряли концентрацию и чистоту РНК. Валидация шести потенциальных прогностических генов методом qPCR проводилась с использованием мастер-микса для ПЦР на основе SYBR Green на системе ПЦР в реальном времени: начальная денатурация при 95 °C в течение 30 s, затем 40 циклов: 95 °C в течение 20 s, 55 °C в течение 20 s и 72 °C в течение 20 s. Относительную экспрессию рассчитывали и стандартизировали по глицеральдегид-3-фосфатдегидрогеназе (GAPDH) с помощью метода 2-ΔΔCt. Подробная информация о всех реагентах и приборах представлена в Таблице материалов.
Статистический анализ
Статистический анализ проводили с использованием программного обеспечения для статистических вычислений и построения графиков. Визуализацию сети белок-белковых взаимодействий осуществляли с помощью программного обеспечения для сетевого анализа. После проверки распределения на нормальность для непрерывных переменных с нормальным распределением использовали t-критерий Стьюдента, а для переменных с ненормальным распределением — U-критерий Манна-Уитни.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Результаты
Идентификация генов-кандидатов и функциональный анализ
Всего было выявлено 4 915 дифференциально экспрессируемых генов (ДЭГ), включая 2 485 генов с пониженной экспрессией и 2 430 генов с повышенной экспрессией (Рисунок 1A). Анализ кластеризации функциональных модулей распределил эти ДЭГ по шести модулям экспрессии (C1-C6), среди которых модули C1, C2, C3 и C5 продемонстрировали относительно более высокий уровень экспрессии в образцах опухоли (
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Обсуждение
Аденокарцинома легкого (LUAD) является одной из ведущих форм рака легких и продолжает представлять значительную проблему для общественного здравоохранения21. Митотическая катастрофа (MC) представляет собой процесс гибели клеток, который может способствовать элиминации клеток с тяжелыми митотическими нарушениями и подавлению прогрессирования опухоли22. Следовательно, изучение потенциальной роли генов, связанных с митотической катастрофой (MCRGs), при LUAD может помочь в поис...
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Раскрытие информации
Авторы заявляют об отсутствии конфликта интересов.
Благодарности
Нет данных
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Материалы
| Имя | Компания | Каталожный номер | Комментарии |
|---|---|---|---|
| ClusterGVis | CRAN | версия 0.1.2 | Кластеризация и визуализация экспрессии генов |
| Cytoscape | Cytoscape Consortium | версия 3.9.1 | Визуализация сетей белковых взаимодействий RRID:SCR_003032 |
| Система количественной флуоресцентной ПЦР в реальном времени CFX384 | Bio-Rad | CFX384 Touch | реагент для qPCR |
| праймер к DMD | Tsingke | Н/Д | Прямой: 5’-GCTCAACCATCGATTTGCAGCC-3’ Обратный: 5’-TTCAGCCTCCAGTGGTTCAAGC-3’ |
| праймер к FKBP4 | Tsingke | Н/Д | Прямой: 5’-TGACTCCAGTCTGGATCGCAAG-3’ Обратный: 5’-CTGGTTTGCAGGTGATGTGGCA-3’ |
| GEO | NCBI | Онлайн-инструмент | Получение внешнего валидационного набора данных LUAD RRID:SCR_005012 |
| праймер к GAPDH | Tsingke | Н/Д | Прямой: 5’-GTCTCCTCTGACTTCAACAGCG-3’ Обратный: 5’-ACCACCCTGTTGCTGTAGCCAA-3’ |
| glmnet | CRAN | версия 4.1-8 | Отбор признаков в LASSO-регрессии RRID:SCR_015505 |
| праймер к LDHA | Tsingke | Н/Д | Прямой: 5’-GGATCTCCAACATGGCAGCCTT-3’ Обратный: 5’-AGACGGCTTTCTCCCTCTTGCT-3’ |
| limma | Bioconductor | версия 3.60.6 | Скрининг DEG RRID:SCR_010943 |
| maftools | Bioconductor | версия 2.20.0 | Визуализация данных о соматических мутациях RRID:SCR_024519 |
| pRRophetic | CRAN | 0.5 | Предсказание значений IC50 препаратов RRID:SCR_024417 |
| праймер к PDGFB | Tsingke | Н/Д | Прямой: 5’-GAGATGCTGAGTGACCACTCGA-3’ Обратный: 5’-GTCATGTTCAGGTCCAACTCGG-3’ |
| Мастер-микс qPCR SYBR Green | Vazyme | Q111-02 | реагент для qPCR |
| ПО R | R Foundation | версия 4.2.2 | Биоинформатический анализ |
| regplot | CRAN | версия 1.1 | Построение линейных графиков |
| survival | CRAN | версия 3.8-3 | Анализ выживаемости и регрессия Кокса RRID:SCR_021137 |
| STRING | STRING Consortium | Онлайн-инструмент | Анализ сетей белковых взаимодействий RRID:SCR_005223 |
| праймер к S100B | Tsingke | Н/Д | Прямой: 5’-GAAGAAATCCGAACTGAAGGAGC-3’ Обратный: 5’-TCCTGGAAGTCACATTCGCCGT-3’ |
| survminer | CRAN | версия 0.5.0 | Построение и оптимизация кривых выживаемости RRID:SCR_021094 |
| TRIzol | Tiangen | DP424 | реагент для qPCR |
| TCGA | NCI | Онлайн-инструмент | Сбор данных транскриптома и клинических данных LUAD RRID:SCR_003193 |
| праймер к ZEB2 | Tsingke | Н/Д | Прямой: 5’-AATGCACAGAGTGTGGCAAGGC-3’ Обратный: 5’-CTGCTGATGTGCGAACTGTAGG-3’ |
Ссылки
- Asada K, et al. Multi-omics and clustering analyses reveal the mechanisms underlying unmet needs for patients with lung adenocarcinoma and identify potential therapeutic targets. Mol Cancer. 2024;23(1):182.
- Sun Q, et al. Prediction of lung adenocarcinoma prognosis and diagnosis with a novel model anchored in circadian clock-related genes. Sci Rep. 2024;14(1):18202.
- Ho KH, et al. Cancer Essential Genes Stratified Lung Adenocarcinoma Patients with Distinct Survival Outcomes and Identified a Subgroup from the Terminal Respiratory Unit Type with Different Proliferative Signatures in Multiple Cohorts. Cancers (Basel). 2021;13(9):2128.
- Zhang J, et al. Unraveling the Expression Patterns of Immune Checkpoints Identifies New Subtypes and Emerging Therapeutic Indicators in Lung Adenocarcinoma. Oxid Med Cell Longev. 2022;2022:3583985.
- Zheng T, et al. The pathological significance and potential mechanism of ARHGEF6 in lung adenocarcinoma. Comput Biol Med. 2023;158:106894.
- Yu Y, et al. Predicting potential therapeutic targets and small molecule drugs for early-stage lung adenocarcinoma. Biomed Pharmacother. 2024;174:116528.
- Guo Q, et al. Heterogeneous mutation pattern in tumor tissue and circulating tumor DNA warrants parallel NGS panel testing. Mol Cancer. 2018;17(1):131.
- Wang S, et al. Development and validation of a mitotic catastrophe-related genes prognostic model for breast cancer. PeerJ. 2024;12:e18075.
- Mao Z, et al. Mitotic catastrophe heterogeneity: implications for prognosis and immunotherapy in hepatocellular carcinoma. Front Immunol. 2024;15:1409448.
- Zhang QY, et al. Multiple Regulatory Mechanisms of Post-Translational Modifications and Therapeutic Potential of Mitotic Catastrophe. Int J Mol Sci. 2026;27(8):3370..
- Minemoto Y, et al. Loss of p53 induces M-phase retardation following G2 DNA damage checkpoint abrogation. Arch Biochem Biophys. 2003;412(1):13-9.
- Liu Y, et al. Developing a prognosis and chemotherapy evaluating model for colon adenocarcinoma based on mitotic catastrophe-related genes. Sci Rep. 2024;14(1):1655.
- Ritchie ME, et al. limma powers differential expression analyses for RNA-sequencing and microarray studies. Nucleic Acids Res. 2015;43(7):e47.
- Szklarczyk D, et al. The STRING database in 2023: protein-protein association networks and functional enrichment analyses for any sequenced genome of interest. Nucleic Acids Res. 2023;51(D1):D638-d46.
- Lei J, et al. Clinicopathological characteristics of pheochromocytoma/paraganglioma and screening of prognostic markers. J Surg Oncol. 2023;128(4):510-8.
- Thorsson V, et al. The Immune Landscape of Cancer. Immunity. 2018;48(4):812-30.e14.
- Guo Y, et al. Novel immune checkpoint-related gene model to predict prognosis and treatment responsiveness in low-grade gliomas. Heliyon. 2023;9(9):e20178.
- Sun X, et al. A transcriptomic-based model associated with PARP inhibitor sensitivity and immunogenic signatures in ovarian cancer. Discover Oncology. 2026;843.
- Wang L, et al. Identification of an ac4C modification related gene signature for predicting prognosis in laryngeal squamous cell carcinoma patients based on single-cell analysis and machine learning. 2026.
- Lin W, et al. Screening of Molecular Markers of Cisplatin Resistance in Lung Adenocarcinoma and Functional Verification Based on TCGA Database. Cancer Research on Prevention and Treatment. 2024;49(6):569-74.
- Gao W, et al. Promising therapeutic efficacy and safety of a novel integrin α6-targeting peptide-drug conjugate in lung adenocarcinoma. Molecular Cancer 2025;24(1):190.
- Vitale I, et al. Mitotic catastrophe: a mechanism for avoiding genomic instability. Nat Rev Mol Cell Biol. 2011;12(6):385-92.
- Liu M, et al. CDK1-mediated phosphorylation of LDHA fuels mitosis through LDHB-dependent lactate oxidation. EMBO Reports 2025;26(20):4923-4949.
- Zhang W, et al. Inhibition of LDHA suppresses cell proliferation and increases mitochondrial apoptosis via the JNK signaling pathway in cervical cancer cells. Oncology reports 2022;47(4).
- Mangé A, et al. FKBP4 connects mTORC2 and PI3K to activate the PDK1/Akt-dependent cell proliferation signaling in breast cancer. Theranostics. 2019;9(23):7003-7015.
- Meng W, et al. FKBP4 Accelerates Malignant Progression of Non-Small-Cell Lung Cancer by Activating the Akt/mTOR Signaling Pathway. Analytical cellular pathology (Amsterdam) 2020;2020:6021602.
- Xiu-Ying H, et al. PDGFBB facilitates tumorigenesis and malignancy of lung adenocarcinoma associated with PI3K-AKT/MAPK signaling. Sci Rep. 2024;14(1):4191.
- Sharma D, Singh M, Rani R. Role of LDH in tumor glycolysis: Regulation of LDHA by small molecules for cancer therapeutics. Semin Cancer Biol. 2022;87:184-95.
- Zhang P, et al. An Epithelial-Mesenchymal Transition-Based Prognostic Model for Survival Prediction in Lung Adenocarcinoma: COL5A2 and ZEB2. Current gene therapy 2026.
- Xu X, et al. Proteomic landscape of lung adenocarcinoma precancerous lesions reveals mitochondrial dsRNA-associated immune and stress responses. American journal of cancer research 2025;15(9):3888-3903.
- Li P, et al. Peripheral blood mononuclear cell DNA methylation biomarkers for prognostic stratification in Chinese lung adenocarcinoma: a genome-wide epigenetic profiling study. Clinical Epigenetics 2025;17(1):177.
- Chaudhary S, et al. Dissecting the MUC5AC/ANXA2 signaling axis: implications for brain metastasis in lung adenocarcinoma. Exp Mol Med. 2024;56(6):1450-60.
- Kondrup M, Nygaard AD, Madsen JS, Bechmann T. S100B as a biomarker for brain metastases in patients with non-small cell lung cancer. Biomed Rep. 2020;12(4):204-8.
- Jones L, Naidoo M, Machado LR, Anthony K. The Duchenne muscular dystrophy gene and cancer. Cell Oncol (Dordr). 2021;44(1):19-32.
- Peng G, Yan J, Shi P, Li H. LINC01140 Hinders the Development of Breast Cancer Through Targeting miR-200b-3p to Downregulate DMD. Cell Transplant. 2023;32:9636897231211202.
- Alnassar N, et al. Downregulation of Dystrophin Expression Occurs across Diverse Tumors, Correlates with the Age of Onset, Staging and Reduced Survival of Patients. Cancers (Basel). 2023;15(5):1378.
- Luce LN, Abbate M, Cotignola J, Giliberto F. Non-myogenic tumors display altered expression of dystrophin (DMD) and a high frequency of genetic alterations. Oncotarget. 2017;8(1):145-55.
- Hu Z, et al. IL6-STAT3-C/EBPβ-IL6 positive feedback loop in tumor-associated macrophages promotes the EMT and metastasis of lung adenocarcinoma. J Exp Clin Cancer Res. 2024;43(1):63.
- Ugel S, Canè S, De Sanctis F, Bronte V. Monocytes in the Tumor Microenvironment. Annu Rev Pathol. 2021;16:93-122.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Перепечатки и разрешения
Эта статья была опубликована
Видео скоро будет доступно