Этот протокол описывает, как построить, обучить и оценить многовидную структуру Vision Mamba U-shaped Network для сегментации медицинских изображений, позволяющую воспроизводимую сегментацию кожных поражений и органов брюшной полости через стандартизированную подготовку наборов данных, внедрение моделей и оценку эффективности.
Для просмотра этого контента требуется подписка на JoVE. Войдите или начните свой бесплатный пробный период.
Методическая статья
Мульти-view Vision Mamba U-образная сетевая структура для сегментации медицинских изображений
В этой статье
Краткое содержание
Аннотация
Сегментация медицинских изображений требует вычислительных методов, которые точно фиксируют глобальный контекст, локальные границы и многомасштабные анатомические структуры, оставаясь при этом воспроизводимыми в различных приложениях. В этой статье представлен протокол для построения, обучения и оценки фреймворка Multi-view Vision Mamba U-shaped Network для двумерной сегментации медицинских изображений. Протокол обеспечивает воспроизводимый рабочий процесс, включающий сбор публичных наборов данных, предварительную обработку изображений и масок, построение сети, обучение моделей, выбор контрольных точек, а также количественную и качественную оценку производительности. Фреймворк включает многовидное сканирование признаков для захвата дополнительной пространственной, контурной, масштабной и граничной информации, а также применяет многоступенчатое слияние признаков в U-образной архитектуре энкодер-декодера для улучшения интеграции признаков во время сегментации. Протокол демонстрируется на основе общедоступных наборов данных по кожным поражениям и сегментации органов брюшной полости. В описанном рабочем процессе реализации фреймворк достигает конкурентоспособной сегментации с использованием стандартных метрик оценки. Следуя процедурам, представленным в этом протоколе, исследователи могут воспроизводить реализацию модели, обучать сеть с использованием определённых экспериментальных параметров, оценивать производительность сегментации и адаптировать рабочий процесс для связанных задач сегментации медицинских изображений, требующих воспроизводимого анализа на основе глубокого обучения.
Введение
Сегментация медицинских изображений является фундаментальной задачей в области компьютерного зрения и анализа медицинских изображений 1,2,3. Это включает разбиение изображения на несколько областей или объектов для дальнейшего анализа и обработки. Эта технология особенно важна в медицинской визуализации, поскольку помогает клиницистам выявлять и локализовать патологические области, тем самым повышая точность диагностики и планирование лечения. С развитием технологий медицинской визуализации, таких как магнитно-резонансная томография (МРТ), компьютерная томография (КТ) и позитронно-эмиссионная томография (ПЭТ), спрос на точные методы сегментации медицинских изображений продолжает расти. Современные методы сегментации медицинских изображений можно в широком смысле разделить на три основных подхода: методы на основе сверточной нейронной сети(CNN) 4, методы на основетрансформаторов 5 и методы на основе модели пространства состояний (SSM) 6,7. Методы на основе CNN обычно используют U-образные сетевые архитектуры для сегментации медицинских изображений. Наиболее широко используемая архитектура в этой категории —U-Net 8, которая продемонстрировала эффективность U-образной архитектуры энкодер-декодер для сегментации биомедицинских изображений. U-Net3+ сочетает плотные пропускные соединения из UNet++9 с полномасштабными пропускными соединениями для улучшения многомасштабной агрегации признаков. Однако методы, основанные на CNN, имеют ограниченные возможности для захвата долгосрочных зависимостей и, следовательно, могут не эффективно моделировать контекстную информацию для дальнего расстояния.
Методы на основе трансформаторов эффективно фиксируют дальние зависимости с помощью механизма самовнимания, который позволяет параллельно вычислять и назначать разные веса внимания разным областям интереса. UNETR++10 вводит модуль Efficient Paired Attention (EPA) для снижения количества параметров и вычислительных затрат. nnFormer 11 объединяет перемежающиеся сверточные и самовнимательные операции и вводит локально-глобальный объемный механизм самовнимания для обучения объемных представлений в трёхмерной (3D) медицинской сегментации изображений. H2Former12 предлагает эффективный иерархический гибридный визуальный трансформер, сочетающий механизмы внимания с извлечением признаков на основе CNN в энкодере. Однако методы на основе трансформеров демонстрируют квадратичную вычислительную сложность с увеличением длины последовательности, что приводит к значительно большей вычислительной стоимости. Рисунок 1 иллюстрирует мотивацию MVM-UNet и сравнивает предложенную стратегию многовидного сканирования с существующими фреймворками сегментации на основе SSM.
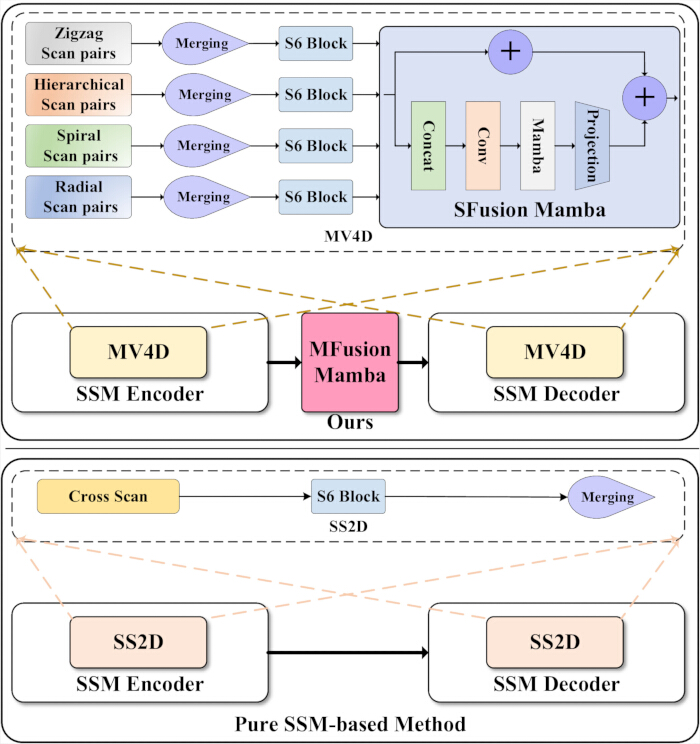
Рисунок 1. Сравнение MVM-UNet с существующими архитектурами сегментации на основе чисто пространственных моделей состояний (SSM). Сравнение традиционной модели сегментации на основе чистого пространства состояний (SSM) и предлагаемой архитектурой Multi-View Mamba U-Net (MVM-UNet). Верхняя панель иллюстрирует MVM-UNet, в котором модуль Multi-View 4-Directional (MV4D) извлекает взаимодополняющие признаки с помощью зигзагообразных, иерархических, спиральных и радиальных пар сканирования, интегрированных Spatial Fusion Mamba (SFusion Mamba), в то время как Multistage Fusion Mamba (MFusion Mamba) агрегирует многомасштабные элементы кодирования перед декодированием. Нижняя панель показывает представительную чисто SSM-архитектуру с использованием модулей Selective Scan 2-Dimensional (SS2D) с перекрёстным сканированием. На рисунке подчёркиваются архитектурные различия между традиционными сегментационными сетями на основе SSM и предлагаемым MVM-UNet. Пожалуйста, нажмите здесь, чтобы увидеть увеличенную версию этой фигуры.
Методы на основе SSM сочетают глобальные возможности моделирования трансформаторов с линейной вычислительной сложностью. Архитектура Mamba избирательно обрабатывает входную информацию с помощью селективной модели пространства состояний (Selective-SSM), позволяя модели динамически корректировать параметры в зависимости от входных данных, фильтруя нерелевантную информацию и делая акцент на информативных особенностях. Vim13 иVMamba 14 адаптируют архитектуру Mamba для задач компьютерного зрения. U-Mamba15 использует гибридную архитектуру CNN–SSM для изучения применения SSM в сегментации медицинских изображений, тогда как Mamba-UNet16 использует полностью архитектуру энкодер-декодер на основе SSM для сегментации медицинских изображений. Эти методы обеспечивают конкурентоспособную производительность при использовании значительно меньшего количества параметров. Однако современные методы на основе SSM/Mamba в основном извлекают особенности изображения с помощью простых патчей и стратегий SS2D-сканирования, которые имеют ряд ограничений для сегментации медицинских изображений. Во-первых, методы SS2D и патч-базы в первую очередь разработаны для общих задач компьютерного зрения. Local Mamba17 и MotionMamba 18 предположили, что стратегия сканирования SS2D недостаточна для всех визуальных задач, поскольку разные стратегии сканирования захватывают разные типы визуальной информации. Во-вторых, стратегия сканирования SS2D относительно проста, основана только на горизонтальных и вертикальных направлениях сканирования. В результате она может не зафиксировать сложные пространственные отношения и мелкие структурные детали. Сегментация медицинских изображений требует одновременного моделирования как глобального пространственного контекста, так и точных локальных анатомических особенностей. Кроме того, современные методы на основе SSM/Mamba обеспечивают ограниченное слияние функций между энкодером и декодером. Архитектуры, такие как UNet++ и FATNet, повышают точность сегментации за счёт улучшенного слияния признаков, подчёркивая важность эффективной интеграции признаков для сегментации медицинских изображений.
Для устранения этих ограничений в статье предлагается новая модель сегментации медицинских изображений на основе Mamba, называемая MVM-UNet. Как показано на рисунке 1, предлагаемый модуль Multi-View Four-Directional (MV4D) служит основным компонентом извлечения признаков MVM-UNet и специально разработан для сегментации медицинских изображений путём интеграции информации из четырёх различных стратегий сканирования. Каждая стратегия сканирования выделяет дополняющие элементы изображения и представляет разный вид входного изображения. Зигзагообразноесканирование 19 чередует направление движения в конце каждой строки или столбца, тем самым балансируя локальную и глобальную пространственную информацию. В отличие от этого, спиральные и радиальные схемысканирования 20 обеспечивают полное покрытие, распространяясь либо наружу от центра, либо внутрь с периферии. Иерархическоесканирование 18 фиксирует как локальные, так и глобальные признаки на различных масштабах. Для повышения надёжности каждой стратегии сканирования пары сканирования объединяются перед вводом в блок S6. Модуль Scan-view Fusion Mamba (SFusion Mamba) впоследствии интегрирует функции, извлечённые из четырёх модальностей сканирования. Для эффективного использования функций многомасштабного энкодера в этой статье также предлагается многомасштабный модуль синтеза Mamba (MFusion Mamba), который собирает и объединяет выходные данные с каждого этапа кодера перед передачей объединённых функций декодеру. MVM-UNet был оценен на наборах данных ISIC 2017, ISIC 2018 и Synapse. Экспериментальные результаты показывают, что MVM-UNet достигает конкурентоспособных результатов сегментации на наборах данных ISIC 2017, ISIC 2018 и Synapse.
Репрезентативные архитектуры сегментации привели к дальнейшему развитию сегментации медицинских изображений. U-Net также успешно применялся для анализа биомедицинских изображений, таких как подсчёт клеток, обнаружение иморфометрия 21. Архитектуры CNN, ориентированные на внимание, такие какCA-Net 22, улучшают представление признаков через комплексные механизмы внимания. Репрезентативные фреймворки сегментации на основе трансформеров, включая TransUNet23, Pyramid MedicalTransformer 24, SwinU-Net 25, TransAttUNet26 и TransCUNet27, дополнительно демонстрируют эффективность глобального моделирования признаков на основе внимания для сегментации медицинских изображений.
Дизайн MVM-UNet мотивирован двумя ограничениями существующих методов сегментации на основе SSM/Mamba. Во-первых, многие современные модели Vision Mamba используют простые двумерные стратегии сканирования, которые могут быть недостаточны для медицинских изображений с неправильными границами поражений, небольшими целями и многомасштабными анатомическими структурами. Во-вторых, традиционные U-образные архитектуры энкодер-декодера в основном передают функции через соответствующие пропускные соединения, что ограничивает прямое использование многоступенчатой информации энкодера при декодировании. Поэтому MVM-UNet вводит MV4D для улучшения многовидного пространственного моделирования и MFusion Mamba для явного агрегирования многоступенчатых функций энкодера. Эта конструкция направлена на адаптацию дальнодействующего моделирования на основе Mamba к специфическим требованиям сегментации медицинских изображений.
Хотя MVM-UNet построен на общей парадигме энкодер–декодер и моделировании последовательностей на основе Mamba, его новизна заключается в том, как эти компоненты адаптируются и интегрируются для сегментации медицинских изображений. Вместо простого включения стандартного блока Mamba в U-образную основную основу сети, предлагаемый фреймворк перерабатывает процесс пространственного моделирования через несколько задачно-ориентированных пар сканирования, вводит SFusion Mamba для интеграции специфических для сканирования представлений, улучшает MVV Block с помощью остаточных и проекционных путей, а также вставляет MFusion Mamba между энкодером и декодером для агрегирования многоступенчатых особенностей кодера перед декодированием. Этот архитектурный дизайн направлен на устранение неправильных границ, малых целевых областей и многомасштабных анатомических структур, часто наблюдаемых на медицинских изображениях.
Этот протокол наиболее подходит для задач сегментации, требующих одновременного моделирования дальнодействующей контекстной информации, неправильных границ объектов и многомасштабных анатомических структур в двумерных медицинских изображениях. По сравнению с методами сегментации на основе CNN, дизайн энкодер-декодер на базе Mamba обеспечивает эффективный механизм контекстного моделирования, сохраняя при этом U-образный рабочий процесс, знакомый исследователям сегментации медицинских изображений. По сравнению с методами на основе трансформеров, предлагаемая структура избегает прямого использования квадратичного самовнимания и предназначена для исследователей, стремящихся к глобальному контекстному моделированию с использованием относительно эффективного механизма моделирования последовательностей. Соответственно, этот протокол подходит для сегментации поражений кожи, сегментации органов брюшной полости и аналогичных двухмерных задач сегментации медицинских изображений, где важны как глобальная структурная информация, так и локальные границы.
Этот протокол также имеет ограничения, которые следует учитывать перед использованием. Это может быть не обязательно для относительно простых задач сегментации, когда лёгкий CNN уже обеспечивает достаточную производительность. Кроме того, он не предназначен напрямую для полной трёхмерной объемной сегментации без архитектурной адаптации. Исследователи с очень ограниченными аннотированными данными, ограниченными ресурсами графических процессоров (GPU) или требованием к высокоинтерпретируемым классическим моделям также должны учитывать эти ограничения перед применением протокола. В целом, этот метод предназначен для исследователей, стремящихся воспроизвести и оценить U-образную сегментационную структуру на базе Mamba, которая балансирует долгосрочное моделирование контекста, локальное представление границ и многоступенчатое слияние признаков.
Ключевые вклады следующие:
1. В этой статье представлена новая модель сегментации медицинских изображений на основе Mamba, называемая MVM-UNet. В отличие от подходов, которые напрямую включают существующие блоки на базе SS2D или стандартные блоки Mamba, MVM-UNet вводит MV4D для моделирования медицинских характеристик изображений на основе четырёх комплементарных пар сканирования, включая зигзагообразное, иерархиальное, спиральное и радиальное сканирование.
2. В данной статье разрабатывается SFusion Mamba и MVV Block для интеграции специфических для сканирования представлений и улучшения трансформации признаков. SFusion Mamba объединяет признаки, извлечённые из разных ветвей пар сканирования, тогда как остаточные и вверх-вниз проекции в блоке MVV обеспечивают дополняющие пути признаков, которые стабилизируют и обогащают представления признаков.
3. В этой статье представлена MFusion Mamba как промежуточный многоступенчатый модуль синтеза между энкодером и декодером. В отличие от обычных пропускных соединений, которые в основном передают соответствующие этапные характеристики, MFusion Mamba явно агрегирует многоступенчатые элементы энкодера посредством крупно-тонкого синтеза и предоставляет обогащённую информацию для декодирования.
4. Обширные экспериментальные результаты показывают, что предлагаемый MVM-UNet обеспечивает конкурентоспособную сегментацию на наборах данных ISIC 2017 и ISIC 2018, а также высокие показатели на наборе мультиорганной сегментации Synapse. Кроме того, комплексные исследования абляции подтверждают вклад каждого компонента в MVM-UNet.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Протокол
В этом исследовании использовались только общедоступные и деидентифицированные наборы данных медицинских изображений, включая ISIC 2017, ISIC 2018 и Synapse. В этом исследовании не было собрано новых участков людей, животных или идентифицируемых частных медицинских записей. Набор данных ISIC 2017, использованный в этом исследовании, — это сегментационный набор данных ISIC 2017 Challenge по кожным поражениям, полученный из официального репозитория данных International Skin Imaging Collaboration (https://challenge.isic-archive.com/data/#2017). Версия набора данных, использованная в этом исследовании, соответствует задаче сегментации поражений ISIC 2017, включая официальные разделы обучения, валидации и тестирования. Набор данных был загружен 15 марта 2024 года. Набор данных ISIC 2018, использованный в этом исследовании, — это набор данных по сегментации границ поражения ISIC Challenge 2018 2018, полученный из официального репозитория данных International Skin Imaging Challenge (https://challenge.isic-archive.com/data/#2018). Версия набора данных, используемая в этом исследовании, соответствует задаче ISIC 2018 Задача 1: Сегментация границ поражения. Набор данных был загружен 8 июля 2024 года.
Набор данных Synapse, использованный в этом исследовании, — это набор данных Multi-Atlas Labeling Beyond the Cranial Vault брюшной КТ, полученный из репозитория Synapse под идентификатором присоединения syn3193805 (https://www.synapse.org/Synapse:syn3193805). Использованный в этом исследовании набор данных соответствует широко используемому набору данных по сегментации КТ брюшной полости с 30 случаями. Скачанный архив назывался Abdomen/RawData.zip, доступен под номером syn3193805. На момент скачивания репозиторий не предоставил отдельный номер версии, ярлык релиза или датированный тег. В соответствии со стандартным разделением, принятым в предыдущих исследованиях, 18 кейсов использовались для обучения, а 12 — для тестирования. Разделение данных соответствовало списку случаев, использованному TransUNet23. В частности, обучающие случаи были case0031, case0007, case0009, case0005, case0026, case0039, case0024, case0034, case0033, case0030, case0023, case0040, case0010, case0021, case0006, case0027, case0028 и case0037, тогда как тестовыми случаями были case0008, case0022, case0038, case0036, case0032, case0002, case0029, case0003, case0001, case0004, case0025 и case0035. Набор данных был загружен 9 июля 2024 года. Поскольку в этом исследовании использовались только общедоступные, деидентифицированные наборы данных и не включали сбор новых данных о людях или идентифицируемой личной информации, одобрение институционального экспертного совета для вычислительных экспериментов, описанных в этом протоколе, не требовалось. Официального письменного решения об освобождении от учреждения не было получено. Если это требует местная институциональная политика, исследователи должны получить определение об освобождении до проведения вторичного анализа общедоступных наборов данных. Для этого исследования не было доступен референсный номер об освобождении от институциональной этики или формальная документация об освобождениях.
1. Подготовка наборов данных
- Скачайте набор данных по сегментации кожных поражений ISIC 2017 из официального репозитория International Skin Imaging Colpository. Используйте официальные разделы для обучения, валидации и тестирования. Проверьте, содержит ли набор данных 2000 обучающих изображений, 150 изображений валидации и 600 тестовых изображений.
- Скачайте набор данных по сегментации кожных поражений ISIC 2018 из официального репозитория International Skin Imaging Collaboration. Используйте официальные разделы для обучения, валидации и тестирования. Проверьте, содержит ли набор данных сегментации 2 594 обучающих изображений, 100 изображений валидации и 1 000 тестовых изображений.
- Скачайте набор данных Synapse по сегментации мультиорганов. Используйте стандартное разделение, состоящее из 18 случаев (2 212 осевых срезов) для обучения и 12 случаев (1 567 осевых срезов) для тестирования. Не вводите отдельный набор валидации.
- Зарезервируйте 12 тестовых случаев исключительно для окончательной оценки. Не используйте тестовые случаи для обучения моделей, настройки гиперпараметров или выбора модели. Задача сегментации включает восемь органов брюшной полости: аорту, желчный пузырь, селезёнку, левую почку, правую почку, печень, поджелудочную железу и желудок.
- Используйте следующий раздел набора данных Synapse. 18 обучающих случаев: case0031, case0007, case0009, case0005, case0026, case0039, case0024, case0034, case0033, case0030, case0023, case0040, case0010, case0021, case0006, case0027, case0028 и case0037. 12 тестовых случаев: case0008, case0022, case0038, case0036, case0032, case0002, case0029, case0003, case0001, case0004, case0025 и case0035.
- Организуйте каждый набор данных в отдельные папки с изображениями и масок. Убедитесь, что у каждого изображения есть соответствующая маска сегментации с одинаковым идентификатором случая.
- Преобразуйте каждую маску поражения кожи в бинарную карту сегментации переднего и заднего плана. Сохраняйте оригинальные метки многоклассных органов для набора данных Synapse.
- Для наборов данных ISIC 2017 и ISIC 2018 после преобразования двоичной маски присваивается значение меток 0 для фоновых пикселей и 1 пикселям на переднем плане. Пиксели с исходными значениями маски больше 0 рассматриваются как передний план и преобразуются в 1, тогда как пиксели с исходными значениями маски равными 0 рассматриваются как фон и сохраняются как 0. Для набора данных Synapse сохраняйте исходные значения целых меток: 0 — фоновый класс, а 1–8 — восемь классов органов переднего плана.
- Измените размер изображений и масок ISIC 2017 и ISIC 2018 до 256 × 256 пикселей без сохранения исходного соотношения сторон. Не наносите обрезку или подкладку.
- Измените размер каждого среза Synapse CT и соответствующего отображения меток до 224 × 224 пикселей. Используйте билинейную интерполяцию для RGB-изображений, интерполяцию сплайна третьего порядка для CT-срезов и интерполяцию ближайших соседей для сегментационных масок.
- Изменяйте размер изображений в Python.
- Для наборов данных ISIC 2017 и ISIC 2018 используйте пользовательское преобразование myResize, реализованное в utils.py, которое вызывает torchvision.transforms.functional.resize для изменения размера тензоров изображения и маски до 256 × 256 пикселей. Не указывайте явный режим интерполяции или аргумент сглаживания в этом преобразовании.
- Для набора данных Synapse используйте scipy.ndimage.zoom в datasets/dataset.py. Измените размер срезов изображения CT до 224 × 224 пикселей с помощью интерполяции сплайна третьего порядка (порядок = 3), а также измените размер отображений меток с помощью интерполяции ближайших соседей (order = 0). При изменении размера не применяйте отдельную операцию сглаживания или anti_aliasing=Истинную настановку.
- Нормализуйте каждое изображение ISIC RGB перед тензорным преобразованием, используя специфичное для набора данных среднее значение и стандартное отклонение (SD) с помощью уравнения 1 следующим образом:
 (1)
Затем масштабируйте нормированное изображение до диапазона 0–255 с помощью нормализации min–max.- Используйте μ = 159.922 и σ = 28.871 для обучающего набора ISIC 2017, а μ = 148.429 и σ = 25.748 для наборов валидации и тестирования ISIC 2017. Используйте μ = 157.561 и σ = 26.706 для обучающего набора ISIC 2018, а μ = 149.034 и σ = 32.022 для наборов валидации и тестирования ISIC 2018.
- Преобразуйте каждое нормализованное изображение в тензор формы 3 × 256 × 256. Преобразуем каждую бинарную маску в тензор формы 1 × 256 × 256.
- Выполнять минимально-максимальную нормализацию независимо для каждого изображения после нормировки среднего, специфичного для набора данных, и стандартной нормировки отклонения. В частности, вычтите среднее, специфичное для набора данных, из каждого изображения и делите на соответствующее стандартное отклонение.
- Вычислите минимальные и максимальные значения интенсивности из нормализованного изображения и перемасштабируйте изображение до диапазона 0–255, используя эти значения минимального и максимального значения на изображение. Не используйте минимальные и максимальные значения по всему набору данных для этого этапа минимального и максимального масштабирования.
- Подготовьте каждый срез Synapse CT в виде двумерного изображения в оттенках серого. Преобразуйте каждый срез CT в float32 и добавьте размер канала с одним тоном, чтобы получить входной тензор с формой 1 × 224 × 224.
- Сохраняйте каждую карту меток Synapse как одноканальную целочисленную маску с формой 224 × 224. Не применяйте дополнительную нормализацию среднего SD на уровне набора данных в загрузчике данных.
- Используйте предварительно обработанные файлы Synapse, предоставленные в формате .npz, для обучающих срезов и формат .npy.h5 для тестирования томов. Загружайте массивы изображений и меток напрямую из каждого .npz-файла во время обучения и напрямую из каждого файла .npy.h5 во время тестирования. Не применяйте дополнительное обрезывание интенсивности, CT-окно, нормализацию на уровне набора данных или пересэмплирование по сырому объему в освобождённом загрузчике данных.
- Во время обучения модели преобразуйте каждый загруженный двумерный срез в float32, измените его размер до целевого пространственного размера с помощью scipy.ndimage.zoom с указанием порядка = 3 для срезов изображения и порядка = 0 для отображения меток, а затем преобразуйте изменённые массивы в тензоры с размером одного канала.
- Применяйте дополнение данных только к обучающему набору. Для ISIC 2017 и ISIC 2018 применяйте случайное горизонтальное переворот (p = 0,5), случайное вертикальное переворот (p = 0,5) и случайное вращение (p = 0,5) с углом, отобранным от 0° до 360°.
- Примените одинаковое геометрическое преобразование к каждой паре изображение-маска. Во время валидации и тестирования применяйте только изменение размера, нормализацию и преобразование тензоров.
- Для набора данных Synapse применяйте случайное вращение и случайное переворот во время обучения. Случайным образом повернуть каждую пару изображение-метка на k × 90°, где k ∈ {0,1,2,3}, случайным образом перевернуть пару изображение-метка вдоль одной пространственной оси или случайным образом повернуть пару изображение-метка под углом, отобранным от −20° до 20°.
- Не применяйте стохастическое усиление во время тестирования.
- Примените дополнение данных к набору данных Synapse с помощью взаимоисключающих ветвей, реализованных в преобразовании RandomGenerator.
- Для каждой обучающей выборки сначала оценивают состояние random.random() > 0.5. Если это условие выполнено, применяют random_rot_flip, состоящий из случайного поворота на 90° (k = 0, 1, 2 или 3), за которым следует случайный переворот вдоль одной пространственной оси.
- Если первая ветвь не выбрана, вычислите второе условие random.random() > 0.5. Если это условие выполнено, применяйте random_rotate случайно выбранным углом вращения между −20° и 20°. Если ни одно из условий не удовлетворяется, не применяйте стохастическое дополнение к образцу.
- Примените одно и то же преобразование как к входному образу, так и к соответствующей отображению меток.
- Задайте случайный сид до загрузки, предварительной обработки и обучения датасетов. Используйте случайные семена 1, 52 и 100 для основных сравнительных экспериментов и семя 100 для исследований абляции, если не указано иное.
- Инициализируйте генераторы случайных случаев Python, NumPy, PyTorch, PyTorch CUDA и cuDNN перед созданием загрузчика данных. Сохраняйте без изменений разделы датасетов, процедуры предварительной обработки, настройки дополнения, параметры нормализации, стратегию изменения размера и предварительную обработку оценки во всех запусках seed.
- Установите num_workers = 0 для экспериментов ISIC и Synapse для загрузки данных в основном процессе. Перед созданием набора данных и DataLoader инициализуйте глобальное случайное сидение с помощью функции set_seed для заседа генераторов случайных чисел Python, NumPy, PyTorch, PyTorch CUDA и cuDNN. Не определяйте отдельный worker_init_fn или специфический для DataLoader генератор случайных случаев, так как они не используются в выпущенной реализации.
2. Создание архитектуры MVM-UNet
- Постройте предлагаемую Multi-view Vision Mamba UNet (MVM-UNet) с использованием U-образной архитектуры энкодер-декодера.
- Установить размерность входного изображения на H × W × 3. Пропустите входное изображение через слой вложения патча.
- Реализуйте слой вложения патча с использованием 2D-свёртки с размером ядра 4 × 4, шагом 4, тремя входными каналами и 96 выходными каналами.
- Преобразуйте карту входных признаков в пространственное разрешение H/4 × W/4 с C = 96 выходных каналов.
- Постройте четыре стадии энкодера и четыре стадии декодера. Уменьшить пространственное разрешение вдвое и удвоить размер канала после каждого этапа энкодера.
- Используйте симметричную конфигурацию энкодер-декодер. Установите количество блоков MVV в обоих кодировщике и декодере в {2, 2, 2, 2}.
- Разместите по два блока MVV на каждом этапе энкодера и по два блока MVV на каждом этапе декодера.
- Вставьте блок MVV в каждый этап кодера и декодера. Используйте модуль MV4D как модуль извлечения основных элементов внутри каждого блока MVV.
- Вставьте модуль MFusion Mamba между энкодером и декодером. Используйте этот модуль для объединения многоступенчатых энкодеров перед декодированием.
- Настройте общий рабочий процесс MVM-UNet. Используйте MV4D для извлечения признаков по всему энкодере.
- Сохраняйте выходы энкодера как пропускные соединения. Передайте выходы энкодера соответствующим ступеням декодера.
- Передайте функции кодировщика MFusion Mamba перед декодированием. Постепенно увеличивайте образ слияния через декодер и генерируйте финальную карту сегментации с помощью сегментационной головки.
- Пропустите входное изображение I ∈ RB×H×W× 3 через слой вложения патча, чтобы получить
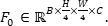 здесь C = 96.
- Генерируйте карты признаков энкодера: E 1 ∈ RB×H/4×W/4×C, E 2 ∈ R B×H/8×W/8×2 C, E3 ∈R B×H/16×W/16×4 C, и E4 ∈R B×H/32×W/32×8C. Используйте блоки MVV, содержащие MV4D, на каждом этапе энкодера.
- Сохраняйте все функции кодировщика для соответствующего пропускающего соединения. Передайте все функции кодировщика MFusion Mamba для многоступенчатого синтеза функций.
- Выровнять признаки энкодера с общим пространством признаков до грубого и тонкого слияния внутри MFusion Mamba. Передайте слитое представление декодеру.
- Постепенно увеличивайте представление декодера. Объедините функции декодера с E3 на H/16 × W/16, E 2 на H/8 × W/8 и E1 на H/4 × W/4.
- Увеличите размер финальной функции декодера до исходного разрешения изображения. Сгенерируйте карту
 предсказания ∈ RB×H×W×K. Здесь K = 1 для сегментации двойных поражений и K = 8 для сегментации мультиорганов Synapse.
- См. рисунок 2 для общей архитектуры сети и дополнительную таблицу 1 для полной спецификации архитектуры по слоям, включая операции, основные параметры и размеры выходных признаков для каждого этапа
- Переходные слои кодировщик–декодер
- Функция энкодера понижения сэмплирования с использованием переходных слоёв с объединением патчей. Для каждого перехода возьмите выборку четырёх пространственно перемежающихся групп признаков из окрестности 2 × 2, соедините их вдоль размера канала, примените нормализацию слоя (LayerNorm) и проецируйте полученную 4C-мерную особенность на 2C-каналы с помощью линейного слоя без смещения. Эта операция уменьшает пространственное разрешение в 2 раза и удваивает размер канала.
- Функции апсемплирования декодера с использованием переходных слоёв расширения патчей. Примените линейную проекцию без смещения, пространственно перестановите расширенные признаки для увеличения разрешения в 2 раза и примените LayerNorm после пространственного расширения. Повторите эту операцию для постепенной реконструкции карт признаков от H/32 × W/32 до H/16 × W/16, H/8 × W/8 и H/4 × W/4.
- Выровнять признаки энкодера в модуле MFusion Mamba, переразмерив их до целевого пространственного разрешения с помощью билинейной интерполяции (align_corners = False), а затем применить обучаемую линейную проекцию канала перед слиянием признаков.
- Сегментационная головка
- Увеличите дискретизацию финальной карты функций декодера с H/4 × W/4 до исходного разрешения изображения (H × W) с помощью финального слоя расширения патча. Примените линейную проекцию, выполните пространственную перепланировку с коэффициентом расширения 4 и примените LayerNorm.
- Спроектируйте реконструированную карту функций на выходные каналы K, используя свёртку 1 × 1 после преобразования тензора в формат канал-первый.
- Сгенерируйте окончательное предсказание во время оценки, применяя сигмоидную активационную функцию для сегментации бинарных поражений или softmax-активацию, а затем argmax для сегментации мультиорганов Synapse. Не применяйте активационную функцию непосредственно в сегментационной головке.
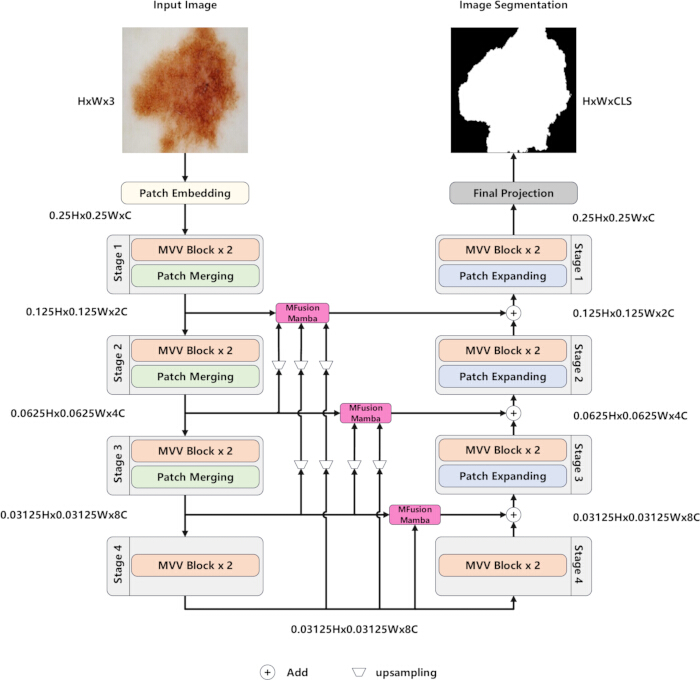
Рисунок 2. Общая архитектура Multi-View Mamba U-Net (MVM-UNet). Обзор предлагаемой архитектуры Multi-View Mamba U-Net (MVM-UNet). Входное изображение преобразуется в патч-эмбеддинги и обрабатывается через четыре этапа кодирования, состоящих из блоков Multi-View Vision (MVV), разделённых операциями объединения патчей. Особенности энкодера агрегируются многоступенчатыми термоядерными Mamba (MFusion Mamba) и распространяются на декодер через пропускные соединения. Декодер постепенно восстанавливает пространственное разрешение с помощью операций расширения патчей и генерирует итоговую карту сегментации через проекционный слой. Пожалуйста, нажмите здесь, чтобы увидеть увеличенную версию этой фигуры.
3. Создание модуля MV4D
- Используйте модуль MV4D в качестве базового блока извлечения признаков в блоке MVV. Подайте вводные патчи в четыре пары сканирования. См. Алгоритм 1, Дополнительный файл 1 для полного псевдокода пространственного выравнивания, построения индекса пар сканирования, сбора последовательностей, обработки S6/Mamba, обратного пространственного перепорядка, слияния пар сканирования, слияния SFusion Mamba, проекции и перестройки выхода.
- Используйте точные зигзагообразные, иерархические, спиральные и радиальные процедуры генерации индексов сканирования, реализованные в моделях/mvmunet/core.py. Для каждой стратегии сканирования используйте прямой порядок сканирования и его обратный порядок как одну пару двунаправленного сканирования.
- Постройте пару зигзагообразного сканирования. Пройдите по объектам изображения в чередующихся направлениях в конце каждой строки или столбца. Используйте этот паттерн сканирования для балансировки локальной и глобальной пространственной информации.
- Постройте иерархическую пару сканирования. Функции захвата на нескольких пространственных масштабах. Используйте этот паттерн сканирования для усиления извлечения как локальных, так и глобальных представлений.
- Постройте пару спирального сканирования. Отсканируйте объекты изображения от центра к границе или от границы к центру. Используйте этот паттерн сканирования для улучшения извлечения глобальной информации о контуре.
- Постройте пару радиального сканирования. Сканирующие изображения вдоль нескольких радиальных направлений. Используйте этот паттерн сканирования для улучшения извлечения локальных деталей границ и ребер.
- Объедините каждую пару сканирования перед тем, как ввести объединённую последовательность в блок S6. Используйте парный дизайн для повышения надёжности каждой стратегии сканирования при сохранении вычислительной эффективности.
- Подайте выходную последовательность каждой ветви пары сканирования в блок S6. Получите четыре представления признаков, соответствующих зигзагообразным, иерархическим, спиральным и радиальным сканирующим видам.
- Объединять четыре извлечённых представления признаков с помощью модуля SFusion Mamba. Используйте два параллельных пути термоядерного синтеза. В первом пути интегрируйте четыре признака путём сложения по элементам.
- Во втором пути SFusion Mamba объедините четыре признаки. Обработайте конкатенированное представление с помощью Conv1d и Mamba. Уменьшите размер канала с помощью проекционного слоя, чтобы соответствовать выходной размерности блока S6.
- Настройте блок S6/Mamba, используя размер признака C в качестве размера модели. Используйте проекционный слой для отображения каждой объединённой пары сканирования обратно к размеру канала C до слияния.
- В SFusion Mamba выполняйте сложение по элементам в первом пути. Объедините четыре признака сканирования во втором пути перед Conv1d, Mamba и линейной проекцией. Используйте нормализацию, линейную проекцию, глубинную сепарабельную свёртку и операции активации, связанные с MV4D, как описано в шаге 4.
- Добавьте выходы двух путей синтеза, чтобы получить итоговый выход модуля MV4D.
- Постройте четыре дополняющие парные ветви сканирования вместо использования только горизонтальных и вертикальных направлений сканирования. Используйте зигзагообразное сканирование для акцента на непрерывном пространственном переходе, иерархическое сканирование для усиления многомасштабного представления, спиральное сканирование для захвата информации о контурах от центра до границы и радиальное сканирование для улучшения локального выделения локальных деталей, ориентированных на границы.
- Обрабатывайте каждую ветвь пары сканирования независимо. Объедините полученные признаки с помощью SFusion Mamba. Отобразите каждую обработанную последовательность обратно в её исходный пространственный порядок до слияния.
- Имея входное отображение признаков X ∈ RB×H×W×C, сравняем её на X seq ∈ RB×L×C, где L = H × W.
- Перестройте сплющенную последовательность в соответствии с индексами сканирования для каждой ветви пары сканирования. Обрабатывайте каждую перестроенную последовательность с помощью блока S6. Восстановить обработанную последовательность в исходном пространственном порядке.
- Объедините четыре функции сканирования через аддитивный путь и путь SFusion Mamba для получения конечного результата MV4D. См. рисунок 3 для архитектуры MV4D и алгоритма 1, дополнительный файл 1 для полного тензорного рабочего процесса реализации.
- Используйте полную программную реализацию в моделях/mvmunet/core.py. Этот файл содержит генераторы индекса сканирования: PairwiseScanMamba, SequenceS6, SFusion Mamba и модуль MV4D.
- Генерируйте индексы многопросмотрного сканирования
- Генерируйте индексы сканирования, следуя опубликованной реализации в моделях/mvmunet/core.py. Для входной карты признаков пространственного размера H × W выравните каждое расположение пикселя в одномерный индекс с помощью индекса: index = r × W + c, где re и c обозначают координаты строки и столбца соответственно.
- Генерируйте зигзагообразное сканирование, проходя диагонали изображения с постоянной r + c. Соберите допустимые индексы пикселей для каждой диагонали и чередуйте направление движения, меняя порядок каждой чётной диагонали.
- Сгенерируйте иерархическое сканирование, рекурсивно разделив изображение на четыре квадранта. Посещайте верхний левый, верхний правый, нижний левый и нижний правый квадранты последовательно, пока высота или ширина субрегиона не превышает 2 пикселей, а затем пройдите оставшиеся пиксели в порядке основных строк.
- Сгенерируйте спиральное сканирование, пройдя по внешней границе изображения слева направо вдоль верхнего ряда, вниз по правому столбцу, справа налево по нижнему ряду и вверх вдоль левого столбца, постепенно сужая границу к центру изображения.
- Генерируйте радиальное сканирование, сортируя каждый пиксель по его квадрату от центра изображения, а затем по его полярному углу, рассчитанному с помощью функции atan2.
- Генерируйте обратный скан для каждой стратегии сканирования, изменяя соответствующий порядок прямого сканирования. Комбинируйте прямую и обратную последовательность сканирования, чтобы получить одну пару для каждой стратегии сканирования перед передачей пар сканирования в модуль MV4D.
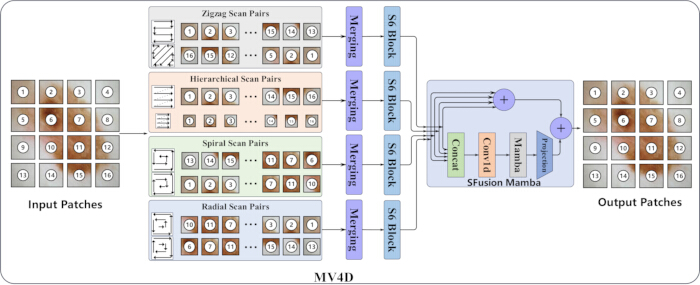
Рисунок 3. Архитектура модуля Multi-View 4-Directional (MV4D). Структура модуля извлечения признаков с многовидным видом в 4 направлениях (MV4D). Входные патчи обрабатываются через четыре комплементарные пары сканирования, включая зигзагообразное, иерархическое, спиральное и радиальное сканирование. Признаки, извлечённые из четырёх ветвей, объединяются, обрабатываются с помощью блоков пространства состояний и интегрируются Spatial Fusion Mamba (SFusion Mamba) для генерации выходного представления признаков. Пожалуйста, нажмите здесь, чтобы увидеть увеличенную версию этой фигуры.
4. Строительство блока MVV
- Постройте блок MVV, используя одну основную и две вспомогательные ветви. Используйте общую структуру, показанную на рисунке 4.
- Применить нормализацию слоя к входной особенности в главной ветви. Введите нормализованный признак в линейный слой. Передайте трансформированную особенность к разделяемой по глубине свертке.
- Обрабатывайте трансформированную особенность с помощью сепарабельной свёртки по глубине. Примените функцию активации GELU. Подключите активированную функцию в модуль MV4D.
- Постройте первую вспомогательную ветвь как остаточное соединение идентичности. Подключите входную функцию напрямую к конечному выходу. Используйте эту ветку для сохранения исходного представления и стабилизации тренировок.
- Постройте вторую вспомогательную ветвь как ветвь проекции вниз-вверх. Сжать входную функцию с помощью слоя проекции вниз. Восстановить размер признака с помощью слоя проекции вверх.
- Объедините выходы основной ветви и обеих вспомогательных ветвей. Получите финальный выход MVV Block. См. рисунок 4 для полной архитектуры.
- Установите скрытую размерность главной ветви равной размеру входного канала Cs. Примените LayerNorm(Cs) перед основной линейной проекцией и используйте линейный слой с размерами Cs→Cs. Используйте по глубине сепарабельную свёртку, состоящую из свёртки 3×3 по глубине с заполнением 1, группами = C s и отсутствием смещения, затем свёрткой по точкам 1×1 без смещения.
- Примените функцию активации GELU после сепарабельной свёртки по глубине. Введите активированную функцию в MV4D и примените выходную линейную проекцию размерами Cs→Cs. Настройте ветвь проекции вниз-вверх с помощью LayerNorm(Cs), коэффициента проекции 4, проекции Cs→Cs/4, активации GELU и проекции Cs/4→C s.
- Объедините тождествную ветвь, проекционную вверх ветвь и основную ветвь, обработанную по дроп-траектории, используя элементное сложение, чтобы получить итоговый выход MVV Block.
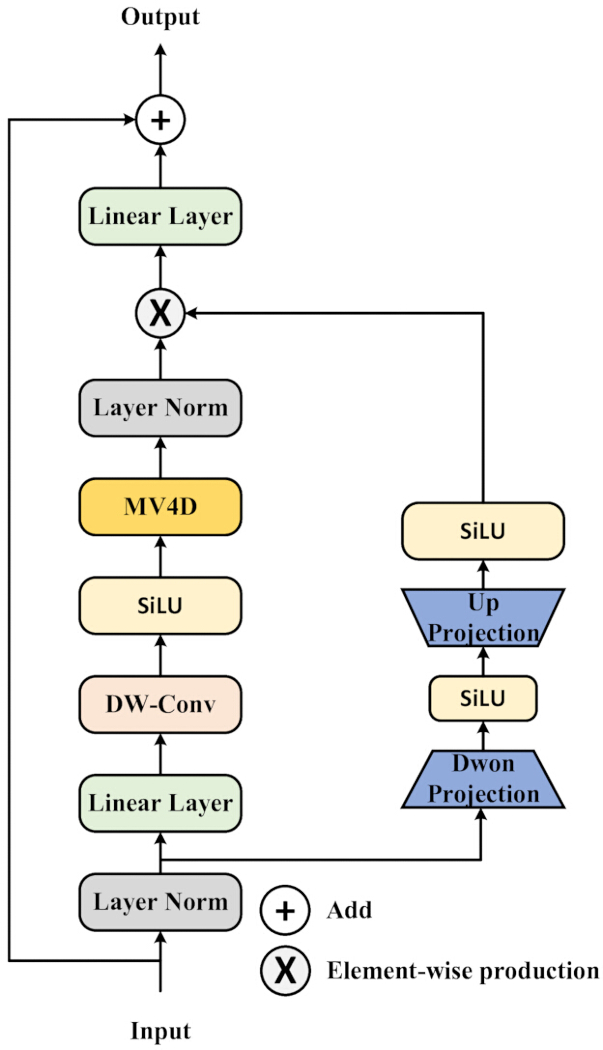
Рисунок 4. Архитектура блока Multi-View Vision (MVV). Структура блока многовидного зрения (MVV). Блок состоит из главной ветви выделения объектов, содержащей модуль Multi-View 4-Directional (MV4D) вместе с глубинными свертками, нормализацией и линейными проекционными слоями. Вспомогательная ветвь проекции вверх-вниз обеспечивает модуляцию элементов с помощью элементного умножения перед остаточным сложением для получения выходного представления признаков. Пожалуйста, нажмите здесь, чтобы увидеть увеличенную версию этой фигуры.
5. Строительство MFusion Mamba
- Собирайте карты функций со всех уровней энкодера. Выровняйте функции кодировщика по единому пространству представлений, изменяя их размер или проецируя при необходимости. См. Алгоритм 2, Дополнительный файл 1 для полного тензорного рабочего процесса реализации.
- При необходимости изменяйте размер функций энкодера до целевого пространственного разрешения. Проектировать функции с разными размерами канала в одну и ту же часть канала. Выровняйте все функции энкодера перед многоступенчатым синтезом.
- Введите выровненные функции энкодера в компонент грубого синтеза. Проведите грубое сплавление с использованием продукта Hadamard. Сгенерируйте грубое сплавленное представление.
- Введите грубое сплавленное представление в компонент тонкого синтеза. Постройте два параллельных пути тонкого синтеза. Обрабатывайте оба пути отдельно.
- Обработайте первый путь тонкого синтеза с помощью линейного слоя. Обработайте второй путь тонкого синтеза с помощью восходящей проекции, Conv1d, Mamba и нисходящей проекции. Восстановить измерение признака после проекции вниз.
- Объединить выходы двух путей тонкого синтеза с помощью произведения Адамара. Примените последний линейный слой. Получите выход MFusion Mamba.
- Введите выход MFusion Mamba в декодер. Декодировать слитое многоступенчатое представление вместе с функциями пропуска энкодер-декодер. Сгенерируйте окончательную карту сегментации.
- Выровнять признаки энкодера с разных уровней в единое пространство признаков до грубого синтеза. Обработайте выровненные представления с помощью крупных и тонких стадий плавления. См. рисунок 5 для архитектуры MFusion Mamba и Дополнительного алгоритма 2 для полного рабочего процесса реализации на тензорном уровне.
- Используйте параметры реализации MFusion Mamba следующим образом. Для каждой особенности энкодера Ei проецируйте размерность канала от Ci к Ct. Изменение размера проекционируемых объектов до целевого пространственного размера с помощью билинейной интерполяции с align_corners=False при необходимости.
- Примените продукт Hadamard для выполнения грубого синтеза по выровненным признакам энкодера. Настройте первый путь тонкого синтеза с помощью линейного слоя размеров Ct → Ct. Настройте второй путь тонкого синтеза, используя восходящую проекцию Ct → 2Ct, Conv1d, блок Mamba/S6 с размерностью модели 2Ct, направлением сканирования, измерением состояния 16 и нисходящей проекцией 2Ct → Ct.
- Объединяйте выходы путей тонкого синтеза с помощью продукта Адамара. Применим окончательную линейную проекцию размерностями Ct к Ct. Введите слитое многоступенчатое представление в декодер.
- Функции многоступенчатого энкодера с использованием MFusion Mamba
- Собрать функции кодировщика со всех четырёх ступеней кодировщика (E1,E 2, E3 и E4) и использовать их как вход для модуля MFusion Mamba. Не выбирайте только функцию соответствующего этапа кодирования для слияния декодеров.
- Выровнять все функции энкодера с пространственным разрешением, необходимым для текущей стадии декодера. Измените размер признаков энкодера до целевого разрешения и проецируете их до необходимого размера канала перед слиянием функций.
- Повторите процедуру выравнивания признаков для каждого этапа декодера. Когда декодер работает на H/16 × W/16, H/8 × W/8 и H/4 × W/4, изменяйте размер и проецируете E1,E 2,E 3 иE 4 в соответствующее целевое пространство признаков.
- Объединить выровненные многоступенчатые функции кодировщика с помощью операций грубого синтеза и тонкого синтеза модуля MFusion Mamba, а также объединить представление слияния с функциями декодера на соответствующем масштабе.
- Выполните операции проекции признаков, изменения размера и слияния в соответствии с опубликованной реализацией в моделях/mvmunet/core.py.
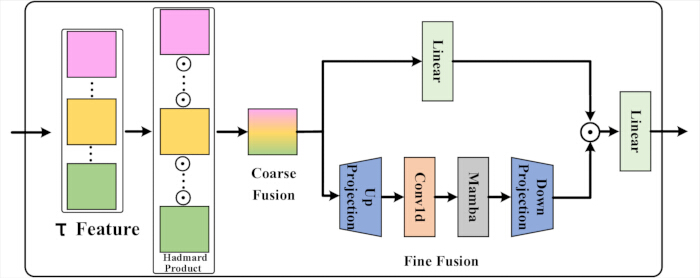
Рисунок 5. Архитектура модуля многоступенчатого термоядерного синтеза Mamba (MFusion Mamba). Структура модуля многоступенчатого термоядерного синтеза Mamba (MFusion Mamba). Многомасштабные признаки энкодера сначала объединяются крупным термоядерным синтезом, а затем дорабатываются через модуль Fine Fusion, состоящий из линейной проекции, одномерной свёртки (Conv1d), блока Mamba и слоёв проекции признаков, прежде чем создать представление слияных признаков, используемое декодером. Пожалуйста, нажмите здесь, чтобы увидеть увеличенную версию этой фигуры.
6. Обучение моделям
- Обучайте MVM-UNet на Ubuntu 22.04.1 с ядром Linux версии 6.8.0. Используйте рабочую станцию с процессором Intel Core i9-13900K 13-го поколения и видеокартой NVIDIA A800. Используйте одну и ту же аппаратную конфигурацию на протяжении всего обучения и оценки.
- Реализуйте и обучайте модель с использованием PyTorch 2.0.1 с CUDA 11.8. Установите все необходимые программные зависимости перед обучением.
- Используйте оптимизатор AdamW с начальной скоростью обучения 3 × 10⁻⁵, β1 = 0,9, β2 = 0,999, ε = 1 × 10⁻⁸ и затуханием веса 0,01. Установите размер партии на 32, если не указано иное.
- Обучайте каждую модель на протяжении 300 эпох. Используйте расписание косинусного отжига с частотой обучения сη min = 1 × 10⁻⁵. Установите размер входного изображения на 256 × 256 для ISIC 2017 и ISIC 2018 и на 224 × 224 для Synapse.
- Используйте три независимых случайных семена (1, 52 и 100) для основных сравнительных экспериментов. Повторите полный процесс обучения и оценки для каждого семя. Сообщайте итоговые количественные результаты как среднее ± SD по трём запускам.
- Используйте фиксированное случайное семено 100 для всех исследований абляции, если не указано иное. Сохраняйте без изменений разделы наборов данных, стратегию предварительной обработки, архитектуру сети, оптимизатор, скорость обучения, размер пакета и количество обучающих эпох во всех экспериментах по абляции.
- Используйте потерю BCE-Dice для сегментации бинарных поражений на ISIC 2017 и ISIC 2018. Установите BCE и вес для потери кубиков на 1.0. Используйте потерю CE-Dice для Synapse и установите как вес потерь по кросс-энтропии, так и Dice на 1.0.
- Изменяйте размер, нормализуйте и дополняйте обучающие изображения ISIC 2017 и ISIC 2018 с помощью процедуры предварительной обработки, описанной в Шаге 1. Примените изменение размера, случайное вращение и случайное переворот к обучающим изображениям Synapse, как описано в Шаге 1. Используйте одинаковые настройки предварительной обработки во всех тренировках.
- Выберите контрольные точки модели согласно протоколу валидации, специфичным для набора данных. Сохраняйте контрольную точку с лучшей валидацией для ISIC 2017 и ISIC 2018 и проводите валидацию каждые 30 эпох. Тренируйте Synapse на 300 эпох без валидационного набора и используйте финальную тренировочную контрольную точку для тестирования.
- Используйте официальный набор валидации только для выбора модели на ISIC 2017 и ISIC 2018. Не используйте набор тестирования Synapse для обучения, настройки гиперпараметров или выбора контрольных точек. Оставляйте все данные тестирования исключительно для окончательной оценки.
- Используйте следующие параметры обучения для воспроизводимости. Установите размер пакета на 32 для всех наборов данных. Используйте AdamW с начальной скоростью обучения 3 × 10⁻⁵, β1 = 0,9,β 2 = 0,999, ε = 1 × 10⁻⁸, и затуханием веса 1 × 10⁻².
- Настройте планировщик скорости обучения косинусного отжига с T max = 50 и ηmin = 1×10⁻⁵ для ISIC 2017 и ISIC 2018. Настройте планировщик с T max = 100 и ηmin = 1×10⁻⁵ для Synapse. Оставляйте конфигурацию планировщика без изменений для всех повторяющихся экспериментов.
- Обучайте все модели с использованием арифметики FP32 с полной точностью. Отключите автоматическое обучение смешанной точности. Не применяйте градиентное клиппинг во время оптимизации.
- Сохраняйте без изменений настройки точности, стратегию обновления градиента, конфигурацию оптимизатора, график скорости обучения и протокол случайного засея во всех сравнительных экспериментах, исследованиях абляции и повторяемости.
- Выберите лучшую контрольную точку модели
- Оценивайте модель на валидационном наборе после каждой учебной эпохи для наборов данных ISIC 2017 и ISIC 2018.
- Вычислите потери бинарной перекрёстной энтропии (BCE)-кубиков для каждой партии валидации и вычислите средние потери валидации по всему набору валидации.
- Сохраняйте текущую модель как лучшую контрольную точку, когда средние потери валидации ниже ранее зафиксированных минимальных потерь валидации.
- Записывайте среднее пересечение по объединению (mIoU), коэффициент сходства кубиков (DSC), точность (Acc), специфичность (Spe) и чувствительность (Sen) во время валидации только для мониторинга производительности. Не используйте эти метрики как критерий выбора контрольной точки.
7. Оценка модели
- Оценивайте обученную модель, используя официальный набор тестирования для каждого набора данных. Используйте тестовый набор только для финальной оценки производительности.
- Для ISIC 2017 и ISIC 2018 рассчитывайте mIoU, DSC, Acc, Sen и Spe. Для всех расчётов используйте на уровне пикселей истинные положительные (TP), ложноположительные (FP), истинные отрицательные (TN) и ложноотрицательные (FN).
- Примените функцию активации сигмоидов к выходу моделей для ISIC 2017 и ISIC 2018. Преобразите отображение вероятностей в бинарную маску сегментации с использованием порога 0,5. Вычислите метрики оценки с помощью уравнений 2–6:
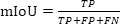 (2)
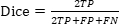 (3)
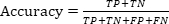 (4)
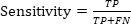 (5)
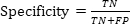 (6)
- Для Synapse примените функцию активации softmax к выходу модели. Назначьте каждый пиксель или воксель классу с наибольшей вероятностью с помощью операции argmax. Вычислите DSC и 95-е процентильное хаусдорфово расстояние (HD95) для каждого органа переднего плана и сообщайте средние значения для всех тестовых случаев.
- Сравните MVM-UNet с репрезентативными методами сегментации на основе CNN, трансформаторов и моделей пространства состояний (SSM). Используйте одинаковые разделы наборов данных, процедуры предварительной обработки, разрешения входных данных и метрики оценки для всех методов.
- Используйте официальные разделы обучения, валидации и тестирования для ISIC 2017 и ISIC 2018. Используйте стандартное разделение из 18 обучающих и 12 тестовых кейсов для Synapse. Установите входное разрешение на для наборов данных ISIC и для Synapse.
- Воспроизводите базовые методы, используя их официальные реализации, когда это возможно. Отчёт воспроизводит результаты как среднее ± SD по повторным запускам. Сохраняйте значения, представленные литературой, в первоначальном виде, и различайте их в соответствующих примечаниях к таблице.
- Проводите абляционные исследования с использованием фиксированного случайного семена 100, если не указано иное. Сохраняйте без изменений разделы набора данных, процедуру предварительной обработки, разрешение входных данных, оптимизатор, график скорости обучения, размер пакета, количество эпох, функцию потерь и метрики оценки во всех абляционных экспериментах.
- Оценить вклад MV4D, SFusion Mamba, ветви проекции вверх-вниз в блоке MVV, MFusion Mamba, размера входного изображения, значения dropout и конфигурации слоя энкодер-декодера. В каждом абляционном эксперименте изменяйте только целевую компоненту или параметр.
- Проведите тест Wilcoxon со знакомым рангом, используя парные результаты для каждого изображения для ISIC 2017 и ISIC 2018, а также парные результаты по каждому сценарию для Synapse. Рассмотрим p-значение меньше 0,05 для обозначения статистической значимости.
- Оценивайте вычислительную эффективность с использованием одной и той же аппаратной среды и разрешения входов для всех методов. Измерять время обучения за эпоху, время вывода на изображение, пиковое использование памяти GPU во время обучения, количество параметров модели и операции с плавающей запятой (FLOPs). Рассчитывайте FLOP с помощью одного прямого прохода.
- Выбирайте представительные качественные примеры только из тестового набора после завершения оценки модели. Сравните исходное изображение, маску с основной правдой и предсказанную маску, используя идентичные тестовые случаи для всех методов. Выберите представительные примеры, включающие малые цели, неправильные границы, неоднозначные границы и представительные многоорганные структуры.
- Рассчитывайте метрики оценки и проводите статистический анализ
- Рассчитывайте метрики сегментации для наборов данных ISIC 2017 и ISIC 2018 на Python с помощью NumPy и sklearn.metrics.confusion_matrix. Определите порог предсказанной вероятностной карты на уровне 0,5, получите пиксельные значения TP, FP, TN и FN и вычислите mIoU, DSC, Acc, Sen и Spe из этих значений.
- Вычислите DSC и HD95 для набора данных Synapse с использованием medpy.metric.binary.dc и medpy.metric.binary.hd95 соответственно. Примените softmax, а затем argmax к выводу модели, прежде чем вычислить метрики оценки.
- Вычислите количество FLOP и обучаемые параметры с помощью thop.profile с помощью одного прямого прохода.
- Проведите тест Wilcoxon с знаковым рангом на Python с помощью scipy.stats.wilcoxon. Используйте парные значения метрик на изображение для наборов данных ISIC 2017 и ISIC 2018, а также парные значения для каждого случая для набора данных Synapse.
8. Определение функции потерь
- Используйте стандартные потери по перекрестной энтропии (CE) для многоклассовой сегментации и стандартные потери BCE для бинарной сегментации. Используйте стандартную формулу потерь кубиков для сегментации. Уравнения 7–11 определяют функции потерь, используемые в этом протоколе.
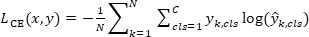 (7)
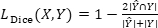 (8)
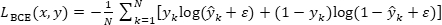 (9)
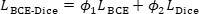 (10)
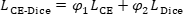 (11)
- Установите вес потери BCE и кубиков на уровне 1.0 для ISIC 2017 и ISIC 2018, чтобы
 1 = 1.0 и 2 = 1.0. Установить вес потери CE и кубиков на 1.0 для Synapse, например , φ1 = 1.0, и φ2 = 1.0.
- Реализуйте функции потерь в utils.py. Используйте nn. BCELoss для семестра BCE и nn. CrossEntropyLoss для термина CE. Вычислите потерю бинарного кубика, выравнивая каждую прогнозируемую маску и маску правдивости на земле, рассчитывая потерю кубиков для каждого образца и усредняя потерю по партии. Вычислите потерю мультикласса кубиков, преобразовав карту целевых меток в формат one-hot, применив softmax к выводу модели, вычислив потери кубиков для каждого класса и усредняя потери по всем классам.
- Установим константу сглаживания в 1 для потерь бинарных кубиков и в 1×10⁻⁵ для потерь мультикласса в Кубике. Реализуйте потери BCE-Dice с помощью класса BceDiceLoss с wb = 1 и wd = 1. Реализуйте потери CE-кубиков с помощью класса CeDiceLoss с loss_weight = [1, 1]. Сохраняйте константы сглаживания, стратегию сокращения и программную реализацию без изменений для всех наборов данных, случайных засечек и экспериментов.
- Настройте снижение потерь
- Instantiate nn. BCELoss() и nn. CrossEntropyLoss() без явного указания аргумента редукции.
- Используйте стандартную настройку уменьшения потерь PyTorch (уменьшение = «среднее») для обеих функций потерь. Не используйте редукция = «сумма» или выход с неуменьшенными потерями.
9. Настройки воспроизводимости и выполнение
- Скачайте выпущенную реализацию с https://github.com/LIXUEGUANG002/MVM-UNet. Используйте репозиторий вместе с программными пакетами, наборами данных, аппаратными спецификациями и вычислительными ресурсами, перечисленными в Таблице материалов.
- Клонируйте репозиторий и войдите в каталог проекта, запустив git clone https://github.com/LIXUEGUANG002/MVM-UNet.git, затем cd MVM-Unet.
- Настройте эксперимент ISIC 2017 или ISIC 2018, установив имя набора данных, путь к набору, размер входа, размер пакета, количество эпох, функцию потерь, оптимизатор, планировщик скорости обучения и случайный seed в configs/config_setting.py. Запустите обучающий скрипт из корня репозитория с помощью Python train.py.
- Настройте эксперимент Synapse, задавая имя набора данных, путь обучающих данных, путь к тестированию тома, каталог списков, размер входных данных, количество классов, размер пакета, количество эпох, функцию потерь, оптимизатор, планировщик скорости обучения и случайное заседание в конфигурациях/config_setting_synapse.py. Запустите обучающий скрипт из корня репозитория с помощью Python train_synapse.py.
- Выполните вычисление только на основе вывода, установив only_test_and_save_figs = True, best_ckpt_path в обученную контрольную точку и img_save_path в выходную папку в соответствующем конфигурационном файле. Запустите Python train.py для ISIC 2017 или ISIC 2018, или Python train_synapse.py для Synapse для генерации прогнозных результатов и качественных данных.
- Используйте версию исходного кода
- Клонируйте вышедший репозиторий GitHub и ознакомьтесь с commit ee891b42c2f083c4990eed72f1d4463adc5e103e на главной ветке, прежде чем настроить наборы данных, обучающие скрипты и настройки оценки.
- Используйте это обязательство для воспроизведения экспериментов, описанных в этом исследовании. На момент редакции рукописи для репозитория не было доступно тегированной версии.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Результаты
Ожидаемые результаты и интерпретация
При правильной реализации этого протокола обученная модель MVM-UNet должна обеспечивать стабильную производительность сегментации при повторных запусках, при этом для большинства показателей оценки оцениваются лишь небольшие вариации между различными случайными семенами. Для ISIC 2017 и ISIC 2018 успешные результаты отражаются в высоких значениях DSC, mIoU, Acc, Sen и Spe, а также в прогнозируемых масках поражения, которые тесно сл...
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Обсуждение
Этот протокол описывает MVM-UNet — основную рамочную систему сегментации медицинских изображений на базе Mamba. Метод был разработан для устранения двух ограничений существующих моделей сегментации. Во-первых, традиционные методы на основе CNN имеют ограниченные возможности моделирования долгосрочных зависимостей и иерархической контекстуальной информации в сложных медицинскихизображениях 43. Во-вторых, методы на основе трансформеров могут моделировать глобальный ...
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Раскрытие информации
Авторы заявляют, что у них нет конкурирующих финансовых интересов.
Благодарности
Это исследование не получило внешнего финансирования.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Материалы
| Имя | Компания | Каталожный номер | Комментарии |
|---|---|---|---|
| Оборудование - GPU-рабостанция или GPU-сервер | Платформа институциональных вычислений / локальная рабостанция | Кастомная локальная GPU-рабостанция; Ubuntu 22.04.1 с ядром Linux 6.8.0; Intel Core i9-13900K CPU; видеокарта NVIDIA A800; 128 ГБ ОЗУ; 512 ГБ локального хранилища. | Вычислительная платформа для тренировки, валидации, тестирования, абляции и экспериментов только с инференсом. |
| Оборудование - Графический процессор (GPU) | NVIDIA Corporation | Видеокарта NVIDIA A800 (80 ГБ памяти). | Тренинг и инференс с ускорением GPU. |
| Оборудование - Центральный процессор (CPU) | Intel Corporation / AMD | 13-го поколения Intel Core i9-13900K CPU. | Хост-процессор для загрузки данных, предобработки и выполнения экспериментов. |
| Оборудование - Системная память (RAM) | Платформа институциональных вычислений / локальная рабостанция | 128 ГБ системной памяти | Память для загрузки наборов данных, предобработки и тренировки. |
| Оборудование - Хранилище | Платформа институциональных вычислений / локальная рабостанция | 2 ТБ NVMe твердотельного накопителя. | Хранилище для наборов данных, контрольных точек, логов и сгенерированных предсказаний. |
| Софтверное окружение - Операционная система | Canonical Ltd. | Рекомендуется: Ubuntu 22.04.1 LTS | Операционная система для вычислительной среды. |
| Софтверное окружение - Conda окружение | Anaconda, Inc. / Miniconda | Имя окружения: mvmunet | Python окружение, используемое для установки и изоляции зависимостей. |
| Софтверное окружение - Python | Python Software Foundation | Python 3.8 | Язык программирования, используемый для реализации и выполнения экспериментов. |
| Софтверное окружение - CUDA toolkit | NVIDIA Corporation | CUDA Toolkit 11.8 | GPU вычислительный бэкенд, необходимый для PyTorch и пакетов, связанных с Mamba. |
| Софтверное окружение - cuDNN | NVIDIA Corporation | cuDNN 8.7.0. | ГПУ-ускоряемые примитивы глубокого обучения, используемые через PyTorch. |
| Пакет Python - PyTorch | PyTorch | torch == 2.0.1 | Фреймворк глубокого обучения для тренировки моделей, расчета потерь, оптимизации и инференса. |
| Пакет Python - Torchvision | PyTorch | torchvision == 0.14.0 | Утилиты для преобразования изображений, используемые при предобработке и увеличении. |
| Пакет Python - Torchaudio | PyTorch | torchaudio == 0.13.0 | Устанавливается в рекомендуемой среде PyTorch. |
| Пакет Python - timm | timm developers | timm == 0.4.12 | Зависимость модельного компонента или утилиты, указанная в инструкциях среды репозитория. |
| Пакет Python - triton | OpenAI / Triton developers | triton == 2.0.0 | Зависимость, используемая GPU-ускоряемыми компонентами моделирования последовательностей. |
| Пакет Python - causal-conv1d | causal-conv1d developers | causal_conv1d == 1.0.0 | Эффективная зависимость причинно-следственной свертки, необходимая для реализации Mamba. |
| Пакет Python - mamba-ssm | Mamba SSM developers | mamba_ssm == 1.0.1 | Пакет моделирования последовательностей состояний, используемый для компонентов, связанных с Mamba/S6. |
| Пакет Python - NumPy | NumPy developers | Версия NumPy 1.24.3. | Численные вычисления и операции с массивами. |
| Пакет Python - SciPy | SciPy developers | Версия SciPy 1.10.1. | Научные вычисления; scipy.ndimage.zoom импортируется в utils.py. |
| Пакет Python - SimpleITK | Insight Software Consortium | Версия SimpleITK 2.2.1. | Утилита ввода/вывода и предобработки медицинских изображений, импортируемая в utils.py. |
| Пакет Python - MedPy | MedPy developers | Версия MedPy 0.4.0. | Пакет для вычисления метрик медицинских изображений, импортируемый в utils.py. |
| Пакет Python - scikit-image | scikit-image developers | Версия scikit-image 0.21.0. | Зависимость для обработки изображений, указанная в README. |
| Пакет Python - scikit-learn | scikit-learn developers | Версия scikit-learn 1.3.2. | Пакет утилит машинного обучения, указанный в README. |
| Пакет Python - matplotlib | Matplotlib developers | Версия Matplotlib 3.7.2. | Используется для сохранения качественных визуализаций. |
| Пакет Python - h5py | h5py developers | Версия h5py 3.9.0. | Поддержка файлов HDF5 для тестовых объемов Synapse. |
| Пакет Python - thop | THOP developers | Версия THOP 0.1.1.post2209072238. | Используется при расчете FLOPs и вычислительной стоимости, связанной с параметрами. |
| Пакет Python - packaging | Python Packaging Authority | Версия packaging 23.1. | Зависимость, указанная в README. |
| Пакет Python - pytest | pytest developers | Версия pytest 7.4.0. | Зависимость, указанная в README. |
| Пакет Python - chardet | chardet developers | Версия chardet 5.2.0. | Зависимость, указанная в README. |
| Пакет Python - yacs | YACS developers | Версия yacs 0.1.8. | Утилита конфигурации, зави |
Ссылки
- Zhang F, et al. Cross co-teaching for semi-supervised medical image segmentation. Pattern Recognit. 2024;152:110485.
- Gu Y, et al. Dual-scale enhanced and cross-generative consistency learning for semi-supervised medical image segmentation. Pattern Recognit. 2025;158:111140.
- Zhu X, Wang W, Zhang C, Wang H. Polyp-Mamba: A hybrid multi-frequency perception gated selection network for polyp segmentation. Inf Fusion. 2025;115:103161.
- Iqbal S, et al. TBConvL-Net: A hybrid deep learning architecture for robust medical image segmentation. Pattern Recognit. 2025;158:111147.
- Zhao Z, et al. Balanced feature fusion collaborative training for semi-supervised medical image segmentation. Pattern Recognit. 2025;157:110986.
- Zhou T, et al. MambaYOLACT: You only look at Mamba prediction head for head-neck lymph nodes. Artif Intell Rev. 2025;58(6).
- Zhao Y, et al. MGF-GCN: Multimodal interaction Mamba-aided graph convolutional fusion network for semantic segmentation of remote sensing images. Inf Fusion. 2025;122:103268.
- Ronneberger O, Fischer P, Brox T. U-Net: Convolutional networks for biomedical image segmentation. In: Medical Image Computing and Computer-Assisted Intervention (MICCAI). Springer; 2015.
- Zhou Z, Siddiquee MMR, Tajbakhsh N, Liang J. UNet++: Redesigning skip connections to exploit multiscale features in image segmentation. IEEE Trans Med Imaging. 2019;39(6):1856-1867.
- Shaker A, et al. UNETR++: Delving into efficient and accurate 3D medical image segmentation. IEEE Trans Med Imaging. 2024;43(9):3377-3390.
- Zhou HY, et al. nnFormer: Volumetric medical image segmentation via a 3D Transformer. IEEE Trans Image Process. 2023;32:4036-4045.
- He A, et al. H2Former: An efficient hierarchical hybrid Transformer for medical image segmentation. IEEE Trans Med Imaging. 2023;42(9):2763-2775.
- Zhu L, et al. Vision Mamba: Efficient visual representation learning with bidirectional state space model. In: Proceedings of the 41st International Conference on Machine Learning (ICML). 2024.
- Liu Y, et al. VMamba: Visual state space model. Adv Neural Inf Process Syst. 2024;37:103031-103063.
- Ma J, Li F, Wang B. U-Mamba: Enhancing long-range dependency for biomedical image segmentation. arXiv. 2024;arXiv:2401.04722.
- Wang Z, et al. Mamba-UNet: UNet-like pure visual Mamba for medical image segmentation. arXiv. 2024;arXiv:2402.05079.
- Huang T, et al. LocalMamba: Visual state space model with windowed selective scan. In: European Conference on Computer Vision (ECCV). Springer; 2024.
- Zhang Z, et al. Motion Mamba: Efficient and long sequence motion generation. In: European Conference on Computer Vision (ECCV). Springer; 2024.
- Hu VT, et al. Zigma: A DiT-style zigzag Mamba diffusion model. In: European Conference on Computer Vision (ECCV). Springer; 2024.
- Rahman MM, et al. Mamba in vision: A comprehensive survey of techniques and applications. arXiv. 2024;arXiv:2410.03105.
- Falk T, et al. U-Net: Deep learning for cell counting, detection, and morphometry. Nat Methods. 2019;16(1):67-70.
- Gu R, et al. CA-Net: Comprehensive attention convolutional neural networks for explainable medical image segmentation. IEEE Trans Med Imaging. 2020;40(2):699-711.
- Chen J, et al. TransUNet: Rethinking the U-Net architecture design for medical image segmentation through the lens of Transformers. Med Image Anal. 2024;97:103280.
- Zhang Z, Zhang W. Pyramid medical Transformer for medical image segmentation. arXiv. 2021;arXiv:2104.14702.
- Cao H, et al. Swin-Unet: UNet-like pure Transformer for medical image segmentation. In: European Conference on Computer Vision (ECCV). Springer; 2022.
- Chen B, et al. TransAttUNet: Multi-level attention-guided U-Net with Transformer for medical image segmentation. IEEE Trans Emerg Top Comput Intell. 2023.
- Jiang S, Li J. TransCUNet: UNet cross-fused Transformer for medical image segmentation. Comput Biol Med. 2022;150:106207.
- Wu R, Liu Y, Liang P, Chang Q. H-vmunet: High-order Vision Mamba UNet for medical image segmentation. Neurocomputing. 2025;624:129447.
- Liu J, et al. Swin-UMamba: Adapting Mamba-based vision foundation models for medical image segmentation. IEEE Trans Med Imaging. 2024.
- Huang X, et al. MISSFormer: An effective Transformer for 2D medical image segmentation. IEEE Trans Med Imaging. 2023;42(5):1484-1494.
- Ruan J, et al. MALUNet: A multi-attention and lightweight U-Net for skin lesion segmentation. In: 2022 IEEE International Conference on Bioinformatics and Biomedicine (BIBM). IEEE; 2022.
- Ruan J, Xiang S. VM-UNet: Vision Mamba UNet for medical image segmentation. arXiv. 2024;arXiv:2402.02491.
- Valanarasu JMJ, Patel VM. UNeXt: MLP-based rapid medical image segmentation network. In: Medical Image Computing and Computer-Assisted Intervention (MICCAI). Springer; 2022.
- Ren S, Li X. HResFormer: Hybrid residual Transformer for volumetric medical image segmentation. IEEE Trans Neural Netw Learn Syst. 2025;36(6):10558-10566.
- Karimijafarbigloo S, Azad R, Kazerouni A, Merhof D. MedScale-Former: Self-guided multiscale Transformer for medical image segmentation. Med Image Anal. 2025;103.
- Yan S, et al. Multi-scale convolutional attention frequency-enhanced Transformer network for medical image segmentation. Inf Fusion. 2025;119.
- Gao Y, Zhou M, Metaxas DN. UTNet: A hybrid Transformer architecture for medical image segmentation. In: Medical Image Computing and Computer-Assisted Intervention (MICCAI). Springer; 2021.
- Mei J, et al. SANet: A slice-aware network for pulmonary nodule detection. IEEE Trans Pattern Anal Mach Intell. 2021;44(8):4374-4387.
- Hu XZ, Jeon WS, Rhee SY. ATT-UNet: Pixel-wise staircase attention for weed and crop detection. In: 2023 International Conference on Fuzzy Theory and Its Applications (iFUZZY). IEEE; 2023.
- Wang X, et al. Transferable normalization: Towards improving transferability of deep neural networks. Adv Neural Inf Process Syst. 2019;32.
- Azad R, et al. TransDeepLab: Convolution-free Transformer-based DeepLabV3+ for medical image segmentation. In: International Workshop on Predictive Intelligence in Medicine (PRIME). Springer; 2022.
- Ruan J, Gao J, Xie M, Xiang S. Learning multi-axis representation in frequency domain for medical image segmentation. Mach Learn. 2025;114(1):10.
- Goodfellow I, Bengio Y, Courville A. Deep Learning. MIT Press; Cambridge, MA; 2016.
- Milletari F, Navab N, Ahmadi SA. V-Net: Fully convolutional neural networks for volumetric medical image segmentation. In: 2016 Fourth International Conference on 3D Vision (3DV). IEEE; 2016.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.