В данном исследовании представлена легковесная архитектура для уменьшения галлюцинаций в больших языковых моделях посредством верификации на уровне утверждений и адаптивного статистического порога. Благодаря выборочному исправлению необоснованных утверждений с помощью логического вывода на естественном языке (Natural Language Inference), данный подход повышает фактическую точность при сохранении низкой задержки ответа и практической эффективности развертывания.
Для просмотра этого контента требуется подписка на JoVE. Войдите или начните свой бесплатный пробный период.
Исследовательская статья
Адаптивная верификация утверждений на основе NLI со статистическим моделированием принятия решений для снижения уровня галлюцинаций в больших языковых моделях с малой задержкой
В этой статье
Краткое содержание
Аннотация
Большие языковые модели (LLM) демонстрируют критическую тенденцию к созданию фактически неверных, но лингвистически связных ответов — явление, называемое галлюцинацией, которое создает серьезные риски в областях, требующих высокой точности. Существующие стратегии минимизации этого эффекта, включая генерацию с дополнением поиском (RAG) и сэмплирование с самосогласованностью, либо приводят к значительному увеличению задержки вывода, либо зависят от внешней инфраструктуры знаний, что ограничивает их применение в системах реального времени. В данной работе предлагается легковесная двухэтапная структура верификации утверждений, которая разделяет ответы LLM на атомарные фактические утверждения и независимо проверяет каждое извлеченное утверждение по отдельно сгенерированному эталону, полученному с помощью изолированного промпта на воспроизведение фактов. Несмотря на то, что генератор и верификатор используют одну и ту же базовую языковую модель, отделение генерации ответа от воспроизведения фактов снижает прямое обусловливание ответа и минимизирует предвзятость подтверждения при верификации с использованием логического вывода на естественном языке (NLI). Для выборочного исправления только опровергнутых утверждений применяется адаптивный статистический порог, определяемый как τ = µ + kσ по распределению показателей уверенности NLI. В отличие от предыдущих методов на основе NLI, опирающихся на фиксированные границы принятия решений, предлагаемая структура динамически адаптирует порог верификации к распределению уверенности для каждого конкретного ответа, демонстрируя стабильную эффективность на оцениваемых бенчмарках без необходимости переобучения модели. При тестировании на TruthfulQA и FEVER структура снизила уровень галлюцинаций на TruthfulQA с 28% до 9% — относительное снижение на 67,9%, при этом дополнительная задержка составила всего 160 ms по сравнению с базовой LLM, а точность обнаружения галлюцинаций оказалась выше, чем у SelfCheckGPT и FActScore. Эти результаты показывают, что предлагаемая структура обеспечивает оптимальный баланс между фактической надежностью и временем отклика на исследуемых бенчмарках, хотя для окончательных выводов требуется дальнейшая валидация в различных предметных областях и условиях развертывания.
Введение
Большие языковые модели (LLM) стали основополагающими компонентами современных систем искусственного интеллекта, демонстрируя выдающиеся способности в широком спектре задач по обработке естественного языка, включая генерацию текста, ответы на вопросы, реферирование и сложное логическое рассуждение1. Их способность создавать беглые и контекстуально связные ответы ускорила их внедрение в таких высокозначимых областях, как поддержка принятия клинических решений, юридический анализ, программная инженерия и образовательные технологии2. Однако существует критическое и стойкое ограничение, которое подрывает их надежность в этих условиях: галлюцинации, при которых модели генерируют лингвистически правильные, но фактически неверные, необоснованные или полностью выдуманные ответы 3. Эмпирические исследования показывают, что частота галлюцинаций варьируется от 15% до более чем 40% в зависимости от задачи и модели, при этом даже современные системы, такие как GPT-4, демонстрируют заметные фактические несоответствия при специализированной оценке в конкретных областях2,3. Это ограничение создает серьезные риски в приложениях, требующих высокой точности, где ошибочные результаты могут привести к дезинформации, неправильной диагностике или принятию ошибочных решений4. Галлюцинации фундаментально возникают из-за вероятностной природы языкового моделирования: LLM генерируют токены, предсказывая статистически вероятные продолжения входных последовательностей, а не извлекая или анализируя проверенные фактические знания5. Как следствие, сгенерированные результаты могут содержать правдоподобно звучащие, но неточные утверждения, вводить необоснованные тезисы или смешивать семантически связанные, но фактически разные понятия6.
Существующие стратегии смягчения этой проблемы основаны на нескольких парадигмах, каждая из которых имеет существенные ограничения. Генерация с дополненной выборкой (RAG) снижает вероятность галлюцинаций, основывая ответы на внешних извлеченных документах, однако вносит значительные задержки в работу, требует доступа к поддерживаемым базам знаний и остается уязвимой к ошибкам поиска в специализированных областях или областях с ограниченными ресурсами7,8,9.
Хотя генератор ответов и генератор ссылок инициализируются с использованием одной и той же базовой модели GPT-3.5 Turbo, они работают в рамках разных целей промптинга и контекстов исполнения. Генератор ответов формирует неограниченный ответ на запрос пользователя, в то время как генератор ссылок выполняет изолированную задачу по воспроизведению фактов без доступа к ранее сгенерированному ответу. Такое разделение снижает эффекты прямого влияния ответа и ограничивает предвзятость подтверждения при проверке утверждений. Таким образом, в данной архитектуре сгенерированная ссылка рассматривается как процедурно независимая, а не статистически независимая.
В недавних исследованиях также изучались легковесные стратегии декодирования для уменьшения галлюцинаций при генерации текста без использования внешнего поиска или повторной верификации. Одним из репрезентативных подходов является декодирование путем контрастирования слоев (Decoding by Contrasting Layers, DoLA), которое повышает фактическую точность за счет сопоставления представлений из промежуточных и финальных слоев трансформера в процессе декодирования. В отличие от систем верификации после генерации, такие методы воздействуют непосредственно на процесс генерации токенов и, следовательно, оптимизируют другой этап процесса генерации языка. Эти взаимодополняющие стратегии показывают, что снижение галлюцинаций может быть достигнуто либо во время декодирования, либо посредством постгенерационной верификации, при этом каждый подход предлагает свои компромиссы в отношении вычислительных затрат, сложности реализации и фактической надежности.
Методы самосогласованности повышают фактическую достоверность путем выборки нескольких ответов и выбора наиболее часто встречающегося или связного результата, однако их вычислительная стоимость линейно растет с увеличением количества выборок, что делает их непригодными для развертывания в системах, чувствительных к задержкам8. Подходы к итеративному уточнению, которые неоднократно пересматривают результаты через циклы самоотзыва, постепенно снижают частоту ошибок, но существенно увеличивают время вывода с каждым дополнительным проходом9. Методы верификации на основе NLI представляют собой более целенаправленную альтернативу, оценивая семантическое следование между сгенерированными утверждениями и эталонными текстами, однако существующие реализации опираются на фиксированные пороги принятия решений, которые не адаптируются к различным распределениям уверенности, доменам или поведению моделей10,11. В совокупности эти подходы либо создают неприемлемые вычислительные затраты, либо зависят от внешней инфраструктуры, либо лишены адаптивности, необходимой для generalized deployment. Сравнение основных характеристик этих подходов к верификации галлюцинаций представлено в Дополнительной таблице 1.
В данной работе предлагается облегченный двухэтапный фреймворк верификации утверждений, предназначенный для снижения частоты галлюцинаций в ответах LLM при сохранении низкой задержки отклика. На первом этапе LLM генерирует первичный ответ, который затем разлагается на атомарные фактические утверждения. На втором этапе каждое утверждение проверяется с помощью логического вывода на естественном языке (NLI) путем сопоставления с отдельно сгенерированным фактическим эталоном, полученным в ходе изолированного цикла рассуждений без доступа к первоначальному ответу; при этом решение о принятии или исправлении на уровне утверждения определяется статистически выведенным порогом уверенности. Основной вклад данной работы заключается в следующем: (1) разработка двухэтапного конвейера верификации на уровне утверждений, который отделяет генерацию ответа от фактической валидации, что позволяет проводить независимую и целенаправленную оценку каждого атомарного утверждения без необходимости внешнего поиска или полной регенерации ответа; (2) внедрение механизма адаптивного статистического порога, основанного на распределении показателей уверенности NLI (τ = µ + kσ), который динамически определяет границы принятия и исправления вместо использования фиксированных правил принятия решений, что повышает робастность при различных распределениях уверенности; (3) разработка стратегии селективной коррекции, которая ограничивает регенерацию только теми утверждениями, которые классифицированы как противоречивые, что существенно снижает вычислительные затраты по сравнению с методами полного пересэмплирования ответа или итеративного уточнения; (4) проведение эмпирической оценки на бенчмарке, ориентированном на выявление галлюцинаций, которая демонстрирует, что предлагаемый фреймворк снижает уровень галлюцинаций с 28% до 9%, сохраняя при этом задержку ответа в пределах допустимых норм для практического развертывания.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Протокол
В данном исследовании не принимали участия люди, не использовались животные, биологические образцы или данные пациентов. Таким образом, одобрение институционального этического комитета и информированное согласие не требовались.
Обзор дизайна исследования
Для повышения фактической достоверности ответов больших языковых моделей (LLM) была внедрена двухэтапная система верификации. Процедура включала генерацию ответа, извлечение утверждений, построение изолированных ссылок, верификацию на основе логического вывода на естественном языке (NLI), адаптивное статистическое принятие решений, селективную коррекцию и окончательную сборку ответа. Эффективность системы была оценена с использованием наборов данных TruthfulQA и FEVER.
Общая схема рабочего процесса
Запрос пользователя → Генерация первоначального ответа → Извлечение утверждений → Независимая генерация ссылок → NLI-верификация → Вычисление статистического порога → Коррекция утверждений → Итоговый верифицированный ответ. Общий рабочий процесс адаптивной системы верификации утверждений проиллюстрирован на Рисунке 1.
Подготовка набора данных
Набор данных TruthfulQA12, содержащий 817 ориентированных на факты вопросов, был загружен и подготовлен для оценки. Набор данных FEVER13 состоит из 185 445 аннотированных утверждений, помеченных как «Подтверждено» (Supported), «Опровергнуто» (Refuted) или «Недостаточно информации» (Not Enough Information); при оценке использовались размеченные данные разработки с полями утверждения, доказательства и эталонной метки. Каждое утверждение оценивалось на основе предоставленных доказательств, в то время как исходная метка FEVER сохранялась в качестве контрольного результата для верификации. Набор данных FEVER, содержащий пары «утверждение-доказательство» для проверки фактов, был получен и предварительно обработан. Входные вопросы и утверждения были преобразованы в стандартизированный текстовый формат. Перед проведением экспериментов были удалены дубликаты и неполные образцы. TruthfulQA был разделен на подмножества для валидации и тестирования. Примерно 20% образцов TruthfulQA (164 вопроса) использовались для настройки порога, а остальные 653 вопроса были зарезервированы для оценки производительности. Для FEVER утверждения, предоставленные в бенчмарке, использовались непосредственно в качестве единиц верификации и не подвергались процедуре генерации ответа и извлечения утверждений, применявшейся к TruthfulQA. Характеристики наборов данных бенчмарков, использованных для разработки и оценки системы, обобщены в Таблице 1.
Первичная генерация ответа
Каждый запрос был отправлен в базовую языковую модель. Ответы генерировались с использованием ядерного семплирования (nucleus sampling) при температуре 0,7 и значении top-p 0,9. Максимальная длина вывода была ограничена 256 токенами. Сгенерированные ответы сохранялись без какой-либо последующей обработки или ручного изменения. Сгенерированный текст направлялся непосредственно на этап извлечения утверждений.
Извлечение утверждений
Каждый сгенерированный ответ был разложен на независимо проверяемые фактические утверждения. Для выявления атомарных утверждений использовался структурированный запрос на декомпозицию. Составные утверждения были разделены на минимальные фактические единицы. Субъективные мнения, стилистические выражения и разговорные слова-филлеры были удалены. Каждое извлеченное утверждение было сохранено как отдельная единица верификации.
Пример:
Исходный ответ:
«Мария Кюри была физиком и химиком польского происхождения, которая провела новаторские исследования в области радиоактивности».
Извлеченные утверждения: (1) Мария Кюри родилась в Польше; (2) Мария Кюри была физиком и химиком; (3) Мария Кюри проводила исследования в области радиоактивности.
Создание изолированного референсного контроля:
Для каждого извлеченного утверждения была создана независимая фактическая ссылка. Модель-верификатор получала только исходный запрос пользователя. Доступ к первоначально сгенерированному ответу был ограничен во избежание предвзятости подтверждения. Для стимулирования кратких, основанных на доказательствах ответов использовался промпт на фактическое воспроизведение. Сгенерированные ссылки были сохранены для последующей проверки.
Верификация логического вывода на естественном языке
Каждая пара «утверждение — ссылка» была передана в предварительно обученную модель NLI (естественного логического вывода). Модель NLI классифицировала связь как: следствие (Entailment), нейтральную (Neutral) или противоречие (Contradiction). Были зафиксированы вероятности достоверности для всех трех классов. Каждому утверждению был присвоен знаковый показатель верификации: положительное значение для следствия, ноль для нейтральной связи или отрицательное значение для противоречия. Все показатели верификации были собраны для расчета порогового значения.
Адаптивное вычисление статистического порога
Доверительный интервал верификации, создаваемый моделью NLI, существенно варьируется в зависимости от ответов, поскольку разные запросы генерируют различное количество утверждений, разный уровень семантической сложности и разные распределения уверенности. Фиксированный глобальный порог предполагает, что все ответы имеют схожий профиль уверенности, что на практике встречается редко. Чтобы учесть эту вариативность, предлагаемая структура оценивает границу принятия решения индивидуально для каждого ответа, используя среднее значение и стандартное отклонение его показателей верификации. Среднее значение отражает общий уровень уверенности в ответе, в то время как стандартное отклонение характеризует разброс значений уверенности среди извлеченных утверждений. Такая адаптивная формулировка позволяет критерию принятия подстраиваться под неопределенность конкретного ответа, а не полагаться на единый порог для всех входных данных.
Были рассчитаны среднее значение (µ) и стандартное отклонение (σ) всех знаковых показателей верификации.
Адаптивный порог принятия решения рассчитывали следующим образом:

где τ представляет собой адаптивный порог, µ обозначает средний балл верификации, σ обозначает стандартное отклонение, а k представляет собой параметр чувствительности.
Параметр чувствительности был инициализирован на значении 0.7. Утверждения, классифицированные как «Следование» (Entailment) с показателями больше или равными +τ, были приняты. Утверждения, классифицированные как «Противоречие» (Contradiction) с показателями меньше или равными −τ, были отмечены для исправления. Утверждения с показателями в интервале (−τ, +τ) были оставлены как нейтральные.
Селективная коррекция пунктов формулы
Утверждение направлялось на исправление только в том случае, если модель NLI классифицировала пару «утверждение — ссылка» как противоречие (Contradiction) и соответствующий ей знаковый балл верификации удовлетворял критерию адаптивного порога si ≤ -τ. Таким образом, решение о корректировке совместно определялось меткой класса NLI и специфическим для конкретного ответа статистическим порогом. Утверждения, классифицированные как «Следование» (Entailment) со значением si были приняты, тогда как утверждения, попадающие в интервал -τ < si < Значения τ рассматривались как нейтральные и сохранялись без корректировки. Данный комбинированный критерий гарантировал, что корректировка применялась только к тем утверждениям, которые демонстрировали как семантическое противоречие, так и достаточно веские доказательства отрицательной верификации.
Реконструкция ответа
Принятые и исправленные утверждения были расположены в их исходной последовательности. Границы предложений были восстановлены для обеспечения читабельности. При необходимости были внесены незначительные грамматические правки. Сформированный результат был сохранен в качестве окончательного проверенного ответа.
Оценка эффективности
Эффективность системы оценивалась по четырем показателям: (1) Точность (Accuracy): доля ответов, которые остались фактически верными после верификации; (2) F1-мера (F1 Score): гармоническое среднее точности (precision) и полноты (recall) обнаружения галлюцинаций; (3) Задержка ответа (Response Latency): общее время обработки от момента подачи запроса до генерации верифицированного ответа; (4) Частота галлюцинаций (Hallucination Rate)
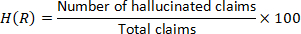
Задержка была представлена как среднее время выполнения по результатам повторных измерений. Поскольку значения задержки для каждого отдельного запуска не сохранялись, стандартные отклонения и доверительные интервалы не рассчитывались.
Оценка корректности с учетом специфики бенчмарка
Для TruthfulQA окончательный проверенный ответ сравнивали с эталонными ответами, подтвержденными людьми, и списками неправильных ответов. Ответ считался правильным, если содержащиеся в нем фактические утверждения соответствовали принятой информации об ответе и не содержали контента, соответствующего выявленным паттернам неправильных ответов. Для FEVER каждое утверждение в конечном результате оценивалось на основе соответствующего доказательства и исходной аннотации FEVER; утверждения со статусом Supported (подтверждено) считались фактически проверенными, а утверждения со статусом Refuted (опровергнуто) — неправильными. Случаи Not Enough Information (недостаточно информации) оставались неопределенными и не рассматривались как положительные фактические доказательства. Полученные решения на уровне отдельных утверждений объединялись по каждому бенчмарку для расчета сообщаемых показателей точности (Accuracy) и частоты галлюцинаций (Hallucination Rate).
Экспериментальная среда
Программный каркас был реализован с использованием Python 3.9. Операции обработки данных выполнялись с помощью библиотек для численного и табличного анализа. Модель NLI работала в режиме вывода без дополнительного дообучения. Эксперименты проводились на рабочей станции, оснащенной процессором Intel Core i5, 16 GB ОЗУ и 64-разрядной операционной системой. Все оценки проводились в режиме однопроходного вывода для обеспечения работы с низкой задержкой. Все эксперименты выполнялись с использованием идентичных аппаратных и программных конфигураций для обеспечения согласованности оценки различных наборов данных и базовых методов.
Ожидаемый результат
Данный протокол предназначен для принятия решений о верификации на уровне отдельных утверждений путем выявления потенциально необоснованных тезисов и выборочного направления на исправление тех утверждений, которые содержат явные противоречия. Ожидаемым результатом является верифицированный ответ с сокращением фактических несоответствий и ограниченными дополнительными затратами на обработку, в зависимости от показателей, полученных в ходе экспериментальной оценки.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Результаты
Генерация первоначального ответа
Базовая языковая модель генерировала беглые и контекстуально релевантные ответы на вопросы из обоих наборов эталонных данных. Однако детальный анализ выявил необоснованные и фактически неточные утверждения в ряде ответов. На наборе данных TruthfulQA уровень галлюцинаций базовой системы составил 28%, в то время как на наборе данных FEVER наблюдался уровень галлюцинаций 26%. Эти результаты подтвердили, что одной прямой генерации языка недостаточн...
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Обсуждение
Предложенная архитектура позволила повысить эффективность проверки фактов, избежав при этом повторной выборки и внешнего поиска. В тесте TruthfulQA уровень галлюцинаций снизился с 28% для базовой LLM до 9% при использовании полной архитектуры, в то время как точность увеличилась с 0,72 до 0,87. В тесте FEVER уровень галлюцинаций снизился с 26% до 10%, а точность выросла с 0,74 до 0,89. Данные сравнения следует интерпретировать в рамках экспериментальных настроек и реализаций, использованных в этом исследовании, а не как ...
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Раскрытие информации
Авторы заявляют об отсутствии конфликта интересов.
Благодарности
Авторы выражают искреннюю благодарность своему учреждению за предоставление академической среды и вычислительных ресурсов, необходимых для проведения данного исследования. Авторы также благодарят разработчиков и администраторов общедоступных эталонных наборов данных, использованных в этой работе, что позволило провести комплексную оценку предлагаемой структуры. Благодарность выражается коллегам и рецензентам за их конструктивные замечания, которые помогли повысить качество и ясность данной работы. Кроме того, авторы признательны сообществу исследователей открытого исходного кода за предоставление программных библиотек и инструментов, которые облегчили проведение экспериментов, анализ данных и визуализацию результатов. Их постоянные усилия значительно продвинули исследования в области обработки естественного языка и надежного искусственного интеллекта. Авторы заявляют, что для данного исследования не привлекалось внешнее финансовоеสนับสนุน или финансирование.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Материалы
| Имя | Компания | Каталожный номер | Комментарии |
|---|---|---|---|
| набор данных для бенчмаркинга FEVER | Общая задача FEVER (Thorne et al.) | https://fever.ai/dataset/fever.html | Общедоступный набор данных для проверки фактов, состоящий из пар «утверждение — доказательство» и используемый для оценки |
| GPT-3.5 Turbo (большая языковая модель B10+2:12:12) | OpenAI | Идентификатор модели: gpt-3.5-turbo; https://developers.openai.com/api/docs/models/gpt-3.5-turbo | Использовался как в качестве генератора ответов, так и в качестве независимого генератора эталонных данных, доступ к которому осуществлялся через OpenAI API |
| NumPy | Разработчики NumPy (открытый исходный код) | https://numpy.org/ | Библиотека для численных вычислений, используемая для статистических расчетов, включая среднее значение и стандартное отклонение показателей верификации NLI |
| Openai (клиентская библиотека Python API) | OpenAI | https://github.com/openai/openai-python | Библиотека клиента Python, используемая для отправки промптов и получения ответов от GPT-3.5 Turbo |
| pandas | команда разработчиков pandas (открытое ПО) | https://pandas.pydata.org/ | Библиотека анализа табличных данных, используемая для предобработки наборов данных и обработки результатов |
| Предобученная модель классификации для логического вывода на естественном языке (NLI) | Хаб моделей Hugging Face (модель, построенная на архитектуре DeBERTa-v3-large от Microsoft) | MoritzLaurer/DeBERTa-v3-large-mnli-fever-anli-ling-wanli | Используется в режиме логического вывода, без дополнительного обучения, для классификации каждой пары «утверждение — ссылка» как следствия, нейтрального отношения или противоречия |
| Python | Python Software Foundation | Версия 3.9; https://www.python.org/downloads/release/python-390/ | Основной язык программирования, использованный для реализации платформы верификации |
| SciPy | Разработчики SciPy (открытое программное обеспечение) | https://scipy.org/ | Библиотека для научных вычислений, используемая для статистического анализа результатов экспериментов |
| Трансформеры (библиотека Hugging Face Transformers) | Hugging Face | https://github.com/huggingface/transformers | Библиотека Python, используемая для загрузки и запуска предобученной модели NLI |
| контрольный набор данных TruthfulQA | Первоначально опубликовано Лином, Хилтоном и Эвансом | https://github.com/sylinrl/TruthfulQA | Общедоступный контрольный набор из 817 ориентированных на факты вопросов, используемый для настройки порога и оценки |
| Рабочая станция | Не указано в рукописи (пожалуйста, подтвердите производителя/модель) | процессор Intel Core i5; 16 ГБ оперативной памяти; 64-разрядная операционная система | Оборудование, использованное для проведения всех экспериментов при идентичных конфигурациях |
| Примечание: все вышеперечисленные URL-адреса были проверены и подтверждены как активные на дату составления данной таблицы. |
Ссылки
- Dai Z, et al. Promptagator: Few-shot dense retrieval from 8 examples [conference presentation]. Presented at: The Eleventh International Conference on Learning Representations; 2022. [https://iclr.cc/virtual/2023/poster/10937]
- Achiam J, et al. GPT-4 technical report. arXiv. 2023;arXiv:2303.08774. [https://arxiv.org/abs/2303.08774]
- Ji Z, et al. Survey of hallucination in natural language generation. ACM Comput Surv. 2023;55(12):1-38.
- Bender EM, McMillan-Major A, Shmitchell S, Gebru T. On the dangers of stochastic parrots: Can language models be too big? [conference presentation]. Presented at: 2021 ACM Conference on Fairness, Accountability, and Transparency; 2021. [https://dl.acm.org/doi/10.1145/3442188.3445922]
- Devlin J, et al. BERT: Pre-training of deep bidirectional transformers for language understanding [conference presentation]. Presented at: 2019 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies; 2019. [https://arxiv.org/abs/1810.04805]
- Maynez J, Narayan S, Bohnet B, McDonald R. On faithfulness and factuality in abstractive summarization [conference presentation]. Presented at: 58th Annual Meeting of the Association for Computational Linguistics; 2020. [https://arxiv.org/abs/2005.00661]
- Brown T, et al. Language models are few-shot learners. Adv Neural Inf Process Syst. 2020;33:1877-901.
- Guu K, et al. Retrieval augmented language model pre-training [conference presentation]. Presented at: International Conference on Machine Learning; 2020. [https://arxiv.org/abs/2002.08909]
- Izacard G, Grave E. Leveraging passage retrieval with generative models for open domain question answering [conference presentation]. Presented at: 16th Conference of the European Chapter of the Association for Computational Linguistics; 2021. [https://arxiv.org/abs/2007.01282]
- Bowman SR, Angeli G, Potts C, Manning CD. A large annotated corpus for learning natural language inference [conference presentation]. Presented at: 2015 Conference on Empirical Methods in Natural Language Processing; 2015. [https://arxiv.org/abs/1508.05326]
- Platt J. Probabilistic outputs for support vector machines and comparisons to regularized likelihood methods. Adv Large Margin Classif. 1999;10(3):61-74.
- Lin S, Hilton J, Evans O. Truthfulqa: Measuring how models mimic human falsehoods. InProceedings of the 60th annual meeting of the association for computational linguistics (volume 1: long papers) 2022 May (pp. 3214-3252).
- Thorne J, Vlachos A, Christodoulopoulos C, Mittal A. FEVER: A large-scale dataset for fact extraction and verification [conference presentation]. Presented at: 2018 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies; 2018. [https://aclanthology.org/N18-1074/]
- Williams A, Nangia N, Bowman SR. A broad-coverage challenge corpus for sentence understanding through inference. arXiv. 2017;arXiv:1704.05426.
- Manakul P, Liusie A, Gales M. SelfCheckGPT: Zero-resource black-box hallucination detection for generative large language models [conference presentation]. Presented at: 2023 Conference on Empirical Methods in Natural Language Processing; 2023.
- Min S, et al. FActScore: Fine-grained atomic evaluation of factual precision in long-form text generation. arXiv. 2023;arXiv:2305.14251.
- Cohen J. Statistical power analysis for the behavioral sciences. Routledge; New York; 2013.
- Kadavath S, et al. Language models (mostly) know what they know. arXiv. 2022;arXiv:2207.05221.
- Hendrycks D, et al. Aligning AI with shared human values. arXiv. 2020;arXiv:2008.02275.
- Lewis P, et al. Retrieval-augmented generation for knowledge-intensive NLP tasks. Adv Neural Inf Process Syst. 2020;33:9459-74.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Перепечатки и разрешения
Эта статья была опубликована
Видео скоро будет доступно