В данной работе представлена объяснимая архитектура на основе CNN для классификации поражений кожи, которая сочетает в себе высокую диагностическую точность с интерпретируемостью модели. Она классифицирует изображения поражений и генерирует визуальные объяснения своих прогнозов. Результаты демонстрируют высокую эффективность и повышенную прозрачность, что способствует принятию клинических решений и помогает дерматологам в раннем выявлении заболеваний кожи.
Исследовательская статья
Объяснимая компьютерная система классификации кожных поражений на основе глубокого обучения
В этой статье
Краткое содержание
Аннотация
Использование глубоких сверточных нейронных сетей для диагностики заболеваний кожи в различных исследованиях продемонстрировало точность, сопоставимую с результатами дерматологов. Тем не менее, по-прежнему существует множество проблем, включая недостаточную эффективность и плохую обобщающую способность в некоторых случаях, а также низкую интерпретируемость, связанную с использованием моделей «черного ящика». Это создает серьезные препятствия для практического внедрения, поскольку помимо точной диагностики требуется объяснимость, что делает поиск решения необходимым. Для преодоления указанных трудностей в данном исследовании разработан объяснимый фреймворк глубокого обучения для классификации кожных поражений (EDLF-SLC). Фреймворк в трехэтапном режиме использует различные подходы машинного обучения и объяснимого искусственного интеллекта (XAI) для обеспечения повышения как точности, так и интерпретируемости. На начальном этапе глубокие представления, извлеченные из нескольких предобученных архитектур CNN, объединяются для сохранения дополняющей дискриминационной информации, изученной различными архитектурами сетей, перед классификацией с помощью SVM с радиально-базисным функционным ядром. Затем для классификации полученных признаков используются классификаторы метода опорных векторов (SVM) с радиально-базисным функционным ядром. Наконец, прогнозы, сделанные моделью, интерпретируются с помощью локальных интерпретируемых модельно-независимых объяснений (LIME). Результаты экспериментов показывают, что EDLF-SLC достигает точности (accuracy) 88,0%, точности (precision) 89,0%, полноты (recall) 87,0% и F1-меры 88,0%, демонстрируя конкурентоспособную эффективность по сравнению с несколькими недавно описанными методами в экспериментальных условиях, рассмотренных в данном исследовании.
Введение
Поражения кожи представляют собой серьезную проблему в дерматологии и онкологии, поскольку они варьируются от доброкачественных образований до злокачественных опухолей, таких как меланома — самая опасная форма рака кожи. В 2020 году в мире было зарегистрировано примерно 325 000 новых случаев заболевания меланомой и более 57 000 смертей1. Несмотря на то, что достижения в области скрининга и лечения улучшили результаты терапии, несвоевременная диагностика и ограниченный доступ к медицинскому обслуживанию по-прежнему способствуют высокому уровню смертности и потере лет жизни, особенно среди молодого населения2,3.
Традиционная диагностика опирается преимущественно на визуальный осмотр и дерматоскопию, что делает процесс зависимым от опыта клиницистов и подверженным субъективизму, межнаблюдательской вариабельности, проведению излишних биопсий и увеличению времени обследования4,5,6. Чтобы устранить эти недостатки, глубокое обучение, в частности сверточные нейронные сети (CNN), стало эффективным решением для автоматизированной классификации кожных новообразований. Модели на базе CNN, включая DDCNN-F7, YOLOv7-XAI8 и ряд других архитектур9,10,11,12,13, продемонстрировали высокую диагностическую точность за счет автоматического извлечения дискриминативных признаков изображений. Несмотря на успех, большинство моделей глубокого обучения работают как «черные ящики», что ограничивает доверие клиницистов и препятствует их внедрению в рутинную медицинскую практику. В связи с этим были внедрены методы объяснимого искусственного интеллекта для повышения прозрачности моделей путем предоставления визуальных объяснений прогнозов. Среди этих методов Local Interpretable Model-Agnostic Explanations генерирует интерпретируемые локальные объяснения, идентифицируя области изображения, которые оказывают наибольшее влияние на решения модели14.
Классификация кожных поражений прошла путь от традиционной клинической оценки до передовых диагностических систем на базе ИИ, что было обусловлено необходимостью точного, надежного и раннего выявления рака кожи. Эта эволюция прошла через пять основных этапов — традиционные методы диагностики, компьютерная диагностика (CAD), машинное обучение (ML), глубокое обучение (DL) и, в последнее время, объяснимый ИИ (XAI) и федеративное обучение (FL), что отражает постоянные усилия по повышению точности, согласованности, масштабируемости и клинического доверия к диагностике при одновременном преодолении ограничений традиционного обследования. Ранние вычислительные методы пытались имитировать клиническое мышление с помощью созданных вручную дескрипторов изображений, основанных на правиле ABCD, включая асимметрию, неровность границ, вариативность цвета и диаметр поражения. Эти признаки объединяли с байесовскими сетями, деревьями решений, экспертными системами и моделями нечеткого вывода для поддержки диагностики меланомы; в ряде исследований сообщалось о точности классификации, превышающей 90%15,16,17. Несмотря на то, что эти методы заложили важный фундамент для компьютерной диагностики, они полностью зависели от вручную разработанных признаков и предопределенных диагностических правил. Следовательно, они демонстрировали ограниченную устойчивость к вариациям качества изображений, морфологии поражений, освещения и условий получения снимков.
Для устранения этих недостатков появились классические системы CAD (компьютерной диагностики), ставшие промежуточным этапом между традиционным анализом изображений и современными платформами на базе ИИ. Системы CAD сочетали ручное извлечение признаков с традиционными классификаторами для повышения согласованности диагностики и помощи в принятии клинических решений. Ряд гибридных подходов интегрировал иерархическую кластеризацию с рекуррентными нейронными сетями и архитектурами долгой краткосрочной памяти, что позволило достичь точности классификации, приближающейся к 99,5%18. Другие платформы на базе CAD включали классификаторы градиентного бустинга с объяснениями на основе SHAP, демонстрируя конкурентоспособную диагностическую точность при одновременном повышении прозрачности моделей19. Несмотря на то, что эти системы представляли собой значительный шаг вперед по сравнению с чисто основанными на правилах подходами, они по-прежнему в значительной степени опирались на ручное извлечение признаков, обширную предварительную обработку, тщательно аннотированные наборы данных и многостадийные конвейеры обработки.
Методы машинного обучения способствовали дальнейшему развитию автоматизированной классификации новообразований кожи, обеспечив возможность обучения на основе данных вместо разработки явных правил. Гибридные структуры, сочетающие сверточные нейронные сети с традиционными классификаторами машинного обучения, включая логистическую регрессию и метод k-ближайших соседей, продемонстрировали высокую эффективность классификации на эталонных наборах данных, достигая точности более 95%9. Самообучающееся мультимодальное обучение позволило дополнительно улучшить представление признаков за счет совместного использования дерматоскопических и клинических изображений, что снизило зависимость от обширной ручной разметки при одновременном повышении качества классификации20. В дополнительных исследованиях CNN сочетались с обобщенным дискриминантным анализом, дескрипторами SURF и алгоритмами оптимизации для улучшения различения признаков и точности классификации21. Методы автоматического отбора признаков с использованием DenseNet-201, InceptionV3 и алгоритмов оптимизации бинарного дерева дополнительно улучшили представление признаков при сохранении конкурентоспособной диагностической эффективности22. Подходы на основе трансферного обучения с использованием предобученных архитектур, таких как AlexNet и GoogLeNet, также продемонстрировали многообещающие возможности классификации, несмотря на ограниченный объем обучающих данных23. Тем не менее, большинство методов машинного обучения по-прежнему зависели от тщательно разработанных процедур предобработки, ручных стратегий оптимизации, сбалансированных наборов данных и обширной настройки гиперпараметров. Ограниченная внешняя валидация и чувствительность к дисбалансу классов дополнительно ограничивали их практическую применимость в различных клинических условиях.
Внедрение глубокого обучения (DL) коренным образом изменило автоматизированную классификацию новообразований кожи, обеспечив возможность сквозного обучения непосредственно на основе необработанных данных изображений. Сверточные нейронные сети (CNN) устранили необходимость в ручном проектировании признаков, существенно повысив диагностическую эффективность на нескольких эталонных наборах данных. Большинство подходов на основе CNN продемонстрировали значительное улучшение классификации поражений благодаря использованию все более сложных архитектур. Модели CNN с учетом симметрии позволили исследовать клинически значимые характеристики новообразований, однако обеспечили лишь умеренную сбалансированную точность24. Другие исследователи интегрировали архитектуры EfficientNet с методами интерпретации LIME и SHAP для повышения прозрачности моделей, введя при этом количественные показатели достоверности25. Гибридные системы глубокого обучения, сочетающие сегментацию поражений, ансамблевое обучение и CNN, достигли отличных результатов на нескольких наборах данных ISIC, но остались чувствительными к качеству сегментации и дисбалансу классов26.
В последнее время всё более сложные гибридные архитектуры позволили дополнительно повысить точность классификации за счет интеграции взаимодополняющих методов глубокого обучения (DL). Условные генеративно-состязательные сети в сочетании с YOLOv5 и анализом независимых компонент позволили достичь точности классификации более 99%, хотя их вычислительная сложность ограничила возможности практического применения 27. Аналогичным образом, гибридные архитектуры LSTM–ResNet эффективно обучались пространственно-временным представлениям, но требовали значительно больших вычислительных ресурсов28. Модели на базе трансформеров, включая Sap-Former, использовали глобальную контекстную информацию для улучшения представления признаков, однако требовали тщательной предварительной обработки, крупномасштабных аннотированных наборов данных и значительной вычислительной мощности29. Облегченные альтернативы, такие как S-MobileNet, были направлены на поиск баланса между вычислительной эффективностью и диагностической точностью30, в то время как методы ненаправляемой адаптации домена улучшили обобщающую способность между различными доменами, несмотря на снижение эффективности при наличии ограниченного количества обучающих выборок31. Гибридные сети с механизмом внимания, включающие модифицированные модули сверточного внимания и snapshot-ансамблевое обучение, также продемонстрировали многообещающие результаты при классификации кожных поражений при оспе обезьян, хотя проблемы, связанные с дисбалансом классов, разнообразием изображений и ограниченной интерпретируемостью, остались нерешенными32. Специализированные остаточные архитектуры, использующие более глубокие структуры сетей и гибридные функции потерь, еще больше повысили точность классификации (свыше 99%), но привели к значительному увеличению вычислительных затрат и времени обучения33. Комплексные обзорные исследования последовательно подтверждают, что методы DL существенно превосходят традиционные подходы с ручным проектированием признаков за счет автоматического извлечения дискриминативных представлений изображений, одновременно выявляя устойчивые проблемы, связанные с артефактами визуализации, вариабельностью освещения, вычислительной сложностью и ограниченной клинической обобщаемостью34.
Хотя глубокое обучение (DL) значительно повысило точность диагностики, вопросы, касающиеся прозрачности моделей, оценки неопределенности и надежности клинического внедрения, стимулировали растущий интерес к объяснимому искусственному интеллекту (XAI) и федеративному обучению. В ряде исследований изучались методы количественной оценки неопределенности, включая конформное прогнозирование, метод Монте-Карло с использованием дропаута и эвиденциальное глубокое обучение; было показано, что надежная оценка уверенности может существенно улучшить поддержку принятия решений, несмотря на дополнительные вычислительные ограничения и требования к данным35. Для решения проблемы дисбаланса классов при одновременном повышении эффективности обучения признакам были предложены фреймворки взаимного обучения на базе трансформеров36. В других подходах использовалось сочетание сверточных нейронных сетей (CNN) полного разрешения с методами оптимизации на основе графов для улучшения сегментации и классификации очагов поражения37, в то время как гибридные архитектуры глубокого обучения, интегрирующие несколько дополняющих друг друга представлений признаков, позволили достичь точности классификации, приближающейся к 99,5%, несмотря на необходимость обширной предварительной обработки данных38.
В последнее время исследования все чаще сосредоточены на интеграции интерпретируемости непосредственно в структуры глубокого обучения (DL) для повышения доверия клиницистов и содействия практическому внедрению в клинику. Объяснимые системы, использующие несколько архитектур сверточных нейронных сетей вместе с Grad-CAM и Score-CAM, успешно локализовали диагностически значимые области поражений, сохраняя при этом конкурентоспособную точность классификации как на внутренних, так и на внешних наборах данных39. Гибридные структуры CNN-Transformer, объединяющие дерматоскопические изображения с клиническими метаданными, еще больше улучшили прогнозную способность, используя SHAP и Grad-CAM для создания клинически значимых визуальных объяснений40. Дополнительные гибридные архитектуры на основе трансформеров, интегрирующие EfficientNetV2S, Swin Transformers, модифицированные сети Xception и механизмы внимания на графах, эффективно фиксировали взаимодополняющие глобальные и локальные характеристики поражений, хотя большое количество параметров и ограниченная эффективность на редких классах ограничили их практическое применение41. Аналогично, гибридные структуры YOLOv8-Vision Transformer продемонстрировали улучшенную локализацию поражений, многоклассовую классификацию и визуальную интерпретируемость благодаря адаптивной аугментации вместе с объяснениями SHAP и Grad-CAM; однако эти методы по-прежнему опирались преимущественно на эталонные наборы данных и демонстрировали ограниченную робастность для редких категорий поражений42. В нескольких обзорных статьях были обобщены эти разработки, подчеркивая как значительный прогресс, достигнутый современными методами глубокого обучения, так и сохраняющиеся проблемы, связанные с вычислительной эффективностью, интерпретируемостью, зависимостью от наборов данных и клинической валидацией43,44,45. В Таблице 1 обобщены некоторые из недавно опубликованных работ по использованию алгоритмов глубокого обучения для классификации поражений кожи.
Несмотря на значительные успехи, достигнутые современными методами глубокого обучения (DL) в классификации поражений кожи, большинство существующих подходов по-прежнему ограничены высокой вычислительной сложностью, зависимостью от больших аннотированных наборов данных, ограниченной интерпретируемостью моделей и недостаточной валидацией в различных реальных клинических условиях. Чтобы преодолеть эти ограничения, в данной работе предлагается платформа EDLF-SLC, которая интегрирует дополняющие друг друга признаки, извлеченные из нескольких архитектур CNN, с классификатором SVM для обеспечения надежной и точной классификации. В платформе также используются улучшенные методы предобработки для повышения качества изображений и устранения дисбаланса классов, в то время как применение метода LIME позволяет предоставлять визуальные объяснения отдельных прогнозов, повышая тем самым прозрачность модели и доверие к ней в клинической практике.
Данное исследование вносит вклад в трех направлениях. Во-первых, авторы предлагают надежную структуру EDLF-SLC, которая объединяет современные сверточные нейронные сети (CNN) с классификатором на базе метода опорных векторов (SVM) для достижения точной и надежной классификации кожных поражений. Во-вторых, авторы применяют усовершенствованные методы предварительной обработки для устранения дисбаланса классов и снижения шума на изображениях, что повышает качество входных данных и общую эффективность модели классификации. В-третьих, авторы внедряют метод локально интерпретируемого модельно-независимого объяснения (LIME) для визуализации и интерпретации отдельных прогнозов модели путем выделения областей изображения, которые оказывают наибольшее влияние на решения по классификации, тем самым повышая прозрачность и интерпретируемость предлагаемой структуры.
Протокол
Данное исследование не предусматривало привлечения людей в качестве участников или сбора идентифицируемых данных пациентов. Все эксперименты проводились с использованием общедоступного набора данных поражений кожи ISIC 2020, полученного из репозитория Kaggle; в связи с этим одобрение институционального комитета по этике и информированное согласие не требовались. Все материалы, использованные в данном исследовании, находятся в Таблица материалов.
Извлечение и объединение признаков
Изображения поражений кожи обрабатывались с использованием нескольких предварительно обученных моделей CNN. Векторы глубоких признаков, извлеченные из выбранных архитектур предобученных CNN, объединяются конкатенацией для создания единого представления признаков для каждого изображения поражения кожи. Принятая стратегия объединения позволяет сохранить дополнительную визуальную информацию, полученную различными архитектурами CNN, что дает последующему классификатору SVM использовать как низкоуровневые текстурные характеристики, так и высокоуровневые семантические представления. Несмотря на то, что методы снижения размерности, такие как анализ главных компонентов или отбор признаков на основе взаимной информации, могли бы уменьшить размерность данных, полное объединенное представление было намеренно сохранено, поскольку объединенное пространство признаков остается вычислительно доступным для используемого классификатора RBF-SVM, при этом сохраняется взаимодополняющая диагностическая информация, извлеченная из гетерогенных базовых сетей CNN.
Классификация
Объединенные векторы признаков использовались для обучения классификатора SVM с RBF-ядром. Для определения оптимальных настроек классификации применялись методы оптимизации гиперпараметров. Затем классификатор распределил поражения кожи по соответствующим классам.
Объяснимость
Для повышения интерпретируемости был применен метод LIME для создания визуальных объяснений, выделяющих области изображения, которые вносят наиболее значительный вклад в результаты классификации. Эти объяснения помогут клиницистам понять и подтвердить решения модели.
План оценки
Предложенная структура была протестирована с использованием эталонного набора данных новообразований кожи. Эффективность оценивали по таким показателям, как точность (Accuracy), прецизионность (Precision), полнота (Recall) и F1-мера (F1-Score). Для подтверждения эффективности предложенного подхода были проведены сравнительные эксперименты с существующими методами машинного и глубокого обучения.
Ожидаемые результаты
Ожидалось, что в результате исследования будет разработана точная и интерпретируемая система классификации поражений кожи. Предварительные экспериментальные результаты показывают, что EDLF-SLC достигает точности (accuracy) 88.0%, прецизионности (precision) 89.0%, полноты (recall) 87.0% и F1-меры (F1-score) 88.0%, что превосходит показатели нескольких конкурирующих методов. Предполагалось, что интеграция объяснений LIME повысит степень доверия и облегчит внедрение диагностических систем с поддержкой ИИ в клиническую практику.
Значимость
Данное исследование вносит вклад в развивающуюся область объяснимого ИИ в здравоохранении, решая проблемы как производительности, так и прозрачности диагностики новообразований кожи. Предложенная структура обладает потенциалом для поддержки дерматологов в принятии более надежных и интерпретируемых диагностических решений, что в конечном итоге позволит улучшить качество ухода за пациентами. Кроме того, в данном разделе авторы представили информацию о материалах и методологии, примененных в этом исследовательском проекте. В частности, авторы начали с описания набора данных, использованного для экспериментов, и перешли к детальному обсуждению структуры объяснимого глубокого обучения для классификации новообразований кожи.
Набор данных
Представленная работа основана на общедоступном наборе данных ISIC 2020 (International Skin Imaging Collaboration), доступ к которому можно получить на веб-сайте Kaggle (https://www.kaggle.com/datasets/fanconic/skin-cancer-malignant-vs-benign). Репозиторий ISIC признан одним из лучших ресурсов в области дерматологической визуализации, так как он содержит большое разнообразие дерматоскопических изображений различных типов поражений кожи, как показано на рисунке 1. Важно отметить, что набор данных включает изображения как доброкачественных, так и злокачественных образований, что делает его полезным для выполнения задач бинарной классификации рака кожи 46. В текущем наборе данных содержится 3 297 изображений, из которых 1 800 являются доброкачественными и 1 497 — злокачественными. Для более эффективного проведения экспериментов данные были разделены на обучающую и тестовую выборки. В частности, обучающая выборка содержит 2 637 изображений, включая 1 440 доброкачественных и 1 197 злокачественных, в то время как тестовая выборка состоит из 660 изображений, из которых 360 — доброкачественные и 300 — злокачественные. Сводка по набору данных представлена в таблице 2.
Предлагаемая модель EDLF-SLC
В данной работе предложено эффективное и понятное решение для классификации поражений кожи на доброкачественные и злокачественные с использованием нового метода объяснимого глубокого обучения, основанного на гибридном подходе, который сочетает в себе преимущества нескольких предварительно обученных моделей сверточных нейронных сетей. Сверточные нейронные сети доказали свою высокую эффективность в извлечении семантических признаков высокого уровня из медицинских изображений. Используя эту возможность, предлагаемая архитектура объяснимого глубокого обучения для классификации поражений кожи (EDLF-SLC) задействует несколько предобученных моделей CNN для достижения превосходных результатов. Чтобы обеспечить необходимую прозрачность процесса принятия медицинских решений, в предлагаемом подходе был применен метод LIME для генерации локальных, понятных человеку объяснений полученных результатов. Полную структуру архитектуры можно разделить на три основных этапа, как показано на Рисунке 2, а именно: (1) предварительная обработка данных, (2) извлечение признаков и классификация и (3) интерпретируемость.
Архитектура и интеграция модели
В качестве предварительного этапа семь популярных моделей глубокого обучения (MobileNetV2, ResNet50, EfficientNetB0, Xception, InceptionResNetV2, NASNetLarge и MobileNet) были отобраны и по отдельности протестированы на валидационном наборе данных; для этапа извлечения признаков были выбраны четыре наиболее эффективные модели (ResNet50, EfficientNetB0, MobileNet и Xception). В предлагаемой структуре каждое входное изображение x независимо пропускалось через выбранные предобученные модели. Из каждой из этих моделей был удален последний полносвязный слой, а векторы признаков были получены с предыдущих слоев. fResNet50(x), fEfficientNetB0(x), fMobileNet(x) и fXception(x) обозначают выходные векторы признаков каждой из вышеупомянутых моделей. Путем конкатенации этих векторов признаков получается новый агрегированный вектор признаков F(xi):
F(xi) = [f(ResNet50)(xi);f(EfficientNetB0)(xi);f(MobileNet)(xi);f(Xception)(xi)] (1)
После этого F(xi) пропускается через классификатор SVM с радиально-базисной функцией (RBF) для получения результата классификации. Полный алгоритм предложенной структуры представлен в Дополнительном файле 1.
Предложенная структура основана на прямом слиянии признаков на уровне функций, поскольку каждая предобученная архитектура CNN извлекает различные дискриминантные характеристики поражений кожи благодаря своей уникальной архитектуре сети и иерархии выученных признаков. Следовательно, конкатенация этих гетерогенных представлений признаков позволяет сохранить дополняющую друг друга информацию, что способствует более всесторонней характеристике поражений перед этапом классификации. Хотя методы снижения размерности, такие как анализ главных компонентов (PCA) или отбор признаков на основе взаимной информации, могут уменьшить размерность объединенного представления, полный вектор слитых признаков был сохранен намеренно, так как его размерность остается вычислительно приемлемой для используемого классификатора RBF-SVM, при этом сохраняется комплементарная диагностическая информация, извлеченная различными базовыми сетями CNN. Таким образом, данная архитектура отдает приоритет сохранению дополняющих друг друга глубоких представлений, а не удалению потенциально информативных признаков перед классификацией.
Подготовка данных
Подготовка данных включала предварительную обработку и разделение набора данных на обучающую и тестовую выборки. Предварительная обработка направлена на повышение качества данных путем устранения противоречий, удаления дублирующих элементов, форматирования входных изображений и масштабирования признаков для стабильного обучения качественной модели. Все изображения были нормализованы до диапазона [−1, 1] с помощью Z-score нормализации:
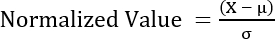 (2)
где µ и σ обозначают соответственно среднее значение и стандартное отклонение для соответствующего изображения. Набор данных был разделен на два подмножества: обучающую выборку (70.0%) и тестовую выборку (30.0%).
Аугментация данных
Для предотвращения переобучения и повышения обобщающей способности модели для обучающей выборки были использованы некоторые методы аугментации. Аугментация изображений предполагает модификацию снимков с целью искусственного расширения набора данных без изменения основных признаков медицинских состояний. Конвейер аугментации был построен с использованием Keras Sequential API. Применялись такие преобразования, как случайное горизонтальное отражение, поворот на небольшой угол, изменение размера, масштабирование, регулировка яркости/контрастности, зумирование и некоторые незначительные смещения. Репрезентативные примеры аугментированных изображений представлены на Рисунке 3.
Предобученные модели
В предлагаемой структуре для извлечения признаков из входных изображений были использованы несколько предобученных моделей глубокого обучения. К этим моделям относятся MobileNet, ResNet50, EfficientNetB0, Xception, NASNetLarge, Inception-ResNet-v2 и MobileNetV2. MobileNet и MobileNetV2 представляют собой легковесные модели глубокого обучения для эффективных вычислений с использованием глубинных разделяемых сверток. В ResNet50 для обучения модели применяется механизм остаточных связей, что позволяет избежать проблемы затухающих градиентов в процессе обучения. EfficientNetB0 обеспечивает баланс между эффективностью и точностью благодаря подходу комбинированного масштабирования. Xception расширяет сеть Inception, используя глубинные разделяемые свертки. NASNetLarge основана на использовании автоматического поиска нейронной архитектуры для построения оптимальных структур глубоких нейронных сетей, а Inception-ResNet-v2 представляет собой гибрид модели Inception и механизма остаточных связей. Векторы признаков, извлеченные из ResNet50 (1,024 признака), EfficientNetB0 (1,280 признаков), MobileNet (1,024 признака) и Xception (2,048 признаков), объединяются (конкатенируются) для создания единого 5,376-мерного представления. Данная стратегия слияния была выбрана для сохранения дополняющих друг друга представлений, полученных различными архитектурами CNN, вместо сокращения размерности представления перед классификацией. Полученный вектор признаков затем подается на классификатор RBF-SVM, который определяет оптимальную нелинейную решающую границу в объединенном пространстве признаков.
Интерпретируемая модель ИИ (LIME)
Для обеспечения локальной интерпретируемости прогнозов модели авторы используют метод генерации локализованных, понятных человеку объяснений для каждого конкретного прогноза модели, называемый LIME47. Для любого входного изображения LIME сначала разделяет его на более мелкие единицы, называемые суперпикселями. Затем на основе исходного изображения создаются возмущения, и для каждого из них оцениваются прогнозы глубокой нейронной модели. После этого на основе возмущений строится взвешенная линейная модель, где веса зависят от степени близости возмущения к исходному входному экземпляру. После построения линейной модели оцениваются показатели значимости признаков, которые указывают на роль каждого суперпикселя в прогнозировании итоговой метки. Эти показатели значимости визуально выделены на итоговом изображении-объяснении. Алгоритм LIME представлен в Дополнительном файле 2.
Результаты
Оценка эффективности разработанной структуры классификации основана на традиционных показателях оценки, вытекающих из матрицы ошибок. Матрица ошибок позволяет получить полное представление о работе классификатора путем представления количества правильных и неправильных классификаций для каждого определенного класса. Таким образом можно проанализировать все типы ошибок. Например, ложноположительные и ложноотрицательные результаты особенно важны при диагностике заболеваний. Высокие значения ложноположительных результатов могут свидетельствовать о высокой чувствительности классификатора, но в то же время большое количество ложноотрицательных результатов указывает на его низкую чувствительность и создает потенциальные риски для здоровья. В данной работе используются следующие метрики эффективности: точность (accuracy), прецизионность (precision), полнота (recall), F1-мера (F1-score), специфичность (specificity), доля истинно положительных результатов (TPR) и доля ложноположительных результатов (FPR). Формулы этих метрик приведены ниже:
Точность=(TP+TN)/(TP+TN+FP+FN) (3)
Точность (Precision) = TP/(TP+FP) (4)
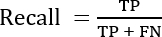 (5)
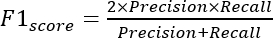 (6)
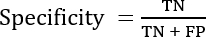 (7)
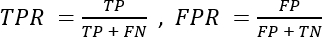 (8)
В данном случае TP показывает количество злокачественных раков кожи, обнаруженных системой, в то время как TN указывает количество доброкачественных образований. В свою очередь, FP демонстрирует число ошибочных решений, когда образования классифицируются как злокачественные, хотя на самом деле они являются доброкачественными. FN отражает количество ошибочно распознанных доброкачественных образцов. Применительно к классификации рака кожи минимизация ложноотрицательных результатов крайне важна из-за потенциальных неблагоприятных последствий, которые могут возникнуть в результате таких ошибок.
Результаты базовых моделей
Все вычислительные эксперименты проводились в облачной среде Google Colab. Стоит отметить, что эта платформа позволяет запускать экземпляры виртуальных машин с предустановленной операционной системой Ubuntu 20.04. Для обучения базовых моделей использовались Python версии 3.9 и фреймворк PyTorch версии 2.3.1. Кроме того, все вычислительные узлы имели идентичные характеристики, а именно: процессор Intel Xeon с частотой 2.2 GHz, графический процессор NVIDIA Tesla T4, 16 GB оперативной памяти и объем хранилища 70 GB. Таким образом, такие условия эксперимента позволили снизить вариативность, обусловленную использованием различных аппаратных платформ, и повысить надежность и воспроизводимость результатов. Полное описание экспериментальной среды приведено в Таблице 3.
Рисунок 4 демонстрирует кривые обучения, соответствующие 100 эпохам обучения для архитектуры ResNet-50. Обучение проводилось на наборе данных, содержащем 2 110 изображений, при этом размер валидационного набора данных составлял 660 изображений. Как видно, в процессе обучения точность постоянно росла, достигнув почти 90.0%. При этом повышение точности наблюдалось в течение первых 50 эпох; после этого показателя точность стала почти постоянной, что можно рассматривать как признак сходимости модели. При валидации модель продемонстрировала значение AUC, равное 86.0%, что свидетельствует о приемлемых дискриминационных свойствах.
Матрица ошибок, представленная на рисунке 5, характеризует эффективность модели ResNet-50 с точки зрения точности классификации на тестовом наборе из 660 изображений. При оценке модель правильно распознала 310 из 360 доброкачественных образцов и 239 из 300 злокачественных образцов. Однако относительно большое количество злокачественных образцов было классифицировано неверно, что привело к сравнительно высокому значению ложноотрицательных результатов. Этот результат следует рассмотреть более детально в связи с серьезными последствиями ошибок такого типа при практическом использовании классификатора. В целом точность модели составила 83.0%, при этом прецизионность (precision) составила 83.3%, полнота (recall) — 83.3%, а F1-мера — 83.3%.
Таблица 4 содержит подробное описание рабочих характеристик модели ResNet-50 для обоих классов. Классификатор продемонстрировал относительно сбалансированные показатели точности (precision): для доброкачественных образцов это значение составило 83.0%, в то время как для злокачественных образцов точность составила 84.0%. Аналогично, показатели полноты (recall) достигли 88.0% для доброкачественных новообразований и 78.0% для злокачественных. Столбец «Support» в таблице представляет количество образцов, соответствующих каждому классу.
Предлагаемая модель EDLF-SLC
На рисунке 6 показаны значения AUC при обучении и валидации предлагаемой модели на протяжении 300 эпох. Метрика AUC отражает способность модели различать доброкачественные и злокачественные классы, при этом более высокие значения указывают на лучшую дискриминационную способность. Как видно из графика, AUC обучения стабильно растет в течение всего процесса обучения, достигая максимального значения 1.00 примерно к 200-й эпохе. AUC валидации также постепенно улучшается на начальных этапах обучения, однако после примерно 150 эпох начинается выход на плато, что свидетельствует о сходимости модели. Итоговое значение AUC валидации, равное 0.95, демонстрирует высокую обобщающую способность и эффективную разделимость классов.
Матрица ошибок предлагаемой модели, представленная на Рисунке 7, показывает, что модель правильно классифицировала 299 доброкачественных образцов и 272 злокачественных образца, при этом 28 доброкачественных случаев были ошибочно классифицированы как злокачественные, а 61 злокачественный случай — как доброкачественный. В общей сложности модель обеспечила 571 правильное предсказание и 89 ошибочных классификаций. Примечательно, что большее количество ложноотрицательных результатов (злокачественные случаи, ошибочно классифицированные как доброкачественные) указывает на критическое ограничение, поскольку такие ошибки могут иметь значительные клинические последствия. Тем не менее, общая эффективность классификации остается высокой. В отличие от подходов по отбору признаков, в которых измерения намеренно удаляются перед классификацией, предлагаемая структура сохраняет полное объединенное глубокое представление, созданное несколькими гетерогенными архитектурами CNN. Такой подход был принят потому, что каждая базовая сеть извлекает взаимодополняющие характеристики поражения, и сохранение полного представления позволяет классификатору SVM использовать комбинированную дискриминативную информацию без исключения потенциально информативных признаков. Следовательно, принятая стратегия объединения признаков отдает приоритет изучению взаимодополняющих представлений при сохранении вычислительной осуществимости.
Рисунок 8 представляет репрезентативные примеры результатов классификации, полученных с помощью предложенной модели. Результаты демонстрируют, что модель присваивает высокие показатели достоверности правильно классифицированным случаям. В частности, для доброкачественных случаев наблюдаются высокие прогнозируемые вероятности (например, 99.84% и 99.85%), в то время как для злокачественных случаев также отмечаются высокие уровни достоверности (например, 99.98% и 99.96%). Эти данные указывают на то, что модель может эффективно дифференцировать доброкачественные и злокачественные образования даже в визуально сложных сценариях. Для повышения интерпретируемости используется фреймворк LIME для генерации локальных объяснений прогнозов модели, как показано на Рисунке 9A–D. LIME аппроксимирует сложную границу принятия решений модели с помощью локально интерпретируемой линейной модели. Для каждого входного изображения метод генерирует возмущенные образцы путем выборочного маскирования суперпикселей и оценки соответствующих прогнозов. Затем к этим образцам подбирается взвешенная линейная модель, где веса определяются на основе близости к исходным входным данным с использованием ядра радиально-базисной функции. Полученные коэффициенты представляют вклад каждого суперпикселя в итоговый прогноз и определяются следующим образом:
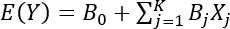 (9)
где Xj ∈ {0, 1} обозначает наличие или отсутствие j-го суперпикселя, Bj представляет собой соответствующий вес вклада, а B0 является базовым прогнозом. Положительные коэффициенты (Bj > 0) указывают на области, способствующие отнесению к злокачественному классу, тогда как отрицательные коэффициенты (Bj < 0) соответствуют признакам доброкачественности. Визуализации на основе LIME, представленные на рисунке 9B, D, выделяют наиболее влиятельные области, определяющие каждое решение по классификации. Для доброкачественных образований модель делает акцент на областях, характеризующихся однородной пигментацией и четкими границами. Напротив, в злокачественных случаях выделенные области соответствуют клинически значимым признакам, таким как неровные края, неоднородность цвета и атипичная текстура. Интенсивность выделенных областей отражает величину соответствующих коэффициентов Bj.
Эти результаты демонстрируют, что модель EDLF-SLC фокусируется на клинически значимых признаках, которые согласуются с установленными дерматологическими критериями, такими как правило ABCD. Такое соответствие повышает интерпретируемость и надежность модели, делая её более подходящей для поддержки принятия клинических решений. Кроме того, на Рисунке 10 представлены результаты сравнительной визуализации, полученные с использованием дополнительных методов объяснимости, включая Grad-CAM, HiResCAM, GradCAM++, XGradCAM, LayerCAM, EigenGradCAM и EigenCAM, что дополнительно подтверждает согласованность выявленных значимых областей при использовании различных методов. Сравнение эффективности предлагаемой модели EDLF-SLC и семи базовых моделей после обучения в течение 100 эпох приведено в Таблице 5. Модель EDLF-SLC показала конкурентоспособный результат 0,88 по каждому из оцениваемых показателей по сравнению с базовыми архитектурами, протестированными в данном экспериментальном контексте. Модели EfficientNetB0 и ResNet50 также показали хорошие результаты с точностью 0,85 и 0,83 соответственно. Напротив, Inception-ResNetV2 продемонстрировала наихудшие показатели классификации среди оцениваемых моделей. С другой стороны, несмотря на относительно более низкую точность классификации, её вычислительная эффективность оставалась сопоставимой с базовыми моделями. Предложенная модель EDLF-SLC продемонстрировала конкурентоспособную эффективность по сравнению с оцениваемыми базовыми моделями в принятых экспериментальных условиях.
Для оценки эффективности предлагаемого подхода по сравнению с существующими методами в Таблице 6 представлено сравнение с репрезентативными современными методами классификации поражений кожи. Например, в работе47 была отмечена точность 0,86, в то время как в48 использовалась модель на основе ансамбля, которая достигла аналогичной точности, но продемонстрировала более низкие показатели прецизионности, полноты и F1-меры. В недавних исследованиях, основанных на ансамблевом обучении и нескольких архитектурах CNN25,49, сообщалось о точности до 0,87. В принятых экспериментальных условиях предлагаемая архитектура EDLF-SLC достигла точности 0,88, используя единую объяснимую архитектуру без необходимости в дополнительных компонентах, таких как модели сегментации поражений.
ДОСТУПНОСТЬ ДАННЫХ
Данные, подтверждающие результаты этого исследования, находятся в открытом доступе на Kaggle по адресу https://www.kaggle.com/datasets/fanconic/skin-cancer-malignant-vs-benign.
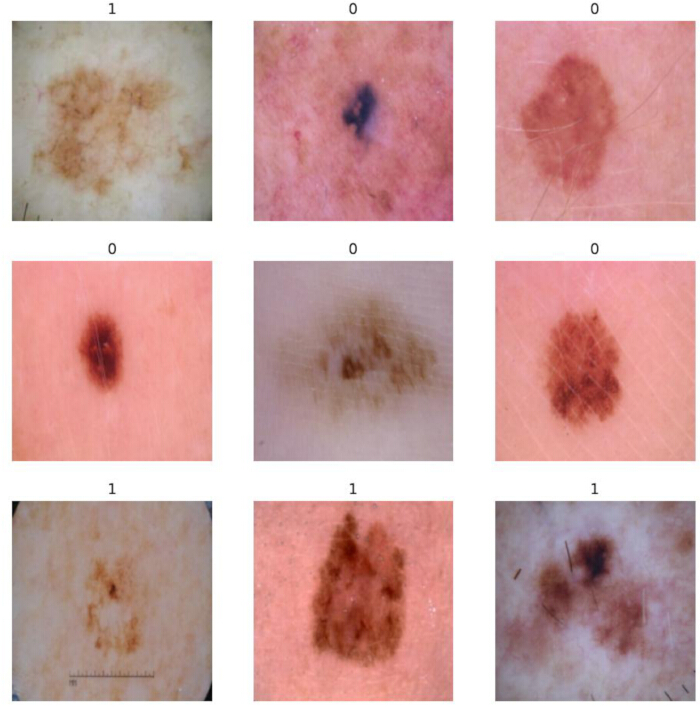
Рисунок 1: Репрезентативные дерматоскопические изображения из набора данных ISIC, иллюстрирующие два диагностических класса, использованных в данном исследовании. Образцы помечены как доброкачественные (0) и злокачественные (1), что подчеркивает вариабельность морфологии, цвета и текстуры поражений в наборе данных. Пожалуйста, нажмите здесь, чтобы просмотреть этот рисунок в более крупном размере.
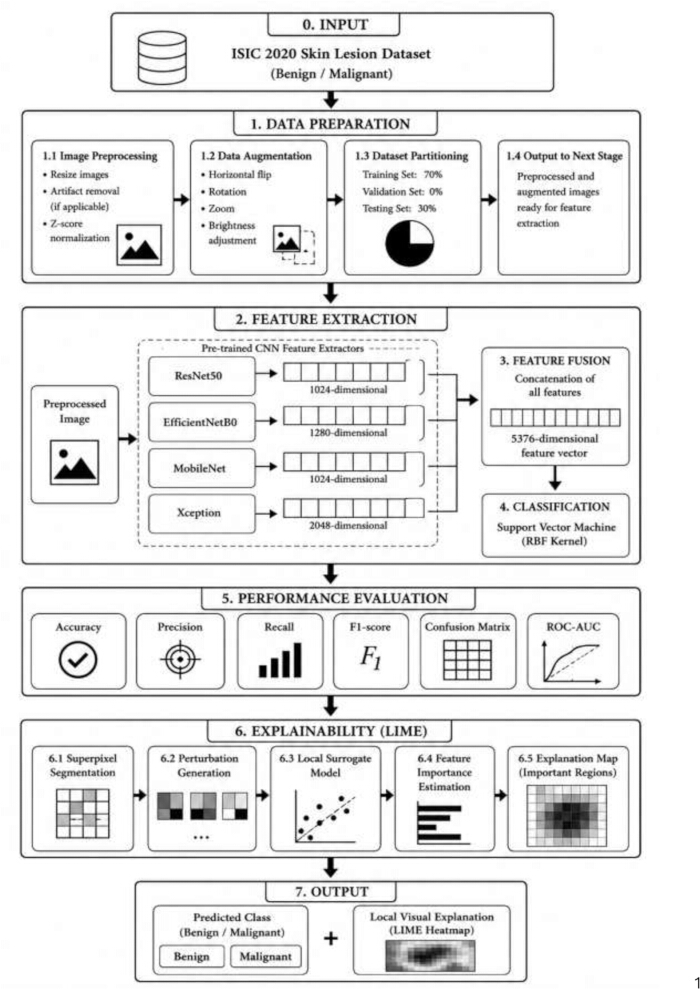
Рисунок 2: Полный рабочий процесс предлагаемой структуры EDLF-SLC. Протокол начинается со сбора изображений из базы данных ISIC 2020, за которым следуют предобработка, аугментация данных, разделение набора данных, извлечение глубоких признаков с использованием четырех предобученных архитектур CNN, объединение признаков, классификация SVM, оценка эффективности и генерация объяснений на основе LIME. Пожалуйста, нажмите здесь, чтобы просмотреть этот рисунок в более крупном размере.
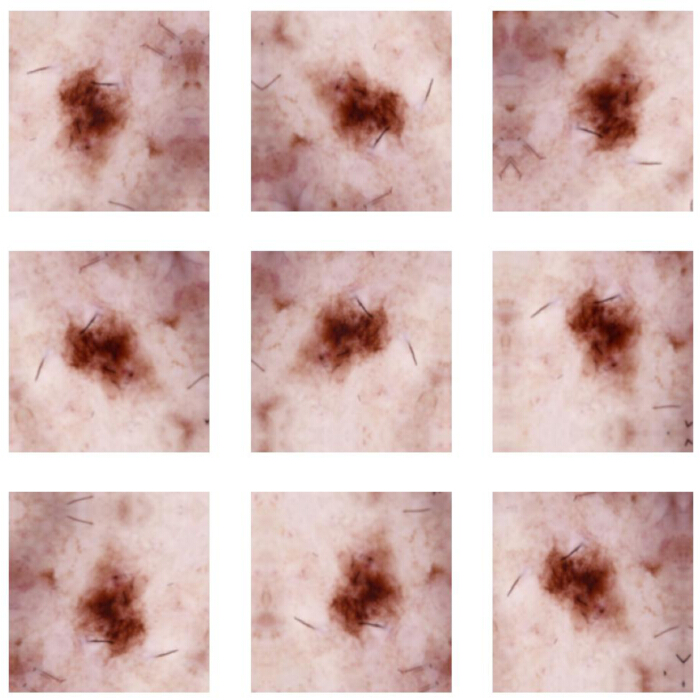
Рисунок 3: Примеры дополненных изображений кожных поражений, созданных с помощью методов аугментации данных. Сюда входят горизонтальное и вертикальное отражение, поворот, масштабирование и регулировка яркости. Эти преобразования увеличивают разнообразие набора данных, повышают устойчивость модели и снижают риск переобучения в процессе обучения. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
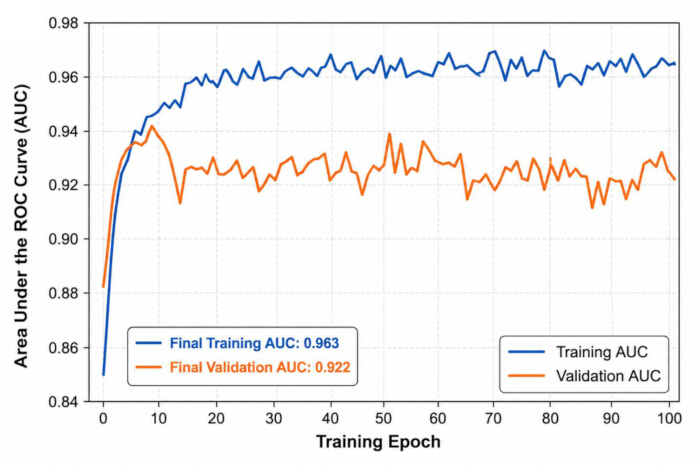
Рисунок 4: Значение площади под ROC-кривой (ROC-AUC) при обучении и валидации модели ResNet-50 на протяжении 100 эпох обучения. Синяя кривая представляет AUC обучения, в то время как оранжевая кривая представляет AUC валидации. Кривые демонстрируют быструю сходимость в течение начальных эпох обучения с последующей стабильной оптимизацией при неизменно высоких показателях валидации, что указывает на эффективное обучение и удовлетворительную обобщающую способность на валидационном наборе данных. Пожалуйста, нажмите здесь, чтобы просмотреть этот рисунок в большем размере.
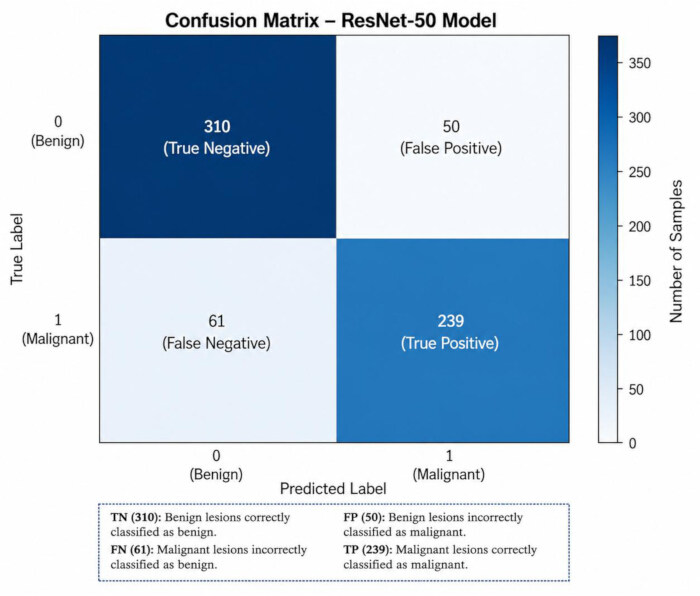
Рисунок 5: Матрица ошибок модели ResNet-50 на тестовом наборе данных. Строки представляют истинные метки классов (0 = доброкачественные, 1 = злокачественные), в то время как столбцы представляют предсказанные метки классов. Диагональные элементы указывают на правильно классифицированные образцы (310 доброкачественных и 239 злокачественных), а внедиагональные элементы представляют ошибочно классифицированные образцы, включая 50 ложноположительных и 61 ложноотрицательных результатов. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
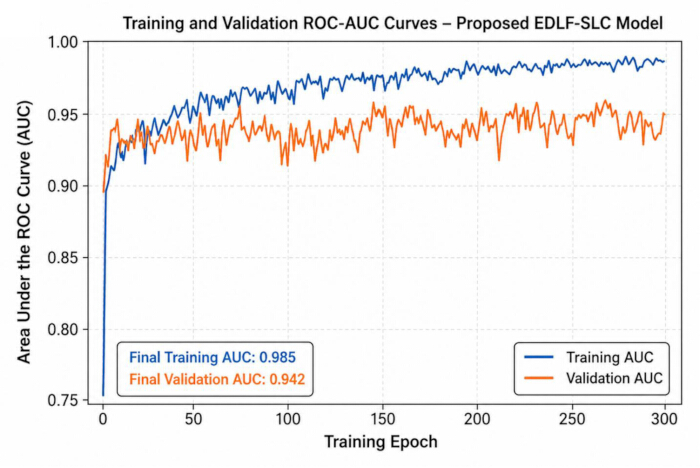
Рисунок 6: Площадь под ROC-кривой (ROC-AUC) при обучении и валидации предлагаемой модели EDLF-SLC на протяжении 300 эпох обучения. Синяя кривая представляет AUC обучения, в то время как оранжевая кривая представляет AUC валидации. Модель демонстрирует быструю сходимость в течение начальных эпох обучения с последующей стабильной оптимизацией и неизменно высокими значениями AUC обучения и валидации на протяжении всех оставшихся эпох. Стабильные показатели валидации свидетельствуют о хорошей обобщающей способности и устойчивом процессе обучения предлагаемой структуры EDLF-SLC на валидационном наборе данных. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
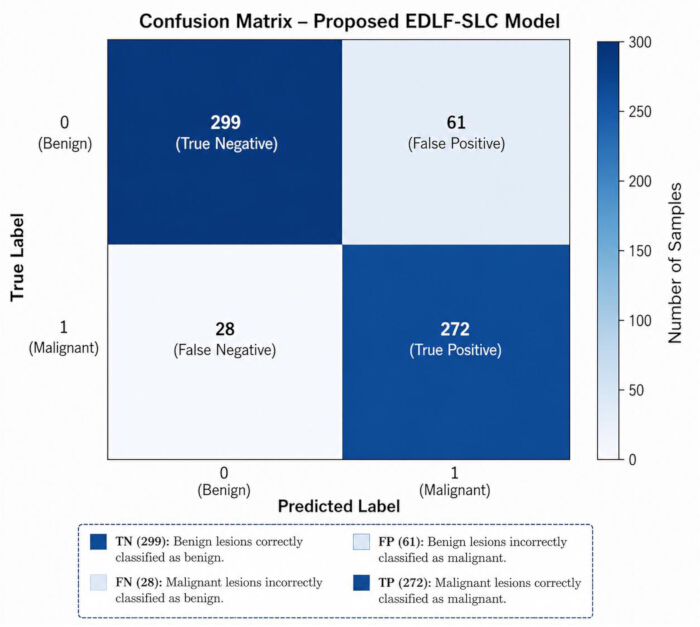
Рисунок 7: Матрица ошибок предлагаемой модели EDLF-SLC на тестовом наборе данных. Строки представляют истинные метки классов (0 = доброкачественные, 1 = злокачественные), тогда как столбцы представляют прогнозируемые метки классов. Диагональные элементы указывают на правильно классифицированные образцы (299 доброкачественных и 272 злокачественных), в то время как внедиагональные элементы соответствуют ошибочно классифицированным образцам, включая 61 ложноположительный и 28 ложноотрицательный результаты. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
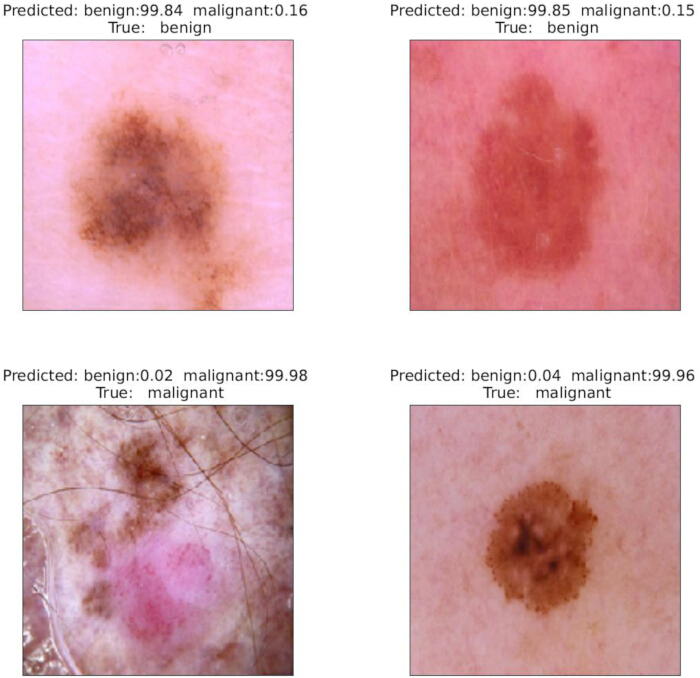
Рисунок 8: Примеры прогнозов, сгенерированных предложенной моделью EDLF-SLC. На данном рисунке показаны уровни достоверности классификации доброкачественных и злокачественных поражений, что демонстрирует дискриминационную способность модели. Пожалуйста, нажмите здесь, чтобы просмотреть этот рисунок в большем размере.
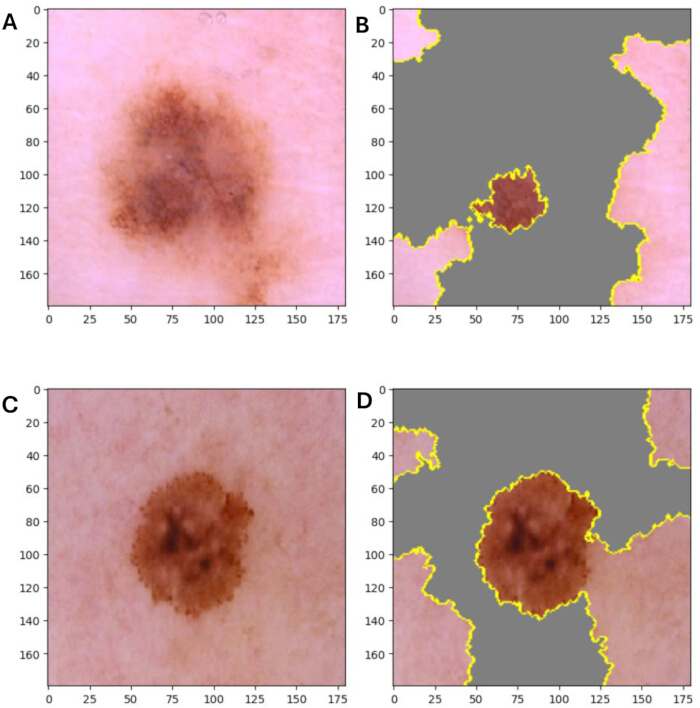
Рисунок 9: Локальные объяснения на основе LIME для предлагаемой модели EDLF-SLC. На рисунке выделены наиболее влиятельные области суперпикселей, которые определили решения модели по классификации. (A) Исходное дерматоскопическое изображение доброкачественного поражения кожи. (B) Объяснение LIME для доброкачественного поражения, где выделенные суперпиксели указывают на области, внесшие наибольший вклад в прогноз о доброкачественности. (C) Исходное дерматоскопическое изображение злокачественного поражения кожи. (D) Объяснение LIME для злокачественного поражения, демонстрирующее дискриминантные области суперпикселей, которые преимущественно повлияли на классификацию как злокачественного. Желтые границы очерчивают влиятельные суперпиксели, определенные LIME, в то время как серые области представляют зоны с минимальным вкладом в прогноз. Пожалуйста, нажмите здесь, чтобы просмотреть этот рисунок в большем размере.
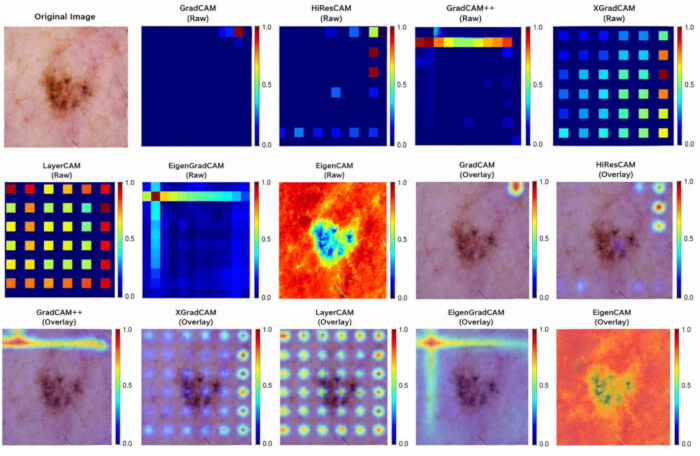
Рисунок 10: Сравнение методов интерпретируемости на основе карт активации классов (CAM), примененных к предложенной модели EDLF-SLC. На рисунке сравниваются карты локализации, созданные GradCAM, HiResCAM, GradCAM++, XGradCAM, LayerCAM, EigenGradCAM и EigenCAM для одного и того же дерматоскопического изображения. На первой панели показано исходное входное изображение, за которым следуют соответствующие необработанные карты активации и наложенные тепловые карты, полученные с помощью каждого метода интерпретируемости. Визуализации демонстрируют различия в пространственной локализации и выделяют области изображения, которые вносят наибольший вклад в решение о классификации в рамках предложенной структуры EDLF-SLC. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
| Лист. | Год | Набор данных | Объем данных | Извлечение признаков | Метод | Точность |
| 9 | 2022 | Набор данных HAM10000 | 10015 изображений поражений кожи | Признаки цвета и формы | Алгоритмы ML и модели сверточных нейронных сетей (CNN) | 95.1% |
| 19 | 2023 | Набор данных PH2 | 200 аннотированных изображений | Признаки асимметрии, полос, точек/глобул, зон регрессии | Модели ML | 94.0% |
| 30 | 2024 | Набор данных HAM10000 | 10000 изображений | Признаки цвета и формы | S-MobileNet | 97.7% |
| 28 | 2025 | Наборы данных ISIC2020 и HAM10000 | ISIC2020 (12,670 изображений) и HAM10000 (10,015 изображений) | Цвет и форма | Резидуальная сеть — долгая краткосрочная память (R-LSTM50) | 95.7% (ISIC2020); 94.2% (HAM10000) |
| 32 | 2026 | Набор данных поражений кожи при оспе обезьян (MSLD) | 770 изображений | Контекст и текстура | DenseNet121, Xception, InceptionV3 и CBAM | 88% (DenseNet121) |
| 39 | 2025 | HAM10000 | 38,569 изображений | Контекст и текстура | MobileNet, ResNet50, InceptionV3 и EfficientNet | 93.6% (MobileNet) |
| 40 | 2025 | ISIC 2019 | 2357 изображений | Контекстные и пространственные признаки | Мультимодальное глубокое обучение (DL) на основе CNN-трансформеров | 98.71% |
| 41 | 2026 | ISIC 2019 | 25,000 изображений | Контекст и текстура | TransXV2S | 95.26% |
| 42 | 2025 | HAM10000 | 10,015 изображений | Цвет и форма | ViT с YOLOv8 | 93% |
Таблица 1: Сравнение с литературой. Обзор некоторых недавно опубликованных работ, в которых используются алгоритмы глубокого обучения для классификации поражений кожи.
| Набор данных | Доброкачественный | Злокачественный | Общее количество |
| Обучающие данные | 1440 | 1197 | 2637 |
| Тестовые данные | 360 | 300 | 660 |
| Общий объем данных | 1800 | 1497 | 3297 |
Таблица 2: Распределение набора данных. Распределение доброкачественных и злокачественных образцов в наборе данных ISIC 2020, включая обучающую и тестовую выборки.
| Компонент | Спецификация |
| Операционная система | Ubuntu 20.04 |
| Язык программирования | Python 3.9 |
| Фреймворк глубокого обучения | PyTorch 2.3.1 |
| Оптимизатор | Адам |
| Планирование скорости обучения | 1e−3 |
| Количество эпох | 100/300 |
| ЦПУ | 2 vCPU 2,2 ГГц |
| ГП (графический процессор) | Tesla T4 (16 ГБ) × 1 |
| ОЗУ | 16 ГБ |
| Обучаемые параметры | 2 430 353 (9,27 МБ) |
| Необучаемые параметры | 133 434 397 (509,01 МБ) |
Таблица 3: Характеристики системы. Подробные спецификации вычислительной среды, включая программные платформы и аппаратные ресурсы, использованные для обучения и оценки модели.
| Класс | Точность (Precision) | Полнота (Recall) | F1-мера | Поддержка (Support) |
| Доброкачественный класс | 0.83 | 0.88 | 0.85 | 360 |
| Злокачественный класс | 0.84 | 0.78 | 0.81 | 300 |
| Общая точность (Accuracy) | - | - | 0.832 | 660 |
| Макросреднее | 0.84 | 0.83 | 0.83 | 660 |
| Взвешенное среднее | 0.84 | 0.83 | 0.83 | 660 |
Таблица 4: Отчет о классификации. Показатели эффективности классификации модели ResNet-50 на тестовом наборе данных, включая точность (precision), полноту (recall), F1-меру (F1-score) и количество объектов (support) для каждого класса.
| Модель | Точность | Точность | Полнота (Recall) | F1-мера | Время (с) |
| NASNetLarge | 0.77 | 0.76 | 0.77 | 0.76 | 2002.47 |
| EfficientNetB0 | 0.85 | 0.85 | 0.85 | 0.85 | 734.8 |
| Xception | 0.8 | 0.81 | 0.8 | 0.8 | 732.23 |
| ResNetV2 | 0.63 | 0.64 | 0.63 | 0.611 | 1072.34 |
| MobileNet | 0.79 | 0.8 | 0.79 | 0.79 | 629.29 |
| MobileNetV2 | 0.77 | 0.79 | 0.77 | 0.77 | 660.5 |
| ResNet50 | 0.83 | 0.83 | 0.83 | 0.83 | 749.77 |
| EDLF-SLC | 0.88 | 0.89 | 0.87 | 0.88 | 3279.77 |
Таблица 5: Сравнение производительности моделей. Сравнительная производительность предлагаемой модели EDLF-SLC и базовых моделей глубокого обучения по показателям точности (accuracy), прецизионности (precision), полноты (recall), F1-меры (F1-score) и времени вычислений.
| Модель | Точность | Точность | Полнота | F-мера (F1-score) |
| ResNet-18 [25] | 0.85 | 0.85 | 0.85 | 0.85 |
| ResNet-50 с SVM [50] | 0.87 | 0.88 | 0.98 | 0.93 |
| Гибридные модели глубокого обучения + SVM [48] | 0.86 | 0.84 | 0.8 | 0.84 |
| Гибридные модели глубокого обучения + SVM [49] | 0.86 | 0.8 | 0.6 | 0.68 |
| Предлагаемый EDLF-SLC | 0.88 | 0.89 | 0.87 | 0.88 |
Таблица 6: Метрики сравнения моделей. Сравнение эффективности предлагаемого фреймворка EDLF-SLC и современных передовых подходов к классификации новообразований кожи.
Дополнительный файл 1: Алгоритм 1. Рабочий процесс предлагаемого фреймворка EDLF-SLC, описывающий предварительную обработку данных, извлечение глубоких признаков с использованием нескольких архитектур CNN, классификацию на основе SVM и интерпретируемость на базе LIME для прогнозирования поражений кожи. Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Дополнительный файл 2: Алгоритм 2. Рабочий процесс локального объяснения на основе LIME, иллюстрирующий генерацию суперпикселей, выборку пертурбаций, построение суррогатной модели и визуализацию областей изображения, которые в наибольшей степени повлияли на решение по классификации. Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Обсуждение
Предложенная интерпретируемая структура глубокого обучения для классификации кожных новообразований (EDLF-SLC) демонстрирует, что сочетание дополняющих друг друга представлений глубоких признаков с объяснимым искусственным интеллектом позволяет повысить как точность классификации, так и прозрачность модели. Благодаря интеграции нескольких предобученных архитектур CNN (ResNet50, EfficientNetB0, MobileNet и Xception) для извлечения признаков и использованию метода опорных векторов (SVM) для окончательной классификации, данная структура задействует преимущества различных экстракторов признаков для создания более насыщенных и дискриминативных представлений новообразований по сравнению с теми, что были бы получены из одной базовой сети. Кроме того, интеграция локальных интерпретируемых объяснений, не зависящих от модели (LIME), обеспечивает локализованные визуальные пояснения, что позволяет клиницистам понимать, какие области изображения в наибольшей степени влияют на каждый прогноз, и повышает уверенность в диагностических решениях модели.
Экспериментальные результаты демонстрируют, что EDLF-SLC обеспечивает конкурентоспособную производительность по сравнению с базовыми моделями CNN, включая MobileNet, Xception и ResNet50, что подчеркивает эффективность слияния взаимодополняющих признаков и классификации на основе SVM. Сравнение с современными передовыми подходами дополнительно подтверждает конкурентоспособность предложенной структуры. Например, в двух исследованиях48,49 сообщалось о точности примерно 0,86 при использовании методов ансамблирования, в то время как другие гибридные структуры CNN-SVM25,50,51,52,53 достигали точности до 0,87, но опирались на более сложные архитектуры и дополнительные модули предобработки или сегментации. Напротив, предложенная структура достигает точности 0,88, используя сравнительно упрощенную архитектуру без необходимости явной сегментации поражений, одновременно обеспечивая интерпретируемость прогнозов с помощью LIME. Эти результаты указывают на то, что объединение взаимодополняющих экстракторов признаков CNN перед классификацией SVM может повысить диагностическую эффективность при сохранении простоты и прозрачности архитектуры.
Хотя предложенная архитектура повышает точность классификации и интерпретируемость, это улучшение достигается за счет увеличения вычислительных затрат. Общее время обучения EDLF-SLC составляет приблизительно 3279.77 s, что значительно выше, чем у отдельных моделей CNN, таких как ResNet50 (749.77 s) и MobileNet (629.29 s). Эти дополнительные вычислительные затраты обусловлены обучением нескольких предобученных CNN и выполнением слияния признаков перед классификацией. Подобный компромисс часто наблюдается в гибридных подходах и методах ансамблевого обучения, где повышение прогностической эффективности достигается ценой более высоких требований к вычислительным ресурсам. Тем не менее, в системах поддержки принятия клинических решений диагностическая точность, робастность и надежность обычно считаются более важными, чем эффективность обучения, поскольку они напрямую влияют на исходы для пациентов.
Еще одним важным преимуществом предлагаемого фреймворка является его интерпретируемость. В отличие от традиционных моделей глубокого обучения, которые часто функционируют как «черные ящики», EDLF-SLC включает LIME для предоставления специфических для каждого случая визуальных объяснений процесса прогнозирования. Эти объяснения помогают клиницистам проверить, фокусируется ли модель на клинически значимых областях поражения, что повышает прозрачность, поддерживает клиническую интерпретацию и способствует доверию к диагностике с помощью ИИ. Следовательно, предлагаемый фреймворк обеспечивает практический баланс между прогностической способностью и интерпретируемостью модели, что делает его перспективным инструментом компьютерной поддержки принятия решений для классификации новообразований кожи.
Несмотря на эти обнадеживающие результаты, следует признать наличие нескольких ограничений. Во-первых, оценка данной структуры проводилась только с использованием общедоступного набора данных ISIC, и ее способность к обобщению применительно к изображениям, полученным в различных клинических условиях, с помощью разных устройств визуализации и у разных групп пациентов, еще требует подтверждения. Во-вторых, использование нескольких предобученных архитектур CNN неизбежно повышает вычислительную сложность и время обучения по сравнению с моделями с одним базовым звеном (backbone). В-третьих, на протяжении всех экспериментов применялись фиксированные значения гиперпараметров, и дальнейшая оптимизация может улучшить производительность и адаптивность при работе с различными наборами данных. Наконец, хотя LIME повышает прозрачность модели, предоставляемые им объяснения являются локальными и зависят от пертурбаций, что означает, что согласованность объяснений может варьироваться между запусками и должна быть дополнительно подтверждена экспертами-дерматологами перед внедрением в рутинную клиническую практику.
Будущие исследования будут сосредоточены на валидации предложенного фреймворка с использованием нескольких крупномасштабных и многоцентровых наборов данных по новообразованиям кожи, оптимизации вычислительной эффективности за счет применения методов легковесного слияния признаков и сжатия моделей, изучении передовых стратегий оптимизации гиперпараметров, а также расширении возможностей фреймворка для многоклассовой классификации поражений кожи. Кроме того, интеграция дополнительных методов объяснимого ИИ и проведение проспективных клинических оценок с участием дерматологов позволят дополнительно повысить надежность, интерпретируемость и практическую применимость предложенного фреймворка в реальных клинических условиях.
Раскрытие информации
Авторы заявляют об отсутствии конфликта интересов.
Благодарности
Авторы выражают искреннюю благодарность Университету Таифа за предоставление исследовательской среды и институциональную поддержку, которые способствовали завершению данной работы.
Материалы
| Имя | Компания | Каталожный номер | Комментарии |
|---|---|---|---|
| Набор данных кожных поражений ISIC 2020 | International Skin Imaging Collaboration (ISIC) | Набор данных конкурса ISIC 2020 | Набор дерматоскопических изображений, используемый для разработки и оценки моделей. |
| Keras | Keras Team | Интегрирован с TensorFlow | Построение и обучение моделей глубокого обучения. |
| LIME (Local Interpretable Model-Agnostic Explanations) | Ribeiro et al. | Пакет Python | Создание локальных визуальных объяснений прогнозов моделей. |
| Matplotlib | Matplotlib Developers | Последняя совместимая версия | Визуализация кривых обучения, матриц ошибок и графиков оценки. |
| NumPy | NumPy Developers | Последняя совместимая версия | Численные вычисления и манипуляции с массивами. |
| NVIDIA Tesla T4 GPU | NVIDIA Corporation | 16 GB VRAM | Ускорение обучения и логического вывода моделей. |
| Pandas | Pandas Development Team | Последняя совместимая версия | Обработка данных и управление результатами экспериментов. |
| Предобученные модели CNN | TensorFlow/Keras Applications | ResNet50, EfficientNetB0, MobileNet, Xception | Извлечение глубоких признаков из дерматоскопических изображений. |
| Python | Python Software Foundation | Версия 3.9 | Язык программирования, использованный для реализации. |
| PyTorch | PyTorch Foundation | Версия 2.3.1 | Фреймворк глубокого обучения, использованный для извлечения признаков и реализации модели. |
| Scikit-learn | Scikit-learn Developers | Последняя совместимая версия | Метод опорных векторов (SVM), метрики оценки и предобработка данных. |
| Метод опорных векторов (RBF-ядро) | Scikit-learn | SVC | Классификация объединенных представлений глубоких признаков. |
| TensorFlow | Google LLC | Версия 2.x | Фреймворк глубокого обучения для обучения и логического вывода моделей. |
| Операционная система Ubuntu | Canonical Ltd. | Ubuntu 20.04 | Операционная среда для проведения экспериментов. |
Ссылки
- Chan S, Reddy V, Myers B, Thibodeaux Q, Brown-Stone N, Liao W. Machine learning in dermatology: current applications, opportunities, and limitations. Dermatol Ther (Heidelb). 2020;10:365-386.
- Olsen CM. Global trends in melanoma mortality differ by sex and age. Br J Dermatol. 2020;183(6):985-986.
- Sun Y, Shen Y, Liu Q, Zhang H, Jia L, Chai Y, et al. Global trends in melanoma burden: a comprehensive analysis from the Global Burden of Disease Study, 1990-2021. J Am Acad Dermatol. 2025;92(1):100-107.
- Monika MK, Vignesh NA, Kumari CU, Kumar M, Lydia EL. Skin cancer detection and classification using machine learning. Mater Today Proc. 2020;33:4266-4270.
- Hosny KM, Elshora D, Mohamed ER, Vrochidou E, Papakostas GA. Deep learning and optimization-based methods for skin lesions segmentation: a review. IEEE Access. 2023.
- Baghdadi NA, Farghaly Abdelaliem SM, Malki A, Gad I, Ewis A, Atlam ES. Advanced machine learning techniques for cardiovascular disease early detection and diagnosis. J Big Data. 2023;10(1):144.
- Veeramani N, Jayaraman P, Krishankumar R, Ravichandran KS, Gandomi AH. DDCNN-F: double decker convolutional neural network feature fusion as a medical image classification framework. Sci Rep. 2024;14(1).
- Veeramani N, Jayaraman P. YOLOv7-XAI: multiclass skin lesion diagnosis using explainable artificial intelligence with fair decision making. Int J Imaging Syst Technol. 2024;34(6).
- Shetty B, Fernandes R, Rodrigues AP, Chengoden R, Bhattacharya S, Lakshmanna K. Skin lesion classification of dermoscopic images using machine learning and convolutional neural network. Sci Rep. 2022;12(1):18134.
- Ali AR, Li J, Yang G, O'Shea SJ. A machine learning approach to automatic detection of irregularity in skin lesion border using dermoscopic images. PeerJ Comput Sci. 2020;6:e268.
- Pham TTH, Luu TN, Nguyen TV, Huynh NT, Phan QH, Le TH. Polarimetric imaging combining optical parameters for classification of mice non-melanoma skin cancer tissue using machine learning. Heliyon. 2023;9(11).
- Liu N, Rejeesh M, Sundararaj V, Gunasundari B. ACO-KELM: anti coronavirus optimized kernel-based softplus extreme learning machine for classification of skin cancer. Expert Syst Appl. 2023;232:120719.
- Masud M, Almars AM, Rokaya MB, Meshref H, Gad I, Atlam ES. A novel lightweight convolutional neural network model to predict Alzheimer's disease applying weighted loss function. J Disabil Res. 2024;3(4):20240042.
- Kumar A, Veeraiah V, Gongada TN, Ahamad S, Khan H, Gupta A. Explainable machine learning models for clinical decision support systems. In: 2024 15th International Conference on Computing Communication and Networking Technologies (ICCCNT). Piscataway (NJ): IEEE; 2024. p. 1-6.
- Shahzad K, Wasim M, Pires IM, Garcia NM. Multi-classification of skin lesions using a deep learning-based convolutional neural network. Procedia Comput Sci. 2024;241:588-593.
- Celebi ME, Kingravi HA, Uddin B, Iyatomi H, Aslandogan YA, Stoecker WV, et al. A methodological approach to the classification of dermoscopy images. Comput Med Imaging Graph. 2007;31(6):362-373.
- Li CX, Shen CB, Xue K, Shen X, Jing Y, Wang ZY, et al. Artificial intelligence in dermatology: past, present, and future. Chin Med J (Engl). 2019;132(17):2017-2020.
- Ramprasad M, Nagesh S, Sahith V, Lankalapalli RK. Hierarchical agglomerative clustering based skin lesion detection with region-based neural networks classification. Meas Sens. 2023;29:100865.
- Khater T, Ansari S, Mahmoud S, Hussain A, Tawfik H. Skin cancer classification using explainable artificial intelligence on pre-extracted image features. Intell Syst Appl. 2023;20:200275.
- Wang H, Ahn E, Bi L, Kim J. Self-supervised multi-modality learning for multi-label skin lesion classification. Comput Methods Programs Biomed. 2025;265:108729.
- Thapar P, Rakhra M, Alsaadi M, Quraishi A, Deka A, Naga Ramesh JV. A hybrid grasshopper optimization algorithm for skin lesion segmentation and melanoma classification using deep learning. Healthc Anal. 2024;5:100326.
- Kumar S, Nath VK, Hazarika D. Blend of deep features and binary tree growth algorithm for skin lesion classification. Symmetry (Basel). 2023;15(12):2213.
- Chandrahaas BV, Mohanty SN, Panda SK, et al. An empirical study on classification of monkeypox skin lesion detection. EAI Endorsed Trans Pervasive Health Technol. 2023;9:e4.
- Talavera-Martínez L, Bibiloni P, Giacaman A, Taberner R, de Paz Hernando LJD, González-Hidalgo M. A novel approach for skin lesion symmetry classification with a deep learning model. Comput Biol Med. 2022;145:105450.
- Ieracitano C, Morabito FC, Hussain A, Suffian M, Mammone N. TIXAI: a trustworthiness index for explainable artificial intelligence in skin lesion classification. Neurocomputing. 2025;630:129701.
- Hasan MK, Elahi MTE, Alam MA, Jawad MT, Martí R. DermoExpert: skin lesion classification using a hybrid convolutional neural network through segmentation, transfer learning, and augmentation. Inform Med Unlocked. 2022;28:100819.
- Koparde S, Kotwal J, Deshmukh S, Adsure S, Chaudhari P, Kimbahune V. Conditional generative adversarial networks and YOLOv5 Darknet-based skin lesion localization and classification using an independent component analysis model. Inform Med Unlocked. 2024;47:101515.
- Padhy S, Dash S, Kumar N, Singh SP, Kumar G, Moral P. Temporal integration of ResNet features with LSTM for enhanced skin lesion classification. Results Eng. 2025;25:104201.
- Xin C, Liu Z, Ma Y, Wang D, Zhang J, Li L, et al. Transformer-guided self-adaptive network for multi-scale skin lesion image segmentation. Comput Biol Med. 2024;169:107846.
- Sulthana R, Chamola V, Hussain Z, Albalwy F, Hussain A. A novel end-to-end deep convolutional neural network-based skin lesion classification framework. Expert Syst Appl. 2024;246:123056.
- Chamarthi S, Fogelberg K, Brinker TJ, Niebling J. Mitigating the influence of domain shift in skin lesion classification: a benchmark study of unsupervised domain adaptation methods. Inform Med Unlocked. 2024;44:101430.
- Maity S, Paul S, Guha S, Dasgupta S, Ghosh M. Automated classification of monkeypox skin lesions using a hybrid deep learning model. Biomed Signal Process Control. 2026;126:110955.
- Nasir S, Bilal M, Khalidi H. Detection and classification of skin cancer by using CNN-enabled cloud storage data access control algorithm based on blockchain technology. Int J Theor Appl Comput Intell. 2025:145-169.
- Saba T. Computer vision for microscopic skin cancer diagnosis using handcrafted and non-handcrafted features. Microsc Res Tech. 2021;84(6):1272-1283.
- Fayyad J, Alijani S, Najjaran H. Empirical validation of conformal prediction for trustworthy skin lesion classification. Comput Methods Programs Biomed. 2024;253:108231.
- Liu P, Qian W, Li H, Cao J. A relationship-aware mutual learning method for lightweight skin lesion classification. Digit Commun Netw. 2025;11(3):603-612.
- Adla D, Reddy GVR, Nayak P, Karuna G. A full-resolution convolutional network with a dynamic graph cut algorithm for skin cancer classification and detection. Healthc Anal. 2023;3:100154.
- Thamizhamuthu R, Maniraj SP. Deep learning-based dermoscopic image classification system for robust skin lesion analysis. Trait Signal. 2023;40(3).
- Di Giammarco M, Santone A, Cesarelli M, Martinelli F, Mercaldo F. A method for skin lesion detection and localization by means of deep learning and reliable prediction explainability. Image Vis Comput. 2025;162:105675.
- Haq IU, Joarder HA, Khan AA, Shi X, Alsayaydeh JAJ, Yusof MFB, et al. XAAI-ledger: an explainable CNN-transformer-based multimodal deep learning framework for early detection of melanoma and non-melanoma skin cancers using dermoscopic and clinical data. Biomed Signal Process Control. 2026;123:110410.
- Saeed K, Shehzad M, Malik MGA, Ahmed S, Azar AT. TransXV2S-NET: a novel hybrid deep learning architecture with dual-contextual graph attention for multi-class skin lesion classification. Knowl Based Syst. 2026;337:115407.
- AbuAlkebash H, Saleh RAA, Ertunç HM. Automated explainable deep learning framework for multiclass skin cancer detection and classification using hybrid YOLOv8 and vision transformer (ViT). Biomed Signal Process Control. 2025;108:107934.
- Hasan MK, Ahamad MA, Yap CH, Yang G. A survey, review, and future trends of skin lesion segmentation and classification. Comput Biol Med. 2023;155:106624.
- Li H, Pan Y, Zhao J, Zhang L. Skin disease diagnosis with deep learning: a review. Neurocomputing. 2021;464:364-393.
- Wu Y, Chen B, Zeng A, Pan D, Wang R, Zhao S. Skin cancer classification with deep learning: a systematic review. Front Oncol. 2022;12:893972.
- Fanconic. Skin cancer: malignant vs benign dataset. Kaggle; 2023. Available from: https://www.kaggle.com/datasets/fanconic/skin-cancer-malignant-vs-benign
- Ribeiro MT, Singh S, Guestrin C. "Why should I trust you?": Explaining the predictions of any classifier. In: Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining (KDD '16). New York (NY): ACM; 2016. p. 1135-1144.
- Bassel A, Abdulkareem AB, Alyasseri ZAA, Sani NS, Mohammed HJ. Automatic malignant and benign skin cancer classification using a hybrid deep learning approach. Diagnostics (Basel). 2022;12(10):2472.
- Bhardwaj A, Rege PP. Skin lesion classification using deep learning. In: Advances in Signal and Data Processing: Select Proceedings of ICSDP 2019. Singapore: Springer; 2021. p. 575-589.
- Keerthana D, Venugopal V, Nath MK, Mishra M. Hybrid convolutional neural networks with SVM classifier for classification of skin cancer. Biomed Eng Adv. 2023;5:100069.
- Ahmed A, Siam AI, Atwa MA, Atwa EM, Abdelrahim EM, Atlam ES. An explainable YOLO-based deep learning framework for pneumonia detection from chest X-ray images. Algorithms. 2025;18(11):703.
- Farsi M, ZainEldin H, Sayed RF, El-Agamy ES, Atlam SA, Alsaedi M, et al. Deep learning for pathology: YOLOv8 with EigenCAM for reliable colorectal cancer diagnostics. Bioengineering (Basel). 2025;12(11):1203.
- Atwa EA, Atlam ES, Ahmed A, Atwa MA, Abdelrahim EM, Siam AI. Interpretable deep learning models for arrhythmia classification based on ECG signals using the PTB-XL dataset. Diagnostics (Basel). 2025;15(15):1950.