В данной работе предлагается новая модель — графовые нейронные сети с линейным вниманием на основе затворных слотов (gated-slot linear attention graph neural networks) для рекомендаций на основе сессий, в которой используется механизм линейного внимания с затворными слотами на базе дважды сконструированного графа сессий. Данный подход повышает точность и эффективность рекомендаций и превосходит современные методы (SOTA) на трех общедоступных наборах данных.
Исследовательская статья
Графовые нейронные сети с линейным вниманием и вентилируемыми слотами для рекомендаций на основе сессий
В этой статье
Краткое содержание
Аннотация
Системы рекомендаций на основе сессий (SBR) предназначены для прогнозирования следующего объекта, с которым пользователь, вероятно, будет взаимодействовать, исходя из последовательности действий в рамках текущей сессии. Современные подходы, использующие механизм внимания Transformer (например, GC-SAN), продемонстрировали более высокую эффективность по сравнению с традиционными методами; однако они характеризуются высокой вычислительной нагрузкой и пространственной сложностью из-за квадратичной стоимости самовнимания (self-attention). Для преодоления этих ограничений предлагается новая модель под названием GSLA4Rec (графовые нейронные сети с линейным вниманием на основе гейтированных слотов для рекомендаций на основе сессий), которая интегрирует линейное внимание с обучаемым механизмом гейтирования и стратегией обновления памяти на основе слотов, вдохновленной механизмом gated-slot attention. В частности, GSLA4Rec сначала строит два графа: граф сессии для фиксации переходов между объектами внутри одной сессии и глобальный граф соседей для кодирования коллаборативных сигналов между сессиями, моделируя таким образом как локальную, так и глобальную контекстную информацию. Предложенный подход основан на механизме линейного внимания с гейтированными слотами, который (1) использует блоки гейтирования для подавления шума от нерелевантных или избыточных взаимодействий в длинных сессиях, (2) использует слотовые блоки для динамического хранения и обновления компактных представлений сессий, что снижает затраты памяти, и (3) заменяет самовнимание линейным вниманием для достижения линейной временной сложности. В совокупности эти компоненты значительно повышают точность прогнозирования модели и эффективность фиксации меняющихся интересов пользователей. Обширные эксперименты на нескольких общедоступных эталонных наборах данных, включая Diginetica, Tmall и NowPlaying, показывают, что GSLA4Rec последовательно превосходит современные SOTA-методы SBR по качеству рекомендаций, что подтверждает эффективность механизма GSLA.
Введение
С быстрым развитием онлайн-сервисов (таких как электронная коммерция, платформы коротких видеороликов и новостные ленты) проблема избытка информации становится все более заметной и серьезной. Рекомендательные системы1,2 обеспечивают персонализированную и точную рассылку информации путем глубокого анализа данных о поведении пользователей. Однако во многих практических приложениях, характеризующихся анонимным доступом, наличием неавторизованных пользователей, защитой конфиденциальности и короткой продолжительностью взаимодействия, традиционные методы рекомендаций, такие как коллаборативная фильтрация3 и матричная факторизация4,5, существенно ограничивают применимость алгоритмов рекомендаций. Для решения этих проблем появились SBR6,7,8,9. SBR фокусируется на последовательности взаимодействий в рамках текущей сессии пользователя для прогнозирования следующего потенциального объекта интереса. Эта парадигма не только позволяет избежать зависимости от долгосрочных исторических данных пользователей, но и точно фиксирует краткосрочные динамические изменения интересов, демонстрируя тем самым уникальную ценность применения в таких сценариях, как электронная коммерция, короткие видео, рекомендация музыки и так далее.
Ранние методы в основном опирались на цепи Маркова5,10,11,12 для моделирования вероятностей переходов между элементами в сессионных последовательностях. Хотя эти методы позволяли фиксировать зависимости первого порядка, возможности характеристики сложных зависимостей высокого порядка и нелинейной динамики пользовательских интересов оставались ограниченными, что снижало эффективность моделей в сложных сценариях. С развитием технологий глубокого обучения13,14 методы на основе нейронных сетей стали широко применяться в SBR. GRU4REC15 стал первым методом применения рекуррентных нейронных сетей14 (RNNs) для рекомендаций на основе сессий, что позволило эффективно фиксировать временные зависимости в последовательностях; NARM16 далее расширил возможности выявления основных интересов пользователей путем интеграции механизмов внимания с RNN; STAMP17 использовал многослойные перцептроны (MLPs) в сочетании с механизмами внимания для фокусировки на краткосрочных интересах пользователей. Несмотря на определенный прогресс в моделировании последовательностей, эти методы все еще сталкивались с такими проблемами, как трудности при обработке долгосрочных зависимостей и чувствительность к шуму.
В последние годы графовые нейронные сети (Graph Neural Networks, GNNs)18,19,20,21привнесли новый подход к решению задачи SBR. Такие модели, как SR-GNN22, эксплицитно моделируют сложные переходные связи путем построения графа сессии (session graph, SG), что позволяет добиться существенного повышения точности рекомендаций. Однако большинство существующих методов на базе GNN осуществляют построение графа и передачу сообщений внутри отдельных сессий, что не позволяет эффективно использовать информацию о глобальных корреляциях между объектами. Для решения этой проблемы в GCE-GNN23 глобальная семантика и графы сессий объединяются с помощью механизма самовнимания (self-attention) для адаптивного взвешивания значимости объектов путем построения соседнего глобального графа (neighbor global graph, NGG), что приводит к значительному улучшению производительности. Тем не менее методы на базе GNN по-прежнему сталкиваются с двумя основными проблемами: во-первых, сложность механизма самовнимания растет квадратично по мере увеличения длины сессии, что приводит к значительным вычислительным затратам при обработке длинных сессий; во-вторых, традиционные GNN не обладают способностью динамически регулировать значимость объектов в процессе агрегации информации, из-за чего становится трудно отличить шум от критически важных действий, что отрицательно сказывается на качестве представления.
Для решения этих проблем в данной работе предлагается графовая нейронная сеть с линейным вниманием и механизмом вентильных слотов для рекомендаций на основе сессий (GSLA4Rec): (1) разработка механизма вентильных слотов, который фильтрует шум с помощью гейтинга и сохраняет ключевую семантическую информацию в слотах сессии, что повышает робастность модели и снижает затраты на хранение данных; (2) внедрение механизма линейного внимания, который снижает вычислительную сложность с O(N2) до O(N), где N — длина сессии, сохраняя при этом способность моделировать долгосрочные зависимости; (3) проведение обширных экспериментов на трех общедоступных эталонных наборах данных (Diginetica, Tmall и NowPlaying), показавших, что GSLA4Rec значительно превосходит существующие современные методы (SOTA), демонстрируя явные преимущества особенно в сценариях с длинными сессиями и разреженными данными.
Протокол
Опыт использования сессионных рекомендаций
Рекомендации на основе сессий можно рассмотреть с трех точек зрения: SBR, глобального контекстного обучения и GSLA (см. Таблицу материалов). В данном исследовании не принимали участия люди или животные. Все экспериментальные наборы данных, использованные в этой работе, находятся в открытом доступе и представлены в Дополнительном файле: GSLA4Rec. zip.
Сессионные рекомендации
Рекомендательная система на основе сессий (SBR) представляет собой систему искусственного интеллекта, которая взаимодействует с пользователями посредством многоходовых диалогов на естественном языке для динамического понимания предпочтений пользователей и предоставления персонализированных рекомендаций. SBR эволюционировала от традиционных методов к подходам на основе глубокого обучения и гибридным методам, а затем развилась в сторону решений на базе больших языковых моделей (LLM).
Традиционные рекомендации на основе сессий
Традиционные системы SBR обычно представляли собой методы на основе цепей Маркова и коллаборативную фильтрацию. Первые генерировали рекомендации путем разложения специфичных для пользователя вероятностных матриц переходов. Например, Guy Shani24 предложил метод рекомендаций на основе марковского процесса принятия решений, который создавал рекомендации путем разложения соответствующих матриц; Wanrong Gu25 повысил эффективность рекомендаций, интегрировав цепи Маркова с интервалами времени между покупками. Вторые генерировали рекомендации путем извлечения скрытых последовательных связей между смежными объектами взаимодействия с помощью матричного разложения. Так, Sarwar B1 рассчитывал сходство между объектами на основе истории поведения пользователей (такой как оценки и клики), чтобы рекомендовать объекты, соответствующие прошлым предпочтениям пользователей. Если пользователю A понравился объект a, а объект c был очень похож на a, система рекомендует c пользователю A; Rendle S5 предложил FPMC — модель рекомендаций последовательностей, сочетающую матричное разложение с цепями Маркова для фиксации скрытых последовательных связей между смежными объектами взаимодействия. Однако такие традиционные SBR фокусировались на последовательных связях между соседними объектами, что затрудняло моделирование сложных зависимостей.
Рекомендательная система на основе сессий с использованием глубокого обучения
Рекомендательные системы на основе сессий с применением глубокого обучения прошли через этапы эволюции, включавшие использование сверточных нейронных сетей (CNN)26,27,28,29, рекуррентных нейронных сетей (RNN) и графовых нейронных сетей (GNN). SBR на базе CNN использовали такие операции, как свертка и пулинг, для изучения представлений контекста каждой сессии, которые затем применялись для последующих рекомендаций. В модели Caser30 L последних элементов, с которыми взаимодействовал пользователь, преобразовывали в d-мерные векторы с помощью слоя вложения, формируя матрицу вложений, которая рассматривалась как «изображение», отображенное во временном и латентном пространстве. Затем использовались три сверточных фильтра паттернов последовательности — на уровне точек, на уровне объединения без пропуска и на уровне объединения с одним пропуском — для изучения последовательных паттернов с целью повышения эффективности SBR. Tuan и соавт.31 единообразно моделировали потоки кликов в сессиях и признаки контента с помощью ядер 3D-свертки для формирования совместных пространственно-временных контентных представлений.
Рекуррентные нейронные сети (РНС) представляли собой класс архитектур нейронных сетей, специально разработанных для обработки последовательных данных. Основная идея заключалась в фиксации временных зависимостей с помощью рекуррентных структур, таких как сети долгой краткосрочной памяти (LSTM).13 и управляемые рекуррентные блоки (GRU)32и они широко использовались в таких областях, как обработка естественного языка (NLP)33, распознавание речи34Пожалуйста, предоставьте текст для перевода.35путешествия36,37преступность38, и прогнозирование будущих тенденций39 (например, трафик)40, фондовые рынки41,42и метеорология43GRU4Rec, предложенная Hidasi и соавторами, стала важным этапом в исследованиях SBR; в этой модели рекуррентные нейронные сети (RNN) впервые были применены в SBR для фиксации последовательных паттернов поведения пользователей с помощью GRU с целью формирования персонализированных рекомендаций.
Графовые нейронные сети (GNNs)44 продемонстрировали высокую выразительную способность при моделировании сложных взаимосвязей в данных со структурой графа, и некоторые исследователи внедрили GNNs для моделирования сложных переходов внутри сессий или между ними. В зависимости от архитектуры модели GNNs методы сессионных рекомендаций (SBR) на их основе обычно разделяют на управляемые графовые нейронные сети (GGNNs)45, графовые сверточные сети (GCNs)46 и графовые сети внимания (GATs)47. SR-GNN стала первой моделью, применившей GNNs в SBR путем представления последовательностей сессий в виде ориентированных графов и использования GGNNs для фиксации сложных отношений переходов между объектами внутри сессий в сочетании с механизмами внимания для получения итогового эмбеддинга сессии, что позволило повысить качество рекомендаций. Chen L48 предложил многопредставленную структуру GNNs, которая объединяет структурированные атрибуты и неструктурированные ключевые слова для моделирования многомерных ассоциаций продуктов, что повысило точность SBR. Driss E49 разработал инновационную систему сессионных рекомендаций с использованием капсульных графовых нейронных сетей для извлечения сложных признаков объектов и повышения точности прогнозирования в SBR.
Вышеупомянутые методы глубокого обучения расширили область исследований SBR и эффективно повысили производительность, однако они по-прежнему имели определенные ограничения, которые в основном проявлялись в следующем: 1) для новых позиций или очень разреженных сессий моделям было трудно делать точные прогнозы из-за отсутствия глобального контекста; 2) они не могли использовать глобальные закономерности, содержащиеся во всех исторических сессиях.
Гибридная рекомендательная система на основе сессий
Гибридные сессионные рекомендательные системы объединяют преимущества различных методов, таких как коллаборативная фильтрация, глубокое обучение и механизмы внимания, для повышения эффективности SBR. В GC-SAN50 был внедрен механизм самовнимания на основе SR-GNN для более точного захвата информации о взаимодействиях с наиболее значимыми объектами внутри сессии. FGNN51 дополнительно агрегирует информацию из соседних объектов с помощью многоголового механизма внимания для изучения множественных связей целевого объекта. SR-HetGNN52 относится к SBR с гетерогенными графами; путем введения объектов нескольких типов (пользователь, объект, сессия) и ребер с множественными отношениями (клик, покупка, совместное появление, ассоциация атрибутов) была построена глобальная сеть знаний, что позволило преодолеть ограничение одиночных последовательностей объектов; этот метод стал важным инструментом моделирования поведения анонимных пользователей и межсессионных ассоциаций интересов в последние годы. KGSR-SAP53 формирует граф знаний, соединяя объекты ребрами с множественными отношениями для описания различных взаимодействий «пользователь-объект», что решает проблему потери информации, возникающую, когда глобальный граф содержит ребра только одного типа (взаимодействие пользователь-объект). Wang ZH54 предложил DiffSBR — модель сессионных рекомендаций на основе диффузии. Она генерирует надежные предпочтения по следующему объекту путем симуляции шумоподавления, что улучшает моделирование динамических последовательностей кликов пользователя. Qiao ST55 разработал SBR-фреймворк, сочетающий многовидовое обучение намерениям и выравнивание с LLM. Данный подход извлекает неявные намерения пользователя с разных ракурсов и использует языковые модели для выравнивания семантических признаков с целью повышения качества рекомендаций.
Общий контекст
Чтобы преодолеть недостаток «рассмотрения сессий в изоляции», исследователи поняли, что глобальная информация может быть использована для расширения репрезентативных возможностей текущей сессии, что позволит решить такие проблемы, как разреженность данных, «холодный старт» и семантический разрыв в традиционных SBR. В то же время при построении глобального контекста требовалась интеграция глобальной информации в одну сессию при минимизации шумовых помех. CSRM56 оптимизировала представление на уровне сессии путем интеграции коллаборативной информации между текущей сессией и соседними сессиями, используя внешний кодировщик памяти (OME) для извлечения коллаборативного намерения из коллаборативной информации. CA-TCN57 предложила модель временной сверточной сети с учетом межсессионных связей, создавая глобальные графы и графы контекста сессий для имитации влияния межсессионных взаимодействий на товары и сессии, в то время как временная сверточная сеть (TCN) расширяет поле восприятия с помощью разреженных сверток, где количество слоев охватывает последовательности экспоненциальной длины (поле восприятия = ), решая проблему затухания градиента в RNN. Chen58 предложил метод SBR на основе гиперграфовых нейронных сетей (SR-HGNNs), который объединяет механизмы распространения смешанного порядка (низкого и высокого порядка) и механизмы внимания для решения проблемы чрезмерного сглаживания традиционных GNN в коротких сессиях и дифференциации значимости различных порядков распространения, что позволило более точно улавливать зависимости и избегать шумовых помех. GCE-GNN использовала пары совместно встречающихся товаров различных порядков для построения ненаправленного взвешенного графа, подсчитывая частоту совместного появления товаров для отражения их важности в сессии; AGNN-GC59 использовала межсессионные отношения переходов между товарами для построения глобального коллаборативного графа, рассчитывая вероятности переходов между товарами в глобальном графе для отражения изменений интересов в сессии; DA-GCN60 использовала кратчайший путь для обновления матрицы смежности с целью построения динамического взвешенного графа, рассчитывая частоту совместного появления в глобальном графе и расстояние пути между товарами. Вдохновившись вышеупомянутыми работами, в данной статье предложено построение глобального графа с помощью метода на основе соседства, т. е. с использованием коэффициента сходства Жаккара для расчета схожих сессий, что позволило не только использовать глобальную информацию, но и отфильтровать шум (исключить иррелевантные товары), достигнув цели точного построения глобального контекста и заложив прочный фундамент для последующего алгоритма SBR.
Линейное внимание с затворами в слотах
Традиционные трансформеры61 обладали высокой пространственно-временной сложностью из-за необходимости выполнения операций полносвязного внимания по всей последовательности следующим образом:
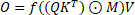 (1)
Где Q, K, V ∈ RN×d представляли собой линейные преобразования входных элементов, M = {Mij = 1, если i ≥ j, в противном случае −∞ } было каузальной маской для предотвращения утечки информации из будущего, ⊙ обозначало поэлементное произведение, а f обозначало функцию активации softmax.
Для реализации линейного внимания62 наиболее очевидной идеей был отказ от функции активации softmax. Однако прямое удаление функции активации softmax неизбежно привело бы к ряду потенциальных проблем: потере мощного выразительного потенциала нейронных сетей и невозможности решения сложных прикладных задач.
Слотовое линейное внимание с контролем ограниченной памяти
Исходя из необходимости сохранения функции активации softmax, K и V сжимались по отдельности в K̃, Ṽ ∈ Rm×d. С точки зрения сети памяти, K̃ и Ṽ имели ячейки памяти, длина которых увеличивалась вместе с последовательностью, то есть количество ячеек m = N. Если m было фиксированным, линеаризация была очевидно возможна. По аналогии с управлением с ограниченной памятью (Bounded-memory Control)63, каждый токен во входных элементах длиной N должен был конкурентно записываться в m ячеек.
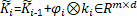 ,
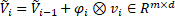 ,
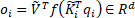 (2)
Где f — функция активации softmax, а φi — вектор для регулирования эффективного входного сигнала, который управляет значением ключа ki следующим образом.
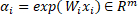 ,
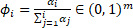 (3)
Здесь (φi)j представляет собой интенсивность записи i-го токена в j-й слот, которая была получена с помощью функции кумулятивного softmax.
Для обеспечения эффективных линейных вычислений формула (2) была переписана в виде формулы (4), которая вычисляла οi на основе qi, ki и vi (ур. 4) с помощью {οi|i=1T, qi, ki, vi)|i=1T} и применения двухпроходного последовательного вычисления:
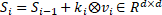 ,
 (4)
Таким образом, можно вывести операции SLA:
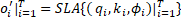 ,
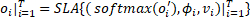 (5)
Где oi′ ∈ ℝm, οi ∈ ℝd. Таким образом, SLA может обеспечить аппаратно-эффективное поблочное обучение за линейное время64.
Линейное внимание с вентилируемыми слотами
Слотное линейное внимание с контролем ограниченного объема памяти может снизить вычислительную и пространственную сложность. Однако накопление информации может также привнести шум в сессионное взаимодействие, поэтому затухание, зависящее от данных, имело большое значение для селективного сохранения и удаления информации; этот селективный механизм был повторно рассмотрен в недавних селективных моделях пространства состояний65. GSLA с зависимостью от данных может быть выражена следующим образом:
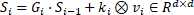 ,
 (6)
В данном случае гейты затухания были параметризованы в форме внешнего произведения Gi = αi ⊗ βi, αi, βi ∈ [0,1]d. Далее GSLA также может быть записан в следующей эквивалентной форме при условии, что обычно βt = 1, с использованием матричного умножения, как показано в64:
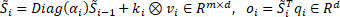 (7)
Где αi и ki по отдельности обозначают вентиль забывания и входной вентиль; эти два вентиля могут быть связаны соотношением ki = 1 − αi, что основано на литературе по RNN с вентилированием. Очевидно, что GSLA может быть сформулирована с помощью двухпроходного последовательного вычисления, как показано в уравнении (8). Структура второго порядка поддерживала блочное параллельное обучение для повышения эффективности тренировки, а внедрение операции softmax в середину структуры второго порядка расширило возможности моделирования памяти с ограниченным количеством слотов.
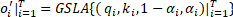 ,
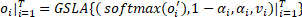 (8)
Преобразование данных сессии
Постановка задачи
Пусть заданная последовательность сессий будет S = {v1s, v2s, ⋯, vns}, где vis обозначает i-й выбранный элемент. Путем анализа поведения пользователя по кликам в этой последовательности система предсказывает следующий элемент, который может заинтересовать пользователя, vn+1s.
Построение графа
Построение графа сессий
Для сессии S = {v1s, v2s, ⋯, vns} был построен ориентированный граф Gs = (Vs, εs), где Vs представлял собой набор элементов данной сессии S, а εs = {eijlocal|vi, vj, vi, vj ∈ Vs} был набором ребер данной сессии S. ε(vi-1s, vis) обозначал последовательно выбранные элементы в этой сессии. Ребро eijlocal можно было разделить на четыре типа: ein, eout, ein-out, eself. Поскольку один и тот же элемент мог неоднократно появляться в последовательности, для каждого ребра рассчитывалось весовое значение.
Текущая сессия s = [v1, v2, v4, v2, v3] была преобразована в SG, как показано на Рисунке 1A.
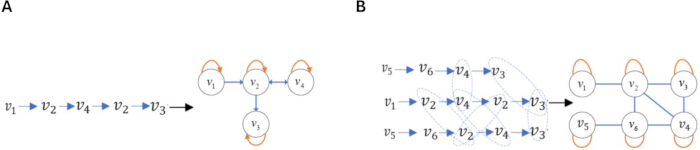
Рисунок 1: Преобразование интерактивных элементов в графовые структуры. (A) Иллюстрация построения графа сессии (SG) путем преобразования сессии в граф. (B) Иллюстрация построения глобального графа соседей (NGG) путем объединения множества сессий в один граф. Данный рисунок был самостоятельно отрисован в Visio с использованием полностью настраиваемых элементов. Сторонние графические ресурсы, защищенные авторским правом, не использовались, поэтому дополнительное лицензирование сторонних авторских прав не потребовалось. Авторские права на рисунок принадлежат авторам и будут соответствовать правилам журнала по авторскому праву после принятия статьи. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Построение глобального графа соседей
На основе текущей сессии S был построен соответствующий NGG Gg = (Vg, εg) для обогащения обучения представлениям текущей сессии перекрестным способом. Vg представлял собой набор элементов, содержащий все элементы в Gg, а εg = {eijglobal|vi, vj, vi, vj ∈ Vg} был набором ребер Gg. ε(vi-1g, vig) обозначал непосредственно взаимодействующие элементы vi-1g и vig в NGG Gg. Этот процесс состоял из двух этапов: получения соседних сессий и построения NGG.
Сбор данных о соседних сессиях
По всему набору данных был выполнен поиск сессий с максимальным количеством элементов, совпадающих с элементами текущей сессии. Для формирования набора сессий-кандидатов в соседние сессии S были выбраны топ-N сессий с наибольшим количеством совместных вхождений. Впоследствии для расчета сходства между текущей сессией cu и сессией Sr ∈ S из набора кандидатов S использовался коэффициент сходства Жаккара, как показано в уравнении (9).
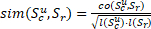 (9)
Здесь co(Scu, Sr) обозначало количество элементов, совместно встречающихся как в Scu, так и в Sr, в то время как l(Scu) и l(Sr) соответственно представляли длины Scu и Sr, а Scu и Sr обозначали текущую сессию и соседнюю сессию. Сессии со сходством ниже определенного порога (который мог быть задан в качестве гиперпараметра) отфильтровывались, а оставшиеся сессии составляли набор соседних сессий Ns для текущей сессии.
Построение глобального графа соседей
На основе набора соседних сессий Ns был построен NGG, как показано на Рисунке 1B. При построении матрицы смежности, если между двумя объектами (vi, vj) имело место взаимодействие, соответствующий элемент Aij принимал значение 1, в противном случае он принимал значение 0. Кроме того, взаимодействия между объектами рассматривались как ненаправленные и дополнялись петлями, после чего проводилась нормализация, как показано в Таблице 1.
| 1 | 2 | 3 | 4 | 5 | 6 | |
| 1 | 1/2 | 1/2 | 0 | 0 | 0 | 0 |
| 2 | 0 | 1/4 | 1/4 | 1/2 | 0 | 0 |
| 3 | 0 | 0 | 1 | 0 | 0 | 0 |
| 4 | 0 | 1/4 | 1/2 | 1/4 | 0 | 0 |
| 5 | 0 | 0 | 0 | 0 | 1/3 | 2/3 |
| 6 | 0 | 1/3 | 0 | 1/3 | 0 | 1/3 |
Таблица 1: Нормализованная матрица смежности глобального графа соседей. В таблице представлена нормализованная матрица смежности, описывающая взвешенные связи между узлами в построенном глобальном графе соседей.
Разработка алгоритма рекомендаций на основе сессий
В данном разделе подробно описывается предлагаемая инновационная модель GSLA4Rec, которая позволила повысить эффективность SBR за счет внедрения механизма GSLA в совместное представление признаков SG и NGG.
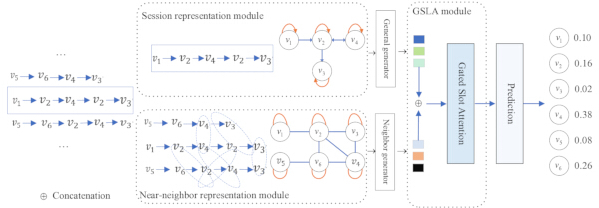
Рисунок 2: Структура GSLA4Rec. Данная структура объединяет обучение структуре графа сессий и глобального графа соседей, фильтрует шум взаимодействий с помощью механизма гейтинга, балансирует объем памяти и эффективность с помощью механизма слотов памяти и фиксирует релевантность элементов с помощью механизма линейного внимания для прогнозирования следующего клика пользователя. Данный рисунок был самостоятельно отрисован в Visio с использованием полностью настраиваемых элементов. Сторонние графические ресурсы, защищенные авторским правом, не использовались, поэтому дополнительное лицензирование авторских прав третьих лиц не потребовалось. Авторские права на рисунок принадлежат авторам и будут соответствовать правилам журнала по авторскому праву после принятия статьи. GSLA4Rec представляет собой графовые нейронные сети с линейным вниманием и гейтированными слотами для SBR. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Рисунок 2 демонстрирует структуру GSLA4Rec, которая состоит из четырех основных компонентов: 1) Представление объектов на уровне сессии. Используется модель GNNs на SG для изучения эмбеддингов объектов на уровне сессии внутри текущей сессии; 2) Глобальное представление соседних объектов. Глобальные эмбеддинги объектов по всем сессиям изучаются с помощью GRU для рекурсивного объединения эмбеддингов соседей каждого объекта на основе NGG; 3) GSLA. Моделирование предпочтений пользователя в текущей сессии осуществляется путем агрегирования изученных представлений объектов как на уровне сессии, так и на глобальном уровне; 4) Слой прогнозирования. Вычисляет прогнозируемые вероятности для объектов-кандидатов. Эти четыре компонента подробно описаны далее.
Представление сессии
В SBR понимание особенностей взаимодействия пользователей имело решающее значение. С этой целью для обучения представлениям сессий были построены SG и NGG, что позволило всесторонне изучить поведение пользователей и тем самым более точно определить их истинные намерения.
Представление объектов на уровне сессии
На основе SG, представленного на рисунке 1A, для извлечения признаков SG был применен метод взвешенного двунаправленного графового внимания (Weighted Bidirectional Graph Attention, WBGAT). В данном методе на базе стандартного механизма GAT были введены веса ребер и направленность элементов (входящие и исходящие соседи), что позволило усилить значимые ребра и зафиксировать двунаправленные зависимости, тем самым устранив недостатки традиционного GAT в отношении асимметричных отношений между элементами и силы их взаимодействия. Процесс вычисления был следующим:
Сначала проводится расчет весов нормализации входящей степени элементов.
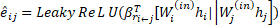 (10)
где eij обозначает вес признаков объекта j по отношению к объекту i первого порядка соседства,  была связью между объектом i и объектом j, β* ∈ ℝd представляли собой векторы весов, hi и hj были представлениями объекта i и j соответственно, Wi(in) ∈ ℝd*d и Wj(in) ∈ ℝd*d были обучаемыми параметрами, || обозначала операцию конкатенации. Для разграничения различных отношений входящей степени были обучены два вектора весов, а именно rin и rin-self. В качестве функции активации использовалась LeakyReLU.
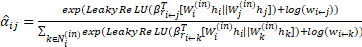 (11)
Для того чтобы коэффициенты были сопоставимы для разных объектов, веса внимания были нормализованы с помощью функции softmax. Если Ni(in) представляло собой набор ближайших входящих соседей объекта i, а  было весом входящего соседа направленного ребра (i←j) в SG, то данный метод позволил модели изучать корреляции признаков объектов, сохраняя при этом информацию о внутренней силе связей структуры графа путем взятия логарифма весов ребер и их добавления к исходному показателю внимания eij.
Во-вторых, расчет весов нормализации исходящей степени элементов.
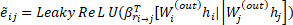 (12)
где ẽij обозначает вес исходящего соседа первого порядка признаков объекта j по отношению к объекту i,  был связью между объектами i и j; были обучены два вектора весов, а именно rout и rout-self.
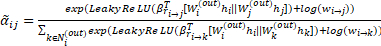 (13)
Где Ni(out) — множество исходящих соседей первого порядка элемента i,  — вес исходящего соседа ориентированного ребра (i→j) в SG.
В-третьих, агрегация информации. Обновленное эмбеддинг-представление объекта может быть получено путем взвешивания и суммирования эмбеддингов первого порядка входящих и исходящих степеней объекта i.
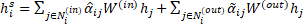 (14)
Где  и α̃ij соответственно обозначают веса входящей и исходящей степеней элемента i, а
 обозначает обновленное представление элемента i.
Представление элементов на глобальном уровне соседства
Последние исследования единогласно подтверждают, что построение глобального графа может улучшить представление данных и, следовательно, повысить эффективность SBR, в этом нет никаких сомнений. Однако глобальное расширение данных может также привнести и иррелевантную информацию, например, шум. В предлагаемой модели для достижения глобальной аугментации данных при максимально возможном снижении уровня шума был построен глобальный граф ближайших соседей.
На основании NGG на Рисунке 1B и нормализованной матрицы смежности в Таблице 1 текущая сессия и соседние сессии были преобразованы в NGG, после чего был применен метод GGNNs45 для извлечения признаков NGG. Процесс обучения векторов элементов в NGG представлен в Уравнении (15).
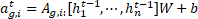
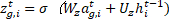
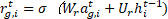
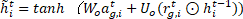
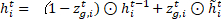 (15)
W ∈ ℝd×2d обозначает веса управления, zg,i и rg,i представляют собой вентиль обновления и вентиль сброса соответственно. [h1t-1, ⋯, hnt-1] представляет собой список всех векторов элементов в сессии s. σ(x) = 1/(1 + e-x) — логистическая сигмоидная функция, ⊙ обозначает поэлементное умножение, а hi ∈ ℝd представляет собой вектор после управляемого обновления. Матрица смежности As ∈ ℝn×n указывает на связность между элементами в соседних сессиях, а As,i: ∈ ℝ1×n представляет собой блок столбцов As, соответствующий элементу vs,i в матрице смежности. Для текущей сессии s = [v1, v2, v4, v2, v3] NGG и нормированная матрица смежности показаны на Рисунке 1B и в Таблице 1 соответственно.
Представление объекта
Представление объекта было получено путем суммирования вектора объекта на уровне сессии и глобального вектора объекта соседнего уровня, как показано в уравнении (16):
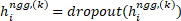
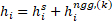 (16)
В случаях, когда для предотвращения переобучения использовался метод дропаута (dropout) для представлений соседних объектов на глобальном уровне.
Линейное внимание с вентилируемыми слотами
Механизм линейного внимания с затворами в слотах (gated-slot linear attention, GSLA), описанный в данной работе, объединяет линейное внимание с контролем ограниченной памяти и зависимым от данных механизмом затворов. С одной стороны, он унаследовал механизм слотов конечной памяти из модели контроллера на основе внимания (attention-based controller, ABC), сжимая пары «ключ-значение», которые изначально росли пропорционально длине последовательности, в фиксированное количество слотов, при этом каждый слот обновлялся посредством конкурентной записи, что решает проблему вычислительной сложности глобального внимания трансформера. С другой стороны, был внедрен механизм мелкозернистого затвора, аналогичный GLA, при котором входные данные динамически регулируют коэффициент удержания исторической информации с помощью затвора забывания αi, что устраняет проблему шума, вызванную отсутствием механизма забывания в ABC.
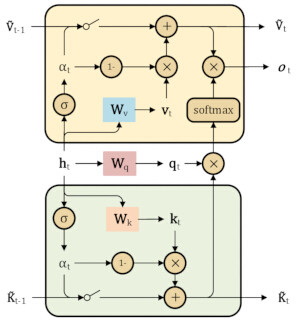
Рисунок 3: Схематическая диаграмма GSLA. Входной вектор отображался на вектор запроса, вектор ключевых слов и вектор значений соответственно, после чего обрабатывался с помощью линейного внимания с контролем ограниченной памяти и зависимым от данных механизмом гейтирования для получения обновленного вектора запроса, вектора ключевых слов, вектора значений и выходного вектора. Данный рисунок был самостоятельно отрисован в Visio с использованием полностью настраиваемых элементов. Сторонние графические ресурсы, защищенные авторским правом, не использовались, поэтому дополнительное лицензирование сторонних авторских прав не потребовалось. Авторское право на рисунок принадлежит авторам и будет соответствовать правилам авторского права журнала после принятия статьи. GSLA означает gated-slot linear attention. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Как конкретно показано на рисунке 3, входной вектор был раздельно отображен в вектор запроса (query vector), вектор ключа (key vector) и вектор значения (value vector)64:
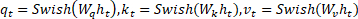 (17)
Где Wq, Wk, Wv ∈ ℝd×d представляют собой матрицы весов преобразования, соответствующие запросу (query), ключу (key) и значению (value) соответственно, а ht обозначает вектор эмбеддинга на t-м временном шаге во входной последовательности сессии. Функция Swish была определена как Swish(x) = x · σ(x) и представляла собой функцию активации с саморегулируемыми затворами (self-gated activation function), где σ — сигмоидальная функция; данная функция продемонстрировала более высокую эффективность по сравнению с традиционной функцией активации ReLU в различных задачах глубокого обучения.
В GSLA использовались затвор забывания αi и входной затвор 1 − αi, которые в зависимости от входных данных динамически обновляли информацию в i-м слоте памяти. Процесс протекал следующим образом64:
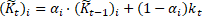 (18)
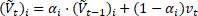 (19)
Здесь K̃t и Ṽt обозначали слоты векторов ключей и векторов значений на временном шаге t, в то время как K̃t-1 и Ṽt-1 обозначали слоты векторов ключей и векторов значений на временном шаге t−1. Забывающий вентиль αi = σ(Wαht)1/τ, где Wα ∈ ℝd представлял собой матрицу весов преобразования, σ — сигмоидную функцию, а τ — коэффициент демпфирования (обычно равный 8), используемый для управления «мягкостью» забывающего вентиля. Это позволяло GSLA плавно регулировать скорость забывания исторической информации: чем больше значение αi, тем больше GSLA опирался на историческую информацию; чем меньше значение αi, тем больше GSLA фокусировался на текущем входном сигнале.
Слоты ключевых векторов K̃t и слоты векторов значений Ṽt для слотов на t-м шаге были записаны в матричной форме, как показано65 в уравнениях (20) и (21):
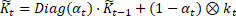 (20)
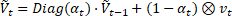 (21)
Затем GSLA со свойствами второго порядка (см. уравнение (8)) использовался для вычисления выходного значения oi |i=1T для каждого временного шага i ∈ [1, …, T]. К выходу каждого временного шага применялось линейное преобразование для получения результата h̃t. Наконец, было вычислено среднее значение представлений всех элементов в последовательности сессии для генерации эмбеддинга сессии S̃e с динамическим обновлением памяти:
 (22)
 (23)
Здесь ot представляет собой выход Gated-Slot на временном шаге t, а h̃t обозначает результат применения линейного преобразования к ot. S̃e обозначает среднее значение h̃t по всем временным шагам.
Прогностический слой
На основе полученного представления сессии S̃e и начального эмбеддинга объекта i была выполнена операция скалярного произведения для расчета оценки каждого объекта-кандидата hi. Впоследствии использовалась функция softmax для получения вероятностей рекомендации объекта-кандидата i:
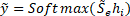 (24)
Здесь ỹ представляла вероятности рекомендации искомого объекта, hi обозначал вектор искомого объекта, а для обучения модели использовалась функция потерь перекрестной энтропии.
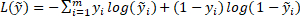 (25)
Здесь y представляла собой истинное значение в кодировке one-hot.
Результаты
Наборы данных и предварительная обработка
В экспериментах для оценки производительности модели были выбраны три общедоступных набора данных SBR, полученных из реальных данных о транзакциях в сценариях практического применения: Diginetica, извлеченный из конкурса CIKM Cup 2016, содержащий записи о транзакциях и кликах пользователей; Tmall, представляющий собой логи пользователей платформы Tmall и содержащий записи о поведении пользователей при просмотре и совершении покупок; и Nowplaying, содержащий записи о истории воспроизведения музыки пользователями на музыкальных платформах. Эти наборы данных широко используются в исследованиях SBR и позволяют всесторонне оценить эффективность и применимость модели.
На этапе предобработки данных наборы данных были стандартизированы для обеспечения единообразия качества данных. В частности, были отфильтрованы все сессии длительностью менее 2, а элементы, встречающиеся менее 5 раз, были удалены. Кроме того, для каждой сессии S = {v1, v2, ..., vn} было создано несколько подпоследовательностей для обучения и тестирования модели. Эти подпоследовательности имели вид: ([v1]|v2), ([v1, v2]|v3), ..., ([v1, v2, ..., vn-1]|vn). После завершения вышеупомянутой предобработки был проведен статистический анализ наборов данных; подробная информация представлена в Таблице 2.
| Набор данных | Diginetica | Tmall | Сейчас воспроизводится |
| нажмите | 982961 | 818479 | 1367963 |
| обучать | 719470 | 351268 | 825304 |
| тест | 60858 | 25898 | 60417 |
| материалы | 43097 | 40728 | 60417 |
| сред. дл. | 5.12 | 6.69 | 7.42 |
Таблица 2: Описание наборов данных. В таблице приведены статистические данные наборов данных Diginetica, Tmall и Nowplaying, включая количество кликов, обучающих и тестовых выборок, количество объектов и среднюю длину сессии.
Экспериментальные условия
Настройка параметров
Для обеспечения объективности эксперимента были применены методы предобработки трех наборов данных, а также предварительно заданы параметры модели GSLA4Rec. Для наборов данных Diginetica и Nowlaying размер пакета (batch size) был установлен на уровне 150, а для набора Tmall — 300. Параметры данной модели были инициализированы с помощью гауссова распределения со средним значением 0 и стандартным отклонением 0.1, размерность была установлена на уровне 100. В качестве оптимизатора использовался Adam с начальной скоростью обучения 0.001; скорость обучения умножалась на 0.1 каждые 3 эпохи. Обучение проводилось в течение в общей сложности 30 эпох на GPU NVIDIA TITAN V и PyTorch 1.11.0 с cu113 (см. Таблицу материалов) для получения оптимального значения. Порог фильтрации соседних сессий был установлен на уровне 0.5, в эксперименте применялась L2-регуляризация. Для каждого набора данных последние 10% данных, отсортированных по времени совершения сделки, были выбраны в качестве тестового набора, а оставшиеся 10% и 80% были случайным образом выбраны в качестве валидационного и обучающего наборов соответственно. Количество слотов памяти в GSLA было установлено в значение из множества {0, 1, 2, 3, 4, 5}.
Метрики оценки
В данной работе были приняты метрики P@N (Precision@N, N = 10/20) и MRR@N (Mean Reciprocal Rank@N, N = 10/20). P@N использовалась для измерения доли правильных рекомендаций среди первых N результатов выдачи, а MRR@N — для расчета среднего обратного ранга правильных проектов; чем выше значение MRR, тем лучше качество сортировки.
Анализ производительности
Эффективность модели GSLA4Rec оценивалась в сравнении с базовыми моделями, представляющими различные этапы технологического развития. На ранних этапах для SBR использовались методы машинного обучения, например, FPMC5 применялась для прогнозирования последовательного эффекта на основе цепей Маркова. Затем, с развитием искусственного интеллекта, для SBR стали широко применяться методы глубокого обучения; так, GRU4Rec10 была основана на RNN, которые моделируют SBR путем стекирования нескольких слоев GRU, и использовала специализированные функции потерь для оптимизации SBR; NARM16 внедрила AM для фиксации основных интересов пользователей и генерировала итоговое эмбеддинг-представление следующего возможного рекомендуемого объекта; STAMP17 использовала многослойные перцептроны с усилением AM для одновременного учета общих и сиюминутных интересов пользователей. В последние годы в SBR также стали широко использоваться графовые нейронные сети благодаря их высокой способности к обучению на неевклидовых данных. Например, SR-GNN22 впервые применила GNN к SBR, извлекая сложные отношения переходов между объектами с помощью GGNN и фокусируясь на сиюминутных интересах пользователей в сочетании с AM; GCE-GNN23 использовала GAT для получения отношений переноса объектов в локальном и глобальном контекстах и генерировала представления сессий с помощью RPE и soft-AM; S2-DHCN66 преобразовывала данные сессий в гиперграф и линейный граф, задействуя самообучение для улучшения SBR.
В последнее время для повышения эффективности SBR был принят комплексный подход. Например, в GC-SAN50 GNN были объединены с многослойными сетями самовнимания для улучшения качества рекомендаций путем моделирования краткосрочных и долгосрочных зависимостей; TASRec67 включил временную информацию путем построения последовательности динамических снимков графа в разные моменты времени; CT-GNN68 использовал GNN в сочетании с временной информацией для изучения дополнительных временных связей между объектами; CORE69 объединил информацию о совместном появлении и временную информацию об объектах для получения окончательного представления сессии; RESTC70 предложил паттерны пространственно-временного взаимодействия, основанные на свойствах единообразия и выравнивания контрастивного обучения; COTRec66,71 применил самообучение на двух представлениях графа сессии и совместное обучение для решения проблемы разреженности данных в SBR; RAIN71 использовал маскирование ребер и структурную реконструкцию, а также совместное обучение индикатора ребер для явного выявления и удаления зашумленных ребер, что значительно повысило точность и робастность SBR.
| Наборы данных | Diginetica | Tmall | Сейчас воспроизводится | ||||||||||
| Класс метода — ификация | Метрики | P@10 | P@20 | MRR@10 | MRR@20 | P@10 | P@20 | MRR@10 | MRR@20 | P@10 | P@20 | MRR@10 | MRR@20 |
| Машинное обучение | ФПМК | 15.42 | 22.10 | 6.20 | 6.66 | 13.12 | 16.05 | 7.10 | 7.30 | 5.28 | 7.35 | 2.66 | 2.82 |
| Глубокое обучение | GRU4REC | 17.92 | 30.80 | 7.73 | 8.20 | 9.47 | 10.93 | 5.78 | 5.89 | 6.74 | 7.92 | 4.40 | 4.48 |
| Глубокое обучение | NARM | 35.44 | 48.32 | 15.12 | 16.00 | 19.16 | 23.30 | 10.40 | 10.70 | 13.60 | 18.59 | 6.62 | 6.92 |
| Глубокое обучение | STAMP | 33.97 | 46.62 | 14.26 | 15.13 | 22.63 | 26.47 | 13.10 | 13.35 | 13.20 | 17.65 | 6.57 | 6.88 |
| Графовые нейронные сети (GNN) | SR-GNN | 38.42 | 51.26 | 16.89 | 17.76 | 23.41 | 27.57 | 13.46 | 13.72 | 14.17 | 18.86 | 7.15 | 7.47 |
| Графовые нейронные сети (GNN) | S2 -DHCN | 40.21 | 53.66 | 17.59 | 18.51 | 26.22 | 31.42 | 14.60 | 15.05 | 17.35 | 23.50 | 7.87 | 8.18 |
| GNN (графовые нейронные сети) | GCE-GNN | 41.16 | 54.22 | 18.15 | 19.04 | 28.01 | 33.42 | 15.08 | 15.42 | 16.94 | 22.37 | 8.03 | 8.40 |
| GNN с механизмом внимания (GNN+Att) | TASRec | 39.85 | 52.53 | 17.19 | 18.22 | 25.72 | 29.58 | 14.22 | 14.51 | 16.35 | 20.52 | 7.30 | 7.78 |
| GNN с механизмом внимания (GNN+Att) | ГХ-САН | 38.40 | 51.30 | 16.80 | 17.80 | 23.50 | 27.60 | 13.50 | 13.80 | 14.20 | 18.90 | 7.20 | 7.50 |
| GNN + Tem | CT-GNN | 39.40 | 52.71 | 17.50 | 18.56 | 25.95 | 31.42 | 14.52 | 15.00 | 16.55 | 22.28 | 7.75 | 8.06 |
| GNN + Tem | ЯДРО | 41.03 | 52.84 | 17.95 | 18.47 | 32.97 | 39.16 | 18.72 | 19.16 | 17.65 | 21.81 | 7.92 | 7.35 |
| GNN+Tem | RESTC | 42.35 | 55.93 | 18.75 | 19.65 | 35.57 | 42.47 | 18.05 | 18.52 | 18.39 | 24.79 | 8.31 | 8.72 |
| Графовые нейронные сети (GNN) + цепочка рассуждений (COT) | COTRec | 39.87 | 54.18 | 17.53 | 19.07 | 30.62 | 36.35 | 17.65 | 18.04 | - | - | - | - |
| GNN+ReStr | ДОЖДЬ | - | 55.50 | - | 19.20 | - | 38.73 | - | 19.12 | - | 24.17 | - | 8.47 |
| GNN + Gated-Slot | GSLA4Rec | 43.35 | 56.47 | 19.38 | 19.98 | 36.56 | 43.60 | 19.46 | 19.96 | 19.80 | 27.10 | 8.86 | 9.32 |
| СД | ±0.0009 | ±0.0011 | ±0.0008 | ±0.0009 | ±0.0018 | ±0.0021 | ±0.0016 | ±0.0018 | ±0.0028 | ±0.0031 | ±0.0024 | ±0.0026 | |
| p-значение | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.01 | |
| Твывод | 0.294 | 0.296 | 0.295 | 0.297 | 0.168 | 0.169 | 0.169 | 0.171 | 0.472 | 0.478 | 0.475 | 0.479 | |
Таблица 3: Сравнение эффективности на трех наборах данных. В таблице приведено сравнение GSLA4Rec с методами рекомендаций на основе машинного обучения, глубокого обучения, GNN, механизмов внимания, временных факторов и другими методами на наборах данных Diginetica, Tmall и Nowplaying с использованием метрик P@10, P@20, MRR@10 и MRR@20. Для GSLA4Rec также указаны значения SD и p-значения.
Для проверки эффективности модели GSLA4Rec и исключения случайного характера улучшения показателей, вызванного случайными факторами, на тестовом наборе данных были проведены многократные групповые эксперименты и статистический анализ. В частности, тестовый набор был разделен на группы по 150 сессий в одной партии, и процедура повторялась 30 раз с использованием метода случайного числа (random seed). Средние результаты и затраты времени всех групповых экспериментов были рассчитаны как эффективность и время вывода (inference time) модели GSLA4Rec соответственно. Для дальнейшего подтверждения стабильности и достоверности улучшения показателей модели GSLA4Rec были рассчитаны стандартное отклонение (SD) и статистическая значимость с помощью t-критерия. В Таблице 3 представлены эффективность, SD, p-значение и Tinference предложенной рекомендательной модели GSLA4Rec в сравнении с базовыми моделями на трех наборах данных. Подчеркиванием отмечены лучшие базовые методы, а модель с наилучшими показателями по каждой метрике оценки выделена жирным черным шрифтом.
Методы рекомендаций на основе машинного обучения: в задачах SBR традиционный метод FPMC показал наихудшие результаты, главным образом из-за того, что модели цепей Маркова не смогли уловить сложные паттерны переходов между объектами. 2) Методы рекомендаций на основе глубокого обучения: такие модели, как GRU4REC, NARM и STAMP, использовали подходы моделирования последовательностей и достигли определенного повышения эффективности. Среди них NARM и STAMP продемонстрировали лучшие результаты рекомендаций, чем GRU4REC, прежде всего потому, что в NARM был внедрен механизм внимания для выявления основных интересов пользователей. 3) Методы рекомендаций на основе GNN: применение GNN в SBR привело к заметному улучшению производительности. Например, модель SR-GNN, ставшая первой в преобразовании сессионных последовательностей в графовые структуры для захвата пространственной структурной информации об объектах, превзошла методы глубокого обучения, представленные STAMP, с улучшением на 0.36–4.64%, что демонстрирует пространственное преимущество графовых структур при обработке последовательных данных. S2-DHCN использовала двухканальную свертку гиперграфов для захвата зависимостей высокого порядка между объектами в сочетании с самообучающимся контрастивным обучением для улучшения представлений; это позволило преодолеть ограничение традиционных GNN, которые моделируют только попарные отношения и обладают недостатком информации, в результате чего ее производительность превзошла методы глубокого обучения, представленные STAMP, на 1.30–7.04%. Модель GCE-GNN за счет эффективной интеграции информации по отдельным сессиям и глобальной сессионной информации превзошла методы глубокого обучения, представленные STAMP, на 1.46–7.60%, и модель SR-GNN на 0.88–5.85%, что указывает на то, что методы графовых структур, включающие глобальную контекстную информацию, могут значительно повысить эффективность SBR. 4) Методы рекомендаций GNN + механизм внимания: TASRec была направлена на более точный захват краткосрочных и долгосрочных предпочтений в поведенческих последовательностях пользователей путем внедрения механизма учета времени; ее производительность превзошла методы глубокого обучения на 0.73–5.91% и модель SR-GNN на 0.30–2.31%, но уступила модели GCE-GNN на 0.59–3.84%. GC-SAN сочетала графовые структуры, преобразованные из сессионных последовательностей, с многоголовыми механизмами самовнимания для успешного захвата локальных и долгосрочных зависимостей внутри сессий; ее производительность была сопоставима с моделью SR-GNN или немного выше, но уступала моделям TASRec и GCE-GNN. Это говорит о том, что внедрение механизмов внимания может эффективно повысить эффективность SBR, однако это улучшение менее значимо, чем достигнутое за счет глобальной информации, что подтверждает важность глобальной контекстной информации. 5) Методы рекомендаций GNN + временное кодирование: CT-GNN стала первой моделью, объединившей графовые структуры с временным кодированием для одновременного захвата «пространственной структуры» и «временной динамики», превзойдя модель GC-SAN на 0.55–3.82%. CORE фиксировала долгосрочные предпочтения и краткосрочные намерения путем статистического анализа частот совместного появления объектов в глобальных сессиях и разработки временного позиционного взвешивания для текущих сессий соответственно, а затем объединяла эту информацию о совместном появлении и временную информацию для получения итогового представления сессии; ее производительность превзошла модель TASRec на 0.25–9.58% и модель GC-SAN на 0.67–11.56%, показав значительное улучшение на 3.64–5.74% по сравнению с моделью GCE-GNN на наборе данных Tmall. RESTC представила модель контрастивного обучения на основе пространственно-временных GNN для решения проблем традиционных GNN, таких как сосредоточенность исключительно на пространственных графовых структурах, игнорирование временной информации и недостаточное пространственно-временное слияние; ее производительность превзошла модель CORE на 0.39–3.31% и модель GCE-GNN на 0.28–7.56%, что указывает на то, что как временное кодирование, так и контрастивное обучение эффективно повышают эффективность SBR. RAIN использовала методы маскирования ребер и структурной реконструкции для совместного обучения индикатора ребер с целью явного выявления и устранения зашумленных ребер, достигнув производительности, близкой к модели RESTC.
Предложенная модель GSLA4Rec интегрирует глобальную контекстную информацию и механизм линейного внимания с вентилируемыми слотами (gated-slot linear attention) для эффективного извлечения контекстных данных пользователей при одновременной фильтрации шума и снижении вычислительной сложности. Она продемонстрировала улучшение показателей на всех наборах данных, превзойдя два наиболее эффективных базовых решения: модель RESTC на 0,54–2,31% и модель GCE-GNN на 0,83–10,18%. Это было особенно заметно при обработке последовательных зависимостей в сценариях с длительными сессиями в SBR (в частности, улучшение на 10,18% и 4,73% по сравнению с GCE-GNN и на 1,44% и 2,31% по сравнению с RESTC на наборах данных Tmall и Nowplaying соответственно). Вкратце, предложенная модель GSLA4Rec включает эффективное построение графа для захвата пользовательского контекста и фильтрации шума; ее производительность последовательно превосходила SOTA-решения на всех исследованных наборах данных.
Анализ эффективности
Как показано на рисунке 4, результаты экспериментов на наборе данных Diginetica продемонстрировали, что предложенный метод GSLA4Rec обеспечил более высокую скорость обучения по сравнению с базовыми моделями с точки зрения времени обучения за эпоху; все эксперименты проводились на GPU NVIDIA TITAN V с потреблением памяти примерно 9300MB. Модели на основе глубокого обучения, включая STAMP, NARM и GRU4Rec, работали эффективно, но показали самые низкие результаты; модели TASRec и GC-SAN, основанные на GNN и механизме Self-Attention, улучшили производительность, однако потребовали значительных временных затрат. Хотя модели S2-DHCN и CORE на базе GNN привели к небольшому увеличению времени вычислений, общая производительность заметно выросла, и особенно это проявилось в предложенной модели GSLA4Rec, которая продемонстрировала существенное улучшение показателей. Основная причина заключалась в том, что модель GSLA4Rec затратила меньше времени на построение графа, чем базовые модели; более того, в ней использовался двухпроходный механизм gated linear attention с фиксированными слотами памяти m, что обеспечило линейную временную сложность O(Ldm). Эта архитектура оказалась значительно эффективнее стандартного self-attention O(L2d), сохраняя при этом высокую емкость памяти за счет чтения слотов с усилением softmax. Тестирование производительности на тестовом наборе для синхронизации времени статистического вывода, представленное в последней строке таблицы 3, подтвердило преимущество модели GSLA4Rec в эффективности, что позволило избежать ситуации «ложно высокой точности при недоступности использования» и действительно достичь компромисса между эффективностью и результативностью.
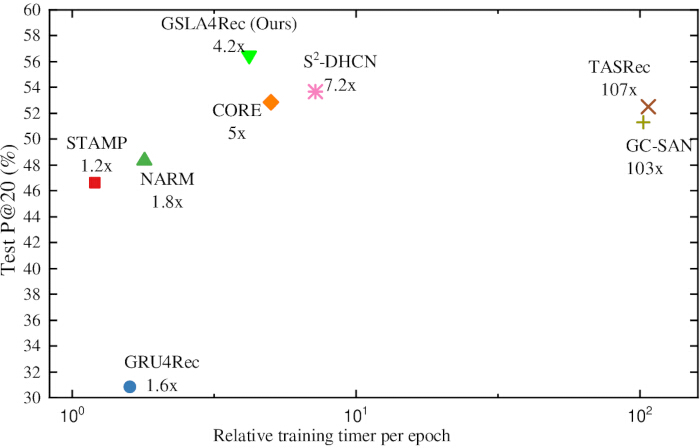
Рисунок 4: Производительность GSLA4Rec на наборе данных Diginetica в зависимости от времени выполнения. На рисунке показано относительное время обучения за эпоху для предложенной модели GSLA4Rec и базовых моделей, запущенных на GPU NVIDIA TITAN V с использованием Diginetica; GSLA4Rec обеспечила более высокую скорость обучения по сравнению с базовыми моделями. Данный рисунок был построен авторами в программе OriginPro с использованием полностью настраиваемых элементов. Внешние графические ресурсы, защищенные авторским правом, не использовались, в связи с чем дополнительное лицензирование сторонних авторских прав не потребовалось. Авторские права на рисунок принадлежат авторам и будут соответствовать правилам журнала по авторскому праву после принятия работы. GSLA4Rec представляет собой графовые нейронные сети с линейным вниманием с затворами слотов (gated-slot linear attention graph neural networks) для SBR. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Резюмируя, эффективность предложенной модели GSLA4Rec с механизмом gated-slot attention с линейной сложностью стабильно превосходила показатели SOTA на всех наборах данных. В частности, GSLA4Rec обеспечила значительный прирост производительности в сценариях рекомендаций для длинных сессий на наборах данных Tmall и Nowplaying, а также продемонстрировала превосходную способность к моделированию последовательных зависимостей.
Анализ экспериментов по абляции
Влияние SG, NGG и GSLA
Для оценки влияния SG, NGG, механизма гейтинга, слотов памяти и линейного внимания на текущий SBR были проведены абляционные исследования на наборах данных Diginetica, Tmall и Nowplaying. В модификации GSLA4Rec‑NotSG было исключено кодирование признаков SG при сохранении кодирования NGG; в GSLA4Rec‑NotNGG кодирование NGG было удалено, а извлечение признаков выполнялось исключительно на основе SG; в GSLA4Rec‑NotGM был удален только механизм гейтинга внутри GSLA; в GSLA4Rec‑NotMS были исключены только слоты памяти GSLA, а в GSLA4Rec‑NotLA был опущен только модуль линейного внимания в GSLA.
| Набор данных | Diginetica | Tmall | Сейчас воспроизводится | |||
| Показатели | P@20 | MRR@20 | P@20 | MRR@20 | P@20 | MRR@20 |
| GSLA4Recs-NotSG | 54.28 | 18.87 | 31.40 | 15.11 | 22.48 | 7.45 |
| GSLA4Recs-NotNGG | 52.65 | 17.67 | 28.90 | 14.61 | 20.17 | 7.74 |
| GSLA4Rec-NotGM | 53.82 | 18.21 | 39.26 | 16.52 | 23.14 | 7.62 |
| GSLA4Rec-NotMS | 53.40 | 17.60 | 38.05 | 15.65 | 22.55 | 7.40 |
| GSLA4Rec-NotLA | 51.86 | 16.92 | 29.12 | 13.96 | 20.82 | 7.28 |
Таблица 4: Результаты экспериментов по абляции GSLA4Rec. В таблице представлены результаты абляционного анализа GSLA4Rec после удаления отдельных компонентов модели на наборах данных Diginetica, Tmall и Nowplaying, оцененные с помощью метрик P@20 и MRR@20.
Таблица 4 демонстрирует результаты абляционного исследования на различных наборах данных; все показатели эффективности снизились по сравнению с полной моделью. Снижение производительности при удалении глобального кодирования сессионного графа ближайших соседей (GSLA4Rec-NotNGG) было более выраженным, чем при удалении кодирования признаков сессионного графа (GSLA4Rec-NotSG). Удаление любого подмодуля в GSLA приводило к ухудшению показателей, при этом степень снижения производительности ранжировалась от высокой к низкой следующим образом: линейное внимание, слоты памяти и механизм гейтинга. Причиной этого является то, что важность каждого элемента в SBR определенно различается, и существует необходимость в ассоциативной памяти между элементами. Таким образом, можно сделать вывод, что GSLA является ключевой частью модели, представленной в данной работе.
Влияние различных методов агрегации
Для оценки влияния различных методов агрегации информации на эффективность модели GSLA4Rec были исследованы следующие три классических метода агрегации: 1) Average Pooling (усреднение): выполнение операции усреднения векторов, сгенерированных SG и NGG; 2) Vector Concatenation (конкатенация векторов): объединение векторов, сгенерированных SG и NGG; 3) Vector Summation (суммирование векторов): сложение векторов, сгенерированных SG и NGG. Результаты представлены в Таблице 5. Модель GSLA4Rec с использованием Vec-Sum продемонстрировала наилучшие показатели на наборах данных Diginetica, Tmall и Nowplaying. Напротив, Mean-pooling дал неудовлетворительные результаты на всех наборах данных. Низкая эффективность усреднения и конкатенации может быть следствием переобучения, вызванного избыточным количеством параметров, что привело к снижению общей производительности модели.
| Набор данных | Diginetica | Tmall | Nowplaying | |||
| Показатели | P@20 | MRR@20 | P@20 | MRR@20 | P@20 | MRR@20 |
| Среднее объединение (Mean-Pooling) | 45.26 | 15.63 | 38.84 | 16.3 | 23.56 | 7.55 |
| Конкатенация векторов (Vec-Concating) | 51.77 | 17.24 | 39.83 | 18.24 | 24.06 | 8.88 |
| Суммирование векторов (Vec-Sum) | 56.47 | 19.98 | 43.6 | 19.96 | 27.1 | 9.32 |
Таблица 5: Эффекты различных методов агрегации. В таблице сравнивается влияние среднего пулинга, конкатенации векторов и суммирования векторов на производительность GSLA4Rec на наборах данных Diginetica, Tmall и Nowplaying с использованием метрик P@20 и MRR@20.
Анализ настроек гиперпараметров
Влияние различных размеров слотов памяти
Слоты памяти хранили информацию из предыдущих временных шагов, что было особенно важно для задач с временными зависимостями. В данном разделе исследовалось влияние размера слотов памяти m = [0, 1, 2, 3, 4, 5] на эффективность SBR. Экспериментальные результаты, представленные в Таблице 6, показали, что при установке размера слотов памяти m равным 3 метрики P@20 и MRR@20 демонстрировали оптимальные значения для всех трех наборов данных. Это говорит о том, что умеренный размер слотов памяти эффективно повышает точность рекомендаций и качество ранжирования модели; при меньшем размере слоты памяти не способны запомнить достаточное количество исторической информации и больше фокусируются на краткосрочных интересах пользователей, в то время как при увеличении размера слотов памяти до 4 и более модель сохраняет избыточную историческую информацию, что приводит к чрезмерному полаганию на прошлые интересы при игнорировании более критической текущей входной информации, тем самым снижая качество рекомендаций.
| Набор данных | Diginetica | Tmall | Сейчас воспроизводится | |||
| Показатели | P@20 | MRR@20 | P@20 | MRR@20 | P@20 | MRR@20 |
| GSLA4Rec-m0 | 53.40 | 17.60 | 38.05 | 15.65 | 22.55 | 7.40 |
| GSLA4Rec-m1 | 55.43 | 18.92 | 41.55 | 17.12 | 25.60 | 8.43 |
| GSLA4Rec-m2 | 56.02 | 19.35 | 42.90 | 18.25 | 26.62 | 8.95 |
| GSLA4Rec-m3 | 56.47 | 19.98 | 43.60 | 19.96 | 27.10 | 9.32 |
| GSLA4Rec-m4 | 53.96 | 19.25 | 43.06 | 19.09 | 26.34 | 8.35 |
| GSLA4Rec-m5 | 52.18 | 18.03 | 42.12 | 17.56 | 24.86 | 8.85 |
Таблица 6: Влияние различных размеров слотов памяти. В таблице представлены показатели эффективности GSLA4Rec с различными конфигурациями слотов памяти (m0–m5) на наборах данных Diginetica, Tmall и Nowplaying с использованием метрик P@20 и MRR@20.
Эффекты различных коэффициентов дропаута
Для предотвращения переобучения была введена регуляризация методом исключения (dropout). Перед суммированием вектора объектов на уровне сессии и вектора объектов на глобальном уровне соседства, выходные значения нейронов в векторе объектов на глобальном уровне соседства hingg,(k) случайным образом исключались для повышения робастности и обобщающей способности модели GSLA4Rec.
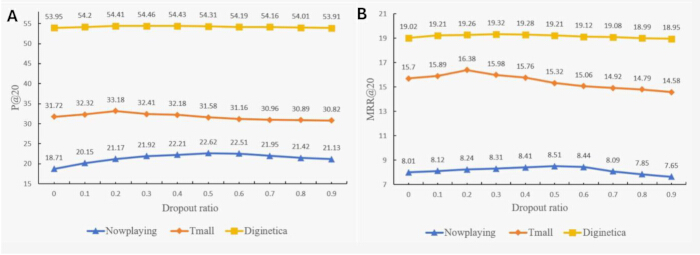
Рисунок 5: Эффективность GSLA4Rec при различных коэффициентах дропаута. (A) P@20 и (B) MRR@20 модели GSLA4Rec при различных коэффициентах дропаута на наборах данных Nowplaying, Tmall и Diginetica. Эффективность сначала росла, а затем снижалась по мере увеличения коэффициента дропаута, что демонстрирует робастность и обобщающую способность модели. GSLA4Rec — графовые нейронные сети с линейным вниманием к затворам слотов для сессионных рекомендаций (SBR). Данный рисунок был самостоятельно отрисован в OriginPro с использованием полностью настраиваемых элементов. Сторонние графические ресурсы, защищенные авторским правом, не использовались; следовательно, дополнительное лицензирование сторонних авторских прав не потребовалось. Авторские права на рисунок принадлежат авторам и будут соответствовать правилам журнала по авторскому праву после принятия статьи. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Рисунок 5A–B демонстрирует влияние различного коэффициента дропаута в уравнении (16) на производительность модели. Результаты экспериментов показали, что при низком коэффициенте дропаута модель работает плохо, однако по мере увеличения этого коэффициента производительность модели постепенно улучшалась до достижения оптимального уровня. В частности, оптимальный коэффициент дропаута составил 0,3 для набора данных Diginetica, 0,2 для набора данных Tmall и 0,5 для набора данных Nowplaying. Когда коэффициент дропаута превышал эти оптимальные значения, производительность модели начинала снижаться, главным образом из-за того, что чрезмерное исключение нейронов препятствовало эффективному обучению модели важным признакам из данных сессий.
Влияние различного размера эмбеддинга
Для максимально возможного снижения вычислительных затрат при сохранении оптимальной эффективности модели было исследовано влияние различных размерностей эмбеддингов d на работу модели GSLA4Rec. Как показано на рисунке 6A–B, на трех общедоступных наборах данных Diginetica, Tmall и Nowplaying модель GSLA4Rec демонстрировала низкие результаты при размерности эмбеддингов d от 10 до 40; однако по мере увеличения значения d эффективность модели быстро росла. Показатели эффективности имели тенденцию к стабилизации при значениях d в диапазоне от 80 до 120, после чего наблюдалось снижение эффективности при дальнейшем росте d, что, вероятно, было вызвано переобучением из-за слишком большой размерности эмбеддинга. Таким образом, размерность вектора эмбеддинга объекта была окончательно установлена на уровне 100.
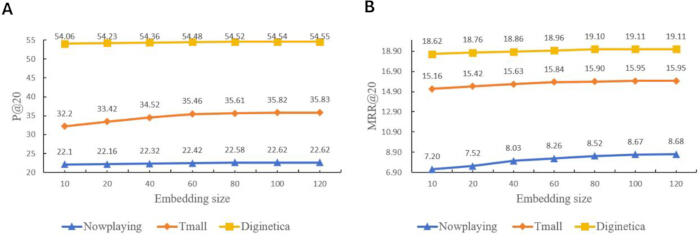
Рисунок 6: Эффективность GSLA4Rec при различных размерах эмбеддингов. (A) P@20 и (B) MRR@20 модели GSLA4Rec при различных размерах эмбеддингов на наборах данных Nowplaying, Tmall и Diginetica. Эффективность модели постепенно повышалась с увеличением размера эмбеддингов и в конечном итоге достигла плато. GSLA4Rec — графовые нейронные сети с линейным вниманием и вентильными слотами для рекомендаций на основе сессий (SBR). Данный рисунок был самостоятельно построен в программе OriginPro с использованием полностью настраиваемых элементов. Сторонние графические ресурсы, защищенные авторским правом, не использовались, поэтому дополнительное лицензирование авторских прав третьих лиц не потребовалось. Авторское право на рисунок принадлежит авторам и будет соответствовать правилам журнала по авторскому праву после принятия работы. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Влияние различной продолжительности сеансов
Было известно, что длительность каждой сессии варьируется в трех реальных наборах данных SBR (Diginetica, Tmall и Nowplaying). Чтобы проверить робастность модели GSLA4Rec по сравнению с базовыми моделями при различной длительности сессий, все сессии в Diginetica и Tmall были разделены на три группы: короткие (S), средние (M) и длинные (L), соответствующие диапазонам от 1 до 6, от 7 до 12 и более 12 соответственно. Для проверки эффективности методов вместо P@20 был использован показатель MRR@20, так как MRR лучше отражает качество ранжирования правильных результатов. Рисунок 7A–B показал, что модель GSLA4Rec превзошла основанную на последовательностях базовую модель NARM, основанную на GNN базовую модель SR-GNN, дополненную контрастивным обучением GNN базовую модель S2-DHCN и пространственно-временную базовую модель RESTC при различной длительности сессий. В то же время было замечено, что эффективность всех методов снижалась с увеличением длины последовательности, так как долгосрочные переходы между объектами затрудняли захват предпочтений пользователей, однако предложенная модель GSLA4Rec имела самую низкую скорость снижения по сравнению с базовыми моделями, поскольку механизм Gated-slot мог отфильтровывать нерелевантные объекты; эффективность GSLA4Rec в группах длинных сессий Diginetica и Tmall превысила показатели модели NARM на 6,3 и 8,85 соответственно.
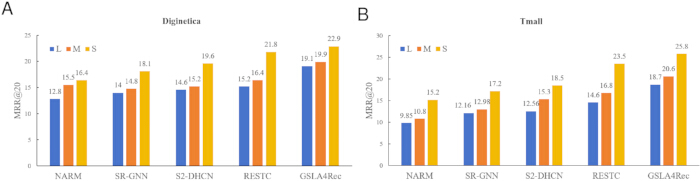
Рисунок 7: Эффективность GSLA4Rec при различной длине сессий. Эффективность GSLA4Rec и базовых моделей в различных группах по длине сессий на наборах данных (A) Diginetica и (B) Tmall, оцененная с помощью MRR@20. Группы по длине сессий обозначены как L, M и S. GSLA4Rec — графовые нейронные сети с линейным вниманием и вентильными слотами для рекомендаций на основе сессий (SBR). Данный рисунок был самостоятельно отрисован в OriginPro с использованием полностью настроенных элементов. Сторонние графические ресурсы, защищенные авторским правом, не использовались; следовательно, дополнительное лицензирование авторских прав сторонних организаций не потребовалось. Авторские права на рисунок принадлежат авторам и будут соответствовать правилам журнала по авторскому праву после принятия статьи. Пожалуйста, нажмите здесь, чтобы просмотреть этот рисунок в большем размере.
Заключение
В данной работе предлагается глобальная контекстная сеть линейного внимания с вентилируемыми слотами для сессионных рекомендательных систем (SBR). Благодаря объединению SG и NGG, а также внедрению механизма линейного внимания с вентилируемыми слотами, данный метод позволяет фокусироваться на ключевых элементах в последовательности сессий, улавливать долгосрочные и краткосрочные зависимости, эффективно снижать уровень шума и уменьшать вычислительную сложность. Результаты экспериментов подтверждают, что данный метод демонстрирует высокую точность и эффективность рекомендаций на трех открытых наборах данных, особенно превосходя другие подходы в задачах моделирования долгосрочных зависимостей.
ДОСТУПНОСТЬ ДАННЫХ:
Три общедоступных набора данных (Diginetica, Tmall и Nowplaying, URL-адреса которых указаны в Таблице материалов), подтверждающие результаты данного исследования, находятся в открытом доступе в Интернете. Одновременно с этим три широко используемых открытых набора данных и исходный код данной работы представлены в Дополнительной папке: GSLA4Rec.zip. Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Обсуждение
По сравнению с базовыми моделями, модель GSLA4Rec достигает двойного улучшения производительности и эффективности по трем основным причинам. Во-первых, применение механизмов управления к NGG смягчает проблему разреженности данных и эффективно фильтрует шум. Во-вторых, механизм слотов памяти обеспечивает баланс между ёмкостью хранения и эффективностью за счёт настройки гиперпараметров м регулировка. Во-третьих, линейный механизм внимания вычисляет корреляции между элементами на уровне О(N) сложность, значительно ниже, чем у О(Н2)61Модель GSLA4Rec чрезмерно полагается на пользователей' последовательности взаимодействий и игнорирует мультимодальные свойства элементов48Между тем, построение NGG использует фиксированный порог Жаккара без функции динамической настройки и слотов памяти м не может обеспечить адаптивную регулировку65.
Модель GSLA4Rec, которая строит SG&NGG и принимает линейное внимание с вентилируемыми слотами, особенно подходит для анонимной рекомендации сессий39 на платформах электронной коммерции и онлайн-стриминга. На платформах электронной коммерции данная модель рекомендует товары, соответствующие пользователям, на основе анализа их действий — просмотров, кликов или добавления товаров в корзину — без использования атрибутов, характеризующих пользователя. Наборы данных Diginetica и Tmall, использованные в данной статье, представляют собой наборы данных для задач рекомендаций в электронной коммерции. Для платформ коротких видео и стриминга музыки этот метод анализирует пользователей' последовательности воспроизведения для выявления их скрытых предпочтений, обновляет сводки содержания для удержания пользователей и увеличивает продолжительность просмотра. Набор данных Nowplaying, использованный в данной статье, представляет собой набор данных музыкальных рекомендаций.
Существуют альтернативные решения, которые могут заменить архитектуру линейного внимания с управляемым слотом. Перспективная модель Mamba65 модель на основе пространства состояний в качестве альтернативы обладает свойствами избирательного хранилища состояний и линейной вычислительной сложности, обеспечивая баланс между линейной сложностью и способностью к аппроксимации длинных последовательностей, и сочетается с крупной языковой моделью (LLM)55 рамка улучшения, извлекает пользователей' неявное намерение из исходного лога взаимодействий, обеспечивая высокую эффективность и качество рекомендаций. В будущем работу можно оптимизировать с нескольких точек зрения: построение динамического NGG вместо фиксированной фильтрации по Жаккару, реализация переменных слотов памяти для автоматического сопоставления сессий разной длины, а также интеграция мультимодальной информации о пользователях для повышения точности рекомендаций. Кроме того, с помощью моделей, усиленных крупными языковыми моделями (LLM),55, пользователи' скрытые намерения можно извлекать из последовательностей взаимодействий, а шумные данные разговоров — более точно фильтровать72.
Раскрытие информации
Авторы заявляют об отсутствии известных конфликтов финансовых интересов или личных отношений, которые могли бы повлиять на работу, описанную в данной статье.
Благодарности
Автор благодарит рецензентов за продуманные отзывы и предложения в процессе рецензирования, а также профессора Jiang Nan, моего научного руководителя, за тщательное руководство. Данное исследование было частично поддержано Национальным фондом естественных наук Китая (грант №6217072713 и грант №62061019), а также в рамках открытых тем исследований по инженерным исследованиям беспилотных сенсорных систем и технологий искусственного интеллекта провинции Цзянси в 2025 году и Провинциальной ключевой лабораторией передовых электронных материалов и устройств провинции Цзянси (№2024SSY03012).
Материалы
| Имя | Компания | Каталожный номер | Комментарии |
|---|---|---|---|
| CUDA 11.3 | NVIDIA | НЕТ | CUDA 11.3 — это версия платформы параллельных вычислений и модели программирования, выпущенная NVIDIA в 2021 году и направленная на повышение производительности и гибкости разработки приложений с ускорением на GPU. |
| Diginetica | Diginetica | НЕТ | Diginetica — это официальный соревновательный набор данных конкурса CIKM (International Information Retrieval Conference) Cup 2016 года, который использовался в конкурсе алгоритмов CIKM для решения задачи персонализированного поиска товаров в электронной коммерции с учетом контекста поиска. В настоящее время он стал наиболее распространенным стандартным эталонным набором данных в области рекомендаций на основе сессий (Session based Recommendation, SBR). |
| Nowplaying | Zenodo | НЕТ | Это крупномасштабный набор данных о поведении пользователей при прослушивании музыки, построенный на основе майнинга твитов с тегом "# nowplaying"; в основном он используется для исследований в области рекомендаций в музыкальных диалогах, рекомендаций с учетом контекста и анализа корреляции настроений. |
| OriginPro 2024 (64-bit) SR1 | OriginLab Corporation | НЕТ | OriginPro — это коммерческое профессиональное программное обеспечение для научного черчения и анализа данных, разработанное OriginLab Corporation, которое обычно используется для построения графиков публикационного уровня, статистического анализа данных, аппроксимации кривых, обработки сигналов и т. д. В данной статье OriginPro используется для построения сравнительных графиков, линейных графиков и гистограмм. |
| PyTorch 1.11.0 | PyTorch Foundation | НЕТ | PyTorch — это открытый фреймворк глубокого обучения для машинного и глубокого обучения, выпущенный Facebook в 2016 году. Он в основном реализует автоматическое дифференцирование и вводит динамические графы вычислений, что делает создание моделей более гибким. |
| TITAN V GPU | NVIDIA | НЕТ | NVIDIA TITAN V — это флагманская видеокарта, выпущенная NVIDIA в конце 2017 года, ориентированная главным образом на области высокопроизводительных вычислений и искусственного интеллекта. |
| Tmall | Tmall | НЕТ | В рамках конкурса рекомендаций Alibaba Tmall на IJCAI 2015 платформа Alibaba Tianchi публично выпустила десенсибилизированные реальные онлайн-логи Tmall. Этот набор является одним из трех стандартных датасетов в области SBR (Diginetica, Yoocoose, Tmall) и предпочтительным набором для оценки в сценариях китайской электронной коммерции. |
| visio 2021 | Microsoft | НЕТ | Visio — это программное обеспечение для векторного рисования, разработанное Microsoft и используемое для построения схем структуры моделей, блок-схем, структурных диаграмм, диаграмм топологии сети в научных работах, а также для вывода векторных изображений для иллюстраций к статьям. |
Ссылки
- Sarwar B, Karypis G, Konstan J, Riedl J. Item-based collaborative filtering recommendation algorithms. In: Proceedings of the 10th International Conference on World Wide Web; 2001 May 1–5; Hong Kong, China. ACM; 2001.p.285-295.
- Zhao ZD, Shang MS. User-based collaborative-filtering recommendation algorithms on hadoop. In: 2010 Third International Conference on Knowledge Discovery and Data Mining; 2010 Jan 9–10; Washington, DC, USA. IEEE; 2010.p.478-481.
- Koren Y, Rendle S, Bell R. Recommender Systems Handbook. Berlin: Springer; 2022.
- Koren Y, Bell R, Volinsky C. Matrix factorization techniques for recommender systems. Computer. 2009;42(8):30-37.
- Rendle S, Freudenthaler C, Schmidt-Thieme L. Factorizing personalized markov chains for next-basket recommendation. In: Proceedings of the 19th International Conference on World Wide Web; 2010 Apr 26–30; Raleigh, North Carolina, USA. ACM; 2010.p.811-820.
- Wang S et al. A survey on session-based recommender systems. ACM Comput Surv. 2021; 54(7): 1-38.
- Ninichuk M, Namiot D. Survey On Methods For Building Session-Based Recommender Systems. Int J Open Inf Technol. 2023;11(5):22-32.
- Saxena A. A Survey of Session-Based Recommender Systems. In: 2023 5th International Conference on Advances in Computing, Communication Control and Networking. IEEE, 2023.
- Ravanmehr R, Mohamadrezaei R. Session-Based Recommender Systems Using Deep Learning. Berlin: Springer; 2023.
- He R, McAuley J. Fusing similarity models with markov chains for sparse sequential recommendation. In: 2016 IEEE 16th International Conference on Data Mining; 2016 Dec 12–15; Barcelona, Spain. IEEE; 2016.p.191-200.
- Chen R, Fan J, Wu M. MC-RGN: Residual graph neural networks based on Markov chain for sequential recommendation. Inf Process Manag. 2023;60(6):103519.
- Ni S, Hu S, Li L. An intention-aware markov chain based method for top-k recommendation. IEEE Trans Autom Sci Eng. 2022;21(1):581-592.
- Yu Y, Si X, Hu C, Zhang J. A review of recurrent neural networks: LSTM cells and network architectures. Neural Comput. 2019;31(7):1235-1270.
- Mienye ID, Swart TG, Obaido G. Recurrent neural networks: A comprehensive review of architectures, variants, and applications. Information. 2024;15(9):517.
- Hidasi B, Karatzoglou A, Baltrunas L, Tikk D. Session-based recommendations with recurrent neural networks. In: Bengio Y, LeCun Y, editors. Proceedings of International Conference on Learning Representations; 2016 May 2–4; San Juan, Puerto Rico.
- Li J et al. Neural attentive session-based recommendation. In: Proceedings of the 2017 ACM Conference on Information and Knowledge Management; 2017 Nov 6–10; Singapore. ACM; 2017. p.1419-1428.
- Liu Q, Zeng Y, Mokhosi R, Zhang H. STAMP: short-term attention/memory priority model for session-based recommendation. In: Proceedings of the 24th ACM SIGKDD International Conference on Knowledge Discovery & Data Mining; 2018 Aug 19–23; London, United Kingdom. ACM; 2018.p.1831-1839.
- Zhou J et al. Graph neural networks: A review of methods and applications. AI open. 2020;1:57-81.
- Scarselli F, Gori M, Tsoi AC, Hagenbuchner M, Monfardini G. The graph neural network model. IEEE Trans Neural Netw. 2009;20(1):61‑80.
- Corso G, Stark H, Jegelka S, Jaakkola T, Barzilay R. Graph neural networks. Nat Rev Methods Primers. 2024;4(1):17.
- Zheng Y, Yi L, Wei Z. A survey of dynamic graph neural networks. Front Comput Sci. 2025;19(6):196323.
- Wu S et al. Session-based recommendation with graph neural networks. In: Proceedings of the AAAI Conference on Artificial Intelligence; 2019 Jan 27‑Feb 1; Honolulu, USA. AAAI Press; 2019.p.346-353.
- Wang Z et al. Global context enhanced graph neural networks for session‑based recommendation. In: Proceedings of the 43rd International ACM SIGIR Conference on Research and Development in Information Retrieval; 2020 Jul 25‑30; Virtual conference. ACM; 2020.p.169‑178.
- Shani G, Heckerman D, Brafman RI. An MDP‑based recommender system. J Mach Learn Res. 2005;6:1265‑1295.
- Gu W, Dong S, Zeng Z. Increasing recommended effectiveness with Markov chains and purchase intervals. Neural Comput Appl. 2014;25(5):1153‑1162.
- O'shea K, Nash R. An introduction to convolutional neural networks. arXiv preprint arXiv:1511.08458, 2015.
- Wu J. Introduction to convolutional neural networks. Nanjing: National Key Lab for Novel Software Technology, Nanjing University; 2017.
- Li Z, Yang W, Peng S, Liu F. A survey of convolutional neural networks: analysis, applications, and prospects. IEEE Trans Neural Netw Learn Syst. 2021;33(12):6999‑7019.
- Krichen M. Convolutional neural networks: A survey. Computers. 2023;12(8):151.
- Tang J, Wang K. Personalized top-n sequential recommendation via convolutional sequence embedding. In: Proceedings of the 11th ACM International Conference on Web Search and Data Mining; 2018 Feb 5–9; Marina Del Rey, California, USA. ACM; 2018.p.565-573.
- Tuan T, Phuong T. 3D convolutional networks for session-based recommendation with content features. In: Proceedings of the 11th ACM Conference on Recommender Systems; 2017 Aug 27–31; Como, Italy. ACM; 2017.p.138-146.
- Graves A. Generating sequences with recurrent neural networks. arxiv preprint arxiv: 1308.0850, 2013.
- Tang D, Qin B, Liu T. Document modeling with gated recurrent neural network for sentiment classification. In: Proceedings of the 2015 Conference on Empirical Methods in Natural Language Processing; 2015 Sep 17‑21; Lisbon, Portugal. Association for Computational Linguistics; 2015.p.1422‑1432.
- Chan W, Jaitly N, Le Q, Vinyals O. Listen, attend and spell: a neural network for large vocabulary conversational speech recognition. In: 2016 IEEE International Conference on Acoustics, Speech and Signal Processing; 2016 Mar 20‑25; Shanghai, China. IEEE; 2016.p. 4960‑4964.
- Sutskever I, Vinyals O, Le QV. Sequence to sequence learning with neural networks. In: Advances in Neural Information Processing Systems 27; 2014 Dec 8‑13; Montreal, Canada.
- Xiao C, Li Z, Tang J, Lee J. United prediction of travel modes and purposes in travel chains based on multitask learning deep neural networks. Mathematics. 2025;13(9):1528.
- Chmielewski J, Wójcik M. The use of deep neural networks (DNN) in travel demand modelling. Appl Sci. 2025;15(20):11290.
- Shahmoradi N, Alesheikh AA, Jafari A, Lotfata A. Hybrid ST-ResNet and LSTM approach for precise crime hotspot prediction. Sci Rep. 2025;15:18672.
- Park J, Yi D, Ji SM. Analysis of recurrent neural network and predictions. Symmetry.2020;12(4): 615.
- Ramakrishnan N, Soni T. Network traffic prediction using recurrent neural networks. In: 2018 17th IEEE International Conference on Machine Learning and Applications; 2018 Dec 17‑20; Orlando, Florida, USA. IEEE; 2018.p.187‑193.
- Yu P, Yan X. Stock price prediction based on deep neural networks. Neural Comput Appl. 2020;32(6):1609‑1628.
- Zhao J, Zeng D, Liang S, Kang H, Liu Q. Prediction model for stock price trend based on recurrent neural network. J Ambient Intell Humaniz Comput. 2021;12:745‑753.
- Zaytar MA, Chaker EA. Sequence to sequence weather forecasting with long short-term memory recurrent neural networks. Int J Comput Appl. 2016;143(11):7-11.
- Xu L, Peng J, Jiang X, Chen E, Luo B. Graph neural network based on graph kernel: a survey. Pattern Recognit. 2025;161:111307.
- Li Y, Tarlow D, Brockschmidt M, Zemel R. Gated graph sequence neural networks. arxiv preprint arxiv: 1511.05493, 2015.
- Kipf TN, Welling M. Semi-supervised classification with graph convolutional networks. arXiv preprint arXiv:1609.02907;2016.
- Veličković P et al. Graph attention networks. arXiv preprint arXiv:1710.10903;2017.
- Chen L, Zhu X, Zhu G. Exploiting attributes and keywords for session-based recommendation with multi-view graph neural network. Expert Syst Appl. 2025;128990.
- Driss El Alaoui et al. A novel session-based recommendation system using capsule graph neural network. Neural Netw. 2025;185:107176.
- Xu C et al. Graph contextualized self‑attention network for session‑based recommendation. In: Proceedings of the 28th International Joint Conference on Artificial Intelligence; 2019 Aug 10‑16; Macao, China. 2019.p.3940‑3946.
- Qiu R, Huang Z, Li J, Chen H. Rethinking the item order in session‑based recommendation with graph neural networks. In: Proceedings of the 28th ACM International Conference on Information and Knowledge Management; 2019 Nov 3‑7; Beijing, China. ACM; 2019.p.579‑588.
- Chen J, Ji J, Li H, Zhang X. SR‑HetGNN: session‑based recommendation with heterogeneous graph neural network. Knowl Inf Syst. 2024;66(2):1111‑1134.
- Wang Y et al. Knowledge graph‑based session recommendation with session‑adaptive propagation. In: Companion Proceedings of the ACM Web Conference 2024; 2024 May 13‑17; Singapore. ACM; 2024.p.264‑273.
- Wang Z, Jin B. DiffSBR: a diffusion model for session-based recommendation. Inf. Process. Manag. 2026;63(1):104284.
- Qiao S et al. Multi-view intent learning and alignment with large language models for session-based recommendation. ACM Trans. Inf. Syst. 2025;43(4):91.
- Wang M et al. A collaborative session‑based recommendation approach with parallel memory modules. In: Proceedings of the 42nd International ACM SIGIR Conference on Research and Development in Information Retrieval; 2019 Jul 21‑25; Paris, France. ACM; 2019. p.345‑354.
- Ye R, Zhang Q, Luo H. Cross-session aware temporal convolutional network for session-based recommendation. In: 2020 International Conference on Data Mining Workshops; 2020 Nov 16–19; Sorrento, Italy. IEEE Computer Society; 2020.p.220-226.
- Chen Y, Huang L, Wang C, Lai J. Hybrid-order gated graph neural network for session-based recommendation. IEEE Trans Ind Inform. 2021;18(3):1458‑1467.
- Chen Y, Tang Y, Yuan Y. Attention-enhanced graph neural networks with global context for session-based recommendation. IEEE Access. 2023;11:26237-26246.
- Tang L, Wang X, Wang H, Shi C, Song L. DA‑GCN: a domain‑aware attentive graph convolution network for shared‑account cross‑domain sequential recommendation. In: Proceedings of the 30th International Joint Conference on Artificial Intelligence; 2021 Aug 19‑27; Montreal, Canada.
- Vaswani A et al. Attention is all you need. In: Advances in Neural Information Processing Systems 30; 2017 Dec 4‑9; Long Beach, USA.
- Lu Y, Letey M, Zavatone‑Veth JA, Maiti A, Pehlevan C. Asymptotic theory of in‑context learning by linear attention. Proc. Natl. Acad. Sci. U.S.A. 2025;122(28):e2502599122.
- Peng H, Pappas N, Yogatama D, Kong L. ABC: attention with bounded‑memory control. In: Proceedings of the 60th Annual Meeting of the Association for Computational Linguistics; 2022 May 22‑27; Dublin, Ireland. Association for Computational Linguistics; 2022.p.7469‑7483.
- Yang S et al. Gated linear attention transformers with hardware‑efficient training. In: Proceedings of the 41st International Conference on Machine Learning; 2024 Jul 21‑27; Vienna, Austria. PMLR; 2024.
- Yuan H et al. DG‑mamba: robust and efficient dynamic graph structure learning with selective state space models. In: Proceedings of the 39th AAAI Conference on Artificial Intelligence; 2025 Feb 25‑Mar 4; Philadelphia, Pennsylvania, USA. AAAI Press; 2025.p.22272‑22280.
- Xia X et al. Self‑supervised graph co‑training for session‑based recommendation. In: Proceedings of the 30th ACM International Conference on Information and Knowledge Management; 2021 Oct 25‑29; Virtual Event. ACM; 2021.p.2180‑2190.
- Zhou H, Zhang D, Song M, Han W. Temporal augmented graph neural networks for session‑based recommendations. In: Proceedings of the 44th International ACM SIGIR Conference on Research and Development in Information Retrieval; 2021 Jul 11‑15; Montreal, Canada. ACM; 2021. p. 1798‑1802.
- Chen Q, Jiang F, Wang Y, Li Y, Zhang Y. Combine temporal information in session‑based recommendation with graph neural networks. Expert Syst Appl. 2024;238:121969.
- Hou Y, Hu B, Zhang Z, Zhao W. Core: simple and effective session‑based recommendation within consistent representation space. In: Proceedings of the 45th International ACM SIGIR Conference on Research and Development in Information Retrieval; 2022 Jul 11‑15; Madrid, Spain. ACM; 2022.p.1796‑1801.
- Wan Z et al. Spatio‑temporal contrastive learning‑enhanced GNNs for session‑based recommendation. ACM Trans. Inf. Syst. 2023;42(2):1‑26.
- Zeng X et al. RAIN: reconstructed‑aware in‑context enhancement with graph denoising for session‑based recommendation. Neural Netw. 2025;184:107056.
- Zhan H et al. Capturing dynamic interests with deformable attention mechanism for session-based recommendation. Int J Mach Learn Cybern. 2026;17:375.