В данном протоколе описывается создание набора данных о погоде и систематическая оценка моделей машинного обучения, глубокого обучения и гибридных моделей для прогнозирования атмосферного затухания в системах оптической связи в свободном пространстве в различных условиях окружающей среды Ирака, включая пыльные бури, туман, дождь и снег.
Исследовательская статья
Машинное обучение превосходит глубокое обучение в прогнозировании атмосферного затухания в системах оптической связи в свободном пространстве в условиях иракского климата
В этой статье
Краткое содержание
Аннотация
Системы оптической связи в свободном пространстве обеспечивают высокую пропускную способность, повышенную безопасность и работу без лицензирования, однако они подвержены значительному ухудшению характеристик из-за атмосферного затухания, вызванного рассеянием и поглощением. Точность прогнозирования затухания особенно важна в Ираке, где условия окружающей среды характеризуются жарой, запыленностью, туманом и дождями, возникающими случайным образом. Целью данной работы является оценка эффективности методов машинного обучения, глубокого обучения и гибридного моделирования для прогнозирования атмосферного затухания в системах оптической связи в свободном пространстве при различных погодных условиях в Ираке. С помощью общепринятых физических моделей распространения был создан синтетический набор данных из 1500 образцов для пяти погодных режимов: ясное небо, туман, дождь, пыльные бури и снег. Были систематически оценены пятнадцать прогностических моделей, состоящих из шести методов машинного обучения (случайный лес [RF], градиентный бустинг Extreme Gradient Boosting, Light Gradient Boosting Machine, регрессия на основе метода опорных векторов, линейная регрессия и метод k-ближайших соседей), шести архитектур глубокого обучения (многослойный перцептрон, глубокая нейронная сеть, долгая краткосрочная память [LSTM], одномерная сверточная нейронная сеть [CNN], CNN–LSTM и сеть на основе механизма внимания) и трех гибридных подходов. Результаты показали, что RF продемонстрировал наилучшие показатели (R2 = 0.9654, среднеквадратическая ошибка = 1.324 dB/km) по сравнению с подходами глубокого обучения (лучший R2 = 0.7766) и гибридными методами (лучший R2 = 0.9571). Важность признаков была проанализирована с помощью аддитивных объяснений Шепли (Shapley Additive exPlanations), в результате чего было установлено, что наиболее влиятельными факторами являются концентрация пыли (67.3%) и видимость (21.2%). Хотя использование RF привело к существенно более быстрому обучению и выводу, статистическое тестирование не выявило значимых различий между RF и наиболее эффективным гибридным подходом (p = 0.083). Доказано, что традиционные методы машинного обучения высокоэффективны для оценки атмосферного затухания в системах связи FSO в неблагоприятных условиях окружающей среды, что согласуется с известными физическими теориями распространения. Однако мы подчеркиваем, что данные выводы основаны на синтетических данных и должны быть подтверждены реальными атмосферными измерениями перед их внедрением в эксплуатационные системы FSO.
Введение
Сети оптической связи в свободном пространстве (FSO), как правило, обладают более высокой пропускной способностью и лучшей безопасностью, однако атмосферное затухание вследствие рассеяния и поглощения является основным сдерживающим фактором для дальности связи1. В данной работе мы представляем детальный анализ подходов на основе машинного обучения, глубокого обучения и гибридных методов2 для оценки затухания сигнала FSO в сложных условиях Ирака, характеризующихся высокими температурами, пыльными бурями и неравномерным распределением осадков.
Системы связи FSO (оптическая связь в свободном пространстве) стали одним из перспективных решений для высокоскоростного беспроводного соединения3 со скоростями передачи данных, превышающими 100 Gbps на расстояниях от нескольких сотен метров до нескольких километров4. В отличие от традиционных радиочастотных систем, каналы FSO работают в видимом и инфракрасном спектрах, предлагая такие преимущества, как безлицензионная эксплуатация, устойчивость к электромагнитным помехам, повышенная безопасность за счет узкой расходимости луча и большая пропускная способность5. Эти особенности делают FSO привлекательной технологией для приложений транспортных сетей (backhaul), межкорпусных соединений, сетей аварийного восстановления и обеспечения «последней мили» в случаях, когда прокладка оптоволокна неоправданно дорога6. Однако связь, подверженная влиянию рассеяния, отклонения луча и поглощения7,8, сильно зависит от условий окружающей среды с точки зрения доступности и производительности. Эта проблема является одним из основных ограничений систем оптической связи в свободном пространстве. Погодные условия вызывают значительные колебания уровней затухания (dB/km). При ясном небе затухание может составлять менее 0.5 dB/km, тогда как сильный туман может привести к тому, что затухание достигнет ≥50 dB/km на длине волны 1550 nm (согласно модели тумана Кима, которая предсказывает значения затухания до 50 dB/km при видимости менее 50 m на 1550 nm)9,10, а сильный дождь может вызвать затухание до 20–30 dB/km в зависимости от интенсивности осадков (согласно прогнозу модели Карбонно)11. Таким образом, для надежного проектирования каналов связи, планирования сети и адаптивных стратегий передачи требуется точное прогнозирование затухания. Традиционные методы основаны на физических моделях распространения, таких как модель Кима для тумана12, модель Карбонно для дождя13 и теория рассеяния Ми для аэрозольных частиц14. Однако, несмотря на то что эти модели обеспечивают хорошую теоретическую базу, они часто опираются на точные атмосферные параметры, которые не всегда доступны на практике, и зачастую не учитывают сложные взаимодействия между одновременными множественными метеорологическими явлениями15.
Экстремальная изменчивость условий окружающей среды в Ираке создает значительные трудности для развертывания систем оптической связи в открытом пространстве. Ситуация с передачей данных дополнительно осложняется минимальным количеством осадков и отдельными эпизодами тумана, в то время как зимние температуры могут опускаться ниже нуля, а летние — подниматься выше 50 °C16. При использовании стандартных длин волн, таких как 1550 nm, пыльные бури, известные на местном уровне как «аль-хабуб», могут ограничивать видимость до менее чем 100 метров, что приводит к значениям затухания, превышающим 20dB/km17. Для успешного внедрения систем FSO в Ираке и других странах Ближнего Востока необходимо создать надежные прогностические модели, способные точно оценить производительность системы в этих различных условиях окружающей среды18.
Новые разработки в области машинного обучения представляют собой жизнеспособную альтернативу традиционным методам физического моделирования. Способность методов машинного обучения напрямую выявлять сложные нелинейные корреляции между затуханием и атмосферными факторами позволяет обнаруживать незначительные взаимодействия, которые могли быть упущены традиционными аналитическими моделями19. В различных задачах климатического прогнозирования стратегии случайного леса (Random Forest, RF) и градиентного бустинга продемонстрировали высокую эффективность20. Аналогичным образом, методы глубокого обучения добились значительных успехов в обработке естественного языка, компьютерном зрении и прогнозировании временных рядов21. Однако эти подходы недостаточно исследованы для прогнозирования затухания в системах FSO, особенно при ограниченных наборах данных и сильно меняющихся погодных условиях22. Чтобы восполнить этот пробел, в данной работе представлено тщательное исследование методов машинного обучения, глубокого обучения и гибридных подходов для прогнозирования затухания сигнала FSO в атмосферных условиях Ирака. Это достигается путем создания грамотно спроектированного синтетического набора данных на основе общеизвестных физических моделей распространения23. Мы предполагаем, что для табличных наборов данных об окружающей среде среднего размера с небольшим количеством доминирующих прогностических переменных предсказательная способность ансамблевых методов на основе деревьев будет выше, чем у сложных архитектур глубокого обучения. Основными целями являются: (1) создание базовой методологии для сравнения методов прогнозирования в контролируемой симуляционной среде, (2) определение наилучших алгоритмических стратегий для прогнозирования атмосферного затухания и (3) оценка значимости признаков и интерпретируемости моделей для понимания того, какие факторы окружающей среды оказывают наибольшее влияние на затухание. В данной работе используются синтетические данные, однако закладывается основа для последующей валидации с использованием реальных экспериментальных измерений, что запланировано в будущих работах. Кроме того, включен анализ значимости признаков и интерпретируемости для определения наиболее важных факторов окружающей среды, влияющих на затухание.
Протокол
Данное исследование не предполагало участия людей или позвоночных животных, а также забора тканей. Все данные, использованные в этом исследовании, были синтетически сгенерированы с помощью моделей физического распространения и общедоступных метеорологических параметров. Следовательно, одобрение комитета по этике институционального наблюдательного совета (IRB) или институционального комитета по уходу и использованию животных (IACUC) не потребовалось.
Генерация набора данных на основе теории физического распространения. Набор данных был создан для имитации ежечасных атмосферных условий для системы оптической связи в свободном пространстве в течение всего календарного года (2024) для атмосферных условий Ирака. Мы создали синтетическую базу данных с 1 500 образцами в час.
Во-первых, погодные условия распределялись случайным образом на основе региональных тенденций: ясное небо (54,3%), пыль (24,9%), туман (10,5%), дождь (7,4%) и снег (2,8%). Во-вторых, к каждому образцу в зависимости от погодных условий применялась соответствующая модель физического затухания, а именно: закон Бугера — Ламберта — Бера для ясного неба, модель Кима для тумана, теория Карбонно для дождя и теория рассеяния Ми для пыльных бурь. В-третьих, параметры системы FSO были установлены следующим образом: мощность передачи 20 dBm, длина волны 1550 nm, расстояние передачи 3 km, апертура передатчика 2,5 cm и апертура приемника 20 cm. В-четвертых, для каждого образца рассчитывалось затухание в dB/km. Наконец, полный набор данных был случайным образом разделен на 1200 обучающих образцов (80%) и 300 тестовых образцов (20%). Смоделированные условия включают высокие концентрации пыли, связанные с песчаными бурями, ливнями и изменениями температуры от −4.89°C до 47.99°C. Погодные условия и распределение параметров были выбраны на основе климатических данных Ирака за период 2020–2024 гг. Пять погодных режимов (ясное небо, туман, дождь, пыльные бури и снег) были выбраны потому, что они охватывают весь спектр атмосферных условий, влияющих на затухание FSO в Ираке, при этом пыльные бури особенно распространены на Ближнем Востоке. Исторические метеорологические данные, собранные по всем регионам Ирака, использовались для создания распределения вероятностей для каждого погодного условия. Полученное распределение было следующим: 54,3% — ясное небо (преобладающее состояние), 24,9% — пыль (отражает проблему песчаных бурь в Ираке), 10,5% — туман (часто встречается зимой в северном Ираке), 7,4% — дождь (низкий уровень осадков, типичный для Ирака) и 2,8% — снег (иногда выпадает в северных горных районах). Соответствующие метеорологические параметры моделировались с использованием распределений вероятностей для каждого погодного условия следующим образом: температура моделировалась с помощью нормального распределения (среднее 28.55±11.18°C) в диапазоне от −4.89°C до 47.99°C на основе сезонных экстремумов в Ираке; влажность моделировалась с помощью равномерного распределения (среднее 42.01±25.56%) от 0% до 100%; видимость моделировалась с помощью логнормального распределения в диапазоне от 0.05 km до 29.99 km (среднее 13.10±10.91 km) для учета частых случаев низкой видимости во время пыльных бурь; концентрация пыли моделировалась с помощью экспоненциального распределения в диапазоне от 0 до 4.96 mg/m3 (среднее 0.74±1.30 mg/m3) с более высокой вероятностью низких концентраций и длинными «хвостами» для экстремальных случаев запыленности.
Система связи была спроектирована с мощностью передачи 20 dBm, длиной волны 1550 nm, расстоянием передачи до 3 km, апертурой передатчика 2.5 cm и апертурой приемника 20 cm для компенсации потерь на расходимость. Параметры системы FSO были разделены на две группы: фиксированные параметры, которые оставались неизменными для всех образцов, и переменные параметры, которые изменялись в процессе генерации набора данных. Для всех 1500 образцов были зафиксированы следующие параметры: мощность передачи (20 dBm), рабочая длина волны (1550 nm), апертура передатчика (диаметр 2.5 cm, эффективность 0.7) и апертура приемника (диаметр 20 cm, эффективность 0.7). Эти параметры были зафиксированы, так как они представляют собой физические характеристики оборудования системы FSO и не меняются в зависимости от погодных условий. Набор данных был сформирован из 1500 образцов с варьированием следующих параметров: температура (−4.89°C до 47.99°C), влажность (0% до 100%), видимость (0.05 km до 29.99 km), концентрация пыли (0 до 4.96 mg/m3) и погодные условия (ясное небо, туман, дождь, пыль, снег). Эти параметры изменялись в соответствии с распределениями вероятностей, выведенными из климатических записей Ирака за 2020–2024 годы. Для каждого образца значение затухания (dB/km) рассчитывалось с использованием соответствующей физической модели затухания в зависимости от конкретной комбинации погодных условий и переменных параметров.
Физическое затухание моделировалось с использованием модели Карбонно для дождя, закона Бугера — Ламберта — Бера для ясного неба, теории рассеяния Ми для пыли и модели Кима для тумана24. Закон Бугера — Ламберта — Бера применим для условий ясного неба, когда в затухании преобладают молекулярное рассеяние и поглощение, которые экспоненциально убывают с расстоянием25. Коэффициент экстинкции α при 1550 nm обусловлен рэлеевским рассеянием молекулами воздуха и поглощением атмосферными газами26. Модель Кима представляет собой специализированную модель для тумана, которая связывает затухание с видимостью через эмпирические коэффициенты, полученные из распределений капель тумана по размеру. Зависящий от длины волны показатель степени q учитывает рассеяние Ми27. Основным параметром модели Карбонно является интенсивность дождя R, так как затухание в дожде зависит от размера и плотности дождевых капель, а коэффициенты получены эмпирически при 1550 nm и специально откалиброваны для оптических длин волн28. Теория рассеяния Ми применима к условиям запыленности, поскольку размер частиц пыли (радиус 0.1–100 μm) сопоставим с длиной волны (1550 nm), а комплексный показатель преломления m = 1.55–0.005i для пыли Ближнего Востока учитывает как рассеяние, так и поглощение29. Следующие модели физического затухания были реализованы с соответствующими уравнениями и настройками параметров.
Для условий чистого неба использовался закон Бугера — Ламберта — Бера:
Aclear = 10×log₁₀(e(α×d)) (1)
где α — коэффициент затухания (варьировался с использованием нормального распределения с центром 0.02 dB/km и отклонением ±0.005 dB/km при 1550 nm в условиях ясного неба), а d — расстояние передачи (фиксировано на уровне 3 km). Для условий тумана была реализована модель Кима с использованием следующего уравнения:
Afog = 10×ln(10)/V×(λ/550)−q (2)
где V — видимость в километрах (варьировалась от 0.05km до 10km), λ — длина волны в нанометрах (фиксированная на уровне 1550nm), а q — коэффициент распределения частиц по размерам, рассчитываемый следующим образом: q=1.6 при V>50 km, q=1.3 при 6<V<50 km, q=0.585×V(1/3) при 1 <V<6km, q=0 при 0.5<V<1km и q=0.5 при V<0.5km. Для условий дождя использовалась модель Carbonneau:
Arain=0.023×R0.93 (3)
где R — интенсивность дождя в mm/h (варьировалась от 0.25 до 50mm/h согласно данным осадков в Ираке). Для условий пыльной бури использовалось соотношение эффективности экстинкции на основе рассеяния Ми:
Adust=10×log₁₀(e(τ×L)) (4)
где τ=∫₀^∞ πr2Qext(r,λ,m)N(r)dr, r — радиус частицы (0,1–100 μm согласно составу иракской пыли), Qext — эффективность экстинкции, рассчитанная по теории Ми, λ=1550 nm, m=1,55–0,005i — комплексный показатель преломления для пыли Ближнего Востока, а N(r) — распределение частиц по размерам, смоделированное с использованием логнормального распределения с геометрическим средним радиусом 2,5 μm и стандартным отклонением 2,0. Модель затухания была реализована для снежных условий следующим образом:
Asnow = 0.1×S0.75 (5)
где S — скорость снегопада в mm/h (0,5–15 mm/h). Данное эмпирическое уравнение было выбрано на основе литературных данных30, где модели затухания при оптическом распространении через снег были разработаны с использованием теории рассеяния Ми, примененной к распределению размеров снежинок. Уравнение применимо для скоростей снегопада от 0,5 до 15 mm/h и предполагает условия сухого снега с типичным диаметром снежинок 1–10 mm. Коэффициент 0,1 и показатель степени 0,75 были получены путем аппроксимации кривой расчетов рассеяния Ми30 для снега на длине волны 1550 nm. Оно не учитывает влажный снег или смешанные осадки, которые могут обладать переменными характеристиками затухания, хотя и дает достаточно точную оценку для сухого снега. Поскольку данный подход вычислительно эффективен, часто упоминается в публикациях по FSO и соответствует прогнозируемым снеговым условиям в северном Ираке (регион Курдистан в январе и феврале), он был выбран для данного исследования. Все модели были реализованы на Python 3.9 с использованием Numpy для численных расчетов. Соответствующая модель применялась к случайно выбранным погодным условиям и выборочным данным окружающей среды для расчета значения затухания для каждого образца. Полученное распределение погоды включало 814 условий ясного неба (54,27%), 375 случаев запыления (25,00%), 157 случаев тумана (10,47%), 111 случаев дождя (7,40%) и 43 случая снегопада (2,87%).
Для установления пропорций погодных условий использовался анализ исторических метеорологических данных, собранных с иракских метеостанций в нескольких регионах (Багдад, Басра, Мосул и Рамади) в период с 2020 по 2024 год. Первичные данные были предоставлены Министерством транспорта Ирака и Иракской организацией по метеорологии и сейсмологии (IMOS). Данные включали ежедневные записи погоды, фиксирующие текущие атмосферные условия на каждый день. Среди конкретных характеристик, извлеченных из этих записей, были температура (суточный минимум, максимум и среднее значение), относительная влажность, видимость, количество осадков и случаи возникновения пыльных бурь. Портал открытых данных правительства Ирака (https://www.motrans.gov.iq/) предоставляет доступ к части данных IMOS; однако конкретные записи, использованные в данном исследовании, не хранятся в открытом доступе в центральном репозитории. Климатическая информация, использованная для расчета процентного соотношения погодных условий и значений параметров, обобщена в Таблице 1. Дни с ясным небом определялись как дни без осадков, с видимостью более 10 km и отсутствием запыления, что составило 54,27% от 1825 зарегистрированных дней. Дни с пыльными бурями (включая полноценные пыльные бури (видимость < 1 km) и взвешенную пыль (видимость 1–5 km)) составили 25,00% дней, что указывает на высокую частоту песчаных бурь в засушливом и полузасушливом климате Ирака. Дни с видимостью менее 1 km, вызванной зависанием капель воды (исключая снижение видимости из-за пыли), классифицировались как дни с туманом. Процент дней с туманом составил 10,47%, при этом туманы наблюдались в основном зимой в северных регионах Ирака. Дождливые дни, дни с измеримыми осадками >0,1 mm, составили 7,40%, что соответствует низкому среднему годовому количеству осадков в Ираке, составляющему 150–200 mm в год. Снежные дни (дни с накоплением замерзших осадков) составили 2,87% дней и были ограничены горными северными районами (регион Курдистан) в январе и феврале. Эти пропорции в дальнейшем использовались в качестве весовых коэффициентов вероятности для случайной выборки при генерации набора данных. Таким образом, синтетический набор данных отражает реальную частоту каждого погодного условия в условиях Ирака.
Вопросы предвзятости при генерации синтетических данных
Для минимизации возможной систематической ошибки были предприняты следующие шаги:
(1) Выбор распределения: Для выбора вероятностных распределений использовались статистические свойства исходных климатических данных. Температура имела нормальное распределение со средним значением и стандартным отклонением согласно записям IMOS. Влажность имела равномерное распределение во всем наблюдаемом диапазоне (0-100%). Было принято допущение, что видимость следует логнормальному распределению, чтобы учесть частое возникновение явлений низкой видимости во время пыльных бурь. Концентрация пыли следовала экспоненциальному распределению, характеризующемуся более высокими вероятностями при низких концентрациях и длинными «хвостами» при экстремальных пылевых явлениях31. Это соответствовало наблюдаемой частоте пылевых явлений в Ираке32.
(2) Доли погодных условий: Анализ записей IMOS за 2020–2024 гг., включающий 1 825 ежедневных наблюдений во всех четырех регионах, показал следующие доли: 54,3% — ясное небо, 24,9% — пыль, 10,5% — туман, 7,4% — дождь и 2,8% — снег. Днями с ясным небом определялись дни без осадков, с видимостью >10 km и отсутствием пылевой активности. Дни с пыльными бурями включали как полноценные пыльные бури (видимость <1 km), так и взвесь пыли (видимость 1–5 km). День с туманом определялся как день, когда видимость составляла менее 1 km и причиной была взвесь капель воды (не пыль). Дни с дождем определялись как дни с измеримыми осадками >0,1 mm. Дни со снегом определялись как дни с накопленными замерзшими осадками33.
(3) Диапазоны параметров: Диапазоны параметров были основаны на наблюдаемых экстремумах в записях IMOS: температура варьировалась от −4.89 °C (Мосул, зима) до 47.99 °C (Басра, лето), видимость — от 0.05 km (сильные пыльные бури) до 29.99 km (ясная погода), а концентрация пыли — от 0 до 4.96 mg/m3 (на основе максимальной концентрации пыли, зафиксированной во время сильных хабубов)34.
(4) Предположения о независимости: Мы исходили из того, что параметры окружающей среды отбирались независимо, что является упрощением реальных условий, в которых атмосферные переменные коррелируют между собой (например, высокая концентрация пыли часто коррелирует с низкой видимостью). Для обеспечения контролируемой среды моделирования с целью систематического сравнения моделей было принято данное предположение о независимости 35. Последствия этих предположений рассмотрены в разделе «Обсуждение».
(5) Стратифицированное разделение: разделение на обучающую и тестовую выборки было стратифицировано по категориям погодных условий (ясное небо, туман, дождь, пыль, снег), чтобы обеспечить соответствие пропорции каждого погодного условия в обучающем и тестовом наборах распределению исходного набора данных. Таким образом, тестовый набор не будет несбалансированным в отношении редких погодных условий (особенно снега — 2,87%)36.
Подтверждение детерминированной генерации мишени
Важно отметить, что высокая прогностическая способность, наблюдаемая в данном случае, может быть частично обусловлена тем, что модель изучила или аппроксимировала детерминированные физические уравнения, использованные для генерации синтетических целевых значений37. В отличие от реальных экспериментальных измерений, которые содержат шум измерений, инструментальные погрешности и немоделируемые физические явления, синтетический набор данных обеспечивает чистую, свободную от шума взаимосвязь между входными признаками и целевым показателем затухания. Это объясняется тем, что значения затухания были вычислены непосредственно на основе физических моделей распространения (закон Бугера — Ламберта — Бера, модель Кима, модель Карбонно и теория рассеяния Ми) исходя из входных параметров. Следовательно, количественные показатели эффективности (R2, RMSE, MAE) отражают результаты работы на синтетических данных, полученных с помощью уравнений, и не должны интерпретироваться как ожидаемая эффективность на зашумленных обсервационных или экспериментальных данных. Полученные результаты следует рассматривать прежде всего как сравнительную оценку методологий моделирования в контролируемой среде симуляции38.
Полный набор признаков для обучения модели
Обучающий набор данных содержал 10 входных признаков для обучения модели:
1. Температура (°C)
2. Влажность (%)
3. Видимость (km)
4. Концентрация пыли (mg/m3)
5. Интенсивность осадков (mm/h)
6. Интенсивность снегопада (mm/h)
7. Скорость ветра (m/s)
8. Атмосферное давление (hPa)
9. Месяц (числовое значение, 1–12)
10. Сезон (one-hot кодирование: весна, лето, осень, зима)
Важное уточнение: погодные условия (ясное небо, туман, дождь, пыль, снег) использовались в качестве категориальной переменной для стратификации при разделении набора данных и не включались в число входных признаков для какой-либо модели. Анализ SHAP включает только 10 перечисленных выше признаков. Переменная «сезон» была закодирована методом one-hot encoding (4 категории: весна, лето, осень, зима), и для анализа SHAP вклады переменных сезонов, закодированных методом one-hot, суммировались по всем сезонам для получения единого значения вклада сезона. Это комбинированное значение представляет собой общий вклад всех переменных, связанных с сезоном, в прогнозирование затухания. Перед созданием итогового рисунка были определены четыре столбца сезонов с one-hot кодированием, и их значения SHAP были суммированы для каждого образца. Этот метод гарантирует, что использование моделью сезона в качестве составной категориальной переменной согласуется с анализом SHAP.
Основными экологическими факторами, которые непосредственно влияли на оптическое затухание посредством физических механизмов, были признаки 1–6. Добавление признаков 7 и 8 (скорость ветра и давление) в качестве дополнительных метеорологических факторов может оказывать косвенное влияние на затухание, воздействуя на стабильность воздуха и дисперсию аэрозолей. Для учета сезонных колебаний атмосферных условий в качестве временных дескрипторов были включены признаки 9–10 (месяц и сезон). Значение затухания (dB/km) использовалось в качестве целевой переменной для всех моделей. Ключевые статистические показатели набора данных включали температуру (28.55°C ± 11.18°C), влажность (42.01% ± 25.56%), видимость (13.10 ± 10.91 km; диапазон: 0.05–29.99 km), концентрацию пыли (0.74 ± 1.30 mg/m3; максимум: 4.96 mg/m3), затухание (4.80 ± 7.20 dB/km; диапазон: 0.09–50.93 dB/km), рабочую дальность (5.74 ± 1.97 km) и отношение сигнал/шум (64.88 ± 15.07 dB). Рабочая дальность и SNR были рассчитаны на основе значений затухания с использованием стандартных уравнений энергетического бюджета каналов FSO.
Расчет рабочего диапазона
Рабочий диапазон (в км) был рассчитан с использованием уравнения энергетического бюджета радиолинии:
Prx=Ptx×Gt×Gr×(λ/(4πR))2×10(−A×R/10) (6)
где: Prx = принятая мощность (установлена на минимальном уровне чувствительности −30 dBm); Ptx = мощность передачи (фиксированная, 20 dBm); Gt = коэффициент усиления передатчика (рассчитан на основе размеров апертуры); Gr = коэффициент усиления приемника (рассчитан на основе размеров апертуры); λ = длина волны (1550 nm); R = дальность в km; A = атмосферное затухание в dB/km (рассчитано на основе физических моделей).
Коэффициенты усиления передатчика и приемника: Коэффициент усиления передатчика (Gt) рассчитывался следующим образом: Gt = 10×log₁₀[0.7×(π×0.025/1.55×10⁻6)2] ≈ 44.2 dBi. Коэффициент усиления приемника (Gr) рассчитывался следующим образом: Gr = 10×log₁₀[0.7×(π×0.20/1.55×10⁻6)2] ≈ 62.3 dBi. Диаметр передающей апертуры составлял 2.5 cm при эффективности 0.7. Диаметр приемной апертуры составлял 20 cm при эффективности 0.7. Уравнение решалось итерационным методом относительно R для определения максимально возможной дистанции связи при каждом значении затухания.
Расчет отношения сигнал/шум
Отношение сигнал/шум (SNR) в дБ рассчитывали по следующей формуле:
SNR=Prx−10×log₁₀(kTB)−NF (7)
где: Prx = получаемая мощность в dBm (рассчитанная на основе энергетического бюджета линии связи); k = 1.38×10⁻23 J/K (постоянная Больцмана); T = 290 K (температура приемника); B = 109 Hz (полоса пропускания приемника, 1 GHz); NF = 3 dB (коэффициент шума приемника). Порог шума был рассчитан следующим образом:
10 × log10(kTB) ≈ −84 dBm (8)
Для каждого образца после расчета затухания A с использованием соответствующей физической модели был определен рабочий диапазон путем решения уравнения энергетического бюджета связи для R, а отношение сигнал/шум (SNR) было рассчитано на основе результирующей принимаемой мощности Prx на данном расстоянии.
Значения рабочего диапазона при различных погодных условиях: рабочий диапазон варьировался в зависимости от погодных условий: чистое небо (7.12 ± 1.85 km), туман (5.81 ± 1.92 km), снег (5.42 ± 1.56 km), дождь (3.81 ± 0.98 km) и пыль (3.72 ± 1.08 km). В данных расчетах запас в 3 dB не применялся; рабочий диапазон представляет собой теоретический максимум без учета системного запаса. Указанный рабочий диапазон (5.74 ± 1.97 km) является общим средним значением для всех погодных условий39.
Фиксированная дистанция передачи: в моделях физического затухания дистанция передачи была установлена на уровне 3 km. Это расстояние линии связи, для которого выполнялись расчеты затухания. Указанный рабочий диапазон представляет собой теоретическое максимальное расстояние, вычисленное с помощью уравнения энергетического бюджета линии связи, которое может отличаться от фиксированной дистанции передачи 3 km. Значения затухания для конкретных погодных условий были зафиксированы для ясной погоды (0.27±0.06 dB/km), тумана (1.88±1.92 dB/km), снега (6.45±2.54 dB/km), дождя (13.58±6.32 dB/km) и пыли (13.10±7.32 dB/km). Все количественные значения, приведенные в данной работе, представлены как среднее значение ± стандартное отклонение (SD), если не указано иное40.
Значение перекрестной проверки R2 для Random Forest составило 0.960±0.007. В некоторых случаях, таких как температура (−4.89 to 47.99°C), видимость (0.05 to 29.99km), концентрация пыли (0 to 4.96 mg/m3) и затухание (0.09 to 50.93dB/km), диапазон (от минимального до максимального значения) указан словами. Набор данных был разделен на подгруппы для тестирования (300 образцов; 20%) и обучения (1200 образцов; 80%). Для разделения выборки на обучающую и тестовую использовалась стратифицированная случайная выборка. Чтобы процент каждого погодного условия в обучающем наборе (80%) и тестовом наборе (20%) соответствовал распределению в исходном наборе данных, применялась стратификация по категориям погодных условий (ясное небо, туман, дождь, пыль и снег). В частности, 1200 (80%) из 1500 образцов были распределены в обучающий набор и 300 (20%) — в тестовый набор. Образцы для каждой категории метеорологических условий выбирались случайным образом с сохранением исходных пропорций: из 814 образцов с ясным небом (54.27%) 651 был назначен для обучения и 163 — для тестирования; из 375 образцов с пылью (25.00%) 300 — для обучения и 75 — для тестирования; из 157 образцов с туманом (10.47%) 126 — для обучения и 31 — для тестирования; из 111 образцов с дождем (7.40%) 89 — для обучения и 22 — для тестирования; из 43 образцов со снегом (2.87%) 34 — для обучения и 9 — для тестирования. Случайный отбор внутри каждой страты выполнялся с использованием случайного значения seed 42 для обеспечения воспроизводимости. Данный стратифицированный подход был выбран во избежание несбалансированного представления редких погодных условий (в частности, снега — 2.87%) в тестовом наборе, что в противном случае могло привести к недостоверной оценке эффективности модели для этих условий.
Оценка модели машинного обучения
Было оценено шесть методов машинного обучения, включая метод опорных векторов (SVR) с радиально-базисным ядром (C = 100), метод k-ближайших соседей (KNN; k = 10, с учетом веса расстояния), случайный лес (RF; 200 деревьев, максимальная глубина = 20), экстремальный градиентный бустинг (XGBoost; 200 оценщиков, максимальная глубина = 10, скорость обучения = 0.1), легковесную машину градиентного бустинга (LightGBM; 200 оценщиков, максимальная глубина = 10, скорость обучения = 0.1) и базовую линейную регрессию. Для всех моделей машинного и глубокого обучения была проведена настройка наиболее критических гиперпараметров, в то время как для неопределенных параметров были оставлены значения по умолчанию. Для моделей машинного обучения следующие параметры были явно настроены с использованием сеточного поиска с 5-кратной перекрестной проверкой на обучающей выборке: 1) Случайный лес: количество деревьев (тестировались значения: 50, 100, 150, 200, 250) и максимальная глубина (тестировались значения: 10, 15, 20, 25, без ограничений), при этом были выбраны оптимальные значения 200 деревьев и глубина 20. 2) XGBoost: количество оценщиков (тестировались значения: 100, 150, 200, 250), максимальная глубина (тестировались значения: 6, 8, 10, 12) и скорость обучения (тестировались значения: 0.05, 0.1, 0.2), при этом оптимальными оказались 200 оценщиков, глубина 10 и скорость обучения 0.1. 3) LightGBM: использовались идентичные диапазоны настройки, что привело к выбору 200 оценщиков, глубины 10 и скорости обучения 0.1. 4) SVR: настраивались параметр регуляризации C (тестировались значения: 1, 10, 50, 100) и коэффициент ядра gamma (тестировались значения: «scale», «auto», 0.1, 0.01), при этом оптимальными были C = 100 и RBF-ядро. 5) KNN: настраивалось количество соседей k (тестировались значения: 3, 5, 7, 10, 15), при этом оптимальным было k = 10 с включенным голосованием с учетом веса расстояния.
Все остальные параметры для этих моделей были оставлены по умолчанию, как определено в scikit-learn (см. Таблица материалов для каждой версии; например, Random Forest: bootstrap=True, min_samples_split=2, min_samples_leaf=1; XGBoost: subsample=1.0, colsample_bytree=1.0, gamma=0). Для моделей глубокого обучения архитектура (количество слоев и количество нейронов в слое) и коэффициент дропаута (20%) подбирались вручную путем итеративного экспериментирования на валидационной выборке, в то время как оптимизатор (Adam), начальная скорость обучения (0,001), параметр терпения для ранней остановки (20 эпох) и параметры снижения скорости обучения (фактор 0,5, терпение 10) были установлены в соответствии со стандартной практикой, описанной в литературе, и оставались неизменными во всех экспериментах с моделями глубокого обучения.
Источники климатических данных
Исторические метеорологические данные, собранные с иракских метеостанций в нескольких городах (Багдад, Басра, Мосул и Рамади) в период с 2020 по 2024 год, были использованы для расчета долей погодных состояний и распределения переменных. Исходные данные были предоставлены Министерством транспорта Ирака и Иракской организацией по метеорологии и сейсмологии (IMOS). В данные были включены ежедневные записи погоды с подробным описанием преобладающего атмосферного состояния для каждого дня. Конкретные переменные, полученные из этих записей, включали температуру (ежедневный минимум, максимум и среднее значение), относительную влажность, видимость, количество осадков и случаи пыльных бурь. Данные IMOS частично доступны через портал открытых данных правительства Ирака (https://www.motrans.gov.iq/), хотя конкретные записи, использованные в данном исследовании, не архивированы публично в централизованном репозитории. Сводка климатических данных, использованных для определения долей погодных условий и диапазонов параметров, представлена в Таблице 1.
Для настройки гиперпараметров и оценки эффективности всех моделей машинного обучения на обучающем наборе (1 200 образцов) использовалась пятикратная перекрестная проверка. Все входные переменные (температура, влажность, видимость, концентрация пыли, интенсивность осадков в виде дождя, интенсивность осадков в виде снега, скорость ветра, давление) прошли масштабирование признаков путем стандартизации (Z-масштабирование): x_scaled = (x − μ)/σ, где μ и σ — среднее значение и стандартное отклонение обучающего набора. Стандартизация проводилась внутри каждого фолда перекрестной проверки с использованием только статистических данных обучающего фолда во избежание утечки данных. Модели на основе деревьев решений (Random Forest, XGBoost, LightGBM) инвариантны к масштабу, однако для единообразия всех моделей машинного обучения применялась одна и та же стандартизация. Для моделей глубокого обучения использовалась min-max нормализация: x_scaled = (x−x_min)/(x_max−x_min), которая масштабирует признаки до диапазона [0, 1] на основе минимальных и максимальных значений обучающего набора. Ограниченные входные данные обеспечивают более быструю сходимость нейронных сетей, поэтому был выбран именно этот метод. Тестовый набор масштабировался с использованием параметров, полученных из обучающего набора, и не использовался для выбора модели или настройки гиперпараметров.
Были зафиксированы полные показатели эффективности, включая тестовый коэффициент детерминации (R2), среднеквадратичную ошибку (RMSE), среднюю абсолютную ошибку (MAE), R2 при кросс-валидации и время обучения. Время обучения для всех моделей машинного и глубокого обучения указано в секундах (s) для более быстрых моделей (Linear Regression, KNN, SVR, Random Forest, XGBoost, LightGBM) и в минутах (min) для более медленных моделей (архитектур глубокого обучения). Все модели обучались в одной вычислительной среде для обеспечения объективности сравнения41.
Время обучения измеряли с помощью модуля time в Python, т. е. общее время (стенные часы), прошедшее от начала до завершения функции подбора параметров модели, за исключением времени, затраченного на загрузку и предобработку данных. Под временем обучения модели глубокого обучения понимается время, необходимое для завершения всех эпох до срабатывания условия ранней остановки. Сюда входят прямое распространение, обратное распространение и проверки на валидации. Все эксперименты проводились при отсутствии в системе других ресурсоемких вычислительных процессов для получения согласованных показателей времени. Указанное время представляет собой среднее значение по 5 независимым запускам (стандартные отклонения)42.
Оценка модели глубокого обучения
С использованием GPU-ускорения были оценены шесть архитектур глубокого обучения, включая многослойный перцептрон (MLP; 64-32-16), глубокую нейронную сеть (DNN) с пакетной нормализацией (128-64-32-16), сеть долгой краткосрочной памяти (LSTM; 64-32 единицы, длина последовательности = 10), одномерную сверточную нейронную сеть (1D-CNN), гибридную модель CNN–LSTM и сеть на основе механизма внимания. Все модели глубокого обучения были реализованы с помощью TensorFlow с использованием API Keras и запущены с GPU-ускорением (версии аппаратного и программного обеспечения указаны в Таблице материалов). Архитектура 1D-CNN состояла из трех сверточных слоев (64, 128 и 256 фильтров, размер ядра 3, активация ReLU, padding=’same’), двух слоев MaxPooling1D (размер пула 2), слоя GlobalAveragePooling1D, полносвязного слоя (Dense) со 128 единицами и активацией ReLU, слоя Dropout (0,2) и выходного полносвязного слоя (1 единица, линейная активация), что в сумме составляет примерно 245 000 обучаемых параметров. Гибридная архитектура CNN-LSTM принимала входные последовательности из 10 временных шагов с 5 признаками, используя два слоя Conv1D (64 и 128 фильтров, размер ядра 3, ReLU, padding=’same’), слой MaxPooling1D (размер пула 2), два слоя LSTM (64 и 32 единицы, return_sequences=False), слои Dropout (0,2), полносвязный слой (32 единицы, ReLU) и выходной полносвязный слой (1 единица, линейная активация), что в сумме составляет примерно 198 000 обучаемых параметров. В сети на основе механизма внимания использовался многоголовый механизм внимания (multi-head attention) с 4 головами (размерность ключа и значения 64), где входные данные проецировались в 64 измерения с последующим применением масштабированного скалярного произведения внимания (формула: Attention(Q, K, V) = softmax(QKT/√d_k), остаточных связей, нормализации слоя, сети прямого распространения (128→64 единицы), глобального усредняющего пулинга, Dropout (0,2), полносвязного слоя (32 единицы, ReLU) и выходного полносвязного слоя (1 единица, линейная активация), что в сумме составляет примерно 167 000 обучаемых параметров43.
Во всех моделях использовались ранняя остановка (patience = 20), снижение скорости обучения (factor = 0.5, patience = 10), дропаут (20%) и оптимизатор Adam (learning rate = 0.001). Для всех моделей глубокого обучения размер пакета (batch size) был установлен на уровне 32 образцов, максимальное количество эпох обучения составляло 200 с применением ранней остановки (patience = 20, с восстановлением наилучших весов), а в качестве функции потерь использовалась среднеквадратическая ошибка (MSE). Разделение на обучающую и валидационную выборки было следующим: из исходных 1,200 обучающих образцов (после разделения на обучающую и тестовую выборки в соотношении 80/20) 80% (960 образцов) использовались для обучения и 20% (240 образцов) — для валидации. Мы провели стратификацию при разделении на обучающую и валидационную выборки по погодным условиям для сохранения распределения. Валидационный набор использовался только для ранней остановки, снижения скорости обучения и мониторинга переобучения; он никогда не использовался для выбора модели или настройки гиперпараметров за пределами этих автоматизированных процедур. Мы не выделяли отдельный валидационный набор для моделей машинного обучения; вместо этого мы использовали пятикратную перекрестную проверку на 1,200 обучающих образцах для настройки гиперпараметров и оценки производительности44.
Обоснование оценки архитектур LSTM и CNN–LSTM
Основной набор данных состоит из независимо сгенерированных образцов погоды, однако мы также протестировали архитектуры LSTM и CNN–LSTM по следующим причинам: (1) реальные атмосферные условия обладают временной автокорреляцией, и тестирование моделей, основанных на последовательностях, позволяет нам определить, может ли учет таких зависимостей повысить точность прогнозирования; (2) недавние исследования в области атмосферного прогнозирования продемонстрировали потенциальную ценность последовательных архитектур для моделирования временной эволюции метеорологических параметров34; (3) тестирование разнообразного ряда архитектур обеспечивает всестороннее сравнение методологических подходов, что является ключевым вкладом данной работы; и (4) гибридная архитектура CNN–LSTM сочетает в себе извлечение пространственных признаков с временным моделированием, что может быть полезно для фиксации сложных взаимодействий между несколькими атмосферными переменными45.
Форматирование данных для ввода в последовательную модель
Для последовательных архитектур (LSTM и CNN–LSTM) входные данные были реструктурированы из независимых образцов в псевдопоследовательности с использованием метода скользящего окна. В частности, 1200 обучающих образцов сначала были сгруппированы по категориям погодных условий для сохранения физической согласованности. Внутри каждой погодной категории образцы были упорядочены по их временным меткам (смоделированные ежечасные наблюдения за 2024 календарный год). Затем было применено скользящее окно длиной 10 для создания входных последовательностей из 10 последовательных временных шагов (каждый с 5 признаками: температура, влажность, видимость, концентрация пыли и интенсивность осадков) для прогнозирования затухания на 11ым временном шаге. Этот метод сохраняет временную последовательность смоделированных наблюдений, позволяя последовательным моделям изучать временные зависимости. Структура тестового набора была аналогичной с тем же размером окна и набором признаков. Мы признаем, что такая псевдопоследовательная структуризация является методологическим упрощением и не отражает реальную временную динамику. Это было отмечено в качестве ограничения в разделе «Обсуждение».
Оценка гибридных подходов
Были изучены три гибридных подхода. Первый подход представлял собой голосовой ансамбль (Voting Ensemble), который усреднял прогнозы моделей Random Forest, XGBoost и глубокой нейронной сети с использованием равных весов (каждой модели присваивался вес 1/3), при этом окончательный прогноз рассчитывался следующим образом:
ŷensemble=(1/3)ŷRF+(1/3)ŷXGB+(1/3)ŷDNN (9)
Равное взвешивание было выбрано, чтобы избежать введения дополнительных гиперпараметров и оценить базовую эффективность ансамбля без смещения в сторону какой-либо отдельной модели. Второй подход основывался на стекинге с использованием мета-обучаемого Ridge-регрессора. Базовыми моделями обучения были Random Forest, XGBoost и глубокая нейронная сеть (на основе механизма внимания). Процедура стекинга включала два этапа: сначала каждая базовая модель была обучена на полном обучающем наборе из 1 200 образцов с использованием 5-кратной перекрестной проверки для генерации предсказаний вне выборки (out-of-fold predictions), что позволило создать новую матрицу мета-признаков размером 1 200×3 (по одному предсказанию от каждой базовой модели для каждого образца). Затем мета-обучаемая Ridge-регрессия (параметр L2-регуляризации alpha=1.0) была обучена на этих мета-признаках, используя исходные значения затухания в качестве целевой переменной, чтобы определить оптимальные веса комбинации базовых моделей. Итоговое предсказание стекинга было следующим:
ŷstacking=wRF×ŷRF+wXGB×ŷXGB+wDNN×ŷDNN (10)
где веса w были определены с помощью мета-обучателя Ridge. Третий подход представлял собой физически-информированную нейронную сеть, в которой для образцов в условиях тумана сочетались 70% прогнозов нейронной сети и 30% прогнозов модели Кима. Объединение выполнялось путем фиксированного средневзвешенного вычисления по следующей формуле:
ŷhybrid=0.7×ŷneural+0.3×ŷKim (11)
где ŷneural — это выход нейронной сети на основе механизма внимания (Attention), а ŷKim — затухание, рассчитанное по модели тумана Кима на основе входных данных о видимости. Для образцов без тумана физическая часть была установлена на 0, и модель работала как чистая нейронная сеть. Веса (70% нейронной сети и 30% физической модели) были зафиксированы на основе предварительных экспериментов на валидационном наборе (не на тестовом), в ходе которых мы протестировали комбинации весов 90:10, 80:20, 70:30, 60:40 и 50:50. Разделение 70/30 было выбрано, так как оно обеспечило наилучший коэффициент R2 при валидации и при этом сохранило достаточное физическое ограничение модели Кима для регуляризации прогнозов и предотвращения физически недопустимых результатов, особенно в условиях тумана, где модель Кима задает установленные теоретические пределы затухания.
Анализ важности признаков и интерпретируемости
Для определения рангов значимости всех 10 входных признаков использовалась модель Random Forest с расчетом значимости признаков на основе примеси (снижения дисперсии). Анализ показал, что наиболее важными предикторами были концентрация пыли (67,3%) и видимость (21,2%), которые в совокупности обеспечили 88,5% общей прогностической значимости. Третьим по важности признаком была интенсивность дождя (6,0%), за которой следовали скорость ветра (2,1%), температура (1,5%), влажность (0,9%), месяц (0,5%), сезон (0,3%), интенсивность снегопада (0,1%) и атмосферное давление (0,1%). Низкие показатели значимости временных признаков (месяц и сезон) указывают на то, что сезонные колебания атмосферного затухания определяются преимущественно базовыми параметрами окружающей среды, а не только временными закономерностями.
Для оценки взаимосвязей между факторами окружающей среды и затуханием был проведен анализ SHAP (Shapley Additive exPlanations). Для реализации SHAP использовался модуль TreeExplainer из библиотеки SHAP, который специально оптимизирован для моделей на основе деревьев, включая Random Forest, XGBoost и LightGBM (версию см. в Таблице материалов). Конфигурация анализа SHAP была следующей: обученная модель Random Forest была передана в TreeExplainer, который вычислял значения SHAP с использованием интервенционного (маргинального) подхода к атрибуции признаков на основе условного ожидания выходных данных модели. Значения SHAP были рассчитаны для всех 300 образцов тестового набора, что позволило создать матрицу размером 300 × 10 (одно значение SHAP на один признак для каждого образца). Для каждого признака значение SHAP представляло собой его вклад в прогноз относительно базового уровня (среднего прогноза модели). Отрицательные значения SHAP указывали на смещение вниз, в то время как положительные значения SHAP показывали, что данный признак увеличивал прогноз затухания. Сила вклада определялась величиной значения SHAP. Распределение значений SHAP для каждого признака (с помощью графиков beeswarm), направление влияния (корреляция между значениями признаков и значениями SHAP) и ранги важности признаков были визуализированы с помощью сводных графиков. Для создания всех визуализаций SHAP использовались встроенные функции построения графиков библиотеки SHAP: shap.summary_plot() для графика beeswarm и shap.bar_plot() для глобальной важности признаков.
Обработка переменных с одногорячим кодированием (one-hot encoding): для кодирования переменной «сезон» изначально использовались четыре бинарных столбца (весна, лето, осень и зима). Чтобы для анализа SHAP создать единое значение вклада «сезона» для каждого образца, вклады этих четырех переменных с одногорячим кодированием были объединены путем суммирования значений SHAP для каждой категории сезона. Для выполнения этой группировки были найдены все столбцы, соответствующие группам сезонов с одногорячим кодированием, извлечены их значения SHAP для каждого образца, после чего они были суммированы поэлементно. Полученные комбинированные значения SHAP представляют собой общий вклад сезона в прогноз затухания. Такой метод позволяет отобразить в сводном графике SHAP одну строку «сезон» и обеспечивает соответствие использованию сезона в модели в качестве составной категориальной переменной. Поскольку комбинированный показатель дает более понясное представление об общем вкладе сезона, значения SHAP для сезона не приводились отдельно для каждой категории.
Результаты
Характеристики синтетического набора данных представлены на рисунке 1A–F. Набор данных включал условия чистого неба, пыли, тумана, дождя и снега (рисунок 1A), при этом образцы были распределены по жарким-сухим и прохладным-влажным сезонам (рисунок 1B), а также по дневным и ночным периодам (рисунок 1C). Распределения температуры, влажности и видимости при различных погодных условиях показаны на рисунке 1D–F.
Модели машинного обучения продемонстрировали высокую прогностическую способность при оценке атмосферного затухания (Рисунок 2A–D; Таблица 3). RF показала наилучшие общие результаты среди оцениваемых моделей с тестовым R2, равным 0.9654, и RMSE 1.324 dB/km (Рисунок 2A; Таблица 3). Модель RF объяснила 96.54% наблюдаемой вариации, сохранив при этом ошибку прогнозирования ниже 1.5 dB/km. XGBoost также показала хорошие результаты (Рисунок 2C), за ней следовала LightGBM (Рисунок 2B). Робастность моделей была подтверждена пятикратной перекрестной проверкой, при этом RF достигла значения R2 при перекрестной проверке 0.960 ± 0.007 (Рисунок 2D). Напротив, метод K-ближайших соседей продемонстрировал признаки переобучения с R2 на обучающей выборке 1.000 и R2 на тестовой выборке 0.7341, в то время как линейная регрессия показала умеренную прогностическую способность (Рисунок 2A; Таблица 3).
Анализ значимости 10 вышеупомянутых входных признаков представлен на рисунке 3A. Относительные показатели значимости распределились следующим образом: концентрация пыли (67,3%), видимость (21,2%), интенсивность дождя (6,0%), скорость ветра (2,1%), температура (1,5%), влажность (0,9%), месяц (0,5%), сезон (0,3%), интенсивность снегопада (0,1%) и давление (0,1%). Переменная «погодные условия» используется для стратификации набора данных, но не включена в анализ значимости признаков, поскольку она является категориальной композитной переменной, представляющей несколько базовых физических параметров, и ее влияние учитывается отдельными характеристиками окружающей среды. Анализ значимости признаков и интерпретируемость позволили выявить переменные окружающей среды, наиболее сильно связанные с затуханием (рисунок 3A,B). На долю концентрации пыли (67,3%), видимости (21,2%) и интенсивности дождя (6,0%) в совокупности пришлось 94,4% общей прогностической значимости (рисунок 3A). Анализ SHAP дополнительно показал, что увеличение концентрации пыли и снижение видимости связаны с увеличением прогнозируемого затухания (рисунок 3B).
Модели глубокого обучения продемонстрировали более низкую прогностическую способность по сравнению с методами машинного обучения (Рисунок 4A–D). Наилучшие результаты среди моделей глубокого обучения показала сеть на основе механизма внимания (Attention-based network), достигнув R2 0.7766 и RMSE 3.362 dB/km (Рисунок 4A). Рекуррентные архитектуры показали особенно низкую эффективность: модели LSTM и CNN–LSTM выдали значения R2, близкие к нулю, а значения RMSE превысили 7.19 dB/km (Рисунок 4B). Относительно низкая эффективность архитектур LSTM и CNN-LSTM (R2 = 0.0110 и 0.0109 соответственно; RMSE = 7.193 dB/km и 7.196 dB/km) может быть частично объяснена псевдопоследовательной природой входных данных, которые не в полной мере отражают истинную временную динамику атмосферных условий.
В отличие от приложений для анализа временных рядов в реальном времени, где последовательные зависимости сильны и четко определены, наш набор данных состоял в основном из независимых образцов с искусственно наложенным временным порядком. Низкая прогностическая способность этих архитектур указывает на то, что временная информация, извлеченная с помощью метода скользящего окна, была либо недостаточной, либо не отражала реальную эволюцию атмосферы (Рисунок 4C). Это подтверждает наш вывод о том, что для наборов данных такого типа более подходящими являются простые подходы машинного обучения, чем сложные модели глубокого обучения на основе последовательностей. Результаты валидации для всех архитектур глубокого обучения обобщены на Рисунке 4D.
Эффективность методов машинного обучения, глубокого обучения и гибридных подходов обобщена на Рисунке 5A,B и в Таблице 3. Среди гибридных методов голосовой ансамбль (Voting Ensemble) достиг значения R2 0,9340 и RMSE 1,827 dB/km (Рисунок 5A,B; Таблица 3). Стекинг с мета-обучателем Ridge достиг значения R2 0,9571 и RMSE 1,473 dB/km (Рисунок 5A,B; Таблица 3), приблизившись по эффективности к RF, но потребовав существенно большего времени обучения. Физически-информированная нейронная сеть (Physics-Informed Neural Network) достигла R2 = 0,8269 и RMSE = 2,960 dB/km (Рисунок 5A,B; Таблица 3) и показала результаты лучше, чем модели глубокого обучения, но хуже, чем лучшие подходы машинного обучения. Статистическое сравнение моделей RF и Stacking Ensemble не выявило значимых различий в прогностической способности (Таблица 3; парный t-критерий: t = −1,74, p = 0,083). Таким образом, хотя RF достиг самого высокого числового значения R2, различие с лучшим гибридным подходом не было статистически значимым.
В целом, полученные результаты подтверждают гипотезу о том, что подходы машинного обучения позволяют точно прогнозировать атмосферное затухание в погодных условиях Ирака. RF последовательно демонстрировал самые высокие показатели прогнозной точности (Рисунок 2A,B; Таблица 3), в то время как анализ важности признаков и анализ SHAP выявили концентрацию пыли и видимость в качестве доминирующих факторов окружающей среды, влияющих на затухание (Рисунок 3A,B).
Заявление о данных валидации: все оценки моделей проводились на синтетическом наборе данных, подробно описанном в разделе «Методы». При валидации модели не использовались экспериментальные или наблюдательные данные об атмосферном затухании. Синтетический набор данных был создан с использованием общеизвестных физических моделей распространения (закон Бугера — Ламберта — Бера, модель Кима, модель Карбонно и теория рассеяния Ми), при этом метеорологические параметры выбирались из распределений вероятностей на основе климатических записей Ирака. Как отмечено в разделе «Методы», высокая прогностическая способность может частично отражать процесс обучения модели или ее аппроксимацию детерминированных физических уравнений, использованных для генерации целевых значений. Следовательно, количественные показатели эффективности (R2, RMSE, MAE) представляют собой результаты работы на синтетических данных, полученных из уравнений, и должны интерпретироваться как относительные сравнения методологий моделирования в контролируемой среде симуляции, а не как абсолютные гарантии работоспособности операционных систем FSO. Такой подход обеспечивает контролируемую среду для сравнительной оценки методологий прогностического моделирования (перечисленных в Таблице 2), но не заменяет валидацию с помощью реальных измерений затухания FSO в фактических погодных условиях Ирака.
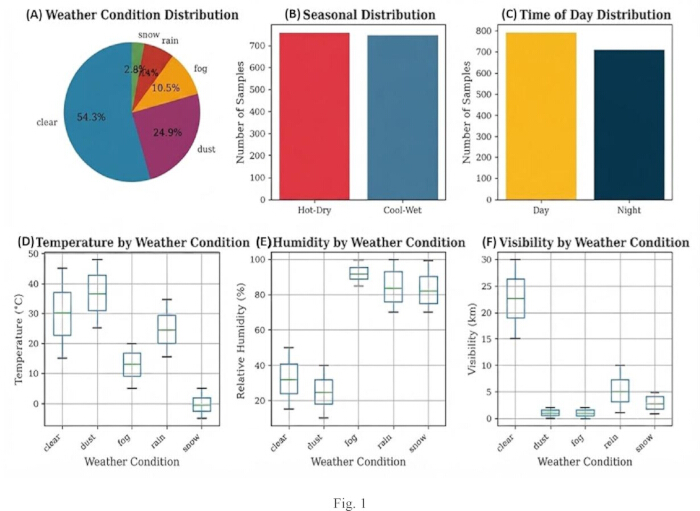
Рисунок 1: Характеристики синтетического набора данных и переменные окружающей среды, использованные для моделирования атмосферного затухания. (A) Распределение представленных в наборе данных метеорологических условий, включая ясное небо, пыль, туман, дождь и снег. (B) Сезонное распределение образцов по жарким-сухим и прохладным-влажным периодам. (C) Распределение образцов, собранных в дневное и ночное время. (D) Распределение температуры для каждого погодного условия. (E) Распределение влажности для каждого погодного условия. (F) Распределение видимости для каждого погодного условия. На диаграммах размаха («ящиках с усами») показаны медиана (центральная линия), межквартильный размах (ящик), а также минимальное и максимальное значения (усы). Температура указана в °C, влажность в %, а видимость в km. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
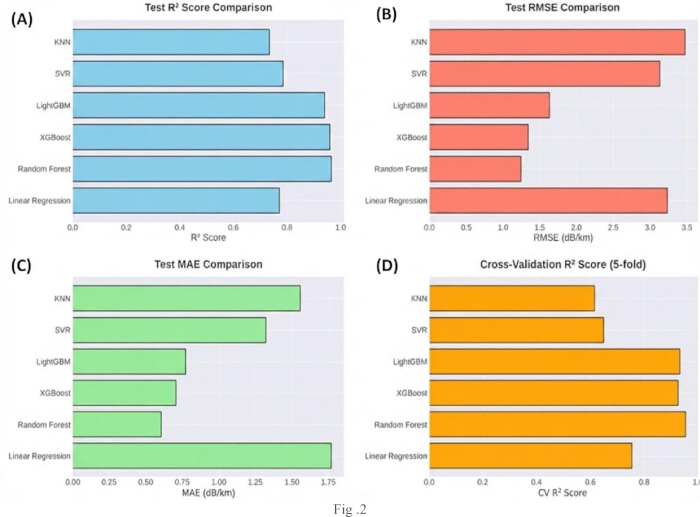
Рисунок 2: Сравнение эффективности моделей машинного обучения для прогнозирования атмосферного затухания. (A) Значения тестового коэффициента детерминации (R2) для оцениваемых моделей машинного обучения, включая линейную регрессию (Linear Regression), случайный лес (Random Forest), экстремальный градиентный бустинг (XGBoost), Light Gradient Boosting Machine (LightGBM), регрессию на основе метода опорных векторов (SVR) и метод k-ближайших соседей (KNN). (B) Значения тестовой среднеквадратичной ошибки (RMSE) для каждой модели машинного обучения. (C) Значения тестовой средней абсолютной ошибки (MAE) для каждой модели машинного обучения. (D) Значения коэффициента детерминации (R2) при кросс-валидации, полученные с использованием пятикратной перекрестной проверки. Более высокие значения R2 и более низкие значения RMSE и MAE свидетельствуют о лучшей прогностической способности. RMSE и MAE указаны в dB/km. Нажмите здесь, чтобы просмотреть этот рисунок в большем размере.
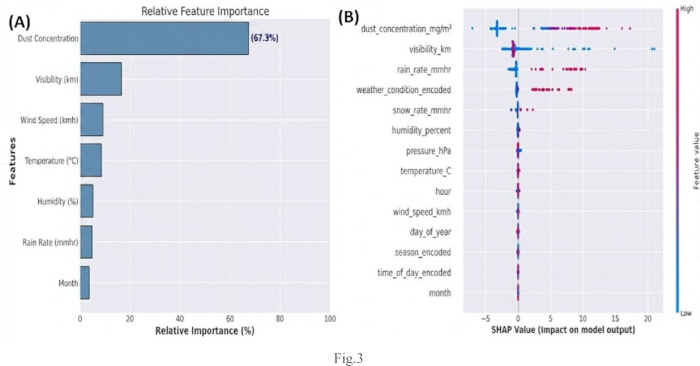
Рисунок 3: Анализ важности признаков и интерпретируемости модели для прогнозирования атмосферного затухания. (A) Ранжирование важности признаков на основе относительной примеси из модели Random Forest, демонстрирующее вклад всех 10 экологических и временных переменных в прогнозирование затухания. Наиболее влиятельным признаком была концентрация пыли (67.3%), за которой следовали видимость (21.2%), интенсивность дождя (6.0%), скорость ветра (2.1%), температура (1.5%), влажность (0.9%), месяц (0.5%), сезон (0.3%), интенсивность снегопада (0.1%) и атмосферное давление (0.1%). Относительная важность представлена в процентах от общей важности модели. (B) Сводный график SHapley Additive exPlanations (SHAP), иллюстрирующий влияние отдельных признаков на прогнозы модели. Матрица SHAP была рассчитана для 300 образцов тестового набора (300 × 10 признаков). Для переменной «сезон», закодированной методом one-hot (изначально четыре бинарных столбца: весна, лето, осень, зима), значения SHAP были объединены путем суммирования по четырем категориям для получения одного значения вклада «сезона» на образец. Каждая точка представляет собой образец, а цветовая шкала указывает значение признака: от низкого (синий) до высокого (красный). Положительные значения SHAP указывают на увеличение прогнозируемого затухания, тогда как отрицательные значения SHAP указывают на его уменьшение. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
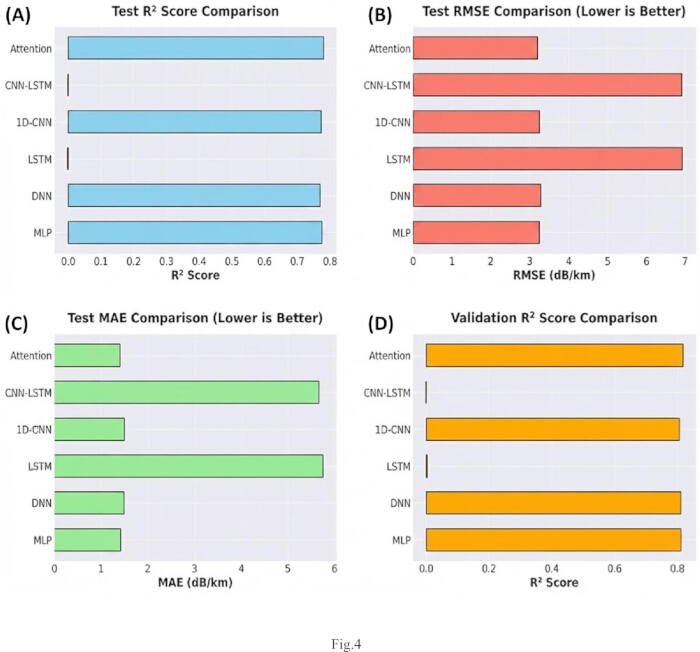
Рисунок 4: Сравнение эффективности моделей глубокого обучения для прогнозирования атмосферного затухания. (A) Значения тестового коэффициента детерминации (R2) для оцениваемых архитектур глубокого обучения, включая многослойный перцептрон (MLP), глубокую нейронную сеть (DNN), долгую краткосрочную память (LSTM), одномерную сверточную нейронную сеть (1D-CNN), гибридную сеть сверточная нейронная сеть — долгая краткосрочная память (CNN–LSTM) и модели на основе механизма внимания. (B) Значения тестовой среднеквадратической ошибки (RMSE) для каждой модели глубокого обучения. (C) Значения тестовой средней абсолютной ошибки (MAE) для каждой модели глубокого обучения. (D) Значения валидационного коэффициента детерминации (R2) для оцениваемых моделей глубокого обучения. Более высокие значения R2 и более низкие значения RMSE и MAE указывают на улучшенную прогностическую способность. RMSE и MAE указаны в dB/km. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
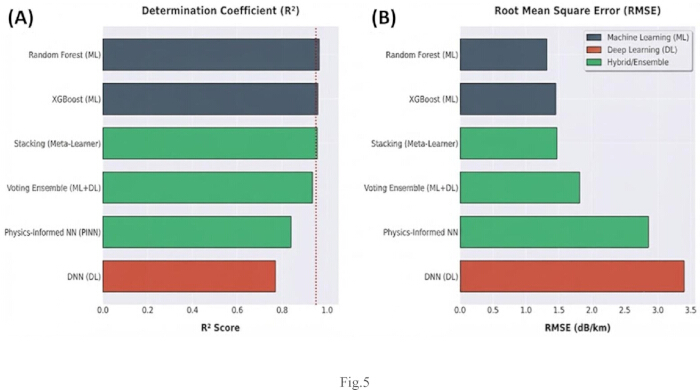
Рисунок 5: Сравнительная эффективность моделей машинного обучения, глубокого обучения и гибридных моделей для прогнозирования атмосферного затухания. (A) Значения коэффициента детерминации (R2) для репрезентативных подходов машинного обучения, глубокого обучения и гибридных методов, включая модели Random Forest, Extreme Gradient Boosting (XGBoost), глубокую нейронную сеть (DNN), Voting Ensemble, Stacking и физически-информированную нейронную сеть. (B) Значения среднеквадратической ошибки (RMSE) для тех же моделей. Модели разделены по цветам на три категории: машинное обучение (ML), глубокое обучение (DL) и гибридные/ансамблевые методы. Повышение прогностической эффективности характеризуется более высокими значениями R2 и более низкими значениями RMSE. RMSE выражена в dB/km. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
| Погодные условия | Пропорция | Диапазон температур | Диапазон влажности | Диапазон видимости | Диапазон основных параметров |
| Чистое небо | 54,27% (814 образцов) | от −4,89 до 47.99°C | 0–100% | >10 км | — |
| Пыль | 25,00% (375 образцов) | 10–45°C | 10–60% | 0,05–5 км | Пыль: 0–4,96 мг/м³3 |
| Туман | 10,47% (157 образцов) | от −5 до 20°C | 70–100% | 0,05–1 км | — |
| Дождь | 7,40% (111 образцов) | 5–30°C | 60–100% | 1–10 км | Осадки: 0,25–50 мм/ч |
| Снег | 2,87% (43 образцов) | от −10 до 5°C | 50–100% | 0,5–5 км | Снег: 0,5–15 мм/ч |
Таблица 1: Показатели эффективности моделей машинного обучения для прогнозирования атмосферного затухания.
| Модель | Тестовый R2 | RMSE (dB/km) | MAE (dB/km) | CV R2 | Время обучения (s) |
| Random Forest | 0.9654 | 1.324 | 0.815 | 0.960 ± 0.007 | 1.6 |
| XGBoost | 0.9582 | 1.455 | 0.892 | 0.953 ± 0.009 | 2.1 |
| LightGBM | 0.9507 | 1.581 | 0.971 | 0.946 ± 0.011 | 1.8 |
| Регрессия на основе метода опорных векторов (SVR) | 0.8874 | 2.389 | 1.445 | 0.879 ± 0.015 | 3.2 |
| Линейная регрессия | 0.8358 | 2.889 | 1.791 | 0.831 ± 0.018 | 0.2 |
| Метод k-ближайших соседей (KNN) | 0.7341 | 3.671 | 2.296 | 0.721 ± 0.022 | 0.8 |
Таблица 2: Сравнительная оценка специфических моделей глубокого обучения, гибридных моделей и моделей машинного обучения.
| Модель | Категория | Тестовый R2 | RMSE (dB/km) | Ранг |
| Random Forest | ML | 0.9654 | 1.324 | 1 |
| XGBoost | ML | 0.9582 | 1.455 | 2 |
| Stacking Ensemble | Гибридная | 0.9571 | 1.473 | 3 |
| LightGBM | ML | 0.9507 | 1.581 | 4 |
| Voting Ensemble | Гибридная | 0.934 | 1.827 | 5 |
| Физически-информированная нейронная сеть | Гибридная | 0.8269 | 2.96 | 6 |
| Attention | DL | 0.7766 | 3.362 | 7 |
| LSTM / CNN–LSTM | DL | −0.0006 | 7.195 | — |
Таблица 3: Сравнение вычислительной эффективности каждой оцениваемой модели (обучение и логический вывод).
ДОСТУПНОСТЬ ДАННЫХ:
Полный синтетический набор данных из 1 500 образцов со всеми входными признаками (температура, влажность, видимость, концентрация пыли, интенсивность дождя, интенсивность снегопада, скорость ветра, атмосферное давление, месяц, сезон и погодные условия) и целевой переменной (затухание в dB/km) предоставляется в качестве дополнительного файла к данной рукописи по адресу https://doi.org/10.5281/zenodo.21792999. Набор данных отформатирован таким образом, что каждый образец занимает одну строку, включая все рассчитанные переменные (рабочий диапазон и SNR).
Полный код реализации, включающий: скрипты генерации данных (реализации физических моделей); функции для предобработки и масштабирования признаков; все реализации моделей машинного обучения; все реализации моделей глубокого обучения; скрипты для оценки и визуализации; а также процедуры настройки гиперпараметров и перекрестной проверки, также будет предоставлен в виде дополнительного файла.
Исходные климатические данные: климатические данные, использованные для определения распределений синтетических данных, были получены от Иракской организации метеорологии и сейсмологии (IMOS) и Министерства транспорта Ирака за период 2020–2024 гг. Сводка климатических данных, использованных для определения долей погодных условий и диапазонов параметров, представлена в Дополнительной таблице 1. Конкретные записи IMOS, использованные в данном исследовании, не архивированы в открытом централизованном репозитории, но могут быть запрошены непосредственно в IMOS. Сводная статистика и производные распределения вероятностей представлены в дополнительных материалах для обеспечения воспроизводимости.
Информация о репозитории: исходный код и набор данных размещены в открытом репозитории (Zenodo) по адресу https://doi.org/10.5281/zenodo.21792999.
Обсуждение
Для прогнозирования затухания сигнала в атмосфере в системах связи FSO, функционирующих в погодных условиях Ирака, в данном исследовании были оценены методы машинного обучения, глубокого обучения и гибридные подходы. Поскольку атмосферные воздействия остаются одной из основных проблем, влияющих на производительность и доступность канала связи, в последних исследованиях подчеркивается растущая значимость прогностического моделирования для систем FSO21. Результаты показали, что классические подходы машинного обучения, в частности RF и XGBoost, обеспечивают высокую точность прогнозирования и в некоторых случаях количественно превосходят методы глубокого обучения и гибридные методы. Однако статистические тесты не выявили значимой разницы (p=0.083) между RF и наилучшим гибридным ансамблем (Stacking), что означает, что оба подхода могут достигать схожих результатов на данном наборе данных. Наши результаты указывают на то, что ансамблевые методы на основе деревьев решений по-прежнему высокоэффективны для табличных экологических данных с умеренным объемом выборки и небольшим количеством доминирующих предикторов. Анализ важности признаков показал, что концентрация пыли и видимость являются основными факторами затухания, которые в совокупности объясняют большую часть прогностической способности. Этот вывод согласуется с более ранними исследованиями, демонстрирующими значительное влияние тумана, пыли, аэрозолей и загрязнения атмосферы на распространение оптического сигнала22,23,24,25. Аналогичные результаты были отмечены в приложениях для экологического мониторинга, где модели машинного обучения часто выигрывают от использования наборов данных, содержащих небольшое количество высокоинформативных переменных26,27,28,29,30,31,32. Анализ SHAP дополнительно повысил интерпретируемость модели путем количественной оценки влияния отдельных параметров окружающей среды на прогнозы затухания.
Более низкая эффективность моделей глубокого обучения может быть обусловлена несколькими факторами. Размер набора данных был относительно невелик для обучения сложных нейросетевых архитектур (в https://doi.org/10.5281/zenodo.21792999), а переменные окружающей среды демонстрировали высокую концентрацию значимости признаков. Предыдущие исследования показали, что методы глубокого обучения, как правило, выигрывают от больших наборов данных, иерархических структур признаков и сложных нелинейных представлений33,34,35,36,37. Напротив, набор данных по затуханию, использованный в данном исследовании, содержал ограниченное число доминирующих предикторов и не обладал временными зависимостями, необходимыми для рекуррентных архитектур. Низкая эффективность моделей LSTM и CNN–LSTM указывает на то, что механизмы последовательного обучения могут не приносить существенных преимуществ в данной области применения.
Доминирующее влияние концентрации пыли (67,3%) и видимости (21,2%) как предикторов атмосферного затухания может быть обусловлено несколькими факторами. Во-первых, молекулярное рассеяние и поглощение на длине волны 1550 nm нивелируются рассеянием Ми на частицах пыли. Согласно теории Ми, эффективность экстинкции Q_ext крайне чувствительна к концентрации частиц, и в режиме умеренной или высокой концентрации затухание масштабируется почти линейно с концентрацией пыли. Во-вторых, Ирак подвержен частым пыльным бурям (25,00% дней согласно нашим климатическим записям), которые приводят к значениям затухания 4–30 dB/km. Это контрастирует с туманом (10,47%, 0,5–10 dB/km) и дождем (7,40%, 2–25 dB/km). Большая вариативность затухания при пыльных бурях обеспечивает более сильные сигналы для обучения моделей. В-третьих, экспоненциальное распределение концентрации пыли (0,4–4,96 mg/m3) создает широкий диапазон значений затухания. «Длинный хвост» при экстремальных запылениях дает высокие значения затухания, которые важны для точного прогнозирования. В-четвертых, модель рассеяния Ми имеет более простую (приблизительно линейную) зависимость от концентрации пыли, которую моделям на основе деревьев решений легче аппроксимировать по сравнению с более сложной взаимосвязью между видимостью и затуханием в тумане в модели Кима. В-пятых, данный результат имеет практическое значение, поскольку пыльные бури являются одним из самых сложных условий окружающей среды для FSO на Ближнем Востоке. Точное прогнозирование во время пыльных явлений необходимо для надежной работы системы.
Полученные результаты способствуют развитию исследований в области связи FSO, предоставляя практические рекомендации по выбору алгоритмов для прогнозирования атмосферного затухания. Точное прогнозирование затухания имеет важное значение для планирования сетей, адаптивного управления каналами связи и надежного развертывания систем оптической связи в сложных условиях, таких как Ближний Восток23,28,30,36. Кроме того, данная методология может быть применима к другим задачам экологического прогнозирования, связанным с распространением волн в воздухе, атмосферным мониторингом и оценкой производительности оптических сетей38,39,40. К другим методам изучения данной концепции относятся использование более обширных реальных наборов данных, сложных методов ансамблевого обучения, структур переносного обучения или более комплексных архитектур, основанных на физических закономерностях41,42,43,44,45.
Область применения выводов и вопросы обобщаемости
Выводы данной работы в основном основаны на синтетическом наборе данных, созданном с помощью общепринятых физических моделей распространения (закон Бугера — Ламберта — Бера, модель Кима, модель Карбоно и теория рассеяния Ми). Такой методологический подход накладывает определенные ограничения на область применения и обобщаемость наших результатов:
Выводы на основе симулированных данных: (1) Сравнительный рейтинг эффективности машинного обучения, глубокого обучения и гибридных подходов для прогнозирования атмосферного затухания. (2) Определение концентрации пыли и видимости в качестве доминирующих факторов окружающей среды, прогнозирующих оптическое затухание в моделируемых условиях. (3) Преимущество ансамблевых методов на основе деревьев решений в вычислительной эффективности по сравнению с архитектурами глубокого обучения. (4) Интерпретируемость значимости признаков и анализ SHAP для объяснения прогнозов моделей.
Выводы, требующие подтверждения в реальных условиях: (1) Абсолютные значения R2 и RMSE, полученные с помощью оцениваемых моделей, зависят от конкретных характеристик синтетического набора данных и могут отражать тот факт, что модели усвоили детерминированные физические уравнения, использованные для генерации целевых показателей. (2) Еще предстоит доказать, что лучшая модель, Random Forest, может быть применена к неизвестным атмосферным условиям в реальном мире. (3) Для применимости полученных результатов к эксплуатируемым установкам FSO, установленным в Ираке, необходима полевая валидация. (4) Необходимо подтвердить, что определенные рейтинги значимости признаков остаются устойчивыми в условиях полевых измерений.
Важно различать результаты работы на синтетических данных, полученных на основе уравнений, и результаты на зашумленных обсервационных или экспериментальных данных. Синтетический набор данных обеспечивает чистую, свободную от шума взаимосвязь между входными признаками и целевым показателем затухания, что может привести к более высоким показателям прогностической эффективности, чем те, которые могут быть достигнуты на реальных данных с шумом измерений, погрешностями приборов и неучтенными физическими явлениями. Мы рекомендуем направить будущие исследования на получение реальных измерений затухания в системе FSO в погодных условиях Ирака, чтобы подтвердить результаты, представленные в данном исследовании, и оценить истинную обобщающую способность предлагаемых методик.
Значение синтетических данных для обобщающей способности модели
При оценке обобщающей способности моделей в данном исследовании следует тщательно учитывать последствия использования синтетических данных:
Преимущества синтетического подхода. Набор данных физически согласован и основан на общепринятых теоретических концепциях благодаря использованию установленных моделей физического распространения. Метеорологические параметры были извлечены из метеорологических сводок Ирака, чтобы набор данных отражал статистические свойства реальных погодных условий в этой стране. Помимо исключения вмешивающихся переменных, характерных для полевых измерений (таких как погрешности измерений, калибровка оборудования или недостаточность записей данных), такие контролируемые условия позволяют проводить систематический анализ методик моделирования.
Ограничения обобщаемости. Синтетический набор данных имеет ограничения в отражении всей сложности реального атмосферного затухания, включая: (1) взаимодействие нескольких атмосферных явлений, происходящих одновременно; (2) нелинейный и нестационарный характер атмосферных параметров; (3) долгосрочную изменчивость климата, не охваченную выборочными распределениями; (4) локальные микроклиматические эффекты, которые могут существенно влиять на распространение FSO; и (5) шум и неопределенность, присущие сбору данных в реальных условиях.
Вопросы смещения при генерации синтетических данных. Предположение о независимой выборке параметров окружающей среды (см. раздел «Методы») является упрощением реальных условий, в которых атмосферные переменные, как правило, коррелируют между собой (например, высокая концентрация пыли обычно коррелирует с низкой видимостью). Предположение о независимости было сделано для создания контролируемой среды моделирования с целью систематического сравнения моделей. Однако данный метод может не в полной мере отражать всю сложность взаимодействий атмосферных параметров. Мы используем метод стратифицированного разделения (сохраняя соотношение погодных условий в обучающей и тестовой выборках), чтобы минимизировать вероятность несбалансированного представления редких условий в тестовой выборке (в частности, снегопада, доля которого составляет 2.87%).
Детерминированная генерация целевых значений: высокая прогностическая способность, наблюдаемая в данном исследовании, может быть частично объяснена тем, что модели усваивают детерминированные физические уравнения, использованные для генерации целевых значений. Напротив, реальные экспериментальные данные содержат шумы измерений, инструментальные погрешности и немоделируемые физические явления, которые усложняют прогнозирование. Следовательно, количественные показатели эффективности (R2, RMSE, MAE) следует интерпретировать как относительное сравнение методологий в контролируемой среде моделирования, а не как абсолютные гарантии производительности для работающих систем FSO.
Таким образом, хотя сравнительные результаты рейтинга эффективности моделей, вероятно, являются устойчивыми (благодаря физической согласованности синтетических данных), абсолютные показатели эффективности (R2, RMSE, MAE) не следует рассматривать как индикаторы ожидаемой производительности в реальных системах FSO. Необходимо проверить обобщающую способность модели в реальных условиях, используя экспериментальные измерения затухания в воздухе, полученные при различных погодных условиях в Ираке.
Необходимо учитывать ряд ограничений. Во-первых, вместо полевых наблюдений в исследовании использовался синтетический набор данных, созданный с помощью общеизвестных физических моделей распространения. Как было сказано ранее, количественные показатели эффективности (R2, RMSE, MAE) следует рассматривать как относительное сравнение подходов в контролируемой среде моделирования, а не как абсолютные гарантии производительности для эксплуатируемых систем FSO. Во-вторых, стандартные модели и модели глубокого обучения, возможно, не смогли сформировать устойчивые представления признаков из-за объема набора данных. В-третьих, другие показатели эффективности FSO, такие как доступность соединения, ошибки наведения и замирания, вызванные турбулентностью, не принимались во внимание в пользу прогнозирования затухания. В-четвертых, для расчета пропорций погодных условий использовались исторические записи с 2020 по 2024 год, которые могут неточно отражать ежегодные колебания климатических условий в Ираке. В-пятых, псевдопоследовательная структура входных данных моделей CNN–LSTM и LSTM является методологическим упрощением, которое может неадекватно отражать временную динамику в реальных приложениях. При оценке результатов следует учитывать эти ограничения, так как они могут повлиять на обобщаемость полученных выводов.
Рекомендуемый приоритет: верификация в реальных условиях. Сбор и анализ фактических измерений затухания FSO в погодных условиях Ирака является наиболее важным направлением будущей работы. Это должно включать: (1) установку испытательных стендов FSO в различных частях Ирака (например, в Багдаде, Басре, Мосуле, Рамади) для регистрации региональных климатических вариаций; (2) использование калиброванных приборов в точках размещения FSO для одновременного измерения атмосферных параметров (температуры, влажности, видимости, концентрации пыли); (4) документирование затухания во время экстремальных погодных явлений (пыльных бурь, сильного тумана, проливного дождя); (5) обеспечение публичного доступа к собранным данным для обеспечения воспроизводимости и проведения сравнительных исследований; и (3) продолжение мониторинга в течение как минимум одного полного годового цикла для фиксации сезонных колебаний. Такая практическая валидация позволит оценить обобщаемость модели и усовершенствовать методы прогнозирования, разработанные в данном исследовании.
Для валидации и совершенствования созданных моделей будущие исследования должны быть сосредоточены на включении реальных измерений FSO, полученных в погодных условиях Ирака. Дополнительные исследования могут быть направлены на изучение стратегий трансферного обучения с использованием соответствующих атмосферных наборов данных, программ онлайн-обучения, адаптирующихся к меняющимся условиям окружающей среды, а также гибридных экспериментально-симуляционных подходов, сочетающих измеренные данные с физическими моделями. Дальнейшие исследования в области объяснимого ИИ и сложных методов обучения на основе физических принципов также могут пролить больше света на механизмы, лежащие в основе затухания сигнала в воздухе, и повысить устойчивость будущих систем прогнозирования.
Раскрытие информации
Конфликт интересов: Авторы заявляют об отсутствии конфликта интересов.
Благодарности
Авторы заявляют, что для данного исследования не привлекалось внешнее финансирование. Мы выражаем благодарность Международному центру прикладных и теоретических исследований (IATRC), Багдад, Ирак.
Материалы
| Имя | Компания | Каталожный номер | Комментарии |
|---|---|---|---|
| CUDA Toolkit | NVIDIA Corporation | 11.8 | Библиотека GPU-ускорения для обучения глубокого обучения |
| cuDNN | NVIDIA Corporation | 8.6.0 | Библиотека глубоких нейронных сетей с GPU-ускорением |
| GPU (графический процессор) | NVIDIA Corporation | GeForce RTX 4090, 24 GB VRAM | Используется для обучения глубокого обучения с GPU-ускорением |
| CPU (центральный процессор) | Intel Corporation | Core i9-13900K, 24 cores/32 threads | Процессор рабочей станции для всего обучения и оценки моделей |
| Системная память (RAM) | n/a | 64 GB DDR5, 5200 MHz | Память рабочей станции |
| Keras API | Open source (часть TensorFlow) | в комплекте с TensorFlow 2.11.0 | API глубокого обучения высокого уровня, используемый для всех DL-архитектур |
| LightGBM | Open source (Microsoft) | 3.3.5 | Фреймворк градиентного бустинга |
| NumPy | Open source (NumFOCUS) | 1.23.5 | Библиотека для численных вычислений |
| Операционная система | Canonical Ltd. | Ubuntu 22.04 LTS | Операционная система рабочей станции |
| Python | Python Software Foundation | 3.9 | Язык программирования, используемый для всей генерации данных и моделирования |
| scikit-learn | Open source | 1.2.2 | Библиотека машинного обучения (RF, SVR, KNN, линейная регрессия, кросс-валидация, масштабирование) |
| SHAP (SHapley Additive exPlanations) | Open source | 0.41.0 | Библиотека интерпретируемости моделей, модуль TreeExplainer |
| TensorFlow | Open source (Google) | 2.11.0 | Фреймворк глубокого обучения, используемый для всех шести DL-архитектур |
| XGBoost | Open source | 1.7.5 | Библиотека экстремального градиентного бустинга |
Ссылки
- Kadhim MS, Hussein H, Elwi TA. Hybrid ANN-Z method for modeling carbon nanotube-based reconfigurable intelligent surfaces for terahertz beam steering. J Vis Exp. 2026;in press.
- Raham JK, Alshaibi M, Elwi TA. SMS optical fiber laser sensor for transformer oil temperature monitoring-based IoT of AI control. Prog Electromagn Res B. 2026;118:72–86.
- Abdulkareem ZJ, Hamad TK, Elwi TA. Reconfigurable metasurface based on graphene optical antennas for dynamic beam steering. Sustain Eng Innov. 2025;7:127–136.
- Abdulsattar RK, et al. Optical-microwave sensor for real-time measurement of water contamination in oil derivatives. AEU Int J Electron Commun. 2023;170:154798. doi:10.1016/j.aeue.2023.154798.
- Al-Khaylani HH, Elwi TA, Ibrahim AA. Optically remote control of miniaturized 3D reconfigurable CRLH printed self-powered MIMO antenna array for 5G applications. Micromachines. 2022;13(12):2061. doi:10.3390/mi13122061.
- Al-Khaylani HH, Elwi TA, Ibrahim AA. Optically remote-controlled miniaturized 3D reconfigurable CRLH-printed MIMO antenna array for 5G applications. Microw Opt Technol Lett. 2023;65(2):603–610.
- Jassim DA, Elwi TA. Optical nano monopoles for interconnection of electronic chip applications. Optik. 2022;249:168142. doi:10.1016/j.ijleo.2021.168142.
- Elwi TA. A novel approach for modeling the geometry and constitutive parameters of an armchair single-wall carbon nanotube antenna operating in the NIR regime. Al-Ma’mon Coll J. 2014;(24):261–285.
- Mohammed, AB.F.A., Al-hadeethi, S.T., Al-khaylani, H.H. et al. An investigation of success probability and fidelity of quantum repeater in asymmetry in midpoint placement in fiber-based quantum networks. J Opt (2025). https://doi.org/10.1007/s12596-025-02866-6.
- Kim II, McArthur B, Korevaar EJ. Comparison of laser beam propagation at 785 nm and 1550 nm in fog and haze for optical wireless communications [conference paper]. Presented at: Optical Wireless Communications III; Boston, MA, USA; 2000. Proc SPIE. 2001;4214:26–37. https://doi.org/10.1117/12.417512.
- Okbi ZA, Alak IK, Abdulla EN, Al-Khaylani HH. Design and security analysis of an image encryption based on a gigabit passive optical network employing fiber-FSO protection at the last mile. J Opt Commun. 2025. doi:10.1515/joc-2025-0466.
- Ojo JS, Olaitan JA, Ojo OL. Characterization of fog-induced attenuation for optimizing optical propagation links in Nigeria. Results Opt. 2022;9:100279. doi:10.1016/j.rio.2022.100279.
- Khidher SA. Dust storms in Iraq: Past and present. Theor Appl Climatol. 2024;155:4721–4735.
- Ali, Alaa Hussein, Abdulla, Essam N. and Al-Azawi, Razi J.. "Security and network performance analysis of coexistence TWDM – NG-PON2, GPON and 10G-EPON systems based on Hill Cipher" Journal of Optical Communications, 2025. https://doi.org/10.1515/joc-2025-0435.
- Lionis A, et al. Using machine learning algorithms for accurate received optical power prediction of an FSO link over a maritime environment. Photonics. 2021;8(6):212. doi:10.3390/photonics8060212.
- Chen T, Guestrin C. XGBoost: A scalable tree boosting system [conference paper]. Presented at: 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining; San Francisco, CA, USA; 2016. p. 785–794. https://doi.org/10.1145/2939672.2939785.
- Bai Y, et al. Air pollutants concentrations forecasting using back propagation neural network based on wavelet decomposition with meteorological conditions. Atmos Pollut Res. 2016;7(3):557–566.
- LeCun Y, Bengio Y, Hinton G. Deep learning. Nature. 2015;521:436–444.
- Mousa, Ekhlass, Abdulla, Essam N. and Adnan, Salah A.. "Enhancing network security based on 10G-EPON with the use of the Hill cipher algorithm" Journal of Optical Communications, 2025. https://doi.org/10.1515/joc-2025-0201.
- Lu G, et al. A survey of deep learning for time series forecasting: Theories, datasets, and state-of-the-art techniques. Comput Mater Contin. 2025;85(2):2403–2441.
- Liu J, Yang X, Wei Y, Zhao F. Integrated THz/FSO communications: A review of practical constraints, applications and challenges. Micromachines. 2025;16(11):1297. doi:10.3390/mi16111297.
- Bott A, Sievers U, Zdunkowski W. A radiation fog model with a detailed treatment of the interaction between radiative transfer and fog microphysics. J Atmos Sci. 1990;47:2153–2166.
- Fadhil HA, et al. Optimization of free space optics parameters: An optimum solution for bad weather conditions. Optik. 2013;124(19):3969–3973.
- Osipov S, et al. Severe atmospheric pollution in the Middle East is attributable to anthropogenic sources. Commun Earth Environ. 2022;3:203. doi:10.1038/s43247-022-00514-6.
- Castellanos P, et al. Mineral dust optical properties for remote sensing and global modeling: A review. Remote Sens Environ. 2024;303:113982. doi:10.1016/j.rse.2023.113982.
- Lolli S. Urban PM2.5 concentration monitoring: A review of recent advances in ground-based, satellite, model, and machine learning integration. Urban Clim. 2025;63:102566. doi:10.1016/j.uclim.2025.102566.
- Ridha, Fay F., Abdulla, Essam N. and Abdulhadi, Ali H.. "Machine learning based on raw ensemble predictions scheme for TWDM-PON" Journal of Optical Communications, 2025. https://doi.org/10.1515/joc-2025-0373.
- Khalid H, Sajid SM, Cheema MI, Leitgeb E. Optical signal attenuation through smog in controlled laboratory conditions. Photonics. 2024;11(2):172. doi:10.3390/photonics11020172.
- Ejike O, Ndị D, Shakir MZ. Comparative study of machine learning-based rainfall prediction in tropical and temperate climates. Climate. 2025;13(8):167. doi:10.3390/cli13080167.
- Esmail MA, Fathallah H, Alouini MS. An experimental study of FSO link performance in desert environment. IEEE Commun Lett. 2016;20(9):1888–1891.
- Kshirsagar MP, Khare KC. Support vector regression models of stormwater quality for a mixed urban land use. Hydrology. 2023;10(3):66. doi:10.3390/hydrology10030066.
- Mosso S, Lapo K, Stiperski I. Revealing the drivers of turbulence anisotropy over flat and complex terrain: An interpretable machine learning approach. Boundary Layer Meteorol. 2025;191:51. doi:10.1007/s10546-025-00946-5.
- Mohsen S, Ali AM, Emam A. Automatic modulation recognition using CNN deep learning models. Multimed Tools Appl. 2024;83:7035–7056.
- Mienye ID, Swart TG, Obaido G. Recurrent neural networks: A comprehensive review of architectures, variants, and applications. Information. 2024;15(9):517. doi:10.3390/info15090517.
- Castelli M, et al. Generative adversarial networks for generating synthetic features for Wi-Fi signal quality. PLoS One. 2021;16(11). doi:10.1371/journal.pone.0260308.
- Al-Imran, Chowdhury MZ, Mofidul RB, Jang YM. Machine learning and deep learning in FSO communication: A comprehensive survey. ICT Express. 2025;11(6):1026–1046.
- Grose MG, Watson EA. Forecasting atmospheric turbulence conditions from prior environmental parameters using artificial neural networks. Appl Opt. 2023;62:3370–3379.
- Radhi SS, et al. Design a secure TWDM-PON via the Hill cipher algorithm. Opt Contin. 2025;4:1051–1064.
- Mushatet, Adil Fadhil, Fadil, Elaf A. and Abdulla, Essam N.. "High bit rate secure FSO system utilizing Hill coding" Journal of Optical Communications, 2025. https://doi.org/10.1515/joc-2025-0147.
- Musadaq R, Abdulwahid SN, Abd Alwahed NN, Abdulla EN. Security analysis of an image encryption algorithm based on Blowfish in GPON. J Opt Commun. 2025. doi:10.1515/joc-2025-0109.
- Raissi M, Yazdani A, Karniadakis GE. Hidden fluid mechanics: Learning velocity and pressure fields from flow visualizations. Science. 2020;367(6481):1026–1030.
- Vasiliauskaite V, Antulov-Fantulin N. Generalization of neural network models for complex network dynamics. Commun Phys. 2024;7:348. doi:10.1038/s42005-024-01837-w.
- Oh S, Hong SK. Physics-informed neural modeling of 2D transient electromagnetic fields. Appl Sci. 2025;15(23):12612. doi:10.3390/app152312612.
- Pradhan S, Bhattarai JS, Murugavel M, Sharma OP. Machine learning approaches to surpass the limitations of the Beer–Lambert law. ACS Omega. 2025;10(16):16597–16601.
- Pavlyshenko B. Using stacking approaches for machine learning models [conference paper]. Presented at: 2018 IEEE Second International Conference on Data Stream Mining and Processing (DSMP); Lviv, Ukraine; 2018. p. 255–258. https://doi.org/10.1109/DSMP.2018.8478522.