В данном протоколе предлагается FedMediFormer-XAI — мультимодальная система анализа данных при диабете, обеспечивающая конфиденциальность за счет федеративного обучения, мультимодальных трансформеров, аугментации на основе диффузионных моделей, графовых методов персонализированного подбора лекарственных средств и объяснимого искусственного интеллекта для точного прогнозирования, прозрачного принятия решений и персонализированного управления диабетом.
Методическая статья
FedMediFormer-XAI: Федеративные мультимодальные трансформеры с диффузионным усилением и графовой системой рекомендаций препаратов для лечения диабета
В этой статье
Краткое содержание
Аннотация
Управление диабетом сталкивается с рядом препятствий, таких как фрагментированность данных здравоохранения, вопросы конфиденциальности, недостаточная объяснимость и отсутствие персонализированных терапевтических рекомендаций. В данной исследовательской работе представлена FedMediFormer-XAI — унифицированная и комплексная платформа, объединяющая федеративное обучение, мультимодальные трансформеры, аугментацию данных на основе диффузионных моделей, графовые нейронные сети (GNN) для рекомендаций лекарственных средств и объяснимый искусственный интеллект (XAI) для анализа данных о диабете. Система использует различные типы данных здравоохранения, например, клинические записи, показатели здоровья населения, данные непрерывного мониторинга глюкозы, изображения глазного дна, измерения с носимых датчиков и фармакологическую информацию. Для генерации синтетических образцов и устранения дисбаланса классов используются диффузионные модели, а архитектуры мультимодальных трансформеров применяются для изучения взаимосвязей между крайне разнородными источниками данных. Федеративное обучение позволяет осуществлять совместное обучение моделей с соблюдением конфиденциальности без обмена исходными данными пациентов. Компонент GNN фиксирует взаимодействия «пациент-препарат» и «препарат-препарат» для персонализированного подбора лекарственных средств. Методы объяснимости, такие как аддитивные объяснения Шепли (SHAP), визуализация внимания, интегрированные градиенты и контрфактуальный анализ, обеспечивают прозрачную интерпретацию результатов прогнозирования и рекомендаций. В репрезентативной реализации предлагаемая платформа достигла точности (accuracy) 94.2%, прецизионности (precision) 93.1%, полноты (recall) 92.8%, F1-меры 92.9%, коэффициента корреляции Мэтьюза (MCC) 0.88 и площади под ROC-кривой (AUC-ROC) 0.96. Модуль рекомендаций на основе графов достиг значений precision = 0.89, recall = 0.84 и нормализованного дисконтированного кумулятивного усиления (NDCG) = 0.91. Данный протокол предлагает структурированный подход к интеграции гетерогенных данных здравоохранения с использованием мультимодальных трансформеров, федеративного обучения, диффузионной аугментации, графовых рекомендаций и объяснимого искусственного интеллекта. Представленные результаты вычислений демонстрируют потенциал платформы для прогнозирования диабета и персонализированного подбора медикаментов, в то время как федеративная архитектура обеспечивает децентрализованную обработку данных. Для подтверждения клинической полезности, обобщающей способности и применимости в реальных условиях требуется проведение проспективного многоцентрового клинического исследования.
Введение
Сахарный диабет входит в число основных хронических метаболических заболеваний, поражающих человечество, и представляет собой серьезную проблему общественного здравоохранения в связи с его постоянным распространением, долгосрочными последствиями и огромными затратами на лечение пациентов1,2. Согласно отчету, в настоящее время во всем мире более 537 миллионов взрослых людей живут с диабетом, и ожидается, что в ближайшие несколько десятилетий это число значительно возрастет3. При отсутствии контроля над высоким уровнем сахара в крови у человека могут развиться тяжелые осложнения, такие как ишемическая болезнь сердца4, поражение почек5, повреждение нервов6, потеря зрения7 и инсульт8. Таким образом, выявление заболевания на самом раннем этапе, регулярный мониторинг состояния пациента и его обучение с использованием передовых медицинских подходов являются необходимыми шагами, которые помогут пациентам вести более здоровую жизнь и, тем самым, снизят расходы государственной системы здравоохранения9,10.
В настоящее время стремительно распространяется использование электронных медицинских карт (ЭМК), носимых устройств, систем непрерывного мониторинга глюкозы (НМГ), технологий визуализации сетчатки и мобильных приложений для здравоохранения, что приводит к созданию больших объемов гетерогенных медицинских данных, доступных для анализа11. Эти разнообразные инструменты сбора данных позволяют получить обширную информацию о человеческом организме, его функциональных возможностях на разных стадиях заболевания, реакции пациента на различные виды лечения, а также об особенностях его поведения в реальной жизни12. Искусственный интеллект (ИИ) зарекомендовал себя как оптимальное решение для обработки высокосложных данных, прогнозирования диабета, мониторинга заболевания и оказания помощи врачам при принятии клинических решений13. Кроме того, алгоритмы машинного обучения, включая случайные леса, метод опорных векторов и методы градиентного бустинга, показали отличные результаты в оценке риска развития диабета14. В последнее время архитектуры глубокого обучения обеспечили автоматическое извлечение признаков и повысили прогностическую эффективность в различных областях здравоохранения15.
Благодаря методам мультимодального обучения возможности анализа данных о диабете были значительно расширены за счет объединения структурированных клинических записей, физиологических показателей, изображений сетчатки и поведенческих индикаторов в единую прогностическую систему16. Используя несколько источников информации, мультимодальные модели позволяют выявлять закономерности, которые не видны при раздельном изучении каждой модальности17. Модели на основе трансформеров в последнее время эффективно выявляют долгосрочные зависимости и контекстуальные связи в различных типах данных здравоохранения18. Однако такие проблемы, как несбалансированность классов, пропуски в данных, гетерогенность данных и ограниченная обобщающая способность, все еще препятствуют широкому внедрению мультимодальных систем ИИ в клиническую практику19.
Несмотря на эти достижения, многие существующие системы интеллектуального анализа диабета по-прежнему опираются на централизованные структуры обучения, которые по определению требуют консолидации данных пациентов из разных учреждений в едином репозитории20. Подобные методы уже приводят к спорам о конфиденциальности данных пациентов, праве владения данными, кибербезопасности и соблюдении нормативных требований21. Фактически, из-за правовых и этических соображений поставщики медицинских услуг часто ограничены в возможности обмена конфиденциальными данными пациентов22. В этом контексте федеративное обучение становится жизнеспособным решением, так как оно позволяет обучать совместную модель без передачи фактических данных пациентов23. Благодаря децентрализованной оптимизации и безопасному агрегированию параметров федеративное обучение обеспечивает анализ состояния здоровья с защитой конфиденциальности, используя знания из географически распределенных наборов данных24. Тем не менее, издержки связи, неоднородность клиентов и стабильность сходимости по-прежнему представляют собой серьезные проблемы в сценариях применения федеративного обучения в здравоохранении25.
Еще одним недостатком используемых в настоящее время интеллектуальных систем для диагностики и лечения диабета является отсутствие прозрачности и поддержки персонализированной терапии. Многие модели глубокого обучения работают по принципу «черного ящика», что представляет проблему для клиницистов, стремящихся понять логику, лежащую в основе прогнозов и рекомендаций26. Методы объяснимого искусственного интеллекта (XAI), такие как SHAP, Integrated Gradients, визуализация внимания (attention visualization) и контрфактуальные рассуждения, демонстрируют большой потенциал для повышения прозрачности моделей и доверия со стороны врачей27. Кроме того, графовые нейронные сети (GNNs) стали наиболее продвинутыми инструментами для анализа взаимодействий «пациент — препарат» и «препарат — препарат», что позволяет формировать персонализированные рекомендации по лекарственной терапии и оценивать безопасность медикаментов28. Новые диффузионные модели также предложили решения для генерации достоверных синтетических данных в сфере здравоохранения и устранения дисбаланса классов29.
Трансформеры, федеративное обучение, генерация синтетических данных на основе диффузионных моделей, графовые нейронные сети и объяснимый искусственный интеллект продемонстрировали многообещающие результаты в приложениях для здравоохранения; однако их интеграция в рамках единой воспроизводимой системы анализа данных при диабете остается ограниченной. Существующие подходы обычно рассматривают эти компоненты независимо, фокусируясь либо на обучении с сохранением конфиденциальности без персонализированных рекомендаций по лечению, либо на мультимодальном прогнозировании без децентрализованного обучения, либо на объяснимости без поддержки принятия клинических решений на основе графов. Хотя диффузионные модели могут способствовать балансировке классов, а архитектуры трансформеров — изучению взаимосвязей между гетерогенными модальностями данных здравоохранения, стандартизированные протоколы интеграции этих дополняющих друг друга технологий по-прежнему ограничены. Таким образом, в данной работе представлен унифицированный методологический протокол, который объединяет мультимодальное прогнозирование, аугментацию на основе диффузионных моделей, федеративную оптимизацию, персонализированный подбор лекарственных препаратов на основе графов и объяснимый искусственный интеллект в рамках воспроизводимого рабочего процесса, обеспечивая при этом основу для будущей клинической валидации и внедрения.
В отличие от исследований, в которых предполагается наличие мультимодальных наборов данных на уровне отдельных пациентов, данный протокол объединяет гетерогенные общедоступные наборы данных без проведения прямого сопоставления пациентов. Для каждого источника данных обучаются независимые модели, специфичные для конкретной модальности, а скрытые вложения признаков объединяются с помощью механизма кросс-модального внимания. Такая архитектура обеспечивает методологическую строгость, позволяя интегрировать мультимодальные знания из различных репозиториев данных здравоохранения.
Предлагаемый протокол предназначен прежде всего для методологической разработки и распределенных систем ИИ в здравоохранении, в которых гетерогенные источники данных доступны в разных репозиториях или учреждениях, а прямая централизация данных ограничена. В текущей реализации наборы данных для разных модальностей независимы и не сопоставлены по пациентам; следовательно, мультимодальная интеграция выполняется на уровне выученных представлений, а не посредством прямого соответствия на уровне пациентов. Практическое применение потребует наличия надлежащим образом связанных мультимодальных данных пациентов, согласованной предварительной обработки и определений результатов во всех участвующих центрах, подходящей вычислительной инфраструктуры, а также соблюдения применимых этических, нормативных требований и правил конфиденциальности.
В данной работе представлен FedMediFormer-XAI — федеративный мультимодальный трансформерный фреймворк, который обеспечивает конфиденциальный анализ данных при диабете за счет объединения функций прогнозирования, рекомендаций и интерпретируемости в рамках одной системы. Данный фреймворк интегрирует аугментацию данных на основе диффузионных моделей для решения проблемы дисбаланса классов, мультимодальное трансформерное обучение для прогнозирования диабета, федеративное обучение для совместной разработки моделей, персонализированный подбор лекарственных средств на основе графовых нейронных сетей, а также методы объяснимого искусственного интеллекта для обеспечения прозрачности поддержки принятия клинических решений. Общая архитектура и рабочий процесс предлагаемого фреймворка FedMediFormer-XAI проиллюстрированы на Рисунке 1.
Основные вклады предложенного фреймворка FedMediFormer-XAI резюмированы следующим образом: (1) Представлен унифицированный протокол, объединяющий федеративное обучение, мультимодальные трансформеры, аугментацию данных на основе диффузионных моделей, персонализированный подбор лекарственных средств на базе графовых нейронных сетей и объяснимый искусственный интеллект в рамках единого воспроизводимого рабочего процесса для интеллектуального анализа диабета. (2) Разработана стратегия федеративного обучения с сохранением конфиденциальности, позволяющая осуществлять совместное обучение моделей между симулированными распределенными медицинскими клиентами без обмена исходными данными пациентов. (3) Внедрена архитектура мультимодального трансформера для совместного извлечения взаимодополняющих представлений из структурированных клинических записей, данных непрерывного мониторинга глюкозы, изображений глазного дна и показателей здоровья населения. (4) Интегрирована генерация синтетических данных на основе диффузионных моделей для уменьшения дисбаланса классов и повышения устойчивости модели при сохранении статистических характеристик исходных обучающих данных. (5) Использован модуль обучения на гетерогенных графах на базе GraphSAGE для моделирования связей «пациент-препарат» и «препарат-препарат» с целью персонализированного подбора лекарств и ранжирования методов лечения с учетом лекарственных взаимодействий. (6) Интегрированы несколько методов объяснимого искусственного интеллекта, включая SHapley Additive exPlanations (SHAP), интегрированные градиенты (Integrated Gradients), визуализацию внимания и контрфактуальные объяснения, для повышения прозрачности модели и обеспечения интерпретируемости результатов прогнозирования и рекомендаций. (7) Представлен комплексный протокол валидации, включающий прогностическую оценку, анализ эффективности федеративного обучения, оценку качества рекомендаций, анализ объяснимости, оценку с участием клиницистов, внешнюю валидацию и анализ воспроизводимости.
Протокол
Все наборы данных, использованные в данном исследовании, были получены из общедоступных репозиториев и содержали обезличенную информацию о пациентах. К ним относились Pima Indians Diabetes Dataset, CDC Diabetes Health Indicators Dataset, OhioT1DM Dataset, APTOS 2019 Blindness Detection Dataset, Drug Review Dataset и Drug-Drug Interaction Dataset. Прямой набор пациентов, вмешательства, сбор образцов или доступ к идентифицируемой личной медицинской информации не осуществлялись. Исследование было ограничено вторичным анализом общедоступных анонимизированных наборов данных для разработки и валидации методологии и проводилось в соответствии с институциональными требованиями к использованию таких данных. Оценка с участием людей, описанная в данном протоколе, предназначена для последующей реализации и не проводилась в настоящем исследовании. Исследователям, проводящим такую оценку, следует получить соответствующее одобрение Институционального комитета по этике, получить письменное информированное согласие от всех участников и соблюдать применимые институциональные требования, соглашения об использовании данных и государственные нормы.
1. Настройка вычислительной среды
- Установите Python 3.11 в качестве основной среды программирования. Установите PyTorch 2.3 и TensorFlow 2.15 для разработки и обучения моделей глубокого обучения. Установите библиотеку Transformers (v4.45) для реализации архитектур на базе трансформеров.
- Установите PyTorch Geometric (v2.5) для построения и обучения графовых нейронных сетей. Установите SHAP (v0.47) и Captum (v0.8) для проведения анализа интерпретируемости и атрибуции признаков.
- Установите NumPy, Pandas и Scikit-learn для численных вычислений, предобработки данных и использования инструментов машинного обучения. Установите OpenCV и Matplotlib для обработки изображений и визуализации. Установите NetworkX для построения и анализа графов лекарственных взаимодействий.
- Установите CUDA Toolkit и совместимые драйверы NVIDIA GPU для обеспечения аппаратного ускорения вычислений. Настройте GPU NVIDIA RTX 4090 с объемом системной памяти не менее 32 GB. Установите случайный seed на значение 42 для этапов обучения, валидации и тестирования для обеспечения воспроизводимости результатов. Проверьте установку и совместимость используемых программных библиотек. Зафиксируйте версии программного обеспечения, технические характеристики оборудования и параметры конфигурации моделей, использованные при анализе.
2. Подготовка и предварительная обработка наборов данных
- Загрузите и распределите необходимые клинические, физиологические, визуализационные и фармакологические наборы данных по репозиториям соответствующих модальностей и проверьте их целостность. Подтвердите характеристики наборов данных, цели прогнозирования и уровни интеграции, как указано в Таблицах 1 и 2. Рабочий процесс проиллюстрирован на Рисунке 2.
- Удалите дубликаты, недостоверные или противоречивые записи, а также записи с отсутствующими важными переменными. Разделите каждый применимый набор данных на независимые по пациентам подмножества для обучения (70%), валидации (15%) и тестирования (15%). Выполните импутацию медианой, Min-Max масштабирование и категориальное кодирование, используя только обучающее подмножество, и примените полученные преобразования без изменений к подмножествам валидации и тестирования. Генерацию синтетических данных выполняйте только на обучающем подмножестве. Проверьте правильность разделения и отсутствие утечки данных в соответствии с Дополнительной таблицей 1.
- Импортируйте данные об уровне глюкозы, потреблении пищи, дозировке инсулина, физической активности и сне. Стандартизируйте временные метки, приведите события к регулярным интервалам, линейно интерполируйте незарегистрированные значения глюкозы, разделите непрерывные записи на окна фиксированной длины и примените z-score нормализацию для создания входных данных временного трансформера (Temporal Transformer).
- Загрузите изображения глазного дна и удалите поврежденные или нечитаемые файлы, дубликаты, изображения с отсутствующими метками, а также изображения с серьезными артефактами или недостаточной видимостью поля сетчатки.
- Измените размер сохраненных изображений до 224 × 224 пикселей, нормализуйте интенсивность пикселей до диапазона [0, 1] и примените адаптивную гистограммную эквализацию с ограничением контраста (CLAHE).
- Выполните аугментацию обучающих изображений с помощью случайного поворота в пределах ±15°, горизонтального отражения с вероятностью 0.5, случайного масштабирования в пределах 0.9–1.1× и регулировки яркости в пределах ±20%. Не применяйте стохастическую аугментацию к изображениям для валидации или тестирования. Сохраните обработанные изображения для обучения Vision Transformer.
- Интегрируйте представления конкретных модальностей в соответствии со стратегией интеграции наборов данных, обобщенной в Таблице 2. Не выполняйте прямое сопоставление на уровне пациентов между независимыми репозиториями при отсутствии общих идентификаторов пациентов.
- Сохраняйте каждый общедоступный набор данных как независимый набор данных конкретной модальности, так как идентификаторы пациентов не передаются между репозиториями.
- Обучайте экстракторы признаков для каждой модальности независимо, используя соответствующие наборы данных: (а) клинические записи → энкодер TabTransformer; (б) показатели здоровья населения → энкодер TabTransformer; (в) непрерывный мониторинг глюкозы → Temporal Transformer; (г) изображения глазного дна → Vision Transformer; (д) фармакологические данные → модуль GraphSAGE.
- Извлеките латентные эмбеддинги признаков независимо для каждой модальности. Объединяйте только полученные латентные эмбеддинги с помощью предложенного модуля кросс-модального внимания (cross-modal attention fusion module), а не путем слияния необработанных записей пациентов.
- Убедитесь, что между независимыми общедоступными наборами данных не проводится искусственное сопоставление пациентов. Сохраняйте независимые разделы для обучения, валидации и тестирования для каждого набора данных на протяжении всех этапов предобработки, аугментации и разработки модели.
- Сохраните объединенные мультимодальные представления признаков для последующего прогнозирования, федеративного обучения, обеспечения интерпретируемости и персонализированного подбора лекарственных препаратов (Рисунок 2).
3. Выполнение аугментации данных на основе диффузионных моделей
- Примените аугментацию на основе диффузионных моделей к структурированным табличным наборам данных клинического характера и данных о здоровье населения с помощью TabDDPM. Генерируйте синтетические образцы исключительно из предварительно обработанного обучающего раздела, чтобы предотвратить утечку данных. Настройте модель в соответствии с Дополнительная таблица 2.
- Обучайте TabDDPM в течение максимум 500 эпох, используя оптимизатор Adam (скорость обучения = 1 × 10⁻4; размер пакета = 256). Примените раннюю остановку, если функция потерь на валидационной выборке не улучшается как минимум на 0,001 в течение 20 последовательных эпох. Сгенерируйте синтетические образцы для малопредставленных классов.
- Оцените качество синтетических данных с помощью статистики Колмогорова–Смирнова (KS), расхождения Йенсена–Шеннона, расстояния Вассерштейна, попризнакового корреляционного анализа и эффективности последующей классификации. Сравните распределения признаков оригинальных и синтетических данных с помощью перекрытия гистограмм, ядерной оценки плотности и парных коэффициентов корреляции.
- Принимайте синтетические образцы только в том случае, если распределения признаков по классам остаются согласованными с исходными обучающими данными (критерий Колмогорова-Смирнова, p > 0,05; расхождение Йенсена — Шеннона < 0,10) и не содержат нереалистичных клинических значений. Объедините принятые образцы с исходным обучающим набором данных для создания сбалансированного по классам набора данных. Рабочий процесс аугментации показан на Рисунок 3.
- Проведите валидацию синтетических данных путем повторного обучения модели прогнозирования диабета с использованием исходного и дополненного обучающих наборов данных. Сравните показатели точности (Accuracy), F1-меры (F1-score), коэффициента корреляции Мэтьюза (MCC) и площади под ROC-кривой (AUC-ROC) для оценки изменений в обобщающей способности модели и систематической ошибке распределения.
4. Разработка мультимодальной модели трансформера
Настройте мультимодальный трансформер с использованием специфических для каждой модальности энкодеров для структурированных клинических данных, последовательностей CGM и изображений глазного дна сетчатки, как показано на рисунке 4. Интегрируйте полученные представления с помощью кросс-модального внимания для прогнозирования диабета и графового персонализированного подбора лекарственных препаратов.
- Разработка клинического энкодера
- Инициализируйте архитектуру энкодера TabTransformer. Подайте на вход нормализованные клинические переменные и показатели здоровья населения. Сгенерируйте контекстуальные представления признаков с помощью механизмов внимания трансформера.
- Настройте энкодер TabTransformer, используя 32 структурированные входные клинические переменные, размерность эмбеддинга 128, четыре слоя трансформера, восемь голов внимания, размерность полносвязного слоя (feed-forward) 512, коэффициент дропаута 0.20 и функцию активации GELU (Gaussian Error Linear Unit).
- Обучите латентные клинические эмбеддинги, которые отражают взаимосвязи между атрибутами пациентов. Сохраните полученные клинические эмбеддинги для мультимодальной интеграции.
- Разработка энкодера непрерывного мониторинга глюкозы
- Инициализируйте темпоральный трансформер-энкодер. Подайте в него последовательности данных непрерывного мониторинга глюкозы и физиологические измерения. Используйте механизмы самовнимания для кодирования временных зависимостей.
- Настройте темпоральный трансформер со следующими параметрами: длина последовательности 96 временных шагов, интервал дискретизации 15 min, размерность эмбеддинга 128, четыре слоя трансформера, восемь голов внимания, синусоидальное позиционное кодирование и коэффициент дропаута 0.20.
- Сформируйте последовательные эмбеддинги, отражающие динамику глюкозы у пациента. Подготовьте темпоральные эмбеддинги для последующего процесса слияния.
- Разработка энкодера Vision Transformer
- Инициализируйте архитектуру Vision Transformer. Подайте на вход предварительно обработанные изображения глазного дна. Разделите изображения на патчи фиксированного размера.
- Настройте Vision Transformer с разрешением входного изображения 224 × 224 pixels, размером патча 16 × 16 pixels, размерностью эмбеддинга 768, 12 блоками трансформера, 12 головами внимания и коэффициентом дропаута 0.10.
- Сгенерируйте представления признаков на уровне патчей. Получите визуальные признаки, указывающие на патологии сетчатки и биомаркеры заболевания. Сохраните эмбеддинги изображений для мультимодального слияния.
- Выполнение кросс-модального слияния
- Извлеките латентные представления из клинического энкодера, энкодера CGM и Vision Transformer и спроецируйте каждое из них в общее 256-мерное латентное пространство, используя независимые линейные проекции с последующей послойной нормализацией (Layer Normalization).
- Конкатенируйте спроецированные токены модальностей, добавьте обучаемые эмбеддинги типов модальностей и примените многоголовое кросс-модальное внимание для обеспечения обмена информацией между клиническими, CGM и ретинальными представлениями. Настройте блок внимания с восемью головами, 256-мерным пространством модели, 1024-мерным полносвязным слоем, активацией GELU, дропаутом 0.10, остаточными связями (residual connections) и послойной нормализацией.
- Выполните средний пулинг (mean-pooling) для каждой группы специфичных для модальности токенов и конкатенируйте полученные представления. Спроектируйте конкатенированный 768-мерный вектор в единое мультимодальное представление размерностью 512 и сохраните веса внимания и объединенные представления для последующего анализа интерпретируемости и абляционного анализа.
- Передайте единое представление в модули прогнозирования диабета и рекомендации лекарственных средств на основе GraphSAGE. Сохраняйте исходные разделения на обучающую, валидационную и тестовую выборки для каждой модальности на протяжении всего процесса слияния без искусственного сопоставления пациентов между независимыми наборами данных.
- Настройте мультимодальный трансформер в соответствии с параметрами модели, приведенными в Дополнительной таблице 3.
5. Настройка федеративного обучения
- Настройте среду федеративного обучения для обеспечения совместного обучения моделей в географически распределенных медицинских учреждениях без обмена данными на уровне пациентов. Выполните локальную оптимизацию модели в каждом участвующем учреждении, используя доступные локально данные. Передавайте на центральный сервер агрегации только защищенные параметры модели. Обеспечьте конфиденциальность данных пациентов, создав условия для совместной разработки мультимодальных моделей.
- Разделите мультимодальные наборы данных и распределите их между несколькими федеративными клиентами, чтобы имитировать сценарий сотрудничества различных медицинских учреждений без обмена данными.
- Настройте сеть федеративного обучения, включив 10 участвующих клиентов (больниц), один центральный сервер агрегации, установив пять локальных эпох на раунд связи, 100 раундов связи, долю участия клиентов 80%, случайный выбор клиентов в каждом раунде связи и минимум восемь участвующих клиентов за раунд.
- Предоставьте каждому клиенту набор данных, относящийся к конкретному учреждению, чтобы данные оставались локальными и конфиденциальными. Распределите мультимодальные обучающие данные между 10 симулируемыми клиентами-больницами, используя стратегию распределения на основе распределения Дирихле (non-IID), чтобы создать гетерогенные распределения классов, демографический состав и различные размеры наборов данных клиентов.
- Используйте фиксированный seed генератора случайных чисел для обеспечения воспроизводимости. Проверьте полученные распределения на уровне клиентов и сохраните эти разделы на протяжении всего процесса федеративного обучения. Оставьте валидационные и тестовые наборы данных независимыми от разделов клиентов.
- Инициализируйте каждого локального клиента параметрами глобальной модели, полученными от центрального сервера агрегации. Обучайте локальный мультимодальный трансформер в течение пяти эпох, используя локальные обучающие данные клиента. Оптимизируйте локальную модель с помощью оптимизатора AdamW с коэффициентом скорости обучения 1 × 10⁻4.
- Вычислите обновления параметров локальной модели после завершения локального обучения. Защитите параметры локальной модели перед передачей на центральный сервер агрегации. Передайте защищенные локальные параметры модели на центральный сервер агрегации для глобальной агрегации.
- Примите защищенные параметры модели от всех участвующих клиентов-больниц. Перед агрегацией проверьте целостность полученных обновлений модели. Агрегируйте веса локальных моделей с помощью алгоритма федеративного усреднения (FedAvg). Обновите глобальный мультимодальный трансформер, используя агрегированные параметры модели.
- Перераспределите обновленные параметры глобальной модели между участвующими клиентами-больницами. Повторяйте процедуры локального обучения и глобальной агрегации до завершения 100 раундов связи или до выполнения заданного критерия сходимости.
- Защитите передаваемые параметры модели с помощью указанного механизма безопасной агрегации и шифрования AES-256. Выполните аутентификацию участвующих клиентов с помощью цифровых сертификатов.
- Установите зашифрованные каналы связи с использованием протокола Transport Layer Security (TLS) 1.3. После завершения каждого раунда связи сохраняйте только агрегированные параметры глобальной модели.
- Оцените конфиденциальность и безопасность с помощью анализа раскрытия исходных данных, несанкционированной передачи, вывода о принадлежности к выборке (membership inference) и инверсии модели. Для вывода о принадлежности сравните AUC-ROC атаки с базовым случайным показателем (0,50); оцените инверсию с помощью индекса структурного сходства (SSIM) и пикового отношения сигнал/шум (PSNR) для изображений сетчатки, а также нормированной ошибки реконструкции для числовых признаков.
- Подтвердите безопасную агрегацию, убедившись, что сервер не имеет доступа к индивидуальным неагрегированным обновлениям клиентов. Проверьте защиту AES-256/TLS 1.3 и подтвердите отсутствие передач обновлений модели в незашифрованном виде.
- При необходимости сравните показатели конфиденциальности для федеративной и централизованной конфигураций и представьте метрики, указанные в Дополнительной таблице 4.
- Оцените вычислительную сложность локального обучения трансформера как O(N × L × d2), где N — количество образцов, L — количество слоев трансформера, а d — размерность эмбеддинга.
- Оцените вычислительную сложность федеративной агрегации как O(K × P) за раунд связи, где K — количество участвующих клиентов, а P — количество обучаемых параметров модели.
- В течение каждого раунда связи обменивайтесь между участвующими клиентами и центральным сервером агрегации только защищенными параметрами модели. Рассчитайте коммуникационные затраты на основе размера модели, количества участвующих клиентов и количества раундов связи.
- Сравните затраты на обмен параметрами с оценочной стоимостью передачи соответствующих мультимодальных медицинских наборов данных. Настройте среду федеративного обучения в соответствии с параметрами, приведенными в Дополнительной таблице 4. Рабочий процесс федеративного обучения и процесс агрегации параметров проиллюстрированы на Рисунке 5.
6. Создание модуля персонализированных рекомендаций по лекарственным препаратам
- Импортируйте фармакологические данные, сведения о лекарственных препаратах, лечении пациентов и лекарственных взаимодействиях в вычислительную среду. Постройте гетерогенный граф здравоохранения, содержащий узлы пациентов, лекарств, заболеваний, лабораторных тестов и клинических факторов риска.
- Определите связи «пациент-заболевание», «пациент-лекарство», «заболевание-лекарство», лекарственные взаимодействия и связи «пациент-лаборатория» в качестве ребер графа. Проверьте структуру графа и удалите дубликаты, недостоверные или разорванные связи перед обучением модели.
- Представьте узлы пациентов с помощью таких параметров, как возраст, пол, индекс массы тела (BMI), HbA1c, глюкоза в крови, артериальное давление и длительность диабета. Представьте узлы лекарств с помощью класса препарата, механизма действия, дозировки, частоты применения и известных побочных эффектов.
- Представьте узлы заболеваний с помощью степени тяжести заболевания, стадии заболевания и сопутствующих осложнений. Закодируйте категориальные атрибуты и нормализуйте непрерывные признаки узлов перед обучением GraphSAGE.
- Инициализируйте эмбеддинги узлов с использованием предварительно обработанных признаков узлов. Выберите до 25 соседних узлов для каждого целевого узла в процессе агрегации окрестности. Агрегируйте представления соседних узлов с помощью усреднения (mean aggregation). Обновите эмбеддинги целевых узлов, используя агрегированные представления окрестности.
- Применяйте функцию активации Rectified Linear Unit (ReLU) после каждого слоя GraphSAGE. Нормализуйте полученные эмбеддинги узлов. Повторите процедуру агрегации окрестности в трех слоях GraphSAGE.
- Настройте модель GraphSAGE со скрытой размерностью 256, размерностью эмбеддинга 128, тремя слоями GraphSAGE, размером выборки соседей 25, коэффициентом dropout 0.30, скоростью обучения 1 × 10⁻4, размером батча 512 и максимальным количеством эпох обучения 100. Оптимизируйте модель с помощью оптимизатора Adam.
- Вычислите специфичный для пациента эмбеддинг с помощью обученной модели GraphSAGE. Вычислите эмбеддинги для потенциальных лекарственных препаратов. Рассчитайте показатели пригодности между представлением пациента и представлениями потенциальных препаратов. Ранжируйте потенциальные лекарства в соответствии с их прогнозируемыми показателями пригодности.
- Выявите и исключите противопоказанные или потенциально небезопасные препараты, используя имеющуюся информацию о лекарственных взаимодействиях. Верните пять наиболее подходящих допустимых препаратов в качестве персонализированных рекомендаций Top-5.
- Обучите рекомендательную модель, используя функцию потерь Bayesian Personalized Ranking (BPR). Оптимизируйте задачу ранжирования, чтобы присваивать более высокие баллы клинически подходящим препаратам по сравнению с менее подходящими вариантами.
- Определите влиятельные соседние узлы и клинически значимые связи в графе, которые способствуют каждой рекомендации лекарства. Рассчитайте показатели значимости признаков для характеристик пациента, заболевания, лабораторных показателей и свойств лекарств, повлиявших на рекомендацию.
- Сгенерируйте визуальные объяснения на основе графа, демонстрирующие связи, которые привели к каждой персонализированной рекомендации лекарства. Настройте рекомендательную модель GraphSAGE в соответствии с параметрами, приведенными в Дополнительной таблице 5. Рабочий процесс персонализированного подбора лекарств на основе графа проиллюстрирован на Рисунке 6.
7. Проведение оценки интерпретируемости
- Проведение анализа SHAP
- Загрузите обученный мультимодальный трансформер и отдельный тестовый набор данных в вычислительную среду.
- Инициализируйте эксплейнер SHAP, используя обученную модель прогнозирования и фоновую выборку из 100 обучающих образцов, отобранных исключительно из обучающего набора данных с помощью стратифицированного случайного отбора в соответствии с классом исхода диабета. Сохраните в фоновой выборке примерное распределение классов, характерное для всего обучающего раздела, и используйте фиксированный случайный seed 42 для обеспечения воспроизводимости отбора образцов. Вычислите значения SHAP для выбранных тестовых образцов.
- Рассчитайте глобальную важность признаков на основе абсолютных значений SHAP, создайте глобальные и локальные визуализации SHAP и сохраните вычисленные значения для последующего количественного и статистического анализа.
- Проведение анализа интегрированных градиентов (Integrated Gradients)
- Выберите репрезентативные образцы с правильной и неправильной классификацией из отдельного тестового набора данных. Определите базовые входные данные (baseline), специфичные для каждой модальности, перед расчетом интегрированных градиентов. Используйте нулевой baseline для нормализованных числовых признаков клинических данных и CGM, что соответствует нулевому вкладу нормализованного признака, и используйте изображение с нулевыми значениями в качестве baseline для нормализованного входного изображения сетчатки.
- Вычислите показатели атрибуции интегрированных градиентов, используя 100 шагов интерполяции между baseline и исходным входом. Нормализуйте полученные показатели атрибуции для возможности сравнения между признаками и модальностями. Создайте визуализации атрибуции для выявления значимых клинических, временных и имиджинговых признаков, влияющих на индивидуальные прогнозы модели.
- Визуализация внимания (attention visualization)
- Извлеките матрицы внимания из обученных слоев трансформера для репрезентативных тестовых образцов. Рассчитайте средние веса внимания по соответствующим головкам внимания. Постройте тепловые карты внимания для визуализации кросс-модальных взаимодействий между клиническими, временными представлениями и изображениями сетчатки. Определите доминирующие клинические, временные и ретинальные признаки, получившие высокие веса внимания при прогнозировании.
- Извлеките веса внимания из обученного мультимодального трансформера для случайно выбранного отдельного тестового образца и визуализируйте соответствующие распределения внимания для клинических признаков, временных данных CGM, пространственных данных сетчатки и кросс-модального внимания.
- Генерация контрфактуальных объяснений
- Выберите репрезентативные записи пациентов из отдельного тестового набора данных. Определите клинически допустимые диапазоны и ограничения для модифицируемых признаков пациентов перед генерацией контрфактуальных образцов. Ограничьте непрерывные признаки диапазоном значений, наблюдаемым в обучающих данных, а категориальные признаки — допустимыми категориями из обучающих данных. Не изменяйте неизменные демографические характеристики, включая возраст и пол.
- Сгенерируйте контрфактуальные образцы путем минимального изменения только разрешенных модифицируемых признаков при соблюдении предопределенных клинических ограничений и ограничений предметной области признаков. Отклоняйте контрфактуальные варианты, содержащие значения вне диапазона наблюдаемых обучающих данных, недопустимые категориальные состояния или изменения неизменных признаков. Определите минимальные клинически правдоподобные изменения признаков, необходимые для изменения прогнозируемого исхода.
- Укажите измененные признаки, исходные значения, контрфактуальные значения и соответствующие изменения в прогнозах модели. Рабочий процесс оценки объяснимости проиллюстрирован на Рисунке 7, а репрезентативные результаты визуализации внимания и контрфактуальных объяснений представлены на Дополнительном рисунке 1.
- Оценка качества объяснений
- Рассчитайте точность (fidelity) для количественной оценки степени соответствия между сгенерированными объяснениями и поведением модели прогнозирования. Рассчитайте стабильность (stability), многократно генерируя объяснения при небольших возмущениях входных данных и сравнивая полученные паттерны атрибуции. Оцените согласованность (consistency), сравнивая объяснения, сгенерированные для клинически схожих тестовых образцов.
- Рассчитайте разреженность (sparsity), определив количество или долю признаков, вносящих существенный вклад в каждое объяснение. Оцените полноту (completeness), чтобы определить, достаточно ли атрибутированные признаки объясняют соответствующий выход модели. Оцените чувствительность (sensitivity), измеряя изменения в показателях атрибуции после контролируемых возмущений входных признаков.
- Рассчитайте неточность (infidelity) для количественной оценки расхождения между атрибуциями признаков и наблюдаемыми изменениями в прогнозах модели. Зафиксируйте все количественные метрики объяснимости для последующего статистического анализа.
- Проспективная валидация клиницистами
- Для будущей проспективной клинической валидации получите одобрение соответствующего Институционального комитета по этике перед привлечением клинических экспертов. После получения этического одобрения привлеките 12 клиницистов, включая шесть эндокринологов, трех специалистов по диабету и трех клинических фармакологов, и получите информированное согласие от всех участников перед началом оценки.
- Случайным образом выберите репрезентативные прогнозы модели и соответствующие им объяснения для оценки клиницистами. Представьте выбранные объяснения каждому участвующему клиницисту независимо, используя стандартизированный формат оценки.
- Попросите каждого клинициста оценить полезность, клиническую значимость, интерпретируемость и достоверность объяснения по пятибалльной шкале Лайкерта. Зафиксируйте анонимизированные оценки клиницистов, рассчитайте межэкспертное согласие и соответствующие статистические показатели, как указано в шаге 7.7.
- Статистический анализ
- Оцените распределение количественных показателей оценки перед выбором статистического критерия сравнения. Примените парный t-критерий для нормально распределенных парных измерений или критерий знаковых рангов Уилкоксона для ненормально распределенных парных измерений, в зависимости от ситуации.
- Рассчитайте каппу Фляйса для количественной оценки межэкспертного согласия между участвующими клиницистами. Рассчитайте 95% доверительные интервалы для основных метрик объяснимости и оценки клиницистов. Установите порог статистической значимости на уровне p < 0.05.
- Представьте рассчитанные тестовые статистики, доверительные интервалы и p-значения вместе с соответствующими результатами оценки. Оцените и опишите метрики объяснимости в соответствии с критериями, обобщенными в Дополнительной таблице 6.
8. Оценка эффективности модели
- Сравните FedMediFormer-XAI с логистической регрессией, случайным лесом (Random Forest), XGBoost, TabTransformer, Vision Transformer, Temporal Transformer и централизованным мультимодальным трансформером, используя показатели точности (accuracy), прецизионности (precision), полноты (recall), F1-меры (F1-score), коэффициента корреляции Мэтьюса (MCC) и AUC-ROC.
- Выполните оценку каждой базовой модели с использованием одной и той же предопределенной стратегии обучения, валидации и тестирования для обеспечения сопоставимости с предлагаемой структурой.
- Повторите оценку модели в нескольких независимых экспериментальных прогонах и зафиксируйте метрики эффективности, полученные в каждом прогоне. Рассчитайте среднее значение, стандартное отклонение (SD) и 95% доверительный интервал (CI) для Accuracy, Precision, Recall, F1-score, MCC и AUC-ROC. Представьте результаты эффективности в виде среднего значения ± SD вместе с соответствующим 95% CI.
- Оцените нормальность распределения парных разностей показателей эффективности между FedMediFormer-XAI и каждой базовой моделью. Примените парный t-критерий для нормально распределенных парных измерений и критерий знаковых рангов Уилкоксона для ненормально распределенных парных измерений. Установите порог статистической значимости на уровне p < 0.05.
- Приведите соответствующие значения статистик теста, p-значения и 95% доверительные интервалы для количественной оценки статистической значимости и неопределенности наблюдаемых различий в эффективности.
- Подсчитайте общее количество раундов связи до окончательной сходимости моделей. Отслеживайте эффективность глобальной модели в процессе федеративного обучения. Изучите, как сходимость изменяется с течением времени в раундах связи.
- Проверьте эффективность агрегации параметров. Исследуйте, как децентрализованное обучение влияет на прогностическую способность. Проведите сравнение результатов федеративного и централизованного обучения.
- Оцените федеративную сходимость по раундам связи и сравните прогностическую эффективность федеративного и централизованного подходов. Оцените рекомендации по лекарственным препаратам с помощью метрик Precision@5, Recall@5 и NDCG@5.
- Сгенерируйте отрицательные образцы (образцы лекарств) из пула подходящих лекарств-кандидатов, выбирая препараты, которые не зафиксированы как положительные взаимодействия «пациент-лекарство» для соответствующего пациента. Исключите из пула отрицательного семплирования все известные положительные взаимодействия и все противопоказанные препараты. Поддерживайте фиксированное соотношение отрицательных и положительных образцов 1:1 для обучения рекомендательной системы и используйте фиксированное случайное число (seed) 42 для воспроизводимого выбора отрицательных образцов.
- Сформируйте соответствующий набор элементов для каждого пациента исключительно на основе отложенных данных для оценки. Определите набор релевантных элементов Ru для пациента u как множество лекарственных препаратов, которые удовлетворяют критериям положительного взаимодействия «пациент-лекарство» в отложенных эталонных записях. Не используйте прогнозы модели для построения Ru. Удалите противопоказанные препараты из набора кандидатов для рекомендации перед ранжированием.
- Сгенерируйте пять наиболее высокоранжированных подходящих препаратов для каждого пациента из группы оценки. Рассчитайте Precision@5 как долю из пяти рекомендованных препаратов, которые входят в набор релевантных элементов Ru данного пациента. Рассчитайте Recall@5 как долю релевантных препаратов пациента, отобранных среди пяти рекомендаций. Рассчитайте NDCG@5, используя градуированную релевантность рекомендованных препаратов, присваивая более высокую релевантность клинически подходящим препаратам и нулевую релевантность нерелевантным препаратам. Агрегируйте метрики по всем пациентам группы оценки и представьте средние значения Precision@5, Recall@5 и NDCG@5.
- Сформируйте эталонную истину для рекомендаций до оценки модели и держите отложенные взаимодействия «пациент-лекарство» отдельно от данных для обучения рекомендательной системы. Не используйте взаимодействия с лекарствами из тестового набора, метки тестового набора или информацию о будущем лечении во время обучения GraphSAGE, отрицательного семплирования или ранжирования кандидатов.
- Измерьте достоверность (Fidelity), чтобы проверить, насколько объяснения соответствуют поведению модели. Оцените стабильность объяснений с помощью многократных проверок. Оцените понятность (Comprehensibility) на основе критериев, ориентированных на врачей.
- Исследуйте согласованность объяснений для различных типов данных. Подтвердите клиническую ценность полученных объяснений. Метрики оценки, использованные в исследовании, обобщены в Дополнительной таблице 7.
9. Проведение проспективной валидации с участием клиницистов
- Проведите проспективную валидацию с участием клиницистов после получения соответствующего одобрения комитета по этике и информированного согласия, следуя процедурам набора участников, оценки, сбора данных и статистического анализа, описанным в шагах 7.6–7.8. Дизайн проспективной валидации клиницистами, включая состав участников, критерии оценки, условия сравнения и планируемый статистический анализ, обобщен в Дополнительной таблице 8.
10. Проведение валидации и оценки воспроизводимости
- Проведите абляционные исследования, систематически удаляя отдельные компоненты из полной структуры FedMediFormer-XAI при сохранении тех же разделений набора данных, процедур предобработки, настроек обучения и критериев оценки. Оцените полную модель и конфигурации без диффузионного дополнения, федеративного обучения, рекомендаций по лекарственным препаратам на основе GraphSAGE и мультимодального объединения.
- Сравните абляционные конфигурации с полной структурой FedMediFormer-XAI, используя Accuracy, Precision, Recall, F1-score, MCC и AUC-ROC. Количественно определите изменение каждого показателя эффективности, чтобы установить вклад каждого компонента структуры. Сравните результаты валидации с результатами внутреннего тестирования для оценки обобщающей способности. Проведите проверку статистической значимости, чтобы определить достоверность наблюдаемых различий в эффективности.
- Оцените обобщающую способность структуры, используя независимый внешний набор данных, если такой набор с совместимыми входными переменными и определениями результатов доступен. Примените те же процедуры предобработки и оценки, что и для внутреннего тестового набора данных, и сравните полученные показатели эффективности с результатами внутреннего тестирования.
- Проведите анализ статистической значимости по результатам повторных экспериментальных запусков. Оцените нормальность распределения парных разностей показателей эффективности перед проведением статистического тестирования. Примените парный t-критерий для нормально распределенных парных измерений и критерий знаковых рангов Вилкоксона для парных измерений с ненормальным распределением. Установите порог статистической значимости p < 0.05.
- Рассчитайте среднее значение и 95% доверительный интервал для Accuracy, Precision, Recall, F1-score, MCC и AUC-ROC. Приведите соответствующие тестовые статистики, p-значения и доверительные интервалы для основных сравнений моделей. Документируйте все параметры моделей, процедуры предобработки, конфигурации обучения и протоколы оценки, необходимые для воспроизведения описанных экспериментов.
- Сохраните исходный код, конфигурационные файлы, скрипты оценки и спецификации обученных моделей, использованные в описанных экспериментах. Ведите подробные записи об обучении моделей, экспериментальных настройках, случайных числах (random seeds) и результатах оценки.
- Проверьте полноту и согласованность доступных материалов для воспроизведения. Убедитесь, что документированные методы и материалы содержат достаточную информацию для независимого воспроизведения экспериментального рабочего процесса.
- Обобщите ресурсы для воспроизведения и процедуры валидации, использованные в исследовании, в Дополнительной таблице 9. Документируйте процедуру абляционного исследования и критерии оценки для анализа вклада основных компонентов структуры.
Результаты
Анализ прогностической эффективности
FedMediFormer-XAI продемонстрировал более высокую прогностическую эффективность по сравнению с оцениваемыми унимодальными и традиционными базовыми моделями. Аугментация на основе диффузионных моделей улучшила репрезентативность миноритарного класса; результаты прогностической эффективности приведены в Таблице 3. Оценка при повторных запусках показала стабильную прогностическую эффективность всех исследованных моделей. FedMediFormer-XAI достиг наилучших общих показателей: точность (accuracy) составила 94.20 ± 0.34% (95% CI: 93.78–94.62), прецизионность (precision) — 93.10 ± 0.30% (95% CI: 92.73–93.47), полнота (recall) — 92.80 ± 0.28% (95% CI: 92.45–93.15), а F1-мера (F1-score) — 92.90 ± 0.28% (95% CI: 92.55–93.25). Модель достигла значения MCC 0.88 ± 0.02 (95% CI: 0.86–0.90) и AUC-ROC 0.96 ± 0.01 (95% CI: 0.95–0.97). Следующие по эффективности результаты показал централизованный мультимодальный трансформер, в то время как унимодальные и традиционные модели машинного обучения продемонстрировали сравнительно более низкую прогностическую эффективность. Эти результаты указывают на то, что мультимодальное обучение представлениям в сочетании с федеративной оптимизацией обеспечивает более высокую и стабильную эффективность классификации диабета.
Абляционное исследование
Для оценки вклада аугментации с помощью диффузии, федеративного обучения, рекомендации лекарственных средств на основе GraphSAGE и мультимодального слияния использовалось покомпонентное абляционное исследование. Полная архитектура FedMediFormer-XAI достигла точности (accuracy) 94.20 ± 0.34%, прецизионности (precision) 93.10 ± 0.30%, полноты (recall) 92.80 ± 0.28%, F1-меры 92.90 ± 0.28%, MCC 0.88 ± 0.02 и AUC-ROC 0.96 ± 0.01 по результатам пяти независимых запусков. Удаление аугментации с помощью диффузии снизило точность до 91.80 ± 0.42%, что соответствует снижению на 2.40 процентного пункта, в то время как F1-мера и AUC-ROC снизились до 90.30 ± 0.38% и 0.94 ± 0.01 соответственно. Данное снижение указывает на вклад диффузионной аугментации в репрезентативность миноритарного класса и робастность прогнозирования.
Исключение федеративного обучения привело к снижению точности до 93.10 ± 0.37%, что на 1.10 процентного пункта меньше по сравнению с полной структурой. Точность (precision), полнота (recall), F1-мера, коэффициент корреляции Мэтьюза (MCC) и AUC-ROC также снизились до 92.20 ± 0.34%, 91.80 ± 0.32%, 92.00 ± 0.33%, 0.86 ± 0.02 и 0.95 ± 0.01 соответственно. Данное сравнение демонстрирует вклад федеративной конфигурации в прогностическую эффективность.
Удаление компонента персонализированного подбора лекарственных средств на основе GraphSAGE привело к сравнительно небольшому изменению эффективности прогнозирования диабета: точность снизилась до 93.80 ± 0.35%, а F1-мера — до 92.60 ± 0.30%. Соответствующие значения MCC и AUC-ROC составили 0.87 ± 0.02 и 0.96 ± 0.01 соответственно. Этот результат указывает на то, что GraphSAGE в первую очередь способствует персонализированному подбору медикаментов, а не напрямую определяет эффективность классификации диабета.
Наибольшее снижение наблюдалось при удалении мультимодального слияния. Точность снизилась до 87,60 ± 0,55%, что представляет собой снижение на 6,60 процентного пункта, в то время как прецизионность, полнота, F1-мера, коэффициент MCC и AUC-ROC снизились до 86,80 ± 0,51%, 85,90 ± 0,54%, 86,30 ± 0,52%, 0,76 ± 0,03 и 0,91 ± 0,01 соответственно. Этот результат демонстрирует важность совместного моделирования взаимодополняющей информации из клинических данных, данных НМГ и ретинальных модальностей.
Анализ федеративного обучения
Структура федеративного обучения позволила осуществлять совместное обучение моделей на распределенных клиентских узлах при сохранении децентрализованной обработки необработанных данных пациентов. В процессе обучения локальная модель каждого клиента дорабатывалась индивидуально и объединялась с помощью метода федеративного усреднения (Federated Averaging). После 100 раундов обмена данными глобальная модель сошлась, и ее прогностическая эффективность осталась сопоставимой с показателями централизованного обучения. Структура федеративного обучения продемонстрировала стабильную сходимость на протяжении раундов обмена данными, несмотря на гетерогенное распределение данных на клиентских узлах. Защищенный обмен параметрами обеспечил децентрализованную обработку данных, при этом глобальная модель сохранила конкурентоспособную прогностическую эффективность по сравнению с централизованным базовым вариантом. В таблице 4 приведено сравнение централизованной и федеративной реализаций. Федеративное обучение потребовало дополнительного времени на обучение из-за накладных расходов на связь, сохраняя при этом прогностическую эффективность, сравнимую с централизованным обучением.
Анализ эффективности на уровне наборов данных
Для оценки обобщающей способности модели в различных модальностях здравоохранения мы оценивали эффективность на каждом наборе данных по отдельности. Мультимодальная модель FedMediFormer-XAI продемонстрировала высокую и в целом конкурентоспособную эффективность на всех оцениваемых наборах данных. Она достигла точности 91.8%, 93.1%, 92.4% и 94.2% на наборах данных Pima Indians Diabetes, CDC Diabetes Health Indicators, OhioT1DM и APTOS 2019 соответственно. Хотя на наборе данных APTOS 2019 была достигнута несколько более высокая точность (94.7%) и прецизионность (93.9%), чем у мультимодальной модели, предлагаемый мультимодальный подход сохранил конкурентоспособную эффективность на всех наборах данных и обеспечил показатель AUC-ROC 0.96, что сопоставимо с наивысшим значением AUC-ROC на уровне отдельных наборов данных. Общие результаты на уровне наборов данных представлены в Таблице 5. При использовании отдельных наборов данных наилучшая эффективность была достигнута при анализе изображений сетчатки, тогда как мультимодальное объединение обеспечило наиболее стабильные и сбалансированные прогнозы.
Анализ персонализированных рекомендаций по лекарственным препаратам
Компонент рекомендаций на основе графовых нейронных сетей был оценен с использованием данных об эффективности лекарственных средств и данных о лекарственных взаимодействиях; при этом потенциальные препараты ранжировались в соответствии с вычисленными показателями пригодности конкретного препарата для данного пациента, а противопоказанные комбинации исключались в процессе генерации рекомендаций. Использование формата гетерогенного графа и моделирование взаимодействий «пациент-препарат» и «препарат-препарат» позволило провести тщательный анализ, что способствовало персонализированному подбору лекарств и оценке безопасности. Модель рекомендаций GraphSAGE эффективно выявила сложные взаимосвязи между пациентами, заболеваниями, результатами лабораторных исследований и лекарственными препаратами. Персонализированные рекомендации продемонстрировали высокую точность ранжирования, сохраняя при этом клинически значимые обоснования благодаря анализу окрестностей графа и атрибуции признаков.
Согласно Таблице 6, модуль персонализированных рекомендаций по лекарственным препаратам был оценен с помощью показателей Precision@5, Recall@5 и NDCG@5. Эти метрики количественно определяют релевантность и качество ранжирования пяти лучших персонализированных рекомендаций по медикаментам, сформированных модулем рекомендаций на основе GraphSAGE. Система рекомендаций продемонстрировала высокие показатели ранжирования: precision = 0.89, recall = 0.84 и NDCG = 0.91.
Анализ объяснимости
В структуру включены методы SHAP, интегрированные градиенты (Integrated Gradients), визуализация внимания и контрфактуальные объяснения для поддержки интерпретации мультимодальных прогнозов. Метод SHAP использовался для количественной оценки вклада отдельных признаков, интегрированные градиенты — для соотнесения прогнозов с входными признаками, визуализация внимания — для изучения фокуса модели по различным модальностям, а контрфактуальные объяснения — для выявления изменений признаков, связанных с альтернативными прогнозами. На рисунке 8 представлен репрезентативный сводный график SHAP, полученный с помощью обученной модели FedMediFormer-XAI, в то время как на рисунке 9 приведены репрезентативные результаты визуализации внимания, извлеченные из обученного трансформера. Данные рисунки представляют собой результаты оценки модели, а не схематические иллюстрации предлагаемой архитектуры.
На Рисунке 8 представлены агрегированные рейтинги важности признаков. Признаки с более высокими абсолютными значениями SHAP оказали большее влияние на прогнозы модели, что также хорошо согласуется с имеющимися клиническими знаниями.
Рисунок 9 представляет репрезентативные визуализации внимания, извлеченные непосредственно из обученной модели FedMediFormer-XAI для случайно выбранного отложенного тестового образца. Визуализации включают внимание к клиническим признакам, временное внимание CGM, пространственное внимание к сетчатке и кросс-модальное внимание между тремя модальностями. Визуализация внимания дополнительно продемонстрировала изученное моделью распределение внимания по нескольким модальностям. Для выбранного образца наблюдалось относительно более выраженное внимание к HbA1c, длительности диабета и возрасту среди клинических признаков, в то время как карта внимания CGM выделила несколько периодов с заметной вариабельностью глюкозы. Карта внимания к сетчатке определила конкретные области изображения, вносящие вклад в представление модели, а матрица кросс-модального внимания продемонстрировала как внутримодальные, так и кросс-модальные паттерны внимания. Как показано на Рисунке 9, репрезентативные карты внимания, полученные с помощью модели, выделяют выбранные временные паттерны глюкозы, влиятельные клинические переменные и диагностически значимые области изображений сетчатки в отложенном тестовом образце.
Результаты оценки с участием людей
Был разработан проспективный протокол оценки с участием людей для анализа доверия клиницистов, интерпретируемости, удобства использования, клинической полезности и релевантности объяснений в условиях предоставления только прогноза и в условиях предоставления прогноза вместе с объяснением. В предлагаемой оценке примут участие эндокринологи, диабетологи и клинические фармакологи при наличии соответствующего одобрения Институционального комитета по этике и информированного согласия. Поскольку данная оценка предназначена для будущей проспективной реализации, показатели результатов на уровне клиницистов в настоящем протоколе не приводятся.
В таблице 7 обобщены предлагаемый дизайн проспективной оценки клиницистами и предопределенные критерии для анализа влияния объяснений на доверие клиницистов, интерпретируемость и воспринимаемую полезность. В ходе проспективной оценки будет проведено сравнение экспертных оценок предсказаний модели с сопровождающими их объяснениями и без них с использованием предопределенных критериев по шкале Лайкерта. Предлагаемая структура проспективной человеко-ориентированной оценки объяснимости представлена на рисунке 10
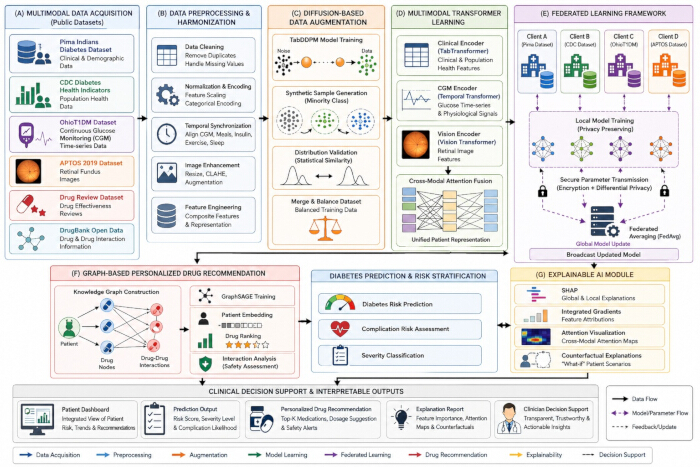
Рисунок 1: Общая архитектура системы FedMediFormer-XAI. Схематический обзор системы FedMediFormer-XAI, демонстрирующий сбор и предобработку мультимодальных данных, аугментацию на основе диффузионных моделей, обучение трансформеров для конкретных модальностей, федеративное обучение модели, персонализированный подбор лекарственных средств на основе GraphSAGE и анализ интерпретируемости. Система обеспечивает прогнозирование диабета, персонализированные рекомендации по медикаментозному лечению и интерпретируемые результаты работы модели. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
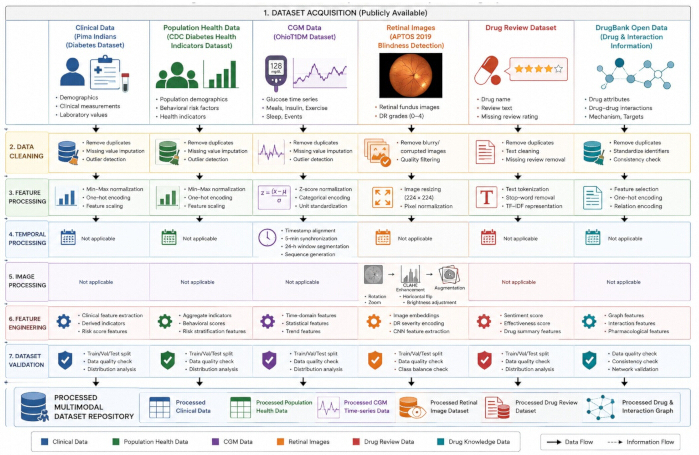
Рисунок 2: Конвейер сбора и предварительной обработки мультимодальных наборов данных. Схематический рабочий процесс сбора и предварительной обработки мультимодальных наборов данных, используемых в FedMediFormer-XAI. Клинические данные и данные о здоровье населения, записи НМГ, изображения сетчатки и фармакологическая информация проходят специфичный для каждой модальности контроль качества, предварительную обработку, нормализацию, кодирование и аугментацию перед преобразованием в представления, готовые для использования в модели для последующего анализа. Пожалуйста, нажмите здесь, чтобы просмотреть этот рисунок в большем размере.
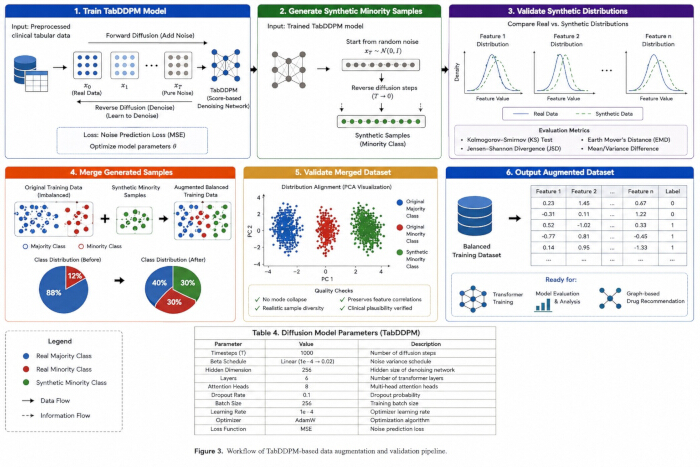
Рисунок 3: Рабочий процесс аугментации данных на основе диффузии. Схематическое описание процесса аугментации структурированных табличных обучающих данных с использованием TabDDPM. Сгенерированные образцы проходят оценку качества и сходства распределения перед объединением с исходными обучающими данными для улучшения баланса классов. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
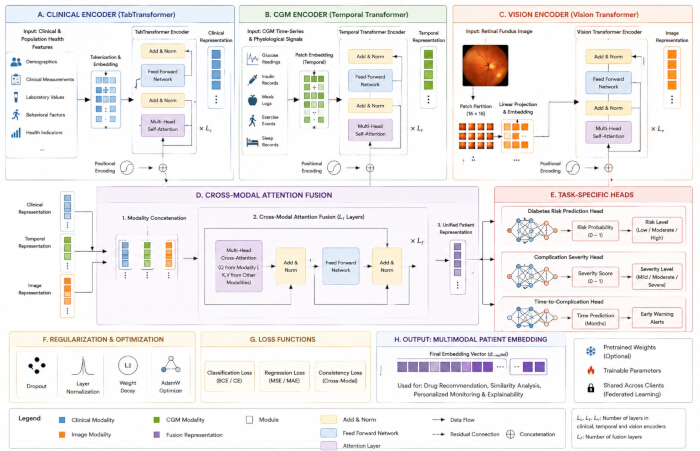
Рисунок 4: Архитектура предлагаемой мультимодальной структуры на основе трансформеров. Схематическая архитектура, включающая (A) энкодер TabTransformer для клинических данных, (B) темпоральный энкодер-трансформер для данных CGM и (C) энкодер Vision Transformer для изображений сетчатки. (D) Модально-специфические представления объединяются с помощью кросс-модального внимания для создания единого мультимодального представления. (E) Специфические для конкретных задач предсказательные головы формируют выходные данные модели. (F) Компоненты регуляризации и оптимизации поддерживают обучение модели, а (G) функции потерь для классификации, регрессии и кросс-модальной согласованности направляют процесс оптимизации. Полученное мультимодальное представление используется для последующего прогнозирования, рекомендаций и задач интерпретируемости. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
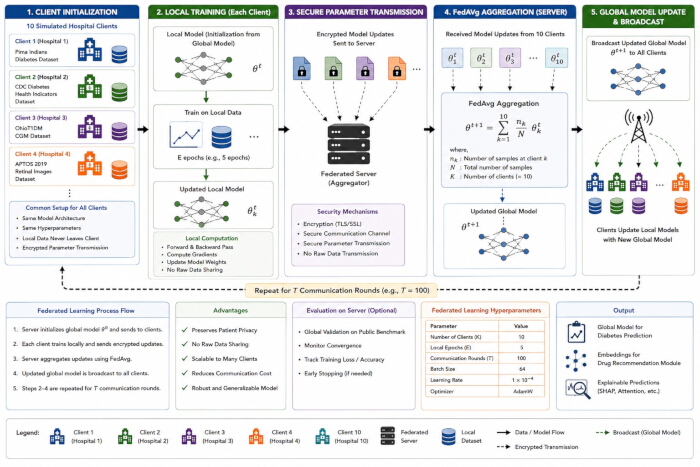
Рисунок 5: Структура коммуникации федеративного обучения. Схематический рабочий процесс федеративного обучения для распределенных клиентов-больниц. Локальные мультимодальные модели обучаются с использованием специфических данных клиентов, а защищенные обновления моделей передаются на центральный сервер для федеративного усреднения (Federated Averaging). Агрегированная глобальная модель повторно распределяется между клиентами для последующих раундов обмена данными. Структура также иллюстрирует безопасный обмен параметрами и оценку требований к конфиденциальности, связи и вычислительным ресурсам. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
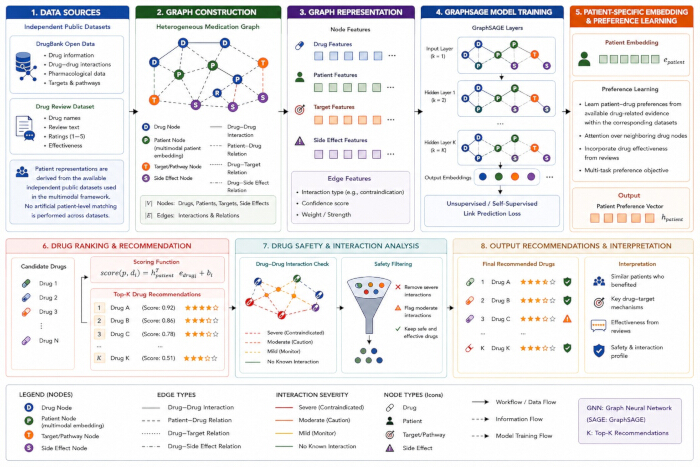
Рисунок 6: Рабочий процесс персонализированного подбора лекарственных средств на основе графов. Схематическое изображение рабочего процесса персонализированного подбора лекарств на базе GraphSAGE. Фармакологические данные и данные представления пациентов организованы в виде гетерогенного графа, который включает соответствующие медицинские сущности и связи между ними. GraphSAGE формирует представления пациентов и лекарств, которые используются для расчета показателей совместимости пациента и препарата, а также для ранжирования потенциальных лекарственных средств. Противопоказанные или небезопасные комбинации препаратов отфильтровываются перед формированием итогового списка Top-K рекомендаций, при этом информация на основе графа служит поддержкой для интерпретации данных рекомендаций. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
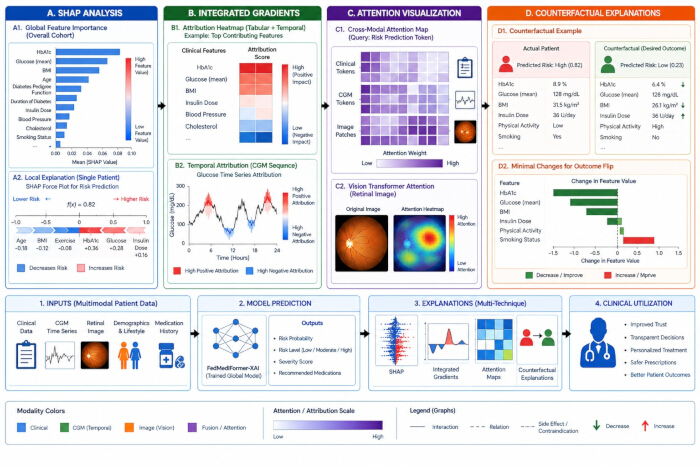
Рисунок 7: Структура оценки интерпретируемости. Схематический обзор рабочего процесса обеспечения интерпретируемости. (A) анализ SHAP оценивает глобальный и локальный вклад признаков; (B) интегрированные градиенты (Integrated Gradients) предоставляют объяснения на основе атрибуции; (C) визуализация внимания определяет влиятельные признаки и взаимодействия модальностей; и (D) контрфактуальный анализ выявляет изменения признаков, связанные с изменением прогнозов. Полученные результаты объяснения способствуют интерпретации прогнозов модели и персонализированных рекомендаций. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
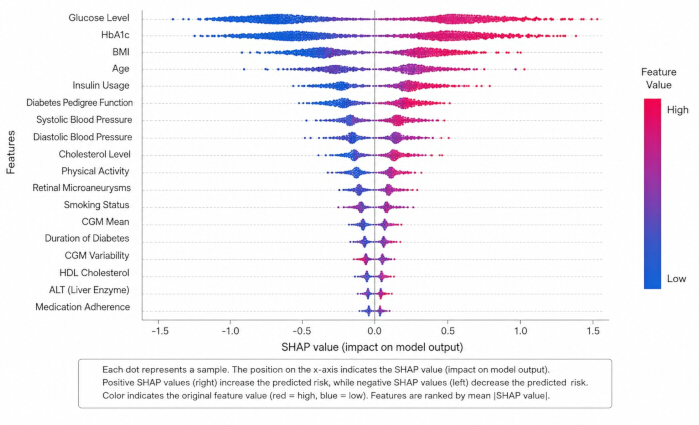
Рисунок 8: Репрезентативный анализ важности признаков SHAP, полученный с помощью обученной модели FedMediFormer-XAI. Обобщающий график SHAP показывает распределение значений SHAP по оцениваемым образцам, при этом признаки ранжированы согласно их среднему абсолютному вкладу SHAP. Положительные значения SHAP указывают на вклад в более высокий прогнозируемый риск диабета, в то время как отрицательные значения указывают на вклад в более низкий прогнозируемый риск. Цвет соответствует значению признака: более высокие значения показаны красным, более низкие — синим. График представляет собой реальный результат интерпретируемости, полученный из модели, а не схематичную иллюстрацию. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
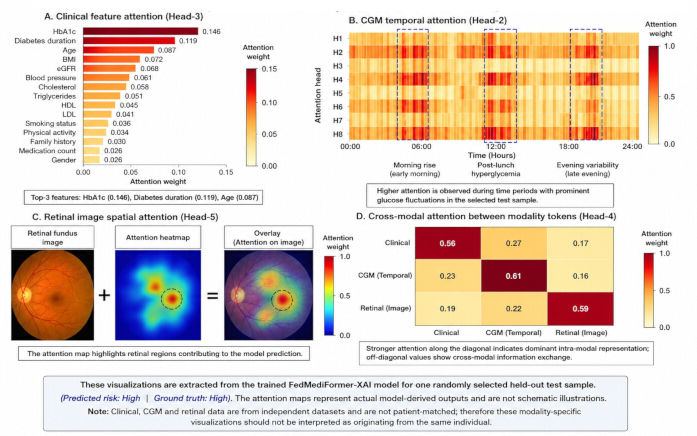
Рисунок 9: Репрезентативные результаты анализа внимания, сгенерированные обученной моделью FedMediFormer-XAI для одного случайно выбранного тестового образца из отложенной выборки. (A) Внимание к клиническим признакам, полученное из головы внимания мультимодального трансформера, демонстрирующее относительные веса внимания, присвоенные клиническим признакам. (B) Временное внимание по последовательности CGM, иллюстрирующее периоды времени, получившие более высокое внимание модели. (C) Пространственное внимание для изображения глазного дна сетчатки, включающее исходное изображение, тепловую карту внимания и наложение карты внимания. (D) Кросс-модальное внимание между токенами клинической модальности, CGM и модальности сетчатки, демонстрирующее внутримодальное и кросс-модальное взвешивание информации. Представленные визуализации являются выходными данными, сгенерированными обученной моделью. Веса внимания показаны для выбранного тестового образца и должны интерпретироваться как паттерны внимания модели, а не как независимые показатели клинической причинно-следственной связи. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
| Набор данных | Тип данных | Образцы/Записи | Особенности/Содержание | Цель | Общедоступность |
| Набор данных по диабету у индейцев племени пима | Клинические таблицы | 768 пациентов | 8 клинических переменных | Прогнозирование риска развития диабета | Публичный |
| Показатели здоровья при диабете CDC | Здоровье населения | 253 680 записей | Демографические данные, образ жизни, показатели здоровья | Анализ рисков для популяции | Общедоступный |
| Набор данных OhioT1DM | Временные ряды CGM (непрерывного мониторинга глюкозы) | 12 испытуемых | Глюкоза, инсулин, приемы пищи, физические нагрузки, сон | Моделирование темпорального диабета | Общедоступный |
| APTOS 2019: обнаружение слепоты | Изображения сетчатки | 3 662 изображения | Фотографии глазного дна с метками степени тяжести | Анализ диабетической ретинопатии | Общедоступный |
| Набор данных с отзывами о лекарственных препаратах | Фармакологический | 215 063 отзыва | Эффективность препаратов, рейтинги, отзывы | Рекомендация лекарственных препаратов | Общедоступный |
| Открытые данные DrugBank | Граф знаний о лекарственных препаратах | Тысячи лекарственных препаратов | Лекарственные взаимодействия, мишени, сигнальные пути | Построение графика | Общественный/академический доступ |
Таблица 1: Характеристики наборов данных. Сводка общедоступных наборов данных, использованных в данном исследовании, включая тип набора данных, размер выборки, модальность данных, содержание признаков, целевое назначение и доступность.
| Набор данных | Модальность | Целевой показатель прогнозирования | Уровень слияния |
| Диабет у индейцев племени пима | Клинический | Классификация сахарного диабета | Эмбеддинг признаков |
| Показатели состояния здоровья при диабете по данным CDC | Здоровье населения | Прогнозирование риска развития диабета | Вложение признаков |
| OhioT1DM | Непрерывный мониторинг глюкозы | Прогнозирование динамики уровня глюкозы | Вложение признаков |
| APTOS 2019 | Изображения глазного дна | Анализ диабетической ретинопатии | Встраивание признаков |
| Обзор лекарственных средств + DrugBank | Фармакологический | Рекомендация по применению лекарственного препарата | Вложение графа |
Таблица 2: Стратегия интеграции мультимодального набора данных. Обзор наборов данных, использованных для мультимодального анализа диабета, включая модальность данных, цель прогнозирования и уровень интеграции специфических для модальности представлений. Клинические данные, данные о здоровье населения, данные непрерывного мониторинга глюкозы и ретинальные изображения представлены в виде эмбеддингов признаков, в то время как фармакологическая информация интегрируется с помощью графовых эмбеддингов для персонализированного подбора препаратов.
| Модель | Точность (Accuracy), среднее ± SD (95% CI) | Прецизионность (Precision), среднее ± SD (95% CI) | Полнота (Recall), среднее ± SD (95% CI) | F1-мера (F1-score), среднее ± SD (95% CI) | MCC, среднее ± SD (95% CI) | AUC-ROC, среднее ± SD (95% CI) |
| Random Forest | 83.60 ± 0.74 (82.68–84.52) | 82.70 ± 0.60 (81.96–83.44) | 81.90 ± 0.56 (81.21–82.59) | 82.30 ± 0.56 (81.61–82.99) | 0.67 ± 0.03 (0.63–0.71) | 0.88 ± 0.01 (0.87–0.89) |
| XGBoost | 85.30 ± 0.71 (84.42–86.18) | 84.70 ± 0.60 (83.96–85.44) | 83.80 ± 0.56 (83.11–84.49) | 84.20 ± 0.56 (83.51–84.89) | 0.70 ± 0.03 (0.66–0.74) | 0.90 ± 0.01 (0.89–0.91) |
| TabTransformer | 87.50 ± 0.52 (86.85–88.15) | 87.00 ± 0.60 (86.26–87.74) | 86.20 ± 0.56 (85.51–86.89) | 86.60 ± 0.56 (85.91–87.29) | 0.75 ± 0.03 (0.71–0.79) | 0.92 ± 0.01 (0.91–0.93) |
| Vision Transformer | 88.80 ± 0.50 (88.18–89.42) | 88.20 ± 0.60 (87.46–88.94) | 87.60 ± 0.56 (86.91–88.29) | 87.90 ± 0.56 (87.21–88.59) | 0.78 ± 0.03 (0.74–0.82) | 0.93 ± 0.01 (0.92–0.94) |
| Temporal Transformer | 87.20 ± 0.51 (86.57–87.83) | 86.60 ± 0.60 (85.86–87.34) | 85.90 ± 0.56 (85.21–86.59) | 86.20 ± 0.56 (85.51–86.89) | 0.74 ± 0.03 (0.70–0.78) | 0.91 ± 0.01 (0.90–0.92) |
| CNN-LSTM | 86.90 ± 0.58 (86.18–87.62) | 86.30 ± 0.60 (85.56–87.04) | 85.60 ± 0.55 (84.92–86.28) | 85.90 ± 0.56 (85.21–86.59) | 0.73 ± 0.03 (0.69–0.77) | 0.91 ± 0.01 (0.90–0.92) |
| Centralized Multimodal Transformer | 91.30 ± 0.12 (91.15–91.45) | 90.70 ± 0.60 (89.96–91.44) | 90.10 ± 0.56 (89.41–90.79) | 90.40 ± 0.56 (89.71–91.09) | 0.83 ± 0.03 (0.79–0.87) | 0.95 ± 0.01 (0.94–0.96) |
| FedMediFormer-XAI | 94.20 ± 0.34 (93.78–94.62) | 93.10 ± 0.30 (92.73–93.47) | 92.80 ± 0.28 (92.45–93.15) | 92.90 ± 0.28 (92.55–93.25) | 0.88 ± 0.02 (0.86–0.90) | 0.96 ± 0.01 (0.95–0.97) |
Таблица 3: Эффективность прогнозирования диабета. Сравнительная прогностическая эффективность FedMediFormer-XAI и базовых моделей машинного и глубокого обучения с использованием метрик accuracy, precision, recall, F1-score, MCC и AUC-ROC.
| Показатель | Централизованное обучение | Федеративное обучение |
| Точность (%) | 94.7 | 94.2 |
| AUC-ROC | 0.97 | 0.96 |
| Сохранение конфиденциальности | Нет | Да |
| Требуется передача исходных данных | Да | Нет |
| Раунды связи | Н/Д | 100 |
| Время обучения (часов) | 4.8 | 5.6 |
| Соответствие нормативным требованиям | Среднее | Высокое |
Таблица 4: Сравнение эффективности федеративного и централизованного обучения. Сравнение реализаций централизованного и федеративного обучения с точки зрения прогностической эффективности, требований к обмену необработанными данными, количества раундов связи и времени обучения.
| Набор данных | Точность (%) | Прецизионность (%) | Полнота (%) | AUC-ROC (площадь под ROC-кривой) |
| Набор данных по диабету у индейцев племени Пима | 91.8 | 90.5 | 89.8 | 0.93 |
| Показатели здоровья при диабете по данным CDC | 93.1 | 92.2 | 91.6 | 0.95 |
| Набор данных OhioT1DM | 92.4 | 91.8 | 91.1 | 0.94 |
| Обнаружение слепоты APTOS 2019 | 94.7 | 93.9 | 93.5 | 0.96 |
| Мультимодальный синтез (FedMediFormer-XAI) | 94.2 | 93.1 | 92.8 | 0.96 |
Таблица 5: Результаты на уровне набора данных. Анализ эффективности по отдельным наборам данных и в условиях мультимодального слияния. Результаты иллюстрируют вклад различных модальностей данных в общую прогностическую способность.
| Метрика | Значение |
| Точность@5 | 0.89 |
| Полнота@5 (Recall@5) | 0.84 |
| NDCG@5 | 0.91 |
| Точность обнаружения лекарственных взаимодействий | 0.95 |
| Охват рекомендаций | 0.88 |
| Средний ранг взаимности (MRR) | 0.86 |
| Показатель соблюдения требований безопасности | 0.94 |
Таблица 6: Эффективность персонализированного подбора лекарственных препаратов. Оценка персонализированного подбора лекарственных препаратов на основе графов с использованием метрик ранжирования, точности определения взаимодействий, охвата рекомендаций и оценки безопасности медикаментов.
| Критерий оценки | Предлагаемый план оценки |
| Доверие клинициста | Оценка по пятибалльной шкале Лайкерта |
| Интерпретируемость | Оценка по пятибалльной шкале Лайкерта |
| Клиническая значимость | Оценка по пятибалльной шкале Лайкерта |
| Полезность пояснений | Оценка по пятибалльной шкале Лайкерта |
| Воспринимаемая полезность | Оценка по пятибалльной шкале Лайкерта |
| Межэкспертное согласие | Каппа Фляйсса, рассчитывается после проспективной оценки |
| Статистическое сравнение | Парный статистический критерий, в зависимости от данных после сбора |
| Участники | 12 клиницистов, при условии одобрения этического комитета и информированного согласия |
| Статус оценки | Проспективная/будущая оценка |
Таблица 7: Предлагаемые критерии оценки с участием человека. Предлагаемая перспективная структура оценки с участием клиницистов для анализа полезности, клинической значимости, интерпретируемости, достоверности и удобства использования объяснений FedMediFormer-XAI. Оценка включает стандартизированную проверку по пятибалльной шкале Лайкерта, определение согласованности экспертов с помощью каппы Флесса, статистическое сравнение условий «только прогноз» и «прогноз плюс объяснение», а также 95% доверительные интервалы. Оценка клиницистом должна проводиться только после получения одобрения соответствующего Институционального комитета по этике и информированного согласия.
Дополнительная таблица 1: Стратегия валидации набора данных. Для обеспечения воспроизводимости и надежной оценки модели были реализованы разделение набора данных, процедуры валидации, стратегии балансировки классов и меры контроля качества. Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Дополнительная таблица 2: Параметры диффузионной модели. Настройки конфигурации диффузионной модели TabDDPM, включая параметры обучения, настройки оптимизации, размерности латентного пространства, стратегию планирования шума и спецификации генерации синтетических образцов. Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Дополнительная таблица 3: Конфигурация мультимодального трансформера. Конфигурация архитектуры мультимодального трансформера, включая клинический, временной и визуальный энкодеры, размерности эмбеддингов и слияния, количество голов внимания, оптимизатор, скорость обучения, размер пакета, количество эпох обучения, критерий ранней остановки и комбинированную функцию потерь при обучении. Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Дополнительная таблица 4: Конфигурация федеративного обучения. Параметры, использованные для федеративного обучения с сохранением конфиденциальности, включая количество участвующих больниц, раунды связи, эпохи локального обучения, долю участия клиентов, алгоритм агрегации, оптимизатор, скорость обучения, метод шифрования, протокол связи и политику обмена необработанными данными. Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Дополнительная таблица 5: Конфигурация GraphSAGE. Конфигурация персонализированного модуля рекомендации лекарственных препаратов на основе гетерогенного GraphSAGE, включая тип графа, размерности скрытого слоя и эмбеддингов, количество слоеий графа, размер выборки окрестности, оптимизатор, скорость обучения, размер пакета, количество эпох обучения, функцию потерь Bayesian Personalized Ranking и количество лучших рекомендаций по препаратам. Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Дополнительная таблица 6: Метрики оценки интерпретируемости. Количественные и ориентированные на человека метрики, используемые для оценки интерпретируемости платформы FedMediFormer-XAI. Метрики позволяют оценить достоверность, стабильность, согласованность, разреженность, полноту, чувствительность, недостоверность объяснений, согласие между экспертами и качество объяснений с точки зрения клинициста. Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Дополнительная таблица 7: Метрики оценки. Для оценки производительности, робастности, качества ранжирования и интерпретируемости системы используются метрики прогнозирования, федеративного обучения, рекомендаций и объяснимости. Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Дополнительная таблица 8: Дизайн оценки с участием человека. Дизайн исследования по оценке с участием клиницистов, включая группы участников, условия оценки, критерии оценки и процедуры статистического анализа. Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Дополнительная таблица 9: Ресурсы для воспроизводимости. Сводка наборов данных, спецификаций реализации, конфигурационных файлов, процедур оценки, документации и экспериментальных записей, необходимых для обеспечения воспроизводимости предлагаемого фреймворка FedMediFormer-XAI. Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Обсуждение
Интерпретация основных результатов
Представленные результаты показывают, что мультимодальное обучение на базе трансформеров, федеративное обучение, аугментация на основе диффузионных моделей, рекомендация лекарственных средств с помощью графовых нейронных сетей и объяснимый искусственный интеллект могут быть объединены в единую систему интеллектуального анализа диабета. Благодаря интеграции клинических записей, показателей здоровья населения, данных непрерывного мониторинга глюкозы, изображений глазного дна и фармакологической информации, предложенная платформа FedMediFormer-XAI продемонстрировала высокую прогностическую эффективность, поддерживая при этом интерпретируемую и децентрализованную разработку моделей. Метод мультимодального обучения позволил извлечь информативные признаки из различных модальностей здравоохранения, что привело к более точному прогнозированию диабета и персонализированным рекомендациям по лечению.
Преимущества федеративного обучения
Одним из основных вкладов предлагаемой структуры является интеграция федеративного обучения для обеспечения децентрализованного совместного построения моделей. Федеративное обучение отличается от традиционных методов централизованного обучения тем, что позволяет нескольким учреждениям участвовать в обучении модели без прямой передачи необработанных данных пациентов. Основные результаты показали, что федеративное обучение обеспечило прогностическую точность, сопоставимую с централизованным обучением, поддерживая при этом децентрализованную обработку данных. Эта особенность особенно актуальна для сценариев в сфере здравоохранения, где обмен данными ограничен политикой учреждений и требованиями к конфиденциальности.
Анализ интерпретируемости
Оценка интерпретируемости показала, что анализ SHAP, интегрированные градиенты (Integrated Gradients), визуализация внимания и контрфактуальные объяснения могут дать клинически значимое понимание работы модели. Глобальные и локальные объяснения в значительной степени совпали в определении наиболее важных предикторов с клинической точки зрения (т. е. показатели глюкозы, индекс массы тела, возраст, особенности введения инсулина и патологии сетчатки). Визуализация внимания также продемонстрировала, что архитектура трансформера фокусируется на клинически значимых временных признаках и особенностях изображений. Эти подходы повышают прозрачность, обеспечивая взаимодополняющую интерпретацию прогнозов модели и вклада отдельных признаков.
Анализ персонализированных рекомендаций по подбору лекарственных препаратов
Мы предлагаем рекомендательную модель на основе GNN, которая, наряду с моделированием взаимосвязей «пациент-препарат» и «препарат-препарат», предоставляет персонализированные рекомендации по подбору лекарств. Фактически, гетерогенная топология графа способствовала как освоению паттернов эффективности лечения, так и учету безопасности медикаментозной терапии. Высокие результаты подбора препаратов, полученные в данном исследовании, демонстрируют возможности методов обучения на основе графов для разработки интеллектуальных систем по борьбе с диабетом, выходящих за рамки прогнозирования заболевания в сторону создания платформы персонализированной терапевтической поддержки.
Оценка с участием человека
В структуру включен проспективный протокол оценки с участием человека для анализа влияния объяснимости на доверие клиницистов, интерпретируемость, удобство использования и воспринимаемую клиническую полезность. Предлагаемая оценка будет сравнивать условия «только прогноз» и «прогноз с объяснением» с использованием стандартизированных критериев оценки. Последующая реализация данной оценки, при условии получения соответствующего одобрения Институционального комитета по этике и информированного согласия, позволит получить эмпирические данные о принятии метода клиницистами и практической полезности сгенерированных объяснений.
Критические этапы для успешного и воспроизводимого внедрения
Несколько этапов предлагаемого протокола требуют особого внимания для обеспечения воспроизводимости. При предобработке и разделении набора данных необходимо поддерживать разделение на уровне пациентов и предотвращать утечку данных, а при федеративном обучении следует сохранять указанные распределения клиентов non-IID. Кросс-модальный синтез должен поддерживать определенные латентные размерности, конфигурацию внимания, эмбеддинги типов модальностей, нормализацию и финальную проекцию. Для аугментации на основе диффузии должны использоваться согласованные параметры предобработки и обучения, а для рекомендаций на основе GraphSAGE необходимо поддерживать единообразные представления «пациент-препарат», скрининг взаимодействий, определения релевантных объектов и критерии ранжирования Top-K. Анализ объяснимости должен использовать фиксированные фоновые выборки SHAP, базовые линии Integrated Gradients, процедуры извлечения внимания и клинически допустимые контрфактуальные ограничения. Версии программного обеспечения, случайные числа (seeds), конфигурации моделей, разделения наборов данных и параметры оценки должны быть задокументированы для минимизации вариаций, зависящих от реализации.
Ограничения
При интерпретации результатов данного исследования следует учитывать несколько ограничений. Во-первых, платформа была разработана и протестирована с использованием общедоступных наборов данных, которые могут не в полной мере отражать разнообразие популяций пациентов и клинических условий в реальной практике здравоохранения. Во-вторых, несмотря на то, что федеративное обучение оценивалось с помощью симуляции клиентов-больниц, крупномасштабная валидация с участием независимых медицинских учреждений не проводилась. В-третьих, федеративное обучение создает дополнительные коммуникационные и вычислительные затраты, что может повлиять на масштабируемость в условиях ограниченных ресурсов. Наконец, методы объяснимости, примененные в данном исследовании, представляют собой преимущественно методы апостериорной (post hoc) интерпретации и могут не в полной мере отражать поведение сложной модели.
Предлагаемый протокол валидации с участием человека предусматривает первоначальную панель из 12 клинических экспертов, в которую входят эндокринологи, диабетологи и клинические фармакологи. Данный размер выборки предназначен для предварительной оценки удобства использования и интерпретируемости, а не для окончательной клинической валидации. Относительно небольшой состав экспертной панели может ограничить статистическую мощность и обобщаемость результатов. Следовательно, будущие проспективные исследования должны охватывать более крупные многоцентровые когорты клиницистов, представляющих различные клинические условия и специализации.
Основным ограничением предлагаемой структуры является то, что данные клинических исследований, непрерывного мониторинга глюкозы (CGM), ретинальной визуализации и данные о лекарственных препаратах получены из независимых открытых наборов данных, а не из сопоставленных по пациентам мультимодальных записей. Следовательно, компонент кросс-модального слияния следует рассматривать как методологическую основу для интеграции дополняющих друг друга представлений модальностей, а не как доказательство, полученное на основе одновременных мультимодальных измерений у одних и тех же пациентов. Различия в характеристиках популяций, протоколах сбора данных, распределении признаков и определениях заболеваний в исходных наборах данных могут привести к расхождениям в распределениях и ограничить степень, в которой выявленные кросс-модальные связи отражают истинные ассоциации на уровне пациентов. Хотя протокол намеренно исключает искусственное сопоставление пациентов между независимыми наборами данных, такой подход ограничивает прямую оценку специфических для конкретного пациента мультимодальных взаимодействий и может повлиять на клиническую обобщаемость. Таким образом, сообщаемые показатели мультимодальной эффективности не должны интерпретироваться как эквивалентные валидации на проспективно собранной сопоставленной по пациентам мультимодальной когорте. Будущие исследования должны подтвердить эффективность данной структуры с использованием более крупных, независимо собранных наборов данных, содержащих синхронизированную клиническую информацию, данные CGM, ретинальные данные и сведения о лечении одних и тех же пациентов.
Устранение неполадок и модификации протокола
На реализацию предлагаемого протокола могут повлиять несколько практических факторов. Дисбаланс классов может снизить прогностическую эффективность при недостаточном представлении миноритарных классов; эту проблему можно решить с помощью аугментации на основе диффузионных моделей и стратегий ресэмплинга. Пропущенные значения и несогласованность форматов данных могут повлиять на стабильность модели, что требует применения строгих процедур предобработки. Сходимость при федеративном обучении может стать нестабильной, если наборы данных клиентов характеризуются существенной гетерогенностью; для повышения стабильности может потребоваться корректировка локальных эпох обучения, скорости обучения и частоты агрегации. Ограничения аппаратного обеспечения также могут повлиять на эффективность обучения, особенно при обработке больших мультимодальных наборов данных и использовании архитектур трансформеров. В таких случаях уменьшение размера пакета (batch size) или сложности модели может повысить вычислительную осуществимость при сохранении воспроизводимости.
Перспективы дальнейших исследований
Будущие исследования могут быть сосредоточены на интеграции технологий цифровых двойников для персонализированного моделирования заболеваний и планирования лечения. Базовые модели, обученные на крупномасштабных мультимодальных наборах данных здравоохранения, могут дополнительно улучшить обучение представлениям и обобщающую способность моделей. Методы причинно-следственной интерпретируемости могут обеспечить более глубокое понимание механизмов заболеваний и эффектов лечения, выходя за рамки объяснений, основанных на корреляции. Кроме того, подходы обучения с подкреплением могут способствовать адаптивной оптимизации лечения и стратегиям динамического подбора лекарственных препаратов. Эти достижения могут дополнительно расширить клиническую полезность и возможности персонализации интеллектуальных систем управления диабетом. Более того, прогнозы и рекомендации по медикаментозному лечению, созданные ИИ, следует рассматривать как инструменты поддержки принятия решений, а не как замену профессиональному клиническому суждению. Надлежащий человеческий контроль остается необходимым условием для ответственного и этичного внедрения систем искусственного интеллекта в здравоохранении.
Заключение
FedMediFormer-XAI представляет собой воспроизводимую структуру, объединяющую мультимодальное обучение, федеративное обучение, персонализированный подбор лекарственных препаратов и интерпретируемость для интеллектуального анализа диабета. Репрезентативные результаты подтверждают осуществимость предложенного рабочего процесса, однако перед внедрением в клиническую практику необходима дальнейшая валидация с использованием подходящих мультимодальных наборов данных пациентов, в более широких клинических условиях, а также проспективная оценка специалистами).
Раскрытие информации
Авторы заявляют об отсутствии конкурирующих финансовых интересов, конфликтов интересов или личных отношений, которые могли бы повлиять на работу, представленную в данном исследовании. Инструменты искусственного интеллекта использовались исключительно для помощи в улучшении языка, организации рукописи, форматировании и редактировании в процессе подготовки данной статьи. Всё научное содержание, дизайн исследования, методология, анализ данных, интерпретация результатов и выводы были разработаны, проверены и утверждены авторами. Авторы несут полную ответственность за точность, целостность и оригинальность работы, представленной в данной рукописи.
Благодарности
Авторы выражают благодарность разработчикам и администраторам общедоступных наборов данных и ресурсов программного обеспечения с открытым исходным кодом, использованных в данном исследовании.
Материалы
| Имя | Компания | Каталожный номер | Комментарии |
|---|---|---|---|
| Шифрование AES | NIST | AES-256 | Шифрование хранимых данных / защищенных параметров модели в федеративном обучении |
| APTOS 2019 Blindness Detection Dataset | Kaggle/APTOS | Выпуск 2019 | Набор данных изображений глазного дна; общедоступный и деидентифицированный; https://www.kaggle.com/competitions/aptos2019-blindness-detection/data |
| Captum | Meta AI | Версия 0.8 | Интерпретируемость моделей и анализ атрибуции |
| CUDA Toolkit | NVIDIA | Версия 12.2 | Вычисления с ускорением GPU |
| Diabetes Health Indicators Dataset (CDC BRFSS 2015) | CDC/BRFSS; Kaggle | Выпуск 2015 | Показатели здоровья населения; общедоступный и деидентифицированный; https://www.kaggle.com/datasets/alexteboul/diabetes-health-indicators-dataset |
| Diabetic Retinopathy Detection Dataset | Kaggle | Публичный выпуск | Набор изображений сетчатки; общедоступный и деидентифицированный; https://www.kaggle.com/c/diabetic-retinopathy-detection/data |
| Цифровые сертификаты | — | — | Аутентификация клиентов в федеративном обучении |
| Drug Interaction Dataset | Kaggle | Публичный выпуск | Графовые данные о лекарственных взаимодействиях; общедоступный и деидентифицированный; https://www.kaggle.com/datasets/rohanharode07/drug-drug-interaction |
| Drug Review Dataset | UCI Machine Learning Repository | Набор данных 462 | Набор данных об эффективности и отзывах о лекарствах; общедоступный и деидентифицированный; https://archive.ics.uci.edu/dataset/462/drug+review+dataset+drugs+com |
| Matplotlib | Matplotlib Developers | Версия 3.9 | Визуализация |
| MTS Diabetes Dataset | Kaggle | Публичный выпуск | Набор данных носимых датчиков / прогнозирования диабета; общедоступный и деидентифицированный; https://www.kaggle.com/datasets/marshalpatel3558/diabetespredictiondataset |
| NetworkX | NetworkX Developers | Версия 3.3 | Построение и анализ графов лекарственных взаимодействий |
| NumPy | NumPy Developers | Версия 1.26 | Численные вычисления |
| NVIDIA RTX 4090 GPU | NVIDIA | RTX 4090 | Обучение и инференс моделей; минимум 32 GB системной памяти |
| OhioT1DM Dataset | Ohio University | Публичный выпуск | Набор данных непрерывного мониторинга глюкозы; общедоступный и деидентифицированный; https://webpages.charlotte.edu/rbunescu/data/ohiot1dm/OhioT1DM-dataset.html |
| OpenCV | OpenCV Foundation | Версия 4.10 | Обработка изображений |
| Pandas | PyData | Версия 2.2 | Обработка и предобработка данных |
| Pima Indians Diabetes Dataset | UCI Machine Learning Repository | Набор данных 34 | Клинический набор данных для прогнозирования диабета; общедоступный и деидентифицированный; https://archive.ics.uci.edu/dataset/34/diabetes |
| Python | Python Software Foundation | Версия 3.11 | Основная среда программирования |
| PyTorch | Meta AI | Версия 2.3 | Разработка и обучение моделей глубокого обучения |
| PyTorch Geometric | PyG Team | Версия 2.5 | Построение и обучение графовых нейронных сетей |
| Scikit-learn | Scikit-learn Developers | Версия 1.5 | Инструменты машинного обучения и оценки |
| Механизм безопасного агрегирования | — | — | Защищенное агрегирование локальных параметров модели в федеративном обучении |
| SHAP | SHAP Developers | Версия 0.47 | Объяснимый ИИ и анализ атрибуции признаков |
| TensorFlow | Версия 2.15 | Разработка и обучение моделей глубокого обучения | |
| Transformers | Hugging Face | Версия 4.45 | Реализация архитектуры на основе трансформеров |
| Transport Layer Security | IETF | TLS 1.3 | Зашифрованный канал связи для обмена федеративными параметрами |
| Рабочая станция | Общая | — | Вычислительная среда; минимум 32 GB системной памяти |
Ссылки
- Al-Hejri AM, et al. A hybrid explainable federated-based vision transformer framework for breast cancer prediction via risk factors. Sci Rep. 2025;15:18453.
- Dosovitskiy A, et al. An image is worth 16×16 words: transformers for image recognition at scale [conference presentation]. Presented at: International Conference on Learning Representations (ICLR); 2021. [https://arxiv.org/abs/2010.11929]
- Touvron H, et al. Training data-efficient image transformers & distillation through attention [conference presentation]. Presented at: 38th International Conference on Machine Learning; 2021. [https://arxiv.org/abs/2012.12877]
- Kotelnikov A, Baranchuk D, Rubachev I, Babenko A. TabDDPM: modelling tabular data with diffusion models [conference presentation]. Presented at: 40th International Conference on Machine Learning (ICML); 2023. [https://arxiv.org/abs/2209.15421]
- Pinaya WHL, et al. Brain imaging generation with latent diffusion models [conference presentation]. Presented at: International Conference on Medical Image Computing and Computer-Assisted Intervention (MICCAI); 2022. [https://arxiv.org/abs/2209.07162]
- Ho J, Jain A, Abbeel P. Denoising diffusion probabilistic models [conference presentation]. Presented at: Advances in Neural Information Processing Systems (NeurIPS); 2020. [https://arxiv.org/abs/2006.11239]
- Song Y, et al. Score-based generative modeling through stochastic differential equations [conference presentation]. Presented at: International Conference on Learning Representations (ICLR); 2021. [https://arxiv.org/abs/2011.13456]
- Li T, Sahu AK, Talwalkar A, Smith V. Federated learning: challenges, methods, and future directions. IEEE Signal Process Mag. 2020;37(3):50-60.
- Kairouz P, et al. Advances and open problems in federated learning. Found Trends Mach Learn. 2021;14(1-2):1-210.
- Rieke N, et al. The future of digital health with federated learning. NPJ Digit Med. 2020;3:119.
- Kaissis GA, Makowski MR, Rückert D, Braren RF. Secure, privacy-preserving and federated machine learning in medical imaging. Nat Mach Intell. 2020;2(6):305-11.
- Sheller MJ, et al. Federated learning in medicine: facilitating multi-institutional collaborations without sharing patient data. Sci Rep. 2020;10:12598.
- McMahan HB, et al. Communication-efficient learning of deep networks from decentralized data [conference presentation]. Presented at: International Conference on Artificial Intelligence and Statistics (AISTATS); 2017. [https://arxiv.org/abs/1602.05629]
- Lundberg SM, et al. From local explanations to global understanding with explainable AI for trees. Nat Mach Intell. 2020;2(1):56-67.
- Ribeiro MT, Singh S, Guestrin C. Why should I trust you? Explaining the predictions of any classifier [conference presentation]. Presented at: ACM SIGKDD International Conference on Knowledge Discovery and Data Mining (KDD); 2016. [https://arxiv.org/abs/1602.04938]
- Wachter S, Mittelstadt B, Russell C. Counterfactual explanations and algorithmic recourse in healthcare AI. AI Ethics. 2021;1(2):123-37.
- Chen J, Liao W, Yu W. Explainable AI for precision medicine: a systematic review. Brief Bioinform. 2024;25(2):bbae045.
- Zitnik M, Agrawal M, Leskovec J. Modeling polypharmacy side effects with graph neural networks. Bioinformatics. 2020;36(2):i457-i466.
- Wu Z, et al. A comprehensive survey on graph neural networks. IEEE Trans Neural Netw Learn Syst. 2021;32(1):4-24.
- Hamilton WL. Graph representation learning. Morgan & Claypool Publishers; San Rafael (CA); 2020.
- Shang J, Ma T, Xiao C, Sun J. Pre-training of graph augmented transformers for medication recommendation [conference presentation]. Presented at: International Joint Conference on Artificial Intelligence (IJCAI); 2021. [https://arxiv.org/abs/1906.00346]
- Wang X, et al. Neural graph collaborative filtering. IEEE Trans Knowl Data Eng. 2021;33(5):2136-49.
- Yu KH, Beam AL, Kohane IS. Artificial intelligence in healthcare. Nat Biomed Eng. 2021;5(8):719-31.
- Muhammad G, Hossain MS, Kumar N. EEG-based pathology detection for home health monitoring. IEEE J Sel Areas Commun. 2021;39(2):603-10.
- Alshehri F, Muhammad G. Internet of Things and edge computing in healthcare: a survey. IEEE Access. 2021;9:3660-78.
- Vaid A, et al. Federated learning of electronic health records to improve mortality prediction. JMIR Med Inform. 2021;9(1):e24207.
- Lim WYB, et al. Dynamic contract design for federated learning in smart healthcare applications. IEEE Internet Things J. 2021;8(23):16853-62.
- Chikumo OT, et al. Transformer-based models for disease prediction using electronic health records: a systematic review. J Appl Artif Intell Comput. 2026;10(1):1-18.
- Lai T. Interpretable medical imagery diagnosis with self-attentive transformers: a review of explainable AI for healthcare. Diagnostics (Basel). 2023;13(18):3021.