В данном исследовании используется сочетание сценарного эксперимента и электроэнцефалографии для изучения того, как определение ролей «эксперта» и «компаньона» влияет на уровень доверия в различных контекстах выполнения медицинских задач.
Методическая статья
Фрейминг ролей и доверие к медицинскому ИИ: данные сценарного эксперимента и ЭЭГ
В этой статье
Краткое содержание
Аннотация
Онлайн-медицинский ИИ эволюционировал из аналитических инструментов бэкэнда в пользовательские интерфейсы обслуживания пациентов, что делает калиброванное доверие все более важной проблемой проектирования и управления. Опираясь на теорию конгруэнтности ролей, в данном исследовании изучалось, как фрейминг ролей эксперта и компаньона связан с доверием в различных контекстах медицинских задач. В исследовании 1 использовался сценарный эксперимент 2 (роль: эксперт против компаньона) × 2 (задача: консультация по болезни против консультации по здоровью) (N = 300). Фрейминг эксперта повышал воспринимаемый профессионализм, тогда как фрейминг компаньона увеличивал социальное присутствие; оба этих восприятия были независимо связаны с общим доверием при одновременном введении в модель. Косвенная связь через профессионализм зависела от контекста задачи, однако прямое бутстреп-сравнение не показало, что два индекса модерируемой медиации различались для общего доверия. Диагностика измерений выявила существенное перекрытие между воспринимаемым профессионализмом и когнитивным доверием, а также между социальным присутствием и аффективным доверием, что требует осторожной интерпретации. В исследовании 2 с помощью ЭЭГ в 39 парных наблюдениях сравнивались утверждения, сформулированные в ролях эксперта и компаньона. Фрейминг эксперта сопровождался более высоким фронтально-срединным тета-ERS и менее отрицательным скорректированным по базовой линии FCz-F6 тета ΔPLV, в то время как поведенческие показатели на уровне условий не показали достоверных различий в уровне доверия, времени отклика или частоте пропущенных ответов. Эти данные ЭЭГ являются исследовательскими коррелятами на уровне процессов, а не нейронным подтверждением условной косвенной модели. В целом, ролевые подсказки, по-видимому, формируют неисключающие оценки, ориентированные на компетенцию и на отношения. Проектирование ролей должно поддерживать калиброванную опору на систему через определение границ возможностей, сообщение о неопределенности, предупреждения о рисках и соответствующую эскалацию, а не просто максимизировать доверие.
Введение
Медицинский ИИ в настоящее время охватывает как серверные приложения, такие как распознавание изображений, патоморфологический анализ и поиск новых лекарственных средств, так и интерфейсы обслуживания, ориентированные на пациента. Отраслевой анализ прогнозирует дальнейший рост рынка ИИ в здравоохранении до 2033 года1. Большие языковые модели позволяют системам медицинского ИИ отвечать на вопросы о здоровье, интерпретировать результаты анализов, обобщать информацию и предоставлять рекомендации на естественном языке2. Этот сдвиг меняет характер отношений пользователя с технологией. Серверный аналитический инструмент оценивается клиницистами и организациями, тогда как интерфейс, ориентированный на пациента, должен сообщать пользователям о своей роли, имеющихся доказательствах, степени неопределенности и ограничениях. Медицинский ИИ может выступать в качестве диагностического помощника, интерфейса семейного врача или сопровождающего по управлению здоровьем, и каждый из этих вариантов может влиять на то, как пользователи воспринимают функциональное назначение системы. По мере того как эти системы все чаще участвуют в консультациях по поводу заболеваний и повседневном управлении здоровьем, доверие становится чем-то большим, чем просто отношением к технологии. Оно влияет на то, будут ли пользователи раскрывать информацию, считать ли рекомендации достоверными, взаимодействовать ли с системой и следовать ли медицинским указаниям. Таким образом, доверие является центральным вопросом проектирования и управления цифровыми платформами здравоохранения.
Одна лишь техническая возможность не определяет того, считают ли пользователи медицинский ИИ заслуживающим доверия и приемлемым. Обзоры разговорных агентов в сфере здравоохранения показывают, что внедрение зависит от качества взаимодействия, клинической значимости, прозрачности и условий развертывания3. Недавние работы, посвященные достоверным доказательствам для медицинского ИИ, аналогичным образом утверждают, что производительности модели недостаточно, если утверждения не подкреплены доказательствами, соответствующими предполагаемому использованию4. Прозрачность имеет важное значение, поскольку пациенты должны иметь возможность определить границы возможностей, степень неопределенности и основание для рекомендации, а не делать вывод о надежности только на основе беглости речи5. Исследования информационных систем аналогичным образом представляют внедрение диагностики с помощью ИИ как проблему конфигурации доверия, при которой интерпретируемость, защита конфиденциальности и интерфейсные подсказки совместно определяют степень принятия6. Эти соображения важны для интерфейсов языковых моделей. Беглость речи может сделать ответ легким для понимания, при этом оставаясь нерешенным вопрос о том, обладает ли система клиническими знаниями, применима ли ее рекомендация к обстоятельствам пользователя и когда необходимо обращение к квалифицированному клиницисту. Актуальным является вопрос не только о том, может ли медицинский ИИ дать ответ, но и о том, могут ли пользователи оценить его с соответствующим уровнем доверия.
Доверие к медицинскому ИИ зависит от контекста задачи. Исследования сопротивления медицинскому ИИ показывают, что пользователи могут отвергать алгоритмические рекомендации при принятии критически важных решений, так как считают, что алгоритм не способен учесть их индивидуальные особенности7. Сопротивление не является универсальным. Исследования «признания алгоритмов» указывают на то, что люди могут отдавать предпочтение алгоритмическим суждениям, когда задачи носят объективный характер, а правила более четко определены8. В онлайн-консультациях по вопросам здоровья персонализация и тщательность советов, генерируемых ИИ, влияют на доверие и степень их принятия9. Исследования дискретного выбора, сравнивающие традиционные, цифровые и основанные на ИИ консультации, также показывают, что предпочтения и ожидания в отношении доверия варьируются в зависимости от формата10. Командное взаимодействие человека и ИИ также может снизить сопротивление за счет переноса доверия от экспертных знаний человека к сервисной структуре с поддержкой ИИ11. Таким образом, доверие к медицинскому ИИ формируется в результате взаимодействия воспринимаемого риска, требований задачи, стиля общения и оценки системы. Консультация по поводу заболевания делает более значимыми неопределенность, возможные потери, диагностические последствия и стоимость ошибок. Консультации по вопросам здоровья чаще касаются диеты, физических упражнений, сна, приверженности лечению и профилактического управления, где более важную роль могут играть длительное взаимодействие и доступность отношений. Следовательно, один и тот же интерфейсный сигнал может быть истолкован по-разному в зависимости от того, обращается ли пользователь за помощью при возможном заболевании или в целях долгосрочного управления здоровьем.
Определение роли является одной из функций интерфейса, с помощью которой могут передаваться эти ожидания. Медицинский ИИ может быть представлен как эксперт, при котором акцент делается на профессиональном авторитете, структурированном мышлении, клинических границах и доказательствах компетенции, или как компаньон, где приоритет отдается эмпатии, поддержке, психологическому комфорту и непрерывности взаимодействия. Это различие относится к компетентности и теплоте — двум измерениям социального восприятия, однако оно не является простым выбором между компетентной и теплой системой12. Стиль общения и определение агентности влияют на оценку разговорных агентов13. В мобильных медицинских приложениях социальные сигналы и вопросы конфиденциальности совместно влияют на доверие и поведенческие намерения14. Антропоморфные признаки в медицинских разговорных агентах могут повысить уровень социального присутствия, доверия и принятия, хотя они также могут создать ожидания, превышающие возможности системы15. Исследования команд «человек-ИИ» дополнительно показывают, что теплота и компетентность предсказывают разные формы восприимчивости16. При выполнении задач с высоким риском доверие зависит от соответствия между ролью в команде, контекстом задачи и случаями нарушения эффективности17. Соответствие между социальной ролью чат-бота и его эффективностью также влияет на формирование и восстановление доверия18. Таким образом, сигналы «эксперта» и «компаньона» не просто меняют тон беседы, а делают значимыми различные оценочные стандарты.
Остаются два пробела. Во-первых, в исследованиях не объяснено, как значимость сигналов, ориентированных на компетентность и взаимоотношения, меняется в зависимости от требований медицинской задачи. Обзоры доверия человека к ИИ подчеркивают зависимость от контекста, но не уточняют, как работают сигналы «эксперта» и «компаньона» при консультациях по поводу болезни и при консультациях по вопросам здоровья19. Во-вторых, исследования доверия к медицинскому ИИ опираются на самоотчеты, что дает ограниченные данные о процессах, связанных с оценкой в рамках заданной роли. Конфиденциальность, прозрачность, подотчетность и предвзятость также ограничивают интерпретацию внешних ролевых сигналов20,21. Чтобы восполнить эти пробелы, в данной работе используется теория конгруэнтности ролей, которая объясняет процесс оценки через соответствие между ролевыми сигналами и значимыми требованиями контекста22. В исследовании 1 используется рандомизированный сценарный эксперимент по схеме 2 (роль: эксперт против компаньона) x 2 (задача: консультация по болезни против консультации по здоровью) (N = 300) для изучения ролевого фрейминга, контекста задачи и параллельных косвенных связей через воспринимаемый профессионализм и социальное присутствие. Исследование 2 представляет собой отдельный внутрисубъектный ЭЭГ-эксперимент (N = 39) для сравнения активности в тета-диапазоне в ответ на утверждения, сформулированные в ролях эксперта и компаньона. Исследование 1 оценивает поведенческие связи и контекстуальную модерацию; исследование 2 предоставляет эксплоративное сравнение на уровне процессов, а не нейронную валидацию условной косвенной модели.
Теоретическая база и разработка гипотезы
Определение ролей в медицинском ИИ
Медицинский ИИ работает в условиях высокого риска, связанных с риском развития заболеваний, рекомендациями по лечению, ответственностью и этическими границами23. Следовательно, определение роли имеет значение, поскольку формулировки интерфейса могут сделать границы возможностей, доказательной базы и ответственности более или менее заметными для пользователей. Исследования в области прозрачности также подчеркивают, что системы медицинского ИИ должны сообщать об ограничениях своих возможностей и доказательной базе5. Ответы в стиле эксперта передают компетентность через формальную терминологию, структурированное рассуждение, определение границ применимости и рекомендации по действиям, в то время как ответы в стиле компаньона выражают реляционную поддержку через эмпатию, успокоение и совместные формулировки. Эти сигналы не являются просто украшением интерфейса: они формируют стандарты, которые пользователи применяют при оценке системы24,25. Антропоморфизм может вызывать социальные реакции, но также может создать нереалистичные ожидания и размыть границы ответственности26,27. Исследования команд «человек-ИИ» и чат-ботов дополнительно указывают на то, что доброжелательность, компетентность, соответствие роли контексту и согласованность между социальной ролью и эффективностью влияют на принятие и доверие16,17,18. В данном исследовании конгруэнтность роли означает согласованность между сигналами, передаваемыми ответом ИИ, и оценочными требованиями, актуальными для задачи консультирования22.
Двухпутевое доверие: воспринимаемый профессионализм и социальное присутствие
Соответствие роли выводится из наблюдаемого взаимодействия роли и задачи, а не измеряется как отдельный субъективный конструкт. Таким образом, интерпретация привязана к экспериментальному взаимодействию и не означает, что участники сознательно сообщали об ощущении соответствия роли. Доверие включает когнитивные суждения о компетентности и надежности, а также аффективные суждения о реляционной безопасности и комфорте28,29,30. При использовании ИИ в медицине пользователи оценивают как способность системы поддержать принятие решения о здоровье, так и то, кажется ли взаимодействие с ней достаточно безопасным и доступным. Экспертный фрейминг должен сделать более выраженной оценку, ориентированную на компетентность. Данные исследований систем поддержки принятия клинических решений указывают на то, что объяснения и информация о принципах работы системы влияют на доверие и опору на неё31. В онлайн-консультациях по вопросам здоровья персонализация и забота также связаны с доверием и принятием9. Воспринимаемый профессионализм отражает ориентированную на компетентность оценку, имеющую значение для доверия25. Исследования онлайн-консультаций по вопросам здоровья аналогичным образом определяют достоверность источника как значимый фактор принятия пользователями рекомендаций по здоровью32. Таким образом, настоящее исследование проверяет, связан ли экспертный фрейминг с более высоким уровнем воспринимаемого профессионализма.
H1: Роли компаньона создают более низкое восприятие профессионализма по сравнению с медицинским ИИ в экспертном стиле.
Фрейминг компаньона должен сделать реляционную оценку более выраженной. Социальное присутствие относится к воспринимаемому межличностному качеству опосредованного взаимодействия, а не к убеждению в том, что система является человеком33. Оно связано с качеством взаимодействия, доверием и принятием в онлайн-сервисах и разговорных агентах в сфере здравоохранения15,34.
Социальное присутствие может снизить психологическую стоимость самораскрытия и способствовать обмену информацией во время онлайн-консультаций32. Таким образом, настоящее исследование проверяет, связано ли фреймирование в формате сопровождения с более высоким уровнем социального присутствия.
H2: Экспертные роли обеспечивают более низкое социальное присутствие по сравнению с медицинскими ИИ в стиле компаньона.
Воспринимаемый профессионализм и социальное присутствие рассматриваются как параллельные, неисключающие друг друга факторы, связанные с доверием. Надлежащая степень опоры на автоматизацию в критических ситуациях зависит от возможностей системы, ее ограничений и требований к задаче, а не только от максимизации доверия35.
H3: Воспринимаемый профессионализм и социальное присутствие при одновременном моделировании положительно предсказывают уровень доверия.
Модерирующий эффект контекста задачи
Одни и те же ролевые признаки могут иметь разный психологический вес в зависимости от медицинских задач. Концепция соответствия задачи и технологии (task-technology fit) дает контекстуальное обоснование для изучения того, насколько ролевые признаки согласуются с требованиями задачи36. Консультация по поводу заболевания сопряжена с более высокой степенью неопределенности, риском потерь и стоимостью ошибок, что делает профессионализм, точность и четкие границы особенно значимыми7,37. Следовательно, признаки эксперта должны быть более тесно согласованы с этими требованиями, чем признаки компаньона. Консультации по вопросам здоровья сосредоточены на долгосрочном управлении здоровьем, устойчивости поведенческих изменений и непрерывности взаимодействия. Обзоры систем поддержки принятия клинических решений на базе ИИ и разговорных агентов в сфере здравоохранения подчеркивают важность контекстуальной информации, возможности реализации действий, взаимодействия и условий внедрения3,38,39.
В данном исследовании прогнозируется, что разница в восприятии профессионализма между экспертом и компаньоном будет более выраженной при консультации по поводу болезни, чем при консультации по вопросам здоровья. Отсутствие статистически значимого взаимодействия в отношении социального присутствия не рассматривается как доказательство инвариантности. Гипотеза сформулирована следующим образом:
H4: Контекст задачи значительно модерирует влияние экспертных ролей на воспринимаемый профессионализм. Влияние сильнее при консультации по поводу болезни, чем при консультации по вопросам здоровья.
Протокол
Обзор исследования
Исследование проводилось в соответствии с Хельсинкской декларацией и было одобрено комитетом по этике Университета Хуацяо (M2025021), разрешение которого распространялось как на эксперимент в онлайн-сценарии, так и на ЭЭГ-эксперимент. Все участники предоставили информированное согласие и получили компенсацию по завершении исследования.
Данная работа содержит два взаимодополняющих исследования (см. Рисунок 1). Исследование 1 представляет собой рандомизированный сценарный эксперимент по схеме 2 × 2, в котором оцениваются эффекты фрейминга роли и контекста задачи, анализируется структура измерений и тестируются параллельные условные косвенные связи через воспринимаемый профессионализм и социальное присутствие. Исследование 2 является внутрисубъектным ЭЭГ-экспериментом, в котором сравнивается активность в тета-диапазоне при высказываниях с фреймингом «эксперт» и «компаньон»; данное исследование интерпретируется как разведочное сравнение на уровне процессов. Эти исследования предоставляют поведенческие и нейронные доказательства на разных уровнях; они не рассматриваются как единый прогрессирующий механизм.
Исследование 1: Сценарный эксперимент
Участники и дизайн исследования
В исследовании 1 использовался сбалансированный межгрупповой дизайн 2 × 2 с факторами фрейминга роли (эксперт против компаньона) и контекста задачи (консультация по поводу болезни против консультации по вопросам здоровья). Первоначальный расчет в G*Power предполагал средний общий эффект ANOVA (f = 0.25), α = .05 и мощность = .80, что указывало на необходимость минимум 128 участников40. Поскольку этот расчет не был адаптирован для анализа условных косвенных эффектов, он приводится как исходная основа для набора участников, а не как доказательство мощности для модерируемой медиации. При N = 300 и четырех сбалансированных группах анализ чувствительности показал мощность 80% для обнаружения взаимодействия f = 0.162 (частичный η2 = .026) при α = .05.
Кроме того, мы провели апостериорный анализ мощности на основе симуляции для индексов модерируемой медиации, используя набор данных опроса SPSS из 300 случаев. В ходе симуляции было создано 1000 сбалансированных выборок 2 × 2 из подогнанной модели параллельных медиаторов путем повторного сэмплирования эмпирических остатков; для каждого симулированного набора данных использовались 500 процентильных бутстрэп-доверительных интервалов с повторным сэмплированием случаев. Оценочные вероятности того, что доверительный интервал не будет включать ноль, составили .698 для индекса профессионализма, .157 для индекса социального присутствия и .279 для прямой разности между этими двумя индексами. Данный анализ основан на наблюдаемых коэффициентах, распределениях остатков и спецификации модели и не является априорным обоснованием размера выборки. Полный апостериорный анализ мощности на основе симуляции представлен в Дополнительной таблице S1.
Триста участников были набраны через Credamo и случайным образом распределены по четырем условиям (n = 75 в каждой группе). Выборка включала 109 мужчин (36,3%) и 191 женщину (63,7%); 43,7% находились в возрасте 21-30 лет, 41,3% — в возрасте 31-40 лет, и 69,7% имели степень бакалавра. Все обязательные пункты опросника были заполнены. Специальные контрольные вопросы на внимательность или предварительно зарегистрированные критерии исключения по времени заполнения не использовались, и ни один участник не был исключен. Медианное время заполнения составило 268 s (диапазон = 67-1,894 s). Для оценки чувствительности к необычно быстрым ответам был проведен апостериорный анализ робастности с исключением ответов, время заполнения которых было ниже пятого процентиля (<125 s; осталось n = 285). Подробные статистические данные проверки манипуляций и анализ чувствительности к времени заполнения представлены в Дополнительной таблице S2.
Экспериментальные стимулы и процедура
Стимулирующие материалы состояли из введения в сценарий задачи и ответа в диалоге с ИИ-врачом, что в совокупности составило четыре полных экспериментальных набора. В сценарии консультации по поводу болезни участникам предлагалось представить себе рецидивирующее ночное чувство стеснения в груди и сердцебиение, а также обеспокоенность по поводу необходимости немедленного обращения в больницу. В сценарии консультации по вопросам здоровья участникам предлагалось представить, что они в целом здоровы и стремятся получить индивидуальный план питания и физических упражнений. Каждая категория задач была представлена одним сценарием; следовательно, выводы ограничены этими двумя сценариями и не могут быть обобщены на все виды консультаций по поводу болезней и здоровья.
На всех четырех скриншотах анкет использовалась одна и та же иконка и отображалось название системы Medical AI (DiagnosPro), что обеспечивало неизменность визуальной идентификации во всех условиях. Ответы в рамках экспертной роли основывались на структурированном анализе, заявлениях о рисках или доказательствах, директивном языке и четких рекомендациях по действиям. Ответы в рамках роли компаньона характеризовались эмпатией, словами поддержки, совместными формулировками и гибкими предложениями. Таким образом, данное воздействие представляло собой совокупность соответствующих роли коммуникационных и информационных сигналов; оно не отделяло фрейминг роли от конкретики, применимости действий, уверенности, медицинских деталей или эмоциональной поддержки. Общее название DiagnosPro также могло служить экспертным сигналом во всех условиях. Полный набор стимулов представлен в Дополнительном файле 1.
Сначала участники ознакомились с формой информированного согласия, после чего были случайным образом распределены по одной из четырех экспериментальных групп. После прочтения сценария и стимулирующего диалога они заполнили опросник в соответствии со своими ответами. Опросник начинался с проверок манипуляции, за которыми следовали показатели воспринимаемого профессионализма, социального присутствия, доверия и демографические данные. Процедура занимала примерно 15 min.
Во всех шкалах использовалась 7-балльная шкала Лайкерта, где 1 означало «полностью не согласен», а 7 — «полностью согласен». Воспринимаемый профессионализм измерялся с помощью трех пунктов: «Этот медицинский ИИ способен давать медицинские рекомендации», «Этот медицинский ИИ кажется очень профессиональным» и «Этот медицинский ИИ является экспертом в области медицины» (α = .883)41. Социальное присутствие измерялось с помощью трех пунктов: «Во взаимодействии с этим медицинским ИИ я ощущал человеческое отношение», «Взаимодействие с этим медицинским ИИ позволило мне почувствовать близость» и «Этот медицинский ИИ казался общительным во время взаимодействия» (α = .932)42. Когнитивное доверие включало три пункта: «Я могу полагаться на этот медицинский ИИ, потому что он обладает навыками, необходимыми для предоставления рекомендаций», «Я уверен в точности рекомендаций, предоставляемых этим медицинским ИИ» и «Этот медицинский ИИ обладает достаточными возможностями для решения моей проблемы со здоровьем» (α = .837). Аффективное доверие включало три пункта: «Этот медицинский ИИ вызывает у меня чувство тепла и заботы», «Полагаясь на этот медицинский ИИ, я чувствую себя в безопасности, так как он, по всей видимости, заботится о моем здоровье» и «Я верю, что этот медицинский ИИ не станет намеренно делать что-либо вредное для меня» (α = .700). Общее доверие представляло собой среднее значение всех шести пунктов доверия (α = .784). Эти показатели анализировались как результаты, ориентированные на компетенцию, межличностные результаты, когнитивное доверие, аффективное доверие и общее доверие, а не как взаимоисключающие конструкты.
Анализ проводился в четыре этапа. Во-первых, с помощью подтверждающего факторного анализа предлагаемая четырехфакторная модель сравнивалась с двухфакторной и однофакторной альтернативами; изучались композитная надежность, средняя извлеченная дисперсия, латентные корреляции и коэффициенты гетеротрайт-монотрайт. Во-вторых, с использованием полных факторных моделей 2 x 2 оценивались основные эффекты и эффекты взаимодействия для воспринимаемого профессионализма, социального присутствия, когнитивного доверия, аффективного доверия и общего доверия с расчетом средних значений по ячейкам, доверительных интервалов и частичного η2. Оцененные предельные средние и 95% доверительные интервалы представлены на рисунке 2. В-третьих, в программе PROCESS 4.2 beta (модель 7) воспринимаемый профессионализм и социальное присутствие вводились одновременно в качестве параллельных медиаторов с использованием 5 000 процентильных бутстреп-выборок43. Фрейминг роли кодировался как 1 = эксперт и 2 = компаньон, а контекст задачи как 1 = консультация по болезни и 2 = консультация по здоровью. Бутстреп с общим ресемплированием использовался для прямого сопоставления двух индексов модерируемой медиации. В-четвертых, когнитивное и аффективное доверие анализировались отдельно в качестве эксплораторных результатов. Поскольку медиаторы и результаты измерялись одновременно, полученные оценки интерпретируются как косвенные связи, согласующиеся с медиацией, а не как причинно-следственные психологические механизмы.
Исследование 2: ЭЭГ-эксперимент
Участники
В исследование 2 было включено 40 участников. Один участник был исключен, так как количество проб, загрязненных артефактами, превысило 30% как минимум в одном экспериментальном условии; таким образом, для окончательного ЭЭГ-анализа осталось 39 участников. Данный критерий гарантировал, что каждый оставшийся участник внес вклад в объеме не менее 70% проб в каждом условии. Все участники предоставили письменное информированное согласие и получили компенсацию после завершения эксперимента. Демографическая информация не смогла быть сопоставлена со всеми сохраненными записями ЭЭГ и поэтому не представлена в обобщенном виде для итоговой выборки ЭЭГ.
Экспериментальные стимулы и процедура
Эксперимент проводился в стандартной лаборатории ЭЭГ с использованием внутрисубъектного дизайна; стимулы предъявлялись с помощью программы E-Prime 2.1. Участникам было предложено представить взаимодействие с медицинской системой ИИ и оценить степень своего доверия к системе в каждом сценарии медицинской консультации. В ходе эксперимента варьировалась воспринимаемая роль медицинской системы ИИ, включая варианты в виде «эксперта» и «компаньона».
Было разработано в общей сложности 40 стимулов в виде предложений на китайском языке. Условие «эксперт» включало 20 стимулов, начинающихся с фразы «Медицинский ИИ-эксперт», в то время как условие «компаньон» включало 20 параллельных стимулов, начинающихся с фразы «Медицинский ИИ-компаньон». Медицинские сценарии охватывали как профессиональные диагностические функции, такие как сбор анамнеза, анализ отчетов об обследовании, оценка данных о частоте сердечных сокращений, интерпретация генетических тестов, определение риска заболевания и рекомендация планов лечения, так и вспомогательные функции управления здоровьем, такие как проявление заботы о физическом состоянии, вопросы о качестве сна, облегчение тревожности, запись данных о здоровье, поощрение соблюдения режима лечения и предоставление ежедневных советов по здоровью. Таким образом, условия также различались по семантическому содержанию и сложности; независимый подбор стимулов или предварительное тестирование не проводились.
Перед началом основного эксперимента участники выполнили короткий тренировочный блок. Каждая проба начиналась с фиксационного креста в течение 500 ms, за которым следовал варьируемый пустой интервал длительностью 300–500 ms и утверждение от медицинского ИИ, которое отображалось в течение 1,600 ms. Затем участники в собственном темпе выносили бинарное суждение о доверии, нажимая клавишу F для подтверждения доверия или клавишу J для указания на отсутствие доверия (см. Рисунок 3). Утверждения, сформулированные от лица эксперта и компаньона, предъявлялись в рандомизированном порядке. Журналы заданий E-Prime зафиксировали по 80 основных проб для каждой записи задания: 40 проб с экспертом и 40 проб с компаньоном, при этом каждое из 20 уникальных утверждений для каждой роли предъявлялось дважды.
Данные поведенческого теста
Данные поведенческого теста были пригодны для анализа у 38 из 39 участников итоговой выборки ЭЭГ; запись выполнения задания одного участника в программе E-Prime была непригодна. Таким образом, для поведенческого анализа было использовано N = 38. Подробные результаты поведенческого анализа и учет выборки приведены в Дополнительной таблице S3. Доверие кодировалось как нажатие клавиши F; нажатие клавиши J означало отсутствие доверия. Пустые ответы или зафиксированное время реакции 0 ms кодировались как пропущенные данные. Частота доверия рассчитывалась по ответам в завершенных пробах, а время реакции суммировалось по всем отвеченным пробам. Нейронные данные, доступные для анализа, содержали показатели, агрегированные по условиям, но не включали показатели ЭЭГ на уровне отдельных проб или проверенный идентификатор, связывающий каждую запись поведения с соответствующей записью ЭЭГ; следовательно, смешанная модель ЭЭГ и суждений о доверии на уровне отдельных проб не рассчитывалась.
Регистрация и анализ ЭЭГ
Для поддержания импеданса между электродом и кожей на уровне ниже 5 kOhm использовали электропроводящий гель Quik-Gel. В качестве стандартного онлайн-референса устройства был выбран электрод FCz, частота дискретизации составила 1,000 Hz. Офлайн-пересчет референса на среднее значение по двум сосцевидным отросткам выполняли с помощью встроенной функции пересчета референса в программе CURRY; сигнал FCz был сохранен и автоматически реконструирован относительно нового референса без использования специальных команд реконструкции или скриптов. Последующая офлайн-обработка проводилась в MATLAB R2020b с использованием EEGLAB44 и ICLabel45. Частота дискретизации данных была снижена до 500 Hz, и был применен полосовой фильтр в диапазоне от 0.1 до 40 Hz. Плохие каналы и сегменты данных с грубыми помехами определяли и удаляли путем визуального анализа; автоматическая интерполяция или автоматические пороги отсева сегментов не применялись. Затем использовали стандартную реализацию runica в EEGLAB (Infomax ICA), и компоненты удаляли, если ICLabel присваивал вероятность не менее .70 классу артефактов (например, глазным, мышечным, сердечным, сетевым помехам или шуму каналов). Участники, у которых более 30% попыток в любом из условий были загрязнены артефактами, исключались из анализа, что обеспечивало сохранение не менее 70% попыток для каждого условия. Эпохи охватывали интервал от −1,000 до 1,996 ms. Для анализа функциональной связности предварительно обработанные данные подвергались дальнейшему снижению частоты дискретизации до 250 Hz, а периферические электроды, включая P7, P8, F7 и F8, исключались перед оценкой фазовой синхронности.
Тета-активность, регистрируемая в фронтально-срединных областях скальпа, была связана с вычислениями, обусловленными требованиями когнитивного контроля46. Фазовая синхронизация в тета-диапазоне между медиальными и латеральными фронтальными электродами также была связана с координацией во время процессов, связанных с контролем47. В частности, усиление фазовой синхронизации в тета-диапазоне между такими точками, как FCz и F6, наблюдалось после обнаружения конфликта или ошибки48. Поскольку эти показатели скальпа не являются специфичными исключительно для когнитивного контроля, здесь они рассматриваются как конвергентные индикаторы процессов, а не как прямые показатели одного когнитивного механизма.
Во-первых, была количественно определена фронтально-срединная тета-синхронизация, вызванная событием (ERS), в диапазоне 4–8 Hz в окне 800–1,000 ms после стимула. ERS рассчитывали с помощью частотно-временного анализа, при этом относительное изменение мощности вычисляли по отношению к базовой линии перед стимулом от −500 до −200 ms. Положительные значения указывают на усиление мощности (синхронизацию), в то время как отрицательные значения указывают на подавление мощности (десинхронизацию). Во-вторых, функциональная связность оценивалась после дополнительного понижения частоты дискретизации предварительно обработанных данных до 250 Hz и исключения периферических электродов, включая P7, P8, F7 и F8. Перед расчетом значения фазовой синхронизации (PLV) в тета-диапазоне между FCz и F6 применялось кратковременное преобразование Фурье (STFT). Изменение PLV с поправкой на базовую линию (ΔPLV) вычисляли относительно базовой линии перед стимулом от −600 до −200 ms. Исходное значение PLV ограничено диапазоном от 0 до 1; следовательно, отрицательные значения ΔPLV указывают на снижение относительно базовой линии, а не на отрицательную фазовую синхронизацию. Эти показатели скальпа интерпретируются как исследовательские паттерны, связанные с процессами контроля и префронтальной координацией; они не идентифицируют напрямую конкретный когнитивный процесс или нейронный источник.
Результаты
Исследование 1: Результаты сценарного эксперимента
Измерительная модель. Четырехфакторная модель продемонстрировала лучшее соответствие, чем двухфакторная и однофакторная альтернативы, однако показатели абсолютного соответствия были неоднозначными: χ2(48) = 23.93, p < .01; CFI = .935; TLI = .91; RMSEA = .1; SRMR = .140. Стандартизированные нагрузки варьировали от .382 до .937. Композитная надежность составила .86 для воспринимаемого профессионализма, .932 для социального присутствия, .840 для когнитивного доверия и .709 для аффективного доверия; соответствующие значения AVE составили .72, .821, .636 и .474. Дискриминантная валидность была ограничена: значения HTMT составили .935 между воспринимаемым профессионализмом и когнитивным доверием, и .926 между социальным присутствием и аффективным доверием. В связи с этим результаты условного процесса интерпретируются с осторожностью, а анализы доверия по конкретным измерениям носят поисковый характер (Таблица 1).
Проверка манипуляций. Участники из группы «экспертного позиционирования» (n = 150, M = 5.57, SD = 1.18) оценили медицинский ИИ как более экспертный, чем участники из группы «позиционирования в качестве компаньона» (n = 150, M = 3.21, SD = 1.76). Поскольку дисперсии различались (F = 47.42, p < .01), использовался t-критерий Уэлча: t(259.90) = 13.63, p < .01, средняя разность = 2.36, 95% CI [2.02, 2.70]. Участники с состоянием болезни (n = 150, M = 2.51, SD = 1.53) дали более низкие оценки ориентации на профилактику здоровья, чем участники со здоровым состоянием (n = 150, M = 5.98, SD = 1.2), F = 10.96, p = .001; t-критерий Уэлча t(284.1) = −21.70, p < .01, средняя разность = −3.47, 95% CI [−3.79, −3.16]. Степени свободы по Уэлчу не равны N − 2 при неравенстве дисперсий; во всех анализах использовалось N = 30.
Описательная статистика по условиям эксперимента. При фрейминге «эксперт» консультации по вопросам болезни и здоровья дали средние значения воспринимаемого профессионализма 5,69 (SD = 0,83) и 5,85 (SD = 0,63), среднего значения социального присутствия 4,28 (SD = 1,54) и 4,25 (SD = 1,64) и среднего значения общего доверия 5,45 (SD = 0,86) и 5,28 (SD = 0,87) соответственно. При фрейминге «компаньон» соответствующие средние значения для болезни и здоровья составили 4,52 (SD = 1,47) и 5,25 (SD = 0,94) для воспринимаемого профессионализма, 5,68 (SD = 1,07) и 5,93 (SD = 0,74) для социального присутствия и 5,30 (SD = 1,02) и 5,61 (SD = 0,64) для общего доверия. В Таблице 2 приведены все доверительные интервалы для конкретных условий и полные результаты факторного анализа.
Полные результаты факторного анализа. Для воспринимаемого профессионализма был выявлен главный эффект формулирования роли, F(1, 296) = 56.92, p < .01, partial η2 = .161, главный эффект контекста задачи, F(1, 296) = 14.37, p < .001, partial η2 = .046, а также взаимодействие роли × задачи, F(1, 296) = 5.89, p = .016, partial η2 = .020. Социальное присутствие продемонстрировало главный эффект формулирования роли, F(1, 296) = 105.57, p < .01, partial η2 = .263, однако ни главный эффект задачи, F(1, 296) = 0.59, p = .42, ни взаимодействие, F(1, 296) = 0.84, p = .359, не были значимыми. Последний результат указывает на отсутствие обнаруженной модерации; это не устанавливает эквивалентность между задачами. Для когнитивного доверия взаимодействие роли × задачи было значимым, F(1, 296) = 5.60, p = .019, partial η2 = .019; соответствующее взаимодействие не было значимым для аффективного доверия, F(1, 296) = 3.48, p = .063, partial η2 = .012. Общее доверие не показало главного эффекта формулирования роли, F(1, 296) = 0.81, p = .369, или главного эффекта задачи, F(1, 296) = 0.5, p = .459, но взаимодействие роли × задачи было значимым, F(1, 296) = 5.78, p = .017, partial η2 = .019. При консультации по поводу болезни общее доверие не различалось между формулировками «компаньон» и «эксперт», mean difference = −0.15, SE = 0.14, t(296) = −1.06, p = .28, 95% CI [−0.42, 0.13]. При консультации по вопросам здоровья общее доверие было выше при формулировке «компаньон», mean difference = 0.3, SE = 0.14, t(296) = 2.34, p = .020, 95% CI [0.05, 0.60].
Параллельные условные косвенные связи. При одновременном включении воспринимаемого профессионализма и социального присутствия оба показателя положительно коррелировали с общим доверием: b = 0.4872, SE = 0.0258, p < .01, 95% CI [0.4294, 0.5460] и b = 0.3293, SE = 0.0208, p < .001, 95% CI [0.2762, 0.3829] соответственно. Прямая связь с фреймингом роли не была значимой, b = 0.019, SE = 0.0680, p = .861, 95% CI [−0.1071, 0.1361]. Косвенные связи для профессионализма составили −0.5695 при консультации по болезни, 95% bootstrap CI [−0.7687, −0.3851], и −0.2923 при консультации по здоровью, 95% bootstrap CI [−0.428, −0.1634]. Косвенные связи для социального присутствия составили 0.4625 при консультации по болезни, 95% bootstrap CI [0.3165, 0.6091], и 0.532 при консультации по здоровью, 95% bootstrap CI [0.3855, 0.7383] (Таблица 3). Индекс модерируемой медиации через воспринимаемый профессионализм составил 0.272, 95% bootstrap CI [0.0594, 0.5035], тогда как индекс через социальное присутствие составил 0.0907, 95% bootstrap CI [−0.0984, 0.308]. Прямой бутстреп-контраст между индексами не был значимым, разность = 0.1864, 95% bootstrap CI [−0.0856, 0.47]. Таким образом, результаты подтверждают контекстуальную модерацию косвенной связи с профессионализмом, но не устанавливают статистически значимых различий в контекстуальной модерации этих двух связей.
Разведочный анализ измерений доверия. Для когнитивного доверия контраст между индексами модерируемой медиации профессионализма и социального присутствия был положительным: разность = 0.3707, 95% бутстреп-ДИ [0.0493, 0.696]. Для аффективного доверия соответствующий контраст не получил подтверждения: разность = 0.002, 95% бутстреп-ДИ [−0.3421, 0.3127]. Оба медиатора сохранили положительную связь с обоими измерениями доверия, что указывает на перекрестные пути, а не на эксклюзивные эффекты. Учитывая высокие значения HTMT, данные результаты не следует интерпретировать как окончательное разделение когнитивных и аффективных механизмов.
Апостериорная мощность модерируемой медиации. Согласно подогнанной модели и допущениям о ресэмплинге остатков, расчетная вероятность того, что процентильный бутстреп-доверительный интервал не будет включать ноль, составила .698 для индекса профессионализма, .157 для индекса социального присутствия и .279 для их прямой разности (1 0 симуляций; 50 бутстреп-ресэмплов на симуляцию). Эти оценки, основанные на наблюдаемом дизайне, объясняют, почему подтвержденный индекс профессионализма и незначимый прямой контраст не следует интерпретировать как убедительные доказательства различной контекстуальной модерации.
Устойчивость результатов по времени выполнения. После исключения 15 ответов, полученных менее чем за 125 s, осталось 285 случаев. Взаимодействие общего доверия осталось значимым, p = .029; индекс профессионализма остался подтвержденным, 95% bootstrap CI [0.0242, 0.4827]; а контраст между индексами модерируемой медиации остался незначимым, 95% bootstrap CI [−0.1027, 0.4506]. Основные выводы не зависели от 5% самых быстрых ответов.
Исследование 2: результаты ЭЭГ
Фронто-медиальный тета-ERS. В итоговой аналитической выборке (N = 39) тета-ERS в диапазоне 4–8 Гц в окне 80–10 мс была выше при экспертном фрейминге (M = 0,2948, SD = 0,8218), чем при фрейминге компаньона (M = −0,042, SD = 1,215); средняя разность = 0,369, 95% ДИ [0,0125, 0,614], t(38) = 2,10, p = ,042, d Коэна (dz) = 0,37, парциальный η2 = .104. Значение p с поправкой Холма для двух указанных парных результатов ЭЭГ составило .042. Эта разница указывает на дифференцированную обработку в тета-диапазоне в данном временном окне задачи; одна лишь тета-ERS не позволяет идентифицировать конкретный психологический процесс.
Изменение theta PLV с коррекцией по базовой линии для пары FCz-F6 (ΔPLV). В окончательной аналитической выборке (N = 39) theta ΔPLV было менее отрицательным при экспертном фрейминге (M = −0.01, SD = 0.0546), чем при фрейминге компаньона (M = −0.0350, SD = 0.0473), средняя разница = 0.0239, 95% CI [0.058, 0.0420], t(38) = 2.68, p = .01, dz Коэна = 0.429, partial η2 = .159. Значение p с поправкой Холма для двух представленных парных результатов ЭЭГ составило .02. Такая закономерность указывает на меньшее снижение фазовой согласованности theta относительно базовой линии при экспертном фрейминге; само по себе это не доказывает наличие более сильного префронтального контроля или специфического когнитивного механизма (см. Рисунок 4 и Таблицу 4).
Результаты поведенческого задания. В 38 проанализированных записях выполнения задания частота ответов доверия составила 83.1% (SD = 15.8%) при формулировке «эксперт» и 82.4% (SD = 17.5%) при формулировке «компаньон», средняя разница = 0.7 процентных пункта, 95% CI [−0.9, 2.4], t(37) = 0.91, p = .371, dz = 0.147. Среднее время реакции составило 828.7 ms (SD = 204.6) и 826.1 ms (SD = 208.9) соответственно, средняя разница = 2.5 ms, 95% CI [−14.0, 19.1], t(37) = 0.31, p = .758, dz = 0.050. Частота отсутствия ответов составила 6.3% (SD = 7.4%) и 5.2% (SD = 6.3%) соответственно, средняя разница = 1.1 процентных пункта, 95% CI [−1.0, 3.1], t(37) = 1.05, p = .302, dz = 0.170.
Заявление о доступности данных:
Обезличенные данные опросников Исследования 1, предварительно обработанные файлы ЭЭГ и сводные выходные файлы ЭЭГ, использованные в Исследовании 2, общедоступны на платформе Open Science Framework (OSF) по адресу https://doi.org/10.17605/OSF.IO/JKSP7. Дополнительные материалы включают полный набор экспериментальных стимулов (Дополнительный файл 1), проверки манипуляций, дополнительные поведенческие анализы, апостериорный анализ статистической мощности и вспомогательную методологическую информацию.
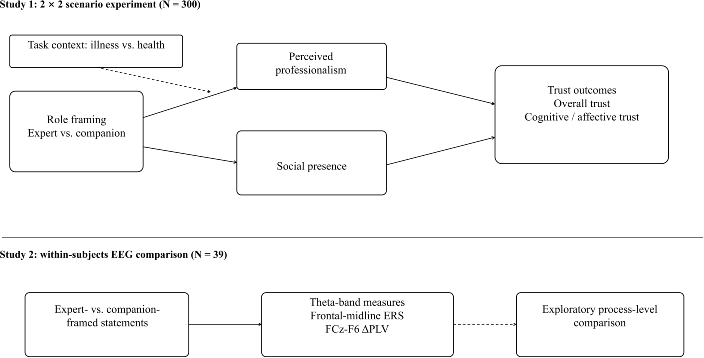
Рисунок 1Основа исследования. Исследование 1 представляет собой сценарный эксперимент с дизайном 2 × 2 (N = 30), в котором изучаются фрейминг роли, контекст задачи и параллельные косвенные связи через воспринимаемый профессионализм и социальное присутствие. Исследование 2 содержит эксплоративное сравнение показателей электроэнцефалограммы для утверждений, сформулированных в категориях «эксперт» и «компаньон» (N = 39); в нем не проводится прямая проверка модели условного косвенного влияния. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
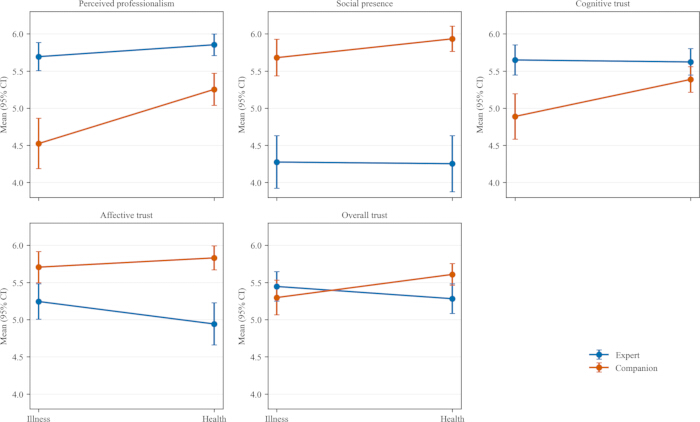
Рисунок 2Графики взаимодействия ролевого фрейминга и контекста задачи для показателей воспринимаемого профессионализма, социального присутствия, когнитивного доверия, аффективного доверия и общего доверия. Точки обозначают средние значения по группам, а планки погрешностей — 95%-ные доверительные интервалы (n = 75 в каждой группе). Пожалуйста, нажмите здесь, чтобы просмотреть этот рисунок в более крупном размере.
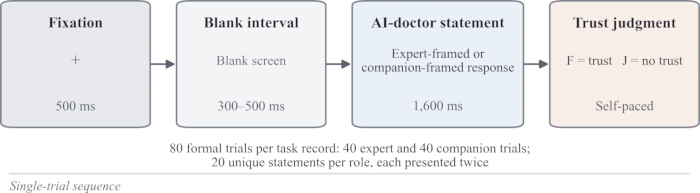
Рисунок 3Последовательность одного пробного испытания в исследовании 2. Каждая проба включала фиксацию в течение 50 мс, пустой интервал с варьируемой длительностью (джиттером) от 30 до 50 мс, утверждение ИИ-врача с фреймингом «эксперт» или «компаньон» длительностью 160 мс и бинарную оценку доверия, выполняемую испытуемым в собственном темпе. Согласно логам заданий в программе E-Prime, в каждой записи было зафиксировано 80 формальных проб: по 40 проб для каждого условия фрейминга роли и по два предъявления каждого из 20 уникальных утверждений в рамках каждого условия. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
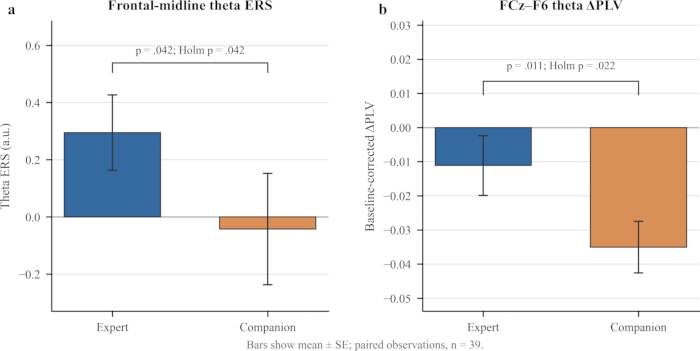
Рисунок 4Влияние фрейминга роли медицинского ИИ на фронтально-медиальную тета-ERS и PLV в тета-дельта диапазонах между электродами FCz и F6. (A) Фронто-медиальная тета-синхронизация, вызванная событием. (B) Изменение значения фазовой синхронизации (ΔPLV) тета-ритма между электродами FCz и F6 с поправкой на базовую линию; отрицательные значения указывают на снижение относительно предстимульного базового уровня. Столбцы отображают среднее значение ± стандартную ошибку (SE) для n = 39. Парные t-критерии дали p = 0,042 для тета-ERS и p = 0,01 для ΔPLV; значения p с поправкой Холма для этих двух зарегистрированных результатов составили 0,042 и 0,022 соответственно. Сокращения: Нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Таблица 1: Диагностика измерительной модели для Исследования 1. В таблице представлены стандартизированные нагрузки, α Кронбаха, композитная надежность, средняя извлеченная дисперсия, латентные корреляции и значения HTMT для воспринимаемого профессионализма, социального присутствия, когнитивного доверия и аффективного доверия. N = 30. Четырехфакторная модель подошла лучше, чем альтернативные варианты, однако показатели RMSEA и SRMR указали на слабый абсолютный уровень соответствия, а два значения HTMT превысили .90. Сокращения: CR = композитная надежность; AVE = средняя извлеченная дисперсия; HTMT = отношение гетеротрайта к монотрайту. Пожалуйста, нажмите здесь, чтобы скачать эту таблицу.
Таблица 2: Описательная статистика для четырех условий и полные результаты 2 × 2 факторного анализа для Исследования 1. В ячейках указаны n, среднее значение, стандартное отклонение и 95% доверительный интервал; результаты факторного анализа представлены значениями F, p и частичного η2. N = 30; n = 75 на ячейку. Фрейминг роли был закодирован как 1 = эксперт и 2 = компаньон; контекст задачи был закодирован как 1 = болезнь и 2 = консультация по здоровью. Коэффициенты и доверительные интервалы являются нестандартизированными. Пожалуйста, нажмите здесь, чтобы скачать эту таблицу.
Таблица 3: Параллельные условные косвенные связи в Исследовании 1. N = 30. Фрейминг роли кодировался как 1 = эксперт и 2 = компаньон; контекст задачи кодировался как 1 = консультация по болезни и 2 = консультация по здоровью. Воспринимаемый профессионализм и социальное присутствие вводились одновременно. Оценки являются нестандартизированными, а для расчета доверительных интервалов методом процентильного бутстрепа использовалось 5 0 ресэмплов. Таблица включает условные косвенные связи, оба индекса модерируемой медиации и их прямой бутстреп-контраст. Прямой контраст между двумя индексами модерируемой медиации для общего доверия составил 0,1864, 95% CI [-0,0856, 0,47]. Пожалуйста, нажмите здесь, чтобы скачать эту таблицу.
Таблица 4: Парные результаты ЭЭГ в Исследовании 2. N = 39 парных наблюдений в итоговой аналитической выборке. В таблице представлены средние значения по условиям, парные разности средних, 95% доверительные интервалы, результаты парных t -критериев, dz Коэна, частичный η2 и p-значения с поправкой Хольма для фронтально-срединного тета-ERS и скорректированного по базовой линии FCz-F6 тета-ΔPLV. Поправка Хольма применяется только к двум представленным парным результатам ЭЭГ и не подразумевает проведение какого-либо недокументированного более широкого поиска по электродам, частотным диапазонам или временным окнам. Пожалуйста, нажмите здесь, чтобы скачать эту таблицу.
Дополнительный файл 1: Экспериментальные стимулы, использованные в Исследовании 1. Файл содержит полный текст ответов медицинского ИИ, сформулированных в экспертном и партнерском стилях, которые использовались в сценариях консультации по болезни и консультации по вопросам здоровья. Предоставлены как оригинальный китайский текст, так и перевод на английский язык.Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Дополнительная таблица S1. Апостериорный анализ статистической мощности на основе симуляций для модели модерируемой медиации. Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Дополнительная таблица S2. Статистика проверки манипуляций и анализ чувствительности времени выполнения для Исследования 1. Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Дополнительная таблица S3. Результаты поведенческого теста, учет выборки и описательная статистика для Исследования 2. Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Обсуждение
Теоретическое значение
Два исследования предоставляют доказательства на разных уровнях. Исследование 1 выявляет связи между ролью и задачей, а также параллельные косвенные связи в рандомизированном сценарном эксперименте, в то время как Исследование 2 представляет собой эксплоративное сравнение данных ЭЭГ на уровне процессов. Таким образом, данные исследования подтверждают ограниченный подход к оценке в рамках ролевого фрейминга, а не единый прогрессивный механизм. Полученные результаты расширяют теорию ролевого соответствия применительно к медицинскому ИИ, рассматривая соответствие как согласованность между ролевыми признаками и значимыми для задачи оценочными требованиями22. Эта интерпретация отличается от концепций содержания компетентности-теплоты и соответствия задачи и технологии. Результаты, касающиеся неприятия алгоритмов и признания их ценности, можно интерпретировать как контекстно-зависимые оценки того, насколько ролевые признаки и признаки возможностей соответствуют задаче49,50.
Результаты также подтверждают наличие параллельных, неисключающих друг друга связей между фреймингом роли, воспринимаемым профессионализмом, социальным присутствием и доверием. Поскольку профессионализм перекрывается с когнитивным доверием, а социальное присутствие — с аффективным доверием, полученные данные свидетельствуют о дифференцированном оценочном содержании, но не о двух четко разделенных механизмах. Взаимодействие роли и задачи в отношении воспринимаемого профессионализма согласуется с предложенной концепцией конгруэнтности ролей. Данные подтверждают контекстуальную модерацию связи с профессионализмом, однако они не устанавливают статистически асимметричных контекстуальных механизмов или инвариантности в пути социального присутствия.
Результаты ЭЭГ обеспечивают исследовательский взгляд на уровне процессов. Высказывания, сформулированные экспертами, сопровождались отчетливыми паттернами в тета-диапазоне, однако условия также различались по семантическому содержанию и сложности, а поведение на уровне условий не выявило достоверных различий в уровне доверия. Таким образом, показатели ЭЭГ не устанавливают отдельный механизм когнитивного контроля или доверия. Нейронные результаты следует рассматривать как гипотетические. В исследовании 2 не проводилось манипуляций с контекстом задачи, не измерялись воспринимаемый профессионализм или социальное присутствие, а также не устанавливалась связь между индексами ЭЭГ на уровне отдельных проб и суждениями о доверии; следовательно, результаты ЭЭГ дополняют, а не подтверждают условную косвенную модель.
Полученные результаты свидетельствуют о наличии умеренного, а не максимального доверия. Степень опоры на автоматизированную систему должна быть откалибрована в соответствии с возможностями системы, ее ограничениями и требованиями задачи35. В смежных работах описываются адаптивные когнитивные механизмы, которые могут поддерживать калиброванное доверие и уверенность в системе51. Подход NeuroIS обосновывает использование нейронных показателей в качестве дополнения к поведенческим данным при изучении процессов с высоким временным разрешением52. Предыдущие исследования с помощью фМРТ также показывают, что нейронная активность при принятии решений о доверии в режиме реального времени варьируется в зависимости от объектов и контекста53.
Управленческие последствия
Для онлайн-медицинских платформ практическим следствием является калиброванное доверие, а не простое стремление к его максимизации. Ролевые подсказки должны соответствовать требованиям задачи и сочетаться с сообщением о неопределенности, четко определенными пределами возможностей, предупреждениями о рисках и возможностью передачи случая квалифицированным клиницистам.
В модулях с высоким уровнем риска, касающихся диагностики, интерпретации отклоняющихся результатов, медицинских рекомендаций или сортировки пациентов, подсказки, ориентированные на компетенции, могут помочь пользователям определить границы доказательств и действий, не наделяя систему неоправданным авторитетом. В модулях с меньшей степенью срочности, таких как питание, физические упражнения, сон, приверженность лечению и эмоциональная поддержка, подсказки, ориентированные на установление отношений, могут способствовать вовлеченности, не создавая при этом ложного чувства уверенности или неуместного антропоморфизма.
Проектирование ролей должно быть модульным и основанным на сценариях, а не представлять собой фиксированную настройку личности. Конфигурация ролей должна быть интегрирована с пояснениями, запросами о конфиденциальности, метками рисков и механизмами эскалации. Исследования в области управления подчеркивают, что прозрачность, подотчетность, управление предвзятостью и конфиденциальность должны проектироваться совместно, чтобы достоверные внешние признаки роли не скрывали внутренние риски6,20,21.
Ограничения исследования и будущие направления
Исследование 1 представляет собой эксперимент со сценариями, а не реальную консультацию. Условия не проходили независимого предварительного тестирования на продолжительность, частоту слов, читабельность, точность, применимость, эмоциональную валентность, уровень возбуждения, риск, привычность или сложность. В будущих исследованиях следует использовать несколько сценариев, нейтральные названия систем, стимулы с согласованным содержанием, независимое манипулирование или разделенные во времени измерения, а также случайные эффекты на уровне участников и стимулов.
Исследование 2 предоставило данные ЭЭГ на уровне процессов, однако итоговая демографическая привязка для 39 человек была неполной, утверждения для ЭЭГ не проходили независимое сопоставление или предварительное тестирование на длину предложения, частоту слов, удобочитаемость, эмоциональную валентность, уровень возбуждения, воспринимаемый риск, знакомость и сложность, а явные обозначения ролей могли создать эффект ожиданий экспериментатора. В настоящем исследовании в качестве предопределенного показателя функциональной связности использовалось значение фазовой синхронизации с коррекцией по базовому уровню (ΔPLV). Хотя взвешенный индекс фазового сдвига (wPLI) менее чувствителен к объемному проведению, он не был включен в исходный конвейер анализа. В будущих исследованиях следует проверить, воспроизведутся ли настоящие результаты при использовании wPLI или других дополнительных показателей связности. Доступные нейронные данные агрегированы по условиям и не могут быть связаны с суждениями о доверии на уровне отдельных попыток; следовательно, смешанная модель ЭЭГ-поведения на уровне попыток не оценивалась. PLV на уровне скальпа также чувствителен к эффектам общего электрода сравнения и объемного проведения. Эти ограничения означают, что нейронные результаты следует считать предварительными, и их не следует интерпретировать как доказательство существования уникального механизма когнитивного контроля или доверия.
Раскрытие информации
Авторы заявляют об отсутствии конфликта интересов.
При подготовке данной работы авторы использовали ChatGPT для улучшения качества языка. После использования данного инструмента/сервиса авторы проверили и отредактировали содержимое по мере необходимости и несут полную ответственность за содержание публикации.
Благодарности
Данный исследовательский проект был поддержан Национальным фондом общих проектов в области социальных наук КНР (грант № 22BGL006).
Материалы
| Имя | Компания | Каталожный номер | Комментарии |
|---|---|---|---|
| Платформа для онлайн-опросов Credamo | Credamo (Jianshu), China | Не применимо | Платформа для онлайн-анкетирования, случайного распределения и набора участников, использованная в Исследовании 1. |
| Функция пересчета референса CURRY | Compumedics Neuroscan, USA | Версия не указана | Встроенный оффлайн-пересчет референса с онлайн-референса FCz на среднее значение двусторонних мастоидов; FCz был автоматически реконструирован относительно нового референса. |
| ЭЭГ-шапочка с электродами, 64-канальная | Compumedics Neuroscan (Compumedics Limited), Australia | Модель/номер по каталогу не указаны | 64-канальная электродная шапочка Ag/AgCl, использованная для непрерывной записи ЭЭГ. |
| EEGLAB | Swartz Center for Computational Neuroscience, University of California San Diego, USA | Version 2023.0 | Инструментарий MATLAB, использованный для предобработки ЭЭГ и анализа независимых компонентов. |
| E-Prime | Psychology Software Tools, Inc., USA | Version 2.1 | Презентация стимулов и сбор ответов в Исследовании 2. |
| G*Power | Heinrich Heine University Dusseldorf, Germany | Version 3.1.9.7 | Первоначальный априорный расчет размера выборки, анализ чувствительности взаимодействия и апостериорный анализ мощности на основе модели для Исследования 1. |
| IBM SPSS Statistics | IBM Corp., USA | Version 27 | Статистическая среда, использованная для запуска макроса PROCESS. |
| ICLabel | Swartz Center for Computational Neuroscience, University of California San Diego, USA | Version 1.7 | Плагин EEGLAB, использованный для классификации артефактных независимых компонентов. |
| MATLAB | The MathWorks, Inc., USA | Release R2020b | Вычислительная среда, использованная для обработки и анализа ЭЭГ. |
| Макрос PROCESS для SPSS | Andrew F. Hayes, Canada | Version 4.2 beta | Модель 7 с одновременным вводом воспринимаемого профессионализма и социального присутствия в качестве параллельных медиаторов с использованием 5,000 процентильных бутстреп-выборок в Исследовании 1. |
| Проводящий электролитный гель Quik-Gel | Compumedics Neuroscan (Compumedics Limited), Australia | Номер по каталогу не указан; 32 oz | Проводящий гель, использованный для снижения импеданса электрод-кожа при записи ЭЭГ. |
| Усилитель ЭЭГ SynAmps2 | Compumedics Neuroscan (Compumedics Limited), Australia | SynAmps2; номер по каталогу не указан | 64-256-канальный усилитель ЭЭГ, сконфигурированный для 64-канальной записи. |
Ссылки
- Grand View Research. Artificial intelligence in healthcare market size & share, industry report, 2033 [Internet]. Grand View Research; [cited 2026 Jul 11]. Available from: https://www.grandviewresearch.com/industry-analysis/artificial-intelligence-ai-healthcare-market
- Singhal K, et al. Large language models encode clinical knowledge. Nature. 2023;620(7972):172-80.
- Laranjo L, et al. Conversational agents in healthcare: a systematic review. J Am Med Inform Assoc. 2018;25(9):1248-58.
- Kouzy R, Hong JC, Bitterman DS. One shot at trust: building credible evidence for medical artificial intelligence. Lancet Digit Health. 2025;7(7):100883.
- Kim C, Gadgil SU, Lee SI. Transparency of medical artificial intelligence systems. Nat Rev Bioeng. 2026;4(1):11-29.
- Bian X, Chen Y, Yang A. Configuring trust in AI-augmented healthcare: the role of AI interpretability and data privacy in patient adoption of AI-assisted diagnosis. Int J Inf Manage. 2026;88:103039.
- Longoni C, Bonezzi A, Morewedge CK. Resistance to medical artificial intelligence. J Consum Res. 2019;46(4):629-50.
- Logg JM, Minson JA, Moore DA. Algorithm appreciation: people prefer algorithmic to human judgment. Organ Behav Hum Decis Process. 2019;151:90-103.
- Qin H, et al. Examining the impact of personalization and carefulness in AI-generated health advice: trust, adoption, and insights in online healthcare consultations experiments. Technol Soc. 2024;79:102726.
- Mayer CJ, et al. User preferences and trust in hypothetical analog, digitalized and AI-based medical consultation scenarios: an online discrete choice survey. Comput Human Behav. 2024;161:108419.
- Du G, Zhou C, Cheng X. Reducing consumers’ resistance to AI agents in online healthcare consultations: the role of human-AI teaming from a trust transfer perspective. J Bus Res. 2026;206:115959.
- Fiske ST, Cuddy AJC, Glick P, Xu J. A model of often mixed stereotype content: competence and warmth respectively follow from perceived status and competition. J Pers Soc Psychol. 2002;82(6):878-902.
- Araujo T. Living up to the chatbot hype: the influence of anthropomorphic design cues and communicative agency framing on conversational agent and company perceptions. Comput Human Behav. 2018;85:183-9.
- Zhang J, Luximon Y, Li Q. Seeking medical advice in mobile applications: how social cue design and privacy concerns influence trust and behavioral intention in impersonal patient-physician interactions. Comput Human Behav. 2022;130:107178.
- Li Q, Luximon Y, Zhang J. The influence of anthropomorphic cues on patients’ perceived anthropomorphism, social presence, trust building, and acceptance of health care conversational agents: within-subject web-based experiment. J Med Internet Res. 2023;25:e44479.
- Harris-Watson AM, et al. Social perception in human-AI teams: warmth and competence predict receptivity to AI teammates. Comput Human Behav. 2023;145:107765.
- Schelble BG, et al. Addressing the role of context on trust in human-AI teams: the influence of team role and violation type in high-risk tasks. Ergonomics. 2025. doi:10.1080/00140139.2025.2570300.
- Mou Y, Ye X, Ma W. Building and repairing trust in chatbots: the interplay between social role and performance during interactions. Behav Sci (Basel). 2026;16(1):118.
- Glikson E, Woolley AW. Human trust in artificial intelligence: review of empirical research. Acad Manage Ann. 2020;14(2):627-60.
- Luo Y, Li S, Ye Q, Zheng J. How privacy calculus builds user engagement through trust in AI medical consultation. Electron Mark. 2025;35(1):50.
- Nouis SCE, Uren V, Jariwala S. Evaluating accountability, transparency, and bias in AI-assisted healthcare decision-making: a qualitative study of healthcare professionals’ perspectives in the UK. BMC Med Ethics. 2025;26(1):89.
- Eagly AH, Karau SJ. Role congruity theory of prejudice toward female leaders. Psychol Rev. 2002;109(3):573-98.
- Laï MC, Brian M, Mamzer MF. Perceptions of artificial intelligence in healthcare: findings from a qualitative survey study among actors in France. J Transl Med. 2020;18(1):14.
- Feine J, Gnewuch U, Morana S, Maedche A. A taxonomy of social cues for conversational agents. Int J Hum Comput Stud. 2019;132:138-61.
- Mayer RC, Davis JH, Schoorman FD. An integrative model of organizational trust. Acad Manage Rev. 1995;20(3):709-34.
- Nass C, Moon Y. Machines and mindlessness: social responses to computers. J Soc Issues. 2000;56(1):81-103.
- Epley N, Waytz A, Cacioppo JT. On seeing human: a three-factor theory of anthropomorphism. Psychol Rev. 2007;114(4):864-86.
- McAllister DJ. Affect- and cognition-based trust as foundations for interpersonal cooperation in organizations. Acad Manage J. 1995;38(1):24-59.
- McKnight DH, Choudhury V, Kacmar C. Developing and validating trust measures for e-commerce: an integrative typology. Inf Syst Res. 2002;13(3):334-59.
- Johnson D, Grayson K. Cognitive and affective trust in service relationships. J Bus Res. 2005;58(4):500-7.
- Bussone A, Stumpf S, O’Sullivan D. The role of explanations on trust and reliance in clinical decision support systems [conference paper]. Presented at: 2015 International Conference on Healthcare Informatics; 2015. p. 160-9. doi:10.1109/ICHI.2015.26.
- Li Y, Chen L, Fu L. Vicarious interaction in online health consultation service: the effects of generative AI’s anthropomorphism and social support on intended responses through social presence and source credibility. Int J Hum Comput Interact. 2025;41(17):11209-26.
- Short J, Williams E, Christie B. The social psychology of telecommunications. John Wiley & Sons; London; 1976.
- Gefen D, Straub DW. Consumer trust in B2C e-commerce and the importance of social presence: experiments in e-products and e-services. Omega. 2004;32(6):407-24.
- Lee JD, See KA. Trust in automation: designing for appropriate reliance. Hum Factors. 2004;46(1):50-80.
- Goodhue DL, Thompson RL. Task-technology fit and individual performance. MIS Q. 1995;19(2):213-36.
- Castelo N, Bos MW, Lehmann DR. Task-dependent algorithm aversion. J Mark Res. 2019;56(5):809-25.
- Parsons CS, et al. Task-technology fit of artificial intelligence-based clinical decision support systems: a review of qualitative studies. BMC Med Inform Decis Mak. 2025;25(1):397.
- Wutz M, Hermes M, Winter V, Köberlein-Neu J. Factors influencing the acceptability, acceptance, and adoption of conversational agents in health care: integrative review. J Med Internet Res. 2023;25:e46548.
- Faul F, Erdfelder E, Lang AG, Buchner A. G*Power 3: a flexible statistical power analysis program for the social, behavioral, and biomedical sciences. Behav Res Methods. 2007;39(2):175-91.
- Tadros FJ, et al. Perceived professionalism of a dietitian is not influenced by attire or white coat: a prospective, randomized online study. Top Clin Nutr. 2021;36(3):231-41.
- Shams G, Kim KK, Kim K. Enhancing service recovery satisfaction with chatbots: the role of humor and informal language. Int J Hosp Manag. 2024;120:103782.
- Hayes AF. Introduction to mediation, moderation, and conditional process analysis: a regression-based approach. 3rd ed. Guilford Press; New York; 2022.
- Delorme A, Makeig S. EEGLAB: an open source toolbox for analysis of single-trial EEG dynamics including independent component analysis. J Neurosci Methods. 2004;134(1):9-21.
- Pion-Tonachini L, Kreutz-Delgado K, Makeig S. ICLabel: an automated electroencephalographic independent component classifier, dataset, and website. Neuroimage. 2019;198:181-97.
- Cavanagh JF, Frank MJ. Frontal theta as a mechanism for cognitive control. Trends Cogn Sci. 2014;18(8):414-21.
- Buzzell GA, et al. Adolescent cognitive control, theta oscillations, and social observation. Neuroimage. 2019;198:13-30.
- Cavanagh JF, Cohen MX, Allen JJB. Prelude to and resolution of an error: EEG phase synchrony reveals cognitive control dynamics during action monitoring. J Neurosci. 2009;29(1):98-105.
- Dietvorst BJ, Simmons JP, Massey C. Algorithm aversion: people erroneously avoid algorithms after seeing them err. J Exp Psychol Gen. 2015;144(1):114-26.
- Jussupow E, Benbasat I, Heinzl A. An integrative perspective on algorithm aversion and appreciation in decision-making. MIS Q. 2024;48(4):1575-90.
- Lebiere C, Blaha L, Fallon C, Jefferson BA. Adaptive cognitive mechanisms to maintain calibrated trust and reliance in automation. Front Robot AI. 2021;8:652776.
- Dimoka A, et al. On the use of neurophysiological tools in IS research: developing a research agenda for NeuroIS. MIS Q. 2012;36(3):679-702.
- Riedl R, Hubert M, Kenning P. Are there neural gender differences in online trust? An fMRI study on the perceived trustworthiness of eBay offers. MIS Q. 2010;34(2):397-428.