В данном вычислительном исследовании представлен рабочий процесс с учетом компартментализации для бенчмаркинга общедоступных транскриптомов респираторных вирусов; показано, что ответы хозяина в носовых выделениях и крови демонстрируют ограниченную согласованность на уровне генов, однако позволяют выявить воспроизводимые, биологически интерпретируемые компартмент-специфичные модули в независимых наборах данных, при клинических сравнениях, в процессе лонгитюдного восстановления и в ходе анализа робастности.
Исследовательская статья
Бенчмаркинг транскриптомов респираторных вирусов с учетом компартментализации для модулей ответа хозяина в носовых выделениях и крови: вычислительное исследование
В этой статье
Краткое содержание
Аннотация
Общедоступные транскриптомы респираторных вирусов представляют большую ценность для изучения ответов хозяина, однако различия в источнике тканей, определении контрольных групп и дизайне исследования могут привести к искажениям при проведении объединенных анализов. Мы разработали вычислительный рабочий процесс с учетом компартментализации, чтобы определить, можно ли выявить воспроизводимую активность ответа хозяина, сохраняя при этом биологический контекст носа и крови. В качестве опорного набора данных служила парная педиатрическая когорта GSE117827, включающая транскриптомы мазков из носа и цельной крови при симптоматической пикорнавирусной инфекции, симптоматической инфекции респираторно-синцитиальным вирусом, бессимптомном обнаружении пикорнавируса и вирусотрицательных контролях. После фильтрации по номенклатуре Комитета по номенклатуре генов человека (HGNC) было проанализировано 27 685 генов. На основе наиболее выраженных положительных ответов были определены отдельные модули из 50 белок-кодирующих генов для носа и крови, которые были зафиксированы перед внешней оценкой. Эффекты на уровне генов в носу и крови были почти независимы (r Пирсона = 0.015), а модули имели шесть общих генов при исследовании перекрытия рангов (индекс Жаккара = 0.064). Тем не менее, назальный модуль отделял инфекцию от контрольных групп в независимых когортах верхних дыхательных путей с показателями площади под ROC-кривой (AUROC) 0.749, 0.693 и 0.609, в то время как модуль крови достиг AUROC 0.832, 0.924 и 0.870 во внешних когортах крови. В лонгитюдных данных о естественном заражении соответствующие показатели снижались от стадии острого заболевания до выписки с парными дельтами 0.436 для образцов из носа и 0.30 для крови. Три дополнительных эталонных набора данных, включающих 6 внешних образцов, вместе с контрольными группами случайных генов, анализом влияния размера модуля, бутстреп-стабильностью, корреляциями маркеров и разделением дисперсии, определили надежность и ограничения рабочего процесса. Набор из 3 матричных рибонуклеиновых кислот (мРНК) Пандии оставался более эффективным для дифференциации вирусных и бактериальных инфекций, при этом показатели модуля крови также повышались при бактериальной пневмонии. Эти результаты подтверждают, что компартмент-специфические модули могут служить многократно используемыми показателями активности ответа хозяина для сравнения когорт и отслеживания выздоровления, а не универсальными пантканевыми биомаркерами или автономными классификаторами патогенов.
Введение
Транскриптомные профили хозяина широко используются для классификации инфекционных синдромов и сравнения иммунных ответов на различные патогены1,2,3,4,5. Респираторные вирусы часто активируют перекрывающиеся интерферон-стимулируемые гены (ISGs), воспалительные медиаторы и пути презентации антигенов6,7,8,9,10. Недавние парные и лонгитюдные исследования также показывают, что локальные ответы в дыхательных путях и системные ответы могут различаться по времени, клеточному составу и выраженности1. Эта проблема актуальна не только для гриппа, респираторно-синцитиального вируса (RSV), риновируса и SARS-CoV-2. Метапневмовирус человека остается важной причиной респираторных заболеваний, однако литература, посвященная ответу организма хозяина и методам вмешательства, все еще находится на стадии разработки12,13. Эти наблюдения при различных респираторных вирусных инфекциях дополнительно подчеркивают различия между локальным ответом в дыхательных путях и системным ответом хозяина14. Таким образом, при проведении вычислительных исследований взаимодействия хозяина и вируса практический вопрос заключается не только в том, существует ли ответ. Важно определить, можно ли повторно использовать общедоступные данные с помощью прозрачного рабочего процесса, который сохраняет тканевый контекст и позволяет получить воспроизводимые показатели ответа хозяина.
Большинство общедоступных наборов данных транскриптомов респираторных вирусов не были предназначены для чистого межвирусного или межтканевого анализа. Источник ткани, время забора, степень тяжести заболевания, возраст, определение контрольной группы и используемая платформа часто варьируются одновременно. Наборы данных экспрессии с высокой пропускной способностью также подвержены нежелательным техническим вариациям и вариациям на уровне конкретного исследования15,16. Таким образом, при объединенном анализе может быть выявлен выраженный интерфероновый или воспалительный сигнал, при этом его происхождение останется неясным. Образцы из носовых ходов отражают иммунную биологию эпителия и слизистых оболочек, тогда как цельная кровь отражает системные лейкоцитарные ответы. Рассматривание этих компартментов как взаимозаменяемых упрощает расчет показателей, но затрудняет их интерпретацию.
Мы построили анализ на основе GSE17827 — когорты с парными образцами из носа и крови из одного исследования, а не на основе самого крупного доступного набора данных для поиска17. Эта когорта невелика, но она позволяет снизить влияние межисследовательских искажающих факторов при сравнении величины эффекта в слизистой носа и крови. В нее включены пациенты с симптоматической пикорнавирусной инфекцией, симптоматической инфекцией RSV, бессимптомным выявлением пикорнавирусов и вирусоотрицательные контроли. Поэтому мы использовали ее только в качестве основы для отдельных модулей, специфичных для каждого компартмента. Состав модулей был зафиксирован до проведения внешнего тестирования. Стабильность отбора в малой когорте проверялась с помощью стратифицированного бутстреп-ресемплинга, анализа нулевых гипотез со случайными генами и анализа чувствительности к размеру модуля.
Мы добавили слой сравнительного анализа с бактериальными и неинфекционными контрольными группами. GSE63990 содержит образцы цельной крови при острых респираторных заболеваниях, помеченные как вирусные, бактериальные или неинфекционные18. GSE4012 содержит образцы при тяжелой внебольничной пневмонии, синдроме системного воспалительного ответа (SIRS) и образцы здоровых людей (контроль)19. Эти когорты позволяют проверить, отражает ли модуль общую активность иммунного ответа хозяина или специфичность к определенному классу патогенов. GSE53543 анализировался отдельно в качестве эталона воздействия риновируса на мононуклеарные клетки периферической крови (PBMC) ex vivo. Он измеряет реактивность лейкоцитов при контролируемом стимуле, но не эквивалентен естественной инфекции.
Наша исходная предпосылка намеренно консервативна. Мы не стремимся доказать существование универсального противовирусного профиля на основе гетерогенных общедоступных данных. Вместо этого мы проверяем, может ли рабочий процесс с учетом компартментализации генерировать оценки модулей, которые остаются полезными при внешней валидации. Данный подход предназначен для использования в качестве дополнения к диагностическим классификаторам, таким как Pandya 3-mRNA. Эти модули позволяют оценить активность ответа хозяина в носовых выделениях и крови в различных когортах, на разных стадиях выздоровления и при разной степени выраженности симптомов. Они не предназначены для определения класса патогена.
Протокол
В данном исследовании был проведен повторный анализ обезличенных, общедоступных данных; набор новых участников, вмешательства или сбор образцов не проводились. В связи с этим для настоящего вторичного анализа не требовалось одобрение институционального комитета по этике и повторного информированного согласия. Сведения об одобрении комитета по этике и информированном согласии для оригинальных исследований были представлены соответствующими поставщиками данных.
Дизайн исследования и логика рабочего процесса
Мы провели ретроспективное биоинформатическое исследование на основе общедоступных данных с использованием наборов данных, размещенных в Gene Expression Omnibus20,21. Новые образцы пациентов, эксперименты на клеточных культурах, модели на животных или лабораторная валидация не проводились. В рабочем процессе использовался дизайн с предварительным определением «якоря» (anchor-first design). Набор GSE17827 применялся для оценки величины эффекта, построения модулей, анализа согласованности между компартментами и анализа градиента симптомов. Независимые наборы данных вводились только после фиксации состава модулей. Рабочий процесс включал анкоринг парных компартментов, картирование по HGNC и фильтрацию белок-кодирующих генов, раздельное построение модулей для слизистой носа и крови, валидацию на соответствующих тканях и в лонгитюдном анализе, клинический бенчмаркинг и анализ робастности. Подтверждающие анализы включали фиксированные тесты на соответствующих тканях и лонгитюдные тесты. Анализы перекрывающихся генов, градиента симптомов, маркерных программ и дисперсии носили исследовательский или описательный характер.
Якорная когорта и основной контраст
GSE17827 содержит профили экспрессии из мазков из носа и цельной крови 26 детей: 9 случаев симптоматического заражения пикорнавирусом, 5 случаев бессимптомного обнаружения пикорнавируса, 6 случаев симптоматического заражения RSV и 6 бессимптомных вирусотрицательных контролей17. По двум случаям RSV отсутствовали образцы крови. Таким образом, полный якорный дизайн включал 50 образцов, а основной контраст «инфицированные против контролей» включал 40 образцов после исключения случаев бессимптомного обнаружения пикорнавируса из построения модулей. Для основного контраста образцы с симптоматическим течением пикорнавирусной и RSV-инфекций были помечены как «инфицированные», а бессимптомные вирусотрицательные образцы — как «контроли». Бессимптомные случаи обнаружения пикорнавируса не рассматривались в качестве контролей, поскольку обнаружение вируса без симптомов биологически отличается от здоровья при отсутствии вируса. Эти образцы были исключены из построения модулей и впоследствии использованы для анализа градиента симптомов.
Картирование и предварительная обработка зондов
Профилирование GSE17827 проводилось на GPL23126. Идентификаторы транскриптных кластеров были сопоставлены с символами генов с использованием файла аннотации Clariom D Human na36, hg38, распространяемого через платформу GEO GPL24539. Были сохранены только символы, одобренные HGNC2. Контрольные зонды, зонды ERCC, некартированные транскриптные кластеры и неодобренные символы были удалены. Несколько транскриптных кластеров, картированных на один и тот же одобренный символ, были объединены по медианному значению экспрессии. После фильтрации и объединения для якорного анализа стало доступно 27 685 генов. Преобразование log₂(x + 1) применялось только в тех случаях, когда 95-й процентиль матрицы экспрессии превышал 50, что указывало на нелогарифмированную шкалу интенсивности. Гены с более чем 20% пропущенных значений были удалены; остальные пропущенные значения были заменены медианой по данному гену. Затем каждый ген был стандартизирован по всем образцам в этом наборе данных как z = (x − mean)/sample standard deviation (ddof = 1). Генам с нулевой дисперсией было присвоено стандартизированное значение 0. Построение модулей было ограничено записями, классифицируемыми как белок-кодирующие гены в полном наборе HGNC.
Анализ величины эффекта и построение модулей
Назальный и гемодинамический компартменты анализировали раздельно. Симптоматические вирусные образцы сравнивали с вирусоотрицательными контролями с использованием g-статистики Хеджеса г стандартизированные средние разности и двусторонние критерии Уэлча23. Хеджирование г был рассчитан как разность средних значений между инфицированной и контрольной группами, деленная на объединенное стандартное отклонение и умноженная на поправку для малых выборок 1 − 3/(4df − 1), где df = нинфицированный + нконтроль − 2. Тесты Уэлча проводились с учетом неравенства дисперсий. Поправка Бенджамини — Хохберга для контроля частоты ложноположительных результатов (FDR) рассчитывалась для всех исследуемых генов в каждом компартменте.24Поскольку ни один белок-кодирующий ген не соответствовал заранее установленному строгому сочетанию показателей FDR < 0,05 и хеджс г > 0,8 в небольшой опорной когорте; гены с положительным эффектом были ранжированы в первую очередь по возрастанию двустороннего t-критерия Уэлча P значение, затем по убыванию g Хеджеса г, при этом символ гена использовался в качестве окончательного определяющего критерия при равенстве показателей. Топ-50 генов образовали каждый первичный модуль. Число пятьдесят было выбрано априори как умеренный размер модуля, обеспечивающий биологическую широту охвата при одновременном ограничении потерь из-за отсутствующих генов на разных платформах. Данный размер модуля не подбирался под внешние значения AUROC. Анализы чувствительности с использованием 10, 25, 50, 10 и 20 генов дали тот же качественный результат разделения якорей. Целью была воспроизводимость на уровне модулей, а не поиск отдельных генов.
Межкомпартментное соответствие
Оценки Hedges g для назальных проб и крови были сопоставлены по генам и сравнены с помощью корреляций Пирсона и Спирмена. Перекрытие между топ-50 модулями в носовых пробах и топ-50 модулями в крови было суммировано по количеству общих генов и индексу Жаккара. Общие гены интерпретировались как предварительные кандидаты на перекрытие рангов между компартментами, а не как валидированные консервативные биомаркеры.
Внешняя валидация на соответствующих тканях
Валидация баллов модулей проводилась с использованием независимых общедоступных наборов данных с интерпретируемыми исходными группами. Валидация по верхним дыхательным путям включала образцы промываний носа при RSV (GSE41374), а также наборы данных по SARS-CoV-2 (GSE152075 и GSE156063). Валидация по крови включала GSE17110 и два отдельно нормализованных блока GSE3890: GPL10558 (36 образцов; 28 RSV и 8 контролей) и GPL6884 (138 образцов; 107 RSV и 31 контроль). Для каждого внешнего набора данных зонды были сопоставлены с символами HGNC, а дублирующиеся символы объединялись по медианному значению экспрессии. В каждом наборе данных применялись те же правила трансформации, фильтрации пропущенных значений, импутации медианы и z-стандартизации по каждому гену, что и для опорного набора данных. Балл модуля рассчитывался как невзвешенное среднее стандартизированных значений экспрессии генов, представленных в данном модуле. AUROC, средняя точность и FDR по тесту Уэлча были представлены в качестве показателей переносимости, а не как оценки клинической диагностической эффективности.
Обширные клинические эталонные наборы данных и наборы данных ex vivo возмущений
Два набора данных цельной крови использовались в качестве клинических эталонов, а не когорт для первичного поиска. В GSE6390 образцы были распределены на основе метаданных о статусе инфекции по группам: вирусная респираторная инфекция (n = 17), бактериальная респираторная инфекция (n = 73) или неинфекционное заболевание (n = 90); образцы без одной из этих однозначных меток были исключены18. В GSE4012 поля диагнозов были сопоставлены с пневмонией, вызванной гриппом А (n = 39), бактериальной пневмонией без гриппа (n = 61), СРОР без пневмонии (n = 40), здоровым контролем (n = 36) или смешанной бактериальной/гриппозной пневмонией (n = 14)19. Образцы со смешанной бактериальной/гриппозной инфекцией были описаны, но исключены из бинарных эталонных сравнений.
Набор GSE53543 содержит 196 профилей PBMC ex vivo от 98 человек. От каждого человека был получен один образец только со средой и один образец, подвергнутый воздействию риновируса 16 в течение 24 h; идентификаторы субъектов подтвердили наличие 98 полных пар. Основной контрольный показатель AUROC был рассчитан для 98 стимулированных и 98 нестимулированных образцов, так как AUROC является метрикой разделения по рангам. Информация о парах субъектов была сохранена в метаданных и использована при проведении парного анализа чувствительности разностей показателей. Данный эксперимент анализировался отдельно от естественной клинической инфекции и не использовался для подтверждения клинических диагностических утверждений.
Были загружены исходные матрицы серий GEO для GSE6390, GSE4012 и GSE53543. Для GSE63990 использовалась GPL571, для GSE4012 — GPL6947, а для GSE53543 — GPL1058. Зонды были сопоставлены с символами, утвержденными HGNC, а дублирующие сопоставления были объединены по медиане экспрессии. Использовались депонированные нормализованные матрицы. Общее правило 95-го процентиля инициировало преобразование log₂(x + 1) только для матриц в нелогарифмическом масштабе. Данные GSE53543 уже были подвергнуты log₂-преобразованию, рангово-инвариантной нормализации и корректировке по дню обработки первоначальными исследователями, поэтому дополнительное логарифмическое преобразование не применялось. После удаления генов с более чем 20% пропущенных значений и заполнения оставшихся пропусков медианными значениями, каждый ген был подвергнут z-стандартизации по всем образцам внутри своего набора данных. Эталонный слой содержал 470 клинических образцов цельной крови и 196 образцов PBMC ex vivo.
Бенчмаркинг эталонных сигнатур
Базовые модули для назальных проб и крови были протестированы с помощью трех невзвешенных эталонных наборов. Официальный набор Pandya из 3 мРНК был перенесен из Дополнительной таблицы 1 оригинального отчета по классификатору5. Компаратор Andres-Terre включал 33 интерферон-ориентированных гена, отобранных из описанной многовирусной сигнатуры3. Компаратор Hallmark включал базовый поднабор из 3 генов интерферона-альфа, связанный с набором MSigDB HALLMARK_INTERFERON_ALPHA_RESPONSE25,26. Полные списки генов для всех трех эталонных наборов приведены в Дополнительных данных 1. Эти эталонные показатели не воспроизводят оригинальные взвешенные классификаторы. Для каждого набора данных показатель рассчитывался как невзвешенное среднее значение доступных z-показателей для каждого гена; требовалось наличие как минимум трех представленных генов, и количество представленных генов было зафиксировано. Сравнения при бенчмаркинге проводились между вирусной и бактериальной инфекциями, вирусной и неинфекционными состояниями, вирусной и бактериальными или неинфекционными состояниями, вирусной и здоровой/контрольной группами, а также бактериальной и здоровой/контрольной группами, если соответствующие группы были доступны. В качестве метрик бенчмаркинга интерпретировались AUROC и средняя точность (average precision). Значения P по тесту Уэлча были скорректированы с использованием процедуры Бенджамини–Хохберга для всех допустимых комбинаций «набор данных — сравнение — модуль» в таблице бенчмаркинга.
Независимая лонгитюдная валидация
Парные наборы данных острого периода и периода выписки GSE9741 и GSE9742 использовались только для лонгитюдной валидации27. Образцы, помеченные в переданных метаданных как одиночная инфекция RSV (RSVsi) или риновирус (hRV), составили основу основного анализа; коинфекции RSV (RSVco) были сохранены только в дополнительных результатах. Метки «острый период» и «выписка» были извлечены из названий образцов. Образцы сопоставлялись по набору данных, компартменту, вирусной группе и идентификатору субъекта, при этом были сохранены только субъекты с данными за обе временные точки. Основная комбинированная группа состояла из 38 пар RSVsi и 30 пар hRV (68 пар на один компартмент).
Для отбора генов, уточнения модулей или настройки пороговых значений наборы данных GSE9741 или GSE9742 не использовались. Эти наборы данных были зарезервированы для внешней валидации. Идентификаторы зондов были сопоставлены с утвержденными символами HGNC, а дублирующиеся символы были объединены по медианному значению экспрессии. Перед расчетом фиксированных показателей модулей GSE17827 были применены те же правила логарифмического преобразования по 95-му процентилю, фильтрация пропущенных значений, импутация медианы и процедуры внутринаборной z-стандартизации для каждого гена.
Для каждой ткани и модуля показатели острого периода и периода выписки были сопоставлены по испытуемому и группе вируса. Для каждой пары рассчитывалась разность между показателем острого периода и показателем периода выписки. Коэффициент Cohen dz рассчитывался как средняя парная разность, деленная на стандартное отклонение этой выборки. Были представлены результаты двухсторонних парных t-критериев и двухсторонних критериев знаковых рангов Уилкоксона, а также AUROC для разделения показателей острого периода и периода выписки. Значения FDR по методу Бенджамини–Хохберга рассчитывались для всех 20 валидных парных t-критериев в полном лонгитюдном выводе (два набора данных, два источника модулей и пять заранее определенных резюме по группам вирусов).
Анализ градиента симптомов и апостериорный анализ
После определения принадлежности к модулям данные о выявлении бессимптомных пикорнавирусов в GSE17827, которые были исключены из основного анализа, использовались только для анализа градиента симптомов. Порядковый клинический балл составлял 0 для вирусоотрицательных контролей, 1 для случаев бессимптомного выявления пикорнавируса и 2 для симптоматической инфекции. Для оценки порядкового тренда использовался коэффициент корреляции Спирмена, а общие различия между тремя группами оценивались с помощью критерия Краскела–Уоллиса. Для сравнения трех пар групп применялись двусторонние апостериорные тесты Манна–Уитни. Поправка Бенджамини–Хохберга применялась отдельно для каждого компартмента к семейству из трех попарных сравнений.
Функциональный анализ обогащения
Гены модулей из носовых выделений и крови были проанализированы с помощью Enrichr через gseapy с использованием библиотек MSigDB Hallmark 2020, Reactome 202 и GO Biological Process 202325,26,28,29,30,31. В Enrichr использовался стандартный метод анализа избыточного представления (over-representation analysis) на основе точного критерия Фишера. Значимыми считались скорректированные по методу Бенджамини — Хохберга P-значения < 0.05, полученные из библиотек. Восемь наиболее значимых терминов для каждого модуля по трем запрашиваемым библиотекам были ранжированы по скорректированному P-значению. Результаты обогащения использовались только для интерпретации.
Анализ робастности, программности маркеров и дисперсии
Анализ робастности проводился для проверки того, зависели ли результаты от размера модуля или случайного выбора. Оценивались модули размером 10, 25, 50, 10 и 20 генов. Для нулевого анализа со случайными генами совокупность подходящих объектов включала белок-кодирующие гены HGNC, представленные в обработанной матрице GSE17827. С помощью генератора случайных чисел NumPy с seed 2026062 было отобрано пятьсот наборов по 50 генов без возвращения. Бутстреп-перевыборка была ограничена 1 0 белок-кодирующими генами с положительным эффектом, имевшими наивысший ранг в исходном якорном анализе для каждого компартмента. В каждой повторной выборке белок-кодирующие гены с положительным эффектом ранжировали по возрастанию двустороннего значения P по критерию Уэлча, а затем по убыванию средней разности. Были отобраны 50 лучших генов. Стабильность генов рассчитывали как количество выборов, деленное на 10. Для каждого компартмента были представлены 20 генов с наибольшей частотой выбора.
Баллы программ-маркеров использовались в качестве описательных средств, а не для оценки клеточных фракций. Были оценены шесть курируемых программ: эпителиальная (EPCAM, KRT8, KRT18, KRT19, MUC1, KRT5, KRT14, SCGB1A1, FOXJ1), моноцитарно-макрофагальная (LYZ, LST1, S10A8, S10A9, FCGR3A, FCGR1A, CD14, MS4A7, CTSS), нейтрофильная (S10A8, S10A9, MPO, ELANE, CEACAM8, FCGR3B, OLFM4, MMP8), T/NK (CD3D, CD3E, TRAC, NKG7, GNLY, PRF1, GZMB, KLRD1, IL7R), B/плазматическая (MS4A1, CD79A, CD79B, MZB1, JCHAIN, IGHG1, SDC1) и миелоидный интерфероновый ответ (SIGLEC1, IFI27, IFI4L, ISG15, MX1, OAS1, RSAD2, IFIT3). Балл каждой программы рассчитывался как среднее значение доступных z-показателей для отдельных генов, при этом требовалось наличие как минимум трех представленных генов. Значения P по критерию Спирмена были скорректированы с использованием процедуры Бенджамини–Хохберга для всего семейства корреляций «набор данных–модуль–программа». Однофакторный показатель eta-квадрат рассчитывался как сумма квадратов между группами, деленная на общую сумму квадратов для каждой пары «модуль–фактор». Строки, в которых отсутствовал соответствующий фактор, исключались из этого расчета. Данный анализ носил описательный характер и не учитывал взаимно коррелирующие факторы.
Воспроизводимость
Все виды анализа выполнялись с использованием скриптов на языке Python 3.12.13 с применением программных пакетов и версий, указанных в Таблице материалов. Для рандомизированных процедур использовалось фиксированное начальное число (seed) 2026062. Публичные матрицы экспрессии из GEO обрабатывались с использованием единообразной структуры проекта, в которой были разделены необработанные входные данные, обработанные данные, результаты статистического анализа, таблицы и рисунки. Для обеспечения возможности независимой проверки были сохранены определения модулей, записи о курации образцов, оценки величины эффекта, статистика валидации, результаты обогащения, анализ робастности и исходные данные для рисунков. Код анализа, спецификации зависимостей и вспомогательные производные данные доступны в соответствии с разделом «Доступность данных».
Результаты
Бенчмаркинг с использованием опорных этапов позволил разделить тканеспецифические и общетканевые эффекты генов
Курированная опорная матрица GSE17827 содержала 27 685 генов, одобренных HGNC. Основное сравнение по назальным пробам включало 15 образцов от инфицированных пациентов с симптомами и 6 контрольных образцов с отрицательным результатом на вирус; сравнение по крови включало 13 образцов от инфицированных пациентов с симптомами и 6 контрольных образцов (Таблица 1). Поскольку данная малая когорта не может обеспечить стабильное обнаружение отдельных генов, она была использована в качестве опорной для парных компартментов. Стабильность оценивалась на уровне модулей с помощью бутстрэп-ресемплинга, проверки нулевой гипотезы с использованием случайных генов, внешней валидации и анализа чувствительности к размеру модуля.
| Пожалуйста, предоставьте исходный текст для перевода. | Группа | Условие | Основной контраст | н |
| Кровь | РСВ | Инфицированный | Да | 4 |
| Кровь | Бессимптомный пикорнавирус | Вторичный | Нет | 5 |
| Кровь | Симптоматический пикорнавирус | Инфицированный | Да | 9 |
| Кровь | Вирус-отрицательный контроль | Контроль | Да | 6 |
| Носовой | РСВ | Инфицированный | Да | 6 |
| Назальный | Бессимптомный пикорнавирус | Вторичный | Нет | 5 |
| Носовой | Симптоматический пикорнавирус | Инфицированный | Да | 9 |
| Назальный | Вирус-отрицательный контроль | Контроль | Да | 6 |
Таблица 1: Дизайн якорей GSE17827 после первичной курации контраста. Распределение образцов по кровяному и назальному компартментам в парном наборе данных якорей после первичной курации контраста. Образцы с симптоматическим респираторно-синцитиальным вирусом (RSV) и симптоматическим пикорнавирусом были классифицированы как инфицированные и включены в первичный контраст, тогда как вирус-отрицательные контроли были классифицированы как контроли и включены в первичный контраст. Бессимптомные образцы с пикорнавирусом были обозначены как вторичные и исключены из построения модуля; они использовались только в эксплораторном анализе градиента симптомов. В двух случаях RSV отсутствовали образцы крови, в результате чего было получено четыре образца крови и шесть назальных образцов RSV.
Среди 27 685 общих генов оценки g Хеджеса для носа и крови оказались практически не скоррелированы (коэффициент Пирсона r = 0,015; Рисунок 1). Этот результат был получен в рамках одного исследования и в меньшей степени подвержен межисследовательским различиям, чем совокупное сравнение разных когорт. Плотное центральное облако показывает, что большинство генов не демонстрировали схожей динамики в обоих компартментах. Выделенные перекрывающиеся гены были исключениями, находившимися в верхней части обоих ранжированных списков. Такая закономерность обосновывает раздельное построение модулей для носа и крови.
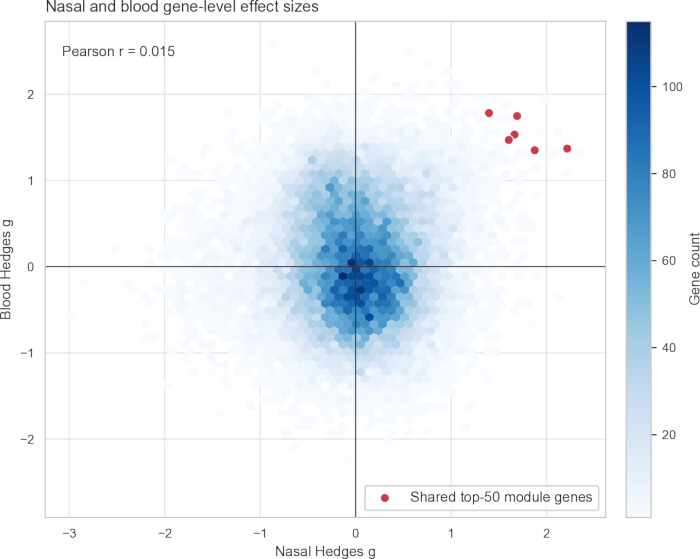
Рисунок 1. Размеры эффектов на уровне генов в мазках из носа и образцах крови в парной когорте-якоре GSE17827. Хеджирование г значения сравнивают симптоматическую инфекцию с вирус-отрицательным контролем для 27 685 генов. По оси x представлены оценки для назальных мазков (15 инфицированных, 6 контрольных), по оси y — оценки для крови (13 инфицированных, 6 контрольных). Гексагональное заштрихованное разбиение указывает количество генов в каждом бине. Красные точки обозначают шесть генов, общих для топ-50 модулей в носовых мазках и крови. Коэффициент Пирсона Пожалуйста, предоставьте текст для перевода. = 0.015. Нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Построение модулей выявило небольшое перекрытие, сосредоточенное вокруг интерферонов
Топ-50 модулей назального секрета и крови имели шесть общих генов: ISG15, ACRBP, IFIT1, RSAD2, CCRL2 и XAF1 (индекс Жаккара = 0.064; Таблица 2; Рисунок 2). ISG15, IFIT1, RSAD2 и XAF1 согласуются с интерферон-зависимой противовирусной биологией32,3,34. CCRL2 правильнее интерпретировать в контексте воспалительной миграции лейкоцитов35. Для ACRBP установленной противовирусной роли не описано. Все шесть генов приведены для прозрачности данных, однако ни один из них не заявляется как валидированный межтканевый биомаркер. Значения FDR для каждого отдельного гена в небольшой опорной когорте не были значимыми. Таким образом, основной вывод основывается на фиксированной валидации на уровне модулей, а не на списке перекрывающихся генов.
| Ген | Назальные Hedges g | Назальные FDR | Кровь Hedges g | Кровь FDR | Интерпретация |
| ISG15 | 2.215 | 0.213 | 1.369 | 0.42 | Стимулируемый интерфероном противовирусный ген; исследовательское перекрытие |
| ACRBP | 1.69 | 0.205 | 1.748 | 0.429 | Установленная противовирусная роль отсутствует; сохранен для прозрачности |
| IFIT1 | 1.875 | 0.213 | 1.35 | 0.42 | Стимулируемый интерфероном противовирусный ген; исследовательское перекрытие |
| RSAD2 | 1.63 | 0.213 | 1.532 | 0.42 | Стимулируемый интерфероном противовирусный ген; исследовательское перекрытие |
| CCRL2 | 1.396 | 0.217 | 1.782 | 0.42 | Контекст воспалительной миграции лейкоцитов; не вирус-специфичный |
| XAF1 | 1.603 | 0.26 | 1.47 | 0.42 | Связанный с интерфероном фактор апоптоза; исследовательское перекрытие |
Таблица 2: Полное эксплораторное перекрытие между наиболее значимыми модулями в носовых выделениях и крови. Для всех шести общих генов указаны значения Hedges g для носа и крови, а также значения FDR для каждого гена. Все шесть генов рассматриваются как эксплораторные кандидаты с перекрытием по рангу, поскольку значения FDR для отдельных генов не были значимыми в малой якорной когорте. ACRBP сохранен для обеспечения прозрачности, несмотря на отсутствие установленной противовирусной роли. Ни один из шести генов не представлен в качестве валидированного универсального биомаркера; основные доказательства основаны на внешней валидации на уровне модулей.
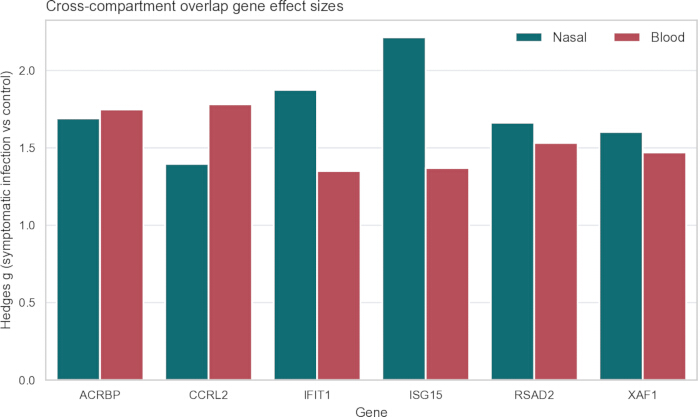
Рисунок 2Размеры эффектов для шести эксплораторных генов с перекрытием в назальном секрете и крови. Назальные и кровяные геджи г представлены оценки для ACRBP, CCRL2, IFIT1, ISG15, RSAD2 и XAF1 в GSE17827. Положительные значения указывают на более высокую экспрессию при симптоматической инфекции, чем в вирусонегативных контролях. Полное перекрытие показано для прозрачности; значения FDR для отдельных генов не были значимыми, и данные гены не представлены в качестве валидированных универсальных биомаркеров. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Функциональный анализ обогащения обеспечил биологическую проверку содержания модулей
Оба модуля были обогащены путями интерферона и противовирусными путями, хотя генный состав и степень обогащения различались (Рисунок 3). Представлены восемь наиболее значимых терминов для каждого модуля. Для назального модуля среди ведущих терминов были: Hallmark interferon-gamma response (скорректированное P = 2.23 × 10⁻24), Hallmark interferon-alpha response (скорректированное P = 1.40 × 10⁻22), Reactome interferon-alpha/beta signalling (скорректированное P = 3.64 × 10⁻19) и GO defense response to virus (скорректированное P = 5.47 × 10⁻15). Модуль крови продемонстрировал те же общие биологические характеристики, но с меньшей степенью обогащения: interferon-alpha response (скорректированное P = 3.87 × 10⁻6), Reactome interferon-alpha/beta signaling (скорректированное P = 5.70 × 10⁻6), interferon-gamma response (скорректированное P = 8.89 × 10⁻6) и defense response to virus (скорректированное P = 1.07 × 10⁻4). Эти результаты подтверждают биологическую согласованность, не подразумевая при этом идентичного ранжирования генов в разных компартментах.
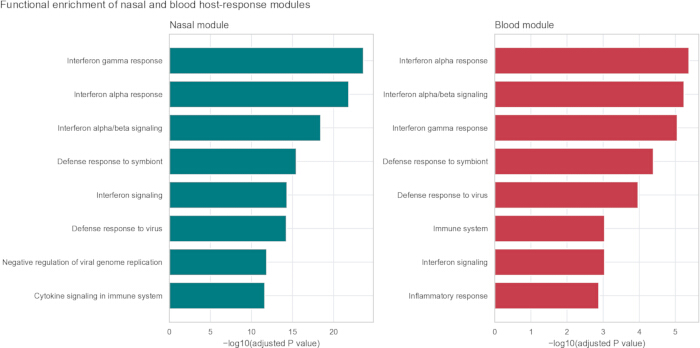
Рисунок 3. Отобранные термины обогащения для назального модуля и модуля крови. Анализ избыточного представления был выполнен с помощью Enrichr с использованием баз данных Hallmark 2020, Reactome 202 и GO Biological Process 2023. Восемь терминов с наименьшими значениями, скорректированными по методу Бенджамини — Хохберга, P представлены значения для каждого модуля. Длина столбца соответствует −log10(скорректированный P значение). На левой и правой панелях представлены модули носа и крови соответственно. Термины приведены строчными буквами (с заглавной только первая буква). Анализ обогащения не изменил принадлежность к модулю. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Закрепленные модули были протестированы в ходе внешней валидации на соответствующих типах тканей
Закрепленный назальный модуль достиг значений AUROC 0,749 в GSE41374, 0,693 в GSE152075 и 0,609 в GSE156063 (Таблица 3; Рисунок 4). Закрепленный модуль для крови достиг значений AUROC 0,832 в GSE1710, 0,924 в блоке GPL1058 набора GSE3890 и 0,870 в блоке GPL684. Данные по эффективности внутренних якорей опущены, так как они имеют оптимистическое смещение по определению. Внешние значения AUROC рассматриваются как сводные показатели переносимости. Они не устанавливают клиническую чувствительность, специфичность или готовность к диагностике.
| Когорта | Образец/вирус | Модуль | n-положительный | n-отрицательный | Представленные гены | AUROC (площадь под ROC-кривой) | Средняя точность | FDR-исправление для критерия Уэлча |
| GSE152075 | SARS-CoV-2 в верхних дыхательных путях | Носовой | 430 | 54 | 50 | 0.693 | 0.935 | 2,20 × 10⁻⁴ |
| GSE156063 | SARS-CoV-2 в верхних дыхательных путях | Назальный | 93 | 100 | 49 | 0.609 | 0.551 | 1,38 × 10⁻² |
| GSE1710 | цельная кровь на SARS-CoV-2 | Кровь | 44 | 10 | 50 | 0.832 | 0.959 | 7,94 × 10⁻⁴ |
| GSE3890-GPL1058 | цельная кровь на РСВ | Кровь | 28 | 8 | 50 | 0.924 | 0.979 | 7,94 × 10⁻⁴ |
| GSE3890-GPL6884 | цельная кровь на РСВ | Кровь | 107 | 31 | 49 | 0.87 | 0.962 | 3,47 × 10⁻¹⁵ |
| GSE41374 | Промывание носа при РСВ | Назальный | 76 | 10 | 50 | 0.749 | 0.951 | 2,63 × 10⁻² |
Таблица 3: Внешняя валидация модуля с учетом соответствия тканей. Заблокированный назальный модуль был протестирован в GSE41374, GSE152075 и GSE156063, а заблокированный модуль крови — в GSE1710 и в единицах платформы GSE3890 GPL1058 и GPL6884. В таблице указано количество положительных и отрицательных образцов, представленные гены модуля, AUROC, средняя точность (average precision) и FDR по тесту Уэлча. Показатели внутреннего якоря опущены. AUROC и средняя точность представлены в качестве показателей переносимости, а не как оценки клинической диагностической эффективности.
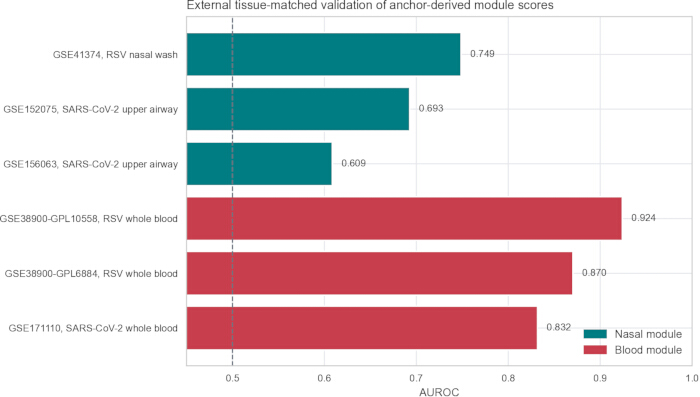
Рисунок 4Внешняя переносимость оценки модуля с сопоставлением по типу ткани. Представлены значения AUROC для назального модуля в наборах GSE41374 (76 случаев RSV, 10 контролей), GSE152075 (430 случаев SARS-CoV-2, 54 контроля) и GSE156063 (93 случая SARS-CoV-2, 10 контролей), а также для модуля крови в наборах GSE17110 (4 случая SARS-CoV-2, 10 контролей), GSE38900-GPL1058 (28 случаев RSV, 8 контролей) и GSE3890-GPL6884 (107 случаев RSV, 31 контроль). Показатели представляют собой невзвешенные средние значения соответствующих z-показателей для каждого гена. Пунктирная линия соответствует AUROC = 0,5. Приведенные значения являются сводными данными по переносимости модели, а не клиническими диагностическими оценками. Пожалуйста, нажмите здесь, чтобы просмотреть эту иллюстрацию в увеличенном размере.
Продольная валидация позволила проверить, снижаются ли показатели в процессе выздоровления
Сопутствующие наборы данных GSE9741/GSE9742 обеспечили независимую среду валидации при естественном инфицировании, включая образцы, полученные от госпитализированных детей в острой фазе и при выписке27. Эти образцы не использовались в качестве данных группы здорового контроля при поиске. Они применялись для оценки того, снижались ли баллы модулей, производных от анкеров, при переходе от острой фазы заболевания к выписке.
Для заранее определенной комбинированной группы с однократной инфекцией RSV и риновирусом в каждой ткани было проанализировано 68 пар испытуемых (Таблица 4; Рисунок 5). Показатели кровяного модуля снизились от стадии острой болезни до выписки в крови (средняя дельта = 0.30; Cohen dz = 0.740; FDR парного теста = 1.98 × 10⁻7; AUROC = 0.765). Назальный модуль также снизился в образцах из носоглотки (средняя дельта = 0.436; Cohen dz = 0.477; FDR парного теста = 3.06 × 10⁻4; AUROC = 0.679). Парные траектории и их стандартные ошибки показывают, что снижение на уровне группы не было вызвано несколькими единичными экстремальными значениями.
| Набор данных | Образец источника | Модуль | Соответствие по типу ткани | n пар | Средняя дельта при выписке в остром периоде | Коэн Пожалуйста, предоставьте исходный текст для перевода. | AUROC | FDR для парного теста |
| GSE9741 | Кровь | Кровь | Да | 68 | 0.330 | 0.740 | 0.765 | 1,98 × 10⁻⁷ |
| GSE97741 | Кровь | Носовой | Нет | 68 | 0.479 | 0.721 | 0.755 | 3,19 × 10⁻⁷ |
| GSE97742 | Носоглоточный | Кровь | Нет | 68 | 0.361 | 0.914 | 0.845 | 9,42 × 10⁻¹⁰ |
| GSE97742 | Носоглоточный | Носовой | Да | 68 | 0.436 | 0.477 | 0.679 | 3,06 × 10⁻⁴ |
Таблица 4: Независимая лонгитюдная валидация: острый период в сравнении с моментом выписки. В таблице представлены количество полных пар, средняя разница показателей между острым периодом и моментом выписки, Cohen dz, AUROC и FDR парного теста для фиксированных модулей в GSE9741 и GSE9742. Положительное значение дельты указывает на более высокий показатель модуля во время острого заболевания. Значения FDR парного теста представляют собой двухсторонние P-значения парного t-критерия, скорректированные по методу Бенджамини — Хохберга и рассчитанные по всем 20 валидным парным t-тестам в полном лонгитюдном массиве данных.
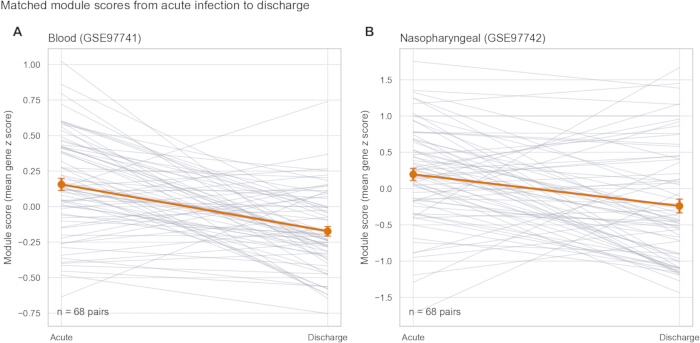
Рисунок 5Парные изменения баллов по модулям от стадии острого заболевания до выписки. (A) Баллы показателей модуля крови в цельной крови (GSE9741). (B) Показатели назального модуля в образцах из носоглотки (GSE9742). На каждой панели представлены 68 полных пар субъектов: 38 случаев первичной инфекции РСВ и 30 случаев инфекции риновирусом. Тонкие линии соединяют согласованные измерения одного и того же субъекта. Оранжевые точки обозначают средние значения по группе, а оранжевые планки погрешностей — стандартную ошибку среднего. Двусторонний парный t были проведены t-критерии и критерии знаковых рангов Вилкоксона; для 20 валидных продольных парных сравнений была применена поправка Бенджамини–Хохберга для контроля доли ложноположительных результатов (FDR) t тесты Пожалуйста, нажмите здесь, чтобы просмотреть эту фигуру в большем размере.
Тесты между различными компартментами выявили важный нюанс. Модуль крови, примененный к образцам из носоглотки, показал значение AUROC 0,845, несмотря на то что величины эффекта для отдельных образцов из носа и крови в анкоре были слабо согласованы. Анализ парных траекторий показал последовательное снижение показателей, а не инверсию распределения меток. Таким образом, данный результат не является доказательством того, что в обеих тканях доминируют одни и те же гены. Он указывает на то, что скоординированная интерфероновая/воспалительная программа может быть описана различными, но частично избыточными наборами генов. Специфичность компартментов наиболее выражена на уровне ранжирования генов и не является абсолютной на уровне путей или итоговых показателей.
Тестирование поведения градиента симптомов на исключенных бессимптомных случаях
Случаи обнаружения бессимптомного пикорнавируса в GSE17827 были исключены из построения модуля, чтобы избежать их включения в основную контрольную группу. Эта отделенная группа затем была использована для биологической проверки. В обоих компартментах показатели модулей возрастали в упорядоченных группах: вирус-отрицательный контроль, бессимптомное обнаружение пикорнавируса и симптоматическая инфекция (Рисунок 6A,B).
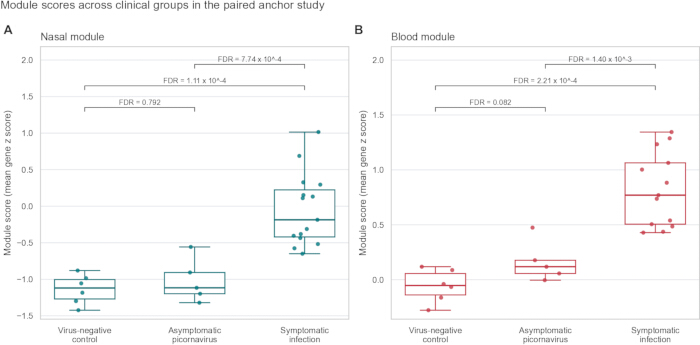
Рисунок 6Показатели модулей по всему градиенту симптомов в отложенной выборке. (A) Назальный модуль: 6 вирусотрицательных контролей, 5 случаев обнаружения пикорнавирусов у бессимптомных пациентов и 15 случаев симптоматических инфекций. (B) Модуль крови: 6 вирус-отрицательных контролей, 5 случаев обнаружения пикорнавирусов у бессимптомных особей и 13 случаев симптоматических инфекций. Точки представляют отдельные образцы. Центральные линии обозначают медианы; прямоугольники охватывают диапазон от 25-го до 75-го перцентиля; «усы» extending до наиболее экстремальных значений в пределах 1,5 межквартильного размаха. Метки содержат результаты двусторонних апостериорных сравнений по U-критерию Манна–Уитни с поправкой Бенджамини–Хохберга для трех сравнений в каждом отделе. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Назальный модуль коррелировал с порядковым баллом симптомов (Spearman rho = 0.818, P = 3.28 × 10⁻7; Kruskal-Wallis P = 1.57 × 10⁻4). Модуль крови продемонстрировал аналогичный градиент (rho = 0.861, P = 6.89 × 10⁻8; Kruskal-Wallis P = 1.92 × 10⁻4). После коррекции внутри каждой группы из трех сравнений симптомная инфекция значимо отличалась от контрольной группы и случаев бессимптомного обнаружения вируса в обоих компартментах. Бессимптомные случаи не отличались от вирус-отрицательных контролей (назальный FDR = 0.792; кровь FDR = 0.082). Таким образом, модули более четко отслеживали активность симптомного ответа хозяина, чем простое обнаружение вируса.
Клинические контрольные показатели определили границу между ответом хозяина и специфичностью патогена
Клинические контрольные показатели позволили разграничить активность ответа хозяина и классификацию патогенов (Таблица 5; Рисунок 7). В наборе данных GSE6390 назальный модуль обеспечил значения AUROC 0,782 для дифференциации вирусных и бактериальных заболеваний и 0,791 для дифференциации вирусных и неинфекционных заболеваний. Модуль крови обеспечил значения AUROC 0,678 и 0,753 соответственно. Компаратор Pandya 3-mRNA показал более высокие результаты с AUROC 0,867 и 0,852 соответственно. Такой результат ожидаем для набора, разработанного для разграничения вирусных и невирусных состояний, и показывает, что опорные модули не следует представлять в качестве заменяющих диагностических классификаторов.
| Набор данных | Контраст | Назальный анкер | Фиксация крови | мРНК Pandya 3 | ISG Андрес-Терре | Характерный интерферон-альфа |
| GSE6390 | Вирусная и бактериальная инфекции | 0.782 | 0.678 | 0.867 | 0.833 | 0.831 |
| GSE6390 | Вирусные и неинфекционные препараты | 0.791 | 0.753 | 0.852 | 0.851 | 0.848 |
| GSE40012 | Вирусная пневмония в сравнении с бактериальной пневмонией | 0.755 | 0.789 | 0.893 | 0.867 | 0.872 |
| GSE40012 | Вирусная пневмония в сравнении с СРВС | 0.897 | 0.907 | 0.985 | 0.965 | 0.956 |
| GSE40012 | Вирусная пневмония в сравнении со здоровым состоянием | 0.804 | 0.986 | 0.923 | 0.906 | 0.891 |
| GSE4012 | Бактериальная пневмония в сравнении со здоровым состоянием | 0.476 | 0.917 | 0.465 | 0.391 | 0.378 |
| GSE53543 | PBMC, стимулированные риновирусом ex vivo, в сравнении с нестимулированными PBMC | 1 | 0.957 | 1 | 1 | 1 |
Таблица 5: Контрольные показатели AUROC для якорных модулей и эталонных наборов ответов хозяина. GSE63990 и GSE4012 представляют собой клинические когорты цельной крови. GSE53543 является экспериментом по пертурбации PBMC ex vivo с участием 98 пар субъектов и приводится отдельно от естественных клинических когорт. Эталонные наборы оценивались как невзвешенные средние значения по генам, а не как их исходные взвешенные классификаторы. Значения AUROC приводятся в качестве контрольных показателей и не являются оценками клинической диагностической эффективности.
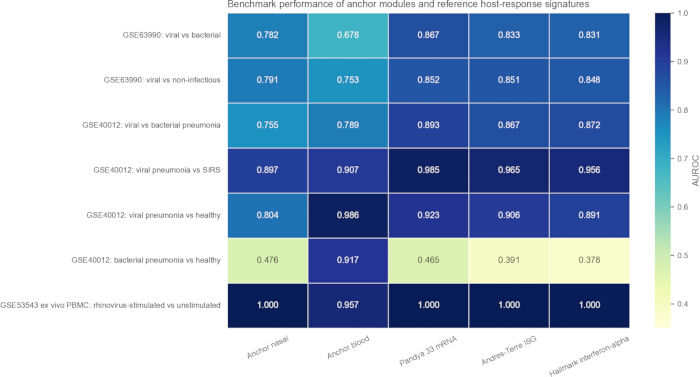
Рисунок 7Сравнительный анализ AUROC для анкерных модулей и эталонных наборов ответов хозяина. Строки представляют собой предварительно определенные контрасты в наборах GSE63990, GSE4012 и GSE53543; столбцы представляют два якорных модуля и три невзвешенных референтных набора. Набор GSE53543 обозначен как PBMCs, стимулированные риновирусом ex vivo, в сравнении с нестимулированными PBMCs, и представлен отдельно от естественных клинических когорт. Компаратор Hallmark обозначен как Hallmark interferon-alpha. Значения в ячейках указывают AUROC, использованные для бенчмаркинга метода, и не должны интерпретироваться как оценки клинической диагностической эффективности. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Набор данных GSE4012 позволил уточнить эту границу. Компаратор Пандьи достиг значений AUROC 0,893 при сравнении вирусной и бактериальной пневмонии и 0,985 при сравнении вирусной пневмонии с SIRS. Модуль анализа крови позволил дифференцировать пневмонию, вызванную гриппом А, от здорового контроля (AUROC = 0,986) и от SIRS (AUROC = 0,907), однако он также дифференцировал бактериальную пневмонию от здорового контроля (AUROC = 0,917). Таким образом, модуль анализа крови измеряет общую системную воспалительную активность и активность, связанную с интерфероном. Он не является вирус-специфичным, и высокий балл не позволяет определить класс патогена.
В отдельном сравнительном анализе ex vivo PBMC (GSE53543) назальный модуль и компараторы интерферона достигли показателя AUROC 1,0 при сравнении PBMC, стимулированных риновирусом, с PBMC в среде; модуль крови достиг AUROC 0,957. Все 98 субъектов предоставили парные образцы. Этот контролируемый результат подтверждает чувствительность оцениваемых программ к стимуляции риновирусом. Данные результаты не являются оценкой клинической диагностической эффективности.
Проверки робастности позволили протестировать размер модуля, случайные альтернативы и стабильность отбора
Разделение якорей оставалось неизменным для 10, 25, 50, 100 и 20 наиболее высокорейтинговых генов (Рисунок 8A). Эти внутренние показатели AUROC не являются внешней валидацией, однако они демонстрируют, что качественный результат не зависел от выбора именно 50 генов. В 50 случайных наборах из 50 генов медианы нулевого AUROC составили 0,489 для назальных проб и 0,705 для крови; соответствующие 9-й процентили составили 0,72 и 0,872 (Рисунок 8B). Наблюдаемые модули превысили эти нулевые распределения. Частоты отбора при бутстрэппинге были распределены, а не сконцентрированы в одном инвариантном списке (Рисунок 8C). Этот результат напрямую отражает малый размер выборки якорей. Он подтверждает наличие стабильного совокупного сигнала, предостерегая при этом от рассмотрения каждого отобранного гена как фиксированного.
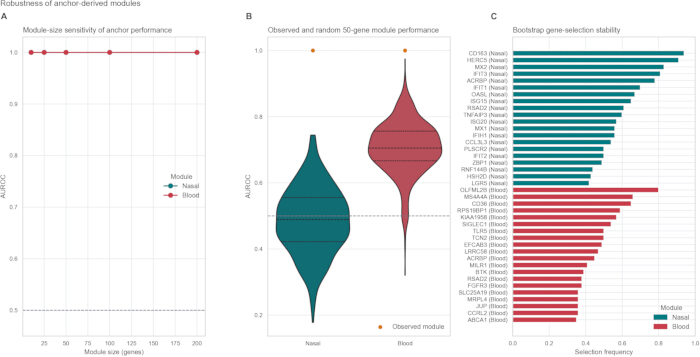
Рисунок 8Анализ устойчивости к размеру модуля, случайному выбору генов и бутстреп-анализ. (A) Значения Anchor AUROC для модулей размером 10, 25, 50, 10 и 20 генов; эти значения представляют собой результаты внутренней проверки чувствительности. (B) Распределения AUROC для 500 случайных наборов из 50 белок-кодирующих генов, отобранных без возвращения из числа генов, представленных в GSE17827 (seed = 2026062). Оранжевые точки обозначают наблюдаемые значения AUROC модулей. Горизонтальные линии внутри каждой скрипичной диаграммы указывают на 25-й процентиль, медиану и 75-й процентиль. (C) Повторный отбор методом бутстрэппинга был ограничен 1 0 кодирующими белками генами с положительным эффектом, имевшими самые высокие ранги в исходном базовом анализе для каждого компартмента. Столбцы отображают 20 генов с наибольшей частотой отбора для каждого компартмента; частота отбора рассчитывалась как количество выборок, деленное на 10. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Анализ программ-маркеров и дисперсионный анализ позволили уточнить, что именно измеряют полученные показатели
В наборах данных GSE4012, GSE53543 и GSE6390 оба модуля наиболее последовательно коррелировали с миелоидной интерфероновой программой (Рисунок 9A). Коэффициенты корреляции для назального модуля составили 0,812, 0,878 и 0,82; для модуля крови — 0,517, 0,843 и 0,74. Разделение дисперсии носило описательный характер (Таблица 6; Рисунок 9B). Для модуля крови состояние и детальная группа объясняли большую часть дисперсии (эта-квадрат = 0,282 и 0,250 соответственно), чем набор данных (0,06), тип образца (0,026) или исходная группа (0,025). Для назального модуля детальная группа и состояние также объясняли большую часть дисперсии, чем набор данных, тип образца или исходная группа. Таким образом, биологическое состояние и детальная группа определяли более значительные доли дисперсии показателей модулей, чем набор данных или тип образца, хотя ненулевые эффекты набора данных и состава остаются ограничением при повторном использовании общедоступных данных секвенирования совокупной РНК (bulk RNA-seq).
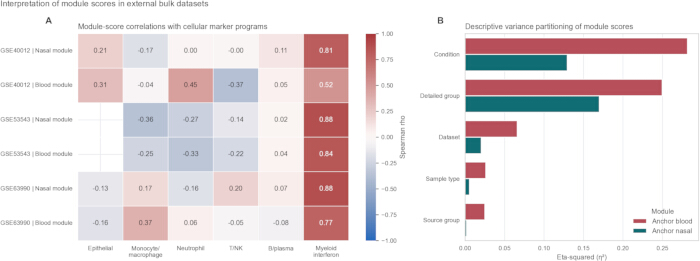
Рисунок 9Корреляции между маркерами и программами и дескриптивное разделение дисперсии. (A) Корреляции Спирмена между показателями модулей и показателями шести маркерных программ в наборах данных GSE4012, GSE53543 и GSE6390. Для программ требовалось наличие как минимум трех представленных генов. P значения были скорректированы для всех корреляций «набор данных — модуль — программа». Пустые ячейки указывают на недоступные или не подлежащие оценке комбинации после учета требований к генам и образцам. (B) Однофакторная эта-квадрат (η2; межгрупповая сумма квадратов/общая сумма квадратов) для условий, детальных групп, наборов данных, типов образцов и исходных групп. Анализ включал 934 показателя модуля крови и 1469 показателей назального модуля; данный анализ является описательным, а не причинно-следственным. Пожалуйста, нажмите здесь, чтобы просмотреть эту фигуру в увеличенном масштабе.
| Модуль | Фактор | Эта-квадрат | Кол-во образцов (n) |
| Anchor blood | Состояние | 0.282 | 934 |
| Anchor blood | Подробная группа | 0.25 | 934 |
| Anchor blood | Набор данных | 0.066 | 934 |
| Anchor blood | Тип образца | 0.026 | 934 |
| Anchor blood | Исходная группа | 0.025 | 934 |
| Anchor nasal | Подробная группа | 0.17 | 1469 |
| Anchor nasal | Состояние | 0.13 | 1469 |
| Anchor nasal | Набор данных | 0.021 | 1469 |
| Anchor nasal | Тип образца | 0.006 | 1469 |
| Anchor nasal | Исходная группа | 0.02 | 1469 |
Таблица 6: Описательный анализ распределения дисперсии показателей модулей. Для каждой пары «модуль-фактор» приведена одна строка с соответствующим значением эта-квадрат и размером выборки. Эта-квадрат рассчитывался как сумма квадратов между группами, деленная на общую сумму квадратов, после исключения строк с отсутствующими показателями соответствующего модуля или фактора. Факторы оценивались индивидуально; следовательно, данный анализ является описательным, не учитывает взаимосвязанные факторы и не должен интерпретироваться как причинно-следственный.
Доступность данных:
Все транскриптомные наборы данных, проанализированные в этом исследовании, находятся в открытом доступе в базе Gene Expression Omnibus под номерами доступа GSE17827, GSE41374, GSE152075, GSE156063, GSE17110, GSE38900, GSE9741, GSE9742, GSE6390, GSE4012 и GSE53543. Данные, полученные в результате анализа и легшие в основу основных рисунков и таблиц, а также код анализа могут быть предоставлены автором для корреспонденции по обоснованному запросу. В данном исследовании не использовались ограниченные или вновь сгенерированные данные на уровне отдельных участников.
Обсуждение
Основной практический вывод заключается в следующем: начинать следует с анализа отдельных исследуемых компартментов, а не с анализа самого крупного объединенного массива данных. Набор GSE17827 невелик, однако его парный дизайн позволяет провести прямое сравнение показателей в носу и крови в рамках одного исследования. Корреляция эффектов на уровне генов, близкая к нулю, показывает, что объединенный общетканевый ранжированный список скрыл бы существенную компартментальную структуру. Таким образом, разделение на отдельные модули оказалось более обоснованным подходом. Их внешняя и лонгитюдная эффективность подтверждают воспроизводимость активности ответа хозяина на уровне модулей, а не универсального списка генов.
Переносимость на уровне генов и на уровне модулей различается. Модуль крови продемонстрировал хорошие результаты в продольных образцах из носоглотки (AUROC 0.845), несмотря на слабую согласованность между индивидуальными величинами эффекта в носовых пробах и пробах крови. Парные траектории не показали инверсии меток. Более вероятным объяснением является избыточность путей: координированная активность интерферонов и воспалительные процессы могут быть представлены различными подмножествами генов в разных компартментах6,7,8,9,10,1,32,3,34. Именно поэтому мы описываем модули как учитывающие компартмент (compartment-aware), а не исключительные для конкретного компартмента (compartment-exclusive). Точные ранги различаются, но общий компонент на уровне путей остается обнаружимым. Профили bulk-секвенирования также смешивают изменения экспрессии с изменениями в клеточном составе. Корреляции программ-маркеров могут указывать на эту проблему, но они не позволяют выявить механизмы с клеточным разрешением36,37.
Клинические контрольные показатели определяют вторую границу. Сравнение по 3-мРНК по Пандье (Pandya) и интерферонам оказалось более эффективным для дифференциации вирусной и бактериальной инфекций. Якорные модули отвечают на другой вопрос: насколько сильно образец экспрессирует программу острого ответа хозяина? Модуль крови также демонстрировал повышение при бактериальной пневмонии. Следовательно, его следует интерпретировать как общий показатель системной воспалительной активности/активности интерферона, а не как специфический классификатор вирусов. Высокий балл может служить основанием для сравнения когорт, отслеживания ответа или описания воспалительного состояния, но он не позволяет идентифицировать патоген. Растущая клиническая значимость таких вирусов, как метапневмовирус человека, дополнительно подтверждает необходимость валидации на разнообразных патогенах и соответствующих тканях, а не экстраполяции данных на основе узкого набора вирусов12,13.
Шесть перекрывающихся генов носят исследовательский характер. ISG15, IFIT1, RSAD2 и XAF1 имеют вероятные роли, связанные с интерфероном32,3,34; CCRL2 связан с воспалительной миграцией лейкоцитов35; для ACRBP установленная противовирусная интерпретация отсутствует. Небольшая когорта и незначимые значения FDR по отдельным генам не позволяют делать более категоричные утверждения. Методологическая инновация заключается в другом: использовании парного «якоря» в рамках одного исследования, фиксированных компартмент-специфичных модулей, внешних тестов с подбором тканей, анализа парного восстановления, бенчмаркинга с клиническим компаратором, а также эксплицитных проверок на случайность, размер, бутстрепинг, маркеры и дисперсию. Данная иерархия доказательств обеспечивает консервативную основу для интерпретации результатов.
Остается ряд ограничений. Якорная когорта включает всего 15 образцов из носа от инфицированных пациентов и 6 от контрольной группы, а также 13 образцов крови от инфицированных и 6 от контрольной группы. Результаты бутстрэп-анализа подтверждают, что принадлежность отдельных генов не является полностью стабильной. Симптоматические РСВ и пикорнавирусы были объединены, поэтому якорные эффекты не являются специфичными для конкретного вируса. Внешние когорты различаются по возрасту, используемой платформе, степени тяжести, срокам и определению контрольной группы. GSE53543 представляет собой исследование парных возмущений ex vivo. GSE6390 и GSE4012 предоставляют полезные клинические данные для сравнения, но не содержат парных образцов из носа и крови. Данные о вирусной нагрузке, продолжительности симптомов, потребности в кислороде и степени тяжести были доступны непоследовательно. Более надежный проспективный дизайн предполагал бы сбор мазков из носа и крови у одних и тех же участников в соответствующие временные точки с измерением вирусной нагрузки и симптомов, использованием бактериальных и симптоматических вирус-отрицательных групп сравнения, а также валидацией с разрешением по типам клеток1,14,36,37.
В заключение следует отметить, что современные общедоступные транскриптомы подтверждают воспроизводимость модулей активности ответа хозяина в носовых ходах и крови при сохранении тканевого контекста. Они не подтверждают существование взаимозаменяемой 범тканевой генной сигнатуры. Парный якорь продемонстрировал низкую согласованность на уровне отдельных генов, тогда как показатели закрепленных модулей переносились внутри соответствующих тканей и снижались в период выздоровления. Ответ модуля крови при бактериальной пневмонии и более высокая эффективность установленного классификатора при разграничении вирусной и бактериальной инфекций определяют назначение данных инструментов: эти модули описывают активность ответа хозяина и служат для прозрачного бенчмаркинга когорт, но не являются автономными классификаторами патогенов. Код анализа и производные данные доступны в соответствии с заявлением о доступности данных для обеспечения независимой проверки и повторного использования рабочего процесса.
Раскрытие информации
Авторы заявляют об отсутствии финансовых или нефинансовых конфликтов интересов, имеющих отношение к данной работе.
Благодарности
Авторы благодарят исследователей и участников открытых исследований GEO, данные которых были повторно проанализированы в данной работе. Другие лица не соответствовали критериям авторства. Данное исследование не получило специального гранта от какого-либо финансирующего агентства из государственного, коммерческого или некоммерческого секторов.
Материалы
| Имя | Компания | Каталожный номер | Комментарии |
|---|---|---|---|
| Набор интерферон-стимулированных генов при мультивирусной инфекции по Andres-Terre | Andres-Terre et al. | компаратор из 3 генов; Supplementary Data 1 | Невзвешенный интерферон-ориентированный компаратор, составленный на основе опубликованной мультивирусной сигнатуры; полный список генов приведен в Supplementary Data 1. |
| Enrichr | Ma'ayan Laboratory | Дата доступа: 18 августа 2026 г.; RRID:SCR_01575 | Ресурс для анализа гиперпредставленности генных наборов, доступ к которому осуществляется через gseapy. |
| Gene Expression Omnibus | National Center for Biotechnology Information | GEO; RRID:SCR_05012 | Общедоступный репозиторий транскриптомов, использованный для доступа к анализируемым наборам данных. |
| Gene Ontology | Gene Ontology Consortium | GO Biological Process 2023; RRID:SCR_0281 | Библиотека функциональных аннотаций, использованная через Enrichr. |
| GPL10558 | NCBI GEO | GPL1058 | Платформа для GSE53543 и валидационного модуля GSE3890 из 36 образцов. |
| GPL23126 | NCBI GEO | GPL23126 | Платформа экспрессии для GSE17827. |
| GPL24539 | NCBI GEO | Clariom_D_Human.na36.hg38. probeset.csv | Аннотация Clariom D Human na36, hg38, использованная для картирования кластеров транскриптов GSE117827. |
| GPL571 | NCBI GEO | GPL571 | Аннотация платформы, примененная к GSE6390. |
| GPL684 | NCBI GEO | GPL684 | Платформа для валидационного модуля цельной крови GSE3890 (138 образцов) при RSV. |
| GPL6947 | NCBI GEO | GPL6947 | Аннотация платформы, примененная к GSE4012. |
| GSE17827 | NCBI GEO | GSE17827 | Основной парный набор данных (якорный) по мазкам из носа и цельной крови. |
| GSE152075 | NCBI GEO | GSE152075 | Внешний валидационный набор данных по верхним дыхательным путям при SARS-CoV-2. |
| GSE156063 | NCBI GEO | GSE156063 | Внешний валидационный набор данных по верхним дыхательным путям при SARS-CoV-2. |
| GSE17110 | NCBI GEO | GSE1710 | Внешний валидационный набор данных по цельной крови при SARS-CoV-2. |
| GSE3890 | NCBI GEO | GSE3890; GPL1058 и GPL684 | Внешняя валидация по цельной крови при RSV, проанализированная как отдельные нормализованные модули платформ из 36 и 138 образцов. |
| GSE4012 | NCBI GEO | GSE4012 | Контрольный набор данных: клиническая пневмония при гриппе А, бактериальная пневмония, SIRS и здоровый контроль. |
| GSE41374 | NCBI GEO | GSE41374 | Внешний валидационный набор данных по промывным водам из носа при RSV. |
| GSE53543 | NCBI GEO | GSE53543 | Контрольный набор данных парного ex vivo воздействия риновируса на PBMC, включающий 98 субъектов и 196 образцов. |
| GSE6390 | NCBI GEO | GSE6390 | Клинический контрольный набор данных по цельной крови при вирусных, бактериальных и неинфекционных заболеваниях. |
| GSE9741 | NCBI GEO | GSE97741 | Лонгитюдный валидационный набор данных по цельной крови (острый период против момента выписки). |
| GSE9742 | NCBI GEO | GSE9742 | Лонгитюдный валидационный набор данных по носоглотке (острый период против момента выписки). |
| gseapy | разработчики gseapy | Версия 1.3.1 | Интерфейс Python, использованный для запросов к Enrichr. |
| Ресурс символов генов HGNC | HUGO Gene Nomenclature Committee | Дата доступа: 18 августа 2026 г.; RRID:SCR_02827 | Ресурс для нормализации утвержденных символов генов и классификации белок-кодирующих генов. |
| Matplotlib | команда разработчиков Matplotlib | Версия 3.1.1 | Построение графиков. |
| Наборы генов MSigDB Hallmark | Broad Institute | Hallmark 2020; RRID:SCR_016863 | Библиотека обогащения Hallmark, доступ к которой осуществляется через Enrichr. |
| Набор генов ответа на интерферон-альфа MSigDB Hallmark | Broad Institute | HALLMARK_INTERFERON_ALPHA_ RESPONSE; основной поднабор из 3 генов в Supplementary Data 1 | Невзвешенный компаратор интерферона-альфа; точный поднабор приведен в Supplementary Data 1. |
| NumPy | разработчики NumPy | Версия 2.5.2 | Вычислительная математика и случайная выборка с заданным зерном. |
| pandas | команда разработчиков pandas | Версия 3.0.5 | Обработка табличных данных. |
| Набор генов ответа хозяина из 3 мРНК по Pandya | Pandya et al. | Supplementary Table 1; Supplementary Data 1 | Официальный набор из 3 генов, оцененный как невзвешенный компаратор. |
| Python | Python Software Foundation | Версия 3.12.13 | Среда для вычислительного анализа. |
| Reactome | Reactome | Reactome 202; RRID:SCR_03485 | Библиотека обогащения путей, доступ к которой осуществляется через Enrichr. |
| scikit-learn | разработчики scikit-learn | Версия 1.9.0 | Расчет AUROC и средней точности. |
| SciPy | разработчики SciPy | Версия 1.18.0 | Тесты Уэлча, парный t-тест, критерии Вилкоксона, Манна–Уитни и корреляционные тесты. |
| Seaborn | команда разработчиков Seaborn | Версия 0.13.2 | Статистическая графика. |
| statsmodels | разработчики statsmodels | Версия 0.14.6 | Статистические инструменты. |
Ссылки
- Zaas AK, et al. Gene expression signatures diagnose influenza and other symptomatic respiratory viral infections in humans. Cell Host Microbe. 2009;6(3):207-17.
- Woods CW, et al. A host transcriptional signature for presymptomatic detection of infection in humans exposed to influenza H1N1 or H3N2. PLoS One. 2013;8(1):e52198.
- Andres-Terre M, et al. Integrated, multi-cohort analysis identifies conserved transcriptional signatures across multiple respiratory viruses. Immunity. 2015;43(6):1199-211.
- Herberg JA, et al. Diagnostic test accuracy of a 2-transcript host RNA signature for discriminating bacterial vs viral infection in febrile children. JAMA. 2016;316(8):835-45.
- Pandya R, et al. A machine learning classifier using 33 host immune response mRNAs accurately distinguishes viral and non-viral acute respiratory illnesses in nasal swab samples. Genome Med. 2023;15(1):64.
- Ioannidis I, et al. Plasticity and virus specificity of the airway epithelial cell immune response during respiratory virus infection. J Virol. 2012;86(10):5422-36.
- Mejias A, et al. Whole blood gene expression profiles to assess pathogenesis and disease severity in infants with respiratory syncytial virus infection. PLoS Med. 2013;10(11):e1001549.
- Blanco-Melo D, et al. Imbalanced host response to SARS-CoV-2 drives development of COVID-19. Cell. 2020;181(5):1036-45.e9.
- Hadjadj J, et al. Impaired type I interferon activity and inflammatory responses in severe COVID-19 patients. Science. 2020;369(6504):718-24.
- Mick E, et al. Upper airway gene expression reveals suppressed immune responses to SARS-CoV-2 compared with other respiratory viruses. Nat Commun. 2020;11(1):5854.
- Yoshida M, et al. Local and systemic responses to SARS-CoV-2 infection in children and adults. Nature. 2022;602(7896):321-7.
- Jamali MC, et al. Respiratory infections by human metapneumovirus: epidemiological evidence and treatment prospects. Res J Pharm Technol. 2026;19(8):3905-12. doi:10.52711/0974-360X.2026.00549.
- Gao G, Lin R, Ma D. Human metapneumovirus: pathogenesis, epidemiology, diagnostic technologies, and potential intervention strategies. Virol J. 2025;22(1):376.
- Lim FY, et al. homeRNA self-blood collection enables high-frequency temporal profiling of presymptomatic host immune kinetics to respiratory viral infection: a prospective cohort study. EBioMedicine. 2025;112:105531.
- Johnson WE, Li C, Rabinovic A. Adjusting batch effects in microarray expression data using empirical Bayes methods. Biostatistics. 2007;8(1):118-27.
- Leek JT, et al. The sva package for removing batch effects and other unwanted variation in high-throughput experiments. Bioinformatics. 2012;28(6):882-3.
- Yu J, et al. Host gene expression in nose and blood for the diagnosis of viral respiratory infection. J Infect Dis. 2019;219(7):1151-61.
- Tsalik EL, et al. Host gene expression classifiers diagnose acute respiratory illness etiology. Sci Transl Med. 2016;8(322):322ra11.
- Parnell GP, et al. A distinct influenza infection signature in the blood transcriptome of patients with severe community-acquired pneumonia. Crit Care. 2012;16(4):R157.
- Edgar R, Domrachev M, Lash AE. Gene Expression Omnibus: NCBI gene expression and hybridization array data repository. Nucleic Acids Res. 2002;30(1):207-10.
- Barrett T, et al. NCBI GEO: archive for functional genomics data sets-update. Nucleic Acids Res. 2013;41(D1):D991-5.
- Tweedie S, et al. Genenames.org: the HGNC and VGNC resources in 2021. Nucleic Acids Res. 2021;49(D1):D939-46.
- Welch BL. The generalization of Student's problem when several different population variances are involved. Biometrika. 1947;34(1-2):28-35.
- Benjamini Y, Hochberg Y. Controlling the false discovery rate: a practical and powerful approach to multiple testing. J R Stat Soc Series B Stat Methodol. 1995;57(1):289-300.
- Subramanian A, et al. Gene set enrichment analysis: a knowledge-based approach for interpreting genome-wide expression profiles. Proc Natl Acad Sci U S A. 2005;102(43):15545-50.
- Liberzon A, et al. The Molecular Signatures Database Hallmark Gene Set Collection. Cell Syst. 2015;1(6):417-25.
- Do LAH, et al. Host transcription profile in nasal epithelium and whole blood of hospitalized children under 2 years of age with respiratory syncytial virus infection. J Infect Dis. 2018;217(1):134-46.
- Ashburner M, et al. Gene Ontology: tool for the unification of biology. Nat Genet. 2000;25(1):25-9.
- The Gene Ontology Consortium. The Gene Ontology resource: enriching a GOld mine. Nucleic Acids Res. 2021;49(D1):D325-34.
- Gillespie M, et al. The Reactome pathway knowledgebase 2022. Nucleic Acids Res. 2022;50(D1):D687-92.
- Kuleshov MV, et al. Enrichr: a comprehensive gene set enrichment analysis web server 2016 update. Nucleic Acids Res. 2016;44(W1):W90-7.
- Schoggins JW, et al. A diverse range of gene products are effectors of the type I interferon antiviral response. Nature. 2011;472(7344):481-5.
- Schneider WM, Chevillotte MD, Rice CM. Interferon-stimulated genes: a complex web of host defenses. Annu Rev Immunol. 2014;32:513-45.
- Perng YC, Lenschow DJ. ISG15 in antiviral immunity and beyond. Nat Rev Microbiol. 2018;16(7):423-39.
- Schioppa T, et al. Molecular basis for CCRL2 regulation of leukocyte migration. Front Cell Dev Biol. 2020;8:615031.
- Avila Cobos F, et al. Benchmarking of cell type deconvolution pipelines for transcriptomics data. Nat Commun. 2020;11(1):5650.
- Maden SK, et al. Challenges and opportunities to computationally deconvolve heterogeneous tissue with varying cell sizes using single-cell RNA-sequencing datasets. Genome Biol. 2023;24(1):288.