В данной исследовательской работе представлен подход FusionNetX, основанный на расширении возможностей объединения признаков DenseNet121 и EfficientNetB7 для классификации опухолей головного мозга на пяти общедоступных наборах данных с применением аугментации данных, предварительной обработки и настройки гибридной модели (промежуточный синтез), что позволило достичь результатов от 98,77% до 99,89%, превзойдя показатели по нескольким параметрам оценки.
Для просмотра этого контента требуется подписка на JoVE. Войдите или начните свой бесплатный пробный период.
Методическая статья
FusionNetX: модель глубокого слияния признаков на основе МРТ и глубокого обучения для улучшенного обнаружения опухолей головного мозга
В этой статье
Краткое содержание
Аннотация
Опухоли головного мозга считаются одними из самых смертоносных заболеваний в мире, и ошибочная диагностика представляет угрозу для жизни пациентов и снижает показатели выживаемости. Магнитно-резонансная томография (МРТ) с применением методов глубокого обучения, особенно сверточных нейронных сетей, имеет решающее значение для преодоления этого препятствия, так как она позволяет более детально изучить внутреннюю структуру мозга и обладает выдающимися способностями к обучению и прогнозированию. Потребность в точной диагностике опухолей головного мозга по-прежнему остается значительной. В связи с этим предлагается усовершенствованная модель глубокого обучения на основе слияния признаков (FusionNetX), которая использует преимущества двух предобученных моделей, DenseNet121 и EfficientNetB7, с применением индивидуально настроенных гиперпараметров дообучения, включая обучаемые и необучаемые слои. Предложенная модель FusionNetX была применена к пяти общедоступным наборам данных по опухолям головного мозга: Br35H, Figshare, Sartaj, Masoud и Balanced Brain Tumor. Для повышения качества изображений и предотвращения переобучения были применены некоторые этапы предобработки, включая изменение размера и аугментацию данных. С использованием различных метрик оценки эффективности, таких как точность (accuracy), функция потерь (loss), прогностическая ценность положительного результата, прогностическая ценность отрицательного результата, чувствительность (TPR), специфичность (TNR), F1-мера, частота ложноотрицательных и ложноположительных результатов, было установлено, что модель FusionNetX показала точность 99.33% для Br35H, 99.13% для Figshare, 99.89% для Masoud, 99.19% для BBT-Dataset и 98.77% для Sartaj. Кроме того, пять наборов данных по опухолям головного мозга были проанализированы с использованием позднего слияния (late fusion) и слияния на основе механизмов внимания (attention-based fusion), чтобы продемонстрировать значимость предложенной модели FusionNetX; результаты оказались существенно лучше с приростом от 0.3% до 1.9% по всем наборам данных. Кроме того, была построена рабочая характеристика приемника (ROC-кривая), и результаты различных метрик оценки эффективности указывают на то, что предложенная модель FusionNetX может точно обнаруживать и прогнозировать опухоли головного мозга, помогая медицинским работникам принимать своевременные решения.
Введение
Рак в настоящее время является самым смертоносным заболеванием человеческого организма из-за его тяжести и высокой скорости распространения. Существует множество онкологических заболеваний, таких как опухоли головного мозга, рак молочной железы, узлы в легких, рак почек и другие, что приводит к росту уровня смертности. Рак развивается, когда клетки или ткани в организме человека начинают размножаться аномально. При метастазировании рак может повреждать другие органы человека и становиться более опасным1. Поскольку мозг контролирует все функции организма, любое его повреждение может иметь далеко идущие последствия для всего тела. Именно поэтому опухоли или рак головного мозга так летальны для человека2. Кроме того, опухоли головного мозга делятся на две основные категории: доброкачественные и злокачественные. «Доброкачественный» по сути означает отсутствие рака; это проблема в мозге, которую можно решить путем воздействия на окружающую среду. Однако в случае злокачественности опухоль считается опасной из-за ее метастатической природы: аномальные клетки или ткани перемещаются в другие части тела или из них, нарушая работу других органов и тем самым увеличивая вероятность распространения рака в организме3.
Кроме того, согласно данным Американской ассоциации опухолей головного мозга и Всемирной организации здравоохранения (ВОЗ), опухоли гипофиза, менингиомы и глиомы представляют собой три основные категории рака мозга4. Глиомы развиваются из глиальных клеток, которые питают нейроны головного мозга. Опухоли гипофиза начинаются в гипофизе, расположенном в основании мозга и отвечающем за различные функции организма; менингиомы же развиваются в мозговых оболочках, которые защищают мембраны, окружающие головной и спинной мозг. Более того, для диагностики внутренних органов тела обычно используются различные модальности медицинской визуализации, включая рентгенографию, компьютерную томографию (КТ) и магнитно-резонансную томографию (МРТ)5,6. Каждый метод визуализации имеет свои преимущества и недостатки. МРТ — это метод визуализации, который позволяет получать детальные изображения мягких тканей и клеток организма, особенно в головном мозге. Рак характеризуется наличием аномальных тканей или клеток в организме, и МРТ обеспечивает детальную визуализацию этих патологий, что делает этот метод более полезным для диагностики опухолей или рака головного мозга. Кроме того, МРТ безопаснее других методов визуализации, так как при исследовании внутренней анатомии тела она не создает вредного излучения.
Кроме того, для решения диагностических задач, связанных с опухолями головного мозга, применяется множество вычислительных методологий, включая машинное обучение (ML), обработку изображений (IP) и глубокое обучение (DL), при этом каждый подход применяется к изображениям, полученным с помощью различных методов визуализации, для диагностики рака7. Эти подходы позволяют выявлять скрытые закономерности и структуры различных объектов на изображениях для диагностики рака путем идентификации паттернов в пораженной области. Каждый вычислительный подход имеет свои преимущества и недостатки в процессе диагностики. Методы на основе ML и IP используют извлечение признаков вручную, что зачастую приводит к неточным прогнозам и ошибочной диагностике, особенно на больших наборах данных8. Чтобы преодолеть проблемы с ручным извлечением признаков, происходит переход к моделям на основе глубокого обучения, обычно называемым моделями на базе сверточных нейронных сетей (CNN), которые обучаются и автоматически извлекают наиболее значимые признаки из изображений для точной диагностики опухолей. Подходы на основе DL сейчас широко используются в медицинской визуализации для диагностики заболеваний человеческого организма, особенно для раннего и точного обнаружения опухолей головного мозга, рака молочной железы, рака легких и других заболеваний, благодаря их способности обучаться и извлекать сложные паттерны в крупномасштабных данных, обеспечивая более точные результаты9. Основной проблемой моделей DL является потребление большого количества ресурсов и необходимость в выборке данных, что преодолевается с помощью другого подхода на основе глубокого обучения, называемого трансферным обучением10 (TL), при котором для диагностики заболевания используются предобученные модели, что экономит время и ресурсы. Ранняя и точная диагностика проблем со здоровьем становится возможной благодаря предобученным моделям, которые уже изучили базовые признаки, связанные с текстурой, цветом, краями и многим другим, на большом наборе данных. Затем эти модели могут быть перенесены на новый, ранее неизвестный набор данных путем использования архитектуры модели, добавления гиперпараметров, а также обучаемых и необучаемых слоев11. Был проведен значительный объем исследований по классификации опухолей головного мозга, и в Таблице 112,13,14,15,16,17,18,19,20,21,22,23 представлены подробности этих исследований, включая подходы, наборы данных и результаты. Тем не менее, в исследовательских работах еще не применялась методология, сочетающая две модели трансферного обучения для надежного извлечения признаков и корректирующая методы регуляризации для обеспечения стабильного обучения и тестирования. Тщательная оценка предлагаемой методологии позволяет получить представление о производительности модели при различных характеристиках опухолей головного мозга.
| Ссылка | Метод | Выборки данных | Результаты | Ограничения |
| 12 | Специализированная CNN | Br35H | Accuracy = 97.45%, | Результаты все еще требуют улучшения; вместо использования собственной CNN целесообразнее использовать существующую модель CNN с модификацией. |
| Loss = 0.1141%, | ||||
| Recall = 98.09%, | ||||
| F1-Score = 97.69%, | ||||
| Precision = 97.29%, | ||||
| Augmented Br35H | Accuracy = 98.99%, | |||
| Precision = 98.90%, | ||||
| Loss = 0.0570%, | ||||
| Recall = 98.91%, | ||||
| F1-Score = 99.04% | ||||
| 13 | Модель DNN с объединением признаков | Br35H | Accuracy = 98.22%, | Результаты все еще требуют улучшения, и вместо использования специализированной модели необходимо рассмотреть существующие модели для объединения признаков. |
| FNR = 1.77%, | ||||
| Sensitivity = 98.2%, | ||||
| F1-Score = 98%, | ||||
| Specificity = 98%, | ||||
| Figshare | Accuracy = 98.01%, | |||
| Sensitivity = 96.03%, | ||||
| F1-Score = 96%, | ||||
| Specificity = 98.67%, | ||||
| FNR = 3.96% | ||||
| 14 | AlexNet с SGD | Br35H | Accuracy = 98.79%, | Тем не менее, результаты нуждаются в некоторых улучшениях, а также необходимо протестировать более продвинутые модели на базе CNN на различных выборках данных. |
| MCR = 1.20%, | ||||
| Sensitivity = 98.98%, | ||||
| Specificity = 98.58%, | ||||
| F1-Score = 98.82% | ||||
| 15 | InceptionV3 | Figshare | Accuracy = 98.89%, | Авторы использовали набор данных Figshare, содержащий три класса опухолей; вместо их классификации они определяют только наличие или отсутствие опухоли; также требуются улучшения результатов и категоризация классов опухолей. |
| SensitivityB = 95.28%, | ||||
| SensitivityM = 94.47% | ||||
| 16 | Оптимизированная ResNet50 | Figshare | Accuracy = 99.03%, | Необходимо рассчитать другие параметры оценки эффективности и добиться дальнейшего улучшения результатов. |
| Recall = 99%, | ||||
| F1-Score = 99% | ||||
| 17 | Res-BRNet | Br35H | Accuracy = 98.22%, | Результаты все еще требуют улучшения. |
| Sensitivity = 98.11%, | ||||
| Precision = 98.22%, | ||||
| Figshare | F1-Score = 98.41% | |||
| 18 | ResNet101 + DenseNet121 | Figshare | Accuracy = 99.18%, | Наблюдается небольшое улучшение результатов; необходимо проверить больше наборов данных, связанных с опухолями головного мозга. |
| Recall = 99.11%, | ||||
| F1-Score = 99.08, | ||||
| Precision = 99.07%, | ||||
| Sartaj | Accuracy = 97.24%, | |||
| Recall = 97.58%, | ||||
| F1-Score = 97.28%, | ||||
| Precision = 97.06%, | ||||
| 19 | CNN-SVM | Brats | Accuracy = 98.02%, | Необходимо применить некоторые существующие модели совместно с SVM, а также требуется дальнейшее улучшение результатов. |
| F1-Score = 98.31%, | ||||
| Precision = 98.09%, | ||||
| Sensitivity = 98.53%, | ||||
| Specificity = 97.30%, | ||||
| Sartaj | Accuracy = 96.83%, | |||
| Precision = 95.36%, | ||||
| Sensitivity = 94.73%, | ||||
| Specificity = 97.56%, | ||||
| F1-Score = 95% | ||||
| 20 | Дообученная EfficientNetB3 | Figshare | Accuracy = 98.70% | Для улучшения результатов необходимо использовать вышеупомянутые варианты EfficientNetB3. |
| Sartaj | Accuracy = 97.50% | |||
| 21 | InceptionV4 | Masoud | Accuracy = 98.7%, | Требуется улучшение результатов с использованием дополнительных наборов данных. |
| Precision = 99%, | ||||
| Sensitivity = 98%, | ||||
| Specificity = 99%, | ||||
| F1-Score = 99.1% | ||||
| 22 | VGG16 | Masoud | Accuracy = 98% | Необходимо улучшить результаты, проверив больше моделей глубоких нейронных сетей. |
| 23 | MFR-CNN | Masoud | Accuracy = 94%, | В предлагаемом решении используется сложная архитектура. |
| Recall = 96%, | ||||
| F1-Score = 96%, | ||||
| Precision = 96%, |
Таблица 1: Сравнительный анализ последних исследовательских работ.В таблице обобщены существующие исследования, их подходы, выборки данных, результаты и ограничения. Пожалуйста, нажмите здесь, чтобы скачать эту таблицу.
В таблице 1 представлены существующие подходы, при этом освещаются их ограничения в улучшении результатов и необходимость использования ранее созданных моделей глубокого обучения (DL) при оценке их эффективности по различным статистическим параметрам в рамках эффективной системы, демонстрирующей более высокие результаты на различных наборах данных по опухолям головного мозга.
Цели исследования и постановка задачи
Ручная интерпретация требует больших временных затрат и подвержена межиндивидуальной вариабельности; поэтому быстрая и точная категоризация типов опухолей головного мозга по данным МРТ имеет решающее значение для принятия клинических решений. Большинство современных подходов глубокого обучения (DL) для автоматизированной классификации опухолей головного мозга основаны на одной базовой сети или простом объединении на уровне принятия решений, что не позволяет в полной мере использовать дополняющие друг друга представления признаков из нескольких предобученных архитектур, и зачастую проходят валидацию только на одном наборе данных, что ограничивает уверенность в их обобщающей способности.
Данный исследовательский проект направлен на разработку и предоставление полного и точного метода диагностики рака мозга у людей с использованием двухканальной архитектуры глубокого обучения (EfficientNetB7 и DenseNet121), которая использует взаимодополняющие представления признаков для обеспечения надежной классификации опухолей головного мозга по данным МРТ. Также оценивается устойчивость данной архитектуры на нескольких независимых общедоступных наборах данных. Этот подход может помочь рентгенологам и фельдшерам быстро и эффективно диагностировать опухоли головного мозга, спасая жизни пациентов за счет возможности своевременного распознавания и классификации заболеваний.
Для решения конкретной исследовательской задачи и достижения целей данного исследовательского проекта были сформулированы следующие исследовательские вопросы и определен вклад в их решение: 1) Является ли слияние двух предобученных базовых сетей на уровне признаков (промежуточное слияние) более эффективным, чем методы слияния на уровне принятия решений (позднее слияние) и методы слияния на основе внимания для классификации опухолей головного мозга? 2) Обеспечит ли предлагаемая система стабильную эффективность классификации на нескольких независимых наборах данных МРТ опухолей головного мозга?
Область данного исследования ограничена классификацией на уровне изображений (2D-срезов МРТ) с использованием пяти общедоступных наборов данных МРТ опухолей головного мозга (Br35H, Figshare, Sartaj, Masoud и BBT-Dataset); оценка проводилась независимо для каждого набора, а не между наборами данных; при этом использовались конкретная архитектура, конвейер предварительной обработки и экспериментальная конфигурация, описанные в разделе «Методология». Исследование не включает валидацию на уровне пациентов или тестирование в условиях клинического применения.
Основные вклады данной исследовательской работы заключаются в следующем: 1) Основным вкладом данной работы является использование двух предобученных моделей для более качественного извлечения признаков, включая DenseNet121 и EfficientNetb7 с оптимизированными гиперпараметрами. 2) Инновационная архитектура модели с применением передового метода регуляризации, интегрированного с конкатенированными признаками из двух предобученных моделей для обеспечения стабильной производительности. 3) Применение эффективной стратегии аугментации данных для увеличения разнообразия обучающих выборок с целью изучения более общих и специфических признаков, что позволяет преодолеть проблему переобучения. 4) Оценка производительности предложенной модели на пяти различных общедоступных наборах данных по опухолям головного мозга с акцентом на различные статистические параметры оценки, включая точность (accuracy), уровень ошибочной классификации (misclassification rate), прецизионность (precision), отрицательное прогностическое значение (negative predictive value), чувствительность (sensitivity), специфичность (specificity), F1-меру (F1-Score), частоту ложноотрицательных результатов (false negative rate) и частоту ложноположительных результатов (false positive rate).
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Протокол
Опухоль головного мозга является одним из самых опасных заболеваний в мире. Точная диагностика может существенно повысить выживаемость пациентов. Тем не менее, существует потребность в надежной диагностической системе, способной выявлять опухоли головного мозга на ранней стадии. Для решения этой проблемы был предложен более надежный метод точного обнаружения опухолей на ранних этапах с использованием гибридного механизма двойного глубокого обучения с оптимизированными гиперпараметрами и точно настроенными слоями на основе моделей DenseNet121 и EfficientNetB7. Предложенный подход принимает на вход 2D-МРТ-изображения и выдает прогноз о наличии или отсутствии опухоли для набора данных бинарной классификации Br35H, а также категорию опухоли для четырех других наборов данных многоклассовой классификации. Таким образом, в данном разделе представлены основные этапы предлагаемого подхода — от сбора данных до конечного результата, включая получение данных, предварительную обработку, разделение данных, выбор модели, извлечение признаков, прогнозирование опухоли и оценку предложенной модели, как показано на Рисунке 1.
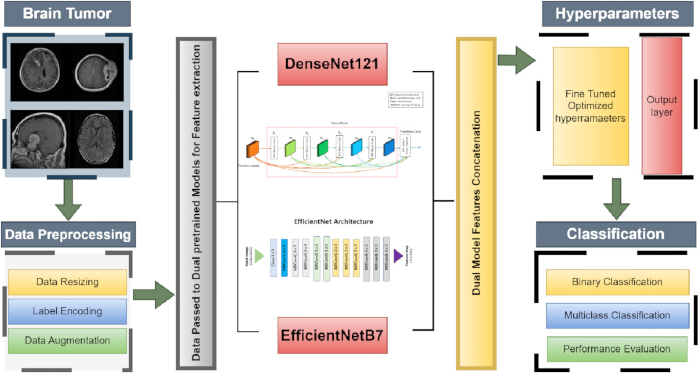
Рисунок 1: Схема предлагаемой методологии. На данной схеме представлена общая архитектура предлагаемой модели, включающая сбор и предварительную обработку данных, две предобученные модели для извлечения признаков, конкатенацию полученных признаков, а также тонкую настройку гиперпараметров для классификации опухоли и определения ее типа. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Сбор данных
Первым этапом любого экспериментального исследования является сбор данных. Для этого были выбраны пять различных общедоступных наборов данных, включая Br35H24, Figshare25, Sartaj26, Masoud27 и набор данных МРТ-изображений опухолей головного мозга из открытой библиотеки Kaggle28, которые уже использовались многими исследователями для диагностики опухолей головного мозга. Набор данных Br35H содержит 3 0 изображений, разделенных на два класса: изображения здорового мозга и мозга с патологией (опухолью), по 1 50 в каждом классе, в то время как набор данных Figshare состоит из 3 064 изображений, разделенных на три группы по типу опухоли: 1 426 изображений глиомы, 708 изображений менингиомы и 930 изображений опухолей гипофиза. Набор данных Sartaj содержит 3 264 изображения, распределенных по четырем классам опухолей: глиомы (926 изображений), менингиомы (937 изображений), опухоли гипофиза (901 изображение), а также здоровый мозг или отсутствие опухоли (50 изображений). Кроме того, набор данных Masoud также включает четыре различных класса опухолей, изображения для которых были взяты из трех вышеупомянутых наборов данных; всего представлено 7 023 изображения, которые далее разделены на глиомы (1 621 изображение), менингиомы (1 645 изображений), опухоли гипофиза (1 757 изображений) и здоровый мозг или отсутствие опухоли (2 0 изображений). Последним был выбран набор данных на основе МРТ-изображений, который также содержит четыре класса с общим количеством 5 248 изображений, разделенных по типам опухолей: 1 312 изображений глиомы, 1 312 изображений менингиомы, 1 312 изображений опухолей гипофиза и 1 312 изображений здорового мозга или отсутствия опухоли; данный набор данных является сбалансированным, так как изображения распределены по типам опухолей в равных пропорциях.
Предобработка данных
После сбора данных следующим этапом является их предварительная обработка, которая необходима для получения более качественных результатов и более эффективна для вычислительных подходов при извлечении и изучении наиболее значимых признаков данных, что обеспечивает более точные результаты. Первым этапом было изменение размера изображений. Пять общедоступных наборов данных с различными классами и размерами изображений (даже в пределах одного набора данных для разных классов опухолей) были выбраны и единообразно приведены к размеру 24 x 24 для улучшения интерпретации и обучения модели. Кроме того, ко всем наборам данных была применена аугментация данных путем создания дополнительных образцов под разными углами, что улучшило извлечение признаков и обучение моделями глубокого обучения (DL). Для этого ко всем изображениям был применен диапазон поворота 7%, при котором они поворачивались на угол до 7 градусов. Далее ко всем изображениям был применен случайный сдвиг 5% по горизонтали и вертикали, со сдвигом по высоте и ширине на 5% относительно исходных изображений. После этого изображения были масштабированы с увеличением на 10% относительно оригиналов, и, наконец, все изображения были зеркально отражены по горизонтали и вертикали. Основной целью аугментации данных29 является преодоление переобучения и улучшение обобщающей способности моделей за счет обучения на различных преобразованных версиях исходных образцов данных. Перед разделением наборов данных на обучающую и валидационную выборки было выполнено кодирование меток, что более эффективно при расчете функции потерь в процессе обучения и валидации, а также делает образцы данных более подходящими для корректной обработки меток моделями. Кроме того, наборы данных были разделены на обучающую и валидационную выборки в соотношении 80% к 20%30 соответственно; в Таблице 2 показано общее распределение образцов данных и их соотношение в обучающей и валидационной выборках.
| Набор данных | Классы опухолей | Общее количество изображений | Обучающие изображения | Валидационные изображения |
| Br35H | Здоровый | 1500 | 1200 | 300 |
| Опухоль | 1500 | 1200 | 300 | |
| Общее количество изображений | 3000 | 2400 | 600 | |
| Figshare | Глиома | 1426 | 1141 | 285 |
| Менингиома | 708 | 566 | 142 | |
| Гипофиз | 930 | 744 | 186 | |
| Общее количество изображений | 3064 | 2451 | 613 | |
| Сартаж | Глиома | 926 | 741 | 185 |
| Менингиома | 937 | 749 | 188 | |
| Опухоль отсутствует | 500 | 400 | 100 | |
| Гипофиз | 901 | 721 | 180 | |
| Общее количество изображений | 3264 | 2611 | 653 | |
| Масуд | Глиома | 1621 | 1297 | 324 |
| Менингиома | 1645 | 1316 | 329 | |
| Опухоль отсутствует | 2000 | 1600 | 400 | |
| Гипофиз | 1757 | 1405 | 352 | |
| Общее количество изображений | 7023 | 5618 | 1405 | |
| Сбалансированный набор данных по опухолям головного мозга (BBT-Dataset) | Глиома | 1312 | 1050 | 262 |
| Менингиома | 1312 | 1050 | 262 | |
| Опухоль отсутствует | 1312 | 1050 | 262 | |
| Гипофиз | 1312 | 1050 | 262 | |
| Общее количество изображений | 5248 | 4200 | 1048 |
Таблица 2: Распределение наборов данных. В таблице представлены статистические данные по классам относительно общего количества изображений, а также количества изображений для обучения и валидации в наборах данных по опухолям головного мозга.
Набор данных Br35H состоит из 30 изображений, из которых 240 выбрано для обучения и 60 — для валидации. Набор данных Figshare включает 3064 изображения. Из всех изображений 2451 было выбрано для обучения, а остальные 613 — для валидации. Набор данных Sartaj содержит в общей сложности 3264 изображения, из которых 261 использованы для обучения, а остальные 653 — для валидации. Набор данных Masoud содержит всего 7023 изображения; из них 5618 были использованы для обучения, а остальные 1405 — для валидации. Набор данных BBT содержит в общей сложности 5248 изображений. Из общего числа изображений 420 были предназначены для обучения, в то время как остальные 1048 изображений были предназначены для валидации. Кроме того, на рисунке 2 ниже представлены различные изображения опухолей головного мозга.
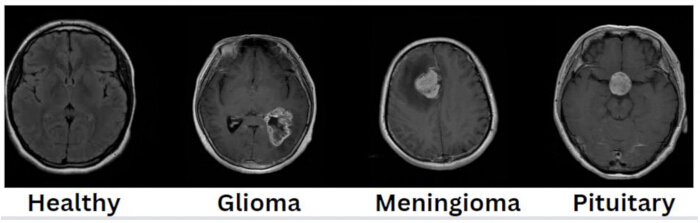
Рисунок 2Изображения опухолей головного мозга, включая типы опухолей. Набор данных содержит четыре изображения здоровой ткани мозга и три изображения опухолей: глиомы, менингиомы и гипофизарной опухоли. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Предлагаемая модель
После этапа предварительной обработки следующим шагом является предложение модели обучения, эффективной именно для классификации опухолей головного мозга. Для этой цели была предложена эффективная модель обучения, специально предназначенная для классификации опухолей головного мозга. В частности, предлагается новая эффективная предобученная модель на основе гибридного слияния признаков, включающая DenseNet12131,32 и EfficientNetB73, которые использовались для извлечения признаков из изображений; далее эти извлеченные признаки объединялись (конкатенировались) и передавались в различные тонко настроенные гиперпараметры, включая обучаемые и необучаемые слои, для точной диагностики опухолей головного мозга, что было реализовано на пяти различных общедоступных наборах данных, рассмотренных в вышеуказанных соответствующих разделах. Кроме того, модель DenseNet121 была разработана Гао Хуангом и его коллегами в 2017 году и состоит из 121 слоя. Основная цель данной модели заключалась в максимальном повторном использовании признаков и предотвращении проблемы затухающего градиента34. Слои в этой модели организованы в плотные блоки (dense blocks), каждый из которых содержит несколько сверточных слоев, извлекающих и изучающих признаки. Каждый слой принимает на вход карту признаков всех предыдущих слоев, а его выход соединяется с выходами этих слоев и передается в качестве входных данных последующим слоям в том же блоке по принципу прямой связи. Кроме того, между плотными блоками добавляются переходные слои, каждый из которых состоит из сверточного слоя 1 × 1, слоя BatchNormalization и слоев усредняющего пулинга 2 × 2, которые уменьшают карту признаков для контроля сложности модели. Кроме того, перед слоем глобального усредняющего пулинга для классификации добавляется финальный слой с функцией активации (AF) SoftMax. Базовая архитектура модели DenseNet121 показана на рисунке 334 ниже.
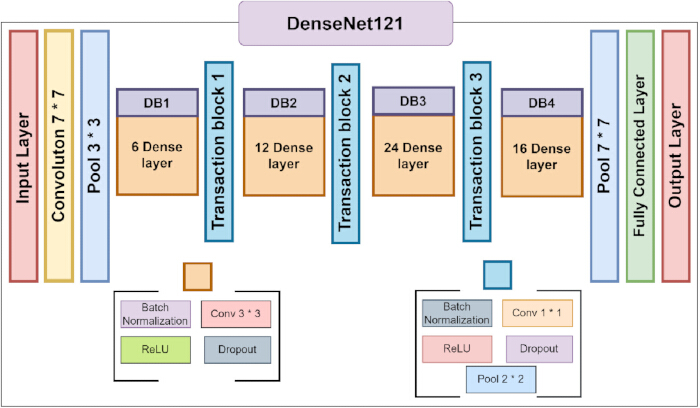
Рисунок 3Архитектурные особенности DenseNet12134. На данном рисунке представлена детальная архитектура модели DenseNet121, включая все плотные блоки и переходные блоки. Пожалуйста, нажмите здесь, чтобы просмотреть эту фигуру в увеличенном размере.
Кроме того, модель EfficientNetB7 была разработана Tan и Lee в 2019 году. Она принадлежит к семейству EfficientNet, включающему варианты от B0 до B7, и ее основной целью является превосходство над другими моделями при использовании меньшего количества параметров и меньших вычислительных мощностей. Ширина модели (количество каналов на слой), глубина (количество слоев) и разрешение могут быть точно настроены с помощью комбинированного масштабирования, которое является ключевой особенностью модели. Более того, эта модель состоит из блоков MBConv (mobile inverted bottleneck convolutional — мобильный инвертированный сверточный блок с «бутылочным горлышком»), которые включают слой свертки 1 × 1 для расширения каналов, глубинный разделяемый сверточный слой (depthwise separable convolution), отвечающий за применение свертки к каждому каналу в отдельности, и проекционный сверточный слой 1 × 1, который возвращает количество каналов к исходному. Кроме того, каждый блок MBConv содержит блоки Squeeze and Excitation (SE)35, которые перекалибровывают признаки по каналам, помогая сети сосредоточиться на наиболее важных из них. Далее, вместо сигмоиды или любой другой функции активации используется функция Swish, которая работает эффективнее, чем ReLU, за счет допуска отрицательных значений, что способствует более стабильному градиентному потоку. Кроме того, для целей классификации перед слоем глобального усредняющего пулинга (global average pooling) добавляется финальный выходной слой с функцией активации SoftMax. На рисунке 435 представлена базовая схема модели EfficientNetB7, а на рисунке 5 показана рекомендуемая архитектура модели.
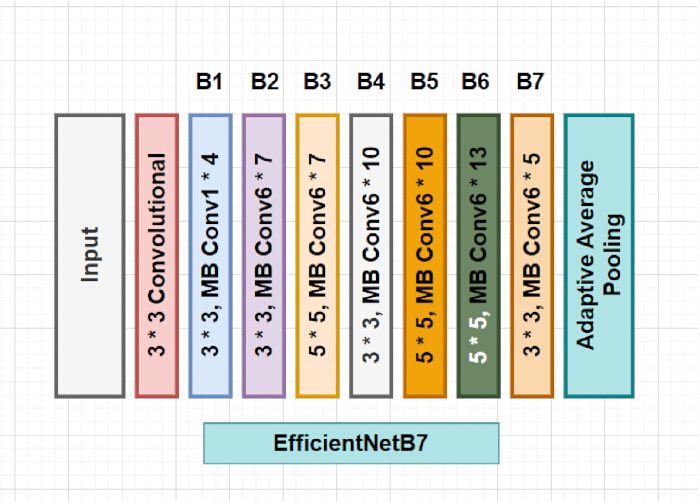
Рисунок 4Архитектурные особенности EfficientNetB735. На этом рисунке представлена детальная архитектура модели EfficientNetB7, включая все мобильные инвертированные сверточные блоки с узким местом (MBConv). Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
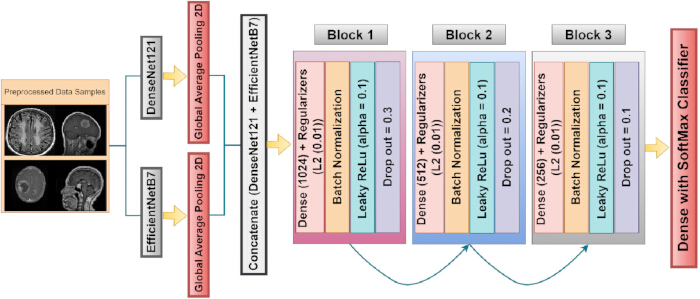
Рисунок 5Предлагаемая архитектура гибридной комбинированной модели. Предложенная архитектура иллюстрирует процесс передачи предварительно обработанных изображений в экстрактор признаков, который состоит из трех специализированных блоков с различными гиперпараметрами, за которыми следует выходной слой. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Кроме того, первичные признаки были извлечены с помощью предобученных моделей DenseNet121 и EfficientNetB7. Обновленные веса предобученных моделей были загружены в обученные модели, при этом базовые слои моделей были заморожены, чтобы предотвратить их повторное обучение. Это должно помочь модели сохранить наилучшие накопленные знания, адаптировать их с учетом новых выборок данных для улучшения сходимости и сосредоточиться на обучении дополнительных слоев для извлечения более сложных признаков. Приведенные ниже уравнения 1 и 2 демонстрируют принципы работы моделей DenseNet121 и EfficientNetB7.
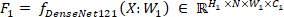 (1)
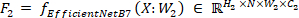 (2)
Приведенные выше уравнения 1 и 2 описывают работу предобученной модели в части извлечения признаков; F1 обозначает выходные карты признаков, полученные с помощью предобученной модели DenseNet121, а F2 — выходные карты признаков, полученные с помощью предобученной модели EfficientNetB7 при обработке входных изображений, которые представлены как X. Кроме того, W1 и W2 являются обучаемыми параметрами или весами, связанными с первыми блоками и слоями моделей DenseNet121 и EfficientNetB7 соответственно. Далее, ∈ RN ×H1×W1×C1 и ∈ RN ×H2×W2×C2 представляют размерность выходных карт признаков моделей DenseNet121 и EfficientNetB7 соответственно, с размерностью H1 ×N×W1×C1 и H2 ×N×W2×C2, где N обозначает размер пакета (batch size) изображений, который был принят равным 16. Кроме того, H1×W1 представляет высоту и ширину изображений соответственно для модели DenseNet121, а H2×W2 — высоту и ширину изображений для модели EfficientNetB7, которые были выбраны в размере 24 × 24. C1 и C2 обозначают цветовые каналы для моделей DenseNet121 и EfficientNetB7 соответственно. После получения выходных карт признаков из моделей (2560 каналов для EfficientNetB7 и 1024 для DenseNet121), к этим картам применяется слой глобального двумерного среднего пулинга (global average pooling 2D36) для уменьшения пространственной размерности путем вычисления среднего значения всех пространственных измерений в один вектор, что более удобно для передачи на следующий слой с целью более эффективного извлечения признаков и распознавания интерпретируемых паттернов.
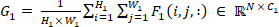 (3)
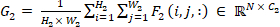 (4)
Вышеприведенные уравнения 3 и 4 демонстрируют принцип работы слоя глобального усредняющего пулинга 2D (global average pooling 2D), примененного к моделям DenseNet121 и EfficientNetB7 соответственно, где  и
 показана процедура нормализации суммы путем деления на общее количество пространственных позиций для обеих моделей; это необходимо для того, чтобы объединенный результат представлял собой среднее значение, а не простую сумму.
 и
 представляет собой суммирование по пространственным измерениям карт признаков, в то время как i, и j Эти циклы используются только для итерации по высоте и ширине соответственно с целью суммирования карт признаков для обеих моделей. Кроме того, F1(i, j, :) и F2(i, j, :) представляет значения карт признаков в конкретных пространственных позициях (i, j) по всем каналам для моделей DenseNet121 и EfficientNetB7 соответственно. Эта операция пулинга объединяет пространственную информацию в более компактное и точное представление, сохраняя наиболее важные признаки для каждого изображения. Далее выходы слоев глобального усредняющего пулинга объединяются (конкатенируются) для создания единого вектора признаков для каждого образца; такой подход часто используется для слияния признаков из разных моделей с целью повышения производительности за счет использования сильных сторон обеих моделей; принцип этой работы показан в уравнении 5.
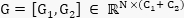 (5)
Выше в уравнении 5 показана процедура конкатенации двух различных векторов признаков моделей [G1, G2], где G1 представляет вектор признаков модели DenseNet121, а G2 — вектор признаков модели EfficientNetB7; при этом размерность конкатенированного вектора признаков представлена как RN ×(C1+ C2), где N — размер пакета (batch size), определяющий количество параллельно обрабатываемых образцов, а (C1+ C2) — общее количество признаков, полученных из моделей 1 и 2 соответственно, что составляет примерно 3584, которые обрабатываются параллельно; конкатенированный выходной вектор признаков обозначен как G. Далее, для модификации объединенной модели были добавлены три различных блока с целью извлечения более сложных признаков, улучшения обобщающей способности и предотвращения переобучения для достижения более точных и эффективных результатов. Каждый блок состоит из полносвязного слоя с определенным количеством нейронов: первый блок имеет 1024 нейрона в полносвязном слое, что позволяет фиксировать широкий спектр признаков и более общие закономерности в данных; второй блок имеет 512 нейронов в полносвязном слое, что служит для уточнения признаков путем снижения размерности и фокусировки на более специфических паттернах. Третий блок содержит 256 нейронов в полносвязном слое, которые осуществляют более детальную дистилляцию признаков, чтобы на выходной слой для выполнения конкретной задачи передавались только наиболее значимые признаки и закономерности. Кроме того, в каждый полносвязный слой каждого блока добавлены методы L2-регуляризации37 для предотвращения переобучения путем штрафования за слишком большие веса, что также делает модель более сложной. После каждого блока также введен слой дропаута (dropout layer)38 для случайного игнорирования 30%, 20% и 10% нейронов в блоках 1, 2 и 3 соответственно, что заставляет сети вырабатывать более устойчивые признаки, не зависящие от одного нейрона. Более того, для стабилизации процесса обучения после каждого полносвязного слоя применяется слой пакетной нормализации (BatchNormalization)39, который гарантирует, что активации остаются в стабильном диапазоне, а также помогает модели избежать таких проблем, как затухание или взрыв градиентов в фазе обучения. Дополнительно слой BatchNormalization ускорил процесс обучения, что позволило модели быстрее сходиться за счет сглаживания ландшафта функции потерь, облегчая оптимизаторам поиск глобального минимума. Далее, в каждом блоке для обеспечения нелинейности используется функция активации leaky ReLU40, которая позволяет модели изучать сложные закономерности; leaky ReLU имеет преимущества перед другими функциями активации, так как предотвращает инактивизацию нейрона, допуская небольшой ненулевой градиент для отрицательных входных значений. Далее в уравнении 6 показан принцип работы различных блоков, интегрированных в гибридную объединенную модель.
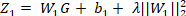 (6)
После получения конкатенированного вектора G он проходит через полносвязный слой (dense layer) блока 1 с 1024 нейронами, где матрица весов W1 преобразует входной вектор G в выходной вектор размерности 1024, при этом каждый элемент выходного вектора представляет собой линейную комбинацию входных признаков. Далее к каждому из 1024 элементов выхода добавляется вектор смещения b1, что позволяет модели независимо смещать выходные значения входных признаков. Кроме того, член L2-регуляризации λ||W1||22 штрафует большие веса, что препятствует чрезмерной зависимости модели от одного нейрона и помогает избежать переобучения. Здесь W1 — матрица весов конкретного слоя в нейронной сети, ||W1||22 обозначает квадрат L2-нормы матрицы весов W1, а λ — параметр регуляризации, контролирующий степень применяемой регуляризации, который для всех блоков был установлен равным 0.1. Z1 становится новым представлением признаков после применения полносвязного слоя и L2-регуляризации к входным данным, переданным из конкатенированного вектора G, что показано в уравнении 6.
После получения выходных данных от плотного слоя блока 1 в виде Z1 был применен слой BatchNormalization, который использовался для ускорения процесса обучения; уравнение 7 ниже демонстрирует принцип его работы.
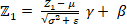 (7)
σ2 представляет собой дисперсию выходных данных последнего слоя Z1 по всему пакету, в то время как μ — это среднее значение выхода Z1, которое рассчитывается отдельно для каждого нейрона (их количество в первом полносвязном слое составляло 1024). ε представляет собой малую константу, которая вводится для обеспечения численной стабильности и предотвращения деления на ноль. Модель может корректировать нормированный выход путем изменения обучаемого параметра масштабирования γ, а также смещать его с помощью обучаемого параметра сдвига β. В конечном итоге применение слоя BatchNormalization к выходу полносвязного слоя гарантирует, что нормированный выход Z1 имеет согласованное распределение активаций в различных слоях, что способствует стабилизации и ускорению процесса обучения. После BatchNormalization нормированный выход Z1 проходит через функцию активации leaky ReLU, которая вносит в сеть нелинейность, позволяя извлекать сложные закономерности из данных. Вместо ReLU или другой функции активации была выбрана leaky ReLU — модифицированная версия функции ReLU, которая учитывает небольшие отрицательные значения вместо того, чтобы обнулять их, как это делает стандартная функция ReLU, что позволяет преодолеть проблему «отмирания ReLU» (dying ReLU problem). Принцип ее работы показан в уравнении 8 ниже.
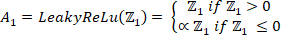 (8)
Где Z1 представляет собой выход слоя BatchNormalization, который передается в Leaky ReLU в качестве входных данных для обеспечения нелинейности, а ∝ — это малая константа, используемая для определения наклона отрицательной части функции. Далее, A1 обозначает результат, полученный после применения нелинейности. Наконец, к выходу A1, полученному в результате активации Leaky ReLu, применяется слой dropout, что показано в уравнении 9.
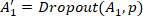 (9)
Здесь A1 — исходный выход функции активации, полученный от последней функции активации ReLu, а p — вероятность исключения (dropout rate), которая варьируется от 0 до 1 и была выбрана как 0,3, 0,2 и 0,1 для трех слоев блоков соответственно, чтобы исключить определенную долю нейронов. Далее, A1′ представляет собой измененный выход после применения слоя dropout, в котором некоторые нейроны были обнулены. Основным преимуществом использования данного метода является предотвращение переобучения, а также снижение коадаптации. Кроме того, выход из первого блока A1′ снова передается в следующий блок для повторного извлечения более абстрактных признаков с применением тех же параметров, что и в блоке 1, за исключением использования 512 нейронов в полносвязном слое вместо 1024 и вероятности исключения 0,2 вместо 0,3; остальные последовательности операций идентичны, что описано в уравнениях 10–13 ниже.
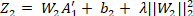 (10)
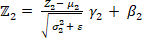 (11)
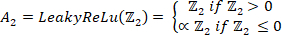 (12)
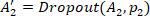 (13)
После получения выходных данных из блока 1 в виде A1′, они передаются через полносвязный слой (dense layer) блока 2 с 512 нейронами, где матрица весов W2 преобразует входной вектор A1′ в 512-мерный выходной вектор, и каждый элемент этого вектора представляет собой линейную комбинацию входных признаков. Далее к каждому из 512 элементов выхода добавляется вектор смещения b2, что позволяет модели независимо смещать выходные значения входных признаков. Кроме того, применяется L2-регуляризация, где член λ||W2||22 штрафует большие значения весов, что служит для уменьшения переобучения, предотвращая чрезмерную зависимость модели от любого конкретного нейрона в данном блоке. Здесь W2 — матрица весов определенного слоя нейронной сети, а λ — параметр регуляризации, контролирующий степень применяемой регуляризации, который был установлен равным 0.1. Z2 становится новым представлением признаков после применения полносвязного слоя и L2-регуляризации к входным данным, переданным из блока 1, что показано в уравнении 10.
Кроме того, слой BatchNormalization был применен к новому признаку Z2 для ускорения процесса обучения, где σ22 представляет собой дисперсию по пакету, а μ2 — среднее значение выходного сигнала Z2. В то время как ε является малой константой, введенной для обеспечения численной устойчивости, γ представляет собой обучаемый параметр масштабирования, позволяющий модели изменять нормализованный выход, а β — обучаемый параметр сдвига, позволяющий модели смещать нормализованный выход. Наконец, после применения слоя BatchNormalization, описанного в уравнении 1, нормализованный выход Z2 проходит через функцию активации leaky ReLU, которая обеспечивает нелинейность сети, что показано в уравнении 12. Здесь Z2 является выходом слоя BatchNormalization, который поступает на вход Leaky ReLU для реализации нелинейности. При этом A2 обозначает результат, полученный после применения нелинейности.
Наконец, к выходу A2, полученному на вход от активации Leaky ReLU, применяется слой исключения (dropout), что показано в уравнении 13. Здесь A2 — это выход, полученный от последней функции активации ReLU, а p2 — коэффициент исключения, который для данного блока был выбран равным 0.2 для отсечения части нейронов. Далее A2′ представляет собой модифицированный выход после применения слоя исключения, в котором некоторые нейроны были обнулены. Затем выход из блока 2 A2′ снова передается в третий блок для повторного извлечения более абстрактных признаков; при этом используются те же параметры, что и в блоке 2, за исключением того, что в плотном слое используется 256 нейронов вместо 512, а коэффициент исключения составляет 0.1 вместо 0.2. Остальные операционные последовательности идентичны, что описано в уравнениях 14–17 ниже.
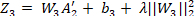 (14)
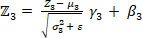 (15)
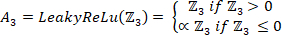 (16)
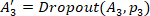 (17)
После получения на выходе блока 2 значения A2′, оно передается через полносвязный слой (dense layer) блока 3 с 256 нейронами, где матрица весов W3 преобразует входной вектор A2′ в 256-мерный выходной вектор, при этом каждый элемент выходного вектора представляет собой линейную комбинацию входных признаков. Далее к каждому из 256 элементов выхода добавляется вектор смещения b3, что позволяет модели независимо смещать выходные значения входных признаков. Кроме того, применяется L2-регуляризация, где λ||W3||22 штрафует большие веса, что препятствует чрезмерной зависимости модели от одного нейрона и помогает избежать переобучения. Здесь W3 — матрица весов конкретного слоя нейронной сети, а степень применяемой регуляризации контролируется параметром регуляризации λ, который был установлен на уровне 0.01. Z3 становится новым представлением признаков после применения полносвязного слоя и L2-регуляризации к входным данным, переданным из блока 3, что показано в уравнении 14.
Кроме того, к новому признаку Z3 был применен слой BatchNormalization, который использовался для ускорения процесса обучения; σ32 представляет собой дисперсию по батчу, в то время как μ3 — среднее значение выходного сигнала Z3. При этом ε — малая константа, добавляемая для обеспечения численной устойчивости. Нормализованный выход может быть скорректирован моделью с помощью обучаемого параметра масштабирования γ3 и смещен с помощью обучаемого параметра сдвига β3. Наконец, после применения слоя BatchNormalization, что показано в уравнении 15, нормализованный выход Z3 проходит через функцию активации leaky ReLU, которая обеспечивает нелинейность в сети, что показано в уравнении 16. Здесь Z3 является выходом слоя BatchNormalization, который поступает на вход Leaky ReLU для реализации нелинейности, а A3 представляет собой результат после применения нелинейности.
Наконец, к выходу A3, полученному на вход от функции активации Leaky ReLU, применяется слой дропаута (dropout), что показано в уравнении 17. Здесь A3 — это выход, полученный от последней функции активации ReLU, а p3 — вероятность исключения (dropout rate), которая для данного блока была выбрана равной 0.1 для исключения определенной доли нейронов. Далее A3′ представляет собой модифицированный выход после применения слоя дропаута, в котором значения некоторых нейронов были установлены в 0.
Кроме того, выход из блока 3 A3′ проходит через последний плотный слой для целей классификации с количеством нейронов K, которое соответствует фактическому количеству классов в наборе данных, что описано в уравнении 18 ниже.
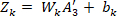 (18)
Матрица весов, связанная с толстым слоем, — это Wk, которая отвечает за преобразование 256-мерного вектора A3′ в k-мерный вектор, представляющий извлеченные признаки из предыдущего блока и являющийся выходным значением. Кроме того, bk представляет собой вектор смещения, который корректирует предсказание, чтобы функция активации имела ненулевой выход при нулевом входном сигнале, а Zk является выходом последнего слоя перед применением функции активации; он генерирует логиты для каждого класса, и в конце был применен классификатор SoftMax41, который преобразует логит Zk в вероятность каждого класса, что показано в уравнениях 19 и 20.
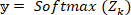 (19)
 (20)
Здесь прогнозируемая вероятность ith класса представлена как yi, K — количество классов, Zk, i — логит для ith класса, а eZk, i — экспонента логита ith класса. y отображает распределение вероятностей всех возможных классов и обеспечивает, чтобы сумма вероятностей была равна 1. В Таблице 3 ниже приведены сведения о гиперпараметрах, использованных для обучения предлагаемой гибридной модели, включая архитектурные детали, принятые для повышения воспроизводимости и производительности.
| Гиперпараметры | Предлагаемая модель (FusionNetX) |
| Размер изображения | 224 × 224 |
| Архитектура базовой сети | Предобученные модели EfficientNetB7 и DenseNet121 в качестве BBA1 и BBA2 |
| Аугментация данных | Диапазон вращения = 7, |
| Ширина/высота – диапазон сдвига до 0,05, | |
| Диапазон масштабирования до 0,01, | |
| Отражение по горизонтали/вертикали | |
| Коэффициент разделения данных | 80% для обучения и 20% для валидации с использованием стратифицированной выборки и фиксированным randome_state = 42 |
| Извлечение и объединение признаков | Глобальный усредняющий пулинг применяется к выходным данным каждой базовой сети: 2560 для BBA1 и 1024 для BBA2, которые затем объединяются для получения совместных векторов признаков размерностью 3584. |
| Состав полносвязного блока | 3 полносвязных блока с одним выходным слоем. Каждый блок содержит L2-регуляризацию (λ=0,01), пакетную нормализацию (BatchNormalization), LeakyReLU (α=0,01), Dropout (0,3, 0,2 и 0,1 соответственно) и скрытую размерность (1024, 512, 256 соответственно). Дополнительные перекрестные связи (Skip connections) в объединяющей головке (fusion head) не используются. |
| Функция активации | Leaky ReLU (линейный выпрямитель с утечкой) & SoftMax |
| Оптимизатор и скорость обучения | Adam с фиксированным значением 0,01 без планировщика скорости обучения. |
| Функция потерь | разреженная категориальная перекрестная энтропия |
| Размер партии | 16 |
| Эпохи | 10 фиксированных эпох для каждого набора данных |
| Используемая платформа | Блокнот Kaggle с графическим процессором P10 и 16 ГБ видеопамяти (VRAM) с использованием платформ TensorFlow и Keras. |
Таблица 3: Гиперпараметры, использованные для обучения предлагаемой модели, и предлагаемые архитектурные особенности.В этой таблице приведены структурные и архитектурные характеристики предлагаемой модели, а также точно настроенные параметры и среда реализации.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Результаты
В данном разделе подробно описаны результаты тестирования предложенной модели двойного слияния признаков на пяти открытых наборах данных по раку мозга, включая Br35H, Figshare, Sartaj, Masoud и Balanced Brain tumor; эффективность моделей оценивалась с использованием различных статистических параметров оценки производительности, таких как точность (accuracy)42,43,4, доля ошибочно классифицированных объектов (MCR)
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Обсуждение
В заключение, предложенная модель работала следующим образом: во-первых, размер изображения был выбран равным 224 × 224, что является умеренным размером для любой модели глубокого обучения для извлечения и изучения подходящих признаков из образцов данных при сохранении всей важной информации; далее была выполнена аугментация данных, что более эффективно для создания образцов данных в более разнообразных направлениях, что играет важную роль для извлечения моделями признаков с разных плоскостей или ракурсов, при этом диапа...
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Раскрытие информации
Авторы не имеют сведений о раскрытии и конфликтов интересов. Кроме того, при подготовке рукописи и иллюстраций инструменты ИИ не использовались.
Благодарности
Авторы выражают благодарность за поддержку, оказанную в рамках проекта поддержки исследователей Университета принцессы Нуры бинт Абдулрахман (PNURSP2026R192), Университет принцессы Нуры бинт Абдулрахман, Эр-Рияд, Саудовская Аравия. Авторы также благодарят участников исследования и учреждения, которые внесли вклад в данную работу.
Финансирование:
Эта работа была поддержана грантом Национального исследовательского фонда Кореи (NRF), финансируемым правительством Кореи (MSIT) (№ RS-2023-00218176), и исследовательским фондом Университета Сунчунхян. Проект по поддержке исследователей Университета принцессы Нуры бинт Абдуррахман, номер (PNURSP2026R192), Университет принцессы Нуры бинт Абдуррахман, Эр-Рияд, Саудовская Аравия.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Материалы
| Имя | Компания | Каталожный номер | Комментарии |
|---|---|---|---|
| Набор данных опухолей мозга Br35H | Kaggle (автор набора данных) | https://www.kaggle.com/datasets/ahmedhamada0/brain-tumor-detection | Общедоступный набор данных; бинарная классификация (опухоль / нет опухоли), 300 МРТ-изображений |
| Набор данных опухолей мозга Figshare | Kaggle / Figshare | https://doi.org/10.6084/m9.figshare.1512427 | Общедоступный набор данных; многоклассовая классификация (глиома, менингиома, опухоль гипофиза), 3064 МРТ-изображения |
| Набор данных МРТ для классификации опухолей мозга Sartaj | Kaggle (набор данных Sartaj Bhuvaji) | https://doi.org/10.34740/kaggle/dsv/12745533 | Общедоступный набор данных; многоклассовая классификация (глиома, менингиома, нет опухоли, опухоль гипофиза), 3264 МРТ-изображения |
| Набор данных МРТ опухолей мозга Masoud | Kaggle (набор данных Masoud Nickparvar) | https://doi.org/10.34740/kaggle/dsv/14832123 | Общедоступный набор данных; многоклассовая классификация (глиома, менингиома, нет опухоли, опухоль гипофиза), 7023 МРТ-изображения |
| BBT-Dataset (Набор данных опухолей мозга) | Kaggle (автор набора данных) | https://doi.org/10.34740/kaggle/dsv/6758053 | Общедоступный набор данных; сбалансированный многоклассовый набор данных опухолей мозга, 5248 МРТ-изображений |
| Python | Python Software Foundation | https://www.python.org | Язык программирования, версия 3.10.13 |
| TensorFlow / Keras | Google / разработчики TensorFlow | https://www.tensorflow.org | Фреймворк глубокого обучения; построение, обучение и оценка моделей, версия 2.15.0 |
| EfficientNetB7 (предобученная) | Google / Keras Applications | https://keras.io/api/applications/efficientnet/ | Предобученная на ImageNet базовая сеть; извлечение признаков |
| DenseNet121 (предобученная) | Keras Applications | https://keras.io/api/applications/densenet/ | Предобученная на ImageNet базовая сеть; извлечение признаков |
| scikit-learn | разработчики scikit-learn (NumFOCUS) | https://scikit-learn.org | Кодирование меток, разделение на обучающую и тестовую выборки, метрики оценки (отчет о классификации, матрица ошибок, ROC/AUC) |
| OpenCV (cv2) | команда OpenCV | https://opencv.org | Загрузка и изменение размера изображений |
| NumPy | разработчики NumPy (NumFOCUS) | https://numpy.org | Численные вычисления и операции с массивами |
| pandas | команда разработки pandas (NumFOCUS) | https://pandas.pydata.org | Организация данных и табуляция метрик |
Ссылки
- He Z, et al. A review on methods for diagnosis of breast cancer cells and tissues. Cell Prolif. 2020;53(7):e12822. doi:10.1111/cpr.12822.
- Siegel RL, Giaquinto AN, Jemal A. Cancer statistics, 2024. CA Cancer J Clin. 2024;74(1):12–49.
- Varuna Shree N, Kumar TNR. Identification and classification of brain tumor MRI images with feature extraction using DWT and probabilistic neural network. Brain Inform. 2018;5(1):23–30.
- Ghoreishi Mokri SM, Valadbeygi N, Grigoryeva V. Diagnosis of glioma, menigioma and pituitary brain tumor using MRI images recognition by deep learning in Python. EAI Endorsed Trans Intell Syst Mach Learn Appl. 2024;1:1–9.
- Sadeghi MH, et al. Deep learning in ovarian cancer diagnosis: a comprehensive review of various imaging modalities. Pol J Radiol. 2024;89:e30–e48.
- Anari S, Safarpour H, Cunneen M, Bendechache M. AR-EpiAid: an augmented reality decision support system for real-time interpretation of multimodal epilepsy data [conference paper]. Presented at: 3rd International Conference on Artificial Intelligence, Computer, Data Sciences, and Applications; Boracay Island, Philippines; 2026. https://doi.org/10.1109/ACDSA67686.2026.11468245.
- Iyortsuun NK, et al. A review of machine learning and deep learning approaches on mental health diagnosis. Healthcare (Basel). 2023;11(3):285. doi:10.3390/healthcare11030285.
- An Q, Rahman S, Zhou J, Kang JJ. A comprehensive review on machine learning in the healthcare industry: classification, restrictions, opportunities, and challenges. Sensors (Basel). 2023;23(9):4178. doi:10.3390/s23094178.
- Iqbal S, Qureshi AN, Li J, Mahmood T. On the analyses of medical images using traditional machine learning techniques and convolutional neural networks. Arch Comput Methods Eng. 2023;30:3173–3233.
- Chhimpa GR, et al. A transfer learning-driven fine-tuning of YOLOv10 for improved brain tumor detection in MRI images. Sci Rep. 2026;16:98. doi:10.1038/s41598-025-28813-w.
- Akbarian S, Seyyed-Kalantari L, Khalvati F, Dolatabadi E. Evaluating knowledge transfer in the neural network for medical images. IEEE Access. 2023;11. doi:10.1109/ACCESS.2023.3283216.
- Meena G, Mohbey KK, Acharya M, Lokesh K. An improved convolutional neural network-based model for detecting brain tumors from augmented MRI images. J Auton Intell. 2023;6:1–19.
- Ata MM, Yousef RN, Karim FK, Khafaga DS. An improved deep structure for accurately recognizing brain tumors. Comput Syst Sci Eng. 2023;46(2):1597–1616.
- Khushi HMT, et al. Performance analysis of state-of-the-art CNN architectures for brain tumour detection. Int J Imaging Syst Technol. 2024;34:e22949. doi:10.1002/ima.22949.
- Agarwal M, et al. Deep learning for enhanced brain tumor detection and classification. Results Eng. 2024;22:102117. doi:10.1016/j.rineng.2024.102117.
- Peddinti AS, Maloji S. Optimised ResNet50 for multiclass classification of brain tumors. Scalable Comput Pract Exp. 2024;25(3):1667–1680.
- Zahoor MM, et al. Brain tumor MRI classification using a novel deep residual and regional CNN. Biomedicines. 2024;12(7):1395. doi:10.3390/biomedicines12071395.
- Chen W, et al. A robust approach for multitype classification of brain tumors using deep feature fusion. Front Neurosci. 2024;18:1288274. doi:10.3389/fnins.2024.1288274.
- Suryawanshi S, Patil SB. Efficient brain tumor classification with a hybrid CNN-SVM approach in MRI. J Adv Inf Technol. 2024;15:340–354.
- Reyes D, Sánchez J. Performance of convolutional neural networks for the classification of brain tumors using magnetic resonance imaging. Heliyon. 2024;10:e25468. doi:10.1016/j.heliyon.2024.e25468.
- Bibi N, et al. A transfer learning-based approach for brain tumor classification. IEEE Access. 2024;12:111218–111238.
- Albalawi E, et al. Integrated approach of federated learning with transfer learning for classification and diagnosis of brain tumor. BMC Med Imaging. 2024;24:110. doi:10.1186/s12880-024-01261-0.
- Alkhatib AJ, et al. Diagnosing brain tumors from MRI images through a multi-fused CNN with auxiliary layers. Sustain Mach Intell J. 2024;6(1):4–13.
- Hamada A. Br35H: Brain Tumor Detection 2020 [dataset]. Kaggle; 2020. Available from: https://www.kaggle.com/datasets/ahmedhamada0/brain-tumor-detection.
- Cheng J. Brain tumor dataset [dataset]. Figshare; 2024. Available from: https://doi.org/10.6084/m9.figshare.1512427.
- Bhuvaji S. Brain Tumor Classification (MRI) [dataset]. Kaggle; cited 2026 Jul 30. Available from: https://doi.org/10.34740/kaggle/dsv/12745533.
- Nickparvar M. Brain Tumor MRI Dataset [dataset]. Kaggle; cited 2026 Jul 30. Available from: https://doi.org/10.34740/kaggle/dsv/14832123.
- Jayanti V. Brain Tumor MRIs [dataset]. Kaggle; cited 2026 Jul 30. Available from: https://doi.org/10.34740/kaggle/dsv/6758053.
- Tuteja P, et al. Augmented multimodal fusion for optimized brain tumor detection: evaluation and comparative analysis. J Vis Exp. 2025;(220):e67822. doi:10.3791/67822.
- Rasool N, et al. CNN-TumorNet: leveraging explainability in deep learning for precise brain tumor diagnosis on MRI images. Front Oncol. 2025;15:1554559. doi:10.3389/fonc.2025.1554559.
- Huang G, Liu Z, van der Maaten L, Weinberger KQ. Densely connected convolutional networks [conference paper]. Presented at: IEEE Conference on Computer Vision and Pattern Recognition; Honolulu, HI, USA; 2017. p. 4700–4708. Available from: https://openaccess.thecvf.com/content_cvpr_2017/html/Huang_Densely_Connected_Convolutional_CVPR_2017_paper.html.
- Tuteja P, Wani MA, Wani NA, Bedi J. EASE-Net: an explainable AI-based segmentation and ensemble network for interpretable brain tumor diagnosis and classification in MRI images. Arab J Sci Eng. 2026;in press. doi:10.1007/s13369-026-11350-7.
- Tan M, Le QV. EfficientNet: rethinking model scaling for convolutional neural networks [conference paper]. Presented at: 36th International Conference on Machine Learning; Long Beach, CA, USA; 2019. p. 6105–6114. Available from: https://proceedings.mlr.press/v97/tan19a.html.
- Vellaichamy AS, Swaminathan A, Varun C, Kalaivani S. Multiple plant leaf disease classification using DenseNet-121 architecture. Int J Electr Eng Technol. 2021;12(5):38–57.
- Naidji MR, Elberrichi Z. Automatic detection of COVID-19 from chest X-ray images using the EfficientNet-B7 CNN model with channel-wise attention. Int J Comput Digit Syst. 2024;15:1443–1456.
- Malla PP, Sahu S, Alutaibi AI. Classification of tumors in brain MR images using a deep convolutional neural network and global average pooling. Processes. 2023;11(3):679. doi:10.3390/pr11030679.
- Shi G, Zhang J, Li H, Wang C. Enhance the performance of deep neural networks via L2 regularization on the input of activations. Neural Process Lett. 2019;50:57–75.
- Srivastava N, et al. Dropout: a simple way to prevent neural networks from overfitting. J Mach Learn Res. 2014;15:1929–1958.
- Ioffe S, Szegedy C. Batch normalization: accelerating deep network training by reducing internal covariate shift [conference paper]. Presented at: 32nd International Conference on Machine Learning; Lille, France; 2015. p. 448–456. Available from: https://proceedings.mlr.press/v37/ioffe15.html.
- Varshney M, Singh P. Optimizing nonlinear activation functions for convolutional neural networks. Signal Image Video Process. 2021;15:1323–1330.
- Bera S, Shrivastava VK. Analysis of various optimizers on a deep convolutional neural network model in the application of hyperspectral remote-sensing image classification. Int J Remote Sens. 2020;41:2664–2683.
- Safarpour H, et al. A dual-phase segmentation framework utilizing Gumbel-Softmax and a cascaded Swin Transformer for multiclass brain tumor segmentation. Research Square. 2025:doi:10.21203/rs.3.rs-7093467/v1.
- Seyrek EC, Uysal M. A comparative analysis of various activation functions and optimizers in a convolutional neural network for hyperspectral image classification. Multimed Tools Appl. 2024;83:53785–53816.
- Maxwell AE, Warner TA, Guillén LA. Accuracy assessment in convolutional neural network-based deep-learning remote-sensing studies—part 1: literature review. Remote Sens (Basel). 2021;13(13):2450. doi:10.3390/rs13132450.
- Villon S, et al. A new method to control error rates in automated species identification with deep-learning algorithms. Sci Rep. 2020;10:10972. doi:10.1038/s41598-020-67573-7.
- Rasool N, et al. TransResUNet: revolutionizing glioma brain tumor segmentation through transformer-enhanced residual UNet. IEEE Access. 2024;12:72105–72116.
- Chen Y, et al. Evaluation efficiency of hybrid deep-learning algorithms with neural-network decision-tree and boosting methods for predicting groundwater potential. Geocarto Int. 2022;37:5564–5584.
- Alakus TB, Turkoglu I. Comparison of deep-learning approaches to predict COVID-19 infection. Chaos Solitons Fractals. 2020;140:110120. doi:10.1016/j.chaos.2020.110120.
- Ranjbarzadeh R, et al. Explainable attention-guided Swin Transformer networks for brain tumor segmentation from 3D MRI. Lect Notes Netw Syst. 2026;1730:110–128. Available from: https://lero.ie/bibliography/explainable-attention-guided-swin-transformer-networks-for-brain-tumor-segmentation-from-3d-mri/.
- Ranjbarzadeh R, et al. A global-local 3D brain tumor segmentation model using vision transformers and axial state-space modeling [conference paper]. Presented at: 3rd International Conference on Artificial Intelligence, Computer, Data Sciences, and Applications; Boracay Island, Philippines; 2026. https://doi.org/10.1109/ACDSA67686.2026.11468214.
- Hussain SS, et al. Next-generation automation in neuro-oncology: advanced neural networks for MRI-based brain tumor segmentation and classification. IEEE Access. 2025;13:41141–41158.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.