В данной статье представлен вычислительный рабочий процесс под контролем человека для изучения повторяющихся образов женщин в 433 китайских экспортных картинах эпохи Цин. Семь категорий человеческих эталонов и повторяющиеся визуальные признаки характеризуют закономерности внутри корпуса, при этом полученные результаты ограничены выборкой изображений и не являются мерой социальной реальности или исторического восприятия эпохи Цин.
Исследовательская статья
Женская идентичность и классовое воображение в китайской экспортной живописи эпохи Цин: исследование кросс-культурной интерпретации с применением искусственного интеллекта
В этой статье
Краткое содержание
Аннотация
В данном исследовании изучались повторяющиеся репрезентации женской идентичности и визуальные признаки классовой принадлежности в корпусе из 433 китайских экспортных картин периода Цин, датированных 1757–1911 гг. Рабочий процесс сочетал использование CLIP ViT-B/32 для предварительной разметки, локализацию с помощью Segment Anything Model (SAM), снижение размерности и кластеризацию, а также ручное иконографическое кодирование двумя независимыми кодерами. Метки CLIP использовались для предварительной организации, SAM служил вспомогательным средством локализации, а согласованное человеческое кодирование обеспечило эталонные категории. В совокупности результатов было выделено семь эталонных категорий: элита/красавицы (n = 112), трудящиеся (n = 72), домашний быт (n = 64), служанки (n = 58), ритуал/свадьба (n = 45), рынок (n = 43) и исполнительское искусство (n = 39). Предварительные вычислительные метки совпали с эталонными метками человека для 356 из 433 картин (82,2%), при этом полнота на уровне категорий варьировалась от 73,3% до 88,4%. Для характеристики визуальных профилей этих категорий использовались повторяющиеся сочетания одежды, пространственной обстановки, предметов, позы и изображенных социальных отношений. Оценка 433 пар меток «ИИ — человек» на уровне отдельных случаев позволила получить комплексные показатели точности, полноты и F1-меры на уровне категорий, а также матрицу ошибок, детализирующую паттерны классификации. Валидация кластеров подтвердила выбранное решение по кластеризации и продемонстрировала соответствие между полученными кластерами и определенными человеком эталонными категориями. В целом, повторяющиеся сочетания одежды, пространственной обстановки, предметов, позы и социальных отношений указывают на наличие структурированных живописных типологий в исследуемом корпусе. Эти результаты характеризуют визуальную репрезентацию в китайской экспортной живописи периода Цин, но их не следует интерпретировать как прямые показатели правового статуса, реального жизненного опыта, рыночного спроса или исторического восприятия за рубежом.
Введение
Китайская экспортная живопись эпохи Цин была частью коммерческих и культурных сетей, связывавших Кантон и другие центры коллекционирования с евро-американскими покупателями, начиная с конца восемнадцатого века1,2,3,4,5. Купцы, путешественники, дипломаты, миссионеры и коллекционеры приобретали эти картины как портативные товары, сувениры, источники визуальной информации, а также как репрезентации мест, профессий, производства, обычаев и социальных типов. Таким образом, их распространение отражало как практику китайских мастерских, так и ожидания внешних рынков.
Иностранный спрос был ориентирован на узнаваемых персонажей, серийные форматы, повторяющиеся мотивы и сцены, которые можно было бы коллекционировать и сравнивать. Мастерские адаптировали технику, масштаб, композицию и тематику под требования рынка, в то время как покупатели зачастую отдавали предпочтение доступным для понимания изображениям ремесел, церемоний, интерьеров, садов, улиц и живописных социальных типов. Повторяющиеся версии сцен из кантонских мастерских дополнительно демонстрируют, как художники и их помощники адаптировали иконографию и западные изобразительные приемы для зарубежных заказчиков1,2,3,4,5. Хотя рыночный спрос мог повлиять на то, что создавалось и сохранилось, данный корпус работ не позволяет напрямую оценить предпочтения или реакции отдельных покупателей.
Следовательно, данные картины следует рассматривать как селективные и опосредованные источники, а не как исчерпывающие записи повседневной жизни. Их сюжеты могут идеализировать, упрощать, стандартизировать или адаптировать социальные практики в соответствии с правилами мастерских, рыночным отбором, музейным приобретением, каталогизацией и оцифровкой1,2,3,4,5. Историческая интерпретация должна разграничивать особенности, непосредственно наблюдаемые на картинах, и выводы об изображенных людях, условиях создания произведений и смыслах, которые более поздние зрители приписывали этим работам.
Женские фигуры позволяют целенаправленно изучить это различие. Одежда, прическа, поза, пространственное окружение, предметы, виды деятельности и отношения с другими фигурами могут объединять женщин в визуально повторяющиеся роли, включая категории элиты/красоты, домашнего быта, служанок, трудящихся, рыночной торговли, исполнительского искусства и ритуалов/свадеб. Эти категории представляют собой аналитические описания живописных паттернов и сами по себе не определяют правовой статус, богатство, род занятий, этническую принадлежность, принадлежность к баннерам или ханьцам, моральный облик или реальную идентичность.
Цифровая история искусств и компьютерное зрение позволяют проводить крупномасштабные сравнения оцифрованных визуальных коллекций, а также обеспечивают возможность критического анализа допущений, заложенных в вычислительные модели6,7. Модели «зрение-язык» могут помочь в выявлении и систематизации повторяющихся визуальных мотивов, хотя культурная предвзятость остается существенным ограничением при применении словарей современных моделей к историческим изображениям не-западного происхождения8. Аналогичные вычислительные исследования традиционной китайской живописи также демонстрируют ценность сочетания количественного обнаружения паттернов с исторически обоснованной интерпретацией9.
В данном исследовании рассматриваются три вопроса: (1) Какие утвержденные категории женской идентичности, закодированные человеком, представлены в корпусе? (2) Какие комбинации одежды, пространственного окружения, предметов, позы и социальных отношений характеризуют эти категории? (3) Как общая точность полного совпадения и полнота на уровне категорий варьируются в зависимости от семи категорий? Рабочий процесс опирается на вычислительные подходы к традиционной китайской живописи9, при этом исторические выводы ограничиваются выбранными изображениями и задокументированным анализом.
Данный вклад имеет как историографический, так и технический характер. Сравнение в масштабе всего корпуса позволяет выявить повторяющиеся иконографические формулы, которые впоследствии могут быть контекстуализированы посредством детального исторического анализа. Такой подход может быть полезен для исследований гендера, иерархии, репрезентаций повседневной жизни и межкультурных контактов, при этом не трактуя частоту появления изображений как доказательство социальной распространенности, а визуальное сходство — как подтверждение исторической идентичности.
Протокол
Дизайн исследования и аналитическая единица
Каждая картина или запись в каталоге рассматривалась как одна аналитическая единица. Использовался обсервационный дизайн на основе корпуса данных, сочетающий обзор метаданных, предварительную компьютерную организацию, независимое ручное кодирование и искусствоведческую интерпретацию. Период исследования был определен как 1757–1911 гг., и в рамках этого временного интервала применялись критерии включения и исключения. Анализировались исторические произведения искусства и связанные с ними метаданные каталогов. При сравнении распределений по временным интервалам неодинаковой продолжительности количество объектов нормализовалось по длительности интервала, а при интерпретации учитывались возможные систематические ошибки, связанные с сохранностью и приобретением работ.
Формирование и отбор корпуса
Записи-кандидаты были извлечены из цитируемых музейных каталогов, цифровых архивов и опубликованных каталогов. Для каждой записи были сохранены следующие данные: учреждение, название, дата или временной интервал, материал, инвентарный или каталожный номер, постоянный URL-адрес источника, дата извлечения и заявление о правах. Ссылки на источники сохранялись даже в тех случаях, когда соответствующий файл изображения не мог быть законно перераспределен. Описанная процедура скрининга началась с 612 изображений-кандидатов. Из них 85 были исключены, так как они не соответствовали периоду 1757–1911 гг. или традиции экспортной живописи, 58 были исключены, поскольку являлись современными репродукциями, размытыми записями или изображали неверные сюжеты, 29 были исключены из-за отсутствия идентифицируемой женской фигуры или недостаточного разрешения изображения, и 7 были исключены из-за недостаточных метаданных. Итоговый аналитический корпус составил 433 записи.
Стандартизация метаданных и предварительная обработка изображений
Каждому полотну в итоговом аналитическом корпусе был присвоен устойчивый идентификатор QEP в диапазоне от QEP_001 до QEP_433. Были сохранены соответствующие музейные метаданные, включая учреждение, инвентарный номер, название, дату, технику или материалы, место происхождения, ссылку на источник и доступное описание из каталога. Для визуального анализа фиксировались предварительная метка ИИ, верифицированная человеком категория, количество женских фигур, возрастная группа, поза, одежда, пространственная обстановка, связанные объекты и социальные отношения. Каждая картина была классифицирована по одной из семи основных категорий: элита/красота, домашняя обстановка, служанка, физический труд, рынок, исполнительское искусство или ритуал/свадьба. Для сцен, содержащих несколько женских фигур, центральная фигура определялась по визуальной значимости и повествовательной центральности. В случаях, когда ни одна женская фигура не была доминирующей, основная категория присваивалась на основе главного изображенного действия и общего контекста сцены. Перекрывающиеся категории разрешались путем приоритезации изображенного действия и контекста сцены над одной лишь одеждой или внешним видом. Неоднозначные случаи независимо рассматривались обоими кодировщиками и разрешались путем достижения консенсуса. Исходные изображения сохранялись в форматах JPEG или PNG. Обрезались только границы веб-страниц, рамки каталогов или неотносящиеся к изображению поля. Живописное содержание не подвергалось реконструкции, перекрашиванию, улучшению или реставрации.
Предварительная маркировка на основе CLIP
Для предварительного анализа сходства изображений и текста использовался кодировщик изображений CLIP ViT-B/329. Потенциальные термины идентификации включали: элитная женщина, домохозяйка, служанка, рабочая женщина, торговка, артистка, невеста и женщина при ритуале. Термины описания сцен включали: китайский интерьер, сад, уличный рынок, мастерская, производство чая, текстильные работы и церемониальная сцена. Для каждого изображения были сохранены полный набор шаблонов промптов, их порядок, любые методы ансамблирования промптов, процедуры нормализации текста, правила принятия решений, показатели достоверности и случаи равенства показателей.
Полный список промптов последовательно применялся ко всем изображениям с использованием модели OpenAI CLIP ViT-B/32, реализованной на Python 3.10 с PyTorch 2.0.1 и пакетом OpenAI CLIP. Инференс выполнялся на GPU с поддержкой CUDA с размером пакета 32 с использованием точности FP32. Каждое изображение было изменено в размере и обрезано по центру до 224 × 224 пикселей, а RGB-каналы были нормализованы с использованием преобразования предобработки, связанного с моделью ViT-B/32. Текстовые промпты были сконструированы с использованием определителей личности и сцены, описанных выше, и закодированы с помощью текстового энкодера CLIP. Косинусное сходство рассчитывалось между нормализованными эмбеддингами изображений и текста, и промпт с наивысшим показателем сходства назначался в качестве предварительной ИИ-метки. Показатели сходства для всех возможных меток были сохранены для последующего анализа человеком. Использовался фиксированный случайный seed 42; идентичные процедуры предобработки, шаблоны промптов и правила принятия решений применялись ко всем 433 картинам.
Локализация с помощью SAM
Модель Segment Anything (SAM) использовалась исключительно для локализации фигур, предметов одежды, мебели, инструментов, ритуальных объектов и архитектурных зон для визуального анализа человеком. Необходимо подчеркнуть, что SAM не участвовала в процессе классификации; ее маски, вырезанные фрагменты и производные признаки были изолированы от процессов маркировки и кластеризации CLIP, что гарантировало использование SAM только в качестве вспомогательного средства локализации без влияния на показатели эффективности классификации или их завышения.
При необходимости для уточнения локализации визуальных элементов применялись ручные точечные подсказки или ограничивающие рамки. Маски SAM генерировались для женских фигур, одежды, мебели, инструментов, ритуальных предметов и архитектурных элементов; каждый результат сегментации подвергался визуальному контролю на предмет надлежащего охвата областей. Полученные маски использовались для идентификации и анализа соответствующих иконографических особенностей, но не применялись для маркировки с помощью CLIP или присвоения категорий.
Снижение размерности и кластеризация
Были вычислены эмбеддинги изображений CLIP, а для двухмерной визуализации использовался метод UMAP с косинусным расстоянием10. Были зафиксированы представление, использованное для кластеризации, а также процедура предварительной обработки, размерность и определение расстояния.
Для выявления повторяющихся визуальных групп в корпусе изображений к представлениям признаков изображений были применены K-means и иерархическая кластеризация11. Потенциальные решения K-means для k = 5–9 оценивались с помощью коэффициента силуэта и индекса Дэвиса–Боулдина. Инициализация K-means++ проводилась с параметрами n_init = 10, max_iter = 300, tol = 1 × 10⁻4 и random_state = 42. Иерархическая кластеризация была выполнена с использованием агломеративной кластеризации со средним методом связывания (average linkage) и косинусным расстоянием. Варианты решений сравнивались с помощью количественных индексов валидации, анализа стабильности кластеров и искусствоведческой интерпретируемости; окончательный вариант кластеризации был выбран на основе наиболее согласованного представления повторяющихся визуальных паттернов. Результаты распределения по кластерам для каждой из 433 картин были сохранены для последующего сравнения с категориями, определенными человеком.
Ручное кодирование, обучение и согласование
Два кодировщика независимо проанализировали все 433 изображения, используя версионную книгу кодов, охватывающую основную категорию, количество фигур, возрастную группу, позу, одежду, пространственную обстановку, объекты и социальные отношения. Записи каждого кодировщика были сохранены до этапа согласования. Кодировщики имели соответствующую подготовку в области истории искусств и визуального анализа; их обучение проходило с использованием стандартизированного руководства по кодированию и репрезентативных примеров из корпуса живописи. Перед началом официального кодирования они выполнили калибровочное упражнение на 30 картинах для обеспечения единообразия интерпретации семи категорий идентичности и пяти измерений визуальных признаков.
В ходе формального кодирования оба кодера независимо оценивали все подходящие картины, не имея доступа к решениям друг друга по кодированию, предварительным меткам ИИ и распределению по кластерам. Межкодерная надежность оценивалась с помощью каппы Коэна. Наблюдаемое значение каппы для основной категории идентичности составило 0,88, а для категориальных переменных визуальных признаков — от 0,79 до 0,92, что свидетельствует о высокой степени согласованности между кодерами. Разногласия разрешались путем обсуждения и достижения консенсуса; итоговые коды категорий и визуальных признаков записывались для последующего анализа12. Метки, присвоенные до этапа согласования, были сохранены.
Согласованность ИИ и человека и оценка эффективности
Экспертная категория, определенная человеком, использовалась в качестве эталона для описательного сравнения с одной предварительной меткой ИИ для каждой картины. Общая точность точного совпадения была рассчитана как 356/433 (82,2%). Полнота категории рассчитывалась как число точных совпадений ИИ и человека, деленное на поддержку эталона человека для каждой категории. Поддержка категории, точные совпадения, несоответствия и соответствующие знаменатели были указаны в явном виде.
На основании 433 парных меток искусственного интеллекта и человека на уровне отдельных случаев были вычислены показатели ложноположительных результатов для целевого класса, а также точность (precision), полнота (recall) и F1-мера для каждой категории. Была построена полная матрица ошибок для анализа паттернов классификации вне главной диагонали, что в дальнейшем легло в основу анализа несоответствий, документации таксономии ошибок и правил принятия окончательных решений.
Пакет для воспроизведения и материалы
Вычислительный рабочий процесс и вспомогательные исследовательские материалы были организованы в репозитории с контролем версий. Пакет для воспроизведения был разработан таким образом, чтобы включать скрипты для предварительной обработки, анализа CLIP, локализации SAM, UMAP, кластеризации, анализа согласованности и построения графиков, а также кодовую книгу для ручного кодирования, конфигурационные файлы, информацию о зависимостях, производные выходные данные на уровне отдельных случаев и машиночитаемый перечень источников изображений и информации о правах. Архивированным исследовательским материалам был присвоен постоянный идентификатор для облегчения воспроизведения и повторного использования.
Для организации и управления метаданными использовалось программное обеспечение Microsoft Excel 2021. В вычислительном анализе применялись CLIP ViT-B/32 для предварительной разметки визуально-языковых признаков, SAM для локализации визуальных элементов, UMAP с косинусным расстоянием для снижения размерности, а также K-means и иерархическая кластеризация для эксплораторного анализа паттернов. Решения по кластеризации оценивались с помощью коэффициента силуэта и индекса Дэвиса–Боулдина, а согласованность между кодировщиками определялась с использованием каппы Коэна. Программная среда, конфигурации моделей, вычислительные настройки и случайные числа (random seeds), использованные на протяжении всего рабочего процесса, были задокументированы для обеспечения воспроизводимости результатов.
Результаты
Построение корпуса и описательный состав
На рисунке 1 представлен четырехпанельный обзор корпуса. На рисунке 1A показан процесс отбора записей: от 612 потенциальных кандидатов до 433 отобранных записей. На рисунке 1B приведены репрезентативные примеры медиафайлов и форматов. На рисунке 1C представлены данные по количеству записей для четырех временных интервалов, а на рисунке 1D обобщен состав корпуса по источникам и носителям. Поскольку временные интервалы охватывают разные периоды, данные показатели описывают состав сформированного корпуса и не должны интерпретироваться как исторические темпы производства.
Таблица 1 содержит сводные характеристики корпуса. Музейные коллекции составили 302 записи, цифровые архивы — 81, опубликованные каталоги — 50. Материалы были разделены на следующие категории: экспортная акварель (n = 176), живопись на сердцевине тростника (n = 112), лист экспортного альбома (n = 83), фигуративная живопись (n = 41) и прочие форматы (n = 21). Метаданные были классифицированы как полные (n = 288), частичные (n = 118) или минимальные (n = 27). Женские фигуры были разделены на центральные (n = 214), второстепенные (n = 102) или множественные (n = 117). Каждый блок классификации включал в себя все 433 записи.
Предварительные метки ИИ и эталонные категории, определенные человеком
В таблице 2 приведен обобщенный анализ согласованности между предварительными метками, сгенерированными ИИ, и эталонными категориями, определенными человеком, для 433 картин, в то время как в Дополнительной таблице 1 представлены соответствующие предварительные метки ИИ на уровне отдельных случаев, классификации кодировщиков, утвержденные эталонные категории, статус совпадения и назначения по кластерам. В целом, метки ИИ и эталонные метки совпали для 356 картин, что соответствует точности полного совпадения 82,2%. Полнота на уровне категорий рассчитывалась как доля точных совпадений ИИ и человека относительно эталонного количества случаев для каждой категории.
Полнота на уровне категорий варьировалась от 73,3% для сцен ритуалов/свадеб (33/45) до 88,4% для элиты/красоты (99/112). Полнота составила 84,7% для физического труда (61/72), 82,1% для выступлений (32/39), 79,7% для домашнего быта (51/64), 79,3% для слуг (46/58) и 79,1% для рынка (34/43). В целом, точное совпадение составило 356/433 (82,2%). Оценка пар на уровне конкретных случаев позволила рассчитать точность и F1-меры для всех семи категорий: точность варьировалась от 74,5% до 89,2%, а F1-меры — от 0,75 до 0,88. Подробная матрица ошибок с указанием ложноположительных результатов целевого класса и внедиагональных закономерностей представлена на Дополнительном рисунке 1.
Сводные данные о выявленных вычислительных паттернах
На рисунке 2 представлены четыре варианта отображения результатов вычислительного анализа. На рисунке 2A показана галерея из девяти картин с цветными масками сегментации, используемыми для визуальной локализации и анализа. На рисунке 2B представлен график рассеяния UMAP для полученных эмбеддингов изображений CLIP с контурами плотности, обозначенными C1–C7. На рисунке 2C приведено сравнение зарегистрированного количества картин (закрашенные точки) с полнотой охвата на уровне категорий (пустые круги), а на рисунке 2D представлена галерея репрезентативных картин, сгруппированных в соответствии с теми же метками. Валидация кластеров подтвердила правильность выбранного решения по кластеризации, для которого коэффициент силуэта составил 0.54, а индекс Дэвиса–Болдина — 0.92. Сопоставление полученных кластеров с человеческими категориями продемонстрировало высокую степень соответствия, при этом каждый выделенный кластер преимущественно соответствовал отдельной эталонной категории, определенной человеком.
Таблица 3 представляет семь зарегистрированных вычислительных профилей с размерами выборок, соответствующими семи категориям эталонных оценок человека. Таблица сопряженности «кластер по категориям» приведена в Дополнительной таблице 2 и показывает распределение семи установленных эталонных категорий человека по кластерам C1–C7. Анализ распределения этих конкретных случаев по кластерам показал, что вычислительная кластеризация позволила выявить визуальные структуры, которые тесно соответствуют семи эталонным категориям человека.
Ассоциации визуальных признаков и интерпретационный синтез
В таблице 4 обобщены качественные профили визуальных признаков, использованные для характеристики семи категорий, закодированных человеком. Эти профили описывают повторяющиеся связи между одеждой, пространственной обстановкой, позой, объектами и социальными отношениями. Они не были получены путем количественной перекрестной табуляции и, следовательно, не устанавливают правовой статус, этническую принадлежность, социальную причинность или восприятие аудиторией.
Рисунок 3 объединяет описательные количественные сводки закодированных визуальных признаков с интерпретационной концептуальной моделью. Рисунок 3A представляет семь согласованных категорий человеческих эталонов и объемы их выборок. Рисунок 3B показывает относительные связи между этими категориями и закодированными визуальными маркерами по пяти измерениям: одежда, пространственная обстановка, объекты, поза и социальные отношения. Отображаемая сила ассоциаций была рассчитана на основе аннотаций на уровне конкретных случаев в каждой категории человеческих эталонов. Рисунок 3C обобщает взаимосвязи между категориями человеческих эталонов, измерениями визуальной маркировки и архетипами классовой принадлежности, используя взвешенные потоки, полученные из закодированных наблюдений. Эти количественные зависимости характеризуют повторяющиеся репрезентативные паттерны в выбранных картинах и не должны интерпретироваться как оценки исторических демографических или социальных распределений. Рисунок 3D представляет концептуальную модель кросс-культурной интерпретации и должна пониматься как исторически обоснованная интерпретационная база, а не как эмпирически проверенный причинно-следственный путь.
Интегративная интерпретация визуальных паттернов
В исследуемом корпусе семь категорий женской идентичности характеризовались повторяющимися сочетаниями одежды, пространственного окружения, предметов, поз и социальных отношений. Эти сочетания предоставили описательные доказательства наличия устойчивых визуальных конвенций в отобранных картинах. Исторические интерпретации, касающиеся гендера, иерархии и кросс-культурного посредничества, оставались на уровне умозаключений.
В совокупности полученные результаты позволили выделить семь категорий женской идентичности, определенных человеком, и пять повторяющихся измерений, используемых для их характеристики: одежда, пространственная обстановка, объекты, поза и социальные отношения. Предварительные метки ИИ совпали с согласованными человеческими категориями для 356 из 433 картин (82,2%), при этом самый низкий показатель полноты (recall) на уровне категорий наблюдался для ритуальных/свадебных сцен (73,3%). Эти результаты подтвердили возможность описательной организации и сравнения корпуса данных. Метки ИИ и человека на уровне отдельных случаев позволили рассчитать точность (precision) и F1-меру на уровне категорий. Отдельно проведенный кластерный анализ выявил структуры, которые соответствовали семи категориям, определенным человеком. Тем не менее, эти вычислительные результаты характеризуют конвенции визуального представления, а не устанавливают причинно-следственные связи с исторической социальной реальностью или восприятием аудитории.
ДОСТУПНОСТЬ ДАННЫХ:
Данные, подтверждающие результаты настоящего исследования, включая метаданные, информацию об источниках и записи о скрининге, доступны через Zenodo по адресу https://doi.org/10.5281/zenodo.21130291.
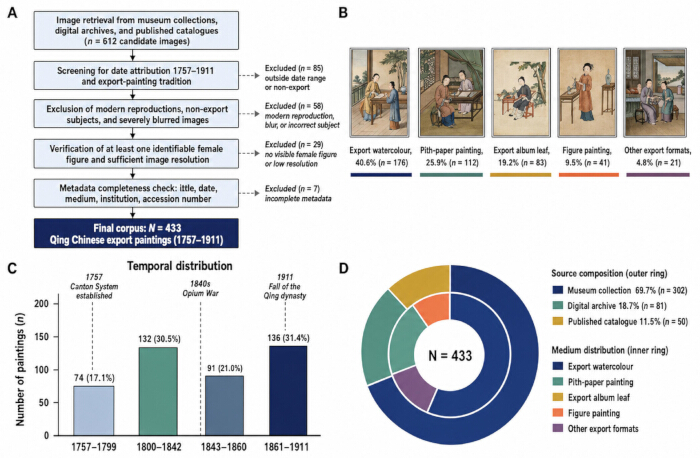
Рисунок 1: Формирование корпуса и дескриптивный состав выборки из 433 картин. (A) Последовательный отбор 612 потенциальных изображений, в результате которого было отобрано 433 подходящих картины. Исключения составили картины, не относящиеся к периоду исследования или к традиции экспортной живописи (n = 85), современные репродукции, размытые изображения или некорректные сюжеты (n = 58), изображения без идентифицируемой женской фигуры или с недостаточным разрешением (n = 29), а также записи с недостаточными метаданными (n = 7). (B) Репрезентативные примеры пяти техник и форматов: экспортная акварель (40,6%, n = 176), живопись на бумаге из сердцевины растения (pith-paper) (25,9%, n = 112), лист экспортного альбома (19,2%, n = 83), фигуративная живопись (9,5%, n = 41) и другие экспортные форматы (4,8%, n = 21). (C) Распределение отобранных картин по четырем хронологическим интервалам. (D) Распределение источников коллекций (внешнее кольцо) и техник/форматов (внутреннее кольцо). Проценты рассчитаны на основе общей выборки (N = 433) и округлены до одного десятичного знака. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
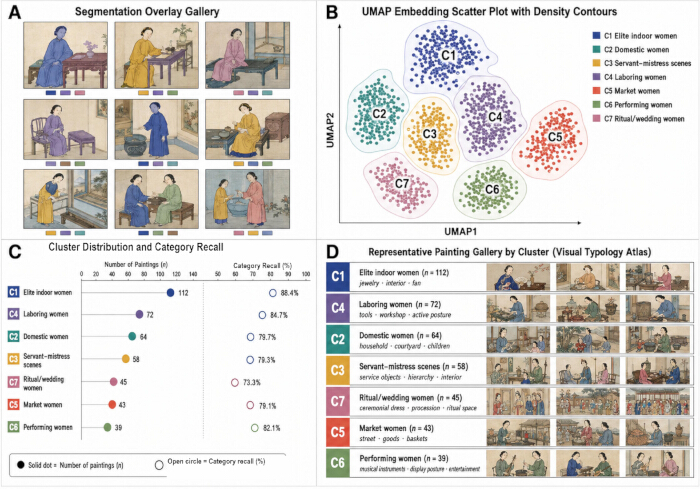
Рисунок 2: Представленные результаты сегментации, визуализация эмбеддингов, распределение кластеров, полнота категорий и репрезентативные картины. (A) Галерея из девяти картин с цветными наложенными масками сегментации, использованными для локализации фигур или визуальных элементов при анализе. (B) Диаграмма рассеяния UMAP для полученных эмбеддингов изображений CLIP с контурами плотности и метками C1–C7. (C) Представленное количество картин (закрашенные точки, верхняя ось) и полнота категорий (пустые круги, нижняя ось); полнота категории равна количеству точных совпадений, деленному на поддержку в человеческом эталоне. Доверительные интервалы или планки погрешностей не показаны. (D) Галерея репрезентативных картин, сгруппированных по меткам C1–C7, где изображения выбраны на основе их близости к центроидам соответствующих кластеров. Сокращения: AI = искусственный интеллект; CLIP = Contrastive Language–Image Pre-training; SAM = Segment Anything Model; UMAP = Uniform Manifold Approximation and Projection; C1–C7 = полученные метки 1–7. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
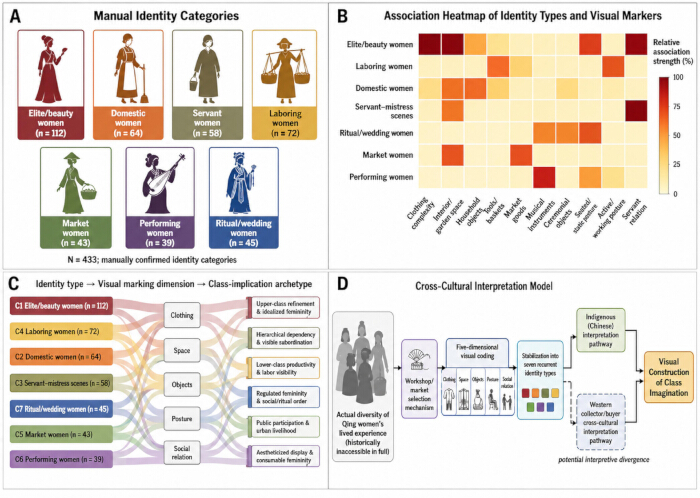
Рисунок 3: Ассоциации визуальных подсказок и кросс-культурная интерпретационная модель. (A) Семь согласованных эталонных категорий женской идентичности и размеры их выборок в корпусе из 433 картин. (B) Тепловая карта ассоциаций, показывающая относительную силу связей между семью эталонными категориями и кодируемыми визуальными маркерами одежды, пространственного окружения, объектов, позы и социальных отношений. Сила ассоциаций была выведена из аннотаций на уровне конкретных случаев в каждой категории. (C) Аллювиальная диаграмма, обобщающая взвешенные связи между эталонными категориями, измерениями визуальной маркировки и архетипами классовой принадлежности на основе закодированных наблюдений. (D) Концептуальная модель кросс-культурной интерпретации, связывающая изображенную деятельность, выбор мастерской и рынка, пятимерное визуальное кодирование, повторяющиеся типы идентичности и потенциальные пути интерпретации. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Таблица 1: Характеристики корпуса и полнота метаданных (N = 433).Количество и процентное соотношение обобщены по шести отдельным блокам: временной интервал, источник, носитель или формат, полнота метаданных, изображение женских фигур и тип сцены. В каждом блоке в качестве знаменателя используется N = 433, и общая сумма составляет 433; проценты представляют собой доли корпуса внутри блока, округленные до одного десятичного знака. Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Таблица 2: Предварительные метки ИИ и эталонные категории, определенные человеком (N = 433). Поддержка представляет собой количество картин, отнесенных к каждой эталонной категории. Точные совпадения указывают на картины, для которых предварительная метка, созданная ИИ, соответствовала эталонной категории. Полнота на уровне категории рассчитывается как количество точных совпадений, деленное на количество эталонных поддержек. Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Таблица 3: Сводка полученных результатов вычислительного профилирования. C1–C7 воспроизводят проверенные размеры профилей и доминирующие метки. Интеграция назначений кластеров на уровне случаев и таблицы сопряженности «кластер по категориям» подтверждает, что ненаправляемая кластеризация эффективно выявила визуальные структуры, соответствующие семи категориям человеческого эталона. Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Таблица 4: Качественные профили категорий женской идентичности и связанных с классом визуальных признаков. Количественные показатели и проценты обобщают категории человеческих эталонов, в то время как одежда, пространство, объекты, поза и социальные отношения характеризуют повторяющиеся визуальные профили, связанные с каждой категорией. Интерпретации, связанные с классом, представляют собой иконографический анализ живописных паттернов, а не прямые показатели исторического социального статуса. Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Дополнительный рисунок 1: Матрица путаницы, сравнивающая предварительные метки ИИ с верифицированными эталонными категориями, определенными человеком, для корпуса из 433 картин. Строки представляют верифицированные эталонные категории (истинные метки), а столбцы — предварительные категории, созданные CLIP (предсказанные метки). Значения в ячейках указывают количество картин для каждой комбинации меток ИИ и человека. Диагональные ячейки представляют точные совпадения ИИ и человека, при этом соответствующая полнота на уровне категории указана в процентах. Внедиагональные ячейки представляют несоответствия между предварительной классификацией ИИ и верифицированной эталонной категорией. Общая точность точных совпадений составила 82,2% (356/433). Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Дополнительная таблица 1: Послучайное сравнение предварительных меток ИИ, установленных эталонных категорий, определенных человеком, и назначений кластеров UMAP. Каждая строка представляет одну из 433 экспортных китайских картин эпохи Цин, включенных в аналитический корпус. В таблице указаны стабильный идентификатор изображения QEP, предварительная метка CLIP ViT-B/32, независимые классификации от Кодировщика-человека 1 и Кодировщика-человека 2, установленная эталонная категория, определенная человеком, статус соответствия ИИ и человека, а также назначение кластера UMAP. «Exact Match» (точное совпадение) означает согласие между предварительной меткой ИИ и установленной эталонной категорией; «Mismatch» (несоответствие) означает расхождение. Установленная категория, определенная человеком, служила эталонной классификацией для анализа согласованности данных ИИ и человека. Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Дополнительная таблица 2: Таблица сопряженности категорий, определенных экспертами, и результатов компьютерной кластеризации. Строки представляют семь согласованных эталонных категорий, определенных человеком, а столбцы — кластеры C1–C7, полученные в результате компьютерного кластерного анализа. Значения в ячейках указывают количество картин, отнесенных к каждой комбинации категория–кластер. Общая поддержка представляет количество картин в каждой эталонной категории. Концентрация наблюдений в комбинациях категория–кластер обеспечивает описательную оценку соответствия между независимо полученными компьютерными кластерами и согласованными эталонными категориями. Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Обсуждение
В предоставленных сводных агрегатах 433 записи были распределены по семи категориям человеческих эталонов и описаны с помощью пяти семей визуальных признаков. Самой многочисленной категорией была «элита/красота» (112/433), при этом 356 предварительных меток совпали с указанным человеческим эталоном (82,2%). Данные представляют собой наблюдения по корпусу. Они подтверждают изучение повторяющихся иконографических формул, но не доказывают более сильное утверждение о том, что эти формулы достоверно воспроизводят общество эпохи Цин или вызывали определенную реакцию у иностранной аудитории13.
Нормативный гендерный дискурс, положение в семье, труд и законы эпохи Цин определяли жизнь женщин, но не диктовали её единообразно. Исследования женщин периода расцвета династии Цин свидетельствуют об их участии в трудовой деятельности, литературном творчестве, ритуалах, религии и развлечениях наряду с соблюдением нормативных семейных режимов и правил целомудрия. Восемь знамен представляли собой наследственную и многоэтническую статусную группу, определенную законом и административной практикой; следовательно, принадлежность к знаменам не должна автоматически приравниваться к маньчжурской этнической принадлежности14,15,16,17. В данном исследовании одежда, поза, предметы и обстановка рассматриваются как живописные подсказки, а не как доказательства юридического ранга, принадлежности к знаменам или ханьцам, этничности, морального соответствия или реальной идентичности. Для таких утверждений потребовались бы архивные и юридические доказательства.
Вычислительные результаты также требуют культурной и технической сдержанности. Не следует полагать, что многоцелевые визуально-языковые модели культурно нейтральны. Опубликованные результаты CulturalVQA демонстрируют неравномерную эффективность в зависимости от регионов и культурных аспектов, однако в данном бенчмарке не оценивалась модель CLIP ViT-B/32 и не использовалось историческое искусство Восточной Азии8,18,19. Таким образом, это обосновывает необходимость создания соответствующего бенчмарка на данном корпусе, а не заменяет его. До проведения такого эксперимента CLIP следует рассматривать как предварительный инструмент систематизации, а не как авторитетный источник по вопросу идентичности или иерархии эпохи Цин. Вычислительный конвейер подтвердил, что SAM функционировал исключительно как вспомогательное средство локализации; маски или производные от них признаки не использовались в качестве входных данных для разметки или кластеризации, что гарантировало опору визуальной категоризации только на глобальные семантические эмбеддинги несегментированных изображений. Исследования в области цифрового культурного наследия также подчеркивают важность культурной чувствительности, междисциплинарного надзора, доступности, защиты данных и прозрачности рабочих процессов20.
С исторической точки зрения значимость этих паттернов заключается в торговле экспортной живописью: китайские мастерские и иностранный спрос определили и стандартизировали сюжеты, которые были портативны, понятны и пригодны для коллекционирования; повторяющиеся изображения мастерских также свидетельствуют о копировании с внесением вариаций, а не о чисто механическом дублировании1,2,3,4,5. Таким образом, данный корпус может внести вклад в историю гендера, иерархии, образов повседневной жизни и межкультурного взаимодействия, демонстрируя, какие формулы повторяются в широком масштабе. Он не доказывает, что данные изображения являются исчерпывающими этнографическими записями. Вычислительное сравнение может служить ориентиром для детального анализа и межкультурного контекстуалирования21, в то время как записи о производстве, истории покупок и свидетельства восприятия должны служить основанием для утверждений о рыночных намерениях или смысле, который вкладывала аудитория.
Аффективный и когнитивный отклик остаются направлением для дальнейших исследований, а не результатом данной работы. Ши и коллеги объединили оценки предпочтений, анализ латентных измерений и айтрекинг, чтобы разграничить эмоциональные, формально-эстетические и когнитивные пути восприятия картин серии «Фонари Сиаси» (Xiashi Pinprick Lantern Pictures)22. Аналогичный дизайн исследования мог бы проверить, насколько по-разному зрители воспринимают одежду, предметы, позы или иерархию на экспортных картинах. Поскольку в данном исследовании не собирались рейтинги, данные айтрекинга или иные данные аудитории, оно не позволяет делать выводы об эмоциональном возбуждении, визуальной значимости или восприятии только на основе содержания изображений.
Ограничения исследования носят теоретический, методологический и практический характер. С теоретической точки зрения категории материальных признаков упрощают гендерные аспекты, внутрисемейные отношения, правовую иерархию, этническую принадлежность и жизненный опыт. Методологически выводы ограничены факторами сохранности, сбора, оцифровки, метаданных, использованием моделей с нулевым обучением (zero-shot models), кодированием и систематическими ошибками, связанными с неравномерностью временных периодов. Несмотря на то, что аналитический конвейер демонстрирует надежное обнаружение закономерностей, эти структурные искажения подчеркивают необходимость рассматривать результаты компьютерного анализа как анализ иконографических конвенций, а не как прозрачное отражение социальной реальности эпохи Цин. На практике права на изображения ограничивают их распространение, а полученные результаты могут быть не применимы к другим институциям, периодам, носителям или вычислительным средам. С учетом этих ограничений исследование предлагает контролируемую человеком систему преобразования повторяющихся визуальных наблюдений в проверяемые исторические вопросы, а не в автоматизированные выводы. Поскольку данная работа является интерпретационным исследованием, а не прикладным вмешательством, в ней не оценивался прогресс в достижении каких-либо Целей устойчивого развития (ЦУР) или соответствующих показателей. Тем не менее, предмет исследования актуален для Цели 5, а документация с соблюдением авторских прав и кросс-культурный образовательный подход концептуально согласуются с задачами 11.4 и 4.7; количественные результаты по ЦУР не измерялись. Предоставленный пакет для воспроизводимости приводит исследование в соответствие с современными призывами к прозрачности рабочих процессов в области цифрового наследия и требованиями FAIR в отношении постоянных идентификаторов, насыщенных метаданных, лицензий, происхождения данных, а также возможности повторного использования данных, алгоритмов, инструментов и рабочих процессов20,23.
Раскрытие информации
Авторы не имеют конфликтов интересов, подлежащих раскрытию.
Благодарности
Авторы выражают благодарность Музею Виктории и Альберта, Британскому музею, Метрополитен-музею, Национальному музею азиатского искусства Смитсоновского института, Музею Пибоди Эссекса, Гонконгскому музею искусств, Британской библиотеке, Исследовательскому институту Гетти, а также другим хранящим организациям и группам по каталогизации, чьи онлайн-записи помогли в поиске корпуса данных. Доступ к онлайн-записи не означает разрешение на распространение изображения; поэтому права на уровне отдельных панелей и ссылки на источники документированы отдельно. Авторы также выражают признательность открытым исследовательским сообществам, поддерживающим CLIP и SAM, а также благодарят за административную поддержку Университет города Макао и Гуандунский политехнический педагогический университет.
Материалы
| Имя | Компания | Каталожный номер | Комментарии |
|---|---|---|---|
| CLIP ViT-B/32 | OpenAI | OpenAI CLIP, ViT-B/32 | Визуально-языковая модель, используемая для предварительной обработки изображений–анализ сходства текстов и присвоение предварительных меток ИИ. |
| Вычислительная рабочая станция | Авторы’ вычислительная рабочая станция | GPU с поддержкой CUDA; необходимо указать точную конфигурацию оборудования | Рабочая станция, использованная для инференса CLIP и SAM, а также для вычислительного анализа; характеристики GPU, CPU, ОЗУ, операционной системы и CUDA должны быть указаны в соответствии с параметрами исходной среды выполнения. |
| Matplotlib | команда разработчиков Matplotlib | пакет Python; необходимо указать точную версию | Используется для компьютерной визуализации, а также для создания аналитических рисунков и графиков. |
| Microsoft Excel 2021 | Microsoft Corporation | Microsoft Excel 2021 | Используется для организации метаданных, ведения записей скрининга и управления табличными данными исследования. |
| NumPy | разработчики NumPy | Пакет Python; необходимо указать точную версию | Используется для численных вычислений и манипуляций с массивами аналитических данных и признаков изображений. |
| pandas | команда разработчиков pandas | Пакет Python; необходимо указать точную версию | Используется для структурированной обработки данных, обработки метаданных и организации аналитических результатов на уровне отдельных случаев. |
| Python 3.10 | Python Software Foundation | Python 3.10 | Программная среда, использованная для реализации алгоритма компьютерного анализа изображений. |
| PyTorch 2.0.1 | PyTorch Foundation | PyTorch 2.0.1 | Фреймворк глубокого обучения, используемый для кодирования изображений и текста на основе CLIP и выполнения вывода на GPU. |
| scikit-learn | разработчики scikit-learn | Пакет Python; необходимо указать точную версию | Используется для кластеризации методом K-средних, агломеративной кластеризации, вычисления коэффициента силуэта, индекса Дэвиса–индекс Боулдина и коэффициент Коэна’расчеты коэффициента каппа. |
| Модель Segment Anything (SAM) | Исследования Meta AI | SAM | Модель сегментации, используемая для локализации женских фигур, предметов одежды, мебели, инструментов, ритуальных объектов и архитектурных зон для визуального осмотра. |
| umap-learn | МакИннес и др. | Реализация UMAP на языке Python | Используется для снижения размерности и двумерной визуализации эмбеддингов изображений CLIP с применением косинусного расстояния. |
Ссылки
- Gao J, Zhang Y, Liu J, Sousa JP. A digital humanities approach to Chinese export watercolours: a case study on the Victoria and Albert Museum collection. Digit Scholarsh Humanit. 2026;41(2):692-714.
- Liu H, Fu C, Li W. Silk road heritage: the artistic representation of port trading culture in the images of characters in Qing Dynasty Guangzhou export paintings. PLoS One. 2024;19(10):e0308309.
- Ao J, Ye Z, Li W, Ji S. Impressions of Guangzhou city in Qing Dynasty export paintings in the context of trade economy: a color analysis of paintings based on k-means clustering algorithm. Herit Sci. 2024;12:77.
- Mok MKW. Chinese export paintings: a marketing success story. Cambridge Scholars Publishing; Newcastle upon Tyne; 2025.
- Yaron E. The many versions of the painting of Tingqua's studio: painting copying and originality in nineteenth-century Canton. Humanit Soc Sci Commun. 2020;7:132.
- Impett L, Offert F. There is a digital art history. Vis Resour. 2022;38(2):186-209.
- Münster S. Artificial intelligence for digital heritage innovation: setting up a R&D agenda for Europe. Heritage. 2024;7(2):794-816.
- Foka A, Griffin G. AI, cultural heritage, and bias: some key queries that arise from the use of GenAI. Heritage. 2024;7(11):6125-6136.
- Zhang W. Computational approaches for traditional Chinese painting: from the Six Principles of Painting perspective. J Comput Sci Technol. 2024;39(2):269-285.
- McInnes L, Healy J, Saul N, Großberger L. UMAP: Uniform Manifold Approximation and Projection. J Open Source Softw. 2018;3(29):861.
- Rousseeuw PJ. Silhouettes: a graphical aid to the interpretation and validation of cluster analysis. J Comput Appl Math. 1987;20:53-65.
- Cohen J. A coefficient of agreement for nominal scales. Educ Psychol Meas. 1960;20(1):37-46.
- Stejskal J. Art-historical empiricism and digital visualization of cultural heritage. Synthese. 2025;205:132.
- Mann S. Precious records: women in China's long eighteenth century. Stanford University Press; Stanford; 1997.
- Porter DC. Slaves of the emperor: service, privilege, and status in the Qing Eight Banners. Columbia University Press; New York; 2023.
- Sommer MH. Sex, law, and society in late imperial China. Stanford University Press; Stanford; 2000.
- Theiss JM. Disgraceful matters: the politics of chastity in eighteenth-century China. University of California Press; Berkeley; 2005.
- Nayak S, et al. Benchmarking vision language models for cultural understanding [conference paper]. Presented at: 2024 Conference on Empirical Methods in Natural Language Processing; Miami, Florida, USA; 2024. https://aclanthology.org/2024.emnlp-main.329/
- Vitaloni C, Shullani D, Baracchi D. A comparative study of vision language models for Italian cultural heritage. Heritage. 2025;8(3):95.
- Li W. Systematic review: a scientometric analysis of the status, trends and challenges in the application of digital technology to cultural heritage conservation (2019-2024). npj Herit Sci. 2025;13:90.
- Zhang W, et al. CultiVerse: towards cross-cultural understanding for paintings with large language model [conference paper]. Presented at: 33rd ACM International Conference on Multimedia; Dublin, Ireland; 2025. https://doi.org/10.1145/3746027.3755698
- Shi W. A dual-path approach to emotional arousal and visual cognition in intangible cultural heritage: the case of Xiashi Pinprick Lantern Pictures. Digit Scholarsh Humanit. 2026;41(1):376-395.
- Wilkinson MD, et al. The FAIR Guiding Principles for scientific data management and stewardship. Sci Data. 2016;3:160018.