VoiceNet-RAI объединяет признаки MFCC, многоязычные эмбеддинги wav2vec 2.0 и сеть EfficientNet-Lite для классификации пола и возраста по голосовым данным. Система достигает точности до 97,87% на англоязычном подмножестве данных и поддерживает ответственное применение в области распознавания речи, аутентификации и цифровой криминалистики.
Для просмотра этого контента требуется подписка на JoVE. Войдите или начните свой бесплатный пробный период.
Исследовательская статья
VoiceNet: ответственная многоязычная платформа искусственного интеллекта для анализа речи с целью классификации пола и возраста
127 просмотров
⸱
11 сентября 2026 г.
В этой статье
Краткое содержание
Аннотация
Точная классификация пола и возраста по голосовым данным имеет важное значение для персонализированного, безопасного и этичного человеко-машинного взаимодействия (HCI). С растущим использованием больших предобученных моделей речи, таких как wav2vec 2.0, возникает необходимость ответственного использования этих представлений для многоязычного и учитывающего конфиденциальность вывода демографических данных. В данной работе предлагается VoiceNet-RAI — платформа глубокого обучения (DL), которая интегрирует мел-кепстральные коэффициенты (MFCC) с многоязычными эмбеддингами wav2vec 2.0 на базе трансформера в архитектуре EfficientNet-Lite для обеспечения точной, справедливой и прозрачной классификации в различных лингвистических контекстах. Платформа объединяет контекстную и спектральную информацию для повышения устойчивости к различным условиям записи. Эксперименты на многоязычных речевых данных, охватывающих 28 языков, демонстрируют высокую эффективность классификации: для английского подмножества достигнута точность (accuracy) 97,87%, прецизионность (precision) 98,61%, полнота (recall) 98,70% и F1-мера 98,65%. Внешняя валидация с использованием набора данных Mozilla Common Voice показала точность 98,27% при классификации пола, что подтверждает обобщающую способность модели на независимом наборе данных. Абляционный анализ дополнительно показал, что сочетание признаков MFCC и wav2vec 2.0 улучшает производительность по сравнению с использованием только необработанных данных или только MFCC. Эти результаты демонстрируют потенциал гибридных спектрально-контекстных представлений речи для надежной и ответственной классификации пола и возраста.
Введение
Распознавание голоса является основным компонентом человеческого общения, посредством которого люди выражают свои чувства, мысли и цели. Человеческий голос формируется в результате биологического процесса, при котором воздух выдыхается из легких и превращается в звук органами артикуляции, такими как губы, язык и зубы1. Ухо играет важнейшую роль в идентификации голоса и может различать мужские и женские голоса на основе таких характеристик, как громкость и высота тона. Одной из характеристик, способствующих существенным различиям в высоте голоса между мужчинами и женщинами, является половой диморфизм2. Классификация возраста и пола по голосу актуальна для множества приложений, включая взаимодействие человека и машины, автоматическое распознавание пола, персонализированные приветствия, предварительную классификацию эмоций в речи и классификацию вызовов на основе пола3.
Речь является неотъемлемой частью человеческого взаимодействия. Человеческий голос обладает множеством характеристик, которые варьируются у разных людей и могут предоставлять информацию об эмоциональном и психическом состоянии, а также о возрасте и поле. Эти многомерные характеристики могут быть использованы в таких приложениях, как системы безопасности на основе голосового управления и ориентированные на речь помощники с искусственным интеллектом (ИИ). Другие области, в которых важен анализ голоса, включают системы автоматической верификации говорящего (ASV) и системы ИИ для распознавания эмоций. Системы голосового ввода также могут сократить пространство поиска в базах данных4,5. Кроме того, системы безопасности на базе ИИ могут использовать голосовые данные для таких целей, как уголовные расследования и защита потерпевших. Мужские и женские голоса обладают различными характеристиками из-за различий в резонансных свойствах голосового тракта. Эти характеристики могут быть извлечены из речевых сигналов в форме, подходящей для компьютерной обработки, что позволяет осуществлять классификацию пола по голосовым данным6,7. Следовательно, для классификации пола по голосу требуются эффективные алгоритмы обучения. Алгоритмы глубокого обучения (DL) особенно хорошо подходят для классификации речевых данных благодаря их способности выявлять сложные закономерности в аудиоданных. Такие модели могут содержать сверточные, рекуррентные, временно-сверточные или полносвязные слои, в зависимости от архитектуры. Эти слои могут изучать соответствующие акустические характеристики, включая тон и высоту звука. После обучения модель может определять пол по ранее не использованным аудиозаписям8. Еще одной важной областью исследований в машинном обучении (ML) является классификация возраста по голосовым записям. Алгоритмы ML могут использовать такие акустические характеристики, как высота, тембр и амплитуда, для выявления возрастных закономерностей. Такие методы, как анализ главных компонентов (PCA), также могут быть применены для извлечения информативных паттернов из речевых данных и потенциального повышения точности классификации9.
Глубокое обучение (DL) продемонстрировало высокую эффективность в таких приложениях, как распознавание изображений, эмоций и речи. В частности, глубокие нейронные сети (DNN) широко используются для задач, связанных с речью. В данном исследовании подходы на основе DL применяются для классификации голоса в сочетании с общепринятыми методами извлечения признаков. Мел-кепстральные коэффициенты (MFCC) фиксируют соответствующие спектральные характеристики речевых сигналов и обеспечивают эффективное представление для последующей обработки. Извлеченные признаки затем интегрируются в структуру переносимого обучения (transfer learning) для классификации пола и возраста на основе голоса10,11.
В последних исследованиях для классификации атрибутов говорящего все чаще применяются представления речи на основе самообучения (self-supervised) и архитектуры Transformer. Исследователи изучали демографические искажения, включая предвзятость по гендерному и возрастному признакам, в моделях самообучения речи, таких как HuBERT и wav2vec 2.0, подчеркивая важность оценки с учетом принципов справедливости12. Недавно языконезависимые подходы на базе Transformer продемонстрировали эффективность выученных контекстных представлений речи для распознавания пола в многоязычных условиях и в условиях зашумленности13. Sinha и соавторы дополнительно исследовали послойные представления wav2vec 2.0 для классификации возраста и пола, показав, что различные слои Transformer фиксируют разный уровень информации о говорящем14. Эти достижения послужили основанием для разработки предлагаемой структуры VoiceNet-RAI, которая объединяет традиционную спектральную информацию на основе MFCC с контекстными представлениями wav2vec 2.0, учитывая при этом многоязычность и принципы ответственного искусственного интеллекта (Responsible AI).
Недавние исследования показали, что возраст и пол говорящего могут быть охарактеризованы с помощью как традиционных акустических признаков, так и представлений на основе глубокого обучения. Подходы, сочетающие акустическую и временную информацию, продемонстрировали, что взаимодополняющие характеристики речи могут повысить точность классификации по возрасту и полу15,16. Соответствующие исследования также показали, что преобразованные признаки речи, созданные с использованием глубоких узкобутылочных представлений (deep bottleneck representations), могут улучшить эффективность классификации возраста и пола говорящего17. Эти результаты обосновывают более широкое применение спектральных, временных и выученных представлений для задач классификации, связанных с речью и сигналами, производными от речи.
В нескольких исследованиях изучались вопросы распознавания возраста и пола по речи с использованием методов машинного и глубокого обучения18,19,20,21,22,23,24,25,26,27,28,29,30. В более современных подходах исследовались преобразованные представления MFCC и глубокие нейронные сети для классификации возраста и пола говорящего31, при этом многоязычная и языковая вариативность остаются важными аспектами при разработке надежных систем демографической классификации на основе голоса. Различия в произношении, фонетической структуре, характеристиках говорящего и условиях записи могут снизить обобщающую способность модели для разных языков и популяций. Соответственно, использование взаимодополняющих спектральных и контекстуальных представлений речи может повысить устойчивость системы в многоязычной среде.
Хотя в гибридных подходах ранее комбинировались многочисленные акустические признаки или ансамблевые классификаторы для демографического распознавания по голосу, VoiceNet-RAI отличается интеграцией двух дополняющих друг друга уровней представления речи в рамках единой структуры. В частности, традиционные признаки MFCC сохраняют локализованные спектральные и вокальные характеристики, в то время как wav2vec 2.0 предоставляет контекстуализированные представления, полученные из необработанной речи с помощью энкодера Transformer. Вместо того чтобы полагаться исключительно на созданные вручную акустические дескрипторы или единое глубокое представление, VoiceNet-RAI выполняет слияние на уровне признаков временно агрегированных представлений MFCC и wav2vec 2.0, после чего уточняет полученное гибридное представление с помощью EfficientNet-Lite. Таким образом, научная новизна заключается в скоординированной интеграции спектральных, самообучающихся контекстуальных и легковесных глубоких представлений для классификации пола и возраста, наряду с многоязычной оценкой, валидацией на независимом наборе данных и анализом справедливости для подгрупп. Эта комбинация расширяет возможности традиционных гибридных конвейеров классификации речи, переходя от слияния признаков, ориентированного только на точность, к структуре, которая одновременно учитывает взаимодополняемость представлений, легковесный дизайн модели, обобщающую способность и принципы Responsible AI.
Основные результаты данного исследования включают разработку подхода для определения пола и возраста по голосовым данным путем интеграции признаков MFCC и wav2vec 2.0 с архитектурой EfficientNet-Lite. Проведены обширные эксперименты на наборе данных голосовых записей на 28 языках, в которых оценивались оригинальные признаки, признаки MFCC, признаки wav2vec 2.0 и их комбинации с использованием моделей машинного обучения (ML) и глубокого обучения (DL). Эффективность моделей оценивалась как на полном многоязычном наборе данных, так и на подмножестве английского языка. Структура системы дополнительно анализировалась с точки зрения многоязычности и ответственного ИИ (Responsible AI) посредством анализа подгрупп по полу и языку, оценки независимо от говорящего и валидации с использованием набора данных Mozilla Common Voice. Кроме того, эффективность предлагаемой системы сравнивается с передовыми подходами, описанными в существующей литературе, и приводятся результаты кросс-валидации. Был проведен анализ значительного объема связанных исследований, и в Таблице 1 обобщены эти работы, включая используемые модели, наборы данных и зарегистрированные результаты19,20,21,22,23,24,25,26,27,28,29,30,31.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Протокол
В данном исследовании использовались общедоступные наборы данных BVC Challenging Voice Set и Mozilla Common Voice без прямого участия испытуемых. Таким образом, одобрение институционального комитета по этике и дополнительное информированное согласие не требовались. Обработке подвергались только данные, необходимые для классификации пола и возраста; попыток идентифицировать отдельных говорящих не предпринималось. Полная методология рабочего процесса предлагаемой структуры представлена на Рисунке 1.
Сбор данных
Набор данных, использованный в предлагаемом подходе, состоял из аудиофайлов формата .wav, полученных из BVC Challenging Voice Set — общедоступного набора голосовых данных, разработанного группой Biometrics Vision and Computing (BVC) и размещенного на GitHub32. Набор данных содержал голосовые записи 526 человек, включая 336 мужчин и 190 женщин. Он включал примерно 3 964 записи, в том числе как однопредложные, так и многопредложные записи каждого говорящего. В Таблице 2 обобщены демографические характеристики, языковой охват, свойства записей, стратегия разделения данных и настройки предобработки, использованные для наборов речевых данных в предлагаемой архитектуре VoiceNet-RAI.
Извлечение признаков
Аудиофайлы были обработаны для извлечения основных свойств, которые впоследствии были сохранены в файл CSV. Метаданные, включая возраст, пол и произношение говорящего, были извлечены из соответствующих файлов README. Для обработки WAV-файлов и извлечения соответствующих признаков использовался язык Python с пакетом SciPy. Функции быстрого преобразования Фурье (FFT) и частотные функции NumPy применялись для преобразования аудиосигналов из временной области в частотную. В WAV-файлах амплитуда была представлена как функция времени, однако для задачи классификации наибольший интерес представляли частотные характеристики, позволяющие различать мужские и женские голоса33.
Для преобразования аудиосигналов в представления в частотной области с помощью алгоритма БПФ был реализован дискретный преобразователь Фурье (ДПФ). Преобразование Фурье переводит сигнал из временной области в частотный спектр. Поскольку этот спектр не сохраняет временную информацию, аудиосигнал был разделен на перекрывающиеся сегменты, и к каждому сегменту было применено преобразование Фурье с использованием метода коротковременного преобразования Фурье (STFT). Функция np.fft.fft генерировала комплексный частотный спектр, а np.fft.fftfreq предоставляла соответствующие частоты дискретизации. В каталоге образцов было доступно 10 аудиофайлов одного говорящего. Каждый WAV-файл обрабатывался с использованием скользящего окна длительностью 200 ms для извлечения доминирующих частот. Например, 4-секундная аудиозапись давала список из 20 значений частоты. Для каталога, содержащего 10 записей, 10 соответствующих списков, каждый из которых содержал 20 значений частоты, были объединены в список списков. Частоты фильтровались для сохранения значений в диапазоне от 20 Hz до 280 Hz, при этом потенциальный шум в районе 50 Hz исключался.
Гибридное представление признаков MFCC и wav2vec 2.0
Для захвата как высокоуровневых контекстных представлений речи, так и низкоуровневых акустических характеристик в данном исследовании была применена гибридная стратегия извлечения признаков, объединяющая коэффициенты MFCC с эмбеддингами wav2vec 2.0 на базе Transformer.
Извлечение признаков MFCC
Мел-кепстральные коэффициенты (MFCC) являются широко используемыми признаками в обработке речи и аудиосигналов, в частности, для таких приложений, как распознавание речи и идентификация говорящего34,35. В данном исследовании извлечение MFCC позволило преобразовать аудиосигналы в векторы признаков, представляющие перцептивно значимые характеристики речи. Процесс начинался с преакцентирования (pre-emphasis) для усиления высокочастотных компонентов, за которым следовали фрейминг и оконное преобразование для разделения сигнала на короткие перекрывающиеся кадры. Каждый аудиообразец сначала был передискретизирован до 16 kHz и сегментирован на кадры длительностью 25 ms с перекрытием 10 ms. Затем к каждому кадру применялось быстрое преобразование Фурье для перевода сигнала из временной области в частотную.
Полученный частотный спектр пропускали через серию банков Mel-фильтров, которые аппроксимировали нелинейную частотную характеристику слухового восприятия человека. Эти банки фильтров усиливали более значимые с точки зрения восприятия частоты, снижая при этом вклад менее информативных. Затем вычислялся логарифм выхода каждого банка фильтров для аппроксимации логарифмической чувствительности человеческого слуха к громкости. После этого к логарифмам энергий банков фильтров применялось дискретное косинусное преобразование (DCT) для декорреляции коэффициентов и создания компактного представления аудиосигнала. Полученные коэффициенты, известные как MFCC, отражали важные спектральные характеристики речи. MFCC использовались для классификации по полу и возрасту, так как они фиксировали акустические особенности, позволяющие дифференцировать голоса по этим признакам.
извлечение эмбеддингов wav2vec 2.0
Базовая модель wav2vec 2.0 была предварительно обучена на крупномасштабных неразмеченных корпусах речи. Модель состояла из многослойного кодировщика Transformer, который обрабатывал необработанные формы волны на входе и генерировал контекстуализированные речевые эмбеддинги36.
Для заданной входной формы волны x ∈ RT модель wav2vec 2.0 генерирует последовательность латентных представлений:
Z = {z1,z1,....,zn},zi ∈ R768 (1)
где каждый вектор вложения имел размерность 768. Для получения представления фиксированной длины, подходящего для классификации, была применена операция темпорального усредняющего пулинга по всем временным шагам.
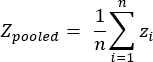 (2)
Механизм слияния признаков
Признаки MFCC и wav2vec 2.0 были объединены путем конкатенации на уровне признаков. В частности, признаки MFCC сначала были агрегированы с помощью временного усреднения для получения вектора фиксированной длины.
m ∈ R40 (3)
Итоговый гибридный вектор признаков был получен следующим образом:
h = [m || zpooled] ∈ R808 (4)
где || обозначает конкатенацию. Это слияние объединило глубокие контекстуальные эмбеддинги с вручную подобранными спектральными признаками, что позволило модели фиксировать как семантическую информацию высокого уровня, так и детальные акустические паттерны.
Все аудиообразцы были предварительно передискретизированы до 16 kHz. Признаки MFCC вычислялись по кадрам и усреднялись во времени для получения фиксированного 40-мерного вектора, в то время как эмбеддинги wav2vec 2.0 подвергались среднему пулингу по времени для получения 768-мерного представления. Поскольку оба набора признаков были преобразованы в векторы фиксированной длины перед слиянием, временное выравнивание на уровне кадров не потребовалось. Полученные представления MFCC и wav2vec затем объединялись в гибридный вектор признаков размерностью 808 перед передачей в модель классификации.
Интеграция с EfficientNet-Lite
Объединенный вектор признаков, h, был преобразован в формат, подходящий для обучения признаков, и использован в качестве входных данных для модели EfficientNet-Lite в процессе обучения. Сначала полносвязный проекционный слой отобразил 808-мерный вектор в более высокоразмерное латентное пространство, после чего блоки EfficientNet-Lite уточнили иерархические признаки. Для уменьшения переобучения и улучшения обобщающей способности модели были применены слои пакетной нормализации (batch normalization) и исключения (dropout). Функция активации SoftMax использовалась для получения конечных предсказанных вероятностей для классов пола и возраста. Объединенное представление, h ∈ R808, изначально рассматривалось как одномерный вектор признаков и пропускалось через полносвязный проекционный слой, который отображал его в 4 096 измерений. Затем спроецированное представление было преобразовано в тензор размером 1 × 64 × 64 перед подачей в архитектуру EfficientNet-Lite.
Для обеспечения работы с одноканальным представлением признаков речи, вместо традиционного трехканального входного изображения, исходный входной сверточный слой EfficientNet-Lite был изменен с трех на один входной канал. Остальные блоки извлечения признаков EfficientNet-Lite были сохранены без значительных архитектурных изменений. Для получения представления фиксированной длины к финальным картам признаков был применен слой адаптивного глобального усредняющего пулинга. Оригинальный классификационный блок был заменен на специализированный полносвязный слой, содержащий два выходных модуля для классификации пола и соответствующее количество выходных модулей для предопределенных возрастных групп. Наконец, для генерации вероятностей классов была применена функция активации SoftMax. Предложенное гибридное представление объединило современные самообучающиеся эмбеддинги речи с традиционными признаками обработки сигналов. Эмбеддинги wav2vec 2.0 зафиксировали контекстную информацию и долгосрочные зависимости, в то время как признаки MFCC предоставили дополнительную низкоуровневую акустическую информацию. Интеграция этих представлений позволила повысить точность классификации, особенно в условиях шумной и многоязычной речи.
ML-классификатор
В данном исследовании была проанализирована эффективность нескольких алгоритмов машинного обучения (ML) для классификации пола и возрастной группы по голосу.
Случайный лес
Случайный лес (Random Forest, RF) использовался в качестве надежного классификатора машинного обучения (ML), объединяющего несколько деревьев решений (Decision Trees, DTs) для повышения точности прогнозирования и снижения переобучения. RF работал по принципу ансамблевого обучения, при котором прогнозы от множества деревьев агрегировались для формирования окончательного результата37,38. Такой подход позволил RF выявлять разнообразные закономерности в данных, минимизируя переобучение, характерное для отдельных деревьев решений. Рандомизация, вводимая при построении деревьев, улучшила обобщающую способность модели, что сделало RF подходящим для таких задач классификации, как определение пола и возраста по голосовым данным.
Логистическая регрессия
Логистическая регрессия (LR) использовалась в качестве статистической модели машинного обучения (ML) для классификации39. При бинарной классификации LR оценивает вероятность исхода на основе входных признаков с помощью логистической (сигмовидной) функции, и полученные вероятности используются для формирования прогнозов по классам. LR также была применима к задачам многоклассовой классификации, включающим более двух классов. Для многоклассовой классификации LR использовала такие подходы, как «один против всех» (one-vs-rest) или регрессия SoftMax, в зависимости от условий классификации.
Классификатор «экстра-деревьев» (Extra Tree Classifier)
Классификатор экстремальных деревьев (Extra Trees Classifier, ETC) использовался в качестве алгоритма ансамблевого обучения, объединяющего несколько деревьев решений (DT) для создания прогнозов40,41. В отличие от случайного леса (RF), ETC вносит дополнительную случайность, выбирая подходящие признаки и пороги разделения случайным образом в процессе построения деревьев. Эта процедура позволила создать менее коррелированные деревья и снизить чувствительность модели к отдельным признакам, тем самым повысив устойчивость к шуму. В качестве критерия разделения для оценки значимости признаков и разбиения данных использовался индекс Джини.
Метод опорных векторов
Метод опорных векторов (SVM) использовался в качестве классификатора машинного обучения (ML) для определения оптимальной решающей границы в многомерном пространстве признаков42. Целью было определение гиперплоскости, которая максимизирует зазор между классами. Более широкий зазор между решающей границей и ближайшими точками данных, как правило, способствует лучшему разделению классов и обобщающей способности модели. SVM применим для решения ряда задач машинного обучения, включая классификацию, регрессию и анализ данных на основе признаков.
Сверточные нейронные сети
Сверточные нейронные сети (CNN) использовались в качестве моделей глубокого обучения (DL) для задач классификации структурированных представлений данных изображений и аудио. Одномерные сверточные сети (1D-CNN) также широко применялись для работы с последовательными и текстовыми данными. Архитектуры CNN использовали сверточные фильтры и операции пулинга для извлечения дискриминативных признаков из входных данных43,44. Для классификации пола и возраста по голосовым данным CNN применялись к представлениям речевого сигнала для изучения закономерностей, связанных с высотой голоса, частотой, тембром и другими вокальными характеристиками, которые имеют значение для разграничения групп по полу и возрасту.
VGG19
В качестве архитектуры глубокого обучения (DL) использовалась сеть VGG19, характеризующаяся глубокой и относительно однородной иерархической структурой извлечения признаков45. Ее архитектура включает небольшие сверточные фильтры размером 3 × 3 в 19 слоях, что обеспечивает прогрессивное извлечение дискриминантных признаков. При применении к представлениям речевых сигналов VGG19 улавливала как низкоуровневые акустические паттерны, такие как вариации высоты тона и частоты, так и высокоуровневые дискриминантные признаки. Глубокая архитектура сети позволила осуществлять последовательную абстракцию признаков для моделирования вокальных характеристик, связанных с полом и возрастом.
EfficientNet-Lite
В качестве вычислительно эффективной архитектуры глубокого обучения (DL) была использована EfficientNet-Lite46,47. Модель применяла стратегию сбалансированного масштабирования для достижения высоких показателей классификации при меньших затратах вычислительных ресурсов по сравнению с более тяжелыми архитектурами DL. Подход комбинированного масштабирования совместно учитывал глубину, ширину модели и разрешение входных данных для обеспечения эффективного извлечения признаков.
Для предлагаемой платформы VoiceNet-RAI была выбрана модель EfficientNet-Lite благодаря ее легковесной архитектуре и оптимальному балансу между точностью классификации и сложностью модели. По сравнению с более массивными архитектурами, в ней используются эффективные сверточные блоки и составное масштабирование, что позволяет добиться эффективного извлечения признаков при меньшем количестве параметров и более низких требованиях к вычислительным ресурсам. Эти характеристики делают EfficientNet-Lite подходящей для предлагаемой платформы классификации речи и обеспечивают возможность ее развертывания в условиях ограниченных ресурсов.
MobileNet
MobileNet использовалась в качестве легковесной архитектуры глубокого обучения (DL) для приложений с ограниченными вычислительными ресурсами, включая мобильные среды и среды граничных вычислений48. Ее вычислительная эффективность была достигнута преимущественно за счет использования глубинных разделяемых сверток, которые сократили количество параметров и вычислительных операций по сравнению с традиционными сверточными архитектурами. Эти характеристики сделали MobileNet подходящей для оценки классификации пола и возраста по голосовым данным при сохранении относительно низких требований к вычислительным ресурсам.
InceptionV3
InceptionV3 была использована в качестве глубокой архитектуры для извлечения иерархических признаков из представлений, полученных из речи49. Архитектура включала операции свертки, пулинга и смешанные операции для извлечения признаков на различных уровнях абстракции. Для классификации пола и возраста по голосовым данным InceptionV3 применялась для изучения сложных акустических паттернов и иерархических представлений, связанных с вариациями вокальных характеристик.
Параметры оценки
Точность (accuracy) была одной из наиболее часто используемых метрик оценки для задач классификации50. Хотя точность обеспечивала полезную меру общей эффективности классификации, она не всегда позволяла провести комплексную оценку, особенно для несбалансированных наборов данных. Поэтому для оценки эффективности модели использовались дополнительные метрики, включая точность (precision), полноту (recall) и F1-меру. Эти метрики обеспечили более комплексную оценку за счет учета правильных и неправильных прогнозов для каждого класса.
Точность определялась как отношение количества правильно классифицированных наблюдений к общему числу наблюдений. Хотя точность была особенно информативной для сбалансированных наборов данных, набор данных, использованный в этом исследовании, был несбалансированным. Поэтому при расчете и интерпретации метрик классификации учитывались истинно положительные результаты (TP), ложноположительные результаты (FP), истинно отрицательные результаты (TN) и ложноотрицательные результаты (FN). Уравнение ниже представляет стандартное определение точности:
Точность = (TP+TN)/(TP+TN+FP+FN)×100 (5)
Точность (precision) оценивает способность классификатора возвращать только релевантные экземпляры:
Точность= TP/(TP+FP) ×100 (6)
Полнота, также называемая чувствительностью, определяет способность классификатора выявлять все релевантные экземпляры:
Полнота (Recall)= TP/(FN+TP) × 100 (7)
F1-мера объединяет точность и полноту в единый показатель и особенно полезна для оценки эффективности классификации на несбалансированных наборах данных:
F1-Score =2 ×(PPV ×TPR)/(TPR+PPV) × 100 (8)
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Результаты
Experimental results for age and gender classification were evaluated using MFCC-based and hybrid feature representations with ML and DL models. The dataset was partitioned into training and testing sets at an 80:20 ratio, with 80% used for training and 20% for testing. Speaker-level partitioning was applied to prevent recordings from the same speaker from appearing in both sets.
The hyperparameters and implementation details of the proposed framework are summarized in Table 3...
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Обсуждение
В данном исследовании была разработана и оценена автоматизированная система классификации пола и возраста по голосовым данным путем интеграции признаков MFCC и эмбеддингов wav2vec 2.0 с моделью EfficientNet-Lite. В ходе первичных экспериментов EfficientNet-Lite при использовании исходных признаков достигла точности (accuracy) 83,48%, прецизионности (precision) 82,87%, полноты (recall) 84,28% и F1-меры 83,54%. После интеграции признаков MFCC производительность существенно повысилась: на наборе данных, включающем 28 языков...
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Раскрытие информации
Авторы заявляют об отсутствии конфликта интересов.
Благодарности
Авторы выражают благодарность Университету принцессы Нуры бинт Абдуррахман и Проекту поддержки исследователей (номер PNURSP2026R748), Университет принцессы Нуры бинт Абдуррахман, Эр-Рияд, Саудовская Аравия, за финансирование данного исследования.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Материалы
| Имя | Компания | Каталожный номер | Комментарии |
|---|---|---|---|
| BVC Challenging Voice Set | Biometrics Vision and Computing Group / OgeNI | BVC Challenging Voice Set | https://github.com/OgeNI/BVC_Challenging_Voice_Set |
| EfficientNet-Lite | EfficientNet-Lite, использованный вариант | https://github.com/tensorflow/tpu/tree/master/models/official/efficientnet/lite | |
| Графический процессор | NVIDIA | Tesla K80 | https://www.nvidia.com/ |
| Набор данных Mozilla Common Voice | Mozilla Foundation | Common Voice, версия, использованная в экспериментах | https://www.kaggle.com/datasets/mozillaorg/common-voice/data |
| NumPy | NumPy Developers | Точная версия, использованная в экспериментах | https://numpy.org/ |
| Процессор | Intel | Intel Core i7-8265U | https://www.intel.com/ |
| Python | Python Software Foundation | Точная версия, использованная в экспериментах | https://www.python.org/ |
| PyTorch | PyTorch Foundation | Точная версия, использованная в экспериментах | https://pytorch.org/ |
| Scikit-learn | Scikit-learn Developers | Точная версия, использованная в экспериментах | https://scikit-learn.org/ |
| SciPy | SciPy Developers | Точная версия, использованная в экспериментах | https://scipy.org/ |
| wav2vec 2.0 Base | Meta AI | facebook/wav2vec2-base | https://huggingface.co/facebook/wav2vec2-base |
| Windows 11 | Microsoft | Windows 11, точное издание/сборка, если доступно | https://www.microsoft.com/windows/windows-11 |
Ссылки
- Pahwa A, Aggarwal G. Speech feature extraction for gender recognition. Int J Image Graph Signal Process. 2016;8:17.
- Ericsdotter C, Ericsson AM. Gender differences in vowel duration in read Swedish: Preliminary results. Work Pap Lund Univ Dep Linguist Phon. 2001;49:34-37.
- Gamit MR, Dhameliya K, Bhatt NS. Classification techniques for speech recognition: A review. Int J Emerg Technol Adv Eng. 2015;5:58-63.
- Rabiner LR, Juang BH. Fundamentals of Speech Recognition. PTR Prentice Hall; Englewood Cliffs, NJ; 1993.
- Hansen JHL, Hasan T. Speaker recognition by machines and humans: A tutorial review. IEEE Signal Process Mag. 2015;32(6):74-99.
- Zhang Y, et al. Towards end-to-end speech recognition with deep convolutional neural networks [conference presentation]. Presented at: Interspeech 2016; San Francisco, CA; 2016. p. 410-414. Available from: https://www.isca-archive.org/interspeech_2016/zhang16b_interspeech.html
- Kabil SH, Muckenhirn H, Magimai-Doss M. On learning to identify genders from raw speech signal using CNNs [conference presentation]. Presented at: Interspeech 2018; Hyderabad, India; 2018. p. 287-291. Available from: https://www.isca-archive.org/interspeech_2018/kabil18_interspeech.html
- Albawi S, Mohammed TA, Al-Zawi S. Understanding of a convolutional neural network [conference presentation]. Presented at: 2017 International Conference on Engineering and Technology (ICET); Antalya, Türkiye; 2017. p. 1-6. Available from: https://ieeexplore.ieee.org/document/8308186
- Abdi H, Williams LJ. Principal component analysis. Wiley Interdiscip Rev Comput Stat. 2010;2(4):433-459.
- Mavaddati S. Voice-based age, gender, and language recognition based on ResNet deep model and transfer learning in spectro-temporal domain. Neurocomputing. 2024;580:127429.
- Jiang H, et al. 3WD-DRT: A three-way decision enhanced dynamic routing transformer for cost-sensitive multimodal sentiment analysis. Inf Sci. 2026;725:122704.
- Jameel HK, Al Ghrairi AHT, Neamah MM. Self-supervised learning for speech recognition: A review. Dijlah J Eng Sci. 2026;3(2).
- Anidjar OH, Yozevitch R. Transformer-based language-independent gender recognition in noisy audio environments. Sci Rep. 2025;15(1):14421.
- Sinha A, Kathania HK, Kurimo M. A study on the layer-wise transferability of self-supervised learning features for children's speech processing tasks. Speech Commun. 2026;180:103392.
- Li M, Han KJ, Narayanan SS. Automatic speaker age and gender recognition using acoustic and prosodic level information fusion. Comput Speech Lang. 2013;27(1):151-167.
- Sánchez-Hevia HA, Gil-Pita R, Utrilla-Manso M, Rosa-Zurera M. Age group classification and gender recognition from speech with temporal convolutional neural networks. Multimed Tools Appl. 2022;81:3535-3552.
- Abu Mallouh A, Qawaqneh Z, Barkana BD. New transformed features generated by deep bottleneck extractor and a GMM–UBM classifier for speaker age and gender classification. Neural Comput Appl. 2018;30:2581-2593.
- Almomani A, et al. Age and gender classification using backpropagation and bagging algorithms. Comput Mater Contin. 2023;74(2):3045-3062.
- Sahar RM, Rao TS, Anuradha S, Rao BS. Performance analysis of ML algorithms to detect gender based on voice. In: Recent Trends in Intensive Computing. 2021. p. 163-171. Available from: https://journals.sagepub.com/doi/abs/10.3233/APC210192
- Kone VS, et al. Voice-based gender and age recognition system [conference presentation]. Presented at: 2023 International Conference on Advancement in Computation & Computer Technologies (InCACCT); Gharuan, India; 2023. p. 74-80. Available from: https://ieeexplore.ieee.org/document/10141801
- Alhussein M, Muhammad G. Voice gender recognition under unconstrained environments using self-attention. Appl Acoust. 2021;175:107823.
- Yücesoy E. Automatic age and gender recognition using ensemble learning. Appl Sci. 2024;14(16):6868.
- Alnuaim AA, et al. Speaker gender recognition based on deep neural networks and ResNet50. Wirel Commun Mob Comput. 2022;2022:4444388.
- Ibrahim F, Nahar KMO, Al-Shannaq MA. Gender identification and age estimation of Arabic speaker using machine learning. J Theor Appl Inf Technol. 2020;98(19):3242-3256.
- Kannapiran P, Sindha MMR. Voice-based gender recognition model using FRT and LightGBM. Teh Vjesn. 2023;30:282-291.
- Alkhammash EH, Hadjouni M, Elshewey AM. A hybrid ensemble stacking model for gender voice recognition approach. Electronics. 2022;11:1750.
- Mutiany M, Herlistiono IO. Gender detection by voice using deep learning. Int J Innov Sci Res Technol. 2020;5(10):841-845.
- Raahul A, Sapthagiri R, Pankaj PK, Vijayarajan V. Voice based gender classification using machine learning. IOP Conf Ser Mater Sci Eng. 2017;263(4):042083. Available from: https://iopscience.iop.org/article/10.1088/1757-899X/263/4/042083
- Iloanusi O, et al. Voice recognition and gender classification in the context of native languages and lingua franca [conference presentation]. Presented at: 2019 6th International Conference on Soft Computing & Machine Intelligence (ISCMI); Johannesburg, South Africa; 2019. p. 175-179. Available from: https://ieeexplore.ieee.org/document/9004306
- Gupta Y, Gangwar K, Singhal M, Hemavathi D. Gender and age recognition using audio data-artificial neural networks. In: Soft Computing for Security Applications: Proceedings of ICSCS 2021. Springer; 2022. p. 449-470. Available from: https://link.springer.com/chapter/10.1007/978-981-16-5301-8_34
- Qawaqneh Z, Mallouh AA, Barkana BD. Deep neural network framework and transformed MFCCs for speaker’s age and gender classification. Knowl-Based Syst. 2017;115:5-14.
- OgeNI. BVC Challenging Voice Set [Internet]. GitHub; 2025 [cited 2026 Aug 16]. Available from: https://github.com/OgeNI/BVC_Challenging_Voice_Set
- Oppenheim AV, Schafer RW. Discrete-Time Signal Processing. 3rd ed. Pearson; Upper Saddle River, NJ; 2010.
- Logan B. Mel frequency cepstral coefficients for music modeling [conference presentation]. Presented at: International Society for Music Information Retrieval Conference (ISMIR); Plymouth, UK; 2000. Available from: https://ismir.net/conferences/ismir-2000/
- Davis SB, Mermelstein P. Comparison of parametric representations for monosyllabic word recognition in continuously spoken sentences. IEEE Trans Acoust Speech Signal Process. 1980;28(4):357-366.
- Baevski A, Zhou H, Mohamed A, Auli M. wav2vec 2.0: A framework for self-supervised learning of speech representations [conference presentation]. Presented at: Advances in Neural Information Processing Systems 33 (NeurIPS 2020); Virtual; 2020. p. 12449-12460. Available from: https://proceedings.neurips.cc/paper/2020/hash/92d1e1eb1cd6f9fba3227870bb6d7f07-Abstract.html
- Yıldırım Ş, Bingöl MS. Metaheuristic approaches to enhance voice-based gender identification using machine learning methods. Appl Sci. 2025;15(23):12815.
- Breiman L. Random forests. Mach Learn. 2001;45:5-32.
- Hosmer DW Jr, Lemeshow S, Sturdivant RX. Applied Logistic Regression. 3rd ed. Wiley; Hoboken, NJ; 2013.
- Geurts P, Ernst D, Wehenkel L. Extremely randomized trees. Mach Learn. 2006;63:3-42.
- Yücesoy E, Nabiyev VV. A new approach with score-level fusion for the classification of a speaker age and gender. Comput Electr Eng. 2016;53:29-39.
- Cortes C, Vapnik V. Support-vector networks. Mach Learn. 1995;20:273-297.
- Abdel-Hamid O, et al. Convolutional neural networks for speech recognition. IEEE/ACM Trans Audio Speech Lang Process. 2014;22(10):1533-1545.
- Nasaruddin N, Pratama Tresma MAP, Muchamad MK, Fuadi Z. Voice frequency-based gender classification using convolutional neural network for smart home. IEEE Access. 2024;12:104190-104203.
- Simonyan K, Zisserman A. Very deep convolutional networks for large-scale image recognition [conference presentation]. Presented at: International Conference on Learning Representations (ICLR); San Diego, CA; 2015. Available from: https://iclr.cc/archive/www/2015.html
- Tan M, Le QV. EfficientNet: Rethinking model scaling for convolutional neural networks [conference presentation]. Presented at: 36th International Conference on Machine Learning (ICML); Long Beach, CA; 2019. p. 6105-6114. Available from: https://proceedings.mlr.press/v97/tan19a.html
- Ertam F. An effective gender recognition approach using voice data via deeper LSTM networks. Appl Acoust. 2019;156:351-358.
- Zhao L, Wang L, Jia Y, Cui Y. A lightweight deep neural network with higher accuracy. PLoS One. 2022;17(8):e0271225.
- Szegedy C, et al. Rethinking the Inception architecture for computer vision [conference presentation]. Presented at: IEEE Conference on Computer Vision and Pattern Recognition (CVPR); Las Vegas, NV; 2016. p. 2818-2826. Available from: https://openaccess.thecvf.com/content_cvpr_2016/html/Szegedy_Rethinking_the_Inception_CVPR_2016_paper.html
- Sokolova M, Lapalme G. A systematic analysis of performance measures for classification tasks. Inf Process Manag. 2009;45(4):427-437.
- Mozilla Common Voice Project. Common Voice Dataset [Internet]. 2024 [cited 2024 Jun 18]. Available from: https://www.kaggle.com/datasets/mozillaorg/common-voice/data
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.