В данном протоколе интегрируются мультимодальные записи поведения для оценки наблюдаемых коррелятов когнитивных усилий и функциональной эффективности редактирования при письменном переводе и синхронном переводе с листа с английского языка на китайский. Метод сочетает в себе регистрацию нажатий клавиш, захват экрана, аудиоанализ, кодирование на основе транскриптов и стандартизированную оценку качества.
Методическая статья
Поведенческий протокол оценки когнитивных усилий и стратегического пересмотра при выполнении задач по англо-китайскому переводу и синхронному переводу с листа
В этой статье
Краткое содержание
Аннотация
В данной статье представлен мультимодальный поведенческий протокол для изучения наблюдаемых коррелятов когнитивных усилий и стратегического пересмотра при письменном переводе и переводе с листа с английского языка на китайский. Для письменного перевода синхронизируются журналы нажатий клавиш и записи экрана, в то время как для перевода с листа используются аудиозаписи и дословные транскрипты. Эпизоды пересмотра и самокоррекции кодируются по типу и функциональному результату (эффективный, нейтральный или отрицательный) независимо от целостных оценок качества конечного продукта. В демонстрационном исследовании с участием 62 человек, разделенных на группы новичков и подготовленных специалистов, обе группы выполняли два типа заданий в сбалансированном порядке. Подготовленные участники имели более высокие средние баллы качества перевода при письменном переводе (20.1 ± 2.1 против 16.8 ± 2.3) и переводе с листа (18.9 ± 2.4 против 15.4 ± 2.6), а также большую долю эффективных пересмотров или самокоррекций. Поскольку паузы, удаления, латентный период начала действия и плотность пересмотра являются косвенными и зависят от конкретной задачи, они интерпретируются как поведенческие корреляты, требующие триангуляции, а не как прямые показатели единого конструкта. Протокол предназначен для контролируемых экспозиционных текстов и может быть адаптирован для других языковых пар после перекалибровки обработки методов ввода, порогов пауз, сопоставимости текстов и процедур оценивания.
Введение
Письменный перевод и перевод с листа с английского на китайский языки требуют понимания исходного текста, кросс-лингвистического переноса и формулирования на языке перевода, однако эти виды деятельности предполагают разные условия выполнения задачи. Письменный перевод допускает рекурсивное чтение и отложенное редактирование, в то время как перевод с листа требует устного воспроизведения в условиях более жестких временных ограничений. Когнитивная нагрузка, сложность обработки и когнитивные усилия являются взаимосвязанными, но не взаимозаменяемыми конструктами: нагрузка относится к требованиям задачи, тогда как усилия касаются ресурсов, которые участник затрачивает для выполнения этих требований. Когнитивные усилия носят латентный и многомерный характер; следовательно, латентный период, паузы, пропуски и плотность ревизий рассматриваются здесь как поведенческие корреляты, которые могут отражать планирование, мониторинг, моторные процессы или затруднения, и должны интерпретироваться совместно, а не как прямые показатели усилий1,2,3,4,5,6,7,8.
Процессо-ориентированные исследования сочетают оценки качества конечного продукта с синхронизированными по времени записями поведения, чтобы определить, когда и как принимаются переводческие решения. Регистрация нажатий клавиш (кейлоггинг) дает важную информацию о последовательности создания и редактирования текста, однако особенности ввода китайских иероглифов могут приводить к разрыву между физическими нажатиями клавиш и итоговыми символами; поэтому для реконструкции видимого состояния текста требуется синхронизированная запись экрана9,10,11. Пороги пауз являются результатом аналитического выбора, а не универсальными когнитивными границами, и использование более коротких порогов может существенно изменить выводы, основанные на анализе пауз8,12. Следовательно, данный протокол требует проведения эксплицитных проверок синхронизации, анализа чувствительности к порогам и разграничения специфических для конкретной задачи показателей и общих мер.
Одна лишь частота исправлений не указывает на то, улучшает ли мониторинг результат. Письменные правки и устные самоисправления могут быть направлены на лексический выбор, синтаксис, смысл или стиль, однако их функциональный результат должен оцениваться в сопоставлении с исходным значением и непосредственно предшествующим сегментом перевода. Исследования синхронного перевода с листа при обработке пар английский-китайский и китайский-английский языки показывают, что подготовка, направление перевода, глазо-речевая координация и специфические для конкретного языка триггеры проблем могут изменять паттерны исполнения13,14,15,16. По этой причине тип эпизода, результат эпизода, качество конечного продукта и поведение, связанное с подачей речи, кодируются как отдельные переменные.
Данный протокол предназначен для взрослых учащихся или квалифицированных переводчиков/синхронных переводчиков, работающих с короткими неспециализированными экспозиционными текстами в контролируемых компьютерных сессиях. Он наиболее эффективен в случаях, когда при письменном воспроизведении возможно фиксировать нажатия клавиш и записи экрана, а при устном воспроизведении — записывать высококачественный аудиосигнал. Методологию можно адаптировать для других языковых пар, однако соответствие текстов, сегментация на информационные единицы, особенности поведения клавиатуры или метода ввода, пороги пауз и опорные точки оценки должны быть заново подтверждены для каждой языковой пары и системы письма17. В данной демонстрации сравниваются условия выполнения задания, а не только влияние модальности, поскольку длина текста, временные ограничения, режим вывода и возможности редактирования также различаются.
Протокол
Все методы, предполагающие участие людей, были выполнены в соответствии с институциональными рекомендациями и получили официальное одобрение Комитета по этике исследований с участием людей Института информационных технологий города Гуйлинь (номер одобрения UYHAJ2025899). До начала участия от всех добровольцев было получено письменное информированное согласие. Полный список оборудования и программного обеспечения, использованного в данном исследовании, приведен в Таблице материалов.
1. Набор участников и распределение по группам
- Наберите 62 участника, включая студентов специальностей «английский язык» или «перевод», а также стажеров-переводчиков-синхронистов. Убедитесь, что все участники являются носителями китайского языка и имеют нормальное или скорректированное до нормы зрение и слух.
- Распределите участников со стажем структурированного обучения переводу менее 12 месяцев в группу новичков, а участников со стажем 12 месяцев и более — в группу обученных специалистов. Отдельно укажите опыт письменного перевода и перевода с листа для всех участников.
- Проведите скрининг участников перед назначением заданий, чтобы исключить лиц, которые ранее сталкивались с исходными текстами, имеют нескорректированные нарушения сенсорного восприятия или не умеют пользоваться стандартизированным методом ввода китайских иероглифов.
- Исключайте задания после записи только по заранее определенным причинам, таким как использование запрещенных внешних инструментов, неполное выполнение, повреждение файлов или непригодность аудиозаписи.
- Ведите журнал исключения заданий без указания персональных данных. Приводите данные об окончательной анализируемой выборке согласованно в тексте и на Рисунке 1A–D.
2. Выбор материалов и предварительная оценка
- Выберите короткие английские экспликативные тексты из областей общей академической, образовательной, социальной или общественной коммуникации. Используйте тексты для письменного перевода объемом примерно 180–220 слов и тексты для синхронного перевода с листа объемом примерно 120–160 слов.
- Сопоставьте или статистически скорректируйте длину текста, лексическую сложность, синтаксическую сложность, плотность информации и степень знакомства с темой для всех условий задания.
- Поручите трем двуязычным экспертам независимо оценить лексическую сложность, синтаксическую сложность, плотность информации, степень знакомства с темой и пригодность для перевода по шкале от 1 до 5 баллов (1 = очень низкая, 5 = очень высокая).
- Рассчитайте двухфакторный коэффициент внутриклассовой корреляции (ICC) со случайными эффектами с 95% доверительным интервалом для усредненных оценок. Пересмотрите пункты, демонстрирующие низкое согласование (ICC < 0.75).
- Сохраняйте пары текстов только в том случае, если стандартизированные переменные сопоставления находятся в пределах допуска ±10%.
- Определите информационную единицу как наименьшее предложение исходного текста, которое выражает одну независимо оцениваемую идею, связь или событие. Разрешите разногласия по поводу границ единиц до начала выполнения задания.
- Проведите пилотное тестирование инструкций, метода ввода, синхронизации, качества звука и временных ограничений с участием лиц, не включенных в основной анализ. Зафиксируйте распределение времени выполнения и долю участников, достигших каждого временного лимита.
- Пересмотрите текст или временное ограничение, если результаты пилотных участников демонстрируют «эффект потолка» или «эффект пола», стойкую двусмысленность или нестабильность записи. Документируйте каждое изменение до запуска основного исследования.
3. Организация проведения задания и настройка записи
- Тестируйте участников индивидуально в тихом помещении с шумоподавлением, используя стандартизированные конфигурации аппаратного и программного обеспечения.
- Зачитайте стандартизированный сценарий инструкций и предоставьте один неэкспериментальный тренировочный пример. Запретите использование словарей, поисковых систем, генеративного искусственного интеллекта, машинного перевода и внешних корпусов текстов.
- Используйте контрбалансировку порядка выполнения двух заданий (сначала письменный перевод или сначала перевод с листа) внутри каждой тренировочной группы и соблюдайте 5-минутный интервал отдыха.
- Подготовьте список распределения до завершения набора участников и держите назначение в секрете до подтверждения соответствия критериям отбора. Если используются несколько исходных текстов, проведите контрбалансировку идентичности текстов независимо от порядка заданий и сохраните переменную ID текста для последующего анализа.
- Выведите английский исходный текст непрерывно и поручите участнику создать точный и естественный перевод на китайский язык в назначенном поле ввода. Разрешите неограниченное редактирование, но строго запретите вставку внешнего текста.
- Примените 20-минутный лимит времени, установленный в ходе пилотного исследования, не отображая при этом таймер обратного отсчета, и зафиксируйте факт достижения этого лимита.
- Непрерывно фиксируйте весь процесс письменного перевода, используя программное обеспечение для регистрации нажатий клавиш, синхронизированное с непрерывной записью экрана. Сохраните окончательные варианты перевода вместе с файлами логов с временными метками для последующего извлечения поведенческих данных.
- Выведите исходный текст для перевода с листа на экран и поручите участнику начать устный перевод на китайский язык без использования письменных заметок.
- Последовательно применяйте 6-минутный лимит времени и фиксируйте факт его достижения. Отличайте наблюдение, ограниченное по времени, от обычного завершенного наблюдения.
- Записывайте устную речь с помощью программного обеспечения для цифрового захвата звука. Создайте строгие дословные транскрипты этих записей для облегчения последующего кодирования.
4. Извлечение индикаторов поведенческих процессов
- Извлеките поведенческие корреляты письменного задания из лог-файлов, определив начальную латентность как интервал от начала предъявления стимула до ввода первого китайского иероглифа.
- Извлеките общее время выполнения задания, количество и продолжительность пауз, частоту удалений, плотность правок и скорость продукции. Сохраните исходные временные метки и точное значение знаменателя, использованного для каждого нормализованного показателя.
- Используйте 2 s в качестве операционного порога письменной паузы. Укажите, включены ли паузы при перемещении курсора, выделении текста или выборе кандидата в методе ввода.
- Извлеките поведенческие корреляты устного задания из осциллограммы и верифицированной транскрипции, определив латентность начала как интервал от предъявления стимула до первого значимого высказывания на целевом языке.
- Исключите вдох, прочистку горла и прерванные нелексические звуки из расчета латентности начала. Извлеките общее время перевода, молчаливые паузы, заполненные паузы, повторы, ложные старты, самокоррекции и темп речи.
- Определите устную молчаливую паузу как тишину внутри высказывания продолжительностью не менее 1.0 s. Сверьте границы пауз с осциллограммой и верифицированной транскрипцией; исключите начальную и конечную тишину из подсчета пауз внутри высказывания.
- Заполните запись контроля качества для каждого выполненного задания. Задокументируйте, является ли соответствующий файл процесса читаемым и полным, была ли верифицирована транскрипция и было ли завершено кодирование или проведено вынесение окончательного решения (адъюдикация). Сохраните исходную запись и фиксируйте все исправления в журнале аудита.
5. Кодирование стратегического пересмотра и устного самоисправления
- Реконструируйте каждую письменную правку, сопоставляя лог нажатий клавиш, запись экрана и окончательный текст.
- Рассматривайте эпизод как непрерывную последовательность действий по редактированию, направленных на один и тот же целевой сегмент; завершайте эпизод, если работа возобновляется в другом месте в течение как минимум 2 s или если редактируется другой сегмент.
ПРИМЕЧАНИЕ: Для ввода на китайском языке отличайте изменения в процессе набора (до подтверждения ввода) от удалений целевого текста после подтверждения ввода; в качестве текстовых правок кодируйте только последние. - Присвойте один основной тип правки на основе семантических, синтаксических, лексических или стилистических изменений. Допускается использование вторичного тега для перекрывающихся случаев, но для взаимно исключающего подсчета используйте основной тег. Применяйте примеры, приведенные в Supplementary File 1.
- Создайте дословную транскрипцию с временными метками перед кодированием устных самоисправлений. Поручите первому транскрибатору отмечать лексический контент, заполненные паузы, повторы, ложные старты, обрывы фраз и неразборчивые участки.
- Привлеките второго обученного рецензента для проверки транскрипции на соответствие аудиозаписи и устранения расхождений с сохранением исходных временных меток аудио.
- Определяйте устное самоисправление как явную переформулировку, которая заменяет, дополняет или исправляет непосредственно предшествующий сегмент на целевом языке. Не делайте выводов о скрытом мониторинге только на основании тишины. Применяйте те же правила принятия решений по лексическим, синтаксическим, семантическим и стилистическим аспектам к устным самоисправлениям.
- Кодируйте точный повтор без корректирующего изменения как дисфлюэнтность, незавершенный старт, за которым следует новая конструкция, — как ложный старт плюс исправление, а пропуск или ошибочный перевод без явной переформулировки — как ошибку вывода.
- Если аудиозапись нечеткая или если две категории остаются в равной степени правдоподобными, отметьте эпизод как неоднозначный. Сохраняйте предварительные теги для неоднозначных эпизодов и выносите окончательное решение по ним до проведения анализа надежности.
- Оценивайте функциональный результат, сравнивая целевые сегменты до и после эпизода с исходной информационной единицей и локальным контекстом целевого текста. Сделайте эту оценку до раскрытия окончального общего балла. Не используйте изменение общего балла в качестве определения эффективности.
- Проведите двойное кодирование как минимум 20% выходных данных, выбранных из обеих групп и порядков выполнения задач, и рассчитайте надежность на основе независимых кодов до вынесения окончательного решения.
- Проведите повторное обучение и перекодирование, если согласованность между экспертами упадет ниже значения каппы Коэна 0.80. Задокументируйте этот точный порог и любые предпринятые корректирующие действия.
6. Оценка качества и статистическое моделирование
- Оцените каждый окончательный письменный перевод и результат синхронного перевода по 25-балльной аналитической рубрике в Дополнительном файле 1.
- Оцените точность, полноту, лексическую уместность, связность и естественность на целевом языке по шкале от 0 до 5, используя установленные ориентиры. Не корректируйте критерии оценки после ознакомления с принадлежностью к группе.
- Инструктируйте оценивающих использовать как аудиозапись, так и проверенную транскрипцию для параметров синхронного перевода. Анализируйте показатели пауз и дисфлюэнтности отдельно от баллов по рубрике.
- Обучите двух независимых оценивающих, используя кодовую книгу и не менее 10 тренировочных примеров, обеспечив слепой метод в отношении группы участников и порядка выполнения заданий.
- После независимой оценки и кодирования эпизодов рассчитайте надежность до проведения обсуждения. Разрешайте разногласия путем консенсуса и привлекайте третьего оценивающего только в тех случаях, когда консенсус не может быть достигнут.
- Укажите двухфакторный коэффициент внутриклассовой корреляции с рандомными эффектами и абсолютным согласием для усредненных непрерывных показателей качества. Укажите каппа Коэна для основного категориального кода пересмотра и отдельный показатель каппа для кода исхода (эффективный/нейтральный/вредный). Укажите точное количество и процент эпизодов с двойным кодированием.
- Перед началом анализа убедитесь, что каждый файл процесса читаем и полон; сопоставьте логи письменных заданий с соответствующими записями экрана и сверьте транскрипции с аудиозаписями.
- Фиксируйте сбои сопоставления, проблемы с разборчивостью и корректирующие действия в журнале контроля качества. Нормализуйте показатели частоты, используя 100 информационных единиц исходного текста для частоты пауз и 100 созданных китайских иероглифов для плотности письменного пересмотра.
- Кодируйте функциональный исход независимо от итогового общего балла качества. Кодируйте эпизод как «эффективный», если сегмент после пересмотра улучшает текст, не внося новых проблем; как «нейтральный», если он не приводит к существенным изменениям; и как «вредный», если он вносит ошибку.
- Рассчитайте долю эффективности как отношение количества эффективных эпизодов к общему числу классифицируемых эпизодов, исключая неоднозначные эпизоды из знаменателя.
- Анализируйте демонстрацию как исследовательский набор данных с повторными измерениями. Определите модель с фиксированными эффектами для прогнозирования общего балла качества, используя условие задачи, группу обучения, показатели пауз, плотность пересмотра, долю эффективности, степень дисфлюэнтности и темп речи.
- Включите случайный перехват для участника (participant random intercept) и случайные эффекты исходного текста только в том случае, если дизайн содержит достаточное количество независимо отобранных текстов.
- Центрируйте непрерывные предикторы, проверьте остатки и коллинеарность. Укажите метод оценки, версию программного обеспечения, β, SE, 95% CI, точные значения p, компоненты дисперсии, AIC, BIC, а также предельный и условный R2. Опишите анализ как исследовательский и избегайте подтверждающих причинно-следственных утверждений.
- Экспортируйте воспроизводимый пакет анализа, содержащий деидентифицированные данные, словарь, кодовую книгу, рубрику, сведения о ПО, скрипты и результаты. Перед публикацией подтвердите, что каждое значение в рисунках и таблицах может быть прослежено до именованной переменной и этапа анализа.
Результаты
Исходные характеристики участников и доступность данных
В опроснике приняли участие 62 участника (31 новичок и 31 опытный специалист), а лист заданий содержал 124 записи, что соответствует двум заполненным записям о выполнении задания на каждого участника (Таблица 1). Группа новичков имела менее 12 месяцев структурированного обучения переводу (наблюдаемый максимум — 8,6 месяца), в то время как группа опытных специалистов имела стаж обучения не менее 12 месяцев (наблюдаемый минимум — 13,3 месяца). Распределение по возрасту, полу, продолжительности изучения английского языка, уровню владения языком и порядку выполнения заданий в группах было схожим. На рисунке 1 представлена итоговая анализируемая выборка с разграничением данных по конкретным заданиям: логи нажатий клавиш и записи экрана относятся к письменному переводу, аудиозаписи и дословные транскрипты — к синхронному переводу с листа, а оценки качества применяются к обоим видам деятельности.
Поведенческие профили в различных условиях выполнения задачи
Поведенческие профили различались между двумя условиями выполнения заданий и между группами обучения (Таблица 2; Рисунок 2A–E). При письменном переводе время выполнения было больше, а средняя продолжительность пауз была длиннее, в то время как при устном переводе с листа наблюдалось большее количество пауз на 100 единиц информации ниже установленного порога. В каждом условии выполнения задания группа, прошедшая обучение, справлялась с заданиями быстрее и имела более высокие средние показатели качества конечного текста. Эти различия не следует интерпретировать исключительно как эффекты модальности, поскольку также различались длина текста, ограничение по времени, способ вывода и возможность редактирования. Паузы не всегда носят деструктивный характер: пауза может отражать неразрешенную трудность, успешное планирование, мониторинг или активность метода ввода, поэтому показатели пауз интерпретируются совместно с показателями редактирования, подачи материала и качества.
Стратегический пересмотр, самовосстановление и прогностическое моделирование
Схема кодирования разделяла тип эпизода и функциональный результат (Таблица 3; Рисунок 3A–D). Обученные участники создали больше эпизодов письменного пересмотра, чем новички (12.4 ± 3.7 против 8.9 ± 3.0 на задание), в то время как общее количество устных самоисправлений существенно не различалось между группами (4.9 ± 1.6 против 4.4 ± 1.5 на задание). Тем не менее, в группе обученных участников доля эффективных эпизодов была выше в обоих заданиях. Приведенное в Таблице 4 резюме смешанных эффектов представляет ассоциации, а не причинно-следственные связи; поэтому на Рисунке 3E вместо причинно-следственной диаграммы отображены сообщенные оценки фиксированного эффекта и доверительные интервалы.
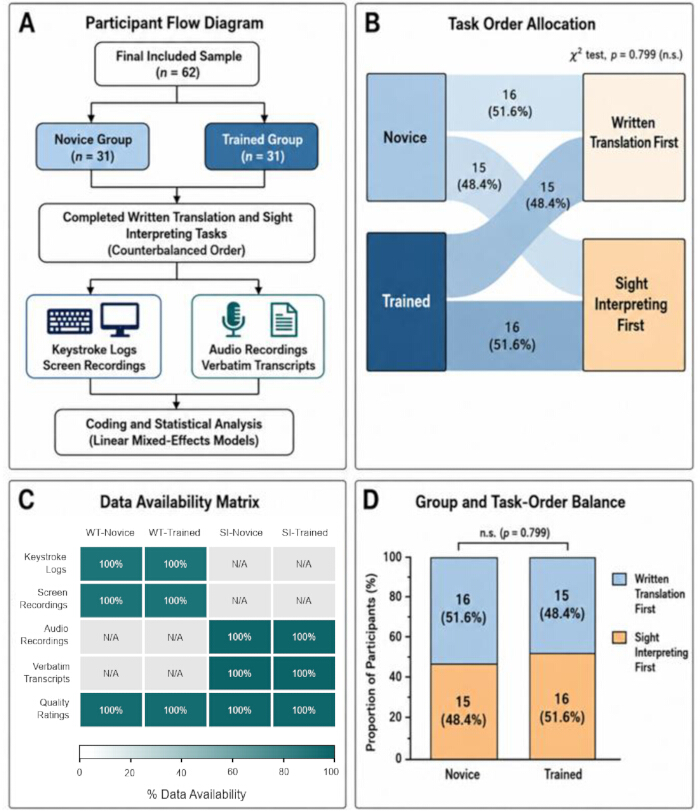
Рисунок 1: Поток участников, распределение порядка выполнения заданий и доступность данных по конкретным заданиям. (A) Итоговая анализируемая выборка из 62 участников и 124 записей о выполнении заданий. (B) Сбалансированное распределение порядка выполнения заданий внутри групп новичков и обученных специалистов. (C) Матрица доступности, в которой логи нажатий клавиш и записи экрана применимы только к письменному переводу, аудиозаписи и дословные транскрипты — только к устному переводу с листа, а оценки качества — к обоим видам заданий. (D) Баланс групп по порядку выполнения (критерий хи-квадрат, p = 0.799). n = 62 участника (по 31 в каждой группе). Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
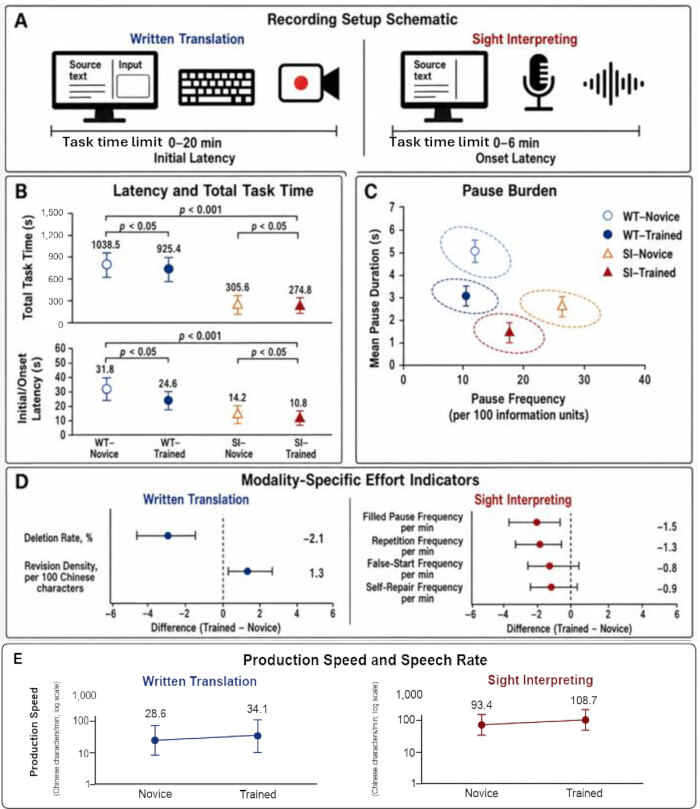
Рисунок 2: Поведенческие профили в условиях выполнения задач по письменному переводу и устному переводу с листа. (A) Специфическая для каждой задачи установка для записи. (B) Начальная латентность и общее время выполнения задания. (C) Совместное распределение частоты пауз и средней продолжительности пауз. (D) Специфические для каждой задачи показатели удалений, исправлений и устных дисфлюенций. (E) Скорость письменного воспроизведения и скорость устной речи. На панелях B, C и E точки и планки погрешностей отображают средние значения по группе ± SD; на панели D точки отображают средние различия между опытными и начинающими специалистами, а планки погрешностей — 95% доверительные интервалы. n = 31 участник в каждой группе. На панели E ось y представлена в логарифмическом масштабе. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
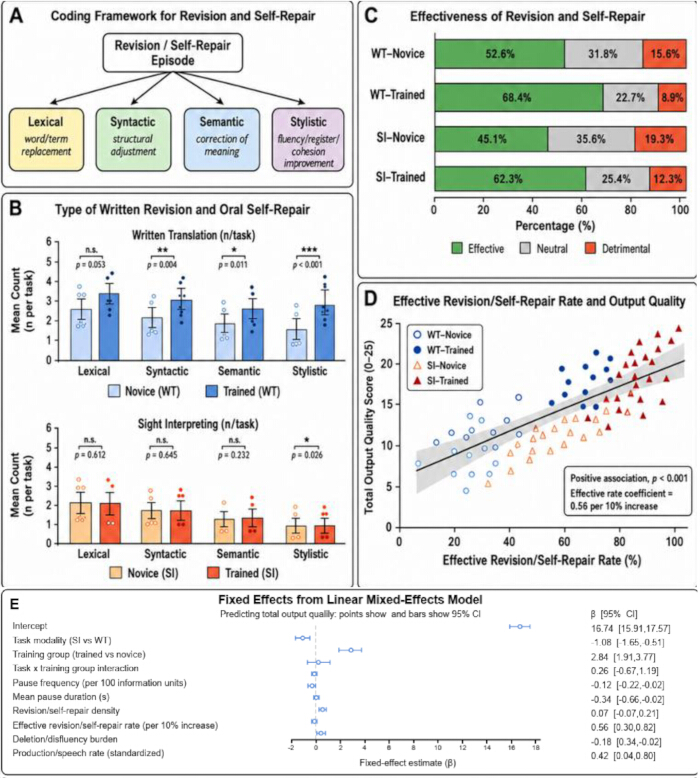
Рисунок 3: Связи между кодированием пересмотра/самокоррекции, функциональным результатом и качеством выходных данных. (A) Структура принятия решений для независимого назначения типа эпизода и функционального результата. (B) Среднее количество лексических, синтаксических, семантических и стилистических эпизодов в каждом условии задачи. (C) Средние доли эффективных, нейтральных и вредных эпизодов. (D) Описательная связь между частотой эффективных эпизодов и общим баллом качества выходных данных. (E) Форест-график, отображающий фиксированные эффекты линейной смешанной модели с 95% доверительными интервалами (подробно описаны в Таблице 4); график носит ассоциативный характер и не представляет собой модель причинно-следственной связи. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
| Переменные | Группа новичков (n = 31) | Обученная группа (n = 31) | p значение |
| Возраст, лет | 21.9 ± 1.7 | 22.4 ± 1.9 | 0.279 |
| Женщины, n (%) | 22 (71.0) | 21 (67.7) | 0.779 |
| Продолжительность изучения английского языка, лет | 12.4 ± 2.1 | 12.9 ± 2.2 | 0.36 |
| Балл владения английским языком | 548.6 ± 41.3 | 562.4 ± 45.8 | 0.216 |
| Продолжительность обучения переводу, месяцев | 5.6 ± 3.0 | 18.7 ± 5.4 | <0.001 |
| Интерпретация продолжительности обучения, месяцы | 2.3 ± 2.1 | 13.9 ± 5.7 | <0.001 |
| Опыт письменного перевода в прошлом ≥5 заданий, n (%) | 9 (29.0) | 24 (77.4) | <0.001 |
| Практика предварительного анализа снимков ≥5 заданий, n (%) | 5 (16.1) | 20 (64.5) | <0.001 |
| Письменный перевод сначала, n (%) | 16 (51.6) | 15 (48.4) | 0.799 |
| Первичная интерпретация зрения, n (%) | 15 (48.4) | 16 (51.6) | 0.799 |
Таблица 1: Характеристики участников и исходные профили языкового обучения по группам. Переменные представлены в виде среднего значения ± стандартного отклонения для непрерывных данных и в виде количества (процентов) для категориальных данных. Указанные значения p отражают межгрупповые сравнения для проверки исходного демографического баланса и подтверждения намеченных различий в продолжительности обучения.
| Переменные | Письменный перевод: начинающие (n = 31) | Письменный перевод: обученные (n = 31) | Начинающие специалисты по интерпретации (n = 31) | Обученная группа интерпретации с листа (n = 31) | Эффект задачи p | Групповой эффект p |
| Латентный период начала/возникновения, с | 31.8 ± 12.4 | 24.6 ± 9.7 | 14.2 ± 5.6 | 10.8 ± 4.2 | <0.001 | 0.003 |
| Общее время выполнения задачи, с | 1038.5 ± 168.2 | 925.4 ± 151.6 | 305.6 ± 59.3 | 274.8 ± 50.7 | <0.001 | 0.004 |
| Частота пауз на 100 единиц информации | 18.6 ± 6.1 | 14.2 ± 5.0 | 24.8 ± 7.4 | 19.6 ± 6.3 | <0.001 | 0.001 |
| Средняя продолжительность паузы, с | 4.1 ± 1.2 | 3.3 ± 1.0 | 2.7 ± 0.8 | 2.3 ± 0.7 | 0.012 | 0.002 |
| Скорость продукции/речи, иероглифов в минуту | 28.6 ± 6.7 | 34.1 ± 7.5 | 93.4 ± 18.9 | 108.7 ± 20.4 | 0.001 | |
| Частота делеций, % | 8.9 ± 3.4 | 6.8 ± 2.7 | 0.009 | |||
| Плотность правок на 100 китайских иероглифов | 7.6 ± 2.8 | 8.9 ± 3.1 | 0.087 | |||
| Частота заполняющих пауз, в мин. | 5.7 ± 1.9 | 4.2 ± 1.6 | 0.002 | |||
| Частота повторений, в мин⁻¹ | 4.9 ± 1.8 | 3.6 ± 1.4 | 0.004 | |||
| Частота ложных стартов, в мин⁻¹ | 2.8 ± 1.1 | 2.0 ± 0.9 | 0.006 | |||
| Частота самовосстановления, в мин⁻¹ | 4.8 ± 1.7 | 3.9 ± 1.4 | 0.031 | |||
| Общий показатель качества, 0–25 | 16.8 ± 2.3 | 20.1 ± 2.1 | 15.4 ± 2.6 | 18.9 ± 2.4 | 0.002 | <0.001 |
| Точность, 0–5 | 3.4 ± 0.7 | 4.1 ± 0.6 | 3.1 ± 0.8 | 3.8 ± 0.7 | 0.004 | <0.001 |
| Полнота, 0–5 | 3.3 ± 0.8 | 4.0 ± 0.6 | 3.0 ± 0.8 | 3.7 ± 0.7 | 0.006 | <0.001 |
| Лексическая адекватность, 0–5 | 3.2 ± 0.7 | 4.0 ± 0.6 | 3.1 ± 0.7 | 3.8 ± 0.6 | 0.041 | <0.001 |
| Когерентность, 0–5 | 3.5 ± 0.6 | 4.0 ± 0.6 | 3.1 ± 0.7 | 3.8 ± 0.6 | 0.003 | <0.001 |
| Естественность языка перевода, 0–5 | 3.4 ± 0.7 | 4.0 ± 0.6 | 3.1 ± 0.7 | 3.8 ± 0.7 | 0.007 | <0.001 |
Таблица 2: Показатели поведенческого процесса и качество результатов в зависимости от условий задачи и групп. Значения представлены как среднее ± стандартное отклонение. Приведенные значения p указывают на основные эффекты модальности задачи (письменный перевод против синхронного перевода с листа) и опыта обучения (новички против подготовленных специалистов) для каждой переменной процесса и качества.
| Переменные | Письменный перевод (новички) | Письменный перевод (обученные) | Значение p | Устный перевод с листа (новички) | Устный перевод с листа (обученные) | Значение p |
| Лексическая правка/самокоррекция, n/задание | 3.4 ± 1.5 | 4.2 ± 1.7 | 0.053 | 1.8 ± 0.8 | 1.7 ± 0.7 | 0.612 |
| Синтаксическая правка/самокоррекция, n/задание | 2.1 ± 1.1 | 3.0 ± 1.2 | 0.004 | 1.1 ± 0.7 | 1.2 ± 0.8 | 0.645 |
| Семантическая правка/самокоррекция, n/задание | 1.8 ± 1.0 | 2.5 ± 1.1 | 0.011 | 0.9 ± 0.6 | 1.1 ± 0.7 | 0.232 |
| Стилистическая правка/самокоррекция, n/задание | 1.6 ± 0.9 | 2.7 ± 1.2 | <0.001 | 0.6 ± 0.4 | 0.9 ± 0.6 | 0.026 |
| Общее количество эпизодов правки/самокоррекции, n/задание | 8.9 ± 3.0 | 12.4 ± 3.7 | <0.001 | 4.4 ± 1.5 | 4.9 ± 1.6 | 0.209 |
| Эффективные эпизоды, % | 52.6 ± 13.5 | 68.4 ± 12.1 | <0.001 | 45.1 ± 14.2 | 62.3 ± 13.0 | <0.001 |
| Нейтральные эпизоды, % | 31.8 ± 10.4 | 22.7 ± 8.8 | 0.001 | 35.6 ± 11.7 | 25.4 ± 9.6 | 0.001 |
| Деструктивные эпизоды, % | 15.6 ± 7.1 | 8.9 ± 5.6 | <0.001 | 19.3 ± 8.6 | 12.3 ± 6.8 | 0.001 |
Таблица 3: Тип и эффективность письменных исправлений и устных самоисправлений в различных условиях выполнения задания. Типы эпизодов представлены в виде средних значений количества на задание (± стандартное отклонение), а функциональные результаты — в виде средних процентов (± стандартное отклонение). Значения p указывают на значимость межгрупповых различий в рамках каждого модального режима выполнения задания.
| Фиксированные эффекты | β | СЭ (стандартная ошибка) | 95% ДИ | p значение |
| Перехват | 16.74 | 0.42 | 15.91–17.57 | <0.001 |
| Модальность задачи: синхронный перевод с листа против письменного перевода | -1.08 | 0.29 | от -1,65 до -0,51 | <0.001 |
| Группа обучения: обученные против новичков | 2.84 | 0.47 | 1,91–3,77 | <0.001 |
| Модальность задачи × группа обучения | 0.26 | 0.47 | от -0,67 до 1,19 | 0.581 |
| Частота пауз на 100 единиц информации | -0.12 | 0.05 | от -0,22 до -0,02 | 0.018 |
| Средняя продолжительность паузы, с | -0.34 | 0.16 | от -0,66 до -0,02 | 0.041 |
| Плотность ревизий/самовосстановления | 0.07 | 0.07 | от -0,07 до 0,21 | 0.334 |
| Эффективная скорость ревизии/самовосстановления на каждые 10% увеличения | 0.56 | 0.13 | 0,30–0,82 | <0.001 |
| Нагрузка из-за делеций/дисфлюэнции | -0.18 | 0.08 | от -0,34 до -0,02 | 0.027 |
| Стандартизированная скорость продукции/речи | 0.42 | 0.19 | 0,04–0,80 | 0.032 |
Таблица 4: Отчетные фиксированные эффекты линейной модели со смешанными эффектами для прогнозирования общего качества результатов. В сводке приведены нестандартизированные коэффициенты (β), стандартные ошибки (SE), 95% доверительные интервалы (CI) и точные значения p для всех указанных предикторов задач и поведения.
Обсуждение
В данном исследовании представлен мультимодальный протокол измерения наблюдаемых показателей процесса и кодирования стратегического пересмотра при письменном переводе и экспромте с английского языка на китайский. Данный протокол не измеряет напрямую единую переменную когнитивных усилий. Вместо этого латентный период, паузы, удаления и паттерны пересмотра интерпретируются как чувствительные к задаче поведенческие корреляты, значение которых определяется путем триангуляции с синхронизированными записями и данными о качестве выходного текста.1,2,3,4,5,6,7,8Эти две задачи также различаются по используемым материалам, временным рамкам, способу вывода данных и возможности внесения исправлений; таким образом, выявленные контрасты описывают различия между условиями выполнения задач, а не изолированные эффекты модальности. Основной аналитический вклад заключается в разграничении частоты исправлений и функционального результата. В представленных сводках обученные участники вносили больше письменных исправлений, а не меньше, тогда как общее количество устных самоисправлений существенно между группами не различалось. Более высокая доля эффективных эпизодов у этой группы позволяет предположить, что качество мониторинга может быть более информативным показателем, чем абсолютная частота, однако такая интерпретация зависит от прозрачности правил принятия решений, независимого кодирования результатов и представленных данных о надежности. Кодбук и практические примеры в Дополнительный файл 1 предназначены для того, чтобы сделать это различие воспроизводимым, а не рекламным.
Критически важными этапами являются синхронизация записей, качество аудио, проверка транскрипции и согласованность кодирования. При синхронизации журналов и записей следует проверять имеющиеся временные метки и сигналы границ задач. Перед транскрипцией необходимо проверить аудио на наличие клиппинга и разборчивость речи, а предлагаемые границы пауз следует верифицировать по осциллограмме и транскрипту. При вводе на китайском языке нажатия клавиш в процессе набора символов не должны приравниваться к правкам окончательно введенных иероглифов. Результаты этих проверок и корректирующие действия должны фиксироваться в журнале контроля качества.
Интерпретация результатов ограничена рядом факторов. В демонстрации использовались когорты студентов и стажеров, короткие общеэкспозиционные тексты, задания различной длины и разные временные ограничения, а выборка формировалась на основе доступности участников. Условия выполнения заданий также различались по способу вывода данных и возможности редактирования, а набор данных не содержит независимо отобранных идентификаторов исходных текстов для оценки вариативности на уровне текста. Кроме того, пороговые значения пауз являются операционным выбором, и более длительные паузы могут отражать как продуктивное планирование, так и неразрешенные трудности. Обобщение результатов на профессионалов, специализированные области, другие языковые пары или иные системы письма требует повторной валидации материалов, способов обработки ввода, пороговых значений и опорных точек оценивания.
В будущих работах можно объединить записи поведения с айтрекингом, пупиллометрией или субъективными показателями рабочей нагрузки, чтобы определить, какие паузы и исправления соответствуют вниманию, приложенным усилиям или успешному планированию5,6,13,14,15,16. Shreve и др. использовали айтрекинг при устном переводе с листа, и их работу не следует цитировать как исследование по пупиллометрии18; пупиллометрия напрямую обсуждается в работе Seeber5. Подобные мультимодальные расширения должны сохранять разграничение между требованиями задачи, затраченными усилиями, наблюдаемым поведением и результативностью. Таким образом, настоящий протокол лучше всего использовать как прозрачную систему оценки процесса, индикаторы которой поддерживают, но сами по себе не доказывают утверждения о скрытых когнитивных усилиях.
Раскрытие информации
Авторы заявляют об отсутствии коммерческого или финансового конфликта интересов. Что касается использования искусственного интеллекта, авторы сообщают, что OpenAI Codex использовался в процессе доработки исключительно для помощи в редактировании языка, проверки согласованности, подготовки исправлений в режиме правки и перестройки макетов рисунков на основе предоставленных авторами данных. Авторы тщательно проверили все результаты, полученные с помощью ИИ, и несут полную ответственность за точность, целостность и оригинальность окончательного текста рукописи. Структурированная рабочая тетрадь, лежащая в основе представленных резюме, находится в открытом доступе на Zenodo (https://doi.org/10.5281/zenodo.21189434). Дополнительный файл 1 содержит руководство по кодированию и закрепленную рубрику оценки качества.
Благодарности
Автор благодарит Гуйлиньский институт информационных технологий за лабораторную поддержку, экспертов-билингвов, оценивавших исходные тексты, независимых рецензентов и участников. Данное исследование не получило специального гранта от какого-либо финансирующего агентства в государственном, коммерческом или некоммерческом секторах.
Материалы
| Имя | Компания | Каталожный номер | Комментарии |
|---|---|---|---|
| Программное обеспечение для акустического анализа (Praat) | Paul Boersma and David Weenink | https://www.fon.hum.uva.nl/praat/ | |
| Настольный компьютер | Dell | OptiPlex | |
| Программное обеспечение для цифровой записи аудио (Audacity) | Audacity Team | https://www.audacityteam.org/ | |
| Программное обеспечение для регистрации нажатий клавиш (Inputlog) | University of Antwerp | https://www.inputlog.net/ | |
| Программное обеспечение для записи экрана (OBS Studio) | OBS Project | https://democreator.wondershare.com/ | |
| Программное обеспечение для статистического анализа (SPSS) | IBM | Version 27 |
Ссылки
- Gieshoff AC, Heeb AH. Cognitive load and cognitive effort: probing the psychological reality of a conceptual difference. Transl Cogn Behav. 2023;6(1):3–28.
- Sweller J, van Merriënboer JJG, Paas F. Cognitive architecture and instructional design. Educ Psychol Rev. 1998;10(3):251–96.
- Paas F, Tuovinen JE, Tabbers H, Van Gerven PWM. Cognitive load measurement as a means to advance cognitive load theory. Educ Psychol. 2003;38(1):63–71.
- Gile D. Basic Concepts and Models for Interpreter and Translator Training. Amsterdam: John Benjamins; 2009.
- Seeber KG. Cognitive load in simultaneous interpreting: measures and methods. Target. 2013;25(1):18–32.
- Ferreira A, Schwieter JW, Gottardo A, Jones JA. Cognitive effort in direct and inverse translation performance: insight from eye-tracking technology. Cad Trad. 2016;36(3):60–80.
- Zou D, Zhang J. Measuring the invisible: clarifying the concept of cognitive effort in translation and interpreting processes. Curr Trends Transl Teach Learn E. 2023;10:217–58.
- Lacruz I, Shreve GM, Angelone E. Average pause ratio as an indicator of cognitive effort in post-editing: a case study. Workshop on Post-Editing Technology and Practice. San Diego: Association for Machine Translation in the Americas; 2012. p. 21–30.
- Qassem M, Al Thowaini BM. Cognitive processes and translation quality: Evidence from keystroke-logging software. J Psycholinguist Res. 2023;52(5):1589–604.
- Ma X, Li D. Effect of word order asymmetry on the cognitive load of English–Chinese sight translation: Evidence from eye movement data. Transl Interpret Stud. 2024;19(1):105–31.
- Leijten M, Van Waes L. Keystroke logging in writing research: using Inputlog to analyze and visualize writing processes. Written Commun. 2013;30(3):358–92.
- Heilmann A, Neumann S, editors. Dynamic pause assessment of keystroke logged data for the detection of complexity in translation and monolingual text production. Proceedings of the Workshop on Computational Linguistics for Linguistic Complexity; 2016; Osaka: COLING.
- Su W, Li D. Identifying translation problems in English-Chinese sight translation: an eye-tracking experiment. Transl Interpret Stud. 2019;14(1):110–34.
- Su W, Li D. Exploring processing patterns of Chinese-English sight translation: an eye-tracking study. Babel. 2020;66(6):999–1024.
- Su W, Li D. Exploring the effect of interpreting training: eye-tracking English-Chinese sight interpreting. Lingua. 2021;256:103094.
- Su W. Eye-voice span in sight interpreting: an eye-tracking investigation. Perspectives. 2023;31(5):969–85.
- Rojo López AM, Muñoz Martín R. Research Methods in Cognitive Translation and Interpreting Studies. Amsterdam: John Benjamins; 2025.
- Shreve GM, Lacruz I, Angelone E. Cognitive effort, syntactic disruption, and visual interference in a sight translation task. Transl Interpret Stud. 2010;5(1):63–84.
Перепечатки и разрешения
Теги
Эта статья была опубликована
Видео скоро будет доступно