В данной статье представлен воспроизводимый биоинформатический рабочий процесс, объединяющий общедоступные транскриптомные наборы данных, машинное обучение, внешнюю валидацию, количественную обратную транскрипцию с ПЦР, скрининг с использованием Connectivity Map и молекулярный докинг для идентификации биомаркеров легочной гипертензии и потенциальных терапевтических соединений.
Исследовательская статья
Идентификация биомаркеров и потенциальных терапевтических соединений при легочной гипертензии с помощью биоинформатики и машинного обучения
В этой статье
Краткое содержание
Аннотация
Данное исследование было направлено на поиск молекулярных биомаркеров, связанных с легочной гипертензией (ЛГ), и потенциальных низкомолекулярных соединений с использованием общедоступных транскриптомных данных и независимых ресурсов для валидации. Три набора данных Gene Expression Omnibus (GSE22356, GSE33463 и GSE48149) были интегрированы после нормализации, аннотации зондов и коррекции пакетного эффекта с помощью ComBat. Для выявления основных генных признаков использовались анализ дифференциальной экспрессии, взвешенный анализ сетей коэкспрессии генов, анализ функционального обогащения, анализ сети белок-белковых взаимодействий и три алгоритма машинного обучения. Диагностическая эффективность оценивалась с помощью кривых рабочих характеристик приемника (ROC-кривых). Внешняя валидация включала независимую когорту образцов легочной ткани (GSE117261), набор данных секвенирования РНК отдельных клеток легочной артерии (GSE210248) и количественную обратную транскрипционную ПЦР в независимых образцах легочной ткани. Для скрининга соединений-кандидатов использовались репозиционирование лекарственных средств на основе Connectivity Map и молекулярный докинг. Было выявлено 78 дифференциально экспрессируемых генов, из которых CXCL10, JUN, IFIH1, MX1 и TLR7 были выбраны в качестве основных генных признаков. В независимой когорте легочной ткани GSE117261 ген JUN продемонстрировал наиболее сильное внешнее подтверждение, в то время как репликация других генов была вариабельной. Количественная обратная транскрипционная ПЦР в 20 биологически независимых образцах при легочной артериальной гипертензии и 20 контрольных образцах подтвердила повышенную экспрессию всех пяти генов. Модель qRT-PCR на основе пяти генов и 100 повторных стратифицированных пятикратных перекрестных проверок дали площадь под кривой (AUC) 1,000, хотя малый размер когорты требует осторожной интерпретации и независимой проспективной валидации. Анализ отдельных клеток GSE210248 подтвердил изменение взаимодействия между иммунными и структурными клетками, а также фенотипическое переключение гладкомышечных клеток. В скрининге Connectivity Map соединение BRD-K91900765/VX-745 заняло первое место. Белок MAPK14/p38α, являющийся его установленной фармакологической мишенью, был включен в качестве положительного эталонного белка для докинга, в то время как докинг с пятью белками, связанными с биомаркерами, рассматривался как исследовательский. Эти результаты позволяют рассматривать данные пять генов как потенциальные биомаркеры ЛГ, а VX-745 — как гипотезу вычислительного репозиционирования лекарств, требующую экспериментальной проверки.
Введение
Легочная гипертензия (ЛГ) представляет собой прогрессирующий сердечно-легочный синдром, характеризующийся стойким повышением давления в легочной артерии, увеличением легочного сосудистого сопротивления и последующей правожелудочковой недостаточностью. Согласно современным гемодинамическим критериям, ЛГ определяется как среднее давление в легочной артерии в состоянии покоя >20 mmHg, измеренное с помощью катетеризации правых отделов сердца1. Среди различных клинических подтипов легочная артериальная гипертензия (ЛАГ) является одной из наиболее тяжелых форм и характеризуется прогрессирующим ремоделированием легочных сосудов. Ее патологические особенности включают эндотелиальную дисфункцию, аномальную пролиферацию и миграцию гладкомышечных клеток легочных артерий, активацию фибробластов адвентиции, отложение внеклеточного матрикса, инфильтрацию воспалительными клетками, а также сужение или облитерацию дистальных легочных артерий2. Эти изменения указывают на то, что ЛГ/ЛАГ является не только нарушением вазоконстрикции, но и комплексным заболеванием с ремоделированием сосудов, обусловленным скоординированными молекулярными, клеточными и иммуновоспалительными механизмами.
Современные методы терапии ЛАГ в основном направлены на пути простациклина, эндотелина, оксида азота — растворимой гуанилатциклазы и фосфодиэстеразы 5-го типа3˒4. Хотя эти методы лечения улучшают симптоматику, переносимость физических нагрузок и гемодинамические показатели, их эффект остается преимущественно вазодилатирующим и гемодинамическим. Их способность обращать вспять уже сформированное ремоделирование легочных сосудов ограничена, и многие пациенты продолжают испытывать прогрессирование заболевания, несмотря на комбинированную терапию. Следовательно, выявление новых молекулярных биомаркеров и терапевтических кандидатов, отражающих процесс ремоделирования, представляет собой важную нерешенную задачу. В частности, иммунно-воспалительная активация, интерферон-зависимая сигнализация, пути Toll-подобных рецепторов, опосредованное хемокинами привлечение иммунных клеток и фенотипическое переключение гладких мышечных клеток были признаны потенциальными факторами прогрессирования ЛГ/ЛАГ5˒6.
Высокопроизводительные транскриптомные наборы данных предоставляют ценные ресурсы для идентификации молекулярных сигнатур, связанных с заболеваниями при ЛГ/ЛАГ. Однако исследования, основанные на одном наборе данных, часто ограничены малым размером выборки, эффектами пакетирования, гетерогенностью платформ и недостаточной валидацией. Анализ дифференциальной экспрессии позволяет выявить гены с измененной экспрессией, но может не полностью охватить связанные с заболеванием коэкспрессионные модули или взаимодействия на уровне сетей. Взвешенный анализ сетей коэкспрессии генов (WGCNA) позволяет идентифицировать генные модули, ассоциированные с признаками заболевания, в то время как анализ сетей белок-белковых взаимодействий (PPI) может выявить высокосвязанные гены внутри биологических сетей. Методы машинного обучения также могут помочь в приоритезации генов, имеющих диагностическую ценность или ценность для классификации. Тем не менее, опора на один алгоритм может привести к возникновению специфического для данной модели смещения. Таким образом, интеграция анализа дифференциальной экспрессии, WGCNA, анализа сетей PPI и нескольких алгоритмов машинного обучения может повысить надежность поиска биомаркеров.
Еще одной серьезной проблемой в исследованиях транскриптомных биомаркеров является биологическая интерпретация. Сигналы, полученные из общей ткани (bulk-tissue), могут отражать изменения экспрессии генов в резидентных сосудистых клетках, инфильтрацию иммунных клеток или изменение пропорций нескольких популяций клеток. Секвенирование РНК отдельных клеток предоставляет возможность поместить гены-кандидаты, выявленные при общем анализе, в клеточный контекст. При ЛГ/ЛСА ремоделирование легочных сосудов затрагивает эндотелиальные клетки, гладкомышечные клетки, фибробласты, моноциты/макрофаги, лимфоциты и другие иммунные или структурные клетки. Прогрессирование заболевания также связано с нарушением межклеточного взаимодействия и фенотипическим переключением гладкомышечных клеток. Таким образом, сочетание общего транскриптомного скрининга с валидацией на уровне отдельных клеток может помочь определить, связаны ли биомаркеры-кандидаты с иммунной активацией, структурным ремоделированием сосудов или дисбалансом в многоклеточном взаимодействии.
Помимо поиска биомаркеров, транскриптомные сигнатуры могут быть использованы для компьютерного перепрофилирования лекарственных средств. Карта связей (Connectivity Map, CMap) связывает профили экспрессии генов, ассоциированные с заболеванием, с малыми молекулами, которые могут обратить вспять или модулировать эти сигнатуры7. В сочетании с курированием соединений и молекулярным докингом эта стратегия позволяет формулировать терапевтические гипотезы, которые можно проверить экспериментально. Хотя прогнозы CMap и молекулярный докинг не позволяют установить эффективность препарата, они помогают приоритизировать соединения-кандидаты для последующих анализов связывания с мишенью, экспериментов на клеточных культурах и валидации на моделях животных.
Был разработан интегрированный и воспроизводимый рабочий процесс для идентификации биомаркеров PH/PAH и потенциальных терапевтических соединений. Три общедоступных транскриптомных набора данных Gene Expression Omnibus были интегрированы после нормализации и коррекции пакетного эффекта. Для отбора устойчивых генов-признаков использовались анализ дифференциальной экспрессии, WGCNA, анализ функционального обогащения, анализ сети PPI и три алгоритма машинного обучения. Для дальнейшей оценки выбранных генов применялись анализ рабочих характеристик приемника (ROC-анализ), независимая когорта валидации тканей легких, данные секвенирования РНК отдельных клеток легочной артерии и количественная обратная транскрипционная ПЦР-валидация на независимых образцах. Наконец, для поиска потенциальных соединений были применены перепрофилирование лекарственных средств на основе CMap и молекулярный докинг. Новизна исследования заключается в многоуровневой структуре валидации, которая объединяет поиск на основе общего транскриптома, приоритизацию с помощью машинного обучения, независимую валидацию, экспериментальное подтверждение методом количественной обратной транскрипционной ПЦР, механистическую интерпретацию на уровне отдельных клеток и компьютерный скрининг соединений. Гипотеза исследования заключалась в том, что в основе PH/PAH лежит скоординированная программа иммунно-воспалительного ответа и сосудистого ремоделирования, и что устойчивые гены в рамках этой программы могут служить потенциальными биомаркерами и открывать возможности для перепрофилирования лекарственных средств.
Протокол
Общедоступные наборы данных Gene Expression Omnibus (GEO), проанализированные в данном исследовании, содержали деидентифицированные транскриптомные данные из ранее опубликованных работ и не требовали дополнительного этического одобрения. Комитет по этике Университета Хуайхуа одобрил независимое валидационное исследование количественной обратной транскрипции с последующей ПЦР (qRT-PCR) на образцах тканей легких человека (номер одобрения 2024(A05112)). До сбора образцов от всех участников или их законных представителей было получено письменное информированное согласие. Процедуры одобрения и получения согласия распространялись на все 20 образцов тканей легких с легочной артериальной гипертензией (ЛАГ) и 20 контрольных образцов тканей легких, включенных в валидацию методом qRT-PCR. Инструменты исследования, использованные в данном протоколе, перечислены в Таблице материалов.
1. Сбор и предварительная обработка общедоступных транскриптомных наборов данных
Наборы данных микрочипов GSE22356, GSE33463 и GSE48149, связанные с легочной гипертензией (ЛГ), были получены из базы данных GEO. Образцы с ЛГ/легочной артериальной гипертензией (ЛАГ) и контрольные образцы были извлечены в соответствии с исходными фенотипическими аннотациями. Матрицы экспрессии и файлы аннотаций платформ были загружены с помощью воспроизводимых R-скриптов и пакета GEOquery.
Аннотация зондов и сопоставление с символами генов проводились единообразно для всех наборов данных. В случаях, когда несколько зондов соответствовали одному гену, рассчитывалось среднее значение экспрессии. Была применена квантильная нормализация, а гены с низким уровнем экспрессии или малой вариабельностью были удалены. Наборы данных были объединены, а пакетные эффекты скорректированы с помощью алгоритма ComBat из пакета sva8. Оценка коррекции проводилась с использованием диаграмм размаха («boxplots») и анализа главных компонентов.
2. Идентификация дифференциально экспрессируемых генов
Для сравнения уровней экспрессии между образцами PH и контрольными образцами в матрице экспрессии с поправкой на батч-эффект использовали пакет limma9. Была построена линейная модель и применены методы эмпирического Байесовского анализа. Дифференциально экспрессируемыми генами считались гены с скорректированным значением P <0,05 и абсолютным значением log2 fold change > 0,585. Результаты были визуализированы с помощью графиков «вулкан» (volcano plots) и тепловых карт.
3. Построение взвешенной сети коэкспрессии генов
С использованием пакета WGCNA10 была построена взвешенная сеть коэкспрессии генов. Для выявления выбросов был проведен кластеринг образцов. Параметр мягкого порога (soft-thresholding power) выбирался на основе индекса соответствия безмасштабной топологии. Модули генов были идентифицированы с помощью алгоритма динамического отсечения дерева. Собственные гены модулей коррелировали с фенотипом PH, и был выбран модуль, связанный с заболеванием, который продемонстрировал наиболее сильную корреляцию. Гены в ключевом модуле были пересечены с дифференциально экспрессируемыми генами для получения консенсусных генов.
4. Анализ функционального обогащения
Категории биологических процессов, клеточных компонентов и молекулярных функций Gene Ontology были проанализированы с помощью clusterProfiler11. Для идентификации сигнальных путей был проведен анализ обогащения путей Kyoto Encyclopedia of Genes and Genomes12. В качестве порогов обогащения использовались значения P < 0.05 и q < 0.2, а обогащенные термины были визуализированы с помощью пузырьковых диаграмм11.
5. Построение сети белок-белковых взаимодействий и идентификация хаб-генов
Согласованный список генов был загружен в базу данных STRING с выбором вида Homo sapiens и порогом достоверности взаимодействия > 0.413. Файл взаимодействий был импортирован в Cytoscape, после чего с помощью плагина CytoHubba была проведена ранжировка генов по степени узла. Гены с высокой степенью связности были определены как хабовые гены.
6. Отбор диагностических genes-признаков с использованием машинного обучения
Были применены три независимых алгоритма отбора признаков. Во-первых, была выполнена логистическая регрессия с использованием метода наименьшего абсолютного сжатия и отбора (LASSO) с помощью пакета glmnet и 10-кратной перекрестной проверки для выявления генов с ненулевыми коэффициентами14. Во-вторых, был применен метод рекурсивного исключения признаков с использованием метода опорных векторов для удаления избыточных признаков и выбора подмножества признаков, обеспечивающего максимальную точность перекрестной проверки15. В-третьих, была построена модель случайного леса, и признаки были ранжированы по среднему снижению индекса примеси Джини16. Пересечение наборов генов, полученных с помощью трех алгоритмов, было использовано для определения окончательного набора основных генов-признаков. Пакет pROC использовался для построения рабочих характеристик приемника (ROC-кривых) и расчета значений площади под кривой (AUC)17.
7. Валидация ключевых генов с использованием независимых наборов данных объемного и одноклеточного секвенирования
GSE117261 использовался в качестве независимой внешней валидационной когорты образцов легочной ткани, содержащей 58 образцов при ЛА и 25 контрольных образцов от доноров, не прошедших отбор18. Этот набор данных не использовался при анализе дифференциальной экспрессии для поиска генов, построении взвешенной сети коэкспрессии генов или отборе признаков с помощью машинного обучения. Матрица экспрессии была нормализована и аннотирована, а анализ дифференциальной экспрессии проводился с использованием limma v3.68.0. По всему аннотированному транскриптому была применена коррекция ложноположительных результатов по методу Бенджамини-Хохберга. ROC-кривые (рабочие характеристики приемника) для отдельных генов рассчитывались с использованием pROC v1.19.0.1, 95% доверительных интервалов по методу Делонга и пороговых значений индекса Юдена. В рамках GSE117261 была построена исследовательская модель логистической регрессии на основе пяти генов, и ее внутренняя эффективность была дополнительно оценена с помощью повторной вложенной перекрестной проверки.
GSE210248 (Таблица 1) использовался в качестве валидационного набора данных одноклеточного секвенирования легочной артерии, содержащего образцы от трех пациентов с ЛАГ и трех здоровых доноров19. Обработка данных осуществлялась с помощью Seurat v5.5.1 для контроля качества, нормализации, снижения размерности, кластеризации и аннотации клеток20. Были идентифицированы основные популяции клеток, включая эндотелиальные клетки, гладкомышечные клетки, фибробласты, моноциты/макрофаги, а также Т-клетки и натуральные киллеры. Анализ межклеточного взаимодействия проводился с использованием CellChat v2.1.2 и базы данных лигандов и рецепторов CellChatDB.human21. Объект CellChat был создан на основе нормализованной матрицы экспрессии Seurat и метаданных о типах клеток. Были определены сверхэкспрессируемые гены и взаимодействия лиганд-рецептор; рассчитаны вероятности взаимодействия; удалены взаимодействия с участием групп клеток, содержащих менее 10 клеток; а также выведены и агрегированы сети взаимодействия на уровне сигнальных путей. Данный набор данных использовался только для внешней механистической валидации и не применялся для обучения модели.
| Элемент | Описание |
| Набор данных | GSE210248 |
| Тип данных | Секвенирование РНК единичных клеток на основе капель 10x Genomics; высокопроизводильное транскриптомное профилирование |
| Образцы человеческого происхождения | Три образца легочной артерии пациентов с ЛАГ и три образца легочной артерии здоровых доноров |
| Источник ткани | Ткань легочной артерии ex vivo, преимущественно отражающая клеточную экологию стенки легочных сосудов и процесс сосудистого ремоделирования |
| Основная аналитическая цель | Локализация по типам клеток, фенотипическое переключение гладкомышечных клеток, взаимодействие между иммунными и структурными клетками и валидация механистической согласованности генов-кандидатов |
Таблица 1: Основная информация о наборе данных для одноклеточной валидации GSE210248. В таблице представлены номер доступа к набору данных, платформа секвенирования, источник ткани, состав образцов и цель анализа при валидации одноклеточного анализа легочной артерии.
8. Валидация экспрессии генов с помощью qRT-PCR
Валидация методом qRT-PCR включала 20 биологически независимых образцов ткани легких при ПАГ от пациентов с ЛГ/ПАГ и 20 биологически независимых контрольных образцов ткани легких. Экстракцию общей РНК проводили с использованием Total RNA Extraction Kit. Концентрацию и чистоту РНК оценивали с помощью спектрофотометра, а целостность РНК — методом электрофореза в агарозном геле. В анализ включали только образцы РНК со значениями A260/280 от 1,8 до 2,1 и отсутствием видимой деградации.
Равные количества РНК были подвергнуты обратной транскрипции в комплементарную ДНК с использованием набора Solarbio Universal RT-PCR Kit (AMV; кат. № RP1200). Количественная ПЦР для CXCL10, JUN, IFIH1, MX1 и TLR7 проводилась с использованием SYBR Green PCR Master Mix на системе ПЦР в реальном времени. Каждый биологический образец анализировали в трех технических повторностях вместе с контролями без матрицы и без обратной транскрипции. Среднее значение Ct трех технических повторностей использовали для последующего анализа; технические повторности не рассматривались как независимые наблюдения. Использовали праймеры, перекрывающие экзон-экзонные стыки и дающие ампликоны размером 80–200 bp (Таблица 2). Специфичность праймеров проверяли с помощью NCBI Primer-BLAST и анализа кривых плавления22.
β-actin (ACTB) использовался в качестве внутреннего референсного гена для нормализации уровней экспрессии целевых генов. Относительная экспрессия рассчитывалась с использованием метода 2-ΔΔCt23. Для межгрупповых сравнений, исходя из распределения данных, применялись двухсторонние U-критерии Манна-Уитни, а для пяти генов была проведена коррекция ложноположительных результатов по методу Бенджамини-Хохберга. ROC-кривые для отдельных генов были построены с 95% доверительными интервалами по методу ДеЛонга, а оптимальные пороговые значения выбирались с помощью индекса Юдена. Модель логистической регрессии для пяти генов изначально подбиралась и оценивалась на тех же 40 биологических образцах; эта оценка была определена как кажущаяся эффективность внутри выборки. Для оценки возможного переобучения было выполнено 100 повторений стратифицированной пятикратной перекрестной проверки с использованием модели логистической регрессии с L2-регуляризацией, после чего была рассчитана совокупная эффективность ROC вне выборки.
| Ген | номер доступа RefSeq | Прямой праймер (5′–3′) | Обратный праймер (5′–3′) | Размер продукта (п. н.) | Tm (°C) | перекрывающие экзоны |
| CXCL10 | NM_001565.4 | GTCAAGCCAT AATTGTTC | ATAGTGCCAG GGTAGAGT | 141 | 46.1 | Да |
| JUN | NM_002228.4 | ACAAGTGGCA GAGTCCCG | CGCCCAAGTT CAACAACC | 152 | 54.5 | Да |
| IFIH1 | NM_022168 | GCACAGAGCG GTAGACCCT | GCCCTGAAGC ACGAGATG | 182 | 54.7 | Да |
| MX1 | NM_002462.5 | TTAGCCGTGG TGATTTAGC | CAAGGTGGAG CGATTCTG | 156 | 52.3 | Да |
| TLR7 | NM_016562.4 | ATTGCCCTCGT TGTTATA | TTCCTGGAGTT TGTTGAT | 179 | 48.1 | Да |
| ACTB | NM_001101.3 | CTCACCATGGAT GATGATATCGC | AGGAATCCTTCT GACCCATGC | 194 | 56.2 | Да |
Таблица 2: Последовательности праймеров, использованных для количественной обратной транскрипции и ПЦР. В таблице приведены целевые гены, номера доступа RefSeq, последовательности прямых и обратных праймеров, размеры продуктов, температуры плавления и статус охвата экзонов для праймеров, использованных в qRT-PCR.
9. Скрининг соединений-кандидатов и молекулярный докинг
Сигнатуры основных генов с повышенной и пониженной экспрессией были загружены в базу данных Connectivity Map для поиска малых молекул, которые, согласно прогнозам, могут обратить экспрессионный профиль, связанный с ЛС7. Кандидаты были ранжированы по показателю Logit и вероятности прогноза.
Трехмерная структура BRD-K91900765/VX-745 была получена из базы данных PubChem под идентификатором CID 303852524. Фармакологическая информация о соединении была собрана из открытых баз данных лекарственных средств, а структурные дескрипторы были рассчитаны с помощью DrugBank и SwissADME25,26. Структуры белков были получены из RCSB Protein Data Bank с использованием следующих PDB-идентификаторов: CXCL10, 1LV9; JUN, 1JUN; IFIH1, 3B6E; MX1, 5GTM; TLR7, 7CYN; и MAPK14/p38α, 1OUK27. Поиск слепых полостей и молекулярный докинг проводились с использованием CB-Dock2 v2.0 с оценочным движком AutoDock Vina v1.2.028,29. Файлы белков и лигандов были загружены в CB-Dock2, кандидатные полости определялись автоматически, и докинг выполнялся в рамках специфических для каждой полости боксов, созданных сервером. Для каждого белка регистрировались идентификатор полости, оценка Vina (Vina score), объем полости, центр бокса докинга, размеры бокса докинга и файл комплекса белок-лиганд. Поза с наиболее отрицательным значением Vina score была выбрана в качестве наиболее приоритетной предсказанной конформации. MAPK14/p38α был включен как установленная фармакологическая мишень и положительный контрольный белок для докинга VX-745. Докинг в отношении CXCL10, JUN, IFIH1, MX1 и TLR7 носил исследовательский характер и не интерпретировался как доказательство прямого фармакологического воздействия, связывания, ингибирования или эффективности.
10. Статистический анализ и контроль воспроизводимости
Все статистические анализы проводились в R, если не указано иное. Двусторонние значения P < 0.05 считались статистически значимыми. Поправка на множественное тестирование применялась к анализам дифференциальной экспрессии, обогащения, внешней валидации и qRT-PCR, как указано выше. Для оценки стабильности моделей машинного обучения и комбинированных моделей qRT-PCR использовалась кросс-валидация.
Результаты
Предварительная обработка общедоступных транскриптомных данных и идентификация дифференциально экспрессируемых генов
Интеграция и коррекция методом ComBat наборов данных GSE22356, GSE33463 и GSE48149 позволили уменьшить систематические различия между ними. Диаграммы размаха (boxplots) показали, что распределения экспрессии образцов стали более согласованными после коррекции. Анализ главных компонент показал, что до коррекции образцы кластеризовались в основном в соответствии с источником набора данных, однако после коррекции они стали более перемешанными, что свидетельствует об эффективном снижении эффекта батча (Рисунок 1).
С использованием пороговых значений абсолютного логарифмического изменения (log2 fold change) >0,585 и скорректированного значения P < 0,05 было выявлено 78 дифференциально экспрессируемых генов, из которых 44 гена имели повышенную экспрессию, а 34 — пониженную (Рисунок 2A). Тепловая карта показала, что гены, связанные с интерфероном, включая XAF1, MX1, IFI44L, EPSTI1, PARP9, IFIH1, CXCL10, GBP1, STAT1, SAMHD1, TNFSF10 и TLR7, в целом имели повышенную экспрессию в образцах, связанных с ЛС. Напротив, гены, связанные с эритроидным ростка, включая HBG1, HBD, ALAS2, CA1 и SLC4A1, имели тенденцию к пониженной экспрессии (Рисунок 2B).
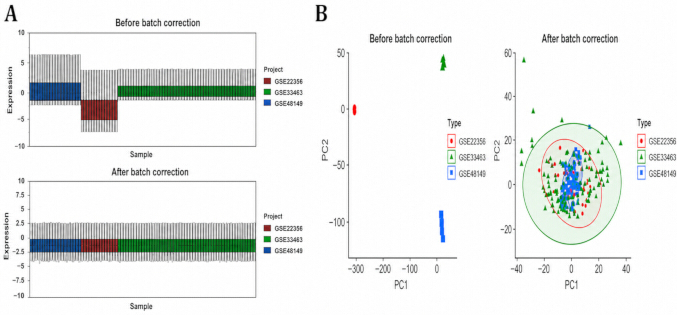
Рисунок 1: Коррекция пакетного эффекта. (A) Диаграммы размаха объединенной матрицы экспрессии до и после коррекции с помощью ComBat. (B) Графики анализа главных компонентов, демонстрирующие распределение образцов до и после коррекции пакетного эффекта. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
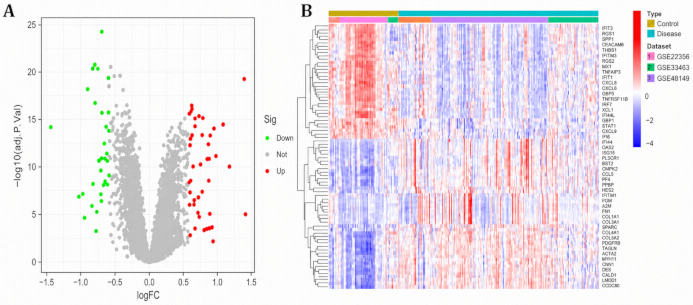
Рисунок 2: Дифференциально экспрессируемые гены. (A) График вулкан, демонстрирующий гены с повышенной и пониженной экспрессией в образцах, связанных с PH. (B) Теплокарта, демонстрирующая дифференциально экспрессируемые гены в контрольной группе и группе с заболеванием. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Построение взвешенной сети коэкспрессии генов и функциональный анализ обогащения
Кластеризация образцов продемонстрировала стабильную общую группировку без явных выбросов (Рисунок 3A). Индекс соответствия безмасштабной топологии приблизился к 0,8 при степени 9, и для построения сети было выбрано значение β = 9 (Рисунок 3B). Кластеризация генов и идентификация динамических модулей позволили выделить несколько модулей коэкспрессии (Рисунок 3C). Синий модуль показал наиболее сильную связь со статусом PH (r = 0,55, P = 1 × 10⁻¹⁹), в то время как бирюзовый и серый модули также проявили корреляцию с PH (Рисунок 3D).
Консенсусные гены, полученные путем пересечения генов ключевого модуля анализа взвешенных сетей коэкспрессии генов с дифференциально экспрессируемыми генами, были обогащены по путям противовирусной иммунной защиты, регуляции NF-κB и JAK-STAT, ответов на воспалительные факторы, связывания рецепторов цитокинов и хемокинов, а также транскрипционной регуляции (Рисунок 4A). Анализ обогащения по базе данных Kyoto Encyclopedia of Genes and Genomes выявил взаимодействие цитокин-цитокиновый рецептор, хемокиновый сигналинг, сигналинг NOD-подобных рецепторов, сигналинг Toll-подобных рецепторов, сигналинг фактора некроза опухоли и сигналинг интерлейкина-17 (Рисунок 4B), что подтверждает роль иммуновоспалительной дисрегуляции как молекулярной основы ремоделирования легочных сосудов.
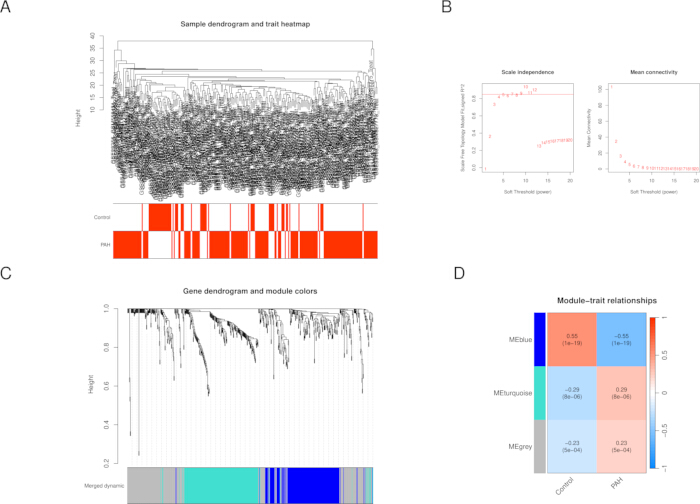
Рисунок 3: Взвешенный анализ сетей коэкспрессии генов. (A) Дерево кластеризации образцов и тепловая карта признаков. (B) График выбора мягкого порога. (C) Дендрограмма генов и цвета модулей. (D) Тепловая карта взаимосвязи между модулями и признаками. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
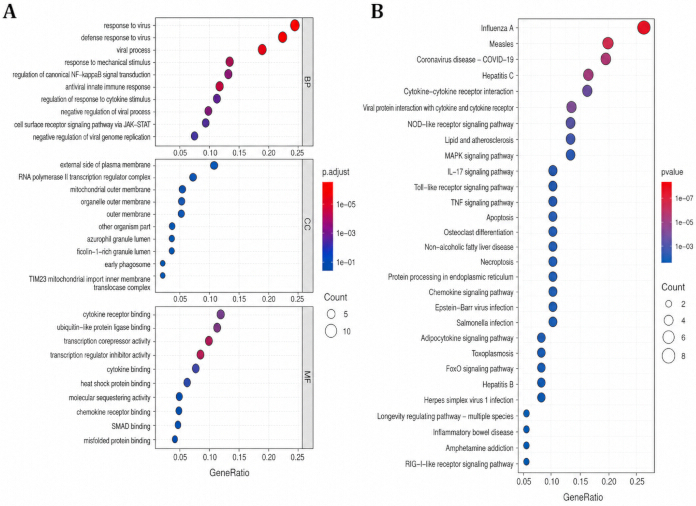
Рисунок 4: Анализ функционального обогащения. (A) Результаты обогащения Gene Ontology для консенсусных генов. (B) Результаты обогащения путей KEGG (Kyoto Encyclopedia of Genes and Genomes) для консенсусных генов. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Сеть белок-белковых взаимодействий и скрининг хаб-генов
Сеть белок-белковых взаимодействий STRING, построенная на основе консенсусных генов, выявила взаимосвязанную иммуновоспалительную сеть (Рисунок 5A). Ранжирование CytoHubba на основе степени связности показало, что FN1, CD44, JUN, TGFB1, CXCL8 и BCL2 обладают высокой степенью связности (Рисунок 5B). Эти хаб-гены могут участвовать в воспалительной сигнализации, клеточной адгезии, ремоделировании внеклеточного матрикса и структурном ремоделировании легочных сосудов.
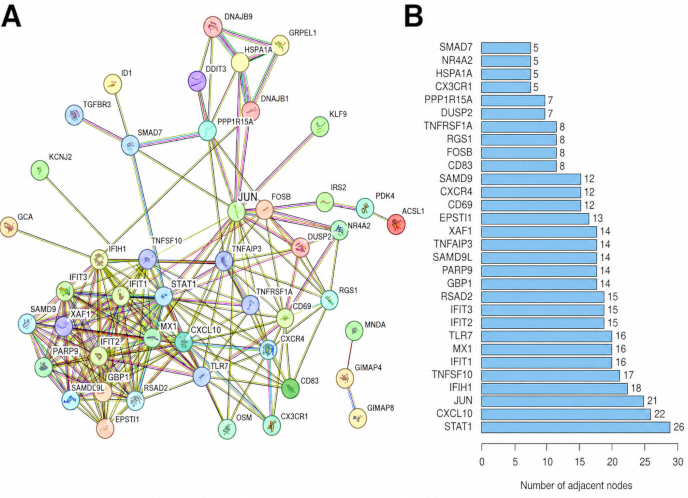
Рисунок 5: Сеть белок-белковых взаимодействий и хаб-гены. (A) Сеть белок-белковых взаимодействий консенсусных генов, построенная с помощью STRING. (B) Хаб-гены, ранжированные по степени связности и идентифицированные с помощью CytoHubba. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Отбор признаков с помощью машинного обучения и диагностическая эффективность
Метод регрессии LASSO (least absolute shrinkage and selection operator) позволил выявить шесть генов-кандидатов с ненулевыми коэффициентами после кросс-валидации (Рисунок 6A, B). Метод рекурсивного исключения признаков на основе опорных векторов (SVM-RFE) оставил восемь генов, при этом точность кросс-валидации составила 0,883, а ошибка — 0,117 (Рисунок 7A). Ошибка «вне выборки» (out-of-bag error) метода случайного леса стабилизировалась при количестве деревьев ≥100, при этом гены IFIH1, JUN и TLR7 вошли в число наиболее значимых согласно показателю важности (Рисунок 7B).
Пересечение результатов методов LASSO (least absolute shrinkage and selection operator), SVM-RFE (support vector machine-recursive feature elimination) и случайного леса позволило выявить пять основных генов: CXCL10, JUN, IFIH1, MX1 и TLR7 (Рисунок 8A). Анализ рабочих характеристик приемника (ROC-анализ) для отдельных генов показал умеренную или хорошую диагностическую разделительную способность со значениями площади под кривой (AUC), равными 0,842 для IFIH1, 0,833 для JUN, 0,827 для TLR7, 0,814 для CXCL10 и 0,759 для MX1 (Рисунок 8B).
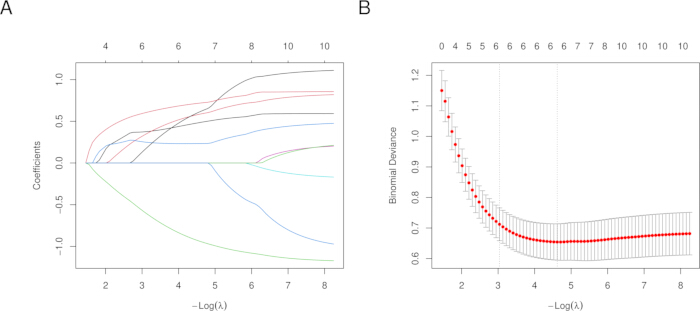
Рисунок 6: Регрессионный анализ с использованием метода наименьшего абсолютного сжатия и отбора (LASSO). (A) Траектория коэффициентов, полученная с помощью LASSO-регрессии. (B) График ошибки перекрестной проверки. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
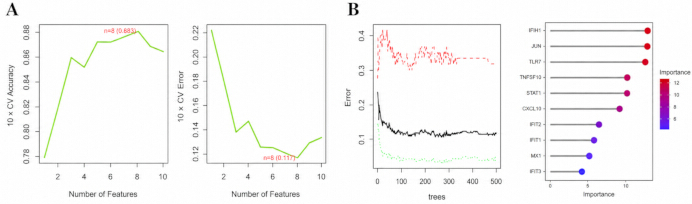
Рисунок 7: Анализ методом рекурсивного исключения признаков на основе метода опорных векторов и анализ случайного леса. (A) График отбора признаков методом рекурсивного исключения признаков на основе метода опорных векторов. (B>) Модель случайного леса и ранжирование генов по степени значимости. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
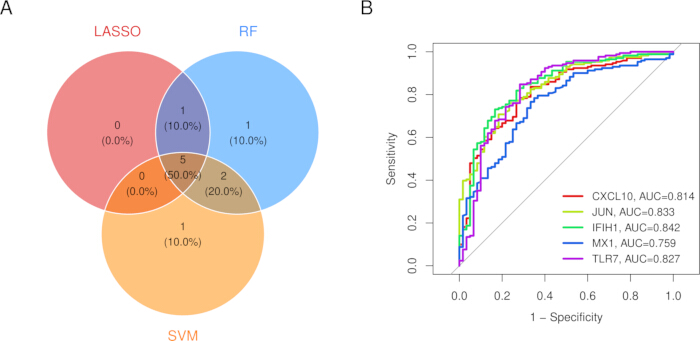
Рисунок 8: Резюме по машинному обучению. (A) Диаграмма Венна, показывающая пересечение трех алгоритмов отбора признаков. (B) ROC-кривые (рабочие характеристики приемника) для пяти основных генов. Пожалуйста, нажмите здесь, чтобы просмотреть этот рисунок в большем размере.
Внешняя валидация в GSE117261
Набор данных GSE117261 использовался в качестве независимой когорты для валидации по ткани легких и не включался в скрининг дифференциальной экспрессии, построение взвешенной сети коэкспрессии генов или отбор признаков с помощью машинного обучения (Таблица 3). Полученные результаты валидации продемонстрировали гетерогенную репликацию по пяти генам (Таблица 4). Уровень CXCL10 был повышен (log₂ fold change = 0.677; P = 0.0410; FDR = 0.144), при этом AUC составила 0.639 (95% CI, 0.491–0.786) с пороговым значением 6.245, чувствительностью 0.724 и специфичностью 0.600. Уровень JUN был повышен (log₂ fold change = 0.463; P = 0.00248; FDR = 0.0194), при этом AUC составила 0.714 (95% CI, 0.593–0.835) с пороговым значением 8.708, чувствительностью 0.707 и специфичностью 0.720.
IFIH1 (log2 fold change = 0.107; P = 0.371; FDR = 0.591; AUC = 0.543, 95% CI, 0.398–0.687), MX1 (log2 fold change = 0.109; P = 0.488; FDR = 0.690; AUC = 0.475, 95% CI, 0.337–0.614) и TLR7 (log2 fold change = -0.050; P = 0.543; FDR = 0.733; AUC = 0.546, 95% CI, 0.414–0.679) не соответствовали заранее установленным критериям внешней поддержки. TLR7 также продемонстрировал направление, противоположное результату qRT-PCR. Исследовательская модель из пяти генов, подобранная и оцененная в рамках GSE117261, дала видимое значение AUC 0.740, в то время как повторная вложенная перекрестная проверка дала AUC 0.656. Таким образом, JUN получил наиболее сильную независимую поддержку, CXCL10 показал ограниченные и согласованные по направлению данные, а репликация IFIH1, MX1 и TLR7 была слабой или противоречивой.
| Объект | Описание |
| Номер доступа к набору данных | GSE117261 |
| Источник данных | Gene Expression Omnibus (GEO) |
| Тип образца | Данные транскриптомного микрочипа ткани легкого человека |
| Размер выборки | 58 образцов ПАУ и 25 контрольных образцов от доноров с несостоявшимся донорством |
| Платформа | GPL6244 / Микрочип Affymetrix Human Gene 1.0 ST Array |
| Цель валидации | Различия в экспрессии, ROC-анализ одного гена и эксплораторное комбинированное ROC-моделирование пяти генов для CXCL10, JUN, IFIH1, MX1 и TLR7 |
| Роль в данном исследовании | Независимый набор данных для внешней валидации; не включен в исходное обучение, WGCNA или анализ отбора признаков |
Таблица 3: Основная информация о независимом внешнем валидационном наборе данных GSE117261. В таблице обобщены источник набора данных, тип образцов, размер выборки, платформа, цели валидации и роль GSE117261 в исследовании.
| Ген/модель | PAH n | Контроль n | log2 кратности изменения | Значение P | FDR | AUC | 95% ДИ AUC | Порог Юдена | Чувствительность | Специфичность |
| CXCL10 | 58 | 25 | 0.677 | 0.041 | 0.144 | 0.639 | 0.491–0.786 | 6.245 | 0.724 | 0.6 |
| JUN | 58 | 25 | 0.463 | 0.00248 | 0.019 | 0.714 | 0.593–0.835 | 8.708 | 0.707 | 0.72 |
| IFIH1 | 58 | 25 | 0.107 | 0.371 | 0.591 | 0.543 | 0.398–0.687 | 5.3 | 0.759 | 0.44 |
| MX1 | 58 | 25 | 0.109 | 0.488 | 0.69 | 0.475 | 0.337–0.614 | 6.833 | 0.724 | 0.4 |
| TLR7 | 58 | 25 | -0.05 | 0.543 | 0.733 | 0.546 | 0.414–0.679 | 4.065 | 0.138 | 1 |
| Модель из пяти генов (видимая/внутривыборочная) | 58 | 25 | / | / | / | 0.74 | 0.621–0.859 | 0.613 | 0.845 | 0.6 |
| Модель из пяти генов (повторяющаяся вложенная перекрестная проверка) | 58 | 25 | / | / | / | 0.656 | 0.517–0.795 | 0.655 | 0.845 | 0.52 |
Таблица 4: Фактическая разница в экспрессии и результаты ROC-валидации для GSE117261. В таблице приведены размеры выборок пациентов с ЛАГ и контрольной группы, значения log₂ fold change, значения P, значения, скорректированные с учетом частоты ложноположительных результатов (FDR), значения AUC, 95% доверительные интервалы, пороги индекса Юдена, чувствительность, специфичность и интерпретация для пяти генов и исследовательских комбинированных моделей.
Валидация количественной ПЦР с обратной транскрипцией
Валидация методом количественной ПЦР с обратной транскрипцией включала 20 биологически независимых образцов легочной ткани при ЛАГ и 20 биологически независимых контрольных образцов; для каждого биологического образца рассчитывалось среднее значение по трем техническим повторностям. Экспрессия CXCL10, JUN, IFIH1, MX1 и TLR7 была значительно повышена при ЛАГ (Таблица 5; Рисунок 9A). Средние значения относительной экспрессии составили приблизительно 3,470 для CXCL10, 2,560 для JUN, 2,760 для IFIH1, 2,650 для MX1 и 2,580 для TLR7. Соответствующие значения P/FDR составили 1,43 × 10⁻7/7,15 × 10⁻7, 4,17 × 10⁻5/4,17 × 10⁻5, 1,10 × 10⁻5/1,38 × 10⁻5, 1,58 × 10⁻6/2,63 × 10⁻6 и 1,37 × 10⁻6/2,63 × 10⁻6 соответственно.
ROC-анализ одиночных генов на основе экспрессии, определенной методом qRT-PCR, показал значения AUC 0,988 для CXCL10 (95% ДИ: 0,961–1,000), 0,880 для JUN (95% ДИ: 0,758–1,000), 0,908 для IFIH1 (95% ДИ: 0,820–0,995), 0,945 для MX1 (95% ДИ: 0,874–1,000) и 0,948 для TLR7 (95% ДИ: 0,886–1,000) (Рисунок 9B; Таблица 5). Модель логистической регрессии по пяти генам достигла кажущегося значения AUC 1,000 (95% ДИ по Делонгу: 1,000–1,000) с чувствительностью и специфичностью 1,000 (Рисунок 9C). Согласованность направления экспрессии между валидацией методом количественной ПЦР с обратной транскрипцией и данными GSE117261 была визуализирована с помощью тепловой карты (Рисунок 9D). Поскольку одни и те же 40 образцов использовались как для подбора, так и для оценки, это отражало кажущуюся эффективность внутри выборки. В 100 повторах стратифицированной пятикратной перекрестной проверки с использованием модели логистической регрессии с L2-регуляризацией объединенное значение AUC вне выборки также осталось равным 1,000 (95% ДИ: 1,000–1,000), и в каждом повторе AUC составляло 1,000. Несмотря на эту внутреннюю стабильность, когорта была небольшой, и независимая проспективная валидация остается необходимой. Сравнение направлений с GSE117261 показало согласованное повышение уровней CXCL10, JUN, IFIH1 и MX1, но несогласованное направление для TLR7 (Рисунок 9D).
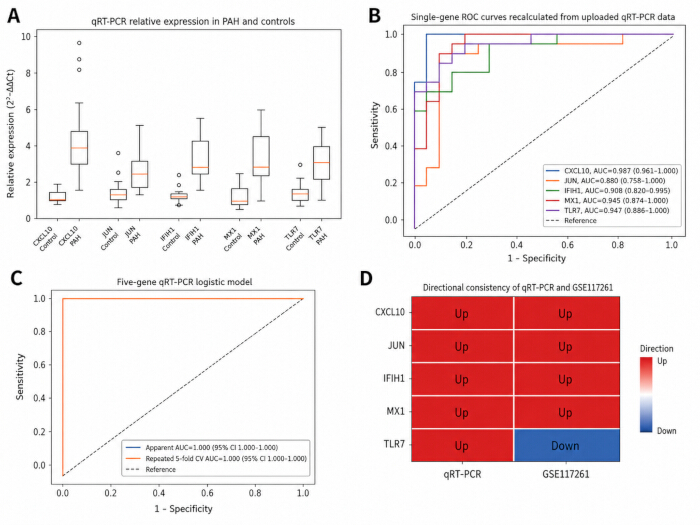
Рисунок 9: Валидация методом количественной ПЦР с обратной транскрипцией. (A) Диаграммы размаха, показывающие относительную экспрессию CXCL10, JUN, IFIH1, MX1 и TLR7 в 20 биологически независимых образцах легочной ткани при ЛАГ и 20 биологически независимых контрольных образцах. Каждый биологический образец измеряли в трех технических повторностях; для анализа использовали среднее значение Ct. На каждой диаграмме центральная линия соответствует медиане, прямоугольник — межквартильному размаху, «усы» простираются на 1,5 межквартильных размаха, а отдельные точки за пределами «усов» представляют собой выбросы. (B) ROC-кривые для отдельных генов на основе значений экспрессии, полученных методом qRT-PCR; указаны AUC и 95% доверительные интервалы по методу Делонга. (C) ROC-кривые для логистической регрессионной модели по пяти генам, демонстрирующие как видимую эффективность на обучающей выборке, так и совокупную эффективность на проверочных выборках (out-of-fold) в результате 100 повторных анализов стратифицированной перекрестной проверки по пяти складываниям. (D) Тепловая карта, показывающая согласованность направления экспрессии между qRT-PCR и GSE117261; экспрессия CXCL10, JUN, IFIH1 и MX1 была согласованно повышена, в то время как экспрессия TLR7 была несогласованной. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
| Ген/модель | PAH n | Контроль n | Контроль 2^-ΔΔCt, среднее ± SD | PAH 2^-ΔΔCt, среднее ± SD | Направление | Значение P | FDR | AUC | 95% ДИ AUC | Порог Юдена | Чувстви- тельность | Специфи- чность | Тип валидации | ||||
| CXCL10 | 20 | 20 | 1.099 ± 0.502 | 3.470 ± 1.043 | Повышена экспрессия | 1.43E-07 | 7.15E-07 | 0.987 | 0.961–1.000 | 2.028 | 1 | 0.95 | Анализ одного гена методом qRT-PCR | ||||
| JUN | 20 | 20 | 1.158 ± 0.738 | 2.560 ± 1.609 | Повышена экспрессия | 4.17E-05 | 4.17E-05 | 0.88 | 0.758–1.000 | 1.423 | 0.85 | 0.9 | Анализ одного гена методом qRT-PCR | ||||
| IFIH1 | 20 | 20 | 1.091 ± 0.440 | 2.760 ± 1.398 | Повышена экспрессия | 1.10E-05 | 1.38E-05 | 0.908 | 0.820–0.995 | 1.579 | 0.8 | 0.85 | Анализ одного гена методом qRT-PCR | ||||
| MX1 | 20 | 20 | 1.132 ± 0.582 | 2.650 ± 1.085 | Повышена экспрессия | 1.58E-06 | 2.63E-06 | 0.945 | 0.874–1.000 | 1.779 | 0.9 | 0.9 | Анализ одного гена методом qRT-PCR | ||||
| TLR7 | 20 | 20 | 1.080 ± 0.444 | 2.580 ± 1.284 | Повышена экспрессия | 1.37E-06 | 2.63E-06 | 0.947 | 0.886–1.000 | 1.764 | 0.85 | 0.9 | Анализ одного гена методом qRT-PCR | ||||
| Модель из пяти генов (кажущаяся/внутривыборочная) | 20 | 20 | Не примени- мо | Не примени- мо | Не применимо | / | / | 1 | 1.000–1.000 | 0.998 | 1 | 1 | Те же 40 биологических образцов, использованных для подбора и оценки модели | ||||
| Модель из пяти генов (100-кратная повторная 5-кратная перекрестная проверка) | 20 | 20 | Не примени- мо | Не примени- мо | Не применимо | / | / | 1 | 1.000–1.000 | 0.716 | 1 | 1 | Внутренняя перекрестная проверка с использованием логистической регрессии с L2-регуляризацией | ||||
Таблица 5: Полные результаты экспрессии методом qRT-PCR и ROC-анализа для CXCL10, JUN, IFIH1, MX1 и TLR7, включая анализы комбинированной модели по пяти генам. В таблице указаны размеры выборок пациентов с ЛАГ и контрольной группы, значения относительной экспрессии, направление экспрессии, значения P, значения с поправкой на ложноположительный результат (FDR), AUC, 95% доверительные интервалы, пороги по индексу Юдена, чувствительность, специфичность и типы валидации для отдельных генов и комбинированных моделей.
Валидация транскриптомики отдельных клеток в GSE210248
Данные GSE210248 обеспечили механистическое обоснование на клеточном уровне, показав, что ремоделирование легочных артерий при ЛАГ сопровождалось изменением взаимодействия между иммунными клетками и структурными клетками сосудов. Это наблюдение согласуется с результатами массового транскриптомного анализа, выявившими обогащение путей воспалительного ответа, хемокинового сигналинга, сигналинга Toll-подобных рецепторов и сигналинга фактора некроза опухоли.
Данные на уровне отдельных клеток свидетельствуют о том, что сигнальная сеть легочной артерии при ЛАГ сместилась в сторону структурных клеток, включая гладкомышечные клетки и фибробласты. Гладкомышечные клетки демонстрировали несколько состояний, включая кислород-чувствительное/перицитоподобное, сократительное, синтетическое и фибробластоподобное. Эти результаты подтверждают модель заболевания, в которой иммунно-воспалительная активация и ремоделирование структурных клеток сосудов совместно стимулируют прогрессирование ЛГ/ЛАГ.
Скрининг соединений-кандидатов и молекулярный докинг
Скрининг с помощью Connectivity Map выявил BRD-K91900765 в качестве самого перспективного соединения-кандидата среди 10 лучших попаданий с показателем Logit 10,13 и прогнозируемой вероятностью 0,085 (Рисунок 10). Курирование соединений показало, что BRD-K91900765 соответствует VX-745/нефламапимоду, селективному ингибитору p38α/MAPK14 с идентификатором соединения в PubChem 3038525 и молекулярной массой 436,27 g/mol (Таблица 6).
Поисковый докинг BRD-K91900765/VX-745 с пятью белками, связанными с биомаркерами, дал следующие наилучшие показатели Vina: -7,5 ккал/моль для CXCL10, -7,6 ккал/моль для JUN, -7,5 ккал/моль для IFIH1, -8,7 ккал/моль для MX1 и -8,1 ккал/моль для TLR7 (Таблицы 7–11; Рисунок 11A–E). Эти результаты указывали лишь на предполагаемую структурную совместимость и не определяли данные пять белков в качестве прямых фармакологических мишеней. Предварительный прогноз абсорбции, распределения, метаболизма, экскреции и токсичности показал, что соединение обладает несколькими лекарственно-подобными свойствами, хотя относительно высокое расчетное значение cLogP требует дальнейшей оценки (Таблица 12). Докинг с установленной мишенью VX-745, MAPK14/p38α (PDB ID: 1OUK), был включен в качестве положительного контрольного анализа. Основная полость MAPK14, C1, показала значение Vina -7,9 ккал/моль, объем полости 3560 Å3, центр бокса докинга (2, 22, 34) и размеры (22, 31, 31) (Таблица 13; Рисунок 11F).
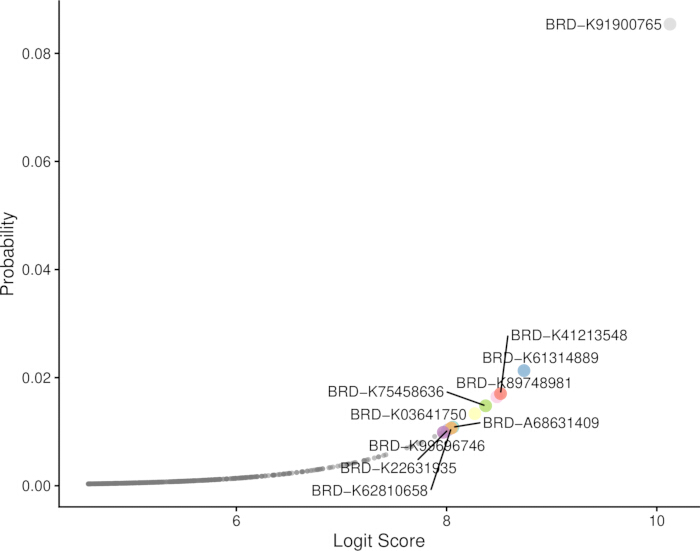
Рисунок 10: Ранжирование соединений-кандидатов Connectivity Map. Ранжирование соединений-кандидатов, выявленных в ходе скрининга с помощью Connectivity Map. Соединение BRD-K91900765 заняло первое место с показателем Logit 10.13 и прогнозируемой вероятностью 0.085. Пожалуйста, нажмите здесь, чтобы просмотреть этот рисунок в большем размере.
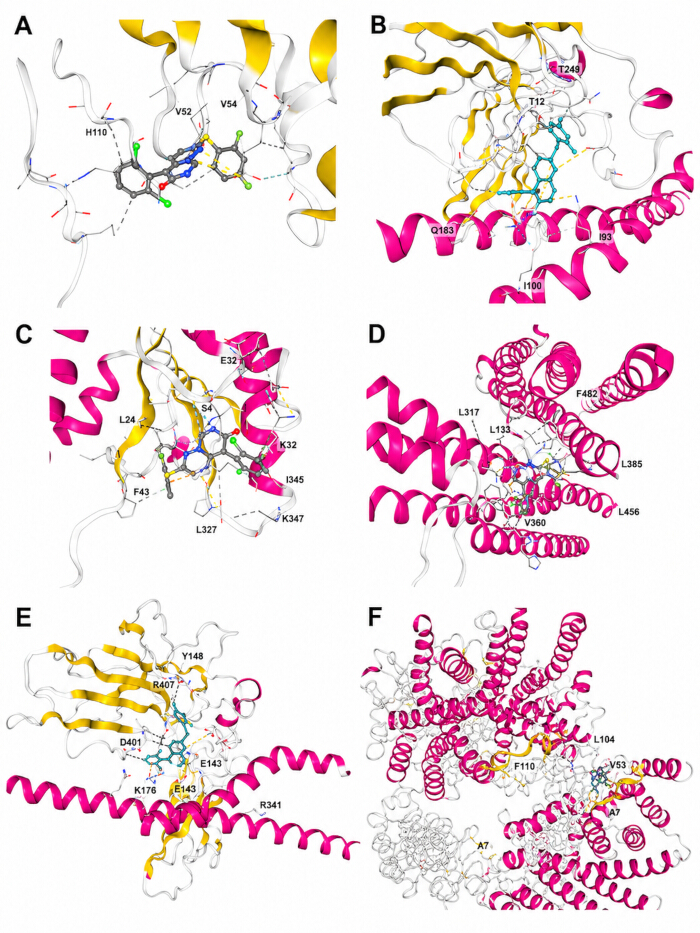
Рисунок 11: Трехмерные диаграммы молекулярного докинга для BRD-K91900765/VX-745. (A) Исследовательский докинг с CXCL10. (B) Исследовательский докинг с JUN. (C) Исследовательский докинг с IFIH1. (D) Исследовательский докинг с MX1. (E) Исследовательский докинг с TLR7. (F) Докинг с положительным контролем по установленной фармакологической мишени MAPK14/p38α (PDB ID: 1OUK). Панели A–E указывают на прогнозируемую структурную совместимость и не устанавливают прямое фармакологическое воздействие. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
| Объект | Описание |
| CMap/Broad ID | BRD-K91900765 (стандартный формат партии: BRD-K91900765-001-xx-x) |
| Общепринятое название/псевдонимы | VX-745; нефламапимод; VRT-031745; VD-31745 |
| Химическое наименование | 5-(2,6-дихлорфенил)-2-(2,4-дифторфенилсульфанил)пиримидо[1,6-b]пиридазин-6-он |
| CID PubChem | 3038525 |
| номер CAS | 209410-46-8 |
| Молекулярная формула / относительная молекулярная масса | C19H9Cl2F2N3OS; 436,27 г/моль |
| Канонические SMILES | C1=CC(=C(C(=C1)Cl)C2=C3C=CC(=NN3C=NC2=O)SC4=C(C=C(C=C4)F)F)Cl |
| InChIKey | VEPKQEUBKLEPRA-UHFFFAOYSA-N |
| Установленная основная фармакологическая мишень | Ингибирование MAPK14/p38α; также сообщалось об ингибировании p38β с более низкой селективностью, чем в случае с p38α |
Таблица 6: Химическая и фармакологическая информация для BRD-K91900765/VX-745. В таблице обобщены идентификаторы соединения, псевдонимы, химическое название, молекулярная формула, молекулярная масса, структурные дескрипторы и установленная фармакологическая мишень BRD-K91900765/VX-745.
| Идентификатор CurPocket | Оценка Vina (ккал/моль) | Объем полости (ų) | Центр (x, y, z) | Размер области докинга (x, y, z) |
| C1 | -7.5 | 7568 | 49, 15, 4 | 34, 33, 35 |
| C4 | -7 | 160 | 46, 0, 4 | 22, 22, 22 |
| C3 | -6 | 208 | 34, 15, 9 | 22, 22, 22 |
| C2 | -5.8 | 465 | 45, -6, 19 | 22, 22, 22 |
| C5 | -5.1 | 150 | 63, 0, 20 | 22, 22, 22 |
Таблица 7: Предсказанные карманы докинга для BRD-K91900765/VX-745 с CXCL10 (PDB ID: 1LV9). В таблице приведены ранжированные идентификаторы полостей, баллы Vina, объемы полостей, центры боксов докинга и размеры боксов докинга, рассчитанные с помощью CB-Dock2.
| ID CurPocket | Балл Vina (kcal/mol) | Объем полости (ų) | Центр (x, y, z) | Размер области докинга (x, y, z) |
| C3 | -7.6 | 1593 | 26, 35, 70 | 22, 22, 22 |
| C2 | -7.5 | 1927 | 25, 21, 60 | 35, 22, 22 |
| C1 | -7.4 | 5420 | 32, 37, 48 | 35, 22, 31 |
| C5 | -6 | 464 | 26, 5, 48 | 22, 22, 22 |
| C4 | -5.3 | 683 | 59, 32, 39 | 22, 22, 22 |
Таблица 8: Предполагаемые карманы докинга для BRD-K91900765/VX-745 с JUN (PDB ID: 1JUN). В таблице приведены ранжированные идентификаторы полостей, баллы Vina, объемы полостей, центры бокса докинга и размеры бокса докинга, полученные с помощью CB-Dock2.
| ID CurPocket | Оценка Vina (kcal/mol) | Объем полости (ų) | Центр (x, y, z) | Размер области докинга (x, y, z) |
| C1 | -7.5 | 583 | 15, 4, 17 | 22, 22, 22 |
| C3 | -7.2 | 146 | 19, 21, 24 | 22, 22, 22 |
| C4 | -6.6 | 141 | 31, 19, 15 | 22, 22, 22 |
| C2 | -6.2 | 273 | 38, 9, 24 | 22, 22, 22 |
| C5 | -6.2 | 125 | 27, -7, 10 | 22, 22, 22 |
Таблица 9: Прогнозируемые карманы докинга для BRD-K91900765/VX-745 с IFIH1 (PDB ID: 3B6E). В таблице приведены ранжированные идентификаторы полостей, баллы Vina, объемы полостей, центры бокса докинга и размеры бокса докинга, полученные с помощью CB-Dock2.
| CurPocket ID | Показатель Vina (ккал/моль) | Объем полости (ų) | Центр (x, y, z) | Размер области докинга (x, y, z) |
| C1 | -8.7 | 523 | -18, -14, -5 | 22, 22, 22 |
| C4 | -7.3 | 262 | -13, -6, -9 | 22, 22, 22 |
| C3 | -7 | 306 | 12, 12, -7 | 22, 22, 22 |
| C2 | -6.9 | 408 | -3, 1, -12 | 22, 22, 22 |
| C5 | -6.2 | 179 | 24, 25, 13 | 22, 22, 22 |
Таблица 10: Предполагаемые карманы докинга для BRD-K91900765/VX-745 с MX1 (PDB ID: 5GTM). В таблице представлены ранжированные идентификаторы полостей, баллы Vina, объемы полостей, центры бокса докинга и размеры бокса докинга, рассчитанные с помощью CB-Dock2.
| Идентификатор CurPocket | Балл Vina (ккал/моль) | Объем полости (ų) | Центр (x, y, z) | Размер области докинга (x, y, z) |
| C2 | -8.1 | 7347 | 112, 137, 148 | 33, 28, 35 |
| C3 | -8.1 | 2604 | 124, 124, 176 | 30, 22, 22 |
| C1 | -8 | 7676 | 137, 112, 148 | 34, 29, 35 |
| C5 | -6.9 | 1976 | 117, 157, 88 | 22, 22, 22 |
| C4 | -6.6 | 2040 | 132, 92, 91 | 22, 22, 22 |
Таблица 11: Предполагаемые карманы докинга для BRD-K91900765/VX-745 с TLR7 (PDB ID: 7CYN). В таблице приведены ранжированные идентификаторы полостей, баллы Vina, объемы полостей, центры бокса докинга и размеры бокса докинга, рассчитанные с помощью CB-Dock2.
| Категория | Параметр | Результат | Интерпретация |
| Физико-химическое свойство | Молекулярная масса | 436,27 г/моль | Менее 500 Да, что соответствует порогу молекулярной массы по Липински |
| Физико-химическое свойство | cLogP | Приблизительно 5,49 | Значение немного выше 5, что указывает на высокую липофильность и необходимость учитывать растворимость и неспецифическое связывание |
| Физико-химическое свойство | TPSA (суммарная полярная площадь поверхности) | Приблизительно 47,26 Ų | Низкая полярная площадь поверхности, что соответствует потенциально благоприятной мембранной проницаемости |
| Лекарственно-подобные свойства | акцептор/донор водородной связи | Май-00 | Соответствует пороговым значениям Липински для акцепторов и доноров водородной связи |
| Лекарственноподобность | Вращающиеся связи | 3 | Низкая конформационная гибкость, благоприятная для образования стабильных конформаций связывания |
| Структурные оповещения | PAINS/бренковские оповещения (Brenk alerts) | Не обнаружено | Общих структурных оповещений о реакционной способности или интерференции с широким спектром тестов не обнаружено |
| Прогнозирование токсичности | Мутагенность по тесту Эймса | Прогнозируемая не-Эмсовская токсичность | Указывает на низкий прогнозируемый мутагенный риск; требуется экспериментальное подтверждение |
| Прогнозирование токсичности | Канцерогенность | Предположительно неканцерогенный | Указывает на относительно низкий прогнозируемый долгосрочный канцерогенный риск; требуется экспериментальное подтверждение |
| Примечание по фармакокинетике | Пероральная биодоступность/проникаемость в мозг | Данные литературы и баз данных указывают на наличие доступной для перорального приема малой молекулы, проникающей через гематоэнцефалический барьер | В соответствии с профилем разработки препарата в качестве ингибитора p38α, все еще требуется пересмотр показаний для лечения легочной гипертензии |
Таблица 12: Предварительные прогнозы физико-химических свойств, лекарственно-подобности, ADMET и токсичности для BRD-K91900765/VX-745. В таблице обобщены прогнозируемые физико-химические свойства, показатели лекарственно-подобности, структурные оповещения, показатели токсичности и фармакокинетические характеристики. Данные расчетные прогнозы являются предварительными и не заменяют экспериментальной фармакокинетической или токсикологической валидации.
| ID CurPocket | Оценка Vina (kcal/mol) | Объем полости (ų) | Центр (x, y, z) | Размер области докинга (x, y, z) |
| C1 | -7.9 | 3560 | 2, 22, 34 | 22, 31, 31 |
| C5 | -7.5 | 254 | -9, 28, 60 | 22, 22, 22 |
| C3 | -7.4 | 351 | 12, 7, 37 | 22, 22, 22 |
| C2 | -6.3 | 827 | 18, 5, 28 | 22, 22, 22 |
| C4 | -6.3 | 334 | -16, 17, 38 | 22, 22, 22 |
Таблица 13: Прогнозируемые сайты докинга для BRD-K91900765/VX-745 с его установленной фармакологической мишенью MAPK14/p38α (PDB ID: 1OUK), включенным в качестве положительного контрольного анализа. В таблице приведены ранжированные идентификаторы полостей, баллы Vina, объемы полостей, центры и размеры боксов докинга, полученные с использованием того же рабочего процесса докинга, который применялся к пяти белкам, связанным с биомаркерами.
В совокупности результаты анализа обнаружения и qRT-PCR подтверждают, что CXCL10, JUN, IFIH1, MX1 и TLR7 являются потенциальными биомаркерами ЛГ/ЛАГ, связанными с иммунно-воспалительной дисрегуляцией и ремоделированием легочных сосудов, хотя независимая репликация GSE117261 была наиболее выражена для JUN и варьировалась для других генов. BRD-K91900765/VX-745 представляет собой приоритетного кандидата для перепрофилирования лекарственных средств, выбранного вычислительным методом, с вероятным механизмом ингибирования MAPK14/p38α; перед терапевтической интерпретацией необходима проверка связывания с мишенью, клеточные исследования, изучение фармакокинетики, токсичности и валидация на моделях животных.
ДОСТУПНОСТЬ ДАННЫХ:
Все общедоступные транскриптомные наборы данных, использованные в этом исследовании, доступны в базе данных Gene Expression Omnibus под номерами доступа GSE22356, GSE33463, GSE48149, GSE117261 и GSE210248. Все файлы с кодом, обработанные наборы данных, деидентифицированные необработанные и проанализированные данные qRT-PCR, результаты работы моделей, а также входные и выходные файлы молекулярного докинга были объединены в структурированный репозиторий Zenodo. Репозиторий содержит файл README с описанием каждого файла, версиями программного обеспечения и пакетов, порядком выполнения скриптов и полными шагами для воспроизведения результатов — https://zenodo.org/records/21682282
Обсуждение
Был разработан интегрированный и воспроизводимый рабочий процесс для идентификации молекулярных биомаркеров, связанных с ЛГ/ЛАГ, и потенциальных терапевтических соединений путем объединения данных общедоступной транскриптомики, анализа weighted gene co-expression network, функционального обогащения, анализа сетей белок-белкового взаимодействия, трех алгоритмов машинного обучения, внешней валидации, интерпретации транскриптомики отдельных клеток, подтверждения методом количественной обратной транскрипции с ПЦР, скрининга Connectivity Map и молекулярного докинга. Гены CXCL10, JUN, IFIH1, MX1 и TLR7 последовательно определялись как ключевые гены-признаки и в совокупности были соотнесены с иммунно-воспалительной и интерферон-зависимой молекулярной осью. Эти результаты подтверждают концепцию того, что ЛГ/ЛАГ является не только гемодинамическим расстройством, но и сложным заболеванием с ремоделированием сосудов, включающим иммунную активацию, воспалительную сигнализацию, врожденное распознавание нуклеиновых кислот, а также структурные и клеточные фенотипические изменения2,5,6.
Диагностический потенциал пяти генов был подтвержден с помощью многоалгоритмического отбора признаков и ROC-анализа в когорте для обнаружения. Независимая валидация в GSE117261 оказалась неоднородной, а не единообразной: JUN соответствовал заранее установленным критериям FDR и AUC, CXCL10 продемонстрировал согласованное по направлению номинальное увеличение без статистической значимости FDR по всему транскриптому, IFIH1 и MX1 показали ограниченную воспроизводимость, а TLR7 продемонстрировал противоречивое направление. Эти результаты не подтверждают утверждение о том, что все пять генов были независимо валидированы, и указывают на возможные эффекты состава когорты, гетерогенности тканей, различий платформ и тяжести заболевания. Напротив, qRT-PCR в 20 образцах легочной ткани пациентов с ЛА и 20 контрольных образцах подтвердили значительное повышение экспрессии всех пяти генов и благоприятные показатели ROC-анализа для каждого отдельного гена.
Логистическая модель qRT-PCR на основе пяти генов достигла видимой площади под кривой (AUC) 1,000 (95% ДИ, 1,000–1,000), а ее объединенный показатель AUC при перекрестной проверке остался равным 1,000 в 100 повторных анализах стратифицированной пятикратной перекрестной проверки. Тем не менее, модель была разработана всего на 40 биологических образцах, а полное разделение в небольшой ретроспективной когорте может привести к оптимистичным и нестабильным оценкам эффективности. Таким образом, данную панель следует рассматривать как исследовательскую молекулярную сигнатуру, а не как клинически валидированный диагностический инструмент. Перед внедрением в клиническую практику необходимы более крупные многоцентровые когорты, заранее определенные фиксированные коэффициенты модели, валидация на уровне белков, иммуногистохимический анализ и проспективное тестирование.
Среди пяти основных генов CXCL10 может способствовать привлечению иммунных клеток и локальному усилению воспаления в микроокружении легочных сосудов. IFIH1 и TLR7 участвуют в врожденном распознавании нуклеиновых кислот и могут отражать активацию противовирусных воспалительных путей. MX1 является классическим интерферон-стимулированным геном и может служить нижележащим маркером активации пути интерферона I типа. JUN представляет собой стресс-индуцируемый транскрипционный фактор, который связывает воспалительную стимуляцию с пролиферацией клеток, апоптозом и ремоделированием тканей. В совокупности эти гены указывают на биологически согласованную модель, в которой активация врожденного иммунитета и интерферон-зависимая сигнализация взаимодействуют с процессами сосудистого ремоделирования при ЛС/ЛАГ. Такая интерпретация согласуется с ранее полученными данными о том, что воспаление, иммунитет и интерферон-зависимые пути вносят вклад в патобиологию ЛАГ2,5,6.
Валидация на уровне отдельных клеток обеспечила механистический контекст для результатов, полученных при анализе совокупности клеток. Данные GSE210248 свидетельствуют о том, что ремоделирование легочных артерий при ПАГ сопровождалось изменением взаимодействия между иммунными клетками и структурными клетками сосудов, включая гладкомышечные клетки, фибробласты, эндотелиальные клетки, а также моноциты/макрофаги. Наличие нескольких фенотипических состояний гладкомышечных клеток, включая сократительное, синтетическое, кислородно-чувствительное/перицитоподобное и фибробластоподобное, подтверждает модель заболевания, при которой иммунная активация и структурное ремоделирование клеток происходят одновременно. Эти клеточные доказательства важны, поскольку сигналы совокупной транскриптомики могут возникать из-за изменения пропорций клеток, инфильтрации иммунных клеток или транскрипционных изменений в резидентных сосудистых клетках. Таким образом, анализ отдельных клеток помещает CXCL10, JUN, IFIH1, MX1 и TLR7 в контекст многоклеточной экосистемы ремоделирования легочных сосудов, а не в рамках процесса, затрагивающего один тип клеток18,19,20,21.
Анализ перепрофилирования лекарственных средств определил BRD-K91900765, соответствующий VX-745/нефламапимоду, как наиболее перспективного кандидата по результатам компьютерного моделирования. VX-745 является селективным ингибитором p38α/MAPK14, и его связь с путями воспалительного стресса делает его применение механистически обоснованным в контексте воспаления, связанного с ЛС/ЛКА-гипертензией30. Таким образом, докинг с MAPK14/p38α был включен в качестве механистически релевантного анализа с положительным контролем. Напротив, докинг с CXCL10, JUN, IFIH1, MX1 и TLR7 носил исследовательский характер и указывал лишь на предполагаемую структурную совместимость; он не доказывал, что эти белки-биомаркеры являются прямыми мишенями VX-745, и не устанавливал прямого связывания, ингибирования мишени или терапевтической эффективности. Более биологически правдоподобная гипотеза заключается в том, что VX-745 может косвенно модулировать выявленную иммунно-воспалительную и интерферон-зависимую транскрипционную сигнатуру путем ингибирования MAPK14. Прогнозы Connectivity Map, показатели докинга и оценки ADMET остаются компьютерными данными. Дальнейшая работа должна включать биохимические анализы связывания с мишенью, эксперименты на эндотелиальных клетках и гладких мышцах легочной артерии, модели воспалительной стимуляции, фармакокинетические и токсикологические исследования, а также валидацию на моделях животных.
Недавние экспериментальные исследования гипоксической легочной гипертензии также подчеркнули важность взаимодействия между нейтрофилами и клетками легочных сосудов. Было сообщено, что опосредованные HCK взаимодействия между нейтрофилами и гладкомышечными клетками легочных артерий, а также опосредованные SERPINB3 взаимодействия между нейтрофилами и эндотелиальными клетками способствуют ремоделированию легочных сосудов31˒32. Ось SERPINB3–STAT1/3 особенно актуальна для данных результатов, так как при транскриптомном анализе были выявлены интерферон-зависимые сигналы, а также сигналы STAT1 и JAK–STAT. В совокупности эти наблюдения подтверждают интерпретацию, согласно которой активация иммунных клеток и их взаимодействие со структурными клетками сосудов могут способствовать прогрессированию ЛГ/ЛАГ.
Данное исследование обладает рядом сильных сторон. Для снижения специфической систематической ошибки наборов данных использовались несколько открытых датасетов и коррекция эффекта батча. Для повышения устойчивости признаков были объединены анализ дифференциальной экспрессии, взвешенный анализ генных коэкспрессионных сетей, анализ белок-белковых взаимодействий и три алгоритма машинного обучения. Независимая валидация на объемных образцах (bulk validation), подтверждение методом qRT-PCR и данные секвенирования единичных клеток обеспечили взаимодополняющие, но не идентичные уровни доказательств. Гетерогенные результаты GSE117261 и малая когорта для qRT-PCR также указывают на важные ограничения, включая неполную внешнюю репликацию, потенциальные эффекты, зависящие от ткани и платформы, а также риск переобучения. Поиск биомаркеров был расширен до скрининга соединений-кандидатов, однако анализ докинга носит характер выдвижения гипотез. В будущих исследованиях следует validating пять генов в более крупных независимых когортах с использованием пространственной транскриптомики, протеомики, иммуногистохимии, а также моделей органоидов или сосудов-на-чипе. В целом, CXCL10, JUN, IFIH1, MX1 и TLR7 остаются кандидатными биомаркерами ЛС/ЛАС, связанными с иммуновоспалительным и интерферон-зависимым ремоделированием сосудов, в то время как BRD-K91900765/VX-745 является кандидатом для перепрофилирования лекарственных средств, полученным расчетным путем, терапевтическая значимость которого требует экспериментального подтверждения.
Раскрытие информации
Авторы заявляют об отсутствии конфликта интересов.
Благодарности
Данное исследование было поддержано Проектом по строительству инновационной провинции Хунань (№ 2022JJ30465).
Материалы
| Имя | Компания | Каталожный номер | Комментарии |
|---|---|---|---|
| 2× Мастер-микс SYBR Green для ПЦР | Beijing Solarbio Science & ООО «Технология» | Кат. № SR1110 | Количественная ПЦР в реальном времени с использованием красителей для амплификации и флуоресцентной детекции |
| AI21.msvmRFE.R и e1071 | Пользовательский R-скрипт с использованием пакета e1071 из CRAN | AI21.msvmRFE.R; e1071 v1.7-17 | Метод рекурсивного исключения признаков на основе метода опорных векторов |
| Агароза | Beijing Solarbio Science & Technology Co., Ltd. | Кат. № A8201; CAS 9012-36-6 | Оценка целостности тотальной РНК с помощью электрофореза в агарозном геле |
| Аппарат для электрофореза в агарозном геле | Beijing Liuyi Biotechnology Co., Ltd. | Модель DYCZ-24DN | Электрофоретическая оценка целостности РНК |
| Скоринговая функция AutoDock Vina | Центр вычислительной структурной биологии, Scripps Research | v1.2.0; RRID: SCR_011958 | Оценка позирования белка и лиганда в рамках рабочего процесса CB-Dock2 |
| CB-Dock2 | Лаборатория Cao, веб-сервер CB-Dock2 | v2.0; доступ по состоянию на июль 2026 г. | Слепое определение полостей и молекулярный докинг VX-745 с выбранными структурами белков |
| CellChat | Пакет R CellChat | v2.1.2 | Вывод и визуализация межклеточного взаимодействия на основе матрицы экспрессии отдельных клеток |
| CellChatDB.human | Распространяется вместе с R-пакетом CellChat | CellChatDB.human; подмножество секретируемых сигналов; минимальный порог количества клеток = 10 | База данных взаимодействий лиганд-рецептор человека для CellChat |
| clusterProfiler | R-пакет Bioconductor | v4.20.0; выпуск Bioconductor 3.23 | Анализ обогащения по Gene Ontology и Киотской энциклопедии генов и геномов (KEGG) |
| Карта связей (Connectivity Map (CMap/CLUE)) | Институт Брод | ресурс L1000/CLUE; RRID: SCR_016204; доступ получен в июле 2026 г. | Вычислительный анализ перепрофилирования лекарственных средств |
| Синтетические олигонуклеотидные праймеры | Beijing Solarbio Science & Technology Co., Ltd. | Синтезированы на заказ; последовательности праймеров приведены в таблице 2 | Амплификация ACTB, CXCL10, JUN, IFIH1, MX1 и TLR7 |
| cytoHubba | Магазин приложений Cytoscape | v0.1 | Ранжирование хабовых генов на основе степени связности в сети белок-белковых взаимодействий |
| Cytoscape | Консорциум Cytoscape | v3.10.4; RRID: SCR_003032 | Визуализация и анализ сетей белок-белковых взаимодействий |
| DrugBank | База знаний DrugBank | v6.0; RRID: SCR_002700 | Идентификация соединений и курирование фармакологической информации |
| Система гель-документации | Beijing Liuyi Biotechnology Co., Ltd. | Модель WO-9413B | Визуализация и регистрация результатов проверки целостности РНК с помощью агарозного геля |
| Архив экспрессии генов (Gene Expression Omnibus, GEO) | Национальный центр биотехнологической информации | GSE22356, GSE33463, GSE48149, GSE117261 и GSE210248; RRID: SCR_005012 | Получение наборов данных транскриптомики единичных клеток и объёмных образцов |
| GEOquery | R-пакет Bioconductor | v2.80.0; релиз Bioconductor 3.23 | Программное скачивание и импорт данных об экспрессии и фенотипах из GEO |
| glmnet | пакет R из репозитория CRAN | v5.0 | Логистическая регрессия с применением метода наименьших абсолютных отклонений (LASSO) и регуляризованное логистическое моделирование |
| limma | R-пакет Bioconductor | v3.68.0; Bioconductor выпуск 3.23; RRID: SCR_010943 | Анализ дифференциальной экспрессии и эмпирическая статистика Байеса |
| спектрофотометр NanoDrop | Thermo Fisher Scientific | NanoDrop ND-1000; программное обеспечение v3.8 | Измерение концентрации РНК и коэффициентов чистоты A260/280 и A260/230 |
| NCBI Primer-BLAST | Национальный центр биотехнологической информации | Веб-инструмент; RRID: SCR_003095; доступ в июле 2026 г. | Проверка специфичности праймеров |
| pROC | пакет R из репозитория CRAN | v1.19.0.1; RRID: SCR_024286 | Анализ рабочих характеристик приемника (ROC-анализ), доверительные интервалы Делонга и точки отсечения по индексу Юдена |
| Банк данных белков (Protein Data Bank, PDB) | Банк данных белков RCSB (RCSB Protein Data Bank) | CXCL10: 1LV9; JUN: 1JUN; IFIH1: 3B6E; MX1: 5GTM; TLR7: 7CYN; MAPK14/p38α: 1OUK; RRID: SCR_012820 | Поиск экспериментально определенных структур белков для молекулярного докинга |
| PubChem | Национальный центр биотехнологической информации | PubChem CID 3038525; RRID: SCR_004284 | Восстановление трехмерной структуры и химических идентификаторов BRD-K91900765/VX-745 |
| R | R Foundation for Statistical Computing | v4.6.1; RRID: SCR_001905 | Статистические вычисления, обработка данных, машинное обучение и визуализация |
| случайный лес | пакет R из CRAN | v4.7-1.2 | Отбор признаков и ранжирование переменных по степени важности методом случайного леса |
| Система ПЦР в реальном времени | Stratagene, ныне Agilent Technologies | Система ПЦР в реальном времени Mx3000P | амплификация методом кРТ-ПЦР, регистрация флуоресценции, анализ кривых плавления и экспорт значений Ct |
| Seurat | R-пакет CRAN; лаборатория Satija | v5.5.1; RRID: SCR_016341 | Контроль качества, нормализация, снижение размерности, кластеризация и аннотация при секвенировании РНК единичных клеток |
| Пожалуйста, предоставьте текст (STRING), который необходимо перевести. | Консорциум STRING | v12.0; RRID: SCR_005223 | Построение сети белок-белковых взаимодействий |
| sva (ComBat) | R-пакет Bioconductor | v3.60.0; релиз Bioconductor 3.23 | Коррекция пакетных эффектов между наборами данных |
| SwissADME | Швейцарский институт биоинформатики | Веб-сервер; доступ получен в июле 2026 г. | Предварительный скрининг лекарственно-подобных свойств, физико-химических свойств и параметров ADME |
| Набор для экстракции тотальной РНК | Beijing Solarbio Science & ООО «Технолоджи Ко., Лтд.» | Каталожный номер R1200 | Экстракция и очистка общей РНК из образцов тканей легкого |
| Универсальный набор для ОТ-ПЦР (AMV) | Beijing Solarbio Science & Technology Co., Ltd. | Кат. № RP1200 | Обратная транскрипция тотальной РНК в комплементарную ДНК |
| WGCNA (взвешенный анализ сетей ко-экспрессии генов) | пакет R из репозитория CRAN | v1.74 | Построение взвешенной сети коэкспрессии генов и анализ связи модулей с признаками |
Ссылки
- Simonneau G, et al. Haemodynamic definitions and updated clinical classification of pulmonary hypertension. Eur Respir J. 2019;53(1):1801913. doi: 10.1183/13993003.01913-2018.
- Rabinovitch M, Guignabert C, Humbert M, Nicolls MR. Inflammation and immunity in the pathogenesis of pulmonary arterial hypertension. Circ Res. 2014;115(1):165–175.
- Humbert M, et al. 2022 ESC/ERS Guidelines for the diagnosis and treatment of pulmonary hypertension. Eur Heart J. 2022;43(38):3618–3731.
- Galiè N, et al. 2015 ESC/ERS Guidelines for the diagnosis and treatment of pulmonary hypertension. Eur Respir J. 2015;46(4):903–975.
- Soon E, et al. Elevated levels of inflammatory cytokines predict survival in idiopathic and familial pulmonary arterial hypertension. Circulation. 2010;122(9):920–927.
- George PM, et al. Evidence for the involvement of type I interferon in pulmonary arterial hypertension. Circ Res. 2014;114(4):677–688.
- Subramanian A, et al. A next-generation Connectivity Map: L1000 platform and the first 1,000,000 profiles. Cell. 2017;171(6):1437–1452.e17.
- Leek JT, et al. The sva package for removing batch effects and other unwanted variation in high-throughput experiments. Bioinformatics. 2012;28(6):882–883.
- Ritchie ME, et al. limma powers differential expression analyses for RNA-sequencing and microarray studies. Nucleic Acids Res. 2015;43(7):e47. doi: 10.1093/nar/gkv007.
- Langfelder P, Horvath S. WGCNA: an R package for weighted correlation network analysis. BMC Bioinformatics. 2008;9:559. doi: 10.1186/1471-2105-9-559.
- Yu G, Wang LG, Han Y, He QY. clusterProfiler: an R package for comparing biological themes among gene clusters. OMICS. 2012;16(5):284–287.
- Kanehisa M, Goto S. KEGG: Kyoto Encyclopedia of Genes and Genomes. Nucleic Acids Res. 2000;28(1):27–30.
- Szklarczyk D, et al. The STRING database in protein–protein association networks and functional enrichment analyses for any sequenced genome of interest. Nucleic Acids Res. 2023;51(D1):D638–D646.
- Friedman J, Hastie T, Tibshirani R. Regularization paths for generalized linear models via coordinate descent. J Stat Softw. 2010;33(1):1–22.
- Guyon I, Weston J, Barnhill S, Vapnik V. Gene selection for cancer classification using support vector machines. Mach Learn. 2002;46:389–422.
- Breiman L. Random forests. Mach Learn. 2001;45(1):5–32.
- Robin X, et al. pROC: an open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics. 2011;12:77. doi: 10.1186/s12859-011-0077-8.
- Stearman RS, et al. Systems analysis of the human pulmonary arterial hypertension lung transcriptome. Am J Respir Cell Mol Biol. 2019;60(6):637–649.
- Crnkovic S, et al. Single-cell transcriptomics reveals skewed cellular communication and phenotypic shift in pulmonary artery remodeling. JCI Insight. 2022;7(20):e153471. doi: 10.1172/jci.insight.153471.
- Hao Y, et al. Integrated analysis of multimodal single-cell data. Cell. 2021;184(13):3573–3587.e29.
- Jin S, et al. Inference and analysis of cell–cell communication using CellChat. Nat Commun. 2021;12(1):1088. doi: 10.1038/s41467-021-21246-9.
- Bustin SA, et al. MIQE 2.0: revision of the Minimum Information for Publication of Quantitative Real-Time PCR Experiments guidelines. Clin Chem. 2025;71(6):634–651.
- Livak KJ, Schmittgen TD. Analysis of relative gene expression data using real-time quantitative PCR and the 2−ΔΔCt method. Methods. 2001;25(4):402–408.
- Kim S, et al. PubChem 2023 update. Nucleic Acids Res. 2023;51(D1):D1373–D1380.
- Knox C, et al. DrugBank 6.0: the DrugBank Knowledgebase for 2024. Nucleic Acids Res. 2024;52(D1):D1265–D1275.
- Daina A, Michielin O, Zoete V. SwissADME: a free web tool to evaluate pharmacokinetics, drug-likeness, and medicinal chemistry friendliness of small molecules. Sci Rep. 2017;7:42717. doi: 10.1038/srep42717.
- Burley SK, et al. RCSB Protein Data Bank: powerful new tools for exploring 3D structures of biological macromolecules for basic and applied research and education. Nucleic Acids Res. 2021;49(D1):D437–D451. doi: 10.1093/nar/gkaa1038.
- Eberhardt J, Santos-Martins D, Tillack AF, Forli S. AutoDock Vina 1.2.0: new docking methods, expanded force field, and Python bindings. J Chem Inf Model. 2021;61(8):3891–3898. doi: 10.1021/acs.jcim.1c00203.
- Liu Y, et al. CB-Dock2: improved protein-ligand blind docking by integrating cavity detection, docking, and homologous template fitting. Nucleic Acids Res. 2022;50(W1):W159–W164. doi: 10.1093/nar/gkac394.
- Duffy JP, et al. The discovery of VX-745: a novel and selective p38α kinase inhibitor. ACS Med Chem Lett. 2011;2(10):758–763.
- Sheng Y, et al. Crocin inhibits neutrophil migration and activation to treat hypoxic pulmonary hypertension through targeting HCK. Phytomedicine. 2025;148:157334. doi: 10.1016/j.phymed.2025.157334.
- Cui H, et al. Leonurine ameliorates hypoxic pulmonary hypertension by inhibiting cross-talk between neutrophils and endothelial cells via SERPINB3 targeting. Int Immunopharmacol. 2026;176:116467. doi: 10.1016/j.intimp.2026.116467.